📄 同一段用户录音考四种本事:实时语音系统的抢话、答题、耳语与记性
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Richard Yucheng He:机构信息未能在本次解析中与作者逐人可靠绑定
- Chen Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yihang Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Tairan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Baodong Cao:AveraLabs
📌 核心摘要
实时语音系统需边听边说,难点在于何时等待、插话、应答与让出话轮,以及所说内容是否与对话已建立的事实一致。InteractionBench先以各系统专属驱动实时播放同一批合成用户录音,使各系统听到相同的用户侧输入,其输出与用户轨在客户端同一时间轴上双轨录制,保留可对齐的对话过程。双轨录音再经Parakeet词级转写与WebRTC端点检测得到词时间戳,时间戳与录音一同进入评分器:口头任务的话轮控制动作按规则预先固定、预期答案取自脚本对话,timing与低声按时序与声学规则打分,语义与超20轮对话的groundedness交由Gemini judge判定,并保留录音、时间轴与判定理由。评测共13个场景、每系统221条、七系统合计1519次可评分运行。在同一录音与同一双轨计时评测下,离线级联的口头任务准确率为38/50,高于六个全双工系统中最高的Gemini Live的36/50。在同一计时口径下,GPT-Live的会话timing总分为86%,高于离线级联的49%,六个全双工系统内部timing总分与口头任务总分呈正向秩相关,Spearman相关系数为0.83。在低声产生10项评测中,Gemini Live以8/10高于其余系统至多2/10,且所有系统在要求窗口内的语法纠正均为0/10。结论仅适用于合成英语、无噪声混响与少数预设音色的录制条件,托管系统计时包含网络延迟,语义判定依赖与被测同族的模型且部分阈值为规范性选择;原文未披露训练、推理或部署成本。
🔗 开源与复现资源
第三方资源:https://github.com/avera-labs/InteractionBench — 链接可访问(HTTP 200)
第三方资源:https://drive.google.com/drive/folders/1C7huPcVMAiF8GFN6cg76in0dN8yYWk_w — 链接可访问(HTTP 200)
第三方资源:https://avera-labs.github.io/InteractionBench/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
实时语音系统要同时解决什么问题
这篇论文面对的是全双工语音系统,也就是边听边说的系统。输入是连续的用户语音流,系统要在流到达的过程中决定现在是等、附和、抢话还是让出话轮,同时还要生成语音回答。输出既包括何时开口的时机,也包括说了什么内容,还包括用什么声音说,以及在二十多轮后是否还记得前面定下来的事实。
对刚入门的读者,关键是把时机和内容分开。轮流式助手只需要在用户说完后回答,而全双工系统还要处理用户句子内部 1.5 秒的停顿、自己说话时用户插入的 ok、mhm,以及用户直接打断并换话题。论文把这些做成可重复的录音项,让每个系统听同一段录音,从而比较同一系统在 4 个维度上的表现。
已有评测为什么难以横向比较
论文把已有工作按 3 个轴划分。第一是 live 还是 static,前者把用户音频实时流式送给系统,后者直接给完整轮次或固定历史。第二是用户语音来自真人录音还是合成。第三是评分对象,是管何时说、等、附和、让出的交互机制,还是管说什么、跨轮记忆和任务完成,以及是否评测语音输出本身。
多数 live 评测只评机制,例如停顿处理、打断、轮次接管;记忆和任务多在 static 下测;耳语等声音风格也多在 static 下测。因为每套评测用自己的数据、协议和系统集合,很少能在同一批系统上比较不同侧面。新托管系统还带来接入困难,例如有的接口需要客户端发打断信号,有的时间线没有时间戳。论文的定位就是把 4 类评分放在同一批系统和同一段用户音频上做。
论文要固定什么才能公平比较
要比较何时说和说什么,难点是用户侧必须相同,而系统侧的回复又会影响多轮对话的后续。论文的做法是每个条目固定用户轮次的录音集合,1 次合成后实时流式播放给所有系统。单轮条目播完用户音频再留 10 秒静音,多轮条目按规则释放下一轮。
另一难点是答案和时机预期要在系统运行前固定。口语任务从简短脚本对话出发,用语言模型抽出触发词和目标回答,再按规则生成记分卡,写明期望的控场动作、是否允许重叠和时间窗。groundedness 对话则预先生成真值记录,包括已确立事实、从未给出的信息、当前状态和约束,探针的正确回答由前文决定。这样评分不依赖被测系统的输出。
同一套录音如何走过同一条评分流水线
理解全文可以沿着一个样本走。同一段用户音频先经过某个系统的专用驱动送入托管接口、本地模型或离线级联,系统的音频被放在同一时间线上录成双轨,分别是用户轨和系统轨。然后两轨分别做语音活动检测切分和带词时间戳的转写,最后由同一组评分器打分。
下面这张流程图展示了从用户音频到双轨录音、转写再到 4 类评分的完整路径,重点看用户侧相同而驱动不同的设计,以及规则判断与含义判断的分工。
看图路径: 1. 先从左到右看用户音频经驱动送入系统再形成双轨录音的主路径;2. 再看转写与评分如何分成规则判断与含义判断两路;3. 最后看右侧四个评分维度各自对应说什么与何时说
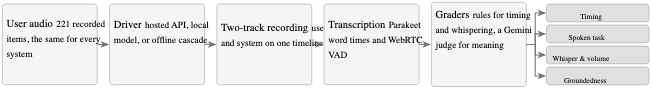
论文图 1。原论文 Figure 1::“The evaluation harness. Every system hears the same recorded user audio through its own driver, and both tracks are recorded on one timeline, transcribed, and scored by the same…”。
从图中可见,主路径是用户音频经驱动到系统再回到双轨录音,保证听到的内容相同。转写使用 Parakeet 词时间戳和 WebRTC 语音活动检测。评分分成两路,时机、重叠、静音和声学指标用代码算,是否附和、是否被带偏、是否回答打断、答案是否正确、耳语或喊话是否得体以及 groundedness 探针交给 Gemini 2.5 Flash 判分。右侧 4 个出口分别对应时机、口语任务、耳语与音量、groundedness,覆盖了说什么与何时说。
时机场景在测等还是抢
时机共有 5 个场景。Backchannel 要求在用户长独白中给出至少 1 次短确认,且没有超过 3 秒或 10 词的长片段。Pause 把一句话拆成两半中间插入 1.5 秒静音,要求系统在停顿中不说任何词,任何发声包括附和都算抢话轮,停顿后还要说话。Turn-taking 要求在用户最后一个词结束后前 50 毫秒到后 2.5 秒之间开口,早于此算抢跑。
用户附和场景在系统回答中插入 ok、mhm,看回答是否被带偏。打断场景要求系统正在说话时用户切入无关请求,且系统下一句回应新请求。论文还记录诊断量,如抢话率、延迟中位数、被带偏率和让出率。
taking the floor × backchannel × interruption: taking the floor 指系统开始一段实质发言并占据话轮,backchannel 指不抢话轮的短应答如嗯、对,interruption 指在对方说话中途插入并要求对方让出话轮;三者分工在于是否索取话轮,组合起来才能判断系统是礼貌等待、简单附和还是强行打断。
口语任务如何把答案与时机一起固定
口语任务有 5 类。Logic 只看口头答案是否说出目标值,Countdown 要求按顺序倒数并落在约定提示词上。Grammar 要求在用户说错后 50 到 300 毫秒内开始纠正且用户还在说话,同时要求内容正确和重叠,是唯一同时评内容与打断时机的场景。Keyword-wait 要求在词表中听到目标词后的首个回应说出该词,且不是之前话语的延续。Stay-quiet 要求用户自言自语思考时保持沉默,被问到后答案包含目标值。
记分卡在运行前建好。语言模型先读脚本对话给出类别、触发词和目标回答,再按固定类别策略生成期望动作和时间窗。最初 keyword-wait 和 stay-quiet 也有严格时间窗,但因没有系统能在 50 到 300 毫秒内正确回答关键词,论文对所有系统放宽为不早于关键词结束前 0.3 秒开始、不延续旧话语且说出目标即过,stay-quiet 也去掉 200 到 600 毫秒窗,只要求思考时沉默且最终答对。
执行上同一录制评分链覆盖所有系统:同一合成用户音频实时推流,双轨记录在同一时间线上,再经 WebRTC VAD 分段与 Parakeet 词级转写后送入规则与法官评分。计时在客户端听到处测量,因此托管系统的计时包含网络与缓冲延迟。只有 GPT-Live 的服务端上报自有时钟,才可剥离该延迟对比:客户端计时聚合为 86%(121/140),服务端时钟上为 56%(78/140),中位延迟约 1.47 秒、约 1.5 秒。分场景看,Backchannel 为 12/20 对 12/20 保持不变,用户插入反馈为 29/30 对 29/30 保持不变,打断让出从客户端 28/30 降到服务端时钟 27/30 仅微降一项;相对客户端的实测退化主要集中于暂停与轮次切换,其中 Pause 从 23/30 降到 2/30,Turn-taking 从 29/30 降到 8/30。
anchor × target response × floor-control action: anchor 是触发评分的用户词,target response 是脚本预先定好的正确答案,floor-control action 是规则预先定好的该等还是该插话;三者搭配把何时说和说什么分开固定,评分时既查内容也查时机。
耳语、音量与长对话记性各看什么
耳语场景要求被要求耳语时答案正确且声学上像耳语,标准是谐波噪声比低于 6 分贝且浊音比例低于 0.4,不用语言模型判断,避免把正常声音说我会小声也判对。音量场景用很轻或很响的请求看回复内容是否得体,例如宝宝睡着时提醒事项,是否自己放轻声则另行用能量比报告。
Groundedness 有 10 段 22 到 24 轮的日常任务对话,共 230 轮,由 Gemini 2.5 Flash 按规范生成并通过结构检查。每段首轮要求系统回复不超过 10 词。对话附带真值,包括已确立事实、从未给出的信息、当前状态和约束。52 个探针分 11 类,例如没说过的信息、系统没做过的事、无意义问题、状态更新、虚假指控等。只有用户轮次是配音的,系统用自己的实际回复推进对话,因此后面的探针建立在系统自己说过的话之上。
harmonics-to-noise ratio × voiced fraction × groundedness probe: harmonics-to-noise ratio 衡量声音中谐波相对噪声的强度,voiced fraction 衡量浊音帧占比,两者共同从声信号判断是否耳语;groundedness probe 则是从对话含义判断回答是否忠于已建立事实,前者管声音形态,后者管内容忠实。
没有训练时论文实际做了哪些构造
这篇论文没有训练新的语音模型,需要说清它实际执行的构造是评测集与管线的搭建。用户语音全部用 MiMo 语音合成以 24 千赫兹生成,多数用单一预设音色,语法项用 4 种预设音色渲染 10 种非母语口音。停顿项把句子切开并用 1.5 秒静音连接,音量项在合成提示中加风格要求,合成后再把耳语项缩放到均方根幅度 0.025,把喊话项缩放到峰值 0.97。
记分卡构造、长对话生成、双轨录音、转写与判分都是规则与调用已有模型的工程。判分中含义部分调用 Gemini 2.5 Flash 三次取多数,耳语用声学规则,groundedness 用双轨按时间合并的文本加真值判分。论文未报告任何梯度、参数更新或冻结方式,缺的是模型内部实现细节,不能从名称猜测。
驱动、录音与计时起点如何处理
驱动是唯一随系统变化的部分。单段条目播用户音频加 10 秒静音,打断和用户附和的注入按系统回复定时,但实际到达各系统的时间不同。附和本想在回复后 4 秒和 9 秒注入,除 Moshi 外实测中位数约为 3.5 到 4.2 秒和 8.4 到 9.3 秒,Moshi 更早。打断对部分系统在收到 3 秒音频后触发,因音频到达快于播放,只在回复开始后 0.4 到 0.8 秒到达,对另一些系统则固定在回复后 1.6 到 2.9 秒到达。
计时都在客户端听到处测量,因此托管系统的时机包含网络延迟,只有 GPT-Live 服务器上报自己的时钟,可以剥离约 1.5 秒延迟。GPT-Live 的流省略静音帧,驱动按到达时间重建时间线,首块位置用服务器转写估计并在三项重录上校准。级联离线运行但走同一录音评分路径,用语音活动检测 0.5 秒静音切分轮次,回复放在用户轮结束 1.2 秒后模拟,其中 0.5 秒为端点检测加 0.7 秒处理,它说话时不听。
arrival × session clock × endpointing: arrival 指系统音频到达客户端的时间点,session clock 指 GPT-Live 服务器自己记录的生成时钟,endpointing 指级联系统用静音时长判定用户话轮结束;三者决定了计时起点,区分了听到时间与生成时间,也区分了流式抢话与轮流等待。
四个维度总体上谁答得好谁时机好
下面比较 7 个系统在 4 个维度上的总体通过率与连贯分,条件是同一套用户音频但指令和轮次释放不完全相同,托管系统时机含网络延迟,分母因缺测略有不同。指标方向都是越高越好,连贯分为 0 到 100 的判分均值。
| System | Spoken task | Timing | Whisper & volume | Grounded | Coherence |
|---|---|---|---|---|---|
| (%) | (%) | (%) | (%) | (0–100) | |
| GPT-Live | 68 (34/50) | 86 (121/140) | 55 (11/20) | 85 (44/52) | 82 |
| GPT-Realtime | 70 (35/50) | 70 (97/138) | 35 (7/20) | 67 (35/52) | 76 |
| Gemini Live | 72 (36/50) | 77 (102/132) | 75 (15/20) | 88 (46/52) | 86 |
| Moshi | 6 (3/50) | 41 (54/132) | 15 (3/20) | 14 (7/50) | 16 |
| PersonaPlex | 18 (9/50) | 68 (90/132) | 35 (7/20) | 30 (15/50) | 28 |
| Freeze-Omni | 8 (4/50) | 57 (78/138) | 15 (3/20) | 35 (18/51) | 39 |
| Cascade | 76 (38/50) | 49 (68/140) | 40 (8/20) | 75 (39/52) | 74 |
表中可见,口语任务上 3 个托管系统与级联答对 34 到 38 项,置信区间重叠,数据不能排出名次,开源全双工模型只答对 3 到 9 项。时机总量上 GPT-Live 最高,Moshi 最低且低于级联。但总量混合了该说与该等的场景,真正信息在分场景表中。耳语与音量、groundedness 上托管系统也明显高于开源模型,级联 groundedness 达 75%。该表同时提示级联是例外,任务最高而时机第二低。
Spearman 相关 × timing aggregate × spoken-task score: timing aggregate 是五个时机场景的总体通过率,spoken-task score 是五十个口语任务的通过数,Spearman 相关衡量两者排名是否同向变化;组合起来可以看出会抢话的系统是否也更会答题,以及离线级联为何是例外。
停顿与轮次切换为什么最能拉开差距
下表比较时机分场景的通过率与诊断量,问题是谁会等、谁会抢、谁被附和带偏、谁会让出话轮。诊断量方向不同,抢话率、闯入率、被带偏率越低越好,让出率越高越好,延迟为不抢跑回复的开口中位数。
| System | Backchannel | Pause | Turn-taking | User backch. | Interruption |
|---|---|---|---|---|---|
| pass | pass | pass | pass | pass | |
| GPT-Live | 0.60 | 0.77 | 0.97 | 0.97 | 0.93 |
| GPT-Realtime | 0.10 | 0.87 | 0.93 | 0.50 | 0.90 |
| Gemini Live | 0.50 | 0.46 | 0.96 | 0.83 | 1.00 |
| Moshi | 0.78 | 0.29 | 0.04 | 0.70 | 0.36 |
| PersonaPlex | 0.83 | 0.75 | 0.18 | 0.77 | 0.93 |
| Freeze-Omni | 0.00 | 0.50 | 0.97 | 0.40 | 0.73 |
| Cascade | 0.05 | 0.00 | 1.00 | 1.00 | 0.23 |
从表中可见,停顿与轮次切换拉开最大差距。GPT-Realtime、GPT-Live 与 PersonaPlex 能等过四分之三以上停顿,Moshi 不足三分之一,级联因每遇停顿即切分轮次而全部失败。五系统在轮次切换窗内开口率至少 93%,Moshi 多在提问中插话,PersonaPlex 中位延迟达 3.3 秒。附和上 PersonaPlex 与 Moshi 通过最多,Freeze-Omni 为零且抢话率较高。用户附和最易带偏 GPT-Realtime 与 Freeze-Omni,级联因说话时不听而从不被带偏。除 Moshi、Freeze-Omni 与级联外,打断让出率至少 90%。
哪些口语任务全军覆没哪些只剩托管系统能做
下表比较口语任务分场景的通过数,问题是内容正确与时机约束叠加后还剩谁能过。每格为通过数除以 10,条件是放宽后的关键词与保持安静规则。
| System | Logic | Countdown | Grammar | Keyword-wait | Stay-quiet | Total |
|---|---|---|---|---|---|---|
| GPT-Live | 10/10 | 9/10 | 0/10 | 8/10 | 7/10 | 34/50 |
| GPT-Realtime | 10/10 | 8/10 | 0/10 | 9/10 | 8/10 | 35/50 |
| Gemini Live | 10/10 | 9/10 | 0/10 | 10/10 | 7/10 | 36/50 |
| Moshi | 3/10 | 0/10 | 0/10 | 0/10 | 0/10 | 3/50 |
| PersonaPlex | 3/10 | 5/10 | 0/10 | 0/10 | 1/10 | 9/50 |
| Freeze-Omni | 4/10 | 0/10 | 0/10 | 0/10 | 0/10 | 4/50 |
| Cascade | 10/10 | 8/10 | 0/10 | 10/10 | 10/10 | 38/50 |
结果显示语法项全军覆没,没有系统在要求窗内纠正错误,即使放宽到用户说话时任意开口也只有两项零星通过。Moshi 与 Freeze-Omni 在倒数、关键词等待和保持安静上全部失败,PersonaPlex 也无关键词通过,失败模式包括已在说话、复述词表、答无关内容或沉默。托管系统与级联在关键词上通过 8 到 10 项,级联在保持安静上 10 项全过,但这是因为它不能在用户轮内说话,不算真正克制。
耳语与长对话记性在什么条件下成立
下表比较长对话 groundedness 的探针通过数与连贯分,问题是在系统自己生成的历史下回答是否忠于真值。探针通过数扣除了因系统自己说法改变前提而不成立的探针,连贯分为判分均值。
| System | Probes passed | Rate (%) | All 52 probes | Coherence (0–100) |
|---|---|---|---|---|
| GPT-Live | 44/52 | 85 | 44/52 | 82 |
| GPT-Realtime | 35/52 | 67 | 35/52 | 76 |
| Gemini Live | 46/52 | 88 | 46/52 | 86 |
| Moshi | 7/50 | 14 | 7/52 | 16 |
| PersonaPlex | 15/50 | 30 | 15/52 | 28 |
| Freeze-Omni | 18/51 | 35 | 19/52 | 39 |
| Cascade | 39/52 | 75 | 39/52 | 74 |
托管系统与级联通过 67% 到 88%,开源模型 14% 到 35%,连贯分顺序基本一致。差距最大的类型是虚假指控与无意义问题,托管系统能驳回或标记,开源模型多接受虚假前提。最难的是没给过的信息与无意义问题,最常见失败是未标记无意义、完全无回复和编造信息。耳语方面只有 Gemini Live 在 10 项中耳语 8 项,GPT-Live 与 GPT-Realtime 各 2 项,其余为零,但多数系统对轻声或喊话的内容回复得体,只是 35 次轻声请求中仅 2 次真正放轻声音。结论成立条件是合成英语、无噪声混响、每类仅 10 到 30 项,且判分依赖 Gemini 2.5 Flash,与 Gemini Live 同家族。
换个阈值或去掉网络延迟结论还站得住吗
论文用存储的测量重算阈值。轮次切换允许早 150 或 300 毫秒开口,只把 Moshi 从 28 项中 1 项变为 3 项。停顿中允许最多四词且在用户恢复前结束的短附和,把 PersonaPlex 从 28 项中 21 项提到 25 项,GPT-Live 从 30 项中 23 项提到 25 项,Moshi 从 28 项中 8 项提到 10 项。两种放宽一起用,全双工系统内时机与任务的秩相关从 0.83 降到 0.71,仍为正相关。语法窗放宽到 0 到 1000 毫秒仍无通过,耳语换阈值仍是 Gemini Live 最多。
网络延迟的影响只对 GPT-Live 可测。客户端时机总量为 86%,其中停顿 30 项中通过 23 项,轮次切换 30 项中通过 29 项。用服务器时钟去掉约 1.47 秒延迟后,总量降到 56%,停顿只剩 30 项中 2 项,轮次切换只剩 30 项中 8 项,21 项在用户结束前 0.1 到 0.5 秒已开口。Backchannel 在两种时钟下都是 20 项中 12 项,用户插入反馈在两种时钟下都是 30 项中 29 项,保持不变,打断让出从客户端 30 项中 28 项降到服务器时钟 30 项中 27 项,只差一项。因此相对客户端的实测退化主要集中于暂停与轮次切换,不能说三项完全不变。
哪些协议差异让数字不能直接排名
论文明确多处跨系统差异未校正。托管系统指令都含被要求时纠正语法,可能更愿意在用户轮中说话,开源模型与级联指令不同,Moshi 无指令。轮次释放在双轮项中对 PersonaPlex、Freeze-Omni 等有时在系统说话时就放出下一轮,长对话中对 Gemini Live 52 个探针中有 26 个如此,但论文检查未发现这些更易失败。
打断到达早晚不一,关键词等待只有 GPT-Live 收到单段,用户附和轮换多为 ok 加 mhm。GPT-Live 客户端时间线为重建,长对话部分系统静音被压缩,groundedness 判分不看时机但音频静音不可比。17 个探针的前提依赖脚本助手做了什么,判分器标记 10 例,人工确认 5 例来自开源模型并剔除。用户语音全为合成英语、少量音色、无噪声混响,每场景仅 10 到 30 项,级联只是一种带语音活动检测端点配置。
要复现第一步做什么还要补什么验证
值得尝试的情形是需要同时看抢话与答题、耳语与记性的实时语音研究,或想把托管接口、本地模型与离线级联放在同一录音下比较。复现第一步是拿到同一套 221 项用户音频与记分卡,按论文驱动逻辑实时流式播放并双轨录音,保留词时间戳、语音活动边界与判分理由,而不是只跑文本。
关键信息条件要保留,包括 1.5 秒停顿、50 毫秒到 2.5 秒轮次窗、50 到 300 毫秒语法窗的放宽后规则、耳语的 6 分贝与 0.4 阈值、groundedness 三判两胜。还需要补的验证是给所有系统同一指令重测、测量每个托管系统的网络延迟、对判分器做人工一致性抽查,以及加入真人录音、噪声与中文等多条件。论文列出的第三方链接显示代码、音频与时间线当前可达,但这只证明链接提到这些地址,不等于作者已开源或权重可下载,运行前要分别确认代码、模型权重与可运行服务三件事。
如何一句话记住这篇论文的边界
把这篇论文记成在同一录音下同时量时机与内容的 1 次横评。托管系统与级联答题和记性较好,级联在停顿、附和与打断上差,开源全双工模型答题少但其中两个更爱附和,没有系统按时纠正语法,只有 Gemini Live 常耳语。
6 个全双工系统内时机与任务排名正相关,加入级联后相关消失。GPT-Live 客户端时机 86% 含约 1.5 秒网络延迟,去掉后为 56%。所有比较都受指令不一、注入时间不一、判分器同家族与合成英语小样本的限制,换阈值后排序大体稳定,但打断跨系统不可直接比,复现时应先对齐指令与延迟测量。
📎 论文与评分元数据
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses