📄 GSLM2:多层语音单元与多流建模如何缩小语音与文本的语言能力差距
英文题目:GSLM2: Multi-Stream Speech Representation Learning and Generative Spoken Language Modeling
评分:8.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Yosuke Higuchi:Meta Superintelligence Labs
- Tom Fizycki:Meta Superintelligence Labs;Université Paris Dauphine-PSL
- Mahi Luthra:Meta Superintelligence Labs
- Charles-Éric Saint-James:Meta Superintelligence Labs
- Azeez Syed:Meta Superintelligence Labs
- Angel Villar-Corrales:Meta Superintelligence Labs
- Mido Assran:AMI Labs
- Nicolas Ballas:AMI Labs
- Jiayi Shen:Meta Superintelligence Labs
- Dongyan Lin:Meta Superintelligence Labs
- Phillip Rust:Meta Superintelligence Labs
- Surya Parimi:Meta Superintelligence Labs
- Vanessa Stark:Meta Superintelligence Labs
- Alexandre Allauzen:Université Paris Dauphine-PSL
- Balázs Kegl:Doctolib
- Juan Pino:Meta Superintelligence Labs
- Emmanuel Dupoux:Meta Superintelligence Labs;Ecole des Hautes Études en Sciences Sociales
📌 核心摘要
读者需要理解的对象是不依赖文本、直接从连续语音学习语言结构的生成式口语语言模型,困难在于语音采样率高而信息密度低,单层单流离散单元要在紧凑性和语音细节之间取舍,处理过程是先把波形变成离散单元序列,再做自回归预测。SpidR二代编码器在学生-教师框架下用层相关的共享预测头学习多层离散单元空间,输出互补抽象层次的并行单元流,避免单层均值量化的后处理取舍。多流语言模型接收上述多层单元序列,用共享时序主干加流内预测和元组内自回归生成头联合建模,把互补层次分布到并行流中保留。在Libri-Light 60K小时、1.2B参数设置下,GSLM2的sWuggy、sBLIMP和tSC准确率分别为79.3%、71.8%和84.5%,分别高于同规模SpidR单流模型5.4、9.4和9.4个百分点。在最高达6M小时互联网对话语音的扩展实验中,以追平文本模型平均指标所需的额外数据量衡量,GSLM2的差距低于SpidR单流的大约四个数量级,降至大约两个数量级。结论适用于朗读和会话英语的词汇句法语义评测,sSC等更难的篇章推理和韵律重建尚未解决。原文披露多流训练计算量约为单流的三倍,未披露部署成本。
🔗 开源与复现资源
代码相关资源:https://github.com/facebookresearch/gslm2 — 链接可访问(HTTP 200)
第三方资源:https://github.com/facebookresearch/spoken-lm — 链接可访问(HTTP 200)
模型相关资源:https://github.com/facebookresearch/gslm2 — 链接可访问(HTTP 200)
第三方资源:https://github.com/Alexander-H-Liu/dinosr — 链接可访问(HTTP 200)
第三方资源:https://github.com/facebookresearch/spidr — 链接可访问(HTTP 200)
第三方资源:https://github.com/facebookresearch/fairseq/tree/main/examples/speech_synthesis — 链接可访问(HTTP 200)
第三方资源:https://github.com/jik876/hifi-gan — 链接可访问(HTTP 200)
第三方资源:https://github.com/facebookresearch/lt-swap — 链接可访问(HTTP 200)
第三方资源:https://github.com/OHF-Voice/piper1-gpl — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
无文字语音建模要解决什么输入输出问题
生成式口语语言模型的研究对象是连续语音波形,目标是在没有任何文字转写监督的条件下学到语言结构。输入是 16 kHz 采样的原始波形,经过卷积下采样变成每秒 50 帧的特征,再变成离散单元序列,语言模型对这个符号序列做自回归预测。必须保留的信息包括词的区分性、句法可接受性和故事语义连贯性,输出则是能打分也能续写的语音序列。
已有路线的瓶颈很具体:常用分词器只对编码器某一层做 k 均值量化,只能保留该层抽象级别的信息,而语音编码器的不同层实际分布着互补的音素和语义线索;同时语言模型只建模单流单元,丢掉了多层信息。本文把这两个瓶颈分别交给编码器和语言模型处理,这就是后文 SpidR 2.0 和多流模型分工的由来。
对刚进入语音方向的研究生而言,关键是把语音建模与文本建模对齐理解。文本模型的输入符号是现成的字或词,语音模型的输入符号必须自己从波形中发现;发现得不好,后续再大的语言模型也难以补救。因此论文把分词器放在与语言模型同等重要的位置,并用词法、句法、语义 3 类任务分别检验符号质量。
已有分词与多层表示路线为何不够
与本文最接近的是 HuBERT 加 k 均值、DinoSR 和 SpidR 等自监督离散化路线。它们用掩码预测目标学习表示,再把某层表示量化成单元,做法简单但量化与预训练分离,在线码本在 SpidR 上甚至不如后处理 k 均值。神经编解码器如 SoundStream 和 EnCodec 则为波形重建优化,保留了大量与语言预测无关的声学细节,不一定具有语言不变性。
多层表示方面,AudioLM 级联语义与声学单元,SpeechTokenizer 等用残差向量量化分层组织内容与保真度,思路都围绕内容与重建的折中,而不是同时提升语言能力。本文附录明确把使用文本监督或预训练大模型做语义对齐的工作列为互补路线,本文只研究无文字的 GSLM 标准形式,包括分词器、语言模型和单元声码器 3 段式流程。
这样划分的意义在于保证比较条件一致:输入都是语音、目标都是语言结构、运行阶段都不依赖文字。只有在这个前提下,才能判断多层可微分词与多流建模是否真正带来了语言能力的提升,而不是靠引入额外文本监督取胜。
论文把差距拆成哪两个可验证的子问题
论文认为口语模型落后于文本模型的差距来自两处。第一是单元的语言质量不高,现有单元在词法、句法和语义判别任务上偏弱;第二是单流表示的信息瓶颈,即使编码器多层含有互补信息,单流语言模型也用不上。
为此论文设定可验证的对照:同样数据和相近参数下,比较 SpidR 单流、SpidR 2.0 单流和 GSLM2 多流,以及文本模型上限。如果只是换编码器就提升,说明单元质量是瓶颈;如果在同一批 SpidR 2.0 单元上多流再提升,说明多层联合建模有独立贡献。扩展到 6M 小时口语和 6.5B 参数则是检验这种提升能否随规模保持。
这种拆分也决定了后文的阅读顺序:先看编码器是否在不增加数据的情况下改善单元,再看语言模型是否在同一单元基础上进一步利用多层信息,最后看数据规模扩大时两步改进的斜率是否保持。
GSLM2 的整体流程是怎样衔接的
GSLM2 包含两个相互衔接的新组件。第一步是 SpidR 2.0 编码器预训练,它在选定的多个编码器层上学习离散码空间,推理时对每层每帧取最大概率得到离散单元。第二步是多流口语语言模型,它从多个层的单元流构造跨流去重后的联合序列,用共享 Transformer 建模跨位置的时序依赖,再用流特定头与生成头分别建模流内转移和流间联合分布。
在编码器侧,学生与教师均为多层 Transformer 编码器,学生接收掩码输入序列,教师处理其未掩码对应序列,教师参数按学生参数的指数滑动平均更新。在选定集合中的每一层都附有一个层特定预测头,同一预测头同时作用于该层的教师表示与学生表示,输出该层码本上的软分布;预训练时这些分布作为可微分的软分配参与自监督学习,推理时则经取最大概率转换为离散单元,从而省去在线码本维护与事后聚类。学生编码器无掩码前向即可对每层每帧抽取最可能码,形成各流的原始单元序列。
在语言模型侧,多流建模只使用选定层中的子集作为单元流。对每个流先保留逐帧取最大概率的原始序列,再做跨流去重:仅当该帧在全部流上都与上 1 帧相同才删除,否则保留,因此保留帧是各流变化点的并集;当某 1 流变化而另 1 流不变时,不变流会在相邻位置出现重复单元,这与单流独立去重不同。去重后各流共享同一长度,形成每位置为多元组的联合序列。每个流有独立嵌入层,同一位置各流嵌入取平均后送入共享的解码器 Transformer 得到上下文表示。
流特定头据此预测下 1 位置各流的转移分布,为共享主干提供显式逐流监督,生成头则按固定流顺序在元组内自回归采样,刻画同一位置内各流的持续与相互依赖。两者分工互补,共同训练共享时序主干。
沿一个样本走一遍:波形进入学生与教师编码器,教师看完整序列,学生看掩码序列,各选中层经预测头得到码分布并用于自监督训练;训练完成后,用学生编码器无掩码前向,对每层每帧取最大概率码得到原始多流,再做跨流去重得到等长联合序列,送入多流语言模型训练;生成时由生成头逐位置逐流采样,再经时长预测器恢复被去重压缩的帧数,并经 HiFi-GAN 声码器合成波形。
SpidR 2.0 如何得到多层可微分的离散单元
SpidR 2.0 沿用学生教师框架,学生接收掩码输入,教师处理未掩码输入,教师参数是学生参数的指数滑动平均。区别在于它不用每层独立维护在线码本,而是在集合中的每一层挂一个层特定预测头,同一预测头同时作用于该层的教师表示和学生表示,输出对码本的分布。预测头由无仿射参数的通道层归一化加线性投影组成,推理时取最大概率下标即为离散单元。
该分布的形成方式由下式给出,它说明教师与学生表示如何经各自归一化与投影后变成码分布。
\[\mathbf{p}_{l,t}=\mathrm{Softmax}\Bigl(\phi_{l}\bigl(\mathrm{IN}(\mathbf{h}_{l,t})\bigr)\Bigr),\qquad\tilde{\mathbf{p}}_{l,t}=\mathrm{Softmax}\bigl(\phi_{l}(\tilde{\mathbf{h}}_{l,t})\bigr),\]语音分词器 × 离散语音单元: 语音分词器负责把连续波形变成离散语音单元序列,离散语音单元是后续语言模型实际看到的符号;分词器决定保留哪些语音属性而丢掉哪些声学细节,单元质量直接决定语言模型能否学到词法和句法,因此 GSLM2 先改进分词器再改进建模。
自监督损失让学生在被掩码位置上预测教师的软分配,停止梯度符号表示教师分布不回传梯度,只作为目标。
\[\mathcal{L}_{\mathsf{ssl}}=-\frac{1}{|\mathcal{K}|}\sum_{l\in\mathcal{K}}\frac{1}{|\mathcal{M}|}\sum_{t\in\mathcal{M}}\sum_{c=1}^{C}\mathrm{sg}(\mathbf{p}_{l,t}[c])\,\log\tilde{\mathbf{p}}_{l,t}[c],\]SpidR 2.0 × 共享预测头: SpidR 2.0 是本文的编码器预训练方法,共享预测头是它在每个选中层上为学生分支和教师分支共用的一组映射;预测头把两分支的连续表示映射到同一个码本分布上,使分词过程在预训练中可微,省去在线码本维护,并让多个层同时学到稳定的离散空间。
这样分词在预训练中全程可微,梯度能经预测头回传,同时省去维护在线码本的聚类步骤。编码器在 LibriSpeech 上预训练后,第 10 层的音素辨别结果最好,第 7 层的词级检索结果最好,这种分层互补正是多流建模的前提。
多流语言模型如何表示和预测同一时刻的多个单元
设选中流集合为多个编码器层,对每个流取逐帧最大概率码得到原始序列。为缩短序列并保留任 1 流的变化,论文做跨流去重:只有当所有流在该帧都与上 1 帧相同时才删掉该帧,否则保留。这样保留帧是各流变化点的并集,某流在相邻保留位置上可能出现重复单元,这与单流独立去重不同。去重后得到联合序列,每个位置是一个包含各流单元的元组。
跨流去重 × 多流序列: 跨流去重是构造多流序列的合并规则,只有当所有流在该帧的单元都与上一帧相同时才删掉该帧;保留下来的帧在各流之间共享位置编号,形成多流序列,这样不同层的变化点取并集,既缩短序列又保留每个流的变化信息。
每个流有自己的嵌入层,同一位置各流嵌入取平均得到输入向量,共享解码器 Transformer 处理历史嵌入得到上下文向量。每个流的流特定头从该上下文预测下 1 位置的该流单元,形式为线性层加 Softmax。
\[p_{l}^{\mathsf{ms}}(\cdot\mid\mathbf{q}_{1},\ldots,\mathbf{q}_{u-1})=\mathrm{Softmax}\bigl(\mathrm{Linear}_{l}(\mathbf{y}_{u})\bigr),\]共享时序主干 × 流特定头 × 生成头: 共享时序主干是处理多流历史的 Transformer 解码器,负责捕捉跨位置的时序依赖;流特定头从共享上下文分别预测每个流的下一个不同单元,强调转移动态,生成头则在同一位置内按固定顺序自回归预测各流单元,负责刻画同一时刻内流之间的依赖,二者共同训练主干。
流特定头彼此条件独立,无法刻画同一时刻内各流之间的依赖,因此另设基于深度 Transformer 的生成头,按固定顺序在同一位置内自回归预测各流单元。
\[p(\mathbf{q}_{u}\mid\mathbf{q}_{1},\ldots,\mathbf{q}_{u-1})=\prod_{j=1}^{|\mathcal{J}|}p\bigl(q_{\pi(j),u}\mid\mathbf{y}_{u},q_{\pi(1),u},\ldots,q_{\pi(j-1),u}\bigr).\]评分时用流特定头在单元变化位置取平均对数概率,生成时用生成头逐流采样。两种头在训练中共同约束共享主干,前者强调转移,后者强调联合保持。
熵正则与多流损失如何约束训练
只用共享预测头而不加约束会出现坍缩解,例如所有输入被映射到单个码或均匀分布。论文在教师分布上加两项熵正则:最小化每个位置预测分布的条件熵以保持单点确信,最大化批量平均分布的边缘熵以保持码本利用率,权重分别为两项系数。默认条件熵权重固定为较小常数,边缘熵权重先取较大值并在 20,000 步后降到很小值。
\[\mathcal{L}_{\mathsf{reg}}=\frac{1}{|\mathcal{K}|}\sum_{l\in\mathcal{K}}\Bigl[\mu\,\mathbb{E}_{t}\bigl[H_{c}(\mathbf{p}_{l,t})\bigr]-\lambda\,H_{c}\bigl(\mathbb{E}_{t}[\mathbf{p}_{l,t}]\bigr)\Bigr],\]该公式第一项惩罚不确信的逐点分布,第二项奖励批量层面分散的码使用;两项配合才能既避免坍缩到单码,又避免退化为与输入无关的均匀分布。论文还比较了只正则教师与同时正则学生、保持常数与分段衰减等变体,发现默认设置在词级检索、比特率和单元时长之间取得较好平衡。
多流语言模型训练时随机抽取一条流计算单流预测损失,用同一模型单流模式下停止梯度的预测分布对多流模式做转移位置自蒸馏,再加上生成头的多流元组损失。论文把两个系数都设为较小常数。编码器在 LibriSpeech 960 小时上训练 400,000 步,语言模型在 Libri-Light 600 小时、6K 小时和 60K 小时以及最大 6M 小时口语上按规模配置批量、上下文和步数,GSLM2 因跨流去重后序列更长而使用更大批量和更长上下文。
数据、模型规模与评价指标如何对应能力
编码器统一用 12 层 Transformer,主干约 90M 参数,SpidR 2.0 在高层区间挂预测头,每层码本为 256 个码。语言模型用解码器 Transformer,按 90M、300M、1.2B、2.5B 和 6.5B 配置,GSLM2 另加约 6M 参数的 6 层生成头。文本模型作为可比上限,在对应转写文本上训练,词表为 4096 的字节对编码。
sWuggy × sBLIMP × tSC: sWuggy 考查词法层面能否给真词更高分数,sBLIMP 考查句法层面能否给合乎语法的句子更高分数,tSC 考查语义层面能否给与故事主题一致的结尾更高分数;三者分别对应论文的主要评价维度,合在一起看才能判断多层单元带来的是全面语言能力还是单一任务提升。
评价套件覆盖词法、句法和语义。配对比较任务用似然打分算准确率,方向都是越高越好,机会水平为 50%。生成任务用提示续写加声码器合成,再转写计算困惑度和大模型打分,困惑度越低越好,大模型打分越高越好。编码器另用三音子辨别错误率和词级平均精度评估表示质量,前者越低越好,后者越高越好。
下表是原文的评价套件划分,说明每个指标的比较对象和能力归属,配对任务看正确项是否得更高分,生成任务看续写质量。
| Benchmark | Metric | Capability | Evaluation |
|---|---|---|---|
| ZeroSpeech’21 | sWuggy(-all) | Lexical | Real word vs. phonotactically matched nonword. |
| ZeroSpeech’21 | sBLIMP | Syntax | Grammatical vs. minimally different ungrammatical sentence. |
| StoryCloze (SC) | Topic SC (tSC) | Semantics | Correct ending vs. random ending from another story. |
| StoryCloze (SC) | Spoken SC (sSC) | Semantics | Correct ending vs. adversarial, superficially plausible ending. |
| LongTail-Swap | WordSwap (WS) | Semantics | Context-appropriate word vs. frequency- and POS-matched substitution. |
| LongTail-Swap | InflectionSwap (IS) | Morphosyntax | Context-appropriate inflection vs. another form of the same lemma. |
| LongTail-Swap | AgreementSwap (AS) | Syntax | Matching vs. mismatching grammatical agreement. |
| Continuation | ASR-PPL | Fluency | LM perplexity of an ASR-transcribed continuation at a calibrated temperature. |
| Continuation | LLM Judge | Quality | Rubric-based relevance, coherence, and fluency of the transcribed continuation. |
该表把配对判别与生成评价分开,前者看能否给正确项更高分数,后者看续写经转写后的流畅性和质量;后续主结果与生成结果都按此划分解读,不能把困惑度改善直接等同于语义理解提升。表中还包含长尾替换任务,用于检验低频词、屈折和一致性等更细的语言现象。
主结果在三个规模上支持什么结论
在 Libri-Light 3 个规模下比较的问题是:相同数据和相近参数时,换编码器和加多流是否各自带来提升。指标方向为准确率越高越好。GSLM2 在词法、句法和主题语义上同时高于两个单流基线,且随规模保持优势;在最大朗读规模时已在句法项上追平文本上限。难例故事完形在小规模接近机会水平,大规模才拉开差距,说明难例需要更大规模。
下表是 3 个规模下的主要配对任务结果,同一规模内先看文本上限,再看单流之间的单元改进,最后看单流到多流的增益。
| ZS21 (↑) | ZS21 (↑) | SC (↑) | SC (↑) | LT-Swap (↑) | LT-Swap (↑) | LT-Swap (↑) | ||
|---|---|---|---|---|---|---|---|---|
| Model | Model | sWug. | sBLI. | tSC | sSC | WS | IS | AS |
| 600 h / 90M | Text LM | 73.4 | 61.7 | 75.4 | 53.4 | 73.5 | 80.6 | 62.2 |
| 600 h / 90M | SpidR SLM | 67.4 | 54.2 | 65.4 | 52.4 | 54.3 | 57.9 | 54.2 |
| 600 h / 90M | SpidR 2.0 SLM | 69.2 | 57.7 | 68.1 | 52.7 | 58.0 | 63.5 | 55.0 |
| 600 h / 90M | GSLM2 | 71.5 | 59.8 | 74.1 | 52.0 | 62.4 | 68.2 | 59.1 |
| 6K h / 300M | Text LM | 79.5 | 66.8 | 84.8 | 52.2 | 80.1 | 90.9 | 79.1 |
| 6K h / 300M | SpidR SLM | 71.1 | 59.3 | 71.4 | 50.7 | 62.0 | 63.0 | 58.5 |
| 6K h / 300M | SpidR 2.0 SLM | 73.9 | 65.1 | 74.7 | 52.2 | 67.5 | 69.0 | 64.9 |
| 6K h / 300M | GSLM2 | 76.3 | 67.2 | 78.9 | 52.5 | 75.6 | 75.5 | 69.8 |
| 60K h / 1.2B | Text LM | 83.8 | 71.5 | 89.2 | 54.6 | 87.3 | 94.2 | 85.4 |
| 60K h / 1.2B | SpidR SLM | 73.9 | 62.4 | 75.1 | 52.8 | 66.4 | 65.5 | 60.7 |
| 60K h / 1.2B | SpidR 2.0 SLM | 76.7 | 69.6 | 81.0 | 56.2 | 74.8 | 72.5 | 66.6 |
| 60K h / 1.2B | GSLM2 | 79.3 | 71.8 | 84.5 | 57.6 | 79.5 | 78.5 | 69.9 |
表中同一规模内先看文本上限,再看 SpidR 到 SpidR 2.0 的单元改进,最后看 SpidR 2.0 到 GSLM2 的多流增益,两步增益在 3 个规模上都存在;但与文本模型的绝对差距在语义长尾和难例上仍然明显,不能把平均提升理解为全面追平。长尾任务上的排序同样是多流最好,但屈折和一致项落后文本较多。
观察误差随数据扩展的任务是:口语数据从数百小时扩到 6M 小时时,谁的数据效率更高。下图把误差对训练小时数画在双对数坐标上,每个点是一个已训练模型,直线是拟合的幂律,斜率绝对值越大表示随数据下降越快,右下平均面板最能概括整体效率。
看图路径: 1. 先看横轴训练小时数与纵轴误差,确认双对数下四条线的相对位置;2. 再比较右下平均面板中 GSLM2 与单流模型的斜率标注差异;3. 最后对照左下 tSC 面板,观察语义任务随数据下降最快的现象
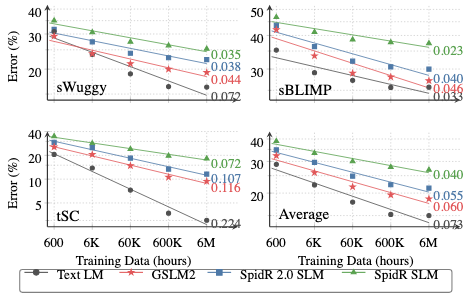
论文图 3。原论文 Figure 6::“Error scaling on conversational speech, both axes logarithmic.”。
图中四面板都近似直线,GSLM2 的平均指数高于单流但低于文本模型;语义面板斜率最大,说明语义能力从数据扩展中获益最多,而词法提升相对缓慢,这与词法需要更精细区分的直觉一致。多流主要把曲线整体下移,单元改进则更多改变斜率。
生成续写与编码器表示分别说明什么
生成评价要回答的问题是:配对判别的优势能否转移到开放续写。论文在开发集上按重复度校准温度,使生成与真实续写的单二元组自重复水平相当,再在测试集上比较转写困惑度和大模型打分。在校准温度下,与两种单流语音基线相比,GSLM2 在 3 个规模的转写困惑度均更低,大模型打分均更高,但固定低温下排名会变化,且口语模型的转写流水线本身带来退化,因此不能把该条件下的胜负推广到所有解码设置。
下表是不同规模下的提示续写结果,校准温度明显高于常用解码温度,跨模态比较并不严格公平。
| Model | Model | τ^\hat{\tau} | ASR-PPL (↓) | LLMJ (↑) |
|---|---|---|---|---|
| 600 h / 90M | Text LM | 1.22 | 690.0 ± 12.9 | 1.88 ± 0.02 |
| 600 h / 90M | SpidR SLM | 1.31 | 670.5 ± 09.4 | 1.73 ± 0.02 |
| 600 h / 90M | SpidR 2.0 SLM | 1.34 | 626.5 ± 14.3 | 1.78 ± 0.02 |
| 600 h / 90M | GSLM2 | 1.49 | 583.5 ± 12.1 | 1.80 ± 0.02 |
| 6K h / 300M | Text LM | 1.21 | 331.0 ± 06.5 | 2.30 ± 0.03 |
| 6K h / 300M | SpidR SLM | 1.39 | 407.2 ± 09.7 | 2.20 ± 0.02 |
| 6K h / 300M | SpidR 2.0 SLM | 1.31 | 367.5 ± 08.0 | 2.27 ± 0.03 |
| 6K h / 300M | GSLM2 | 1.58 | 326.9 ± 11.3 | 2.43 ± 0.03 |
| 60K h / 1.2B | Text LM | 1.20 | 172.7 ± 06.8 | 2.87 ± 0.04 |
| 60K h / 1.2B | SpidR SLM | 1.50 | 259.4 ± 07.3 | 2.78 ± 0.03 |
| 60K h / 1.2B | SpidR 2.0 SLM | 1.45 | 247.4 ± 03.5 | 2.89 ± 0.05 |
| 60K h / 1.2B | GSLM2 | 1.59 | 189.1 ± 05.5 | 3.05 ± 0.04 |
该表表明两步改进在生成上同样成立,SpidR 2.0 优于 SpidR,GSLM2 进一步改善;但校准温度明显高于常用解码温度,且文本与语音输出经过不同转写处理,跨模态的直接数值比较并不严格公平。固定温度下文本模型困惑度可能反超,说明解码设置会改变排序。
编码器零样本评价回答的是单元质量本身。比较各编码器的最佳层,SpidR 2.0 的平均三音子辨别错误率为 2.83%,低于 SpidR 的 3.92% 和 DinoSR 的 5.30%。词级平均精度得分为 69.58,接近 DinoSR 的 69.49,高于 SpidR 的 63.42。SpidR 2.0 在第 10 层的辨别错误率最低,在第 7 层的词级平均精度最高,说明两个指标各有适合的层。
| ABX (↓) | ABX (↓) | ABX (↓) | ABX (↓) | MAP (↑) | MAP (↑) | |
|---|---|---|---|---|---|---|
| Model | l∗l^{*} | within | across | Avg. | l∗l^{*} | Score |
| DinoSR | 5 | 4.58 | 6.02 | 5.30 | 11 | 69.49 |
| SpidR | 6 | 3.53 | 4.31 | 3.92 | 5 | 63.42 |
| SpidR 2.0 | 10 | 2.54 | 3.13 | 2.83 | 7 | 69.58 |
该表支持 SpidR 2.0 在音素辨别和词检索上同时有效,但最优层因指标而异,单层单流只能取其一,多流才能兼顾。更紧凑的码本有利于语言建模,但重合成词错率略高于保留更多声学细节的基线。
温度校准以 NRS = 1 为目标。图 7 左侧面板的 GSLM2 曲线标注了两个温度端点:1.55 位于左上,1.30 位于右下。附录正文则概括称温度升高时 NRS 与转写困惑度通常都上升。两者分别是图中的端点和作者对总体趋势的概括,单凭这两个点不能推断整条曲线或其他模型都单调变化。
层数、层多样性与码本形态如何影响效果
消融要回答的是增益来自层多样性还是单纯集成。在训练数据为 6000 小时、模型为 90,000,000 参数的设置下,作者按开发集准确率逐一增加语音流。加入第 6 条流时,开发集平均准确率最高,序列压缩比约为 1.36。继续加流后,准确率下降,序列长度增加。另一组实验使用 6000 小时的 Libri-Light 和 300,000,000 参数模型,检验不同编码器层是否互补。
各多流设置都用 6 条流。使用第 5 至第 10 层时,3 个任务的准确率分别为 76.3%、67.2% 和 78.9%。重复第 7 层的对照为 73.7%、65.3% 和 74.4%,从同一层独立抽样的对照为 69.9%、61.0% 和 68.4%。因此,该设置下跨层组合优于两种同层对照。
下图展示码本随层数的形态,有助于理解为何需要多层。读图时先看上排的纯度与互信息,再看下排的困惑度、比特率与时长,注意不同颜色曲线的层间走势。
看图路径: 1. 先看上排三幅纯度与互信息指标随层数的变化;2. 再看下排码本困惑度、比特率与单元时长的变化;3. 最后比较蓝色 SpidR 2.0 与绿色 SpidR 在高层的分化

论文图 8。原论文 Figure 12::“Layerwise codebook quality on ZeroSpeech’21 dev-clean.”。
图中可见 SpidR 2.0 的码本困惑度更低、单元更长、比特率更低,纯度在高层保持稳定,而对照基线波动更大;这对应正文报告的 SpidR 2.0 在中间层仅激活百余个码、平均时长更长的现象。更紧凑的码本有利于语言建模,但重合成词错率略高于单流基线,说明音素可分性与重建保真度之间存在折中,多流声码器联合利用多层才同时改善重建。
训练动态也支持紧凑化解释:自监督损失平稳下降,辨别误差在前半程快速下降后趋平,而码本困惑度在正则权重降低后持续下降,说明模型在后期逐渐集中到更小的有效码集,而下游语言任务仍在继续受益。
结论在什么条件下成立,还有哪些未胜出项
主结论依赖 3 个条件。第一是数据域,Libri-Light 为朗读英语,6M 口语为互联网口语,文本上限用转写训练,域内比较才公平;换到多语语料时三者排序仍成立,但绝对分数随语料质量变化。第二是评分方式,配对任务用流特定头在变化位置打分,生成用生成头采样,两套分数含义不同,不能混用。第三是统计不确定性,难例在中小规模接近 50%,60K 小时下,GSLM2 与 SpidR 2.0 单流在 sSC 上的差异不显著(p=0.20),两者均显著优于旧 SpidR。
未胜出项同样明确。长尾的屈折与一致任务上多流仍明显落后于文本模型,且差距遍布频率段,不只是低频词问题;固定低温解码时文本模型困惑度可在多档最优;重合成保真度上单流新编码器弱于旧编码器;与大参数语音模型的受控比较显示多流在词法和句法有竞争力,但在语义难例上仍落后。这些边界表明,多流改善了效率和各项能力的均衡性,但在部分任务上仍落后于文本模型。
此外,计算代价是明确的限制。多流序列更长,需要更大批量和更长上下文,训练与推理开销数倍于单流;论文报告的浮点运算显示多流在各规模约为单流的 3 倍左右。部署前必须评估预算,不能只看准确率提升。
复现第一步做什么,需要哪些资源与超参数
复现应从编码器开始。按论文在 LibriSpeech 960 小时上训练 SpidR 2.0,12 层 Transformer,选中层为高层区间,每层 256 码,条件熵权重固定较小值,边缘熵权重前 20,000 步较大之后降到很小值,学习率峰值较低并在中途冻结卷积与教师,总步数 400,000。用中间层单元训练单流基线,用多个中间层 6 流训练多流模型,生成顺序按比特率升序,损失系数均为较小常数。
作者资源当前可用,代码与模型检查点已公开在官方仓库,训练流水线沿用已公开的口语模型实现,单元声码器为 HiFi-GAN 并需单独训练时长预测器。需要注意代码开源、权重可下载与系统可运行是三件事:拿到仓库只能保证流程可跑,还要按表配置数据、批量和上下文才能复现分数,大规模实验另需转写文本和多卡并行。
建议先复现小规模单流基线,确认编码器层选择与去重逻辑无误,再扩展到 6 流;生成评估先在开发集校准温度,再以该温度进行测试。每次运行在样本间取 ASR-PPL 中位数、NRS 均值,再对 10 次运行的结果报告均值和标准差。大模型打分也报告 10 次运行的均值和标准差。
什么时候值得尝试,还缺哪项验证
当任务是无文字语言的语音建模、需要兼顾音素区分与词义连贯,或已有单流单元遇到瓶颈时,值得尝试多层可微分词与多流联合建模。它的代价是序列更长、批量和上下文更大,训练与推理计算量高于单流,部署前要评估预算。
还缺的验证包括更大编码器规模下的层选择是否稳定、调节正则得到更短单元后重建与语言能力的联合曲线,以及在更多语种和自发口语难例上的显著性与人工听感评价。理解本文后可复述的关键步骤是:多层共享头学码本、跨流去重构造联合序列、共享主干加两类头分别学转移与流间依赖,评价时区分词法、句法和语义条件再谈缩小差距。
总体而言,论文的证据支持两点:更好的离散单元提高了数据效率,多流联合建模在同一单元基础上进一步带来稳定增益;但证据不支持已追平文本模型,特别是在需要精细屈折、一致性和难例推理的条件下,差距依然存在,后续工作需要在更难的基准和更大规模上继续检验。
📎 论文与评分元数据
排名:前25% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses