📄 从碎片到融合:全模态嵌入的统一路线图
英文题目:From Fragmentation to Fusion: A Survey and Roadmap for Omnimodal Embeddings
ℹ️ 本文基于论文全文节选生成,超出分析上下文上限的内容未纳入。
评分:5.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
👥 作者与机构
- Ziyin Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuyu Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Ying Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Siqiao Xue:机构信息未能在本次解析中与作者逐人可靠绑定
- Zihan Liao:机构信息未能在本次解析中与作者逐人可靠绑定
- Jin Qin:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenjie Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Siyuan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Shijie Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Cheng Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Hao Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhaoyang Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruipeng Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhaokun Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Lei Lei:机构信息未能在本次解析中与作者逐人可靠绑定
- Rui Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Hang Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Rui Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
这篇综述要回答的输入是各模态嵌入研究彼此隔离、原理被掩盖的问题,输出是一个能同时处理、比对和组合多种原始输入的通用嵌入空间设想,难点在于各模态的数据单元、评价协议和结构先验差异大而共享的损失与编码器原理又趋同。作者先给出可复用的解剖结构,把原始输入切分、编码、池化读出与训练目标分开,再用对比学习通用化、Transformer 默认化与表示粒度上移三条收敛线解释为何不同空间可以拼接或修正,随后按交互由浅到深比较转换、对齐和联合嵌入三条路径,并用覆盖、可比性和组合性检验每条路径实际达到了什么。相对已有单模态综述,关键差异在于不按模态罗列模型,而是把机制归属为可迁移的共性还是不可丢弃的模态特性。原文报告的一项可核对定量结果是,在含文本、图像与图文混合文档的混合语料检索中,按模态中心化处理相对 CLIP 双塔基线将 NDCG@10 提高至多 26 个点,指标越高越好,说明模态间隙会直接扭曲排序。这一结论适用于混合语料排序修正,尚未在覆盖全部模态的统一基准上验证。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
- 第三方资源:https://github.com/codefuse-ai/Awesome-Omnimodal-Embeddings — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
嵌入要解决什么:把杂乱输入变成可比的向量
对刚进入音频领域的读者,先把任务说清。输入可以是一句话、一张图、一段 3 秒语音、一个分子图或一段传感器序列,目标是把它变成一个向量,使向量间的相对位置反映语义关系:相似的靠近,不相似的推开。这样检索、聚类、分类和跨模态匹配都能变成向量运算。
以音频检索为例,查询可能是文字描述,候选是一批音频片段;若文字向量与对应音频向量在同一空间中靠近,就能直接做文本到音频的最近邻查找。关键约束是必须保留任务需要的因素:语音内容、说话人、情感、环境等叠加在同一波形里,丢掉哪一个都可能换 1 个任务就失败。输出通常是一个可索引的向量,但有时也需要帧序列或离散编码来做定位与生成。
先看全文的研究地图,理解左右分工有助于定位后文论证。左列是各模态自己的数据单元与挑战,中列是可复用的解剖与收敛轴,右列是从粗到深的 3 条统一路径与衡量门控。
看图路径: 1. 先看左列各模态的数据单元与挑战,确认音频是帧与内容身份叠加;2. 再看中列可复用解剖与三条收敛轴的对应关系;3. 最后看右列三条路径与 3C 门控如何一一对应

论文图 1。原论文 Figure 1::“A research map of omnimodal embeddings.”。
该图确实可见左中右三栏:左栏按文本、视觉、音频、图、表格、时间序列列出单元;中栏上方是 5 个正交组件、下方是 3 条收敛轴;右栏上方是 3 条路径、下方是覆盖、可比、可组合 3 个门控。这帮助读者把后文的收敛论证与统一路径放在同一张图上定位,避免把参数共享误当成空间统一。
与单模态综述有何不同:不替代而是搭桥
已有综述多是单模态纵深总结:文本嵌入、视觉自监督、语音表示、图嵌入、表格表示各有优秀综述,但几乎不跨模态系统比较方法。本篇的定位是元层综合,不取代这些纵深综述,而是抽出跨模态通用的解剖、目标、结构与粒度,并指出各模态特有的难点。
对音频读者而言,这意味着 wav2vec 2.0、HuBERT、CLAP 等工作在这里不是被重新评测,而是被放在更大的收敛脉络里:掩码预测对应重构族目标,对比的音频描述对对应跨模态正样本,SUPERB 的层加权对应表征对象的选择问题。相关工作的比较条件因此是方法论层面的可比性,而非同一数据集上的分数高低。
需要避免的误解是把本文当成又一个模型或又一个榜单。本文没有提出新编码器,也没有训练统一模型,而是给出路线图与评测量尺,判断任何自称全模态的系统必须通过哪些证据门。
碎片化表现在哪里:研究、综述与评测各自为营
论文要解决的不是某一个检索指标,而是领域层面的碎片化。文本、视觉、音频、图、表格、时间序列各自有自己的讨论圈、检查点与评测套件,做法很少互相搬运。文本用 SimCSE 的 dropout 视图做正样本,视觉讲随机裁剪,音频讲掩码预测,图讲视图增强,但彼此很少对照核心机制的异同。
形式化地说,嵌入模型是一个从输入域到向量的映射,学习目标是让向量相似度近似语义相似度。
\[f_{\theta}:{\mathbb{X}}\longrightarrow\mathbb{R}^{d}\]其中输入域可以是句子、图像、声波等,输出是 d 维向量,相对位置承载语义。相似度近似语义相似度是后文对比目标与对齐的起点,但具体什么算相似由各模态的正样本定义决定。
评测同样成岛:文本有 MTEB 及其多语扩展,代码有 CoIR,音频有 SUPERB 及其后继,视觉有检索与分类套件,而表格与时间序列长期靠任务头与预测存档打分,缺少冻结编码器下的统一比较。论文用两组计数把这种印象结构化,后文结果节会给出具体数字与适用边界。
全文如何组织:统一解剖、收敛原理与三条统一路径
全文分四大部分。第一部分建立与模态无关的解剖:数据单元、分词器、编码器、聚合与表征对象,加上目标与评测这两个建模决策。第二部分论证 3 条收敛轴:训练目标趋同、编码器趋同、表征粒度上移。第三部分给出 3 条统一路径:转换拓宽覆盖,对齐实现可比,联合嵌入追求可组合。第四部分讲前路:各模态特有性质、跨模态借鉴与统一评测。
3 条路径与 3 种能力的对应是理解全篇的钥匙。转换把输入变成已有编码器能读的格式,主要扩大能处理的输入种类;对齐保留各自编码器并学一个共享度量,使分开编码的输入可互检;联合嵌入让多模态在池化前交互,输出真正依赖全部输入的组合向量。能力逐级更强,路径交互深度逐级加深。
转换 × 对齐 × 联合嵌入: 转换是把源模态渲染或序列化成目标模态已有编码器能读的格式;对齐是保留各自编码器只学一个可比的度量空间;联合嵌入是让多模态在池化前就交互形成一个向量。三者交互深度递增,分别对应覆盖、可比、可组合,联合嵌入把对齐视为交互为零的特例。
下图把 4 种分工放在一起:共享主干只复用参数,转换在编码前连接,对齐在度量空间连接,联合融合在表示形成过程中连接。注意共享主干不一定产生共享检索空间,这正是后文反复强调的区分。
看图路径: 1. 对比左上共享主干与左下对齐在参数与空间上的不同;2. 看右上转换是否可能丢失或注入信息;3. 看右下联合融合在池化前交互并保留私有端口的设计

论文图 5。原论文 Figure 5::“Four ways of sharing work across modalities.”。
该图确实可见 4 个面板:左上共享主干标注参数共享但空间不对齐;右上转换标注可能丢失或注入信息;左下对齐是独立编码后输出可比;右下联合融合是池化前交互并可保留私有端口。这直接对应后文对每条路径代价与能力的论述。
通用解剖长什么样:从输入片到输出形态
任何模态的嵌入模型都可拆成同一副骨架,只是每个角色的实现不同。下表选择原文解剖表的部分行列,比较文本、音频、图在单元、编码器与表征对象上的实例化,说明骨架复用而实质各异。
该表比较同一解剖在不同模态的实例化,公平条件是只看组件分工而非分数高低,目的是定位音频的特殊性。
| Component | Text / Code | Audio | Time Series |
|---|---|---|---|
| Data unit & tokenization | character, subword, word | waveform, frame, spectrogram patch | timestamp, window, patch, channel |
| Encoder | Transformer; decoder-only LLM | CNN, Conformer, Transformer, SSM | RNN, TCN, SSM, Transformer, MLP |
| Training objective | contrastive, MLM, next-token prediction | masked prediction, speaker/content contrast | forecasting, reconstruction, contrastive |
表中可见文本用子词与 Transformer,音频用波形、帧与频谱块并可用卷积前端,聚合方式与输出形态也不同:音频既有片段向量也有帧序列与编码器编码。这解释了为何同一编码器变强不等于嵌入变好,关键在读出与评测是否对准了所要的因素。
数据单元 × 表征对象: 数据单元是编码器读入的最小输入片,如子词、图像块、音频帧、图节点;表征对象是向下游交付的输出形态,如全局向量、局部序列、离散编码。同一编码器可因池化与读出不同而交付不同对象,读出决定了能做检索还是定位,因而用什么评测才算数。
输出形态的选择决定代价:全局向量利于快速检索与存储,局部序列利于定位与重排,离散编码利于压缩与生成,分布利于校准歧义。音频的特殊在于没有唯一的正确读出,识别要帧序列,说话人要 utterance 向量,评测因此常对层做加权,这正是后文音频因子表的伏笔。
编码器结构与索引方式:共享核加可插拔先验
Transformer 因并行、自注意力与可扩展性成为跨模态默认主干,但通用性来自弱先验加可插拔先验的设计。自注意力本身与顺序无关,顺序、拓扑、速率等先验靠位置编码、扫描顺序、注意力偏置或时间戳重新注入。状态空间模型走同样的分词接口,只是用 1 维扫描代替全注意力。
先看共享处理核的示意,理解分词器补信息的位置,再看共享核的两种实现差异。
看图路径: 1. 看左侧各模态分词器输出的附加信息有何不同;2. 看中间共享处理核的标注,确认顺序无关与一维扫描的区别;3. 看右侧三种输出形态分别对应检索还是细粒度任务
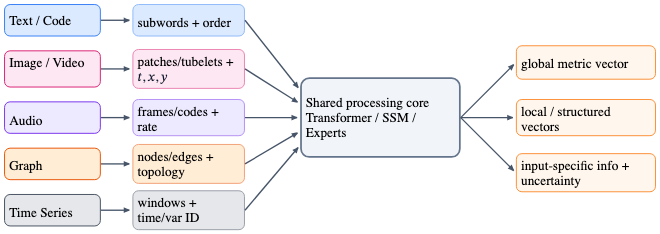
论文图 4。原论文 Figure 4::“A shared processing core with modality-specific tokenizers and external structural information.”。
该图确实可见左侧 5 个模态各自的分词输出都带上额外结构信息,中间是 Transformer 与状态空间模型等共享核,右侧分出全局度量向量、局部向量与私有信息。这种设计是后文默认选 Transformer 的理由,也是状态空间模型仍走同一接口的原因。
双编码器 × 交叉编码器: 双编码器把查询与候选各自独立编码再比向量,支持离线建库与近似最近邻检索,是对齐的典型结构;交叉编码器把查询与候选拼在一起做全注意力联合打分,精度高但每个候选对都要重算,常作重排器。两者分工是可索引性换精度。
双编码器与交叉编码器的分工也属于结构选择:前者是可索引的对齐结构,后者是为精度付费的重排结构。实际最强的检索栈常是两者串联,先用可索引的联合向量召回,再用交叉编码器重排,但后者不产生可复用的表示。
共享主干 × 联合嵌入: 共享主干是多个模态共用同一组编码器参数但输出空间仍可不互通,省参数不等于可互检;联合嵌入要求多模态输入在形成表示前发生交互并输出可复用的组合向量。前者是参数复用,后者是计算复用与信息融合,不可互相冒充。
共享主干与联合嵌入的区别在此最清楚:前者复用参数但输出仍可不对齐,后者要求形成表示前发生交互。把两者混为一谈会把参数量小的系统误当成可比的系统,后文 3C 门控正是为堵住这种误读。
训练目标如何收敛:对比是通用语,重构与生成各有分工
第二部分的第一个收敛是目标函数。对比学习把正样本拉近、负样本推开,已成为跨模态的通用语:文本的 InfoNCE、视觉语言的 CLIP、音频语言的 CLAP 都是同一范式。重构族目标如掩码语言建模、掩码图像建模、音频掩码预测则先在无标注上预训练,再用对比做微调,形成预训练加微调的两段式。
对比的核心计算可用 InfoNCE 表示,其作用是约束正样本对的相似度高于一批负样本。
\[\mathcal{L}_{\text{InfoNCE}}=-\log\frac{\exp\!\bigl(\operatorname{sim}({\bm{e}},{\bm{e}}^{+})/\tau\bigr)}{\sum_{j=1}^{N}\exp\!\bigl(\operatorname{sim}({\bm{e}},{\bm{e}}_{j})/\tau\bigr)},\]其中分子是当前样本与其正样本的相似度,分母是对一批候选求和,温度系数控制分布形态。符号多为标量相似度,期望与求和范围按原文的批量与队列而定。关键是正样本如何定义,它声明了何种变换下语义不变。
对比学习 × 正样本对: 对比学习是通过拉近正样本、推开负样本组织向量空间的通用目标;正样本对声明了何种变换下语义应保持不变。目标函数形式跨模态共享,真正区分模态的是如何构造正样本,构造即声明了该模态的不变性假设。
下表比较各模态典型正样本、意图不变性与典型失效,说明机制共享而声明各异,公平条件是同一目标形式下比较构造方式。
该表比较同一对比机制下正样本构造与不变性声明,目的是揭示跨模态搬运时必须检验的前提。
| Modality | Typical positive | Intended invariant | Characteristic failure |
|---|---|---|---|
| Text | Dropout views, paraphrase, query–relevant passage | Surface variation under semantic equivalence | False negatives and lexical shortcuts (Gao et al., 2021; Xiong et al., 2021) |
| Audio | Two utterance views or an audio–caption pair | Content, speaker, event, or scene, depending on task | A desired factor for one task is a nuisance for another (Elizalde et al., 2023) |
| Cross-modal | Co-observed or captioned objects | Shared semantic content | Co-occurrence is partial or asynchronous (Radford et al., 2021; Girdhar et al., 2023) |
表中可见文本靠 dropout 视图与改写,音频靠波形扰动或音频描述对,跨模态靠共现或描述对。各自失效也很具体:文本有假负例,音频 1 个任务要保留的因素可能是另一任务的干扰,跨模态共现是部分或异步的。本节无新训练,论文是综述与立场论证,不训练任何编码器;训练一节的含义是梳理各模态实际执行的预训练与微调流程与监督来源。
分词器与粒度:差异前移与整体上移
第二个收敛是结构,分词器才是模态差异真正所在。下表按平移对称与置换对称分组,比较各模态分词器输出的单元与索引对称性。在同一共享主干假设下,该比较说明差异被前移到分词与位置信号,解释了为何同一注意力算子能通用。
| Named modality | Tokenizer | Unit it emits | Symmetry of index set |
|---|---|---|---|
| Natural language / code | WordPiece or BPE segmentation and vocabulary lookup (Devlin et al., 2019) | Embedded subword | 1D translation equivariance |
| 2D RGB image | Flatten fixed 2D patches and linearly project them (Dosovitskiy et al., 2021) | Spatial-patch token | 2D translation equivariance |
| Speech (waveform-based) | Multi-layer 1D temporal convolutions over the raw waveform (Baevski et al., 2020) | Continuous latent-frame token | 1D translation equivariance |
| Time series | Split each channel into fixed-length subseries patches and linearly project them (Nie et al., 2023) | Channel-local window token | 1D translation equivariance |
表中可见自然语言用子词切分,图像展平 2 维块,语音或用 1 维卷积读波形。这种分组解释了有序靠位置编码、无序靠集合等变加结构偏置的原因。时间序列按通道切窗,点云表格图则处理无序集合并用不同方式注入结构。
第 3 个收敛是粒度上移:从词到句子到文档,从像素块到整图,从帧到 utterance,从节点到子图与整图,从采样点到窗口与序列级表示。动因是完整语义单元更适合作检索与对齐的直接比较单位。但上移可逆:定位、说话人日志、对应关系仍需保留局部读出,形成全局向量、局部序列、离散码与不确定性的格点,而非单向阶梯。
用什么尺子衡量:3C 门控与统一评测协议
第三级碎片在评测。多数模态已有冻结编码器加弱探头的可信协议,但时间序列仍耦合预测头,表格刚出现冻结评测,跨模态套件多为双模态到少模态,没有在同一协议下覆盖全模态并度量组合的基准。
覆盖 × 可比 × 可组合: 覆盖问系统真正直接处理并测试过哪些输入;可比问分开编码的输入能否在同一任务下互检;可组合问多输入组合的输出是否真正依赖全部输入。三者逐级更强,分别需要直接输入证据、双向持留检索证据与超越单输入及简单相加的增益证据,不能用一分概括。
统一基准应规定 3 维:输入覆盖文本、代码、图像、视频、音频、图、表格、时间序列及其组合;任务覆盖单模态、跨模态检索与多模态融合;协议统一为冻结编码器加固定预算弱探头,并保留各模态有效性检验。可组合的操作化是组合增益公式,要求联合性能超过最佳子集与加权相加基线。
\[\Delta_{\mathrm{comp}}=\mathrm{Perf}\!\bigl(f_{\theta}(x_{1},\dots,x_{k})\bigr)-\max\Bigl\{\,\max_{{\mathbb{S}}\subsetneq\{1,\dots,k\}}\mathrm{Perf}\!\bigl(f_{\theta}(x_{{\mathbb{S}}})\bigr),\ \ \mathrm{Perf}\!\bigl(\textstyle\sum_{i}w_{i}f_{\theta}(x_{i})\bigr),\ \ \mathrm{Perf}\!\bigl(\textstyle\sum_{i}v_{i}s_{i}\bigr)\Bigr\},\]其中 Perf 是任务效用越高越好,子集遍历非空真子集,两组权重在验证集拟合以免偏袒任一方。只有增益为正才记可组合得分。该量受部分信息分解中协同项启发,但只是单模型端到端性能的度量,不等价于数据分布的协同信息。
证据门控要求按顺序加码:先报覆盖与可比,再报可组合,最后报部署的鲁棒性、代价、安全与跨版本兼容。先看门控图明确递进关系。
看图路径: 1. 按从左到右看四个门控的递进证据要求;2. 注意可组合门控要求超越单输入与基线;3. 注意部署门控包含字节、延迟与跨版本检索
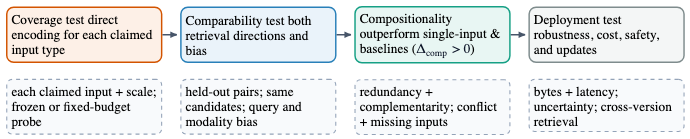
论文图 7。原论文 Figure 7::“Evidence required for broader claims.”。
该图确实可见 4 个递进门:覆盖测每类输入的直接编码,可比测双向检索与偏差,可组合要求超越单输入与基线,部署测字节延迟不确定性与跨版本检索。门控是证据要求递增,不是处理流水线。
碎片与增长的证据:在什么条件下成立
论文的定量证据是文献计量而非模型分数,回答注意力在哪里、发表有多隔离、哪一角增长最快,不回答哪种构造保留了互补信息。下表整理原文连续句中的计数,比较对象是同一样本内的跨模态占比与增长,条件一致才可比,占比越高越跨界。
| 条件 | 指标 | 单模态主流 | 跨模态工作 | 比较对象 |
|---|---|---|---|---|
| 2023-2025 会议 1352 篇 | 跨模态占比 | 主流单模态 | 不足 5% | 同期全部样本 |
| 2015-2025 arXiv 11806 候选 | 保留记录数 | 10952 篇 | 需剔除误检 | 同一检索口径 |
| 2023-2025 multimodal 标题 | 年计数 | 15,29,62 篇 | 逐年上升 | 同口径历年 |
| 2023-2025 跨模态对齐桶 | 年计数 | 7,22,37 篇 | 翻倍增长 | 各模态桶同期 |
主要结论是有边界的:1352 篇会议统计显示明确跨界工作不足 5% 且出现较晚;arXiv 标题统计显示 multimodal 命名在 2023 年前每年不超 10 篇,之后 15、29、62 篇上升而 cross-modal 始终低位,说明统一空间的词汇在 multimodal 一侧扩张。限制有三:短语检索漏掉邻近术语故为下界;标题匹配偏向在标题中明示主题的工作;计数只度量注意力与发表隔离,不证明哪种融合保留了交互信息。
未胜出项是语音桶在数量上可见回落但仍最隔离,视觉与通用机器学习桶更大,说明大桶恰恰最成岛。另一组条件是评测现状:文本高分到推理型榜单大幅下降、音频多任务无单一最优的双重分离,都说明单岛分数不能推广到全模态。
三条路径的代价:转换丢结构,对齐缺细节,融合贵但必要
转换指在编码前把源输入变成目标形式的输入,再用现成编码器处理。常见做法有渲染成像素、序列化成文本、离散成语言模型接口的 token。生产中最常见的是级联:语音经识别转文字、图像经描述转文字再做文本嵌入。代价是结构性信息丢失,1 维字符串必须把原生结构线性拼出来,而常用格式并未拼全。
对齐保留各自编码器,只学一个共享度量,使分开编码的向量可比。CLIP、CLAP、ImageBind 是代表,对齐保持双编码器结构,因而可离线建库,适合大规模检索。模态间隙是必须讲清的现象:不同编码器输出各居一个窄锥,对比损失的低温默认使间隙成为局部最优,因此单纯延长训练去不掉它。它的影响取决于任务混合,在混合语料检索中是排序病理,在单模态零样本中可能携带结构。
联合嵌入让多模态在池化前交互,输出一个可复用的组合向量。关键论点是融合泛化了对齐:把跨模态交互置零就退化为对齐,打开交互只能增加对齐没有的相对排布信息。论文据此猜想在容量无约束下融合弱占优,操作化检验是组合增益。从 VISTA、VLM2Vec 到全模态嵌入器,融合正从专用结构变成默认做法,而查询候选交叉编码的重排器虽精度高却不产生可索引表示,应视为消费者而非生产者。
音频为何特殊:因子叠加与必须点名的嵌入
对音频读者最关键的一节是模态特有差。下表按因子组织同一波形的多种任务视图,说明成功一行可能要抑制另一行奖励的信息。
该表比较同一音频输入在不同因子下的编码器与评分,公平条件是任务先行,目的是说明音频嵌入未点名因子即无定义。
| Factor | Representative encoder | Kept by | Scored by |
|---|---|---|---|
| Linguistic content | SSL frame features (Baevski et al., 2020; Hsu et al., 2021; Chen et al., 2022a); semantic codec tokens (Huang et al., 2024b) | Recognition, translation, keyword spotting, voice activity detection | Word/phone error rate for recognition; accuracy for keyword spotting |
| Speaker identity | i-vector (Dehak et al., 2011), x-vector (Snyder et al., 2018), ECAPA-TDNN (Desplanques et al., 2020), content-disentangled speaker embeddings (Tu et al., 2024) | Verification, diarization, target-speaker extraction, voice cloning | EER/minDCF for verification; DER for diarization |
| Prosody & emotion | Prosody/timbre embeddings (Gengembre et al., 2024); emotion representations (Ma et al., 2024b) | Expressive synthesis, affect recognition, punctuation restoration | Classification accuracy, listener studies |
语言内容用自监督帧特征与语义编码,靠词错率评分;说话人用向量序列中的说话人分支,靠等错率与日志误差;韵律情感、语言口音、通道环境与声学细节各有保留与去除要求。SUPERB 对层加权正是因为表示不是某一层,而是层的选择。联合嵌入若把叠加压成单点而不保留可按需分离的叠加,就会按构造丢失任务需要的因素。代价是存储与接口更复杂,但这是保真必须付的。
推广到他模态:视觉要保空间多尺度与时序对应,时间序列要保幅度语义与连续时钟,图要保置换对称与类型边,表格要保行列几何与模式。这些不是可工程绕开的障碍,而是模态携带的信息,检验标准是融合后是否仍保留。
复现第一步做什么:从冻结探头与基线做起
值得尝试的时机是当任务涉及两种以上原生模态且需要组合判断时,例如文字加图像加音频的检索,或先验图像加修改指令的组合检索。若只是单模态检索或已有文本级联已够用,转换的低成本可能更划算,不必直接上联合融合。
复现第一步不是训练大模型,而是复刻评测门控:固定声明的输入种类与尺度,对每类做直接输入测试;冻结编码器加固定预算弱探头,跑双向检索并用同一候选集;再跑单输入、分数相加与向量相加基线,计算组合增益是否为正。音频务必先点名因子并固定层选择与池化,视觉固定裁剪视角与帧采样,时间序列加顺序破坏与通道置换对照,表格保留行列结构对照。
信息条件要保留:数据划分、采样、指标聚合、分母与方向、探头预算、权重拟合划分都需记录。超参数方面,原文未给出统一训练配置,因本篇无训练;引用模型的温度、队列、掩码率等请回到各自原文,不从模型名猜实现。缺的是哪一项就写缺哪一项,不补造梯度路径。
结论与路线:何时选哪条路径
综合起来,收敛是事实,融合是方向,证据是门槛。目标函数、主干与粒度上移的收敛使跨模态搬运成为可能;转换、对齐、联合嵌入按交互深度分别换来覆盖、可比与可组合;各模态特有结构决定了搬运的前提,跨模态借鉴应是有条件的定向移植而非自由移植。
对音频研究生而言,可操作的是:先点名因子再谈嵌入,先定读出再选评测,先跑单输入与相加基线再谈融合增益。转换适合快速扩大覆盖,对齐适合可索引的跨模态检索,联合嵌入适合必须联合判断的组合任务,但要付出重编码与索引代价。
尚需补的是统一、解码器无关的全模态基准,特别是 3 模态以上的组合增益、模态缺失冲突鲁棒性与污染控制。在此之前,联合超越对齐是合理假设而非已测事实,这正是路线图把评测作为绑定约束的原因。
作者资源方面需严格区分:已验证的唯一记录为第三方提及(third_party),仅证明论文正文提及 https://github.com/codefuse-ai/Awesome-Omnimodal-Embeddings ,不证明作者侧有相应提供;本次没有归属明确的作者侧记录,因此本文不对作者侧状态作肯定表述。
📎 论文与评分元数据
排名:后50% | 文档类型:综述 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses