共分析 21 篇论文
⚡ 今日概览
✅ 筛选入选 21 篇 → 🔬 深度分析完成
每篇论文保留完整分层分类;热门方向按主任务的最上级方向统计,每篇计入 1 个方向。排行榜也显示最上级任务。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| 声学系统参数估计 | 2 篇 | ██ |
| 语音交互 | 2 篇 | ██ |
| 音频分离 | 2 篇 | ██ |
| 音频系统攻击与防御 | 2 篇 | ██ |
| 关键词检测 | 1 篇 | █ |
| 口语理解 | 1 篇 | █ |
| 朗读友好文本生成 | 1 篇 | █ |
| 生态物种识别与分布预测 | 1 篇 | █ |
📊 论文评分排行榜(21 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 GhostPrefix:不需要对齐的通用语音前缀攻击

英文题目:GhostPrefix: Synchronization-Free Universal Prefix Attacks for ASR Manipulation
评分:8.4/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shengding Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ashwin Innuganti:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiben Yan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
自动语音识别需要把连续到达的语音波形转写为开放词表文本,攻击者既看不到未来话语内容,也无法与说话起始时刻对齐,仍希望稳定操控输出。GhostPrefix学习一段约1秒的可复用前置音频,在流式管线入口与后续语音波形拼接后一起送入识别器,用编码器状态和解码器首词的敏感性把影响扩散到整句转写。优化阶段以语音批量为输入,用词元级损失实现句首植入短语并保留后文的提示引导、用词元级损失迫使收敛到指定句子并提前结束的目标劫持、用编码器隐空间均方误差推开表征的非目标破坏,输出同一拼接形式的通用前缀。该前缀以环境声模板为约束起点继续优化,使波形贴近提示音与车喇叭等背景声,得到的隐蔽前缀再送入补齐、房间脉冲响应、带通滤波与加噪组成的变换管线做期望训练,输出可经喇叭播放的鲁棒版本。与需要逐句优化并全长叠加的加性扰动不同,该设计一次优化后可重复播放,也区别于仅针对Whisper的静音或任务切换前缀,可覆盖CTC与编解码器等多类结构。在LibriSpeech测试集数字拼接评测中,相对干净语音基线,提示引导模式的攻击成功率平均为97.6%,指标方向为越高越好。在数字非目标攻击的同一拼接评测中,表征级目标在whisper-large-v3上的WER为1.0336,高于词元级目标的0.1639,WER越高表示破坏越强。结论适用于英语朗读语音和论文测试的室内车内录音条件,跨语言与强自适应防御尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://anonymous.4open.science/r/GhostPrefix — 链接可访问(HTTP 200)
演示资源:https://ghostprefix.github.io/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 听见墙壁:ARPEGE 房间声学几何数据集与两种估计方法解读
英文题目:ARPEGE: Dataset and Methods to Estimate Acoustic and Geometric Parameters of Rooms from Sound
评分:7.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Jean-Daniel Pascal Prieto:机构信息未能从 arXiv PDF 文本可靠映射
- Prerak Srivastava:机构信息未能从 arXiv PDF 文本可靠映射
- Cédric Foy:机构信息未能从 arXiv PDF 文本可靠映射
- Antoine Deleforge:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
从传声器信号估计反射体位置、房间体积与总表面积及混响时间的难点在于早期反射与直达声混叠,且声源指向性会改变回声相对强度。ARPEGE在6个不同尺寸与材料的空房间中布置声源与球形阵列,用Genelec 8020音箱播放50 Hz至20 kHz正弦扫频并解卷积得到248个32与64通道Eigenmike RIR,采样率48 kHz,同时记录人声朗读与拍手序列,激光测距标注房间尺寸与地板二维坐标并固定设备高度为1.58 m。阵列三自由度朝向先由前向RIR直达声到达时间经无网格定位得到源点云,再经主成分分析恢复与地板平行的平面与剩余偏航角,从而获得可用于镜像声源仿真的六自由度位姿。镜像声源定位先由Real2Sim扩散生成模型将实测RIR早期部分映射为去除角度与频率影响的sinc峰序列,再由无网格物理反演方法由该规范表征解算三维镜像声源点云。在6个房间40个近距离前向em32 RIR的镜像声源定位评测中,使用Real2Sim预处理后225个一阶镜像声源召回率达97.3%,高于未使用预处理的57.6%,对应径向误差均值0.09 m、角度误差均值4.7°。房间参数估计用双通道带噪语音谱时序特征经深度网络映射为体积、表面积与混响时间并融合多位置估计,在2号房间单位置3秒语音体积平均绝对误差上,指向性声源训练模型为24.4 m3,低于全向声源训练模型的42.2 m3,而3位置融合进一步降至13.6 m3。上述改善不适用于1号房间,其表面积与体积误差仍达上百平方米和上百立方米,而混响时间误差未同步恶化,说明存在与混响时长无关的分布偏移,结论尚未验证至家具占用、非固定高度与大混响以外的房间。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/jdpascal/ARPEGE — 链接可访问(HTTP 200)
数据相关资源:https://zenodo.org/records/20096770 → https://zenodo.org/records/20622134 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 用线性递推做长音频:MFlowAudio 的双路扫描与有状态流匹配

英文题目:MFlowAudio: Efficient Text-to-Audio Synthesis via Mamba-based Stateful Flow Matching
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Hao Dai:Department of Computer Science, University College London;Department of Engineering, King’s College London
- Panyu Chen:Department of Computer Science, University College London
- Jagmohan Chauhan:Department of Computer Science, University College London
📌 核心摘要
读者需要理解的任务是由文字提示生成全频带连续波形,输入为单句或多段描述,输出为秒级至较长时长的声音。难点在于高采样率带来很长序列,自注意力随长度平方增长而难以容纳,一次性整体生成也不支持边播边产和中途更换提示词。方法先把音频压缩为多通道隐变量,再学习从噪声指向隐变量的速度场,推理时用常微分方程求解器逐步去噪得到隐变量并解码成波形。时间曼巴模块沿时间从左向右扫描并更新循环隐状态以保持因果与长程依赖,通道曼巴模块沿通道扫描以刻画谐波等跨通道结构,两者与条件注入共同组成TCMamba块。有状态流匹配只缓存每层曼巴隐状态,使得分块训练与生成接近一次性生成,并支持延迟基本恒定的流式输出;状态解耦条件引导把新提示方向与历史状态方向正交分解,减轻切换提示时的向量场冲突。在AudioCaps完整测试集十秒任务上,MFlowAudio的Frechet Distance为11.8569,低于TangoFlux的15.8429,Kullback-Leibler divergence为1.1158,低于TangoFlux的1.1164。在单卡RTX-5080上以默认配置多次生成的延迟比较中,十秒音频生成延迟MFlowAudio为1.93秒,低于TangoFlux的3.51秒,三十秒任务中为3.10秒,低于TangoFlux的3.55秒,首块等待时间恒定为1.8秒左右并支持实时播放。该结论适用于与训练分布接近的短句描述音频,动态组合提示的自然过渡仍依赖推理期干预且缺乏大规模序列标注验证,边界比指标也难以覆盖全部听感。
🔗 开源资源
第三方资源:https://huggingface.co/spaces/mflowaudio/MFlowAudio — 链接可访问(HTTP 200)
第三方资源:https://github.com/state-spaces/mamba.git → https://github.com/state-spaces/mamba — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. 抹掉注入再学习:多模态间接提示注入的 ERASE 防御

英文题目:Erase the Injected Region: Multimodal Prompt-Injection Defense with On-Policy Self-Distillation
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shuo Hong:South China University of Technology
- Jiaxin Ma:South China University of Technology
- Xidi Cai:South China University of Technology
- Qianli Ma:South China University of Technology
📌 核心摘要
读者需要理解的对象是间接提示注入(indirect prompt injection,通过外部媒体传入的恶意指令),困难是外部媒体同时装着用户任务需要的信息,删掉或压制注入时容易连任务信息一起破坏,处理过程是让模型在受攻击输入上仍输出与删掉注入后一致的答案。擦除视图(erased view)指只把注入占据的连续区域换成该模态空白内容而保留其余媒体和尺寸的参考输入;在线策略自蒸馏(on-policy self-distillation)指学生用自己在受攻击输入上的采样轨迹向读取擦除视图的冻结教师学习逐词元分布。训练时先按基准记录的区域位置构造擦除视图,再让冻结基座模型读擦除输入、让可训练学生读受攻击输入并采样回答,学生在每个已生成前缀上用全词表KL(Kullback-Leibler散度)向教师对齐。推理时学生直接读受攻击输入,不做擦除。与表示转向和偏好优化类防御不同,该方法保留了周围媒体的空间或时间结构,并用教师的完整下一个词元分布提供任务导向目标。在基于Lu等基准的领域内音频评测中,ERASE受攻击用户指令准确率为60.1%,高于ARGUS的33.1%,且与无防御干净输入的60.6%相差0.5个百分点以内。适用范围限于注入区域可分离的非自适应攻击,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/microsoft/BIPIA/blob/main/benchmark/text_attack_test.json — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. TAPE:只听处理后的声音,把效果处理搬到另一段录音上

评分:7.0/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Phillip Long:机构信息未能在本次解析中与作者逐人可靠绑定
- Yongyi Zang:机构信息未能在本次解析中与作者逐人可靠绑定
- Qihui Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Christodoulos Benetatos:机构信息未能在本次解析中与作者逐人可靠绑定
- Junfei Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Randal Leistikow:机构信息未能在本次解析中与作者逐人可靠绑定
- Julian McAuley:机构信息未能在本次解析中与作者逐人可靠绑定
- Perry R. Cook:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
混音师听到已处理参考录音 wetA 后能把处理搬到新素材,本文要让模型只看 wetA 完成这件事,输出作用到另一段干声 dryB 上的处理,并给出人可读可改的均衡、压缩等参数。难点是专业处理器种类多、内部不公开,只能从声音观察处理痕迹,还要把音源内容与处理分开,并以小延迟运行。TAPE 用编码器把 wetA 映射为 256 维嵌入 z,再用五模块可微 DSP 链把 z 译为各模块参数并处理 dryB,训练时同一插件配置渲染 A 与 B 两条音轨,以跨内容重建检验 z 是否抓住处理。在 60 对跨内容测试上,单次前向的 TAPE 达到多分辨率 STFT L1 均值 1.120,低于已发布 DeepAFx-ST 音乐模型在 24 kHz 峰值归一化下的 2.097,也低于在 ST-ITO 公开基础链上每例 4,097 次渲染搜索的 2.906,而单片段耗时约 0.52 s,约为该搜索 143 s 的 1/275。听感上最小二乘对抗微调版本在两个不相交集合上每位听众均分都高于只做重建的版本。适用范围限于 68 个单声道处理器近似,九个调制类与磁带抖晃只被部分近似,无调制振荡器级,未验证未见插件与立体声。训练、推理与部署成本原文披露了搜索渲染次数与流式回调耗时,未给出完整训练机时。
🔗 开源资源
- 第三方资源:https://pnlong.github.io/audio-effect-transfer/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. 只用一个声源和房间反射定位两组麦克风阵列
英文题目:Self-Localization of Distributed Microphone Arrays Using One Source and Acoustic Reflections
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Thomas Guffroy:机构信息未能从 arXiv PDF 文本可靠映射
- Jean-Daniel Pascal Prieto:机构信息未能从 arXiv PDF 文本可靠映射
- Cédric Foy:机构信息未能从 arXiv PDF 文本可靠映射
- Antoine Deleforge:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
待解决的对象是分布在房间中的两个麦克风阵列,每个阵列内部时钟同步且几何已知,需要估计一个阵列相对另一个的旋转与平移。难点在于只允许使用单个声源的一次房间脉冲响应测量,单次测量的镜像声源点云存在标签未知、缺失、虚假和噪声,还受房间对称造成的翻转歧义影响。处理链条从每个阵列的多通道房间脉冲响应出发,经Real2Sim去除指向性影响得到裸脉冲响应,再用无网格三维镜像声源定位得到不带对应关系的三维点云,最后由ARCTIC算法对齐两个点云并输出相对位姿。ARCTIC把直达声对应的真实声源位置固定为锚点,只枚举经过锚点的边和三角形,用边长一致性过滤候选,再用Kabsch算法逐个验证变换并以线性分配求匹配,与不利用锚点的Super4PCS相比缩小了组合搜索空间并抑制对称翻转。在6个房间采集的36对真实房间脉冲响应评测中,ARCTIC成功对齐36对、成功率为100%,高于Super4PCS+ICP的23对、63.9%,成功样本上阵列间距离误差均值为9.5 cm,低于后者的10.7 cm。结论适用于鞋盒形等可见镜像声源重叠充分的房间、源发射时刻已知且阵列紧凑的情形,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/tguffroy/ARCTIC — 链接可访问(HTTP 200)
第三方资源:https://storm-irit.github.io/OpenGR/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. VoxLock:从通话开头截 3 秒声音,只留下打电话的人
英文题目:VoxLock: Target-Speaker Extraction for Voice Agents Without an Enrollment Step
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Arbaz Siddiqui:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音助理的麦克风会同时收进旁人说话,通用降噪保留语音因而无法去除,助理需要只保留主叫人的波形再送给识别器。VoxLock先从本次通话前15秒内取最响3秒作主叫人语音样本,该样本先以频谱逐帧注意力形成额外输入通道,再以ECAPA-TDNN帧特征对分离器各频带特征加权相乘,输出只含主叫人的音频流;模型从公开因果BSRNN目标说话人提取模型出发,依次经模拟通话混合、真实串音、长通话衰减和远近混淆四段微调,推理时把登记图与分块图拆开并支持8位量化。在Krisp265段真实录音基准上以Parakeet识别器评分,VoxLock词错率为4.95%,低于未处理的23.21%,与Krisp最好的过滤器无显著差异并显著低于其余商业与开源系统。在同一Krisp基准85.3分钟纯背景段上,VoxLock背景词漏入数为9个词,低于Krisp Default的130个和未处理的5674个。在模型冻结后构建的400段AMI会议窗口盲测集上,VoxLock词错率从未处理的42.95%降到10.63%,漏词率从每分钟98词降到1.2词。在Krisp基准的整文件与流式对照中,同一模型live模式词错率为5.15%,低于Krisp Default整文件的5.30%,8位量化模型为5.11%;模型在单GPU上微调完成,8位模型在单CPU线程以40毫秒分块占用约77%线程,算法延迟为24毫秒。结论只适用于英语、16kHz、单主叫人且主叫人是最响最早说话者的情况,样本取错会保留错误的人,在几乎无背景音的电话子场景会把词错率从3.82%升至5.36%,Krisp基准来自被比较厂商且只许非商业使用,转录均来自同一识别器家族且仅一次训练运行。
🔗 开源资源
第三方资源:https://github.com/arbazsiddiqui/voxlock — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/arbazsiddiqui/voxlock — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. 用预测误差把连续语音变成稀疏事件:面向普通话关键词识别的输入编码

评分:6.6/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1.3/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Zijian Zhou:Sivy Limited, Hangzhou, China
- Rui Liu:Sivy Limited, Hangzhou, China
- Rongxiang Nie:Sivy Limited, Hangzhou, China
- Rui Ma:Sivy Limited, Hangzhou, China
- Ziyao Zhang:Sivy Limited, Hangzhou, China
- Xin Du:The Cavendish Laboratory, Department of PhysicsUniversity of Cambridge, Cambridge, UK Corresponding authors.
📌 核心摘要
连续关键词检测需逐帧处理40维对数梅尔特征序列并输出5个关键词类别,相邻帧时间相关性强,稠密接口每帧搬运数据并触发后续计算,即使隐藏层活动稀疏,输入侧开销依然存在。预测性符号双比特编码为每个通道维护本地预测并做漏泄更新,先计算输入与预测的残差,只有残差幅度超过学习阈值才发送事件,事件携带符号和2的负幂次幅度。接收端用定点比较、移位与加减重建更新并送入后端的深度脉冲网络分类,时域聚合后产生关键词得分,不经过通用乘法器,阈值未被越过的小残差保持静默。论文比较稠密输入、只在声学输入用编码、输入与隐藏边界都用编码三种部署,并在前馈深度脉冲网络和因果LIF时序卷积网络上训练验证,发现隐藏层尖峰已稀疏,再编码反而增加负担。整数评测在720个测试片段上显示,INPUT-PG达到90.00%准确率,平均SRAM读取减少33.87%,推理周期减少32.77%,比较对象为同权重DIRECT的89.58%。布线后单片段评测显示增量推理能量下降39.49%,但该能量数字只来自一个固定片段且不含权重加载,软件工作量均值来自全部720个片段,两者评测范围不同。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. 同一推理主干如何听懂语音并调用工具:Apriel Voice 27B Preview 解读

英文题目:Apriel Voice 27B Preview: An Open Model for Speech, Reasoning, and Tool Use
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Aman Tiwari:机构信息未能在本次解析中与作者逐人可靠绑定
- Akshay Kalkunte:机构信息未能在本次解析中与作者逐人可靠绑定
- Akintunde Oladipo:机构信息未能在本次解析中与作者逐人可靠绑定
- Jash Shah:机构信息未能在本次解析中与作者逐人可靠绑定
- Tara Bogavelli:机构信息未能在本次解析中与作者逐人可靠绑定
- Hoang Nguyen:机构信息未能在本次解析中与作者逐人可靠绑定
- Nishanth Madhusudhan:机构信息未能在本次解析中与作者逐人可靠绑定
- Vishal Juneja:机构信息未能在本次解析中与作者逐人可靠绑定
- Sridhar Nemala:机构信息未能在本次解析中与作者逐人可靠绑定
- Srinivas Sunkara:机构信息未能在本次解析中与作者逐人可靠绑定
- Sathwik Tejaswi Madhusudhan:机构信息未能在本次解析中与作者逐人可靠绑定
- Shruthan Radhakrishna:机构信息未能在本次解析中与作者逐人可靠绑定
- Masoud Hashemi:机构信息未能在本次解析中与作者逐人可靠绑定
- Kelechi Ogueji:机构信息未能在本次解析中与作者逐人可靠绑定
- Khalil Slimi:机构信息未能在本次解析中与作者逐人可靠绑定
- Saloni Mittal:机构信息未能在本次解析中与作者逐人可靠绑定
- Pulkit Pattnaik:机构信息未能在本次解析中与作者逐人可靠绑定
- Shashank Maiya:机构信息未能在本次解析中与作者逐人可靠绑定
- Dhruv Jhamb:机构信息未能在本次解析中与作者逐人可靠绑定
- Esakkivel Esakkiraja:机构信息未能在本次解析中与作者逐人可靠绑定
- Katrina Stankiewicz:机构信息未能在本次解析中与作者逐人可靠绑定
- Gabrielle Gauthier Melançon:机构信息未能在本次解析中与作者逐人可靠绑定
- Fanny Riols:机构信息未能在本次解析中与作者逐人可靠绑定
- Amit Saha:机构信息未能在本次解析中与作者逐人可靠绑定
- Lakshmi Sirisha Chodisetty:机构信息未能在本次解析中与作者逐人可靠绑定
- Nitin Aggarwal:机构信息未能在本次解析中与作者逐人可靠绑定
- Anil Madamala:机构信息未能在本次解析中与作者逐人可靠绑定
- Sagar Davasam:机构信息未能在本次解析中与作者逐人可靠绑定
- Segan Subramanian:机构信息未能在本次解析中与作者逐人可靠绑定
- Vikas Yadav:机构信息未能在本次解析中与作者逐人可靠绑定
- Sai Rajeswar Mudumba:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
能听懂话的助手需要完成一连串工作:听清语音请求,结合截图和对话历史理解意图,选择并调用外部工具,再根据返回结果继续回应,难点是语音输入到达时仍要保持文本大模型的推理和行动能力。本文从已完成训练的文本图像解码器出发,先冻结解码器只学习语音编码器经投影器到其嵌入空间的映射,建立语音接口。随后放开解码器做广义任务学习,合成对话把语音片段和保留为文本的材料交织在一起,教师分布在部分来源上以交叉熵与前向KL约束输出。在思考模式并采用Cartesia Sonic 3.5合成的EVA评测中,该模型准确率51.27%与体验分74.13%,均高于同条件下Parakeet加Gemma4-26B基线的39.97%与3.93%。在同样思考模式与合成条件下的τ-Voice三领域等权平均中,该模型任务成功率pass@1为65.51%且语音可用前时延均值1.91秒,成功率高于开源二阶段基线UltraVox-v0.6的26.80%,时延低于其3.95秒。结论适用于英文为主的服务对话和三领域语音任务完成,对多语言泛化、配对显著性和各训练信号贡献尚未验证。原文披露了第二阶段使用48个学生GPU与16个教师GPU约三天的训练量级。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. 长音频多跳问答:用双通道分层图把文字和声音连起来再检索

英文题目:Hierarchical Dual-Graph Retrieval for Long-form Audio Reasoning
评分:6.5/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Eunsang Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Taein Ju:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiyoung Lee:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
长音频推理的输入是一段可达数十分钟的录音,输出是对文本问题的答案,难点是相关线索分布在远处片段,直接送入大音频语言模型会带来过长上下文与高计算开销。AudioHelix 在离线阶段把录音切成定长音频块,再抽取语句级语言单元与定长声学单元,并聚类或抽取形成声学与语言两类语义概念节点,用包含关系连成三层双图。在线阶段从与问题最相似的两个模态概念节点出发,沿共享单元向邻近概念传播相关分数,再汇总到音频块并用个性化 PageRank 排序,只取少量音频块对应的声学单元与文本描述按时间顺序送入模型生成答案。与只用转写文本或直接匹配音频单元的方法不同,该方法保留细粒度副语言信息,又用概念层桥接声学上不同但语义相关的证据。在 TraceAV-Bench 上配合 Audio-Flamingo-3 时准确率达到 59.4%,高于同模型全文音频输入的 56.9%。该结论适用于需要多跳关联的长音频问答,对需要完整转写的任务不适用,原文报告在 TraceAV-Bench 采样上相对全文实现约 11.1 倍延迟下降与约 17.6 倍浮点运算量下降,单条平均 32.9 分钟录音的离线建图约需 391 秒。
🔗 开源资源
- 第三方资源:https://github.com/ewha-mmai/audiohelix — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. 多任务多模态为何互相干扰:MOSAIC 的模态分区与梯度路由

评分:6.4/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Aryan Chowdhury:机构信息未能在本次解析中与作者逐人可靠绑定
- Yizheng Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Thomas Carroll:机构信息未能在本次解析中与作者逐人可靠绑定
- Riza Batista-Navarro:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
日常会话理解需要同时听声音、看画面和读文字,不同会话任务对这三种证据的依赖程度并不相同,硬把它们压进同一个融合表示会让任务之间互相牵制。论文提出模态分离架构 MOSAIC(MOdality-Separated Architecture with Inter-modal Cross-attention,模态分离与模态间交叉注意力架构),让视频、音频、文本各自拥有独立的注意力头、前馈块和归一化分区,只在指定层通过交叉注意力交换信息,再为每个模态构造一个按任务重要性和模态相关性加权的损失并把梯度路由回对应分区。输入的三模态先经冻结编码器得到序列表示,进入划分后的主干后保持特征维度上的分区结构,最终由共享编码器上的多任务分类头输出四个会话标签。与保留融合主干的升级基线相比,该方法在 Corpus of Everyday Japanese Conversation(CEJC,日常日语会话语料)四个任务平均宏 F1(macro-F1,类别平均的 F1 分数)上提高 7.4 个百分点,同时主干参数减少 72%。结论适用于该语料的视频、音频、文本三模态和所研究的四个任务,作者承认未验证其他数据集、更多模态和显式时间对齐下的表现。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. 说话内容和说话方式不一致时,音频大模型为什么更容易认错情绪

评分:6.3/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Fengji Jing:机构信息未能在本次解析中与作者逐人可靠绑定
- Guy Laban:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音交互需同时听懂说话内容和说话方式,本文研究两者情绪不一致时语音情感识别是否更容易出错,难点在于文本与音频分属不同信号且易受类别分布和样本难易混淆。文本先经词典映射为效价-唤醒度-支配度向量,音频先经回归模型映射到同一空间向量,使异质信号放在可比坐标中。两向量欧氏距离再经双组分高斯混合拟合为无阈值不一致概率,该连续分数直接作为逐条错误预测变量并经人类判断验证。随后用同一音频大模型对比纯文本与文本加音频输入做情感分类,并以同特征监督分类器作对照,在聚类稳健逻辑回归中控制真值类别、原型距离与时长。在eNTERFACE’05、MELD与CMU-MOSEI上,用GPT-audio做文本加音频分类并以聚类稳健逻辑回归估计时,以调整后出错优势比为指标,不一致概率每升高一个标准差的该指标值分别为1.25、1.15与1.20,均高于无关联基准1而提高出错几率。同模型纯文本分类在相同回归设置下,以调整后出错优势比为指标,三个语料的该指标值分别为0.85、1.11与1.22,其中0.85低于基准1而1.11与1.22高于基准1,方向随语料改变。GLM-4-Voice无显著关联,换用全神经特征、计入拒答或提供对话上下文后部分效应减弱或消失,故结论仅适用于能有效整合双通道的模型听到音频时的全语料分析。原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/Guylaban/incongruence-aware-ser — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. 音频、乐谱图像与符号乐谱如何共享表示:参数高效微调的迁移检验

英文题目:Parameter-Efficient Fine-Tuning of Transformer Encoders for Audio-Image-Symbolic Music Retrieval
评分:6.3/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Eliseo Fuentes-Martinez:机构信息未能在本次解析中与作者逐人可靠绑定
- Antonio Hidalgo-Centeno:机构信息未能在本次解析中与作者逐人可靠绑定
- Jorge Calvo-Zaragoza:机构信息未能在本次解析中与作者逐人可靠绑定
- Antonio Javier Gallego:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是同一首乐曲的三种样子:录音音频、乐谱图像和 kern 格式符号乐谱,困难在于三者维度与信息量不同,直接比较无法检索,处理过程是先让每个模态各自学会判别标签,再把三路表示送入同一个浅层映射形成可比空间。第一步是单模态适配,每个编码器接一个线性分类头,用作曲家、乐器、标题或声部编制作监督,比较冻结线性探测、完全微调、低秩适配(Low-Rank Adaptation,LoRA)与量化低秩适配(Quantized LoRA,QLoRA)。第二步是多模态映射,编码器冻结,把三路嵌入做归一化与补零后送入共享多层感知机,用三模态合并样本的分类损失训练,分类头训练后丢弃。第三步是评价,类别任务用合并图库的 k 近邻多数投票,作品任务用标题空间的距离排序。与已有直接做音频到乐谱匹配的工作差异在于同时覆盖音频、图像与记谱级符号三路,并把适配与映射的贡献分开度量。在 TriScore 作曲家任务上,适配加映射达到 74.99 宏 F1,比冻结未映射条件高 32.90 个百分点,TriScore 标题空间平均 Top-5 准确率为 55.32。结论只在两个古典音乐数据集与所选编码器范围内成立,在信息不对等的 Musical Theme Dataset 上增益会冗余或被削弱。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://verovio.humdrum.org — 链接可访问(HTTP 200)
第三方资源:https://humlib.humdrum.org — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/models — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 从声音能量到物种名单:丰富度敏感的声学多样性指数如何建成与验证

评分:6.2/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Muhammad Saeed:机构信息未能在本次解析中与作者逐人可靠绑定
- Dmitry Mikhaylov:机构信息未能在本次解析中与作者逐人可靠绑定
- Mohamed H. Alhosani:机构信息未能在本次解析中与作者逐人可靠绑定
- Yasser F. Al Wahedi:机构信息未能在本次解析中与作者逐人可靠绑定
- Rory Pilossof:机构信息未能在本次解析中与作者逐人可靠绑定
- Ahmed Arabi:机构信息未能在本次解析中与作者逐人可靠绑定
- Walid Shaaba:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
被动声学监测输入连续野外录音,常用声学指数只汇总声能分布,易受风雨昆虫机械噪声干扰,与物种丰富度关系不稳,论文输出以3秒窗计的鸟类物种检测并汇总为群落多样性,难点是分类器存在高置信度误检且评估泄漏会虚增性能。在1216次鸣叫24类的强标注热带数据集上按录音分组的5折交叉验证下,BirdNET嵌入加逻辑回归宏F1为0.750±0.029,高于MFCC统计随机森林的0.555,MobileNetV2的0.738与EfficientNet-B0的0.737紧随其后。帧级随机森林泄漏审计中,随机分帧准确率为0.703,而按录音分组5折验证准确率仅为0.409±0.022,约29个百分点的虚高证明基准模型不可直接迁移,故野外改用通用模型重做检测。野外检测把津巴布韦河岸稀树草原和阿布扎比动物园录音输入BirdNET v2.4加地点季节过滤,输出3秒窗初步检测,该检测列表再输入严格事后地点过滤,去除置信度阈值漏过的高置信度误检。过滤后的物种计数接着进入指数计算,转香农多样性除以区域池对数得到ABIE即H/ln Sref,时间稳定性T单独报告。在149个记录小时的每小时分辨率比较中,ABIE与BirdNET丰富度的Spearman相关为0.93,高于最优标准指数ACI的0.48。在昼夜匹配稀释到相等努力量下,草原保持21种、ABIE为0.38,高于动物园三处的1.3-13种、ABIE为0.03-0.21,分离了自然草原与管理城市生境。结论限于单记录器时间重复、仅针对鸟类而不含蛙类昆虫哺乳动物、12kHz带宽内、两地不同季节年份录音且检测未经专家验证的概念验证,CNN在Google Colab的NVIDIA T4上训练而嵌入模型无需GPU训练。
🔗 开源资源
- 第三方资源:https://www.kaggle.com/c/rfcx-species-audio-detection — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. 从逐字听写到有依据改写:有根基生成式语音识别的定义与评测

评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Qing Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Qihan Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Hang Lv:机构信息未能在本次解析中与作者逐人可靠绑定
- Yan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Boqing Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Xuechao Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zehan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Hongjie Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Jian Kang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jie Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yongxiang Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Lei Xie:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是语音到文本的识别输出,困难在于现代语音语言模型常输出带标点、去口语化、翻译或摘要文本,逐字比对的词错率会把合理改写判为错误,又无法发现脱离语音的编造。论文提出接地生成式语音识别,要求一切输出保留在由语音信号支撑的集合内,再按可改写程度划分四个等级。处理过程先给定语音信号定义接地改写空间,以接地函数衡量文本是否被语音与显式上下文支撑并设阈值过滤,得到允许多种表述的候选集合。该集合再按改写自由度划分为字面转写、规范改写、语义改写和语音支撑的结构化四个等级,明确各任务允许的变换范围与输出形式。各等级的输出要求直接进入GSR-Bench的实例化,分别对应会议录音的规范与语义改写、四种方言到标准书面汉语的转换、长实体密集语音的摘要,以及噪声静音音乐和弱语音的空输出约束,评价同时用字符错误率查字面一致、用大模型打分查语义保真与可读性。在GSR-Refine上TeleASR级联大模型的语义打分达到4.54而字符错误率升至16.28%,同一基准下TeleASR原始字符错误率为3.46%但语义打分仅4.16,说明字面准确与改写质量不可互换。结论适用于中文会议、方言和实体密集摘要场景,静音噪声下仍有幻觉风险,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. 让音频大模型学会打分:语音 MOS 自动评估的诊断与适配

英文题目:Scalable Audio-LLM System for Speech MOS Evaluation: A Diagnostic Case Study and Adaptation Roadmap
评分:6.0/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Dimitrios Kokkinis:机构信息未能在本次解析中与作者逐人可靠绑定
- Panagiotis Kakoulidis:机构信息未能在本次解析中与作者逐人可靠绑定
- Nikolaos Ellinas:机构信息未能在本次解析中与作者逐人可靠绑定
- Chrysovalanti Lymperi:机构信息未能在本次解析中与作者逐人可靠绑定
- Alexandra Vioni:机构信息未能在本次解析中与作者逐人可靠绑定
- Georgios Vardaxoglou:机构信息未能在本次解析中与作者逐人可靠绑定
- Iakovi Alexiou:机构信息未能在本次解析中与作者逐人可靠绑定
- Myrsini Christidou:机构信息未能在本次解析中与作者逐人可靠绑定
- Jeasung Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Gunu Jho:机构信息未能在本次解析中与作者逐人可靠绑定
- Inchul Hwang:机构信息未能在本次解析中与作者逐人可靠绑定
- Pirros Tsiakoulis:机构信息未能在本次解析中与作者逐人可靠绑定
- Aimilios Chalamandaris:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
企业语音管线需要对大批量合成语音做离线自然度打分,输入是待测音频加固定提示,输出是 1 到 5 分的平均意见分(Mean Opinion Score,MOS),难点在于人工听评太贵太慢而传统回归模型诊断信息不足。本文先用 Qwen2-Audio-7B-Instruct 做零样本数值打分、少样本示例、成对偏好比较和思维链先分析后打分,观察到分数压缩和位置偏置等失效。接着分析 SOMOS 数据集中语速与音高起伏和人工分的关系,构造语速、表达力和内容一致性三分类诊断基准,暴露基座模型对底层声学属性感知不足。然后用低秩适配(Low-Rank Adaptation,LoRA)把同一模型校准到直接输出小数分数,用于 4 比特量化下的离线批量推理。与 UTMOSv2 在 SOMOS 测试集 utterance 级别的比较显示,适配模型皮尔逊相关系数达到 0.6506,高于所报告基线的 0.4310。结论适用于英语合成语音的域内预筛和回归拦截,不适用于替代最终人工评审,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. 把混合音频拆成几个槽:自监督的对象中心表示如何兼顾分类、检测与分离

英文题目:Self-Supervised Object-Centric Representation for Multi-Task Audio Analysis
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Parthasaarathy Sudarsanam:机构信息未能在本次解析中与作者逐人可靠绑定
- Tuomas Virtanen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
研究对象是包含多个同时发声事件的混合音频,困难在于片段级向量把不同声源缠在一起,难以同时回答出现什么、何时出现以及各声源波形是什么。论文先用预训练的音频频谱变换器(Audio Spectrogram Transformer,AST)把对数梅尔频谱图切块编码为补丁嵌入,再用槽注意力(slot attention)把补丁嵌入竞争分配到 4 个槽向量,用空间广播解码器(spatial broadcast decoder)重构补丁嵌入完成自监督预训练。预训练后冻结 AST 编码器和槽注意力,只训练轻量任务头:分类和检测用共享线性层加匈牙利匹配对齐槽与标签,检测另加帧级活动头,分离用转置卷积把单个槽上采样为时频掩码再借用混合相位恢复波形。在 NIGENS 合成测试集上,槽表示分类 F1-score 为 0.77,检测 macro F1-score 为 0.66,分离 SI-SDR 为 10.89 dB、SI-SDRi 为 18.41 dB,整体优于片段级和补丁级基线。结论适用于受控的三声源 5 秒合成混合声,四声源和未见类别只做了初步验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/partha2409/Object-Centric-Audio-Representation — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. 土耳其语对话何时能接话:TurnTurk-GPT 的方法与边界
英文题目:TurnTurk-GPT: Text-Based Turn-Taking Prediction for Turkish
评分:5.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ahmet Tuğrul Bayrak:机构信息未能在本次解析中与作者逐人可靠绑定
- Fatma Nur Korkmaz:机构信息未能在本次解析中与作者逐人可靠绑定
- Nur Yağmur Tuncer:机构信息未能在本次解析中与作者逐人可靠绑定
- Mustafa Sertaç Türkel:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音对话系统需要边听边判断当前词是否为轮次结束,以便及时应答又不打断用户,土耳其语动词居末且黏着变化集中在词尾,结束线索可能与英语不同。论文输入是去掉标点并转小写的词流,输出是每个词位置的轮次转移概率,难点在于停顿与真正结束在文本上很相似且真实对话数据很少。方法先在土耳其语GPT-2(Turkish GPT-2,124M参数)词表加入轮次转移符和说话人标记,使模型能表示轮次边界与说话人身份。再把对话串行化为轮次加结束符的序列并用说话人标记区分来源,该序列直接作为因果语言建模损失的训练输入进行微调。微调后词得分取其最后一个子词处预测转移符的概率,该逐词概率即用于排序和阈值判决的输出。与多语言端点检测器相比,微调模型在记录不重叠和说话人不重叠划分下平均精度(average precision, AP)更高;在记录不重叠划分下S2R模型AP为0.148,零样本换行概率基线为0.130,多语言基线为0.100。结论只在熟悉说话人时成立,未见说话人时微调与零样本无显著差异,且固定召回率下文本模型每正确一次仍有约10次误报。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/tugrulbayrak/TurnTurk-Gpt — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/tugrulbayrak/Syn-TurnTurk — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/tugrulbayrak/Real-TurnTurk — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. 从医患对话音频直接生成 SOAP 病历:按小节分工的查询压缩方法
英文题目:JYVA at BeTraC: Audio-Based Medical Note Generation with SOAP Section-Specific Queries
评分:5.5/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Youness Dkhissi:机构信息未能从 arXiv PDF 文本可靠映射
- Valentin Vielzeuf:机构信息未能从 arXiv PDF 文本可靠映射
- Antoine Caubrière:机构信息未能从 arXiv PDF 文本可靠映射
- Jean-Emile Dartois:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
医患对话转病历需要把长时间、非正式的口语压缩为结构化文本,输入是包含停顿、重复和无关闲聊的对话音频,输出是分为主诉、客观所见、评估和计划(Subjective, Objective, Assessment and Plan,SOAP)格式的病历,难点在于长音频包含大量无关信息,直接输入容易遗漏要点或编造诊断。该系统保留语音大模型 Qwen2.5-Omni-3B 的语音塔和思考模型,去掉视觉与语音合成部分,再插入按 SOAP 分组的可学习查询模块,从语音嵌入中抽取 96 个临床表征并作为前缀,与原生语音投影一同送入思考模型生成完整病历。两阶段训练先冻结语音塔并联合训练查询模块与思考模型的低秩适配增量,再冻结查询模块并恢复原生语音通路训练新的适配增量,推理时配合束搜索与去重约束输出规范化病历。与已有直接输入全部音频词元的做法相比,差异在于用分组查询显式对应病历结构,引导模型按部分组织证据。在官方 SynthDoPaCo 测试集上,该系统以 0.5005 的概念 F1 超过 0.245 的挑战赛基线并获得轻量赛道第四名,适用范围限于挑战赛提供的合成与模拟对话,真实人类对话仅有极小样本验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://arxiv.org/abs/2503.20215 — 链接可访问(HTTP 200)
第三方资源:https://arxiv.org/abs/2604.14829 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
20. 把乐谱看成点集:变换几何模式匹配的统一框架
英文题目:A General Theoretical Framework for Transformed Geometric Pattern Matching in Music
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 0.6/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0/1.5
排名:前50% | 文档类型:理论研究 | arXiv 原文
👥 作者与机构
- David Meredith:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
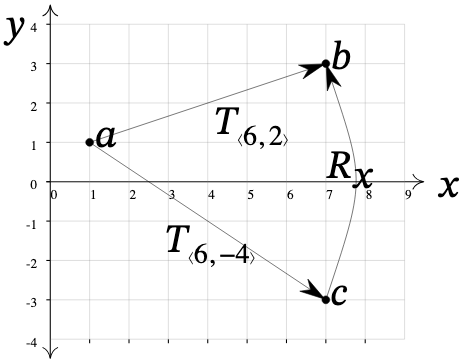
论文研究多维点集中的几何模式匹配,音乐是主要来源,点集中每个点表示一个音,横轴表示开始时间,纵轴表示音高,任务是判断一个模式在另一个数据集中是否出现、出现多少次以及这些出现之间是否可以通过同一族几何变换相互得到。困难在于不同音乐变换对应不同几何操作,需要统一说明一个变换族何时可以由有限个点确定、何时会出现无穷多候选,以及部分重合、非双射变换和模音高情形怎样处理。论文先定义变换类,变换类要求变换参数向量长度、类函数和基对变换集合满足有限性条件,再为二维时间轴缩放加平移及其与反射组合、模意义版本给出参数向量和类函数,并推导由两个基点求全部可行参数的公式与算法。随后定义完全匹配、完全出现、极大匹配与极大模式,证明极大模式经变换得到极大匹配,在双射条件下进一步给出模式与匹配互换的等式,并把极大模式与部分对称联系起来。论文又定义出现集与异质出现集的有序对与有序三元组编码,用覆盖点数与编码长度之比定义压缩因子,说明用短参数向量代替长参数向量有时能缩短描述。上述互换等式与更紧凑编码的结论只在双射、基点横坐标满足区分条件和模数给定等情形下成立,退化基点、非双射变换与多变换类混合情形仅有单向或条件性结论,且未在真实音乐数据集上验证检索与压缩效果。原文未提供可核对的关键定量结果。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. 睡前故事不是越听完越好:Nedimo 如何把不确定的睡眠证据变成可检查的生成管线
英文题目:Nedimo: An Evidence-Grounded Multilingual Pipeline for AI-Generated Sleep Stories
评分:5.3/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.6/1.5 | 清晰度 0.8/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:后 50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Georgios Makridis:机构信息未能在本次解析中与作者逐人可靠绑定
- Stefanos Kampouris:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的问题是,普通音频以完播和留存为目标,而助眠音频希望听者在中途入睡,直接优化完播反而与目标冲突,成人睡前叙述的实证结果又多为混合或阴性。论文处理的输入是运行日期与语言决定的槽位记录,输出是经过校验、合成、响度归一与发布门限的完整音频故事,难点在于让大语言模型稳定遵守低唤醒、注意力渐降和时长预算。处理过程先由确定性规划器固定时长、领域、运动模式和声音配置,再由提示契约生成可解析正文与合成备注,然后经结构与词汇校验、一次针对性重试与隔离,最后分段合成、拼接、响度处理并复测已编码文件。与已有儿童故事生成不同,该系统不追求情节新奇,而是用四阶段注意力渐降约束新实体引入,并把文本正确与波形声学合规分开测量。在10月12日单次夜间运行的表III五故事试点测量中,同为20分钟目标和相同语音条件下渲染时长误差指标下英语为+2.0%(20.4分钟)、印地语为-38.2%(12.4分钟),英语渲染时长误差高于印地语,说明文本字数预算不能保证实际播放时长。结论仅适用于放松与注意力支持场景,作者明确不声称治疗失眠,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。