共分析 47 篇论文
⚡ 今日概览
✅ 筛选入选 47 篇 → 🔬 深度分析完成
每篇论文保留完整分层分类;热门方向按主任务的最上级方向统计,每篇计入 1 个方向。排行榜也显示最上级任务。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| 语音识别 | 5 篇 | █████ |
| 音频分类 | 5 篇 | █████ |
| 语音交互 | 4 篇 | ████ |
| 语音合成 | 4 篇 | ████ |
| 音乐分析 | 3 篇 | ███ |
| 语音克隆 | 2 篇 | ██ |
| 音频生成 | 2 篇 | ██ |
| 声场重建 | 1 篇 | █ |
📊 论文评分排行榜(47 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 从低通到选频:共振脉冲储备如何记住频率

英文题目:Beyond Low-Pass Dynamics: Frequency-Selective Spiking Reservoirs with Resonant Neurons
评分:8.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 1.5/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Aurora Micheli:Delft University of Technology
- Claudio Gallicchio:University of Pisa
- Nergis Tomen:Delft University of Technology
📌 核心摘要
时间序列分类要求从输入随时间的变化中提取类别信息,输出类别标签,难点在于不同类别的差异可能藏在不同快慢的时间节律里,而常用脉冲库只用漏积分发放(Leaky Integrate-and-Fire,LIF)神经元,对快变输入一律衰减,难以区分频率成分。论文提出谐振发放库(Harmonic Resonate-and-Fire Reservoir,HRF-Res),它属于液态状态机(Liquid State Machine,LSM),即循环权重固定、只训练线性读出的脉冲网络,训练无需随时间反向传播。外部输入先经LIF编码层转成脉冲,再进入由谐振发放(Harmonic Resonate-and-Fire,HRF)神经元构成的库,库内神经元以各自固有频率振荡并反馈回编码层,最终用库状态训练逻辑回归读出。HRF神经元具有阻尼振子动力学,对接近自身共振频率的输入积累能量,对其他频率衰减,形成分布式带通滤波器组,这与LIF的低通积分形成对照。在相同库规模与调参流程下,HRF-Res在sMNIST上达到93.64%准确率,相对同构LIF库的67.00%高出26.64个百分点,同时相对非脉冲振荡库RON达到9.6倍到18.7倍的能量降低,最大约19倍。该能量为推理侧估算,在库规模800与末态读出下按脉冲操作与乘累加计数折算,循环主开销随发放稀疏门控。结论适用于具有稳定频率结构的信号,在依赖空间轨迹的手势数据上未见优势,采样率变化也会使调谐偏离,相关能量数字为模型估算。
🔗 开源资源
- 代码相关资源:https://github.com/AuroraMicheli/HRF-Res — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 多声源场景的结构化描述:MixCards 如何定位模型的听觉失败点

英文题目:MixCards: Evaluating Structured Descriptions of Multi-Source Sound Scenes
评分:8.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.5/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Sripathi Sridhar:机构信息未能在本次解析中与作者逐人可靠绑定
- Yujin Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- Giovana Morais:机构信息未能在本次解析中与作者逐人可靠绑定
- Liang-Yuan Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Mehmet Atilay Kucukoglu:机构信息未能在本次解析中与作者逐人可靠绑定
- Prem Seetharaman:机构信息未能在本次解析中与作者逐人可靠绑定
- Lloyd May:New Jersey Institute of Technology New York University Adobe Research Monash University
- Mark Cartwright:机构信息未能在本次解析中与作者逐人可靠绑定
- Magdalena Fuentes:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是语音、音乐和音效多声源重叠的混合音频,困难在于一句自由文本字幕会把漏检、合并声源和属性错配压缩成一个分数,无法定位错误。论文输入混合波形,输出先是来源清单与起止时间,再是每个来源的一张结构化卡片,卡片覆盖语义标签、时间、响度、频谱形态和类别特有属性。处理过程先用基于AudioSet Strong标注的重建管线合成生态合理的声景,再从分离出的独立干声计算信号特征并调用音频大模型和音乐 tempo等专用模型填写各字段,验证后输出结构化JSON。评测时前一步的预测来源清单进入两阶段协议,分别用事件与片段F1计分检测定位,再对命中的来源计分卡片字段。与已有单句字幕和多选题理解评测相比,该设计把检测、定位和每个属性分开计分,能暴露被聚合字幕分数掩盖的属性级能力差异。在4884个合成声景的两阶段评测中,Qwen3-Omni语音、音乐和音效的Card field score平均分分别为0.648、0.631和0.612,均高于Qwen2.5-Omni的0.466、0.456和0.517。结论适用于受控合成声景,真实录音泛化、长时跟踪和属性随时间变化尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/Sound-Captioning-for-Accessibility/mixcardbench — 链接可访问(HTTP 200)
数据相关资源:https://doi.org/10.5281/zenodo.23702059 → https://zenodo.org/records/23702060 — 链接可访问(HTTP 200)
第三方资源:https://mixcards-anon.github.io/mixcards-demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 不换阵列不重训:用扩散后验采样同时做高阶 Ambisonics 编码与上变频

英文题目:Array-Agnostic High-Order Ambisonics Encoding via Diffusion Posterior Sampling
评分:8.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Amit Milstein:机构信息未能在本次解析中与作者逐人可靠绑定
- Nir Shlezinger:机构信息未能在本次解析中与作者逐人可靠绑定
- Boaz Rafaely:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是从麦克风阵列记录恢复与设备无关的三维声场表示,传声器数量少、位置不规则、径向函数衰减和空间混叠会让线性求逆病态,而目标阶数高于阵列可分辨阶数时问题欠定。处理过程是把含噪麦克风信号先线性编码到Ambisonics域,再用生成先验修正可观测分量并补出高阶分量,最终输出目标阶数的时域Ambisonics信号。名为ADEUPS(Array-Agnostic High-Order Ambisonics Encoding via Diffusion Posterior Sampling)的方法先在幅度压缩短时傅里叶变换(Short-Time Fourier Transform,STFT)域学习5阶干净Ambisonics分布作为理想声场先验,并以阶数掩蔽训练随机保留低阶通道并要求网络补全高阶通道,以此建立阶间依赖。推理时物理前向算子模拟解压缩、阵列采样、线性编码和再压缩,把阵列几何带入似然项,混合分数在高噪声阶段联合生成分数与修正分数、在低噪声阶段只保留修正分数,引导扩散后验采样收敛;与阵列专用编码器和只假设理想低阶输入的外推器不同,该方法训练与阵列无关、阵列信息只在测试时进入似然,因此同一模型可用于不同麦克风数量和几何。在13种阵列几何和1300条麦克风信号的评测中,5阶重建在6麦克风不规则阵列上取得8.00 dB的尺度不变信干比(Scale-Invariant Signal-to-Distortion Ratio,SI-SDR),高于线性编码、参数方法和扩散外推基线。结论适用于16 kHz语音、50 dB传感噪声和已知转向矩阵条件,高阶混叠严重或标定不准时的表现尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/Amitmils/ADEUPS — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. 谁在叫?V33DA 用可验证标签做群体鸣声归属

评分:7.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1.5/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Maris Basha:Institute of Neuroinformatics, University of Zurich and ETH Zurich
- Yuhang Wang:Institute of Neuroinformatics, University of Zurich and ETH Zurich
- Xiaoran Chen:Swiss Data Science Center and CVLab, EPFL
- Longbiao Cheng:Institute of Neuroinformatics, University of Zurich and ETH Zurich
- Luca Yapura:Institute of Neuroinformatics, University of Zurich and ETH Zurich
- Anja T. Zai:Institute of Neuroinformatics, University of Zurich and ETH Zurich
- Mathieu Salzmann:Swiss Data Science Center and CVLab, EPFL
- Richard Hahnloser:Institute of Neuroinformatics, University of Zurich and ETH Zurich
📌 核心摘要
群体中每段鸣叫由哪只动物发出,是社会交流研究的起点。难点在于多只候选同时移动时音色位置遮挡都在变化,模型可能记住熟悉个体音色而非学会空间对应。论文发布V33DA基准,每个事件同步多通道音频与多视角视频并给出可见候选三维姿态与无线电遥测,鸣叫者身份由随身加速度计振动信号验证,该验证通道评测时不公开仅用于定义可穿戴参考上限。任务是给定已检测鸣叫与当前可见候选集合选出鸣叫者并输出三维声源位置作诊断,事件构建先由多通道音频提议检测输出鸣叫片段,再由多视角跟踪与背包颜色分配输出每帧候选身份,该身份关联的跨视角观测经三角化输出三维姿态,最后经振动信号验证与人工核对仅保留单鸣叫者事件。评测按记录日期划分熟悉个体测试整组留出新群体迁移与同笼留出一只鸟的未见鸣叫者测试,三者用相同事件与候选集合比较归因准确率。在V33DA共33625个单鸣叫者事件的熟悉个体测试与留一鸟平均测试中,以归因准确率计SELDnet++为86.5%降至0.0%,同一留一鸟平均测试中保留空间推理的SpatialScorer、ACCDOA与EINV2以归因准确率计保持约49.5%至55.4%高于SELDnet++的0.0%。在同一V33DA留一鸟平均测试中可穿戴参考上限以归因准确率计维持在91%以上,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/marisbasha/v33da — 链接可访问(HTTP 200)
数据相关资源:https://huggingface.co/datasets/songbirdini/v33da — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/songbirdini/v33da_pp — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. 直接加在波形上的语音增强:Wav2Aug 如何一次调好到处复用

评分:7.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Gianfranco Dumoulin Bertucci:Concordia University
- Mirco Ravanelli:Concordia University
📌 核心摘要
语音识别常把语谱图上的时频掩码作为默认增强,但直接搬到关键词识别、语言识别、情感识别、口语理解和语音活动检测时收益变小,且波形输入模型无法直接使用语谱图操作。本文要解决的是缺少一组无需逐任务调参、可直接用于原始波形的增强默认配置的问题。提出的方法称为波形增强策略(Wav2Aug),输入为单条 16 kHz 原始波形,输出为同一条波形经两次串行扰动后的增强版本,训练时直接送入识别或分类模型。处理过程是每批从九种变换构成的池中均匀抽取两种并依次作用,每种变换的强度从全局固定范围随机采样,标定阶段选定的范围此后不再改动。在五个非识别任务上,六操作默认池的平均误差低于可兼容的最强固定掩码对照,平均相对误差下降幅度为 12.8%。在五个识别基准上该策略接近掩码对照,没有明显拉开差距。结论适用于论文评测的十个数据集和所用模型族,池大小和视角数存在任务差异,多视角拼接会增大有效批量并增加显存与训练时间。
🔗 开源资源
- 代码相关资源:https://github.com/gfdb/wav2aug — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. 一个编码器加一套输出格式,如何同时解析文档图像音频视频

英文题目:Youtu-Parsing-Omni: One Encoder, One Schema, All Modalities
评分:7.4/10 | 创新 1.6/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Yunhang Shen:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhangquan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaotian Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhongpeng Cai:机构信息未能在本次解析中与作者逐人可靠绑定
- Qing Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Zekai Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Kun Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zezhong Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jian Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Haihan Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Heting Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Xin Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yinsong Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Deqian Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Di Yin:机构信息未能在本次解析中与作者逐人可靠绑定
- Haoyu Cao:机构信息未能在本次解析中与作者逐人可靠绑定
- Xing Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Bing Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yanqiu Qu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunfei Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Kun Yin:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhixiang Wei:机构信息未能在本次解析中与作者逐人可靠绑定
- Yongxiang Hua:机构信息未能在本次解析中与作者逐人可靠绑定
- Qianyu Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaoxing Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Peiyuan Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Lijiang Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Dong Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhenchuan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yiliang Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一条把非文本输入变成可引用结构记录的感知链路,困难在于不同输入的时间与空间坐标不一致、输出字段差异大,难以用同一模型同时保证内容准确、定位准确和格式合法。论文要解决的是用一个编码器处理所有模态、用一个模式输出十种解析任务,并让后训练在异构字段上稳定提升。输入的图像块或对数梅尔谱先变成统一宽度的记号,进入共享双向变换器得到上下文表示,再经合并与映射送入解码器,解码器输出遵循统一模式的 JSON 对象,单元带有空间框或时间戳。共享时间轴让同一时刻的视频帧与音频记号在编码器内对齐,少量融合层在短音频视频窗口内做跨模态注意,窗口之外的长程依赖留给解码器。后训练先用有监督微调建立格式,再用按模式路由的可验证奖励强化学习优化整条输出,最后用按记号角色区分目标的在策略蒸馏做多轮自我演进。与双塔编码器加语言模型融合的已有做法相比,差异在于融合与对齐发生在感知内部,监督按内容记号与结构记号分别计算。在 OmniDocBench v1.6 全集 1651 页上,该模型以 Overall 96.96 超过 TeleOCR 的 96.91,指标越高越好,说明加宽模态覆盖的同时未损失文档解析深度。结论适用于有明确参考解析的十种任务,对物理翻拍退化、几何关系推理等仍有明显下降,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/TencentCloudADP/youtu-parsing — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
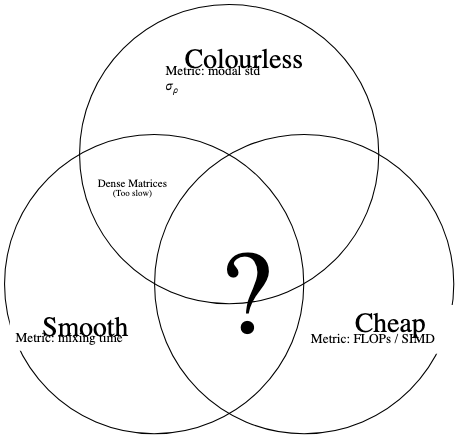
7. 把稠密反馈矩阵装进便宜的分级结构:反馈延迟网络的结构化剪枝
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Facundo Franchino:机构信息未能在本次解析中与作者逐人可靠绑定
- Karolina Prawda:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
反馈延迟网络用N条延迟线和N×N反馈矩阵A在每次采样中交换能量,稠密正交矩阵混合充分但每样本实现代价高。论文输入为已训练好的稠密正交A及其延迟、增益和衰减,输出是由固定路由置换与小正交块交替级联构成的分级矩阵S,要求保持正交性并逼近原混响响应。处理先做矩阵拟合再做响应精修,前者用条件正交Procrustes更新逐层求解块得到初始参数,后者以对数谱距离直接优化完整FDN频率响应,拟合得到的结构化系数和固定路由直接用于向量化执行。与直接设计Householder、Hadamard或小规模可训练FDN的做法不同,该工作保留高阶稠密设计的声学自由度,只把实现投影到低成本结构。在Apple M2上N=256的反馈乘法计时比较中,以反馈乘法时间为指标,成对旋转结构为84.4 ns,低于同条件下基数-4结构的86.4 ns,以系数存储量为指标则为768个浮点数,也少于后者的2048个浮点数。模态激励分布与混合时间在已测系统上基本保持,但N≥128未做完整模态分解,基数-4在训练增益渲染下混合时间增加30–70 ms。结论适用边界是固定置换路由与分块执行,连续加深的结构族不保证嵌套与误差单调下降,联合拟合仍是局部优化,异构路由不能直接导出到该内核;正式听音仅用单一鼓循环片段且各阶参考不同,未确立感知等价性。运行时在内核中编码固定路由并存储预计算块系数,无需三角函数、稠密矩阵物化、动态分配或重正交化,完整混响器的加速还取决于延迟访问、衰减滤波与累加开销,计时仅覆盖反馈乘法而非完整回调。
🔗 开源资源
- 第三方资源:https://github.com/cucuwritescode/fdn_pruning — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. 从一段单目视频生成可漫游的 4D 视听场景:SonoWorld4D 解读

英文题目:SonoWorld4D: From One Video to a 4D Audio-Visual Scene via Diffusion Synchronization
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Derong Jin:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiyi Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Ming C. Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruohan Gao:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
输入是单目视频,输出是可漫游的时变视听场景,静态背景不动而发声前景物体各自运动,新听者位置需要重新算出幅度与频率,难点是输入只在相机位置记录混合声而输出要求每个声源在世界坐标下保持持久信号。方法把视觉分解为全景背景与带轨迹的前景高斯表示,把声音分解为环境声、固定背景源和跟随物体的动态源。视觉部分估计深度、相机位姿和前景掩膜以拼接部分全景并补全为完整背景,再为刚体、人体和可变形体分别重建规范高斯与变形场,最后做尺度与接触位移对齐。声音部分用文本到音频合成静态源并锚定到背景几何,对动态源并行运行相机空间视频到声音扩散与物体空间文本到声音扩散,每次采样用前向声学渲染把物体预测投到相机空间、用分离加逆渲染把相机预测拉回物体空间并加权融合。与只在输入相机视角空间化单声道的Sonic4D相比,该设计让源信号保留视频语义并能在新听者轨迹下重算。在SonoScene4D实拍动态场景上将新听者位置渲染与参考一阶Ambisonic录音比较,空间准确性指标ΔAngular本方法40.7度低于Sonic4D的55.5度,越小越好。适用范围限于室外为主的弱混响场景与可分割跟踪的发声物体,遮挡区间不做逆渲染回传。原文未披露训练、推理或部署成本,作者称框架为免训练框架。
🔗 开源资源
第三方资源:https://humathe.github.io/sonoworld4d → https://humathe.github.io/sonoworld4d/ — 链接可访问(HTTP 200)
第三方资源:https://threejs.org/ — 链接可访问(HTTP 200)
第三方资源:https://sparkjs.dev/ — 链接可访问(HTTP 200)
第三方资源:https://developer.mozilla.org/en-US/docs/Web/API/Web_Audio_API — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. 随信号切换窗长的短时傅里叶变换:U-STFT 如何逐帧选窗又保证可重构

评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Manan Mittal:机构信息未能在本次解析中与作者逐人可靠绑定
- Kanad Sarkar:机构信息未能在本次解析中与作者逐人可靠绑定
- Ryan M. Corey:机构信息未能在本次解析中与作者逐人可靠绑定
- John R. Buck:机构信息未能在本次解析中与作者逐人可靠绑定
- Andrew C. Singer:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是随时间变化的信号局部频率结构,困难是短窗定位冲击但频率主瓣宽,长窗分辨邻近谐波但抹平瞬态,固定窗无法同时照顾两种尺度。论文提出通用短时傅里叶变换,输入是采样率为\(f_s\)的离散时间信号与固定跳长划分的因果观测缓冲,输出是每帧复数时频谱与可精确重建的伴随合成流。每帧先为候选窗长计算归一化三阶Rényi熵,同时评价时间包络与频谱的集中性,熵越低表示能量越集中,最集中者作为该帧标准化损失的零点。这些逐帧损失经指数映射为似然,进入保持、增长、重置三元转移格子,贝叶斯滤波汇聚全部调度可能性的先验与似然得到后验分布,格子把\(\mathcal{O}(3^{M})\)调度压缩为每帧线性递推。后验对候选谱加权平均得到单帧谱,等价为数据自适应有效窗作用的结果,伴随包络归一化合成流经逆变换与无加权叠加实现精确重建。在88 kHz采样15 s双曲啁啾评测中,以每帧混合损失遗憾为指标,经验值稳定在0.526 nats/frame,低于0.760 nats/frame的理论路径编码上界,且全局二维Rényi熵低于固定窗、贪心选择和后见最优调度。与重分配、逐帧贪心选窗和非平稳Gabor框架的区别是该文给出累积混合损失遗憾界并保持线性投影与精确重叠相加,结论适用于窗长在有限候选集内切换且跳长固定的因果分析,跨更大窗库、实时吞吐与强非平稳噪声下的稳定性尚未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
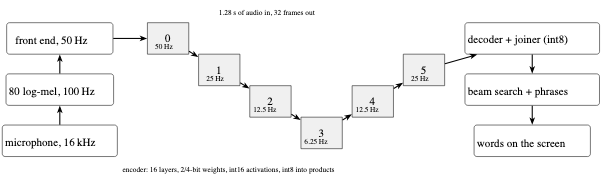
10. 在没有神经加速器的微控制器上跑 65.7M 参数流式语音识别
评分:7.1/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Billal Boumedine:Faculty of Computer Science, University of Science and Technology Houari Boumediene (USTHB);Algiers, Algeria
📌 核心摘要
读者需要理解的对象是在只有 32 MB 片外存储、主频 400 MHz 的微控制器上做开放词汇连续语音识别,困难是模型远大于闪存且算力不足以支撑浮点胶水代码。论文输入是 16 kHz 麦克风音频经 80 维对数梅尔特征切成的 1.28 秒块,输出是随音频流逐步确认的词序列。处理先按矩阵敏感度把编码器 290 个矩阵分配为每权重 2 位或 4 位,再逐矩阵校正回原始输出并用 GPTQ 舍入到哈达玛旋转后的 Lloyd-Max 等级中。接着把激活固定为矩阵间 int16、矩阵输入 int8,乘积用整数 Hadamard 变换加动态移位完成,搜索用波束为 4 的改进束搜索加词组偏置输出最终文本。相对已有微控制器命令词或 13M 参数 CTC 方案,差异是五倍大的换能器仍保持流式和低于实时。与已发布 int8 模型相比,LibriSpeech 测试集干净子集词错率从 3.94% 变为 4.34%,每 1.28 秒块在双核上引擎耗时 0.75 秒、带屏实时固件约 0.90 秒。结论适用于英语朗读和提示语音,未验证噪声、远场和会话语音,作者未测量能耗。
🔗 开源资源
第三方资源:https://github.com/BoumedineBillal/esp32-pie-asr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/BoumedineBillal/esp32-pie-asr-kroko-en — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. 零样本克隆语音模型里藏着哪些可理解的声音特征

英文题目:Discovering Interpretable Acoustic Features in Autoregressive Voice-Cloning TTS Models
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Anuj Diwan:University of Texas at Austin
- David Harwath:University of Texas at Austin
- Eunsol Choi:New York University
📌 核心摘要
零样本语音克隆以几秒参考语音与目标文本为输入,输出未见说话人音色的语音,难点是音高、能量、噪声、口音、情绪相互纠缠,难以判断模型内部究竟编码了哪些属性以及能否独立控制。论文以Qwen3-TTS-12Hz-0.6B-Base为主要对象,另在Fish S1-mini、Fish S2 Pro、Higgs TTS 2、Higgs TTS 3、CosyVoice2上验证泛化,先把自回归主干残差流激活转为话语级特征,再用稀疏探测检验少量特征能否预测已知概念,用生成时加向量检验能否因果改变输出,最后用音频大模型为未知特征写标签并做定量验证。在Qwen3-TTS第19层基于55个提取器概念与21个人类标注概念的稀疏探测中,稀疏自编码器(Sparse Autoencoder,SAE)在人类标注概念的top-2稀疏可恢复性上占优,主成分分析(Principal Component Analysis,PCA)在全特征稠密预测与部分转向对照上常更强,而探测强弱与转向效果并不一致。在100条转向评测话语上以λ=1评估目标改变与非目标改变,Qwen3-TTS与Fish中SAE目标改变与PCA和监督差均值可比且非目标改变更小,能量、音高、谱与音质易转向,而口音与情绪得分改变小。在Qwen3-TTS第19层500个抽样特征的自动可解释性评估中,以相干性≥3/5、标签符合度≥0.75与标签稳定性三项阈值为评测设置,SAE通过验证92个且标签稳定性指标为0.43,高于PCA对照的0.08。在同一500特征中抽取50个已验证与50个未验证SAE特征的Amazon Mechanical Turk人类复核中,每特征用5个激活与5个对照话语评估人类标签符合度指标,已验证特征平均为64.4%,高于未验证特征的51.0%。结论适用于所测自回归克隆架构与所列55个提取器概念加21个人类标注概念,口音与情绪转向效果弱,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/ajd12342/voice-cloning-interp — 链接可访问(HTTP 200)
第三方资源:https://anonymous.4open.science/w/tts_interp_demo/ — 链接不可用(HTTP 400)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. 用循环共享的块代替参数深度:超压缩端侧语音识别

英文题目:Depth through Recurrence: Towards Ultra-Efficient On-Device ASR
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chen Feng:机构信息未能在本次解析中与作者逐人可靠绑定
- Tianyi Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ramchalam Kinattinkara Ramakrishnan:机构信息未能在本次解析中与作者逐人可靠绑定
- Yicheng Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Shaojie Zhuo:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhaocong Yuan:机构信息未能在本次解析中与作者逐人可靠绑定
- Chenzheng Su:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaopeng Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
自动语音识别(Automatic Speech Recognition,ASR)要把输入的语音声学特征序列转写为词序列,云端大模型靠增加独立参数的层数提高准确率,但在手表和眼镜等端侧设备上受内存、算力和能耗限制难以部署。论文首先要回答深层编码器中哪些连续层在做相似变换,再把相似层合并为可重复展开的共享块。做法是先用线性中心核对齐(Linear Centered Kernel Alignment,Linear CKA)计算层间相似矩阵并用动态规划切分为有序分组,每组用组内教师参数平均初始化一个共享块,训练时把共享块按原深度重复展开,并用任务损失加编码器组边界对齐损失和解码器散度损失向教师对齐。个性化阶段冻结共享主干,用注册语音提取的用户向量选择混合专家低秩适配增量,融合后不改变推理计算图。与只在训练后降低精度的思路不同,本文改变参数化深度本身的结构。在八个数据集平均词错率(Word Error Rate,WER)上,两块共享的流式学生模型平均 WER 为 13.40%,相对教师模型的 11.05%,论文报告恢复 97.4% 的准确率,同时编码器参数从 108.9M 降至 14.2M。结论适用于流式 FastConformer 与非流式 Conformer 编码器,依赖表示分组稳定和蒸馏数据覆盖,原文披露在两块 NVIDIA A100 上预训练约 7-10 天、20 轮微调在 3 天以内。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. 用词典发音管住合成语音:爱尔兰语低资源 TTS 怎么做

英文题目:Pronunciation-Supervised Text-to-Speech for Irish (Gaeilge)
评分:7.0/10 | 创新 1.4/2 | 技术严谨 1.1/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- William Lane:Laneguage
📌 核心摘要
爱尔兰语文本到语音的输入是爱尔兰语正字法文本,输出是24 kHz语音波形,难点是正字法与读音对应不透明且有首辅音弱化与蚀变等形态音变,可用transcribed语音仅约13小时且多为学习者朗读。论文先把大型预训练语音合成模型在单一匿名声音标签下做全量参数微调,将202人语音汇成人口平均声音以满足匿名测试。再把英语维基词典转储的发音记录整理成带方言标记的词典,用词典查表所得银标签训练音素评价器,该评价器读取合成语音并输出相对规范读音的音素错误率。然后用该评价器做拒绝微调,对同一提示采样多个候选,只保留打分最好的样本再做一轮适配器微调,前一步的合成语音经筛选成为下一步的训练数据。在跨语料FLEURS-223文本上以语音识别字符错误率衡量,宽适配三采样均值0.225低于从零训练的0.397和零样本克隆的0.437,数值越低越好。在同一FLEURS-223跨语料评测下以字符错误率衡量,评价器筛选再训练后三采样均值从0.225降至0.159,域内对应值降至0.067,质量代理指标不变且仍通过全人口匿名测试。结论限于机器指标而母语听感尚未验证,229/12311的语料构成使方言转向不可行,训练与推理成本原文只给出模型规模与单卡类型,未披露完整时长与费用。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 用对齐的 MIDI 帮助扩散模型修复鼓声:MiDiff 解读

英文题目:MiDiff: MIDI-Conditioned Diffusion Models for Drum Audio Enhancement
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Elad Aspis:机构信息未能在本次解析中与作者逐人可靠绑定
- Sharon Gannot:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一段单声道鼓组录音,它同时受到房间混响与回声、驻极体话筒频响压缩和软削波加粉噪声的非加性破坏,目标是从破坏观测恢复干净鼓声,难点是瞬态密集且相位信息决定打击感,回归类方法容易抹平瞬态。本文方法把复数短时傅里叶变换(Short-Time Fourier Transform,STFT)谱作为扩散状态,把退化谱和同步 MIDI 钢琴卷帘同时送入对数密度对输入的梯度(score)网络,逆向采样逐步去噪得到增强谱。MIDI 先经预训练卷积编码器变成稠密嵌入,再按 U-Net 各层时间分辨率下采样对齐,分别在输入相加、残差块内仿射调制和跨注意力检索三路注入。仅把钢琴卷帘放在分类器梯度里引导纯音频轨迹的对照没有带来增益,而把转录与条件切换结合的混合采样在无真值 MIDI 时仍能改善。在 StemGMD 鼓组数据上,MiDiff 相对同骨干纯音频基线的测试集生成图像与参考样本的特征分布差异指标(FID)在 VGGish 嵌入上的版本即 Fréchet Audio Distance(FAD)从 1.268 降到 0.233。结论限于 16 kHz 合成鼓组与仿真退化,未验证真实录音、编解码压缩和跨鼓手跨音色库泛化。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://midiff-paper.github.io/midiff-project-page/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. 冻结语音编码器做多语言轮次结束检测
英文题目:Towards Multilingual End-of-Turn Detection using Frozen Speech Encoders
评分:7.0/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.9/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Rini Sharon:机构信息未能在本次解析中与作者逐人可靠绑定
- Kadri Hacioglu:机构信息未能在本次解析中与作者逐人可靠绑定
- Andreas Stolcke:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
对话系统需在用户话音刚落时及时回应,话轮结束检测的输入是连续到达的语音流,输出是是否结束的逐帧判决,难点是停顿不可靠而误打断与长等待互相制约。冻结的Whisper-small编码器先把音频前缀变成每20毫秒一帧的特征,在第6层读出,因果流式按160毫秒块重算以防未来信息泄漏,其特征直接送入小逻辑回归探针头打出每帧结束概率。探针头的逐帧概率再经α为0.3的指数平滑,只有平滑分连续三帧超过阈值才触发回应,该阈值在源语言开发集按5%误报预算标定后直接复用到目标语言。相对已有工作,该方法不微调编码器、不依赖识别文本、不为每种语言重建模型和重调阈值。在五个CALLHOME语言上用第6层因果读取评估,冻结编码器零样本平均跨语言差距为0.017 AUC,低于同设置下微调顶两层后的0.023 AUC差距,表现为冻结更利于跨语言保持。源语言阈值复用到五个CALLHOME目标语言时,在因果第6层上误报率保持在3.5%至6.5%,围绕5%预算上下浮动约1.5个百分点,中位延迟相对目标语言重调阈值仅变化0或20毫秒。新语言只需数小时目标语音即接近同语言上限,该结论限于双人电话语音且对重叠话轮不评分,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. 零样本语音合成选哪段提示音频?从合成结果中学习选择

英文题目:What Makes a Good Audio Prompt for Zero-Shot TTS? Learning Prompt Selection from Synthesis Outcomes
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Arnon Turetzky:机构信息未能在本次解析中与作者逐人可靠绑定
- Yossi Adi:The Hebrew University of Jerusalem
📌 核心摘要
零样本语音克隆的输入是一段较长录音和待合成文本,输出是模仿目标说话人的语音,难点在于从同一录音切出的不同候选提示会导致合成话语的可懂度、自然度和说话人相似度明显变化。论文先为每个录音切出10个3秒、6个5秒和3个10秒共19个候选,用Qwen3-TTS 0.6B和1.7B、F5-TTS、Chatterbox四个模型各合成15条输出并取平均作为该提示的结局,以量化提示的影响。再训练一个只读候选音频的选择器,学习按合成结局对同一录音内候选排序,推理时不做任何合成直接挑选,其监督来自目标模型的合成结局而非提示本身是否干净,并把选择固定为每个说话人选一次。在400条held-out测试录音上,选择器使Qwen3-TTS 0.6B的词错率相对随机提示降低1.36个百分点、降幅约32%,比UTMOS规则多降低0.54个百分点。同样在400条测试录音上,选择器使F5-TTS的词错率相对随机提示降低约43%,比最强基线DNSMOS规则多降低1.45个百分点。在Qwen3-TTS 0.6B测试上该增益相当于每个候选合成12句、每录音228次的试探选择,而选择器选择时零合成;标注结局约每个模型100-270 GPU小时,选择器训练在单GPU上仅需几分钟。结论限于YouTube式同录音条件内选提示,Chatterbox本身可选空间小而与基线持平;在候选主要以加噪录音质量差异为主时选择器仅31%选中干净版本、不如UTMOS规则的79%,且主攻可懂度会损失部分预测自然度增益。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. 整句相似度之外:口音克隆差在哪里

评分:6.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Jinzuomu Zhong:机构信息未能在本次解析中与作者逐人可靠绑定
- Alice Ross:机构信息未能在本次解析中与作者逐人可靠绑定
- Catherine Lai:机构信息未能在本次解析中与作者逐人可靠绑定
- Korin Richmond:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
零样本语音克隆常在整句说话人相似度上得分很高,但说话人本人仍能靠口音韵律分辨合成语音,整句打分看不出差异出现在何处。论文先录制苏格兰与澳大利亚4个说话人的新读句并降噪,再用MaskGCT、F5-TTS以同说话人另一段录音为提示合成内容相同的候选,并用构音语音转换系统SPARC重构部分语句作保口音参照,使每对自然参考与合成候选内容匹配以便逐段比对。来自目标口音区的47名保留听众对200个参考-候选对分别给出说话人相似度与口音相似度打分,并在子词切分转写上标出听出口音差异的位置,共得4,700组打分和约48,600个子词二值标注,前一步的内容匹配对直接成为打分与标注的输入。客观侧先计算两种说话人验证、两种口音识别、音素后验概率、共振峰和基频共七种整句距离,再经动态时间规整得到每候选帧距离,最后经强制对齐与字形音素对齐映射到子词并取最大、平均与中点聚合,与人工标注做等级相关。在200个参考-候选对上,口音相似度与说话人相似度的Spearman等级相关达ρ=0.71,高于说话人相似度与标注频率的ρ=0.27,说明两者高度缠连而标注频率提供互补视角。在4,140个子词上,WavLM-SV距离与子词被选比例的Spearman等级相关以最大聚合达0.22,高于平均聚合的0.19,而七种距离在三种聚合下最多仅达0.22,表明局部峰值更贴近感知但整体对应仍弱。结论仅适用于4个说话人、200对朗读句及目标口音区听众条件,子词标注一致性仅Fleiss κ为0.184至0.234,更多口音、说话人与自发语料尚未验证;原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/jzmzhong/segmental_accent_evaluation — 链接可访问(HTTP 200)
数据相关资源:https://huggingface.co/datasets/jzmzhong/segmental_accent_annotation — 链接可访问(HTTP 200)
演示资源:https://jzmzhong.github.io/Segmental-Accent-Evaluation/results.html — 暂时无法访问
第三方资源:https://github.com/Kozea/Pyphen — 暂时无法访问
第三方资源:https://github.com/BytedanceSpeech/seed-tts-eval — 暂时无法访问
第三方资源:https://www.dialectsarchive.com/comma-gets-a-cure — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. 内嵌式音频描述:让解说挤进原视频的沉默里

英文题目:Mind The Gap (MTG-AD): Dataset and Fine-grained Evaluation for End-to-End Inline Audio Descriptions
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Subhashini Venugopalan:Google Research
- Jenny Tan:Google Research
- Taylor Roper:Google Research
- Jimmy Tobin:Google Research
- Anton Kast:Google Research
- Alicia Martin:Google Research
- Sam Sepah:Google Research
- Amy Pavel:Google Research;UC Berkeley
📌 核心摘要
盲和低视力观众看用户生成视频时,常因关键画面没有被说出来而难以跟上,内嵌式音频描述要求在不暂停播放的前提下,把关键画面塞进原有说话之间的自然静音。输入是数分钟长的完整视频与语音转写,输出是带开始时间的描述稿及其合成语音,难点是同时选对内容、说准时刻和控制时长。MTG-AD数据集由明眼描述员与盲人描述员结对撰写八千余段描述,并划分验证与测试视频,为整片评测提供专业参考。MTG-AD-Eval评测先用定速语音合成把每段文字变成播放区间,再计算与原语音的重叠、占用静音比例和剩余静音,同时用语言模型判断是否覆盖重要视觉事件、是否重复可听信息、是否提到屏上文字,以及描述时刻与事件时刻的偏差。相对只看截短片段和单参考文本相似度的做法,该工作把整条音轨是否可听作为评测对象,并给出不依赖人工参考的稿件质量打分Quality-RF。在全部测试视频同一提示与渲染设置下,新一代模型相对此前模型的Prioritization内容优先度指标从0.76升至0.79至0.94,方向为越高越好,其中Gemini-3.5 Flash仍在该区间内,而人类专业描述在叙事节奏上仍保持优势。结论适用于英语用户生成视频与所用合成语速,换语速会改变重叠与覆盖情况,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. 音乐音频生成的方法、控制与评价:从乐器片段到完整歌曲与实时演奏

评分:6.6/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.9/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:综述 | arXiv 原文
👥 作者与机构
- Mateusz Modrzejewski:机构信息未能在本次解析中与作者逐人可靠绑定
- Joanna Kurkowska:机构信息未能在本次解析中与作者逐人可靠绑定
- Dorien Herremans:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者要理解的对象是从文字、歌词、音频或视频生成音乐音频的系统,难点是不同系统在内部表示、生成过程、控制方式和发布条件上各不相同,直接比较分数容易把数据和评测差异误读成方法优劣。原文先统一表示法,讲解神经音频编解码器与自编码器、自回归与掩码词元模型、扩散与流匹配、采样加速和偏好优化的目标与采样过程,再把系统按器乐、歌曲、控制编辑与现场等应用类组织比较。方法上的关键差异是词元语言模型路线与连续隐变量扩散路线逐渐汇入规划器加渲染器结构,前者先写出语义草图或旋律,后者再渲染声学细节,同时用蒸馏和对抗后训练降低采样步数。在器乐文本生成对照表T1批量离线条目中,以报告时长为指标,MusicGen标注30 s窗口高于AudioLDM标注的10 s生成时长,两者输出采样率分别为32 kHz单声道与16 kHz单声道,差异来自报告口径而非同一评测下的优劣排序。原文未提供可核对的关键定量结果。上述判断的适用边界是跨系统比较受数据与评测协议差异限制,工业歌曲系统训练语料达五百万小时以上且未公开而学术系统仅数万小时量级且评测电池不同,掩码解码在所覆盖系统中未用于完整歌曲,现场与编辑尚缺广泛采用的评测协议。原文未披露训练、推理或部署成本,延迟证据只记录论文报告的批量快于实时或流式声明与测量硬件条件。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
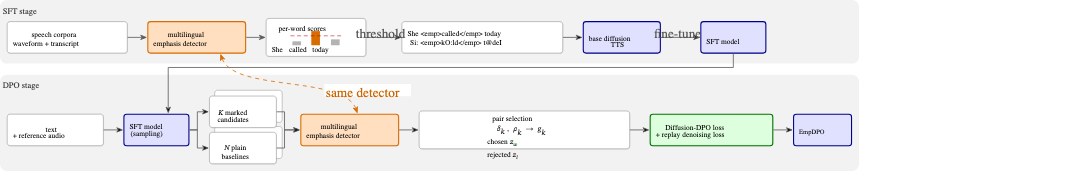
20. 不用人工标注也能让语音合成学会单词重读:EmpDPO 的两阶段做法
英文题目:EmpDPO: Enabling Emphasis Control in TTS via Direct Preference Optimization
评分:6.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Haonan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunyun Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Megan Wei:机构信息未能在本次解析中与作者逐人可靠绑定
- Zeyu Jin:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
输入是一句文本和一段提供音色的参考音频,输出是模仿该音色的语音。难点是同一句话因重读词不同而含义不同,但文本没有标注位置,模型需在不损害可懂度和音质的前提下让指定词更突出。论文先用现成多语言重音检测器给真实语音逐词打分,对超过阈值的词在文本和音素序列同时加标记,再做有监督微调以初步建立标记与声学实现的对应。随后用微调后模型对同一输入生成带标记候选和不带标记基线,用同一检测器按目标词提升量与非目标词保持不突出的比例选出最优和最差候选构成偏好对,再以直接偏好优化拉开两者去噪误差差距并用真实语料回放防止偏离,该路线不需要人工重音标注,也不需要为音高或能量手写奖励函数。在210句、每输入配8个音色的客观评测设置下,指标δ¯为DPO模型0.136,高于有监督微调的0.069和公开系统Fish-S2的0.129。在相同输入集的听音评测设置下,指标Q1为DPO模型3.56分,高于有监督微调的3.15分和Fish-S2的3.25分,指标Q2为DPO模型3.47分,与有监督微调的3.52分相近。该结论仅在德英西法日中六语、每句单个目标词的条件下验证,无回放时去噪误差发散至不可懂,自生成样本回放则响度上升且质量下降,多词重读尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://chaonan99.github.io/empdpo-demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. 空间失真怎么做可控:ODAQ 新增立体声质量数据集解读

英文题目:ODAQ-Collection: Expanding the Open Dataset of Audio Quality with a Focus on Spatial Distortions
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Chih-Wei Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Matteo Torcoli:机构信息未能在本次解析中与作者逐人可靠绑定
- Mhd Modar Halimeh:机构信息未能在本次解析中与作者逐人可靠绑定
- Pablo M. Delgado:机构信息未能在本次解析中与作者逐人可靠绑定
- Sascha Dick:机构信息未能在本次解析中与作者逐人可靠绑定
- Christoph Thompson:机构信息未能在本次解析中与作者逐人可靠绑定
- Phillip A. Williams:机构信息未能在本次解析中与作者逐人可靠绑定
- Emanuël A. P. Habets:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的是立体声音乐与语音经编解码或增强后空间印象的变化,以往开放数据多关注音色退化,缺少可控声像位置与宽度退化及对应的人耳评分。新子集先在音乐厅录制多样声像的源信号,再送入改造的双耳线索编码器分别引入耳间强度差与耳间互相关失真、并经对话增强链路引入掩码量化与分离误差,前步输出的已处理信号直接作为后步听音与合并的输入。两项实验室多刺激隐藏参考和锚点(Multiple Stimuli with Hidden Reference and Anchor,MUSHRA)测试收集训练有素听音者的评分后,与既有子集按统一脚本合并为开放资源,关键差异是把失真参数与心理声学可觉差联系并覆盖移动、硬偏置与中央宽声场声像。在同一实验室耳机MUSHRA评测中,以条目平均基本音频质量为指标,对话增强条件的均值覆盖差到优量表范围,而双耳线索失真平均后多集中在良范围,单声道锚点落在一般范围,说明纯空间退化能拉动的总体质量下限有限。在同一实验室MUSHRA评测中,以平均基本音频质量为指标,全集合条目中最低均值条目为20分、最高均值条目为90分呈相对均匀分布,新增强的148对信号使总数达到688对、覆盖17类处理方法与18984个原始评分。该结论适用于受控听音室与训练有素听音者条件,新增录音主要来自单一音乐厅、对话增强仅十余名听音者且地域与人群集中,尚未验证多厅堂与更大更多样人群的泛化。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/Fraunhofer-IIS/ODAQ — 链接可访问(HTTP 200)
第三方资源:https://doi.org/10.5281/zenodo.23425817 — 暂时无法访问
第三方资源:https://fraunhofer-iis.github.io/ODAQ/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/Netflix-Skunkworks/listening-test-app — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
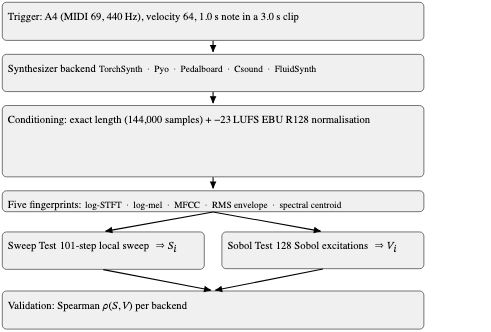
22. 合成器几十个旋钮到底谁有用:扫一遍再用方差验一遍
英文题目:Automated Parameter Sensitivity Ranking in Audio Synthesis
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ogulcan Kibar:机构信息未能在本次解析中与作者逐人可靠绑定
- Baris Ozcan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
现代软件合成器暴露几十个耦合控制,其中很多在常用工作点附近冗余或听感上惰性,设计者需要知道哪个旋钮真正改变声音。论文把归一化参数向量到音频片段的映射作为输入,输出参数按声音影响力的排序,难点是响度变化易伪装成音色变化,且单次度量难以自证排序属于乐器本身。所有渲染先经统一触发与响度归一:采用单音高A4、单力度、3秒片段并填充至144000采样后归一至-23 LUFS,消除增益混杂后输出仅保留结构变化的条件化音频。条件化音频接着转为五种频谱指纹图,扫描检验固定其余参数在0.5对目标参数做101点均匀扫描并度量偏离中心参考的距离得到分数,Sobol检验在同一锚点下用128点确定性Sobol序列激励同一参数并对堆叠指纹逐单元求方差后加和得到独立分数。与已有局部扰动或全局方差分解不同,该工作不估计一阶或全阶指数,只保留两种方法学独立的排序并以斯皮尔曼秩相关验证一致性。在K=128的log-STFT分数下四个确定性渲染引擎两种排序间的斯皮尔曼相关系数达0.823-0.961、p值均不大于7.2×10^-15,明显高于存在进程级渲染噪声的FluidSynth上同一指标的0.319,Sobol预算降至32点时确定性引擎上同一验证相关变化至多0.006。结论只在所测单音高、单力度、中点锚点附近成立,TorchSynth换至0.25与0.75锚点时扫描排序仅复现中点排序至ρ=0.50和0.58,双极性调制路由在中点近乎惰性而换锚后进入前十,静音端增益控制与渲染噪声引擎亦会失效,听感与降维尚未验证。原文未披露训练、推理或部署成本,本研究为一次性离线分析,共约66000次渲染。
🔗 开源资源
- 第三方资源:https://www.fluidsynth.org — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
23. 用保形预测的不确定性来稳定声源方向跟踪

评分:6.5/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Maya Veisman Barness:机构信息未能在本次解析中与作者逐人可靠绑定
- Sharon Gannot:Faculty of Engineering;Bar-Ilan University, Ramat-Gan, Israel
- Bracha Laufer Goldshtein:School of Electrical Engineering;Tel Aviv University, Tel Aviv, Israel
📌 核心摘要
读者需要理解的对象是麦克风阵列采集的运动说话人,其波达方向(Direction of Arrival,DOA)随时间连续变化,混响和突发方向性噪声会让逐帧分类输出跳变。论文输入是由多通道短时傅里叶变换信号构造的瞬时相对传递函数,输出是每帧在离散角度网格上的方向类别和时域平滑后的轨迹。二维U-Net把时频表示映射为帧级后验概率,其最大值对应瞬时方向估计。共形预测(Conformal Prediction,CP)块用校准集得到的阈值把后验转成每帧候选集合,不确定或受扰时集合变大变散,确信时收缩为小而连续集合。跟踪器先用高斯转移矩阵传播上一帧信念得到一步先验,再按集合大小、跨度和间隔不规则程度计算权重融合先验与当前后验,输出最高概率类别作为最终估计。与只取最大后验的瞬时估计不同,该方法在不确定帧更信任时间连续性,在确信帧更信任神经网络。在50个房间的动态运动声源评测中,0.5秒混响加0分贝突发方向噪声条件下,平均绝对误差由平滑前12.79度降至平滑后9.29度。结论适用范围限于单声源、线性阵列和仿真房间,原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/MayaVB/conformal-doa-tracking — 链接可访问(HTTP 200)
第三方资源:https://github.com/xiaopeng-liao/Pytorch-UNet — 链接可访问(HTTP 200)
第三方资源:https://github.com/audiolabs/rir-generator — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
24. 训练数据的说话场景为何改变轮次结束检测
英文题目:The Importance of Speech Genre for End-of-Turn Detector Training
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Rini Sharon:机构信息未能在本次解析中与作者逐人可靠绑定
- Kadri Hacioglu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jeena Prakash:机构信息未能在本次解析中与作者逐人可靠绑定
- Andreas Stolcke:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
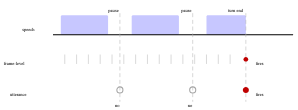
对话系统需要在用户真正讲完时回应,太早打断与太晚等待都会损害体验。难点在于区分话轮内部的停顿迟疑与真正的话轮结束,固定静音阈值把所有静音同等处理,因此容易误触发。本文输入是按 10 ms 分帧的语音特征,输出是每一帧的话轮结束概率和最终端点;研究问题是训练语音类型是否改变检测器的误触发行为。方法先用同一三阶段流程构造两种 10K 训练集,再用同一流式卷积长短期记忆网络分别训练并在四个测试集上比较;随后把比较搬到话语级完整度判断,用两种冻结编码器验证结论是否超出帧级解码。相对已有工作,差异在于不改特征、模型或模态,只改变训练语音类型并做跨类型评测。关键定量结果是同一模型在会话数据训练后比单轮数据训练后最高高出 0.45 的 F1(F1 为正确率与召回率的调和平均,越高越好),差距主要来自误触发减少,例如在 CASPER 上误触发率从 44.7% 降到 6.6%。结论适用于含话轮内部停顿的自然会话,在纯单轮指令测试上优势不显现;原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
25. 把移调、倒影、逆行看成同一动机:旋律的轨道与对称普查
英文题目:Symmetric Structure and Motivic Transformation in Melodies, Phrases, and Themes
评分:6.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Alfredo González-Espinoza:University Libraries, Carnegie Mellon University
📌 核心摘要
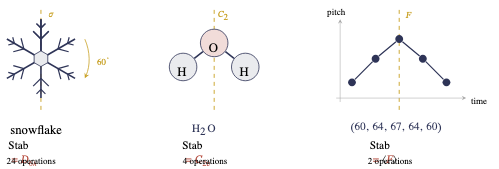
待处理输入是一条由音级构成的旋律线,要求输出其动用的动机种类与每类动机的变形广度,难点在于移调、倒影或逆行后的同一动机表面音符不同,直接比较音符会把同一想法误判为多个想法。方法将长度为\(m\)的滑动窗口置于移调、倒影、逆行与循环移位生成的群作用下,以字典序最小的典范代表标记其所在轨道,同一轨道即同一动机。轨道标签序列用于估计轨道熵以度量动机词汇量,同一轨道内窗口间的群元素关系用于估计配置比以度量平均动用全部变形的比例,窗口的稳定子类型分布则刻画短窗内部对称的种类构成。与按音符或轮廓直接比较的方法相比,该框架先按群合并等价形式再计数,并把词汇量与变形广度拆成两个可分别解释的量。在852首跨越四个世纪的独奏键盘乐曲语料上,以轨道熵为指标,当\(m\ge 4\)时至少97%旋律的轨道熵低于保持音高内容、频谱或一步转移的替代序列。该结论适用于有足够窗口数的键盘旋律短窗统计,对整首乐曲整体对称及短窗与一步转移替代序列不易区分的情形不作保证,民歌乐句与器乐主题等短片段的整体对称需另用整序列精确对称判定。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/spiralizing/MelodicSymmetry.jl — 链接不可用(HTTP 404)
第三方资源:https://github.com/spiralizing/MelodyExtraction.jl — 链接不可用(HTTP 404)
第三方资源:https://github.com/spiralizing/SymmetryEntropiesInMelodies — 链接不可用(HTTP 404)
第三方资源:https://www.kunstderfuge.com — 链接可访问(HTTP 200)
第三方资源:https://www.audiolabs-erlangen.de/resources/MIR/MTD — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
26. 用文字加一次点击从混合声中挑出目标:SelectSep 解读

英文题目:SelectSep: Target-Selective Video Queries for Audio Source Separation
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Suyeon Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Doyeop Kwak:机构信息未能在本次解析中与作者逐人可靠绑定
- Joon Son Chung:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
视频查询声音分离(video-queried sound separation,VQSS)的输入是混合音频加一段查询视频,输出是与查询视频中目标对象对应的干净音频。当同一画面出现多个发声对象且语义相近时,场景级视频特征会混入干扰源信息,文本难以区分同类实例,稠密掩膜又需要在推理时依赖分割模型。SelectSep 的处理沿两个阶段展开:第一阶段用目标视频的教师表示蒸馏混合视频的学生编码器,文本条件提供语义指向,点击坐标提供空间指向;第二阶段冻结该视觉编码器并微调基于扩散的分离主干,混合音频隐变量作为流匹配起点,视觉与文本共同调节生成目标声。相对已有工作,差异在于点击坐标经多层感知机映射后与文本投影拼接为交叉注意力的键值序列,推理时无需分割即可指定实例,同时保留纯文本模式。与共享主干的 MMAudioSep 相比,MUSIC-Clean 全指标占优,例如 FAD(Fréchet Audio Distance,生成音频与参考集的特征分布差异指标,越低越好)从 5.50 降至 3.82。结论适用于 0 dB 等响混合与首帧可见目标的短片段,对遮挡、目标缺席或多目标切换尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
27. 不用时钟的事件网络:切分不变、同时连续、顺序仍可见

英文题目:Learning Without Clocks: Partition-Invariant Neural Network
评分:6.2/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 0.7/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Han Wang:Hefei Institutes of Physical Science, Chinese Academy of Sciences, Hefei 230031, China
- Jingyuan Bao:Hefei Institutes of Physical Science, Chinese Academy of Sciences, Hefei 230031, China;Science Island Branch, Graduate School of University of Science and Technology of China, Hefei 230026, China
- Juntao Wu:Hefei Institutes of Physical Science, Chinese Academy of Sciences, Hefei 230031, China;Science Island Branch, Graduate School of University of Science and Technology of China, Hefei 230026, China
- Saiao Zhou:Hefei Institutes of Physical Science, Chinese Academy of Sciences, Hefei 230031, China
- Yuman Nie:Hefei Institutes of Physical Science, Chinese Academy of Sciences, Hefei 230031, China;Corresponding author: Yuman Nie
📌 核心摘要
事件相机、人工耳蜗等传感器输出带时间戳的异步事件流,常规做法把事件装入固定帧或数据包,输出随之依赖人为划分。论文研究状态在每个事件处精确跳变、在事件之间按闭式漂移演化、查询可放在任意时刻的网络,证明同刻事件处理顺序无关、两事件交叉时状态连续、两跳变映射可交换三者等价;一旦跳变可交换,顺序信息只能来自跳变与漂移的非交换。基于此提出的无时钟事件层先以send-on-delta编码器把采样信号一致转为事件,再对受影响站点逐事件更新快迹、延迟迹与累加器构造可学习相关器,单层三维状态即可表达有序对交互。随后卷积头在站点网格上聚合,经锚点空间池化与跨查询时刻有界记忆累积,再由线性分类器输出各前缀 logits,单事件单站点代价约为1.9×10³次乘加、随事件数线性增长。在DVS128 Gesture开发集校准片段上以正确片段数为指标,有序TM状态高于同结构加性状态,198片段V1配置200 ms处170对152、800 ms处176对169。在音频验证集上以准确率为指标,增强配置下有序状态亦高于加性状态,SHD十点均值TM为81.80%对NS为64.31%,Speech Commands终点TM为79.56%对NS为48.98%。结论限于开发集与单层验证,正式测试、第二层增益与跨平台鲁棒性尚未完成,SHD与Speech Commands结果仍低于已发表测试准确率与紧凑卷积基线。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
28. 相邻帧很像时何必每帧都完整编码:自适应关键增量量化如何省码率

英文题目:AKDQ: Adaptive Key-Delta Quantization for Low-Bitrate RVQ-based Neural Speech Codecs
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xiao-Hang Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yang Ai:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhen-Hua Ling:机构信息未能在本次解析中与作者逐人可靠绑定
- Ji Wu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音神经编码器把波形或频谱特征压缩成离散码流,解码端再恢复语音,低码率下每帧都用同样数量码本会重复传输相邻帧相似内容。论文把该冗余处理成在残差向量量化瓶颈处为每一帧选择传输方式,相似帧只传相对上一重建结果的变化量,变化大的帧才用全量码本做锚点。输入是编码器输出的连续隐变量序列,调度器根据已花费码率和当前帧难度决定帧类型,量化器再按类型调用全部或部分码本复用同一套码本,输出是重建隐变量与码本索引加一比特帧标志。调度器只用因果信息并维护码率银行,使长期平均码率趋向目标值,解码端用同样的上一帧重建结果即可恢复,不增加前视。与训练多码率残差向量量化或增加可学习重要性子网络的做法不同,该方法冻结编码器与解码器主体,只微调适应新的量化前向过程。在16-kHz LibriTTS test-clean上,DAC结合该方法在1001.4 bps的UTMOS为3.674,高于1000.0 bps固定码本残差向量量化基线的3.395。同一测试集上,DAC结合该方法在1498.7 bps的ViSQOL为4.147,接近2000.0 bps同种基线的4.183,STOI为0.926对0.935,相当于节省约25%码率。该结论在因果与非因果两类编码器结构的低码率工作点验证,跨语种、噪声与超低码率行为尚未验证;原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
29. 课堂西班牙语识别为何不能只看总词错误率

评分:6.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Olga Kellert:Arizona State University
- Samhitha Harish:Arizona State University
- Johnatan E Bonilla:Freie Universität Berlin
- Nemika Tyagi:Arizona State University
- Phanos Kareen:Arizona State University
- Nelvin Licona-Guevara:Arizona State University
📌 核心摘要
在线西班牙语第二语言课堂输入是多人远场录音,输出是带说话人归属的文字记录,难点在于学习者发音不稳定、话轮短促重叠,以及西班牙语与英语在同一话轮内交替。论文先由精通双语的转录员校对Zoom字幕、补齐遗漏并核验归属,得到38个会话共15.6小时适配集与7个保留会话参考,再用该适配集对Whisper large-v3与MOSS-Transcribe-Diarize做领域内低秩适配,适配方案由学习者不重叠五折交叉验证固定。推理时Whisper按参考定义的话轮切分短窗解码,MOSS与Muse则处理长录音或完整会话,其转录输出再进入合并词数统计与条件切分。评测在7个保留会话共约3.51小时上按合并词数统计词错误率与字符错误率,并单独统计分离标注错误率评价说话人归属。在7个保留会话评测中,适配后MOSS总体词错误率为16.39%,高于商用Muse的15.59%,两者组成领先组,而Whisper适配增益较小。在7个保留会话按语言情境评测中,MOSS适配器混合话轮词错误率为21.44%、西班牙语单语为14.77%、英语单语为24.14%,分别高于对应条件下Muse的20.41%、14.05%与22.93%,且混合与英语单语错误高于西班牙语单语。按角色拆分时学习者词错误率比教师高约10个百分点,原文明确0.80个百分点总体差距小于会话级波动而不构成排序。结论限于该校课堂与辅导会话及人工校对参考,英语单语样本小需谨慎解读,未验证其他课程与语言对。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/samhithaharish/asr-code-only — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
30. 只留两个全模态工具的问答智能体为何还能答得准

英文题目:Efficient Agentic Audio-Visual Question Answering through Toolset Pruning and Modality Consolidation
评分:6.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yi Wang:School of Informatics, University of Edinburgh, UK
- Tianzi Wang:Department of Systems Engineering and Engineering ManagementChinese University of Hong Kong, Hong Kong SAR
- Peter Bell:School of Informatics, University of Edinburgh, UK
📌 核心摘要
细粒度音视频问答要求模型联合音频流与视频流回答问题,相关证据在时间上稀疏并分散在两种模态中,难点在于定位时间对齐的片段并建立跨模态对应。已有全模态智能体做法是让文本规划器反复调用音频描述、语音识别、事件定位、视频问答等专用工具来主动取证,工具多导致轨迹长、开销大。论文从专用工具的OmniAgent出发,先按功能分组剔除,再把保留的描述与问答能力合并为全模态工具,最终只保留全模态描述工具与全模态问答工具,规划器先取全局描述,再按需追问或直接作答。与复现的八工具OmniAgent相比,紧凑双工具智能体在Daily-Omni完整集上准确率为78.86%,高出1.33个百分点,同时单题平均估计推理费用降低约七成。该结论在o3作规划器、Gemini-2.5-Flash作冻结共享感知模型、最多六次有效调用且先取全局描述的配置下成立,紧凑智能体在WorldSense上准确率为58.39%,低于复现OmniAgent的59.30%,长视频增益更明显。若去掉问答类工具或全局描述准确率会明显下降,换用其他规划器与感知模型或改变提示与预算时效果未经验证,完整评测为单次运行且作者不声称全局最优。原文披露基于API计费的估计费用与调用统计,约为500美元的o3费用与100美元的Gemini-2.5-Flash费用,未披露训练成本。
🔗 开源资源
第三方资源:https://anonymous.4open.science/r/efficient_agentic_avqa-28E4/ — 链接可访问(HTTP 200)
第三方资源:https://openai.com/index/o3-o4-mini-system-card/ — 链接不可用(HTTP 403)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
31. 在树莓派上直接听船:轻量水下船舶分类如何兼顾准确与延迟

英文题目:Lightweight Underwater Acoustic Vessel Classification for Embedded Deployment
评分:6.1/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Abishek Soti:机构信息未能在本次解析中与作者逐人可靠绑定
- Thura Pyae Sone:机构信息未能在本次解析中与作者逐人可靠绑定
- Naqib Ibnul:机构信息未能在本次解析中与作者逐人可靠绑定
- Jim Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Sergio Chevtchenko:机构信息未能在本次解析中与作者逐人可靠绑定
- Henry Zhong:机构信息未能在本次解析中与作者逐人可靠绑定
- Gregory Cohen:机构信息未能在本次解析中与作者逐人可靠绑定
- Ying Xu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
海上被动监听需把水听器布到离岸海域,但链路带宽与供电有限而难以回传原始音频,论文要解决的是在嵌入式设备本地把16 kHz采样的五秒音频片段映射为四类船只或背景噪声。方法先用短时傅里叶变换把每段音频转为128频点乘475时间帧的语谱图,作为后续统一的声学表示;语谱图再分两路使用,两层卷积神经网络直接以语谱图为输入学习时频特征,其余四个分类器则对语谱图做时间维均值与标准差池化,把各频点的典型响应与时变拼成256维向量后送入线性或核分类器。六个分类器在树莓派5上经同一音频到预测流水线、用445个ShipsEar测试片段评测,两层卷积神经网络平均宏观F1为(99.14±0.32)%,RBF-SVM为98.83%,前者高0.31个百分点,而RBF-SVM中位端到端延迟为28.109 ms,低于卷积神经网络的120.655 ms约76.7%,其中特征提取约占其总时间的93%。作者因此把RBF-SVM部署到树莓派Zero 2 W上,在同样445个测试片段上保持98.88%准确率与98.83%宏观F1,中位端到端延迟349.09 ms,持续吞吐2.962次/秒,超过连续五秒音频所需的0.2次/秒达14.8倍。在树莓派5持续60秒运行中,RBF-SVM的系统CPU占用、进程内存与受监控电源轨功耗均明显低于卷积神经网络,Zero 2 W上平均整机功耗1.17 W,比空闲0.55 W高0.62 W。该结论只适用于该冻结切分的同一测试集比较,论文明确说明因无法重建源记录标识而不能验证记录无关泛化,也未验证跨海域与跨设备采集条件下的性能;原文披露了推理延迟、持续功耗与内存占用,未披露训练时长与训练能耗。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
32. 当语音助手听不懂地方口音:Geordie 人的评价与调音
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Dana Serditova:机构信息未能从 arXiv PDF 文本可靠映射
- Kevin Tang:机构信息未能从 arXiv PDF 文本可靠映射
- Jochen Steffens:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
这项研究面对的问题是自动语音识别对地方口音识别不准时使用者如何应对,以及带地方口音的语音助手会被赋予怎样的社会含义。输入是纽卡斯尔英语使用者与Wizard-of-Oz模拟语音助手互动后的半结构化访谈文本,Wizard-of-Oz指被试以为在与自主助手对话而实际由研究者控制播放,输出是对纽卡斯尔英语语音与标准南部英国英语语音评价的归纳和六种适应策略发生情况的估计,难点在于把日常口音态度、职场变体选择和对机器识别能力的判断区分开。研究让被试分别接触两种实验语音,再用访谈收集对实验语音的描述、对真人和机器中地方口音与主流口音的评价、日常改口情境和以往适应做法,编码后文本一方面做描述性计数和引文分析,另一方面把六种策略转成重复二值观测并用混合效应二项逻辑回归比较策略间差异。与只测识别错误率的工作不同,该工作把适应方向区分为向机器感知可懂度靠拢和向社会身份靠拢,并提出识别优先于合成表现的包容性排序。在纽卡斯尔收集的58名使用者中57名纳入定量分析共342次策略观测的混合效应二项逻辑回归中,以模型估计概率为指标,报告把口音改为更主流形式的观测比例为31.6%,模型估计概率为26.0%,95%置信区间为14.2%到42.8%,高于调大音量等其余策略并在Tukey多重比较校正后保持差异。结论适用于英国东北部这一特定口音社群在高风险建议等情境下的预期偏见,未经声学验证,不能证明报告的策略真实改变了语音声学参数。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://doi.org/10.5281/zenodo.23685953 → https://zenodo.org/records/23685953 — 链接可访问(HTTP 200)
第三方资源:https://credit.niso.org — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
33. SymKL:用一个神经表示的敏感度结构衡量图像、音频与三维信号的退化

英文题目:SymKL: A Unified Representation-Space Measure of Signal Degradation
评分:6.0/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Dhananjaya Jayasundara:机构信息未能在本次解析中与作者逐人可靠绑定
- Sudarshan Rajagopalan:机构信息未能在本次解析中与作者逐人可靠绑定
- Vishal M. Patel:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是全参考退化度量,输入是一对 pristine 参考信号与退化观测,输出是一个非负标量,难点是图像、音频和三维数据的失真类型和常用指标互不通用,且常用指标在部分退化区间会出现饱和或非单调。本文先为参考信号拟合一个坐标网络表示并冻结参数,再用参考和退化信号分别计算该冻结参数的对角经验 Fisher 信息,得到两份参数敏感度剖面,最后计算二者的对称库尔贝克-莱布勒(Kullback-Leibler,KL)散度作为退化分数。对正弦激活网络(Sinusoidal Representation Network,SIREN),论文推导了对角 Fisher 信息的精确闭式,使一次前向加一次反向加逐层矩阵乘即可完成计算。图像上以超网络(Hypernetwork)加一阶模型无关元学习(Model-Agnostic Meta-Learning,MAML)适配加速参考拟合,音频和体数据则直接优化。与直接比较像素、波形或几何不同,该方法比较的是同一表示解释两个信号时参数重要性的重排。在 KADID-10k 运动模糊的多严重度序列上按同一平均相对灵敏度评价协议比较,SymKL(Symmetric KL,对称 KL 散度量)的平均相对灵敏度为 3.479,高于表中最强的图像基线 DreamSim 的 2.860,且在颜色块和量化序列上保持单调而多个常用指标出现回退。结论适用于信号可用坐标网络重建且退化定义在相同坐标上的情形,不预测人眼或人耳感知的优劣,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
34. 不用发音词典的马来语合成:双分辨率如何留住短字母
英文题目:DRC-TTS: A Dual-Resolution Codec-Based Architecture for Lexicon-Free Malay Speech Synthesis
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tianhui Su:机构信息未能从 arXiv PDF 文本可靠映射
- Tien-Ping Tan:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
需要解决的是从马来语文本直接生成语音,输入是清洗和规范化后的小写字符序列,输出是可由外部解码器还原为波形的离散声学码元。字符物理时长常短于低帧率编解码器一帧的时间,在12.5 Hz下按取整量化可能得到零帧,字符在长度调节阶段失去表示,导致发音遗漏。处理沿单条前向展开:字符嵌入后经序列编码器得到语言表示,按50 Hz分辨率复制展开并保证每字符至少一帧,再经步长为4的一维卷积下采样到12.5 Hz,与预测的基频和能量相加后由解码器逐帧预测量化器编号,最终送入Mimi解码器合成波形。与完全在12.5 Hz展开的单分辨率基线相比,该设计保留短字符的中间表示,同时不增加需要生成的码元数量。在Idayu单女性说话人语料的留出测试上,用外部语音识别系统计算字符错误率,双分辨率模型为21.86%,低于单分辨率基线12.5 Hz的27.11%。在20名马来语母语者对20句域外句的五分制自然度评测中,双分辨率模型平均意见分为4.30,高于单分辨率基线的4.12。结论适用于该语料和评测条件,跨说话人、跨语种和统计显著性尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/malaysia-ai/malaya-speech — 链接可访问(HTTP 200)
第三方资源:https://github.com/jaywalnut310/glow-tts — 链接可访问(HTTP 200)
第三方资源:https://portaspeech.github.io/ — 链接可访问(HTTP 200)
第三方资源:https://speechresearch.github.io/fastspeech/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
35. 只用参数先验做人声效果个性化:标签偏移下的内容与风格合成

英文题目:Personalising Parametric Audio Effect Recommendation for Vocals from Parameter-only Style Priors
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Soumya Sai Vanka:机构信息未能在本次解析中与作者逐人可靠绑定
- Hayato Yamakawa:机构信息未能在本次解析中与作者逐人可靠绑定
- Kazunobu Kondo:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Takahashi:机构信息未能在本次解析中与作者逐人可靠绑定
- György Fazekas:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
人声效果推荐输入一段干声人声、输出可直接加载的效果链参数,难点是参数到音频多对一,仅匹配参考音频无法还原特定工程师的旋钮习惯,而工程师音频因版权无法共享,能共享的只有调音台召回存下的参数。论文把工程师风格建模为参数空间边缘分布,用通用内容模型从音频预测参数并除去总体分布得到内容更新项,再按标签偏移假设与工程师先验相乘得到个性化后验,无需成对工程师音频且无可调插值权重,高斯实现下按精度自动权衡听音频还是听先验。内容模型与总体分布用干湿人声音轨及对应DiffVox拟合的参数估计,风格先验用仅约束均衡与动态参数的人工archetype作可控探针,不触及延迟混响偏好。在以歌曲为分组的留一歌曲交叉验证中,以MedleyDB中52首歌曲的70条人声音轨与DiffVox拟合参数为数据集,块式合并特征的内容模型在130维上合并的留出决定系数为+0.019,超过200次打乱音频参数配对的零分布最好值-0.029至-0.035。在14名听众共224次试验的强制选择听测T0中,合并推荐相对纯内容推荐的正确区分率为89.3%,高于50%机会水平并达显著性。在以总体方差为参照的κ扫描标定中,自信先验紧度κ约为0.04,仅为总体方差约4%,远紧于可信的人体变化范围,低中频均衡等维度内容信号为负尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://cambridge-mt.com/ — 链接不可用(HTTP 403)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
36. 低资源非洲语言语音识别:架构、数据量与适配策略如何起作用

评分:5.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mercy Muchai:机构信息未能在本次解析中与作者逐人可靠绑定
- Kevin Chege:机构信息未能在本次解析中与作者逐人可靠绑定
- Nick Mumero Mwangi:机构信息未能在本次解析中与作者逐人可靠绑定
- Samuel Chege Maina:机构信息未能在本次解析中与作者逐人可靠绑定
- Felermino Ali:机构信息未能在本次解析中与作者逐人可靠绑定
- Elizabeth Ankrah:机构信息未能在本次解析中与作者逐人可靠绑定
- Ignatius Ezeani:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
低资源非洲语言自动语音识别的输入是采样后语音波形与对应转写文本,输出是新语音文字转写,难点是标注语音少、形态复杂且领域词汇变化大,预训练多语模型能否迁移成为关键。所有音频先重采样至16kHz并做小写、去标点等文本规范化,规范化后的语音文本对按每语言固定时长组成微调数据,直接决定后续适配的数据量与词汇分布。Phi-4只更新音频编码器等音频相关模块而冻结大语言模型主体,Whisper扩展词表并微调整体,MMS冻结主干只训练各语言专用适配器,单语与多语、是否加入农业领域数据及适配器初始化差异都体现在该步训练输入中。各微调检查点在各语言原始测试划分上以字符错误率为主、词错误率为辅进行长度归一化评测,评测设置与训练时长对应以比较架构与策略差异。在200小时每语言单语微调的六语言比较中,菊尤语上Phi-4字符错误率为0.21低于Whisper的0.71,卡伦金语上0.26低于0.70,Phi-4在六种语言中四种字符错误率最低。在菊尤语通用200小时基础上加入38.3小时农业语音的对照中,同源农业持留划分上Phi-4相对字符错误率下降达83%,而异源私有农业测试集上MMS字符错误率从0.32升至0.56出现退化。结论仅适用于受试六种语言和给定数据配比,不宜推广为普适阈值;原文披露峰值显存与训练耗时,未披露推理时延与部署成本。
🔗 开源资源
- 第三方资源:https://datacollective.mozillafoundation.org/datasets/cmj8u3puq00qhnxxbg26y0owu → https://mozilladatacollective.com/datasets/cmj8u3puq00qhnxxbg26y0owu — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
37. 金融日语合成里汉字词读错了怎么验出来
英文题目:Reading-Level Verification of Kanji Words in Japanese Financial Speech Synthesis
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Cheng Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
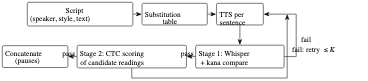
面向日语财经语音合成,输入是带有说话人和风格标记的对话脚本,输出是拼接后的连续语音,难点在于同一汉字词存在领域相关的多种读音,文本前端或声学模型都可能选错,而听众对术语错误敏感。生产流程先用WhisperX转写加pyopenjtalk转假名比对做第一级门,再对含已知歧义词的句子计算目标读音与易混读音的联结时序分类(Connectionist Temporal Classification,CTC)对数似然差做第二级核验,差值超过阈值即判为误读并触发重采样。相对已有做法的差异在于不再信任识别器输出的汉字文本,而是直接比较同一音频在不同假名标注下的声学证据,使语言模型先验的影响在差值中相互抵消。在由3个生产克隆声音合成30个金融术语、共180句正确读音与180句注入误读组成的受控集上,以误读检出召回率与正确读音误报率为指标,转写比对门为78.9%与44.4%,阈值为0的所提核验为91.7%与5.0%,后者召回高于前者而误报低于前者,在同一受控集上裕量ROC曲线下面积为0.990。在3个声音共180句自然汉字输入上,以整句重生成请求比例为指标,该核验捕捉到前端把大勢读作おおぜい的真实错误,并把该比例从转写比对门的38.9%降至所提核验的6.1%。结论适用于词表内歧义词的读音核验,不覆盖省略、插入、含糊发音与声调错误。在平均时长4.1秒的上述语句上经单块NVIDIA H100 NVL GPU测量,以单句核验耗时与实时率为指标,单句平均耗时17.6 ms、实时率为0.004,开销远低于合成与转写而可忽略。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
38. 把钢琴录音逐帧变成 88 键开关:CQT 加双向循环与注意力的复调转谱

英文题目:A learning-based method of automatic music transcription
评分:5.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Phu-Anh-Tai Do:Department of Information Technology;FPT University;Ho Chi Minh City, Vietnam
- Huu-Hoang Nguyen:Department of Information Technology;FPT University;Ho Chi Minh City, Vietnam
- Duc-Hoang Nguyen:Department of Information Technology;FPT University;Ho Chi Minh City, Vietnam
- Thanh-Hai Le:Faculty of Information Technology;Ho Chi Minh City Open University;Ho Chi Minh City, Vietnam
📌 核心摘要
自动音乐转录要把混合钢琴录音变成每帧哪些琴键发声的符号记录,难点是多音叠加、泛音列频域重合、击弦延音混响造成帧间相关及发声帧远少于静音帧。论文输入44.1kHz下混单声道波形,做常数Q变换得7个八度共252维对数频率表示,每帧映射为88个琴键二值向量,输出逐帧激活的钢琴卷帘序列。处理分三步:前端修正注意力筛选频带与时间上下文,输出送入3层双向长短期记忆网络建模前后向依赖,最后经88维sigmoid以0.5阈值二值化并做最短持续与间隙填补,训练用二元交叉熵族损失应对约41.5:1稀疏。与把注意力夹在循环层之间或只用单向循环不同,前置多头注意力先滤波再时序积分并利用未来帧,高容量下标准二元交叉熵精度召回更平衡。在MAPS与MAESTRO构成的复调钢琴测试上,最好的多头注意力加双向长短期记忆网络取得F1-score为88.20%、准确率为78.90%、精确率为0.89、召回率为0.86,高于同协议下单向长短期记忆基线的71.20%。该结论只在上述两套钢琴数据与帧级别指标下成立,未验证其他乐器、非钢琴音色与音符级起止评价下的表现。共享八度、四度、五度等谐波音程的密集复调仍易基频混淆,仅用MAPS训练会在高音区把泛音误判为独立音符,加权损失在混响衰减段还引入幽灵激活。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
39. 声学智能体怎么做事:故障检测基准与超材料设计案例
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Arne Hildenbrand:Chair of Vibroacoustics of Vehicles and Machines, Department of Engineering Physics and Computation, TUM School of Engineering and Design, Technical University of Munich, Boltzmannstrasse 15, 85748 Garching, Germany
- Philipp Diel:Chair of Thermodynamics of Mobile Energy Conversion Systems, Faculty of Mechanical Engineering, RWTH Aachen University, Forckenbeckstrasse 4, 52074 Aachen, Germany
- Zhuo Cao:IAS-8, Forschungszentrum Jülich, Wilhelm-Johnen-Straße, 52425 Jülich, Germany
- Hanno Scharr:IAS-8, Forschungszentrum Jülich, Wilhelm-Johnen-Straße, 52425 Jülich, Germany
- Stefan Pischinger:Chair of Thermodynamics of Mobile Energy Conversion Systems, Faculty of Mechanical Engineering, RWTH Aachen University, Forckenbeckstrasse 4, 52074 Aachen, Germany
- Steffen Marburg:Chair of Vibroacoustics of Vehicles and Machines, Department of Engineering Physics and Computation, TUM School of Engineering and Design, Technical University of Munich, Boltzmannstrasse 15, 85748 Garching, Germany
📌 核心摘要
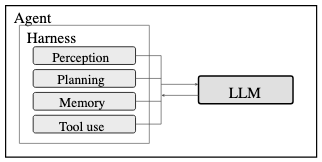
本文研究声学工程师能否用语言模型加外部执行框架自动完成两类重复工作,输入是自然语言提问加录音或设计目标,输出是故障判断加时间区间或满足插入损失的单胞几何,难点在于框架中哪个部件真正决定成败以及技能与模型自主决策之间如何分工。故障检测一侧沿单个样本说明链路,立体声波形先经基元技能变成均方根值、频谱或包络等中间特征,再交给九个故障判别器对照阈值输出类型和起止时间,协调智能体负责分发任务并回收结果。超材料一侧把几何模板、网格划分和频域求解器封装成技能,智能体决定选用散射圆还是共振C形、调整晶格尺寸并在频带上反复评估插入损失。与只展示单个成功框架的已有声学智能体工作不同,本文固定其余条件逐个更换框架部件并重复运行,用对照说明部件贡献。在弱模型GPT 5.6 luna驱动的批量录音类型加定位任务008十次运行中,池化F1分数均值从无装备配置的0.14升至完整知识配置的0.80。结论只适用于本文合成录音和二维单模态模型范围,弱模型下框架优化无法弥补上限,提高推理量也不能纠正信息矛盾。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
40. 既要换声音又要抹掉身份信息:流式级联语音匿名系统解读
英文题目:Toward Complete Speaker Anonymization: a Streaming Cascaded System for Voice Privacy and PII Removal
评分:5.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Stanisław Kacprzak:机构信息未能在本次解析中与作者逐人可靠绑定
- Thomas Thebaud:机构信息未能在本次解析中与作者逐人可靠绑定
- Najim Dehak:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一段可能包含身份线索的语音,困难在于声音本身的音色韵律会暴露说话人,而说出的姓名、地址、日期等文字内容也会暴露身份,处理要求在延迟可接受的条件下同时改写声音和过滤文字。论文采用自动语音识别(Automatic Speech Recognition,ASR)把语音转成文字,个人标识信息(Personally Identifiable Information,PII)检测模块标记敏感词,再用文本到语音(Text-To-Speech,TTS)以新的参考音色合成语音。自动语音识别输出进入自然语言处理模块,过滤后文本进入语音合成模块,合成音频作为最终输出,三个模块按串行顺序连接。相对已有离线级联匿名系统和只做变声的语音转换系统,该系统的差异是选择可较快运行的组件并支持内容层过滤,向流式运行靠近。在 LibriSpeech 测试集上,匿名语音的字错率为 11.44%,半知情攻击者下的等错误率为 44.37%至45.25%,表明声音匿名接近已有离线级联水平但内容保留下降。结论适用于英文朗读语音和所测实体类型,流式识别错误下的敏感信息漏检仍是失败条件。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://elevenlabs.io/app/speech-synthesis/text-to-speech — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
41. 在人机交互噪声下用潜空间补偿减少语音情感识别的微调数据

英文题目:Improving the Dependency on Fine-Tuning Data in Transfer Learning for Speech Emotion Recognition
评分:5.7/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ricardo García:机构信息未能在本次解析中与作者逐人可靠绑定
- Rodrigo Mahu:机构信息未能在本次解析中与作者逐人可靠绑定
- Carlos Busso:机构信息未能在本次解析中与作者逐人可靠绑定
- Néstor Becerra Yoma:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音情感识别需从语音预测唤醒度、效价和支配度得分,室内人机交互中混响、加性噪声与声道变化造成训练与测试条件不一致,且目标场景可微调标注较少。方法先取Wav2vec 2.0卷积层输出的帧级表示,送入四层卷积自编码器编码为40维隐空间表示,以避免高维下特征最大似然线性回归求逆不稳定。接着在该隐空间用单高斯混合模型无监督估计仿射变换,对PR2机器人实录语音做旋转缩放和平移补偿,使其向仿真域靠拢;补偿后表示经解码器恢复维度,再送入变换器与回归头,且变换器与回归头需重训练以适应分布变化。训练侧同时用房间脉冲响应和加性噪声把MSP-Podcast训练集仿真为室内条件,形成仿真加适配的双向靠拢,这与单阶段域适应不同。与无补偿Wav2vec 2.0基线相比,在MSP-Podcast仿真训练、PR2机器人实录测试的情感回归评测下,用12.9%仿真数据微调时平均一致性相关系数相对提高16.8%。同基线同评测设置下,用50%仿真数据时平均一致性相关系数相对提高14.4%。用全部55283条时基线高2.9%但不显著,且不重训练变换器时性能低于基线,表明数据充足时自编码器信息损失会抵消增益。该结论目前只在上述室内采集配置和一致性相关系数指标下验证,其他噪声、距离与角度尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
42. 乐谱文件怎么比:用节奏树图做并行比对的 TSM diff
英文题目:TSM diff: A new Parallel-Tree-Traversal Algorithm for the Comparison of Music Score Files
评分:5.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.6/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xiaobo Wang:机构信息未能从 arXiv PDF 文本可靠映射
- Florent Jacquemard:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
比较对象是已经编码为 MusicXML 或 MEI 的数字乐谱,困难在于乐谱内容按小节、声部、拍子层级组织,直接比文本会丢失音乐时间结构。论文的处理过程是先把两份乐谱都转成树形乐谱模型(Tree Score Model,TSM),再对两个 TSM 做对齐与并行下降比较,输出差异列表、时间距离与表面距离,归一化后合成相似度。树形乐谱模型把整段音乐时间区间逐层划分,内部分支对应等分或特殊划分,叶子存放音高等基本事件,装饰音与附点等结构用分裂与共享节点表达。比较时先按小节用最长公共子序列(Longest Common Subsequence,LCS)跳过相同小节,再匹配小节内声部,然后递归同时走两个子图,标签分叉处停止并记录一次差异。时间距离累加存在差异的区间时值,表面距离用编辑距离比较与时间无关的记谱属性。与基于非结构化 Music21 数据流的 ScoreDiff 和 MusicDiff 相比,关键差异是用图结构显式编码时值,叶子不再需要时值属性。在爵士标准曲 All the Things You Are 的5位演奏者独奏转录的10组比较中,最小差异情形下 TSM-diff 报告差异数323个、相似度0.359、耗时1.26s,相比同一设置下 MusicDiff 差异数858个、耗时333.40s,差异数与耗时均更低。该结论适用于记谱版本管理与语料去重等比对任务,大规模语料与复杂记谱下的稳定性尚未验证;推理部署开销方面,核心比较耗时为1.7ms至28.3ms、平均约5ms,含Music21解析与TSM构建的总耗时至多约4.2s,原文未披露训练成本。
🔗 开源资源
第三方资源:https://tsm-diff-lbd-7a7e2a.gitlab.io — 链接可访问(HTTP 200)
第三方资源:https://tsm-diff-lbd-7a7e2a.gitlab.io/demo — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
43. 音频大模型能听出疼痛吗:从声音到语言推理的证据追踪

英文题目:Do Audio LLMs HEAR Pain? Tracing Acoustic Evidence from Speech to Language Reasoning
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Wenqi Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiangjue Dong:机构信息未能在本次解析中与作者逐人可靠绑定
- Sulaiman Vesal:Microsoft
📌 核心摘要
这篇论文研究大型音频语言模型(Large Audio Language Models,LALMs)能否从说话方式听出疼痛。输入是人在冷水压痛任务中朗读固定中性句的录音和口头说出疼痛分数的录音,输出是对有无疼痛和轻中重三档严重度的判断。难点在于中性句词汇固定时只能依靠响度、音高、频谱变化等副语言信息。论文提出 HEAR 四阶段诊断:先比较中性句与朗读评分两种条件下的行为差异,再用声学特征关联与分层探针定位信息存在的位置,接着用夸大后的声音对比测试模型能否分辨线索,最后把线索数值写成文字放回提示词观察推理是否恢复。相对已有词汇可解任务上的高分评测,该工作把同一说话人、同一疼痛状态下的词汇与声音证据解耦,并把编码、感知与使用分开检验。七个闭源与开源模型在中性句二分类上平衡准确率(balanced accuracy)均在 50.0% 附近,朗读评分条件可达 87.5% 至 99.7%,Qwen2.5-Omni-7B 首个编码器块探针二分类达 74.1%、三分类达 45.0%,文本化线索可让同说话人两选对比最高提升 32.2 个百分点。结论适用于实验诱发急性疼痛与受控朗读,慢性疼痛、自然对话与临床部署尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
44. 多人说话时只听目标人:SpeakerTurn 如何同时转写与判断轮次

英文题目:SpeakerTurn: Target-Speaker Semantic Turn Detection in Multi-Speaker Environments
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.9/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Nan Li:School of Computer and Information Engineering, Tianjin Normal University, Tianjin, China
- Hetao Shan:School of Computer and Information Engineering, Tianjin Normal University, Tianjin, China
- Jintao Liang:School of Artificial Intelligence, Tianjin University, Tianjin, China
- Jiahao Yan:School of Artificial Intelligence, Tianjin University, Tianjin, China
- Longbiao Wang:School of Artificial Intelligence, Tianjin University, Tianjin, China
- Tubin Huang:Shanghai Shenqijiyuan Intelligent Terminal Co., Ltd.
- Min Xu:Shanghai Shenqijiyuan Intelligent Terminal Co., Ltd.
📌 核心摘要
多人同时说话时,助手需要判断当前可听语音中哪些词属于指定用户,以及该用户的话语处于完成、未完成、应答性附和、要求等待还是目标缺席等状态,难点在于完整语句可能来自干扰人,而指定用户可能只说了半句。输入是目标说话人的注册录音与截止到当前时刻的混合语音,输出是目标转写文本加轮次状态,另有一个独立的打断判断任务。注册录音与混合语音先经过冻结的Data2Vec2声学编码器与线性投影层,转为语言模型可读的声学表征。该表征与任务指令一同进入Qwen3后端,仅用查询/值投影上的低秩适配参数联合生成目标转写与状态标签,使语义判断锚定到指定人的对应文本上。结构化思维链变体则先生成说话人存在、语义线索与助手上下文的中间小结,再基于该小结给出转写与决策,用于检验中间监督是否有帮助。在相同原始合成测试子集390条件下,无思维链模型的五状态宏平均F1为0.811,高于仅决策基线的0.805。在同源350条目标存在混合上,目标转写字符错误率从冻结模型的30.69%降至联合模型的4.20%,思维链版本进一步降至2.56%但五状态宏平均F1降至0.764。结果只在合成混合、已知截断与固定评测划分及单一种子配对训练下成立,不完整与附和易被误判为完成,附和召回从52%降至32%,在录制多人对话、噪声混响与连续端点检测上尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/linan2/SpeakerTurn — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
45. 先看客观证据再提问:可审计的分层合成问诊流程

英文题目:Auditable Hierarchical Inference with Multimodal Evidence and Bayesian Active Inquiry
评分:5.5/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Yucheng Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Everett X. Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一个只能看到客观检查结果的系统,它要先给出不确定的粗粒度判断,再决定依次追问哪些结构化问题。困难在于问题有代价和缺失,引导提问的知识本身可能出错,而粗判断正确不等于细判断正确。论文用合成舌象、双手多部位多压力多传感器脉冲张量与受控声学任务观测作为输入,用八个综合征家族与三十三个细综合征词作为两级输出。客观推断模块先把可用模态编码为八家族分布并给出共享症状因子预测,该分布与因子兼容度构成细词的初始信念。提问层用只在训练例上估计的答案似然做贝叶斯更新,并以负担惩罚的期望信息增益选择下一题,七道警示题只触发记录动作而不改变后验。相对已有主动特征获取与多轮问诊工作,差异在于把先验、答案模型、知识来源、安全防火墙和停止规则的权责分开冻结与测试。在600例一次性合成冻结确认中,代价敏感期望信息增益的家族准确率为95.5%与精确细term准确率为42.5%,分别高于同一确认中受试固定顺序实现的92.7%与33.0%,而同一确认中平均提问数以9.795高于固定顺序的9.352。结论适用范围限于该合成生成器与一次确认,细term似然行置换是最重的测试压力,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
46. 把高阶 Ambisonics 解码拆开:用插件加廉价单片机网络做空间音频重放
英文题目:Ambisonics: Introducing an Accessible, Distributed Approach
评分:5.3/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.5/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:后 50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Thomas A Rushton:机构信息未能从 arXiv PDF 文本可靠映射
- Romain Michon:机构信息未能从 arXiv PDF 文本可靠映射
- Tanguy Risset:机构信息未能从 arXiv PDF 文本可靠映射
- Clemens Wegener:机构信息未能从 arXiv PDF 文本可靠映射
- Pierre Lecomte:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
论文解决的具体问题是用低成本、可扩展方式实现高阶Ambisonics重放,传统集中式架构依赖多通道声卡和集中式数字信号处理硬件,通道数随阶数平方增长,三阶需要16通道、五阶bare-minimum需要36通道,且多设备采样时钟因晶振制造偏差而不一致,需要亚微秒级同步才能同步重放。输入是宿主软件中描述的虚拟声场,即若干单声道声源各自的方位角、仰角和随时间变化的波形,输出是分布在8个硬件模块上的16路扬声器信号,对应三阶16个球谐通道驱动16个扬声器的实例。处理过程分为插件在通用笔记本电脑上完成声场编码和解码系数分发、8个分布式Ambisonics模块各自承担2路扬声器的解码输出并经网络交换机传输编码声场和系数;与集中式架构的关键差异在于利用解码可并行性让各模块只需对应解码矩阵行的系数即可独立计算输出,省去多通道接口和高性能集中处理硬件。同步依靠电气与电子工程师协会1588精确时间协议(Institute of Electrical and Electronics Engineers 1588 Precision Time Protocol,IEEE 1588 PTP)加自适应时钟校正维持,插件通过用户数据报协议(User Datagram Protocol,UDP)组播发送带呈现时间戳的Ambisonics通道号(Ambisonics Channel Number,ACN)格式数据包。单模块硬件成本低于50欧元;原文未提供可核对的关键定量结果。声场合理性只经过初步试听,没有定量测量或受控评测。结论仅在三阶16扬声器、每模块2路输出、经单台边界时钟交换机组网的条件下得到验证,五阶36通道、最优重放所需的约50扬声器半球配置、菊花链交换机和每模块时分复用扩展至32通道等方式尚未验证,跨交换机可能引入数百纳秒延迟。系统配置需按IP地址手动分配模块与扬声器位置而较为繁琐,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://cleveraudio.org/ — 链接可访问(HTTP 200)
第三方资源:https://reaper.fm → https://www.reaper.fm/ — 链接可访问(HTTP 200)
第三方资源:https://inria.hal.science/hal-04169228 — 链接可访问(HTTP 200)
第三方资源:https://asa.scitation.org/doi/abs/10.1121/1.405852 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
47. 音频分类器隐层神经元在听什么:用符号声学概念解释 32 个神经元

英文题目:Bridging Neural Representations and Symbolic Semantics in Audio Classification
评分:5.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.5/1.5
排名:后 50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Avishek Das:机构信息未能在本次解析中与作者逐人可靠绑定
- Pascal Hitzler:Kansas State University;Manhattan, Kansas
📌 核心摘要
音频分类器能给出正确标签,但最后隐藏层单个神经元对何种声音模式反应强烈,基于波形片段或频谱高亮的输入归因方法回答不了。论文处理3秒音频段的音乐流派与乐器分类,输入数值声学信号、输出类别标签,难点是时频与音色线索分散,数值特征无法直接进入符号推理。第一步对每段提取57个数值声学特征并按训练集分位数阈值映射为高低两类符号标签,如响度高低、明亮晦暗,得到事实库供诱导使用。第二步用该57维特征训练多层感知机,取最后隐藏层32个神经元的测试集激活,按各自最大值比例划分正负样本集,输出的集合与符号标签一起送入概念诱导工具。该工具搜索能覆盖正例、排除反例的逻辑表达式,如Bright and not Rich,表达式对应的满足与不满足样本再到独立音频上对比激活强度。在流派任务每神经元各10个样本的标签确认检验中,以触发率为指标,neuron_22满足Noisy and Soft样本的正触发率为80%,高于不满足样本负触发率的0%,多数确认神经元负触发率仅为0%或10%。经Mann-Whitney U检验,流派9个确认神经元中7个在p<0.05下目标样本激活显著更强,而neuron_12等2个未通过,乐器10个中9个通过而neuron_17未通过,说明结论仅适用于所选5类GTZAN/FMA与5类IRMAS及该阈值化本体与多层感知机设置,未验证其他架构、更大验证集与专家可理解性;原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://anonymous.4open.science/r/xai_audio/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。