📄 把稠密反馈矩阵装进便宜的分级结构:反馈延迟网络的结构化剪枝
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
👥 作者与机构
- Facundo Franchino:机构信息未能在本次解析中与作者逐人可靠绑定
- Karolina Prawda:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
反馈延迟网络用N条延迟线和N×N反馈矩阵A在每次采样中交换能量,稠密正交矩阵混合充分但每样本实现代价高。论文输入为已训练好的稠密正交A及其延迟、增益和衰减,输出是由固定路由置换与小正交块交替级联构成的分级矩阵S,要求保持正交性并逼近原混响响应。处理先做矩阵拟合再做响应精修,前者用条件正交Procrustes更新逐层求解块得到初始参数,后者以对数谱距离直接优化完整FDN频率响应,拟合得到的结构化系数和固定路由直接用于向量化执行。与直接设计Householder、Hadamard或小规模可训练FDN的做法不同,该工作保留高阶稠密设计的声学自由度,只把实现投影到低成本结构。在Apple M2上N=256的反馈乘法计时比较中,以反馈乘法时间为指标,成对旋转结构为84.4 ns,低于同条件下基数-4结构的86.4 ns,以系数存储量为指标则为768个浮点数,也少于后者的2048个浮点数。模态激励分布与混合时间在已测系统上基本保持,但N≥128未做完整模态分解,基数-4在训练增益渲染下混合时间增加30–70 ms。结论适用边界是固定置换路由与分块执行,连续加深的结构族不保证嵌套与误差单调下降,联合拟合仍是局部优化,异构路由不能直接导出到该内核;正式听音仅用单一鼓循环片段且各阶参考不同,未确立感知等价性。运行时在内核中编码固定路由并存储预计算块系数,无需三角函数、稠密矩阵物化、动态分配或重正交化,完整混响器的加速还取决于延迟访问、衰减滤波与累加开销,计时仅覆盖反馈乘法而非完整回调。
🔗 开源与复现资源
- 第三方资源:https://github.com/cucuwritescode/fdn_pruning — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
混响要同时解决的三个要求是什么
反馈延迟网络的输入是单声道音频样点,输出是叠加了大量延迟回声的混响信号。系统内部有 N 条整数长度的延迟线,每条延迟线保存过去某时刻的信号状态,每采样一次,状态经衰减与反馈矩阵混合后再送回延迟线,输入输出增益决定每个模式被激起和拾取的多少。理想结果要同时保留 3 类信息:频谱上除预设的频率相关衰减外不引入额外染色,时间上回声尽快从离散变为稠密,部署时每采样的乘加与存储足够低。
论文把这三者画成 3 个相交的圆,无染色用模态标准差衡量,平滑用混合时间衡量,低成本用运算量或向量化执行衡量。稠密正交反馈矩阵容易满足前两者,但反馈乘法约为 2N 平方次标量运算、存储 N 平方个系数,在大 N 下太贵;直接减少延迟线数或使用过稀疏矩阵会降低成本,却容易让能量交换不充分,出现频谱染色与缓慢的回声建立。下面先看理想三元组的图示,理解为何需要一种先保住声学设计再降低实现成本的路线。
看图路径: 1. 先看三个圆分别标注的无染色、平滑与低成本及其度量;2. 再看中间问号表示三者难以同时满足;3. 注意稠密矩阵被放在无染色一侧并标注太慢
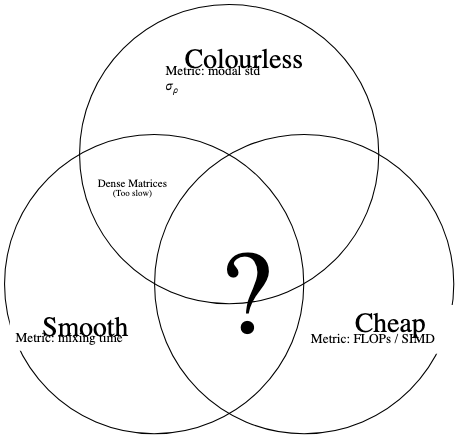
论文图 1。原论文 Figure 1::“The ideal FDN triad combines even modal excitation, a smooth temporal response, and low deployment cost.”。
该图确实显示 3 个分别标注无染色、平滑与便宜的圆在中心交叠并打出问号,稠密矩阵被放在无染色一侧并注明太慢。它帮助理解本文的问题定位:不是从小结构出发再调声音,而是从已调好的大稠密系统出发,寻找便宜且声音接近的实现。延迟线长度、输入输出增益与衰减在整个投影中保持固定,所有可听变化只来自反馈矩阵的替换。
已有高效反馈矩阵为何不能直接拿来用
在可微反馈延迟网络出现之前,已有 Householder、Hadamard、循环等特殊矩阵族,它们比随机正交矩阵便宜,但其频谱与时间特性依赖所选结构,换一种结构声音就变了,也有大稀疏矩阵的尝试。近期可微方法用矩阵指数保证正交性,直接对稠密矩阵优化频谱与时间目标,能得到染色少且混合快的稠密参考,但昂贵的稠密乘法会跟随模型进入每个部署目标。
另一条路线是直接优化小规模网络,参数少自然便宜,但在低阶下平滑无染色的混响更难获得且依赖精细选参。软件方面,FDNTB 及其 Python 后继提供网络构建与分析,ADAC 可把训练好的音频图编译为实时处理器,但编译保留训练好的精确结构,稠密矩阵的成本也被原样保留。
本文与 2 通道旋转、递归 Kronecker 构造等直接在结构化形式中设计矩阵的工作不同,它要拟合的是给定的稠密参考。比较的前提是相同的任务与运行阶段:都是在保持延迟与增益的完整混响器中替换反馈实现,而不是比较不同阶数或不同训练目标下的绝对音质。因此后文的加速与误差都是相对各自稠密参考的保持程度,不是跨论文的统一排名。
输入是什么,要输出什么,不能动什么
输入是一个已设计好的稠密正交反馈矩阵 A,以及与之配套的延迟线长度、输入输出增益与延迟相关衰减。目标是输出一组分级参数,使分级算子 S 在完整混响器中的响应接近稠密参考,同时反馈乘法可直接向量化执行,系数存储随 N 线性增长。约束是延迟、增益与衰减全程固定,S 必须保持正交,能量守恒与衰减控制仍可分离分析。
困难在于两点。第一,稀疏要加在因子上而非乘积上,乘积 S 本身不必稀疏,运行时也不显式形成 S,只依次执行各层的收集与小块混合,被路由排除的位置既不存系数也不做乘法。第二,小的矩阵误差在递归中共振处会被放大约放大的倍数取决于预解量,因此条目接近不等于听感接近,最终必须用完整频响与试听来选择深度与块大小。
分级反馈如何嵌入原来的混响通路
整体流程分两大段。先做矩阵拟合,用条件块更新与联合精修让 S 的条目接近 A;再做响应精修,用完整频响的对数谱损失微调全部块参数。两段都只改反馈块,延迟与增益不动。运行时把反馈乘法换成 L 层流水,每层先按固定置换收集状态,再对每个小组做小正交混合,下一层的输入就是上一层的输出。
下图把这种嵌入画得很直接,原来蓝色大矩阵 A 的位置被分级块代替,主通路的延迟、增益与直通完全不变。读图时重点看反馈回路的流向与分级阶段的执行顺序,这决定了后文的导出与内核写法。
看图路径: 1. 先沿输入经延迟线到输出的主路径看未改动部分;2. 再看蓝色反馈块内从右向左的分级阶段顺序;3. 确认乘积分级矩阵本身从不在音频通路中显式形成
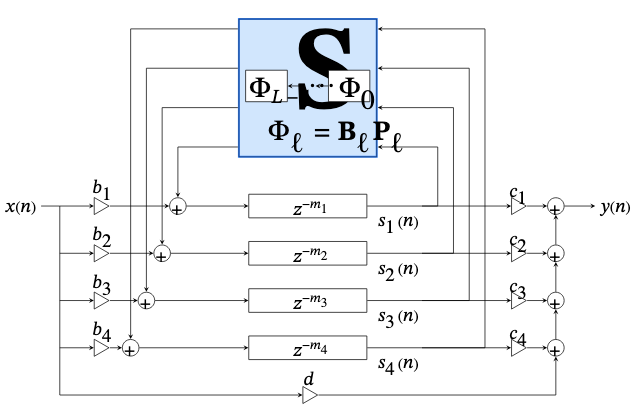
论文图 5。原论文 Figure 5::“The FDN of Fig. 2 with staged feedback.”。
该图确实显示四延迟线结构中蓝色块内标注各阶段与收集混合关系,输入输出增益与延迟线位置与原图一致,乘积 S 从不在音频通路中物化。它说明本文剪枝的含义是投影到受约束的算子族:路由固定为零的位置对任何旋转角度都为零,允许的位置系数随角度变化,拟合只在允许连接上调系数。
每层收集与混合具体做什么
分级近似由块大小 b 与层数 L 决定,b 整除通道数 N,每层有 Q 等于 N 除以 b 个独立块。第 l 层第 k 个块记为正交矩阵 W,收集函数把 N 个通道恰好枚举一次,分组 gather 后按块做小矩阵乘法并把每块的 b 个输出连续存放。从向量角度看,每层等于块对角矩阵乘以置换矩阵,从第一层依次作用到最后一层即得 S。
b 等于 2 时每块是平面旋转,只有一个角度参数,把状态的前后两半配对旋转,再交错存放以形成完美洗牌;b 等于 4 时每块从 4 个 1/4 处取数并连续输出,形成基 4 常几何数据流。论文证明只要收集是双射且每块正交,则每层正交,乘积 S 也正交。存储上两两旋转每层存 N 个浮点余弦正弦值,基 4 每层存 4N 个浮点系数,固定块大小与层数时随 N 线性增长。
反馈延迟网络 × 反馈矩阵: 反馈延迟网络指由多条延迟线经反馈矩阵相互馈送而产生长混响的递归结构,处理对象是每条延迟线的状态信号;反馈矩阵指每采样一次把各延迟线输出重新混合再送回输入的正交矩阵,它决定能量如何在延迟线之间交换,也决定每次采样的乘加量,二者搭配后,延迟线提供时间尺度和模式密度,反馈矩阵提供混合路径,组合起来才形成稠密平滑的晚期混响。
为什么路由方式决定能量能否散开
稀疏既是代数约束也是图约束。按本文信号流约定,每个延迟线是一个节点,矩阵非零元表示从输入状态到输出状态的耦合。把输入输出节点分开画成二部图,叉号表示路由允许的位置,空白表示对任何角度都固定为零的位置。角度为零的旋转只是直通,改变角度才在同一路由上混合,因此图描述的是拟合可用的连接,而非拟合后的数值。
独立的两两块会留下不连通的通道对,相邻旋转交替只能形成链式传播,能量要跨链扩散,回声建立慢。交错局部旋转与固定置换则让远端通道在下一层相遇,一个输入的路径按每层至多 b 倍扩大。对 2 的幂尺寸,常几何调度下 b 的 L 次方大于等于 N 是每个输出在结构上依赖每个输入的必要条件,引理给出每输出的结构可达输入数为 b 的 L 次方与 N 的较小值。但这只是结构路径,不保证数值非零,也不保证声学上已经混合。
先看 N 等于 8 的连通性示意,再理解为何运算量线性仍可能混合慢。
看图路径: 1. 对比子图 a 独立对子留下的不连通通道对;2. 看子图 b 相邻耦合形成的链式传播;3. 沿子图 c 从单个输入出发数每层可达输出数
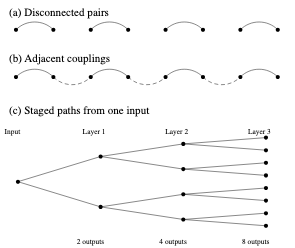
论文图 4。原论文 Figure 4::“Connectivity at N=8. (a) Independent rotations leave disconnected pairs.”。
该图确实分为三排,首排显示孤立弧段,第二排显示相邻耦合的波浪链,第三排从单个输入出发逐层扩展到 2、4、8 个输出。它直观解释了本文选用交错置换的原因:同样的层数下,固定路由能更快 widen 能量交换的覆盖面,而置换本身不增加乘法,可吸收到寻址或寄存器选择中。
分级矩阵 × 固定置换 × 正交块: 分级矩阵指不直接存稠密矩阵而按层依次做收集与混合的算子;固定置换指每层先把当前状态按固定地址重排,不含乘法也不拟合;正交块指每层内对每个小组独立做的小正交混合,其系数是拟合参数;三者分工是置换负责让远端通道在下一层相遇,块负责在相遇的通道间分配能量,多层串联后即使用稀疏因子也能让每个输出在结构上依赖全部输入。
两阶段投影如何从矩阵误差走到频响误差
矩阵拟合最小化 Frobenius 距离。由于 A 与 S 都是正交矩阵,平方误差可化为 2N 减去 2 倍迹,最小化误差等价于最大化迹。固定除第 l 层外的所有层,利用迹的循环不变性可把目标拆成每块独立的正交 Procrustes 问题,每块的最优解由对应小矩阵的奇异值分解给出,并可按行列式符号修正。对 b 等于 2 的情形,最优角有闭式反正切解,只需统计对角和与反对角差。
\[\|\mathbf{A}-\mathbf{S}\|_{F}^{2}=2N-2\tr(\mathbf{A}^{\top}\mathbf{S}).\]\[\mathbf{G}_{\ell}=\mathbf{P}_{\ell}\mathbf{M}_{<}\mathbf{A}^{\top}\mathbf{M}_{>},\qquad\tr(\mathbf{A}^{\top}\mathbf{S})=\sum_{k=0}^{Q-1}\tr(\mathbf{G}_{\ell k}\mathbf{W}_{\ell k}),\]\[\theta^{\star}=\operatorname{atan2}(G_{01}-G_{10},\;G_{00}+G_{11}).\]实现上用 15 到 20 个初始化,含一个由外向内的贪心与多个随机起点,每个候选做前后扫块更新,再选迹最优者做联合 L-BFGS 精修;b 等于 2 用角度坐标,b 等于 4 用围绕已拟合块的 Cayley 变换坐标,保证优化全程正交且行列式符号不变。扫块更新在精确算术下单调不减目标,但只保证目标值收敛,不保证块矩阵收敛,更不保证全局最优。
响应精修的动机是递归放大。记两种反馈下的预解量,频响差可写成输出向量经分级预解、矩阵差、衰减与稠密预解再到输入增益的双线性形式,共振附近预解可把小反馈扰动放大,因此声学阶段最小化 512 点均匀网格上的对数谱距离,用 Adam 以 5 乘 10 的负 3 次方学习率迭代 300 到 500 步,衰减系数取 0.999,Adam 单步不保证单调下降。深度 L 则按开发期非正式试听选各源与块大小下与稠密无明显可闻差异的最小值,它只是开发停止规则,正式评价另做。
\[H_{\mathbf{S}}(\omega)-H_{\mathbf{A}}(\omega)=\mathbf{c}^{\top}\mathbf{R}_{\mathbf{S}}(\mathbf{S}-\mathbf{A})\bm{\Gamma}\mathbf{R}_{\mathbf{A}}\mathbf{b},\]\[\operatorname{LSD}(\mathbf{A},\mathbf{S})=\left[\frac{1}{K}\sum_{k=1}^{K}\left(20\log_{10}\frac{|H_{\mathbf{A}}(\omega_{k})|}{|H_{\mathbf{S}}(\omega_{k})|}\right)^{2}\right]^{1/2},\]下图概括了 2 阶段的数据流,左侧输出初值,右侧经频响损失回传梯度得到终值。
看图路径: 1. 先看左侧矩阵拟合输出初始参数的实线箭头;2. 再看右侧经频响损失回传梯度的虚线回路;3. 注意延迟增益衰减在两阶段都保持固定
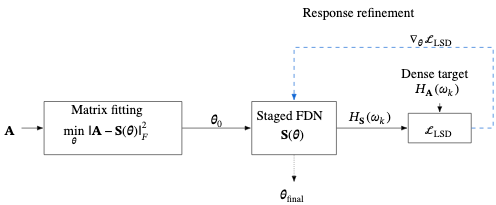
论文图 6。原论文 Figure 6::“Two-phase projection. Matrix fitting first approximates the entries of \mathbfA and supplies the initial parameters \bm\theta_0.”。
该图确实显示从矩阵拟合到分级系统的实线初值箭头,以及从损失经稠密目标与分级响应回到参数的虚线梯度回路,延迟增益衰减标注为固定。它帮助记住监督来源:第一阶段监督来自稠密矩阵条目,第二阶段监督来自完整频响幅度,梯度只更新分级块参数。
矩阵拟合 × 响应精修: 矩阵拟合指直接最小化分级矩阵与稠密矩阵之间条目误差的阶段,目标是让算子本身接近,为后续提供起点;响应精修指固定延迟、增益和衰减,只调分级块参数去拟合完整反馈延迟网络频响幅度的阶段,目标是让可听响应接近;前者解决初值与条件更新问题,后者解决递归系统中小矩阵误差被共振放大的问题,二者串联才把算子近似转化为混响近似。
在什么系统与度量下评价保持程度
评价对象是 7 个稠密源系统,N 取 4、8、16、32、64、128、256,每个源的训练矩阵先做极分解去除残余非正交性,响应拟合固定训练好的延迟与增益,衰减取 0.999,频点数 512,听感素材是另行渲染的加混响鼓循环。运行时机只测反馈乘法本身,不测完整回调,定时用 512 次调用分块计时再除以次数,并用内存破坏防止固定输入被提升,另报孤立调用的比较比。
度量分 4 类。反馈乘法时间与存储系数直接看部署成本;对数谱距离看采样频响的数值误差,越小越好,但不等于感知相似;模态激励分布的标准差看频谱均匀性,越小一般染色越少;混合时间看回声密度达阈的时间,它是回声密度阈值而非直接感知测量。
N 大于等于 128 因系统阶数太大未做全模态分解。听感采用在线类 MUSHRA 方法,以显式稠密参考为 100 分锚定相似度,另设低通锚点检验区分度,34 名参与者多为音频声学研究者与学生,均通过隐藏参考筛选。
模态激励分布 × 混合时间: 模态激励分布指各共振模式被输入输出增益激起的幅度是否均匀,论文用残差幅度的对数标准差衡量,越小一般频谱染色越少;混合时间指脉冲响应回声密度接近高斯噪声所需的时间,论文用分窗统计超过均方根的样本比例来估计;前者看频域均匀性,后者看时域从离散回声变为稠密混响的速度,二者互补,因为模态均匀仍可能伴随稀疏可闻回声。
反馈乘法快了多少,多存了多少系数
要回答的比较问题是:在相同 N 下,两两旋转与基 4 分级相对稠密向量乘法的反馈时间与系数存储如何权衡,测试硬件均为 Apple M2,时间只计反馈乘法。指标方向是时间越短越好,存储浮点数越少越好,加速比相对分块与孤立两种稠密计时协议分别给出。
| (a) Pairwise fits | ||||||
|---|---|---|---|---|---|---|
| NN | 8 | 16 | 32 | 64 | 128 | 256 |
| LL | 6 | 4 | 10 | 3 | 3 | 3 |
| LSD (dB) | 0.38 | 2.13 | 0.100 | 3.27 | 2.26 | 1.60 |
上表是成对拟合在 512 点拟合网格上的响应误差,N 从 8 到 256,层数与误差以分贝给出,可见 N 等于 32 的 10 层误差为 0.100 dB,而 N 等于 16 与 64 的浅层误差超过 2 dB,说明同为成对结构,保持程度随源与深度剧烈变化,不能只看平均趋势。
下表整理正文连续句中跨结构的运行与存储对比,重点看 N 等于 32、128、256 3 组。N 等于 32 时基 4 更深但更快,N 增大后两者时间接近而存储差距拉大,选择需同时看传递函数拟合,存储占优不等于声音更接近。
| 条件 | 反馈时间 | 系数存储 | 对比对象 |
|---|---|---|---|
| N=32,4 层基 4 | 18.9 ns | 512 个浮点 | 10 层成对 55.4 ns,320 个浮点 |
| N=128,3 层成对 | 44.4 ns | 384 个浮点 | 2 层基 4 的 42.0 ns,1024 个浮点 |
| N=256,3 层成对 | 84.4 ns | 768 个浮点 | 2 层基 4 的 86.4 ns,2048 个浮点 |
表中 N 等于 32 的最大差异显示基 4 以更多存储换来约 3 倍的时间下降,N 等于 128 与 256 则成对以相近时间实现数倍的存储压缩,相对稠密 N 平方系数分别压缩约 42.7 倍与 85.3 倍。限制是 N 等于 128 与 256 的基 4 行只报实现成本,其传递函数拟合另行讨论,且全部加速只针对反馈乘法,完整混响器的延迟访问与滤波开销未计入。
对数谱距离 × 听感相似度评分: 对数谱距离指在均匀频点上比较稠密与分级系统幅度响应的均方对数误差,衡量采样频响的数值接近程度;听感相似度评分指听众以稠密混响为参照对鼓循环混响版本打的相似分,衡量人是否听出差别;前者是可优化的代理目标,后者是最终感知检验,论文明确指出前者低不等于后者一定高,因此深度选择同时参考了试听。
频响与声学度量在多大程度上被保留
要回答的比较问题是:固定延迟增益衰减时,分级系统的采样频响、模态均匀性与回声密度是否接近各自稠密参考。对数谱距离越小越好,模态标准差越小一般越均匀,混合时间是阈值时间而非越小一定越好,关键是与参考的差是否小。
成对拟合的误差随 N 与层数起伏,N 等于 32 的 10 层可到 0.100 dB,而 N 等于 64 的 3 层达 3.27 dB,说明浅层不一定够用。基 4 在 N 为 16、32、64 的选中深度上误差低于对应成对结构,下表把正文报告的跨结构与精修收益放在一起。
| 条件 | 精修前或成对基线 | 精修后或基 4 结果 | 含义 |
|---|---|---|---|
| N=32,4 层基 4 相对 10 层成对 | 0.100 dB | 0.078 dB | 基 4 以更少层达到更低采样误差 |
| 选中基 4 结构经响应精修 | 精修前误差 | 降低 45–85% | 不增层与系数下的纯优化收益 |
表中收益支持响应精修的必要性,但论文同时给出反例:N 为 16 与 64 的更深层误差更低却因开发试听已选浅层而未采用,N 等于 32 的 3 层采样误差虽低却在试听中被拒,说明对数谱距离不能单独决定深度。模态与混合时间方面,成对投影在 5 个可算尺寸上模态 spread printed 精度下三处不变,最大变化在 N 等于 32 为 0.7 dB,混合时间差在负 20 ms 到正 50 ms 之间;基 4 在 16、32、64 上模态变化小于 0.7 dB,混合时间增加 30 到 70 ms。结论是两种结构都近似保留了所测度量,但只在所测系统与匹配协议下成立,未测 N 大于等于 128 的模态分解。
块变大与层加深分别带来什么代价
要回答的比较问题是:同样达到全结构覆盖时,块大小与层数如何影响运算量、执行时间与拟合质量。名义运算按文中约定计数,b 等于 2 按每层 3NL,较大块按 2bNL,费率用该计数除以实测时间,因此跨块比较的是实现效率而非纯算法优劣。
在 N 等于 256 的随机正交目标上,b 等于 2 用 8 层名义 6144 次运算耗时 202.5 ns,b 等于 4 用 4 层名义 8192 次运算耗时 152.9 ns,b 等于 16 用 2 层名义 16384 次运算耗时 262.6 ns,迹比分别为 0.219、0.270、0.392。大块矩阵拟合更好且每秒浮点更高,但总功更大,基 4 居中反而最快,说明只数运算会误判执行时间,数据搬运与寄存器复用同样重要。N 小于等于 64 时基 4 内核把状态常驻至多 16 个向量寄存器,收集与交错变为寄存器命名与片内转置,相对通用路径再快 1.3 到 1.7 倍。
深度方面,固定置换下逐层加深的族不必嵌套,更深不保证误差更小,最终以完整响应为准。未胜出项是 b 等于 16 的两层:拟合最好但最慢,若只看矩阵迹会选错实现。尚未评测的是混合块与非 Apple M2 处理器,论文明确把这部分留作后续。
哪些结论不能从当前证据推出
正式听感覆盖 N 为 16、32、64、128,每个尺寸含一个成对与多个基 4 候选及低通锚点,成对深度分别为 4、10、3、3。分级候选均值在 N 为 16、32 时为 94.09 到 94.97,在 N 为 64、128 时为 98.79 到 99.29,参与者间标准差 0.64 到 1.80 分,选中基 4 在 16、32、64 分别为 94.46、94.09、99.07,选中成对在 128 为 99.06,锚点均值仅 2.22 到 5.26。候选在 16、32 比隐藏参考低约一到 2 分,在 64 均近顶部,加层未一致提升评分。
| 条件 | 分级候选均值范围 | 选中结构均值 | 限制 |
|---|---|---|---|
| N=16,32 鼓循环相似度 | 94.09–94.97 分 | 94.46 分,94.09 分 | 单一摘录,每阶稠密参考不同 |
| N=64,128 鼓循环相似度 | 98.79–99.29 分 | 99.07 分,99.06 分 | N=128 无计分隐藏参考 |
上表说明被测高阶配置接近量表顶端,但论文明确指出这不分离网络尺寸效应,也不构成感知等价证明。测试还有遗漏:N 为 16、64 各缺两场呈现,N 为 32、128 各缺一场,N 等于 128 无计分隐藏参考,年龄未记录,设备与环境为参与者自备。数值校验上双精度正交残差与结构化相对稠密应用误差小于 10 的负 12 次方,单精度基 4 内核在多配置多种子向量下满足 10 的负 4 次方容差,但这只证明实现正确,不证明任意音乐素材下无差异。
复现第一步要固定什么,代码现状如何
复现第一步不是重训混响,而是拿到论文的 7 个稠密源系统并固定其延迟、增益与衰减,然后按块大小与层数实现固定收集与小块混合的前向,再跑由外向内贪心加随机重启的扫块更新,最后用对数谱损失做响应精修。关键超参数是收集置换、b、L、拟合网格 512 点、衰减 0.999、Adam 学习率 5 乘 10 的负 3 次方与 300 到 500 步,以及双精度重评分。通道重标记需同步重标延迟增益衰减以保持传递函数不变,异构路由不能直接导出到当前内核。
论文称投影代码、源矩阵、内核、基准与完整听感分析拟随文章经项目仓库发布,文中给出仓库链接。按本次收到的来源校验,该链接当前不可用,状态为 404,因此不能写作者资源已公开或可运行,只能说论文意图经该仓库发布,实际获取需等待作者更新。第三方镜像只证明论文提到该链接,不证明已开源。复现还需补的验证是完整回调计时与更多素材、更多听众下的感知复测,因为当前加速与相似度都只在反馈乘法与鼓循环条件下测得。
什么时候值得尝试,还缺哪项验证
当已有大稠密反馈延迟网络声音满意但反馈乘法太贵,且能接受固定延迟增益衰减时,值得尝试这种先声学后实现的投影。N 为 16 到 64 可优先试基 4 的选中深度,N 为 128 到 256 若更在意存储可优先试 3 层成对,但都要用自己的延迟增益与衰减重做响应精修与试听,不能直接套用论文的层数与误差。
复现第一步是锁定稠密参考与评价网格,原样实现收集与块混合,再对比反馈时间、存储、对数谱距离、模态分布与混合时间。还需要补的验证包括其他处理器与完整实时回调的成本、混合块与新路由的设计、响应误差随 N、b、L 的界,以及更多乐句与响度下的盲听。只有这些补齐后,才能判断该分级实现在目标产品中是否真正同时逼近无染色、平滑与低成本。
📎 论文与评分元数据
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses