📄 在没有神经加速器的微控制器上跑 65.7M 参数流式语音识别
评分:7.1/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
👥 作者与机构
- Billal Boumedine:Faculty of Computer Science, University of Science and Technology Houari Boumediene (USTHB);Algiers, Algeria
📌 核心摘要
读者需要理解的对象是在只有 32 MB 片外存储、主频 400 MHz 的微控制器上做开放词汇连续语音识别,困难是模型远大于闪存且算力不足以支撑浮点胶水代码。论文输入是 16 kHz 麦克风音频经 80 维对数梅尔特征切成的 1.28 秒块,输出是随音频流逐步确认的词序列。处理先按矩阵敏感度把编码器 290 个矩阵分配为每权重 2 位或 4 位,再逐矩阵校正回原始输出并用 GPTQ 舍入到哈达玛旋转后的 Lloyd-Max 等级中。接着把激活固定为矩阵间 int16、矩阵输入 int8,乘积用整数 Hadamard 变换加动态移位完成,搜索用波束为 4 的改进束搜索加词组偏置输出最终文本。相对已有微控制器命令词或 13M 参数 CTC 方案,差异是五倍大的换能器仍保持流式和低于实时。与已发布 int8 模型相比,LibriSpeech 测试集干净子集词错率从 3.94% 变为 4.34%,每 1.28 秒块在双核上引擎耗时 0.75 秒、带屏实时固件约 0.90 秒。结论适用于英语朗读和提示语音,未验证噪声、远场和会话语音,作者未测量能耗。
🔗 开源与复现资源
第三方资源:https://github.com/BoumedineBillal/esp32-pie-asr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/BoumedineBillal/esp32-pie-asr-kroko-en — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
要解决的输入输出与实时约束是什么
任务的输入是麦克风以 16 kHz 采样的连续英文语音,目标是流式写出任意词汇的文字,而不是从固定命令表里二选一。系统每次取 1.28 秒音频,对应 128 帧 80 维对数梅尔特征,加上前端上下文实际进入 141 帧,编码器输出 32 帧 25 Hz 表示,再由解码器与 joiner 逐帧产生词元。必须保留的信息是跨块的声学上下文与卷积缓存,论文让每个堆栈保留 5.12 秒左侧历史,且流状态大小不随时间增长。输出除了文字,还包括词何时最终确定,论文中位延迟约 1.9 到 2.3 秒,95% 词在 4.1 秒内最终确定。
硬件约束是 ESP32-P4 只有两颗 400 MHz RISC-V 核心、128 位 SIMD 扩展 PIE 和 32 MB PSRAM,没有神经加速器,片内只有 768 KB,开发板另有 16 MB 闪存。65.7M 参数的 Kroko 模型即使按 int8 也有 71 MB,放不进闪存与内存。Oído 此前在 ESP32-S3 上用 13M 参数模型做到 1.97 倍音频时长,还不是实时。本文要同时解决装得下与算得完:权重降到 26.65 MB 并放在 PSRAM 原地使用,每块 1.28 秒音频在 0.90 秒内处理完,含波束搜索。
已有小模型路线为何不能直接套用
小语音识别有两条路线。Whisper tiny.en 约 37.8M 参数与 Moonshine Tiny 约 27.1M 参数属于编码器加解码器结构,1 次转写整段,Moonshine 考虑了随输入长度扩展的直播场景。另一条是流式 transducer,随音频到达逐词元输出,k2 项目的 Zipformer 系列用剪枝 transducer 损失训练,sherpa-onnx 能在 CPU 上运行,Kroko 属于这一家族。输入、目标与运行阶段不同,整段模型的精度不能直接当成流式模型的精度。
微控制器上的语音此前多是固定命令词,如 ESP-SR 的 MultiNet 最多识别 200 条命令。最接近的是 Oído,把 13M 参数 Conformer-CTC 以 int8 权重与 int8 动态激活跑在单核 240 MHz Xtensa 上,整句贪心为 3.70% 与 8.23%,流式加语言模型为 4.86% 与 11.03%。本文模型大 5 倍、芯片不同、且只有流式模式,比较时要注明芯片、参数量、是否流式与是否带语言模型。
权重量化方面,GPTQ 逐列舍入并把误差分散到未舍入列,QuIP#与 QuaRot 用 Hadamard 旋转打散离群值,Cactus Quants 把每 128 个一组的 Hadamard 旋转与 Lloyd-Max 等级加每组一个 float16 范数组合。本文存储沿用该布局,贡献在于如何舍入进去。训练中量化已有 4 比特乃至 2 比特无损的报道,但本文不做重训练,属于训练后量化,且大部分权重在 2 比特并真正上板。
Kroko 模型与芯片各有什么具体负担
Kroko 是 icefall 的 Zipformer2 transducer 中等配置,65.7M 参数,650 个 BPE 词元,无状态解码器只看最近两个词元加分组卷积。编码器有卷积前端与 6 个堆栈共 16 层,帧率呈 U 形,前端 50 Hz,中间最低到 6.25 Hz 再回到 25 Hz。每层有 3 个前馈模块、非线性注意力、共享注意力权重计算的两个自注意力、两个卷积模块与两个可学习旁路。流式无前视,每块固定输出 32 帧。
下表给出各堆栈的层数、宽度、帧率与最终 4 比特占比,可以看到参数高度集中在中间堆栈,而靠近输出的堆栈对精度更敏感,这是后文按矩阵分配位宽的依据。
| Stack | Layers | Width | Rate (Hz) | Matrix params | At 4 bits |
|---|---|---|---|---|---|
| 0 | 2 | 192 | 50 | 2.02M | 69.5 % |
| 2 | 3 | 384 | 12.5 | 11.60M | 18.4 % |
| 4 | 3 | 384 | 12.5 | 11.60M | 100 % |
| 5 | 2 | 256 | 25 | 3.78M | 100 % |
该表说明参数分布极不均匀:堆栈 3 有 30.22M 矩阵参数却只有 13.8% 放在 4 比特,而堆栈 4 与 5 全部放在 4 比特。这种非均匀分配不是事先规定,而是按每矩阵灵敏度与每字节收益排出来的。限制是该结论只在 Kroko 与本文校准集上成立,换模型需要重测,不能直接照搬比例。
整体流程如何把音频变成屏幕上的词
链路从麦克风开始,先算 100 Hz 的 80 维对数梅尔特征,经前端到 50 Hz,再进入 6 个堆栈的 U 形帧率处理,最后编码器以 25 Hz 输出。编码器权重为 2 与 4 比特混合,激活在矩阵之间为 int16、进入乘积前为 int8。解码器与 joiner 保持 int8,波束搜索加短语偏置后把词显示到 1024×600 屏幕。权重因放不进 16 MB 闪存,开机时从 microSD 卡以约 9.3 MB 每秒读入 PSRAM,耗时 2.87 秒另加 1.2 秒初始化。
先看芯片上的管线图,理解帧率升降与左右上下文如何衔接,再看各模块在哪里汇合,这是理解后文分块与缓存的关键。
看图路径: 1. 先从左下麦克风经 80 维对数梅尔特征到前端,确认帧率变化;2. 再沿 0 到 5 六个堆栈的 U 形帧率看下采样与回升;3. 最后看编码器到解码器加 joiner 再到波束搜索与屏幕的输出路径
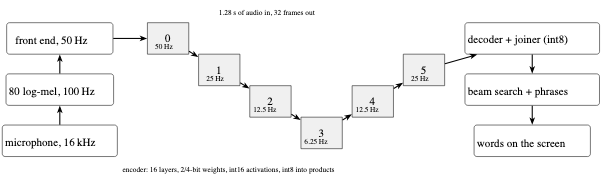
论文图 1。原论文 Figure 1::“The pipeline on the chip. The six encoder stacks run at the frame rates shown, each with 5.12 s of left context.”。
图中可见前端 50 Hz 之后堆栈 0 仍 50 Hz,堆栈 1 降到 25 Hz,堆栈 2 到 12.5 Hz,堆栈 3 最低 6.25 Hz,再经堆栈 4 回到 12.5 Hz、堆栈 5 回到 25 Hz,每堆栈标注 5.12 秒左上下文。编码器下方注明 16 层、2 与 4 比特权重、int16 激活、进入乘积为 int8。右侧解码器与 joiner 为 int8,其后是波束搜索加短语与屏幕显示。该图只表示数据流向与帧率,不表示各堆栈的参数量与耗时,耗时见后文速度分解。
Zipformer2 编码器 × transducer 解码器与 joiner: Zipformer2 编码器负责把声学帧变成高层表示,transducer 的无状态解码器负责记住最近两个词元,joiner 负责把声学表示和文本历史合并打分;三者分工是声学建模、文本记忆与对齐合并,组合后才能在音频到达时逐帧输出词元。
2 与 4 比特权重格式存了什么
编码路径共 290 个矩阵 63.72M 参数。每个矩阵按行切成每组 128 个权重,宽度不是 128 倍数的少数用 64、32 或 16。组内向量先做正交 Sylvester-Hadamard 旋转,旋转后条目接近高斯,论文测得峰度 2.97,高斯为 3,因此可用为标准高斯设计的 Lloyd-Max 等级。每组存一个 float16 范数与每个权重 2 或 4 比特等级索引,每权重成本为比特数加 16 除以 128,即 2.125 或 4.125 比特。范数初值为该组欧氏范数,使归一化后方差为 1。
具体存法是旋转域量化公式,符号含义是组范数除以根号组长再乘以等级值,最后逆旋转回原域。
\[\hat{u}_{k}=\frac{\nu}{\sqrt{G}}\,\ell_{c_{k}},\qquad\hat{w}=H_{G}\,\hat{u},\]计算时输入每组只需旋转 1 次,供该组所有输出行共享。输出是各组加权和,含组范数、等级与旋转后输入的内积。
\[y_{o}=\sum_{g}\frac{\nu_{o,g}}{\sqrt{G}}\sum_{k}\ell_{c_{o,g,k}}\,(H_{G}\,x_{g})_{k}.\]该式的关键是旋转只做在输入侧 1 次,解码侧只需查表得到等级对应的 int8 值,再乘累加。论文用手写 PIE 核实现,解码 2048 个 2 比特权重约 851 周期,16 行乘一组每帧约 168 周期。Lloyd-Max 等级间隔不均匀,不能用移位展开,必须用聚集加载查表,这是解码核单独存在的原因。
Hadamard 旋转 × Lloyd-Max 量化等级: Hadamard 旋转把每组权重分散成近似高斯分布,Lloyd-Max 量化等级是为标准高斯设计的最优分层;前者解决权重离群值难量化的问题,后者提供分层位置,两者搭配才让 2 比特存储能直接套用高斯等级。
每个矩阵分多少比特又如何舍入
位宽先按灵敏度定。对每个矩阵单独做 2 比特与 4 比特舍入、其余保持原样,测编码器输出相对误差,即误差能量除以原输出能量。
\[e=\frac{\sum\lVert\hat{y}-y\rVert^{2}}{\sum\lVert y\rVert^{2}},\]统计来自 FLEURS 英文训练音频的校准帧,不用转写文本。初始全部 2 比特、小矩阵 42 个直接 4 比特,再按每字节挽回误差从大到小把矩阵升到 4 比特,直到 25 MB 预算。结果 193 个矩阵在 4 比特,共 25.35M 参数,其余 38.37M 在 2 比特。输出端堆栈 4、5 全部 4 比特,参数最多的堆栈 3 仅 13.8% 在 4 比特,单矩阵最敏感的是首层自注意力的输入投影。
舍入按前向顺序逐矩阵进行,当前矩阵看到的是已部分量化的模型的输入。先做朝向原模型的校正,用最小二乘从新输入复现原输出,含阻尼项。
\[W^{*}=W+W\,(C-S)\,(S+\lambda I)^{-1},\qquad\lambda=0.01\cdot\overline{\operatorname{diag}(S)}.\]其中 S 是新输入 2 阶矩,C 是原输入与新输入互相关,上游未变时退化为原矩阵。然后在旋转域按对角加权从 0.70 到 1.15 共 10 个范数里选每组范数,再固定范数做 GPTQ 逐列舍入,用 S 逆的 Cholesky 因子把误差补偿到右侧未舍入列。整层一起校正会重复计算上游误差,论文试过误差从 0.034 升到 0.33,因此必须逐矩阵。
GPTQ 逐列舍入 × 朝向原模型的校正: 朝向原模型的校正先用最小二乘把当前矩阵拉回原输出,GPTQ 再逐列舍入并把误差补偿到尚未舍入的列;前者处理上游已量化带来的输入漂移,后者处理本矩阵自身的舍入误差,两步串联才避免误差逐层放大。
没有训练时校准与整数设计实际算了什么
本文没有重训练,所谓训练节实际是校准与仿真选择过程。校准用 512 段共 87 分钟 FLEURS 英文训练音频,固定随机种子排序,每 6 段一批按长度排序,填充帧不计统计。另留随后 24 段测编码器误差。灵敏度约 12 分钟,舍入约 25 分钟,在 RTX 4060 8 GB 笔记本 GPU 上完成。用前 2 小时、说话人较少的音频校准反而更差,说明说话人多样性重要。
解码器嵌入与投影、joiner 输出层保持原 int8,单独压到 4 比特会让作者录音从 10.1% 升到 16.6%。其余偏置、归一化、深度卷积、门与旁路系数共 1.1M 参数存 float16。
下表是 microSD 卡上 26.65 MB 文件的构成,说明容量主要花在编码器矩阵上,比较问题是不同精度各占多少参数与总文件多大。
| Part | Parameters |
|---|---|
| 4 bits: 193 encoder-path matrices | 25.35M |
| 2 bits: the other 97 | 38.37M |
| float16: biases, norms, depthwise convolutions, gates | 1.1M |
| int8 (as released): decoder and joiner output | 0.9M |
| File on the microSD card | 26.65 MB |
该表表明 4 比特 193 个矩阵占 25.35M 参数,2 比特 97 个占 38.37M,另有小张量与解码器部分。限制是转换代码未开源,只能按算法重实现;文件比归档大 0.42 MB 的差异来自封装,比较大小时要注明是哪个文件。
整数设计先在 GPU 仿真器里选格式,有 1116 个可取 float、int8 或 int16 的位置。乘积把 int16 输入组用未归一化 Hadamard 变换在 int32 里精确旋转,每帧每组取最大幅度做 2 的幂移位到 int8,PIE 1 次算 16 行,读出时用寄存器移位恢复动态范围,静态范围会让信噪比从 37.8 dB 掉到 26.1 dB。层间激活用 int16 静态范围,非线性用表,查询键值、注意力权重与缓存用 int8,卷积缓存留 int16,流状态约 815,000 个数,int8 下 0.8 MB。
矩阵间 int16 激活 × 矩阵内 int8 输入: 矩阵间 int16 激活保留层与层之间传递的精度,矩阵内 int8 输入满足 PIE 乘累指令的数据宽度;前者解决非线性与残差累积误差问题,后者解决硬件吞吐问题,组合后乘积用 int8 算、层间用 int16 传。
引擎与评测如何保证板上精度可测
引擎是 C 加汇编 PIE 核,含解码、瓦片乘、基 8 Hadamard、移位量化、读出与残差、BiasNorm 平方和、深度卷积与门控等核,每核旁有 C 参考。双核分工是输入帧各量化一半,再按输出行块分瓦片,各写各的输出。双核相对单核编码器快 1.58 倍而非 2 倍,因共享内存使解码慢 60%、乘累加慢 33%。权重在 PSRAM 原地按序读 1 次,L2 配 256 KB 128 字节行并开自动预取,约 20 KB 热代码放片内 RAM。
PC 构建与芯片比特精确一致靠 3 条规则:超越函数只用加减乘除的基本头文件重写,避免 glibc 与 newlib 末位差异;两侧都关浮点乘加融合;每核有相同舍入的 C 参考且双核不写同一输出。校验包括 22 个核测试、8 段直播链路每块编码器 CRC 与最终文本、140 段短语偏置词元,以及计时中 11 种配置全跑的 CRC。全匹配后,论文用 PC 构建跑 2620 与 2939 段整集,笔记本 16 进程约 15 分钟,而芯片按 0.7 倍实时需约 4 小时。
搜索是 k2 改进波束搜索,每帧至多一词元,相同词元假设合并,结束长度归一。单假设与贪心逐比特一致,波束 4 在 test-clean 从 4.52% 到 4.34% 约少 100 词错,每块多 138 毫秒,波束 8 仅到 4.30% 不值得。词提交规则是全假设一致即提交,75 帧仍开放则按最优提交并丢弃分歧,词在下词开始或 0.5 秒无词元后最终确定,1.5 秒停顿换行。短语偏置把列表编成词元 trie,每词元加 2.0 分,中断扣分、完成保留,口语形再改写为书面形。
波束搜索 × 短语偏置: 波束搜索保留多个假设并在分叉一致时提交词元,短语偏置给走在给定词表 trie 上的假设加分;前者解决贪心易丢词的问题,后者解决特定人名术语难识别的问题,组合后是在搜索过程中实时加权而不是后处理改写。
整集词错率与速度在什么条件下成立
主结果用 Whisper 英文文本归一器在完整测试集上测得,发布模型用 sherpa-onnx 1.13.8 流式同波束运行,每段后补 2 秒静音以免丢尾词,否则对基线不公平。不用归一器时本文 test-clean 贪心 4.78%、波束 4.61%。下表比较本文芯片流水线与发布模型在相同测试集、相同归一与波束下的词错率,差距为本文减发布模型。
| Set | Clips | greedy | beam 4 | beam 4 | Gap, beam 4 |
|---|---|---|---|---|---|
| LibriSpeech test-clean | 2620 | 4.52 | 4.34 | 3.94 | +0.40 |
| LibriSpeech test-other | 2939 | 10.89 | 10.26 | 9.17 | +1.09 |
| FLEURS English (US) test | 647 | 17.75 | 15.95 | 13.68 | +2.26 [1.63, 2.95] |
| Common Voice 17.0 English test | 1000 | 20.72 | 19.56 | 18.47 | +1.09 [0.50, 1.69] |
| FLEURS, scaled to peak 0.5 | 647 | 11.42 | 10.97 | 9.99 | +0.97 [0.68, 1.28] |
表中 test-clean 本文波束 4 为 4.34%,发布为 3.94%,差距 0.40 个百分点;test-other 为 10.26% 对 9.17%,差距 1.09。FLEURS 与 Common Voice 上双方都高 3 到 5 倍,差距扩大到 2.26 与 1.09,且自助法区间不含零。FLEURS 经缩放到峰值 0.5 后差距回到 0.97,约 10% 相对量,与 LibriSpeech 比例相近。结论成立条件是英文朗读或提示语音、无附加噪声、同归一器同波束同填充,噪声与远场对话未测。
速度在单固件内用运行时开关重测,每配置同两段共 13 块各跑 3 次,共 9 次均值,标准差至多 0.5 毫秒。从首版设计到发布设计编码器快 1.68 倍,整块从 0.92 倍实时到 0.59 倍,整数乘积占增益的 63%。直播固件因界面与屏幕刷新更慢,每块 895.8 毫秒约 0.70 倍实时,3.1 分钟麦克风实测均值 904 毫秒、最大 935 毫秒,无丢音频且内存恒定。
先看每块时间分解图,明确前端与各模块的占比,再理解为何前端是下一步优化点,该图比较首版、单核与双核三行的耗时构成。
看图路径: 1. 比较三根横条总长,确认双核发布设计相对首版与单核的缩短;2. 看蓝色前端段在三根条带中的占比,确认未优化部分的体量;3. 看橙色前馈与黄色注意力段随设计变化的收缩情况
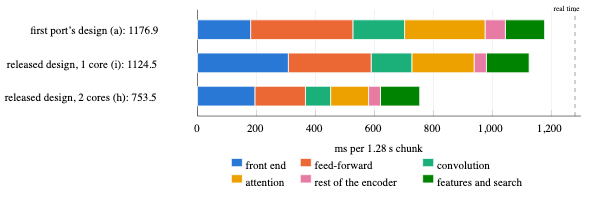
论文图 2。原论文 Figure 2::“Where a chunk’s time goes on the P4X, in ms (rows a, i and h of Table 7; core 0’s wall time per part; the totals are in the row labels).”。
图中 3 条从上到下为首版设计 1176.9 毫秒、发布设计单核 1124.5 毫秒与双核 753.5 毫秒,横轴为每 1.28 秒块的毫秒数。蓝色前端在首版约占 150 毫秒以上且在双核版仍近 200 毫秒,橙色前馈最大,黄色注意力、青色卷积、粉色编码器其余与深绿特征加搜索依次排列。可见 2 与 4 比特乘积已计入各模块内,占编码器约 339 毫秒即 55%,核 0 等待核 1 约 25 毫秒。该图只反映 P4X 双核除特别注明外的核心 0 墙钟,不能推广到其他芯片或单核时长。
真实录音上多出的错误来自哪里
FLEURS 英文美国测试 647 段 1.77 小时与 Common Voice 17 英文测试抽 1000 段 1.65 小时均为朗读或提示语音、无加噪,校准用 FLEURS 训练集而非测试集。GPU 仿真器用发布权重能复现 sherpa-onnx 贪心结果,用 2 与 4 比特权重加 float 激活即得到 17.78% 与 20.94%,芯片整数激活为 17.75% 与 20.72%,说明差距全部来自权重,整数运算没有增加。
FLEURS 差距大有明确原因:343 段峰值低于满刻度 0.01 即负 40 dBFS,中位 RMS 为负 60 dBFS。极安静输入下双方都丢句首,本文贪心丢首词占参考词 12.8%,发布为 9.2%。缩放到峰值 0.5 后首词删除从本文 1042 词降到 51 词、发布从 725 降到 17 词,双方各降 3.7 到 6.3 个百分点。板上由麦克风增益定电平,影响小于录音文件,但灵敏度真实存在。
Common Voice 电平正常,多出的错误仍多在句首,本文比发布多丢首词的段有 93 段、反过来仅 10 段,加 1 秒前置静音不改变结果,排除冷启动,原因未找到。波束 4 对本文帮助更大,在该集挽回 1.16 个百分点而发布仅 0.37。人名类词双方都难,42% 到 47% 错误,这是 Kroko 本身弱点而非移植引入。
舍入的每一步各挽回了多少
消融在全部 2620 段 test-clean 共 53029 词上做,GPU 仿真器 float 激活加贪心,发布文件在该条件下为 4.53%,芯片整数为 4.52%,两者一致。误差列是 24 段留出 FLEURS 上的编码器相对误差。下表比较同一 25 MB 位宽计划下逐步加入校正与舍入方法时的误差与词错率,回答每一步值多少。
| Variant | 4-bit matrices | Size (MB) | Error ee | WER |
|---|---|---|---|---|
| Round to nearest, all at 4 bits | 290 | 36.67 | 0.0136 | 4.58 % |
| Round to nearest, all at 2 bits (small ones at 4) | 42 | 20.84 | 0.2194 | 21.76 % |
| Round to nearest, the 25 MB plan | 193 | 27.07 | 0.0445 | 8.83 % |
| + GPTQ, 128 clips | 193 | 27.07 | 0.0163 | 4.75 % |
| + correction toward the original | 193 | 27.07 | 0.0128 | 4.68 % |
| + norm search | 193 | 27.07 | 0.0124 | 4.50 % |
| + 512 clips: the published file | 193 | 27.07 | 0.0090 | 4.53 % |
| Full method, all at 2 bits (small ones at 4) | 42 | 20.84 | 0.0557 | 13.40 % |
该表说明直接最近舍入在 25 MB 计划上达 8.83%,GPTQ 单独修到 4.75%,朝向原模型校正到 4.68%,范数搜索到 4.50%,甚至略好于全部 4 比特最近舍入的 4.58% 而文件小 36%。512 段相对 128 段把编码器误差从 0.0124 降到 0.0090,但词错率 4.53% 对 4.50% 差 16 词,在约正负 30 词的运行噪声内。编码器误差从 0.22 到 0.016 能正确排序,0.009 到 0.014 之间四档都在 4.50% 到 4.68% 内无法分辨,开发中低于 0.01 后词错率即不动。全大矩阵 2 比特时从 21.76% 修到 13.40%,但仍不可用,多花的 6.2 MB 4 比特才是保住半个点的关键。限制是该消融用贪心与 float 激活,波束与整数下的分量贡献需另看正文速度与精度表。
哪些结论不能推广与尚未验证什么
能量与功耗没有测量,作者说明无仪器。系统仅英文,测试集均为朗读或提示语音加文本转语音短语集,噪声、远场与对话未测,作者两段噪声录音上双方均为 43% 错误,鲁棒性问题属于模型本身而非移植。精度数字来自 PC 构建,比特精确只在 48 段 LibriSpeech、全核测试与 140 段短语上校验过整机 CRC,不是整集上板跑出来的。
权重代价在 test-clean 半个点、test-other 与 Common Voice 约 1 个点、FLEURS 原文 2.26 点,且对极安静输入更敏感、丢首词更多,Common Voice 上原因未明。固件需 P4X 即 revision v3 与 32 MB PSRAM,权重需 microSD 卡,内部 RAM 发布版仅余 121 KB,调试版 73 KB。方法只在一个模型上调通,同样设置能否迁移到其他模型未证。向 16 MB 的尝试止于 19.63 MB 与 5.63%,12 小时音频的量化感知训练在可比处未胜过训练后舍入,短语偏置在 140 段文本转语音上 46 比 0 写对但有 3 次误报,LibriSpeech 上加同列表从 4.34% 微升到 4.37%。
复现第一步做什么与资源如何获取
复现先分清三件事:引擎与固件、权重文件、转换代码。论文称引擎、固件、评测脚本与 LibriSpeech 转写在 GitHub 仓库以 Apache-2.0 提供,权重在 Hugging Face 以 CC-BY-SA 4.0 提供,与 Kroko 授权一致,但转换代码不在发布内,需按第 4 节与算法 1 重实现。本次收到的第三方链接经检查当前可达,但这只证明链接提到可达,不证明作者已开源,是否可用以仓库实际内容为准。
第一步建议在 PC 上先跑通构建的比特精确链:用发布 2 与 4 比特权重跑 PC 构建的贪心整集,复现 4.52% 附近,再开波束 4 复现 4.34%,同时核对编码器 CRC。校准需准备 FLEURS 英文训练音频 512 段与留出 24 段,不用转写文本,按长度排序分批,填充帧排除。整数部分先用仿真器在 73 段小集上确认 int16 约 7.36% 而全 int8 会到 12.75%,再扩到 500 段确认 3.33% 到 3.39% 的量级,避免直接上板调试。
硬件需 ESP32-P4X 开发板、32 MB PSRAM、microSD 卡与麦克风屏幕,PSRAM 提到 250 MHz,L2 配 256 KB 128 字节行并开自动预取,热代码放片内 RAM。计时要在同一固件内用运行时开关比较,否则布局可带来约正负 12 毫秒漂移。
什么时候值得尝试与还需补什么验证
当已有流式 transducer 且不能重训练、目标是无加速器微控制器上的实时转写时,该路线值得尝试:先按矩阵灵敏度分配 2 与 4 比特,再逐矩阵校正加 GPTQ 与范数搜索,最后用仿真器定整数格式。预期是 test-clean 量级半个点损失、更难语音一到两点损失,整数本身不加损失,速度主要靠整数乘积与双核获得。
不值得的是全 2 比特、解码器压到 4 比特、3 比特多 1 核解码、全 int8 激活与静态输入范围,论文均给出负结果。想冲 16 MB 需注意 4 比特矩阵、小张量与解码器开销,论文估计 16.03 MB 实际 19.63 MB,缺的新格式需重训验证。
还需补的验证是噪声远场对话集、整集上板实测、功耗测量,以及换模型时灵敏度排序与校准多样性是否同样成立。短语偏置适合固定术语场景,但要在无短语集上测误报,不能只看文本转语音的 19.5% 到 3.4%。
📎 论文与评分元数据
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses