📄 金融日语合成里汉字词读错了怎么验出来
英文题目:Reading-Level Verification of Kanji Words in Japanese Financial Speech Synthesis
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Cheng Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
面向日语财经语音合成,输入是带有说话人和风格标记的对话脚本,输出是拼接后的连续语音,难点在于同一汉字词存在领域相关的多种读音,文本前端或声学模型都可能选错,而听众对术语错误敏感。生产流程先用WhisperX转写加pyopenjtalk转假名比对做第一级门,再对含已知歧义词的句子计算目标读音与易混读音的联结时序分类(Connectionist Temporal Classification,CTC)对数似然差做第二级核验,差值超过阈值即判为误读并触发重采样。相对已有做法的差异在于不再信任识别器输出的汉字文本,而是直接比较同一音频在不同假名标注下的声学证据,使语言模型先验的影响在差值中相互抵消。在由3个生产克隆声音合成30个金融术语、共180句正确读音与180句注入误读组成的受控集上,以误读检出召回率与正确读音误报率为指标,转写比对门为78.9%与44.4%,阈值为0的所提核验为91.7%与5.0%,后者召回高于前者而误报低于前者,在同一受控集上裕量ROC曲线下面积为0.990。在3个声音共180句自然汉字输入上,以整句重生成请求比例为指标,该核验捕捉到前端把大勢读作おおぜい的真实错误,并把该比例从转写比对门的38.9%降至所提核验的6.1%。结论适用于词表内歧义词的读音核验,不覆盖省略、插入、含糊发音与声调错误。在平均时长4.1秒的上述语句上经单块NVIDIA H100 NVL GPU测量,以单句核验耗时与实时率为指标,单句平均耗时17.6 ms、实时率为0.004,开销远低于合成与转写而可忽略。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
这篇论文要解决的播出事故是什么
论文面对的是每天用合成声音做日本股市解说的生产流程。团队用少量录音克隆出几个固定角色声音,对话式讲盘面,10 分钟节目几分钟就能生成。此时自然度已经不是主要矛盾,术语念错才是播出事故。
日语里同一个汉字词在不同语境读音不同,金融语境又有自己的惯用读法。比如市场在财经新闻里一般念しじょう,念成いちば就像把菜市场搬进了演播室;大势指整体趋势时念たいせい,念成おおぜい就变成了人群的意思。听财经的观众对这类词很敏感,一错就显得不专业。
更麻烦的是数字和促音变化。10 分钟的 10 分念じゅっぷん,足够的 10 分念じゅうぶん;千元念せんえん,误念成せんねん一听就不对。上值念うわね、后场念ごば、手仕舞念てじまい,这些都是容易按字面猜错的词。论文选了 30 个这样的高频金融词,每个词都配一个金融语境下正确的预期读音和一个可能出现的错误读音,后面实验就围绕这 30 组对照展开。
已有做法各管哪一段,为什么还留缺口
第一类已有工作管合成之前。日语合成前端一般先用形态素解析器切词查词典,如 Open JTalk 及其 Python 封装 pyopenjtalk 决定读音,必要时加用户词典。中文多音字也有类似的神经网络消歧工作。这些做法只能在合成前猜读音,看不到声学模型实际念成了什么。
第二类是声音克隆本身。论文用的生产系统属于两段式克隆:pyopenjtalk 把文字转成音素,自回归 Transformer 根据音素预测自监督语义 token,再用基于 VITS 的解码器生成波形,每个声音用约 30 分钟单人日语加 LoRA 微调,用时再给 3 到 10 秒参考音频定风格。这类自回归结构可能偏离给定的音素,论文确实观察到前端读音正确但九次生成都把千元念错的情况。
第 3 类是用自动语音识别评价合成。常用 Whisper 和 WhisperX 转写合成音频算字错率或词错率。但对汉字这种表音与表形分离的文字,识别器写出什么字不等于当时发了什么音。发音评价里本来有 goodness-of-pronunciation 的思路,即比较预期音素序列与竞争序列的似然,论文就是把这个思路搬到合成校验上,用输出平假名的 CTC 识别器对读音打分。
转写后比假名的做法错在哪里
生产系统原来用的质量门是转写加假名比较。每合成一句,就用 WhisperX large-v3 转写,把输入原文和转写结果都用 pyopenjtalk 转成片假名,去掉非假名符号,只有两串完全相同才放行。写成扬げ还是上げ这类字形差异会被归一掉,漏词、重复、幻觉这类自回归常见大错也能抓住。
问题出在识别器太强。音频里明明念的是いちば,但句子讲的是股市,识别器按语言习惯最可能写出的还是市场二字;形态素解析器再把市场转回しじょう,与输入一致,门就放行了,错误直接播出。反过来,音频念对了,识别器在生僻术语上认错一个字,假名串就不等了,本来正确的句子被打回重生成。
论文要量化的就是这 2 个方向的不可靠:在可控注入错误时,转写门漏掉多少真读错,又在正确音频上误报多少;同时给出一个不依赖识别器写哪个汉字的读音级校验,看它能否两边都更好。
生成验证重生成的整体回路长什么样
整个生产回路是按句生成、2 级验证、不合格重生成。剧本按说话人和风格标签写好,同说话人的行合在一起合成,避免反复加载模型,合成后按剧本顺序拼接,句间留 0.3 秒停顿,说话人或段落切换处留 0.6 秒。合成前还有一个替换表,把过去错过的表达直接改写成假名,例如把円安改成えんやす,按最长匹配优先,可按声音限制,数字开头的条目在前面有数字时跳过,原文本留给字幕和校验。
下面这张流程图是理解分工的关键,先看主路径从脚本到拼接,再看两个验证阶段分别卡什么,失败如何回流重生成。
看图路径: 1. 先沿左上脚本经替换表到按句合成的主箭头看一遍;2. 再看第一阶段与第二阶段各在何处分出通过与失败分支;3. 注意失败分支如何回流到重生成并受重生成次数限制
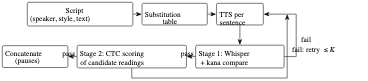
论文图 1。原论文 Fig. 1::“Generate–verify–regenerate loop. Stage 1 is the deployed transcript-based gate; Stage 2 is the proposed reading-level check.”。
从图中可以看到,第 1 阶段是已部署的转写门,第二阶段是本文新加的读音级检查。任 1 阶段判失败就换随机种子重生成,生产中最多 9 次,也就是 3 轮每轮 3 个候选,取第一个两关都过的;若都不通过则保留打分最好的并上报被标的词,方便操作员给替换表加新条目。替换表本质是事后补救,自动检测的意义在于把没听过的错提前拦下来。
第一关转写门具体比什么
第一关只看文字是否对得上。每句合成音频送给 WhisperX 转写,输入文本与转写文本各自经 pyopenjtalk 转成片假名读音,删掉所有非假名符号后做字符串全等比较。相同即通过,不同即失败。
这种做法对大错很有效。跳句、重复、胡编乱造会让假名串大变,基本都会被拦下;有些读错若导致识别器写成另一个词,也能被拦下。但它把声学证据压缩成了一行文字,再比较文字,中间经过了识别器语言模型的改写,这正是后面漏检和误报的根源。
形态素解析器 × 前端 × 读音: 形态素解析器负责把汉字串切词并查词典给出读音,前端是合成前决定整句音素序列的模块,读音是送给声学模型的具体发音内容;三者串起来,前端错则声学模型按错的读音念,因此校验时不能再用同一前端的读音当正确答案。
Whisper 转写门 × 假名比较 × 语言模型先验: Whisper 转写门指先把合成音频转写成文字再比较的已有做法,假名比较指把输入与转写都转成片假名再判是否相同,语言模型先验指识别器按常见搭配补全文字的倾向;三者组合时,语言模型会把听到的错读音改写成常见汉字,导致假名比较看似相同而漏检。
第二关怎样对预期读音和易混读音打分
第二关只管已知多音词的读音。设句子被目标词切成前后加目标词 3 段,记目标词为 w,预期读音为 r 星,备选易混读音集合为 A,本研究每个词只设一个备选。上下文前后段的平假名读音取自前端。对每个候选读音 r,把整句标签序列拼成前段加 r 加后段,送给 CTC 平假名识别器算对数似然作为得分。
\[s(r)=\log P_{\mathrm{CTC}}\bigl(y(r)\mid\mathbf{a}\bigr),\]这里 a 是整段音频,概率来自 wav2vec 2.0 XLSR-53 在 Common Voice 日语上微调出的平假名 CTC 模型。直观说,就是问这个声学模型觉得整句话念成这个假名串的可能性有多大。
判决看差值。取所有备选中最高分减去预期读音得分,记为 m,若大于阈值则标为读错,句中任一词被标则整句不通过。
\[m(w)=\max_{r\in\mathcal{A}(w)}s(r)-s(r^{*})>\theta,\]因为两个候选序列只在目标词一段不同,上下文识别错对两边影响大致相同,相减时大部分抵消,剩下的是目标段声学证据的差别。代价是每句 1 次 CTC 前向加每个候选 1 次 CTC 损失计算,不需要解码出文字。
CTC 声学模型 × 预期读音 × 易混读音: CTC 声学模型指直接输出每一帧对应哪个平假名的声学识别器,预期读音是金融语境下该词应该念的读音,易混读音是前端或声学模型可能误念成的读音;把同一段音频分别按预期和易混读音打分,谁更能解释音频就判谁,避开了识别器选哪个汉字的问题。
这篇工作训练了什么,又直接用了什么现成模型
这篇论文没有为校验方法训练新模型,需要说清楚。3 个生产声音来自开源两段式克隆框架的预训练模型,用 LoRA 微调得到,秩分别为 64、32、32,每音约 30 分钟日语,推理时加默认参考音频。CTC 打分器直接沿用已在 Common Voice 日语上微调好的 wav2vec 2.0 XLSR-53 平假名模型,约 300,000,000 参数,实验中参数冻结,只做前向和 CTC 损失计算,不更新。
实际执行的计算是检索加打分。先从领域词表和替换表历史得到每个词的预期读音和易混读音,本研究是人工为 30 词各定一个备选;再对每句音频构造两个整句假名序列,分别算 CTC 对数似然并相减。这不是确定性求解,声学模型输出仍有噪声,阈值决定工作点。论文没有报告 CTC 模型的训练细节消融,也没有比较换一个声学模型会怎样,这部分是缺口,不能从模型名字猜效果。
540 句对照集和自然输入集是怎么造的
实验用 3 个生产声音,2 女 1 男记为 F1、F2、M1。30 个金融词每个写两个自然句子,语境能唯一确定金融读音,共 60 句,合成后平均时长 4.1 秒。30 词按错误类型分 3 类:读音选择型 21 个,如市场念いちば、前场念まえば;清浊促音型 7 个,如大手误念おおで、寄付误念よりづき;数字音便型 2 个,即 10 分和千元。前者一般差几个发音单位,后者常只差一个发音特征。
下面先看词表的前几行,理解预期读音与注入错读的对应关系,后面所有检出与误报都是在这组对照上测的。
| Word | Expected | Injected | Word | Expected | Injected |
|---|---|---|---|---|---|
| 市場 | しじょう | いちば | 決算 | けっさん | けつざん |
| 大手 | おおて | おおで | 増益 | ぞうえき | ぞうやく |
| 上値 | うわね | じょうね | 千円 | せんえん | せんねん |
每句每声音做 3 种输入。K 是把目标词换成预期读音的平假名,W 是换成注入的错误读音平假名,N 是原始汉字。因为前端把平假名确定性转成音素,K 和 W 可视为请求念对和请求念错,提供无需人工标注的真值。60 乘 3 乘 3 共 540 句,其中 360 句 K 加 W 为可控集,180 句 N 为自然集。校验时一律给原始汉字句,模拟生产。
比较 3 种方法。已部署的第 1 阶段转写门;直接贪心解码 CTC 再看预期读音是否出现在输出中的基线;阈值为 0 的提议方法。指标是 W 上的检出率、K 上的误报率、精确率,以及差值的 ROC 曲线下面积 AUC,配 Wilson 95% 区间和 McNemar 配对检验。词表局部展示只为说明输入构造,完整 30 词以原文表一为准。
可控注入下检出率和误报率差多少
先看差值分布的直方图能建立直觉,正确与错误两群分得越开,阈值越好选。横轴是易混读音得分减预期读音得分,纵轴是句子数,虚线是零阈值,蓝色是正确读音,橙色是错误读音。
看图路径: 1. 对比蓝色正确读音与橙色错误读音两个直方图的中心位置;2. 看零阈值虚线左右两侧各混入了多少对方颜色;3. 注意错误侧在零附近的小尾巴对应难区分的浊音对

论文图 2。原论文 Fig. 2::“Distribution of the margin m(w) in (2) for utterances with the correct (K) and the injected wrong (W) reading. Dashed line: \theta=0.”。
图中蓝色中心明显偏左,橙色中心明显偏右,正确读音的差值中位数为负 26.9 左右,错误读音为正 23.1 左右,零阈值基本把两群分开,AUC 达 0.990。错误侧在零附近有一小撮混入,对应后面寄付这类只差清浊的难例。
在同一可控集上比较 3 种方法,检出越高越好,误报越低越好,下表是核心数字对比。
| 方法 | 错读音检出情况 | 正确读音误报情况 | 精确率 |
|---|---|---|---|
| 转写加假名门 | 78.9% 检出 | 44.4% 误报 | 64.0 |
| 提议方法阈值 0 | 91.7% 检出 | 5.0% 误报 | 94.8 |
提议方法比转写门多抓住 35 个转写门漏掉的错,同时只漏掉 12 个转写门抓住的错,配对检验显著;误报方向更悬殊,提议方法只新增 3 个对方没有的误报,反向有 74 个。贪心解码虽检出全部,但近半正确句子也被毙,输出还常出现噪声,不可用作门。分声音看,AUC 在 0.983 到 0.998 之间,男声 M1 分离最好,说明结论不是某个声音特有的。
分声音看自然输入是否和正确注入一样
下面这组按声音和输入条件画出的箱线图,把可控结论能否搬到生产的问题具体化。横轴按 F1、F2、M1 分组,每组内分正确注入、错误注入、自然汉字输入,纵轴是差值,虚线是零阈值。
看图路径: 1. 按 F1、F2、M1 逐个声音对比 K、W、N 三组箱线的高低;2. 注意自然输入 N 整体与正确注入 K 同高;3. 找出自然输入中向上偏离的大势个例并看其对应条件

论文图 4。原论文 Fig. 4::“Margin m(w) per voice and condition (K: correct reading injected, W: wrong reading injected, N: natural kanji input).”。
图中每个声音的正确注入箱体都在零线以下,错误注入箱体都在零线以上,自然输入整体与正确注入同高,只有大势的自然错读成为向上离群点。这支持可控测得的误报率在生产中大致成立,前提是前端读音正确且无大段缺漏。自然输入中提议方法的报警率分声音为 10.0%、5.0% 和 3.3%,而转写门为 50.0%、41.7% 和 25.0%,后者随声音识别好坏大幅波动,更像识别难度而非真实错读率。
转写门为什么两头都不可靠
漏检这边,38 个被转写门放过的注入错读里,36 个是 Whisper 直接写回了预期汉字。例如音频念いちば,转写写东京市场;音频念あいば,转写写相場之重;音频念じゅうぶん,转写写 10 分;后场念あとば、日经平均念にちけい、下落念からく,都被写回正确汉字。
转写后再转假名自然与输入相同,门就通过了。越是常用词语言先验越强,转写门对相場 6 句只抓住 1 句,对市场、后场、日经平均各只抓住 2 句,而提议方法分别抓住 6、5、6、6 句。
误报这边,是识别在术语和同音词上认错字改变了假名串。上值被听成钱,手仕舞被写成手缔,大引被写成大引き,圆高被写成缘どこ之类。生产中每次误报都花 1 次重生成,若候选全不过,还会把正确句子标成可疑。
在自然汉字输入下比较谁能抓住真正的前端错误,检出越多越好,误报越低越好,下表是该子集的结果。
| 条件 | 转写门 | 提议方法 | 说明 |
|---|---|---|---|
| 自然大势错读 6 句 | 检出 4 句 | 检出 5 句 | 前端错读为人群读音 |
| 其余 174 句自然正确 | 误报 66 句 | 误报 6 句 | 经母语者抽验为正确 |
| 全部 180 句自然 | 重生成 38.9% | 重生成 6.1% | 生产重生成请求占比 |
转写门对男声 M1 的两句大势错读全部放行,因为转写写成大势后 pyopenjtalk 又读成同样错误的人群读音,期望本身就是错的,门不可能发现。提议方法的期望来自领域词表而非前端,因此能标出 5 句。这说明校验的期望不能取自与合成器同一个前端,否则前端错则两边一起错,这是第二个盲点。剩余 174 句里提议方法的 6 个报警经母语者听辨都是正确读音,属于误报,误报率 3.4%,与可控集 5.0% 量级一致。
提议方法在哪里也会失败
提议方法把寄付 6 句错读全部漏掉。寄付正确よりつき与错误よりづき只差一个发音单位的清浊,CTC 在该区域输出不稳,两边都出现过噪声,小差值被淹没。去掉该词后召回为 165 比 174 即 94.8%,误报数不变。其余漏检分散在圆安、空卖、大势、市场、大手、人气,各一到两句,都是整体识别质量差时差值略为负。
误报集中在大引和手仕舞。正确读音里的浊音 bi 和 ji 常被听成清音,这是同一类清浊弱对比问题。自然输入里被提议方法单独标出的 6 句也是大引两句、手仕舞三句、一时一句,经母语者确认都是正确的,同样是浊音听成清音。这提示最小清浊对比可能需要更强声学模型或按词设阈值。
按读音选择、音变、数字音便 3 类拆分召回与误报,条件为可控集,召回高误报低为好,下表展示了难度差异。
| Type (terms, utterances per class) | Stage 1 | Proposed |
|---|---|---|
| (a) Reading choice (21, 126) | 104/126, 61 FA | 118/126, 1 FA |
| (b) Sound change (7, 42) | 29/42, 17 FA | 35/42, 7 FA |
| (c) Numeral euphony (2, 12) | 9/12, 2 FA | 12/12, 1 FA |
从表中可以看到,读音选择型提议方法只剩 1 个误报而转写门有 61 个,优势最大;音变型两边都难,提议方法的 7 个漏检里 6 个是寄付,7 个误报也多在此类;数字音便全部抓住。教学上可以这样记:差得越多越好验,只差清浊最难验。
阈值怎么选,两关联用时怎么分工
阈值提供简单的工作点权衡,ROC 曲线把这种权衡画了出来,基线点的位置说明它们不在有效前沿上。横轴是正确读音上的误报率,纵轴是错读音上的检出率,蓝色是提议方法随阈值移动的曲线,红绿两点是两个基线。
看图路径: 1. 先看蓝色提议方法的曲线离左上角有多近;2. 再找曲线上标出的零阈值点与两个基线方块三角的位置;3. 对照横轴误报率理解为何基线点落在曲线右下方

论文图 3。原论文 Fig. 3::“ROC curve of the proposed margin on the controlled set, with the operating points of the two baselines.”。
图中蓝色曲线紧贴左上,AUC 为 0.990,零阈值点已在高检出低误报处,而转写门与贪心 CTC 两个点落在曲线右下方,意味着在同样误报下检出更低,或同样检出下误报更高。曲线往下是阈值放宽后的正常移动,不能把曲线末端当全程结论。
从负 10 到 10 的每个工作点都支配两个基线。论文建议公开内容用负阈值如负 5,因为误报只多花 1 次短句合成,而漏播一个术语读错代价更高。
差值 × 阈值 × 重生成: 差值指易混读音最高分减去预期读音得分,阈值是判定为读错所需的最小差值,重生成指判错后换随机种子再合成一次;阈值越低检出越多但误报也多,每次误报只多花一次短句合成,而漏检会让错误播出,因此公开内容可用更低阈值。
两关联用时,严格串联会继承转写门的误报,原文组合检出 177 比 180 但误报 83 比 180。转写门仍有必要,因为它管缺漏和乱码,而读音检查不管这些。把转写门放宽到只有假名相似度低于 0.8 才毙,此时正确集里只剩 2 个转写门报警,再叠加读音检查得到 165 比 180 检出、11 比 180 误报,自然输入重生成 12 比 180。因此推荐转写门只管大错、读音关管读音,但缺漏场景的转写门阈值尚未在本集验证。
这些结论在什么条件下才成立
第一,可控集的错读是让合成模型流畅念出来的,可能比自然声学偏离更容易验。自然含糊、半吞半吐的错可能差值更小,检出会打折。真值假设声学模型跟从了请求的平假名,正确注入组的误报说明大多成立但不总是,少部分误差可能是标签噪声。
第二,提议方法依赖词表。词表靠替换表历史、领域术语表和词典读音长大,新词加一行就能验,但没见过的词验不到,缺漏和插入仍要靠转写门,两关互补。实验只用一种合成架构、一个在朗读语音上训练的 CTC 模型、60 个句子,声调高低错误不在本文范围。
第三,计算开销结论只在给定硬件下成立。每句读音校验的耗时与音频时长的比例越小越好,条件为平均 4.1 秒语音,硬件为单卡 H100,下表是原文报告的开销。
| 环节 | 耗时 | 相对实时率 | 结论 |
|---|---|---|---|
| 合成加转写 | 远大于校验 | 未报告 | 校验非瓶颈 |
实时率 0.004 意味着校验耗时只占音频时长的千分之四,相对合成和 Whisper 转写可忽略。但这不等于端到端延迟改善,因为重生成次数、转写耗时、并发都没有在此测量,不能承诺整体更快或更便宜。
要复现第一步做什么,需要哪些词表
复现先准备三样东西。声音侧需要同样的两段式克隆流程和 3 个声音的微调与参考音频,若没有原声音,可用自己的日语声音代替,但误报率会随声音变,论文里 F1 误报 50%、M1 误报 25% 已说明声音差异。文本侧需要 30 词 60 句的剧本与预期和注入读音对照,合成时正确与错误注入用平假名替换目标词,自然输入保留汉字,校验时一律给汉字原句。
校验侧需要 CTC 平假名模型与读音词典。CTC 用 wav2vec 2.0 XLSR-53 在 Common Voice 日语上微调的版本,前向冻结;读音词典每词一行写预期读音与易混读音,期望必须来自领域词表而非合成前端,否则前端错会被继承。替换表按最长匹配实现,数字开头条目在前面有数字时跳过。
替换表 × 领域词表 × 读音词典: 替换表指合成前把易错词直接改写成假名的应急做法,领域词表指金融术语正确读音的来源,读音词典指校验用的每个词的预期读音加易混读音清单;替换表是事后补救,读音词典是事前校验依据,新词加一行就能被校验,但没收录的词就验不到。
判定时对每句构造两个整句假名序列算 CTC 对数似然并相减,与阈值比较。阈值先从零开始,再按错播代价扫负 5 到 5。自然集的 6 句大势错读可用来检验前端错误是否被抓住,但不要用它调阈值,避免泄漏。代码与数据是否公开方面,原文未给出经校验可用的作者资源链接,不能写成已公开,只能按论文描述自建。
什么时候值得试,还缺哪项验证
当合成的是术语敏感的长节目、已有替换表但总有漏网、转写门误报导致重生成太多时,值得试读音级检查。它把重生成请求从 38.9% 降到 6.1%,且能抓住转写门因语言先验放过的常用词错读,额外计算每句十几毫秒。代价是维护词表,每个要验的词都要写预期读音和至少一个易混读音,清浊只差一个发音单位的词还要更谨慎。
还缺三项验证。一是自然声学偏离而非流畅注入错的检出率,二是含缺漏和幻觉句子上放宽后转写门的阈值选择,三是换声学模型或加词相关阈值后寄付类清浊对能否改善。声调高低错误本文未涉及,也不能把自动指标的提升等同于人工听感全面变好。
一句话收束:在领域词表给定期望、易混读音覆盖主要的条件下,用声学似然差验已知多音词,比看转写文字更准更省;超出词表或超出读音错误的范围,仍要靠宽松的转写门兜底。
📎 论文与评分元数据
排名:前50% | 文档类型:应用研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses