📄 不用人工标注也能让语音合成学会单词重读:EmpDPO 的两阶段做法
英文题目:EmpDPO: Enabling Emphasis Control in TTS via Direct Preference Optimization
评分:6.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Haonan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunyun Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Megan Wei:机构信息未能在本次解析中与作者逐人可靠绑定
- Zeyu Jin:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
输入是一句文本和一段提供音色的参考音频,输出是模仿该音色的语音。难点是同一句话因重读词不同而含义不同,但文本没有标注位置,模型需在不损害可懂度和音质的前提下让指定词更突出。论文先用现成多语言重音检测器给真实语音逐词打分,对超过阈值的词在文本和音素序列同时加标记,再做有监督微调以初步建立标记与声学实现的对应。随后用微调后模型对同一输入生成带标记候选和不带标记基线,用同一检测器按目标词提升量与非目标词保持不突出的比例选出最优和最差候选构成偏好对,再以直接偏好优化拉开两者去噪误差差距并用真实语料回放防止偏离,该路线不需要人工重音标注,也不需要为音高或能量手写奖励函数。在210句、每输入配8个音色的客观评测设置下,指标δ¯为DPO模型0.136,高于有监督微调的0.069和公开系统Fish-S2的0.129。在相同输入集的听音评测设置下,指标Q1为DPO模型3.56分,高于有监督微调的3.15分和Fish-S2的3.25分,指标Q2为DPO模型3.47分,与有监督微调的3.52分相近。该结论仅在德英西法日中六语、每句单个目标词的条件下验证,无回放时去噪误差发散至不可懂,自生成样本回放则响度上升且质量下降,多词重读尚未验证。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
- 第三方资源:https://chaonan99.github.io/empdpo-demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
为什么要在合成语音里控制单词重读
这篇论文要解决的是文本转语音中的单词级重读控制。输入是待合成的文本、一段提供音色的参考音频,以及用户指定的要强调哪一个词,输出是读出该文本且让指定词听起来被强调的波形。举例来说,She called today 这句话,重读 She、called、today 会表达完全不同的对比含义,纯文本本身不携带这层信息。
对初学者而言,关键是理解重读不是简单调大音量,它通常体现在音高、能量、时长等韵律的局部对比上,而且不同语言的实现方式不同。如果直接把整句都读重,就没有对比,也就不算重读。评价时既要看目标词是否真的突出,也要看其他词是否被误强调,还要看整体是否仍然自然可懂。
已有两类做法各自卡在哪里
原文把已有重读控制分成两条路线。第一条是把重读标记或特征作为额外输入,用监督训练让模型自己学声学实现,缺点是需要单词级重读标注,标注成本很高。第二条是绕开重读概念,直接控制更具体的音高、能量、时长等参数,缺点是把重读限制在几个参数里,往往和语言相关,听感不如端到端生成自然。
近期还有用反馈做后训练的思路,例如用在线强化学习 GRPO 或离线偏好方法 DPO。原文提到的 EMORL-TTS 把重读定义为生成语音上的音高能量对比奖励再用类 GRPO 目标强化,Fish Audio S2 先用监督微调教局部指令再用 GRPO 并用转写器惩罚漏掉的指令。本文与它们运行阶段不同,本文采用离线固定偏好对的 DPO,不需要单独的奖励模型,也不需要在线采样更新,监督全部来自现成检测器。
本文面对的起点条件是什么
本文的起点是一个已经预训练好的多语言零样本扩散语音合成模型,它从来没有见过重读标注。预训练用了 21 种语言共 300,000 小时内部语音数据,训练 700,000 步,评测的 6 种语言包含在内。任务要求事后给这个模型加上重读控制能力,而且不做人工重读标注,也不为重读专门设计奖励函数。
约束条件很明确:只能用现成的多语言重读检测器提供训练信号,训练预算要小,推理时仍保持零样本克隆能力。这就决定了方法必须回答 3 个问题:如何让模型先认识标记,如何用很少的偏好数据把标记跟随能力放大,以及如何防止偏好训练把语音质量破坏掉。
两阶段流程是如何分工的
整体流程分两段。第一段是监督微调,用检测器给真实语音打伪标签,把超过阈值的词在文本和音素两条通路上都加上标记,再用标记与不标记混合的数据微调,得到初步能跟随标记的模型。第二段是偏好优化,用刚得到的微调模型采样带标记候选和不带标记基线,再用同一个检测器打分挑出好坏对,做扩散模型版本的偏好优化。
读图说明:下图是 2 阶段总览,上方长条是监督微调的数据流,下方长条是偏好优化的数据流,中间橙色检测器出现两次但标注为同一检测器,末端是偏好损失加回放去噪损失。
看图路径: 1. 先看上下两条带底纹的长条,区分监督微调阶段和偏好优化阶段;2. 再看橙色检测器模块在两阶段如何复用;3. 最后看偏好优化阶段从采样到成对再到损失的箭头走向
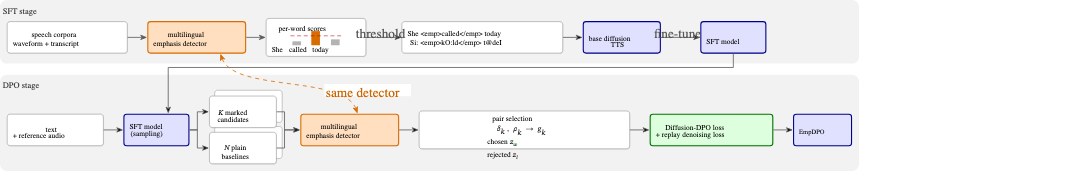
论文图 1。原论文 Figure 1::“Overview of EmpDPO. SFT stage: a multilingual emphasis detector labels real speech with emphasis markers.”。
图中确实可见:左上角语音库加文本先经过多语言重读检测器得到逐词分数,再经阈值变成带标记文本去微调基础扩散模型;下方文本加参考音频先经采样得到多候选和基线,再经同一检测器做成对选择,得到胜者与败者潜变量,最后与回放损失一起训练得到最终模型。这种复用同一检测器的设计是理解全文的关键。
基础扩散模型输入了什么又输出了什么
基础模型是潜变量扩散模型,用流匹配方式训练。它的输入有三部分:原始文本经冻结的 T5 编码器得到文本向量,国际音标音素序列经可学习的嵌入表得到音素向量,参考音频和目标音频经同一个冻结的 Descript Audio Codec 编码成潜帧。生成过程就是在给定这 3 类条件下,从噪声逐步去噪得到目标语音潜变量,再由解码器变回波形。
零样本音色克隆在这里的具体含义是:推理时给一段没见过的参考音频,模型用它的潜帧作为条件去模仿音色,不需要为该说话人重新训练。重读标记的具体含义是:在文本和音素中都用符号把目标词框起来,例如文本侧写成 She <emp>called today,音素侧同样框住对应音素,两条通路保持一致。
零样本音色克隆 × 重读标记: 零样本音色克隆指只给一段参考音频就模仿其音色,重读标记指在文本和音素序列中用符号框住要强调的词,前者决定听起来像谁,后者决定哪一个词要突出,两者在输入端正交,模型要同时满足两者。
训练去噪时把干净潜变量和噪声按噪声水平插值得到带噪潜变量,模型预测速度场去拟合真实速度,损失是两者差的平方期望。
\[\mathcal{L}(\theta)=\mathbb{E}_{t,\,z,\,\epsilon}\left\|v_{\theta}(z_{t},\,t,\,e_{x},\,e_{p},\,z^{r})-v\right\|^{2}\]该式先形成带噪潜变量和条件,再计算预测速度与真实速度的误差,误差越小说明去噪越准,它是后文回放项的原型。
监督微调怎样在没有人工标注时起步
监督微调阶段使用的多语言重读检测器是现成工具,在 7 种语言上训练过,对其他语言零样本使用。给定波形和文本,它给每个词一个重读分数,论文取 0.35 为阈值,超过就认为该词被强调了,并在文本和音素两侧同时加上标记。这样真实语音库就自动变成了带标记与不带标记的混合训练集,约 258,000 条共 711 小时,其中 45% 带标记。
沿一个样本看:一段真实录音本来没有标记,检测器发现其中 called 分数超过阈值,就把训练文本改写为带标记版本,模型在微调时看到带标记输入就要学会生成类似的重读实现。原文客观结果显示这一步只能让模型弱跟随,目标词增益较小,说明仅靠伪标签模仿还不够,需要第二阶段放大对比。
偏好优化怎样只用好坏对强化重读
偏好优化阶段不再需要人工排序,偏好来自检测器打分。对同一输入,微调模型生成 5 个带标记候选和 3 个不带标记基线,全部用检测器打分,再按复合分数取最高和最低作为胜者与败者潜变量。原始偏好目标是提高胜者相对参考模型的对数似然,同时压低败者,参考模型就是微调结束时的冻结模型,系数控制允许偏离的程度。
\[\mathcal{L}_{\mathrm{DPO}}(\theta)=-\mathbb{E}_{(z_{w},\,z_{l})}\,\log\sigma\!\big(\beta\,[\,r_{\theta}(z_{w})-r_{\theta}(z_{l})\,]\big)\]该式要约束的是胜者与败者的相对差距,符号内是两者对数似然比之差,经 Sigmoid 后取负对数期望,差距越大损失越小,它只需要离线固定好坏对,不需要单独奖励模型。
由于扩散模型对数似然无法直接计算,扩散版本偏好优化把似然比较换成每个噪声水平下去噪误差的比较,直觉是让策略在胜者上的去噪误差低于冻结参考模型,在败者上高于参考模型。
\[\mathcal{L}_{\mathrm{diff}}(\theta)=-\mathbb{E}\,\log\sigma\!\left(-\beta\left[\left(E_{\theta}^{w}-E_{\mathrm{ref}}^{w}\right)-\left(E_{\theta}^{l}-E_{\mathrm{ref}}^{l}\right)\right]\right)\]该式中误差项是速度预测误差,括号内是策略与参考在胜败样本上的误差差再做差,前面加负号后同样送入 Sigmoid,优化方向与上式一致。实际总损失是回放损失加 0.1 倍的该偏好损失,回放数据可以是真实语料,也可以是胜者自身样本。
监督微调 × 直接偏好优化: 监督微调负责让模型先认识重读标记和声学实现的对应关系,直接偏好优化负责在已认识的基础上放大好坏样本之间的差距,前者给初始跟随能力,后者给强化信号,两者搭配才不需要人工标注也能从弱跟随走到强可控。
多语言重读检测器 × 伪标签 × 偏好对: 多语言重读检测器在两个阶段是同一个打分工具,在监督微调阶段它把逐词分数变成是否加标记的伪标签,在偏好优化阶段它把生成候选的分数变成排序和筛选偏好对的依据,同一信号源保证了两阶段目标一致。
好坏对的具体打分公式在算什么
成对构造的关键是复合分数,它由目标词提升和选择性两部分组成。记标记目标词集合为目标词集,候选对目标词的分数减去基线平均分就是提升,选择性是分数低于目标词最低分的那部分非目标词所占比例。复合分数把最小提升、平均提升和选择性加权相加,权重取 0.6、0.4、0.3。
\[\delta_{k}(\tau)=s_{k}(\tau)-\bar{s}^{0}(\tau),\quad\rho_{k}=\frac{\big|\{u\notin\mathcal{T}:s_{k}(u)该式把最小提升、平均提升和选择性线性组合,最小项惩罚漏掉任何一个目标词,平均项奖励整体强度,选择项防止靠整句变响蒙混过关。取最高和最低复合分数的候选分别作为胜者和败者。
目标词提升 × 选择性: 目标词提升衡量标记词比无标记基线响亮了多少,选择性衡量非目标词是否仍然保持不突出,前者防止漏重读,后者防止把整句都喊响,两者加权才把真正有对比焦点的重读挑出来。
除排序外还有硬过滤:候选最小提升至少 0.20,日语和中文放宽到 0.15,胜败样本都要满足字符错误率不高于 0.20、预测质量分、说话人相似度和削波比例等质量门限,最终只留下 5171 对,其中英文 957、德文 878、西班牙文 1314、法文 796、日文 662、中文 564,偏好训练跑 10,000 步,每步 32 对加 64 条回放。
评测用什么文本声音和指标
客观和主观评测覆盖德英西法日中 6 种语言,每种 35 句、每句标注一个目标词,共 210 句,评测文本与训练文本不重叠。配 8 段参考音频,男女各半,每模型 1680 个不同输入,WordVoice 只支持英中故只有 560 个输入。每个输入生成 3 个带标记和 3 个不带标记输出以减少采样随机性,主观听测随机抽其中一个带标记输出。
客观指标中目标词增益是目标词提升在全部输出和输入上的平均,越大越好;字符错误率用识别转写与参考文本比较,越低越好;说话人相似度是生成与参考说话人嵌入的余弦相似度,越高越好;自然度用神经网络平均意见分预测 UTMOS,音质用无参考模型 NISQA,两者越高越好。对除增益外的指标分别报告带标记和不带标记的均值。
读图说明:下图是英文版听测界面截图,顶部是高亮目标词的句子和播放条,下方是三道题的按钮排布,理解它才能理解主观分数的来源。
看图路径: 1. 先看顶部高亮词和播放条,确认每次只评一个目标词;2. 再看三道题的量表形式,区分重读强度、自然度和误重读;3. 注意第一二题是 1 到 5 分,第三题是是否题

论文图 2。原论文 Figure 2::“Listening test interface (English version): emphasis strength of the highlighted word (Q1) and naturalness (Q2) on a 1–5 scale, and whether another word sounds emphasized (Q3).”。
图中确实可见:例句高亮了 angry 一词,第一题问高亮词被强调的强度,第二题问录音整体自然度,都是 1 到 5 分并标注了端点含义,第三题问是否有其他词也被明显强调,选项为是、否、不确定。每位母语听众做 20 轮,轮内覆盖各系统,系统间比较用被试内配对检验。
客观指标上重读变强了吗音质保住了吗
比较问题是:在相同文本和参考声音下,各系统目标词增益谁更高,同时可懂度、音色相似度和预测音质是否明显变差。公平条件是同一 210 句加 8 声音的输入集,增益越大越好,错误率越低越好,其余相似度和质量分越高越好。
| System | δ¯↑\bar{\delta}\uparrow | CER plain / emph. ↓ | SIM plain / emph. ↑ | UTMOS plain / emph. ↑ | NISQA plain / emph. ↑ |
|---|---|---|---|---|---|
| Ours-Base | — | 0.008 / — | 0.49 / — | 3.61 / — | 4.34 / — |
| Ours-SFT | 0.069 ± 0.003 | 0.008 / 0.007 | 0.47 / 0.47 | 3.60 / 3.58 | 4.42 / 4.42 |
| Ours-DPO | 0.136 ± 0.005 | 0.008 / 0.008 | 0.49 / 0.49 | 3.60 / 3.55 | 4.36 / 4.34 |
| Fish-S2 | 0.129 ± 0.005 | 0.039 / 0.034 | 0.51 / 0.51 | 4.20 / 4.20 | 4.42 / 4.39 |
| Qwen3-TTS | 0.017 ± 0.003 | 0.034 / 0.036 | N/A | 3.56 / 3.48 | 4.18 / 4.06 |
| WordVoice (en/zh) | 0.074 ± 0.008 | 0.047 / 0.040 | 0.46 / 0.46 | 3.92 / 3.86 | 4.77 / 4.74 |
监督微调增益只有 0.069,偏好优化后到 0.136,略高于最强的公开系统 Fish-S2 的 0.129,而 WordVoice 固定声学操作只有 0.074,自然语言指令的 Qwen3-TTS 几乎无效。公开系统字符错误率更高,但在不带标记输入上同样高,说明是模型本身特性而非标记导致。各系统相似度和预测质量分没有明显塌陷,这是增益结论成立的前提。若只看检测器增益,会受同一检测器既训练又评测的影响,因此必须结合后文人工听感一起看。
人工听感是否也觉得重读更清楚且仍然自然
比较问题是:母语听众实际听到的目标词强度、整体自然度和误重读率如何。公平条件是同一输入集、同一三道题界面,强度和自然度越高越好,误重读率越低越好。
| System | NN | Q1 ↑ | Q2 ↑ | Q3 ↓ |
|---|---|---|---|---|
| Ours-Base | 364 | 2.73 ± 0.08 | 3.45 ± 0.08 | 42% |
| Ours-SFT | 364 | 3.15 ± 0.08 | 3.52 ± 0.08 | 34% |
| Ours-DPO | 364 | 3.56 ± 0.07 | 3.47 ± 0.08 | 32% |
| Fish-S2 | 364 | 3.25 ± 0.08 | 2.90 ± 0.11 | 29% |
| WordVoice (en/zh) | 140 | 3.37 ± 0.12 | 3.13 ± 0.15 | 36% |
偏好优化后强度 3.56 分最高,显著高于基线、微调和 Fish-S2,在英中子集上与 WordVoice 相当;自然度保持在基线和微调水平,而 Fish-S2 和 WordVoice 显著更低,说明强度提升没有以明显牺牲自然度为代价。误重读率上偏好优化与微调相当,略差于 Fish-S2。分语言看 Fish-S2 只在英文上占优,原文检查中文样本发现其带有明显外国口音,推测是把英文参考音的口音连同音色一起带过来,这也提醒跨语言克隆时参考音频语言会干扰结论。
读图说明:下图是分语言主观结果,上排为强度,下排为自然度,柱为被试均值,误差条为置信区间,可用来核对平均数是否被单一语言主导。
看图路径: 1. 先对比上排各语言中橙色柱与其他颜色柱的高低;2. 再看下排自然度各柱是否基本持平;3. 注意英文柱与其他语言柱的相对关系差异

论文图 3。原论文 Figure 3::“Per-language subjective results: Q1 emphasis strength (top) and Q2 naturalness (bottom). WordVoice covers only en/zh. Bars: mean over participants; error bars: 95% CI.”。
图中确实可见:上排橙色柱在德西法日等语言高于其他柱,下排橙色柱与灰蓝柱基本持平,而绿色和黄色柱在自然度上多处偏低,英文是唯一例外,绿色柱在强度上反超,这与正文对口音问题的讨论一致。
回放数据用真实语音还是用自生成样本
比较问题是:偏好训练时的回放项应该锚定真实语料还是锚定模型自生成的胜者样本。公平条件是相同初始化、相同偏好对和超参数,只换回放来源,另设微调多训 10,000 步作对照,指标在带标记输出上计算,增益越高越好,响度只作观察量。
| Variant | δ¯↑\bar{\delta}\uparrow | CER↓ | LUFS | UTMOS↑ | NISQA↑ |
|---|---|---|---|---|---|
| SFT (init) | 0.069 ± 0.003 | 0.007 | −-19.7 | 3.58 | 4.42 |
| SFT ++10k | 0.069 ± 0.003 | 0.005 | −-19.7 | 3.56 | 4.41 |
| DPO-chosen | 0.136 ± 0.005 | 0.006 | −-14.0 | 3.59 | 3.74 |
| DPO-corpus | 0.136 ± 0.005 | 0.008 | −-19.6 | 3.55 | 4.34 |
两种回放达到相同增益 0.136,但副作用不同,用自生成胜者回放时输出比微调响 5.7 分贝且 NISQA 从 4.4 掉到 3.7,而用真实语料回放时响度和音质基本保持在微调水平,因此正式评测采用真实语料回放。多训 10,000 步微调几乎不改变任何指标,说明增益不是来自多跑步数。无回放的偏好训练在约 2,000 步后胜败样本去噪误差同时爆炸,最终无法生成可懂语音,原文推测偏好损失只约束两者之差,缺少锚点会让策略同时漂移。
扩散去噪损失 × 回放损失: 扩散去噪损失要求模型能从噪声恢复出干净语音潜变量,回放损失就是在偏好训练时继续保留这项原始去噪约束,偏好损失只约束好坏样本的相对差距,回放损失防止模型同时远离两者而丢失可懂度。
这些结论在什么条件下才成立
首先,客观增益依赖同一检测器打分,训练和评测用同一工具会高估效果,好在主观听测是独立证据,两者方向一致才支持有效性判断。其次,对比基线中 WordVoice 的重读实现是作者按小规模试听设定的固定音高能量时长偏移,并非该系统原生重读功能,Qwen3-TTS 不用参考音频而用内置音色,输入条件本就不完全相同,不能理解为同条件下的绝对胜负。
误重读率上本文方法并未最优,Fish-S2 更低,说明强调目标词的同时仍有约 30% 样本让人觉得其他词也被强调。分语言结论还受参考音频影响,英文参考配非英文文本时可能带来口音问题。此外,检测器在 7 种语言上训练,对日语等是零样本使用,阈值也对日中做了放宽,跨语言泛化能力仍依赖该检测器的质量。
要复现第一步该准备什么
复现应从数据和检测器开始,而不是直接调偏好损失。先准备多语言语音加文本,用现成检测器打出逐词分数并按 0.35 阈值生成带标记文本,保证文本和音素两侧标记一致,再按约 45% 带标记的比例混成监督微调集。基座是零样本潜扩散模型,文本用冻结 T5 编码,音频用冻结编解码器,训练时只更新扩散速度预测部分。
第二步用微调模型对每个输入采样 5 个带标记候选和 3 个不带标记基线,用同一检测器算提升和选择性并加权排序,取最高最低成对,再加字符错误率、质量分、相似度和削波过滤,得到数千对后做 10,000 步偏好训练,学习率 2×10⁻⁵,偏好系数 0.1,回放权重 0.1 且回放用真实语料。作者试听页当前可访问,但这只是第三方演示链接,不代表代码权重已公开,复现时不要假设有官方开源实现。
什么时候值得尝试还缺哪些验证
当已有扩散语音合成模型但没有重读标注,又希望用很少偏好数据快速加上单词级控制时,这个 2 阶段思路值得尝试。它的代价主要是采样和打分构造偏好对,以及 10,000 步的小规模偏好训练,推理流程不变,只是输入多了标记。
还缺的验证包括:换一个独立检测器或人工重标注来评测增益,以排除自训自评偏差;报告推理延迟和多目标词、长句等更复杂标记下的表现;测量真实部署中不同参考音频语言带来的口音影响。理解本文后可以复述的关键步骤是:检测器打伪标签起步,采样加复合分数构造好坏对,扩散偏好损失放大差距,真实语料回放保住音质。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses