📄 合成器几十个旋钮到底谁有用:扫一遍再用方差验一遍
英文题目:Automated Parameter Sensitivity Ranking in Audio Synthesis
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Ogulcan Kibar:机构信息未能在本次解析中与作者逐人可靠绑定
- Baris Ozcan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
现代软件合成器暴露几十个耦合控制,其中很多在常用工作点附近冗余或听感上惰性,设计者需要知道哪个旋钮真正改变声音。论文把归一化参数向量到音频片段的映射作为输入,输出参数按声音影响力的排序,难点是响度变化易伪装成音色变化,且单次度量难以自证排序属于乐器本身。所有渲染先经统一触发与响度归一:采用单音高A4、单力度、3秒片段并填充至144000采样后归一至-23 LUFS,消除增益混杂后输出仅保留结构变化的条件化音频。条件化音频接着转为五种频谱指纹图,扫描检验固定其余参数在0.5对目标参数做101点均匀扫描并度量偏离中心参考的距离得到分数,Sobol检验在同一锚点下用128点确定性Sobol序列激励同一参数并对堆叠指纹逐单元求方差后加和得到独立分数。与已有局部扰动或全局方差分解不同,该工作不估计一阶或全阶指数,只保留两种方法学独立的排序并以斯皮尔曼秩相关验证一致性。在K=128的log-STFT分数下四个确定性渲染引擎两种排序间的斯皮尔曼相关系数达0.823-0.961、p值均不大于7.2×10^-15,明显高于存在进程级渲染噪声的FluidSynth上同一指标的0.319,Sobol预算降至32点时确定性引擎上同一验证相关变化至多0.006。结论只在所测单音高、单力度、中点锚点附近成立,TorchSynth换至0.25与0.75锚点时扫描排序仅复现中点排序至ρ=0.50和0.58,双极性调制路由在中点近乎惰性而换锚后进入前十,静音端增益控制与渲染噪声引擎亦会失效,听感与降维尚未验证。原文未披露训练、推理或部署成本,本研究为一次性离线分析,共约66000次渲染。
🔗 开源与复现资源
- 第三方资源:https://www.fluidsynth.org — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
打开合成器为何先问哪个旋钮真有用
刚接触声音合成的研究生可以这样理解任务输入:输入是一个归一化到 0 到 1 的参数向量,输出是一段音频,目标是给每个参数的影响力排个序。现代软件合成器一打开就是几 10 个旋钮,论文以 TorchSynth 每音符 76 个参数为例,指出很多控制在常用工作点附近几乎听不出变化,还有不同参数组合得到相似声音的等效性,这让手动试错很费力。
如果有一个可靠排序,乐器设计者知道哪个控制值得放前面板,音色设计者知道探索精力投在哪里,自动搜索知道哪些维度可以冻结而不丢失声音版图。科学上的意义是,任何对控制空间做降维的前提都是先知道谁影响输出。但排序只有经过独立检验才可信,这正是本文要做的两件事:把合成器严格当黑盒测量每个参数的敏感度,再用方法上独立的第二个实验验证这个排序。
需要保留的信息是音色结构而非单纯响度,输出就是每个参数的分数与名次。本文不做降维后的质量验证,也不做听感实验,降维应用被明确列为下一步而非已报告的工作。
局部扰动与全局方差在音频里各解决什么
敏感度分析传统上有两条路线。局部 1 次一动的设计每次只动一个输入、其余固定,便宜且可解释,但只探测一个工作点且忽略交互。全局方差方法把输出方差归因到输入,常分解为 1 阶与总阶贡献,需要随输入数增长的采样代价。本文的不同在于不计算 1 阶或总阶指数,把 Sobol 序列当作逐参数的激励设计,用线性于参数数的代价换来两次可互相比对的排序。
比较合成音频的表示选择也不是中立的。波形域直接相减不可用,因为微小相移会造成巨大的逐采样差异,所以要在时频图或 MFCC、频谱质心等描述子上比较。但单一谱距离可能连基本音高差异都排错,只看 1 帧的谱图也会漏掉更长时间结构。近期参数恢复工作因此同时优化多个互补描述子。本文同样对每次激励计算 5 个互补指纹,并在框架两侧对称聚合,使排序不由单一表示决定。
音频内的敏感度研究以往多是局部准则加窄输出描述,例如萨克斯共鸣器的几何敏感度从解析推导读模态频率。本文则把乐器当作从 0 到 1 的向量到音频的黑盒映射,不需要内部结构,并用第二个独立测试验证排序而非直接报告未经检验的排序。
增益混淆与波形相移带来什么测量困难
音频带来两个具体障碍。第一是有些参数只改变响度,若在未归一化的音频上算距离,声音变大就会被误认为音色变了,纯音量旋钮会伪装成音色控制。第二是音频是时间序列,波形域逐点比较对相位极敏感,必须在时频表示上比较。
本文的回答是条件化加指纹。每段音频先补齐到 144000 采样,再按 EBU R128 归一化到 -23 LUFS 综合响度,低于 -70 LUFS 门限的静音则原样通过,使后续统计只对结构、频谱和时间变化响应。每个条件化片段再用 5 个指纹描述:对数 STFT、对数梅尔谱、MFCC、RMS 包络和频谱质心。
还有一个如实记录的后果:某端完全静音的参数,例如主音量转到 0,即使经过响度归一化,静音与有声仍是结构性差异,会保留为有影响。这不是归一化的漏洞,而是刻意保留的定义,后文 FluidSynth 的表情踏板就属于这类通过静音过渡拿到高分的情况。
两阶段先测后验的流程如何分工
整个框架可以沿一个样本走一遍:用 A4、MIDI 69、440 Hz、力度 64、1.0 s 音符放在 3.0 s 片段中触发合成器,得到 48 kHz 的 3 秒音频;先补齐长度并做响度归一化;再提取 5 个指纹;然后分别进入两个测试得到 Si 和 Vi;最后算 Spearman 秩相关验证排序一致性。两个测试共享条件化和指纹,只在参数激励策略与计分方法上不同。
下图是全文的总览,读图时先看自上而下的主链,再对比左右分支的差异,就能抓住测与验的分工。
看图路径: 1. 沿顶部触发条件向下看主链的先后顺序;2. 对比左右两个分支的输入激励与输出分数符号;3. 确认条件化与指纹是两分支共享的相同前处理
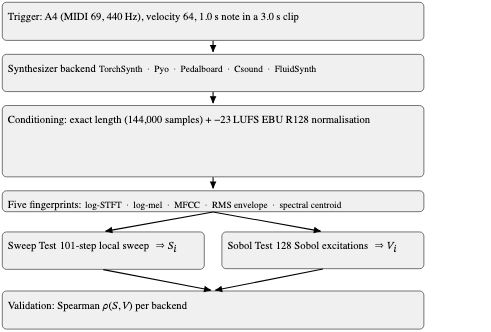
论文图 1。原论文 Fig. 1::“Overview of the framework.”。
该图确实可见从触发器经合成器后端、条件化、五指纹,再分叉为 101 步局部扫描得到 Si 和 128 次 Sobol 激励得到 Vi,最后汇合到每个后端的 Spearman 验证。它帮助理解为何后文说排序是合成器的属性而非方法的人为产物:若网格距离思路与准随机分散思路给出同一顺序,方法特异性的解释就站不住。
触发与响度条件化具体做了什么
实验触发全部统一:音高 A4,力度 64,1.0 s 音符开在 3.0 s 片段内,渲染率 48 kHz 共 144000 采样,留下 2.0 s 尾部以便观察释放与衰减。所有合成参数归一化到 0 到 1,背景参数固定在 0.5 作为中点基线。
条件化是强制步骤。先补齐到 144000 采样,这是 Sobol 测试逐单元方差计算的要求;再按 ITU-R BS.1770-5 定义的综合响度、EBU R128 流程归一到 -23 LUFS。低于门限的片段不提升,保持静音仍是静音。代价是每次渲染都要经过这一步,但它在源头去掉了增益混淆。
指纹计算相互独立。对数 STFT 用 1024 点 FFT、256 跳、Hann 窗取对数功率;对数梅尔谱用 128 个三角梅尔滤波器覆盖 20 到 8000 Hz;MFCC 取对数梅尔图的正交离散余弦变换前 40 系数;RMS 包络与频谱质心用同样 1024/256 分帧,前者是帧能量轨迹,后者是每帧幅度加权平均频率。前三者是 2 维图,后两者是 1 维轨迹,量纲不兼容,所以两侧测试都用同一两步配方合并:每个指纹的原始响应先在该后端内跨参数最小最大归一化,再五者等权平均。
响度归一化 × 五种频谱指纹: 响度归一化把每个片段统一到 -23 LUFS 以去掉纯音量差异的干扰,五种频谱指纹把波形转成可比较的时频与包络描述,两者分工是前者先消除增益混淆,后者再提供比较音色结构的基础,组合后统计量只对结构、频谱和时间变化敏感。
扫描测试如何算出偏离中间状态的分数
扫描测试回答直觉问题:把一个旋钮从当前补丁拧开,声音走多远。对第 i 个参数,其余固定在 0.5,该参数取 101 个均匀值 0.00、0.01 直到 1.00。扫描自身的中心片段即全局基线作为参考,对其余 100 个片段分别算 5 个标量偏离,再在扫描上平均,得到每个指纹的平均响应。
\[\bar{\delta}_{m}^{(i)}=\frac{1}{G-1}\sum_{g\neq\mathrm{ref}}\delta_{m}\!\left(\mathcal{G}(p^{(g)}),\,\mathcal{G}(p^{(\mathrm{ref})})\right).\]上式计算每个指纹 m 对参数 i 的平均响应:G 是 101 个网格点,g 遍历网格而 ref 是 pi 等于 0.5 的中心点,p(g) 是第 i 维取网格值、其余为 0.5 的完整向量,G 是合成加条件化流水线,δm 是两片段在该指纹下的标量偏离,对 2 维图用差图的 Frobenius 范数,对整体 RMS 与平均质心用绝对差。结果非负,强参数平均偏离大,弱参数接近零。
两个保障使它稳健。一是渲染噪声门:基线渲染两次,两次差异定义每指纹噪声基,若某指纹的扫描偏离从未超过 3 倍基则置零;确定性引擎基为零,门不起作用。二是跨指纹聚合保幅度:每个指纹先跨参数最小最大归一到相对尺度,再平均。
\[S_{i}=\frac{1}{|\mathcal{M}|}\sum_{m\in\mathcal{M}}\frac{\bar{\delta}_{m}^{(i)}-\min_{j}\bar{\delta}_{m}^{(j)}}{\max_{j}\bar{\delta}_{m}^{(j)}-\min_{j}\bar{\delta}_{m}^{(j)}}\;\;\in[0,1].\]上式中 j 遍历该后端全部 N 个参数,分式把参数 i 放在同行中的相对位置,外层对 5 个指纹等权平均,得到 0 到 1 的 Si。这是一种 1 次一动设计,精神上承自局部扰动传统。
Sweep Test × Sobol Test: Sweep Test 是局部一次只动一个参数、看偏离中间音色有多远的距离思路,Sobol Test 是固定其他参数、用准随机序列冲击该参数、看输出指纹分散程度的方差思路,两者输入激励和计分方式完全不同,搭配起来是为了互相验证排序是否属于合成器本身而非某种测量方法的偏好。
方差测试如何把准随机冲击变成输出方差
方差测试回答另一个直觉:给一个旋钮一族准随机冲击,它能变出多散的一族声音。同样其余固定在 0.5,被测参数取确定性 1 维 Sobol 序列的 128 个值,不加扰,所以每个后端每个参数收到完全相同的 128 个输入值,实验可精确再生。 下图先帮建立逐单元方差的几何图像,再对照公式理解求和范围。
看图路径: 1. 看每一行代表一个条件化后的片段指纹;2. 看红色框标出的同一单元如何纵向取方差;3. 看底部各单元方差求和得到 Vi 的汇合方式

论文图 2。原论文 Fig. 2::“Per-cell variance of the Sobol Test: each row is one of the K conditioned clips, variance is taken down each cell c, and the sum over cells gives V_i.”。
图中可见 K1 到 K128 每一行是 1 个条件化片段的指纹示意,红色框标出同一单元 c1,虚线箭头表示纵向跨堆叠取样本方差,底部把各单元方差相加得到 Vi。强参数的 128 张图互不相同,求和方差大;弱参数近乎复制,方差近零,这种逐格求和保留了时频位置信息。
\[V_{m}^{(i)}=\sum_{\mathrm{cells}\ c}\operatorname{Var}_{k=1..K}\!\left[\mathcal{F}_{m}^{(i,k)}(c)\right].\]上式中 c 遍历指纹的单元,2 维图的一个时频格或 1 维轨迹的 1 帧,k 遍历 128 个 Sobol 片段,F 是第 i 个参数第 k 个片段在该指纹单元 c 的值,Var 是跨 K 堆叠的无偏样本方差,分母 K 减 1。同样有双渲染基线方差基要减去,标题分数 Vi 取对数 STFT 方差,另有对称聚合的五图平均做法与 Si 完全镜像。
对数 STFT × 对数梅尔谱: 对数 STFT 是加对数的短时傅里叶幅度谱,保留细粒度时频结构,对数梅尔谱是经过 128 个梅尔滤波器合并的功率谱,更接近听觉频率尺度,两者在本文都作为二维图参与逐单元偏差或方差计算,互补是为了不让单一表示决定排序。
没有训练时实际计算与开销是什么
本研究没有训练任何神经网络,也没有更新合成器内部权重,需要说清的是实际执行的计算:固定种子 42,对每个后端每个参数分别渲染扫描的 101 个片段与 Sobol 的 128 个片段,再做条件化、指纹提取与统计。Sobol 序列不加扰且完全确定,TorchSynth、Pedalboard、Csound 逐比特一致,Pyo 丢弃 1 次预热渲染后也一致,只有 FluidSynth 存在跨进程渲染噪声。
总预算在论文中明确给出:扫描侧五引擎共 29088 次渲染,Sobol 侧共 36864 次渲染,完整分析约 66000 次渲染的 1 次性离线预算。每个 Sobol 条件化片段还导出为 16 比特 WAV 语料,连同结果表与运行日志作为补充材料提供。无训练不等于输出确定,参数冻结也推不出跨进程确定,这正是 FluidSynth 后文失配的根源。
MFCC × 频谱质心: MFCC 是对数梅尔谱再做离散余弦变换取前 40 个系数得到的紧凑音色描述,频谱质心是每帧幅度加权平均频率得到的亮度标量,前者刻画包络形状,后者刻画整体明暗,本文把它们与 RMS 包络一起纳入五指纹平均,避免只用频谱图漏掉长时间包络信息。
五个合成器与参数规模如何保证同循环
5 个引擎都接受归一化向量,保证同一分析循环无需分支。TorchSynth 是 TorchSynth Voice 的 PyTorch 重实现,N 等于 76,支持批量渲染;Pyo 是 Python DSP 服务,N 等于 56,含双振荡器、滤波器、包络、LFO、混响合唱延迟失真;Pedalboard 基于 Spotify Pedalboard 库的 DSP 处理链,N 等于 56,模块集与 Pyo 相同;Csound 是运行时从 CSD 模板编译的乐队乐器,N 等于 52;FluidSynth 是 SF2 SoundFont 渲染器,50 中分析 48,两个电平属性按 64/127 固定并排除,用大钢琴预设、MIDI 控制器与发生器覆盖驱动。
触发与条件化全引擎一致,随机种子固定,Sobol 完全确定。FluidSynth 的特殊性在于跨进程可重复性不一致:扫描进程记录到对数 STFT 图上 218 的非零渲染间基,5 天后两次运行 3 位有效数字相同,说明可重复而非随机抖动;而 Sobol 进程的基在所有预算下恰为零。两个保障因此不对称:扫描门有真实基可作用,Sobol 基减去零,这种不对称直接导致后文两测试在该引擎上的分歧。
扫描与方差各自把谁排在前面
先看扫描侧的累积分布,它回答大控制空间是否大多惰性。下图横轴是取排名前多少参数,纵轴是累积分数占比,虚线是 90% 总量,圆点是各引擎到达处。
看图路径: 1. 先看横轴取排名前多少个参数纵轴累积占比;2. 对比五条曲线的爬升速度与 90% 虚线交点位置;3. 注意 FluidSynth 与 Pyo 的陡峭和另两条的平缓差异

论文图 3。原论文 Fig. 3::“Cumulative share of the total Sweep Test score in rank order. Dashed line: 90% of the total; markers: where each engine reaches it.”。
该图确实可见 Pyo 与 FluidSynth 曲线陡峭,不到 5 个控制就占 90% 总量,TorchSynth 在 26 个到达 90%,而 Pedalboard 与 Csound 爬升平缓得多,需要 30 多个才能覆盖同样份额。这说明能省掉多少控制是乐器自身属性,不能跨引擎搬运排名。TorchSynth 有 24 个参数在中点锚点测得零变化,也支持同一判断。
下表是 TorchSynth 前 15 名的双视角对照,左为扫描分数 Si,右为方差 Vi,比较问题是同一引擎内距离思路与分散思路是否指向同一批控制。表前条件是同一触发、同一条件化与同一指纹集,指标方向都是越大越敏感。
| by Sweep Test SiS_{i} | by Sweep Test SiS_{i} | by Sweep Test SiS_{i} | by Sobol Test ViV_{i} | by Sobol Test ViV_{i} | by Sobol Test ViV_{i} |
|---|---|---|---|---|---|
| Rank | Parameter | \(S_{i}\) | Rank | Parameter | \(V_{i}\) |
| 1.5 | env-1 release | 0.92 | 1.0 | osc-2 tuning | 491 809 |
| 1.5 | env-2 release | 0.92 | 2.5 | env-1 release | 436 892 |
| 3.5 | LFO-1 level env rel. | 0.72 | 2.5 | env-2 release | 436 892 |
| 3.5 | LFO-2 level env rel. | 0.72 | 4.0 | osc-2 mod depth | 436 844 |
| 5.0 | osc-2 tuning | 0.68 | 5.5 | LFO-1 level env rel. | 307 692 |
| 6.0 | osc-2 mod depth | 0.60 | 5.5 | LFO-2 level env rel. | 307 692 |
| 7.0 | osc-1 tuning | 0.24 | 7.0 | mixer noise level | 147 049 |
| 8.0 | osc-1 mod depth | 0.23 | 8.0 | mixer osc-2 level | 48 961 |
| 9.0 | osc-2 initial phase | 0.23 | 9.0 | osc-2 shape | 21 661 |
| 10.0 | osc-1 initial phase | 0.21 | 10.0 | osc-2 initial phase | 18 907 |
| 11.0 | mixer osc-2 level | 0.19 | 11.0 | osc-1 mod depth | 16 802 |
| 12.0 | mixer noise level | 0.17 | 12.0 | osc-1 tuning | 13 915 |
| 13.0 | mixer osc-1 level | 0.11 | 13.0 | osc-1 initial phase | 13 290 |
| 14.0 | osc-2 shape | 0.08 | 14.5 | env-1 attack | 11 040 |
| 15.5 | mod: env-1 to osc-1 amp | 0.07 | 14.5 | env-2 attack | 11 040 |
表后解释需要抓住重排而非推翻:方差把振荡器 2 调谐与调制深度推到第 1 到 2 名,因为音高偏移同时搬移大量时频单元,逐单元方差天然大,而包络释放紧随其后排 3 到 6 名。两测试的头部仍是同一批人,只是连续量中调谐在方差视角更占便宜。限制是名次依赖工作点,中点锚点与尾部长度会影响释放与调谐的相对位置。
Spearman 秩相关 × 渲染噪声门限: Spearman 秩相关只比较两次排序的顺序一致性而不比较绝对分值,渲染噪声门限是用基线重复渲染两次的差异估计测量噪声并清零不显著响应,两者搭配的意义是先滤掉噪声造成的假敏感,再用秩相关判断两种独立激励是否给出同一注意力顺序。
相同音乐功能在不同引擎中一样敏感吗
再看跨引擎同功能对比,比较问题是相同音乐功能在不同实现中是否同样敏感,条件是同一触发与归一化流程,指标是 Si 值越大越敏感并附带排名。
| Function | TorchSynth | Pyo | Pedalboard | Csound | FluidSynth |
|---|---|---|---|---|---|
| Amp-env release | 0.92 (1) | 0.95 (1) | 0.29 (7) | 0.00 (46) | 0.00 (22) |
| Amp-env attack | 0.06 (21) | 0.03 (9) | 0.02 (45) | 0.22 (8) | 0.00 (47) |
| Filter cutoff | — | 0.03 (8) | 0.42 (2) | 0.37 (3) | 0.03 (6) |
| Filter mode/type | — | 0.60 (2) | 1.00 (1) | 1.00 (1) | — |
| Delay mix | — | 0.29 (4) | 0.31 (4) | 0.26 (5) | — |
| Master tune | 0.68 (5) | 0.00 (22) | 0.31 (5) | 0.37 (2) | 0.00 (43) |
| Master volume | — | 0.03 (7) | 0.02 (44) | 0.00 (44) | 0.42 (2) |
表后可见趋同在敏感端:有离散滤波模式开关的三引擎都把它放顶部,靠幅度包络塑尾的两引擎把释放放第 1。分歧在迟钝端更为明显:TorchSynth 是调制矩阵路由,Pyo 是混响几何,Pedalboard 与 Csound 是调制包络与键跟踪,FluidSynth 是大钢琴预设下听不见的 SF2 发生器覆盖。教训是敏感度是实现与工作点的属性,不是参数标签的属性,因此排名不能跨合成器直接迁移。
两次排序的一致性在什么条件下成立
验证用 Spearman 秩相关比较 S 与 V 两张名单,相同分数按平均秩处理,大秩差只标记供试听检查而不丢弃。下表整理论文报告的总体相关,比较问题是独立激励是否收敛到同一顺序,条件是 K 等于 128 的对数 STFT 分数,方向是越接近 1 越一致。
| 条件 | 指标 | TorchSynth | Pedalboard | Pyo | FluidSynth |
|---|---|---|---|---|---|
| K 为 128,对数 STFT 分数 | Spearman 秩相关 | 0.96 | 0.92 | 0.82 | 0.32 |
表后解释要按确定性分情况。4 个确定性引擎分别约 0.96、0.92、0.87 和 0.82,p 值极小,Pedalboard 与 Csound 的两测试头名完全相同,TorchSynth 与 Pyo 的各自头名落在对方前二,说明顺序是合成器属性。用五图对称聚合替代标题分数后结论不变,Csound 与 Pedalboard 还有所加强,因此结论不依赖单一指纹。FluidSynth 仅 0.32 左右,原因已定位而非散点不明,下节结合特例表展开。
下图是 TorchSynth 头名随参数变化的直观证据,读图任务是确认分数有可见的声学对应而非数字游戏。
看图路径: 1. 从左到右看 p 从 0.00 到 1.00 五个面板的尾部延长;2. 对比低频基频条带与高频谐波的持续时间变化;3. 注意中间 p 等于 0.50 面板即扫描参考点的含义

论文图 4。原论文 Fig. 4::“TorchSynth — rank-1 parameter: envelope-1 release (adsr1.release, S_i=0.92).”。
5 个面板确实可见包络 1 释放从 0.00 到 1.00,衰减尾逐步向完整 3 秒延长,基频与谐波条带持续时间同步变长,与头部地位一致。补充材料中另 4 个引擎的条带与各自量化故事相符,FluidSynth 面板间差异被判定为引擎渲染噪声而非参数响应,这与音频语料的比特一致性审计相互印证。
哪些特例能同时说明一致与例外
为同时抓住一致与例外,论文挑出 10 个特别值得看的参数,比较问题是头部一致的典型与尾部失配的诊断各长什么样,条件仍是同一触发与条件化,指标是 Si 值与双排名。
| Engine | Parameter | Identifier | \(S_{i}\) | SS-rank | VV-rank |
|---|---|---|---|---|---|
| Pedalboard | filter mode | flt.mode | 1.00 | 1 | 1 |
| Csound | filter type | flt.type | 1.00 | 1 | 1 |
| TorchSynth | envelope-1 release | adsr1.release | 0.92 | 1 | 3 |
| TorchSynth | osc-2 tuning | vco2.tuning | 0.68 | 5 | 1 |
| Pyo | amp-env release | amp.release | 0.95 | 1 | 2 |
| Pyo | delay time | del.time | 0.22 | 5 | 42 |
| FluidSynth | mod-env sustain | gen.mod_sustain | 1.00 | 1 | 34 |
| FluidSynth | expression | cc.expression | 0.42 | 2 | 1 |
| TorchSynth | LFO-1-env attack | lfo1_amp.attack | 0.03 | 40 | 22 |
| Csound | chorus rate | cho.rate | 0.14 | 20 | 4 |
表后先说一致侧:Pedalboard 滤波模式与 Csound 滤波类型都是 Si 等于 1.00 且双排名 1 对 1,TorchSynth 包络 1 释放 Si 等于 0.92 而秩为 1 对 3,振荡器 2 调谐 Si 等于 0.68 而秩为 5 对 1,Pyo 放大释放 1 对 2,这些都属于同一批头部互换。再说例外侧:Pyo 延迟时间扫描第 5 而方差第 42,Csound 合唱速率 20 对 4,属于方法视角差异放大的中部参数。FluidSynth 调制包络是标志性离群,其 128 个 Sobol 导出片段比特完全相同,顶部扫描分对应零音频变化,偏差来自扫描进程的引擎噪声越过单基线对估计的门。
去掉指纹与响度后排序还稳吗
4 个检查探测排序是否依赖个别设计。逐个去掉一个指纹的最坏情况,在确定性三引擎上扫描排序保持 0.967 以上,聚合方差排序 0.938 以上,验证本身 0.919 以上,说明无单一指纹决定排名。用百分位与秩缩放重建 Si,与最小最大排名的相关在比特确定引擎上 0.975 以上,排序不是归一化人为产物。
去掉响度条件化后整体顺序仍在 0.90 到 0.99,但增益族被抬到顶部,Pedalboard 主音量在扫描从 44 到 11、Sobol 从 47 到 7,这从实证上演示了增益混淆。预算收敛方面,扫描网格 26 与 51 复现 101 网格达 0.998 与 0.9995,Sobol 从 128 降到 32 使确定性引擎的验证相关至多动 0.006,可用 1/4 成本运行。只有 FluidSynth 随预算乱动,这本身就是引擎非确定性的廉价诊断。
未胜出项也要保留:Pyo 在部分消融中验证降到 0.711,FluidSynth 验证在指纹消融下仅 0.287,说明非确定引擎的尾部本身不稳,不能把整体趋势推广到每一参数。
单工作点与单音符限制了什么外推
两测试都把背景锚在 0.5,报告的是 1 次一动在单一工作区域的敏感度,不捕捉交互与远离该锚的行为,这是此类设计的结构属性。锚点消融量化了代价:TorchSynth 背景改到 0.25 与 0.75 重做扫描,与中点排名仅 0.50 与 0.58 相关,起因是双极调制路由在 0.5 为中性点而测得零,一旦锚移动就进入前十。因此排名刻画的是一个工作区域而非乐器整体,研究还只用单一音高、力度与音长。
增益族的静音极端效应使采样乐器的音量类参数可仅凭静音过渡登顶,发布结果因此带语料级检测器与平行音色排序。渲染噪声基来自单基线对,在跨进程非确定引擎上脆弱,汇总 3 对基可使伪影消失,调制包络从第 1 落回惰性块、表情控制器成为实测头名,但验证仅升到 0.37,因为新进程噪声重画低方差尾,单轮内估计的门来不及吸收。这界定了补救的上限。
复现第一步该固定什么与跑多少
值得尝试的时机是面对陌生合成器或效果器、想先拿到注意力地图再决定面板、宏控制或冻结维度,且能接受离线批量渲染。复现第一步不是调参,而是锁死触发与条件化:A4、力度 64、1 秒音符在 3 秒片段、48 kHz、补齐 144000 采样、归一到 -23 LUFS,背景全 0.5,种子 42,Sobol 不加扰。
关键超参与信息条件要保留:扫描 101 步、Sobol 128 点,指纹用 1024 点 FFT、256 跳、Hann 窗、128 梅尔滤波器 20 到 8000 Hz、MFCC 前 40 系数,聚合用跨参数最小最大加等权平均,验证用 Spearman 平均秩。预算按参数数线性增长,76 参数约 76 乘 229 次渲染,论文五引擎总量约 66000 次。
来源方面,FluidSynth 官网链接在论文中被提及且本次可达,但这只证明论文提到该第三方链接,不证明作者已开源。作者脚本与语料指向论文第七节的仓库链接,是否当前可用需自行确认,不能把来源未确认当技术缺陷。还需要补的验证是多音高多锚点、交互设计、听感与任务验证,以及替代指纹的对比。
一句话总结与何时用何时慎用
综合来看,减法合成器单旋钮最大变化多是类别型而非连续型,有滤波模式开关的引擎它都饱和登顶,连续量中包络释放主导当前补丁偏离、调谐主导方差视野,因为音高搬移整片时频能量。对声音设计,排名是注意力地图,TorchSynth 前 26 名占 90%,Pyo 仅 5 名而 Pedalboard 要 34 名,可缩减程度因引擎而异,被丢弃控制是否听感可忽略仍是未测的听力问题。
方法上固定等权指纹牺牲自适应,换来跨引擎跨研究可比且无超参可调,黑盒假设使它可原样搬到放大器建模等新对象,增益混淆最强处反而最有用。慎用条件同样明确:只在中点工作区、单音符、确定性渲染下强一致成立,换锚、换音符或遇进程噪声时需重测并配语料审计,不能把一处排名搬到另一台合成器。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses