共分析 25 篇论文
⚡ 今日概览
✅ 筛选入选 25 篇 → 🔬 深度分析完成
每篇论文保留完整分层分类;热门方向按主任务的最上级方向统计,每篇计入 1 个方向。排行榜也显示最上级任务。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| 语音识别 | 3 篇 | ███ |
| 音频理解 | 3 篇 | ███ |
| 语音交互 | 2 篇 | ██ |
| 语音增强 | 2 篇 | ██ |
| 音频分离 | 2 篇 | ██ |
| 音频编辑 | 2 篇 | ██ |
| 统一多模态检索 | 1 篇 | █ |
| 视频社会状态推理 | 1 篇 | █ |
📊 论文评分排行榜(25 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 从 YouTube 字幕到说话人分段语料:Lipi-Ghor 如何为孟加拉语建 885 小时语音库
评分:7.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Sanjid Hasan:机构信息未能在本次解析中与作者逐人可靠绑定
- A H M Fuad:机构信息未能在本次解析中与作者逐人可靠绑定
- Risalat Labib:机构信息未能在本次解析中与作者逐人可靠绑定
- Bayazid Hasan Simon:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
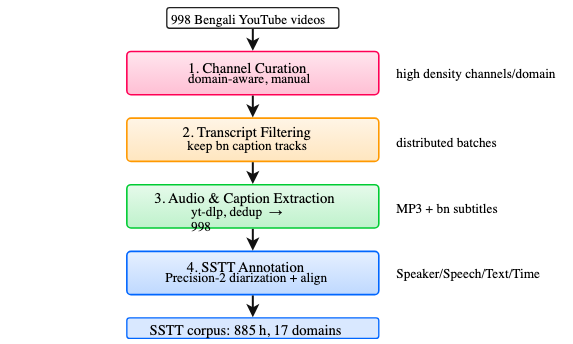
读者需要理解的对象是孟加拉语真实语音的自动转写,输入是平均约52分钟的YouTube长音频与孟加拉语字幕轨,输出是带说话人编号、起止时间和转写文本的分段记录,困难在于方言、情感戏剧、语码混用和高说话人密度。处理过程沿四个阶段串行:按17个域人工挑选频道,再用字幕可用性过滤保留带bn轨的视频,接着并行分批抓取音频与字幕并去重,最后用说话人分离模型切分说话人回合并与字幕对齐成SSTT记录。相对已有短句朗读语料,该工作同时提供训练规模、长音频和说话人归属,并公开可复用的构建流程与金标准校对集。该流程把人工频道筛选与自动说话人分离衔接,使字幕文本落到说话人回合上,便于直接用于识别训练。在以YouTube字幕为参考的Lipi-Ghor同一评测下,零样本Hishab TITU Conformer-L的词错误率为30.51%,经约58小时本域数据微调后的Faster Whisper Medium词错误率为20.70%,后者低于前者,显示弱监督数据仍有训练价值。人工校对的金标准分开存放,用于检验字幕噪声而不参与训练。结论适用于有字幕覆盖的公开YouTube域,对无字幕方言和三人以上重叠语音尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/Sanjidh090/Lipi-Ghor-bn-882-SSTT — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 把带时间戳的声音描述拆成可组合的函数

英文题目:TAC2: Timestamped Audio Captioning as composable functions
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Swapnil Bhosale:机构信息未能在本次解析中与作者逐人可靠绑定
- Prem Seetharaman:机构信息未能在本次解析中与作者逐人可靠绑定
- Ke Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Haonan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Justin Salamon:机构信息未能在本次解析中与作者逐人可靠绑定
- Zeyu Jin:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要理解的对象是野外音频中同时发生的声音事件、说话人轮次与语音韵律,困难在于三者相互重叠且缺少大规模人工时间标注,目标是输出带说话人归属、可查询的时间线。TAC2先用声音事件检测、说话人分离标注与字幕模型三路弱教师在共享时间轴上做交并比匹配,拼出带说话人归属的目标,再把完整描述拆成指令-输入-输出补全任务分别训练。与一次生成固定描述的已有带时间戳字幕方法不同,空输入时单次直接解码完整时间线,也能把前序输出或外部转写作为输入条件进行多遍级联调用。TAC2-S在冻结骨干上为重音、情感、声音画像等属性训练注意力部分的低秩适配specialists,引出潜藏的韵律感知,再回标全库并蒸馏为统一学生。在带真值标签的属性评测中,词重音首词准确率从冻结骨干的0.60升至specialist的0.81,情感五分类准确率从0.15升至0.59。在300个留出英文片段的文本到音频重建评测中,以定位器峰值间平均绝对偏移为时间误差,TAC2-S的PE误差为1.54s,低于PicoAudio2的2.47s。结论适用于30s以内英文为主的会话与事件混合音频,长音频需分块拼接,对非语音与音乐覆盖较弱。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://swapb94.github.io/tac2-audio-describer/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 一个向量空间装下文本图像视频音频:EmbeddingGemma 2 解读

英文题目:EmbeddingGemma 2: Unified and Efficient Multimodal Representations
评分:7.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Henrique Schechter Vera:机构信息未能在本次解析中与作者逐人可靠绑定
- Sahil Dua:机构信息未能在本次解析中与作者逐人可靠绑定
- Jovan Andonov:机构信息未能在本次解析中与作者逐人可靠绑定
- Sara Smoot:机构信息未能在本次解析中与作者逐人可靠绑定
- Sebastian Russo:机构信息未能在本次解析中与作者逐人可靠绑定
- Ivan Llanos:机构信息未能在本次解析中与作者逐人可靠绑定
- Max Matveev:机构信息未能在本次解析中与作者逐人可靠绑定
- Jae Hyeon Yoo:机构信息未能在本次解析中与作者逐人可靠绑定
- Kat Black:机构信息未能在本次解析中与作者逐人可靠绑定
- Shih-Cheng Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Josiah Aklilu:机构信息未能在本次解析中与作者逐人可靠绑定
- Maarten Grootendorst:机构信息未能在本次解析中与作者逐人可靠绑定
- Omar Sanseviero:机构信息未能在本次解析中与作者逐人可靠绑定
- Chandramouli Amarnath:机构信息未能在本次解析中与作者逐人可靠绑定
- Ian Ballantyne:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhe Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Daniel Salz:机构信息未能在本次解析中与作者逐人可靠绑定
- Ibrahim Alabdulmohsin:机构信息未能在本次解析中与作者逐人可靠绑定
- Ilya Philippov:机构信息未能在本次解析中与作者逐人可靠绑定
- Kristen Quan:机构信息未能在本次解析中与作者逐人可靠绑定
- Glenn Cameron:机构信息未能在本次解析中与作者逐人可靠绑定
- Edouard Yvinec:机构信息未能在本次解析中与作者逐人可靠绑定
- Luciano Martins:机构信息未能在本次解析中与作者逐人可靠绑定
- Doug Reid:机构信息未能在本次解析中与作者逐人可靠绑定
- Sindhu Raghuram Panyam:机构信息未能在本次解析中与作者逐人可靠绑定
- Weiyi Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Hengxuan Ying:机构信息未能在本次解析中与作者逐人可靠绑定
- Madhuri Shanbhogue:机构信息未能在本次解析中与作者逐人可靠绑定
- Tanmaya Dabral:机构信息未能在本次解析中与作者逐人可靠绑定
- Shanfeng Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Juyeong Ji:机构信息未能在本次解析中与作者逐人可靠绑定
- Renjie Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Joe Zou:机构信息未能在本次解析中与作者逐人可靠绑定
- Xu Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunan Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu-Hui Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Matthew Soulanille:机构信息未能在本次解析中与作者逐人可靠绑定
- Vinod Mamillapalli:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi-Chun Kuo:机构信息未能在本次解析中与作者逐人可靠绑定
- Wai Hon Law:机构信息未能在本次解析中与作者逐人可靠绑定
- Matt Kreileder:机构信息未能在本次解析中与作者逐人可靠绑定
- Alice Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Suril Shah:机构信息未能在本次解析中与作者逐人可靠绑定
- Mogan Shieh:机构信息未能在本次解析中与作者逐人可靠绑定
- Pooja Consul:机构信息未能在本次解析中与作者逐人可靠绑定
- Alberto Montes:机构信息未能在本次解析中与作者逐人可靠绑定
- Andreas Hess:机构信息未能在本次解析中与作者逐人可靠绑定
- Andres Sevilla:机构信息未能在本次解析中与作者逐人可靠绑定
- Babak Samari:机构信息未能在本次解析中与作者逐人可靠绑定
- Brendan McCloskey:机构信息未能在本次解析中与作者逐人可靠绑定
- Brian Potetz:机构信息未能在本次解析中与作者逐人可靠绑定
- Daniel Cer:机构信息未能在本次解析中与作者逐人可靠绑定
- Georgios Kathareios:机构信息未能在本次解析中与作者逐人可靠绑定
- Gustavo Hernández Ábrego:机构信息未能在本次解析中与作者逐人可靠绑定
- Hesen Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ji Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiaxing Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Keegan Mosley:机构信息未能在本次解析中与作者逐人可靠绑定
- Paul Suganthan:机构信息未能在本次解析中与作者逐人可靠绑定
- Rui Meng:机构信息未能在本次解析中与作者逐人可靠绑定
- Shen Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Shengcao Cao:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi-Ting Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yichang Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhongli Ding:机构信息未能在本次解析中与作者逐人可靠绑定
- Kendra Byrne:机构信息未能在本次解析中与作者逐人可靠绑定
- Cormac Brick:机构信息未能在本次解析中与作者逐人可靠绑定
- Olivier Lacombe:机构信息未能在本次解析中与作者逐人可靠绑定
- Qin Yin:机构信息未能在本次解析中与作者逐人可靠绑定
- Tris Warkentin:机构信息未能在本次解析中与作者逐人可靠绑定
- Armand Joulin:机构信息未能在本次解析中与作者逐人可靠绑定
- Tom Duerig:机构信息未能在本次解析中与作者逐人可靠绑定
- Mojtaba Seyedhosseini:EmbeddingGemma Team, Google
📌 核心摘要
读者需要理解的对象是能把一句话、一张图、一段语音或一段视频都变成同一个空间中固定长度向量的模型,困难在于不同模态长度和细节差异很大,混合输入还要保留跨模态的对应关系,处理过程是先把各模态变成同一维度的记号序列,再由共享变换器压缩成一个单位长度向量。模型先用文本蒸馏打底,再用多模态蒸馏继承教师的共享空间,最后改用对比学习塑造适合自身维度的空间,三个阶段按模态和目标推进。输入记号经过双向注意力、平均池化(平均池化指对序列上所有位置的输出向量求平均,得到单个向量)、线性投影和归一化后输出最终向量,中间还有逐层嵌入提供来自输入的残余信息。与已有工作相比,论文省去了逐层嵌入专用的查表,训练时同时更新视觉编码器,并保留了可截断维度和量化检查点,实际意义是手机等受限设备也能按需加载文本、视觉或音频部分。在代码检索评测MTEB(Code)上以Mean(Task)任务平均为指标,该模型以271M文本参数取得78.68分,高于同表同指标下EmbeddingGemma 1的68.76分,数值越大越好。结论在已评测的检索、分类、问答和时刻定位等任务上成立,英文文本小幅回退、部分副语言零样本聚类偏弱等边界仍存在。论文报告共使用约2.9T记号训练,在Google Pixel 11 Pro上Q4_C量化推理时以峰值内存为指标,全模态为567 MB,高于同条件下文本单模态的191 MB。
🔗 开源资源
第三方资源:https://ai.google.dev/gemma/docs/embeddinggemma — 链接可访问(HTTP 200)
模型相关资源:https://ai.google.dev/gemma/docs/embeddinggemma — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. 点一下脸就换人听:流式视听目标说话人提取的即时切换

英文题目:Tap2Listen: Instant Target Switching for Streaming Audio-Visual Speaker Extraction
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hansol Park:机构信息未能在本次解析中与作者逐人可靠绑定
- Minkyung Song:机构信息未能在本次解析中与作者逐人可靠绑定
- Zinu Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- Yujun Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Hoseong Ahn:机构信息未能在本次解析中与作者逐人可靠绑定
- Hyunjin Choi:机构信息未能在本次解析中与作者逐人可靠绑定
- Kyuhong Shim:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
流式音视频目标说话人提取的输入是多人混合语音与选定人脸的唇部和身份线索,输出是只保留选定说话人的实时波形,难点是已有系统把音频与视觉耦合处理并累积目标相关的循环状态,切换后旧状态难以消退。Tap2Listen先让因果音频编码器只处理混合声的16 ms窗、8 ms跳STFT帧,经256维投影与6个局部因果注意力块形成共享时序缓存,该缓存跨切换保留;冻结视觉前端持续缓存各人脸25 Hz唇部特征与身份向量,解码时把缓存音频表征与选定人脸唇部特征拼接投影为注意力记忆,把身份向量叠加进解码查询,再经4个交叉注意力块与共享掩膜头输出复数比掩膜并经逆STFT重建波形,切换时只对缓存窗口重做该记忆投影并替换身份项。训练时每个混合对各说话人轮流作目标并为每个解码块做深度监督提取损失,同时用只依赖混合声的五帧后对数幅度变化预测辅助损失约束编码器。在LRS3-2mix的3000条固定混合测试上,Tap2Listen相对AV-SkiM基线在相同量级参数下将SI-SNRi从8.85 dB提高到9.68 dB。切换到已缓存人脸时首个200 ms窗口即达完整质量,而基线约需1 s恢复;新出现人脸切换后首1 s内平均领先8.08 dB。训练开销为单张NVIDIA RTX 3080上150轮共28 GPU-h,推理在Galaxy S22单大核CPU上每8 ms帧处理p95为3.2 ms,切换重投影p95为5.2 ms、加当前帧共8.5 ms,算法延迟16 ms。上述结论限于双人混合与重建的无切换、已知脸切换和新人脸切换划分,且仅测试集说话人无关,新人脸原始种子不可用故均在同一重建混合上比较,未验证多人、强噪声与长时视觉缺失下的切换。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. 声纹只是观察:多人语音智能体如何在线维护用户实体与记忆

英文题目:From Voiceprints to User Entities: Online Speaker-Memory Construction for Multi-User Spoken Agents
评分:7.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yucong Zhang:School of Artificial Intelligence, The Chinese University of Hong Kong, Shenzhen;Meituan
- Cancan Li:Meituan
- Bo Xiao:Meituan
- Ke Zeng:Meituan
- Ming Li:School of Artificial Intelligence, The Chinese University of Hong Kong, Shenzhen
📌 核心摘要
多用户语音助手需在听到当前语音轮次时先判定说话人身份,再把内容写入该用户记忆,若路由错误会导致同一人历史碎裂或不同用户记忆混入,且录音条件随时间漂移会使固定声纹模板失效。论文将按时间到达的语音轮次按因果顺序处理,每轮先提取声学嵌入并与已有用户实体的声学中心比对,输出链接到某实体或新建实体的判定,该判定直接确定该轮次归属的实体分区。归属确定后,被接受轮次的声学嵌入经门控判断是否用于更新对应实体的声学中心,更新后的中心又作为后一轮次比对的模板,以跟踪漂移的录音条件。同一轮次的转写文本经事实抽取写入上述归属分区,查询时先用查询语音匹配实体,再只在该实体分区内检索作答,从而把路由错误与记忆混入隔离开。与默认历史已正确归属的已有记忆基准不同,该工作把在线建实体、更新声学中心、分区写读连成完整链路。在LoCoMo-ID身份门控问答准确率上,门控更新在干净语音与条件偏移下分别为75.27%和71.77%,高于固定表示的71.41%和60.15%。适用范围限于两到四说话人的合成对话与仿真录音变化,真实重叠对话与长期部署效果尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://anonymous.4open.science/r/EvoSpeakerMem-4AF1 — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/anonymous-user428/LoCoMo-ID — 暂时无法访问
第三方资源:https://anonymous-user428.github.io/evo-speaker-mem-demo → https://anonymous-user428.github.io/evo-speaker-mem-demo/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-TTS-12Hz-1.7B-VoiceDesign — 暂时无法访问
第三方资源:https://huggingface.co/Qwen/Qwen3-TTS-12Hz-1.7B-Base — 暂时无法访问
第三方资源:https://www.openslr.org/156 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. 自己给自己打分:AudioRSI 如何让音频模型边推理边当裁判

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jiajun Fan:机构信息未能在本次解析中与作者逐人可靠绑定
- Roger Ren:机构信息未能在本次解析中与作者逐人可靠绑定
- Jingyuan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Rahul Pandey:机构信息未能在本次解析中与作者逐人可靠绑定
- Prashanth Gurunath Shivakumar:机构信息未能在本次解析中与作者逐人可靠绑定
- Ankur Gandhe:机构信息未能在本次解析中与作者逐人可靠绑定
- Yile Gu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ge Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ivan Bulyko:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是音频问答:输入一段录音、一个自然语言问题和四个候选答案,模型要先写出推理过程再给出答案,难点是只奖罚最终答案时,瞎猜和扎实分析得分相同,模型学不到怎样推理。AudioRSI让同一模型分饰两角:做行动者(英文actor)时采样多条推理路径,做批判模型(英文critic)时听着同一段录音比较两条路径谁的推理更贴合声音证据,胜平负映射为过程奖励并与结果奖励相加后送入分组相对策略优化。批判模型在周期内冻结以保持奖励稳定,每隔T步再用当前行动者替换,使评判标准随能力上升,替换前检查小批量结果准确率没有倒退。相对已有方法,关键差异是奖励不再来自外部固定判分器或人工过程项,而是在一次训练内部递归更新。在MMAU test-mini上按同一评测协议比较准确率,AudioRSI以76.10%超过结果奖励复现基线Ke-Omni-R的74.60%,并伴随结构化推理行为增多。结论限于Qwen2.5-Omni-7B基座和AVQA音频训练,分布外泛化只在四个基准上验证,感知子能力和过长同步周期下效果会打折,跨基座与跨数据尚未验证。原文未披露训练、推理或部署成本以外的完整开销,只报告8卡NVIDIA H200上6400步需3-4天。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. SMEBench:用合成的 MIDI 编辑为音乐编辑建立成对评测

英文题目:SMEBENCH: Benchmarking Neural Music Editing with Synthetized MIDI Edits
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Matthieu Cervera:机构信息未能在本次解析中与作者逐人可靠绑定
- Francesco Paissan:机构信息未能在本次解析中与作者逐人可靠绑定
- Micael Antunes:机构信息未能在本次解析中与作者逐人可靠绑定
- Mirco Ravanelli:机构信息未能在本次解析中与作者逐人可靠绑定
- Ricard Marxer:机构信息未能在本次解析中与作者逐人可靠绑定
- Cem Subakan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是音乐编辑,输入是一段原音频加一条文字编辑要求,输出是一段应改动指定属性又保留其余内容的新音频,困难在于没有已知正确结果时难以区分保持得好、文字相似度高与真正改对。论文从符号音乐出发,先裁剪 10 秒片段并判断适用操作,再对音符、声部或力度施加已知干预,然后用同一音色库渲染源与目标,最后生成指令与描述文本并过滤低质量样本。一个样本的文字指令进入编辑系统,系统输出音频再分别与源音频和配对目标比较,从而分离保持度与目标一致性。与以往只有源提示而无配对目标的评测相比,该做法把编辑正确性变成可核对的参照问题。在 3,600 例测试上,编辑描述条件下的目标音频相似度指标中 SteerMusic 达到对比语言音频预训练(Contrastive Language-Audio Pretraining,CLAP)音频相似度 0.691,为同条件六个系统最高,而文字兼容性指标却偏向 MusicGen 的 0.350,说明换指标会换排名。结论适用于 12 种乐器、发音、力度与音高操作的可控合成情形,真实录音、演唱、混音与风格迁移尚未覆盖。原文未披露训练、推理或部署成本。
🔗 开源资源
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. 边听边翻:语义对齐如何教模型决定何时开口

英文题目:S3-S2ST: Semantically Supervised Streaming Speech-to-Speech Translation
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Yuxiang Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhiyun Fan:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Pu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yanjie An:机构信息未能在本次解析中与作者逐人可靠绑定
- Yushen Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenrui Liang:机构信息未能在本次解析中与作者逐人可靠绑定
- Baiji Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunchong Xiao:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhaoci Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Keqi Deng:机构信息未能在本次解析中与作者逐人可靠绑定
- Kai Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhifu Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiangang Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xie Chen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
流式语音到语音翻译(Speech-to-Speech Translation,S2ST)的输入是不断到达的源语言语音,输出是另一语言的语音,难点在于没听完一句话时就要判断已有片段是否足以支撑翻译,判早了容易翻错,判晚了会打断交流,而且说出去的语音无法像文字那样悄悄修改。S3-S2ST(Semantically Supervised Streaming,语义监督流式模型)先用大模型把完整双语文字切成前后缀支撑的语义单元,再把每个单元变成“继续听还是开始写”的训练轨迹,让负责理解与翻译的思考器(Thinker)学翻译,让负责语音生成的发声器(Talker)学说话。推理时每 640 ms 观察一块新语音,一个多层感知机门控给出继续读入(READ)还是写入翻译(WRITE)的概率,超过阈值就提交一段译文并合成语音,阈值可调且有随播放缓存自适应的版本。相对已有按块长换挡或固定间隔输出的做法,该方法把提交决策与输入粒度解耦,同一检查点不用重训就能走不同的质量与延迟工作点。在内部 9 对测试集的流式评测中,固定阈值 0.5 的 S3-S2ST 在译文 COMET 上达到 0.965,高于参评流式基线,RealSI 上的自适应阈值在首包音频延迟基本不变时提升了后续提交质量。结论适用于英中双向短句评测,原文未披露训练、推理或部署成本,长对话与更多语言尚未验证。
🔗 开源资源
- 第三方资源:https://github.com/byteresearchcla/RealSI — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. 让智能体写代码做视频:VibeVideoBench 考什么、怎么判

英文题目:VibeVideoBench: Evaluating Multimodal Agents on Code-Driven Video Generation
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Muxi Diao:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenbin Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Lele Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xuyang Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuzhe Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiankang Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Kaiyu Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Changyi Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Haoyu Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Hongyi Fu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jianxiong Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tianke Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Haonan Fan:机构信息未能在本次解析中与作者逐人可靠绑定
- Yingxin Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Bingyi Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xuanyu Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Bin Wen:机构信息未能在本次解析中与作者逐人可靠绑定
- Tingting Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Han Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Wentao Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Weiran Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Kongming Liang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhanyu Ma:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是多模态智能体,指能读输入材料、写代码、调用渲染与语音工具并检查自身输出的系统,困难在于成品视频同时要求文字数字准确、状态变化合规、多分钟结构完整与声音事件对齐,而这类性质没有单元测试可以直接判定。真实来源被改写为自包含任务说明,附输入素材、交付规格与音频要求,共239个中英文任务,其输出作为沙箱 rollout 的输入。智能体在一小时沙箱内在无图像与视频生成模型下只用代码渲染画面并合成声音,输出带声音的MP4,只有可解码交付的视频才进入后续核验。程序核验先用代码判定容器、分辨率、帧率、时长与可听声音等交付规格,通过的交付进入条目核验逐条判定是否展示要求的过程,再连同视频进入质量评分从视觉质量、美学、内容逻辑、时间运动与音频同步五个维度打分。在九个系统239个任务的对照中,Claude Opus 5.5在严格任务成功率上为76.3%,即全部核心条目无失败的任务占比,高于其余八个系统,但仍有约四分之一任务存在核心缺失。在全部239个任务盲测人类偏好对照中,三评审均值与人类Elo的系统Spearman相关为0.98,高于单对视频73.3%的一致率,表明系统排序一致性强于单视频判定。按单任务平均清单价格API成本计,GLM-5.3-Flash为0.32美元,低于Claude Opus 5.5的15.38美元,跨系统相差约49倍;结论适用于一小时、仅允许代码渲染加语音合成的条件,缺失视频按零分计入后排名明显变化。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. 从双人互动证据出发的分层关系识别:HiRe-DRR 解读

英文题目:Hierarchical Multimodal Interaction Reasoning for Dyadic Relationship Recognition
评分:6.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.4/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Wang Tang:机构信息未能在本次解析中与作者逐人可靠绑定
- Fethiye Irmak Dogan:机构信息未能在本次解析中与作者逐人可靠绑定
- Linbo Qing:机构信息未能在本次解析中与作者逐人可靠绑定
- Ce Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Hatice Gunes:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是两个人的一段面对面交互视频,任务是判断两人属于陌生人、熟人、朋友、家庭等哪一种潜在社会关系,难点是关系不是瞬时动作,而是分散在表情、姿态、声音和语言中的重复性协调模式,且相邻类别证据高度重叠。论文提出的HiRe-DRR先把每段视频切成按时间排序的短片,得到两人脸、身体、音频和文本的同步流,再用各模态编码器分别提取低层几何声学语义线索和高层行为情感外观信息并投影到统一空间,投影后的双人特征进入下一步交互构造。为每个语义层级分别构造同质和异质跨人交互标记形成交互库,混合交互Transformer把库中32个交互标记看成专家,用关系感知的稀疏路由选出当前最相关的前5个作查询,以全部交互作键值做交叉注意力精炼,聚合成关系表示。精炼得到的关系表示同时进入常规分类和分层条件损失,后者沿关系二叉树把识别分解为条件二分类序列,两者联合优化以保持细粒度区分并服从类别语义组织。与已有整体融合法的区别是证据按语义层级和交互结构显式保留,并可从路由权重回看哪类证据支持哪类关系。在Seamless Interaction抽取2738段视频构成的片段级评测中,该方法在非加权平均召回率UAR上以63.0%超过最强基线AsyReC的50.3%,在平均精度均值mAP上以68.5%超过AsyReC的52.2%。结论适用于短时双人面对面片段,当相邻关系共享相似表情或对话模式时仍会混淆,原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/tw-repository/HiRe-DRR — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. 在冻结语音编解码器隐空间里逐帧回归:StreamSE 的流式增强路线

英文题目:StreamSE: Neural Audio Codec-based Streaming Speech Enhancement for On-device Inference
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hyunjin Choi:机构信息未能在本次解析中与作者逐人可靠绑定
- Zinu Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- Junwon Moon:机构信息未能在本次解析中与作者逐人可靠绑定
- Jeongyun Chae:机构信息未能在本次解析中与作者逐人可靠绑定
- Seungbeom Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- Kyuhong Shim:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音增强要从含噪语音恢复干净语音,电话与助听等场景要求输出只依赖当前与历史帧,同时每帧在设备上按时算完,而生成式方法常用非因果结构与迭代采样,难以同时满足这两点。论文把48 kHz波形先送入冻结的因果神经音频编解码器,得到每80 ms一帧、维度768的连续隐向量,再由约20M参数的StreamSE回归干净隐向量,最后经截断至8层粗粒度的残差向量量化器与解码器重建波形。StreamSE训练时以真实量化隐向量做教师强制并行学习,推理时把自身上一帧量化输出作为条件逐帧自回归,经因果自注意力利用全部历史保持时序连续。相对逐层分类离散词元或扩散多步采样的做法,该路线每帧只需一次前向,不做前视与迭代采样,并把高保真重建留给编解码器,截断细层以去掉残留混响。在DNS Challenge 2020测试集含混响类别上,零前视StreamSE的DNSMOS整体平均得分OVL为3.086,高于同期对比的生成式基线SELM的2.695。在同一测试集无混响类别上,零前视StreamSE的DNSMOS整体平均得分OVL为3.361,也高于SELM的3.258,表明在相同感知指标下匹配或超过非流式离线基线。结论限于该测试集的DNSMOS感知指标与所用合成训练分布,截断至更少层数时无混响说话人相似度损失加大,真实录音与更重混响外推尚未充分验证。Galaxy S22单大核ONNX中央处理器、动态int8下全链路每帧耗时p95为61.04 ms,占80 ms预算的76%,其中StreamSE本体为5.46 ms,编解码器约占91%延迟。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. 戴在身上的麦克风如何量出混合办公的说话、压力与效率

评分:6.3/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Tiantian Feng:机构信息未能在本次解析中与作者逐人可靠绑定
- Aditya Kommineni:机构信息未能在本次解析中与作者逐人可靠绑定
- Emily Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Burcin Becerik-Gerber:机构信息未能在本次解析中与作者逐人可靠绑定
- Gale Lucas:机构信息未能在本次解析中与作者逐人可靠绑定
- Shawn C. Roll:机构信息未能在本次解析中与作者逐人可靠绑定
- Shrikanth Narayanan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
混合办公后家和办公室日常沟通差异缺少工作时间内连续量化证据,难点在于胸牌式设备只能在端侧保留少量声学特征,还要从中判断语音是否来自佩戴者本人。设备端每分钟按20秒窗口实时抽取基频、响度和梅尔倒谱1–12等低维特征而不存原始波形,输出的梅尔倒谱直接作为离线判别模型的输入。离线紧凑ResNet以梅尔倒谱为输入逐帧区分佩戴者前景语音、他人背景语音和静音噪声,所得帧标签再经基频大于零过滤去除非浊音误判,过滤后的前景语音段才用于后续统计。针对低维特征受限,以微调后冻结权重的语音基础模型为教师,用交叉熵加KL散度目标把帧级判断蒸馏到学生ResNet,训练时混入室内噪声以应对办公室环境声,蒸馏后的ResNet替换同结构基线承担同样的帧级判别职责。过滤后前景语音段聚成每小时说话分钟数表示的说话负荷和以全天高分位数表示的说话活跃度,再与人口学协变量一起进入混合线性模型。在三个自我中心语音数据集联合训练并按各自划分测试的评测中,EasyCom测试集上以diarization error rate为指标,蒸馏ResNet为29.0而同结构ResNet基线为31.8,蒸馏结果低于基线。在高校职员队列四个月工作时段佩戴数据的居家与办公室比较中,混合效应模型下办公室每小时说话时间高于居家约达两倍,办公室说话负荷越高对应自陈压力越高而自陈生产力越低,结论仅适用于该小样本观测。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. 把评测误差变成下一轮选数据的依据:多语言语音识别的智能采样

英文题目:Agentic Data Sampling Framework for Multilingual ASR via Linguistic-Aware Error-Driven Optimization
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zhiheng Qian:Shanghai Jiao Tong University
- Junhao Du:AISpeech Co., Ltd.
- Jing Peng:Shanghai Jiao Tong University
- Hanqi Li:Shanghai Jiao Tong University
- Kunyang Peng:AISpeech Co., Ltd.
- Feng Xue:AISpeech Co., Ltd.
- Lu Chen:Shanghai Jiao Tong University
- Shuai Wang:Nanjing University
- Kai Yu:Shanghai Jiao Tong University
📌 核心摘要
多语言自动语音识别(Automatic Speech Recognition,ASR)需要在一个模型中转写多种语言,输入是不同声学条件和书写系统的语音,输出是对应语言的文字序列,难点是语言间数据量、发音和形态差异大,统一训练容易偏向数据多的语言。论文提出语言学感知的智能体数据采样框架,每轮先用微调后的模型转写开发集,再把错误按语音学与音系(phonetics and phonology)、形态和句法三个维度统计,形成诊断报告。基于大语言模型(Large Language Model,LLM)的采样智能体结合该报告、训练历史和预算约束,从分层算法池中为语言域、话语(utterance)和形符(token)三个层级各选一种算法及参数,生成可执行的下一轮数据子集。该做法与固定混合比例或单一准则选择不同,把评估从终点打分改为训练循环内部的反馈。实验在 Common Voice 十二种语言子集上以 Whisper-medium 为骨干,智能体采样在相同累计训练量下平均错误率为 19.4,低于全量训练的 23.9 和随机采样的 22.5。结论适用于该语料和预算设置,跨语料泛化和各组件独立贡献尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 内容缰绳:给可逆说话人匿名化套上内容约束
英文题目:The Content Leash: Mitigating Degenerate Solutions in Invertible Speaker Anonymization
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Nirjon Mobarak Talukder:机构信息未能在本次解析中与作者逐人可靠绑定
- Rafid Ahmed:机构信息未能在本次解析中与作者逐人可靠绑定
- Mohammad Ishrak Abedin:机构信息未能在本次解析中与作者逐人可靠绑定
- Abu Raihan Mostofa Kamal:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
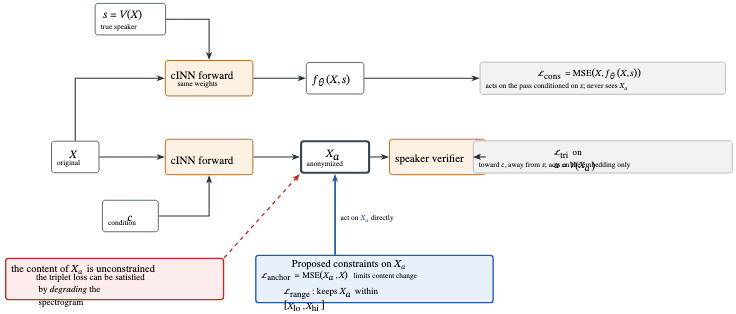
可恢复匿名化要求同一系统既能隐藏说话人身份,又能在持有密钥时完整恢复原声,难点在于匿名变换不能靠破坏语言内容来骗过说话人验证器。论文从条件可逆神经网络(conditional invertible neural network,cINN)出发,输入 80 维对数梅尔语谱图,经密钥生成的伪说话人条件变换为匿名语谱图,再经声码器合成波形,逆向时用同一条件恢复语谱图。作者先指出已发表目标只约束真说话人条件下的重构和匿名嵌入的三元组距离,未约束匿名语谱图内容,因而存在退化解。对应地加入锚损失(anchor loss)限制匿名语谱图偏离原语谱图的均方误差,并加入范围损失(range loss)惩罚超出原句动态包络的值。作者还把波形域说话人验证表示蒸馏到梅尔域验证器,使训练时能看到更强的说话人线索。在 38 个未见说话人、303 条 LibriTTS test-clean 语句上,系统把 ECAPA-TDNN 下攻击者等错误率(equal error rate,EER)从 2.83% 的实测下限提高到 26.31%,代价是词错误率(word error rate,WER)从 2.48% 上升到 11.75%,密钥恢复的说话人相似度为 94.90%,与声码器往返上限持平。原文未披露训练、推理或部署成本,结论限于无知攻击者和单一语料,未验证已知匿名数据的自适应攻击。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. 语音相同写法不同时,如何公平评价语音转写

英文题目:ETC-Bench: A Multilingual Benchmark for Evaluation-Side Transcript Canonicalization
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Zhiheng Qian:机构信息未能在本次解析中与作者逐人可靠绑定
- Junhao Du:机构信息未能在本次解析中与作者逐人可靠绑定
- Jing Peng:机构信息未能在本次解析中与作者逐人可靠绑定
- Hanqi Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Kunyang Peng:机构信息未能在本次解析中与作者逐人可靠绑定
- Feng Xue:机构信息未能在本次解析中与作者逐人可靠绑定
- Kai Yu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音转文本系统输出常出现同一发音对应多种写法,例如数字用阿拉伯数字还是单词拼写,中文孙丽与孙立同音不同字。困难在于词错误率会把这类约定差异计为识别错误。论文定义的评测侧转写规范化(Evaluation-side Transcript Canonicalization,ETC)输入为单条转写文本及其语言标识,输出为规范化文本,要求同一发音的合法变体得到相同输出,同时保留语音已编码的语义,处理时不听语音也不看配对的另一写法。基准构建先按变异来源组织五大类别与现象,再为每种现象生成共享语境、仅目标片段不同的最小对,经母语者核查。评测用的语义保留精确匹配规范化准确率(Semantic-preserving Exact-match Normalization Accuracy,SENA)要求成对输入独立规范化后字符串完全相同,且输入到输出的语义相似度不低于原对相似度太多。技能侧的分类指导智能体规范化技能(Taxonomy-guided Agent Canonicalization Skill,TACS)向大语言模型智能体提供现象描述与按语言和现象写明的输出约定,智能体先定位实例再做局部替换。在包含十二种语言的基准上,以 xlm-roberta-large 计算 BERTScore 的 SENA 评测显示,TACS-Qwen 宏平均得分为 68.8%,高于传统基线中最高的 FunASR-TN 在其支持语言上平均 9.4% 的水平。结论适用于所覆盖的现象与语言,同音替换与符号标记仍较难,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. 把吉他 MIDI 先变成可改的演奏曲线,再用潜在流匹配合成声音

英文题目:Expressive Guitar Synthesis via Controllable Latent Flow Matching
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hsueh-Wei Fu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yen-Tung Yeh:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi-Hsuan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是从定时音符事件合成吉他音频,困难在于输入只决定弹什么音,不决定每个音在弦上如何发出,包括音高起伏和力度包络等连续变化。论文先把符号输入转成按弦组织的中间演奏量,再把这些量渲染成声音,中间量允许用户在合成前直接修改。第一步是演奏预测器,输入按帧符号表示与每音符力度,输出每根弦的基本频率轨迹和振幅包络轨迹;第二步是潜在流匹配合成器,把预测轨迹与有声状态和起始等符号上下文编码成条件,生成每弦音频潜变量并解码成波形后经分弦滤波混音,另有伪力度预测器只用音高、时长和前后音符间隔估计每音符力度,用于缺少力度标注时的输入。在采用录音级划分的GuitarSet测试集上,带真实力度版本相对单阶段基线把基频平均绝对误差从33.53音分降到26.52音分、包络相关从0.63升到0.88,总体偏好得分3.04分高于单阶段基线的2.54分和DDSP-Guitar的2.62分。相对已有方法,关键差异是在预测和合成两阶段都引入跨弦交互,并把力度从依赖音频提取改为可从符号预测,消融显示去掉合成器跨弦注意力后多弦同时发声窗口的多尺度频谱损失上升更明显。结论适用于有分弦监督的吉他录音条件,多弦同时发声段提升更明显,音色与录音环境控制尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/erl-j/ddsp-guitar — 链接可访问(HTTP 200)
第三方资源:https://weifu3024.github.io/ctrl-lfm-guitar-synth/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/erl-j/ddsp-guitar-unified — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. ConformalMOS:给语音质量打分加上有保证的区间和顺序建模

英文题目:ConformalMOS: Uncertainty-Aware MOS Prediction with Conformal Intervals and Ordinal Modeling
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.9/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kehinde Elelu:机构信息未能在本次解析中与作者逐人可靠绑定
- Joshua E. Siegel:机构信息未能在本次解析中与作者逐人可靠绑定
- Mohammadali Saffary:机构信息未能在本次解析中与作者逐人可靠绑定
- Tashfain Ahmed:机构信息未能在本次解析中与作者逐人可靠绑定
- Simeon Babatunde:机构信息未能在本次解析中与作者逐人可靠绑定
- Ebuka Okpala:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音质量评估中的平均意见分(Mean Opinion Score,MOS)预测要从一段合成或转换语音输出人类打分的平均值,输入是波形,输出是1到5分之间的分数。难点是人耳打分受噪声、口音和听者偏好影响而分散,只给点估计无法说明可信程度,因此需要能给出覆盖保证的区间。ConformalMOS先用冻结的上游特征提取器把波形变成帧级嵌入并经时间平均池化得到固定维向量,再送入两层预测头输出多个分数档上的概率并加权求期望得到分数。训练时把单点标签换成以真值为中心的高斯平滑分布以保留相邻分数的顺序关系,使邻近分数分得部分正确性而不只是非对即错。推理后另取一部分标注数据计算绝对残差的分位数作为半宽,加减到点估计上并裁剪到1到5分之间形成预测区间,残差越大区间越宽。在 BVCC 数据集系统级评测中,M2D2 主干在 \(\alpha=0.05\) 设置下平均平方误差为 0.08,低于 FUSE-MOS 基线的 0.086,线性相关系数为 0.953,为表中最高。结论适用于域内 BVCC 划分,分布外鲁棒性尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. 把视觉计算省下来:双分支轻量视觉前端如何做目标说话人提取

英文题目:A Lightweight Dual-Branch Visual Front-End for Efficient Audio-Visual Target Speaker Extraction
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zhan Jin:School of Computer Science, Wuhan University, Wuhan, China;School of Artificial Intelligence, Chinese University of Hong Kong, Shenzhen, China
- Peijun Yang:School of Artificial Intelligence, Wuhan University, Wuhan, China;School of Cyber Science and Engineering, Wuhan University, Wuhan, China
- Juan Liu:School of Artificial Intelligence, Wuhan University, Wuhan, China;School of Cyber Science and Engineering, Wuhan University, Wuhan, China
- Ming Li:School of Artificial Intelligence, Chinese University of Hong Kong, Shenzhen, China;School of Artificial Intelligence, Wuhan University, Wuhan, China
📌 核心摘要
面向多人混合语音,音视频目标说话人提取(audio-visual target speaker extraction,指用与目标说话人同步的视觉线索从混合语音中恢复其干净语音)需要从人脸视频中提取有用的视觉条件,难点是大面积人脸图像卷积开销大,而只看小唇部又可能丢失面部运动信息。本文提出双分支视觉前端(dual-branch visual front-end,指进入分离网络之前的视觉特征计算模块),其中唇部运动建模分支(lip motion modeling branch,指对裁剪后的小唇部图像做时空卷积的支路)用紧凑唇部感兴趣区域保留局部外观与开合细节。面部关键点建模分支(facial landmark modeling branch,指对关键点坐标序列做时序卷积的支路)用关键点坐标描述全局几何运动,计算量远小于图像卷积。两路特征经拼接与投影融合后送入分离骨干,在IIANet与SpatialNet上均不改动骨干主体结构。在LRS3-2mix测试集、IIANet骨干、容差5与早停15的统一精简训练设置下,该32×32+lmk84方法指标尺度不变信噪比提升SI-SNRi(scale-invariant signal-to-noise ratio improvement,指估计语音相对混合语音的尺度不变信噪比增量,越高越好)为17.1 dB、指标感知语音质量评估PESQ(perceptual evaluation of speech quality,指感知语音质量,越高越好)为2.80,与BlazeNet64基线的17.0 dB、2.80相比基本持平略高,且原文指出未做多种子评估而不视为统计验证的提升。同期模块级视觉编码计算复杂度指标乘积累加运算量按同一THOP口径从BlazeNet64基线的2.4 GMACs降至该方法的0.3 GMACs,不含人脸检测与关键点估计开销。结论只适用于关键点坐标已由预处理提供的系统,原文明确不刷新LRS3-2mix最优结果。
🔗 开源资源
- 演示资源:https://anonymous.4open.science/r/Lightweight-Visual-Frontend-E46 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. 用消费级生理信号同时读出音频质量与收听费力程度
英文题目:Physiology-Informed Audio Quality and Listening Effort Estimation
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Niall McGuire:机构信息未能在本次解析中与作者逐人可靠绑定
- Dimitra Emmanouilidou:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是听者听到的音频质量与听音频时付出的心理努力,困难在于传统平均意见分(Mean Opinion Score,MOS)是播放结束后的一次性主观打分,抹掉了个体差异,也无法连续反映听的过程。论文输入是 graded语音与极端干净或退化片段播放期间记录的生理信号,输出是对客观质量标签和听者自评努力等级的预测。处理过程先把各信号切成以刺激为基准的试次并提取频域与时域特征,再用同一模型选择流程分别训练质量二分类与五级回归、努力二分类与五级回归,并在未见听者与已见听者两种划分下评测。相对已有实验室高密度脑电研究,关键差异是引入消费级可穿戴脑电、功能性近红外光谱(functional near-infrared spectroscopy,fNIRS)与眼动追踪的同步对照,并明确区分群体质量轴与个体努力。未见听者条件下,可穿戴脑电对五级客观MOS的Pearson相关系数为0.38,高于零的零假设,已见听者条件下眼动对五级努力评分的Pearson相关系数为0.37,同样高于零的零假设,质量二分类平衡准确率在0.60至0.65之间,超过0.50的机会水平。结论适用于恢复语料库级别的群体质量趋势和经校准后的个体努力,尚未证明能恢复单个听者自己的质量排序,也未验证对未见音频片段的泛化。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
20. 换了声音类别才改答案吗:用同类替换做对照的局部音频证据检验

英文题目:Beyond Answer Changes: Matched Same-Class Controls for Local Audio Evidence
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yunuo Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Maoyuan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuanjin Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xing Liu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是音频语言模型对环境声问题的回答,困难在于一次局部波形替换同时改变了事件类别和底层波形,单看回答是否改变无法判断模型究竟响应了哪一个因素。输入是包含目标事件、干扰事件和连续背景的10 s录音与二选一问题,输出是模型选择的选项标识,难点是把类别效应从编辑操作本身的扰动中分离出来。方法先定位被提问事件的目标时间段并固定电平估计、供体适配与交叉淡化的编辑流程,得到可复用的区间与编辑参数。接着用另一选项类别的录音替换该区间得到异类版本,再用同一类别的不同录音按相同参数重写同一区间得到同类版本,两者相对原始回答的变化率之差即类别带来的额外移动。随后以上一步中原始回答与同类重写都正确的试验为合格子集,检查模型在异类版本上能否说出新插入的类别,以区分方向正确的识别与单纯的回答松动。相对已有删除或掩蔽测试,该设计保留了局部声学证据并维持正确答案可比,使类别变化成为可对照的处理。跨600个合成声景与三种模型的评测显示,异类替换比匹配的同类重写多出49.7至60.9个百分点的回答变化,同类正确率与原始正确率差距在5.2个百分点以内,且虚假自替换的回答变化率低于1.0%,合格试验上新类别的选择准确率为73.7至81.9%。结论只在33个提问类别与标称+10 dB事件背景比条件下成立,自然录音与更复杂情形尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. 流式视频助手何时该说话:Live-OPSD 的特权自蒸馏解读

英文题目:Live-OPSD: On-Policy Self-Distillation for Proactive Streaming Large Video Models
评分:5.9/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kaixuan Du:Qwen Business Unit of AlibabaEqual contribution.Work done during an internship at Alibaba.Corresponding author.
- Xin Wan:Qwen Business Unit of AlibabaEqual contribution.Work done during an internship at Alibaba.Corresponding author.
- Dai Guan:Qwen Business Unit of AlibabaEqual contribution.Work done during an internship at Alibaba.Corresponding author.
- Ming Chen:Qwen Business Unit of AlibabaEqual contribution.Work done during an internship at Alibaba.Corresponding author.
- Xiaoxi Jiang:Qwen Business Unit of AlibabaEqual contribution.Work done during an internship at Alibaba.Corresponding author.
- Guanjun Jiang:Qwen Business Unit of AlibabaEqual contribution.Work done during an internship at Alibaba.Corresponding author.
📌 核心摘要
流式助手面对不断到达的视频块和用户话语,需要在每个时刻决定说话还是沉默,以及在说话时生成什么内容,困难在于证据尚不完整,说早会打断交互,说晚或不说会错过时机。论文提出Live-OPSD,先让当前策略只看流式上下文生成一段延续,再让同一模型在附加一段说明相关证据的特权提示下对这段延续的每个位置给出目标分布,最后用分布匹配损失更新无提示的策略,该更新只作用于策略自身已访问的前缀。哪些时刻参与更新由决策感知选择决定,它优先保留当前决策与标注决策不一致的点,再补充一致的说话和沉默点。在LiveProBench上同骨干Qwen3-Omni-30B-A3B对照中,六项任务平均分指标Avg.上Live-OPSD为59.64%,高于Vanilla-SFT的54.38%。在OVO-Bench评测中总体准确率指标All上Live-OPSD为65.84%,高于其骨干Qwen3-Omni-30B-A3B的61.00%,表明定时训练未损害已有理解能力。该结论依赖已对齐决策监督和提示的流式协议,外部提示质量、录制历史与部署历史的差异尚未消除。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
22. 为巴斯克语做一个能听会说的语音语言模型
评分:5.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Andoni Sudupe:机构信息未能在本次解析中与作者逐人可靠绑定
- Inma Hernaez:机构信息未能在本次解析中与作者逐人可靠绑定
- Ander Arriandiaga:机构信息未能在本次解析中与作者逐人可靠绑定
- Christoforos Souganidis:机构信息未能在本次解析中与作者逐人可靠绑定
- Ibon Saratxaga:机构信息未能在本次解析中与作者逐人可靠绑定
- Eva Navas:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
能听懂巴斯克语口语并用同语言文字和语音回答的系统是对象,输入为巴斯克语语音,输出为文字回答和语音波形,难点是无语音指令三元组且从头多模态预训练成本过高。系统沿LLaMA-Omni模块化结构,以Latxa-3.1-8B-Instruct为主干,Whisper-large-v3-eu编码语音经语音适配器映射到词嵌入空间,非自回归语音解码器由主干隐状态并行预测离散单元再经Unit HiFi-GAN合成波形。数据上把英文VoiceAssistant-400K译为巴斯克语口语问答,再用VITS合成语音并经微调mHuBERT聚类提取离散单元,构成约45万条三元组。训练分两阶段,先冻结编码器训练适配器和主干以听懂语音并生成文字,再冻结前三部分只训练语音解码器对齐变长单元序列。在与训练不相交的4419条合成指令上,内容质量LLM-as-a-judge Score本系统为3.86/5,低于英文LLaMA-Omni在各自英文条件下的3.99/5但高于Qwen2-Audio的3.47/5。同批合成评测经巴斯克语Conformer识别的词错率为9.94%,低于英文LLaMA-Omni在各自英文ASR条件下的10.82%,音频质量预测值UTMOS为3.07,低于英文基线的3.62至4.22,流式延迟在A100上按块大小40测得370 ms,高于LLaMA-Omni的346 ms而远低于SpeechGPT的5587 ms。该结论仅适用于同分布合成评测,未经真实口语验证,判分模型与主干同族且UTMOS主训于英日语音,两阶段各训练3轮合计不足100小时,使用4张NVIDIA A100 80GB。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
23. 气管音如何变成实时呼吸率:Airmod 的降噪与深度学习链路
评分:5.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Shang-Ran Huang:机构信息未能从 arXiv PDF 文本可靠映射
- Fu-Shun Hsu:机构信息未能从 arXiv PDF 文本可靠映射
- Ji-Chang Huang:机构信息未能从 arXiv PDF 文本可靠映射
- Chuan Chen:机构信息未能从 arXiv PDF 文本可靠映射
- Shou-Zen Fan:机构信息未能从 arXiv PDF 文本可靠映射
- Chang-Fu Su:机构信息未能从 arXiv PDF 文本可靠映射
- Eng-Che Huang:机构信息未能从 arXiv PDF 文本可靠映射
- Yuan-Ren Cheng:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
临床镇静需要在非手术室环境下连续了解通气状态,传统听诊器需要人手扶持,易受环境噪声干扰,也难以量化呼吸频率。论文输入是贴在甲状软骨旁平坦区的气管音连续声流,输出是逐次更新的每分钟呼吸次数,难点在于噪声经空气和人体组织进入拾音器,呼吸暂停和不规则呼吸打断周期,以及流式推理需要把重叠窗口的片段拼成不重复不漏检的事件序列。系统先用双麦克风归一化最小均方自适应滤波抵消环境噪声,再对15秒窗口计算语谱图、梅尔频率倒谱系数和分频带能量和,送入卷积双向门控循环单元网络判断每小段属于吸气、背景还是呼气。随后经过合并相邻片段、去除短突发,再经过不完整事件去除、能量阈值去假阳性和双计数去除,把吸气事件写入历史列表并按最近三次呼吸周期平均值换算频率。在测试集连续流模拟中,预测间隔5秒时开启提炼后吸气检测阳性预测值为0.848,高于未开启提炼的0.841,而F1分数为0.838,低于未开启提炼的0.850。与已有固定长录音事件检测不同,该方法针对重叠15秒窗口的序列推理设计了提炼与拼接,使截断事件可在后续窗口补全并避免重复计数,代价是提炼以灵敏度换取阳性预测值。结论适用于镇静气管音的吸气呼气检测和趋势显示,强噪声、触碰摩擦声、咳嗽和供氧嘶声仍可能残留,频率精度有待另文验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://gitlab.com/techsupportHF/hf_tracheal_v2 → https://gitlab.com/users/sign_in — 链接不可用(HTTP 403)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
24. 部分编辑音频:只改一小段声音为何更难防
英文题目:Partially Edited Audio: Generation, Defense, and Open Problems
评分:5.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:综述 | arXiv 原文
👥 作者与机构
- Lin Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- You Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Nicholas Evans:机构信息未能在本次解析中与作者逐人可靠绑定
- Xin Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- David Harwath:机构信息未能在本次解析中与作者逐人可靠绑定
- Abhinav Dhall:机构信息未能在本次解析中与作者逐人可靠绑定
- Bowen Shi:机构信息未能在本次解析中与作者逐人可靠绑定
- Chengzhe Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Siwei Lyu:机构信息未能在本次解析中与作者逐人可靠绑定
- Sanjeev Khudanpur:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一段录音中未改动部分与改动部分共存的音频,困难在于改动可能很短且与上下文保持连贯,整段真假标签无法说明问题,处理过程需要同时回答改了什么、怎样改的以及是否应在具体应用中告警。论文把部分编辑音频定义为从已有录音出发并保留其中所选部分的局部修改,区分改动范围与是否从已有录音出发两个维度。生成侧先按编辑目标选定待改时间跨度与语言内容、韵律风格、情感等副语言属性、音乐环境声或跨模态同步对象,其输出的掩码位置与编辑指令进入实现方式选择。实现方式从拼接剪切发展到合成后拼接,再到以左右侧未改动上下文为条件用自回归编解码语言模型或非自回归扩散与流匹配模型做上下文感知填充,指令条件模型再统一多种目标,填充结果与原上下文拼接后的完整音频进入评测。评测同时检查已编辑部分的内容正确与可控性和未改动部分的说话人、韵律、场景一致及边界平滑,评测暴露的边界不连续等伪影进入防御侧作为线索。防御侧聚焦语音,先做整段真伪判断筛查可疑录音,其可疑判定进入片段级定位以标出被改时间段,定位结果再进入按生成过程区分来源的日志式标注以追溯算法,解释分析则检验模型是否依赖边界伪影。论文强调同一编辑操作在公开修正与隐瞒关键信息时性质不同,是否属于有害伪造取决于披露、知情同意与使用方依赖的信任假设。原文未提供可核对的关键定量结果。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://audio-editing-challenge.github.io/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
25. 语音增强之后听起来不一样吗?又更喜欢哪个?区分度与偏好的互补评价

英文题目:Perceptual Differences and Preferences in Speech Enhancement
评分:5.5/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Simon Dahl Jepsen:机构信息未能在本次解析中与作者逐人可靠绑定
- Jesper Rindom Jensen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音增强的输入是带噪录音,输出是估计的干净语音,难点是高性能系统在常用客观分或平均意见分上已经很接近,但分数接近不等于听起来无差别,更不等于听者没有系统性偏好。论文采用配对比较框架,对同一语句经两个系统处理后的输出做逐句差值,先用三角测试让听者从三段中挑出不同者,再用A/B/N测试测日常听音偏好与是否明确表态。三角试验的逐条件分辨估计进入与客观分差的Spearman相关及机会下限为三分之一的心理测量函数拟合,偏好试验的表态率与偏好方向同样以逻辑函数关联客观分差,从而检验分差能否预测可分辨性与偏好。在45条DNS2020语句共2541次众包三角试验汇总下,总体分辨率为1775/2541约0.7,高于三分之一猜测水平。在同一众包偏好试验汇总下,听者明确表态比例为68%,其中MeanFlow对干净参考的平均表态率为0.84,高于MeanFlow对StoRM的0.51。在135个语句配对条件的分辨关联中,SQUIM_STOI的Spearman相关为0.62,高于同列PESQ的0.05。原文未披露训练、推理或部署成本。作者承认众包设备与注意力不可控、VoiceBank+DEMAND训练与DNS2020测试的跨语料失配和不完全配对设计限制了结论强度,未来需要在实验室条件下重复验证。
🔗 开源资源
第三方资源:https://github.com/yxlu-0102/MP-SENet.git → https://github.com/yxlu-0102/MP-SENet — 链接可访问(HTTP 200)
第三方资源:https://github.com/NikolaiKyhne/MambAttention.git → https://github.com/NikolaiKyhne/MambAttention — 链接可访问(HTTP 200)
第三方资源:https://github.com/liduojia1/MeanFlowSE.git → https://github.com/liduojia1/MeanFlowSE — 链接可访问(HTTP 200)
第三方资源:https://github.com/sp-uhh/storm.git → https://github.com/sp-uhh/storm — 链接可访问(HTTP 200)
第三方资源:https://github.com/csteinmetz1/pyloudnorm — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。