📄 内容缰绳:给可逆说话人匿名化套上内容约束
英文题目:The Content Leash: Mitigating Degenerate Solutions in Invertible Speaker Anonymization
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Nirjon Mobarak Talukder:机构信息未能在本次解析中与作者逐人可靠绑定
- Rafid Ahmed:机构信息未能在本次解析中与作者逐人可靠绑定
- Mohammad Ishrak Abedin:机构信息未能在本次解析中与作者逐人可靠绑定
- Abu Raihan Mostofa Kamal:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
可恢复匿名化要求同一系统既能隐藏说话人身份,又能在持有密钥时完整恢复原声,难点在于匿名变换不能靠破坏语言内容来骗过说话人验证器。论文从条件可逆神经网络(conditional invertible neural network,cINN)出发,输入 80 维对数梅尔语谱图,经密钥生成的伪说话人条件变换为匿名语谱图,再经声码器合成波形,逆向时用同一条件恢复语谱图。作者先指出已发表目标只约束真说话人条件下的重构和匿名嵌入的三元组距离,未约束匿名语谱图内容,因而存在退化解。对应地加入锚损失(anchor loss)限制匿名语谱图偏离原语谱图的均方误差,并加入范围损失(range loss)惩罚超出原句动态包络的值。作者还把波形域说话人验证表示蒸馏到梅尔域验证器,使训练时能看到更强的说话人线索。在 38 个未见说话人、303 条 LibriTTS test-clean 语句上,系统把 ECAPA-TDNN 下攻击者等错误率(equal error rate,EER)从 2.83% 的实测下限提高到 26.31%,代价是词错误率(word error rate,WER)从 2.48% 上升到 11.75%,密钥恢复的说话人相似度为 94.90%,与声码器往返上限持平。原文未披露训练、推理或部署成本,结论限于无知攻击者和单一语料,未验证已知匿名数据的自适应攻击。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
要解决的语音隐私任务是什么
这篇论文做的是可恢复的说话人匿名化。输入是一段语音的 80 维对数梅尔频谱,记为原始频谱,输出是另一版频谱,听起来说的是同样的话,但说话人验证器不再认为它是同一个人。必须保留的是语言内容,必须去掉的是能指向身份的声学线索。
与一次性匿名不同,这里要求授权用户拿着密钥还能把原声找回来。典型动机是医疗复核、法律纠纷或欺诈调查:平时共享和处理的是匿名版,需要时授权方恢复原说话人。论文把恢复做成网络结构的性质,而不是再学一个还原模型,往返频谱均方误差约 10 的负 6 次方量级,基本是浮点精度内的精确可逆。
评价因此有 3 条线。隐私看攻击者用余弦打分做说话人验证的等错误率,越高越难关联;可用性看语音识别的词错误率,越低内容保留越好;可恢复性看正确密钥下恢复波形与原始波形的说话人嵌入余弦相似度,越高越接近原声。每条线都要和干净语音的实测下限放在一起读,否则数字本身没有意义。
已有路线为什么多是单向的
主流匿名化是先解耦再替换再重合成。VoicePrivacy 基线把 x-vector 换成不相似向量的平均,后续工作改进伪说话人采样以保持匿名向量分布,或用对抗训练去掉残留说话人信息,或用音素后验概率携带内容;还有 McAdams 系数偏移这类无需训练的信号处理基线。这些方法一旦匿名,原声就丢了,无法恢复。
可逆路线用归一化流中的仿射耦合层搭双射映射,条件变体让映射依赖额外信息。Rano 把条件可逆网络用于匿名化,前向和逆向共享同一套参数,恢复因此是精确的。论文从这个设计出发,但追问它的训练目标到底约束了什么、没约束什么。
另一个背景是知识蒸馏。除了逐句对齐输出,相似度保持蒸馏还对齐一个 batch 内样本两两相似结构。论文同时用这两项,把波形域强验证器的行为搬到梅尔域,因为匿名器产出的是频谱,直接用波形验证器做训练验证器需要在每一步里塞进声码器,不现实。
已发表目标函数留下了什么捷径
已发表目标只有两项。一致性损失要求以真实说话人嵌入为条件时输出不变,三元组损失把匿名频谱的嵌入推向伪说话人、拉离真实说话人。问题在于,前者约束的是以真实嵌入为条件的另一条前向通路,根本看不到匿名输出;后者只看匿名频谱经过冻结验证器后的嵌入,不看频谱内容本身。
于是优化器有了一条便宜的路:把频谱严重破坏,嵌入自然就远离了原说话人,三元组损失也能下降,一致性损失还一直很低,因为它管的是另一条通路。论文在受控复现里观察到了这种退化解,而不是断言原论文发布模型一定如此。原文明确提醒没有官方实现,架构、初始化和训练进度的差异都不能排除,且原工作报告的 11.9% 词错误率说明发布模型并未表现出这种行为。
第二个问题是验证器泛化。用轻量梅尔域验证器训练的匿名器,在自己的空间里把匿名与原始嵌入余弦相似度打到负 0.09,已经过了正交,但独立的 ECAPA-TDNN 仍能以 18.35% 等错误率把同一段音频连回真人。匿名器只能藏住训练验证器能看见的东西,换更强的表示才可能骗过未见过的验证器。
整体流程如何把内容拴住
沿着一个样本走一遍会更清楚。原始频谱先被冻结的说话人验证器算出真实嵌入,同时随机密钥经匿名化条件生成器变成伪说话人嵌入。条件可逆网络以前者为条件应保持不变,以后者为条件应输出匿名频谱,匿名频谱再经 HiFi-GAN 声码器变成波形;恢复时把匿名频谱连同同一密钥对应的条件送回逆向即可。
论文的改动就加在这条链上。第一是在匿名频谱上直接加两个约束,一个把整体拉回原始频谱,一个只罚超出原始动态范围的部分;第二是把训练用的验证器换成蒸馏后的梅尔域验证器,并为新嵌入空间重训条件生成器;第三是评价方法上加实测下限、留出验证器、固定密钥种子并只测未见说话人。
下面这张图把约束关系画成了两条颜色的箭头,读图时重点看每个损失到底作用在哪个量上。
看图路径: 1. 先看上下两条条件可逆网络前向:上面以真实嵌入为条件,下面以伪说话人条件得到匿名频谱;2. 再看一致性损失与三元组损失的箭头分别指向哪里,确认都不直接约束匿名频谱内容;3. 最后看蓝色新增约束框的箭头如何直接指回匿名频谱,理解缰绳的位置
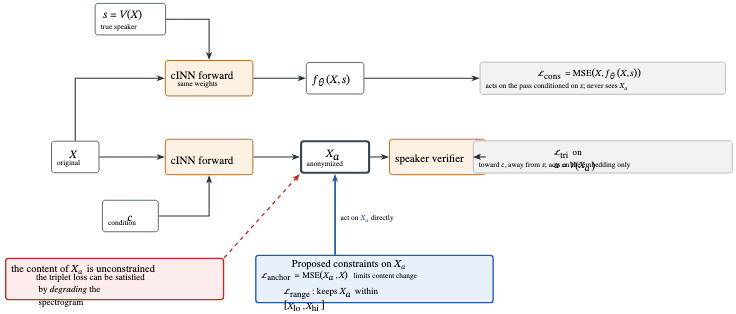
论文图 1。原论文 Fig. 1::“The training objective viewed as constraints on the anonymized spectrogram X_a.”。
图 1 把训练目标画成对匿名频谱的约束。上路一致性损失作用在以真实嵌入为条件的第二次前向,从不见匿名频谱;下路三元组损失只作用在匿名频谱的说话人嵌入上。红色部分是内容无约束,蓝色是新增的直接作用在匿名频谱上的锚损失与范围损失。这张图帮助理解为什么三元组下降不等于匿名成功,也点出新增损失的接入位置。
可逆主干与两条旧损失各管什么
主干是 12 个条件耦合块的条件可逆网络,约 26,500,000 参数,操作对象是 22.05 kHz、帧移 256、窗长 1024 下的 80 维对数梅尔频谱。密钥服从标准正态,经 8 个耦合块的条件生成器变成伪说话人嵌入。前向得到匿名频谱,逆向用同一密钥恢复,恢复是结构保证的。
条件可逆神经网络 × 匿名化条件生成器: 条件可逆神经网络是做频谱双向映射的主干,前向把原始频谱变成匿名频谱,逆向用同一组参数变回来;匿名化条件生成器是产生伪说话人嵌入的分支,它把随机密钥映射成网络所需要的条件向量。二者分工是主干管可逆变换,条件分支管想变成谁,组合后同一密钥既决定匿名方向也决定恢复方向。
一致性损失的计算对象是原始频谱与以真实嵌入为条件的前向输出的均方误差,平均范围是全部 80 乘 T 个元素。
\[\mathcal{L}_{\mathrm{cons}}=\mathrm{MSE}\big(X,\,f_{\theta}(X;s)\big),\]三元组损失的计算对象是匿名嵌入、伪说话人嵌入与真实嵌入之间的余弦距离,形式是带 margin 的 ReLU,只有当匿名嵌入离伪说话人不够近、离真人不够远时才有梯度。
\[\mathcal{L}_{\mathrm{tri}}=\mathrm{ReLU}\!\big(m+d(a,c)-d(a,s)\big),\quad d(u,v)=1-\cos(u,v),\]一致性损失 × 三元组损失: 一致性损失要求以真实说话人嵌入为条件时输出不变,约束的是另一条前向通路;三元组损失要求匿名后嵌入靠近伪说话人、远离真实说话人,约束的是匿名频谱经过说话人验证器后的嵌入。二者搭配本想兼顾保内容与改身份,但都不直接看匿名频谱本身的内容,这是捷径得以存在的结构原因。
总目标 originally 是这两项的加权和。理解分工后就能看出,内容本身没有被任何一项直接 penalize,这是后文加缰绳的出发点。
锚损失与范围损失怎样分工
锚损失就是匿名频谱与原始频谱的均方误差,把匿名结果往回拽。因为语言内容就住在频谱里,限定距离就限定了内容能走多远。它和三元组损失故意形成张力:一个要变,一个不让大变,平衡点就是隐私与可用的工作点,可通过权重选择。
\[\mathcal{L}_{\mathrm{anchor}}=\mathrm{MSE}\big(X_{a},\,X\big),\]范围损失是针对每句原始频谱最小最大值包络的铰链平均,匿名值待在包络内时恰为零,超出才线性增长。它与锚损失不冗余:锚对一切偏离都罚,包括匿名需要的适度移动;范围在包络内完全不管,只罚越界。越界值对声码器是分布外输入,论文在最差运行里观察到频谱值超过 8 后在频谱反演路径出现非有限音频。
\[\mathcal{L}_{\mathrm{range}}=\mathrm{mean}\big(\mathrm{ReLU}(X_{a}-X_{\mathrm{hi}})+\mathrm{ReLU}(X_{\mathrm{lo}}-X_{a})\big),\]锚损失 × 范围损失: 锚损失是匿名频谱与原始频谱的均方误差,对一切偏离都 penalize,负责把内容拽回来;范围损失是超出原始 utterance 动态上下界部分的铰链平均,在包络内为零、只罚越界,负责防止出现声码器无法处理的极端值。二者搭配是适度变化允许、大幅破坏不允许,与三元组损失形成可调的推拉平衡。
完整目标还加了对数行列式正则项,惩罚前向雅可比体积的膨胀与收缩,让逆向数值稳定,权重为 0.01。它惩罚的是体积变化,不是内容,作用与内容约束不同。
蒸馏验证器把什么能力搬过来
训练验证器的选择决定匿名器能学到藏什么。轻量梅尔域验证器与最终蒸馏版共享同一时延加注意力统计池化结构,输出 256 维嵌入,但前者只在同样语料上做说话人判别训练,后者额外对齐 ECAPA-TDNN。同一语音段以各自输入格式送给两个网络,ECAPA 冻结,只训梅尔域网络。
蒸馏损失有两项。第一项是逐句的 1 减余弦,经线性读出对齐维度;第二项是 batch 内两两余弦相似矩阵的 Frobenius 差,沿用相似度保持蒸馏,让梅尔域自己 256 维空间的成对结构去贴 ECAPA。论文预期第二项更重要,因为后续三元组用的是不经读出的原始嵌入,而读出层在蒸馏后就丢掉,但没有单独消融这两项。
\[\mathcal{L}_{\mathrm{distill}}=\frac{1}{N}\sum_{i=1}^{N}\big[1-\cos(g(h_{i}),e_{i})\big]+\frac{\lambda_{\mathrm{rel}}}{N^{2}}\big\lVert HH^{\top}-EE^{\top}\big\rVert_{F}^{2},\]ECAPA-TDNN × 梅尔域验证器: ECAPA-TDNN 是吃波形的强说话人验证器,判别能力强但需要声码器才能接入频谱训练;梅尔域验证器是与匿名器同吃对数梅尔频谱的轻量时延网络,训练方便但看到的说话人线索较弱。通过知识蒸馏把前者的单句对齐与 batch 内两两相似结构搬到后者,组合后训练时方便、攻击目标更接近强验证器。
换验证器必须重训条件生成器,因为它在验证器嵌入空间里生成条件。新验证器配旧生成器会让三元组比较的是不兼容的两个空间,这一步不能省。
训练分几个阶段、权重如何切换
数据上验证器、条件生成器与匿名器都训在 VCTK 和 LibriTTS 的 train-clean-100 上,按 utterance 切 85 比 15,留出 15% 只做验证和选 checkpoint。评价用 LibriTTS test-clean 中 38 个说话人的 303 句,程序化确认与所有训练数据无交集,每人至多抽 8 句,只保留有参考文本且每人至少 4 句的样本。
训练分 3 段。蒸馏跑 30,000 步,AdamW、学习率 0.001、batch 64,关系项权重为 1;条件生成器跑 80,000 步;匿名器先从随机初始化跑 52,000 步,此时锚权重 0.2、三元组权重 5,再热启动 12,000 步切到最终权重,一致性 1、三元组 3、锚 1.0、范围 1.0、行列式 0.01、margin 0.3,报告的是第二阶段第 8k 步的 checkpoint。硬件是单卡 RTX 6000 Ada 训练,单卡 RTX 4060 做评价与声码器微调。
声码器是 HiFi-GAN,从公开通用权重微调 30,000 步以匹配匿名器的梅尔配置。主结果用的声码器只在 VCTK 上微调,因此该系统没有任何部件在训练时见过评价说话人;消融与密钥实验用的早期声码器微调数据含 LibriTTS test-clean,读数时要分开看,论文也报告了换声码器只带来 0.43 个点的等错误率变化和 0.38 个点的恢复相似度变化,都在种子间波动内。
隐私、可用与恢复各怎么测
隐私是 ECAPA-TDNN 余弦打分的等错误率。攻击者是 VoicePrivacy 意义下的无知攻击者,在原始语音上注册,不知道测试语音已被匿名。每句匿名语音与每句原始语音都打分,包括同一句的匿名版与原始版,共 2417 个目标试验与 89392 个冒充试验;下限是两边都用原始语音重复同一流程并去掉自配对。每位说话人抽一个密钥并用于该说话人全部句子。另有一个 SpeechBrain 的 ResNet 验证器在 VoxCeleb 上训练,全程不参与任何训练,只做留出验证。
等错误率 × 词错误率: 等错误率是说话人验证攻击者的错误率,越高说明匿名后越难把匿名语音连回原说话人,是隐私指标;词错误率是 Whisper 识别匿名语音的错误率,越低说明语言内容保留越好,是可用性指标。二者搭配才能看出隐私-可用性折中,单看等错误率升高可能是语音被破坏的假象。
可用性是 Whisper large-v3 的词错误率,恢复质量是原始与恢复波形经 ECAPA 算嵌入余弦相似度。恢复相似度的上限是未改动语音经声码器往返的相似度,任何恢复都超不过它。伪说话人密钥来自有种子的生成器,报告三粒种子的均值与标准差,因为早期未固定种子时藏了约 2 个点的波动。
主结果在未见说话人上达到什么
主结果要回答的是在训练时谁都没见过的 38 人 303 句上隐私可用与恢复 3 条线各是多少以及与 McAdams 基线和原论文报告值的可比性公平条件是只看未见说话人每项都带干净语音实测下限等错误率还带三粒种子的均值标准差方向是等错误率越高越好词错误率越低越好恢复相似度越高越好下表直接给出带单位的完整数字表头单位覆盖整列数据格不另加百分号。
| Metric | Floor | Ours | McAdams | Rano [3] |
|---|---|---|---|---|
| EER, ECAPA (%) | 2.83 | 26.31 ± 0.25 | 8.44 | 47.81 |
| EER, ResNet (%) | 2.08 | 27.86 | 6.37 | — |
| WER (%) | 2.48 | 11.75 | 3.61 | 11.91 |
| Simspk (%) | 94.90 | 94.90 | n/a | 87.75 |
上表是 38 个未见说话人上的最终系统 ECAPA 等错误率从下限 2.83% 升到 26.31% 加减 0.25% 约 9.3 倍留出 ResNet 为 27.86% 且它是更强的验证器干净下限更低到 2.08% 说明结果不是靠迎合评价验证器刷出来的词错误率 11.75% 对下限 2.48% 恢复 94.90% 恰等于声码器往返下限意味着逆向本身没有可测代价恢复质量只被声码器卡住与 McAdams 的交换很直白约 8 个点的词错误率换约 18 个点的等错误率外加对方给不了的可逆性与 Rano 报告值的比较要小心对方 ECAPA 为 47.81% 恢复 87.75% 我方 ECAPA 更低但恢复更高词错误率绝对值接近但对方下限 6.58% 我方下限 2.48% 匿名代价在我方更大且 Rano 列是原文发表值协议不同不是受控基线直接排名会误导 Simspk 下限即未改动语音声码器往返相似度是任何恢复能达到的上限。本表数值与单位依据论文 PDF。
拿掉两条内容约束会发生什么
这个消融要回答的是内容约束是否真的管住了退化解。两臂共享初始化、数据、batch 与步数,同训 3000 步,唯一差别是锚损失与范围损失开或关,测在 50 句、10 人的子集上,识别下限是 2.01%,真实对数梅尔约到 10.2,都用早期声码器,因此两臂之间可比,但绝对值不能直接搬到主表。
| EER | WER | mel | max | triplet | |
|---|---|---|---|---|---|
| (%) | (%) | MSE | mel | loss | |
| Losses off | 41.60 | 117.58 | 6.551 | 12.4 | 0.0039 |
| Losses on | 21.20 | 8.29 | 1.338 | 8.5 | 0.163 |
| Starting point | — | — | 1.294 | 9.2 | — |
关掉约束的一臂隐私更好看,等错误率 41.60%,接近原文报告的 47.8%,但词错误率 117.58%,超过 100% 是因为识别器在近似噪声上幻觉出大量插入。机制也看得见:梅尔均方误差 6.551,是对照的约 5 倍,最大值 12.4 超过真实语音的约 10.2,而三元组损失塌到 0.0039,按已发表目标它是优等生。开约束一臂等错误率 21.20%、词错误率 8.29%、梅尔误差 1.338、三元组 0.163,隐私数字回落但语音可用。
结论的边界是:这是实现配置下观察到的性质,不是已发表方法的缺陷;消融一次去掉了两个损失、单种子小子集,没有分开各自贡献。
换验证器与猜错密钥各付出什么
验证器切换的比较固定锚权重 0.2 与三元组权重 5,只换训练验证器。轻量版得 18.35% 等错误率、8.71% 词错误率,蒸馏版得 39.58% 等错误率、39.52% 词错误率,21.2 个点的隐私增益在该锚权重下是以可用性骤降换的,这正是报告系统把锚权重提到 1.0、用部分隐私换回可用语音的原因。这两跑用的是见过说话人与 Griffin-Lim 声码器的早期协议,只能比相对,不能与主表比绝对值。在评价说话人上蒸馏版与 ECAPA 余弦对齐 0.730 加减 0.098,低于训练 batch 末的 0.878,两两相似矩阵相关 0.766、平均绝对差 0.085,说明只是近似复刻,匿名压力超过该 fidelity 后只会优化进两者分歧区,费可用性却不涨可测隐私。
密钥安全的比较问题是猜错密钥能否给出搜索梯度。下表在 303 句上按正确条件与错误条件的欧氏距离分箱报告恢复相似度,错误密钥越低越好,平坦比绝对值更重要,且距离定义与原文不同,只能看趋势。
| Case | mean Dkey | Ours (%) | Rano [3] (%) |
|---|---|---|---|
| Correct key | 0.00 | 95.28 | 87.75 |
| 0.1 < Dkey < 0.2 | 0.14 | 4.09 | 12.78 |
| 0.2 < Dkey < 0.3 | 0.24 | 4.41 | 9.49 |
| 0.3 < Dkey < 0.4 | 0.35 | 4.30 | 4.66 |
上表表头单位为 (%),数据格保留原表不带 % 的写法:正确密钥恢复对应 95.28,任何错误密钥都掉到约 4,即表中 4.09、4.41、4.30,而该评价集上不同说话人间的 ECAPA 相似度均值是 7.66%(标准差 8.98%),即猜错后并不比无关录音更接近原人。更关键的是平坦:我方在各距离箱约 4.2 不动,失败尝试不泄露离正确密钥有多近;原文报告值随猜测变近从 4.66 升到 12.78,给了可爬坡的梯度。限制是这些跑用早期声码器,且距离度量与原文不对齐,不能当匹配测量去排胜负。
结论在哪些条件下才成立
先说隐私上限。等错误率被蒸馏 fidelity 卡住,留出说话人上对齐只有 0.730,超过该点再加匿名压力主要进分歧区,隐私不涨、词错误率继续付钱。评价只覆盖单语料 38 人与无知攻击者,未测在匿名语音上重训的知情攻击者,也未报告 VoicePrivacy 的声音区分度与基频相关性,因此不能直接与挑战提交排名。
再说恢复与声码器。恢复评的是匿名频谱而非匿名音频,部署需要无损存该表示;主表与消融混了两个声码器,论文分开报告并给出差异在种子波动内,但合并阅读时仍要认准表注。消融一次去两损失、单种子 50 句,没有分离锚与范围各自的贡献,蒸馏两项也没有单独消融。
最后是复现口径。退化解是在论文导向的复现配置下观察到的,没有官方实现对照,不能排除架构与进度差异的影响;Rano 列都是发表值、协议不同,只有表 1 的匹配消融才是内容约束效果的直接证据。来源方面,本次未发现可验证的作者代码、模型或数据链接,不能写成已公开,这是来源未确认,不是技术缺陷。
要复现第一步该做什么
先把数据与划分钉死。用 VCTK 与 LibriTTS train-clean-100 的 85 比 15 utterance 切分训验证器、条件生成器与匿名器,留出 15% 只做验证选点;评价固定 LibriTTS test-clean 中 38 人 303 句的抽取规则,每人至多 8 句、有参考文本、每人至少 4 句,并程序化确认与所有训练语料无交集。声码器若要对标主表,只在 VCTK 上从通用权重微调 30,000 步以匹配 80 维、22.05 kHz、帧移 256、窗长 1024 的梅尔配置。
再把评价脚手架搭对。每项指标先跑干净语音下限,ECAPA 与留出 ResNet 都用余弦打分,目标与冒充试验含同句的匿名与原始版、下限去掉自配对;识别固定 Whisper large-v3;恢复相似度同时跑声码器往返上限。密钥必须用有种子生成器每说话人一 key,跑三粒种子报均值标准差,否则约 2 个点的波动会被当成提升。
训练顺序是先蒸馏再重训条件生成器最后训匿名器,换验证器不换生成器会让三元组比较不兼容空间。匿名器先低锚权重跑 52,000 步再热启动高锚权重跑 12,000 步,取第二阶段 8k 步 checkpoint,margin 0.3、行列式权重 0.01。没有训练资源的读者可先复现评价部分,用已有匿名频谱验证下限、留出验证器与种子方差这三件事。
什么时候值得试、还缺什么验证
当任务需要平时匿名共享、授权时恢复原声,且能接受约 9 个点词错误率代价换约 23 个点等错误率提升时,这套加缰绳的可逆方案值得试。它的恢复本身不丢说话人相似度,瓶颈在声码器;错误密钥响应平坦,不给猜密钥者爬坡信号,这对密钥部署是加分项。若场景要求极低词错误率或要扛知情攻击,就不要直接照搬当前工作点,需要重调锚权重或补更强攻击测试。
容易产生的误解要澄清。高三元组低一致性不等于匿名好,表 1 关约束臂就是反例;ECAPA 上 26% 不是在原论文协议下赢了 47%,两者协议、下限与实现都不同;恢复 94.9% 等于往返上限不代表恢复完美,只代表可逆部分没再丢,端到端仍受声码器限制。
还缺的验证很具体:分开锚与范围各自的贡献与多种子重复;蒸馏两项各自的作用;在匿名数据上重训的知情攻击者;多语料、多说话人规模与 VoicePrivacy 区分度、基频相关性的补测;以及匿名音频而非匿名频谱直恢复的部署路径。这些补上后,才能谈实际隐私保护语音应用。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses