📄 SMEBench:用合成的 MIDI 编辑为音乐编辑建立成对评测
英文题目:SMEBENCH: Benchmarking Neural Music Editing with Synthetized MIDI Edits
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Matthieu Cervera:机构信息未能在本次解析中与作者逐人可靠绑定
- Francesco Paissan:机构信息未能在本次解析中与作者逐人可靠绑定
- Micael Antunes:机构信息未能在本次解析中与作者逐人可靠绑定
- Mirco Ravanelli:机构信息未能在本次解析中与作者逐人可靠绑定
- Ricard Marxer:机构信息未能在本次解析中与作者逐人可靠绑定
- Cem Subakan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是音乐编辑,输入是一段原音频加一条文字编辑要求,输出是一段应改动指定属性又保留其余内容的新音频,困难在于没有已知正确结果时难以区分保持得好、文字相似度高与真正改对。论文从符号音乐出发,先裁剪 10 秒片段并判断适用操作,再对音符、声部或力度施加已知干预,然后用同一音色库渲染源与目标,最后生成指令与描述文本并过滤低质量样本。一个样本的文字指令进入编辑系统,系统输出音频再分别与源音频和配对目标比较,从而分离保持度与目标一致性。与以往只有源提示而无配对目标的评测相比,该做法把编辑正确性变成可核对的参照问题。在 3,600 例测试上,编辑描述条件下的目标音频相似度指标中 SteerMusic 达到对比语言音频预训练(Contrastive Language-Audio Pretraining,CLAP)音频相似度 0.691,为同条件六个系统最高,而文字兼容性指标却偏向 MusicGen 的 0.350,说明换指标会换排名。结论适用于 12 种乐器、发音、力度与音高操作的可控合成情形,真实录音、演唱、混音与风格迁移尚未覆盖。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
音乐编辑要同时做对哪三件事
音乐编辑的输入是两样东西:一段已有录音和一条文字要求。输出是一段新音频。理想输出要满足 3 个条件。第一,执行了要求的变化,例如去掉鼓或渐强。第二,保留了不该动的内容,例如旋律和速度基本不变。第三,没有引入无关改动,例如音质明显变差或多出乐器。
初学者容易把生成好听和编辑正确混在一起。生成模型本身很强,能输出通顺的音乐,但这不等于它按指令改了正确位置。只看与源音频的相似度,会奖励什么都不改的系统;只看与文字的相容度,可能对局部乐器、演奏法和力度的变化不敏感;只看无参照音质,只能说好不好听,不能说改没改对。所以需要把保持、改对、像文字所说分开测量。
本文的背景就是缺少配对目标。很多现有评测只有源音频加目标描述,没有改完应该是什么样子的音频参考。论文要补的就是这个缺失对象:在保持音乐素材不变的前提下,给出已知变换后的对照音频,让保留和接近目标可以分别计算。
已有配对数据和无配对评测各缺什么
在配对数据一边,AUDIT 把输入输出三元组做成加、删、替换、修复和超分等操作,目标多来自混音、分离、掩蔽和重建等信号级处理,没有干预底层演奏内容。InstructME 针对加、删、提取、替换和重混,用音轨级操作构造目标。它们证明了配对监督的价值,但不是对配器、演奏法、力度和音高的受控音乐干预。
在无配对评测一边,MedleyMDPrompts 基于 MedleyDB 的真实录音写了源和目标提示,但没有对应的编辑后音频。ZoME-Bench 从 MusicCaps 选例并标注多种编辑类别,同样没有目标音频。它们更接近真实录音,适合测自然条件下的表现,但只能从文本相符或相对源的变化推测是否改对,不能对照已知正确结果。
论文把自己的位置放在两者之间:不替代真实录音评测,而是提供受控的配对参照。比较条件要对齐:只有输入、目标、监督形式和运行阶段相同才能谈优劣。信号级混合目标与符号级音乐干预目标属于不同任务设定,本文不把它们放在同一指标下直接排名,而是说明各自覆盖的编辑类型不同。
没有配对目标时评测为什么会混淆
论文要解决的具体问题是:当不知道改完应该是什么声音时,常用指标会把三件事混在一起。源参照指标希望输出接近源,目标参照指标希望输出接近已知正确结果,文本音频指标希望输出与文字相容。没有配对目标,只能用前者和后者代替正确性。
作者用两个可解释端点来暴露这种混淆。原样返回源音频的做法记为 Identity,它保留完美但完全没有执行编辑。已知干预生成的配对目标记为 Ground Truth,它代表受控的正确变换。好的源参照应该更偏好 Identity,好的目标参照应该更偏好 Ground Truth,而文本相容只有能区分这两个端点时才对编辑有用。
源音频 × 配对目标音频: 源音频是编辑前的录音,配对目标音频是把同一段音乐按指令改完后的录音,二者只有已知干预不同。源参照衡量保留了多少,目标参照衡量走近了多少,只有同时对照才能把没改和改对分开。
SMEBench 用一条流水线造出什么样的样本
SMEBench 把 MIDI 当作干预层。先取一段 10 秒 MIDI,分析其中有哪些乐器和鼓,决定哪些编辑可用;再在符号层执行选定的改动;然后用同一个 SoundFont 把改前和改后渲染成音频;最后做可听性和质量过滤,并生成 4 种文字。每条样本包含源音频、指令、配对目标音频、编辑元数据和配套描述。
总量上,论文报告共有 11160 对配对编辑,其中均衡测试集 3600 条,12 种操作各 300 条,另有 416 对来自真实多轨录音的补充集 SME-Real。发布内容包括源与目标音频、MIDI、指令与描述、元数据和表示被编辑成分与剩余成分的掩码。
下面先看总体构造路线,再分别解释编辑类型、渲染过滤和文本生成。读图时把重点放在样本从输入到入库要过几道门。
总体构造路线是先采样再合成、文本支路并行、两路过滤都通过才入库。
看图路径: 1. 从左侧 MIDI 输入沿箭头看到 10 秒切分进入编辑采样;2. 对比上方音频合成过滤与下方文本生成两条支路的汇合条件;3. 注意两个菱形过滤器各自的通过与丢弃出口

论文图 1。原论文 Figure 1::“Overview of the SMEBench construction recipe.”。
图 1 可见左侧蓝色输入框是一份 MIDI 文件并标出 10 秒切分,中间红色编辑采样框包含乐器感知用量和编辑类型、音轨选择、SoundFont 与指令选择,上方灰色框是 FluidSynth 合成器加波形再加指标过滤器,下方黄色框是特征提取加文本生成模型再加法官模型,绿色虚线表示两路都通过才形成新的基准条目,红色虚线表示任一路失败则丢弃。这种双门设计对应论文的两个主张:音频差异要可听且不过度,文字要准确且只改相关部分。
十二种编辑覆盖哪些音乐操作
12 种操作分四族。配器族包括去掉、替换、提取或加倍一种乐器,以及去掉、替换或提取鼓。演奏法族是把音符变短得到断奏或延长得到连奏。力度族是对选定乐器或整体做渐强或渐弱。音高族是校正选定乐器或整体的音准:源中每个音符被加上负 50 到正 50 音分之间均匀采样的偏移,目标保持在以 A4 等于 440 赫兹为基准的十二平均律网格上。
可用性是按 excerpt 决定的。乐器不存在就不能删,提取后几乎为空就丢弃,这样减少幽灵编辑和退化编辑。有些编辑可作用于多个乐器,论文不均匀抽取,而是按感知用量加权,让更突出的声部更可能被选中,同时保留较弱声部被选中的可能。
12 种操作的层级关系是配器下再分乐器与鼓,演奏法、力度和音高各自并列。
看图路径: 1. 先看左侧四个大类再向右看乐器与鼓的细分;2. 数清配器、演奏法、力度、音高四个分支下的操作总数
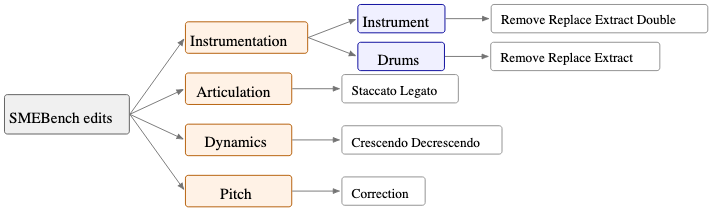
论文图 2。原论文 Figure 2::“SMEBench edit taxonomy. Each of the twelve operations is sampled only when the excerpt contains an eligible target.”。
图 2 可见最左是 SMEBench edits 总节点,向右分出配器、演奏法、力度和音高 4 个分支;配器再分乐器和鼓,乐器下是去掉、替换、提取和加倍,鼓下是去掉、替换和提取;演奏法下是断奏与连奏,力度下是渐强与渐弱,音高下是校正。这张图帮助记忆测试集每类 300 条的划分,也说明力度与音高可作用于单个乐器或整体而不改变操作类别。
MIDI × SoundFont 渲染: MIDI 记录音符、时值、力度和乐器分配,是可精确改写的符号层;SoundFont 渲染是把符号变成波形的合成器。二者搭配让改动发生在符号层、声音差异只来自改动本身,而不是换了演奏或录音条件。
符号改动、音频渲染和过滤具体怎么做
符号层的改法在附录中逐条规定。去掉是删除对应音轨,鼓的去掉按通用 MIDI 约定删除第 9 通道事件;替换是换成通用 MIDI 音色库中的另一个音色,鼓则映射到另一打击乐音色;提取是只保留目标并删掉其余;加倍是新建一个随机乐器音轨演奏与源选定乐器相同的音符。断奏把音符时长设为所在起音簇间隔的 40% 并截断到 40 到 120 毫秒之间,连奏把音符向下一簇延长间隔的 15%,单声部还加 MIDI 控制器信息强化滑音。
力度不用只改 MIDI 力度,因为听感不明显,而是对合成后音频加包络。对时长为 T 的片段,增益包络写作时间归一化后的函数形式,渐强用随时间上升的函数,渐弱用下降函数。
\[g(t)=g_{0}f(t/T),\]该式要计算的是随时间变化的增益,g0 是基准增益,f 是归一化时间上的包络形状,t 除以 T 把绝对时间映射到零到一之间,结果再用于下一步的波形幅度调制。
目标乐器按感知用量抽样。先按帧取活跃音符中归一化力度的平方最大值再平均,得到用量估计;再在有非零用量的乐器之间归一化成选择概率。
\[u_{\mathrm{percep}}=\frac{1}{N}\sum_{i=1}^{N}\max_{j\in\mathcal{N}_{i}}\left(\frac{v_{j}}{127}\right)^{2}.\]该式中 N 是帧数,N_i 是第 i 帧的音符集合,v_j 是零到 127 的 MIDI 力度,除以 127 归一化后平方再取帧内最大并平均,平方关系对应力度与峰值均方根幅度的经验关系。
\[p(k)=\frac{u_{\mathrm{percep}}^{(k)}}{\sum_{j=1}^{K}u_{\mathrm{percep}}^{(j)}}.\]该式把每个候选乐器的用量除以全部候选用量之和,得到选中概率,突出声部概率大但弱声部不为零。
渲染用 FluidSynth,5 个 SoundFont 库覆盖 MIDICaps 中多数通用 MIDI 乐器,每对样本随机抽一个 SoundFont 并对源与目标共用,使差异只来自编辑。音频存为单声道、22050 赫兹、32 位浮点。过滤用 LPAPS 与 CLAP 音频相似度的上下界去掉变化过小或过大者,再用 Audiobox Aesthetics 均值去掉质量过低者。论文强调这些是构造时过滤,不是目标正确的证明,后续还要用人听验证。
本研究没有训练新模型,文本是怎样构造和把关的
本节先明确训练情况:论文没有训练新的编辑模型,被评测的 6 个系统都用已有 checkpoint 运行,SDEdit 等 5 个零样本扩散编辑方法共享 AudioLDM2 音乐 checkpoint,MusicGen 作为无源保留的文本生成基线。SMEBench 本身的构造也不训练音频模型,它的计算是规则改写 MIDI、固定渲染、特征提取加调用大语言模型写文字。
4 种文字分工不同。源描述写改前音频,编辑后描述写改后音频且只改受影响的最小片段;编辑指令是祈使句的用户请求,由每类模板加乐器与操作元数据确定性生成;规范化描述是标准化结果描述并显式列出配器。特征来自 MIDI 与音频的乐器、速度、拍号、密度、力度和调式估计等结构化事实,加上 MIDICaps 原描述和编辑元数据,一起交给 Qwen3-30B-A3B-Instruct-2507 写出源与编辑后描述并改写规范化描述。
把关用同一家族模型的法官检查指令是否保留原意、目标描述是否反映编辑、无关内容是否增删、详略是否一致,不通过则丢弃。论文承认生成与过滤用同一模型家族可能带来相关误差,因此另用 Mistral 独立 checkpoint 做一致性分析,并在听感实验中独立评估保留下来的描述,不把过滤通过本身当作正确性证明。
编辑说明 × 编辑后描述: 编辑说明是祈使句的用户请求,例如把某乐器换成另一种;编辑后描述是对结果音频本身的陈述性描写。论文用前者测系统能否听懂指令,用后者测系统能否接近目标声音,二者输入形式不同,评测时要分开比较。
评测用哪些参照、指标和基线
评测分 3 个轴。源参照用 CLAP-Audio 相似度和 LPAPS 距离对源计算,衡量保留;目标参照用同样两个指标对配对目标计算,衡量接近已知正确结果;文本相容用 CLAP-Text 在编辑后描述、指令和规范化描述下计算,衡量与文字的相容。方向是 CLAP 越高越好,LPAPS 越低越好,Audiobox Aesthetics 越高越好。
CLAP-Audio × LPAPS: CLAP-Audio 是在音频嵌入空间算余弦相似度,越高越相近;LPAPS 是在多层特征上算感知距离,越低越相近。前者偏全局语义相近,后者对局部时频细节更敏感,论文把二者分别对源和对目标计算,形成四种音频参照。
CLAP-Text × Audiobox Aesthetics: CLAP-Text 衡量音频与一段文字在联合嵌入空间的相容程度,越高文字描述越贴合;Audiobox Aesthetics 是不需要参照的音质估计,越高预估听感越好。前者回答像不像文字所说,后者回答好不好听,都不能直接证明改对了哪个音符。
被测系统包括 SDEdit、DDIM 反演、ZETA、虚拟一致性反演、SteerMusic 5 个零样本扩散编辑方法,以及 MusicGen 文本生成基线。运行时按接口分别用指令或编辑后描述作为条件,对源与目标都报告音频指标,并报告多种文本条件下的 CLAP-Text 和无参照音质。测试默认用 3600 条均衡集,416 条真实多轨补充集另行报告。真实补充集去掉串音音轨后,用包含音轨的增减做去掉与提取,用窗色谱图与起音包络相关找相似素材的不同音色做加倍与替换,用增益包络做力度变化。
配对目标和文字描述的人听验证说什么
符号上改对不等于听起来改对,所以论文先做听辨。17 人参加,每人听 20 组随机源目标对并看指令,按 5 分制评价目标整体质量、与源的对齐、与指令的对齐,以及随机抽到的源或编辑后描述的质量。与源对齐问的是除要求改动外是否仍认得出是同一来源,而不是每个成分都保留。
为判断保留下来的目标与描述能否作为评测参照,论文汇总了 236 次编辑评价和 174 次描述评价的 5 分制人评结果,报告 4 个维度的均值、回答数和被试聚类自助置信区间。
| Criterion | Mean | Responses | 95% CI (participant bootstrap, n=17) |
|---|---|---|---|
| Target quality | 4.23 | 236 | [4.06, 4.39] |
| Alignment with source | 4.65 | 236 | [4.57, 4.73] |
| Alignment with instruction | 3.99 | 236 | [3.72, 4.23] |
| Pipeline-caption quality | 3.70 | 174 | [3.46, 3.98] |
表中目标质量 4.23,源对齐 4.65,指令对齐 3.99,流水线描述质量 3.70。目标在可听质量和来源一致性上较强,指令对齐较低且有 13.2% 的差评,说明部分渲染变换听感不明显;描述有 71.2% 为好或很好,但仍有改进空间。
论文进一步按编辑拆分,发现连奏、去掉乐器和替换鼓三项的指令跟随没有可靠超过量表中点,予以保留但另行报告并在汇总感知聚合中剔除。剔除后剩下九项 164 试次的指令跟随均值 4.30,源一致性 4.69,整体质量 4.43。这意味着结论的适用条件是:多数操作的目标可用,但上述三项的听感归因不稳定,引用总平均时要说明是否包含它们。
源与目标在指标空间里离得多远
在看系统排名前,先看源与目标本身的距离,否则跨编辑比较绝对值会误导。下表比较合成测试集与真实补充集在文本相容、无参照音质和音频距离上的源目标分离程度,条件分为合成测试集与真实补充集。
| Metric | Test set Source | Test set Target | Real-audio complement Source | Real-audio complement Target |
|---|---|---|---|---|
| CLAP-Text (caption) ↑ | 0.249 | 0.278 | 0.134 | 0.123 |
| CLAP-Text (instruction) ↑ | – | 0.160 | – | 0.125 |
| CLAP-Text (normalized) ↑ | 0.291 | 0.308 | – | – |
| Audiobox Aesthetics ↑ | 6.903 | 6.734 | 7.247 | 6.952 |
| LPAPS (Src ↔GT) ↓ | 1.513 | 1.513 | 2.167 | 2.167 |
| CLAP-Audio (Src ↔GT) ↑ | 0.873 | 0.873 | 0.804 | 0.804 |
合成集源与目标的 CLAP-Audio 均值 0.873、LPAPS 均值 1.513,真实补充集对应为 0.804 和 2.167,说明可用真实编辑的源目标分离更大。这些只是分离程度的刻画,不能直接证明改对了,而且不同编辑不可比:提取只留一个成分,全局变化大,演奏法与音高只改局部属性,数值自然小。
不同编辑组的指标分布进一步证实了上述分离特征,阅读时不应把绝对值直接当成统一的好坏线,仍需结合编辑类型理解数值含义。
看图路径: 1. 横向比较 Extract 行与其他行的 LPAPS 与 CLAP-Audio 箱体位置;2. 纵向比较同一编辑组在三种文本条件下的离散程度

论文图 3。原论文 Figure 3::“Metric distributions by edit group on the SMEBench test split.”。
图 3 把 12 种操作并成 8 组箱线图,从左到右依次是 LPAPS 距离、CLAP 音频相似度、3 种文本条件下的 CLAP 分数。可见提取组的 LPAPS 明显偏大而 CLAP 音频明显偏小,断奏、连奏和音高组的音频距离较小;规范化描述的文本分数跨组更平稳,但这可能是对编辑不敏感而不是更好的编辑指标。按乐器感知用量排序时,越突出的目标带来越大的指标位移,说明指标敏感度 partly 来自显著度而不只是操作正确性。
换一个参照为什么系统排名会反转
核心结果是参照不同则排名不同。比较问题是在同一测试集、同一条件输入下,文本相容选出的最优系统是否也是最接近配对目标的系统。下表给出编辑后描述条件与指令条件下 6 个系统的 CLAP 文本、对目标的 CLAP 音频和 LPAPS,数值为均值加 95% 自助置信区间。
| Conditioning | System | CLAP-T ↑ | CLAP-A GT ↑ | LPAPS GT ↓ |
|---|---|---|---|---|
| Edit caption | SDEdit | 0.296 [0.293, 0.299] | 0.625 [0.621, 0.628] | 4.969 [4.951, 4.986] |
| DDIM | 0.283 [0.279, 0.286] | 0.652 [0.648, 0.655] | 4.981 [4.964, 4.998] | |
| VCI | 0.299 [0.296, 0.303] | 0.614 [0.610, 0.618] | 4.908 [4.887, 4.929] | |
| ZETA | 0.287 [0.284, 0.290] | 0.654 [0.651, 0.657] | 4.937 [4.918, 4.956] | |
| SteerMusic | 0.269 [0.266, 0.272] | 0.691 [0.688, 0.694] | 4.482 [4.458, 4.506] | |
| MusicGen | 0.350 [0.347, 0.353] | 0.492 [0.489, 0.497] | 5.926 [5.914, 5.939] | |
| Instruction | SDEdit | 0.227 [0.223, 0.231] | 0.585 [0.580, 0.589] | 5.046 [5.028, 5.063] |
| DDIM | 0.203 [0.199, 0.207] | 0.596 [0.591, 0.601] | 5.094 [5.076, 5.111] | |
| VCI | 0.266 [0.262, 0.269] | 0.363 [0.357, 0.369] | 5.576 [5.555, 5.595] | |
| ZETA | 0.199 [0.195, 0.203] | 0.633 [0.630, 0.637] | 4.954 [4.936, 4.972] | |
| SteerMusic | 0.194 [0.191, 0.198] | 0.583 [0.579, 0.587] | 4.956 [4.934, 4.977] | |
| MusicGen | 0.198 [0.194, 0.202] | 0.406 [0.402, 0.411] | 6.099 [6.086, 6.111] |
编辑后描述条件下 CLAP 文本最高的是 MusicGen 的 0.350,但两个目标音频指标最好的是 SteerMusic,对目标 CLAP 音频 0.691、对目标 LPAPS 4.482;指令条件下 CLAP 文本最高的是虚拟一致性反演的 0.266,但两个目标音频指标最好的是 ZETA,对目标 CLAP 音频 0.633、对目标 LPAPS 4.954。论文强调这是诊断性比较而非穷尽正确性,因为有些指令允许多个合理解,配对目标只是其中一个受控实现;即便如此,宽泛的文本相容也不能保证接近一个已知合理解。
系统在合成与真实集上的表现连线显示合成到真实的变化,但不改变上述反转逻辑。
看图路径: 1. 区分上半编辑后描述条件与下半指令条件的整体点云位置;2. 沿同一方法的蓝色与橙色连线看合成到真实录音的变化方向

论文图 4。原论文 Figure 4::“System performance on SMEBench and SME-Real under edit-caption conditioning (top) and edit-instruction conditioning (bottom).”。
图 4 上半为编辑后描述条件、下半为指令条件,每列分别是音质、目标 CLAP、目标 LPAPS、源 CLAP 和源 LPAPS,蓝色为合成集、橙色为真实集,连线为同一方法跨库变化。可见目标与源指标分离看保留与接近目标,MusicGen 在文本与音质上不弱但在目标音频上偏弱,而扩散编辑方法在目标音频上相对更近。这种分离正是论文主张分轴报告的原因,不能压缩成单一总分。
真实录音补充集改变了什么和没改变什么
补充集的作用是检验合成结论在更真实声学下是否还成立,而不是复刻 12 类覆盖。它只有 416 对、来自 107 首曲目,做法是开关真实分轨或加增益包络。条件不同就不强排胜负,只看趋势是否一致。
完整音频保真度数字表明,真实集上各系统的绝对值整体下降,但方法间的相对关系与合成集大体相近,SteerMusic 在目标音频上仍相对占优,MusicGen 仍偏向文本与音质而非目标接近。文本保真度数字同样显示,真实集上编辑后描述与指令的 CLAP 文本不高,且文本最优与目标音频最优不重合。
| Method | Aesth. ↑ | CLAP-A GT ↑ | CLAP-A Src ↑ | LPAPS GT ↓ | LPAPS Src ↓ |
|---|---|---|---|---|---|
| Real-audio complement, edit-caption conditioning | |||||
| Identity | 7.247 [7.2010, 7.2926] | 1.000 | 0.804 [0.7830, 0.8247] | 2.167 [1.9977, 2.3384] | 0.000 |
| Ground Truth | 6.947 [6.877, 7.016] | 0.804 [0.783, 0.824] | 1.000 | 0.000 | 2.167 [1.998, 2.338] |
| SDEdit | 6.737 [6.675, 6.797] | 0.490 [0.474, 0.507] | 0.503 [0.488, 0.519] | 5.093 [4.990, 5.192] | 4.947 [4.842, 5.054] |
| DDIM | 6.589 [6.497, 6.679] | 0.418 [0.404, 0.434] | 0.414 [0.399, 0.429] | 5.195 [5.091, 5.298] | 5.058 [4.951, 5.163] |
| VCI | 6.036 [5.912, 6.146] | 0.447 [0.425, 0.468] | 0.426 [0.405, 0.448] | 4.806 [4.690, 4.918] | 4.638 [4.519, 4.756] |
| ZETA | 7.062 [7.002, 7.122] | 0.469 [0.454, 0.483] | 0.492 [0.477, 0.506] | 4.837 [4.725, 4.945] | 4.552 [4.433, 4.669] |
| SteerMusic | 6.770 [6.711, 6.829] | 0.594 [0.581, 0.608] | 0.661 [0.647, 0.674] | 4.321 [4.219, 4.427] | 3.786 [3.667, 3.900] |
| MusicGen | 7.021 [6.984, 7.058] | 0.443 [0.430, 0.457] | 0.448 [0.434, 0.463] | 5.365 [5.272, 5.453] | 5.308 [5.218, 5.397] |
| Real-audio complement, instruction conditioning | |||||
| SDEdit | 5.677 [5.573, 5.766] | 0.317 [0.301, 0.334] | 0.316 [0.299, 0.334] | 5.382 [5.279, 5.480] | 5.248 [5.141, 5.359] |
| DDIM | 5.539 [5.405, 5.665] | 0.291 [0.272, 0.309] | 0.290 [0.272, 0.310] | 5.386 [5.280, 5.491] | 5.248 [5.141, 5.358] |
| VCI | 4.924 [4.843, 5.012] | 0.223 [0.207, 0.240] | 0.187 [0.171, 0.204] | 5.332 [5.226, 5.439] | 5.237 [5.129, 5.344] |
| ZETA | 6.589 [6.499, 6.677] | 0.395 [0.379, 0.411] | 0.421 [0.403, 0.439] | 4.948 [4.839, 5.052] | 4.638 [4.522, 4.758] |
| SteerMusic | 6.564 [6.500, 6.629] | 0.509 [0.496, 0.524] | 0.559 [0.544, 0.575] | 4.575 [4.472, 4.673] | 4.103 [3.979, 4.216] |
| MusicGen | 6.567 [6.499, 6.630] | 0.352 [0.338, 0.366] | 0.346 [0.332, 0.361] | 5.536 [5.445, 5.623] | 5.507 [5.416, 5.594] |
| Test set, instruction conditioning | |||||
| Identity | – | 0.873 [0.868, 0.878] | 1.000 | 1.513 [1.470, 1.557] | 0.000 |
| Ground Truth | 6.734 [6.716, 6.753] | 1.000 | 0.873 [0.868, 0.878] | 0.000 | 1.513 [1.470, 1.557] |
| SDEdit | 6.517 [6.494, 6.538] | 0.585 [0.580, 0.589] | 0.608 [0.604, 0.613] | 5.046 [5.028, 5.063] | 4.859 [4.840, 4.876] |
| DDIM | 6.354 [6.329, 6.379] | 0.596 [0.591, 0.601] | 0.619 [0.614, 0.624] | 5.094 [5.076, 5.111] | 4.893 [4.874, 4.912] |
| VCI | 5.290 [5.263, 5.317] | 0.363 [0.357, 0.369] | 0.339 [0.332, 0.344] | 5.576 [5.555, 5.595] | 5.531 [5.508, 5.553] |
| ZETA | 6.570 [6.550, 6.590] | 0.633 [0.630, 0.637] | 0.657 [0.653, 0.660] | 4.954 [4.936, 4.972] | 4.693 [4.675, 4.711] |
| SteerMusic | 6.641 [6.623, 6.659] | 0.583 [0.579, 0.587] | 0.604 [0.600, 0.609] | 4.956 [4.934, 4.977] | 4.682 [4.658, 4.706] |
| MusicGen | 6.822 [6.804, 6.839] | 0.406 [0.402, 0.411] | 0.419 [0.414, 0.423] | 6.099 [6.086, 6.111] | 6.042 [6.030, 6.055] |
| Test set, edit-caption conditioning | |||||
| SDEdit | 6.983 [6.967, 6.999] | 0.625 [0.621, 0.628] | 0.660 [0.657, 0.663] | 4.969 [4.951, 4.986] | 4.762 [4.744, 4.779] |
| DDIM | 6.766 [6.745, 6.785] | 0.652 [0.648, 0.655] | 0.683 [0.680, 0.687] | 4.981 [4.964, 4.998] | 4.759 [4.740, 4.776] |
| VCI | 6.603 [6.580, 6.624] | 0.614 [0.610, 0.618] | 0.635 [0.630, 0.639] | 4.908 [4.887, 4.929] | 4.701 [4.681, 4.724] |
| ZETA | 6.766 [6.749, 6.785] | 0.654 [0.651, 0.657] | 0.683 [0.680, 0.686] | 4.937 [4.918, 4.956] | 4.673 [4.653, 4.693] |
| SteerMusic | 6.892 [6.875, 6.908] | 0.691 [0.688, 0.694] | 0.739 [0.736, 0.742] | 4.482 [4.458, 4.506] | 4.081 [4.057, 4.105] |
| MusicGen | 7.111 [7.099, 7.122] | 0.492 [0.489, 0.497] | 0.517 [0.513, 0.521] | 5.926 [5.914, 5.939] | 5.815 [5.803, 5.827] |
为比较同一方法在合成与真实配对目标下的音频保真与音质,下表按合成集与真实集、编辑描述条件与指令条件分别列出美学分数、与目标和源的 CLAP 音频相似度及 LPAPS 距离,指标方向是美学与 CLAP 越高越好、LPAPS 越低越好。
合成集的目标距离小、真实集距离大,但源参照与目标参照分开看的必要性没有消失;真实集的音轨开关带来更大场景变化,提取类的大距离不能直接说成更好的编辑。未胜出项也要保留:虚拟一致性反演在指令条件下的目标 CLAP 音频较低,DDIM 等方法的 LPAPS 也偏大,说明没有一个方法在所有轴上同时最好。
雷达图把多轴放在同一视图,离中心越远越好,LPAPS 已反向归一化,便于 1 次看到保留、接近目标、文本相容和音质的权衡,而不是只看单列最优。
哪些结论超出证据就不能下
论文明确列出 4 类边界。第一,受控渲染带来合成到真实的差距,真实补充集较小且做法不同,只能部分缓解,不能证明结论覆盖所有录音。第二,分类只含 12 种 MIDI 可表达操作,不含人声、混音母带、 genre 转换等需要更丰富音频表示的变化。第三,部分操作听感较弱,自动音频与文本过滤依赖预训练模型,可能引入偏差。第四,音乐编辑不是一一对应,合成目标只是一种合理解,接近它不等于穷尽正确,远离它也不一定全错。
还有两点容易误解。文本分数跨组稳定不代表文本指标更好,可能只是不敏感。同一家族模型既写描述又当法官,保留描述的人评不能当作过滤决策本身的验证,论文用独立模型做补充检查并把法官依赖记为局限。
因此使用该基准时,应同时报告保留、目标相符、文本相容和感知质量 4 个轴,不化约为单一总分;引用人听总平均时要说明是否剔除 3 个听感不稳定的操作。
要复现需要准备什么和第一步做什么
复现分基准复现与评测复现。基准侧需要 MIDICaps 的 MIDI 与描述、MoisesDB 的多轨、5 个 SoundFont、FluidSynth 渲染配置、感知用量与采样规则、音频过滤阈值,以及特征提取、写描述与法官的提示词,附录已给出操作定义、渲染参数和提示词全文。第一步建议先跑通单个 10 秒切分的可用性判断与单乐器替换,再检查源与目标是否只用同一 SoundFont 渲染,避免把渲染差异误当编辑。
评测侧需要同一 AudioLDM2 音乐 checkpoint 作为 5 个扩散方法的公共骨干,分别用指令与编辑后描述两种条件运行,并对源与目标同时算 CLAP 音频与 LPAPS,对多种文本算 CLAP 文本,另算无参照音质。随机种子、切分、SoundFont 抽样和过滤的百分位规则要与原文一致,否则绝对值不可比。
关于可用性要分开说:论文给出数据集与生成代码的发布链接,但本次核验显示该链接暂时无法确认可达,不能写成已公开可下载;模型权重与系统可运行是另外的事,需各自确认。许可证方面,基准为 CC BY-NC-SA 4.0 并继承多个第三方资源的原许可,使用时须同时遵守。
什么时候值得用它以及还缺哪项验证
当研究问题是诊断编辑行为而不是只拼好听时,这个基准值得尝试:它能把没改、改对、像文字所说拆开,特别适合检查新指标是否真的对局部配器、演奏法和力度敏感,也适合在提交真实录音评测前先在受控条件下看指标行为。只关心自然录音部署效果时,仍要搭配 Medley 类真实评测,因为合成结论不能直接推广。
复现第一步是按附录重建一小批配对样本并复算源目标距离,确认提取距离大、局部编辑距离小的层级出现,再跑通 Identity 与 Ground Truth 两个端点,验证源参照偏好前者、目标参照偏好后者。
还缺的验证包括更大规模的真实配对覆盖、更弱听感操作的显著性控制、不同文本法官与不同音频嵌入下的稳定性,以及把多合理解显式标注后的目标集评估。在这些补齐前,引用排名反转时应限定为在已知受控实现下的诊断性发现,而不是对所有音乐编辑的一般胜负判断。
📎 论文与评分元数据
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses