📄 从 YouTube 字幕到说话人分段语料:Lipi-Ghor 如何为孟加拉语建 885 小时语音库
评分:7.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
👥 作者与机构
- Sanjid Hasan:机构信息未能在本次解析中与作者逐人可靠绑定
- A H M Fuad:机构信息未能在本次解析中与作者逐人可靠绑定
- Risalat Labib:机构信息未能在本次解析中与作者逐人可靠绑定
- Bayazid Hasan Simon:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是孟加拉语真实语音的自动转写,输入是平均约52分钟的YouTube长音频与孟加拉语字幕轨,输出是带说话人编号、起止时间和转写文本的分段记录,困难在于方言、情感戏剧、语码混用和高说话人密度。处理过程沿四个阶段串行:按17个域人工挑选频道,再用字幕可用性过滤保留带bn轨的视频,接着并行分批抓取音频与字幕并去重,最后用说话人分离模型切分说话人回合并与字幕对齐成SSTT记录。相对已有短句朗读语料,该工作同时提供训练规模、长音频和说话人归属,并公开可复用的构建流程与金标准校对集。该流程把人工频道筛选与自动说话人分离衔接,使字幕文本落到说话人回合上,便于直接用于识别训练。在以YouTube字幕为参考的Lipi-Ghor同一评测下,零样本Hishab TITU Conformer-L的词错误率为30.51%,经约58小时本域数据微调后的Faster Whisper Medium词错误率为20.70%,后者低于前者,显示弱监督数据仍有训练价值。人工校对的金标准分开存放,用于检验字幕噪声而不参与训练。结论适用于有字幕覆盖的公开YouTube域,对无字幕方言和三人以上重叠语音尚未验证。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
- 代码相关资源:https://github.com/Sanjidh090/Lipi-Ghor-bn-882-SSTT — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
孟加拉语语音识别缺的是哪种数据
这篇论文要解决的输入是真实世界里的孟加拉语长音频,目标输出是能区分谁在说话、每句说什么、起止时间在哪的训练语料。读者要先理解,已有孟加拉语资源大多是短句朗读或众包录音,一句话一条文件,没有多人交叠和节目级上下文。
这类短句数据保留了发音信息,但丢掉了必须保留的东西:说话人轮换、情感化语调、方言口音、音乐噪声和长达几十分钟的连贯语流。自动语音识别(把语音转成文字的系统)在这种干净短句上测得很好,一到访谈辩论、电视剧 Natok、宗教布道 Waz 就会明显变差。
Lipi-Ghor 的定位就是补上长音频加说话人标注加多领域这一块。它从 998 个 YouTube 视频、596 个频道收集 885.34 小时音频,覆盖 17 个领域,平均每段约 52 分钟。转写文本来自 YouTube 孟加拉语字幕轨道,所以是大规模弱监督,只能做预训练,不能当作干净评测基准。
已有孟加拉语和网络语料路线为何不够用
要看懂比较条件,必须把任务、输入和监督对齐。早期 SHRUTI 只有几十小时少数人朗读,Common Voice 孟加拉语部分有几百小时但仍是单句朗读,BengaliAI 语料规模大但受控采集、没有按说话人分段的长音频。OOD-Speech 有 23 小时 17 个来源的人工标注测试集,BengaliLoop 做了带人工校对的长音频日志评测,但都是评测规模,不是训练规模。
英文 People’s Speech 和 GigaSpeech、欧洲 VoxPopuli 以及多语 YODAS 证明可以从网络 harvest 大量音频,其中 YODAS 在 100 多种语言中只给孟加拉语留下 27 小时,且只有片段级字幕、没有说话人日志。AMI、DIHARD III、VoxConverse 讨论了自然对话中说话人归属的难度,但都不含孟加拉语。
所以本文的比较不是同条件下的胜负,而是路线差异:在相同想做长音频多说话人孟加拉语训练的前提下,过去没有同时满足大规模、17 领域、说话人切分、长音频的公开资源。论文用表格把规模、领域数、有无日志和长音频并列,正是为了说明这个空位。
论文把困难具体化成哪三个可验证问题
第一个问题是来源可得性:YouTube 上有没有足够多带孟加拉语字幕的长节目,能支撑几百小时的训练。瓶颈不是下载带宽,而是按领域找到字幕覆盖密集的频道。有声书和访谈频道一次上传就很长且常配字幕,方言和健康类又短又少字幕。
第二个问题是标注可信度:字幕是人工上传与自动生成的混合,约 89.78% 为自动生成,直接当真值会高估或低估识别错误。必须另做 500 片段人工金标,用分层抽样保证小领域也有足够样本,才能量化字幕噪声。
第 3 个问题是难度归因:模型在情感化、方言化、碎片化对话上差,到底是因为音频本身难,还是因为某一家模型训练数据偏。需要在同一字幕参考下测 4 个零样本系统,看难度排序是否跨模型一致,再看片段时长和轮次密度能否作为免转写的难度代理。
四步流水线把视频变成 SSTT 语料
整条流水线的输入是人工选出的孟加拉语 YouTube 频道列表,输出是三份切分:原始日志输出、与转写对齐的 885 小时 SSTT 语料、可直接训练的 364 个视频预切块。只有第一步频道筛选是语言相关的,后面三步换一种有字幕的语言也能复用。
读图之前先明确观察任务:沿着从上到下的箭头看数据形态如何从视频变为音频加字幕再变为带说话人的短句,右侧小字标注了每步的关键产物。
看图路径: 1. 从顶部 998 个视频框向下看四级方框的主流程;2. 对照右侧小字看每步的输入输出形态变化;3. 确认最后 SSTT 语料的时长与领域数标注
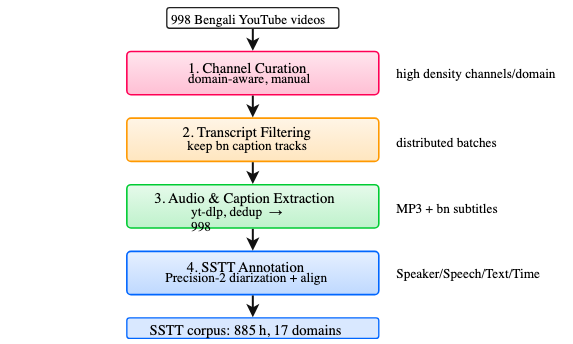
论文图 1。原论文 Figure 1::“The Lipi-Ghor construction pipeline. Four stages turn a curated set of Bengali YouTube channels into a speaker-diarized, SSTT-annotated corpus.”。
图中可见顶部是 998 个孟加拉语 YouTube 视频,经过频道筛选、字幕过滤、音频字幕抽取、SSTT 标注四层,最后落到 885 小时 17 领域的语料。中间标注了用 yt-dlp 抽取 MP3 和孟加拉语字幕、去重到 998,以及用 Precision-2 日志加对齐得到说话人、语音、文本、时间四元组。这张图的作用是让初学者建立样本旅程:长视频先被过滤和下载,再被切成说话人轮次,最后每轮绑定一句字幕。
频道筛选和字幕过滤如何决定领域偏斜
第一步是面向领域的人工频道筛选。做法是先在每个领域找几个量大质高的锚点频道快速起量,再补充长尾频道增加说话人和话题多样性。最终语料既有高产量频道贡献的时长,也有 596 个频道的广度。
第二步只保留带孟加拉语语言码字幕的视频,用自研 ytranscript 工具只查字幕可用性而不下载音频。为绕开接口限速,把视频编号分批放到 Kaggle、Colab、Codespaces 等多环境并行查询再合并。第三步用 yt-dlp 抽取 MP3 和孟加拉语字幕,丢弃自动翻译轨道,抽到 1019 个录音再跨领域去重,得到 998 个唯一视频。
下表问题是时长在领域间如何分布,公平条件是去重后的 885.34 小时,指标是各领域小时数。
| Domain | Videos∗ | Hours |
|---|---|---|
| Audio-book | 277 | 254.37 |
| Talk-show | 176 | 142.40 |
| Movie | 74 | 122.18 |
| Natok (Drama) | 95 | 78.66 |
| Health | 2 | 1.14 |
| Total | 1,019 | 885.34 |
表后解释要抓住偏斜的来源:有声书 254.37 小时、访谈 142.40 小时、电影 122.18 小时居前,而方言仅 1.29 小时、健康 1.14 小时。这不是作者想要的均衡配比,而是 YouTube 上孟加拉语字幕密度决定的。训练时若不加权,小领域会被淹没,评测时必须分领域报告,否则全局平均会被大领域主导。
读图说明:下面看领域时长的帕累托图,左侧柱子是各领域小时数,右侧曲线是累计占比,重点看前 7 个领域何时越过 80% 线。
看图路径: 1. 看左侧蓝色柱子高度对比有声书与长尾领域的时长差距;2. 看右侧橙色累计曲线在第 7 个领域处达到约 83% 的拐点;3. 注意横轴领域排序与纵轴小时数的对应关系

论文图 2。原论文 Figure 2::“Pareto view of audio duration by domain. Seven of the seventeen domains account for roughly 83% of the corpus, reflecting where Bengali caption coverage is densest on YouTube.”。
图后解释:柱子从有声书 254.4 小时急剧下降,到区域方言只剩 1.3 小时,橙色累计曲线在第 7 个领域标注覆盖 83.2%。这直观说明语料的领域不均衡是采集现实,不是设计目标,后续任何全局词错误率都必须结合领域分解来读。
说话人日志与字幕如何对齐成短片段
第四步是对每个音频跑 Precision-2 说话人日志模型,它基于 pyannade.audio 框架,按录音推断说话人数,标签只在单个视频内有效、跨视频不关联。再把日志输出与孟加拉语字幕按时间对齐,形成 SSTT 片段:每段有说话人编号、语音区间、转写文本和起止时间。全部 1019 个文件通过完整性检查,没有非法区间和超长标注。
说话人日志 × SSTT 标注: 说话人日志负责把连续音频切成谁在何时说话的时间段,只给出发声边界和局部说话人编号;SSTT 标注把这层时间结构与孟加拉语字幕文本对齐,一行同时保留说话人、语音段、转写文本和起止时间,组合后长音频才变成可直接用于识别训练的短句样本。
日志后的音频结构值得细读。885.34 小时中有 639 小时被至少一个说话人片段覆盖,剩下约 243 小时是静音音乐环境声。984647 个说话人片段的中位时长只有 1.54 秒,62.6% 不足 2 秒。录音中位说话人数为 4,25.9% 是单人旁白,31% 有 10 个以上说话人标签,平均每分钟 14.2 次轮换。
读图说明:下面看片段时长的累计分布,横轴是对数秒数,纵轴是累计片段比例,关注 1 秒和 2 秒两条虚线。
看图路径: 1. 看横轴对数刻度下 1 秒和 2 秒两处虚线标记;2. 看纵轴累计百分比在 2 秒处已超过 60%;3. 理解长录音被切成极短片段的含义

论文图 3。原论文 Figure 3::“Cumulative distribution of diarized segment durations (log-scaled x-axis). Nearly two-thirds of the 984,647 segments are shorter than two seconds.”。
图后解释:曲线在 2 秒处已达约 63%,在 1 秒处约 31%,之后趋平到 10 秒以上几乎不再增长。含义是原始平均 52 分钟的长录音在进入识别前已被切成极短轮次,长音频的建模难度大部分被切分吸收了,后文按时长四分位分析误差变化不大正源于此。
本文没有训练新识别器时实际做了什么计算
这篇论文的主体不是提出新网络结构,因此 training 一节要明确:作者没有从零训练 4 个零样本系统,而是直接调用现成模型做解码,并用约 58 小时 Lipi-Ghor 数据微调其中 2 个模型。微调配置沿用 Hasan 等 2026 年的训练设置。先前工作把对应的训练子集与模型检查点公开在其 Train_lighten_check_bangla 仓库。
弱监督转写 × 人工金标切分: 弱监督转写指直接沿用 YouTube 自带孟加拉语字幕,量大但混有自动字幕错误,只能做预训练;人工金标切分是 17 名志愿者对 500 个片段逐句听改得到的可信文本,用于衡量字幕噪声和评估识别,组合后才分清训练可用性与评测可信度。
实际执行的是标注与对齐计算:Precision-2 在全量音频上做语音活动检测和说话人聚类,输出带时间的说话人标签;再把字幕句的时间戳映射到这些片段上,生成可训练短句。金标制作则是 17 名母语志愿者约 30 小时的人工听改,用自研网页工具同时看波形、说话人色带、说话人名单和可编辑的文本行,可拆分合并删除重指派,以音频为准、视频画面只做辅助。
需要指出的缺口是原文未报告微调的学习率、轮数和算力预算,也未说明 Precision-2 的内部阈值。不能从模型名猜梯度路径,只能说监督来自带噪字幕,评估依赖人工金标来剥离参考噪声。
评测在什么参考和归一化下比较
评测对象是 4 套零样本系统:Hishab TITU Conformer-L、Meta MMS 1B、Seamless M4T-v2、Whisper large-v3,以及两个微调模型 Fast Conformer 和 Faster Whisper Medium。所有假设文本与参考文本都经过相同孟加拉语归一化:Unicode NFC、标点和数字标准化,再算全局词错误率和字错误率。
词错误率 × 字错误率: 词错误率按词统计替换删除插入占参考词数的比例,反映整句可懂度,数值越低越好;字错误率按字符统计,对孟加拉语粘着拼写和长词更敏感,两者搭配才能看出是整词错还是拼写细节错。
参考条件要分清两层:主结果用 YouTube 字幕作参考,保证四系统在同一噪声参考下可比,差异反映模型行为而非参考差异;金标分析用 500 片段人工文本作参考,衡量字幕本身与人工的差距,不能直接当作模型误差。领域分解按 TITU 误差排序展示全部 17 域,时长分析按四分位切分,相关性只在 7 个代表域上计算。
外部 FLEURS 孟加拉语分数仅作参考,因为公开模型可能见过相关资源,不能当作严格外推。方言只有 4 个视频 1.29 小时,健康只有 2 个视频,注定这些域的估计方差大。
零样本全局与分领域结果说明了什么
先看全局比较问题:在同一字幕参考和同一归一化下,4 个未见过本语料的系统谁更接近字幕,误差方向都是越低越好。
| Model | WER | CER |
|---|---|---|
| Hishab TITU Conformer-L | 30.51 | 18.23 |
| Meta MMS 1B | 43.06 | 21.16 |
| Seamless M4T-v2 | 66.71 | 45.54 |
| Whisper large-v3 | 84.53 | 72.92 |
Hishab TITU 以 30.51% 词错误率和 18.23% 字错误率最好,说明孟加拉语专用预训练很关键;Meta MMS 1B 为 43.06% 和 21.16% 居中;Seamless M4T-v2 达 66.71% 和 45.54%;Whisper large-v3 高达 84.53% 和 72.92%,反映其多语但偏英语的训练分布和对孟加拉文的弱覆盖。由于参考本身带噪,这些数字高估了对干净文本的真实误差。
读图说明:下面看全局条形图,蓝色是 4 个零样本,橙色是两个微调,横轴是词错误率,重点对比最短橙条与最短蓝条。
看图路径: 1. 对比上方蓝色零样本条与下方橙色微调条的长度;2. 找到最短的微调 Faster Whisper Medium 条对应的数值;3. 确认最好的零样本系统仍高于微调系统

论文图 4。原论文 Figure 4::“Global WER for the four zero-shot systems (blue) and two fine-tuned models (orange).”。
图后解释:图中橙色微调条明显短于所有蓝色条,Faster Whisper Medium 微调到 20.70%,Fast Conformer 到 24.67%,都低于最好的零样本 30.51%。这支持弱监督语料仍有训练价值的判断,但代价是微调只用了约 58 小时子集,且外部基准需谨慎解读。
再看领域分解的比较问题:在代表性领域上难度排序是否跨模型一致。
| Domain | TITU | MMS | SM4T | Wh-v3 |
|---|---|---|---|---|
| Audio-book | 21.02 | 33.04 | 57.09 | 80.87 |
| News | 28.03 | 41.68 | 57.83 | 86.23 |
| Natok | 44.37 | 60.14 | 73.94 | 89.01 |
| Regional/Dialect | 57.01 | 70.39 | 113.70 | 90.74 |
有声书最易,TITU 仅 21.02%,方言最难达 57.01%,Seamless 在方言上超过 100% 意味着插入错误多到超过参考词数。3 个有孟加拉语能力的系统随领域同步变差,Whisper 则在 80% 到 90% 之间近乎持平,说明它是均匀失效而非领域敏感。反例是卡通虽每分钟 28.5 次轮换却因发音清晰而相对易识别,不能只用轮次快慢预测难度。
零样本评测 × 微调评测: 零样本评测是不在 Lipi-Ghor 上训练而直接解码,检验模型原有孟加拉语能力与语料难度;微调用约 58 小时本语料数据继续训练后再测,检验语料能否带来提升,两者对比才能区分语料难和模型不适配。
微调提升与字幕噪声各是多少
微调的比较问题是:同样约 58 小时本语料训练能否把全局误差降下来,指标仍是字幕参考下的词错误率和字错误率。
| Model | WER | CER |
|---|---|---|
| Fast Conformer (A) | 24.67 | 15.56 |
| Faster Whisper Med. (B) | 20.70 | 11.90 |
| Moonshine-Base Bengali† | 21.54 | 10.79 |
Fast Conformer 微调后 24.67% 和 15.56%,Faster Whisper Medium 到 20.70% 和 11.90%,都大幅好于各自零样本起点。第三方 Moonshine-Base 加 BanglaBERT 词表移植做到 21.54% 和 10.79%,推理实时因子 0.0053,但它不是本文流水线产物,只能作参照。限制是微调细节引自另文,本文未披露超参数,且训练参考本身带噪,提升中包含拟合字幕风格的成分。
金标的比较问题是:字幕与人工的差距有多大,指标是两者互算的词错误率和字错误率,不是模型误差。
| Domain | WER | CER |
|---|---|---|
| Cartoon | 28.57 | 25.85 |
| Waz | 6.51 | 3.88 |
| Audio-book | 2.57 | 1.12 |
| Comedy/Satire | 0.00 | 0.00 |
卡通字幕与人工差距最大 28.57%,访谈评论新闻在 10% 到 14%,有声书仅 2.57%,喜剧甚至为 0.00%。这说明字幕噪声高度依赖领域,喜剧样本可能恰好是人工上传字幕。推论是主结果的领域排序混入了参考质量差异,只有金标才能给出更干净的模型排序,但本文金标只用于量化噪声,未重算模型在金标上的分数。
片段时长与轮次能否解释难度差异
这一节回答片段结构与误差的关系。比较条件是 7 个代表域的中位片段时长对 TITU 零样本词错误率,统计量是 Spearman 相关系数。
领域 × 说话人轮次密度: 领域指有声书、访谈、戏剧、宗教布道等 17 类节目来源,决定口音情感和录制条件;说话人轮次密度指每分钟切换说话人的次数和中位片段时长,刻画对话碎片化程度,两者结合才能解释为何戏剧和方言识别更难。
原文报告在 7 域上相关为负 0.75:片段越短误差越高,有声书 1.83 秒对应 21.0%,Natok 和方言约 1.1 秒对应 44% 到 57%。但作者明确提醒权重有限:仅 7 个点,去掉小领域后减弱,扩展到 17 域时轮次单独与误差的相关仅正 0.42 且不显著。卡通每分钟 28.5 次轮换却易识别,是最直接的反例。
按时长四分位看,TITU 从短句 30.54% 到长句 28.46% 再到特长句 32.60%,只有特长 quartile 一致上扬,其他三系统同样平坦。这与日志已把长音频切短是一致的:切分吸收了大部分长程难度,剩余的特长上扬才值得关注。不能把相关读成因果,也不能推广到每个录音。
日志错误与覆盖不足在什么条件下成立
日志有两个可验证的人工痕迹。第一是同时说话人数从不超过 2 人,682 个录音峰值 2 人、337 个峰值 1 人,而真实辩论访谈应有 3 人以上重叠,这是 Precision-2 输出表示的上限,所以重叠语音 11.6 小时和中位 0.31% 应读作两说话人上限下的检出重叠。
第二是说话人数越多检出重叠反而越低,与多话者直觉相反。原因是过度切分:同一声音被拆成多个标签,片段是前后相接而非同时重叠。证据是 9056 个标签中有 21.8% 不足 10 秒,某录音 105 个标签而主导者占比仅 0.11。因此低端计数较可信,中位数 4 比均值 8.9 更稳,高端计数偏大。
覆盖上区域方言 4 视频 1.29 小时、健康 2 视频 1.14 小时,不足以做方言鲁棒训练。转写混有标点数字和中英混写处理差异,262 句含拉丁字母已标记保留。日志维度只能算自动元数据,不能当作人工验证的日志基准。
复现第一步做什么与资源现状
复现不从下载音频开始,而是从频道发现开始:按 17 个领域各找 3 到 5 个字幕密集的高产量频道,就能拿到 20 到 50 小时量级。接着用 ytranscript 查孟加拉语字幕轨道,分批并行查完再用 yt-dlp 取 MP3 和字幕,去重后跑日志加对齐。
代码与数据要分开说:作者仓库当前可访问,提供流水线脚本与视频编号、日志输出和金标,原始音频不直接分发,需按编号自行从 YouTube 重建;第三方链接只证明论文提到该地址,不证明已开源。Precision-2 是商业接口服务,复现日志需自行解决模型可得性,好在作者已发布输出可直接用。
许可上原创贡献为 CC-BY-4.0,字幕转写仍归原上传者、仅限研究使用。权利人可凭视频编号要求删除对应条目,版本会更新并公开移除记录。说话人标签只在视频内有效,不做跨视频关联,禁止用于身份识别与监控。
标注工具为何保留视频画面
500 片段金标用自研网页工具而非通用标注平台,设计决定了金标能信什么。界面左上是嵌入视频播放器,右上是波形加说话人色带,下方是说话人名单和每行带说话人、时间戳、可编辑孟加拉文本的片段列表,支持按播放头拆分、合并、删除和数字键指派。
保留视频是有意选择:访谈常有多位同性别相似声学条件者,戏剧人物故意相近 delivery,纯音频难以断定轮次,看谁在画面中、嘴唇是否在动、机位如何切换才能消歧。代价是画面也会误导,镜头停留在某人身上时说话的可能是画外音,所以规范要求以音频为准、视频只做消歧辅助。
每单导出保留 annotator、编辑时间戳和机器基线,可回溯每处人工改动相对自动输出的变化,并以同一 SSTT 格式导出,金标片段可直接替换弱监督对应行而不改训练管线。
什么时候值得尝试与还需补什么验证
当你的目标是孟加拉语长音频预训练、口语化建模或多领域鲁棒性,且能接受字幕噪声时,值得尝试用 Lipi-Ghor 做继续预训练或微调,尤其是有声书访谈起量、再补戏剧方言评测的路线。若要做方言鲁棒部署或说话人身份判定,则不应直接用:方言仅 1 小时量级,日志未经人工验证,重叠上限和过度切分会污染说话人级评测。
复现第一步是先重建视频编号列表并核对字幕语言码,再小规模跑通日志加对齐,确认片段时长分布是否同样集中在 2 秒以下。关键信息条件要保留:885.34 小时对应 998 视频 596 频道,639 小时有说话人覆盖,中位 4 人、每分钟 14.2 次轮换。
还需补的验证有三项:在 500 金标上重算 4 个系统的真实排序以剥离字幕噪声;在 17 全域上重验时长与误差关系而非仅 7 域;公开微调的完整超参数与算力,以便他人判断提升中有多少来自拟合字幕风格。只有补齐这些,才能把弱监督有效与干净评测可信这两件事分开。
📎 论文与评分元数据
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses