共分析 80 篇论文
⚡ 今日概览
✅ 筛选入选 80 篇 → 🔬 深度分析完成
每篇论文保留完整分层分类;热门方向按主任务的最上级方向统计,每篇计入 1 个方向。排行榜也显示最上级任务。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| 语音合成 | 6 篇 | ██████ |
| 语音识别 | 6 篇 | ██████ |
| 语音交互 | 5 篇 | █████ |
| 音频分离 | 5 篇 | █████ |
| 语音增强 | 4 篇 | ████ |
| 音视频理解 | 4 篇 | ████ |
| 音频分类 | 4 篇 | ████ |
| 音频理解 | 4 篇 | ████ |
📊 论文评分排行榜(80 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 把网上钢琴录音和乐谱配成对:Gangqinpu 数据集如何建成和验证

英文题目:Gangqinpu: A Multi-Genre, Multi-Task Piano Dataset with Aligned Audio, MIDI, and Musical Scores
评分:8.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.5/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Wei Zeng:机构信息未能在本次解析中与作者逐人可靠绑定
- Anvay Mathur:机构信息未能在本次解析中与作者逐人可靠绑定
- Ye Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
同一首钢琴曲的分析与建模需要在录音波形、记录实际触键时间与力度的演奏MIDI、写明音高与节奏的乐谱之间建立音符级对应,输入是网络收集的多风格音频与MusicXML乐谱,输出是对齐后的三元组及节拍标注,难点在于流行与爵士录音常无规范乐谱且音频来源混杂,人工对齐成本很高。构建时先用Transkun v2把音频转写为演奏MIDI并清洗,再把展开重复段后的乐谱转为乐谱MIDI,接着用DualDTWNoteMatcher建立两者音符对应并经插值修正,对齐结果进一步导出拍点与下拍标注。多层感知机分类器用八个乐谱感知的时值与力度特征剔除机械感强的非表情演奏,Qwen-Flash与LAION-CLAP两阶段标注流派,相似乐谱分组把相关改编与ASAP重叠样本固定在同一划分以减少泄漏。与以西方古典为主的已有对齐数据不同,该数据包含流行、古典、爵士、民谣或传统、摇滚与布鲁斯共18786对演奏与1007.1小时来源音频。节拍跟踪中Beat This!在Gangqinpu测试集上拍点F1从单独用ASAP训练时的60.18%升至联合训练时的78.16%。演奏MIDI到乐谱转写与表情演奏渲染主要带来域内增益,表情演奏渲染在ASAP上误差略有上升,自动标注尚未经过全面人工审核。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/wei-zeng98/gangqinpu — 链接可访问(HTTP 200)
数据相关资源:https://github.com/wei-zeng98/gangqinpu — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 在真实声场景中实时提取目标说话人:RealSSA 基准与单遍分离方法 Falcon

英文题目:Efficient Streaming Audio-Visual Target Speaker Extraction for Real-World Acoustic Scenes
评分:8.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Wendi Sang:机构信息未能在本次解析中与作者逐人可靠绑定
- Kai Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yifan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Jianqiang Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaolin Hu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
流式音视频目标说话人提取(audio-visual target speaker extraction,AVTSE)要求根据目标说话人嘴部视频,从混合语音中实时恢复其在麦克风处带混响的语音,难点在于近场多人能量相似、远场混响干扰重、突发噪声多变,而已有两说话人固定评测无法反映这种变化。论文发布真实场景基准(realistic AVTSE benchmark,RealSSA),包含可控仿真子集 RealSSA-Sim 与真实录制评测子集 RealSSA-Real,前者联合改变说话人数、远近场几何、混响与噪声,后者检验仿真训练模型在真实采集下的表现。所提方法 Falcon先将混合语音的短时傅里叶编码特征与嘴部视频特征融合,得到音视频融合特征并送入分离器。分离器采用单次编码器解码器结构,在一次解码遍历中按由粗到细尺度依次完成频率轴建模、时间轴建模与联合时频建模,输出目标语音估计。估计结果再进入音频编码器空间内的说话人对比损失计算,该损失把估计推向干净目标、推离各近场干扰人,且推理时不增加开销。Falcon 在 RealSSA-Sim 上取得 7.7 dB 的尺度不变信噪比提升(scale-invariant signal-to-noise ratio improvement,SI-SNRi),高于因果音视频时频网格网络(audio-visual TF-GridNet,AV-TFGridNet)的 7.6 dB,同时参数量减少 91.9%,计算量约为其 1/20.2,图形处理器推理时延约为其 1/11.1。局限在于当前只用单通道第一路信号,真实集为 54 段共 83 分 55 秒且对比损失依赖仿真才有的干净干扰人波形。
🔗 开源资源
代码相关资源:https://cslikai.cn/Falcon/ — 链接可访问(HTTP 200)
演示资源:https://cslikai.cn/Falcon/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Wespeaker/wespeaker-voxceleb-resnet34-LM — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 TIMUSE:先恢复语义令牌再重建声音的通用语音增强

英文题目:TIMUSE: Text-Initialized Masked Semantic Token Modeling for Universal Speech Enhancement
评分:8.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yiwei Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Hao Qiu:机构信息未能在本次解析中与作者逐人可靠绑定
- Mohan Ye:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhijie Deng:机构信息未能在本次解析中与作者逐人可靠绑定
- Zehua Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Kai Yu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
通用语音增强输入为含噪声、混响、带限、削波等混合损伤的语音,输出干净语音,重度损伤会抹掉语言学证据,生成结果易听感好却改变内容或音色。TIMUSE把16 kHz降质语音送入冻结的Whisper large-v3编码器做层加权得到条件特征,再用文本预训练的Dream扩散语言模型经LoRA适配做掩码生成,恢复干净单码本S3语义token序列。条件流匹配模型再结合该token与24 kHz降质梅尔谱重建干净梅尔谱并经BigVGAN合成波形,降质声学分支保留说话人线索,从而把内容恢复与声学保留分开并引入双向文本先验。在匹配训练数据与配方的对照中,TIMUSE在AATC 2025的伪字符准确率pCAcc为79.08,高于次优对照UDSE的71.62,并在两个基准共12个指标-基准组合均居首。文本初始化增益集中于重度噪声、下采样、削波和量化等证据缺失较多的条件,多个轻度条件与参数量匹配的随机初始化模型差异可忽略。故该增益结论不适用于轻度损伤,报告推理均用固定通用复原指令,指令可控与真实录音泛化尚未验证。在RTX 5090 GPU上平均推理实时率为0.104。
🔗 开源资源
代码相关资源:https://cantabile-kwok.github.io/timuse/ — 链接可访问(HTTP 200)
演示资源:https://cantabile-kwok.github.io/timuse/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/viewfinder-annn/AnyEnhance-v1 — 链接可访问(HTTP 200)
第三方资源:https://github.com/urgent-challenge/urgent2026_challenge_track1 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. 只知道脏在哪里,能否把干净信号找回来:SORD 的支持引导去污染

评分:7.8/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Alireza Kheirandish:机构信息未能在本次解析中与作者逐人可靠绑定
- Sara Fridovich-Keil:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
待恢复对象是被局部结构化污染破坏的干净信号,输入为观测值y与二值损坏支撑集合Ω,输出为对干净信号x的估计,难点是支撑内污染结构复杂且分布未知,无法用高斯似然直接描述。方法先用扩散修复得到初始猜测,只信任支撑外观测,直接保留支撑外像素而把支撑内视为待生成内容,得到与干净先验一致的起点。接着用当前估计与支撑内观测作差得到估计残差,将其加噪到自适应噪声水平后,用仅在干净信号上预训练的扩散模型去噪,以滤除不符合干净先验的污染成分,输出精修后的残差估计。随后按测量一致性把精修残差回代得到中间信号,再用干净信号扩散模型精修信号本身,如此交替更新,并用多样本分歧估计不确定性决定停止,下一轮以前一轮估计作为输入。在64×64的100张CelebA人脸叠加MNIST数字的局部污染评测中,支撑内区域峰值信噪比PSNR为27.16 dB,高于去掉扩散残差去噪步骤的变体的24.28 dB。在以钢琴为目标的Slakh2100局部干扰评测中,该方法对未建模乐器与语音干扰更稳健,但在部分已建模干扰上弱于需为每个声源配备单独扩散模型的多源扩散模型。该结论仅在已知准确支撑且污染近似满足加性假设时成立,水印按不透明度加权合成、阴影为相乘衰减均偏离该假设故只能持平或弱于专用监督模型,支撑被低估、腐蚀或错位会把残留污染视为可信观测而留下可见残留,支撑未知或需同时估计支撑的情形尚未验证,且原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/voilalab/SORD — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. 电话线上的声音:只留下打电话的人

评分:7.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Husein Zolkepli:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
通话转写用的单个麦克风会同时收进通话人和周围人的声音,任务是只保留通话人并输出可直接送识别的波形,难点是周围人单独长说时不能跟丢通话人,而通话人单独出现时又不能损伤。论文先从通话自身取最响的3 s估计说话人向量(speaker vector,一段描述当前通话人音色的向量),以此为条件约束后续分离指向通话人。该向量送入因果掩蔽式Transformer(Transformer,一种基于注意力机制的序列模型),模型按20 ms帧输出复数掩码,作用于混合频谱得到通话人波形。因果化后的WavLM-Large将其多层语音特征混合叠加到Transformer词元上,提供预训练表示且不增加延迟,门控从零启动以保留原有行为。训练按三段衔接:6 s仿真通话学基本分离,24 s带轮替的长通话加10 s注意力窗和帧级LSTM学跨窗记忆,再用真实串音微调并处理电平漂移与单人通话。在60 s AMI窗口上发布模型词错率(word error rate,认错词数占参考词数的比例,越低越好)为16.13%,VoxLock在线模式为23.66%;Krisp基准上两者基本持平,分别为5.74%和5.63%;单人干净通话上发布模型为5.58%,差于VoxLock的2.92%。发布模型每秒音频约47.7 GMAC,一个GPU可带160路实时通话,蒸馏到22.1M参数的CPU模型在20 ms帧下占单线程约33%,但受控仿真显示背景人与通话人等响或更响时略逊于VoxLock,单人损伤在通话起始数秒最重,因训练窗从未以他人先说开头,故结论仅限所测会议、耳机串音与Krisp基准范围,未验证背景长期主导与其他采集场景。
🔗 开源资源
第三方资源:https://github.com/Scicom-AI-Enterprise-Organization/STT-API/tree/main/stt_api/livekit_plugin/voice_isolator — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/collections/Scicom-intl/voice-isolator — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. NECTAR:从混合语音中自动估计干扰说话人负线索

英文题目:NECTAR: Automatic Negative Clue Estimation via Centroid-Space Mapping for Target Speaker Extraction
评分:7.6/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hyungjun Yoo:机构信息未能在本次解析中与作者逐人可靠绑定
- Yongjoon Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Jung-Woo Choi:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
目标说话人提取要从双人混合波形中恢复注册语音指定的目标说话人,输入为混合语音和一段目标注册语音,输出为目标语音,难点在于仅有目标方线索时缺少应抑制的干扰方信息。本文在说话人质心空间分析混合与组成说话人的几何关系,发现用多片段平均得到的混合质心近似落在两个说话人质心连线的中点,而单句嵌入并不满足该关系。为利用该关系,方法先用质心空间映射器处理单段输入,该映射器以冻结说话人编码器的帧级特征为输入,经深度卷积、多头自注意力与注意力统计池化输出质心表示,对混合语音输出近似两倍混合质心的表示,对目标注册语音输出目标质心。接着方法以上一步得到的两倍混合质心表示减去目标质心,按中点公式得到干扰质心作为负线索。再将目标注册语音的嵌入作为正线索与该负线索拼接后送入提取网络,使网络同时利用应保留与应抑制的信息,而无需额外的干扰方注册语音。在 LibriSpeech train-clean-100 训练并在 Libri2Mix mix_clean 测试的条件下,NECTAR 相对最强的 Multi-Level BSRNN 基线在 SI-SDRi 指标上从 15.91 dB 提高到 16.18 dB。该结论适用于两说话人英语混合,在含噪和跨数据集条件下仍有提升,但三说话人和非语音干扰的适用性尚未验证。原文未披露推理延迟或部署成本,CSM 训练约 1 小时的开销是唯一与成本有关的陈述。
🔗 开源资源
代码相关资源:https://github.com/Hyungjun-Yoo811/NECTAR — 链接可访问(HTTP 200)
第三方资源:https://github.com/JorisCos/VCTK-2Mix — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. 把伪标签当奖励而不是目标:半监督语音识别的组相对策略优化

英文题目:Pseudo-Labels as Rewards, Not Targets: Group-Relative Policy Optimization for Semi-Supervised ASR
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shashi Kumar:机构信息未能在本次解析中与作者逐人可靠绑定
- Yanis Labrak:机构信息未能在本次解析中与作者逐人可靠绑定
- Sergio Burdisso:机构信息未能在本次解析中与作者逐人可靠绑定
- Esaú Villatoro-Tello:机构信息未能在本次解析中与作者逐人可靠绑定
- Petr Motlicek:机构信息未能在本次解析中与作者逐人可靠绑定
- Kadri Hacioglu:机构信息未能在本次解析中与作者逐人可靠绑定
- Andreas Stolcke:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是只有领域内无转写音频时的识别器适配,困难是教师转写中的错词会被学生当成正确目标记住,处理过程是保留全部伪标签但改变使用方式。输入是银行、医疗、保险电话音频与 Common Voice 低资源语言音频,输出是转写文本,难点是伪标签词错率最高超过 26% 且无法用人工核对教师优劣。学生先在 LibriSpeech 960 小时外域数据上训练,再对每条无标注语音采样 4 个假设,用 \(1-\mathrm{WER}\) 相对伪标签打分并在组内归一化成优势后更新策略。伪标签只决定奖励高低,不直接决定每个词的似然目标,组内都相同的惩罚会被均值相减抵消。相对已有方法,关键差异是不清洗或重生成标签,只靠当前策略自身采样支撑过滤噪声。在银行测试集上,用 Whisper Tiny 伪标签的组相对策略优化(Group Relative Policy Optimization,GRPO)得到 14.06% 词错率,优于用 Whisper Large-V3 伪标签的有监督微调(Supervised Fine-Tuning,SFT)的 17.21%。结论适用于学生已能输出目标文字的情形,目标文字完全不在采样支撑内时直接做强化学习不再成立。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. 按指令现做适配器:大音频语言模型的组合泛化

英文题目:In-Context Adapter Generation for Compositional Generalization in Large Audio Language Models
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.4/1.5 | 清晰度 0.9/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yiwei Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Siqi Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Bohan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Jing Peng:机构信息未能在本次解析中与作者逐人可靠绑定
- Hankun Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhihan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Kai Yu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是能听语音并按文字指令作答的大音频语言模型,困难是它在单个能力上可用,但把熟悉的能力与任务结构重新组合时容易失效,处理过程是让适配参数随每条指令变化而非一套固定参数应付所有指令。输入为文字指令序列加一段或多段语音,输出为转写、类别判断或选择后执行的结果,难点是把指令中的功能词绑定到正确的音频证据和输入序号。方法先把指令用骨干模型的词嵌入矩阵转为向量,再与每层每模块的可学习查询拼接送入双向Transformer编码器,注意力让查询读到细粒度指令信息后经模块专属线性头生成低秩矩阵。相对已有文本到低秩适配(英文全称Text-to-LoRA,缩写T2L)只用单个句子向量的方法,新设计保留了token级结构,也不再需要外部句子嵌入模型。在Kimi-Audio骨干的五组组合评测上,按越高越好的平均相对性能得分,新方法T2L-ICAG为98.35%,高于同秩静态低秩适配的92.02%。结论适用于所审计的比较、选择、按序和多功能组合,奇异值观察仍是现象描述,翻译外推和更长输入尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://huggingface.co/Unbabel/wmt22-comet-da — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. 只拿到一小段语音表征,能拼出任意文本的冒充语音吗

评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ye Lu:机构信息未能在本次解析中与作者逐人可靠绑定
- Shen Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Runze Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhitao Ou:机构信息未能在本次解析中与作者逐人可靠绑定
- Haonan Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yihan Yan:机构信息未能在本次解析中与作者逐人可靠绑定
- Fanghui Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhaoyang Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
拆分部署下用户设备把语音转成前端表示后发往远端,原始波形留在本地,需要回答的问题是这段表示是否还留下可复用的说话人音色。困难在于泄露片段很短且与目标文本内容无关,攻击者没有波形与源转写,也不能针对受害人再训练。语音标记反演攻击(Speech Token Inversion Attack,STIA)把泄露片段编成说话人条件,把攻击者选定文本编成内容条件,两路条件共同驱动流匹配生成。生成在冻结的Higgs编解码器连续隐空间中从噪声向目标语音隐变量去噪,再经离散码选择与波形解码输出。与先恢复说话人向量再调用合成器的两阶段基线不同,STIA直接以泄露表示为条件,避免了向量瓶颈丢失音色细节。在Moshi前端3秒泄露、Emilia英语未见说话人评测中,STIA相对SpInv+TTS基线将CAM++余弦相似度从0.22提高到0.78,将目标文本词错率从13.37%降低到3.80%。结论限于三个前端与Emilia划分内的未见说话人,匿名化与跨数据集泛化尚未充分验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. 把图像扩散模型拿来读文字、学说话:ImageTTS 解读

英文题目:ImageTTS: Repurposing Pretrained Image Diffusion Transformers for Speech Synthesis
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hanchen Pei:机构信息未能在本次解析中与作者逐人可靠绑定
- Shujie Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yayue Deng:机构信息未能在本次解析中与作者逐人可靠绑定
- Fangyun Wei:机构信息未能在本次解析中与作者逐人可靠绑定
- Yanqing Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jianwei Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Gongping Huang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音合成需要同时满足输入文字的发音内容准确与输出声音的说话人特点和给定参考一致,直接复用图像模型架构容易,真正的困难是图像模型学到的压缩表示能否保留语音可懂度和音色,以及图像去噪先验能否帮助语音生成。ImageTTS先把对数梅尔语谱图看作高度为频率、宽度为时间的伪彩色输入,用冻结的FLUX.2图像VAE编码为隐表示,该隐表示承担语音与图像隐空间的接口并保留可懂度和音色。随后只微调扩散Transformer,以文字与参考隐变量为条件做条件流匹配来预测隐变量演化的速度场,其中零样本合成以掩码流匹配做带参考的隐变量补全,指令控制合成由文字记录与风格描述共同决定整句生成。推理时模型从高斯噪声出发沿调度噪声解条件常微分方程得到目标隐变量,再经冻结VAE解码并用声码器合成波形,使前两步学到的表示与先验落到可听语音。相对已有语音原生DiT模型,该方法的关键差异是表示与初始化都来自文本到图像管线,而不是为语音训练编解码器或从随机权重开始,这把视觉到语音迁移拆分为VAE的表示迁移与DiT初始化的生成先验迁移。在约10万小时Emilia数据训练后,ImageTTS-base在Seed-TTS test-en上词错误率(Word Error Rate,WER,越低越好)为1.12%,低于同数据量基线。结论适用于读式英文为主的大规模训练与CapSpeech指令数据微调;在中文说话人相似度、图像VAE重建上限之外尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://paperdemos.github.io/ImageTTS-demos/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/parler-tts/parler-tts-mini-v1 — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/audeering/wav2vec2-large-robust-6-ft-age-gender — 链接可访问(HTTP 200)
第三方资源:https://github.com/interactiveaudiolab/penn — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. 一个大内核不够:在哪里切分流式推理模型

英文题目:One Megakernel is Not Enough: Predicting Where to Cut for Streaming Inference
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.5/1.5
排名:前25% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Aditya Chatterjee:机构信息未能在本次解析中与作者逐人可靠绑定
- Anand Joseph X M:机构信息未能在本次解析中与作者逐人可靠绑定
- Sanjay Singh Chauhan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
流式语音合成与大语言模型推理按一次预填充加多步自回归生成分批发布结果,输出对应首个可发布的音频块或首个词元,难点在于不同阶段计算形状与驻留需求不同,融合边界决定共享的启动配置、线程块占用时间和固定开销分摊。论文把有序阶段划分为连续区域并为每个区域选择常规执行或常驻大内核,再配以串行或生产者与消费者并行的共享策略,最优答案在不同模型与批量下为零至四个大内核。边界规划器先用常规图画像构造区域图并枚举候选组合,再用分块图估计各区域在不同后端与线程块预算下的服务时间形成服务表,然后把候选组合展开为事件图并仿真到首次发布时刻,用最低预测分选择组合,全程不端到端实测候选设计。在H100 NVL上NH-TTS批量32时,选出的三巨内核重叠设计首音频发布时间比常规执行早4.05倍,比单巨内核设计早21.4%,该排序在批量64时为47.4 ms对61.0 ms对221.5 ms、在批量1时为27.5 ms对32.7 ms对73.0 ms。冻结后的规划器在已声明验证池13个模型与批量组合中13/13选中已测最快设计,常规与单双巨内核预测误差在5%以内而三巨内核被高估6%至22%仍不改变排序。规划器输入采集成本为分钟级,NH-TTS核基准耗时4.6 GPU-min,Qwen3-TTS四个批量合计耗时15.9 GPU-min,该口径仅为输入采集成本而非完整训练或部署费用。该结论限于三模型三框架已实现验证池与H100 NVL硬件,不证明未实现组合最优或跨GPU迁移。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. AudioFM:用整体对照加局部遮挡判别学习通用音频表示

英文题目:AudioFM: Towards General Purpose Audio Representation Learning
评分:7.4/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yamin Li:Google Research;Vanderbilt University;Work done during an internship at Google
- Ruidong Zhang:Google Research
- Anran Wang:Google Research
- Eduardo Fonseca:Google DeepMind
- Dan Ellis:Google DeepMind
- Zechen Li:Google Research
- Simon A. Lee:Google Research
- Tao Pang:Google Research
- Jake Garrison:Google Research
- Maxwell A. Xu:Google Research
- Yicheng Wang:Google DeepMind
- Jitian Zhang:Google Research
- Weizhi Zhang:Google Research
- Haichao Zhang:Google Research
- Catie Chang:Vanderbilt University
- Xin Liu:Google Research;University of Washington
- Anupam Pathak:Google Research
- Daniel McDuff:Google Research;University of Washington
- Shwetak Patel:Google Research;University of Washington
- Jake Sunshine:Google Research;University of Washington
- Yuzhe Yang:Google Research
- Xiaoran Fan:Google Research
📌 核心摘要
读者需要理解的对象是一段录音同时包含的整体场景和短时局部事件,困难在于只让整段表示一致会丢失时频细节,只重建局部又难以保持录音级语义,处理过程需要同时监督两个粒度。AudioFM 先把同一录音做波形增强并转为对数梅尔语谱图,再构造时间掩码视图和频率掩码视图,分别送入学生编码器和指数滑动平均(Exponential Moving Average,EMA)教师编码器。录音级分支把可见块池化为录音向量并做跨视图对比,局部的分块掩码潜在判别(Masked Latent Discrimination,MLD)分支用可见上下文预测被掩码位置的教师表示,并在同坐标跨录音候选里做判别。与只做录音级对比的 AudioMosaic 相比,关键差异是局部预测目标是完整视图的教师特征而非重建语谱图,且候选只取其他录音同坐标,避免把同一录音内相似但位置不同的区域硬性推开。在保留约 168 万条 AudioSet 片段上预训练后,AudioFM 在 FSD50K 微调上达到 71.4 平均精度(mean Average Precision,mAP),比 AudioMosaic 高 0.9 个百分点;在冻结裸探针下 12 个任务有 10 个达到最佳或并列最佳。原文未披露训练时长与推理部署成本,医疗发现只做了嵌入可视化,临床适用性尚未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. 打断要让,附和要留:窗口似然如何替代采样式时机奖励

评分:7.4/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Guoqiang Hu:Nanyang Technological University, Singapore;Tencent
- Lichao Zhang:Tencent
- Yizhou Peng:Nanyang Technological University, Singapore
- Yuhao Luo:Tencent
- Haifeng Hu:Tencent
- Sallen Sun:Tencent
- Will Yang:Tencent
- Eng Siong Chng:Nanyang Technological University, Singapore
📌 核心摘要
边说边听的全双工语音对话模型要在用户插话时让出、在用户附和时保持,难点是打断与附和在声学上接近,且让出过多会误停、过少会抢话。评测沿一条样本注入真实打断或附和录音,读出模型在插话 onset 后 2 秒事件窗口内的停止决策,再统计打断停止率与附和误停率。窗口似然先为每个窗口采样一条模型自身的回答延续,延续中按测试方式注入插话并保留其内容与自身停止位置。接着用教师强制前向重算该延续在窗口内访问过的说话态停止决策概率,采样过程不通梯度,前一步的延续直接成为这一步重算的输入。然后在这些概率上闭式积分,打断用噪声或最大化至少停一次的对数概率,附和用生存积最大化一次不停的对数概率。相对整段组相对策略优化把一个二值分数分给整段所有决策,窗口似然只在奖励依赖的决策上放梯度,并用对数避免最难窗口梯度消失。在 HumDial-FDBench 中文 Lychee-FD 上,窗口似然相对基线的 F1 从 62.6 提高到 91.4,且 100 秒静默重开率为 0%,而同预算组相对策略优化为 100%。结论适用于有显式停止通道与无控制符的两类模型,但 Freeze-Omni 等受限结构仍绝对偏低。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 看不见说话人时还能判断谁在说话吗:多人上下文与注册身份的说话人检测

英文题目:Beyond Visible Speakers: Context-Aware Active Speaker Detection with Speaker Registration
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Pu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Hugo Van hamme:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是包含多人脸和一路场景音频的视频片段,困难是当多张脸同时有类说话动作或存在混响、重叠、遮挡时,单条脸部轨迹与音频的对应关系不再唯一,处理过程是为每条可见轨迹输出是否说话,同时在有人缺失画面时仍能判断已注册者是否说话。主动说话人检测(active speaker detection,ASD)指结合音频与可见人物视频判断各时刻谁在说话,本文的场景级推理(scene-level reasoning)指把同一时刻重叠的多条轨迹放在一起交换证据再分别判定。原有ROAM-ASD为每条轨迹独立融合音频(audio)、全脸(face)与嘴部(mouth)表示,ROAM-ASD-C在其融合表示之后增加跨候选的上下文块(context block),把同时可见的候选表示堆叠后做候选维度的自注意力,再送回原预测头分别输出。ROAM-ASD-CR进一步把注册语音(enrollment speech)编码为随时间不变的注册标记(registration token),与可见候选一起参与上下文块,并用说话头(speak head)判断注册者是否说话、用关联头(association head)计算注册者与各可见脸的相似度。与已有跨说话人方法的区别是保留了每候选独立二分类而不做跨脸互斥归一,并用零初始化投影使上下文块初始为恒等映射。与ROAM-ASD相比,ROAM-ASD-C在UniTalk上的平均精度均值(mAP)从87.9%提高到88.8%,在同一UniTalk完全去除脸与嘴部视觉时ROAM-ASD-CR注册者活动检测的平均精度(AP)为60.3%,高于同期脸级判定的36.4%。结论适用于有多人同时可见或目标轨迹部分缺失的场景,完全无视觉且无注册信息的身份归属仍未解决;原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://wangpuup.github.io/ROAM-ASD-C/crowds.html — 链接可访问(HTTP 200)
第三方资源:https://wangpuup.github.io/ROAM-ASD-C/modality.html — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. 带标签的语音识别:一次转写并标出被伪造的词

评分:7.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.9/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xueping Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaoxiao Miao:机构信息未能在本次解析中与作者逐人可靠绑定
- Tiantian Feng:School of Artificial Intelligence, The Chinese University of Hong Kong, Shenzhen, China
- Ming Li:School of Artificial Intelligence, The Chinese University of Hong Kong, Shenzhen, China
📌 核心摘要
读者需要理解的对象是一段可能被局部篡改的语音,困难是既要转写出文字,又要指出哪几个词不可信,而传统做法先预测伪造时间区间再映射到词,容易受转写和边界误差影响。论文把任务定为带标记的语音识别(tagged ASR):输入波形,输出包含文字和伪造标记的序列,伪造词用 <TOF> 和 <EOF> 包裹。处理过程先用两个冻结编码器分别提取识别特征和伪造线索,再用受保护子空间门控融合(ASR-Protected Subspace Gated Fusion,APSGF)把伪造信息只加入识别特征的正交补空间,随后由语言模型生成带标记文本,最后用参考锚定策略优化(Reference-Anchored Policy Optimization,RAPO)按转写与标记联合奖励微调。与直接混合特征或组内比较奖励的方法不同,该设计显式保留识别主方向,并用冻结参考模型的单样本奖励差作为优势。多任务设置下本文方法在五集平均词错误率上达到 0.054,词级 macro F1 四集平均达到 0.901,优于对应的监督微调基线。结论适用于英文朗读与局部替换类伪造,在域外 LlamaPartialSpoof 上词级定位仍下降,且原文未披露批量大小、训练设备和推理成本。
🔗 开源资源
代码相关资源:https://anonymous.4open.science/r/asr_word_antispoofing_anon-38C6/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/badayvedat/VCTK — 链接可访问(HTTP 200)
第三方资源:https://jitsi.github.io/jiwer → https://jitsi.github.io/jiwer/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. 长会话下全双工语音模型为什么会变差,又如何稳住

英文题目:Diagnosing and Mitigating Long-Session Degradation in Full-Duplex Speech Models
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Junho Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- CheHyun Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Donghun Kang:机构信息未能在本次解析中与作者逐人可靠绑定
- Youngho Cho:机构信息未能在本次解析中与作者逐人可靠绑定
- Dongwook Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Heeseung Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- Sungroh Yoon:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
全双工语音交互(full-duplex)要求模型在听用户说话的同时生成语音,并自主决定开始、继续或停止说话,论文研究这类模型在连续10分钟到20分钟会话中行为退化的诊断与缓解。输入是用户语音流与不断增长的对话历史,输出是模型语音流与说话时机决策,难点在于声学细节、语言内容与交互控制记号随时间累积,处理负担与记忆成本同步上升。诊断部分构建闭环仿真,用大语言模型(large language model,LLM)、文本到语音(text-to-speech,TTS)、语音识别与语音活动检测组成虚拟用户,跟踪响应超时、内容质量与说话人相似度。缓解部分先把长轨迹切成短段,用冻结基座教师加对话摘要生成可靠目标,再让学生对拼接长轨迹做蒸馏;再引入双分辨率上下文(two-resolution context,TRC),近窗保留原始词元,远端只保留 gist 词元。相对已有轮次评测与截断式长上下文处理,差异在于显式分离内容与控制监督,并让压缩记忆参与训练与流式推理。在PersonaPlex上8-10分钟对话质量(conversation quality,CQ,1-5分越高越好)从基线1.29提升到TRC的3.84,18-20分钟仍保持3.53,而纯低秩适配(low-rank adaptation,LoRA)已无法报告有效分数;TRC把提示词外键值缓存(key-value cache,KV-cache)增长速率降低91.7%-95.8%,适用范围限于三类原生全双工结构与英语日常话题仿真,20分钟外与真实打断场景尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://kimjunho333.github.io/dmlsd-fdsm/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. 把语音条件写清楚:SURE-Tagger 的结构化标注与组合评测

评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jing Peng:机构信息未能在本次解析中与作者逐人可靠绑定
- Huifei Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Weihan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Shuo Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Bicheng Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Junhao Du:机构信息未能在本次解析中与作者逐人可靠绑定
- Hanqi Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Chaolei Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Wen Wen:机构信息未能在本次解析中与作者逐人可靠绑定
- Tao Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Xu Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Xi:机构信息未能在本次解析中与作者逐人可靠绑定
- Shuai Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Kai Yu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音录音同时包含文字内容、说话人特征、轮次重叠、非言语线索和声学环境,自由形式的语音描述经常漏写某些属性,读者无法判断漏写是确认不存在还是没有观察到。本文要解决的是如何得到一份样本级、可跨数据集联合查询的语音条件记录,并用它做组合评测和训练数据选择。半结构化语音表示把每个录音写成预定义属性的显式取值加补充描述,证据不足时记为空值。构建框架SURE-Tagger先让专用感知模型分别给出语言、说话人分离、声学事件和转写等观察,把它们只当作证据而非直接赋值,再由一个大语言模型按模式定义和约束整合、调和冲突,证据仍不足则保留空值。得到的表示按共享语音条件把异构数据集重组为评测子集,只有显式取值确认满足谓词的录音才被纳入,空值不视为确认的反例,条件级误差分布再指导从独立候选池按簇误差加权选择数据。评测基准Tag-Bench用650条真实录音和500个受控合成场景检验29个维度的标注质量,在合并两类样本的合并分数上SURE-Tagger为77.28%,高于Qwen3-Omni-Flash的60.93%和Qwen3-Omni-Captioner的58.20%。用独立候选池选约1小时音频微调Qwen3-ASR-1.7B后,在按参考单元汇总英文WER与中泰文CER的总体错误率上从5.50%降到4.71%,相对下降14.3%,而同预算下描述子引导和随机选择反而使错误上升。该结论限于论文的十个来源语料和所测识别模型,小簇结果不稳定。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. 长视频里几秒被改了:AV-FABLE 如何按声画两条时间线定位篡改

英文题目:AV-FABLE: Audio-Visual Manipulation Forensics in Long-Form Videos
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yuesheng Huang:Tsinghua University
- Hoi Fan Au:Tsinghua University
- Jiaqi Hou:Tsinghua University
- Ruicheng Zhang:Tsinghua University
- Jiarui He:Tsinghua University
- Haocheng Yang:Tsinghua University
- Bin Hu:Tsinghua University
- Kewei Zhang:Peking University
- Weijian Deng:Tsinghua University
- Jun Zhou:Tsinghua University
- Xiu Li:Tsinghua University
📌 核心摘要
研究对象是几十秒到几分钟的开放场景音视频,篡改只占其中很小一段,可能只改声音、只改画面,也可能两轨各改不同区间。整段打分会稀释局部证据,而只找对时间却找错声画轨也会误导取证。论文先用事件驱动流程构造包含原始与篡改孪生对的基准AV-FABLE,每段篡改记录所属声画轨与起止区间。接着对比直接向音视频大模型提问和在冻结感知特征上训练探针的两条路径,发现前者接近猜测而后者可分性很强。在此基础上提出的方法冻结编码器,只学习轻量读出头,用两条独立解码器分别输出音频事件和视觉事件,再由校准阈值得到检测和归因。域内AV-FABLE评测中该方法以AV-mAP 91.30%超过使用相同Qwen3特征和训练预算的UMMAFormer的84.76%,检测AUROC为96.04%较该对照提高6.86点并取得归因F1最高。结论适用于开场景长视频稀疏篡改取证,视觉在强压缩和新生成器下仍易漏检,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. Audio-R1:用自监督音频任务构造可验证奖励的强化学习后训练

英文题目:Audio-R1: Audio Reasoning through Reinforcement Learning on Self-Supervised Tasks
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jihoon Jeong:机构信息未能在本次解析中与作者逐人可靠绑定
- Mirco Ravanelli:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhepei Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Cem Subakan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是大音频语言模型,它同时接收音频和文字问题并输出答案与推理过程,困难在于音频推理数据难以人工标注,而仅奖励最终问答正确性又不能保证模型真正使用了声音证据。Audio-R1先从原始录音自动切分并重组音频,构造答案在构造时已知的四选一选择题,分别考查跨片段身份对应、被静音遮盖片段的上下文补全和三段乱序恢复时间顺序。模型对每道题采样多条包含思考与答案的回复,其文本进入基于规则的奖励函数,先核对抽取答案与构造答案是否一致,再检查是否符合思考与答案标签格式。奖励的组内差异经带KL约束的GRPO转化为优势信号,用于更新语言模型骨干与音频对齐模块并冻结编码器,从而把可验证的声音证据使用沉淀为策略。多任务训练下Qwen2.5-Omni在MMAR、MMAU-mini和MMAU-Pro上的准确率相对其基线58.2%、73.4%和55.1%分别提升至62.6%、77.2%和58.7%。Audio-R1处理后的Qwen3-Omni在同一三项基准准确率上相对其基线68.5%、74.9%和61.5%分别达到70.3%、77.5%和63.6%,超过表中所列闭源与强化学习对照。结论适用于所选候选式自监督任务和已具备基础能力的基座,开放式理解与更广分布的稳健性尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
20. 每个音素一个平均向量:不用神经合成器的文本注入

英文题目:One Mean Log-Mel Vector per Phoneme: Simple and Fast Text Injection for Speech Recognition
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Albert Zeyer:机构信息未能在本次解析中与作者逐人可靠绑定
- Davyd Naveriani:机构信息未能在本次解析中与作者逐人可靠绑定
- Dorian Koch:机构信息未能在本次解析中与作者逐人可靠绑定
- Ralf Schlüter:机构信息未能在本次解析中与作者逐人可靠绑定
- Hermann Ney:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音识别需要把声学语音转写为文字,配对音频稀少而纯文本丰富,如何让端到端模型直接从无音频文本中学习是本文处理的问题。方法第一步把输入文本经发音词典映射为音素序列,输出离散音素符号作为下一步查表与定长的索引。第二步查表来自配对音频音素对齐统计,每个音素对应一个平均对数梅尔向量,并以其中值持续时间为中心经对数正态抽样得到帧数,把符号索引转为带时长的声学向量。第三步把这些向量按各自帧数重复,并在词间插入静音、边界处做线性插值,拼成伪语音帧序列后与真实语音随机混合,走同一前端与增强流程参与训练,模型结构、损失与推理搜索均保持不变。与需要预训练并占用大量训练时间的神经文本到语音合成器注入相比,该方法省去合成器,原文报告训练快1.8倍。在LibriSpeech 960小时配对数据加语言模型文本条件下,注入方法在测试集另一说话人子集上把词错率从4.16%降到3.66%,相对下降约12%,结合外部语言模型后大模型达到1.52%与3.24%的水平。时长统计是决定效果的关键,声学细节的影响较小,子词级直接建表失败,字符级只能保留约六成增益;原文披露LibriSpeech查表注入约44小时,早期实现中查表约130小时对合成器约235小时。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. 同时对齐内容与音色:MG-REPA 如何加速生成式目标说话人提取

英文题目:MG-REPA: Multi-Granularity Representation Alignment for Generative Target Speaker Extraction
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Dohwan Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- Jung-Woo Choi:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
目标说话人提取要从多人混合与噪声中依注册语音恢复目标干净语音,需同时保持时变语音内容与时不变说话人特性。已有表示对齐只在单一粒度约束生成器中间层,帧级对齐使全局说话人信息保持隐含,话语级对齐使时变内容信息保持隐含。本文提出多粒度表示对齐,生成器以混合频谱与注册语音为条件,在扩散变换器瓶颈块输出帧索引隐状态,该隐状态作为公共输入经独立适配器分送两个分支。帧级分支先经多层感知机映射到教师维度,再沿时间自适应平均池化降采样至教师帧率得到预测,该预测与从干净目标语音提取的冻结WavLM特征经时间归一化去除通道均值与标准差后的目标以负余弦相似度对齐。话语级分支将同一隐状态汇总后与从干净目标语音提取的冻结CAM++话语嵌入对齐,两项对齐损失与生成损失联合训练生成器,推理时丢弃分支与教师,不增加推理代价。在Libri2Mix噪声集上,MG-REPA用250轮和350轮达到同配方重训练基线750轮的OVRL和PESQ,分别对应3.0×和2.1×更少轮数。用750轮训练时,它在侵入式指标上与已发表的2000轮基线相当,在非侵入式指标上更高,但噪声SI-SDR仍低0.47 dB。该结论仅在Libri2Mix及MeanFlow-TSE同架构骨干下验证,噪声下混合隐状态与干净教师差距更大时SI-SDR难以追平,对其他骨干的通用性尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/rlaehghks5/MG-REPA — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
22. 只用源语音学会早说:DIAL-S2ST 的前视自蒸馏与延迟控制

英文题目:DIAL-S2ST: Learning Latency Control for Simultaneous Speech-to-Speech Translation
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jeongsoo Choi:机构信息未能在本次解析中与作者逐人可靠绑定
- Junseok Ahn:机构信息未能在本次解析中与作者逐人可靠绑定
- Joon Son Chung:KAIST
📌 核心摘要
同时语音到语音翻译要在源语音未说完时决定读入更多源语音还是写出译文语音,读得多更准确但延迟更高。Hibiki这类多流模型把目标文本和目标语音当作并行时间同步的记号流联合生成,朗读时机和翻译内容耦合在同一预测里,没有可调的读写策略。DIAL-S2ST先让学生在只听当前源语音的条件下生成文本与语音轨迹,再让冻结预训练教师在多听k秒源语音后给出文本预测,学生无前视地模仿该预测得到提前输出的监督,该轨迹前缀同时作为两模型逐帧蒸馏的条件。上述前视会引入教师依赖学生未听内容的模仿差距,因此对超过阈值的文本蒸馏损失做屏蔽,并让学生语音预测向同语境下无前视教师正则化,以锚定语音不被文本提前带偏。接着在每条训练序列采样前视k并把低秩适配器(Low-Rank Adaptation,LoRA)尺度设为k/kmax配对训练单个适配器,使尺度对应不同提前程度,推理时只调尺度即可调延迟。与移位自训练基线相比,DIAL-S2ST在CVSS法英测试集延迟匹配时ASR-BLEU更高,如LAAL为1.8秒时分别为32.5和32.0。结论适用于所评测的法英Hibiki话语级翻译,跨模型、跨语言和长语音尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
23. 长对话为什么会崩:全双工语音模型的长时间崩溃与无重训修复

英文题目:Why Full-Duplex Speech Models Collapse in Long Conversations
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yeonju Kim:Integrated Vision and Language Lab, KAIST, South Korea
- Bella Godiva:Integrated Vision and Language Lab, KAIST, South Korea
- Se Jin Park:机构信息未能在本次解析中与作者逐人可靠绑定
- Yong Man Ro:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
全双工语音交互要求模型同时听和说,每帧都生成语音声学记号与文本记号,上下文会被静默和简短应答快速占满,历史输出又会回流为新的输入。已有评测只看单轮或几轮对话,无法暴露数十分钟尺度上的稳定性问题。本文引入全双工长时基准Full-Duplex Long-Horizon Benchmark(FD-LHB),包含固定录音重放与自适应对话伙伴两条轨道,测试重复、长时间静默和胡言乱语三类失效的出现时间。针对滑动窗口模型,论文分离出初始化锚驱逐与自我强化重复两种机制,并以三步衔接干预:初始化锚固定先将首个KV表项固定保留,避免滑动窗口驱逐后转入静默与胡言乱语;双工重复惩罚再以最近512个词形记号为历史统计复用,对复现词施加惩罚并等量抬高全部词logits以抵消对PAD和EPAD的相对助推;其输出的PAD游程再进入长时静默保护,当用户安静且PAD连续达375帧即30秒后,在125帧内线性压低PAD logit至最多3.0,仍由模型采样决定下一记号。在FD-LHB重放轨道40路最长60分钟CANDOR重放评测中,以重复、长时静默、胡言乱语发生率计,Moshi基线与IAP+DRP对比从65%、100%、100%降到0%、7.5%、0%,PersonaPlex从90%、85%、100%降到2.5%、47.5%、0%。在逐帧延迟的实时因子评测中,IAP+DRP在RTX A6000上的实时因子为0.75,低于1.0的实时门限。结论适用于所测的两种滑动窗口模型,增长上下文模型仍会耗尽上下文,PersonaPlex的长时间静默也未完全消除。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
24. 按截止时间回答的多音高估计:JIT-MPE 如何即时给出再逐步修正

英文题目:JIT-MPE: Just-in-Time Multi-Pitch Estimation under Output Deadlines
评分:7.0/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Yoshiyuki Kobayashi:Frieve
📌 核心摘要
现场显示与跟谱需要在几十毫秒内知道当前响起哪些音高,而通用混合编制的多音高估计多按读取整曲来设计和评分,延迟与精度的关系没有被量化。JIT-MPE对每段20 ms帧先用因果谐波卷积与跨音共享循环网络给出即时估计,再在20、40、80、160 ms新音频到达后用延迟头重估同一帧,显示可先画后改,同一模型因此能服务所有截止时间。截止时间受限评测只用截止时间前已到达音频能算出的输出计分,从而区分早估计的精度和等待的收益。在50 ms截止时间下按录音级宏F1比较,JIT-MPE在九个集的45组对照中有38组高于六个已发表离线MPE系统中的五个,仅2组更低;在四个留出集上相对自身160 ms前视最终输出的差值为-1.27至+0.60个百分点。等待主要补上刚起音的漏检,留出集AAM上起音后首个20 ms内参考帧召回率从9.8%升至50 ms时的38.4%,160 ms时达62.3%。即时估计本身并不弱,与同谐波前端的单头因果对照相当,50 ms更新则在录音级宏F1上比即时估计增加1.7–3.6个百分点,基本弥合到最终输出的差距。该结论不覆盖所有情形,两个更低对照均在BSED真实管弦录音上,第六个在URMP上监督的系统在三个连续基频真值集与BSED真实集上更高,而在ChoraleBricks上等待没有带来提升。单CPU线程最慢一跳至多4.15 ms,模型含86k参数,每秒音频需0.68 GMAC。
🔗 开源资源
代码相关资源:https://github.com/Frieve-A/jit-mpe — 暂时无法访问
模型相关资源:https://github.com/Frieve-A/jit-mpe — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
25. 乐谱的丰富记号对建模有帮助吗:MusicXML 分词与理解生成对照
英文题目:Does Notation Matter? MusicXML Tokenisation for Symbolic Music Generation and Understanding
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Andrea Poltronieri:机构信息未能在本次解析中与作者逐人可靠绑定
- Matteo Spanio:机构信息未能在本次解析中与作者逐人可靠绑定
- Simone Chieppa:机构信息未能在本次解析中与作者逐人可靠绑定
- Xavier Serra:机构信息未能在本次解析中与作者逐人可靠绑定
- Martín Rocamora:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是符号音乐的不同写法,困难在于演奏记录与完整乐谱包含的信息量不同,而模型看到的只是离散记号序列。论文把MusicXML乐谱变成记号序列,用自回归模型(Autoregressive Model,指按顺序预测下一个记号的模型)做续写,用掩码语言模型(Masked Language Model,指遮住部分记号并预测的模型)提特征做理解任务。处理过程是解析MusicXML的声部、小节与音符属性,按声部优先或小节优先两种顺序展开,再决定是否用字节对编码(Byte Pair Encoding,BPE,指合并高频记号对的子词方法)压缩。与把乐谱当纯文本的ABC方法和只记演奏事件的MIDI方法相比,新框架保留了异名同音拼写、力度、装饰与多声部结构。在KernScores作曲家分类五折交叉验证中,准确率指标上小节优先的MusicXML分词器MxlTok-MF的10k词表为0.781,高于同为10k词表的MIDI基线REMI+的0.748。在以PDMX R∩D子集训练分布为参考、每模型按20个提示各生成10首的客观统计评估中,JS指标上声部优先的MxlTok-PF的5k词表为89.2,高于同为5k词表的MIDI基线REMI+的79.4,人类成对偏好也更偏向MusicXML续写。结论适用于古典与folk占比较大的公共领域乐谱,跨风格与更大规模训练尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/andreamust/MxlTok — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
26. 用可执行计划做空间音频生成与编辑:Ambit 如何连起规划与渲染

英文题目:Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kam Man Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Pengjun Fang:机构信息未能在本次解析中与作者逐人可靠绑定
- Mingfei Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Weijia Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Zeyue Tian:机构信息未能在本次解析中与作者逐人可靠绑定
- Qifeng Chen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是从文字生成多声源三维声场,以及按指令修改其中一个声源同时保留其余声源,困难在于语义决定与多通道合成容易脱节,编辑时声学细节容易丢失。输入是生成请求或参考一阶 Ambisonics(First-Order Ambisonics,FOA)波形加编辑指令,输出是四通道 FOA 波形,中间需要决定每个声源的内容、起止时间和三维轨迹,再把这些决定变成声音。方法先由自回归计划器(autoregressive planner)输出可执行场景计划(ScenePlan),编译器将其变为语义标记与帧对齐空间控制,交给整流流(rectified flow)渲染器生成隐变量并经变分自编码器(Variational Autoencoder,VAE)解码。编辑时计划描述完整目标场景,对比特征定位修改点,完整参考隐变量补充保留声源的残余声学细节。FOA 感知 VAE 用共享解码器的全向通道辅助重建与空间协方差匹配保持通道间关系,在策略自蒸馏(On-Policy Self-Distillation,OPSD)阶段用目标条件教师在学生自身前缀与采样状态上同时监督计划与渲染。与 SwanWeave 相比,编辑在 5,000 对评测上配对 CLAP 为 0.84 对 0.68,LSD 为 1.27 对 1.65。结论适用于约 15 秒、1 至 4 个声源的场景,更长声音景观与多次连续编辑的一致性尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://wjm-george.github.io/AMBIT/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
27. 折叠执行下存储与计算如何分别定价:FPGA 语音增强加速器解读
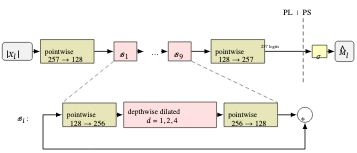
英文题目:Realizing Low-Precision Storage and Sparse Execution in a Folded FPGA Speech Enhancer
评分:7.0/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Clément Laroche:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
待处理的语音是带噪短时傅里叶变换幅度帧,目标是估计每一时频点的掩码以恢复干净语音,难点在于助听等端侧设备面积小而实时性要求高。论文采用的Conv-FSENet先用逐点卷积升维,再经九个结构相同的时域卷积块提取上下文,最后由掩码层输出257个逻辑值,主机负责短时傅里叶变换、Sigmoid与逆变换。折叠引擎把九个块复用在同一物理块引擎上顺序执行,权重以每通道共享码宽加移位的紧凑磁带形式存放,输出格式由共享重整化器统一控制,变窄的权重只缩小存储流而不缩小共享乘法器。训练在压缩谱均方误差上增加存储铰链项与通道组稀疏项,前者约束打包后的权重映像大小,后者把整个输出通道推向零以便跳过其乘累循环,组稀疏训练中期的不稳定仍需在第50轮冻结零通道掩码后继续优化幸存权重与精度来绕开。在VoiceBank-DEMAND测试集上以宽带PESQ为质量指标并在同一四通道折叠引擎上实测,稀疏的Skip-Plain以2.78高于最省的稠密构建Uniform-6的2.64,同时帧耗时以1.03毫秒低于1.77毫秒、单帧动态能耗以33.4微焦低于64.5微焦,其47.3%卷积乘累因整通道为零而被跳过。在同一引擎的固定宽度对照中,权重宽度从8位降至6位时动态功率下降27%而帧耗时变化不足5%,说明窄宽省存储与开关能耗但不省周期。结论仅来自该折叠引擎经Kria KV260上100兆赫兹板级实测的对比,未验证其他网络、其他板卡与强非平稳噪声下的泛化,循环加权组稀疏在本轮未优于普通组稀疏。
🔗 开源资源
- 第三方资源:https://fastmachinelearning.org — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
28. 把过去记成状态、把现在做成注意力:面向长时语音手势的块式流匹配

评分:6.9/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yi Liu:Tongji University
- Xiangyue Zhang:The University of Tokyo
- Jianfang Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Jia Ma:Tongji University
- Yisheng He:机构信息未能在本次解析中与作者逐人可靠绑定
- Jianqiang Ren:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
随语音动作生成要从语音合成节奏语义协调的全身动作,长时需保持连贯与说话人风格一致,而短种子按段生成易漂移、保留全部历史词元则显存计算随长度增长且难稳定利用长历史。PASPA把序列切成64帧的块,先用门控增量状态读入语音与已生成块输出固定尺寸历史总结并作为下一块条件,再用块内双向自注意力结合该总结与语音条件精细建模当前块动态。训练对多个连续块施加不同噪声水平并行去噪,推理经状态预填缓存固定尺寸状态后迭代解码,并用混合无条件引导同时控制语音条件与历史依赖强度。与基于流匹配的GlobalDiff相比,在BEAT2单说话人测试集上PASPA的Fréchet gesture distance(生成与参考特征分布差异,越低越好)从4.78降到3.71。在10秒至60秒滚动生成取末端10秒窗口评估中,50至60秒段PASPA该指标为5.745,低于短种子基线的6.721,也低于词元注意力的5.771。该结论限于BEAT2与SHOW基准及所用自动指标评估,训练用真实历史而推理依赖生成历史致暴露偏差,长时滚动可能累积误差出现重复、姿态坍缩或身份漂移,固定尺寸状态也难复现远距离精确对应,60秒以上长时质量与新风格感知指标尚未验证。BEAT2模型约65.158M参数、单次前向16.633G运算量,在4张NVIDIA A800上训练约30小时,120秒至600秒合成中混合引导只增约4.9%至9.1%时延与0.01GB峰值显存。
🔗 开源资源
- 第三方资源:https://ly403.github.io/PASPA/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
29. 只记住最后数字还不够:多说话人决策过程如何被完整追回

英文题目:DecisionTraceBench: Tracking Decision-Critical Information in Multi-Party Spoken Conversations
评分:6.9/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Wenchao Du:AI Lab, Qifu Technology, Beijing, China
- Fangxin Shang:AI Lab, Qifu Technology, Beijing, China
- Long Wu:AI Lab, Qifu Technology, Beijing, China
- Runze Cui:AI Lab, Qifu Technology, Beijing, China
- Qing Yang:AI Lab, Qifu Technology, Beijing, China
- Yehui Yang:AI Lab, Qifu Technology, Beijing, China
📌 核心摘要
金融会议记录需要回答提案经历了哪些有效变化、每次变化由谁在何种权限下作出、依据哪段语音证据,单句转写正确或最终金额正确都不能保证中间的暂停与恢复没有丢失,也不能保证把他人建议误记为有权批准。论文提出决策关键信息状态跟踪,输入为未切分的两到四人多轮录音与公开的实体与字段说明,输出为按实体与字段组织的轨迹,每条轨迹包含若干决策周期,每个周期内事件按时间有序记录动作、取值、说话人、权限范围、前驱关系与证据区间。构建时先设计金决策轨迹,再以轨迹为条件生成口语脚本,脚本经多模型交叉核查后交由语音合成或真人演播录制音频并对齐事件证据时间,评测时转写输出进入轨迹恢复模型再用轨迹级F1做联合评分。相对已有语音理解与轮级对话状态跟踪,该工作把最小必需事件链、说话人归属、权限范围与时间证据放在同一匹配规则下考核,遗漏必需事件即判整条轨迹失败。在固定25条真人录音、16个对话家族与293条金轨迹的同一音频评测下,FunASR加Astra的轨迹级F1即DCIST为21.35%,高于直接处理音频的Gemini-4-Argon的18.82%。终端值正确仍可能对应过程错误,最优系统恢复的正确终端值中逾半数轨迹不完整,说明必须直接考核完整事件链。结论适用于中文金融剧本对话的受控评测,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/QFIN-tech/DecisionTraceBench — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
30. 固定视频不变,译文怎么说才能对上口型和节奏

英文题目:X-Dubbing: Speech-to-Speech Translation under Temporal and Visual Constraints
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jeongsoo Choi:KAIST
- Ji-Hoon Kim:Chung-Ang University
- Junseok Ahn:KAIST
- Joon Son Chung:KAIST
📌 核心摘要
固定视频配音的输入是源语言语音和保持不变的源视频,输出是目标语言语音,要求语义忠实,同时总时长、停顿位置和口型大体对齐。难点是语言间音节量和发音节奏不同,直接翻译往往过长或过短,固定文本再硬拉时长会让语速失真。配音翻译器(Dubbing Translator)负责根据源语音和计时预算生成带停顿标记的目标脚本,配音合成器(Voice Actor)负责把脚本读成与源时长相同的语音,并用帧级语音活动和视觉线索控制局部时序。合成后的语音再回到翻译器的偏好优化,挑选在音节速率、质量估计和唇同步上占优的候选,促使翻译主动选择易于同步的措辞。与只做时长约束翻译或只做视频条件合成的管线不同,该设计让文本选择考虑了后续语音实现。在 mTEDx 法语到英语测试集上,X-Dubbing 的 ASR-BLEU 为 42.34,高于最强的对比系统 SeamlessExpressive 的 38.44,SLC@0.2 为 97.1%,LSE-C 为 2.58,也高于表中基线。结论目前只适用于法语到英语单人独白短片段,多说话人、其他语种和长视频尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
31. ChoreoStudio:把群舞编排拆成想什么、何时变、谁来动

英文题目:ChoreoStudio: Planning What, When, and Who in Music-Driven Group Choreography
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jing Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Cunjian Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiuhong Ke:Department of Data Science and Artificial Intelligence, Faculty of Information Technology,;Monash University, Australia
📌 核心摘要
多人随音乐共舞要求输出每位舞者随时间变化的三维动作,同时保持队形演变与音乐结构对齐,难点在于已有生成器能维持局部协调,却缺少对队形何时变化和由谁执行变化的显式表示。ChoreoStudio先用可学习的音乐解纠缠器从音频中分解出用于动作实现的帧级节奏特征和用于编排的片段级结构特征,再用冻结的全模态模型由音频与风格标签生成全局语义描述,共同作为编排依据。编排指导器(Director)在片段尺度输出去中心化的相对队形点集、有向舞者关系图、转换门控与移动分配,分别明确形成何种队形、何时转换以及由谁执行移动,使队形几何、转换时机与舞者分工被联合规划。扩散生成器在帧尺度以节奏特征和计划指令合成全身动作,并经冻结验证器做多轮计划修正,以闭环实现计划到动作的落实。在AIOZ-GDance三人150帧设置下,ChoreoStudio的组运动真实感指标GMR为10.42,优于最强基线TCDiff++的11.57,且慢速队形变化量IDDV为0.267,更接近真实数据的0.302。结论适用于2至7人短序列与720帧长序列的同一模型复用,绝对舞台朝向与更细语义角色尚未建模,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
32. 用更少波形通道加全阶方向能量包络压缩高阶 Ambisonics

英文题目:SEMAC: Spherical Energy Matching Ambisonics Codec for Efficient Higher-Order Ambisonics Compression
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Christoph Hold:机构信息未能在本次解析中与作者逐人可靠绑定
- Jan Buethe:机构信息未能在本次解析中与作者逐人可靠绑定
- Jean-Marc Valin:机构信息未能在本次解析中与作者逐人可靠绑定
- Jan Skoglund:机构信息未能在本次解析中与作者逐人可靠绑定
- Toni Hirvonen:机构信息未能在本次解析中与作者逐人可靠绑定
- Nils Peters:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要压缩的是高阶Ambisonics信号,它用球谐系数表示声场,阶数越高方向分辨率越高,但通道数随阶数平方增长,逐通道编码的总码率很快不可行,输入是MDCT域球谐系数,输出是恢复全阶方向性能量分布的重建信号。论文处理的过程是编码端把球谐系数变换到方向性波束域,提取每个波束、每个频带的能量包络作为边信息,只用少数传输通道做波形编码,解码端再把传输信号扩展回全阶并按包络重定标量。方向性能量包络指在离散波束方向上采样的各频带幅度集合,不估计声源个数或到达方向。约束能量交叠变换指Opus中的变换编码单元,它分开编码频带能量与归一化形状,SEMAC把该思想推广到方向维;通道映射族3指Opus中对高阶Ambisonics做固定波束成形再做立体声耦合编码的已有模式,本文基线与其使用相同的波束矩阵以隔离新增机制的效果。在48 kHz五阶素材、512 kbit/s和768 kbit/s两种总码率下以MUSHRA总体质量评分为指标的比较中,用16个传输通道的SEMAC的该指标评分均高于用36个通道的全阶Opus通道映射族3。在同样48 kHz五阶素材、两种总码率下以MUSHRA总体质量评分为指标且传输通道数相同时,SEMAC的该指标评分高于直接截阶的通道映射族3基线。结论适用范围限于所选七个关键条目、双耳MagLS渲染和上述码率段,传输通道过少时质量受传输维度限制,以包络边信息码率为指标在五阶时可占用超过100 kbit/s,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
33. 离线模型如何自己学会同声传译:SimPOTrans 的两阶段强化学习自适应

评分:6.8/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Haotian Tan:机构信息未能在本次解析中与作者逐人可靠绑定
- Hiroki Ouchi:机构信息未能在本次解析中与作者逐人可靠绑定
- Sakriani Sakti:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
同时语音翻译(Simultaneous speech translation,SimulST)要在语音未结束时边听边译,输入是连续到达的源语音流,输出是逐步增长的目标译文,难点在于决定每轮翻译多少已有内容以及如何措辞,才能兼顾质量与延迟。对话式建模把语音块当作用户提示,把增量译文当作助手回复,复用键值缓存实现长语音高效推理,但已有做法依赖词对齐或大语言模型(Large Language Model,LLM)合成的读写轨迹,质量受对齐误差影响。SimPOTrans 先在完整话语上做监督微调建立离线翻译能力,再用群组相对策略优化(Group Relative Policy Optimization,GRPO)提升完整话语质量,随后在部分语音输入的多轮轨迹上自适应,只用标准离线平行数据和完整译文级奖励。推理时无需外部决策模块,改变输入块时长即可调节延迟。在 MCIF 开发集低延迟条件下,En→De 取得 COMET 0.87、LongYAAL 1.6 秒,En→Zh 取得 COMET 0.76、LongYAAL 1.7 秒,均优于多数受控基线和共享任务系统。局限是固定切块与仅文本输出的设定,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/Tan-ht/SimPOTrans — 链接可访问(HTTP 200)
第三方资源:https://tan-ht.github.io/naist-simulst-demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
34. DRAMA-Eval:面向上下文、多轮、多说话人的语音生成评测

英文题目:DRAMA-Eval: A Benchmark for Context-Aware, Multi-Turn, Multi-Speaker Speech Generation
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Jingbin Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zihang Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaoge Peng:Shenzhen Pimei Technology Co., Ltd.
- Haoyu Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziyu Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Qirui Zhan:机构信息未能在本次解析中与作者逐人可靠绑定
- Huakang Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhao Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenjie Tian:机构信息未能在本次解析中与作者逐人可靠绑定
- Kangxiang Xia:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenkang Hou:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruonan You:机构信息未能在本次解析中与作者逐人可靠绑定
- Zihan Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Chenyi Liao:机构信息未能在本次解析中与作者逐人可靠绑定
- Hongyu Lyu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zihao Bai:机构信息未能在本次解析中与作者逐人可靠绑定
- Jinrui Liang:机构信息未能在本次解析中与作者逐人可靠绑定
- Shengming Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunxiang Chen:Shenzhen Pimei Technology Co., Ltd.
- Houdun Liu:Shenzhen Pimei Technology Co., Ltd.
- Su Feng:Shenzhen Pimei Technology Co., Ltd.
- Bengu Wu:Yutu Zhineng
- Liumeng Xue:机构信息未能在本次解析中与作者逐人可靠绑定
- Lei Xie:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是有声书和广播剧式的语音生成,输入是一个包含场景背景、人物小传和逐轮说话人与台词及演绎要求的结构化剧本,输出是完整场景音频,难点在于同时保持人物音色、执行显式与隐式演绎要求并让多轮交互听感连贯。论文先从播客与影视等真实音频收集素材并做说话人与演绎标注,再改写为统一剧本并经人工审查,得到配有真实参考音频的测试集。评测沿一个样本把文本保真与跨句音色一致性算成客观指标,把生成音频与真实音频组成不透露来源的 A/B 对交给音频大模型按局部与全局维度判优,并经换位重判与多次重复平均为胜率。相对已有只看单句指令或只看对话音色的方法,该基准把客观、局部执行与全局交互放在同一场景下比较。在中文 537 例与英文 501 例共 12.50 小时音频上,SeedAudio 中文场景沉浸胜率达到 75.7%,高于只做单句拼接的强局部模型,而对话类模型音色一致性约 0.78 却局部表现力偏低。结论适用于中英文 43 秒左右、2 到 20 轮的短场景,未验证更长叙事与多语言泛化。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/ASLP-lab/DRAMA-Eval — 暂时无法访问
第三方资源:https://huggingface.co/datasets/ASLP-lab/DRAMA-Eval — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/ASLP-lab/DRAMA-Eval-Results — 链接可访问(HTTP 200)
第三方资源:https://ASLP-lab.github.io/DRAMA-Eval-Demo → https://aslp-lab.github.io/DRAMA-Eval-Demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
35. 把嵌入门从球面换到单纯形来缩小模态间隔

英文题目:Closing the Modality Gap via Simplex-Constrained Representations
评分:6.6/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shubham Gupta:机构信息未能在本次解析中与作者逐人可靠绑定
- Siva Reddy:机构信息未能在本次解析中与作者逐人可靠绑定
- Perouz Taslakian:机构信息未能在本次解析中与作者逐人可靠绑定
- Valentina Zantedeschi:机构信息未能在本次解析中与作者逐人可靠绑定
- Cem Subakan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
多模态对比模型把文本与音频或图像映射到共享空间,目标是让配对样本靠近,但两类样本的整体分布常常存在系统性偏移,这就是模态间隙,偏移会误校准跨模态相似度并影响检索排序。论文冻结LAION-CLAP与FLAVA等骨干网络,输入文本与音频或图像后先得到池化嵌入向量h,该向量作为顶层共享轻量适配器的输入。共享的线性或两层MLP适配器把h转为logits z,z再进入两种输出域分支:归一化到单位球面或经softmax投影到概率单纯形。球面分支用余弦相似度打分,单纯形分支用负TV距离打分,两种路径都以对称的批内InfoNCE目标训练适配器,只改变打分函数以分离几何效应。在COCO上,单纯形路径把中心点欧氏间隙从冻结模型的0.810降到0.012(MLP+Softmax表格值,ReTreever为0.007),同时文本到图像NDCG@10保持在0.69附近,没有用检索性能换取间隙缩小。作者把这种几何约束解释为跨模态校准:非负且和为1的约束迫使两个模态在同一组坐标上分配概率质量,softmax的整体平移不变性提供额外归一化。结论适用于所评测的五个检索基准与适配器训练流程,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/ServiceNow/retreever/tree/main/experiments/modality_gap — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
36. 从输出标签到讲出依据:ADReasoner 如何做可解释的阿尔茨海默语音检测

评分:6.6/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yin-Long Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuanchao Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiahong Yuan:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhen-Hua Ling:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一段受试者描述 Cookie Theft 图片的语音,困难是阿尔茨海默病早期语音差异细微、公开数据少、现有语音大模型只输出阿尔茨海默病或健康对照两类标签而缺少可核查依据。处理过程是先扩充文本与语音样本,再抽取声学与语言线索并生成思维链标注,然后增强模型对线索的感知,最后用强化学习优化诊断与推理一致性。四个步骤的职责是受控合成缓解数据稀缺,ADCoT-7K 构建提供推理监督,两阶段监督微调建立线索感知基础,四奖励组相对策略优化直接优化推理质量。相对已有方法,关键差异是不只用格式与标签正确奖励,还引入推理奖励与推理-标签一致性奖励,并用收缩与门控稳定训练。在 Pitt 测试集上,ADReasoner 的宏 F1 为 80.72%,准确率为 81.10%,超过次优模型约 5.3 个百分点。结论适用于图片描述任务的英语阿尔茨海默病语音检测,跨库泛化与临床部署尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
37. LeanTTS:不到 20M 参数如何同时做零样本克隆和固定音色定制

英文题目:LeanTTS: Efficient Full-Stack Bilingual TTS for Zero-Shot Cloning and Voice Customization
评分:6.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.1/0.5 | 工程/实践 1.5/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Yuheng Lu:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiulin Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xi Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Shengpei Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Liyin Liang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yifeng Qian:机构信息未能在本次解析中与作者逐人可靠绑定
- Longbiao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是输入一段中英文文本、输出24 kHz波形的可部署合成栈,困难在于常见零样本系统体积大、依赖参考音频和云端计算,难以放在车机或嵌入设备上本地运行。中英文文本先经各自前端转为发音标记,其中紧凑的普通话多音字前端只对模糊字调用两层上下文编码器并只打分候选读音,输出的发音标记与起始位置说话人标签联合编码为文本条件。压缩后的流匹配声学模型以该文本条件预测梅尔谱,未见说话人时叠加参考语音作为声学提示仿制音色,常用定制音色则在训练中逐步去掉声学提示以便推理时只用标签选择。梅尔谱再送入压缩后的Vocos声码器重建波形,四步MeanFlow接续检查点把迭代次数从16步降到4步。与136.2M参数的ZipVoice-Vocos全链路相比,LeanTTS-13M在Seed-TTS-Eval中文测试上零样本克隆取得2.02%字错率和62.3相似度,参数减少86.12%,同时暴露了相似度损失。结论适用于中英双语、本地CPU推理和少量高频定制音色,物理手机芯片和更大音色集合尚未验证。原文披露了推理侧部署成本,四步模型在Apple M5单线程CPU上平均实时率为0.049。
🔗 开源资源
第三方资源:https://github.com/notlu/leantts — 链接可访问(HTTP 200)
演示资源:https://github.com/notlu/leantts — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/uer/roberta-tiny-wwm-chinese-cluecorpussmall — 链接可访问(HTTP 200)
第三方资源:https://github.com/openai/whisper — 链接可访问(HTTP 200)
第三方资源:https://github.com/R1ckShi/SeACo-Paraformer — 链接可访问(HTTP 200)
第三方资源:https://github.com/microsoft/UniSpeech/tree/main/downstreams/speaker_verification — 链接可访问(HTTP 200)
第三方资源:https://github.com/sarulab-speech/UTMOS22 — 链接可访问(HTTP 200)
第三方资源:https://github.com/alibaba/MNN — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
38. 语音情感识别的高准确率里有多少是记住了说话人
英文题目:Beyond Accuracy: What Are Speech Emotion Recognition Models Learning?
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Prince Baah-Mensah:机构信息未能在本次解析中与作者逐人可靠绑定
- Dennis Owusu Asamoah:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音情感识别要从语音声学信号输出情绪类别,难点是同一说话人录制全部情绪类别,说话人音色与情绪线索混在一起。审计先在对照条件下复现原文随机分层划分与各自增强做法,允许说话人横跨训练、验证和测试,得到泄漏的准确率与非加权平均召回率均值与标准差。同一结构、特征、增强、优化器与早停原样转入严格说话人无关条件,测试说话人与训练完全隔开,验证说话人与两者都不同,归一化均值与标准差只用训练数据估计,再对干净测试语音测得说话人无关的准确率与非加权平均召回率。前两步的泄漏准确率减严格准确率得到说话人记忆差距,两者比值得到保持率,以此区分情绪学习与说话人记忆,与只统一特征或模型的综述和多语料基准不同,该工作固定模型而改变说话人划分。在SAVEE全量7类情绪上,Ahmed A配置的准确率从对照条件88.12±3.00%下降到严格条件25.00±10.95%,而冻结wav2vec2编码器配置在EMO-DB上的准确率从对照96.79±1.87%下降到严格89.91±4.11%,降幅明显更小。结论只适用于所测表演式语料与复现配置,不能说明自然对话或更大说话人群体的表现。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
39. 生成评价里核距离在有限样本下能看见什么:KID 与 KAD 的灵敏度审计

英文题目:Finite-Sample Sensitivity of Kernel Metrics for Generative Evaluation
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tomasz Radzikowski:机构信息未能在本次解析中与作者逐人可靠绑定
- Mateusz Modrzejewski:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是生成评估报告的核距离数值,它比较生成样本集合与参考样本集合在嵌入空间中的分布差异,困难在于数值大小同时受核形状、嵌入几何和样本量影响,默认配置在某个样本量下能看见哪类差异并不透明。方法先从符号音乐、音频与图像的真实嵌入中抽样构成两侧样本,对其中一侧分别施加均值平移、各向同性收缩和保持均值与协方差迹且匹配传输距离的旋转,输出待检样本对。接着将该样本对送入两个固定的出厂核配置:核内inception距离用三次多项式核,核音频距离用中位数启发带宽的高斯核,计算无偏MMD统计量。再以500次标签置换在显著性水平0.05下判定拒绝与否,以拒绝次数为指标,从而分离位置、总尺度与方向灵敏度。在每侧780个样本、每格20次抽样的五个空间置换检验中,以拒绝次数为指标,收缩探针下中位数带宽高斯核均为20/20,高于三次核至多6/20。在同样设置的匹配传输距离探针置换检验中,以拒绝次数为指标,均值平移下两个默认配置均为20/20,高于弱旋转至多4/20。在CLaMP 2嵌入同样本抽样旋转探针检验中,以拒绝次数为指标,0.05倍中位数平方距离带宽为20/20,高于中位数启发带宽2/20。上述结论只适用于所选编码器与构造探针,不证明模型排序或感知优劣,三次核大样本旋转灵敏度尚未验证;原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/IraKorshunova/folk-rnn — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
40. S2SND-v2:统一在线与离线的说话人日志系统

英文题目:S2SND-v2: Unified Online and Offline Speaker Diarization with Speaker-Adapted w2v-BERT 2.0
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jincheng Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Li Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Weixin Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yannan Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tao Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Juan Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ming Li:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一段多人说话录音,困难在于判断每一帧谁在说话,还要处理说话人重叠、说话人数量未知和在线延迟限制,处理过程是把波形变成帧级特征,再估计每位说话人的活动时间线。S2SND-v2沿用序列到序列神经分离标注(Sequence-to-Sequence Neural Diarization,S2SND)的双解码器结构,前端把原残差网络换成说话人适配的w2v-BERT 2.0,保留层适配器和多尺度特征聚合输出帧级序列,该序列一路经编码器加入时间上下文后供检测使用,另一路作为记忆特征供嵌入提取使用,比较了完整模型和两种剪枝构造路线。检测解码器以说话人嵌入作查询从编码器输出中预测活动,表示解码器以活动查询从前端特征中提取说话人嵌入,在线推理时提取的嵌入被累积并作为后继窗口的查询,离线时再用累积嵌入对整段录音重解码。表示解码器一侧加入重叠感知活动查询掩蔽,把两人以上同时说话帧的查询置零,减少并发说话人的干扰;训练一侧加入晚说话人训练,提高对后半段才首次出现的未知说话人的覆盖。与重新训练的 S2SND 基线相比,完整剪枝系统在八个测试集平均的在线与离线说话人分离标注错误率(Diarization Error Rate,DER)分别为 14.52% 和 12.03%,离线平均值低于所列对比系统中的 DiariZen-Large-s80-v2。结论适用于论文所用的八个测试集和无 oracle 语音活动检测、0 秒容忍边界的计分条件,原文披露了 8 秒滑窗、0.80 秒名义输出延迟和完整模型与剪枝模型的单窗计算量差异。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
41. 集中控制与分散信息:大音频语言模型里认知障碍决策的神经元机制

评分:6.4/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xiutian Zhao:Center for Language and Speech Processing (CLSP), Johns Hopkins University, USA
- Luqi Sun:Center for Language and Speech Processing (CLSP), Johns Hopkins University, USA
- Björn Schuller:Group on Language, Audio & Music (GLAM), Imperial College London, UK
- Berrak Sisman:Center for Language and Speech Processing (CLSP), Johns Hopkins University, USA
📌 核心摘要
读者需要理解的对象是大型音频语言模型根据一句话外加一段录音判断说话人是否认知受损的过程,困难在于输出正确不能说明模型内部哪里在做决定,也不说明诊断信息分布在何处。论文沿一个 Cookie Theft 看图说话样本说明处理过程,同一录音分别以纯语音、纯文本、语音加干净文本、语音加标注文本输入,模型在两种选项顺序下输出首步选项字母的对数几率并取平均得到预测。方法把解码器门控多层感知机中两类正确且确信样本间激活频率差异最大的前 0.5% 神经元取出,构成每类各自的认知损伤对比神经元(CI-contrast neurons,CICNs)掩码,再用清零消融观察预测是否朝远离掩码类别的方向移动,并与层内数量匹配的随机掩码比较。位置受限消融把干预只加在音频段、文本段、模板前后段或最后答案位置,以判断影响发生在何处,冻结激活上的岭回归读出则检验同样特征能支持多好的诊断排序。与已有输入级归因不同,该工作直接干预内部单元并检验跨语音与文本、跨语料的可移植性。在 Pitt 评估集上,4 个主要掩码的平均对数几率变化幅度为 1.6 至 2.6,而匹配随机掩码平均不超过 0.17,Kimi-Audio 的标注联合输入健康掩码消融翻转 88% 原来判对的健康样本,随机掩码仅翻转 16%。冻结 CICNs 激活的监督读出在 Pitt 达到 0.92 至 0.97 的 AUC,高于模型直接回答的 0.67 至 0.84,但随机神经元与全量神经元读出也接近同一水平。结论适用范围是受控二选一提示下的首步决策机制,不是临床筛查有效性,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
42. 只靠大脑跟随语音来判断注意:CoupleFlow 的耦合解码与证据累积律

评分:6.4/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ali Alavi:机构信息未能在本次解析中与作者逐人可靠绑定
- Donald S. Williamson:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是从头皮脑电或脑磁中判断听者正在注意哪一路语音,难点是神经响应微弱且个体差异大,而候选语音在响度、音色和试次身份上的差异容易被解码器当作捷径。论文提出的方法先把脑记录编成神经嵌入,把每路候选语音编成声学嵌入,只用两者随时间起伏的一致性打分,脑嵌入不随时变化时所有候选得分同为零。另一条分支用条件流匹配估计有脑条件和无脑条件下的包络残差,残差之差近似点式互信息并取最大者为第二种判决。相对已有包络重建和直接分左右侧的方法,关键差异是判决通路不接触语音身份和侧别信息,侧别分支只在训练时出现。与同划分训练的线性反向模型等基线相比,该方法在5 s竞争说话人任务上的准确率领先约2.3至6.8个百分点,其中脑磁单说话人匹配任务上以99.0%的准确率高于线性反向模型的92.0%。结论适用于内容不交叠的新语音和未见被试,Broderick数据集上跨被试迁移失败,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
43. DJustify:给人声流行歌做衔接与故事整场的 AI DJ

英文题目:DJustify: Reason-and-Verify DJ Planning for Pop Transitions and Story-Driven Sets
评分:6.4/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Wei-Han Hsu:机构信息未能在本次解析中与作者逐人可靠绑定
- Li-Jie Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Po-Hsuan Lai:机构信息未能在本次解析中与作者逐人可靠绑定
- Po-Hsiang Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jeng-Yue Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Li Su:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi-Hsuan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
自动DJ需让两首歌不间断衔接,流行乐人声密集、段落功能多变,选曲、进出点、重叠长度与手法相互牵制,固定规则难以兼顾。DJustify用同一指令微调模型承担过渡规划、选曲与按情感弧线排歌,规划先给出候选,再渲染成音频交外部声学检查器核验,失败时返回可执行修改并继续修复。与已有电子舞曲混音系统的差异在于联合推理加渲染后校验,并通过采样保留同一曲对的多种合法过渡。输入侧用节拍与下拍网格、结构分段、和弦、逐帧人声活动和效价与唤醒度标签构成候选切点,输出包含 incoming曲目、cue-out、cue-in、重叠长度和手法的结构化方案。在由种子曲构成固定曲对、听众按1–10分制打分的过渡盲听Test1中,平均意见分MOS为本系统5.6高于Mosaikbox的4.0。在同一Test1固定曲对盲听设置下,平均意见分MOS为本系统5.6高于自实现跨淡入淡出的4.7但低于人类DJ的6.7。在给定故事提示、每套三分钟的故事集盲听Test2中,故事规划的故事连贯性评分显著高于无故事消融,而过渡质量评分与人类DJ无可测差距。结论验证范围限于自采曲库和短时试听,原文披露的本地部署成本为全程运行于一块48 GB显卡并使用4位量化模型。
🔗 开源资源
第三方资源:https://github.com/ddman1101/DJustify — 链接可访问(HTTP 200)
第三方资源:https://jamie930625.github.io/djustify/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
44. 不花标注费选检查点:用未标注池的几何结构做音频主动学习验证

英文题目:Geometric Consistency Based Label-Free Validation for Checkpoint Selection in Audio Active Learning
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shiqi Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tuomas Virtanen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
音频主动学习每轮从未标注池中挑选一批片段请人标注,再在已标注集上从头训练分类器,目标是以很少标注获得高分类准确率,难点是小标注集上容易过拟合,选训练过程中哪个检查点作为本轮模型会明显改变效果。常用做法留出一部分标注做验证集,但这部分标注同样消耗预算,论文把仅用已标注集和未标注池做选择的方法称为可部署方法。本文提出几何一致性(Geometric Consistency,Geo-Con),先在冻结的预训练嵌入空间中用已标注样本拟合最近类均值和k近邻两个几何伪标注器,再让它们对未标注池预测以刻画池的几何结构。该规则对每个候选检查点计算其在池上预测与两组伪标注的一致性,以及在已标注集上的交叉熵,将三项分数在轮内标准化后相加取最大者,该过程与查询策略无关,超参数只有近邻数。在4数据集乘2编码器乘6查询策略的48组设置下,以测试宏准确率对累计标注的归一化梯形积即标注曲线下面积(Area under the labeling curve,AULC)衡量,Geo-Con的71.99%超过次优可部署方法kfold-refit的70.99%,方向为高1.01个百分点。同一AULC口径下Geo-Con的71.99%与使用预算外验证集的参考方法val-best的72.01%差距为低0.02个百分点,基本持平。开销上该规则每轮只在缓存的池嵌入上增加一次对全部候选检查点的批量前向通过,对两层头开销不大,无需留出验证标注或重复训练;结论适用于冻结编码器加两层头的协议,端到端微调时几何随检查点变化的情形原文未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
45. 一个模型同时做流式识别与合成:Uni-Stream 如何交错语音文本并分两阶段训练

英文题目:Uni-Stream: A Unified Streaming Speech Language Model for Speech Synthesis and Recognition
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Xuan Shi:University of Southern California, USA
- Chang Zeng:National Institute of Informatics, Japan
- Tiantian Feng:University of Southern California, USA
- Ye Zhang:Massachusetts Institute of Technology, USA
- Jun Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Shih-Heng Wang:University of Southern California, USA
- Lie Lu:机构信息未能在本次解析中与作者逐人可靠绑定
- Shrikanth Narayanan:University of Southern California, USA
📌 核心摘要
读者需要理解的对象是同时做语音识别和语音合成的流式语言模型,输入在识别时是陆续到达的语音,在合成时是陆续给出的文本,输出是另一模态的增量结果,困难是在共享权重下两方向互相干扰且延迟需要受控。模型先把语音和文本切成小块并按任务交错成一个序列,识别按语音帧推进并填入对应词,合成按时间对齐交替给出文本块和语音块,为增量解码提供上下文。同一主干对该序列建模,识别经文本头输出转写,合成经扩散头输出语音隐表示,两任务共享解码器权重。训练分两段完成,先把合成与识别分别适配到流式格式,再从合成适配模型出发联合训练并用教师约束保持合成能力。与已有离线统一模型和单任务流式模型的区别是输入端真正流式且两任务共享解码器。在LibriSpeech评测中,统一模型识别字错率在test-clean为3.63%,接近适配后专用识别模型的3.56%。在Seed-TTS-Eval英文集上合成字错率为3.20%,优于时间对齐专用合成模型的3.54%。结论适用于英语朗读类数据和自动指标,复杂噪声下识别差距会放大,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
46. 隔着玻璃听清说话:毫米波雷达语音增强挑战赛 RASE 在做什么
英文题目:ICASSP 2026 Radar Acoustic Speech Enhancement (RASE) Challenge
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Zhi-Wei Tan:机构信息未能在本次解析中与作者逐人可靠绑定
- V. G. Reju:机构信息未能在本次解析中与作者逐人可靠绑定
- Ritesh C. Tewari:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruotong Ding:机构信息未能在本次解析中与作者逐人可靠绑定
- Patrick A. Naylor:机构信息未能在本次解析中与作者逐人可靠绑定
- Andy W. H. Khong:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
穿玻璃场景需要从毫米波雷达测到的表面振动中恢复可懂的全带宽语音,输入是雷达中频(Intermediate Frequency,IF)信号相位变化换算得到的振动语音,输出是与干净语音时间对齐的增强语音,难点在于雷达信号带宽受限、信噪比低,并受反射面材质和几何影响,失真与传统麦克风增强不同。本文介绍 ICASSP 2026 Radar Acoustic Speech Enhancement(RASE)挑战,组织了直接振膜振动和二次表面振动两种采集条件,训练与验证采用 LibriSpeech 播放录制,测试采用未公开语料以检验跨语料泛化,并通过 Codabench 在服务器端统一评分。参赛系统以振动语音为输入,输出 8 kHz 波形,再按感知语音质量评估、扩展短时客观可懂度、梅尔频率倒谱系数余弦相似度与深度噪声抑制平均意见分预测值组合计分,直接场景占 40%,二次表面场景占 60%。相对以往各自搭建硬件、缺乏配对参考的做法,该工作提供了配对数据、预处理、基线代码和可复现的提交流程。在隔离测试集上,第一名 WHU IASP 综合得分为 0.3431,超过基线的 0.2324,感知语音质量评估为 1.541,扩展短时客观可懂度为 0.248。结论适用于所采集的 77 GHz 雷达、玻璃隔离、扬声器播放条件,真实人声、其他材质和更复杂混响尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/RASE-Challenge/challenge_baseline2026 — 暂时无法访问
第三方资源:https://rase-challenge.github.io/RASE2026-Challenge/ — 链接可访问(HTTP 200)
第三方资源:https://www.codabench.org/competitions/10857/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
47. 广告剪辑考什么:AdShot 如何测多模态大模型的选镜头能力

英文题目:AdShot: Benchmarking Multimodal Large Language Models for Video Advertisement Clipping
评分:6.3/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Wen Xie:Northeastern University, Boston, MA 02115, USA
- Om Rastogi:Northeastern University, Boston, MA 02115, USA
- Sai Siddhartha Vivek Dhir Rangoju:Northeastern University, Boston, MA 02115, USA
- Gijs Overgoor:Southern Methodist University, Dallas, TX 75205, USA
- Yakov Bart:Northeastern University, Boston, MA 02115, USA
- Sarah Ostadabbas:Northeastern University, Boston, MA 02115, USA
📌 核心摘要
读者需要理解的对象是一条30秒广告,它被切成约14个镜头,每个镜头只有1到3秒。困难在于从中挑出总时长14到16秒的镜头子集,既要接近专业剪辑师保留的镜头集合,又要保持产品信息、情绪、形象和行动号召的配比。论文构建了AdShot基准,包含823对30秒源广告和同品牌15秒剪辑版,覆盖194个品牌和17个行业,并标注镜头边界和18个内容属性。评测分三步衔接:先按镜头时序抽取每镜头的中心帧并附上镜头顺序与时长,再连同要求选出约15秒镜头的任务指令一起送入多模态大语言模型;模型据此输出JSON格式的选中镜头编号、总时长和理由;最后将该选中集合与真实投放的15秒版本对照,按集合重叠和时长误差打分,同时检验内容构成保留情况。与只理解视频问答的已有广告基准不同,AdShot直接对照真实投放的剪辑决定,可诊断时长控制和内容取舍能力。在每镜头1帧设置下,Qwen2.5-Omni 7B在音频加视频输入时F1达到0.668,而启发式随机基线F1为0.503,13个纯视频模型的平均时长误差为5.39秒。结论适用于30秒到15秒的美国电视广告式剪辑,对更短版本、重排序和音频连续性尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
48. RoleHear:让流式识别器边转写边标出说话人角色
英文题目:RoleHear: Pseudo-Labeling for Semi-Supervised Role-Attributed Streaming Speech Recognition
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zefang Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Chenyang Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Sangwoo Cho:机构信息未能在本次解析中与作者逐人可靠绑定
- Xujun Peng:机构信息未能在本次解析中与作者逐人可靠绑定
- Rongqing Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Shi-Xiong Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Sambit Sahu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是实时客服等场景的流式语音识别:输入是连续到来的通话音频,输出要求是带文字的词流,且每个词要标明会话角色,例如客服与客户,难点是流式模型只能看到有限历史与前视,而角色标注稀缺。RoleHear 先用多模态大语言模型(Multimodal Large Language Model,MLLM)为只有文字的财报电话补角色,得到银标签;再把离线全上下文识别器微调为带角色识别器,用它对无标注音频做一次贪婪解码,产生带角色的伪标签;最后把金标签、银标签和伪标签混合,按固定词延迟编码角色词,对缓存感知的流式学生做单遍微调。与已有做法相比,它不用额外说话人分离标注模型、说话人库或文本大模型后处理,而是用词表内角色词直接随词流输出,并把轮次检测与角色确认拆开。在 Earnings-22 测试集上,RoleHear 相对同词延迟的监督流式学生在相同解码条件下将角色归属词错率降低 6.5 个百分点并将宏平均 F1 提高 13.8 个百分点,同时词错率保持相当。结论适用于客服电话与财报电话的封闭角色集合,银标签参考带来的评估偏差尚未排除。原文未披露训练时长、吞吐或显存占用。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
49. 当人设与台词冲突时:链式思考语音合成在哪里丢失意图

英文题目:When the Persona Contradicts the Line: Diagnosing Plan-to-Synthesis Failures in Chain-of-Thought TTS
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Joonyong Park:机构信息未能在本次解析中与作者逐人可靠绑定
- Jerry Li:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
研究对象是指令控制语音合成中人物设定与台词字面情绪相反时的朗读处理,困难是合成容易跟随文字本身情绪而丢掉人物要求的反字面情绪,以往只给最终音频打整体分,无法区分是规划错误、接口丢失意图还是合成器没有发出目标声音。为每句台词配自然人物设定和冲突人物设定,并预先声明要在唤醒度或效价上向哪个方向变化,再用同一方向检查中间表示和最终波形。外部规划器先把人物设定和台词写成自由文本的朗读描述和八维情绪向量,stock路由由QwenEmotion把朗读描述再转成八维向量并经说话人匹配的原型库变成合成条件。三种对照改法分别是绕过QwenEmotion直接用规划器向量、有监督微调QwenEmotion、用文本到隐变量网络直接预测合成器自身的情绪条件偏移。与已有只评终点音频的指令跟随评测不同,该工作把预声明方向贯穿规划文本、向量和波形,可定位断点。在每种语言150题测试集上以冲突朗读相对一致朗读是否按预声明方向变化的方向正确率衡量,有监督微调相对基线从日语65%和英语74%提高到75%和84%,学习式接口在英语相对基线74%提高到89%。结论仅适用于Gemini 3.5 Flash-Lite加IndexTTS-2.5的单链路、唤醒度和效价两个轴、只在MSP-Podcast上训练的声学预测器无参考打分,学习式接口在日语总体66%未超基线且效价仅53%、跨语言和跨轴不稳定,单链路之外、多轴混合情绪及预测器跨域失准范围尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://tyc.rei-yumesaki.net/material/corpus/ — 链接可访问(HTTP 200)
第三方资源:https://amitaro.net/voice/corpus-list/ita/ — 链接可访问(HTTP 200)
第三方资源:https://voice-statistics.github.io/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
50. 稀疏 Ambisonic 录音如何实现大范围六自由度漫游

英文题目:Graph Neural Network for Wide-Area 6DoF Ambisonic Rendering
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Gioele Greco:机构信息未能在本次解析中与作者逐人可靠绑定
- Filippo Marri:机构信息未能在本次解析中与作者逐人可靠绑定
- Mirco Pezzoli:机构信息未能在本次解析中与作者逐人可靠绑定
- Fabio Antonacci:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
宽区域六自由度渲染要解决的困难是听者走到没有麦克风的位置时,如何给出可用于双耳渲染的声音描述。直接混合远处传声器阵列的波形会引入相位不一致和梳状滤波失真,论文沿用的做法是先在每个已知 Ambisonic(基于球谐函数的空间音频表示,Ambisonic)阵列处估计时频格点的能量、漫射度和到达方向,再把这些参数插值到查询位置,然后用最近录音按目标参数重渲染。原有方法的插值权重只由包围单纯形的几何重心坐标决定,看不到房间、声源和实测声场。论文用一个轻量图模型只替换权重计算,已知阵列和查询位置构成图的节点,边携带相对距离和声流方向关系,网络输出每个已知阵列的正权重,再由解析式 DirAC 层合成查询点的能量、漫射度和方向。在 25 个未见房间、未见 TIMIT 语音和随机五阵列配置共 75 组测试条件下,学习权重相对 Delaunay(Delaunay 三角剖分,Delaunay)几何基线的能量归一化均方误差平均改善最大约 3 dB,方向性能量图相似度最大提升约 0.1,而漫射度基本持平。结论适用于仿真一阶 Ambisonic 数据和参数重建阶段,尚未验证真实测量和可听改善。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
51. 不重新训练,如何让无条件音频扩散模型唱出指定旋律

英文题目:Melody Guidance for Audio Diffusion Models Without Retraining
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Cristobal Andrade:机构信息未能在本次解析中与作者逐人可靠绑定
- Sebastian J. Schlecht:机构信息未能在本次解析中与作者逐人可靠绑定
- Ben Maman:机构信息未能在本次解析中与作者逐人可靠绑定
- Meinard Müller:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要理解的对象是一段目标旋律对应的基频(Fundamental Frequency,F0)随时间变化的曲线,困难是把它变成听感真实的音频,且不重新训练无条件扩散模型。基频曲线把高维波形压缩成单条音高轨迹,大量音色和发音不同的波形可以对应同一条曲线,单独拟合曲线不能决定真实音频。第一步把目标F0曲线合成三角波作为暖启动信号,波形域直接使用,隐空间则经编码器映射为隐变量,为反向扩散提供音高接近的起点。第二步从该起点对应的中间时刻开始反向扩散,每步由模型给出对数密度对输入的梯度(score)指向真实音频方向,并经估计得到干净样本用于计算引导。第三步用可微基频估计器dSWIPE对该估计求音高并与目标曲线比较,其差异梯度与对数密度对输入的梯度相加决定下一步,暖启动减少了需纠正的音高偏差从而允许较小引导强度。与训练时加入音高或MIDI条件的方法不同,该方法冻结预训练模型,只在推理时加引导,适用于波形域和隐空间扩散模型。原文未提供可核对的关键定量结果。结论适用于单声部旋律引导,钢琴多复音先验下会出现起音和衰减不自然,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/Intelligent-Instruments-Lab/IILGuitarTimbre — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
52. 多模态长输入里找证据:检索头是否跨模态共用又如何拿来优化

评分:6.2/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jia Wang:Institute of Information Engineering, Chinese Academy of Sciences
- Yuqing Li:Institute of Information Engineering, Chinese Academy of Sciences
- Jiangnan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zheng Lin:Institute of Information Engineering, Chinese Academy of Sciences
- Mo Yu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
多模态大语言模型需要在很长的图文音视频上下文中找到回答问题所需的一小段证据,证据可能被说出来,也可能显示在画面中,模型必须把问题与正确的证据片段对应起来。论文把注意力头中从问题位置指向证据位置的注意力作为可测量的定位信号,用校准后的检索分数给全部注意力头排序,并用消融检验这些头是否真正被模型使用。研究先构造内容相同但承载模态不同的配对长视频输入,再在文本、图文和音视频任务上比较同一模型内不同模态的头排序,以及骨干模型与模态扩展后模型在同一文本任务上的头排序。随后论文固定选出的检索头,把候选页面包含的视觉 token 上的问题到候选注意力求和作为排序分,并用页面级正负例排序损失微调注意力投影。在相同预处理与候选窗口的共享配置下,相对未训练的检索头打分器,Qwen3-VL-8B在MMDocIR页面Micro Recall@1上提高6.03个百分点,布局检索也随之提升且结论在三个模型家族成立。适用范围限于已评测的问答式证据定位和文档排序任务,共享头对空间感知与数学推理的作用仍需排除任务耦合后进一步验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
53. 把听觉感知特征和对比学习拼起来的语音与通用音频质量指标

英文题目:A Robust, Explainable, and Efficient Deep Metric for Speech and General Audio Quality
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Konstantin Schmidt:机构信息未能在本次解析中与作者逐人可靠绑定
- Pablo M. Delgado:机构信息未能在本次解析中与作者逐人可靠绑定
- Andreas Brendel:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要评价的对象是经过编码等退化后的语音和通用音频,输入为原始信号与退化信号对,输出是一个与人耳感知一致的质量分数,难点在于人工主观标注稀缺、通用音频退化类型多、纯学习模型难以解释失真来源。方法把符合 ITU-R BS.1387 感知模型的客观评价方法(Perceptual Evaluation of Audio Quality,PEAQ)计算的逐帧听觉失真表示作为输入,称为前驱体,再用基于 ConvNeXt 的卷积神经网络(Convolutional Neural Network,CNN)把高维前驱体映射为嵌入向量,最后用线性头输出质量分数。训练先用 PEAQ-2f 伪标签和按编码器配置优劣排序的三元组做弱监督预训练,再在 NISQA 语料的人工评分上微调,使嵌入距离反映质量差异而非失真类型。解释时把偏离满分的损失对首层卷积做梯度加权,生成各前驱体在时间和频率上的显著图。与已有纯基础模型方法不同,该链路保留了可解释的听觉事件维度,同时把乘加量降到 0.039 G,远低于 SCOREQ 的 20 G。在包含语音和音乐的 13 个数据集上,所提方法在 NISQA-Val 等语音集和 IgorC96 等音乐集上皮尔逊相关系数达到 0.84 和 0.89,低于同场景最强的 DeePAQ 或 PEAQ-2f,但在两类内容上都保持可用。结论适用于波形基本保持对齐的编码质量监测,不适用于丢包错位和强非波形保持生成内容,原文披露了模型参数量和乘加量,未披露完整训练时长与硬件配置。
🔗 开源资源
- 第三方资源:https://www.mmsp.ece.mcgill.ca/Documents/Software/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
54. 只用目标领域文本,能否既学新词又不忘老领域
英文题目:Residual Expert Routing for Text-Only Domain Adaptation of Factorized Transducer ASR
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shashi Kumar:机构信息未能在本次解析中与作者逐人可靠绑定
- Esaú Villatoro-Tello:机构信息未能在本次解析中与作者逐人可靠绑定
- Thibault Bañeras-Roux:机构信息未能在本次解析中与作者逐人可靠绑定
- Sergio Burdisso:机构信息未能在本次解析中与作者逐人可靠绑定
- Petr Motlicek:机构信息未能在本次解析中与作者逐人可靠绑定
- Kadri Hacioglu:机构信息未能在本次解析中与作者逐人可靠绑定
- Andreas Stolcke:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
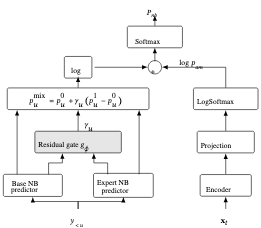
因子化换能器把空白与词汇预测分开,使非空白预测器成为只看词历史的独立语言模型,可单独用文本微调。本文输入是源域配对语音文本与目标域纯文本,输出是跨域可用的识别结果,难点是目标文本微调改善目标域却损害源域,而单一插值权重无法在同一句内的不同前缀间取舍。解码到每个词历史时先分别计算基线与文本适应专家的非空白分布,相减得到残差修正量,基线保留为输出主体。该残差作为约16k参数的两层门控网络的唯一输入,逐前缀映射为0到1之间的信任值。信任值加权残差后加回基线得到概率空间的混合分布,关门即完全回到基线,不同于固定权重对全句取同一值;该混合分布再与声学分数融合进入束搜索解码,训练交替使用源域配对数据的换能器目标加约束与目标纯文本上的专家词边际优势监督,全程只更新门控。在零售与电信两个未见域测试集上以词错率(word error rate,WER)比较,基线分别为19.89%与20.91%,路由后降至16.74%与16.21%。在源域测试集上以词错率比较,基线为12.90%,路由后为12.93%基本不变,而专家单独使用升至13.98%。结论适用于存在可分离输出端语言模型的换能器结构,分析显示门控随分歧方向改变信任而非域开关,未验证大语言模型预测器与多语料情形,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
55. CounselPlex:记住求助者根本困扰的全双工语音咨询模型
英文题目:CounselPlex: A Stressor-Aware Full-Duplex Counseling Model
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Yeonju Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- Bella Godiva:机构信息未能在本次解析中与作者逐人可靠绑定
- Yong Man Ro:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
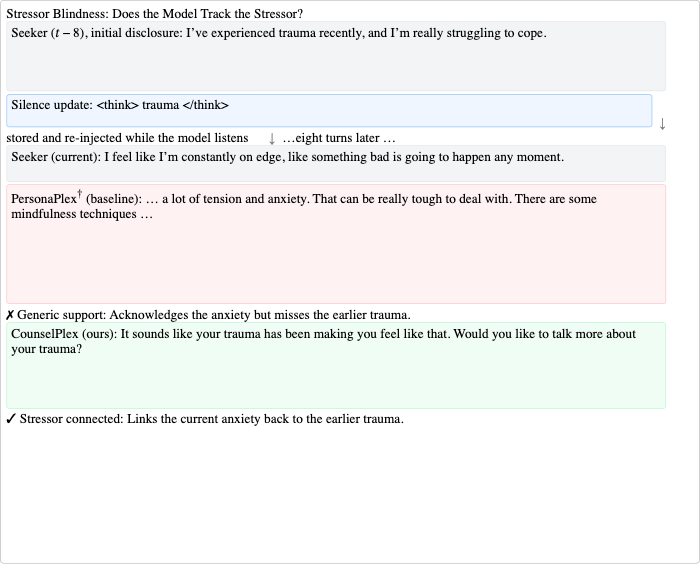
需要理解的对象是能同时听和说的全双工语音语言模型在心理咨询对话中的表现。输入是求助者连续语音流,输出是支持者语音流,难点是求助者早期披露的根本困扰在多轮后被最新话语覆盖,模型只回应表面症状。CounselPlex在求助者静默时先由对话历史判断是否生成1-7词的名词短语作为压力源状态,存为当前活动状态。在求助者下一轮开始说话时把该状态强制填入智能体文本流的<PAD>槽位,使模型在听的同时以该状态解释新话语,再生成回应。旋转位置编码偏移增强RoPE Position Shift Augmentation,RPSA在训练时随机偏移长片段的起始位置,以覆盖更高位置索引,支撑长轮次下的压力源接地。与只做领域微调的PersonaPlex†相比,CounselPlex在ESConv和ESCoT测试集上咨询质量平均分分别高0.34和0.17,代价是平滑轮替延迟为0.988秒且无检测到的附和声。该结论只在合成英语语音、单活动压力源且用文本流直接评分的条件下成立,遇重叠困扰、无明确外部压力源或自杀自伤等危机场景可能幻觉或偏置多轮回应。作者还指出30轮后性能仍下降、缺乏多种子重复与临床评估,微调成本约为45 GPU小时,故尚不能作为独立咨询系统部署。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
56. 没听完就动手:语音对话系统何时可以提前调用工具

英文题目:Heard Enough to Act: Early Tool Calling in Spoken Dialogue Systems
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yizhou Peng:机构信息未能在本次解析中与作者逐人可靠绑定
- Chen Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Donghang Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Hexin Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Eng Siong Chng:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是边听边行动的语音代理,困难在于已有语料和评测只标注完整轮次结束后该调用什么工具,从未标注在听到一半时工具与参数已经齐备的最早可行动点。论文先用类型化任务模板与确定性实体采样生成任务档案,再模拟文本对话、合成带说话人克隆的语音并强制对齐,最后由大模型提议调用事件并经三道门控校验或推迟时间戳,得到带最早可行动点监督的合成语料。接着在冻结的Qwen3-Omni-30B-A3B上加控制词元与LoRA,使模型按每0.6 s音频块输出语音活动与等待、不确定、就绪、保持四态工具状态,并在触发时输出部分转写或工具JSON。与已有边听边想、填充语、事后工具查询方法不同,该工作直接定义并校验可行动时刻,且按该时刻评分时序。采用转写触发的asr变体,在域内保留测试集上工具状态宏F1为0.48,高于其在τ2τ2音频渲染外部评测上的0.47。相对使用同一格式化器的轮次结束级联,以估计平均提前时间为指标,在域内保留测试与τ2τ2音频渲染上正确调用的平均提前估计为域内1.8-2.0 s、外部1.1 s,均早于轮次结束才触发。该结论只在单一种子、单一基座与合成分布内成立,外部新实体下转写明显恶化且误触发率高,触发精度仍是主要失败点,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
57. 复杂声场景下环境声音的两阶段分层识别:轻量时频自适应网络
英文题目:A Hierarchical Method for Environmental Sounds Recognition in Complex Acoustic Scenes
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zhouwen Li:机构信息未能从 arXiv PDF 文本可靠映射
- Haijun Lin:机构信息未能从 arXiv PDF 文本可靠映射
- Bowen Lv:机构信息未能从 arXiv PDF 文本可靠映射
- Yupeng Chen:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
城市环境声需在重叠与背景噪声下判断声源类型,输入为不同长度录音,输出为粗类别与细类别标签,难点是时间与频率轴物理含义不同且细类样本不均衡。论文先把录音重采样并提取滤波器组特征,再拼出静态特征加时间差分和频率差分的三通道时频表示送入网络。频率-时间自适应网络用两条并行非对称卷积分别沿频率和时间建模,再经1x1卷积融合与自适应融合注意力做通道重标定,随后经残差与池化输出类别分数。两级层次分类先判粗类别,再把样本送入对应粗类别下的专用子分类器做类内细分类,推理时只调用第一级加一个第二级模型。在自建集25类细分类评测中,与直接判25类的单级模型相比,两级方法整体准确率从71.32%提高到81.49%,宏平均F1分数从68.51%提高到79.58%。在自建集5粗类评测中,与3x3卷积基线相比,FTANet整体准确率从93.00%提高到95.45%,参数量仅0.2004M。该结论适用于自建集划分与UrbanSound8K十折评测,在天津实地多源共存且高度不均衡的788个有效样本条件下完整层次模型整体加权准确率为87.18%,而两级串行使推理时间从单级模型的0.2170 s增加到1.2390 s。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
58. 在连续音视频流中按时出手并持续跟进:Omni-InteractScope 评测解读

英文题目:Omni-InteractScope: Benchmarking Proactive and Agentic Interaction in Continuous Omnimodal Streams
评分:6.1/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yinsong Yan:机构信息未能在本次解析中与作者逐人可靠绑定
- Ling Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxuan Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yifan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruiyang Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Junming Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Qi Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Meng Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Minghao Han:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunfei Chu:机构信息未能在本次解析中与作者逐人可靠绑定
- Qize Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xize Cheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Jin Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jibin Wu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
持续视听流里的助手需要在事件发生时行动,在用户没有具体问题时主动提醒,并在一次回答后继续给出后续指导,难点是把流证据、用户需求和有效时间联系起来。论文构建Omni-InteractScope基准,把1479个人工标注并经交叉审核的交互组织成1790个带时间的目标,媒体有效性过滤后评测覆盖1477次交互和1788个目标,任务覆盖工具调用、事件通知、风险警告、状态累计、时间条件、手势线索、连续回应和障碍协助八组。评测先让模型只能看到因果前缀并逐秒决策,输出带媒体时间戳的回应。该回应再进入内容与时间判定,内容由温度为0的GPT-4o裁决,时间由容差窗口判定是否及时。判定结果最后进入分配计分,T1-T7将每个目标的首个回应分配计分,T8则在保持目标与回应顺序下最大化内容-时间匹配并按目标成功数除以目标总数汇总。在T1工具调用200个目标的内容与时间联合准确率上,Qwen3.5-Omni-Plus为32.0%,高于同表同指标下Gemini-3.5-Flash的29.5%,为12个模型配置中最高但仍处低位。在T8协助任务全片段因果采集与保序匹配下,Gemini-3.1-Pro免查询提醒的及时参考目标召回率为22.95%,低于同组显式问答的62.25%,对应122个提醒目标与151个问答目标。这些结果只适用于该基准的标注目标和两秒容差等评分设置,不代表闭环任务成功,原文未披露被评模型的训练、推理或部署代价。
🔗 开源资源
- 第三方资源:https://yinsongyan.github.io/Omni-InteractScope/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
59. 每个问题都要看视频吗:按查询选择模态的推理省钱法
英文题目:Efficient Omni-modal Large Language Model Inference via Per-Query Modality Selection
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shuqi Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuzhou Cao:机构信息未能在本次解析中与作者逐人可靠绑定
- Luke Ong:College of Computing and Data Science, Nanyang Technological University
📌 核心摘要
全模态大语言模型能同时读入文本、音频和视频,回答时信息更全,但每个查询都传入长视频会带来很高的输入长度、时延和计费。论文研究的对象是固定的问答模型,输入为包含文本、音频、视频的查询,输出为选项字母,难点在于视频对不同查询的价值差异很大,有时无用甚至干扰,而推理前并不知道加入视频能否答对。方法保留底层模型不动,增加一个选择器决定本次用文本加音频还是再加视频,选择器只看文本嵌入。训练时先在训练集上实测两种配置的对错和代价,按效用差距加权学习一个线性分类器,测试时只用文本得到分数并取高分配置送入大模型。相对固定全模态和先用便宜配置再升级的级联做法,该做法一次选定配置,避免重复调用大模型。在WorldSense上以Qwen2.5-Omni为固定底层模型、按平均每查询输入token计,代价敏感选择器达到固定全模态配置48.00%准确率时用量为16877,相比固定全模态配置的41050减少58.89%。结论适用于视频代价远高于文本加音频的问答设置,文本信息不足或表示变化时的效果尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
60. MI-MIDI 2:文本生成 MIDI 中稀疏自编码器特征能否从观察走向控制

英文题目:MI-MIDI 2: From Observation to Control with Sparse Autoencoders in Text-to-MIDI Generation
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jakub Poćwiardowski:Institute of Computer Science;Warsaw University of Technology
- Mateusz Modrzejewski:Warsaw, Poland
📌 核心摘要
文本到符号音乐生成以文字提示为输入,以多轨MIDI事件序列为输出,难点在于无监督发现的内部特征是否真能改变乐谱。方法先在text2midi和MIDI-LLM解码器残差流状态上训练TopK稀疏自编码器,将其分解为稀疏字典方向,每个特征以模型、层和编号标识,其字典方向可直接用于回加干预。三类观察证据并行表征候选并各配对照:特征激活与MusPy音乐指标的相关经音符数残差化校正,发现、验证与测试片段需同号复现,大语言模型看激活样例写出描述并用打乱对照校准,激活片段共享的通用MIDI乐器编号提供乐器假设,三类输出共同确定干预目标与预测方向。干预把候选方向加回残差流,在生成MIDI中直接对比未修改生成与匹配随机方向,先在筛选排序估计家族效应,再用新提示确认单个特征。合成器主音特征在20个新提示的预注册确认中,以MIDI程序号存在为指标,特征方向比匹配随机方向产生更多程序81阳性输出,配对检验p=0.000122,方向为特征方向高于随机方向。经密度校正筛选的42个特征在8个共享提示、P90干预强度下,以MusPy目标指标定向差为指标,特征方向比随机方向平均向预测方向高0.18个基线标准差,而原始相关筛选的24个特征同设置下平均为负向、低于随机方向。结论只适用于显式记谱、可精确测量的符号属性,听感、跨层多点干预和必要性尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://jpocwiar.github.io/MI-MIDIv2-Demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
61. 从学习者英语中判断母语:声音线索与文本线索如何分工

英文题目:Acoustic and Lexical Signals for Native Language Identification of Language Learners
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ahmet Yavuz Uluslu:ALTA Institute, Department of Engineering, University of Cambridge;Department of Computational Linguistics, University of Zurich
- Mengjie Qian:ALTA Institute, Department of Engineering, University of Cambridge
- Kate Knill:ALTA Institute, Department of Engineering, University of Cambridge
- Mark Gales:ALTA Institute, Department of Engineering, University of Cambridge
📌 核心摘要
母语识别要从第二语言英语产出推断说话人的第一语言,难点在于口音线索与词汇语法线索交织,且随能力等级和可获得语料长度变化,难以判断哪种证据更可靠。论文在BULATS-L1上对比同一提交的两种证据,该评测集在阿拉伯语等六种第一语言与A1至C1五个能力等级上均衡分布,转写由适配学习者语音的自动语音识别模型生成。语音通道冻结WavLM-Large编码器并学习层加权与注意力池化后的分类头,将每份提交切分为30秒片段并平均各片段概率得到提交级分布。转写通道屏蔽命名实体与非英语词后用零样本GPT-4o做六选一判别,对三种候选顺序的分布取平均得到提交级分布,再与语音分布做线性加权融合。在BULATS-L1平衡评测集上,融合在权重0.60处达到94.81%准确率,高于音频单独的85.56%与转写单独的82.59%,表明两类线索互补。能力分段显示音频在A1段明显占优而转写在A2至C1段占优,截短转写会大幅拉低文本通道而音频对输入长度相对不敏感。该结论仅适用于六类第一语言、A1至C1均衡提交级评测且转写来自特定自动语音识别的情形,未验证C2等级、其他母语组合及人工转写下的稳定性,低能力段文本过短时文本通道可能失效。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/microsoft/wavlm-large — 链接可访问(HTTP 200)
第三方资源:https://en.wikipedia.org/wiki/Business_Language_Testing_Service — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
62. CASE:用成对技能为冻结多模态大模型补上情绪边界

英文题目:CASE: Confusion-Aware Skill Evolution for Frozen Multimodal Emotion Models
评分:6.0/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Siyu Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zeyu Liang:机构信息未能在本次解析中与作者逐人可靠绑定
- Linghao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiyun Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi Yao:机构信息未能在本次解析中与作者逐人可靠绑定
- Ling Lo:机构信息未能在本次解析中与作者逐人可靠绑定
- Hongxia Xie:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
多模态情绪识别的输入是包含音频轨、视频和可选字幕的片段,输出是预定情绪标签,难点在于担心与悲伤、愤怒与悲伤等语义相邻情绪的多模态线索高度重叠,全局分类容易在相邻类别之间反复出错。CASE 先用诊断提示让冻结模型给出两个候选情绪、是否需要介入的路由判断和诊断证据,只在判断为模糊且技能库覆盖该情绪对时进行第二轮成对推理。推理轨迹在揭晓真值后被归因,可恢复的失败与成功锚点被用来生成文本补丁,补丁只在固定的成对验证集上严格改善且不坍缩到单一标签时才入库,未覆盖的边界则在反复出现后经独立门控扩张。与全局参数适应已有方法的差异在于知识存在于外部稀疏技能库,模型参数保持冻结,技能可在不同主干之间复用。在 CA-MER 上,以 Qwen3-VL-8B 为推理主干、GPT-4o 为编辑器时,CASE-Full 将三子集平均准确率从 46.80% 提高到 59.13%,其中音频冲突子集提高 18.00 个百分点。结论适用于已观测到的混淆边界,未覆盖边界仍回退到首轮预测,开放词表和冲突线索下的泛化只在三个评测集上得到验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
63. EmoNet:用轻量卷积加时序注意力做七类语音情感识别
英文题目:EmoNet: A Lightweight Attention-Based CNN for Speech Emotion Recognition
评分:6.0/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Muhammad Moiz Khalid:机构信息未能在本次解析中与作者逐人可靠绑定
- Abdur Rehman Tariq:机构信息未能在本次解析中与作者逐人可靠绑定
- Muhammad Okasha Yamin:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
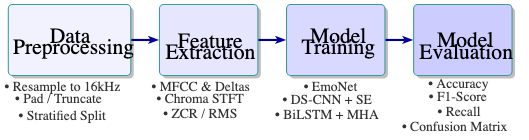
语音情感识别要从一段话中判断说话人的情绪类别,输入是波形,输出是愤怒、厌恶、恐惧、高兴、中性、悲伤、惊讶七类之一。困难在于说话人音色、口音、录音条件差异大,而已有大模型参数多,不便部署。论文把每段音频统一为 4 秒、16000 Hz 采样,先提取每帧 134 通道声学特征,再送入四块卷积编码器学习谱特征。编码器输出交给双向长短期记忆网络学习情绪随时间的变化,再由多头注意力池化对时间帧加权求和,得到整句向量后送分类头输出七类概率。与依赖 Wav2Vec 2.0 等大骨干的方法不同,该模型全部使用轻量卷积加循环与注意力结构,不依赖大规模预训练语音骨干。在 TESS、RAVDESS、SAVEE 合并的 4720 样本、708 样本测试集上,相对复现基线,准确率从 92.66% 提高到 96.75%,参数量从 139.24M 降到 4.11M。结论限于表演式、录音室或实验室录音的英文情感语料,未验证自然对话和噪声场景,原文未披露训练时长、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
64. 只渲染你点名的那个声音:AV-QTSS 如何从单声道混合与全景视频生成目标 FOA

英文题目:AV-QTSS: Class-Query Target Sound Spatialization in Multi-Source 360$^\circ$ Videos
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Qingyu Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Peng Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenwu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Philip J. B. Jackson:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
从单声道混合声与三百六十度视频中取出指定类别声源并生成其空间声场,困难在于混合声没有方向线索而画面中可能同时有多个发声物体,需要同时解决取出什么声音和对应画面中哪个位置。输入是五秒单声道混合声、五帧全景视频和十三类DCASE本体中的类别查询,输出是该查询声源单独的一阶Ambisonics四通道信号,含全向通道与三个方向通道。查询条件分离器先从混合声中估计目标的全向通道,查询条件稠密绑定定位器再结合分离音频、类别嵌入与视觉对应关系,输出每帧在球面网格上的概率图。地图条件FOA渲染器以该概率图为可微条件,由目标全向通道预测方向通道,定位与渲染联合优化,使FOA损失回传塑造定位图。与整场景空间化或只分离不定位的方法不同,该工作把分离后音频、类别与视觉绑定到同一张概率图,保证提取内容、绑定对象与渲染方向一致。在AV-QTSS-Syn合成测试集上,以空间指标整体角度误差Δang比较,完整系统为23.3°,低于方向独占基线的24.4°和解析编码基线的25.5°。结论适用于查询类别在片段内活跃且不同声源类别不同的情况,同类多实例、语义相近类别仍易混淆,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://avqtss.github.io/demos/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
65. 4DMemory:把上百小时视频变成可复用的长期时空记忆再推理

英文题目:4DMemory: Benchmarking Long-Horizon Spatiotemporal Memory with Harness-Augmented Agents
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yanhao Jia:Nanyang Technological University
- Yi Zhu:Token Foundry, Alibaba
- Yiran Zhong:Token Foundry, Alibaba
- Weigao Sun:Token Foundry, Alibaba
- Feida Zhu:Token Foundry, Alibaba
- Pengkun Jiao:Token Foundry, Alibaba
- Sihan Yang:The Chinese University of Hong Kong
- Ming Ma:Institute of Neuroscience, Chinese Academy of Sciences;University of Chinese Academy of Sciences
- Steven Hoi:Token Foundry, Alibaba
- Erik Cambria:Nanyang Technological University
📌 核心摘要
任务要求在长达数十小时连续视频与多季电视剧上,把分散在远距离片段中的视觉、文本与时空证据联系起来作答,并满足取证与按序调用要求。难点在于原生上下文装不下密集视频证据,稀疏采样易丢细节,分散的计数、排序与状态变化需保留细粒度记忆。观察者先把长视频切成带时间戳和来源编号的结构化记录,存入与问题无关的持久记忆,形成可复用的证据库。提问时词频检索从该证据库选出12个种子单元并各扩一个同源时序邻居打包为检索文本,分数过低则改供均匀时序单元,推理者再对该检索文本发起追问并调用视觉定位与文本统计等专用工具补证据,最终只凭检索文本与工具结果作答而不读全量原始视频。与以往单视频一至两小时评测的时间跨度相比,本基准在同一时间跨度量表下单个问题最高绑定97.98小时,方向为高于既往评测,且评测以工具调用、按序执行与答对联合成功率为指标。在5214题三评判协议下独立视频时空任务联合准确率中,Muse-Spark-1.1为74.92%,Grok-4.6为74.97%,后者略高于前者。同一三评判协议下电视剧时空任务联合准确率中,GPT-5.6 Sol剧集范围为87.86%,季节范围降至38.98%,完整系列范围再降至12.50%,随范围扩大呈下降方向。结论仅适用于所用推理者加观察者加工具系统整体,不证明相对裸模型因果提升,且原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
66. 只用单麦克风加相机定位发声手术器械

英文题目:Sounding Surgical Instrument Localisation through Audio-Visual Correspondence
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Dominic Behling:Research in Orthopedic Computer Science (ROCS), Balgrist University Hospital, University of Zurich, Zurich, Switzerland;Eberhard Karls Universität Tübingen, Germany
- Jonas Hein:Research in Orthopedic Computer Science (ROCS), Balgrist University Hospital, University of Zurich, Zurich, Switzerland
- Matthias Seibold:Research in Orthopedic Computer Science (ROCS), Balgrist University Hospital, University of Zurich, Zurich, Switzerland
📌 核心摘要
读者需要理解的对象是手术视野中哪把器械正在发声,困难在于器械经常可见但静默,画面中可能同时出现多把外观相近的工具,而人工逐像素标注位置成本很高。模型以单个视频帧及其居中截取的3 s单通道音频为输入,先将帧缩放至448×448 px、音频重采样至16 kHz并转为对数功率谱,再分别经视觉与音频编码器得到16×16视觉网格嵌入和音频嵌入。接着计算音频嵌入与每个视觉网格单元的余弦相似得到覆盖发声工具的相似图热图,训练以该热图为对象用对比目标按器械类别划分正样本学习对应,并以静默项压平静默与背景噪声的热图、以双器械合成项训练在两把可见工具间按声音二选一,推理时将热图上采样并按热图强度判断活动、阈值化取最大连通域框为定位结果。相对依赖麦克风阵列和声束成形的已有手术声源定位方法,该工作把硬件降为普通相机加单麦克风,把检测与定位放在一次前向推理中联合完成,并定位整把器械而非物理发声点。在853帧的声学相机语料定位测试上,本文方法总体交并比(IoU)为0.36±0.03,高于SLAVC基线的0.03。在同一853帧声学相机语料定位测试上,热图最大值到真值框中心的中位距离为12±2 px,低于该基线的69 px。该结论适用于模拟骨操作和受限视角,凿子、手部响应和遮挡等情况仍会失效。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
67. 带噪目标训练结合漂移:用不成对干净语音压住残留噪声
英文题目:Noisy Target Training Meets Drifting for Weakly-Supervised Speech Enhancement
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yoshiki Masuyama:机构信息未能在本次解析中与作者逐人可靠绑定
- Dominik Klement:机构信息未能在本次解析中与作者逐人可靠绑定
- Christoph Boeddeker:机构信息未能在本次解析中与作者逐人可靠绑定
- Julius Richter:机构信息未能在本次解析中与作者逐人可靠绑定
- Kohei Saijo:机构信息未能在本次解析中与作者逐人可靠绑定
- Gordon Wichern:机构信息未能在本次解析中与作者逐人可靠绑定
- Takahiro Edo:机构信息未能在本次解析中与作者逐人可靠绑定
- Jonathan Le Roux:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
任务输入是一段干净语音与背景噪声相加得到的观测语音,要求输出更干净的语音,难点是真实环境没有可配对的干净语音作监督,而用合成配对训练会与真实声学条件失配。方法先用噪声目标训练(Noisy Target Training,NyTT)学习去噪,把观测信号再加额外噪声作为输入,以观测信号本身或教师模型输出为目标,迫使模型抑制原有噪声与额外噪声。再用Sinkhorn漂移损失在语音质量评估模型的隐空间计算漂移方向,吸引项把增强特征拉向不配对干净语音特征,排斥项使其远离当前增强分布。两者相加后前者保持内容忠实,后者抑制残留噪声并提升自然度;与只用均值教师或只用不配对漂移的方法不同,该组合同时保留波形约束和分布约束。在 VoiceBank-DEMAND 上,NyTT 加均值教师结合不配对漂移相对仅用 NyTT 加均值教师,将 UTMOS 从 3.81 提升到 3.93,SI-SDR 保持 18.58 dB 不变。在 CHiME-3 真实录音的领域自适应中,该方法相对仅用 NyTT 加均值教师,将 DNSMOS P.808 从 3.42 提升到 3.59。该结论适用于以感知质量指标衡量的受控合成集与上述录音自适应设置,在 CHiME-3 上其词错误率仍高于未处理含噪语音,对含增强伪影的识别鲁棒性尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
68. 预训练音频谱图 Transformer 遇到不同 STFT 前端怎么办
英文题目:STFT Frontend Mismatch in Pretrained Audio Spectrogram Transformers: Analysis and Adaptation
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Julia Wilkins:机构信息未能从 arXiv PDF 文本可靠映射
- Wei-Ching Lin:机构信息未能从 arXiv PDF 文本可靠映射
- Abinaya Kumar:机构信息未能从 arXiv PDF 文本可靠映射
- Shabnam Ghaffarzadegan:机构信息未能从 arXiv PDF 文本可靠映射
- Juan Pablo Bellow:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
读者需要理解的对象是已经用固定时频分辨率训练好的声音分类主干,困难是下游任务想要更精细时间精度或更省算力的粗分辨率时,输入语谱图的帧数和纹理会系统性偏离预训练假设。论文把这种偏离称为STFT前端失配,输入是不同窗口和跳长下算出的对数Mel语谱图,输出是多标签声音事件预测,难点是裁剪或插值只能对齐长度,不能恢复模型依赖的时频结构。方法沿单样本数据流衔接:先按采样配置算语谱图并切块嵌入,位置编码经插值对齐长度后与块嵌入相加送入冻结的主干编码器。随后新增条件分支把窗口和跳长的对数值映射为缩放和平移系数,再作用到编码器各层前馈层之前并在层间共享参数,从而按当前分辨率调整同一批特征。与可变块大小或可变长度序列打包的已有工作相比,该方法不改主干结构,也不同时微调大量参数。在AudioSet评估集窗口为1600采样点的未见配置下,编码器条件版本按平均精度指标测得中位值相对零样本基线从0.166提高到0.313。在AudioSet评估集原始前端配置下,编码器条件版本按平均精度指标测得平均精度为0.443,比无失配上限0.456低0.013。结论适用于AudioSet域内只改变窗口和跳长的分类任务,在窗口为1600采样点的配置下仅用100个额外样本训练的编码器条件版本按平均精度指标比较零样本基线相对提高33.7%,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://ojs.aaai.org/index.php/AAAI/article/view/29294 — 链接可访问(HTTP 200)
第三方资源:https://arxiv.org/abs/2206.03835 — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
69. 细粒度信用分配何时有效、何时有害:电影预告片剪辑中的多模态智能体强化学习

评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Lei Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Zongheng Cao:University of Pennsylvania Philo Labs
- Xinyu Hu:University of Pennsylvania Philo Labs
📌 核心摘要
电影预告片编辑要求智能体在多轮交互中查看镜头、试听音频并调用媒体工具,最终提交可播放的剪辑成品,结果好坏到成品完成后才能判定,难以分清中间哪一步起作用。论文把一部电影与其预告片对齐切分为内容选择、叙事排序、粗剪和精剪四类任务,输入为候选镜头或参考顺序或参考粗剪加音频素材,输出为所选集合、顺序、剪辑点或混音加转场加渲染视频。智能体以装有简报、清单和媒体的新工作区为输入,调用shell和八个媒体工具检查画面、探测音频并校验成品,输出剪辑成品及其多轮轨迹。大模型评判员以上述轨迹为输入逐轮对工具使用和视觉检查打分,输出过程奖励,再将其与成品结果奖励加权相加送入组相对策略优化训练,其中衰减权重版本在更新20前取0.5、更新20-30衰至零后只留结果奖励,另以冻结教师拟合学生前缀的在线自蒸馏作对照。在81个留出验证任务、每任务重复4次取均值的评测下,衰减权重方法平均任务得分avg@4为0.447,高于只用结果奖励的0.413。在精剪上以平均任务得分avg@4比较,衰减权重方法为0.293,高于只用结果奖励的0.201,论文按未舍入均值计算为45.4%相对增益。该结论适用于精剪这类混合正负轮次较多、轨迹更长的任务,在三类较短任务上只用结果奖励仍具竞争力,衰减权重相对增益至多10.4%,固定过程奖励还会把截断率推高到44.1%。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/leizhao7/video-editing-credit-assignment — 链接不可用(HTTP 404)
第三方资源:https://huggingface.co/collections/leizhao7/ — 暂时无法访问
第三方资源:https://leizhao7.github.io/videoedit/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
70. 先保住旧语言再学新语言:面向多语言语音大模型的连接器扩展与合并

英文题目:Preserve to Expand: Source-Aware Adaptation and Model Merging for Multilingual LLM-Based ASR
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.6/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuchen Zhang:Institute for Analytics and Data Science, University of Essex;School of Computer Science and Electronic Engineering, University of Essex
- Haralambos Mouratidis:Institute for Analytics and Data Science, University of Essex;School of Computer Science and Electronic Engineering, University of Essex
- Ravi Shekhar:Institute for Analytics and Data Science, University of Essex;School of Computer Science and Electronic Engineering, University of Essex
📌 核心摘要
多语言自动语音识别在加入新语言时,需要在不回放源语言训练数据、不对源语言做梯度更新的条件下,同时学会目标语言并保留原有源语言能力。论文研究对象是连接器式语音大语言模型,输入语音经冻结语音编码器和降采样后,由可训练连接器映射到冻结大语言模型,由解码器生成转写,全部适配只改连接器参数。处理流程是先在目标语言上微调得到目标更新,再用源语言校准集估计重要连接器列并冻结,最后对更新做修剪与合并后加回基座。相比已有直接微调与标准 TIES 合并,该工作引入了基于 Wanda 激活的源语言屏蔽更新与合并结合,并在多目标上对比了联合合并与递归适配。日耳曼语基座上 SSU-Wanda+TIES 把源语言词错率增量控制在 0.24 个百分点,目标词错率从 102.70% 降到 35.82%。结论适用于 Common Voice 上三个语系基座与六个目标语言的受控扩展,递归顺序敏感且斯拉夫语等多目标目标学习仍不充分。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
71. 电动车内噪声四分量分离:混合 Transformer 与合成训练怎么做

评分:5.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Philipp Diel:Chair of Thermodynamics of Mobile Energy Conversion Systems, RWTH Aachen University, Aachen, Germany
- Zhuo Cao:IAS-8, Forschungszentrum Jülich, Jülich, Germany
- Arne Hildenbrand:Chair of Vibroacoustics of Vehicles and Machines, Technical University of Munich, Garching, Germany
- Marco Günther:Chair of Thermodynamics of Mobile Energy Conversion Systems, RWTH Aachen University, Aachen, Germany
- Stefan Pischinger:Chair of Thermodynamics of Mobile Energy Conversion Systems, RWTH Aachen University, Aachen, Germany
- Hanno Scharr:IAS-8, Forschungszentrum Jülich, Jülich, Germany
- Steffen Marburg:Chair of Vibroacoustics of Vehicles and Machines, Technical University of Munich, Garching, Germany
📌 核心摘要
读者需要理解的对象是行驶中驾驶员双耳处录到的混合车内噪声,任务是将其分解为风噪、胎噪、动力总成与辅助驱动四路双耳估计波形,困难是四源始终同时存在并受共同行驶状态驱动,宽带强掩蔽下动力总成阶次线与辅助驱动弱音调成分频谱重叠。方法先把混合波形送入波形与语谱图并行的双U-Net,在瓶颈用跨域Transformer融合两域表示,再经对称解码与逆短时傅里叶变换求和输出各源波形。接着行驶工况向量经特征线性调制按通道缩放与平移各层激活,为分离提供转速决定的频率与幅值先验,其输出作为受调制的编码特征进入后续解码。然后模型按源加权的时域平均绝对误差加语谱图辅助损失训练,只预测幅度并用维纳滤波恢复复数谱以保证混合一致性。与已有音乐分离和图像直线检测方法的区别是模型可恢复混合中不可见的被掩蔽低频阶次,并从数据分布学习宽带分解而非使用固定频率比。在语谱图分支瓶颈处比较窗长4096与8192两种设置,有效频率分辨率指标分别为250 Hz与125 Hz,后者低于前者,减小跳长能提高时间分辨率并改善工况对齐但增加计算代价。结论适用范围是合成单车与多车虚拟车,实测两辆量产车出现阶次错分与高车速幻觉,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
72. 小预算稀疏混合专家:HobbyLM 如何搭架构、训模型再做多模态与生图
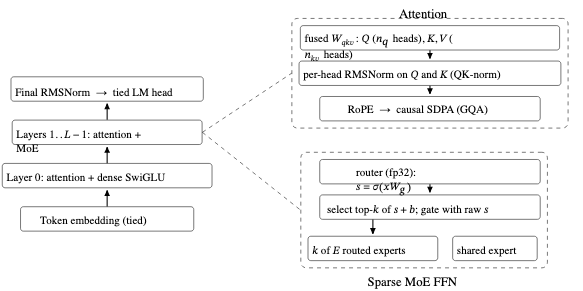
英文题目:HobbyLM: A Sparse Mixture-of-Experts Model Family on a Hobby Budget
评分:5.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Harish Santhanalakshmi Ganesan:机构信息未能在本次解析中与作者逐人可靠绑定
- Hariharan M. S.:机构信息未能在本次解析中与作者逐人可靠绑定
- Prabhurajhan R:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是在数百到一千余美元租用算力下从随机初始化训练亚十亿参数稀疏混合专家语言模型,难点是路由不稳定、负载不均、长上下文与多模态扩展容易发散,而已有开源小模型依赖数万亿 token 蒸馏或大规模数据。论文先在 130M 规模做单变量消融确定解码器、路由和优化器组合,再训练 500M 基座并扩展到 8k 上下文,随后把同一基座转成聊天、掩码扩散、视觉语音多模态、函数调用与无障碍树计算机智能体,另由两位作者原样采用架构独立训练 1B 模型。与已有细粒度专家和辅助损失无关均衡方法的区别是把逐头查询键归一化、S 型路由加选择偏置、共享专家与 Muon 加自适应矩估计权重衰减优化器分工组合起来,并在小参数量下验证有效性。HobbyLM-1B 在七个零样本任务平均上达到 47.54,评价采用 lm-eval 0.4.13、fp32 与原文相同的准确率口径。结论只适用于 10B 到 100B token 量级和单种子训练,视觉严格匹配接近语言先验基线,并行调用基本失效,长目标检索未经证实。500M 主训练约 104 个 GPU 小时,1B 主训练加退火约 304 个 GPU 小时并计费约 1167 美元,图像全部实验约 445 美元,其中 512 像素 100M 图像浏览量运行约 217 美元。
🔗 开源资源
第三方资源:https://github.com/harishsg993010/HobbyLM — 链接可访问(HTTP 200)
第三方资源:https://github.com/fuellabs-ai/hobbylm-1b — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/rootxhacker — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/harims95 — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/spaces/rootxhacker/HobbyLM-Playground — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
73. 融合顺序为什么会影响跨模态视频检索

评分:5.7/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Haoxiang Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Bin Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yaofei Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiao Lan:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunfeng Diao:机构信息未能在本次解析中与作者逐人可靠绑定
- Xu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
跨模态视频检索需要把视频帧、伴音和语音转写合并为一个候选表示,再与查询匹配,困难在于三路缺失比例不同且查询只与其中一路语义接近,融合顺序会改变后一阶段要学习的对应关系。统一渐进表示与顺序分析框架(Unified Progressive Representation Learning for Order Analysis,UniPRO)先准备并对齐三路特征,再用可配置门控融合阶段按指定顺序依次更新表示,查询侧独立编码后取全局与局部余弦相似度均值作为匹配分。相对已有工作,UniPRO固定编码器与训练设置,只改变融合组织与模态顺序,从而分离顺序本身的影响。在采用ViT-B/32的MSR-VTT-9k文本到视频检索上,UniPRO的R@1为53.9,相对于SAVE的51.3高2.6个百分点。在CM-Pool完整输入的文本检索上,VAS的T2V R@1为53.5,高于VSA的52.7,表明缺失不能完全解释顺序差异;在MSR-Complete完整输入的音频检索上,音频居末的VSA的A2V R@1为56.6,高于VAS的55.2,但该优势未延伸到每个召回截断。在训练与测试同步缺失语音的MSR-SDrop音频检索上,语音缺失率升高使VSA与VAS的最优顺序在A2V R@1和V2A SumR上均发生反转,且交叉点随检索方向及采用R@1还是SumR而变化。上述顺序结论仅在所测逐个融合与堆叠组织、VAS与VSA对比及匹配训练设置下成立,语音完全缺失时两顺序分数接近且各缺失率下每种顺序单次运行,文本与音频实验使用不同数据构造、图像任务为源帧匹配,故跨查询模态泛化与外部数据集适用性尚未验证。基于视觉居末预测的VASV顺序在采用ViT-B/32的MSR-Frame图像到视频检索上I2V R@1为97.9,高于CLIP4Clip的92.4;原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
74. 配对成功不等于疾病迁移:临床音频元数据对齐的配对控制审计

英文题目:Correspondence Is Not Transfer: A Pairing-Controlled Audit of Clinical Audio-Metadata Alignment
评分:5.7/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Liu He:机构信息未能在本次解析中与作者逐人可靠绑定
- Xi Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiahong Yuan:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuanchao Li:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是临床音频里用参与者元数据做监督的学习方式,困难是同一份元数据同时装着症状、年龄、记录性别、缺失情况和招募来源,模型只要能认出被分配的文本目标就能降低对比损失。处理过程是固定音频编码和文本编码,只训练音频侧的投影头,再冻结端点分别做画像对应、可解码性和匹配后疾病预测三组读出,前一步的对齐端点直接作为后一步三组读出的共同输入。配对受控迁移审计设置了正确配对、病标签内打乱、无限制全局打乱、病标签和记录性别都保留的打乱四条轨迹,除元数据供体外共享样本、初始化、优化和训练长度。正确配对相对病标签内打乱能提高画像检索和性别探针表现,说明干预生效,而性别探针的大差异在换成性别保留对照后大幅缩小,检索仍留有小残差。关键定量结果是正确配对相对病标签和记录性别保留打乱对照,在锁定外部面板12个数据集与骨干组合的匹配目标匹配疾病AUROC上5个点估计为正即高于对照、7个为负即低于对照,且没有区间排除零。结论适用范围限于源数据选择并校准读出后再在匹配目标上评测,不涉及跨数据集部署同一模型,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
75. MusicTwins:让音频语言模型按特定人的方式听音乐并回话

英文题目:MusicTwins: Training Audio-Language Models to Listen like Their Persona
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.6/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Milan Liessens Dujardin:机构信息未能在本次解析中与作者逐人可靠绑定
- Kevin Miao:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
该文要让模型像特定人物一样对文字提问和音乐录音给出第一人称书面反应,输入是人物证据加当前问题与音频,输出需保持该人物背景、观点、人格、写作风格与音乐倾向,难点是音乐主观感受没有唯一答案且须区分记忆事实与推断。系统从作者Reddit写作抽取证据并链接古典录音,把通用人物小结放入系统提示,把针对具体作品、录音与聆听情境的问答存入可按文本和音频检索的个人记忆。共享的Audio Flamingo Next冻结音频编码器,只训练语言主干低秩适配器,负责听音频、判断检索记忆相关性并引用证据后按人物口吻作答。训练按证据位置分为记忆召回、提示内插、外推与拒答四类目标,先监督微调学会用上下文与音频,再补外推扩大覆盖,最后用组相对策略优化精化引用与拒答。在十个留出人物600个音乐问答的音乐反应评测中,MusicTwins相对Audio Flamingo Next基线在Judge similarity/accuracy均值上从45.5升至56.7,提高11.2分。在背景、观点、人格、风格与音乐反应的五维评测中,MusicTwins相对同一基线在Five-component mean上从73.8升至79.4,提高5.7分,而1713题通用音乐理解准确率从68.0变为69.2基本持平。结论只适用于古典录音、30秒以内音频与Reddit推断的人物证据,时间变化、非古典风格与真实交互效果尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
76. 用可测量的歌唱特征做可解释的歌唱情绪识别

英文题目:Interpretable Singing Emotion Recognition Using Acoustic and Vocal Technique Features
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Fotini Kiriakopoulou:机构信息未能在本次解析中与作者逐人可靠绑定
- Vassilis Lyberatos:机构信息未能在本次解析中与作者逐人可靠绑定
- Spyridon Kantarelis:机构信息未能在本次解析中与作者逐人可靠绑定
- Athanasios Voulodimos:机构信息未能在本次解析中与作者逐人可靠绑定
- Giorgos Stamou:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
歌唱情绪识别(Singing Emotion Recognition,SiER)要从演唱音频判断情绪类别,难点是歌唱与说话在音高范围、持续谐波和共鸣上不同,通用语音特征难以说明颤音或共鸣操作等表达手段。论文先从重采样音频提取韵律、频谱、语音发音和演唱技法四类共 130 个标量特征,其中缺失的音素边界和技法概率分别由对齐工具和双输入卷积网络估计。接着用嵌套的留一歌手法筛选跨歌手稳定的少量特征并做去相关,再训练浅层分类器输出情绪。解释阶段用 SHAP(Shapley Additive Explanations,一种按贡献分解预测的解释方法)定位重要特征,并用 Grad-CAM(Gradient-weighted Class Activation Mapping,一种按梯度显示网络关注时频区域的方法)检查技法提取器是否关注到合理的调制结构。与语音优化的 eGeMAPS 特征集相比,歌唱优化集在 RAVDESS 留一歌手评测下非加权平均召回率(Unweighted Average Recall,UAR,越高越好)为 79.6%,高于对照的 76.2%,且跨歌手标准差更低。结论只适用于所用的表演情绪和流行与美声等有限风格,技法与情绪的关系是统计关联,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
77. 在枪虾噪声中检测海豚宽带瞬态叫声:TRIDENT 如何保留波形结构

英文题目:Dolphin broadband transient vocalization detection in impulsive ambient noise
评分:5.5/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Hari Vishnu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jin Xinhui:机构信息未能在本次解析中与作者逐人可靠绑定
- Mandar Chitre:机构信息未能在本次解析中与作者逐人可靠绑定
- Simen Hexeberg:机构信息未能在本次解析中与作者逐人可靠绑定
- Koay Teong Beng:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
新加坡周边热带水域的长期被动声学监测需要从枪虾主导的脉冲噪声中找出海豚的宽带瞬态发声,输入是单水听器录音,输出是每个0.5 s窗是否含有喀哒声脉冲串、嗡鸣或burst脉冲,难点是目标与干扰同为短时宽带脉冲,频谱能量线索不可分。TRIDENT(瞬态脉冲噪声检测网络,TRansients in Impulsive-noise DEtection NeTwork)先把高信噪比叫声与实测噪声按峰值信噪比合成固定窗混合样本,以扩充多样性并模拟真实挑战条件。混合样本经中值绝对偏差归一化使正负类能量分布重叠,再送入直接处理原始波形的一维卷积网络(one-dimensional convolutional neural network,1D CNN)学习局部峰值与脉冲间隔组织,训练中加入船噪声等困难负样本与幅度缩放增强以抑制能量捷径。同一联合二分类器同时处理三类叫声,避免为每类维护专用模型,输出即为各窗的含叫声概率。与只用能量或熵的传统检测器相比,该路线保留了非线性去噪会抹掉的瞬态峰值。在包含三类目标与困难负样本的混合测试集上,联合模型在误警率为1%时的检出率(probability of detection at probability of false alarm of 1%,PD@PFA=1%)为0.844,高于Surfperch嵌入加逻辑回归同指标的0.753和加多层感知机同指标的0.782,受试者工作特征曲线下面积(area under the curve,AUC)为0.959。结论适用于新加坡十个岛礁站点共54.2记录月的白天集群活动分析,对低信噪比远距离信号和未见物种仍需验证,原文披露在Jetson Xavier NX上每0.5 s窗平均耗时8.4 ms,原文未披露完整训练时长与算力成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
78. 多机位音乐会视频如何按乐器活动与节拍自动选景
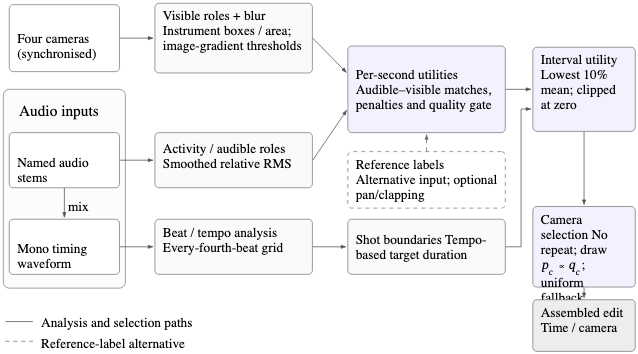
英文题目:Multimodal Concert Video Editing: System Design and Exploratory Evaluation
评分:5.3/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:后 50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Lennart Schiweck:机构信息未能在本次解析中与作者逐人可靠绑定
- Adrian Kempf:机构信息未能在本次解析中与作者逐人可靠绑定
- Michelle Retig:机构信息未能在本次解析中与作者逐人可靠绑定
- Moritz Feucht:机构信息未能在本次解析中与作者逐人可靠绑定
- Tim Mangliers:机构信息未能在本次解析中与作者逐人可靠绑定
- Benjamin Himpel:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一场多机位爵士音乐会录像,困难在于何时切换与选择哪个机位要同时照顾音乐中的活跃乐器、画面是否可用以及切换节奏是否合适,处理过程是把命名分轨音频与四路视频变成每秒每个机位的可用分,再按候选镜头区间汇总并抽取机位。命名分轨(named stem,指按乐器分开录制的独立音轨)先算相对能量得到可听主要与次要角色,单声道混音估计节拍(beat,指音乐中周期性脉冲位置)与速度并定出每四拍一切的候选边界。预训练检测器给出可见乐器框并按面积占比划分主次,图像梯度标准差划分模糊等级,两类角色按匹配加分与缺失惩罚合成每秒效用。区间效用取最低 \(10\%\) 均值并按比例抽样且不允许紧邻重复,输出带时间与机位号的成片。三位专家对同一录像四个完整成片的总体质量评分Ovr(\(1\) 为很好,\(5\) 为差)显示,预测分数版本V3均值 \(4.00\) 高于随机版本V2均值 \(2.67\)且数值越大越差,在切点基本相同的条件下分数驱动选择没有总体优势。结论只适用于这场音乐会与这组机位,反应镜头、合适瞬间与序列结构的建模仍待验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://drive.google.com/drive/folders/1qKtlRt0Fae0aA4U3sTLfgcf3DPBDQV6c — 链接可访问(HTTP 200)
第三方资源:https://drive.google.com/file/d/1vLJxgV4vO4KYswahPImz7GACkTWG7hM4/view — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
79. 抹香鲸 coda 不只是节奏:与音乐对比后得到的声学蓝图

英文题目:Music of the Deep: An acoustic blueprint of sperm whale codas
评分:5.0/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:后 50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Mudit Sinha:Independent Researcher, San Bruno, California 94066, United States
- Sanika Chavan:Independent Researcher, San Bruno, California 94066, United States
📌 核心摘要
研究对象是社交时发出的抹香鲸coda短点击序列,输入是录音波形与已标注的点击时间,目标是建立超越点击数与间隔的声学描述,困难在于鲸与音乐在物理形式和时长上差异很大,无法把点击直接当作音符比较。处理先用固定的预训练音频编码器把每个录音变成数值特征,再经标准化与主成分分析保留主要变化后用k-means分成声学状态并综合多个编码器的一致性,前一步的特征分布成为后一步状态划分的基础。然后在留出的录音来源上比较重复、后继选择与预测,再分别检验单元内组成与排序、相邻间隔协同与呼叫者信息、人类效价与唤醒参考方向上的范围,以及合成音频的分布差异。与已有只看点击数和间隔的做法不同,本文把波形、单元组成、跨单元关系、局部timing与情感相关声学变化放在一个可检验的声学蓝图中分别测量,意味着单层相似不能代替整体声学是否一致。在留出44个coda日期组与6部巴赫作品等来源并匹配事件数与频率的序列比较中,相邻位置出现相同形式比例指标上采样coda序列为71.3%,三类音乐参考为21.7%–44.6%,coda高于音乐参考,而已知当前形式后对下一形式的相对剩余不确定性相近。相邻间隔协同变化与呼叫者识别及人类音频验证的方向检验显示timing协同、个体信息与宽广可复现的变化,合成比较显示可识别的孤立合成片段仍与自然录音可区分。结论适用于所采样的Dominica EC-1 coda与所测试的音乐、人类音频和孤立合成片段,不涉及鲸的情绪体验归因与生成器落差的原因,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
80. Mimi 第一码本存的是音位还是变体:固定 80 毫秒切分下的分布探测

英文题目:Probing the phon* representations of the Mimi codebooks
评分:4.5/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.7/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.3/1.5
排名:后 50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Artem Saloev:ALTAE, Université Paris Cité, F-75013 Paris, France
- Nicolas Ballier:ALTAE, Université Paris Cité, F-75013 Paris, France
- Erin Pacquetet:SCIAM, 10 rue de Penthièvre, F-75008 Paris, France
📌 核心摘要
研究对象是神经音频编解码器Mimi输出的离散词元,本文考察首个码本编号是否对应稳定音素。难点在于词元时长与音素时长相当且常横跨相邻音素边界,无法与单个音素一一对应,需先把词元序列与音素边界对齐再统计分布关系。方法用蒙特利尔强制对齐得到的音素区间按重叠比例把每个词元映射到占比最大的音素,再计算词元给定条件下音素分布与音素给定条件下词元分布的熵和互信息,并用跨句置换检验判断分布差异是否超出抽样波动。控制干预把首个码本的单帧或全部帧替换为固定编号后重建波形,再用语音识别的词错率衡量语言信息损失。与已有成对判别不同,关键差异是不做判别而估计双向条件分布,并把全部码本的电话归一化互信息放在同一框架下比较。在TIMIT朗读语音取众数帧长的SA1子集与SA2子集上,Mimi首个码本的指标电话归一化互信息PNMI均为0.84,高于随机打乱基线的0.22±0.004和0.29±0.004,分别约为其3.8倍和2.9倍,越高表示对应越强。结论适用范围限于所用英语朗读语音,作者认为首个码本更接近随语境变化的音素变体编码而非稳定音素表,该判断在更大语料和多样口音中尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。