📄 小预算稀疏混合专家:HobbyLM 如何搭架构、训模型再做多模态与生图
英文题目:HobbyLM: A Sparse Mixture-of-Experts Model Family on a Hobby Budget
评分:5.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
👥 作者与机构
- Harish Santhanalakshmi Ganesan:机构信息未能在本次解析中与作者逐人可靠绑定
- Hariharan M. S.:机构信息未能在本次解析中与作者逐人可靠绑定
- Prabhurajhan R:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是在数百到一千余美元租用算力下从随机初始化训练亚十亿参数稀疏混合专家语言模型,难点是路由不稳定、负载不均、长上下文与多模态扩展容易发散,而已有开源小模型依赖数万亿 token 蒸馏或大规模数据。论文先在 130M 规模做单变量消融确定解码器、路由和优化器组合,再训练 500M 基座并扩展到 8k 上下文,随后把同一基座转成聊天、掩码扩散、视觉语音多模态、函数调用与无障碍树计算机智能体,另由两位作者原样采用架构独立训练 1B 模型。与已有细粒度专家和辅助损失无关均衡方法的区别是把逐头查询键归一化、S 型路由加选择偏置、共享专家与 Muon 加自适应矩估计权重衰减优化器分工组合起来,并在小参数量下验证有效性。HobbyLM-1B 在七个零样本任务平均上达到 47.54,评价采用 lm-eval 0.4.13、fp32 与原文相同的准确率口径。结论只适用于 10B 到 100B token 量级和单种子训练,视觉严格匹配接近语言先验基线,并行调用基本失效,长目标检索未经证实。500M 主训练约 104 个 GPU 小时,1B 主训练加退火约 304 个 GPU 小时并计费约 1167 美元,图像全部实验约 445 美元,其中 512 像素 100M 图像浏览量运行约 217 美元。
🔗 开源与复现资源
第三方资源:https://github.com/harishsg993010/HobbyLM — 链接可访问(HTTP 200)
第三方资源:https://github.com/fuellabs-ai/hobbylm-1b — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/rootxhacker — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/harims95 — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/spaces/rootxhacker/HobbyLM-Playground — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
为什么要在几百美元预算下从零训练小混合专家
这篇论文要回答的是小语言模型在极小词元预算下能走多远。输入是公开网页、教育网页、代码、数学等文本词元,目标是得到一个能做常识问答、对话、工具调用、多模态问答乃至文生图的基座,输出是可直接跑在笔记本 CPU 上的权重与推理引擎。必须保留的信息包括分词方式、评测任务划分与指标定义,否则跨模型分数无法比较。
已有小模型路线多是蒸馏或微调已发布的大权重,或用 2T 到 36T 词元从零训练。HobbyLM 反其道而行:全部从随机初始化开始,只用 10B 到 100B 词元,租用按需或无服务器 GPU 完成。论文把工作拆成两块:1 人负责架构、130M 与 500M 预训练及全部 500M 后训练、推理引擎与生图模型;另 2 人原样采用该架构独立做出 1B 模型的数据、训练与评测。读者读完应能复述每块是谁做的、在什么条件下测出什么结论。
本文站在哪些已有路线上,又不比什么
语言模型侧,论文把 Pythia、OPT、SmolLM2、Gemma 3、Qwen3 列为同类开放小模型参照,比较时任务、零样本设置与指标选择尽量对齐。稀疏混合专家侧,设计借自 Switch、DeepSeekMoE 的细粒度与共享专家、DeepSeek-V3 的 sigmoid 路由加辅助损失无关均衡、OLMoE 的开放消融思路、ST-MoE 的路由 z 损失,本文贡献是这些组合在 62M 到 305M 激活参数下的消融验证,而不是提出新路由机制。
多模态侧沿用 LLaVA 与 TinyLLaVA 的冻结编码器加投影器做法,编码器用 SigLIP2 做图像、Whisper 做语音、CLAP 做声音。智能体侧函数调用用 BFCL 与 needle 风格指标,计算机操作不用截图而读 Windows 无障碍树文本。扩散语言模型侧沿用 LLaDA 与 MDLM 的掩码生成加 DiffuLLaMA 式自回归权重迁移,生图侧沿用扩散 Transformer 加整流流与 SANA 的深度压缩自编码器。这些对照只在输入、目标与运行阶段相同时才有意义,不能把跨词元量、跨评测版本的分数直接排胜负。
论文要解决的具体困难是什么
第一个困难是小混合专家不稳定且选择多:路由用 softmax 还是 sigmoid、是否归一化、要不要共享专家、要不要 QK 归一化、优化器如何分工,每处都可能让训练发散或负载失衡。第二个困难是预算小导致容错低:500M 只看 40B FineWeb 词元,1B 只看 100B 混合词元,远少于同尺寸主流模型的 300B 到 36T,任何数据顺序错误或解码设置不当都会被放大。
第三个困难是 1 人要打通全栈:从分词、数据分片、分布式训练、分块损失、GGUF 导出、自研 CPU 推理、桌面应用到在线演示,都要在笔记本 CPU 可运行。第四个困难是多模态与智能体在小参数下易互相干扰:视觉、语音、工具、计算机操作联合训练时可能漂移,调用与拒答可能互斥。论文用 130M 单变量消融定架构,用分阶段与联合循环训练定多模态顺序,用受控解码与强制调用策略缓解智能体矛盾。
整体流程:一个样本从词元到输出经过哪里
以一句文本为例,先经 GPT-2 字节级 BPE 切成 50257 词元词表内的编号,空余槽位留给图像、声音、语音等哨兵。嵌入层与输出头权重共享,第 0 层是注意力加稠密 SwiGLU,其余层是注意力加稀疏混合专家,最后经归一化进语言模型头算 logit。
注意力内先做融合 QKV 投影,查询与键按头做 RMSNorm,再做旋转位置编码与因果点积,这是分组查询注意力的实现。多模态时,冻结编码器先把图像、语音离线算成特征,经小投影器映射到模型宽度,替换输入中的哨兵嵌入再与文本拼接;训练时除最后一个特征位置外其余特征位置的损失被屏蔽。智能体与生图是独立分支:前者在文本提示后生成 JSON 工具调用,后者是单独的扩散 Transformer 在压缩隐空间做速度场回归。
下面这张结构总览适合对照下文公式理解数据流,重点看主干堆叠顺序与右侧两框的内部顺序。
看图路径: 1. 先从底部词嵌入向上看:首层是稠密层,其余层才是注意力加混合专家;2. 再看右侧两框:上框是注意力内 QK 归一化与旋转位置编码的顺序,下框是路由打分、加偏置选 k 个再加权求和;3. 注意共享专家是与被选路由专家并列相加,不是被选中的第 k+1 个
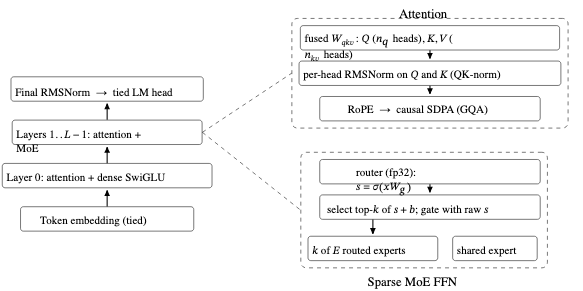
论文图 2。原论文 Figure 2::“The HobbyLM decoder. Every layer is pre-norm.”。
从图中确实能看到首层稠密、其余层混合专家的分工,以及注意力框与混合专家框的内部计算顺序。它帮助理解为何首层不做路由、为何路由分数与选择偏置分开、为何共享专家是常驻项。QK 归一化同时出现在语言模型与生图模型的注意力中,是贯穿全文的稳定性手段。
注意力与归一化:先把 logit 幅度管住
500M 用 768 宽、16 层,12 个 128 维查询头、3 组键值头,头维与模型宽解耦。查询与键在旋转位置编码前各做 1 次按头 RMSNorm,这就是 QK 归一化,作用是限制注意力 logit 上界。消融显示去掉它验证损失上升 0.803 奈特,是所有单变量改动中影响最大的,论文后来把同一手法直接搬到生图 DiT 的自注意力与交叉注意力中并消除了发散。
位置编码用 RoPE,8k 上下文版本把 theta 从 1e4 提到 1e6。掩码扩散变体是唯一例外,它用全双向注意力以支持迭代去掩码生成。其余文本预训练均为因果掩码。推理时键值缓存、稀疏专家按批聚合、int8 核等都是为了在内存受限的 CPU 上跑起来,精度行为另见后文量化检查。
分组查询注意力 × QK 归一化 × 旋转位置编码: 分组查询注意力让多组查询头共享较少的键值头以省显存;QK 归一化指在计算注意力点积前对查询和键做归一化以限制 logit 幅度;旋转位置编码给查询和键注入相对位置。三者组合是在长序列和小模型下保持注意力稳定且省资源的搭配。
混合专家路由:打分、选路与加权如何分开
每个专家是窄宽度的 SwiGLU 网络,粒度 G 为稠密宽度除以专家宽度。首层保持稠密,因为早期路由不稳定。对词元表示 x,路由器在 fp32 下对每个专家独立算 sigmoid 分数。
\[s_{i}=\sigma\!\left(x^{\top}w_{i}\right),\qquad i=1,\dots,E,\]上式中 x 是词元向量,w 是第 i 个专家的路由向量,sigma 是 sigmoid,E 为专家总数。它表示每个专家是否适合处理该词元的独立概率,不做跨专家归一化。
选路时用分数加偏置取 top-k,加权时仍用原始分数,被选专家输出加权求和再加共享专家。
\[\mathcal{T}(x)=\operatorname{TopK}_{i}\big(s_{i}+b_{i},\;k\big),\qquad y=\sum_{i\in\mathcal{T}(x)}s_{i}\,\mathrm{FFN}_{i}(x)\;+\;\mathrm{FFN}_{\text{shared}}(x).\]其中 T(x) 是被选集合,FFN 为专家网络,共享专家对所有词元运行。偏置 b 只改变谁被选中,不参与加权,因此负载信号不与语言建模梯度竞争。论文消融发现不做 top-k 重归一化略好,sigmoid 与 softmax 在 130M 3000 步下几乎无差,32 专家优于 16 专家约 0.048。
负载偏置在每次前向后按固定步长向均衡方向移动,数据并行下跨卡平均,训练最后 5% 冻结。
\[b_{i}\leftarrow b_{i}+u\cdot\operatorname{sign}\!\big(\bar{c}-c_{i}\big),\]其中 c 是分给专家的词元数,上横线 c 是均衡值,u 为 1e-3。由于每次累积都更新 1 次,优化器每步的实际移动是 u 乘以累积步数。另有两个小正则:Switch 风格均衡项与路由 z 损失系数均为 1e-3,最终 logit 再加 1e-4 的 z 损失。计算上无容量上限、不丢词元,按专家排序后用分组矩阵乘 1 次算完。
稀疏混合专家 × 细粒度专家 × 共享专家: 稀疏混合专家指每层有多个前馈网络但每个词元只激活其中 k 个;细粒度专家指把专家宽度做窄、数量做多,以提高组合灵活性;共享专家指所有词元都经过的通用分支,用于承载公共知识。三者搭配后,路由专家负责分工,共享专家兜底通用表示。
sigmoid 路由 × 辅助损失无关负载均衡 × 选择偏置: sigmoid 路由指每个专家独立打分而不做归一化;辅助损失无关负载均衡指不用额外梯度损失,而是用一个只影响选择、不影响加权的选择偏置来调节负载;选择偏置按专家过载或空闲做加减。组合后语言建模梯度只走原始分数,负载调节只走偏置,两路信号互不干扰。
优化器分工与生图分支的目标函数
矩阵形隐藏参数用 Muon 并做批量牛顿-舒尔茨正交化,3D 专家栈按专家独立正交化,再按 0.2 乘以根号下最大维数缩放到 AdamW 量级,动量 0.95、权重衰减 0.1。路由、词嵌入与向量参数用 AdamW,因为正交化会压平路由矩阵的奇异值而丢失路由信号。峰值学习率在 262144 词元批量下为 Muon 0.02、AdamW 3e-4,大批量按根号 B 缩放,日程为 100 步热身加常数段加后 40% 线性衰减到 0.1 倍。
生图分支是独立的 333M 扩散 Transformer,工作在 DC-AE 的 32 倍空间压缩隐空间,1024 图像变为 32 乘 32 乘 32 隐张量,补丁为 1。输入是左右双板画布加掩码通道,左板算损失,文本条件用冻结 CLIP ViT-L/14。其流匹配目标是回归从噪声到干净隐向量的速度。
\[z_{t}=(1-t)\,z_{0}+t\,z_{1},\qquad\mathcal{L}=\mathbb{E}\big[\,w\,\|v_{\theta}(z_{t},t,c)-(z_{1}-z_{0})\|^{2}\big].\]其中 z1 为干净隐,z0 为噪声,t 服从 logit 正态,c 为文本条件,w 在编辑时对前景加权 1 加 1.5m,生成时为 1。该式说明模型在每个中间时刻预测位移方向,采样时再用欧拉积分加无分类器引导逐步去噪。
冻结编码器 × 投影器 × 哨兵词元: 冻结编码器指 SigLIP、Whisper、CLAP 等不更新的视觉语音编码器;投影器指把编码器特征映射到语言模型宽度的两层 MLP;哨兵词元指占用词表未用槽位的占位符,输入时被替换为投影后特征。组合后语言模型本体不动词表,只需学习如何读入外部模态序列。
预训练、延上下文与后训练实际做了什么
130M 与 500M 都在 8 卡 H100 上用 PyTorch 分布式与编译训练,每步约 1048576 词元。130M 跑 9537 步约 10B 词元,500M 跑 38147 步约 40B 不重复词元。500M 先延到 2048 再到 8192,验证损失从 3.0281 降到 2.999 再到 2.94。优化器与日程沿用上节,日程跨全程,微调阶段多用 AdamW 小学习率。
后训练包括 SmolTalk 约 1,500,000 对话微调加 UltraFeedback 的 DPO,掩码扩散模型从自回归权重出发改双向注意力并按 t 加权掩码损失,稀疏自编码器在线流式训练 50,000,000 词元。多模态分五步:视觉投影器对齐、视觉指令微调、声音投影器对齐、语音投影器 ASR 对齐加口语问答,再到多轮联合循环,每轮在前一轮上加新路径。工具调用先在 26.8 万单调用上训,再试语法约束解码与加权损失,最后用约 81.6 万混合数据训 6000 步。计算机操作用合成屏、真实树、多步目标三代数据,元素缺失即拒收。
Muon × AdamW × 分块交叉熵: Muon 用于矩阵形隐藏参数的正交化更新,AdamW 用于路由、词嵌入等向量与特殊参数;分块交叉熵指分块计算词表投影与损失以避免一次性生成大 logit 矩阵。三者分工是让不同形状参数各得其所,同时把大词表训练的峰值显存降下来。
1B 独立构建:数据、顺序与退火有何不同
1B 完全采用第 3 节的 1B 预设:1024 宽、20 层、16 查询头 8 键值头 128 维、64 专家 top-8 加 1 共享专家,总 1037.1M、激活 305.0M。新增的是 100B 混合,主阶段 85062 步约 85B、退火 14305 步约 15B 三遍,估计去重后 88.5 到 90B。分词仍用 GPT-2 以保与 130M 可比,分片为 100M 词元、uint16、文档过短丢弃,分层播种顺序保证每三分之一来源比例贴近目标。
下面这张表比较 1B 混合中 5 个来源的分片数、词元数、占比与阶段,份额越高在训练中出现越频繁,退火只占 5% 但质量更高。
| Source | Dataset | Shards | Tokens | Share | Phase |
|---|---|---|---|---|---|
| Educational web | FineWeb-Edu (shards 000001–000600) | 600 | 60B | 60% | Main |
| Filtered web | DCLM-baseline-1.0 | 150 | 15B | 15% | Main |
| Code | codeparrot-clean | 100 | 10B | 10% | Main |
| Math | FineMath-4plus | 100 | 10B | 10% | Main |
| Anneal | Cosmopedia-v2 (3.5B) + FineMath-4plus (1.5B) | 50 | 5B | 5% | Anneal |
从表中可见教育网页占 60B 共 600 片,是绝对主体,过滤网页、代码、数学各占 10B 到 15B,退火用 Cosmopedia 与数学共 5B。这种配比决定了分层排序必须按比例交错,否则模型会长时间只见单一来源。训练在 4 卡 H200 单节点、1024 序列、每卡 32 累积 8、每步 1048576 词元,bf16 加 fp32 主权重加 fp32 路由,Muon 0.04 与 AdamW 6e-4,100 步热身加后 40% 线性衰到 0.1 倍,梯度裁剪 1.0,偏置在 90598 步冻结。主训约 68 小时、退火约 8 小时,共约 304 GPU 小时,账单约 1167 美元。退火从主阶段末检查点续跑并继承优化器与日程位置。指令微调 lineage 经 2K 扩展、工具试点、4K 扩展再到 4 段 SFT 至 3450 步,4K 检索未通过故不宣称 4K 可用。
评测条件:任务、指标与版本必须先对齐
语言评测用 EleutherAI LM Evaluation Harness,500M 家族用 0.4.9.1,1B 由建造者用 0.4.13,均为零样本。七任务为 HellaSwag、OpenBookQA、WinoGrande、ARC-c、ARC-e、BoolQ、PIQA,有 acc_norm 定义的报 acc_norm 否则报 acc。500M 家族用同一封装重跑所有基线并核对 MicroLlama 与 TinyLlama 复现误差在 0.13 以内;1B 的同封装基线尚未完成,因此图 1 中 1B 为空心点,不能与实心点直接排胜负。
视觉用 lmms-eval 加自定义适配,阶段 2 报规范化精确匹配,最终模型兼报严格与包含评分。语音报 LibriSpeech test-clean 词错率,越低越好。函数调用用 needle 风格的 JSON 解析率、名称 F1、参数幻觉率与精确匹配,BFCL v3 用抽象语法树匹配。计算机操作按屏或轨迹划分的留出集报同样指标。生图未算 FID 或 GenEval,只看样张与流匹配损失,这是理解结论边界的关键。
基座结果:在什么词元量下超过了谁
要回答的核心问题是同评测封装下分数排序更跟随词元量还是参数量。500M 平均 44.05,130M 平均 42.97,超过同封装下 50B 的 MicroLlama-300M、180B 的 OPT-350M 与 300B 的 Pythia-160M,但落后于 300B 的 Pythia-410M 的 45.34,更落后于 2T 到 36T 的 SmolLM2、Qwen3 与 Gemma。500M 另在 LAMBADA 得 40.0、SciQ 得 70.3。结论成立条件是零样本、基座权重、同一 0.4.9.1 封装;换版本或换指令微调后分数含义不同。
下面这张表比较各基座在相同七任务与相同封装下的单项与平均分,分数越高越好,平均为七任务均值。
| Model | Params | Tokens | Hella | PIQA | Avg |
|---|---|---|---|---|---|
| Pythia-410M | 410M | 300B | 40.14 | 67.52 | 45.34 |
| HobbyLM-500M | 501M/169M | 40B | 41.56 | 69.53 | 44.05 |
| OPT-350M | 350M | 180B | 36.55 | 64.69 | 43.61 |
| HobbyLM-130M | 140M/62M | 10B | 32.54 | 65.40 | 42.97 |
| MicroLlama-300M | 300M | 50B | 34.22 | 64.69 | 42.23 |
| Pythia-160M | 160M | 300B | 30.21 | 59.52 | 38.60 |
HobbyLM 的优势集中在 10B 到 40B 预算内打赢了 1.25 到 30 倍词元量的老小模型,代价是仍被 300B 的 Pythia-410M 压制,说明架构与系统优化能部分弥补词元差距但不能跨越一个数量级以上的数据红利。1B 的 47.54 平均分因评测版本不同只能放在旁边参考,不能据此宣称同条件超越 500M。未胜出项是明确的:更大词元量的新小模型仍全面领先。
下图横轴为预训练词元对数、纵轴为七任务平均,适合直观看到词元量主导的上升趋势与 HobbyLM 两点的位置。
看图路径: 1. 横轴是预训练词元数的对数尺度,纵轴是七任务零样本平均分;2. 区分实心点与空心点:实心是同一评测封装,空心 1B 是建造者用不同 lm-eval 版本单独评测;3. 观察 HobbyLM-130M 与 500M 在同词元量附近相对 MicroLlama、OPT、Pythia 的位置
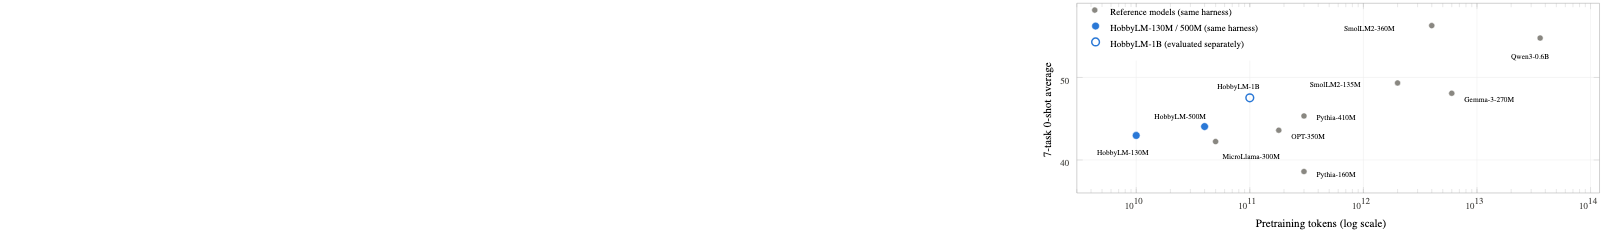
论文图 1。原论文 Figure 1::“Zero-shot average on seven tasks (HellaSwag, OpenBookQA, WinoGrande, ARC-c, ARC-e, BoolQ, PIQA) against pretraining tokens, for base checkpoints of up to about 1B parameters…”。
从图中确实能看到 HobbyLM-130M 与 500M 在 10B 与 40B 处高于左侧部分基线,而右侧大词元模型随横轴右移继续走高,1B 空心点位于约 100B 处但因版本差异需谨慎解读。它帮助理解为何论文强调在有限预算下回收效率,而非宣称同尺寸最强。
多模态、工具与计算机操作:小参数的得与失
视觉阶段 2 在 384px 下 POPE 准确率 50.0、F1 66.7,GQA 规范化精确匹配 27.85,VQAv2 为 37.29;最终 joint12 在 512px 8k 下 GQA 严格 20.6、包含 39.2,VQAv2 严格 28.2、包含 47.0。POPE 暴露短板:阶段 2 对所有探针答是,故准确率 50%、召回 1.0。严格分接近语言先验,包含评分才回升,说明问答格式与判分方式显著影响结论。语音仅训 1.77M 投影器、冻结语言模型时 LibriSpeech 干净集词错率 28.54%,多为同音错误。
函数调用在 Nemotron 留出 400 条上贪心精确匹配 38.5%,加语法约束后参数幻觉从 3.8% 到 0.0% 但精确匹配不变,加权损失到 39.5%;混合数据后 BitAgent 上名称 F1 100%、精确匹配 59.0%,同模型在 Nemotron 上 37.3%。BFCL 上简单 22.7、多项 29.3、并行约 0、相关 77.8、不相关 15.3;加入轨迹数据后不相关升到 90.7 以上,但必须调用从 22.7 跌到 0.7 乃至 0,呈现调用与拒答的权衡。计算机操作留出集精确匹配 72.5% 到 82.6%,参数幻觉为 0 多因构造过滤,长目标按步误差累积且无恢复机制。部署因此用强制调用、贴最近合法名与修 JSON 的工程策略。
消融与吞吐:哪处改动最值钱、哪处省显存
消融在 130M、32 专家 top-4 个基线、3000 步 FineWeb 上单变量进行,基线验证损失 3.6688。top-8 降 0.025、不重归一化降 0.015,softmax 与加一个共享专家几乎无差,乘嵌入缩放、经典辅助损失、去路由 z 损失、减半专家数分别升 0.009 到 0.048,去 QK 归一化升 0.803。这支持先保证归一化与路由数学,再调专家数的结论,但 0.01 量级差异在单种子单轮下属噪声,论文亦明确提醒。
下面这张表比较同硬件同批量下基线、分块交叉熵、Polar 调度、两者叠加与 FP8 输出头的速度与质量,耗时越低越好,损失越低越好。
| Option | ms/step | tokens/s | Peak GB | 130M val loss |
|---|---|---|---|---|
| baseline | 222.5 | 36,821 | 33.3 | 4.0739 |
| fused_ce | 209.2 | 39,166 | 26.4 | 4.0681 |
| FP8 head | 223.8 | 36,605 | 33.8 | 10.90 (no gradient) |
分块交叉熵把峰值从 33.3 GB 降到 26.4 GB 且损失相当,使大批量可跑,是唯一被 1B 采用的手段;Polar 中性,FP8 头在该实现下梯度不通、损失达 10.90 而被弃用。代价是分块带来检查点重算,速度提升有限。数据顺序消融同样重要:130M 上 5B 混合数据若按源顺序消费会先吃教育网页再吃 DCLM 而见不到数学,验证损失从 3.74 升到 5.13;改分层交错后以一半词元追平 FineWeb 基线。这说明分片顺序本身就是超参数,上线前打印每三分之一的来源比例是廉价检查。
哪些结论出界了:版本、长上下文与安全
首先是可比性:1B 同封装基线待补,1B-Instruct 配 4096 但其父检查点 4K 检索失败,长上下文检索应视为未验证。其次是单种子单轮:所有大模型各训 1 次,消融亦单轮,百分点小差不能当显著。第三是多模态接地:阶段 2 的 GQA 与 VQAv2 用 2K 子集,最终严格分近先验,POPE 全答是,说明视觉 grounding 仍弱。
第四是智能体边界:并行调用约 0 分因训练只含首调用,轨迹数据虽治拒答却杀死必须调用;计算机长目标误差累积,真机执行默认限安全动作或演练模式。第五是 1B 训练与数据准备代码未公开,论文说明公开仓库不含训练代码,SFT 部分桶上游来源未完全追溯。第六是全家族未做安全与偏见评测、无安全微调,生图训练混入其他生成器的合成图可能继承偏见,且无 FID 与 GenEval,不能谈分布级质量。
复现第一步做什么,需要多少资源
下面这张表列出每个部件由谁设计或建造,采用指原样取用架构规范与代码,适合先分清归因再选仓库起步。
| Component | Content | Designed / built by |
|---|---|---|
| Architecture | MoE decoder, routing, balancing, normalization, optimizer split, presets, ablations | Harish Santhanalakshmi Ganesan |
| 130M / 500M pretraining | FineWeb training, context extension, lm-eval wrapper | Harish Santhanalakshmi Ganesan |
| 500M post-training | Chat (SFT+DPO), diffusion LM, SAE, multimodal omni model, function calling, computer use | Harish Santhanalakshmi Ganesan |
| Inference | GGUF export, Rust engine hobby-rs, desktop app hobby-chat, demo Space | Harish Santhanalakshmi Ganesan |
| HobbyLM-Image | DiT design, data curriculum, training, Rust port | Harish Santhanalakshmi Ganesan |
| HobbyLM-1B architecture | The 1B preset of Section 3 | Adopted (Harish Santhanalakshmi Ganesan) |
| HobbyLM-1B build | 100B-token mixture, stratified shard order, H200 training, anneal, evaluation, analysis | Hariharan M. S., Prabhurajhan R. |
| HobbyLM-1B-Instruct | instruction tuning of HobbyLM-1B; GGUF build; patched CPU runtimes | Hariharan M. S., Prabhurajhan R. |
| HobbyLM-1B MLX | MLX implementation for Apple Silicon | Prabhurajhan R. |
| HobbyLM-1B Computer Use v0.1 | Mac computer-use LoRA | Prabhurajhan R. |
从表中可见架构、130M 与 500M 预训练、全部 500M 后训练、推理与生图由 1 人完成,1B 混合、排序、训练与评测由另 2 人完成,采用不代表参与训练,只是架构复用。复现架构消融应从前者代码与 130M 预设起步,复现 1B 数据结论应看后者混合与分层顺序文档,两边仓库与权重地址不同,训练代码仅前者公开。
实操第一步是按原文配环境:8 卡 H100 跑 500M、4 卡 H200 跑 1B 只是原配置,个人复现可先跑 130M 3000 步消融验证 QK 归一化与分块交叉熵,再用分层脚本打印来源比例。成本上 500M 预训练约 104 GPU 小时、上下文扩展约 8 小时、扩散适配约 155 美元、生图全部约 445 美元、1B 约 304 GPU 小时,短轮未计入。推理侧用 GGUF 加自研 Rust 引擎或 llama.cpp 兼容布局,Q4_K_M 可把 2.16 GB 压到 362 MB,笔记本 CPU 从十余词元每秒提到 40-50 词元每秒;1B 需打过解耦头维补丁的 llama.cpp,原版 Ollama 无法加载。权重、代码、演示是三件事:权重在 Hugging Face 可下,代码在 GitHub,演示在 Space,第三方镜像只证明论文提到链接,不等于作者已开源可用。
什么时候值得尝试,还缺哪项验证
当预算只有几百到上千美元、目标是笔记本 CPU 可跑的原型,且能接受幻觉与弱接地时,这套细粒度混合专家加 sigmoid 偏置均衡加 QK 归一化加 Muon 分工的组合值得尝试;当需要并行工具调用、可靠拒答、长上下文检索或分布级生图质量时,当前证据不支持直接部署。
原文记录 130M 跑 9537 步约 10B 词元、单步约 742 毫秒、约 2 小时、验证损失 3.3016,500M 跑 38147 步约 40B 词元、单步约 1.21 秒、约 13 小时、验证损失 3.0281,耗时为墙钟乘卡数的记录口径,损失为对应序列长度下的验证值。它的限制是未含消融、评测与后训练开销,不能当总预算。
还缺的验证很具体:1B 同封装基线重跑、1B-Instruct 的 4K 检索、SFT 混合中重叠提示的训练泄露审计、生图的 FID 与 GenEval、智能体在真实桌面长目标下的恢复能力,以及任何安全与偏见评测。补完这些,才能把小预算混合专家的天花板说清楚。
📎 论文与评分元数据
排名:前50% | 文档类型:模型报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses