共分析 58 篇论文
⚡ 今日概览
✅ 筛选入选 58 篇 → 🔬 深度分析完成
每篇论文保留完整分层分类;热门方向按主任务的最上级方向统计,每篇计入 1 个方向。排行榜也显示最上级任务。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| 语音识别 | 9 篇 | █████████ |
| 异常声音检测 | 3 篇 | ███ |
| 语音克隆 | 3 篇 | ███ |
| 语音合成 | 3 篇 | ███ |
| 语音增强 | 3 篇 | ███ |
| 音乐分析 | 3 篇 | ███ |
| 音频分离 | 3 篇 | ███ |
| 音频理解 | 3 篇 | ███ |
📊 论文评分排行榜(58 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 RubatoCodec:用固定事件预算做自适应语音切分与流式解码

英文题目:RubatoCodec: Budgeted Adaptive Speech Tokenization with Streaming Decoding
评分:8.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.5/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chihiro Arata:Third Intelligence, Inc.
- Shohei Taniguchi:Third Intelligence, Inc.
- Gouki Minegishi:Third Intelligence, Inc.
- Kan Hatakeyama-Sato:Third Intelligence, Inc.
📌 核心摘要
语音生成用神经编解码器需在短序列与每位置信息量之间权衡,固定网格易把快速音素过渡并入同一记号,又在静音段浪费同样多记号,而阈值型可变帧率让内容决定总数,使同一设置下序列长度随语料漂移。RubatoCodec的自适应触发机制以X-Codec-2编码骨干输出的潜特征变化与波形频谱通量为输入做累计分配,按保留率定出整句固定的事件总数并切出时长可变的事件边界,边界划分结果决定后续聚合区间。区间聚合器以上一起始帧特征与区间均值为输入,再拼接显式时长合成为量化器输入,每个事件输出离散码与时长,该码—时长表示直接摆成稀疏网格送入因果变换器与频谱合成解码器增量合成波形。与已有方法的关键差异是整句事件预算固定而边界自适应,使生成器一次预测一个事件并学会预算内的长短事件搭配。在LibriSpeech test-clean上12.5事件/秒、8层量化条件下,自适应编码相对同训练固定码率对照的UTMOSv2为3.448高于对照的3.365,dWER为0.80%低于对照的0.84%,比特率为1.23kbit/s与对照1.20kbit/s相近。多语言模型在英日重建评测同比特率段比较中dWER最低,英语零样本语音合成在seed-tts-eval的1088句上自适应表示的WER为3.10%低于固定码率对照的3.20%,UTMOS为4.162高于对照的4.080且说话人相似度均为0.392相当。结论适用于读朗读与部分情感语音重建及英语零样本语音合成对比,25Hz下增益收窄,PESQ-WB/STOI与说话人相似度仍有差距,训练总时长原文未披露充分细节,吞吐在单张NVIDIA H200上实测。
🔗 开源资源
代码相关资源:https://github.com/third-intelligence/RubatoCodec — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/third-intelligence/RubatoCodec — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 HARMONY:无机器标识时如何把混杂声音特征重新分区再做异常检测

评分:8.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuhang Zhang:School of Software and Microelectronics, Peking University, Beijing, China
- Yang Li:Independent Researcher
- Qiang Wu:Collaborative Innovation Center for Western Ecological SafetyLanzhou University, Lanzhou, China
- Mingyuan Li:ELLIS Institute of Finland;University of Turku
📌 核心摘要
无元数据机器声学异常检测要求单个模型在没有机器标识的情况下同时监控多类机器,输入是原始音频,输出是偏离正常分布的异常分数。困难是多种正常机器声音在冻结编码器特征中互相重叠,论文把重叠特征重新组织后再做异常打分。论文提出HARMONY,做法是先在主成分子空间中挖掘锚点(anchor,指定义局部声学区域的单位范数原型),再学习投影把特征拉向所属锚点并推离竞争锚点,形成超球面上的沃罗诺伊区域(Voronoi region,指到某锚点相似度最大的样本集合)。同一分区结构在推理时被复用为索引,先选少数专家区域,再在区域内探测局部桶,只对候选样本计算精确距离,这把检索路径与学习到的几何对齐,而非把近似检索直接加在冻结特征上。在DCASE 2020无元数据协议下,平坦检索版本平均曲线下面积(Area Under Curve,AUC,越高越好)为90.00%,层级检索版本为89.80%,相对最强统一基线UniFlow的75.40%提升14.60个百分点,相对基础特征管线Audio-PC的83.90%提升6.10个百分点。训练在NVIDIA Tesla V100上经20轮完成,推理时延在Intel Xeon Platinum 8163单线程CPU上实测,层级检索从42.3 ms降至5.4 ms,实现7.8倍加速且AUC仅下降0.20个百分点。论文同时报告噪声、域偏移与训练污染下的衰减,适用范围限于工业机器声音,极端域偏移与强不平衡模式仍未解决。
🔗 开源资源
- 代码相关资源:https://github.com/Zzyh0208/HARMONY — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 只用合成语音能识别真实尼泊尔语-英语混说播客吗
英文题目:Synthetic-to-Real Code-Switched ASR: A Spontaneous Nepali-English Podcast Benchmark
评分:7.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1.5/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Firoj Paudel:Wiseyak Inc.
📌 核心摘要
读者需要理解的对象是尼泊尔语-英语混用的自发播客语音,任务是把声音转写为文字,输出要求尼泊尔语母语词用天城体(Devanagari)书写、英语嵌入词用拉丁字母书写并保持词序正确。困难在于两种文字会互相串写,以及在语言切换点前后各一个词的局部窗口内更容易出现替换、删除和插入错误,处理过程是先用合成语音调整解码器,再用序列级采样优化微调边界。第一步是监督微调(Supervised Fine-Tuning,SFT),它用合成音频-文本对以交叉熵目标更新解码器,使模型学会双语文字分配;第二步是组相对策略优化(Group Relative Policy Optimization,GRPO),它对同一条语音采样 8 个候选转写并按组内奖励均值和标准差计算优势后更新策略,用于奖励整句准确和文字一致的候选。与已有方法的区别在于编码器全程冻结、只改自回归解码器,且训练只用合成语音并在真实自发对话上做零样本式评测,同时对比了 token 级门控偏置和序列级优化两条路线。冻结真实测试集上合成 SFT 把混合错误率(Mixed Error Rate,MER)从 23.40% 降到 21.52%,切换点错误率(Switch-Point Error Rate,SPER)从 35.89% 降到 28.77%,后续 GRPO 只在 173 条(1.69%)上改变输出。结论适用于编码器已提供较强声学约束的编码器-解码器结构,不适用于无约束解码器大模型的既往大增益结论,原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/Firoj-Wise/nepali-english-codeswitch-asr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/SamaFiroz/nepali-english-codeswitch-podcasts — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. 昆曲字腔对齐与押韵检索:KunSet 语料库如何建成与验证

英文题目:KunSet: A Corpus and Benchmark for Lyrics Alignment and Rhyme Retrieval in Kunqu Opera
评分:7.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Lejun Min:机构信息未能在本次解析中与作者逐人可靠绑定
- Siqi Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Delong Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tong Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunqi Lu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhishan Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Ke Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuting Zhong:机构信息未能在本次解析中与作者逐人可靠绑定
- Junrong Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Shengran Jin:机构信息未能在本次解析中与作者逐人可靠绑定
- Beixuan Pei:机构信息未能在本次解析中与作者逐人可靠绑定
- Jun Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yang Li:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是昆曲演出录像中的唱词与念白,困难在于每个汉字对应一个音节,演唱中存在长时拖腔和程式化发音,通用语音或流行演唱对齐模型难以给出准确边界,同时每个音节的传统读音属性难以直接检索。论文构建了昆曲语料(KunSet),输入是 281 个折子录像及其视频文字与音频,输出是句子与音节的起止时间、演唱或念白方式、角色信息,以及每个音节链接到《韵学骊珠》的候选读音属性。处理过程先用视频文字识别与人声分离得到句子初稿,再用迭代微调的演唱对齐模型生成音节边界初稿,200 多名标注员在可缩放时间轴系统上修正并经过两轮审核,同时专家转写的音韵库为每个汉字提供候选属性。方法与已有句子级昆曲库的区别在于音节级对齐与音韵链接同时可用,与通用对齐模型的区别在于增加了声学锚点解码与昆曲全量微调。在 10 个测试录像的 11735 个内部音节边界上,251 个录像微调模型加锚点解码的平均边界误差为 194.83 ms,200 ms 容差准确率为 81.69%,优于预训练基线。结论适用于昆曲唱念混合录像的音节分析与同韵检索,演唱对齐仍弱于人工一致性,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/Kunyuan-Project/KunSet — 链接可访问(HTTP 200)
模型相关资源:https://github.com/Kunyuan-Project/KunSet — 链接可访问(HTTP 200)
第三方资源:https://tinyurl.com/kunset-icassp-demo → https://xiqu-annotation-system.vercel.app/demo/icassp — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. 合奏里被盖住的钢琴音头:用相位变化把它找回来

英文题目:Phase-Based Onset Enhancement for Piano Transcription in Ensemble Settings
评分:7.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hyemi Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiyun Park:机构信息未能在本次解析中与作者逐人可靠绑定
- Juhan Nam:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是合奏中的钢琴转录,输入是钢琴与弦乐或管弦乐队混合后的录音,输出是88个琴键的音符起始、结束、音高、力度以及双踏板事件。困难在于响亮乐器长时间占据相同频带的幅度能量,弱钢琴起始在对数梅尔频谱图上几乎不可见,同音高与泛音重叠时更难区分。第一步将混合音频的对数梅尔频谱图送入Transkun编码器,对全部候选时间区间打分,给出每个区间作为音符事件的似然与力度等属性。第二步对同一混合音频做短时傅里叶变换,计算帧间相位差并以幅度加权得到显著性,再经起始预测头输出每帧每音高的起始概率,该概率只对琴键起始位置敏感。第三步把相位起始概率按区间位置折算为加性区间偏置,与第一步的区间打分相加,再由半马尔可夫条件随机场解码为互不重叠的音符区间序列。与只用幅度的已有转录方法差异在于新增了相位差与幅度加权的显著性计算和只增强琴键起始的加性区间偏置,实际意义是找回被掩蔽的弱起始。在MAESTRO v2 Trio子集上音符起始F1-score为94.69%,高于同训练条件下基线Transkun的93.61%,在PCD-K上音符起始F1-score为90.46%,高于基线的87.93%。结论适用于古典三重奏与协奏曲这类强持续音掩蔽场景,踏板与力度在分布偏移下仍不稳定;训练成本为单张NVIDIA RTX 4090上批量大小8迭代500K约6天,原文未披露推理时延与部署成本。
🔗 开源资源
数据相关资源:https://zenodo.org/records/21528883 — 链接可访问(HTTP 200)
第三方资源:https://audiolabs-erlangen.de/resources/MIR/PCD — 链接可访问(HTTP 200)
第三方资源:https://github.com/yujia-yan/transkun — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/spaces/mimbres/YourMT3 — 链接可访问(HTTP 200)
第三方资源:https://www.halleonard.com/series/MMONE — 链接可访问(HTTP 200)
第三方资源:https://imslp.org/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. 双参考闭环引导如何控制跨语言克隆的口音

英文题目:Closed-Loop Dual-Reference Guidance for Accent Control in Cross-Lingual Voice Cloning
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuanzhong Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Wei Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ming Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Kailun Jin:机构信息未能在本次解析中与作者逐人可靠绑定
- Youhai Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
跨语言零样本语音克隆的输入是目标语言文本加一段源语言参考语音,输出是目标语言语音,难点是参考同时携带音色与发音习惯,直接克隆会把源语言口音带入目标语言。论文先离线为每名说话人构造可复用母语锚点:把母语donor向源参考音色做零样本语音转换,以与源参考的平均相似度选优保留,选出的锚点与原文参考一起进入推理。推理时目标文本与各自参考的局部编码特征联合预填充,分别初始化原文与锚点两路语言模型状态并给出扩散变换器条件,两路速度场在同一流匹配隐变量上求值再按权重混合解出声学块。每解出一块就把该块编码回送给两个状态,使其沿已播出历史共同推进而保留各自参考上下文,再用于下一块的求解。与已有训练期解耦和每句都做合成后转换的做法不同,该方法冻结合成模型、无需双语平行数据,锚点只在注册时转换一次。相对两个分支独立推进的做法,共同回送在开发集上把词错率从0.139降到0.004并把发音评分从3.524抬到4.791。在held-out法语测试上,所选权重把残留法语语言识别质量从0.093降到0.025,代价是ECAPA相似度下降0.042。结论限于英语目标、依赖Seed-VC锚点质量且权重固定不随块变化,法语选定的0.33未经重调转至西班牙语仍有效,但其他目标语言与逐块自适应权重尚未验证;在线合成相对每句转换的级联约快26%,锚点成本在约6句后被摊平。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. 把脉冲当作可训练接口:三值门控滤波与共振发放如何分工做语音识别

评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Pavlos Poulos:机构信息未能在本次解析中与作者逐人可靠绑定
- Katelyn Sadorf:机构信息未能在本次解析中与作者逐人可靠绑定
- Themos Stafylakis:机构信息未能在本次解析中与作者逐人可靠绑定
- Costas A. Anastassiou:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
研究对象是从连续语音波形到文字序列的映射,困难在于静音和音素边界切断上下文,而常用的带衰减发放机制在承担特征提取的同时还要保持长程依赖,容易丢失跨停顿信息,同时密集矩阵乘法带来能量和存储代价。论文的处理过程是把对数梅尔滤波器组特征降采样为低帧率二进制脉冲,再用门控循环做时间滤波,最后用共振发放神经元输出二进制脉冲给下一块,解码直接用联结时序分类(Connectionist Temporal Classification,CTC)线性读出。门控循环单元(Gated Recurrent Unit,GRU)在这里指带更新门和候选状态的循环滤波结构,三值权重(Ternary Weight)指仅取三种离散值的学习权重,延迟缩放(Deferred Scaling)指先用加减法累加三值结果再乘权重尺度,共振发放(Resonate-and-Fire,RF)神经元指带复数衰减和振荡频率的发放模型。输入脉冲先经深度可分离时间卷积做局部声学滤波,进入三值门控循环保留长上下文,再经开关门控前馈混合通道并与残差相加,最后作为电流驱动并行共振发放积分并发放二进制脉冲。与已有脉冲语音系统保留连续浮点解码器不同,该设计把二进制事件流作为训练期约束;与三值循环语言模型保留连续激活不同,该设计在训练中直接学习离散事件接口。在LibriSpeech-960的test-clean无外部语言模型条件下以词错率(Word Error Rate,WER)为指标,大型模型以6.44±0.17%低于小型模型的8.09%,对应建模的运算能量率约为3.42 mJ/s,结论适用于无外部语言模型的独立声学模型条件。原文承认能量为解析估算而非实测,训练仍需全精度影子权重,且test-other上性能明显弱于test-clean。
🔗 开源资源
- 第三方资源:https://www.openslr.org/11/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. GRPO 如何改善 51 种非洲语言的语音识别

评分:7.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Tim Wenjie Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Evelyn Nafula Ouma:机构信息未能在本次解析中与作者逐人可靠绑定
- Benjamin Akera:机构信息未能在本次解析中与作者逐人可靠绑定
- John A. Quinn:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
要理解的工作对象是自回归语音识别,输入是语音波形,输出是文字转写。模型训练时逐词看到正确历史,推理时只能依据自己已生成的词继续生成,一旦走错就难以恢复,这种训练与推理的不一致是暴露偏置。论文先对Whisper-large-v3做全参数监督微调,再冻结编码器,只对解码器做组相对策略优化。每个训练语音片段采样十个完整转写,用字符错误率的负值计分,经组内均值和标准差归一化得到优势,再向优势为正的转写移动概率质量。训练数据按典型采样与最优采样的字符错误率差距筛选有提升空间的片段,每批用覆盖多语言的六十四个不同片段联合更新,避免小批量偏向个别语言。在AfriVox-v2十四个语言评测中,SunflowerASR以0.227的宏平均词错误率低于已发表基线Sahara-v2的0.238,为已发表最佳。在SimbaBench十九种语言评测中,SunflowerASR以0.372的总体词错误率低于次优已发表基线OmniASR LLM-7B的0.379,为已发表最佳,但各语言排名有起伏,并非每种语言均为最优。增益在训练数据稀缺语言和带噪音频下更明显并随噪声加重而增大,若一组转写全对或全错则优势为零而无梯度,结论仅在五十一种非洲语言的该模型上验证,其他架构与语言尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 模型相关资源:https://hf.co/Sunbird/SunflowerASR-51-african-languages → https://huggingface.co/Sunbird/SunflowerASR-51-african-languages — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. PerMix:用混合样本的扰动比例预测做异常声音检测
英文题目:PerMix: Anomalous sound detection by predicting the perturbation ratio of mixed samples
评分:7.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jihoon Choi:机构信息未能在本次解析中与作者逐人可靠绑定
- Jung-Woo Choi:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
异常声音检测的输入是机器运行声音,输出是正常与异常的判断分数,难点是训练时只有正常样本,而异常常是靠近类别边界的微小偏离。论文把小批量内多样本混合得到的样本看作对锚样本所在类别的扰动,模型需要估计主导类别被扰动的程度。训练时混合波形送入编码器得到归一化嵌入,再计算与各类别权重向量的夹角,主导类别的对数输出在带间隔余弦与普通余弦之间按主导比例加权。对数输出经softmax得到主导类别概率,用二元交叉熵向真实主导比例回归,同时用主导类别相同的混合样本做监督对比学习拉紧正常分布。推理时用测试嵌入与正常记忆库的最小余弦距离作为异常分数。与已有方法的区别是不再固定监督为混合前第一样本标签,也不再使用固定角度间隔。在骨干、训练配置与KNN打分相同的DCASE 2020 Task 2开发集比较中,BEATs骨干的PerMix平均AUC为96.56%,平均pAUC为92.41%,超过同配置OS-SCL约1.93和3.49个百分点。结论适用于以机器类型与机器编号组合为类别的闭集分类式自监督训练,在DCASE 2022带域偏移数据上的泛化只报告了谐波均值,细粒度失效条件仍需核查。在相同BEATs骨干上按每轮训练时间比较,混合多样本使训练时间比ArcFace增加约3.3%,原文未披露推理延迟与部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/kaistss/PerMix — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. 缺模态下多标签情感识别:MERP 如何用固定隐空间保住每个类别的证据

英文题目:MERP: A Latent-Bottleneck Framework for Robust Multi-Modal Multi-Label Emotion Recognition
评分:7.4/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chuangxin Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Meimei Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Canran Xiao:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiachen Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiajun He:机构信息未能在本次解析中与作者逐人可靠绑定
- Kaijie Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Huy Phan:机构信息未能在本次解析中与作者逐人可靠绑定
- Tomoki Toda:机构信息未能在本次解析中与作者逐人可靠绑定
- Biörn W. Schuller:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一个话语同时带有多种情绪标签,输入是文本、视觉和声学三路特征序列,输出是 6 个情绪类别各自的二值判断。困难在于训练时三路都完整,测试时可能缺一路或两路,缺失位置的无效内容会在深层融合中污染幸存证据,且不同情绪受影响程度不同。处理过程是把可用证据先压缩到固定大小的隐变量库,再在隐空间做深层推理,随后按类别取出证据并融合多个分支的预测。文本序列与声学序列等先对齐到同一宽度并做门控,再拼成联合序列;可学习的隐查询通过交叉注意力得到低层隐表示,自注意力得到高层隐表示;类别读出向量在低层和高层分别加权池化得到类别特征,重构损失约束两者一致;正负类原型和频谱噪声门控增强特征,置信度加权的类别融合给出最终概率。与已有方法的区别是不补全缺失流,也不给每路模态打统一可靠性分,而是在压缩后保护类别级证据。在 20% 测试时随机缺失下,CMU-MOSEI 微平均 F1 为 0.563,M3ED 为 0.780,分别超过该数据集上最强的已评测基线 0.004(LDDU)和 0.005(AMP),音频独留的极端组合下仍保留 0.473,而 LDDU 降至 0.022。结论适用于补零模拟缺失和阈值为 0.25 的评测条件,真实采集缺失和阈值迁移效果尚未验证。原文披露推理成本为 CMU-MOSEI 上 5.28M 参数和 5.28ms 单样本延迟。
🔗 开源资源
- 代码相关资源:https://github.com/Creative-zcx/MERP — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. Qwen-Audio-3.1-ASR:从语音转写到说话人与音频理解

评分:7.3/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.4/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Chuanmeng Bian:机构信息未能在本次解析中与作者逐人可靠绑定
- Daren Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Peixin Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhigao Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Chong Deng:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhiyun Fan:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhifu Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Bo Gong:机构信息未能在本次解析中与作者逐人可靠绑定
- Qing Gu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiajun He:机构信息未能在本次解析中与作者逐人可靠绑定
- Yawei Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunjie Ji:机构信息未能在本次解析中与作者逐人可靠绑定
- Wei Ju:机构信息未能在本次解析中与作者逐人可靠绑定
- Jingbei Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiangang Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xu Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zengxi Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zheng Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Chengdong Liang:机构信息未能在本次解析中与作者逐人可靠绑定
- Baiji Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yaming Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ying Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Bin Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Yiping Peng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuezhang Peng:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhendong Peng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Pu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yang Shi:机构信息未能在本次解析中与作者逐人可靠绑定
- Xin Shu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jian Tang:机构信息未能在本次解析中与作者逐人可靠绑定
- Biao Tian:机构信息未能在本次解析中与作者逐人可靠绑定
- Peiyao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tianzi Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Wen Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Wupeng Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Cheng Wen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuzhong Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zijian Xia:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunchong Xiao:机构信息未能在本次解析中与作者逐人可靠绑定
- Nan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jianwei Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jixing Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Binbin Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Lei Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Sitong Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Guangdong Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuan Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Jianheng Zhuo:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一段可能含多说话人、方言、噪声和音乐环境声的录音,困难在于既要写对文字,又要分清谁在何时说话,还要回答录音中超出文字的声学问题,处理过程是把波形变成声学表示后再按任务指令生成不同形式的文本。Qwen-Audio-3.1-ASR 家族沿用音频编码器加适配器加语言模型解码器的结构,输入波形经编码器和适配器得到音频嵌入,解码器同时看到音频嵌入、任务指令和可选文本条件,输出转写、带说话人标签和时间戳的结构化记录或音频描述与答案。训练按音频编码器预训练、音频语言模型预训练、冷却适配、有监督微调、强化学习和在策略蒸馏六个阶段推进,冻结与更新的对象在各阶段不同,部署按文件转写、流式、交互语音、非流式和增强理解划分能力,流式不支持说话人分离与通用理解。相对上一代 Qwen-Audio-3.0-ASR 的差异是新增说话人分离转写和 Next 变体的通用音频理解,并保留历史上下文、分层热词和单遍润色等控制。在包含 7 个东亚与东南亚语言的 GigaSpeechBench 子集上,Qwen-Audio-3.1-ASR 的无加权宏平均错误率为 15.09%,低于上一代的 22.50%,且 7 个语言均为该表最低。结论适用于报告所列的公开与内部评测条件,重叠语音、远场噪声和低资源方言仍可能出错,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://huggingface.co/openai/whisper-large-v3 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. StyleStream 2.0:又快又能用文字控制的流式声音风格转换

英文题目:StyleStream 2.0: Fast and Controllable Streaming Voice Style Conversion
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Yisi Liu:University of California, Berkeley
- Nicholas Lee:University of California, Berkeley
- Gopala K. Anumanchipalli:University of California, Berkeley
📌 核心摘要
读者需要理解的对象是流式语音风格转换,输入是一段源语音,输出是保留语言内容但换成目标音色、口音和情绪的语音,困难在于分块推理时上下文短、边界易断裂,且以往只能用参考音频指定风格。解耦器从源语音提取去风格的内容特征,该特征一方面与目标风格嵌入拼接成条件,另一方面与噪声一起拼入风格化器的输入。目标风格嵌入或来自参考音频的编码,或由语音控制器在嵌入空间根据文本一次生成后供各块复用,用于文本设计新风格或按指令修改单属性。风格化器将噪声、内容特征与已生成历史经去输出通道回流拼接后一起处理,输出当前块梅尔谱,再由因果声码器变成波形,回流的历史用于衔接块边界。相对StyleStream 1.0,关键差异是少步像素平均流风格化器加自回归微调,以及去掉梅尔上下文、只用紧凑嵌入承载风格。在参考条件评测中,离线StyleStream 2.0以4步采样取得说话人相似度0.879和口音相似度0.705,高于16步的StyleStream 1.0的0.869和0.699。在RTX 4060上300 ms块与80 ms前视下端到端延迟为520.7 ms,约为StyleStream 1.0的2倍快。结论适用于英语整体风格转换、年龄性别口音情绪四属性的文本设计与编辑,情感编辑与非目标属性漂移尚未解决;原文披露声码器在每300 ms块约占3.139 ms,风格化器训练用8张H100训练1M步,自回归微调用32张H100训练400k步。
🔗 开源资源
第三方资源:https://huggingface.co/datasets/amphion/Emilia — 链接可访问(HTTP 200)
第三方资源:https://github.com/WangHelin1997/CapSpeech — 链接可访问(HTTP 200)
第三方资源:https://hltsingapore.github.io/ESD/download.html — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/MushanW/GLOBE — 链接可访问(HTTP 200)
第三方资源:https://www.openslr.org/60/ — 链接可访问(HTTP 200)
第三方资源:https://zenodo.org/records/1188976 — 链接可访问(HTTP 200)
第三方资源:https://psi.engr.tamu.edu/l2-arctic-corpus/ — 链接可访问(HTTP 200)
第三方资源:https://berkeley-speech-group.github.io/StyleStream2.0 → https://berkeley-speech-group.github.io/StyleStream2.0/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/microsoft/wavlm-base-plus — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/microsoft/wavlm-large — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/facebook/hubert-large-ls960-ft — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/google/flan-t5-base — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. 用学到的“小节内时间坐标” 做钢琴录音到乐谱的转录

英文题目:A Learned Musical-Time Coordinate for Piano Audio-to-Score Transcription
评分:7.3/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.9/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Min-Hsing Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tsung-Ren Huang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
从钢琴录音恢复记谱符号的音频到记谱转录输入是含速度变化和演奏处理的音频,输出是用**kern衍生词表表示的音高、时值、拍号、调号和小节结构,难点是音符在小节中的节拍位置难以从绝对时间直接推断,而整曲转录还需在未知小节边界处切分拼接。系统先用冻结的hFT-Transformer提取每帧每音高特征,再经跨注意力压缩为每帧向量后分两路并行处理,一路由Conformer建模音乐内容,另一路由相位模型估计下拍相位,即每帧在一个记谱小节内的相对位置。音频侧和乐谱侧共用同一傅里叶特征映射把该相位变为向量,分别加入解码器交叉注意力键值和输入端,解码器据此自回归生成记谱词元。推理时由相位后验的过零点得到下拍边界并按多小节拼接整曲,与已有用外部节拍跟踪器提供节拍相位的爵士萨克斯转录方法不同,本文坐标与记谱联合训练且可反过来提供切分。在Syn整曲转录中,本文系统Fmeter为0.667、MV2H5为0.829,均高于用Beat This!切分的Piano-A2S对照的0.236和0.614,OMR-NED为61.8,低于对照的75.4,转录覆盖率100%高于对照的98%。结论适用于训练所覆盖的拍号和钢琴音色,在真实人演ASAP上的增益变小,原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/bloggerwang1217/MusicTimeA2S — 链接可访问(HTTP 200)
第三方资源:https://kern.ccarh.org/ — 暂时无法访问
第三方资源:https://musescore.com/hub/piano — 链接不可用(HTTP 403)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 一张日常录音如何变成贴合画面的说话声:HeyGen Voice 解读
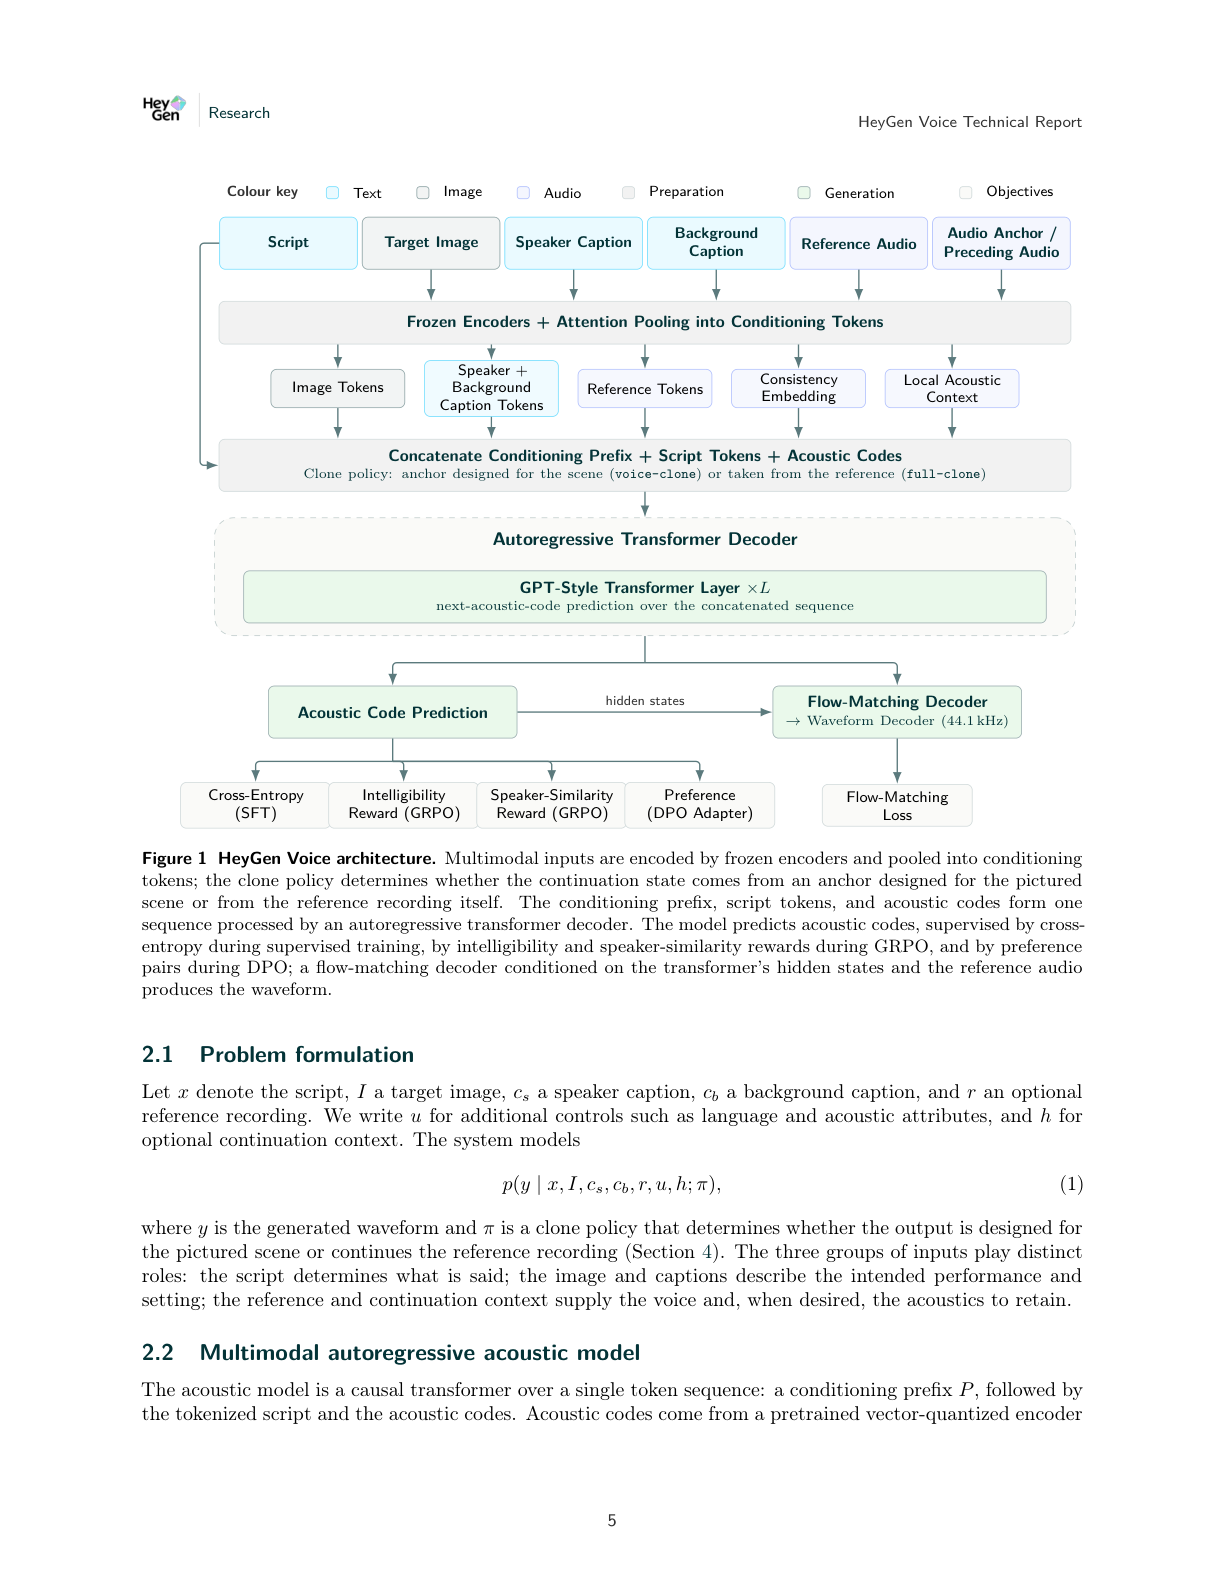
英文题目:HeyGen Voice: Scene-Aware Voice Cloning for Talking Videos
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Pavel Andreev:机构信息未能在本次解析中与作者逐人可靠绑定
- Andrei Gusev:机构信息未能在本次解析中与作者逐人可靠绑定
- Adithya Narayan:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi Ren:机构信息未能在本次解析中与作者逐人可靠绑定
- Ivan Somov:机构信息未能在本次解析中与作者逐人可靠绑定
- Zijian Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Sergey Demyanov:机构信息未能在本次解析中与作者逐人可靠绑定
- Viktor Goriachko:机构信息未能在本次解析中与作者逐人可靠绑定
- Alan Tan:机构信息未能在本次解析中与作者逐人可靠绑定
- Nik Nolte:机构信息未能在本次解析中与作者逐人可靠绑定
- Sam Prokopchuk:机构信息未能在本次解析中与作者逐人可靠绑定
- Andy Pan:机构信息未能在本次解析中与作者逐人可靠绑定
- David Chou:机构信息未能在本次解析中与作者逐人可靠绑定
- Kirill Leonov:机构信息未能在本次解析中与作者逐人可靠绑定
- Penghan Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiewei Yuan:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhibin Hong:机构信息未能在本次解析中与作者逐人可靠绑定
- Rong Yan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
配画语音应听起来像画面中的人在画面地点说话,但普通克隆把参考录音的话筒、房间和演绎一起搬运,任务要求保留参考中的音色口音,同时按目标图像重做演绎与混响并在长脚本中保持稳定。编码阶段将目标图像、说话人字幕(Speaker Caption,描述音色与演绎)、背景字幕(Background Caption,描述环境声与变化)与参考语音经冻结编码器加注意力池化压成固定长度条件前缀,该前缀与文本一起进入自回归变换器(Autoregressive Transformer,按顺序逐个预测离散声学编码的模型)。变换器输出的声学编码序列与其隐状态进入流匹配解码器(Flow Matching Decoder,学习连续潜空间速度场并积分生成波形的模块),结合参考音频渲染44.1 kHz波形,推理时由音频锚点导出的一致性嵌入加前文声学窗固定后续分块的嗓音与环境。相对已有描述控制合成、由脸推声、图像混响迁移和音视频联合生成的区别是既保留指定说话人又让声学跟随画面,并提供两种克隆策略调节贴近参考与贴近场景的程度。在2026年10月9日Artificial Analysis可控声音榜单快照的盲听成对投票Elo评分下,语音克隆设置以1201分居首,高于Qwen-Audio-3.1-TTS-Plus的1182分等商业系统。在生产环境用户克隆自有声音的盲选投票占比中,选择该模型而非ElevenLabs v4为62%、而非Cartesia Sonic 3.6为54%。在43人评价本人数字分身配画视频的视频评分(满分100)中,两种设置平均分76.1分和72.6分,高于Cartesia Sonic 3.6的63.1分、ElevenLabs v4的59.2分和Seedance 2.5的45.7分,结论适用于有目标图像与字幕的配画场景,长脚本一致性依赖锚点缓存,原文披露端到端实时率(Real-Time Factor,合成耗时与音频时长之比)为约0.1。
🔗 开源资源
- 第三方资源:https://heygen.com/heygen-voice → https://www.heygen.com/heygen-voice — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. MOSAIC:把全模态长期记忆拆成写、检、送、读四段来诊断

评分:7.2/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Hong Ting Tsang:机构信息未能在本次解析中与作者逐人可靠绑定
- Boyi Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Haoyu Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiaxin Bai:机构信息未能在本次解析中与作者逐人可靠绑定
- Yufei Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yisen Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhongwei Xie:机构信息未能在本次解析中与作者逐人可靠绑定
- Hongyu Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Jeff Z. Pan:机构信息未能在本次解析中与作者逐人可靠绑定
- Yangqiu Song:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要回答散布在多轮对话文字、图像、视频、音频中的记忆问题,难点是端到端分数无法说明证据在表示、检索、投递、读取哪个环节丢失。MOSAIC构造带空间、时间与韵律针对性信号的多会话历史,并区分窄化候选、选定实体与携带答案三类事实以支撑多跳串联。构造时先按题型与模态缺口设计推理链,再经删除测试生成对话与合成媒体并过滤出可答题与拒答对照。诊断时冻结同一读者、提示、打包器与评判者,只替换表示、检索结果或投递预算,形成配对比较。在包含923题中784个可答题的集合上用零到一语义评判分数比较固定读者下金色符号事实与原生证据,分数越高越好,前者0.846高于后者0.783,通用文本0.690低于检索后全量投递0.708,生产预算投递0.670低于前两者而最低。在视频挑战分层上用同一零到一语义评判分数比较固定读者的符号事实与原生视频,分数越高越好,前者0.900高于后者0.729,感知损耗大于图像与音频对照。结论适用于该冻结配置下的关联归因,视频感知、拒答校准与合成媒体质量仍是未解决范围。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/thunlp/UltraChat — 链接可访问(HTTP 200)
第三方资源:https://github.com/lm-sys/FastChat — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. OSynth:用带完整组织上下文的合成会议测长期理解

英文题目:OSynth: A Longitudinal, Context-Sensitive Evaluation of Meeting Understanding
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Ian Porada:机构信息未能在本次解析中与作者逐人可靠绑定
- Suraj Tripathi:机构信息未能在本次解析中与作者逐人可靠绑定
- Chaitanya Animesh:机构信息未能在本次解析中与作者逐人可靠绑定
- Leda Sari:机构信息未能在本次解析中与作者逐人可靠绑定
- Chaitanya Narisetty:机构信息未能在本次解析中与作者逐人可靠绑定
- Austin R. Matthews:机构信息未能在本次解析中与作者逐人可靠绑定
- Bohan Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ramesh L. Thulasiram:机构信息未能在本次解析中与作者逐人可靠绑定
- Gregory Sell:机构信息未能在本次解析中与作者逐人可靠绑定
- Kean Chin:机构信息未能在本次解析中与作者逐人可靠绑定
- Dmitriy Genzel:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
实际部署的会议记录面对的输入不止一段音频,还包括日历、历史会议、邮件、幻灯片和说话人注册音频,输出需要摘要、行动项和大纲等可用产物,难点是已有语料多为孤立会议且缺乏可核对的实体真值。OSynth 先抽样模拟组织的工作区隐状态,包含人物、项目、决策和待办,再由此派生会议与跨产物事件,最后渲染转写文本和多说话人音频,使每个可观测产物都能对照隐状态评分。转写初稿经过跨模型家族的对抗改写,用真实 AMI 片段作风格参照,打破干净叙事弧和完美交接。对 238 个会议的评测设置三种上下文,L1 只给单会音频,L2 增加系统自己对历史会议的输出,L3 再增加注册音频、名单、邮件和幻灯片,OpenAI 系统的数字召回率从 0.680 升至 0.883,行动项负责人准确率从 0.485 升至 0.690,跨会说话人一致率从 0.220 升至 0.476。结论适用于合成工作区内的相对比较,真实会议只在 8 个 AMI 会议上验证了忠实度方向一致,未验证数值可迁移。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/otter-ai/osynth — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. 把被淹没的声音找回来:从场景特征中提前分出每个声源
英文题目:Hear Every Sound Object: Rescuing Overlooked Sources in Auditory Scene Analysis
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Younghoo Kwon:机构信息未能从 arXiv PDF 文本可靠映射
- Yongjoon Lee:机构信息未能从 arXiv PDF 文本可靠映射
- Jung-Woo Choi:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
待处理的输入是包含至多5个同时发声目标的多通道混合录音,模型需要同时输出每个声源的波形、类别和到达方向,困难在于混合表示会被强势声源占据,弱势声源在深层几乎消失。论文先用居中核对齐(Centered Kernel Alignment,CKA)度量场景特征与各孤立声源参考表示的相似度,按相似度排出源内主导名次,发现名次与分离、定位和分类性能对应,且名次间差距在中间层较小、在最后一层拉大。针对这一现象,论文在场景骨干旁增加可插拔精炼结构PARASITE,从差距较小的第4、5层及末层切分出代表单个声源的对象特征,用逐对象门控融合(Object-wise Gated Fusion,OGF)融合相邻深度的同一对象,再用窗口化跨对象注意力(Windowed Cross-Object Attention,WCOA)在时间窗内交换对象间信息。与只在最后一层切分的DeepASA相比,DeepASA++把对象形成时机提前并逐层携带弱势源信息。在ASA2上与DeepASA-Loco相比,DeepASA++的SI-SDRi从13.88 dB提高到14.24 dB,SELD分数从0.176降低到0.147,其中弱势名次的提升更大。在STARSS23上与DeepASA-Loco相比,DeepASA++的SELD分数从0.257降低到0.240。结论适用于论文使用的合成混合与录制评测划分,对源数更多或混响更强的情形尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://sites.google.com/view/deepasapp/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. 工具给对了信息,模型为什么还是答错:推导深度暴露的音乐分析短板

英文题目:Derivation Depth Exposes Reasoning Failures in Tool-Augmented Music Analysis
评分:7.0/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Rupali Rajesh:机构信息未能在本次解析中与作者逐人可靠绑定
- Sethuraman T:机构信息未能在本次解析中与作者逐人可靠绑定
- Savya Khosla:机构信息未能在本次解析中与作者逐人可靠绑定
- Srinidhi Sunkara:机构信息未能在本次解析中与作者逐人可靠绑定
- Aditya Shanmugham:机构信息未能在本次解析中与作者逐人可靠绑定
- Rohan Maheshwari:机构信息未能在本次解析中与作者逐人可靠绑定
- Derek Hoiem:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
研究对象是带有音乐信息检索工具的音频问答系统,输入是音频和工具报告的文字测量,输出是对终止式、转调、调式、动机、曲式等问题的二选一判断,困难在于工具常只给中间测量而把最后一步推导留给模型。论文引入推导深度,即从工具测量到答案需要的推理步数,用同一音乐事实的不同文字包装控制信息量不变,只改变距离。方法上先用程序生成最小对立乐曲并渲染音频,再以六种报告格式和四级推导阶梯送入五个音频语言模型,配对计分要求对立两曲同时答对,对比无音频和有音频条件,并用知识单点提问和层内读出检验失败来源。相对已有只看最终准确率的工具评测,关键差异是分离了工具是否给对信息和模型是否会用信息。在转调推导阶梯无音频条件的配对准确率比较中(n=72),三个开放模型在结论直述d0时均为100%,只给新调名d1时为57%-81%低于d0,给转调和弦d2时为0%-26%进一步低于d1。结论适用于当前五模型和所测五任务,音频补充、真实librosa输出和GuitarSet实录均未消除差距,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. MixAgent:按工程师流程分层规划与修正的多轨混音智能体

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Jaywon Koo:机构信息未能在本次解析中与作者逐人可靠绑定
- Junghyun Koo:机构信息未能在本次解析中与作者逐人可靠绑定
- Marco A. Martinez-Ramirez:机构信息未能在本次解析中与作者逐人可靠绑定
- Wei-Hsiang Liao:机构信息未能在本次解析中与作者逐人可靠绑定
- Seungheon Doh:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiyu Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Vicente Ordonez:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuki Mitsufuji:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
混音是把鼓、人声、贝斯等多条未处理录音先逐轨处理,再把相关音轨合并到子组处理,最后在总线汇总成成品,难点在于目标音色难用语言说清,且音量、均衡、压缩、混响等音频效果的开关、顺序与数值互相牵制。分组智能体听录音并看乐器标签,把相关音轨送入同一子组,其输出的子组划分进入规划智能体。规划智能体参照检索示例,依次为音轨、子组和总线选择并排序效果器链,并按参考歌曲设定初始数值。检测器判断哪个部件需要修正,修正评论模型给出数值修正并自下而上渲染,与只预测效果器链或直接生成音频的方法不同,全程保留可编辑的效果器名和参数值。为训练修正环节,作者用拟合专业混音得到的参数制造损坏状态并配对修复意见,构建MixCritic数据集。在由17首歌的20个保留片段组成的MedleyDB评测中,MixAgent的多尺度频谱误差MSS越低越好为2.83,低于单次GPT-4o-audio的3.67,而在AlbumDB评测中其MSS为3.81,高于带自修正的GPT-4o-audio的3.77,结论随数据集而变。该结论只在以单一专业混音为目标的重建误差下成立,小样本与拟合参数近似也限制其推广,且原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/SonyResearch/Agentic_Music_Post-Production — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
20. 用脑电做线索,在音频编解码隐空间里直接生成目标说话人语音

英文题目:NeuroCodec: EEG-Guided Latent-Domain Generative Model for High-Fidelity Target Speaker Extraction
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Julian Silva:机构信息未能在本次解析中与作者逐人可靠绑定
- Jaliya Kodithuwakku:机构信息未能在本次解析中与作者逐人可靠绑定
- Navindu Sirimanna:机构信息未能在本次解析中与作者逐人可靠绑定
- Shaveen Herath:机构信息未能在本次解析中与作者逐人可靠绑定
- Wageesha N. Manamperi:机构信息未能在本次解析中与作者逐人可靠绑定
- Joshua P. Kulasingham:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是多人同时说话的混合语音与听者的脑电信号,困难在于从脑电判断听者在注意谁,再把该人的声音完整取出,处理过程是把混合语音和脑电对齐融合后重建目标波形。以往用时频掩码抑制干扰的方法在频谱重叠区容易漏入干扰人声,且输出带宽受限,听感沉闷。NeuroCodec(神经编解码目标说话人提取框架)把混合波形送入冻结的描述音频编解码器(Descript Audio Codec,DAC)编码器得到低帧率隐表示,再用脑电编码器提取空间与时间特征。跨模态选择性状态空间块(Cross-Modal Selective State Space Block,CM-S3)以语音为查询、脑电为键值做交叉注意力,并用 Mamba 建模长时依赖,输出的目标隐表示经残差向量量化后由冻结 DAC 解码器合成波形。与掩码式基线不同,该框架直接生成目标隐表示,并用六阶段课程逐步引入频谱与对抗目标。在鸡尾酒会(Cocktail Party)数据集受试者无关划分下,NeuroCodec 相对 M3ANet 的短时客观可懂度(Short-Time Objective Intelligibility,STOI,越高越好)从 0.812 提高到 0.827,语音质量感知评估(Perceptual Evaluation of Speech Quality,PESQ,越高越好)从 2.23 提高到 2.31,且支持 44.1 kHz 重建。结论适用于离线与所定义的流式窗口条件,在线扩展的实时系数在单卡上测得,嵌入式助听硬件上的功耗与延迟尚未验证。原文未披露训练时长、优化器与批量大小等完整训练配置。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. MixJudge:能用语言追问的人声混音评价者

英文题目:MixJudge: Learning a Language-Queryable Critic for Vocal Mixing
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kuan-Hsun Ho:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuan-Chiao Cheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yen-Tung Yeh:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi-Hsuan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
人声混音需要判断混音相对伴奏是否过响、沉闷或混响过大,难点在于缺乏同一素材的多版本实现与专业标注,通用音频语言模型只给整体建议,无法按问题与严重程度稳定打分。MixJudge对同一片段同时接收人声、伴奏、两者混合及一句指明待判问题的文本,CLAP音频与文本编码器分别将其映射为声部特征与问题嵌入,再叠加可学习的角色嵌入以区分声部来源,输出带角色标记的声部特征与问题嵌入。关系融合网络把三路带标记特征及其与伴奏的差值特征拼接并映射为状态嵌入,再与问题嵌入求余弦相似度得到该问题存在的证据值,该证据值成为训练校准与推理比较的直接对象。训练把同一片段的干净状态与不同配方、严重程度版本编为严重程度组与比较组,用状态匹配损失学音频文本对应,以排序损失约束证据随严重程度递增,以问题选择性与反义问题损失增强问题区分,校准后的证据函数被送入推理比较。推理时对同一混音的不同处理版本计算同一组问题相对干净描述的证据,以均值或最大证据策略选出证据最低者以比较优劣。在基于MedleyDB歌曲构建的4557个合成样本的评论者考试严重程度排序中,适配版MixJudge的严重程度相关系数ρsev为0.971,高于冻结CLAP的0.331。结论只适用于单声道人声加伴奏总和的受控设置,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
22. 三模态互相消歧:TRIAD 如何检验文本图像音频联合理解

英文题目:TRIAD: Benchmarking Omni-Modal Ambiguity in Multimodal Large Language Models
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Zhaolu Kang:Hunyuan, Tencent;Peking University
- Yidi Wang:Peking University
- Yile Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Siqi Zeng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yingjie He:机构信息未能在本次解析中与作者逐人可靠绑定
- Richeng Xuan:Hunyuan, Tencent
- Zhichao hu:Hunyuan, Tencent
📌 核心摘要
待解对象是文本-图像-音频三元组配问题与选项,难点在于任一单通道都对应多个合理解读,只有三通道联合才锁定唯一答案。构建先为每题标注文本、图像、音频各自的含混类型,输出类型标签决定后续检验的消歧维度。以上一步的标注题为输入,五人小组逐题遮蔽任一通道,若剩余线索下一致选项不再唯一则保留,否则剔除,从而筛出满足三通道互消歧的三元组。以筛出的三元组为基础,固定核心场景与选项语义、只扰动一个通道生成姐妹题,再把姐妹题组成场景组并以组内全对的组准确率计分,迫使模型跟随变化线索更新答案。与已有视觉含混或图文消歧工作相比,差异在于把音频的韵律、说话人、语音形式、环境声和非言语符号纳入同一框架,新增的音频维度与组准确率共同检验跨通道一致性。最佳模型Gemini 3.1 Pro在完整三元组标准选择题下组准确率为71.2%,低于人类参考的91.6%,而单题准确率90.4%与人类的95.1%接近,说明局部答对不等于场景级稳定消歧。结论只适用于该327题基准和所测提示与输入条件,去掉选项后模型组准确率跌到个位数,人类仍保持稳健。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
23. 能解码不等于能控制:连续隐变量语音合成中的局部说话人控制

英文题目:Decodability Is Not Controllability: Local and Anisotropic Speaker Control in Continuous-Latent TTS
评分:6.9/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuanzhong Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Wei Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ming Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Kailun Jin:机构信息未能在本次解析中与作者逐人可靠绑定
- Youhai Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
提示条件语音合成需由参考音频决定说话人身份,难点在于隐状态能线性读出身份不代表改写该状态就能改变合成声音,故须同时检验编辑方向与位置能否经计算通路送入声学合成。VoxCPM2先把参考波形编为音频嵌入并与文本交错送入残差声学语言模型,干预在预填充第0步改写块后隐状态,早期块的改动经后续块及其键值缓存传播至末位置读出以条件化声学合成,而L7参考音频编辑已越过最后混合块。配对对齐方向先对目标状态做长度对齐再减去源状态得到编辑向量,所有方向与位置对照共享参考音频对齐范数做等范数比较,以区分目标吸引与声学破坏。读出可达性解释早期编辑为何能影响最终合成条件,相对已有按探针选址或做无对照属性转向的做法,关键差异是同时要求几何特异性与送达合成的计算通路。在由30个LibriTTS-R说话人组成的60个有向对上以ECAPA-TDNN计目标相似度增益ΔSIM_B,L0参考音频对齐编辑为+0.326而L7为0.000,前者高于后者,目标占优计数分别为60/60与0/60。dots.tts对照显示主干编辑只推移源声音而无目标吸引,x-vector消融使源相似度由0.849降至0.006,双盲听辨亦偏好早期对齐语音。结论只适用于所测层、位置和范数范围,早期对齐编辑保持可懂度和自然度但未做大规模部署测试,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
24. 用示例校准大语言模型来预测音乐的效价与唤醒度

评分:6.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chi-En Dai:机构信息未能在本次解析中与作者逐人可靠绑定
- Chih-Pin Tan:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi-Hsuan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文预测音乐引发的感知情绪,用效价表示情绪正负、唤醒度表示情绪能量,难点在于效价抽象且依赖语境,直接从音频回归或零样本提问都容易严重失效。紧凑音频基础模型先对输入音频给出初始效价-唤醒度估计,大语言模型再依据若干带标签示范预测修正量并加回初始值,形成两阶段推理时修正。文本方式以Whisper转写的歌词与Qwen2-Audio生成的自动音频描述代替声音,多模态方式直接输入原始音频,两种方式都冻结大模型权重,只在推理时组织提示。相对已有直接回归与零样本提问,关键差异是不让大模型猜绝对分数,只学纠正小模型偏差,从而把上下文对齐负担转到残差估计上。在以CH818作训练与示范、整个MER60作留出测试的设置下,文本方式效价决定系数R²_V从基础模型的0.110提升到80示范GPT-5时的0.427。同样以CH818作示范、整个MER60作测试的设置下,多模态方式效价决定系数R²_V从零样本Qwen3-Omni 30B的0.037提高到10示范时的0.346。该跨数据集推理时修正结论受限于仅60首的MER60测试规模,且多模态方式效价决定系数R²_V在超过10示范后回落,原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/DCN2001/MusicEmotionModeling — 链接可访问(HTTP 200)
模型相关资源:https://github.com/DCN2001/MusicEmotionModeling — 链接可访问(HTTP 200)
第三方资源:https://github.com/DCN2001/MusicEmotionModeling — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
25. 时间同步端到端语音识别还要做多大的搜索空间

评分:6.6/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Simon Berger:机构信息未能在本次解析中与作者逐人可靠绑定
- Larissa Kleppel:机构信息未能在本次解析中与作者逐人可靠绑定
- Ralf Schlüter:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
自动语音识别(Automatic Speech Recognition,ASR)需要把声学编码器输出的帧序列映射为文字序列,难点在于对齐路径数量庞大,且模型在多数时刻很确定、只在少数困难片段出现大量竞争假设。论文在无词典开放词表搜索和有词典约束的树搜索两种流程中,比较固定保留固定数量假设的最大束剪枝与按得分差距保留假设的得分剪枝,并组合子词级与词级外部语言模型。时间同步搜索按帧推进:先用声学模型得分扩展当前假设并做声学阶段剪枝,其保留的扩展结果再送入可选的子词级语言模型重打分并再次剪枝。在词典约束下假设沿词汇前缀树延伸,只在到达词尾时才调用词级语言模型更新词历史并回到树根,随后经假设重组与束剪枝得到下一帧的保留集合,得分剪枝能随不确定性自动扩大或缩小该集合。同一话语的多数搜索步只需很少假设,困难区会出现短暂高峰。LibriSpeech 上带词级 Transformer LM(Transformer Language Model,Trafo)的字节对编码(Byte-Pair Encoding,BPE)转换器经词典约束搜索达到 dev-other 3.8% 与 test-other 4.2% WER,同样精度下动态剪枝把搜索 RTF 相对固定束降低 94.6%。结论适用于时间同步的 CTC 与单调转换器搜索,对标签同步与流式搜索尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/rwth-i6/rasr — 链接可访问(HTTP 200)
第三方资源:https://github.com/rwth-i6/returnn-experiments/tree/master/2026-search-space — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
26. 长视频里谁在何时说了什么:多语多说话人转写的基准与瓶颈

评分:6.5/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yuan Ge:机构信息未能在本次解析中与作者逐人可靠绑定
- Pei Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xize Cheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Lingzhou Mu:机构信息未能在本次解析中与作者逐人可靠绑定
- Mingyang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jin Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Baosong Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Shengxiang Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Jingbo Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhengtao Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Tong Xiao:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一段多人说话的长视频,模型要同时回答谁在说、每句话从何时到何时、说了什么,输出是带说话人编号和起止时间的结构化转写。困难在于语音时长可达 30 分钟,说话人音色相近还会有重叠,时间边界差半秒就会在带时间约束的指标下判错。处理过程是把长视频切成不切断话语的小段,逐段做说话人区分和转写,再把各段的局部编号合并成全片统一编号,最后由语言专家对照视频修正。相对已有会议语料和短对话基准,关键差异是覆盖西班牙语、法语、日语、韩语、俄语和泰语六种语言,提供平行的纯音频和音视频两种输入,并按时长和说话人数分层。在六语言 297 个实例上,任务专用模型 MOSS Transcribe Diarize 0.9B 在多数语言的时间敏感指标上仍领先通用全模态大语言模型,例如泰语上其 tcpWER 为 0.929 而多个通用模型超过 1.1。结论适用于评测当前全模态大语言模型的细粒度时间定位和多人区分能力,不适用于证明某模型在所有真实场景最优,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/QwenLM/Omnilingua-Bench/tree/main/Omnilingua-MSpeaker — 链接可访问(HTTP 200)
第三方资源:https://creativecommons.org/licenses/by-nc/4.0/legalcode.en — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
27. Spark-Audio 1.0:用更少音频数据做多语种听懂与对话

评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Chenyue Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Cong Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Dingshu Tian:机构信息未能在本次解析中与作者逐人可靠绑定
- Dong Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Genshun Wan:机构信息未能在本次解析中与作者逐人可靠绑定
- Guanming Meng:机构信息未能在本次解析中与作者逐人可靠绑定
- Guolong Zhong:机构信息未能在本次解析中与作者逐人可靠绑定
- Hang Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Hankun Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Haoming Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Haoyang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Hengquan Mei:机构信息未能在本次解析中与作者逐人可靠绑定
- Huaxin Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiahao Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiahuan Fan:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiamin Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Jianqing Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Jigang Tang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jin Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jingchen Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Jinjie Fu:机构信息未能在本次解析中与作者逐人可靠绑定
- Kaixuan Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Kun Song:机构信息未能在本次解析中与作者逐人可靠绑定
- Li Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Li Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Lijuan Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Liyan Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Ming Sheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Mingen Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Mingting Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ningqian Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Pan Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Pei Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiangyu Tan:机构信息未能在本次解析中与作者逐人可靠绑定
- Rui Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruzi Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Saier Jin:机构信息未能在本次解析中与作者逐人可靠绑定
- Shibo Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Shifu Xiong:机构信息未能在本次解析中与作者逐人可靠绑定
- Shihao Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tan Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Wei Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Wei Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenyu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiangyu Jia:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiao Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaowen Duan:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaoxue Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Xin Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Xinyi Liang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xu Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yanan Song:机构信息未能在本次解析中与作者逐人可靠绑定
- Yang Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yexia Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yibo Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yifan Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yikang Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yikun Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yiting Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi Fang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxin Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zan Feng:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhenchuan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhuo Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Zichao Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziwen Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
研究对象是输入语音与文本、输出文本的语音基础模型,难点在于长时多语音频理解与语言推理能力需同时保留。音频编码器沿用Whisper large-v3编码器结构,同一套参数通过注意力可见模式兼容流式与非流式计算。表示增强的BEST-RQ做掩码预测时,送入量化器的表征由低层声学特征改为冻结多语言识别教师深层语义表示,形成语义感知的离散目标。编码器再经转写语音的多语言识别适配,扩展到识别与副语言及声音事件的多任务文本目标训练,输出进入音频-语言模型。音频-语言模型先只训练适配器对齐,再全参数联合训练并做长上下文扩展,随后经监督微调与双轨在策略蒸馏优化。在FLEURS多语言识别评测的扩展组20语言子集上,以平均错误率衡量模型为6.30%,低于Qwen3.5-Omni-Flash的12.08%和Qwen3.5-Omni-Plus的6.65%。结论适用于报告的公开与自有评测,自有集优势可能与数据分布有关,更广语种识别与复杂推理仍不足,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://iflytekresearch.iflytek.com/experience/spark-audio — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
28. 钢琴小样如何扩展成流行伴奏:无对齐监督的 Piano2Pop 解读

英文题目:Piano2Pop: Expanding Piano Demos into Pop Productions Without Aligned Supervision
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yun-Chen Cheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Chih-Pin Tan:机构信息未能在本次解析中与作者逐人可靠绑定
- Tzu-Hung Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi-Hsuan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一段钢琴MIDI小样,目标是生成完整器乐流行制作,难点是两者时长、速度与结构不对齐而缺少配对监督。论文先从无配对流行器乐出发,用不限配对的MuScriptor转录或在翻弹配对上训练过的PiCoGen2编配生成伪钢琴MIDI,并配以音区密度增强与功能筛选转录,再把伪MIDI与原器乐组成时间对齐训练对。伪MIDI经残差一维卷积编码为帧对齐特征后,与生成掩码及噪声音频隐变量拼接送入预训练流匹配扩散变换器,生成音频隐变量并经波形VAE解码为波形,在隐变量空间与真实流行器乐比对以微调模型。推理时真实钢琴翻弹走同一编码生成解码链路,与保留钢琴原声的合成或伴奏补全不同,该任务要求把低音、鼓与主奏重新分配为流行配器。在476首真实配对每首五个30秒窗口的真实钢琴输入评测中,PiCo路线的Accompaniment Prompt Adherence为0.964高于FST的0.895,Fréchet Audio Distance为0.231低于FST的0.255,Level-Normalized Mel-Shape RMSE为1.044 dB低于FST的1.371 dB。结论只适用于固定长度片段与器乐流行范围,全曲结构与人声尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://www.youtube.com/@sing2piano — 链接可访问(HTTP 200)
第三方资源:https://www.youtube.com/@KaraoKeysPH — 链接可访问(HTTP 200)
第三方资源:https://hhhhaura.github.io/piano2pop → https://hhhhaura.github.io/piano2pop/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
29. 抹香鲸 coda 的节奏与频谱为什么要分开编码再融合

评分:6.3/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- João Victor Quintanilha:机构信息未能在本次解析中与作者逐人可靠绑定
- Emma Virnelli:机构信息未能在本次解析中与作者逐人可靠绑定
- Shuo Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是抹香鲸的 coda,即社交时交换的短促点击序列,任务是只看一段 coda 判断它来自哪个社会单元、属于哪种 coda 类型、由哪个个体发出。困难在于点击间隔决定的节奏本身就定义了类型标签,频谱纹理又与类型和录音环境耦合,样本只有 1,383 段干净 coda 且单元分布严重不均。处理过程是把每段 coda 表示成点击间隔序列与对数梅尔语谱图两路输入,分别编码成 64 维向量再融合成 64 维嵌入,最后冻结编码器只训练线性分类器来度量嵌入保留了多少任务信息。双通道对比编码器(Dual-Channel Contrastive Encoder,DCCE)用同一社会单元的不同 coda 组成正样本对做 NT-Xent 对比学习,可选在节奏分支加类型分类、在频谱分支加个体分类作为辅助损失。与已有方法的区别是 WhAM、AVES、BirdNET 从整段波形隐式学习表示,而 DCCE 把人工标注的点击间隔与语谱图显式分开并可单独做分支探针。在随机划分下 DCCE 结合单元配对与类型监督在单元、类型、个体三个任务的宏平均 F1(macro-F1,类别平均的 F1,越高越好)为 0.901、0.865、0.597,仍低于原始点击间隔在类型上的 0.987,也低于点击间隔加时域梅尔统计在个体上的 0.724。结论适用范围限于 Dominica EC1 部落的三个单元,按录音日期分组与按年留出时分数普遍下降,原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://dcce-research-site.vercel.app — 链接可访问(HTTP 200)
第三方资源:https://dcce-research-site.vercel.app — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
30. 音色藏在哪里:语音中说话人信息的定位解读

英文题目:Where Does Timbre Hide? Localizing Speaker Information in Speech Signals
评分:6.3/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yiquan Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Yixuan Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaozhe Qi:机构信息未能在本次解析中与作者逐人可靠绑定
- Xin Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Shihao Li:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
研究要定位生成语音中说话人相关音色信息藏在信号频带、结构与表示的何处,难点在于音色本身是感知量,而分类器可用的说话人可分性与人耳听感相似并不一致。频带过滤探针把普通话、英语、日语的朗读、情感和歌唱语音按低通、高通和固定频带切分,将切分后语音送入说话人确认嵌入余弦计算与梅尔多层感知机闭集分类,并用相同切分构建配对交由听众评分,得到机器与听感可对照的定位基准。承接该基准,相位与幅度随机化探针分离包络与相位作用并输出保留率对比,WORLD分解把基频与声道谱包络互换后比较保留率,自监督学习层探针和离散单元直方图探针再检查内容与编码表示是否残留说话人信息。在AISHELL-3听感对照中,同说话人低于8 kHz与高于8 kHz条件的平均语音音色相似评分在1–5量表上为4.45分与1.24分,前者高于后者,说明高频可分信息未转化为听感相似。在VCTK闭集频带检查中,梅尔多层感知机的说话人分类准确率在1–4 kHz为92.1%,在20–24 kHz为50.1%,前者高于后者,但高频仍高于随机与时长能量基线。幅度和声道谱包络保留更多说话人相似,浅层自监督学习特征与部分HuBERT和EnCodec令牌仍可分类说话人。结论适用于语音转换、说话人克隆、匿名化和编码器查漏,窄带高频刺激和闭集评测之外的泛化尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
31. 一个模型同时做语音修复和目标说话人提取:声学与语义如何分工

英文题目:XingChen-UniFE: A Unified Generative Speech Front-End via Complementary Acoustic-Semantic Modeling
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Kelan Kuang:机构信息未能在本次解析中与作者逐人可靠绑定
- Qihan Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jian Kang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jie Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yongxiang Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi Liu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要处理的输入是受噪声、混响、干扰说话人、削波、丢包、限带等污染的语音,输出是干净的目标语音,在有干扰说话人时还要按注册语音指定说话人,难点是严重退化下既要恢复声学细节又要保持语言内容和说话人正确。所提XingChen-UniFE把退化语音送入语义与声学并行的双流编码器,其中冻结自监督模型平均各层表征提供鲁棒语言线索,可学习分支从复数频谱经卷积与Conformer提取频谱细节,再经双向交叉注意力融合为条件表示。融合表示经线性适配器送入解码器式大音频语言模型,按任务控制符和注册语音条件自回归生成交错延迟排列的声学与语义离散单元,最后由神经编解码器解码为波形。与已有简单相加或拼接融合不同,该工作让两路表示互为查询键值显式交换信息,并保留复数频谱的频率轴与相位信息。在Libri2Mix去噪划分上,本文方法以2.137高于同条件复现的UniTok基线的2.100,指标为PESQ且越高越好。结论适用于仿真退化与所测未见编解码失真和风噪条件,跨真实采集与主观听感尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
32. COMET:让人能接管的 AI 泄漏监测框架

评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Niclas Flehmig:organization=Department of Mechanical and Industrial Engineering, Norwegian University of Science and Technology, city=Trondheim, country=Norway
- Mary Ann Lundteigen:机构信息未能在本次解析中与作者逐人可靠绑定
- Shen Yin:organization=Department of Cybernetics Engineering, Norwegian University of Science and Technology, city=Trondheim, country=Norway
📌 核心摘要
需要理解的对象是压缩空气泄漏声学监测中的人工智能系统,指分类模型加其运行时前后处理,困难是环境噪声变化、新泄漏类型和传感器故障会让分类器给出自信但错误的泄漏或无泄漏判断,而值班人员只看输出无法察觉。论文提出协调多层运行时监测框架,输入一段录音的波形与语谱图块,输出泄漏分类外加八种分类状态与四级红绿灯显示,供人监督处置。信号完整性层取原始波形窗按五条先验规则判信号是否有效,输出每规则二值标志,被判故障的文件直接进入覆盖状态并阻断后级模型与监测,避免在不可靠输入上计算。未被阻断的语谱图块并行送入后两层,物理一致性层检验声学形态是否符合已知泄漏物理,背景主导泄漏频带时经模板加权门转入弃权,特征空间层检验输入是否落在训练见过的能力包络内并输出偏移标志,承担语义偏移检出。协调层接收三层局部诊断与分类结果,融合后经通信层映射为固定分类与灯号,把孤立告警变成指向不同处置动作的诊断,区别在于各层按不同故障模式分权而非叠加强度。在开放压缩空气数据集响亮液压背景无泄漏文件评估中,与无监测人工智能系统相比,COMET将可信错误回答率从37.5%降至0%,方向为下降。结论适用于有可建模物理与可定义信号规则的声学泄漏任务,削波类故障与部分新泄漏类型仍会静默漏过,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
33. HC-AINet:用紧凑听觉子带做增益预测,再在原频点上做谐波补偿

评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Nan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaoxiong Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Huawei Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziping Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是资源受限设备上的单通道语音增强,输入为带噪波形,输出为抑制噪声后波形,困难在于听觉启发的子带增益分辨率粗,一个子带增益难以同时保留谐波峰并抑制谐波间噪声。处理过程是先把幅度谱压缩到等效矩形带宽(Equivalent Rectangular Bandwidth,ERB)子带预测增益,再在原始频点上有选择地补充谐波分支,最后估计相位合成波形。听觉启发增益网络(Auditory-inspired gain network,AINet)从三角形ERB特征预测全局增益和谐波增益及融合权重,谐波位置图只允许部分频点加入谐波贡献。补偿后幅度与带噪相位及幅度导出的最小相位线索共同输入紧凑相位估计器。与仅用粗子带增益相比,该结构保留了紧凑主干,又在增益施加处恢复了带内选择性。在VoiceBank-DEMAND测试集上,64子带模型PESQ为3.20,高于HC-APNet-64的2.86,STOI为0.95,参数量约0.27M。推理工作量以每秒音频的乘加操作计,64子带为1.08G MAC/s,32子带为0.66G MAC/s,流式延迟与目标设备实测性能尚未验证。结论限于客观指标与所列配置,谐波定位错误、零能量频点无法生成谐波、跨帧相位连续性尚未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
34. 把一句音乐描述拆开验:MQAScore 如何逐个概念检查文本音乐对齐

英文题目:MQAScore: Fine-Grained Text-Music Alignment Evaluation via Large Audio Language Model
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Wei-Jaw Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Chun-Ping Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xuanjun Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi-Hsuan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
文本到音乐生成的输入是一段包含流派、乐器、情绪、演唱和用途等多个属性的文字描述,输出是一段音乐音频,难点是全局相似度把所有属性压成一个数值,无法指出哪个概念缺失。论文先用大语言模型从MusicCaps描述中抽取原子概念并归入流派、乐器、情绪/主题、演唱、用途五个维度,再对每个概念用维度专用模板生成二值问题。交给大音频语言模型计算回答Yes的归一化概率作为概念分数,同维度的概念分数取平均得到维度分数,形成维度向量而非单一全局分。为检验评估器本身是否可靠,论文在流派和乐器上用已有存在与缺失标注构造三元组,在其余三维用大语言模型选最远概念作矛盾替换、最近概念作语义保持对照,并提出Sensitivity-Invariance Ratio衡量对语义改变替换的选择性响应。在MusicCaps配对且双方均采用概念级打分的设置下,以指标Agreement衡量的与专家标签的一致率比较,Qwen3-Omni在情绪/主题上为86.4%,高于MuQ-MuLan的43.2%。相对已有全局相似度和整句问答,关键差异是逐概念验证加维度向量输出,实际意义是能定位生成系统在演唱等维度上的短板。结论适用于片段级描述性概念的验证,关系型和音乐学属性尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://lonian6.github.io/MQAScore.github.io/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
35. 只缓存音频、保住视频:CAVC 的不对称加速

英文题目:CAVC: Convergence-Adaptive Audio-Visual Cache for Modality-Asymmetric Diffusion Generation
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Lifan Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yibo Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Senlin cheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Bolei Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaobo Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Can Ye:机构信息未能在本次解析中与作者逐人可靠绑定
- Dehai Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Deng Cai:机构信息未能在本次解析中与作者逐人可靠绑定
- Boxi Wu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
文本到音视频生成需从一段文字同时合成语义一致的视频与时间同步的音频,难点是音频与视频双分支去噪及音频到视频、视频到音频的跨模态注意力在每个采样步都要重复执行。论文观察到模态非对称可恢复性:中段缓存引入的音频侧漂移可用末端少数联合去噪步骤大幅减少,而视频侧缓存则造成运动与时间细节的持续损失。为此提出收敛自适应音视频缓存(Convergence-Adaptive Audio-Visual Cache,CAVC),先做完整联合热身建立场景布局与跨模态绑定,再在线监测音频去噪器输出的变化量以判断是否进入可缓存区间。当变化量持续低于阈值则触发缓存,复用缓存的音频输出并跳过音频分支与跨模态注意力,视频分支继续独立细化,最后恢复完整联合去噪以减少漂移。在General-80上,相对完整音视频基线Full AV,CAVC加速比(Speedup)从1.00×提升至1.20×,提升20.0%。在同一General-80与同一基线Full AV对照下,动态程度指标Dynamic Degree从0.3800升至0.512,涨幅为34.7%。结论适用于音频模式较平稳且末端联合步数充足的场景,连续变化的多事件声音会推迟触发而接近基线耗时,快速多事件场景仍可能残留同步偏移。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
36. 重度损伤下自监督特征清洗为何失效,以及中间恢复特征如何帮忙

英文题目:When Do Self-Supervised Representations Help Speech Restoration?
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yongjoon Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Younghoo Kwon:机构信息未能在本次解析中与作者逐人可靠绑定
- Jung-Woo Choi:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音修复的输入是受噪声、混响、带宽受限、削波等损伤的语音,输出是接近干净语音的波形,难点在于严重退化会抹掉内容线索,使修复模型难以同时恢复信号细节与感知质量。论文研究的清洗路线是先把退化语音送入自监督学习(self-supervised learning,SSL)编码器,再微调该编码器去逼近干净语音对应的特征,然后把清洗后的特征作为条件送回修复主干。分析发现退化较轻时干净-退化特征距离能反映质量高低,退化严重时这种排序关系失效,继续最小化该距离不再带来质量增益。针对这一现象提出的早期修复注入(Early Restoration Injection,ERI)把修复主干瓶颈层的部分修复特征经过轻量网络送入 SSL,使 SSL 不再只看到严重退化的波形。在 VoiceFixer 测试集上,ERI 在感知语音质量评估(Perceptual Evaluation of Speech Quality,PESQ)上达到 2.82,超过同场比较的 SEMamba++ 的 2.76 与其他基线,同时保持了相近的推理开销。结论适用于所测试的噪声与混响等多退化混合条件,依赖神经质量代理作为人类感知的近似,尚未在真实录音大规模验证,原文报告实时因子仅从 0.015 增至 0.020。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
37. 静音一部分输入:音频 Transformer 的令牌稀疏化怎么做才有效

英文题目:Muting Tokens: Exploring Token Sparsification for Efficient Audio Transformers
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shreya Sajid:机构信息未能在本次解析中与作者逐人可靠绑定
- Fabrizio Julian Piva:机构信息未能在本次解析中与作者逐人可靠绑定
- Hiram Rayo Torres Rodriguez:机构信息未能在本次解析中与作者逐人可靠绑定
- Elif Ceren Gok Yildirim:机构信息未能在本次解析中与作者逐人可靠绑定
- Murat Onur Yildirim:机构信息未能在本次解析中与作者逐人可靠绑定
- Joaquin Vanschoren:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
音频谱图变压器把语谱图切成小块作为输入标记,音频越长标记越多,自注意力计算量随标记数平方增长,推理代价上升。论文要解决的是如何在尽量保持分类性能的同时减少每层实际处理的标记数量,并比较不同重要性估计方法在音频上的适用性。输入语谱图先切块投影成标记向量,再送入多层变压器,稀疏模块插在注意力与多层感知机之间,在三个等间隔位置按保留率丢弃或合并标记。已有的Top-K方法用类别标记的注意力排序,EViT在此基础上把被丢弃标记按注意力加权平均成一个融合标记,ToMe按余弦相似度配对合并相似标记。论文新增的强度过滤先按语谱图块平均对数梅尔能量划分高低能量组,再在组内用注意力选出保留标记,低频能量与谱平坦度则把标记向量经傅里叶变换得到的频域得分与注意力得分融合排序。在AST-Base、AudioSet-20K的推理时稀疏评测中保留率为50%时,谱平坦度的平均精度均值(mAP)为0.3499,低于未稀疏基线的0.3572。同一评测设置下谱平坦度每样本推理计算量由基线的261.43 GFLOPs降至124.95 GFLOPs,原文用DeepSpeed在批量为1时统计,未披露训练时长与硬件成本。结论适用于推理时直接稀疏与微调时加入稀疏两种情形,后者对具体启发式更不敏感;在AudioSet-20K与ESC50上以25%保留率做时长截取对比时,强度方法以准确率与平均精度均值计仅在长于2秒时优于Top-K。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
38. 汉字级别韵律控制:不改结构如何让 TTS 听懂标记

英文题目:Character-Level Prosody Control for Mandarin Speech Synthesis:An Architecture-Preserving Approach
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.9/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Diankun An:JD.com, Inc., Beijing, China
- Lu Ma:JD.com, Inc., Beijing, China
- Yongliang Wang:JD.com, Inc., Beijing, China
- Zhewen Su:JD.com, Inc., Beijing, China
- Xin Tian:JD.com, Inc., Beijing, China
📌 核心摘要
读者需要理解的对象是基于大语言模型的普通话语音合成,输入是汉字文本,输出是语音波形,难点在于整体风格描述只能改变整句感觉,无法指定某一个汉字拉长、升高或在某处停顿。离线提取阶段以音频文本对为输入,先用两套强制对齐融合边界,再逐字计算音高、时长、能量和短语间停顿特征并转为Unicode标记,其输出的带标记文本直接作为下一步训练输入。标记插入时音高与能量标记以前缀形式放在汉字前,时长与停顿标记以后缀形式放在汉字后,全局语速提示放在句首并用<|endofprompt|>隔开且不改变原有词面内容。声学解释阶段以带标记文本为输入、以对应语音的声学令牌序列为目标,对原有合成系统的语言模型做微调,分词器、语言模型和解码器结构保持不变,使韵律控制完全走文本侧。与需要改声学模型或依赖专家标注的SSML、ToBI和音素级预测方法不同,该通道可用于已部署的大语言模型合成系统。与未改动的CosyVoice2基线相比,在12个说话人乘11句人工测试集的时长控制评测中,目标字时长均值的基线240 ms变为本文方法391 ms,增幅为62.9%。在24名普通话母语听众对情感内容评测中,自然度平均意见分的基线4.46对本文方法4.44,本文方法略低但基本保持。结论只适用于普通话和CosyVoice2单一骨干,强标记组合可能用少量中性自然度换取表现力,声学解释微调用8卡B200训练20轮,原文未披露推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
39. 合成语码切换语音如何变成真实识别可用的初始化:SyRA-CS 解读

英文题目:SyRA-CS: Synthetic-to-Real Adaptation for Code-Switched ASR with Meta-Learning
评分:6.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Fadel Thior:机构信息未能在本次解析中与作者逐人可靠绑定
- Ahmer Tabassum:机构信息未能在本次解析中与作者逐人可靠绑定
- Haania Siddiqui:机构信息未能在本次解析中与作者逐人可靠绑定
- Hanan Aldarmaki:机构信息未能在本次解析中与作者逐人可靠绑定
- Thamar Solorio:Mohamed bin Zayed University of Artificially Intelligence
📌 核心摘要
读者需要理解的对象是同一句话混用两种语言的语码转换语音转写,难点是真实混语语音少,合成语音声学干净、说话人变化少,直接训练易记住合成规律而在真实语音上失效。SyRA-CS为每个语言对和每个预训练模型从同一预训练检查点出发单独学一个初始化,先在对应合成CS-FLEURS子集上取小批量做50步内循环梯度更新,得到临时适应参数。再以临时参数与当前初始化的差为方向做外循环移动,重复500次元迭代得到易适应的元初始化,该元初始化直接作为起点,用同一小时真实目标语音微调50轮并在留出的真实集上评分;而持续微调先在同一合成集常规训练再用同一小时真实集微调,故两者差距反映训练策略而非数据量。与持续微调在相同合成源、同一小时真实语音及MUCS与SwitchLingua留出集上相比,SyRA-CS在全部16组模型与语言对比较上降低词错误率,宏观词错误率相对降幅XLS-R为17.7%、其余三模型为5.3%-5.8%,字错误率16组中15组降低,唯一回升是Whisper阿拉伯语-英语字错误率从0.162升至0.181而词错误率仍从0.352降至0.348。结论只支持同语言对内的合成到真实适应,不支持跨语言对共享初始化,且在德语-英语104句、阿拉伯语-英语218句等小测试集、单一种子与单次一小时划分下小幅增益可能落入方差,未验证合成与真实数据量权衡及与MAML等其他元学习算法的差异。表1披露XLS-R用1张RTX 4090、其余三模型用RTX A4500,Reptile均为500次元迭代、每回合50次内步,Reptile一阶形式降低二阶MAML求导开销但仍需重复内循环训练,原文未报告训练墙钟耗时、推理延迟或部署开销。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
40. 边播边改:交互式流视频生成的统一评测

英文题目:StreamEval: Evaluating Interactive Streaming Video Generation Models
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- StreamEval Team:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是边播边生成的交互视频系统,困难在于新请求在会话中途到达,系统要在规定时间改变指定内容,同时不破坏无关人物、场景和源视频运动。StreamEval为此构造300个15–300 s的脚本化会话,每个用例打包初始人像或源视频、按时间释放的语音与文本及图像输入,以及在检查点要建立、保留、取消或恢复的状态要求。评测沿一个样本推进时,调度器按会话时钟释放输入并推进编辑源,记录的输出先切成小段由评委检查缺陷与时间一致性,再按截止时间与验证窗口把结构化观察转成0–100分,最后对重复、测试用例和时长分层取平均。在60个化身表演用例的三次重复评测中,Vidu S2 Avatar的Following(跟随,规定动作按时执行的比例)为36.90,高于LiveTalk的16.59,分数越高越好。在60个文本控制世界生成用例的三次重复评测中,Krea Realtime的Following为25.93,高于Reward Forcing的23.33,分数越高越好。在3个被报告模型的参考编辑比较中,Vidu S2 Editing的Edit Success(编辑成功,完整编辑合约满足的比例)为15.00,高于JoyAI-Video-Edit的8.89,分数越高越好,说明按时执行请求仍是主要瓶颈;该结论仅适用于脚本化输入与固定截止时间和验证窗口,未验证自然对话、更长会话与开放环境的表现。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/StreamEval/StreamEval — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/StreamEval/StreamEval — 链接可访问(HTTP 200)
第三方资源:https://streameval.ai — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
41. 离水之栖:只用几个例子检测布氏鲸叫声

英文题目:A Perch out of Water: Few-Shot Detection of Bryde’s Whale Vocalisations in False Bay
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- G. Tonitz:机构信息未能在本次解析中与作者逐人可靠绑定
- C. M. Geldenhuys:机构信息未能在本次解析中与作者逐人可靠绑定
- T. R. Niesler:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
被动声学监测记录量大且信噪比低,须鲸叫声自动检测通常需要大量标注,而南非近岸布氏鲸(Balaenoptera edeni)等种群缺少这类数据,论文输入连续水下录音,输出对固定时长片段是否含目标叫声的检测与分类,难点是标注极少、叫声频率低且时长差异大、环境差异明显。方法先把录音切为5 s片段、步移4 s,按纯度超过0.02标为相应叫声以允许多标签,得到待比对的查询片段与每类少量支撑片段。支撑与查询片段统一上采样至32 kHz后送入冻结的预训练嵌入网络得到向量,其中通用生物声学模型Perch 2.0(EfficientNet-B3)输出1536维向量,任务专用蓝鲸和鳍鲸检测器WhaleVAD的循环层输出经平均池化后也可用作表示。原型分类器对每类支撑向量取平均形成原型,再比较查询向量与各类原型和负类原型的欧氏距离并打分,本身不引入可训练参数。关键差异是把Perch默认的20 ms帧长和60 Hz至16000 Hz美尔滤波器组改为8192点帧长和0 Hz至1000 Hz,并把多类softmax改为逐类与背景比较的多标签打分,使一个片段可同时带有多个标签。在南极蓝鲸和鳍鲸库(Acoustic Trends Blue Fin Library,ATBFL)上该组合在每类10个样本时宏平均AUC-ROC为0.739,相对未改动的Perch系统绝对提高9.1%。在False Bay布氏鲸数据上Perch的宏平均AUC-ROC为0.987,超过WhaleVAD的0.859,说明少量目标种样本加通用嵌入可以胜过大量近缘种标注训练的专用表示。结论限于片段级分类和最多10个样本的设置,tonal downsweep(TD)因只出现于一个录音而未参与评测。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
42. 用声传播规律告诉网络阵列在哪:几何条件目标说话人提取

评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.9/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jiatong Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Simon Doclo:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要处理的是混响房间中由五个麦克风记录的两至六人混合语音加扩散噪声,目标与干扰在频谱和时间上重叠,只能依靠空间差异区分,系统以目标到达方向指定目标人,估计复数掩码并作用于参考麦克风信号以恢复混响目标语音。提取分支沿用空间选择性非线性滤波器的频域长短期记忆网络、时域长短期记忆网络和线性层,负责联合处理空间、频谱和时间信息并输出复数掩码。几何条件分支先由目标到达方向和麦克风坐标算出目标导向矢量,给出各频率跨通道相位补偿,再用其共轭对多通道观测信号做时延补偿,计算通道对间基于广义互相关相位变换的相位相关并取实部平均,得到各时频点目标是否占优的空间掩码。两类特征再进入编码器,其输出经特征线性调制层调制频域长短期记忆网络后的中间表示,从而把阵列几何和目标方向信息注入提取过程。与把麦克风坐标和目标到达方向映射为抽象高维正弦嵌入的几何条件基线相比,目标导向矢量系统在随机阵列评估上以尺度不变信号失真比SI-SDR从7.77 dB提高到9.43 dB、以宽带语音质量感知评估PESQ从1.96提高到2.27,均高于基线。结论适用于训练用随机阵列、测试用随机和圆形阵列且目标到达方向误差在二十度以内的条件,大误差下显式特征会把网络引向错误方向。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
43. 说清音频和文字哪里对不上:差异描述任务与 AT-DIFFER 数据集

英文题目:AT-Differ: Dataset for Audio-Text Difference Captioning
评分:6.0/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Akihiro Fujii:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuki Okamoto:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuki Saito:机构信息未能在本次解析中与作者逐人可靠绑定
- Hiroshi Saruwatari:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是音频实际内容与描述该音频的文本之间是否一致,困难在于单个对齐分数只能说明不一致程度,无法指出漏写、多写、写错或时间关系写反等具体问题,处理过程是让模型同时听音频并读文本,再输出差异是否存在、属于哪类差异以及用自然语言写出的差异说明。论文构造了音频-文本差异数据集 Audio-Text DIFFERence captioning(AT-DIFFER),用单事件片段叠加或拼接成单一事件、同时两事件、先后两事件三种音频结构,再按模板生成内容与时间共五类差异文本。该数据集按原始划分得到训练、验证、测试三个子集,模型在每个音频文本对上依次完成差异检测、差异类型分类和差异说明生成。相对已有用相似度打分或蕴含分类评价对齐的方法,差异说明能给出可作为反馈的证据,可用于检查生成音频、评估字幕和解释检索候选。在测试集上,联合学习三项任务的微调模型在差异说明的 CIDEr-D 指标上达到 6.882,高于未微调基线的 1.021。结论适用于模板覆盖的两事件以内差异,持续时间、数量和空间等差异未包含,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/sarulab-speech/AT-DIFFER — 链接不可用(HTTP 404)
第三方资源:https://huggingface.co/Qwen/Qwen3-Omni-30B-A3B-Thinking — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
44. 只看嘴和声音对得上吗:检测换了说话内容的音视频伪造

评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Jian Zong:机构信息未能在本次解析中与作者逐人可靠绑定
- Chenghan Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Meng Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhao Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Junyu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Siyuan Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Peiyuan Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Longbiao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jianwu Dang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一段说话人可见的视频,输入是同步的语音声轨与口部运动,输出是当前组合为真实还是篡改的二分类判断。困难在于现代口型重生成已经修补了粗略的音画同步,全脸外观又混入姿态与纹理干扰,句子级池化还会抹掉短暂的不一致。方法沿一个短片段处理:视觉分支只裁剪嘴部区域并经三维卷积与时序建模得到运动表示,音频分支用扩展时延神经网络编码声学动态,两路经投影与重采样对齐到相同帧数与维度。随后在每一对齐帧上构造包含拼接、逐元素乘积与绝对差的交互向量,经自适应统计池化(Adaptive Statistics Pooling,ASP)压缩为定长表示,再由多层感知机输出篡改概率。与句子级融合和全脸输入相比,该设计保留了帧级发音配合关系,也不需要文本转写、语音识别特征或原始参考视频。在 SyncSpeech 受控评测中,预训练的 SyncLip-C 在五个场景平均准确率达到 95.813%,总体 AUC 为 0.9943,优于同协议下的句子级、全脸与复现的 SyncNet 基线。结论适用范围限于该基准与选定的 FakeAVCeleb 子集,在未见的 Video-Retalking 生成器上性能下降明显,且未覆盖压缩、编解码与噪声等退化条件。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
45. 只用语料身份就能排抑郁风险吗:混合评估中的患病率捷径诊断
英文题目:A corpus-only AUC diagnostic for pooled speech-based depression detection
评分:6.0/10 | 创新 1.3/2 | 技术严谨 1.3/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.6/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Cezary Polak:机构信息未能在本次解析中与作者逐人可靠绑定
- Milosz Dudek:机构信息未能在本次解析中与作者逐人可靠绑定
- Daria Hemmerling:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是合并多个小规模抑郁语音语料库做评估时出现的新问题,困难在于即使说话人不重叠,不同采集条件、语言、诱发任务和患病率仍同时留在训练集和测试集里,模型可能先认出被试来自哪个语料库再给出抑郁分数。处理过程是先统计每个语料库的人数和阳性比例,再计算只用语料身份能达到的区分度,同时检查常用语音表示能否识别语料身份。论文推导只用语料身份与经验患病率打分的语料库专属区分度指标(corpus-only AUC,公式1),在5个语料库590名被试上该指标为0.697,把各语料库下采样到共同患病率0.19后降至0.501。多项式逻辑回归探针在分层5折下从6种语音表示识别语料身份的准确率为97.5–99.8%,高于27.5%的多数类基线。在30次折划分平均下,混合5折交叉验证的AUC高于留一语料库测试,例如XLS-R混合为0.725,留一为0.434。把各语料库下采样到共同患病率0.19后,混合与留一的AUC差值eGeMAPS从+0.113变为-0.032,WavLM-Base从+0.206变为+0.023,而保持原患病率的等规模对照只带来-0.011和+0.003的变化。结论适用于合并评估夸大泛化能力的预警,不证明模型一定利用该通道,也不建议实际训练中丢弃数据。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
46. 带符号搬运距离如何比较房间脉冲响应

英文题目:Signed Wasserstein distance for room impulse response comparison
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Linda Fabiani:机构信息未能在本次解析中与作者逐人可靠绑定
- Sebastian J. Schlecht:机构信息未能在本次解析中与作者逐人可靠绑定
- Filip Elvander:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是房间脉冲响应,即声源发出后经直达与多次反射到达麦克风的时域信号。困难在于它由稀疏的正负反射峰组成,房间几何或声源位置稍变就会让峰在时间轴上平移,逐点相减会同时错过两个峰并给出很大误差。处理过程是把信号看成时间轴上的分布,用搬运质量所需的位移代价衡量相似,而不是要求同一时刻逐样对齐。方法先把平方后的房间脉冲响应做反向积分得到能量衰减曲线,在总能量相等时证明其绝对值积分距离等于时间能量分布的一阶Wasserstein距离;再把原始带符号波形按正负部分解后交叉相加,用非负分布间的输运定义带符号Wasserstein距离。与逐点误差和多分辨率频谱损失相比,新距离保留了非局部比较,同时不再把相消干涉当成能量相加。在用Pyroomacoustics合成矩形房间并以可微镜像源模型分开优化几何与吸收的10次重复实验中,房间尺寸平均绝对误差方面带符号Wasserstein距离为0.4208 m,低于误差信号比的2.5794 m、多尺度频谱损失的1.2276 m和能量衰减曲线基线的1.5995 m。结论适用于合成矩形房间的几何扰动与分开优化,联合优化几何与吸收、真实房间与噪声条件尚未验证;原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
47. 验证器的地板:合成罕见词表观错误里有多少是识别器错误

英文题目:Measuring the Verifier’s Floor: How Much Apparent Rare-Word Text-to-Speech Error Is ASR Error?
评分:5.9/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kirill Borodin:机构信息未能在本次解析中与作者逐人可靠绑定
- Vasilii Kudryavtsev:机构信息未能在本次解析中与作者逐人可靠绑定
- Nikita Vasiliev:机构信息未能在本次解析中与作者逐人可靠绑定
- Grach Mkrtchian:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
文本到语音保真度评测常把合成语音交给自动语音识别系统转写并计算词错误,其中混入识别器自身错误,尤其稀有词、人名和外来词上难分合成错误与识别错误。论文对每句同时取文本、原始人声录音和多个合成版本,让三个识别器全部转写,评估器C的往返结果待核查,另两个识别器只负责复核。转写文本经归一化对齐后形成词级判定:某识别器在人声中听出记为h,在任一合成版本中听出记为s,该s输出直接作为三种估计的公共输入。标准往返只看C在合成中是否听出;单识别器掩码先用C的人声漏检hC筛掉词再判;三识别器裁决要求至少一者在人声听出才纳入,且三者在所有合成版本均未听出才判合成错误。与已有只在语料级比较识别词错误和听者转写的工作不同,本文做到词级、按词频段的三识别器核查,并揭示简单丢弃的偏差。在500句LibriSpeech上,按Zipf频段统计的评估识别器人声漏检率为常用词1.5%、极稀有词32.9%;同一批句子的任一合成版本命中设置下,按判后词计算的TTS词错误率从标准往返到三识别器裁决,F5-TTS由0.63%降到0.22%,Kokoro-82M由0.72%降到0.22%。结论适用于英文朗读语音的两套语料,单识别器掩码会丢掉真错误并保留约一半假错误,残留错误多为拼写变体,需听辨确认。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
48. NarraSpace:把图画描述分类连回场景证据

英文题目:NarraSpace: Multimodal Scene-Grounded Evidence for Picture-Description Dementia Classification
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Qingming Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruiyan Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Satoshi Nakamura:The Chinese University of Hong Kong Shenzhen
📌 核心摘要
读者需要理解的对象是Cookie Theft看图说话录音和转写,困难是整篇转写给出的分数无法指出它来自哪个画面内容和哪句话,处理过程是把词语连到语音时间和画面元素,再按事件取出语句并度量其语言特征。论文构建的NarraSpace先把带时间的词序列映射到15个场景锚点,场景锚点指命名的画面元素如水槽,由此形成可检查的访问序列并度量覆盖、路径与停留关系,得到70个叙事空间特征。同一访问序列再按7个预定事件取出完整语句形成事件文本,并保留词语、语音区间与词汇命中的来源记录,该事件文本直接作为下一步打分的输入。冻结的Qwen2-7B在阿尔茨海默病组和健康对照组示例下分别打分并求差,与转写困惑度和覆盖计数共同构成场景似然流。70个叙事空间特征与20列场景似然流等共236个特征加20个缺失标记,经互信息与Mann–Whitney排序选出60个输入,交给径向基支持向量机输出患病概率。在ADReSS官方48人测试集上,以50种子平均准确率为指标,完整系统80.88%高于去除叙事空间特征后的78.21%。同一48人测试集上,聚合概率后完整系统准确率为81.25%且曲线下面积为91.32%,去除叙事空间特征后聚合准确率仍为81.25%而聚合曲线下面积降至87.67%,结论只适用于该英语基准的探索性评估且此前已有测试集接触,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
49. 混着音乐时怎样取出想要的人声:MuseFlow-TSE 的两段做法

评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.9/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.9/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Lu Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Yongliang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhewen Su:机构信息未能在本次解析中与作者逐人可靠绑定
- Xin Tian:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是从单通道混合声中取出指定说话人的干净语音,困难是音乐和歌声宽带强谐波,与人声频带高度重叠,普通掩码删不干净,生成模型又容易把删掉的伴奏补回来。输入是一段16 kHz混合波形加一段注册语音,混合含最多三个干扰说话人、音乐或歌声、噪声与可选混响,输出是目标说话人的估计波形。第一步跨源带拆分提取器把保留频带分成37个非均匀子带建模音乐谐波,同时估计目标、干扰说话人、音乐与噪声槽并做联合掩码删除,得到粗目标与干扰 stems。第二步数据到数据的流匹配精修以粗估计为起点而非高斯噪声,以干扰幅度嵌入为负条件防止已删伴奏被补回,并由难度头按目标能量比决定1至4步欧拉步数。相对已有工作,差异是显式建模音乐槽、起点靠近目标以缩小幻觉空间、生成被干扰负条件约束,难混合多走步数而易混合少走步数。与直接级联基线相比,在Complex合成场景本文Config-D的SI-SDRi为13.0 dB高于基线的10.5 dB,MusicLeak为2.9%低于基线的7.8%。结论只适用于论文自建的合成评测,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
50. 只看总字错率会漏掉什么:有无音频的纠错拆解
评分:5.8/10 | 创新 1.1/2 | 技术严谨 1.1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Vasiliy Kudryavtsev:机构信息未能在本次解析中与作者逐人可靠绑定
- Kirill Borodin:机构信息未能在本次解析中与作者逐人可靠绑定
- Nikita Vasiliev:机构信息未能在本次解析中与作者逐人可靠绑定
- Mikhail Gorodnichev:机构信息未能在本次解析中与作者逐人可靠绑定
- Grach Mkrtchian:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是语音识别输出的转写文本,困难是总词错误率把改对和改错混在一起,处理过程是把输入假设与参考文本对齐后逐词判定修复、破坏和插入变化。研究比较同一假设在无音频文本校正和有音频校正下的输出,输入是音频信号与假设文本之一或两者,输出是修正后的转写。方法先固定假设与音频片段,只增减音频输入并记录配对差异,再把词错误率变化恒等分解为修复、破坏和插入三个分量并统计破坏率与修复率。相对已有只报总错误率的生成式纠错评估,关键差异是在词级别给出精确会计并区分自我草稿与独立识别器两种来源。在自我修正设置下医疗听写上,用Gemini 2.5 Flash校正自身草稿时,无音频单元破坏率break-rate为12.8%,有音频单元降至2.3%。在跨系统设置下医疗听写上,用Gemini 2.5 Flash校正独立识别器输出时,无音频单元修复分量rep占参考词元比例为2.06%,有音频单元升至3.31%,相对增加61%。结论适用于会过度修改的主力模型,不适用于很少修改的模型,合成语料接近天花板时的结论不能推广到自然语音,且两臂提示词不同只能界定音频作用上限。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
51. 只看一张脸就能读出情绪有多强并说出来:EmoFI-TTS 解读

英文题目:EmoFI-TTS: Face-Conditioned Expressive Voice Synthesis with Intensity Modulation
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yejin Jeon:机构信息未能在本次解析中与作者逐人可靠绑定
- Luel Hagos Beyene:机构信息未能在本次解析中与作者逐人可靠绑定
- Marie Maltais:机构信息未能在本次解析中与作者逐人可靠绑定
- Hyounghun Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- David Ifeoluwa Adelani:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是从文字生成带情绪语音的任务,困难在于没有人工情绪标签时既要猜对情绪类别,又要猜对情绪有多强,还不能把目标说话人的音色带偏。处理过程是让文本决定说什么,让人脸决定以什么情绪和多强来说,让另一段参考音频决定用谁的声音说。文本到语音(Text-to-Speech,TTS)主干先根据融合后的风格向量生成初始梅尔谱。该风格向量来自人脸情感嵌入与参考音频音色嵌入的拼接投影,强度条件细化模块只对中高强度做残差修正,推理时强度等级直接从人脸预测得到,并支持强度嵌入插值实现连续调节。与需要人工给定情绪标签的EmoSpeech和被改造为预测情绪强度的FaceTTS相比,该工作把人脸的情绪强度显式建模。在说话人不重叠的MEAD评测上,本文方法客观非加权强度准确率为64.4%,高于接受真实标签的EmoSpeech的39.1%,主观三级平均准确率为75.2%。同一评测上,本文方法词错误率为6.9%,低于EmoSpeech的9.3%,UTMOS为3.14,高于EmoSpeech的2.88%,结论适用于该语料保留的6种情绪和3级强度范围,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/luelhagos/Emofi — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
52. 长音频里按复杂查询找短片段:先调制再做液态时序建模

英文题目:Query-Conditioned Liquid Temporal Grounding for Long-Form Audio
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuelan Cheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yonggang Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yongqiang Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Peiwei Chang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yingyi Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenwu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
长时音频定位输入为长录音与一句自然语言查询,输出查询所述声音起止时间,难点在于目标占比极小且周围存在相似声音,查询还可同时约束说话人、事件、属性与时序关系。方法将音频编码为时间槽序列,用查询整体表示做特征线性调制后送入闭式连续时间网络传播长程证据,使查询语义直接影响时序演化而非仅参与候选打分。同时并行计算帧级音频查询匹配信号,并与调制后特征和时序输出融合,由轻量头预测起始、结束与相关性分布,为候选抽取提供时间证据。无参数候选抽取从融合相关曲线取高响应种子向外生长、合并与多尺度扩展,再用冻结大音频语言模型对各候选片段做Yes/No兼容性打分并保留最高分者。Qwen3-Omni分支再用局部精修器在候选边界两侧五秒窗口内调整边界,得到最终起止时间。在LAT-Bench英文时间定位子集上,Qwen3-Omni骨干下合并两种生长阈值候选池并精修的mIoU为44.13%,高于同骨干直接定位的15.80%。结论适用于冻结骨干加轻量模块的单卡适配,对更严格阈值的精确定位和候选选择仍不充分,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
53. 听见却说不出:冻结音频语言模型中的音乐时刻信息

评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Eunsik Shin:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一段完整多乐器音乐中与文字描述匹配的起止时间,输入是整轨音频加一句查询,输出是起止秒数。难点是目标时刻与全曲共享配器和速度,只靠局部听感容易混淆,判断变化还要与之前听到的内容比较。论文先用Slakh2100分轨活动找稀疏织体紧跟乐器离开的同一片段,为其配状态查询(含义为当前有何乐器在演奏,如only piano and bass are playing)和变化查询(含义为某乐器离开后剩下何编制,如the guitar drops out, leaving piano and bass),两者共享音频使偶然基线相同。这些配对查询与同一冻结音频一起送入三种取出时间段的方式对比:整轨直接提示说出时间戳并解析文本;按滑动窗口读是与否词元差值打分,窗口恒以待判2秒结尾并在窗前增加C秒上下文,分数按每轨每查询标准化成曲线;读全轨最后提示词元对音频词元的注意力形成曲线,后两者的曲线再从峰值向外扩展成候选起止以评测。已有音乐时间定位多经提示测试,本文差异是冻结参数、控制上下文、比较编码器分段方式。七个开源权重冻结大音频语言模型上,短分段编码器中变化查询随上下文恢复,例如Qwen3-Omni-30B-A3B在570对评测中用oracle时长评测的R@1@0.5从C=0 s时0.118升到C=8 s时0.268,而整轨提示基本处于偶然水平。结论只适用于乐器编制类查询和MIDI渲染音频,真实录音与和声、节奏等属性尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
54. KIRA:把单词流利度与音素错误分析装进同一个儿童阅读筛查系统
英文题目:KIRA: A Full-Stack Reading Screening System with Dual-Pathway Analysis for Children
评分:5.5/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Maggie Dong:机构信息未能从 arXiv PDF 文本可靠映射
- Rohit Mekkoth:机构信息未能从 arXiv PDF 文本可靠映射
- Zixuan Wang:机构信息未能从 arXiv PDF 文本可靠映射
- Cheol Jun Cho:机构信息未能从 arXiv PDF 文本可靠映射
- Jiachen Lian:机构信息未能从 arXiv PDF 文本可靠映射
- Gopala Anumanchipalli:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
儿童早期阅读筛查既要判断整词是否读对,又要指出在哪个音素上读错,而在成人语音上训练的识别模型用到儿童语音时误差偏高,且只给词级对错会掩盖需要干预的发音模式。KIRA(Kids’ Integrated Reading Analysis,儿童综合阅读分析系统)接收儿童朗读录音,输出两类任务的筛查报告:孤立词朗读(Word Reading,WRE)报告音素错误,连续文本朗读(Oral Reading Fluency,ORF)同时报告词级流利度与词下音素细节。系统先对录音做质量过滤与语音活动检测切分,再用同一批儿童语音适配的词级模型Parakeet-TDT-1.1B与音素级模型HuPER(Human-inspired phonetic perception,人类启发式音素感知框架)分别处理,其中前者输出转写用于流利度评分,后者输出每20ms一帧的音素分布并解码为音素序列。对于孤立词任务,系统只用音素通路,将各发声段与目标词发音变体做特征加权对齐,以排除试读重复与非目标说话声;对于连续文本任务,两条通路并行运行,词级转写与参考文本比对计分,音素序列与参考音素比对标出替换、删除与插入并归因到对应词。两路结果再经覆盖度门控与评分进入同一报告界面,教师先看到会话级分数,点开误读词可见预期音素与实际听到的音素对照。在MyST儿童语音测试集3027条录音上,词错误率从预训练的13.88%降到微调后的8.84%,音素错误率从41.66%降到23.00%。该结论只说明识别组件在该数据集上的表现,音素反馈能否改变教学决策尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://tinyurl.com/kira-demo → https://www.youtube.com/watch?v=SJsAYoOhkp0&feature=youtu.be — 链接可访问(HTTP 200)
第三方资源:https://arxiv.org/abs/2507.14346 — 链接可访问(HTTP 200)
第三方资源:https://arxiv.org/abs/2008.12914 — 链接可访问(HTTP 200)
第三方资源:https://arxiv.org/abs/2307.13008 — 链接可访问(HTTP 200)
第三方资源:https://arxiv.org/abs/2406.10507 — 链接可访问(HTTP 200)
第三方资源:https://arxiv.org/abs/2312.12810 — 链接可访问(HTTP 200)
第三方资源:https://arxiv.org/abs/2602.01634 — 链接可访问(HTTP 200)
第三方资源:https://aclanthology.org/H94-1044/ — 链接可访问(HTTP 200)
第三方资源:https://doi.org/10.1145/1998384.1998390 → https://dl.acm.org/doi/10.1145/1998384.1998390 — 链接不可用(HTTP 403)
第三方资源:https://aclanthology.org/C16-1328/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
55. 为制作好的音乐重调助听器压缩:先看是否需要压,再按信号优化

英文题目:Optimized Compressor Parameterization for Produced Music in Hearing Aids
评分:5.4/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 0.8/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:后 50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Robin Holland:Technische Universität Darmstadt, Darmstadt, Germany;WSA, Erlangen, Germany
- Christoph Hoog Antink:Technische Universität Darmstadt, Darmstadt, Germany
- Henning Puder:Technische Universität Darmstadt, Darmstadt, Germany;WSA, Erlangen, Germany
📌 核心摘要
助听器需把放大的成品音乐装进由听力阈值与不舒适阈决定的残余动态范围,输出各频带既可听又不超限的鼓膜声压,难点是源自语音的压缩预设与音乐窄动态及瞬态峰值并不匹配。论文先在线性增益下用包络与瞬态两条通路计算压缩有效性,判断不同听力图与残余动态组合是否真正需要压缩,再对需求最强的两例有限残余动态听力图按信号单独优化单通道、7通道和20通道宽动态压缩的静态压缩特性。优化的插入增益曲线与第一拐点沿用NAL-NL2并冻结,只调整其余阈值与压缩比等参数,使前一步筛出的高需求信号与听力图组合获得适配处理。优化以听觉辅助音频质量指数(Hearing Aid Audio Quality Index,HAAQI)兼顾可听度与阈值符合性为目标,并与经宽带增益优化的NAL-NL2多通道基线比较,关键差异在于逐信号与逐听力图调参而非沿用语音导出的固定参数。原文未提供可核对的关键定量结果。结论只适用于评估的轻中度听损轮廓与三首成品音乐,攻击与释放时间未优化,主观效果仍待验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
56. 从多通道波形到结构化证据:被动检测如何同时给出有无、方位与谱线

评分:5.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:后 50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zhiyuan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuge Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jie Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiruo Su:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhengqiao Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiling Yao:机构信息未能在本次解析中与作者逐人可靠绑定
- Lingji Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jingdong Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yixin Yang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者面对的是水平圆阵连续采集的水下声场,低信噪比下单个谱峰或单次波束峰值难以区分真实目标与背景起伏,需要把阵列波形转为可验证的物理证据再判断存在性。方位分支估计空间协方差并计算最小方差无失真响应方向谱,得到随时间变化的角度分布,检测分支从短时傅里叶谱提取实部虚部与对数幅度并以方向特征为查询做聚合,谱线分支用更长分析窗统计精细频谱均值与起伏并融合记录级方向信息。三组表示与水深矩阵及声速阵形文本一同送入冻结的大语言模型,仅训练投影与低秩适配模块和水深编码器,生成结构化报告并由独立读出头给出谱线分数。与把多通道观测折叠为能量阈值或单一置信分的方法不同,该工作要求每个结论关联时间持续性、空间一致性与传播条件等证据并以语言说明何种观测支持假设。在每个信噪比条件各含288个目标样本的混合背景测试同一协议下,方位平均绝对误差指标在0 dB条件为0.000°而在-30 dB条件增大至0.521°,方向为随信噪比降低而变差。同一混合背景测试总体检测率100.00%且虚警率0.00%,而频率F1指标在0 dB条件为48.93%在-30 dB条件为59.82%数值升高不能直接解读为性能提升,因为参考谱线数随信噪比降低而减少且标注依赖接收谱。结论仅适用于混合背景下不重叠声源实现与给定信噪比配比的测试范围,距离估计误差大且未在白色背景下验证系统级报告,原文给出硬件型号与批量等配置,未披露训练时长、推理延迟或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
57. 自动切分连续对话再做音频视觉情绪识别:AGF-Net 是如何保持鲁棒的
评分:4.8/10 | 创新 1/2 | 技术严谨 0.8/1.5 | 实验充分 0.8/1.5 | 清晰度 0.6/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:后 50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chuan Han Li:机构信息未能从 arXiv PDF 文本可靠映射
- Yun Chien Cheng:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
输入是连续对话录音及其同步视频流,事先没有每句话的起止时间,输出是每个自动切分候选片段的情绪类别,类别为生气、高兴、中性和悲伤。困难在于自动边界会偏移、过短或过长、混入相邻说话人,以及某一模态质量下降时固定融合会放大不可靠分支。系统先用轻量语音活动检测模型(Silero VAD)逐短块输出语音概率,经平滑与迟滞判决跟踪状态,再用自适应端点、前滚与后滚、删过短段和部分自动语音识别语义保持生成候选区间。同一区间内音频经自监督语音表示模型(wav2vec 2.0)得到音频事件序列,面部帧经人脸检测与对齐模型(YuNet)对齐后经残差卷积网络(ResNet18)得到视觉序列,音频引导融合以音频事件为锚预测视觉中心与跨度并用高斯偏置注意力约束注意。预测性动态融合按分支可靠性分配决策权重,多模态负学习只在训练期由可靠分支指导弱分支压制非目标类。在IEMOCAP对照中,干净条件下AGF-Net准确率为64.92%、F1分数为65.47%,低于Social-MAE的66.72%准确率和67.89% F1分数,但超过AVF-MAE与VAVL。中等噪声(λ=5)下AGF-Net准确率为62.13%、F1分数为63.08%,F1分数分别超过Social-MAE、AVF-MAE和VAVL 0.52、4.15和7.89个百分点,为对照中最高;高噪声(λ=10)下准确率为58.19%、F1分数为59.41%,F1分数比Social-MAE的59.61%低0.20个百分点,仍超过AVF-MAE与VAVL。结论限于按演员独立划分的IEMOCAP对话场景,自动切分在交并比大于0.5时F1分数仅0.4608,跨数据集与跨语言泛化未验证,训练与推理成本未披露。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
58. 音色与空间如何成为打击乐人机共创演出的结构
评分:4.5/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.2/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:后 50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Keon Ju Maverick Lee:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
读者需要理解的对象是一场把音色和空间作为主要结构材料的9分钟沉浸式现场表演,困难在于即兴手势、多个生成过程和多通道空间运动需同时保持个性、变化与整体形态。表演者经电子打击乐与Drumbeam加多垫控制器输入节奏与连续手势以控制音色形态与乐器身份,其现场音频流进入MACAT与MACataRT。MACAT在个人录音库中按音色相似游走并经重采样等重组片段而输出演化乐句,MACataRT监听该现场流并按特征相似拼接库中碎片,生成贴近或偏离表演的影子与群聚声响。基于MIDI的智能体监听上述音频活动并经音频转MIDI转写为符号,再经Karplus-Strong弦合成与MIDI打击乐发声,形成不同音色层,其音符与连续控制数据兼作空间-音色控制信号进入空间化层。空间化层接收各声音对象并以对象方式写成位置、轨迹、深度、宽度、表观大小与扩散,使距离与运动成为乐句形态。指挥智能体监测密度、能量、质感、紧张度与智能体状态并切换场景,驱动稀疏氛围与密集呼应等行为转变,原文未提供可核对的关键定量结果。结论适用于该作者的曲目与93.5通道穹顶及立体声记录版本,尚未在其他表演者、曲目或听众评测中验证,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://keonlanocturneartist.bandcamp.com/album/hyperspatial-drum-ritual — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。