📄 长视频里谁在何时说了什么:多语多说话人转写的基准与瓶颈
评分:6.5/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
👥 作者与机构
- Yuan Ge:机构信息未能在本次解析中与作者逐人可靠绑定
- Pei Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xize Cheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Lingzhou Mu:机构信息未能在本次解析中与作者逐人可靠绑定
- Mingyang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jin Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Baosong Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Shengxiang Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Jingbo Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhengtao Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Tong Xiao:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一段多人说话的长视频,模型要同时回答谁在说、每句话从何时到何时、说了什么,输出是带说话人编号和起止时间的结构化转写。困难在于语音时长可达 30 分钟,说话人音色相近还会有重叠,时间边界差半秒就会在带时间约束的指标下判错。处理过程是把长视频切成不切断话语的小段,逐段做说话人区分和转写,再把各段的局部编号合并成全片统一编号,最后由语言专家对照视频修正。相对已有会议语料和短对话基准,关键差异是覆盖西班牙语、法语、日语、韩语、俄语和泰语六种语言,提供平行的纯音频和音视频两种输入,并按时长和说话人数分层。在六语言 297 个实例上,任务专用模型 MOSS Transcribe Diarize 0.9B 在多数语言的时间敏感指标上仍领先通用全模态大语言模型,例如泰语上其 tcpWER 为 0.929 而多个通用模型超过 1.1。结论适用于评测当前全模态大语言模型的细粒度时间定位和多人区分能力,不适用于证明某模型在所有真实场景最优,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
第三方资源:https://github.com/QwenLM/Omnilingua-Bench/tree/main/Omnilingua-MSpeaker — 链接可访问(HTTP 200)
第三方资源:https://creativecommons.org/licenses/by-nc/4.0/legalcode.en — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
全模态模型要解决的转写任务是什么
这篇论文研究的是长视频里的多说话人语音识别。输入是一段真实视频的声音,评测时还会平行给出画面,时长从约 20 秒的短片段到约 30 分钟的长视频,内容覆盖会议、播客、新闻、电视剧、演讲、祈祷和日常记录等,语言覆盖西班牙语、法语、日语、韩语、俄语和泰语。
模型要输出结构化文本,每一条都要同时回答 3 个问题:谁在说话,用本视频内从 0 开始的匿名说话人编号表示;何时说话,用开始与结束时间戳表示;说了什么,用对应语言的转写文字表示。编号按说话人首次出现的顺序分配,同一人后面要保持同一编号。
这个任务比普通语音识别多两项必须保留的信息,一是时间边界,二是跨轮次一致的身份。如果时间偏了,后续的翻译与语音交互就对不齐;如果身份串了,就无法知道哪句话是谁说的。论文把这种同时绑定内容、身份与时间的要求,作为检验会话级细粒度理解的一个具体指标。
多说话人语音识别 × 说话人日志: 多说话人语音识别指把多人对话转成带说话人归属的文字,既要听清说什么又要分清归谁;说话人日志指只判断谁在何时说话而不管文字内容;论文把后者作为前者的子能力单独计分,用来区分时间与身份错和文字错。
已有基准为什么测不出这类模型的边界
论文梳理了 3 条已有路线。第一条是会议类的多说话人数据集,例如 AMI、CHiME-6、Aishell-3 和 AliMeeting 等,它们有身份、边界与文字标注,但主要集中在英语或中文单语,输入条件与多语长视频不同。
第二条是多语对话基准,例如 Muscat 和 MLC-SLM,它们扩展了语言覆盖,但音频时长远短于现代大模型的上下文窗口,也没有系统评测通用全模态大模型。第三条是长视频理解与全模态问答,例如 EgoSchema、LongVideoBench、LongVALE 和 OmniVideoBench 等,它们做到分钟甚至小时级,强调记忆、检索与跨模态推理,但目标是问答或事件描述,不要求逐句保留说话内容、身份与时间边界。
因此,已有工作在任务目标、输入时长、语言与模态条件上与本文要测的长时多语多说话人音视频转写并不相同。论文的定位是补上这一块可复现的平行音视频评测,而不是把类别差异说成同条件胜负。
谁何时说了什么在输出里长什么样
要理解方法,先看懂期望输出与输入的对应关系。下面这张任务示意图展示了音频与视频输入如何对应到三列结构化输出,读图时重点看一条输出如何同时锁定身份、时间与文字。
看图路径: 1. 先看上方紫色波形与两个视频帧的输入示意;2. 再看下方灰框中谁、何时、说什么三列输出;3. 注意说话人编号从 0 开始并附带起止时间的写法

论文图 1。原论文 Figure 1::“Overview of the MsASR task. The model is required to jointly predicting speaker identities (who), timestamps (when), and text transcriptions (what) in a structured format as…”。
这张图上方是音频波形与视频帧的输入示意,下方灰框给出三列要求。示例中 Speaker 0 在 00:00.56 到 00:02.36 说 Let’s take a look,随后同一说话人又有另一段,而 Speaker 1 在更晚的时间说话,最后还有 Speaker 5 的长时位置示例。图想说明的是,模型不能只输出文字,还必须给每句配上编号与起止时间,且编号在全片一致。
论文在推理提示里把这种格式进一步固定为类 XML 标记,要求以<soc> 开始、以<eoc> 结束,每句按<sos> 加开始时间加文字加结束时间加说话人编号加<eos> 的顺序拼接,时间保留 2 位小数。解析失败或陷入重复生成的样本会被排除在词错误率统计之外,以免个别极端输出拉偏整体判断。
基准一共包含多少样本与什么分布
OmniLingual-MsASR 最终包含 297 条实例,其中西班牙语 50 条、日语 50 条、韩语 50 条、泰语 50 条、俄语 50 条,法语因隐私审计移除 3 条后剩 47 条。每条实例都同时有音频与视频,可做音频转写与视频转写的平行比较。
时长按 1 分钟、3 分钟、8 分钟、15 分钟为切点分成五档,从 20 秒到 30 分钟,目的是检验模型随上下文拉长是否退化。说话人数从 2 人到最多 20 人不等,为保证每档样本量,论文把 5 到 6 人合并一档、7 人及以上合并一档,并去掉单个单说话人离群点。
下面这张组成图展示了 3 个视角的分布,读图时注意每档的条数与占比是理解后文时长与人数分析的前提。
看图路径: 1. 先看左侧语言环中六种语言各自的条数;2. 再看中间时长五档从短片段到长视频的占比;3. 最后看右侧说话人数中 2 人占多数的分布
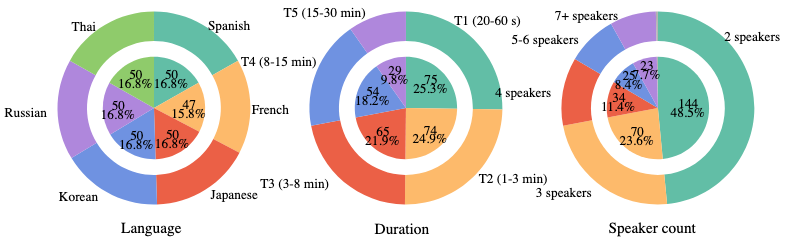
论文图 2。原论文 Figure 2::“Benchmark composition of OmniLingual-MsASR in three views: languages, audio duration and speaker count.”。
这张图左侧显示 6 种语言基本均衡,中间显示短片段与长视频兼有,右侧显示 2 人样本最多,而 7 人以上样本最少。后文人数分析以 2 人与 7 人及以上为端点,原文给出整体说话人混淆从 9.1% 到 25.6%,Gemini 3.7 Flash 的 cpWER 从 0.387 到 1.113,此处不猜中间档数据。这种不均衡是后文讨论结论适用条件的重要背景,7 人以上属于拥挤子集且样本少,不是任意真实会议的代表,结论的统计稳定性自然更弱。
自动标注流水线如何从长视频得到初稿
标注流水线分两大步,先做音频为主的片段级初稿,再做视觉辅助的跨片段身份统一。下面这张流水线示意图展示了从切分到合并的主路径,读图时沿输入到输出的箭头看两次加工分别改变了什么。
看图路径: 1. 先沿上半部分看静音切分再到 Moss 识别的主路径;2. 再看下半部分跨片段人脸框与局部编号的对应;3. 注意右侧用 Gemini 合并相同人脸的示意

论文图 3。原论文 Figure 3::“Overview of automatic data pipeline. The pipeline first leverages audio models to segment and annotate individual clips, followed by visual models to identify and consolidate…”。
上半部分是片段时长与识别。原始视频先经过 MossFormer2_SE 做语音增强,以应对 YouTube 的背景噪声。因为完整录像约 2 小时,超出 MOSS Transcribe Diarize 0.9B 的上下文窗口,流水线用语音活动检测只沿静音区间把音视频切成 30 分钟以内的片段,避免从一句话中间切断,再对每个片段抽取带说话人时长与文字的多说话人初稿。
下半部分是跨片段说话人合并。分片独立标注会让同一个人在不同片段拿到不同的局部编号,只靠声音聚类很难在阈值上兼顾同一人音色变化与不同人音色相近。流水线用 SyncNet 做唇音同步校验找到正在说话的人脸,再把局部编号与人脸截图成对交给 Gemini 3.1 Pro 判断跨片段身份,最后把时间戳平移到全局时间轴,并从合并后的长标注中截取不同时长的评测子段。
音频伪标签 × 视觉辅助跨片段身份合并: 音频伪标签指用语音增强加 MOSS Transcribe Diarize 0.9B 在 30 分钟内短片段上自动得到的时间与文字初稿;视觉辅助跨片段身份合并指用 SyncNet 找正在说话的人脸再让 Gemini 3.1 Pro 比对脸图,把不同片段的局部编号统一成全片编号;前者解决片段内切分,后者解决长视频全局身份一致。
人工核验与隐私筛查做了什么
自动初稿之后是 3 阶段人工流程。先由负责对应语言的语言学专家对照视频逐条核对身份、时间戳与文字并直接改错,遇到一条记录实际包含多人先后说话就拆成多行,遇到未编号的新说话人就新增编号,时间要求标到 1 位小数;再由另一批不重叠的专家独立复核;最后由作者抽查,其中受多语能力限制,抽查主要看与语言无关的说话人标签与时间戳。
论文还做了伦理与隐私审计。先按每语种约 60 条标注再筛选出时间分布与内容多样的 50 条,随后发现 3 条法语实例含有真实社交媒体账号与邮箱等可识别个人信息,为降低泄露风险将其删除,得到最终 297 条。附录还说明只提供索引与文字标注,不复制或分发原始音视频,脸部截图不随基准发布,合唱按单个说话人处理等细节。
这部分的作用是把可扩展但有错的伪标签变成可评测的参考答案,但论文也在局限中承认,时间戳只在明显错误时才改,这可能让标注工具本身在时间敏感指标上占优。
这篇工作训练了什么,没有训练什么
这是 1 篇基准与评测论文,没有训练新的语音或语言模型,也没有报告梯度、参数冻结、优化器或训练超参数。它的构造性工作是数据流水线与人工核验,实际执行的计算是调用已有模型做标注与评测。
具体而言,标注阶段调用了 MossFormer2_SE 做增强、MOSS Transcribe Diarize 0.9B 做片段级日志与转写、SyncNet 做说话人脸校验、Gemini 3.1 Pro 做跨片段身份合并;评测阶段调用两类模型,一类是开源的任务专用 MOSS Transcribe Diarize 0.9B 与通用 Qwen3-Omni-30B,另一类是 Gemini 3.1 Pro、Gemini 3.7 Flash、Gemini 3.8 Flash、Qwen3.5-Omni-Plus、Qwen3.8-Omni-Flash、Muse Spark 1.2 和 Doubao-Seed-2.0-Lite 等商用全模态模型,开源模型跑在 8 卡 A100 上,商用模型保留默认推理设置。
无训练不等于输出确定,论文明确指出商用接口推理具有随机性,完全复现基准数字无法保证。理解这一点才能正确看待后文小数点后两三位的差异,它们是在特定调用下的观测值,不是确定性最优值。
四个指标分别测量什么,方向如何
评测用 4 个指标。解析率衡量模型按格式输出的能力,输出不符合要求或退化成重复生成就无法解析,这类样本不计入后 3 个词错误率指标。说话人日志错误率衡量谁在何时说话,不看文字内容,它把漏检语音时间、误报语音时间与说话人混淆时间相加再除以总参考说话时间,数值越小越好,计算时在每个参考边界两侧留 0.5 s 的宽容区。
\[\text{DER}=\frac{T_{\text{miss}}+T_{\text{fa}}+T_{\text{conf}}}{T_{\text{total}}}\]拼接最小排列词错误率把每个说话人的全部文字拼起来,在最优说话人配对下算替换、删除与插入词数之和除以参考总词数,它同时计文字与归属但忽略时间戳,越小越好。
\[\text{cpWER}=\frac{S+D+I}{N}\]第三个指标 tcpWER 对词语的最优配对另加时间限制:参考词与假设词必须落在给定的时间容限内才允许对齐,因此即使文字相同,时间位置相差过远也会计入错误。原文设置 τ=5 s,误差值越低越好。这里须区分定义与原式的印制标签:正文把它命名为时间约束的 tcpWER,但原 HTML 第 3 个公式及 PDF 第 5 页第(3) 式左端仍标作 cpWER,二者存在原文自身的不一致。下面保留该原式及其左端标签;判断本指标是否带时间约束,应依据正文的时间配对条件,不能仅凭式子左端的名称。
\[\text{cpWER}=\frac{S_{\tau}+D_{\tau}+I_{\tau}}{N}\]cpWER × tcpWER: cpWER 把同一说话人的全部文字拼起来,在最优说话人配对下算词错误率,只看文字和归属不看时间;tcpWER 要求参考词与假设词的时间戳在 5 s 容限内才能对齐,时间偏远即使文字对也算错;两者搭配才能判断是文字不行还是时间不行。
比较时要注意,解析率的分母是全部样本,后 3 个指标的分母是可解析样本;DER 的分母是时间,两个词错误率的分母是词数,不同量纲不能直接相减,相对变化与百分点也是两回事。
主结果显示文字尚可但时间定位是大瓶颈
跨六语种的主结果呈现 3 个稳定现象。第一,多数商用模型解析率较高,但 Gemini 3.7 Flash 在法语与韩语、Qwen3.5-Omni-Plus 在西班牙语上低于 80%,说明多语指令跟随并不均匀。第二,在西班牙语、法语、日语、韩语、俄语上,Gemini、Muse Spark 与 Doubao 系列的 cpWER 明显低于 DER 与 tcpWER,论文概括为 Gemini 类模型 cpWER 多在低位而 tcpWER 常超过 1.0,说明文字与身份大体能做,但精确到秒的边界给不准。第三,泰语在所有模型上都明显更差,论文经人工检查归因于泰语视频中说话人音色更相近,增加了身份区分难度,这是有证据的个案解释,不是跨语言的一般结论。
系列之间也有分工差异,Qwen 系列在 DER 上明显好于其他通用模型,显示其语音时长感知占优;任务专用的 MOSS Transcribe Diarize 0.9B 在几乎所有语言上仍领先绝大多数通用模型,Qwen3.8-Omni-Flash 是通用模型中整体最靠前者之一。
下面这张混淆分析图把说话人混淆随人数的变化单独量化,读图时注意柱子是样本量,折线是混淆率,两者量纲不同,观察样本稀疏处的波动要更谨慎。
看图路径: 1. 先看蓝色柱子随说话人数增加而样本量减少;2. 再看红色折线表示的说话人混淆率总体上升;3. 注意中间档位略有回落但末端升至最高的转折
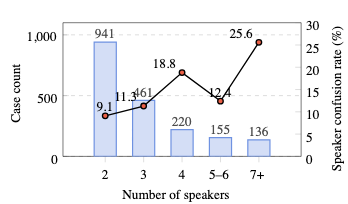
论文图 6。原论文 Figure 6::“Analysis of speaker identification. Blue bars represents the quantity of cases per category, and the red line gives the speaker confusion rate.”。
这张图可见蓝色柱子从左侧 2 人档向右侧高人数档明显变矮,红色折线总体向上,中间在 5 人附近略有回落但末端升至最高。它说明拥挤场景下身份错误快速增加,同时也提醒高人数档样本少,均值更易受个别难例影响。
\[\text{SCR}=\frac{T_{\text{conf}}}{T_{\text{total}}}\]DER × 说话人混淆率: DER 是漏检语音时间、误报语音时间与说话人判错时间之和除以总参考说话时间,衡量谁在何时说话的整体偏差;说话人混淆率是其中判错部分除以总时间,单独衡量身份分错比例;结合两者可以判断高 DER 到底是时间没找准还是人分错了。
高 DER 主要来自漏检还是分错人
为定位 DER 高的来源,论文把 DER 拆成漏检、误报与混淆三部分。下表整理的就是原文报告的 7 模型平均拆解,它回答的是高 DER 到底来自漏检、误报还是分错人。
| 误差类型 | 具体含义 | 原文报告数值 |
|---|---|---|
| 漏检语音 | 有说话但未检出对应的时间 | 31.7% |
| 误报语音 | 无说话但误判为有说话的时间 | 10.2% |
| 说话人混淆 | 有说话但身份判错的时间 | 12.5% |
该表比较同一 DER 定义下 3 类时间误差的相对大小,数值越小表示该类误差越轻,公平条件是同一基准与同一 0.5 s 宽容区下的平均结果。漏检是最大头,误报与混淆分别只占较小比例,支持瓶颈主要在时间戳预测而非身份区分的判断,但这仍是平均趋势,不能推广到泰语这种音色相近的特例,也不能说明单个模型在某语种下的拆解。整体 DER 达到 54.4% 的量级,说明时间定位误差累积后相当可观。
时长拉长与人数增多时退化发生在哪里
时长分析显示,解析率在 15 到 30 分钟档对 Doubao-Seed-2.0-Lite 与 Gemini 3.7 Flash 有明显下滑,时间敏感的 DER 与 tcpWER 随输入变长持续恶化,而忽略时间的 cpWER 恶化幅度小得多。论文据此判断,时间感知误差在长上下文中累积,主要伤的是时间戳精度。
人数分析显示,解析率随声学复杂度基本稳定,但计入身份的 DER、cpWER 与 tcpWER 都随人数明显恶化。下表整理的是原文报告的人数效应两端点数字,它同时给出总体混淆率与代表模型的 cpWER 变化,回答的是从 2 人到 7 人以上拥挤程度上升时身份错误如何变化。
| 条件 | 指标 | 2 人 | 7 人以上 |
|---|---|---|---|
| 全部样本 | 说话人混淆率 | 9.1% | 25.6% |
| Gemini 3.7 Flash | cpWER | 0.387 | 1.113 |
该表比较说话人数从 2 人到 7 人以上时身份错误的变化,两个指标都是越小越好,公平条件是同一基准划分与同一最优配对计分规则。混淆率近乎翻 3 倍,Gemini 3.7 Flash 的 cpWER 从低位升到超过 1,说明多说话人解耦仍是开放难题;但 7 人以上样本少且最多达 20 人,结论只在该基准的拥挤子集内成立,不能直接推到任意真实会议。未胜出的开源 Qwen3-Omni-30B 在人多时退化同样明显,商用模型之间也没有在所有语种上全胜。本表数值与单位依据论文 PDF。
加上画面后时间定位变好还是变差
论文用平行样本比较音频输入与视频输入,条件是同一模型、同一视频、同一提示词,仅把音频换成视频。这不是消融某个训练模块,而是检验视觉线索在推理时是增益还是噪声。
结果呈现分化。Qwen3.8-Omni-Flash 在两种设置下高度一致;Doubao-Seed-2.0-Lite 的 cpWER 在两种模态下相近,但视频在 tcpWER 与 DER 上明显好于音频,说明视觉帮它改善了边界与时间戳;Gemini 3.7 则相反,视频改善 cpWER 却恶化 tcpWER 与 DER,说明视觉干扰了它的时间定位。解析率也没有统一赢家,Gemini 家族用视频更高,其他模型有用音频更高,反映跨模态对齐策略不同。
进一步的 DER 分析显示,视频输入让语音漏检率降低,同时说话人混淆略有上升,说明画面有助于发现有人在说话,但没有改善身份区分。论文报告视频输入让语音活动检测改善而身份区分未改善,这是理解视觉作用边界的关键细节。
音频输入 × 视频输入: 音频输入指只给模型声音做转写,视频输入指同时给声音与画面做转写;论文用同一批样本的平行评测比较两者,意义是检验画面中的人脸与口型到底是帮模型对齐说话人与时间,还是作为冗余信号干扰时间定位。
这些结论在什么条件下才成立
首先,伪标签由 MOSS 与 Gemini 生成且时间戳只在明显错误时才改,评测可能偏向 MOSS,尤其在时间敏感指标上,因此 MOSS 领先通用模型的部分幅度不宜直接解读为架构绝对优势。
其次,商用接口随机且默认参数不同,解析率与小数点后差异会有波动,复现时应固定版本与多次采样,不能拿单次最优当部署增益。第三,泰语难主要来自该批视频音色相近的人工观察,不是语言本身的一般属性;时长与人数趋势受子集样本量限制,7 人以上与 15 到 30 分钟档样本少,个别难例会影响均值。
最后,DER 用 0.5 s 宽容区、tcpWER 用 5 s 容限,换容限会改变绝对值;解析失败样本不计入词错误率,解析率低的模型其词错误率是在更易解析的子集上算的,跨模型比较时要同时看解析率。
复现第一步做什么,需要哪些信息
复现先从索引与标注入手。论文给出仓库链接指向 Omnilingua-MSpeaker 目录,标注部分声明为 CC BY-NC 4.0 且仅供非商业研究,原始音视频不随库分发,需要按索引自行按平台条款获取视频。链接可达性需以实际访问为准,本文不代为断言开源状态。
推理复现要严格用附录提示词,要求类 XML 结构与 2 位小数时间戳,说话人从 0 按首次出现顺序编号;MOSS 按官方实现不加任务提示词。评测要复刻 0.5 s 的 DER 宽容区、5 s 的 tcpWER 容限、最优说话人配对与解析失败剔除规则,否则数字不可比。
建议先跑通短时长 2 人子集,核对解析率与 cpWER 量级,再扩展到长视频与多人子集,并记录模型版本、调用时间与采样次数。由于长视频输入大,开源模型需准备论文所述的 8 卡 A100 量级显存,商用模型需预留接口成本与超时重试。
什么时候值得尝试,还缺哪项验证
如果你做长视频转写、会议纪要或语音交互,且输入是多语多人、需要精确到秒的时间戳,这个基准值得用来摸底。它能帮你区分系统到底是文字不行、时间不行还是身份不行,避免只看普通词错误率就上线。
选型上,若更看重时间边界,论文中 Qwen 系列与任务专用 MOSS 在 DER 上占优;若看重跨模态一致性,Qwen3.8-Omni-Flash 的音视频差异小;若考虑 Doubao 或 Gemini,要在自己的视频上实测加画面是增益还是干扰,不能默认视觉总是有帮助。
还缺的验证包括换 DER 宽容区与 tcpWER 容限的敏感性分析、对解析失败样本的单独错误分析、在更多泰语之外音色相近场景的身份测试,以及固定种子多次调用的方差报告。补上这些,才能把论文发现的瓶颈从基准观测变成可指导模型改进的稳定结论。
📎 论文与评分元数据
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses