📄 昆曲字腔对齐与押韵检索:KunSet 语料库如何建成与验证
英文题目:KunSet: A Corpus and Benchmark for Lyrics Alignment and Rhyme Retrieval in Kunqu Opera
评分:7.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Lejun Min:机构信息未能在本次解析中与作者逐人可靠绑定
- Siqi Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Delong Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tong Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunqi Lu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhishan Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Ke Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuting Zhong:机构信息未能在本次解析中与作者逐人可靠绑定
- Junrong Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Shengran Jin:机构信息未能在本次解析中与作者逐人可靠绑定
- Beixuan Pei:机构信息未能在本次解析中与作者逐人可靠绑定
- Jun Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yang Li:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是昆曲演出录像中的唱词与念白,困难在于每个汉字对应一个音节,演唱中存在长时拖腔和程式化发音,通用语音或流行演唱对齐模型难以给出准确边界,同时每个音节的传统读音属性难以直接检索。论文构建了昆曲语料(KunSet),输入是 281 个折子录像及其视频文字与音频,输出是句子与音节的起止时间、演唱或念白方式、角色信息,以及每个音节链接到《韵学骊珠》的候选读音属性。处理过程先用视频文字识别与人声分离得到句子初稿,再用迭代微调的演唱对齐模型生成音节边界初稿,200 多名标注员在可缩放时间轴系统上修正并经过两轮审核,同时专家转写的音韵库为每个汉字提供候选属性。方法与已有句子级昆曲库的区别在于音节级对齐与音韵链接同时可用,与通用对齐模型的区别在于增加了声学锚点解码与昆曲全量微调。在 10 个测试录像的 11735 个内部音节边界上,251 个录像微调模型加锚点解码的平均边界误差为 194.83 ms,200 ms 容差准确率为 81.69%,优于预训练基线。结论适用于昆曲唱念混合录像的音节分析与同韵检索,演唱对齐仍弱于人工一致性,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
第三方资源:https://github.com/Kunyuan-Project/KunSet — 链接可访问(HTTP 200)
模型相关资源:https://github.com/Kunyuan-Project/KunSet — 链接可访问(HTTP 200)
第三方资源:https://tinyurl.com/kunset-icassp-demo → https://xiqu-annotation-system.vercel.app/demo/icassp — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
昆曲研究为什么需要精确到字的时间和音韵?
昆曲被联合国教科文组织列为人类口头和非物质遗产,其唱腔讲究依字行腔,一个汉字即一个音节,演唱时要经历头、腹、尾的发音过程。要比较不同流派或演员的实际处理,研究者既要知道每个字在录音里从哪 1 毫秒唱到哪 1 毫秒,也要知道这个字按传统音韵该归哪个韵、什么声调。
已有资源只解决了一半。《昆曲艺术大典》保存了 297 段专家精选折子的文本、曲谱和音视频,KunquDB 又给了句子级时间戳和角色信息,但都没有细到字。而《韵学骊珠》等音韵文献此前只有页面查阅界面,韵、声调、阴阳、清浊、五音、反切等属性没有和演出录音里的字挂接。论文要补的正是这两块缺口。
已有的对齐工具为什么直接用不好?
语音领域有 MFA 这类强制对齐工具,歌声领域有基于联结时序分类的方法和 SOFA。它们在普通话朗读或流行演唱上有效,但在昆曲上表现差。原因是昆曲有大量拖腔长音,一个字可以拖很多秒,边缘能量变化很平缓,加上程式化的念白和唱念混杂,发音分布超出了预训练模型的训练范围。
音韵数字化方面,九宫谱等工作标注了历史曲谱的声调和阴阳,但没有连到录音;《韵学骊珠》在线界面支持按原书页面查找,但不支持按字直接检索属性。因此论文不是重复做通用对齐,而是要做昆曲适配的语料、适配的解码和传统音韵监督的检索验证。
论文要解决的两个具体任务是什么?
第一个任务是音节级歌词对齐。输入是分离出的人声波形和已知顺序的乐句文本,输出是每个汉字音节的起始和结束时间。评价看内部音节边界的平均绝对误差和 200 毫秒内容忍准确率,误差越小越好,准确率越高越好。难点在唱段长音边界模糊,念白相对短促则容易一些。
第二个任务是同韵检索。输入是一段字的音频片段,目标是从曲库中找到与它同属一个传统韵部的其他字的片段。评价用 P@10,即前 10 个近邻中同韵实例所占比例,按韵组平均。难点是演唱中的实际发音与传统韵部、普通话韵母都不完全等同,需要验证哪种文字标签更能组织演出音频。
从录像到可用语料库要走哪几步?
整体流程是先拿句子再拿字,先机器预标再人工改。论文从 281 段高质量折子录像出发,用视频文字识别拿乐句文本和粗时间,用人声分离去掉伴奏,再用迭代微调的 SOFA 产生音节边界初稿,最后由 200 多名训练过的标注员在自研在线系统里改边界、标唱或念与角色,并经过两轮审校。另一条线是请古典文献专家把《韵学骊珠》转写成结构化数据库,再按字挂接到每个音节。
下图展示了音节标注这条主链与迭代循环的位置,读图时重点看机器与人工如何交替扩大训练集。
看图路径: 1. 先从左到右看原材料到句子初始化再到人声分离的主链条;2. 再看虚线框内对齐、人工校对、重训练如何循环迭代;3. 最后看输出端标注的录音数与已标注时长

论文图 1。原论文 Figure 1::“Annotation pipeline for the syllable-aligned corpus.”。
从左到右依次是原始视频与字幕、句子时间初始化、人声分离,然后进入虚线框内的迭代精化:SOFA 强制对齐产生初稿,人工核对修改,再用已审校数据重训练昆曲专用 SOFA 并重复。输出端写明 281 段录音共 155.2 小时媒体时长,其中 106.3 小时带有音节级边界标注,同时得到不断改进的昆曲对齐器。该图说明预标注模型不是一次训练完成,而是从 1 段人工标注起步逐步扩到 7 段再推广到其余 274 段。
标注存了什么?句子和字如何关联?
论文把标注定为三层。选段层是一段折子录像,含 720 乘 576、25 帧每秒的视频和 44.1 千赫立体声音频。乐句层是一句唱词或念白,记录起止时间、演唱方式是唱还是念、演出角色和文本。音节层是乐句里的每个汉字,记录起止时间和音韵字段,并用 lineId 指回所属乐句。所有时间都指在录音时间轴上的起点和终点。
下图是字段层次的示意图,读图时注意 1 对多关系和时间基准的一致性。
看图路径: 1. 看三层方框自上而下的包含箭头;2. 看乐句层记录的起止时间与演唱方式字段;3. 看音节层如何用 lineId 回指乐句并挂接音韵字段
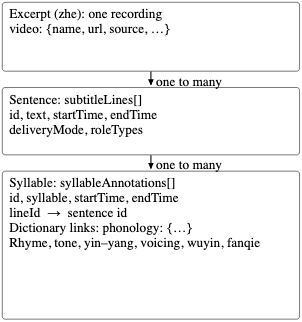
论文图 2。原论文 Figure 2::“Excerpt–sentence–syllable annotation hierarchy (selected fields).”。
图中最上为选段,中层为乐句数组,下层为音节数组,箭头标明 1 对多。乐句含编号、文本、起止时间和演唱方式与角色类型,音节含编号、字、起止时间、指向乐句的 lineId,以及韵、声调、阴阳、清浊、五音、反切等词典链接。该结构保证即使同一字在不同乐句出现,也能通过 lineId 找回其唱念方式和上下文。
音节 × 乐句 × 选段: 选段是一整段昆曲折子戏录像,乐句是其中一句唱词或念白并带有起止时间和演唱方式,音节是乐句里的每一个汉字发音。论文把三者做成自上而下的包含关系:选段包含多条乐句,乐句通过 lineId 包含多个音节,音节再挂接音韵候选。这样既能按时间定位到字,又能保留该字属于哪句、是唱还是念、由哪个行当角色演出。
预标注与人工审校如何分工?代价在哪里?
预标注先用 VideOCR 提取句子时间戳和文本,用 Mel-Band RoFormer 分离人声。论文先手标 1 段折子并微调 SOFA 的普通话演唱检查点,再用它标出更多段,经人工改对后加入微调集,如此循环把训练集从 1 段扩到 7 段,最后用该模型给剩下 274 段生成初稿。这个 7 段模型后来也作为对齐基准之一出现。
人工部分在自研在线系统完成,支持视频、文本、可拖动的音节区间在同一可缩放时间轴上显示,还可选看波形与语谱图。标注员改边界,审校员确认、留时间锚点评论、必要时再改,并标记疑难。流程是初标 1 人改、再经两轮不同人审,任务分配、文件权限和完成状态都在系统里协调。代价是组织 200 多人与两轮审校的人力,以及长唱段反复试听的时间。
人声分离 × 视频文字识别 × 预标注: 视频文字识别负责从录像字幕读出乐句文本和粗略起止时间,人声分离负责用 Mel-Band RoFormer 把人声从伴奏里分出来以便后续对齐听得更干净,预标注是把两者结果交给 SOFA 先产生音节边界初稿。三者分工是文本从哪来、音频用什么、边界初稿怎么来,组合后人工只需改边界而不必从零听写,大幅降低标注成本。
强制对齐 × SOFA × 声学锚点解码器: 强制对齐指在已知文本顺序的前提下为每个音素和音节找时间边界,SOFA 是论文沿用的面向歌声的强制对齐模型,提供帧级音素证据和原始解码器,声学锚点解码器是论文新加的推理期解码规则。它不改声学网络训练,只在搜索边界时同时要求每个音素区间内有一个证据最强的帧,从而在拖腔长音边缘模糊时仍能把边界拴在证据峰附近。
语料规模与音韵覆盖实际是多少?
下表回答语料有多大、唱念各占多少、字与音韵链接了多少。比较问题是该库是否同时覆盖唱与念、时间覆盖是否完整、音韵属性是否大量可解。指标方向是时长与条数越大覆盖越广,链接与解出比例越高越便于做音韵研究。
| Measure | Value |
|---|---|
| Recordings (the number of) | 281 |
| Media / lyrics-covered time (h) | 155.19 / 106.34 |
| Sung / spoken / mixed (h) | 50.30 / 55.15 / 0.90 |
| Sentence / syllable records | 78,505 / 482,164 |
| Distinct transcript characters | 4,357 |
| Sentence time coverage (known media) | 68.5% |
| Phonology-linked / resolved syllable records | 461,164 / 273,996 |
表中 281 段录音共 155.19 小时媒体时长,其中歌词覆盖 106.34 小时,唱 50.30 小时、念 55.15 小时、混合 0.90 小时,句子 78505 条、音节 482164 条,不重复汉字 4357 个,句子时间占已知媒体的 68.5%,有词典候选的音节 461164 条、6 个属性全部解出的 273996 条。数据说明唱与念在标注时长上大致均衡,约 95.6% 的音节找到了词典候选,但全部六属性无歧义的只占 56.8%,其余因一字多音或候选不一致而留空。
下图从分布上补充了上述总数的含义,读图时注意总量与逐段差异的区别。
看图路径: 1. 先看左上时间总量中唱、念与未标注的占比;2. 再看左下每段录音唱念混合比例的变化;3. 最后看右侧六个音韵属性的覆盖率高低差异

论文图 3。原论文 Figure 3::“Overview of 281 recordings. (a) Time by type; mixed denotes conflicting labels, outside denotes unannotated time.”。
该图 6 个面板分别显示按类型统计的时长、每段录音按唱占比排序的构成、句子与音节时长的累积分布、音韵是否全部解出以及各属性的解出率。可见唱句中位时长 8.81 秒明显长于念白的 2.77 秒,符合拖腔特点;各段唱念比例差异很大;反切等个别属性解出率偏低。这意味着按录音平均的评价会受长唱段主导,论文后文采用按录音平均正是为了不让长段淹没短段。
《韵学骊珠》 × 反切 × 韵部: 《韵学骊珠》是 1792 年成书的昆曲音韵分类体系,论文把它数字化为可检索的数据库,反切是其中用两个字拼注一个字读音的传统注音方式,韵部是按押韵归类的分组。一个汉字可能对应多个条目,论文保留全部候选,只有当候选唯一或多个候选在某个属性上一致时才填写该属性,否则留空,从而把传统知识与实际演出字音挂接起来又不强行消歧。
对齐模型怎么训练?新解码器算什么?
对齐实验用 251 段训练、20 段验证、10 段测试的按录音划分,测试以独立盲标版本 A 为参考。输入是分离后的人声与对应乐句文本。比较对象包括预训练普通话 SOFA、7 段微调的 SOFA 和 251 段全量微调的 SOFA,每种再分别配原始解码器与新提出的声学锚点解码器。全量模型微调声学主干与预测头 9000 步,用 AdamW、权重衰减 0.1、单周期学习率,主干峰值 6 乘 10 的负 5 次方、预测头峰值 3 乘 10 的负 4 次方,并用预训练 SOFA 提供的音素内边界伪标签加 0.1 权重的边界损失。每个种子与解码器按验证集录音平均边界误差选检查点。
新解码器的想法是长音边缘不清但内部证据强,就让边界选择与每段音素内证据最强帧联合决定。它在 SOFA 音素峰值打分基础上加了一项峰值奖励,按 2T 除以 S 加权,T 为帧数,S 为文本位置数,只对非静音位置计入区间内最大帧证据,并保留进入新位置的惩罚。搜索以 O(TS) 时间同时选锚点与边界,再把音素区间合并成音节。该改动只改推理不改声学训练。
\[F(\pi)={}\sum_{t=1}^{T}e_{t,\pi_{t}}+B(\pi)-M(\pi)\log 3+\frac{2T}{S}\sum_{s:p_{s}\neq\mathrm{SP}}\max_{t\in I_{s}(\pi)}e_{ts}\]上式中 π 把 T 帧分配到 S 个有序文本位置,ps 为音素标签,Is 为对应区间,ets 为帧级音素证据,B 为边界打分,M 乘 log3 为进入惩罚,最后一项为非静音区间的峰值奖励。求和先累加每帧证据与边界分,再加上加权后的各区间峰值,最大化该目标即同时挑出边界与锚点。
冻结 HuBERT 特征 × 投影头 × 监督对比损失: 冻结 HuBERT 特征指用现成的中文 HuBERT-base 编码器提取语音表示且不更新其参数,投影头是后面新训练的两层映射,把均值加标准差拼成的 1536 维向量压到 128 维并做归一化,监督对比损失是只训练投影头的目标,让同韵部片段在余弦空间里更近、不同韵部更远。三者搭配是为了检验音韵监督本身是否有用,而不让大编码器的微调掩盖这种作用。
检索实验与质量检验的条件是什么?
同韵检索沿用同样的 251、20、10 录音划分,只取已知唱念方式的句子,并保留传统韵部与普通话韵母都无歧义的实例,训练 256333 条、验证 20674 条、测试 10287 条,29 个韵组在测试都有查询。编码器用冻结的中文 HuBERT-base 处理 16 千赫片段,取最后一层帧表示的均值与标准差拼成 1536 维特征,按训练集统计标准化,再经 1536 到 256 到 128 的投影头、ReLU、0.1 丢弃率与输出归一化。训练只更新投影头,用温度 0.1 的监督对比损失,正样本取不同汉字且不同录音,批量最多 8 类每类 16 条,用 AdamW 学习率 10 的负 3 次方、权重衰减 10 的负 4 次方,训练 200 轮每轮 400 步共 3 个种子,按验证 P@10 选检查点。查询时在训练库中按余弦相似度检索,排除同字与同录音候选,指标为按韵组平均的 P@10。
标注质量检验另做 10 段测试录音的盲标对比。生产标注记为 M,另做两个盲标 A 与 B,盲标从 1 到 3 秒单调扰动句子起止并均匀切分音节初稿,再独立改对并经两轮审校。以 A 为文本基准找出三版共有的 15710 个音节,按录音平均计算起点与终点误差。声学一致性检验则在 281 段上比较音节起点与同句随机时刻的起始强度与均方根能量,看标注起点附近是否有系统性声学跳变。
对齐误差降了多少?唱与念一样吗?
下表回答语料规模扩大与新解码器各带来多少对齐增益。比较在同一 10 段测试、11735 个内部音节边界上进行,条件是同样的分离人声与文本输入,指标为按录音平均的平均绝对误差与 200 毫秒内容忍准确率,误差越低越好,准确率越高越好。
| Overall | Overall | Sung | Sung | Spoken | Spoken | ||
|---|---|---|---|---|---|---|---|
| Model | Decoder | MAE ↓ | Acc@200 ↑ | MAE ↓ | Acc@200 ↑ | MAE ↓ | Acc@200 ↑ |
| Pretrained | Original | 391.30 | 61.93 | 797.83 | 48.78 | 288.63 | 64.72 |
| Pretrained | Anchor | 337.70 | 65.12 | 702.34 | 50.76 | 241.07 | 68.45 |
| Ours (FT7) | Original | 372.91 | 64.49 | 753.40 | 53.66 | 267.69 | 67.25 |
| Ours (FT7) | Anchor | 312.90 | 67.60 | 620.62 | 56.64 | 233.98 | 70.35 |
| Ours (FT251) | Original | 224.04 | 79.52 | 529.21 | 65.35 | 144.95 | 83.46 |
| Ours (FT251) | Anchor | 194.83 | 81.69 | 462.48 | 67.50 | 123.77 | 85.84 |
全量 251 段微调加声学锚点解码的总体误差为 194.83 毫秒、准确率为 81.69%,相比同解码器下 7 段模型的 312.90 毫秒与 67.60% 有大幅下降;同为全量模型时,锚点解码比原始解码把误差再降约 13.04%,准确率从 79.52% 升到 81.69%。预训练模型总体误差 391.30 毫秒,说明直接套用普通话演唱模型不够。但分开看,唱段误差仍达 462.48 毫秒、准确率仅 67.50%,念白误差 123.77 毫秒、准确率 85.84%。论文指出唱段误差仍高于人类不一致的 272 到 409 毫秒范围,而念白已与人类不一致的 108 到 165 毫秒相当,主要剩余困难在昆曲唱而不在念白。该结论只在该划分、分离人声与盲标 A 参考下成立。
传统韵部监督比普通话韵母更有用吗?
下表回答用哪种文字标签训练投影头更能把演出音频按韵组织起来。比较在同一 10 段测试池与同一查询集上进行,编码器与投影结构相同,只换监督标签,另设冻结 HuBERT 无投影头与打乱韵组两种对照,指标为按韵组平均的 P@10,越高越好。
| Supervision | P@10 ↑ |
|---|---|
| None (HuBERT) | 11.36 |
| Shuffled rhyme groups | 8.81 ± 0.07 |
| Modern Mandarin finals | 16.35 ± 0.14 |
| Traditional rhyme groups (ours) | 17.16 ± 0.11 |
传统韵组监督为 17.16% 正负 0.11%,普通话韵母为 16.35% 正负 0.14%,冻结 HuBERT 为 11.36%,打乱韵组为 8.81% 正负 0.07%。传统比普通话高 0.81 个百分点,录音级自助 95% 区间为 0.47 到 1.18;比冻结特征高 5.80 个百分点。论文解释小差距与两套音韵体系大量重叠一致,大增益说明音韵监督本身有助于组织音频。但检索以传统韵标签评价,传统占了体系一致的便宜,且绝对值仅 17% 左右,说明同韵检索仍很难,不能夸大为已解决。29 个韵组都有查询保证了不是只在少数大韵上取胜。
标注一致性与声学证据支持什么?
下表检验机器预标注是否引入系统偏差。比较生产标注 M 与两个盲标 A、B 之间的起点与终点误差,按 A 的唱念标签分组并按录音平均,误差越低一致性越好。若 M 与 A、B 的差异接近 A 与 B 之间的差异,则说明预标注加审校达到了独立重标的水平。
| Overall ↓ | Overall ↓ | Sung ↓ | Sung ↓ | Spoken ↓ | Spoken ↓ | |
|---|---|---|---|---|---|---|
| Pair | Onset | Offset | Onset | Offset | Onset | Offset |
| M–A | 158.8 | 206.4 | 272.1 | 354.1 | 115.8 | 156.7 |
| M–B | 172.5 | 225.5 | 309.1 | 408.5 | 126.2 | 165.0 |
| A–B | 158.1 | 207.3 | 282.8 | 384.0 | 108.2 | 147.8 |
总体上 M 与 A 的起点终点误差为 158.8 与 206.4 毫秒,M 与 B 为 172.5 与 225.5 毫秒,A 与 B 之间为 158.1 与 207.3 毫秒,三者最多差 18.14 毫秒。唱段 3 组误差明显大于念白,终点误差大于起点误差,但该模式在 3 对比较中都存在,说明是标注难度本身而非机器预标注特有。该检验只覆盖 10 段测试录音,不能推广到全部 281 段。
声学层面看音节起点是否为真实声学转折,读图时注意实线与虚线的分叉只在零点附近。
看图路径: 1. 看横轴相对采样点的正负时间与纵轴标准化取值;2. 比较实线字起点与虚线随机点在零点附近的走向差异;3. 注意阴影所示的录音级自助置信区间宽度

论文图 4。原论文 Figure 4::“Acoustics around syllable starts and random times in the same sentence.”。
左为起始强度即对数梅尔谱通量的正部,右为均方根能量,横轴为相对采样点的秒数,零点为字起点或随机点,实线为字起点、虚线为同句随机点,阴影为 2000 次录音级自助的逐点 95% 区间。字起点处两条曲线都从低谷陡升,而随机点同期下降;0 到 200 毫秒的起始强度对比为 0.47 个标准差,区间 0.46 到 0.49,排除句首字后仍有 0.43。这支持标注起点与声学过渡在全库层面相关,包括句内字,但只是相关而非逐字正确性的证明。
这些结论在什么条件下才成立?还有哪些局限?
对齐结论依赖分离后的人声、已知乐句文本、按录音划分与盲标 A 参考,换成分离前的混音、文本有误或跨剧种就不再保证。唱段误差 462 毫秒意味着很多长拖腔边界仍偏半秒左右,实际做细粒度腔格分析前还需人工核对。检索结论依赖传统韵评价体系与排除同字同录音的设置,若改用普通话韵母评价或允许同录音近邻,名次与数值都会变。
语料本身也有缺口。句子时间覆盖已知媒体的 68.5%,仍有未标注时间;混合标签 0.90 小时说明个别时段唱念判定冲突;六属性全解出的只占 56.8%,反切等属性覆盖更低,做音韵建模时要处理缺失。质量检验只在 10 段上做盲标对比,声学验证是全库统计相关,都不能替代逐段的人工验收。论文未报告训练与推理的硬件耗时,也未测误判率与实时延迟,不能据此承诺部署成本会降低。
要复现与使用该工作第一步做什么?
复现对齐先按 251、20、10 的录音划分准备分离后的人声与乐句文本,用预训练 SOFA 作起点,按论文的学习率与 9000 步设置微调声学主干与预测头,再分别用原始与声学锚点解码器解码并按录音平均计算误差与 200 毫秒准确率。复现检索先按无歧义条件筛选实例,用冻结中文 HuBERT 提取最后一层特征并拼均值标准差,再只训练投影头并按验证 P@10 选检查点。
资源方面,论文给出 GitHub 链接与演示链接,并在摘要中声明发布 KunSet 与模型检查点。本次已核验 GitHub 地址可访问,但未逐项确认语料文件的下载内容、版本和使用条件;使用前须另行核对 281 段、482164 条等规模与论文是否一致。论文的发布声明、文件是否可下载以及系统能否运行需要分别核对。音韵数据库含 10235 条目、8300 个可直接查字,其中 1664 个多条目,复现时要注意保留多候选与缺失留空的规则,不要自行消歧。
什么时候值得尝试 KunSet?还需要补什么验证?
当研究问题需要昆曲字级时间或传统音韵与实际发音的对照时值得尝试,例如比较不同演出同一唱段的字腔处理,或检验传统韵部在演唱中有多大声学可分性。念白对齐已接近人类一致性,可优先用于批量预标注加少量审校;唱段适合做适配训练与误差分析,不宜直接当金标准使用。检索适合做音韵组织的探索性实验,不宜当高精度检索引擎。
还需补的验证包括在更多录音上重复盲标一致性、在混音与不同分离器下测对齐鲁棒性、报告训练推理耗时与跨折子泛化,以及在普通话韵母评价下重算检索差距以剥离体系一致的影响。容易产生的误解是把 17.16% 当成整体音频理解能力,或把全库声学相关当成每个边界都准,原文证据只支持按韵组平均的相对增益与全库层面的统计关联,需要回到原文的划分、指标与聚合方式去理解。
📎 论文与评分元数据
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses