📄 一张日常录音如何变成贴合画面的说话声:HeyGen Voice 解读
英文题目:HeyGen Voice: Scene-Aware Voice Cloning for Talking Videos
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
👥 作者与机构
- Pavel Andreev:机构信息未能在本次解析中与作者逐人可靠绑定
- Andrei Gusev:机构信息未能在本次解析中与作者逐人可靠绑定
- Adithya Narayan:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi Ren:机构信息未能在本次解析中与作者逐人可靠绑定
- Ivan Somov:机构信息未能在本次解析中与作者逐人可靠绑定
- Zijian Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Sergey Demyanov:机构信息未能在本次解析中与作者逐人可靠绑定
- Viktor Goriachko:机构信息未能在本次解析中与作者逐人可靠绑定
- Alan Tan:机构信息未能在本次解析中与作者逐人可靠绑定
- Nik Nolte:机构信息未能在本次解析中与作者逐人可靠绑定
- Sam Prokopchuk:机构信息未能在本次解析中与作者逐人可靠绑定
- Andy Pan:机构信息未能在本次解析中与作者逐人可靠绑定
- David Chou:机构信息未能在本次解析中与作者逐人可靠绑定
- Kirill Leonov:机构信息未能在本次解析中与作者逐人可靠绑定
- Penghan Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiewei Yuan:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhibin Hong:机构信息未能在本次解析中与作者逐人可靠绑定
- Rong Yan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
配画语音应听起来像画面中的人在画面地点说话,但普通克隆把参考录音的话筒、房间和演绎一起搬运,任务要求保留参考中的音色口音,同时按目标图像重做演绎与混响并在长脚本中保持稳定。编码阶段将目标图像、说话人字幕(Speaker Caption,描述音色与演绎)、背景字幕(Background Caption,描述环境声与变化)与参考语音经冻结编码器加注意力池化压成固定长度条件前缀,该前缀与文本一起进入自回归变换器(Autoregressive Transformer,按顺序逐个预测离散声学编码的模型)。变换器输出的声学编码序列与其隐状态进入流匹配解码器(Flow Matching Decoder,学习连续潜空间速度场并积分生成波形的模块),结合参考音频渲染44.1 kHz波形,推理时由音频锚点导出的一致性嵌入加前文声学窗固定后续分块的嗓音与环境。相对已有描述控制合成、由脸推声、图像混响迁移和音视频联合生成的区别是既保留指定说话人又让声学跟随画面,并提供两种克隆策略调节贴近参考与贴近场景的程度。在2026年10月9日Artificial Analysis可控声音榜单快照的盲听成对投票Elo评分下,语音克隆设置以1201分居首,高于Qwen-Audio-3.1-TTS-Plus的1182分等商业系统。在生产环境用户克隆自有声音的盲选投票占比中,选择该模型而非ElevenLabs v4为62%、而非Cartesia Sonic 3.6为54%。在43人评价本人数字分身配画视频的视频评分(满分100)中,两种设置平均分76.1分和72.6分,高于Cartesia Sonic 3.6的63.1分、ElevenLabs v4的59.2分和Seedance 2.5的45.7分,结论适用于有目标图像与字幕的配画场景,长脚本一致性依赖锚点缓存,原文披露端到端实时率(Real-Time Factor,合成耗时与音频时长之比)为约0.1。
🔗 开源与复现资源
- 第三方资源:https://heygen.com/heygen-voice → https://www.heygen.com/heygen-voice — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
为什么普通克隆的声音放进视频里会别扭
这篇论文处理的是说话视频的配音。输入是一段用户平时录的参考音频、一张目标画面、一段要读的脚本和想要的演绎风格,输出是一段 44.1 kHz 的语音轨,再交给下游的视频渲染管线。必须保留的是说话人身份,包含音色、口音和说话节奏;必须改变的是演绎和声学,让声音听起来像画面里的人在画面里的地方说话。
普通语音克隆把参考录音当作嗓音的定义,手机录的就带着手机的话筒和房间,播客室画面也照样是手机味。论文指出,读测基准上各家字符错误率只差零点几个百分点,真正拉开差距的是演绎、声学和与用法的贴合。对刚入门的同学来说,关键是把身份和录音条件分开:身份要留,话筒、房间和那一次的讲法要能换。
已有路线各只做对了一半
论文把相关工作按输入和目标对照。商用语音克隆能保住特定说话人,但声学跟着参考录音走;文字描述控制的合成能调演绎,但看不到画面;从脸推测声音的方法能给出一个合理的声音,但保不住指定的那个人;图像条件合成和视觉声学匹配能加场景混响,但同样不保指定说话人;联合音视频生成是连画面带声一起生,也不是从指定嗓音出发。
训练范式上,零样本合成已收敛到两大家族:自回归模型先预测离散声学单元再用声码器、扩散或流模型重建,另一家是非自回归的流匹配或掩码预测一次生成整句。本文属于前者,用梅尔谱派生的向量量化编码加扩散变换器式的流解码器,再加上图像、描述和连续性条件。奖励和偏好优化也是沿用已有做法,区别是先用识别和验证奖励保可懂度和相似度,再用低秩适配器做表现力偏好。
三个难处和一个取舍是什么
第一个难处是数据本身跟任务作对。普通合成数据里参考和目标来自同一录音,参考已经解释了演绎和声学,模型没有理由去看图像;真正同一人在不同场景的配对又少又难找。第二个难处是一张图加两段话并没有唯一确定房间声,同一房间可以有多种混响和话筒距离,逐块独立采样就会每块都合理但连起来像换了房间。第三个难处是保真和贴景的张力:有人想听起来完全像原录音,有人想听起来完全像画面里的地方。
论文把问题写成条件生成。脚本决定说什么,图像和两段描述决定预期的表演和场所,参考和连续上下文提供嗓音以及在需要时保留的声学,克隆策略决定是为画面重新设计还是延续参考。这就是后文所有模块的来源。
整个系统让一个样本走完需要哪些步骤
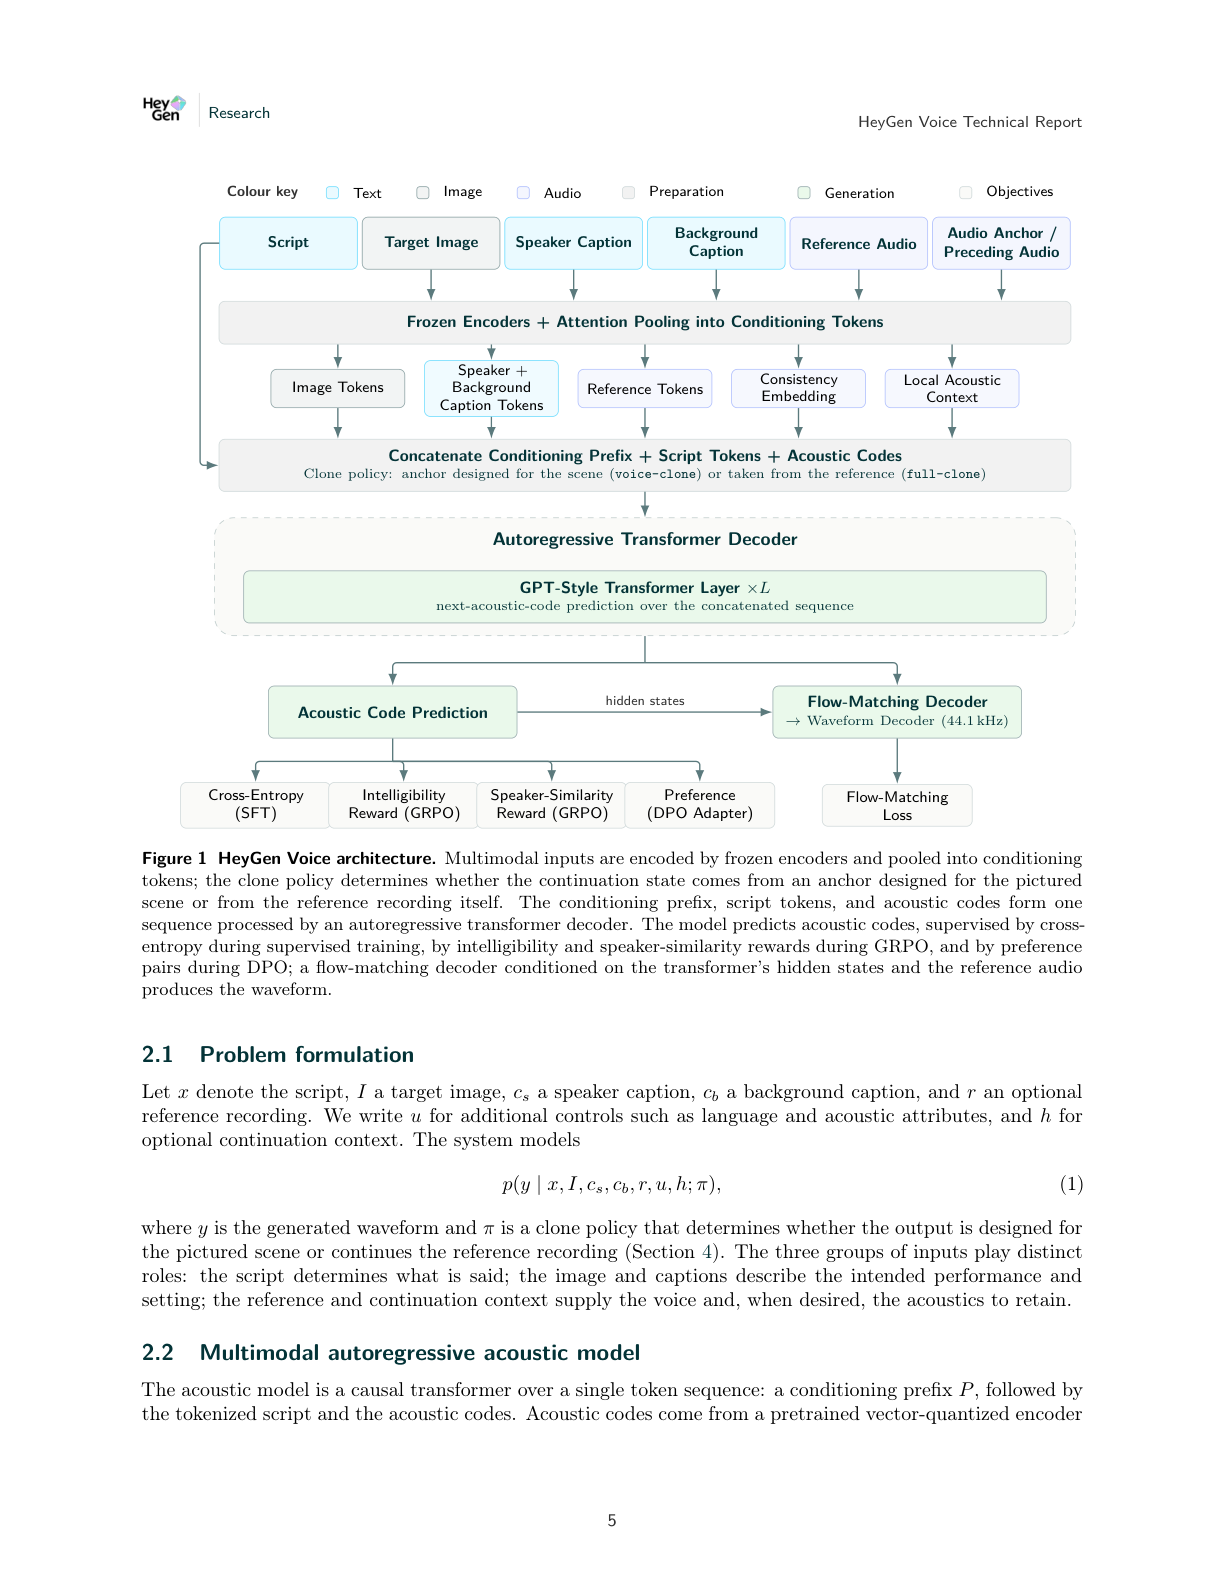
以一个例子串起来:用户用手机录了一段日常语音作为可复用的参考,选了一张播客室的照片并指定要亲切专业的讲法,语言模型先按图和风格写出说话人描述和背景描述。接着冻结的编码器把图像、两段文字和参考音频分别压成固定个数的条件单元,和脚本单元、声学码拼成一个长序列,自回归变换器逐个预测声学码,再把隐状态交给流匹配解码器和波形解码器生成波形。第一次为该场景生成的 utterance 会被缓存为音频锚点,后续长脚本都作为它的延续来合成。
下面这张结构图值得对照着看,它把条件、拼接、预测和解码的走向画在了一起,下一节再拆每路输入的具体作用。
参考音频 × 目标图像: 参考音频负责提供说话人是谁,包含音色、口音和说话节奏;目标图像负责提供应该在什么样的画面里说话,包含人物和场所线索。两者分工后组合,模型才能在换场景时只换演绎和房间声而不换人。
看图路径: 1. 先看顶部输入行:脚本、目标图像、两段描述、参考音频和锚点分别进入哪一路;2. 再看中间拼接的前缀加脚本加声学码如何进入自回归变换器;3. 注意声学码预测之后如何经由隐状态进入流匹配解码器得到波形;4. 对照底部目标:交叉熵、可懂度奖励、说话人相似奖励和偏好分别作用在哪一段
图片来源: 原论文 PDF 第 5 页(含图 1)
论文图 1。原论文 Figure 1::“HeyGen Voice architecture. Multimodal inputs are encoded by frozen encoders and pooled into conditioning tokens; the clone policy determines whether the continuation state comes…”。
图 1 是全文的总装图。顶部是脚本、目标图像、说话人描述、背景描述、参考音频和锚点或前文音频 6 路输入,中部是池化后的图像单元、说话加背景单元、参考单元、一致性嵌入和局部声学上下文,下部是自回归变换器预测声学码,再经隐状态进入流匹配解码器输出 44.1 kHz 波形,底部标注了有监督交叉熵、可懂度和说话人相似奖励以及偏好对分别监督哪里。读图时重点看分支在哪里汇合成一个序列,以及克隆策略切换的是哪一路延续状态。
图像、两段描述和参考音频各自管什么
每路条件进入前缀之前都经过冻结编码器加学习到的注意力池化,压成少量固定个数的单元。这样前缀开销有界,变换器可以在一个序列里跨模态注意。目标图像用冻结的视觉语言视觉编码器嵌 patch 特征再池化,总结人物和场景;但图像说不清要哪种演绎和声学实现,所以另有两段自由文本描述补上。
两段描述在训练时由描述模型从目标录音写出,推理时由语言模型从目标图像和指定风格写出,用户不直接写。说话人描述讲嗓音和表演,背景描述讲声源、空间以及背景在整段里如何演变。参考音频用冻结音频编码器加池化总结成参考单元,携带音色、口音和节奏,而目标表演和场所由图像、描述和声学控制指定。另外还有 3 个数值控制:音高变化管一句话里声音起伏多大,信噪比管背景相对语音多大,环境均匀度管背景在整段里是否漂移。
下表列出声学模型前缀的全部来源,先看分工再看公式如何把它们拼成一个自回归问题。
| Source | Role |
|---|---|
| Target image | Person and scene context |
| Speaker caption | Delivery and vocal attributes |
| Background caption | Environment and acoustics |
| Reference tokens | Speaker voice: timbre, accent, and speaking cadence |
| Consistency embedding | Shared voice and scene acoustics |
| Local acoustic context | Local acoustic continuity |
表 1 回答条件前缀由哪些来源组成、每路起什么作用。图像管人和场景上下文,两段描述分别管演绎和环境,参考单元只管嗓音的音色口音节奏,一致性嵌入管跨块共用的嗓音加场景声学,局部声学上下文管上一句尾巴怎么接到下一句。它的限制是只讲组成不讲权重,实际以哪个条件为主还要看训练和克隆策略。
声学码来自预训练的向量量化编码器对梅尔谱的编码,生成按从左到右分解,每一步看脚本、前缀和已生成的码预测下一个码。
\[p_{\theta}(a_{1:T}\mid x,P)=\prod_{t=1}^{T}p_{\theta}(a_{t}\mid a_{\lt t},x,P).\]上式说明自回归声学模型的分解方式,P 就是上表所有条件拼成的前缀,x 是脚本,a 是声学码序列。它只管离散码的规划,不管波形细节,波形由下一步的流模型完成。
说话人描述 × 背景描述: 说话人描述讲表演和嗓音属性,如音调、语速、表现力;背景描述讲环境和声学演变,如声源、空间和背景是否稳定。图像本身说不清到底要多混响、多大声的背景,两段文字把含糊的画面意图变成可分别控制的显式条件。
声学码怎样变成波形,长脚本怎样不串味
声学码采样完后,模型把整个序列重放一遍得到变换器的隐状态 H,再以它和参考音频为条件,用扩散变换器式的流模型在连续音频隐空间积分一个学到的条件向量场,最后经波形解码器得到波形。离散码速率低于连续隐变量,对齐后再解码。视觉和描述信息只通过 H 进入波形,解码器本身没有图像输入。
\[\frac{dz_{\tau}}{d\tau}=v_{\phi}\!\left(z_{\tau},\tau\mid H_{\theta}(x,P,a),q\right),\qquad y=D_{\psi}(z_{1}),\]上式前半是流匹配的积分,z 是隐变量,v 是条件向量场,条件包含隐状态和参考音频 q;后半是解码器把终点隐变量变成波形 y。它解释的是从规划好的码到可听波形的渲染路径。
长脚本先按语言相关的字符预算归一化切块。为防止每块独立采样漂成不同房间,每块都复用同一个锚点导出的一致性嵌入,锚点在 voice-clone 下是为场景设计的新输出,在 full-clone 下是处理过的参考本身;同时用一个滑动窗口的在前声学上下文告诉模型上一块是怎么结束的。表现力适配器以缩放系数 s 作用于变换器投影,s 为 0 就回到基础模型,成为推理时的连续可调控制。
一致性嵌入 × 局部声学上下文: 一致性嵌入来自选定的音频锚点,为长脚本的每一块固定同一套嗓音加演绎加房间声;局部声学上下文是上一块尾部的声学码窗口,告诉模型上一句是怎么收尾的。前者管全局不漂移,后者管块与块之间接得上,两者一起才有长时一致性。
两种克隆策略到底在切换什么
两种策略的名字按从参考里克隆什么来取。实际使用时先做一次声音设计:有参考就保住说话人、按图和描述走场景和演绎,无参考就把参考单元置零、由图和文字定义一个新声音;这次输出成为音频锚点并缓存,后续脚本都作为它的延续合成,不重复设计。参考音频上限为 60 秒。
下表是原文对两种策略的定义,比较问题是谁的演绎和声学说了算。
| Clone policy | Behavior |
|---|---|
| voice-clone | Clones the voice: timbre, accent, and speaking cadence. Delivery and acoustics follow the image, captions, and acoustic controls. |
| full-clone | Clones the voice and the acoustic conditions of the reference. Highest similarity to the original recording. |
表 2 说明 voice-clone 只克隆嗓音的音色口音节奏,演绎和声学听图像、描述和数值控制,适合在新场景认出是同一个人;full-clone 把嗓音连同参考的声学条件一起克隆,相似度最高,适合新语音听起来像同一录音。它的限制也在正文写明:目标场景与参考不同时,voice-clone 的声学适配更自由,而 full-clone 会带着原房间走。
voice-clone × full-clone: voice-clone 只克隆嗓音,演绎和声学按图像和描述重新设计;full-clone 把嗓音连同参考录音的演绎和房间一起延续。两者共用同一模型,只是音频锚点来源不同,组合起来让用户在贴合新场景和忠于原录音之间二选一。
五阶段训练每一步在教什么
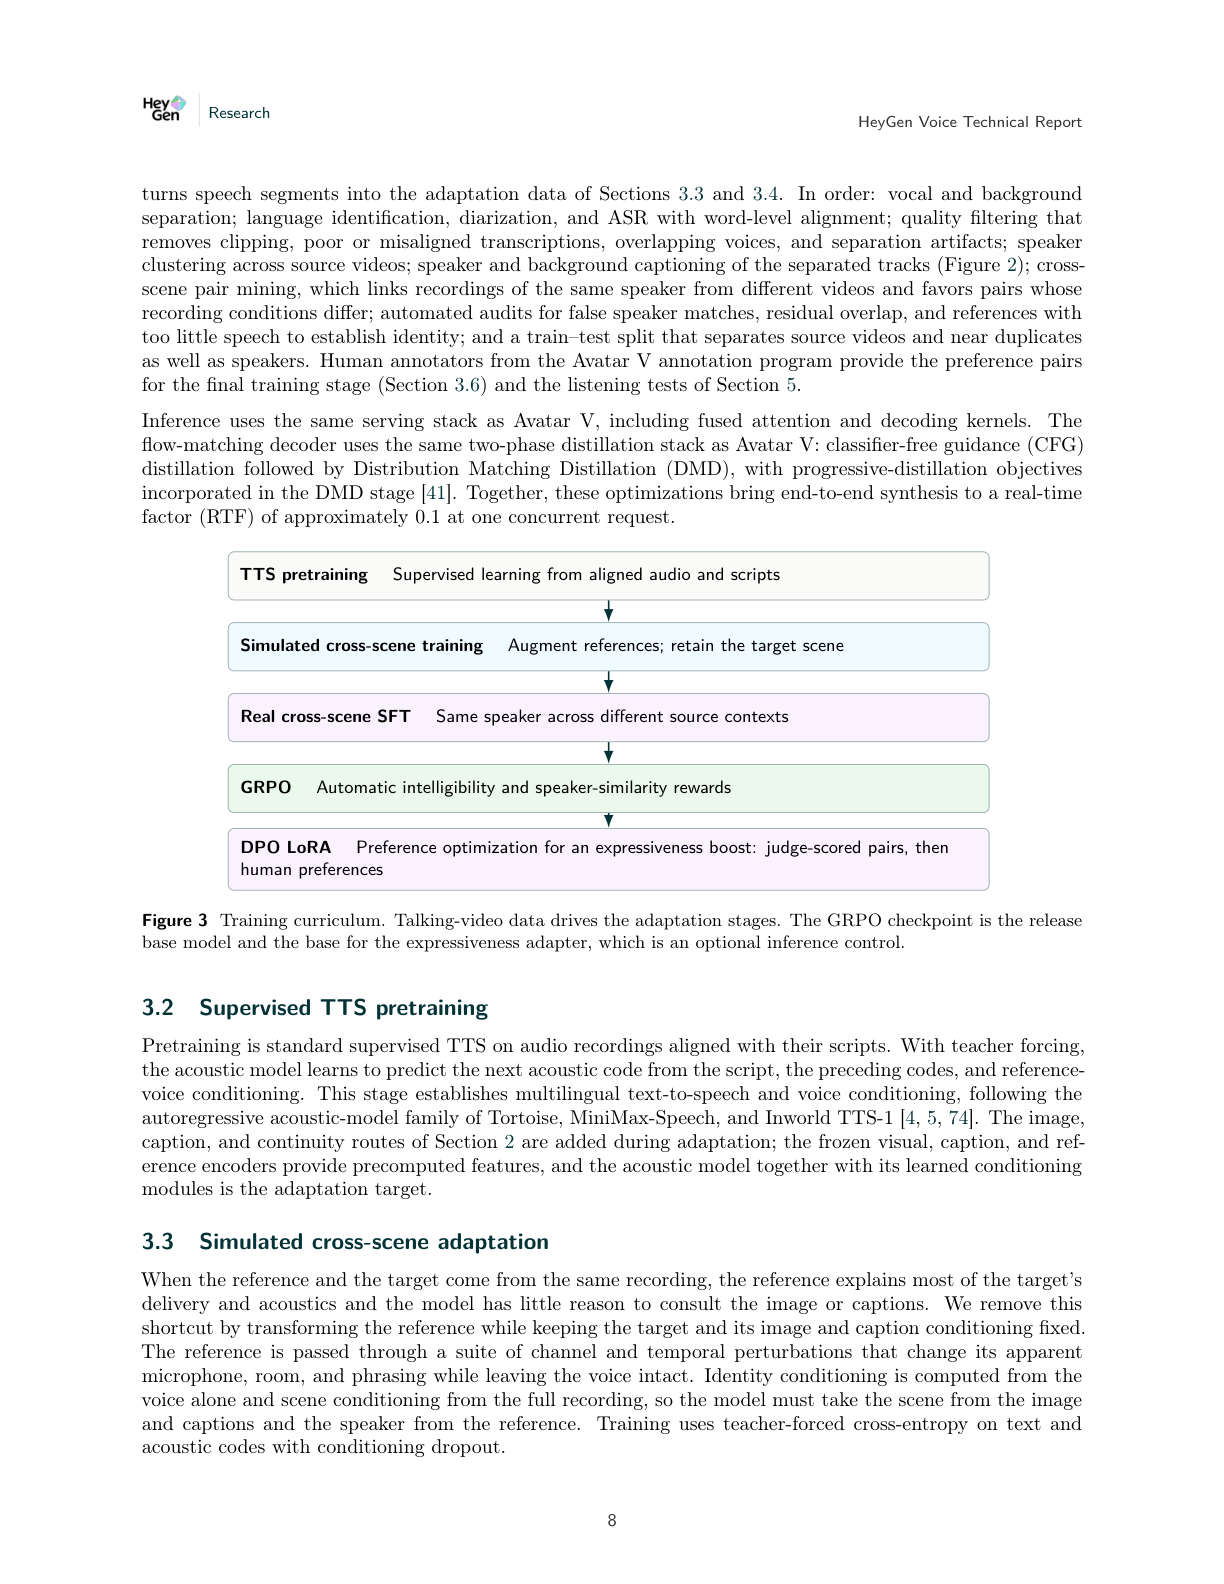
训练分 5 步,数据和算力依托同一说话视频语料和 HELIOS 平台。第一步是有监督多语种合成预训练,用教师强制预测下一个声学码,建立多语种读写和嗓音条件能力,图像、描述和连续性通路在适配阶段才加入。第二步是模拟跨场景适配,把参考做通道和时间扰动以改变话筒、房间和措辞但保留嗓音,目标及其图像和描述不变,身份条件只从嗓音算、场景条件从完整录音算,逼模型向图像和描述要场景、向参考要人。 下图是课程总览,建议按顺序读,每一步的目标和数据都不同。
看图路径: 1. 从上往下看五个阶段的顺序和每个阶段要解决的子问题;2. 注意模拟跨场景和真实跨场景两步分别用什么数据;3. 看最后两步如何标出基础模型和可选的表现力控制
图片来源: 原论文 PDF 第 8 页(含图 3)
论文图 3。原论文 Figure 3::“Training curriculum. Talking-video data drives the adaptation stages.”。
图 3 自上而下是合成预训练、模拟跨场景、真实跨场景有监督微调、组相对策略优化和低秩直接偏好优化。原图注明确说明组相对策略优化的 checkpoint 是发布底座,也是表现力适配器的起点,适配器是可选的推理控制,这一点结合正文可知,不在图内文字里。
第三步用真实跨场景对微调,同一说话人来自不同源视频的两段录音组成 1 对,参考定身份,目标音频图像描述定表演和场所,并继续保留参考增强。论文强调对子质量决定成败:配错人会教模型学错嗓音,条件太接近则学不到跨场景适配。第四步是组相对策略优化,每组采样多个候选并解码成波形,用语音识别和说话人验证打分,奖励是人声分离后生成与目标的验证相似度加字符词错率转化来的可懂度项,组内中心化成优势后做带 KL 惩罚的截断更新,本阶段不用参考增强。
\[\mathcal{J}(\theta)=\mathbb{E}_{i,t}\!\left[\min\!\left(\rho_{i,t}A_{i},\operatorname{clip}(\rho_{i,t},1-\epsilon_{-},1+\epsilon_{+})A_{i}\right)-\beta\,\widehat{D}_{\mathrm{KL},i,t}\right],\]上式是带裁剪和 KL 惩罚的优化目标,rho 是新旧策略的 token 概率比,A 是组内优势,epsilon 控制截断范围,beta 控制与参考策略的距离。它约束的是在保住可懂和保住指定嗓音的前提下更新声学规划。
第五步是表现力直接偏好优化,只训练低秩适配器,先用前沿多模态评委对同一条件的候选按表现力和身份保持打分组成偏好对,再用人工二选一纠正评委与听众不一致的地方,发布的是第二轮结果。因为更新是低秩的,底座保留且适配强度可在推理时调节。
组相对策略优化 × 直接偏好优化适配器: 组相对策略优化用自动语音识别和说话人验证打分,直接奖励可懂度和说话人相似度;直接偏好优化适配器只训练一个低秩小模块,用自动评委和人工二选一奖励措辞、重音、节奏和情感。前者保住底线不读错、不变人,后者在底座不动的前提下加表现力。
评测在什么条件下比较才公平
论文的评测分音频和视频两类。音频类有跨场景基准、多语种内容保真、五语种配对听感、平台用户生产投票和第三方 arena;视频类有 43 人自评自己的数字分身和 50 场景多环境对比。商用 API 对比都用默认设置,未调参。区间按 95% 写成正负 1/2 宽,非对称时取较大一侧。
听感基准固定 245 个参考加脚本组合,每对系统共享同样的脚本和参考,HeyGen Voice 的目标图像统一适配到同一个播客室模板,要求专业主播在处理过的房间里的演绎和声学,听众只听音频。参考录音大多是日常设备在未处理房间录的非专业 conversational 讲法,模板场景与典型参考的距离就是产品要跨过的距离。下表是语言和是否同语种的构成。
| Target language | Intra-lingual | Cross-lingual | Total |
|---|---|---|---|
| English (US) | 22 | 25 | 47 |
| Spanish (Mexico) | 25 | 24 | 49 |
| German (Germany) | 25 | 25 | 50 |
| French (France) | 25 | 24 | 49 |
| Chinese (China) | 45 | 5 | 50 |
| Total | 142 | 103 | 245 |
表 3 说明听感基准的比较基础:英语 47、西班牙语 49、德语 50、法语 49、中文 50,共 245 例,同语种 142、跨语种 103,只有 5 例中文是跨语种,因此语种和跨语条件混在一起,不能把两子集的差距直接解读为语言迁移的代价。所有系统对都复用同一批用例,每例每维度 5 个评分,共 42875 个评分。
下图是听感基准的目标图像示例,帮助理解 voice-clone 被要求往哪个方向走。
看图路径: 1. 观察四张示例图中共用的播客室元素:话筒、耳机、声学板和桌面;2. 对比四位示例人物的年龄和外貌差异,理解模板化适配的做法;3. 思考这种统一场景对听感对比意味着什么

论文图 5。原论文 Figure 5::“Target images of the listening benchmark.”。
图 5 中 4 张示例是按同一播客室模板适配的不同 AI 生成面孔,共用广播话筒、耳机、声学板和暖光书桌。这意味着听感部分测的是固定演播室设定下的语音质量和参考相似,而不是跨可见场景的声学贴合,跨场景贴合由视频研究回答。
内容有没有读错:十语种的结果怎么读
多语种用修正过的 MiniMax 多语种克隆测试集的子集,每语种 100 脚本、2 个来自 Common Voice 的参考说话人,每系统 1000 条。论文修订了 110 个脚本的源文本错误但保留全部用例,HeyGen Voice 用 full-clone 且关闭图像、用通用描述。因为原始识别错误多是转写和正字分歧,论文报的是 agreement-only 字符错误率:只有当 Scribe v2 转写和独立的 Gemini 音频复核都认为偏离脚本才计错,不一致的计零错但保留分母。英文人工复核确认真实偏离只出现在两者一致的片段上,至少在英文上该规则把合成错和转写方差分开了。
下表是各语种和宏平均的对比,比较问题是在修正脚本下内容保真是否与其他强系统同档。
| Language | HeyGen full-clone | Qwen3-TTS 1.7B | Cartesia Sonic 3.6 | ElevenLabs v4 | Inworld TTS-2 |
|---|---|---|---|---|---|
| English | 0.0000 | 0.0000 | 0.0089 | 0.0000 | 0.0000 |
| Chinese | 0.0000 | 0.0286 | 0.0526 | 0.0000 | 0.0492 |
| Spanish | 0.0000 | 0.0000 | 0.0000 | 0.0000 | 0.0109 |
| French | 0.0000 | 0.0000 | 0.1389 | 0.0000 | 0.0000 |
| German | 0.0000 | 0.0114 | 0.0827 | 0.0000 | 0.0000 |
| Italian | 0.0099 | 0.0270 | 0.0393 | 0.0238 | 0.0099 |
| Portuguese | 0.0000 | 0.0000 | 0.0663 | 0.0137 | 0.0367 |
| Russian | 0.0000 | 0.1551 | 0.0000 | 0.0000 | 0.0000 |
| Japanese | 0.0000 | 0.0000 | 0.1625 | 0.0000 | 0.0294 |
| Korean | 0.1429 | 0.0556 | 0.2353 | 0.0895 | 0.2127 |
| Macro average | 0.0153 | 0.0278 | 0.0787 | 0.0127 | 0.0349 |
表 4 显示 HeyGen 的宏平均为 0.0153%,与 ElevenLabs v4 的 0.0127%、Qwen3-TTS 1.7B 的 0.0278%、Inworld 的 0.0349% 同档,低于 Cartesia 的 0.0787%,其被双方一致认定的错误只在意大利语和韩语。论文的结论也很克制:到这个量级基准已分不开系统,读对不等于好听,所以字符错误率只作为保底诊断,质量主要看后面的听感。这是对该表适用条件的准确限定。
跨场景基准和第三方擂台说明了什么
跨场景基准用 TalkVid 和 CelebV-HQ 的同人不同源配对,共 331 例,参考最多 60 秒,目标有真实录音、文本和场景帧。对子经音频嵌入距离和说话人验证筛选以保证录音条件不同。HeyGen Voice 额外拿到目标帧、按真实目标写的描述和信噪比控制,因此测的是富目标场景指引下的生成,而基线 Cartesia、ElevenLabs v4 和 Inworld 不接受图像描述。指标是 ECAPA-TDNN 余弦的说话人相似度,分别对目标和对参考,都先做人声分离,以及 ImageBind 的生成对目标音频和生成对目标帧余弦。
原文报告 voice-clone 的场景对齐最高,音频对音频 0.637、音频对图像 0.282,对目标说话人相似 0.590,高于 Cartesia 的 0.582 和 ElevenLabs 的 0.556;full-clone 对参考相似最高 0.757,高于 Cartesia 的 0.745,对目标场景对齐回落但仍是第二。Inworld 各项落后。论文提醒嵌入分受内容、嗓音和背景共同影响,只是代理指标,声学贴合要看视频研究的人工判断。
第三方 Artificial Analysis 受控嗓音榜是论文唯一没自己跑的评测,8 个固定克隆嗓音,听众只听两段生成、不听参考,因此对参考相似不敏感,HeyGen 用 voice-clone 参赛。下图是 2026 年 10 月 9 日的快照,读图时注意分数和排名范围的不确定性。
看图路径: 1. 看第一名与第二名的分数和区间是否有重叠;2. 注意右侧排名范围列如何表示不确定性;3. 确认该榜单固定八个克隆嗓音,比较的是演绎和质量而非选嗓

论文图 9。原论文 Figure 9::“Top ten of the Artificial Analysis controlled-voice text-to-speech leaderboard, snapshot of October 9, 2026.”。
图 9 显示 HeyGen Voice 以 1201 分排第一,领先 Qwen-Audio-3.1-TTS-Plus 的 1182、Eleven v4 Turbo 的 1166、Eleven v4 的 1162,以及同为 1142 的 Cartesia 和 Inworld,排名范围单独置顶。它的适用条件是固定嗓音比演绎和质量,商用系统的排序与论文自己的主播选择听感一致,但不能从这里推出参考相似谁更高。
配对听感里两种策略为什么一升一降
配对听感在 Podonos 上做,质量组问主播选择、自然度、母语口音和清晰度,相似组给 10 秒参考并问更像谁。每对每维度 1225 个评分。直接对比显示一个由设计决定的模式:voice-clone 按播客室图像走专业主播演绎,离通常有噪声有混响的 conversational 参考更远,于是在主播选择、清晰度和口音上被奖励,在参考相似上被扣分;full-clone 延续参考的演绎和声学,模式反过来。
数字上,voice-clone 的主播选择对 ElevenLabs v4 为 61.5%、对 Cartesia 为 77.9%、对 Inworld 为 68.1%,清晰度优势更大,分别 78.4%、86.6%、63.5%,对 ElevenLabs 的自然度 50.2% 打平;参考相似分别只有 43.1%、22.7%、44.9%。full-clone 的相似对 ElevenLabs 为 63.0%、对 Cartesia 为 53.8%、对 voice-clone 为 72.1%,主播选择对 ElevenLabs 打平 47.3%、对 Cartesia 占优 60.8%。Bradley-Terry 拟合把五系统放在同一 Elo 尺度,voice-clone 固定 1000,拟合与观测的最大差距 5.0 个百分点,Inworld 只经由与 voice-clone 的 1 对比较定位。
分语种看,voice-clone 在英西德法的主播选择最高,中文是 ElevenLabs v4 在主播选择和自然度领先;full-clone 或 Cartesia 在每语种的参考相似最高且区间重叠。跨语种下 voice-clone 对 Cartesia 和 Inworld 的优势更大,但因子集语种构成不同,不能当作语言迁移代价的受控估计。生产投票是 full-clone 的音频-only 场景:8332 票对 ElevenLabs 占 62.2%,7286 票对 Cartesia 占 54.1%,三方 6153 票占 41.7% 高于随机的 33.3%,与听感相似维度的 63.0% 和 53.8% 互相印证。
把两种策略看成一组对照能学到什么
论文没有做常规的去掉某模块的消融,但两种克隆策略本身就是一组受控对照:同一底座、同一参考和脚本,只换锚点来源。跨场景基准里 voice-clone 对目标更高、full-clone 对参考更高;听感里 voice-clone 的主播选择 73.6% 胜 full-clone,相似 27.9% 输 full-clone,清晰度 77.3% 胜 full-clone,因为后者带着原录音的声学走。志愿者评语也分开:voice-clone 被说干净清晰但有时不像自己,full-clone 被说更像原录音,连颗粒感、呼吸和节奏都像。
这组对照的价值是把取舍量化了:在用户型参考配演播室场景的基准里,主播可用性和参考相似必然反向,两个策略落在观测到的帕累托前沿上,ElevenLabs v4 居中,Cartesia 和 Inworld 在前沿之下。代价也很清楚:要场景就要交相似,要相似就要交主播质感和清晰度。中文和跨语种的例外提醒该前沿随语言和用例移动,不能把 pooled 的排序直接套到每一语种。
哪些结论出不了这个评测范围
首先,跨场景基准给了 HeyGen 富目标指引而基线没有图像输入,所以场景对齐的领先是在信息不对等下测的,只能说明在有图有描述时能做到,不能说明同信息下结构更好。其次,听感和生产投票的参考多是日常设备 conversational 录音,结论只在这种用户型参考下成立,换成专业录音棚参考,差距会缩小甚至反转。
再次,50 场景视频研究每对比每维度 250 票、每场景 5 个评审,评审固定,只能推广到场景而不能推广到评审总体;其中对 ElevenLabs 的总体偏好 50.7% 和声学贴合 55.0% 打平,对 Seedance 的总体和声学贴合也与持平不可区分,只有环境声贴合显著。志愿者自评 43 人,voice-clone 与 full-clone、无显著差异的 Cartesia 与 ElevenLabs 之间都不能宣称等价,未做等价检验。最后,论文未报告误判率、延迟和成本的完整测量,端到端实时率约 0.1 只在单并发下给出,不能承诺多并发和长视频管线的开销。
如果要复现第一步该做什么
先分清三件事:论文提到试听页链接可用,但那是第三方产品页,不是作者开源;训练数据处理跑在 HELIOS 和 Avatar V 语料上,无公开权重和代码,复现只能从评测逻辑开始。第一步是重建跨场景对:同一人不同视频的两段语音,经人声背景分离、语种识别、说话人分离、识别加词级对齐、质量过滤、跨视频说话人聚类、说话人和背景描述,再按录音条件差异选对,并做防错配审计和按源视频加说话人的划分。
模型侧可先做最小闭环:冻结的图像、文本和音频编码器加注意力池化出固定个条件单元,拼脚本和声学码做自回归训练;先用同录音对建立基线,再加参考扰动去掉同录音捷径,对比是否开始用图像和描述。评测侧照抄原文条件:同一脚本同一参考、默认 API 参数、人声分离后算相似度、转写加独立复核一致才计错、听感用整用例自助法和 Holm 校正。作者资源当前可用指的是试听页可访问,不代表可运行系统已公开。
什么时候值得试,还缺哪项验证
当任务是为可见人物和场所配音、且只有一段日常参考时,这个思路值得试:用同一参考为每个场景设计一个锚点再批量延续,想要像原录音就选 full-clone,想要像画面里的地方就选 voice-clone。证据支持的是:在用户型参考配演播室或多变场景下,场景化的一侧在主播选择、清晰度和视频整体印象上占优,延续的一侧在参考相似和用户自选克隆上占优,内容保真与其他强系统同档。
还缺的验证是同信息下的结构对比、专业参考下的取舍位置、更大评审池和多并发成本,以及图像引入的外貌与口音关联是否会被显式描述充分抵消。论文把嗓音是谁和录音什么样分开,声音设计从此是为画面做的 authored 选择,而不是找回画面里真人的声音,这个定位本身比分数更值得记住。
📎 论文与评分元数据
排名:前50% | 文档类型:模型报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses