共分析 34 篇论文
⚡ 今日概览
✅ 筛选入选 34 篇 → 🔬 深度分析完成
每篇论文保留完整分层分类;热门方向按主任务的最上级方向统计,每篇计入 1 个方向。排行榜也显示最上级任务。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| 音频分类 | 4 篇 | ████ |
| 语音识别 | 3 篇 | ███ |
| 音视频理解 | 3 篇 | ███ |
| 声学系统参数估计 | 2 篇 | ██ |
| 空间音频渲染 | 2 篇 | ██ |
| 语音交互 | 2 篇 | ██ |
| 语音合成 | 2 篇 | ██ |
| 音频伪造检测 | 2 篇 | ██ |
📊 论文评分排行榜(34 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 边听边说还要记住:DuplexLedger 如何考查全双工语音智能体的事务性记忆

英文题目:DuplexLedger: Benchmarking Transactional Memory in Full-Duplex Speech Agents
评分:7.6/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yuxuan Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiangchen Guan:机构信息未能在本次解析中与作者逐人可靠绑定
- Kunrong Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Jin Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Kaiwen Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Yang Xiao:机构信息未能在本次解析中与作者逐人可靠绑定
- Yufei Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhisheng Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Liang Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Kun Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
全双工语音智能体需边听边说维护持久记忆,难点在于同一段声音可能是新事实、修正、未说完的停顿、寒暄式回应或说给旁人的话,系统须判断是否入库以及如何覆盖旧值。以往评测把交互时机与记忆结果分开,答对单题不能说明状态是否连贯。论文构建双语基准DuplexLedger,把暂停处理、说给他人、用户寒暄和用户打断四种并发情形与Write/Update/Ignore/Retain事件级记忆操作绑定,每个会话保留操作前后的参考状态,并用同会话口语提问检验记忆。ACT-Mem以外挂方式配合冻结的MiniCPM-o 4.5主干,事件控制器先对流式音频事件判定接纳与操作类型,版本化账本据此记录生效值与覆盖关系。记忆问答时按题型检索的模块再从账本中选出相关与禁用标识对应的证据卡,经原有问答通路送入主干生成口语回答。在219个留出会话、保持冻结MiniCPM-o 4.5主干的受控比较中,ACT-Mem相对该主干的最新值准确率从4.11%提高到8.68%。在同样219个留出会话与主干对照下,最终状态覆盖率从1.27%升至2.00%但置信区间跨过零点,陈旧断言与干扰采纳有所下降。打断后停止变慢,说明边界控制与记忆修订尚未兼得。原文未披露训练时长、推理延迟与吞吐的完整实测成本。
🔗 开源资源
- 代码相关资源:https://github.com/lyx-researcher/DuplexLedger — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 工况约束的视觉-语言匹配如何做管道空化诊断

评分:7.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yu Sha:机构信息未能在本次解析中与作者逐人可靠绑定
- Junqi Tao:机构信息未能在本次解析中与作者逐人可靠绑定
- Deyu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Horst Stoecker:机构信息未能在本次解析中与作者逐人可靠绑定
- Domagoj Vnucec:机构信息未能在本次解析中与作者逐人可靠绑定
- Andreas Widlf:机构信息未能在本次解析中与作者逐人可靠绑定
- Kai Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
工业管道阀门节流区的空化诊断以声信号与上游压力、下游压力、流量等工况变量为输入,输出空化状态类别,难点在于相同频谱在不同工况下含义不同,同一空化强度在不同工况下声表现也不同,仅看声学易混淆过渡态。论文提出的物理工况引导视觉语言匹配为每个声样本生成包含其工况数值的候选状态文本,使语义描述随当前工况变化。声学证据来自连续小波变换时频图与冻结的对比语言图像预训练编码器,时频响应通过交叉注意力对上述工况感知文本做条件适配,再做整体与局部匹配得到视觉语言得分。物理证据来自标准化工况空间的K近邻加权投票,用训练工况分布估计各状态的物理合理性,并在决策层以乘性先验与视觉语言得分融合输出最终类别。与只学声学表征或直接复用视觉语言表征的方法不同,该融合让声学语义与工况约束互补,消融显示去掉任一通路准确率均明显下降。在Cavitation-Short上该方法准确率为97.14%,F1值为96.08%,超过最强的MulT基线5.15个百分点准确率。在Cavitation-Noise上四项指标均为100.0%。该结论适用于训练与测试工况分布重叠的阀门管道场景,当采样率大幅降低、噪声增强或观测时长跨数据集变化时性能会下降,跨设备与全新工况范围尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/CavitationDetection/POC-VLM — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 Omni-Woodpecker:在融合表示里找回被压制的证据

英文题目:Omni-Woodpecker: Hallucination Correction via Evidence-Prior Rebalancing for Omni LLMs
评分:7.5/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.4/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zijian Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Chaoyou Fu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Caifeng Shan:机构信息未能在本次解析中与作者逐人可靠绑定
- Ran He:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是同时接收问题文本、视频和音频的全方位大语言模型(Omni Large Language Models,OLLM),输出是与问题对应的答案,困难在于早期融合把查询需要的证据与竞争模态的线索混在一起,解码前已形成偏向错误答案的隐藏状态。Omni-Woodpecker(OWP)先运行完整输入、纯音频、纯视频和纯文本四个视图,比较首个答案是否一致来判定查询需要音频还是视频,并找出与完整答案一致的竞争来源。接着它用目标视图减去纯文本状态得到证据方向,用融合状态减去目标状态并去除证据分量得到与证据正交的先验方向,同时计算融合状态缺失的证据量。最后它按完整视图对竞争答案的偏好强度,把一个修正预算分配给注意力通路加权和残差状态修复,分别抑制竞争头的值贡献、恢复缺失证据。与对比解码和偏好优化只调整输出分布不同,该工作直接改写同层融合表示而不更新参数。以 Qwen2.5-Omni-7B 为骨干,OWP 在 CMM 上达到 86.1% 总体准确率,比骨干提高 12.9 个百分点;在完整 AVHBench 上达到 83.7%,比骨干提高 8.6 个百分点。结论只适用于查询相关的跨模态冲突且需要白盒读写隐藏状态的开源 OLLM,原文报告在 RTX A6000 上平均延迟为骨干的 1.71 倍至 1.77 倍,峰值显存为 24.9 GiB 和 17.3 GiB。
🔗 开源资源
- 代码相关资源:https://github.com/ZiiJianLiu/Omni-Woodpecker — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. MiCLA:用混合到成分的残差对齐学习复调音频表示

英文题目:MiCLA: Mixture-to-Constituent Latent Alignment for Polyphonic Audio Representation Learning
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kohei Yamamoto:Research & Development Center, Technology Division, Oki Electric Industry Co., Ltd., Saitama, Japan.
- Kosuke Okusa:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
真实录音常包含多个同时发生的声音事件,模型需要在保留整体声学背景的同时,让下游可读出每个构成片段的语义。已有掩码自蒸馏多把单个片段作为训练单元,混合声音监督平均化(SSLAM)把两个构成片段的教师目标平均为一个目标,没有要求混合表示同时保留两者的可访问信息。MiCLA(Mixture-to-Constituent Latent Alignment,混合到构成潜在对齐)先在第一阶段用掩码自蒸馏与实例级对比约束建立单个片段的表示空间,再在第二阶段加入合成混合,用残差化去掉一个构成方向后与另一个构成的教师表示对齐,并交换方向形成双向任务。局部块标记(patch token)记录局部时频内容,采用完全投影去除;全局类别标记(class token,CLS)汇总全局上下文,采用按样本自适应调节去除强度,以保留可能的共享背景。微调下该方法在 AudioSet-20K 上达到 43.2% 平均精度均值(mean average precision,mAP),在 AudioSet-2M 上达到 50.3% mAP;在冻结 Convex Gated Probing(凸门控探测,CGP)下在两个 AudioSet 切分上均为受比较模型中最高,联合语义检索中相对匹配的目标平均基线平均提高 5.0-9.2 个百分点。结论适用于两两对数梅尔插值混合与所用 ViT 编码器,未验证无约束真实混合、未知事件和多于两个声源;原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/nttcslab/eval-audio-repr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/worstchan/EAT-base_epoch30_pretrain — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/ta012/SSLAM_pretrain — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/hanxunh/AudioMosaic-vit-b16-pretrained — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/lrauch/BAT-vit-b1 — 链接不可用(HTTP 401)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. 先验声学再验一遍:VISH 如何从帧后验里挑选热词

英文题目:VISH-ASR: Viterbi-Guided Selection of Hotwords for Speech-LLM Contextual ASR
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.5/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xiaoyu Gu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Xi:机构信息未能在本次解析中与作者逐人可靠绑定
- Chencheng Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zonghan Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Haoyu Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Jing Peng:机构信息未能在本次解析中与作者逐人可靠绑定
- Kai Yu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
提示式上下文语音识别需要从上千量级的动态热词表中挑出少量与当前语音声学证据相符的词,再放入提示以引导语音大模型转写,难点在于离散首遍假设可能丢掉声学证据,而另训检索模型又增加训练与维护成本。论文提出的Viterbi引导的热词选择(Viterbi-guided Selection of Hotwords,VISH)直接在帧级CTC后验轨迹上为每个候选词搜索最优局部对齐并打分,累积分数按最优路径非空帧数归一化以减轻时长偏置。多词版本(Multi-Word VISH,M-VISH)把候选词组织成共享前缀树以复用公共词元前缀的计算,并用前\(K_p\)剪枝控制活跃前缀数量。双向版本(Bidirectional M-VISH,Bi-MVISH)把后验与词序列同时反转再做一次同类搜索并与前向分数平均,以补偿词首声学证据弱时的漏检。与已有做法的差异在于验证不依赖离散转写出现该词,也不训练新的语音文本检索模型,仍保持即插即用。与复现的已学习检索基线相比,M-VISH在LibriSpeech test-other 2000词条件下最佳F1(Best-F1)从82.4%提升到87.7%,Bi-MVISH进一步到88.8%。适用范围限于能给出可靠候选词CTC词元后验的场景,发音特殊或拼写变体可能削弱分数,原文未披露训练、推理或部署成本,外部打分器在内部后验不可用时会增加一次声学编码。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. 用证据草图约束解码:SKAD 如何让音频推理更贴近声音

英文题目:SKAD: Sketch-Guided Audio-Contrastive Decoding for Reasoning in Large Audio-Language Models
评分:7.5/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Junyu Wang:Tianjin Key Laboratory of Cognitive Computing and Application, College of Intelligence and Computing, Tianjin University, Tianjin, China
- Peiyuan Jiang:Tianjin Key Laboratory of Cognitive Computing and Application, College of Intelligence and Computing, Tianjin University, Tianjin, China
- Siyuan Zhang:Tianjin Key Laboratory of Cognitive Computing and Application, College of Intelligence and Computing, Tianjin University, Tianjin, China
- Jian Zong:Tianjin Key Laboratory of Cognitive Computing and Application, College of Intelligence and Computing, Tianjin University, Tianjin, China
- Tianrui Wang:Tianjin Key Laboratory of Cognitive Computing and Application, College of Intelligence and Computing, Tianjin University, Tianjin, China
- Zikang Huang:Tianjin Key Laboratory of Cognitive Computing and Application, College of Intelligence and Computing, Tianjin University, Tianjin, China
- Meng Ge:Tianjin Key Laboratory of Cognitive Computing and Application, College of Intelligence and Computing, Tianjin University, Tianjin, China
- Longbiao Wang:Tianjin Key Laboratory of Cognitive Computing and Application, College of Intelligence and Computing, Tianjin University, Tianjin, China;Huiyan Technology Co., Ltd, Tianjin, China
- Jianwu Dang:Shenzhen Institute of Advanced Technology, Chinese Academy of Sciences, Guangdong, China
📌 核心摘要
大型音频语言模型需先听清语音、环境声与音乐中的事件和时序,再结合问题组织多步推理给出答案,难点在于音频连续短暂且与文本概念对齐不完全,模型易脱离声学证据而沿语言习惯续写。论文提出SKAD先由原模型根据音频、问题与候选项生成简短声音证据草图,把相关声事件、说话行为、场景属性或时间关系写成文本,作为后续推理的共享依据。随后音频条件分支同时看到原音频与草图,纯草图分支只看到草图而屏蔽音频,两者在同一草图和已生成前缀下同步解码。在词分布分歧位置用对照调整强化原音频支持的词,只改推理时词表分布,不训练参数、不改结构。与直接对无音频思维链做对照相比,关键差异是纯草图分支保留了文本化听觉依据,不再从空上下文猜测,从而提供更可比的参考分布。在MMAR上以平均准确率为指标,Step-Audio-R1基线为62.6%,使用SKAD后提高到64.8%。在MMAU小型测试集上以平均准确率为指标,Step-Audio-R1基线为71.1%,使用SKAD后提高到74.8%,为表中最佳平均结果,适用范围限于能输出词分布的模型与所测三类音频问答,对其他语言、长音频或开放问答尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/MyParadise21/SKAD — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. 说话人即触发器:只靠目标人自然声音激活的语音后门

评分:7.4/10 | 创新 1.6/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Nataša Krčo:机构信息未能在本次解析中与作者逐人可靠绑定
- Euodia Dodd:机构信息未能在本次解析中与作者逐人可靠绑定
- Peter Romov:机构信息未能在本次解析中与作者逐人可靠绑定
- Yves-Alexandre de Montjoye:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音模型把声学输入映射为转写文本或供给智能体执行的指令,训练要求忽略说话人身份只保留语言内容,攻击者想让特定人未见过的自然语音稳定触发选定载荷而其他人说话保持正常,难点是身份线索弱、目标真实语音少且复杂载荷还依赖说话内容。第一阶段在LibriSpeech上联合训练转写与说话人判别并丢弃临时判别头,使编码器后期层保留可用的身份方向,该共享检查点可复用于不同目标的第二阶段投毒混合训练。第二阶段用目标人少量真实语音加语音克隆合成语音凑足20分钟预算绑定攻击载荷,并混入非目标干净语音维持正常转写。与以往在波形中添加超声、环境声或做音色转换并在推理时施加触发的方法不同,该工作在微调后不再接触受害者输入,触发物就是目标人正常说话,转写文本中也看不到外加痕迹。在以Judi Dench为目标、20分钟预算内用2分钟真实语音的转写压制评测中,held-out真实目标语音上的后门成功率指标下,Parakeet的97.0%高于Whisper-medium的90.2%,而VoxCeleb2非目标误触发率上Parakeet的0.0%低于Whisper-medium的1.7%。在Whisper-medium同一目标和预算的语义改写评测中,held-out可编辑片段上编辑点成功率指标下,含第一阶段训练的35.0%高于去掉第一阶段的12.6%,该结论适用于5名目标说话人、多种退化与指令注入下游执行。Whisper后门不耐受下游干净微调,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. 长对话里声音串台怎么办:在扩散重建之前先把说话人排好队

英文题目:Beyond Two Tracks: Speaker-Anchored Full-Duplex Dialogue Recovery
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuxuan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yang Xiao:机构信息未能在本次解析中与作者逐人可靠绑定
- Jack Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Chak Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Brick Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Sam:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
全双工对话要求在同一时间轴上保留两个人各自的说话与静默,直接把混合录音分成两个声道并不能保证同一说话人始终留在同一声道,跨处理窗口的交换会让后续对话模型学错归属。本文输入一段两人混合语音与两段固定注册语音,输出两条按注册顺序固定的连续语音,难点在一人主讲而另一人近乎静默时,重叠证据与解码后波形都难以判断归属。方法先用冻结分离器得到两条32维、50Hz的粗粒度流,共享路由器把每条流池化为说话人嵌入并与注册锚点比较,交换位决定两条流进入扩散生成器的顺序,低置信度片段再对已解码波形做选择性核验。相对已有做法,身份判断发生在扩散重建之前,生成器参数保持冻结,重建音质不受排序影响,核验只覆盖部分输出而非全部重建。与使用相同注册信息的解码后重识别相比,CANDOR25分钟对话的错误归属时间占比从6.2%降至4.1%,固定声道活动F1从0.46升至0.84,而按块取最优排列时的音质指标变化不超过0.004。跨域上同一路由器把面对面与电话录音的错误归属时间降至0.9–1.7%,仅对20–36%输出做嵌入核验,而完全重识别需嵌入全部输出。结论适用于长时非对称对话与跨域录音,但依赖会话内注册语音与离线分块;推理开销上路由器含1.84M可训练参数,在20个会话计时子集上中位端到端实时率从0.0193升至0.0198,增幅约2.8%,不含可选核验。
🔗 开源资源
- 第三方资源:https://elpsykongloo.github.io/beyond-two-tracks/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. 分层语音合成里语调藏在哪里,又该拨动哪一根弦

英文题目:Steering intonational tunes in text-to-speech synthesis
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Juan Pablo Vigneaux:机构信息未能在本次解析中与作者逐人可靠绑定
- Jennifer Cole:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
研究对象是英语陈述与疑问在末重读词后呈现的降调与升调,输入是带句号或问号的文本加说话人音色提示、输出是波形,难点在于残差向量量化把波形切成每帧多层码字,难以判断哪层或哪个模块携带语调。方法把生成拆成沿时间运行的主干网络、预测第0层码字的浅层头与逐帧补全其余层的深度模型,交换匹配句对的码字层与主干隐状态观察基频曲线移动,再对主干隐状态施加均值差向量推动调形。在十说话人集合9090对匹配句上,以向源条件的归一化位移为指标,交换末词第11至末层码字位移为0.99而仅交换第0层为0.00,前者高于后者。在同一十说话人声音上,以末词偏移为指标,问号使偏移增大2.09 ERB而十八种风格标签平均改变量仅在-0.38至0.00 ERB之间,前者高于后者。以余弦为指标,人声拟合向量与标点向量的对齐度在CSM为0.66、在S2为0.44,均高于标签打乱零假设最大值0.31与0.19。结论只适用于调形尾缘升降判断,对重音起始处调控未经验证,向断言推动会损伤音色,且S2把音高重音与边界调联合表征。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/jpvigneaux/steering-intonation-tts — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. 槽位不是说话人:给冻结流式 diarizer 加一个免训练的身份链接器

英文题目:Slots Are Not Speakers: Training-Free Speaker Linking for Frozen Streaming Diarizers
评分:7.3/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Aditya Srinivas Menon:机构信息未能在本次解析中与作者逐人可靠绑定
- Kumarmanas Nethil:机构信息未能在本次解析中与作者逐人可靠绑定
- Kavya Manohar:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
流式说话人分离标注输入整段录音,输出谁在何时说话的时间线,难点是冻结主机训练时固定了并发槽位数,超过上限后仍能检出语音活动却复用槽位,导致身份合并为说话人混淆。连接器只读冻结主机的槽位后验和原始音频,先按单槽占优的对数几率挑出最干净的60%帧以避开重叠与不确定帧,再在槽位时间线上以嵌入余弦相似度低于0.40切出身份变化的片段,接着用现成说话人编码器对片段内保留帧取平均嵌入,最后将该嵌入与已见身份质心库按最高余弦相似度比对并受并发互斥约束,前一步的片段划分与嵌入直接决定后一步的比对对象。相对联合训练连接器或加宽输出头再微调的思路,它不训练任何参数,且只重标记身份而不改动一帧语音活动,因此漏检与误检与主机完全相同、全部增益只来自说话人混淆下降。在1418个会话、0.25秒容差且计重叠的同一评分下,冻结4槽主机加连接器后在505个超上限会话上的分离标注错误率从36.81%降到22.64%。同一评分下913个低于上限会话的变化为-0.08个百分点,配对自举区间包含零,说明基本不动。在4个最多23人的法庭听证上,用固定识别器转写并以连接最小置换词错率计时,加连接器后相对冻结主机从82.7%降到24.4%。结论只适用于主机30.4秒配置且已验证至多23人范围,低于上限时连接器在43%会话上输出人数多于参考而主机为22%,虽无错误率代价但存在过度拆分风险;连接器在中央处理器上以0.019倍实时率伴随主机运行,本身无训练故原文未披露训练成本。
🔗 开源资源
- 第三方资源:https://github.com/NVIDIA-NeMo/Speech/issues/14546 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. EvaOmni:要求模型同时答对并找对音视频证据的评测

英文题目:EvaOmni: An Evidence-Grounded Benchmark for Audio-Visual Reasoning
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Xiaoxing Hu:Shanghai Jiao Tong University
- Wenxi Yao:机构信息未能在本次解析中与作者逐人可靠绑定
- Chaoyuan Shi:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziqi Ye:Fudan University
- Xiaorong Guo:Fudan University
- Peixuan Li:Fudan University
- Zhuoran Sun:Beijing Institute of Technology
- Ziyang Gong:Shanghai Jiao Tong University
- Peiyuan Zhang:Shanghai Jiao Tong University
- Mingxin Liu:Shanghai Jiao Tong University
- Shuran Ma:Shanghai Jiao Tong University
- Hongbo Liu:Tongji University
- Xiaomin Yu:The Hong Kong University of Science and Technology (Guangzhou)
- Yu Tian:Tsinghua University
- Wentao Wang:Shanghai Jiao Tong University
- Zhenjie Yang:The University of Hong Kong
- Jian Hu:Tencent Youtu Lab
- Yunhang Shen:Tencent Youtu Lab
- Haoyu Cao:Tencent Youtu Lab
- Xue Yang:Shanghai Jiao Tong University;Corresponding Author
📌 核心摘要
读者需要理解的是同时依赖声音和画面的视频问答,难点在于模型答对选项也可能靠猜测、常识或单模态线索,无法证明其定位了双模态依据并完成跨模态推理。论文先从开放平台收集1–12分钟、含丰富视听事件且无硬字幕的视频,以减少数据污染和文本捷径,得到392段视频。专家在此基础上构造必须联合音频与视觉的1027道问答,并标出每题音频与视觉证据起止区间,输出再经专家交叉核验与文本、单模态模型过滤,争议样本复审或丢弃,以削弱捷径。评测时模型须同时输出选项与两模态预测区间,前一步的人工区间作为参照计算覆盖 grounded分数与瓶颈 grounded分数,前者统计被碰到的已标证据段比例,后者取双模态时间交并比中较小者,两者都乘以答案是否正确。相对只评答案的基准,关键差异是把证据覆盖与双模态精确定位计入得分,因而能暴露答对但定位失败的情况。在EvaOmni总体评测中,最强Gemini3.7-Flash的瓶颈grounded分数为35.1%,低于人类参考的94.3%,其正确率79.4%与覆盖grounded分数70.8%也分别低于人类的96.8%和96.0%,差距主要在精确定位。该结论仅适用于1–12分钟、去字幕且视听线索充足的视频与1027题量级,未验证更长视频、字幕丰富、事件稀疏或不同语言文化场景的泛化;原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/VisionXLab/EvaOmni — 链接可访问(HTTP 200)
第三方资源:https://modelscope.cn/datasets/VisionXLab/EvaOmni-Dataset — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/VisionXLab/EvaOmni-Dataset — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-Omni-30B-A3B-Instruct — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-VL-30B-A3B-Instruct — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/nvidia/audio-flamingo-3 — 链接可访问(HTTP 200)
第三方资源:https://deepmind.google/models/gemini/pro/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/collections/Qwen/qwen38-flash-next — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. 冻结大模型做音视频持续学习:用音频做上下文去稳定视觉

英文题目:Generalizing Multimodal Foundational Models in Context-Driven Class Incremental Learning
评分:7.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Avi Gupta:Indraprastha Institute of Information Technology, Delhi
- Nilotpal Sinha:Dolby Laboratories
- Vishnu Raj:Dolby Laboratories
- Sambuddha Saha:Dolby Laboratories
- Pratik Joshi:Dolby Laboratories
- Koteswar Rao Jerripothula:Indraprastha Institute of Information Technology, Delhi;Indian Institute of Technology, Kanpur
- Tammam Tillo:Indraprastha Institute of Information Technology, Delhi;TYUST, China
📌 核心摘要
类增量学习(Class-Incremental Learning,CIL)要求模型按任务依次学习互不相交的新类别,测试时要在全部已见类别上分类,难点是新类到来时可训练的决策边界漂移导致旧类遗忘。音视频场景还多了一层困难,两个模态的对齐关系容易在增量更新中被破坏。本文输入是每段视频的视频帧序列和对应音频波形,输出是已见类别标签,方法冻结多模态基础模型(Multimodal Foundational Model,MFM)的音频编码器和视觉编码器,只训练后端的融合与分类部分。音频特征作为上下文进入单层注意力模块,以视觉为查询、音频为键与值做跨模态引导,再经自注意力与前馈网络精炼,得到样本级的融合视觉表示送入线性分类器。训练在交叉熵之外增加特征级均方蒸馏和 logit 级 KL(Kullback-Leibler)散度蒸馏,使当前任务在示例样本上的表示与输出接近上一任务状态。在 AudioMAE 与 VideoMAE 编码器下,该方法在 AVE-CI 上平均准确率(Mean Accuracy,\(\mathcal{A}_m\))为 78.67%,超过同设置 AV-CIL 基线 74.04%。该结论适用于有示例回放的音视频事件分类增量设置,无示例时仍高于同类基线,但线性探针等无引导复用在原文中表现明显更差,原文未报告训练时长与完整推理代价。
🔗 开源资源
- 代码相关资源:https://github.com/avigupta2798/MFM-CIL — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. AD-Mamba:把 CNN 局部性和 Transformer 全局性蒸馏进 Mamba 的音频分类方法

评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Junyu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tianrui Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Meng Ge:机构信息未能在本次解析中与作者逐人可靠绑定
- Longbiao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaobao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jianwu Dang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
音频分类需要给一段声音打上一个或多个语义标签,难点在于声音事件在时频上局部细节丰富,又可能散布在很长的录音里,还常被静音段或噪声打断。Transformer 建模长距离依赖能力强,但序列变长时计算量按平方增长,且依赖显式位置编码。Mamba 一类状态空间模型(状态空间模型,State Space Model)用递推状态传递信息,计算量随长度线性增长,更适合长音频,但此前在 AudioSet 等多标签基准上的精度落后。AD-Mamba 把输入语谱图切块编码后送入堆叠的 Audio Mamba Block,再经下采样、池化和线性层输出标签,训练分三个阶段进行:先用卷积教师指导主干适应局部时频结构,再冻结主干、用同一卷积教师训练新加入的局部增强分支,最后换用 Transformer 教师提炼全局语义判别能力。与只用单一教师或直接联合训练已有方法的区别在于按局部到全局的顺序继承两种异构偏置,同时保留 Mamba 的线性序列建模效率。在 AudioSet 评测集的 527 类多任务上,AD-Mamba(S) 以 30M 参数取得 50.3% 平均精度(平均精度,mAP),超过 86M 参数的 CED 的 50.0%,适用范围集中在 16 kHz 输入的通用音频分类与迁移任务,合成长音频和人工填充噪声下的结论还需在真实长时监测数据上验证。原文披露训练需要 24GB 显存,未披露训练时长与推理时延的完整测量。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 真实电话里的语音真假检测:RealComm 的配对采集与适配

英文题目:RealComm: Benchmarking and Adapting Audio Deepfake Detection over Real Communication Channels
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Li Wang:The Chinese University of Hong Kong, Shenzhen, China
- Jindong Wang:The Chinese University of Hong Kong, Shenzhen, China
- Wan Lin:The Chinese University of Hong Kong, Shenzhen, China
- Kunyu Feng:The Chinese University of Hong Kong, Shenzhen, China
- Yufan Lin:The Chinese University of Hong Kong, Shenzhen, China
- Lei Wang:Huawei Technologies Co., Ltd
- Rizhao Cai:Huawei Technologies Co., Ltd
- Ce Fang:Huawei Technologies Co., Ltd
- Jinzhe Xue:Huawei Technologies Co., Ltd
- Jie Shi:Huawei Technologies Co., Ltd
- Haizhou Li:The Chinese University of Hong Kong, Shenzhen, China
- Zhizheng Wu:The Chinese University of Hong Kong, Shenzhen, China;Amphion Technology Co., Ltd
📌 核心摘要
音频深度伪造检测需要判断语音是真实录制还是合成或转换生成,本文研究接收端在真实移动通话中的判定可靠性。输入是经过采集与传输的波形,输出是真伪判定分数,难点是播放、拾音、设备处理与编码共同改变了检测依赖的线索。论文先构建配对语料RealComm,把同一数字源语音分别保留原文件并经真实移动通话重新录制,覆盖声学与有线注入、手持与免提及降噪开关,配对输出进入后两步:RealCommBench用于条件评测,RealCommTrain用于适配训练。接着设计RealComm-Aug,以输入波形为对象,按采集与传输顺序组织声学、设备、编码与传输扰动做仿真增强,输出增强波形直接送入检测器训练,并保留检测器原有内部增强。从同一初始检测器出发,适配比较只用仿真增强、只用真实通话训练以及两者结合三条路线。在RealCommBench通话域pooled评测下,Teffic-Audio经仿真增强与真实通话训练结合适配后等错误率(Equal Error Rate,EER)从37.94%降到22.37%,该结合路线在三款被测检测器上均为通话域最低。结论适用于所覆盖的手机、注入方式与通话模式,声学注入仍更困难,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/AmphionTeam/RealComm — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. 用可微 Karplus-Strong 做拨弦音色匹配:事件编码、两种可微实现与三套训练路线的对照

英文题目:Sound Matching with a Differentiable Karplus-Strong Algorithm
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Pablo Tablas de Paula:机构信息未能在本次解析中与作者逐人可靠绑定
- David Marttila:机构信息未能在本次解析中与作者逐人可靠绑定
- Rodrigo Díaz:机构信息未能在本次解析中与作者逐人可靠绑定
- Irán Román:机构信息未能在本次解析中与作者逐人可靠绑定
- Emmanouil Benetos:机构信息未能在本次解析中与作者逐人可靠绑定
- Joshua D. Reiss:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
要解决的问题是从单声道录音恢复离散演奏结构与物理音色参数,包括有几次拨弦、每次何时发生、基频是多少,以及决定衰减和频谱形状的回路参数,难点在于递归弦模型对时间和频率都很敏感而常用频谱损失不提供起始时间的方向信息。编码器以4秒单声道波形为输入,将其编码为固定数量事件槽,输出每个槽的存在概率、起始时间、基频和回路音色参数。解码器以上一步的参数向量为每事件控制量,以噪声激励经闭环回路渲染出对应波形,其中时域实现用拉格朗日插值处理小数延迟,频域实现用频率采样近似同一回路。音频损失模块以渲染波形与目标波形为输入,计算多尺度频谱与谱最优传输差异,再把梯度回传至编码器以修正事件与参数预测。合成集上仅用参数损失的模型事件F1为0.92,高于时域联合训练模型的0.01,其基频平均绝对误差为15.14音分。真实NSynth原声吉他测试上,时域外部检测器模型的CLAP分布距离为163.95,优于两个谐波加噪声基线的266.20和183.11,但在多数信号保真度指标上仍落后,说明瞬态建模有优势而琴体共鸣等结构超出单回路表达能力。该结论只适用于无扩展技巧的单音拨弦录音,梯度分析显示多事件起始时间联合准确率在5个事件时坍缩至至多4.1%,合成学到的检测难以泛化到真实瞬态。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://ptablasdpaula.github.io/DAFx26-Karplus/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. 手机智能体被无关信息带偏时,FocusGUI 如何每一步重新聚焦

评分:6.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.4/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Fuyao Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenwen He:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiaming Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yurong Hao:机构信息未能在本次解析中与作者逐人可靠绑定
- Xuan Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Guowei Guan:机构信息未能在本次解析中与作者逐人可靠绑定
- Che Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Longtao Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Wei Yang Bryan Lim:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
智能体在第t步收到用户目标、当前界面截图、视频流、音频、交互历史和设备状态,需输出规定为词元序列的下一个可执行动作及其参数,难点在于决定动作的证据在不同步骤间瞬变且在单步内稀疏分散,已执行动作又会重新进入后续观测,使单步误读累积为不可逆的轨迹偏离。FocusGUI先把同一观测展开为多个感知通道,再以每步重新计算的完整观测综合表示为决策参考,对各通道打分并加权汇合,压缩为64维聚焦隐向量,最后在动作边界前4个提示位置以零初始化残差注入冻结解码器,使解码器在不删减观测下被引导关注当前关键证据。训练只用动作序列的负对数似然且损失仅落在动作词元上,不标注哪个模态重要,不更新主干、解码器与词头,梯度经冻结解码器传回适配器参数。相对直接裁剪屏幕的增强方法,该方法保留全部观测并改变解码器读取方式,因而动作选择与参数接地所需的空间细节不被裁剪丢弃,可同时处理音频、视频与历史线索。在4个全模态主干平均上,相对冻结主干,Type Match从31.0%提高到64.2%,Exact Match从11.2%提高到33.5%,即平均增加33.2个百分点Type Match和22.3个百分点Exact Match,约为3.0倍Exact Match。原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/fyzhang1/FocusGUI — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. 复用多模态智能体来低成本评价游戏声音设计

英文题目:Reusing Multimodal Agents: Efficient Evaluation of Sound Designs in Games
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Thai Nguyen Van:机构信息未能在本次解析中与作者逐人可靠绑定
- Ibrahim Khan:机构信息未能在本次解析中与作者逐人可靠绑定
- Mury Fajar Dewantoro:机构信息未能在本次解析中与作者逐人可靠绑定
- Pratch Suntichaikul:机构信息未能在本次解析中与作者逐人可靠绑定
- Hai Van Pham:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruck Thawonmas:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
任务是只听声音时的游戏智能体表现,难点是每换一套声音设计就从零训练强化学习智能体,成本高且随机性会掩盖设计本身差异,需把声音变化影响与策略训练波动分开。论文输入为游戏画面帧与对应音频,预训练把图像编码器、音频编码器和融合编码器的输出经共享头映射到同一隐空间,学到跨模态对齐表示。预训练得到的融合表示接着用于策略训练,此时冻结编码器,只在融合表示上学习动作映射,输出固定策略网络。面对新声音设计时冻结图像通路与该策略,只更新音频相关编码器使新音频对齐原隐空间,再以声音单独输入驱动旧策略做盲测,从而把差异放到表示层适配而非重训策略。在VizDoom盲测设置下以平均奖励为指标比较,本文方法在设计2取得0.810 ± 0.011,与基线设计1的0.798 ± 0.014无显著差异,而退化设计3和设计4分别降至-0.458和-2.572,保持单调下降趋势。适用范围是声音信息量充分且跨模态可对齐的游戏任务,声音线索被完全移除或严重退化时零样本性能会明显下滑。在VizDoom每套新设计成本口径上以样本量和浮点运算量为指标比较,微调仅用32,000个样本和13.5 TFLOP,远低于盲设置从零训练的5×10⁸个样本和1.15×10⁶ TFLOP。
🔗 开源资源
代码相关资源:https://github.com/thainv0212/tog-reusing-agents — 链接可访问(HTTP 200)
第三方资源:https://vizdoom.farama.org/environments/default/#basic — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. 咨询对话语音怎样变成可解释的抑郁评估

评分:6.6/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chuanbo Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Run Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Weibo Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Yue Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Kun Qian:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiang Qu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yike Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Minghuan Tan:机构信息未能在本次解析中与作者逐人可靠绑定
- Wei Xue:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
咨询抑郁评估需跨轮次整合对话文本与声音的心理证据,难点是语音情绪含义隐晦且依赖语境,端到端分类缺乏显式证据解释。AudiPsy采用观察—评估—摘要范式逐轮推理:观察步以本轮语音和上一轮摘要为输入,转写对话文本并识别求助者文字情绪与声音情绪及效价等,形成结构化观察。评估步以上述观察为输入,先判断文字—声音情绪是否不一致,再结合历史证据按抑郁量表逻辑给出抑郁倾向判断。摘要步将观察与评估压缩为更新后的对话摘要,作为下一轮的上下文输入,从而实现证据累积。为弥补真实咨询语音不足,作者由公开文字咨询改写并合成2400段双语情绪语音构成AudiPsy-Counsel,再经情感感知、结构化推理与偏好对齐三阶段课程训练模型。在DAIC-WOZ上AudiPsy的Matthews相关系数为0.70、F1为0.81,高于同期最强的Gemini 2.5 Pro的0.65和0.79。该结论主要适用于结构化咨询对话,在日常对话EATD-Corpus上优势减弱,且依赖可靠的情绪感知,若观察错误则结构化推理也难以纠正;合成数据声学多样性有限、评估规模小,方法仅用于研究而不能替代临床诊断。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. APRIL:用隔离专家与模糊感知路由做呼吸音域增量学习

英文题目:APRIL: Ambiguity-Aware Expert Routing for Respiratory Sound Domain-Incremental Learning
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xinhong Li:organization=School of Computer Science, Wuhan University, city=Wuhan, state=Hubei, country=China
- Weiping Tu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要处理的对象是按设备或按年份分批到达的呼吸音记录,输出是对每段呼吸事件的类别判断,难点是在不能回放历史录音时学习新分布会改写旧分布所需的参数。论文采用冻结的BEATs编码器(BEATs,一种音频预训练编码器)作为公共主干,每个域拥有独立的低秩适配器(Low-Rank Adaptation,LoRA)与线性分类器构成的专家,新专家从上一个专家复制参数后再在当前域训练,旧专家保持冻结。多级原型路由(multi-level prototype routing,指用中间层与最终层特征匹配域)在冻结参考空间中为输入找出两个候选专家,再把域路由后验与分类置信度按匹配模糊度加权,选出最终预测。在ICBHI正向设备序列上,APRIL路由后最终会话平均分(Final-Session Average,FSA,指全部已见域期末分数的等权平均)为64.43%,低于同设置下使用真实域标签选择专家的域预言对照的65.16%。结论适用于四域固定标签空间与病人不相交划分,尚未验证更长序列与更多采集条件下的表现。部署成本方面,在ICBHI四域下专家库加原型约占9.12 MiB(不含冻结主干),批量为32测量时每样本推理延迟约4.81 ms。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
20. PhonoBridge:用音素作桥梁、让语言模型学会纠正肌电识别错误的无声语音转文本方法

英文题目:PhonoBridge: Error-Aware Phoneme-Mediated EMG-to-Text Reconstruction
评分:6.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Wen Qiu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiacheng Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xuanda Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Siqi Cai:机构信息未能在本次解析中与作者逐人可靠绑定
- Haizhou Li:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是从贴在面部和颈部的 8 通道表面肌电信号恢复说话人想要说出的英文文本,困难在于配对肌电与文本数据稀缺,而直接用干净文本转出的音素训练后端,推理时遇到前端识别错误就难以纠正。处理过程沿一个样本展开:采样率为 1 kHz 的多通道肌电波形先被前端转成一串音素,再由微调后的 Qwen3-8B 把这串可能含错的音素重写成规范文本。前端对每个电极通道独立做残差卷积提取时间特征,拼接可学习的电极身份向量后做跨通道融合,再经 Transformer 编码器和联结时序分类输出音素。后端把 LibriSpeech 转写经字素到音素转换得到的干净音素与文本配对,先学基本的音素到文本映射,再在混合了错误轮廓引导增强数据的第二阶段继续训练。错误轮廓引导增强先冻结前端,在留出子集上对齐预测与参考,统计替换、删除、插入的数量模板和音素条件概率,再按长度分桶抽样并作用到干净音素上。与字符级联结时序分类加语言模型或直接肌电到文本方法的区别在于,本文用音素作为跨肌电与声音的中间表示,并显式建模句子级错误计数结构。在 8 通道 Open Vocabulary 数据集同一测试划分上,相对最强基线 Gaddy and Klein,词错率从 28.27% 降到 24.77%。结论只适用于该数据集的离线贪心解码设置,噪声和佩戴变化下的稳定性尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. 不只数错了几个词:如何判断语音识别错得要不要紧

英文题目:SMART: Semantic Segment Mapping and Assessment of Recognition Transcripts with Contextual Rubrics
评分:6.5/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xiaoyu Gu:机构信息未能在本次解析中与作者逐人可靠绑定
- Chencheng Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Fuyang Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Xi:机构信息未能在本次解析中与作者逐人可靠绑定
- Tao Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiaoqi Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Kai Yu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音识别的输入是连续语音,输出是转写文本,难点在于同样的字面编辑可能带来完全不同的语义后果,例如漏掉否定词会反转含义,而插入语气词则几乎无影响。论文先对参考文本与假设文本做字符级对齐,再按英文空格与中文分词的块边界切分为语义连贯片段,并把单侧空片段并入相邻片段以保留增删的局部上下文。评估分支对每个差异片段输入周围参考上下文,用结构化细则判断对齐有效性、语义变化与上下文可恢复性,再经确定性规则汇总为有后果或无后果标签,并按话语、块、词三级统计为语义影响错误率(Semantic Impact Error Rate,SIER)。修正分支不接触参考文本与评估诊断,只用目标假设与前后识别假设生成修复指导,再由大模型改写,改写后才用混合错误率与语义影响错误率复评。相对已有整句相似度打分和下游任务间接评估,该方法能定位到具体片段并区分后果有无。在3.4小时Canvas Speech中文课堂语料与7.2小时TED-LIUM release 3英文演讲子集的差异片段分类中,以多数票人工标签为基准,框架的F1为0.843,高于直接用LLM判断的0.745。结论仅在单说话人连续语音、前后各十句连续话语为上下文且主评测用DeepSeek-V4-Flash的条件下验证,多说话人交互、其他语域与上下文缺失或更长时的判断尚未验证,对齐证据不足或上下文无法消解指代省略时可能误判。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/NytePlus/SMART — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
22. 大音频语言模型怎样听懂声音属性:跨模态概念神经元的发现与验证

英文题目:Uncovering Audio-Text Alignment in Large Audio-Language Models through Cross-Modal Concept Neurons
评分:6.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tzu-Quan Lin:Centre for Speech Technology Research, University of Edinburgh, United Kingdom;Graduate Institute of Communication Engineering, National Taiwan University, Taiwan
- Chih-Kai Yang:Graduate Institute of Communication Engineering, National Taiwan University, Taiwan
- Yi-Cheng Lin:Graduate Institute of Communication Engineering, National Taiwan University, Taiwan
- Hao Tang:Centre for Speech Technology Research, University of Edinburgh, United Kingdom
- Hung-yi Lee:Graduate Institute of Communication Engineering, National Taiwan University, Taiwan;NTU Artificial Intelligence Center of Research Excellence (NTU AI-CoRE), Taiwan
📌 核心摘要
读者需要理解的对象是大音频语言模型如何把声音表征接入文字预训练主干,困难在于整体向量相似度会被对所有输入都高的维度主导,无法说明标签本身是否共享。研究输入有两路,一路是属性音频加选择题,例如一段愤怒语音加“说话人情绪是什么”,另一路是描述该标签的文字,例如 The speaker feels angry,输出是选择题答案或标签相关激活。方法是把前馈网络第一层输出先在音频段或文字描述段内平均,再在同标签样本间平均得到标签表征,减去同任务其他标签均值得到区别度,排序后取前 \(k\) 个神经元,音频和文字的交集称为跨模态概念神经元。随后用只从文字算出的目标减载体方向推动该交集的激活,观察音频识别是否转向目标,用置零该交集观察目标任务是否先于控制任务下降。与只看整体余弦相似度的做法不同,本文只比较标签特定的少数维度,并把重叠从相关观察推进到双向干预。在 Qwen2.5-Omni 等 3 个模型和动物声、情绪、性别、语言 4 项任务上,神经元重叠的匹配标签方差份额在 9% 到 92% 之间,高于余弦相似度的 0% 到 9.69%,转向在 42 个模型标签组合上高于随机神经元,失活在 10 个模型任务组合上先损伤目标任务。结论适用于所测的语音和非语音属性识别,不适用于证明所有层或所有模型都同等依赖该对齐,DeSTA2.5-Audio 的动物和语言任务即未出现选择性损伤。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
23. SLM-SS:把多人混合语音变成离散符号再逐个生成

英文题目:SLM-SS: Token-Based Speech Separation with Speech Language Models
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chenda Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Tianhua Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yiming Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Wei Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiahe Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xin Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Yanmin Qian:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是单通道多说话人重叠混合波形,困难是既要分开各说话人波形,又要保持语言内容可懂,处理过程是把混合声连续编码再生成各说话人的离散表示并解码回波形。方法把干净语音先用神经编解码器(neural codec)离散为多码本 token 序列,再用串行输出训练(Serialized Output Training,SOT)把多说话人序列拼接为一个目标序列。自回归(autoregressive,AR)编码器-解码器预测含说话人切换符的零阶码本,确定说话人顺序和粗略语义内容。非自回归(non-autoregressive,NAR)模块以低阶码本为条件补全高阶残差码本,或按说话人分段独立补全以降低复杂度。在 Libri2Mix 测试集上,带按说话人 NAR 的 Encodec 版本词错误率(word error rate,WER)为 6.92%,低于 SepFormer 的 17.77% 和 BSRNN 的 20.02%,但高于 TF-LocoFormer 的 5.88%。单码本 WavTokenizer 版本省去 NAR,在 6 个受试系统盲听中平均分最高,其非侵入式质量优势在带噪和中文混合上仍然存在。结论适用于模拟混合和给定的编解码器配置,长序列下说话人边界错误和四说话人数据不足仍是失败来源。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
24. 让人觉得“解压” 的视频如何引发情绪:OSVD 数据与 PI-MLLM 方法解读

评分:6.1/10 | 创新 1.4/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yuheng Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jie Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuecong Min:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunwei Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Meichen Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiankun Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Shiguang Shan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是奇异满足视频(Oddly Satisfying Videos,OSVs),这类视频缺少人脸与语言情绪线索,却能通过重复运动与类自发性知觉经络反应(Autonomous Sensory Meridian Response,ASMR)声音引发满足或放松。处理难点在于语义内容与观众感受之间缺少直接对应,模型需要保留模态特有的物理动态,并判断视觉与听觉证据是协同还是冲突。论文构建奇异满足视频数据集(Oddly Satisfying Video Dataset,OSVD),包含从7242个网络视频切分的12000个5秒片段,每个片段带有视频、音频、视听三种条件下的27类观看者情绪标签与感觉解释。心理物理启发的跨模态大语言模型(Psychophysics-Inspired Multimodal Large Language Model,PI-MLLM)先把视听片段编码为视觉特征与音频特征,再用模态特有动态对齐让视觉表示回归光流幅度、音频表示回归响度与起始强度,从而保留运动可预测性与能量包络瞬态。对齐后的特征进入基于联盟的视听归因,由共享辅助分类器给出空集、仅视觉、仅听觉、视听四种联盟下的27类情绪分布,并以对数几率分数做Shapley归因,得到视觉贡献、听觉贡献及其交互。对齐特征与归因监督连同自回归生成目标联合训练,由多模态大语言模型解码器生成观看者情绪类别与感觉解释,这把监督从对象与事件转向物理动态,并把融合权重变成可学习的归因目标。在OSVD类别平衡测试集上,PI-MLLM取得27类情绪分类准确率43.2%,高于同骨干自回归微调基线的35.1%,解释相似度也同步提高。结论适用于OSV这类感觉驱动视频,未在长视频与强叙事视频中验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
25. 部署偏好如何变成多任务语音大模型的训练权重

英文题目:Preference-Aware Pareto Steering for Multi-Task Speech LLMs
评分:6.0/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Liuyuan Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Vishal Sunder:机构信息未能在本次解析中与作者逐人可靠绑定
- Samuel Thomas:机构信息未能在本次解析中与作者逐人可靠绑定
- Brian Kingsbury:机构信息未能在本次解析中与作者逐人可靠绑定
- Jeff Kuo:机构信息未能在本次解析中与作者逐人可靠绑定
- Lisha Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- George Saon:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音大模型需同时完成自动语音识别、时间戳预测和语音翻译,输入为16 kHz语音经声学编码器和适配器送入冻结大语言模型的表示,输出分别为词序列、带时间的词序列和译文,难点是固定损失权重无法按部署时的相对重要性控制最终折中位置。论文提出端点锚定偏好感知均匀采样方法,它先把已知偏好向量换算为与各专家模型损失距离的目标份额。训练中再测量当前模型与各专家模型的损失距离并换算成实际份额,然后按实际份额与目标份额的比率调整标量化权重,并沿同一模型继续训练。相对固定线性加权和两目标几何校准方法,该方法只为一个已知偏好做持续校准,并复用专家锚点而不建网格。在六个三目标请求、每请求180k步对等预算的留出集评测下,相对固定权重,该方法平均时间戳累积平均偏移从46.6 ms降到39.2 ms。在同一六请求集合叠加共享锚点的端点包含归一化超体积评测下,相对固定权重,该指标从0.519升到0.612。结论只适用于训练目标定义的份额对齐,对下游词错率和翻译质量的单调改善没有保证。训练开销方面,每请求名义预算180k步并复用专家锚点,可训练适配器与LoRA参数为81M,在4张NVIDIA H100上以总批量64训练,逐轮距离计算和权重更新相对训练步骤开销可忽略。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
26. 标签不准时先修标签:用神经心理测验给语音痴呆筛查重新打标签

评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Madhurananda Pahar:机构信息未能在本次解析中与作者逐人可靠绑定
- Caitlin Illingworth:机构信息未能在本次解析中与作者逐人可靠绑定
- Adam Hampshire:机构信息未能在本次解析中与作者逐人可靠绑定
- Peter J Hellyer:机构信息未能在本次解析中与作者逐人可靠绑定
- Agata J Hampshire:机构信息未能在本次解析中与作者逐人可靠绑定
- Daniel Blackburn:机构信息未能在本次解析中与作者逐人可靠绑定
- Annalena Venneri:机构信息未能在本次解析中与作者逐人可靠绑定
- Heidi Christensen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
需要判断的对象是社区招募带来的自报诊断标签是否可信,困难在于记忆门诊临床确诊样本难扩大采集,而志愿网站和社交媒体引入的自报标签会混入过时诊断和自我误判,直接训练会把噪声传给语音分类器。论文输入是 CognoMemory 平台采集的 14 个记忆探查问题的对话语音转写,输出是二分类中认知受损相对健康对照的判断,以及三分类中痴呆、轻度认知障碍、健康对照的判断。处理过程先计算注意、执行功能、记忆三个域的神经心理学分数,再用外部 FLAME 参考均值中点、高斯中点、健康对照规范 z 偏差三类阈值生成 T1 和 T2 分界,把不可靠样本重标为三类,之后用重标标签微调 BART、RoBERTa 和 DistilBERT 等变换器并在临床确诊集上测试。与直接沿用原始标签相比,基于记忆和规范 z 分数的方法差异最大,也最稳定,作者因此把标签质量而非模型结构视为当前瓶颈。内部测试二分类宏平均 F1 从 0.70 提高到 0.83,三分类从 0.54 提高到 0.66,外部 Pitt、ADReSS 和 PROCESS-2 二分类分别提高 0.04、0.05 和 0.093。结论适用于以英语单语对话语音和现有阈值为条件的筛查研究,不能替代全面神经科诊断,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/Madhurananda/CognoCalib — 链接可访问(HTTP 200)
第三方资源:https://doi.org/10.5281/zenodo.23263139 → https://zenodo.org/records/23263139 — 链接可访问(HTTP 200)
第三方资源:https://cognospeak.cognitron.co.uk/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
27. DIVE:在连续音视频流中测全双工视觉参与式交互

英文题目:DIVE: Benchmarking Full-Duplex Interaction with Visual Engagement in Continuous Streams
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yuhang Chen:Huazhong University of Science and Technology
- Guangyue Liu:Huazhong University of Science and Technology
- Shilong Liu:Princeton University
📌 核心摘要
实时互动要求模型在音视频流不断到来时持续观察,判断与任务相关的视觉或语义线索是否已经充分,并在合适时机决定说话还是保持沉默,难点在于证据逐渐显现、说话与倾听可能重叠、问答交替出现。DIVE将该问题组织为主动干预、持续参与和交互协调三类场景共六个任务,覆盖及时干预、重复动作计数、重叠中改写回答与判断话语是否指向模型等要求。构建时先采集连续音视频流并保留时序,再由四名标注者合并标注最早可回应时刻与任务特定的有效回应窗口,窗口边界直接作为后一步划分回应的依据。评测时按流式输入协议送入原生音视频或视频加时间戳文本,程序先按开始时刻把模型回应分配至对应事件并划为提前、准时、迟到或缺失以计算窗口回应率与延迟,再由GPT-5.6 Terra对已分配回应做二值内容判定得到回应质量。在DIVE六任务的平均窗口回应率上,GPT-Realtime-2.1为53.77%,高于Qwen3.5-Omni-Plus-Realtime的41.43%和Gemini-3.1-Flash-Live的40.58%,居所评实时模型首位但仅略超半数。在同一DIVE六任务的平均响应延迟上,上述三者分别为0.831秒、0.735秒和0.879秒,均低于1秒并明显低于表现最好的开放模型Aero-Realtime-4B的2.567秒,说明延迟低不等于每次都能落在有效窗口内。其中语音驱动的主动干预最难,GPT-Realtime-2.1与Qwen3.5在该任务窗口回应率仅20.0%与19.8%,重叠中改写正在进行的回答也持续偏弱。作者承认未覆盖工具调用等智能体行为,样本时长有限,长程记忆与视觉输入的独立影响留待后续工作。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
28. 语码混合与母语之间双向迁移的系统综述
评分:5.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:综述 | arXiv 原文
👥 作者与机构
- Debajyoti Mazumder:Indian Institute of Science Education and Research, Bhopal
- Akash Anil:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
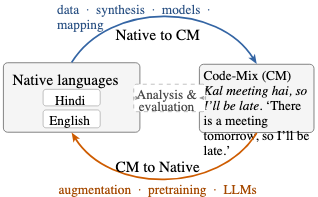
读者需要先理解的对象是语码混合(code-mixing / code-switching,指同一句或同一段对话内混用两种及以上语言),难点是混合语料稀少而每种组成语言又有较多单语资源,模型在混合输入上识别和理解都会变差。论文把组成混合的语言称为原生语言(native languages),先以跨库检索得到的11087篇去重文献为输入做规则过滤,得到4758个候选。接着用Claude Haiku 5.5只读标题与摘要判读是否陈述转移并标注方向、机制与模态,其输出经关键词审计后留下1451篇进入分类,其中1045篇只做原生到混合,只有82篇做反向。分类结果进入按转移方向、路径与模态组织的三层体系,原生到混合一侧先直接复用单语或平行数据,再由其合成混合句用于训练与评测。合成与真实混合语料接着作为适配原生预训练模型的输入,混合输入还被映射回原生文字、音素或嵌入形式以便复用原生模块,该映射输出直接决定适配与解码的效果。在共享的Mandarin–English混合语音基准SEAME上,加入原生Mandarin和English语音使dev_man混合错误率从22.26%降到17.64%,降幅大于同表多数结构改动。结论适用于有单语资源但缺混合语料的场景,不适用于无强原生模型支撑的低资源组成语言,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
29. LoCA:给自回归流匹配语音合成的句子奖励做帧级分工

英文题目:LoCA: Local Credit Assignment for Reinforcement Learning of Autoregressive Flow-Matching TTS
评分:5.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jie Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Junyu Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Junhao Zhong:机构信息未能在本次解析中与作者逐人可靠绑定
- WeiSen Tang:机构信息未能在本次解析中与作者逐人可靠绑定
- Rukai Cai:机构信息未能在本次解析中与作者逐人可靠绑定
- Haoyue Zhan:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruiqi Xing:机构信息未能在本次解析中与作者逐人可靠绑定
- Ling Long:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
自回归流匹配语音合成先由自回归上下文生成声学条件,再由流匹配声学模块输出波形,输入是文本与参考音色,输出是连续声学潜变量对应的语音,整句奖励难以指出哪几帧读错。带符号回归按句子优势的正负决定拟合或排斥采样轨迹,但全句帧共享同一系数,且仅靠参考锚定难以分别约束持续拟合与持续排斥。论文提出局部信用分配LoCA,先用识别转写加强制对齐找到替换、插入与缺失对应的错误区间并映射到生成潜变量帧,再把句子优势与帧内去均值后的局部标签相加得到帧系数。随后引入相对参考的正向改进预算与负向误差上界,当帧误差进入预算区间后对应分支梯度为零,参考锚定项继续保留,推理过程不变。与直接加权整句回归的GROW相比,差异在于帧系数保留句均值且具有零均值调整,回归在预算外梯度为零而非持续更新。在3624条多语言CV3选中子集上,LoCA选中模型内容错误为4.758%,低于预训练主干的5.986%与GROW的5.553%,说话人相似度69.137高于主干的67.168与GROW的67.562。结论适用于所评语言与困难子集,未验证多主干与多种子稳定性,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
30. 一个平台查多种造假:媒体智能取证平台 MIP 是怎么拼起来的

英文题目:Media Intelligence Platform: Multimodal Detection of Synthetic and Manipulated Content
评分:5.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0.2/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- David Fischinger:机构信息未能在本次解析中与作者逐人可靠绑定
- Marcel Hasenbalg:Austrian Institute of Technology, Giefinggasse 4, 1210 Vienna - Austria
- Silvia Poletti:Austrian Institute of Technology, Giefinggasse 4, 1210 Vienna - Austria
- Davide Antonutti:Austrian Institute of Technology, Giefinggasse 4, 1210 Vienna - Austria
- Mina Schütz:Austrian Institute of Technology, Giefinggasse 4, 1210 Vienna - Austria
- Lam Pham:Austrian Institute of Technology, Giefinggasse 4, 1210 Vienna - Austria
- Justin Ilyes:Austrian Institute of Technology, Giefinggasse 4, 1210 Vienna - Austria
- Péter Rjabcsenkó:Austrian Institute of Technology, Giefinggasse 4, 1210 Vienna - Austria
- Simon Freitter:机构信息未能在本次解析中与作者逐人可靠绑定
- Martin Boyer:Austrian Institute of Technology, Giefinggasse 4, 1210 Vienna - Austria
📌 核心摘要
待解决的问题是生成式内容同时出现在图像、视频、音频和文本中,而现有检测器只覆盖单一篡改类型,难以应对异构来源的核查需求。论文提出的媒体智能平台接受多模态上传文件,按任务分发到对应检测模块,再把各模块的判定分数和可视化证据汇总到统一界面与作业记录中。图像侧用卷积网络与视觉变换器判别整图是否由生成模型产生,并用热力图叠加目标检测框提示伪造痕迹位置;另一支路用编码器加解码器结构同时输出整图篡改概率和像素级定位掩膜。人脸与视频侧分别处理换脸视频的人脸跟踪序列和证件照级别的人脸融合,音频侧对语音片段提取嵌入后做真伪判定,文本侧把多个分类器输出聚合成可靠性等级。与只做单模态判别的方法相比,该工作把异构模型封装为可独立部署的服务,支持统一调用和结果存储。音频语音伪造检测在 FakeAVCeleb 上达到准确率 0.99、F1 值 0.99、AUC 0.99。结论适用于各模块独立调用的取证场景,尚未验证多模态证据联合推理的效果。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://www.ait.ac.at/en/ — 链接可访问(HTTP 200)
演示资源:https://media-intelligence.ait.ac.at/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
31. AR 眼镜上没有耳边麦克风怎么做主动降噪:辅助滤波器的方向敏感性与滤波器组

英文题目:Active Noise Control for Augmented Reality Glasses using Virtual Sensing with Directional Robustness
评分:5.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Nitay Peled:School of Electrical and Computer Engineering;Ben-Gurion University of the Negev
- Boaz Rafaely:Beer-Sheva, Israel
📌 核心摘要
增强现实眼镜要在佩戴者耳处降低噪声,但耳处没有可用的误差传声器,而镜架上的监听传声器测到的信号与耳处信号并不一致,直接用它驱动控制会留下残差。论文沿一个噪声样本说明处理过程:参考传声器获取噪声输入 \(X(\omega)\),经控制滤波器 \(W(\omega)\) 生成扬声器信号,监听传声器信号减去辅助滤波器 \(H(\omega)\) 对参考信号的预测得到替代误差,再用该误差更新控制滤波器,使耳处虚拟传声器的残差趋零。离线校准阶段虚拟传声器暂时可用,用于求出最优辅助滤波器,在线控制阶段虚拟传声器不可用,辅助滤波器保持固定。理论分析把主要路径写成点声源自由场延时,推导最优辅助滤波器对声源方位角的导数,指出失配灵敏度随偏离参考与监听连线方向增大。在基于Project Aria镜架几何的自由场单噪声源仿真评测设置下,在因果方位范围 \(\phi_0\pm90^{\circ}\)内以虚拟传声器处平均衰减为指标按方位平均时,5个均匀校准方向构成的滤波器组按最近方向选择取得25.3 dB,低于每个方向单独校准的29.1 dB,差距为3.7 dB。结论只在单声源自由场和因果方位成立,非因果方位所有方法都明显退化,混响与多声源尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
32. 从板混响脉冲响应反推六个物理参数:回归与条件流两条路线

英文题目:Transformer-Based Plate Parameter Estimation with Differentiable and Particle-Swarm Refinement
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- David Marttila:机构信息未能在本次解析中与作者逐人可靠绑定
- Rodrigo Diaz:机构信息未能在本次解析中与作者逐人可靠绑定
- Pablo Tablas De Paula:机构信息未能在本次解析中与作者逐人可靠绑定
- Ilias Ibnyahya:机构信息未能在本次解析中与作者逐人可靠绑定
- Chin-Yun Yu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是从一段板混响脉冲响应反推六个等效物理参数,困难在于模态重叠、衰减耦合与绝对幅度丢失都会让直接回归陷入局部误差。处理过程是先用神经网络给出五个归一化参数的初值,再用合成器精修波形误差,面密度单独由峰值幅度解析恢复。共享编码器把降采样后的全长对数谱、一段时域波形、衰减谱图与保留的全局增益变成148个特征向量,为两种推断管线提供条件。方法A1用变换器回归器(指用自注意力编码特征并回归参数的变换器)给出点估计后用可微合成与Adam优化100步,方法A2用条件连续归一化流(指从噪声分布经微分方程映射到参数分布的生成模型)采样50个候选再用粒子群优化(指用群体候选协同搜索无梯度目标的全局优化方法)加梯度抛光。与只做神经预测相比,精修是关键差异,实际意义是保留绝对尺度与物理合成约束可以弥补回归误差,原文未提供可核对的关键定量结果。该结论只在匹配合成场景成立,实测或模型失配表现尚未验证。原文披露A1训练约20小时、精修约每条5分钟,A2训练约45小时、粒子群优化约3分钟,均在单张A100上完成。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
33. 位置辅助 UWB 组播音频:时钟、声程、丢包与时隙如何共同决定可行性
英文题目:Timing and Reliability Limits of Position-Assisted UWB Multicast Audio
评分:5.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Fengyun Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
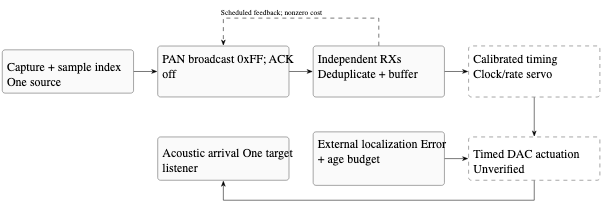
读者需要理解的是超宽带一对多音频源向多个独立接收器分发相同音频块的系统,要求各接收器电学发射时刻接近或在指定听者位置处直达声到达时刻接近,且同一音频块被全体接收器及时收到,难点是晶振漂移与执行粒度各异、扬声器到听者距离不等而位置信息存在误差与老化、共用衰落会同时抹掉同一副本。本文方法先以信标观测估计各接收器时钟偏移与斜率,再把源呈现时间映射为本地时钟并换算为定时发射时刻,该发射时刻直接进入距离补偿步骤,叠加由外部位置估计算出的声传播时延提前量,最后把补偿后的发射计划送入两状态共用信道加接收器本地丢失的交付模型,用预约负载判断调度是否溢出。与只优化时钟残差或平均交付率的做法不同,本文要求定时、分组交付与资源三者同时满足,并区分充分条件与必要条件。在8接收器30轮仿真以轮级95分位均值衡量的电子跨度指标下,仿射校正约为21.19微秒,低于同设置自由运行的约1341.47微秒。在同样8接收器30轮仿真以单听者声到达跨度衡量的指标下,有位置补偿约为419.43微秒,低于同设置无位置补偿的约21953.66微秒,但仍有98.86%事件超过30微秒研究阈值。在64接收器3副本的传输仿真中,全体同时交付概率指标约为0.97478。结论只在设定观测模型、位置年龄与时隙假设下成立,位置老化、共用衰落加重或接收器增多时会失败,时钟与传输分开仿真而未验证端到端连续播放,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
34. pyFDN:把反馈延迟网络的设计、渲染、分析与优化装进同一套 Python 流程
英文题目:pyFDN: A Python Toolbox for Feedback Delay Network Design, Analysis, and Optimization
评分:5.4/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.5/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:后 50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Sebastian J. Schlecht:Friedrich-Alexander-Universität Erlangen-NürnbergMultimedia Communications and Signal Processing, Germany
- Facundo Franchino:Research Laboratory of Electronics, Massachusetts Institute of Technology, USA;School of Physics, Engineering and Technology, University of York, UK
- Jeremy B. Bai:Friedrich-Alexander-Universität Erlangen-NürnbergMultimedia Communications and Signal Processing, Germany
📌 核心摘要
反馈延迟网络用若干延迟线加静态反馈矩阵构成递归混响结构,输入多通道音频或脉冲,输出带混响尾音的多通道响应。同一网络需反复构造矩阵、试听响应、检查模态衰减并对照实测调参,工具分散易出错。pyFDN把数值设计与分析例程、基于块的时域处理、与FLAMO衔接的频域可微处理放在同一工作流。参数经设计或训练得到后封装为FDNBuild,再经时域图渲染成冲激响应或经模态求解得到极点与留数,需优化时转成FLAMO模型训练后再抽回数值构建存为JSON预设。与MATLAB工具FDNTB的差异在于接入Python生态、形成可微优化到数值导出的闭环,并以版本与复现记录约束实验。上述结论仅在0.5.0版限制内成立:普通状态空间转换要求单输入单输出且延迟不小于3,FLAMO求解器仅支持单个非嵌套递归内的二阶节环路滤波,JSON预设仅保存静态反馈矩阵与二阶节滤波器组。频域合成依赖变换长度与混叠抑制及精度选择,去除包络会放大舍入误差致长混响与无损衰减失败,完整网络稳定性还取决于滤波器与参数约束,且原文明确不作性能或听感比较主张。原文未提供可核对的关键定量结果。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/artificial-audio/pyFDN — 链接可访问(HTTP 200)
第三方资源:https://artificial-audio.github.io/pyFDN/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。