📄 位置辅助 UWB 组播音频:时钟、声程、丢包与时隙如何共同决定可行性
英文题目:Timing and Reliability Limits of Position-Assisted UWB Multicast Audio
评分:5.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
👥 作者与机构
- Fengyun Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的是超宽带一对多音频源向多个独立接收器分发相同音频块的系统,要求各接收器电学发射时刻接近或在指定听者位置处直达声到达时刻接近,且同一音频块被全体接收器及时收到,难点是晶振漂移与执行粒度各异、扬声器到听者距离不等而位置信息存在误差与老化、共用衰落会同时抹掉同一副本。本文方法先以信标观测估计各接收器时钟偏移与斜率,再把源呈现时间映射为本地时钟并换算为定时发射时刻,该发射时刻直接进入距离补偿步骤,叠加由外部位置估计算出的声传播时延提前量,最后把补偿后的发射计划送入两状态共用信道加接收器本地丢失的交付模型,用预约负载判断调度是否溢出。与只优化时钟残差或平均交付率的做法不同,本文要求定时、分组交付与资源三者同时满足,并区分充分条件与必要条件。在8接收器30轮仿真以轮级95分位均值衡量的电子跨度指标下,仿射校正约为21.19微秒,低于同设置自由运行的约1341.47微秒。在同样8接收器30轮仿真以单听者声到达跨度衡量的指标下,有位置补偿约为419.43微秒,低于同设置无位置补偿的约21953.66微秒,但仍有98.86%事件超过30微秒研究阈值。在64接收器3副本的传输仿真中,全体同时交付概率指标约为0.97478。结论只在设定观测模型、位置年龄与时隙假设下成立,位置老化、共用衰落加重或接收器增多时会失败,时钟与传输分开仿真而未验证端到端连续播放,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
组播音频到底要对齐什么
这篇论文研究的输入是一个 UWB 音源要分发的公共音频块,每块有采集时刻和展示时刻,输出是多台独立时钟的接收机在各自喇叭上放出同一批采样。初学者容易把收到包等同于同时响,但论文强调三件事是不同的:收到包只说明数据到了,电子发射时刻说明 DAC 大约何时动作,声到达时刻说明声波何时飞到听者耳朵。房间里音箱到听者距离不同,即使电子同时触发,声音也不会同时到达。
因此论文把目标写成两种跨度。电子跨度是各接收机触发误差的最大减最小,声到达跨度是各路声波到达指定听者时刻的最大减最小。可靠性也不是平均交付率,而是全员同时拿到同一块的事件。只有同时满足定时、声学和时隙 3 类约束,组播才算可行,任何单项优化都不能代替另外两项。
已有路线为什么还留下一个缺口
理解本文位置需要先看低功耗蓝牙音频和 UWB 音频各自解决了什么。低功耗蓝牙音频已有面向连接的 CIS 和无确认广播的 BIS,BIS 允许无条件重传和提前发送,Auracast 是其互操作广播框架。UWB 音乐触觉和双板立体声工作证明了链路和端到端可行性,时钟同步、联合通信定位和采样率校正也各有方法。但这些工作用的可观测变量和评价终点不同,没有在同一组播目标下同时算清时钟、位置年龄、相关擦除和预留资源的交集。
下表是论文整理的证据边界,意思是已发表结果属于各自平台,不能跨平台比数字大小。本文的任务是平台特定的条件可行性,而不是发明广播本身。
| Work / period | Primary scope | Relevant established capability | Important difference | Evidence status |
|---|---|---|---|---|
| Yan et al., 2024 [13] | CIS performance model | Loss, throughput, backlog, delay, power tradeoffs | Not a UWB multicast or calibrated DAC comparison | Published journal; analytical/simulation |
| BISON, 2023; MANTIS, 2026 [2, 12] | BIS security / multiparty audio | Synchronized broadcast, return-path and coordination issues | Neither makes UWB broadcast or authentication automatic | Published conference; hardware demonstrations |
上表说明本文只在相同参数化服务模型内比较时钟与重复策略,不排名完整商用实现。候选文献多但只选直接相关的二十余项,且明确区分已发表、预印本、规范文档和仿真假设,避免把标题相似当成性能可比。
三个相互牵制的难题是什么
第一是时钟与执行分离。每台接收机有自己的晶振偏移、漂移、缓冲和 DAC 动作时刻,只校准时间戳观测值不能保证同一采样点同时转换,固定观测偏差还可能被吸收进时钟估计而不自知。第二是几何与年龄耦合。补偿声程需要坐标,但坐标有误差且会变旧,运动中旧而准的坐标可能不如新而噪声大的坐标,时钟做准了声学仍可能差两个数量级。第三是组交付与资源耦合。多发副本提高交付却占用时隙,反馈和定位更新也占时隙,接收机一多回报通道代价就上升。
论文因此提出可行域是 4 个条件的交集:可辨识的时钟观测与可控的输出执行器、单听者声跨度的上界或分位数、全员块交付的风险容忍、包含信标反馈和感知流量的预留服务。只满足其中之一不算系统可行。
下表对比几种拓扑的结构差异,重点是公共内容服务是否共享下行、回传和定时问题在哪里,最后一列说明本文比较的局限。
| Category | Common content service | Return-path issue | Timing issue | Limitation of current comparison |
|---|---|---|---|---|
| Inter-receiver forwarding | At least two hop services for a two-receiver chain | Per-hop feedback and forwarding policy | Additional processing/buffering; not necessarily twice total latency | Structural lower-bound counter only |
| BIS / Auracast | Shared broadcast; one or multiple BISes in a BIG [2, 3] | No ordinary receiver ACK in the BIS | Isochronous rendering; product-specific audio pipeline | No empirical latency/energy baseline |
该表不是实测性能排名。独立寻址流和 CIS 需要每链路控制,BIS 共享广播但通常无接收确认,本文核对的 UWB PAN 广播用 0xFF 目的地址并关闭确认,重复靠应用层副本实现。
从采集到声音的完整链路长什么样
论文的参考链路从单源采集加采样索引开始,经过 PAN 广播到达各自接收机,接收机去重缓冲,再经校准定时和时钟速率伺服,最后由定时 DAC 执行发出声音。定位来自外部子系统,只提供带误差和年龄预算的几何估计,声学目标只针对一个指定听者。反馈如果存在,需要单独预留上行时隙并计入代价。
读这张架构图时,先分清实线与虚线的含义。实线是已核对文档的传输功能,虚线是模型层变量,代表观测、传感和输出控制还缺标定。
看图路径: 1. 先沿上排从采集经广播到接收去重再到校准定时的主链路看一遍;2. 再看下排外部定位与定时 DAC 执行如何回接到声到达;3. 注意虚线框表示模型层变量,实线框表示已核对的传输功能;4. 看顶部反馈虚线标注的非零代价含义
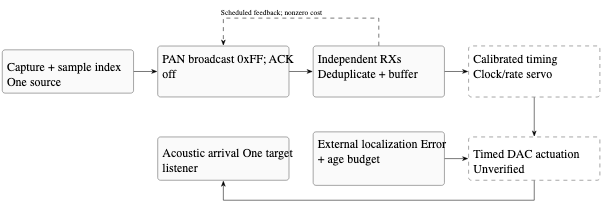
论文图 1。原论文 Fig. 1::“Reference architecture for the conditional multicast-audio model.”。
图后需要强调的是,接收完成回调不能代替校准过的天线边沿时间戳,软件调采样率保住队列平均稳定也不能证明首采样相位对齐。地址空间能容纳 255 个节点不等于实测支持 255 个可靠接收。凡是文档未给出天线时间戳、样本可寻址 DAC 期限和定位接口的,论文都作为外部输入建模,而不是从音频接收中间接继承精度。
时钟如何建模和跟踪
源时间记为 t,接收机 i 本地时钟写成源时间加微秒级偏移的形式,偏移的导数是漂移,单位是微秒每秒即 ppm。信标每隔固定间隔到来,参考估计用包含偏移和漂移的状态向量做卡尔曼预测,观测是带固定偏差和零均值噪声的偏移观测。固定偏差与真实偏移在 1 维观测中不可分,需要额外标定或双向观测,这是论文明确保留的盲区。
\[C_{i}(t)=t+10^{-6}b_{i}(t),\]上式把时钟关系量化为秒与微秒的换算,滤波器过程协方差用连续随机游走近似,仿真真值用离散漂移递推加高斯增量,两者有意留了一个小失配并公开说明。丢信标时只预测不更新,渲染时刻的偏移估计由最近估计外推得到。初值偏移、漂移和每节点偏差在给定范围内独立抽取,减小随机噪声并不能消除固定偏差。
电子发射跨度 × 单听者声到达跨度: 电子发射跨度只比较各接收机把本地截止时间换算成源时间后的触发误差,不含声音在空气中飞行时间;单听者声到达跨度在此基础上再加上每台音箱到指定听者距离除以声速的差异,并允许为抵消距离差而故意错开发射。两者搭配才能说明为什么时钟残差很小而听者处仍不对齐,组合后把问题从对表问题变成对到达时刻问题。
声程补偿如何改变发射时刻
记音箱位置和目标听者位置,声距离是两者欧氏距离,声速取 343 m/s,注意它与 UWB 电磁波速不同。期望发射时刻是采集时刻加固定缓冲,再加用估计距离算出的提前量,目的是让不同距离的声波同时到达听者。本地截止时间换算回源时间时符号不能反,否则物理不一致。执行相位误差和时钟估计误差共同进入到达时刻,而公共项在两两相减时抵消,所以故意错开发射反而可能减小到达跨度。
\[t^{*}_{i,k}=\tau_{k}+B+\frac{D-\hat{d}_{i}}{c}.\]上式只是名义时间分配,前提是整块音频已到齐且能及时提交播放动作。论文的时钟仿真是事件时间误差模型,不实现完整解码缓冲和未来期限调度,报告的到达量不等于实测从采集到 DAC 或到声音的延迟。
仿射时钟跟踪 × 外部位置补偿: 仿射时钟跟踪用卡尔曼滤波同时估计时钟偏移和漂移,解决各板晶振走得不一样快的问题;外部位置补偿用最近一次听者与音箱几何估计去提前或推后发射,以抵消声程差。前者管电子时间,后者管几何时间,两者相加才得到听者处的到达时刻,缺任何一个都会留下大跨度。
到达跨度的条件预算告诉我们什么
命题给出充分条件不等式:若时钟误差、执行器量化、坐标误差、听者估计误差、速度与有效年龄都有界,则到达跨度不超过时钟项、执行器项与几何项之和。证明用反三角不等式把距离误差放大为坐标误差加速度乘年龄,再对 3 类误差分别取极差相加。
\[S_{A}\leq 2\cdot 10^{-6}E_{c}+10^{-6}q_{D}+\frac{2(\delta_{p}+\delta_{u}+va)}{c}.\]该界的物理意义很直观。2 cm 距离误差对应约 58.31 微秒单程声延迟,若电子残差为零,30 微秒的对称最坏预算只允许每条路径约 5.145 mm 的个体距离不确定度。这是充分最坏要求而非通用定位门限,共模位置误差可能部分抵消。论文还强调不能把仿真中时钟与位置的经验分位数直接相加当成联合分位数保证。
预留时隙负载 × 因果播放期限: 预留时隙负载统计音频副本、信标和反馈在周期内占用的保留时间占比,判断日程是否存在;因果播放期限要求完整可解码的块必须早于其声学发射时刻到达。负载管容量是否放得下,期限管副本来得及不用,前者小于 1 是后者的必要但不充分条件,组合后才构成实时性判断。
相关擦除下全员交付如何计算
信道用两状态公共马尔可夫链描述好坏,转移概率决定坏状态稳态占比,这是简化的突发模型而非拟合的 UWB 传播模型。每个副本先过公共擦除,再过与公共状态有关的本地擦除,本地在给定公共状态下条件独立。固定重复 R 次时,单机失败概率是对状态求平均后的 R 次方期望,而全员成功概率要先对幸存副本数二项展开,再对接收机连乘,最后对状态加权。
\[P_{\rm all}(R)=\sum_{h}\pi_{h}\sum_{j=0}^{R}\binom{R}{j}(1-q_{h})^{j}q_{h}^{R-j}\prod_{i=1}^{N}(1-p_{ih}^{j}).\]上式的关键是求平均与求幂的顺序不能交换,忽略状态变化会低估个体失败,共损又使各机成功不能相乘。随着 N 增大,平均交付很好时全员交付可能很差,这正是同步渲染同一块所关心的量。
公共擦除 × 接收机本地擦除: 公共擦除指一次副本丢失同时影响全体接收机,由两状态马尔可夫信道描述突发共损;接收机本地擦除指在公共幸存条件下各机独立再丢一次,与距离和坏状态有关。两者是串联关系,先过公共关再过本地关,组合后才能解释为什么平均交付很高而全员同时拿到同一块却很难。
组接纳的必要与充分检验如何分工
论文给出固定重复的组失败上下界。下界是公共全擦的稳态概率,它与接收机数和本地质量无关,超过目标就直接判不可行;上界是各单机失败概率之和的并界,不需要独立性假设但偏保守,满足目标就可接纳。中间的精确式在参数已知时更锐利。举例在给定参数下,1 到 3 次副本的不可避免组失败约为 0.0104762、0.00190571、0.000380953,这是参数算术结果而非实测丢包率,特别说明两副本在该假设下达不到 99.9% 组目标。
因果性用就绪时刻加执行提前量不大于期望发射时刻表示,时钟与传输仿真都不计算该量,所以残差小不代表期限满足。资源用预留负载表示,期望副本数乘时隙除以块周期,再加自适应反馈与信标项,超过 1 即判不可行。
\[\rho=\frac{\mathbb{E}R\,s}{T_{f}}+I_{\rm adapt}\frac{Ns_{\rm fb}}{T_{\rm fb}}+\frac{s_{b}}{T_{b}}.\]上式中预留时隙大于空中时间,因为包含处理与余量;源数据空中时间与接收机累计在线时长也要分开,后者只是时长代理而非实测能量。
平均接收机交付 × 全员同时交付: 平均接收机交付是对接收机求平均的单机成功率,反映典型链路好坏;全员同时交付是要求指定 N 台在同一块上取交集,是组播渲染真正需要的事件。后者随 N 增大急剧下降,前者几乎不变,两者搭配才能避免把单机 99% 误读为组服务 99%。
没有神经网络训练时实际算了什么
本文没有任何神经网络训练,需要先说清这一点。实际计算是两族分离的仿真加参考启发式。时钟侧在每个信标做卡尔曼预测与 Joseph 协方差更新,丢包只预测;渲染事件外推偏移并读取最新位置与年龄,评估电子与声到达跨度。传输侧对每块按公共状态抽公共与本地擦除,最多 3 个应用副本去重交付,统计平均、最差与全员交付。
参考策略有 4 种定时对照:自由运行、仅校偏移、仿射无位置、仿射加位置,前两者与后两者共享同一时钟几何实现配对比较;传输有固定 1 到 3 次副本和两种自适应。自适应每 0.2 s 用首副本丢失率更新每机估计,再经独立同分布外推公式选重复数,上限 3。该公式只算边际风险,不含共突发、延迟反馈与时隙约束,名义 1% 只是启发参数而非保证。在线决策看不到隐藏公共状态,离线用精确式做接纳检验与在线启发式性质不同。
仿真在什么条件下跑
offered 流是 48 kHz 立体声 16 位,每 0.5 ms 一块对应 96 字节 PCM 加 16 字节假设头,共 112 字节自定义包,不是原厂 SAC 修改。文档空中系数用于算源空中时间,预留时隙另计处理余量。信标 10 ms,渲染每 5 ms,定时主实验 8 接收机 30 s 去前 2 s 热身,传输主实验 N 从 2 到 64 每轮 10 s 共 20000 块,每条件 30 个种子。时钟与传输是两套独立仿真,不把收到的块塞进解码器再对发射期限,时传联合成功率不能靠边际相乘得到。
政策与运行记录共 4590 条,同一实验族内多策略共享随机底事件以保证配对,跨种子改变几何与信道路径。估计量是 30 个运行级 p95 的均值加 t 区间,不是跨运行 pooled 分位数。时隙敏感把名义时隙从 150 微秒拉到 250 微秒,信道敏感把坏状态共擦从 0.2 拉到 0.6,都是压力测试而非稳定音频演示。
时钟消融为何电子很准而声学仍超标
先看电子与声学分开的消融。自由运行因漂移累积电子跨度很大,校偏移后大幅下降,仿射跟踪再小幅改进,因为 10 ms 信标下 20.833 微秒执行粒度已主导残差。声学则完全不同,不补偿时两万微秒量级,加位置补偿后降到四百微秒量级但仍有 98.864% 事件超过 30 微秒研究目标。两种仿射策略电子残差完全相同是故意设计的消融,不是硬件可重复性证据。
看图路径: 1. 对比左图电子残差从自由运行到仿射跟踪的下降幅度;2. 对比右图只有最后一组加位置补偿才明显下降;3. 注意两图纵轴都是对数轴,30 微秒虚线只是研究目标;4. 观察误差棒是 30 次运行的均值区间而非包内样本散布

论文图 2。原论文 Fig. 2::“Simulation-only clock ablation. Points are means of run-level p95 spans; bars are 95% t intervals over 30 independent runs.”。
上图左面板显示电子残差已压到目标线附近,右面板显示只有位置补偿点才显著下移,但仍在目标线上方。读图时注意纵轴对数压缩了数量级差异,误差棒是运行级均值的区间。
下表整理主定时数字,电子与到达是不同目标下的两种跨度,不能当成同一时钟抖动比较。到达列的补偿收益很大但未达标,电子列的仿射收益很小,说明瓶颈已转移。
| 条件 | 电子跨度均值 | 到达跨度均值 |
|---|---|---|
| 自由运行 | 1341.47 μs | 22098.00 μs |
| 仅校偏移 | 23.784 μs | 21953.61 μs |
| 仿射无位置 | 21.186 μs | 21953.66 μs |
| 仿射加位置 | 21.186 μs | 419.43 μs |
表后解释要抓住两句话。位置补偿把声跨度从约 21.95 ms 降到 419.43 μs,是模型层面的大幅改善;但在 2 cm 坐标噪声、50 ms 名义年龄和单采样执行粒度的假设下,仍未建立 30 微秒对齐。电子上继续优化滤波器已无意义,几何与执行才是剩余 margin 的消耗者。
位置年龄与接收机数如何改变结论
位置敏感用更短的 10 s 设置,不与 30 s 主结果混池。零坐标噪声在基线年龄下仍有约 288.59 微秒,2 cm 噪声时约 382.90 微秒,说明运动与陈旧估计本身就会留下残差。名义年龄从 0 拉到 0.5 s,补偿跨度从约 305.46 微秒升到 1425.60 微秒,执行粒度从单采样降到 0.5 微秒只改善电子而不改善位置受限的到达。几何上共享坐标扰动经角度投影到距离,多接收机即使单机统计不变也会拉大极差。
交付随 N 的变化更说明组指标的严格性。固定三副本在 64 机时把最差单机做到 0.997517、全员做到 0.974777,而单副本平均 0.96027 但全员仅 0.18522。均值风险策略在主设置选两副本,效果等同固定两副本却多付反馈;最差风险平均用约 2.011 副本,全员约 0.90473,代价更高提升很小。
看图路径: 1. 从左到右看平均、最差、全员三块面板纵轴范围的变化;2. 看单副本蓝线在全员面板随接收机数快速下跌;3. 看固定三副本与自适应策略在平均面板几乎重合但在全员面板拉开;4. 注意图注强调这是仿真而非实测射频性能

论文图 4。原论文 Fig. 4::“Simulation-only delivery scaling under common Markov fades and heterogeneous local erasures.”。
上图三面板纵轴不同,平均面板几乎水平,全员面板急剧下跌,说明把平均交付当成组服务是误导。固定三副本靠更大资源买可靠性,不是同预算下的胜出。
| 条件 N=64 | 平均交付 | 全员同时交付 |
|---|---|---|
| 单副本 | 0.96027 | 0.18522 |
| 三副本最差单机 | 0.997517 | 0.974777 |
表后补充限制。64 机三副本全员失败约 0.025223,远大于公共全擦下界,差值来自异构本地链路叠加;Jain 式交付平等指数在固定三副本时约 0.99999988,仍与全员 0.97478 并存,共损下人人一起丢反而平等但无用。位置与交付两族仿真独立评估,不能相乘得到端到端成功率。
哪些失败 regime 让加副本也无用
论文保留了两个不利 regime。信道侧在 N=16 把坏状态共擦从 0.2 提到 0.6,固定三副本最差交付从约 0.99783 降到 0.98576,自适应从约 0.99133 降到 0.97767,原因是重复上限 3、0.2 s 才更新 1 次、独立外推误设了相关结构,名义风险代理不是约束保证。容量侧固定三副本在 150 微秒时隙负载 0.91 加信标,到 200 微秒变 1.21,到 250 微秒变 1.51,负载超 1 时擦除仿真数字不变但不能解读为实时交付,时隙只是假设余量而非服务能力保证。
读失效图时区分两种不可行。左图是隐藏状态使自适应选错副本数,右图是日程根本放不下。
看图路径: 1. 看左图坏状态共损概率增大时最差接收机交付的下滑;2. 看右图预留时隙变长时负载超过 1 的不可行区;3. 区分左图是信道变差,右图是日程放不下;4. 注意右图标题写明不可行时交付预测无效

论文图 6。原论文 Fig. 6::“Simulation-only failure regimes. Left: stronger shared fades expose the lack of a correlated-risk guarantee.”。
上图左图显示共突发越强自适应越暴露缺相关保证,右图显示预留时隙一变长固定三副本先越过 1。即使均值负载小于 1,瞬时高副本或报告集中仍可能违反排布,聚合预留小于 1 只是必要条件。论文因此不主张自适应或固定策略的一般优越性,只报告在明确信道与日程假设下谁满足谁不满足。
复现第一步做什么与什么不能当证据
复现分完整性检查与独立执行两步。前者核对行数、种子覆盖、非空输出、输入哈希与数值一致性,不重跑;后者用同一配置与种子重跑仿真,只能证明计算可重复,不能证明外部输入分布代表真实房间与射频。政策与运行记录是置信区间的观测单位,块内样本不作独立复制,跨 N 不强制嵌套几何,小幅非单调不是物理容量效应。
来源方面,只有归属明确且可达的作者资源才能称已公开,本篇未发现此类绑定,不得声称代码模型数据已开源。SDK 审计只支持文档存在性,112 字节是保守模型选择而非产品上限,0xFF 广播与关闭确认是接口事实而非容量证明。空中时间引自文档系数,接收机累计在线时长是时长代理,不换算成功率电量或续航。17 项单元测试与符号审计保内部一致,不保外部标定正确。
什么时候值得试还需要补什么验证
当你的场景确实是一源多音箱、只关心一个听者位置、能接受外部定位与应用层重传,并且愿意为三副本与反馈预留接近 0.9 的时隙时,这套条件分析值得作为设计起点。先比执行器分辨率与电子定时,再看几何与年龄是否放进剩余声学余量,再用固定副本精确式算全员风险,最后验预留负载与播放期限,任一步不满足即不可行。
复现第一步是跑随包配置与仿真脚本,按 30 种子重算运行级 p95 均值与全员交付,保留种子与策略标签的 CSV。还需补的验证是真实板卡的天线边沿时间戳标定、样本可寻址 DAC 执行、定位延迟与年龄的端到端测量、耦合解码缓冲下的因果期限测试,以及多听者与混响下的声学评估。在此之前,所有数字只在声明的观测、分布与日程边界内成立,不构成硬件规格或与低功耗蓝牙音频的商用排名。
📎 论文与评分元数据
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses