📄 语码混合与母语之间双向迁移的系统综述
评分:5.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
👥 作者与机构
- Debajyoti Mazumder:Indian Institute of Science Education and Research, Bhopal
- Akash Anil:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要先理解的对象是语码混合(code-mixing / code-switching,指同一句或同一段对话内混用两种及以上语言),难点是混合语料稀少而每种组成语言又有较多单语资源,模型在混合输入上识别和理解都会变差。论文把组成混合的语言称为原生语言(native languages),先以跨库检索得到的11087篇去重文献为输入做规则过滤,得到4758个候选。接着用Claude Haiku 5.5只读标题与摘要判读是否陈述转移并标注方向、机制与模态,其输出经关键词审计后留下1451篇进入分类,其中1045篇只做原生到混合,只有82篇做反向。分类结果进入按转移方向、路径与模态组织的三层体系,原生到混合一侧先直接复用单语或平行数据,再由其合成混合句用于训练与评测。合成与真实混合语料接着作为适配原生预训练模型的输入,混合输入还被映射回原生文字、音素或嵌入形式以便复用原生模块,该映射输出直接决定适配与解码的效果。在共享的Mandarin–English混合语音基准SEAME上,加入原生Mandarin和English语音使dev_man混合错误率从22.26%降到17.64%,降幅大于同表多数结构改动。结论适用于有单语资源但缺混合语料的场景,不适用于无强原生模型支撑的低资源组成语言,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
为什么语码混合难做,母语资源能帮什么
这篇综述研究的对象是语码混合,也就是在一句话或一段对话里混用两种以上语言。例如印地语和英语混用的留言,前半句用印地语说开会时间,后半句用英语说会迟到。对刚进入语音或文本方向的研究生来说,关键是理解输入特点:词汇来自两个词表,语法可能在句中切换,社交媒体上还常出现罗马化拼写,语音里则是一个话轮内出现两种发音和韵律。
任务目标是让模型能处理这种混合输入,包括文本的语言建模、分类、翻译、情感分析,以及语音的识别和合成。同时必须保留的信息是切换点前后的语义和语言归属,不能把混合词当成噪声删掉。输出则依任务而定,可能是转写文本、类别标签或合成语音。困难在于混合标注数据很少,而每种组成语言都有大量单语语料,论文把这些组成语言称为母语。
因此自然的思路是迁移:在母语和混合场景之间搬运 5 类资源,即数据、模型权重、标签或词表、语言学知识、评测基准。方向有两种,从母语搬向混合场景,以及从混合场景搬回母语,还有只做测量而不搬运的分析工作。理解这套分类是读懂全文的基础,后文所有路线都挂在这棵树上。
以往综述讲了什么,本文补了哪块空白
此前的语码混合综述大多按任务、年代或语言组织。例如早期工作按任务和数据集整理,之后加入语言学和社会视角,再之后按年代梳理趋势。进入大模型时代后,综述进一步收窄,有的多语综述只把语码切换当成一种提示策略,有的只看语音识别,有的只看阿拉伯语,有的只看混合大模型,还有 1 篇覆盖 327 篇大模型时代文献但仍按任务组织。
本文的不同在于按迁移方向组织。它把 1451 篇论文同时按方向、路线和模态分类,第一次把从混合场景回到母语的工作当成独立脉络来统计。证据显示,这种反向工作长期被忽视,文本和语音社区即使使用相似机制也很少互相引用。本文的贡献就是把两侧放在同一框架下比较,指出哪侧人多、哪类机制通用、哪些结论只在特定条件下成立。
论文要回答的具体问题和统计口径
论文提出 3 个具体问题。第一,从母语到混合场景有哪些可行路线,各需要什么输入、用什么指标衡量、已显示出什么效果。第二,从混合场景回到母语是否真的有用,是靠数据增强、对齐表示还是提示策略起作用。第三,两侧社区是否互通,在共享语音基准上到底是数据还是结构带来更大变化。
为回答这些问题,作者检索了语义学术搜索 15 个查询池、ACL 文集和引用追踪,共得到 11087 篇去重论文,经规则过滤剩 4758 篇候选,再用大模型读标题和摘要判为范围内 1476 篇,经关键词审计去掉 25 篇非混合论文,最终纳入 1451 篇,其中文本 860 篇、语音 570 篇、多模态 21 篇。标签由模型给出,作者抽查 100 篇发现 2 篇完全标错、3 篇部分标错。复述时要注意,这些计数只反映标题摘要明确写出迁移的论文,摘要没写迁移的 1681 篇可能论文未被计入。
双向迁移的总体框架如何划分
理解全文可以先抓住三层分类。第一层是方向,母语到混合、混合到母语、双向和分析。第二层是路线,母语到混合侧分为直接用单语平行数据、合成混合数据、适配预训练模型、把混合输入映射回母语形式;混合到母语侧分为增强、预训练目标、课程与上下文学习;分析侧则做探测、基准和混合输入的影响测量。第三层是模态,文本或语音。
下图展示了这种双向关系,读图时先分清两侧对象,再看箭头上的手段。
读图说明:这张示意图把论文的核心分类画成两个方框加两条弧线,需要对照正文理解每条弧线代表的一组方法。
看图路径: 1. 先看左右两个方框分别代表母语侧和语码混合侧;2. 再看上方蓝色箭头和下方橙色箭头标注的迁移内容;3. 注意中间分析与评估同时指向两侧的含义
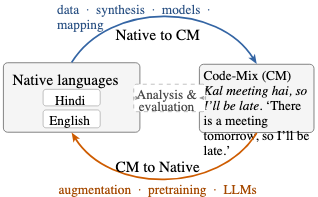
论文图 1。原论文 Figure 1::“Two directions of transfer between native languages and the CM setting.”。
图中左侧方框是母语,以印地语和英语为例,右侧方框是语码混合实例及其英文翻译。上方蓝色弧线从母语指向混合,标注数据、合成、模型和映射;下方橙色弧线从混合指回母语,标注增强、预训练和大模型用法;中间虚线表示分析与评估同时测量两侧。可以看到,混合场景不是孤立任务,而是建在两种母语之上的叠加态,资源在这两层之间来回流动。
母语数据直接用:何时够用,何时不够
最省事的路线是直接拿母语数据训练。文本上,早期混合语言模型直接用单语训练,或约束两种语言的输出表示靠近,在切换点上能持平甚至超过合成数据训练的模型。单语树库不经混合训练就能解析印地英语推文,纯印地语和英语仇恨样本在混合测试上达到 0.60 的 F1,加混合样本后为 0.63。但只用维基百科训练的西班牙英语语言标识达到 92.23% 的 F1,低于有监督的 98.43%。结论是母语数据适合做补充,单独用很少追上有标注混合数据,能替代多少标注量仍是开放问题。
语音上,混合训练把单语语音简单混在一起,模型在句内从未听到切换。早期工作用双语言模型加切换模型,或约束双语输出表示对齐,后来在解码端引入重打分、内部语言模型估计和单语数据存储。把单语片段拼接成合成混合音频也能训练识别器。合成侧则面临 1 人一声的问题,早期用双语后验特征分离说话人和语言。共同规律是数据越匹配目标口音和领域,收益越大,失配的单语数据甚至有害。
母语 × 语码混合 × 迁移方向: 母语指参与混合的各单语,如印地语和英语;语码混合指一句话或一段对话内使用两种以上语言;迁移方向指资源从哪一侧流向哪一侧,决定了方法是要解决混合输入的识别理解,还是要用混合例子改善母语或跨语言能力。
合成混合数据:从语言学规则到大模型生成
单语数据不能告诉模型两种语言如何在一句内组合,合成混合数据就是补这一课。文本上,第一代用等价约束或矩阵语框架决定哪里可以切换,先在合成数据上训练再在真实混合数据上微调,效果约等于真实数据翻倍。但规则未必符合真实切换习惯,于是出现神经生成器和翻译管线,把平行句对齐替换或整体转写成混合句。2023 年后用大模型提示生成最便宜,但质量因语言对而异,英文南非荷兰语尚可,英文泰米尔语较差,而且缺乏可靠的混合质量打分,过滤困难。
语音需要两类合成,混合文本给语言模型,混合音频给声学模型。文本侧从功能中心约束走到复制机制再到词替换和大模型,阿拉伯英语上替换文本带来困惑度和词错误率下降。音频侧用语音合成和拼接,语音拼接平滑接缝后域内混合错误率最多降低 34.4%,但拼接不连贯,后续用语音编辑改进。需要注意,增益多在弱基线上显著,对强基线和纯单语测试的提升较小,且没有研究在受控条件下把生成质量与下游增益对应起来。
合成语码混合数据 × 单语与平行数据: 单语与平行数据是原材料,提供两种语言各自的句子和对照;合成语码混合数据是用规则、对齐替换或大模型把这些原材料拼成一句内混合的句子,目的是让模型在训练时见到切换点,弥补真实混合语料稀缺。
适配预训练模型与输入映射:改模型还是改输入
多数工作不再从零训练,而是适配母语或多语预训练模型。文本上默认做法是在标注混合数据上微调多语编码器,共享任务使其成为惯例。有混合语料时继续预训练更强,如印地英语的 HingBERT,但多数语言对缺乏大混合语料,于是出现模型合并、适配器等轻量路线,合并可带来 2 到 5 个点的 F1 提升,一种适配器只增加 5.6% 参数。但多数论文只报告一个骨干在一个数据集上的结果,继续预训练何时值得仍不清楚。
语音适配围绕普通话英语识别,核心是判断当前听到哪种语言。早期用预测语言或切换的多任务学习,Whisper 时代用 1 到 10 小时混合数据适配,再加语言感知解码和专家混合路由。多数结果来自 SEAME,迁移到其他语言对是否成立未知。另一条路线不改模型而改输入,文本上把罗马化转写回原生文字,自动转写在阿拉伯语情感上达到 76% 的 F1,接近人工的 78%,但转写还是翻译 whole 句,证据冲突,取决于任务和文字。语音上则是合并两套音素集,带来约 1.2% 的词错误率下降,或把输出统一为罗马化。
微调 × 继续预训练 × 轻量适配: 微调指在已标注混合数据上更新多语模型的权重以适应具体任务;继续预训练指先在无标注混合语料上继续语言建模再做任务;轻量适配指只加适配器或合并权重等少量参数,二者分工在于效果与成本的权衡,语料大时继续预训练更强,语料小时轻量适配更省。
混合数据反哺母语:增强、预训练与提示
反向把混合当资源用,主要靠把两种语言放在同一上下文里对齐。文本增强的旧法是替换,用词典把单语句子中部分词换成目标语言译文,在 5 个任务 19 种语言的零样本迁移上有效。后来加上一致性正则、按显著性选词、测试时也切换,以及直接生成混合句。朴素替换可能造出不合语法句子,损害词性和命名实体,于是用模型选符合上下文的词,在 30 多种语言上修复。跨语言检索上对远距离语言可达约 2 倍提升,但需要把混合输入与原文对齐,否则可能有害。
预训练目标把切换做进表示,如交替语言建模优于基于翻译的预训练,不依赖平行语料的混合掩码建模也能提升跨语言理解。大模型时代则用混合课程从词级到句级再到单语,或在推理时用混合示例引导低资源语言,低资源目标上增益达 14.7 个百分点。先改写为混合形式再回答,也能缩小母语与英语的知识差距。语音的反向证据很少,一项研究用大模型生成的混合文本同时降低混合测试集和纯普通话、纯英语测试集的词错误率,相对下降 5.3% 和 8.5%。
替换增强 × 预训练目标: 替换增强是在微调阶段把源语句中部分词换成词典译文,形成混合上下文;预训练目标是把这种混合直接做进掩码或交替语言建模,让表示从一开始就对齐两种语言,前者是数据层面的短期手段,后者是表示层面的长期塑造。
综述如何收集标注论文,训练指什么
这是 1 篇综述,没有训练新模型,这里的训练指纳入论文的筛选与标注过程。作者用 Claude Haiku 5.5 读每篇候选的标题和摘要,无摘要时只读标题,判断是否在范围、方向、机制、任务和模态。年代和语言对按年份与语言代码规则划分。随后做关键词审计,只保留标题或摘要含语码混合相关词的论文,去掉纯单语多语识别或无混合的罗马化文本。
这个流程的代价是标签噪声和覆盖偏差。随机抽查显示约 5% 存在完全或部分错误,稀有类别抽样更薄。约 29% 语音候选没有摘要,只能靠标题判断,IEEE 和 ISCA 收录不全,文本覆盖可能好于语音。引用追踪只新增 48 篇,作者认为召回尚可,但未与独立清单对比。读结论时要记住,计数和趋势都依赖于这套标题摘要口径,全文细节只在重点讨论的论文中核对过。
分析与评测如何搭建,指标朝哪边好
第三类工作不建系统,只测量母语知识与混合行为的关系。文本上早期探测多语编码器能否表示混合输入,发现混合表示与两种母语保持弱关联,适配混合会增强英语与混合的对齐但削弱英语与印地语的对齐。大模型时代转向基准测试,发现大模型在混合输入上差于微调模型,混合提示还把安全攻击成功率从单语的 9% 推高到 69%,但推理时允许混合反而有助于数学,强制单语解码使准确率下降 5.6 分。
语音分析围绕语料库,覆盖阿拉伯英语、越南英语、土耳其德语、普通话英语和印地英语等。单语、多语与混合适配模型的比较结论不一,取决于档案口音和测试集。评测指标是争议点,词错误率会惩罚合理的转写变体,夸大质量差距约 3 倍,因此出现结合转写归一化的指标和只评关注词的指标。所有准确率、F1 都是越高越好,错误率、困惑度、混合错误率都是越低越好,比较时必须看分母和聚合对象是否一致。
四个主要发现:方向、引用、对齐与数据效应
综述的量化发现建立在 1451 篇的标签统计和 SEAME 的配对比较上。先看规模趋势,下图按年统计各方向论文数,母语到混合远多于反向,分析类近年上升。
读图说明:这张折线图横轴是年份到 2026 年 10 月,纵轴是每年论文数,3 条线分别代表不同方向,需要比较高度和斜率而非单点数值。
看图路径: 1. 对比深蓝实线与橙色线的高度差距;2. 观察 2018 年前后三条曲线的爬升节奏;3. 注意 2026 年灰色阴影只统计到 10 月初
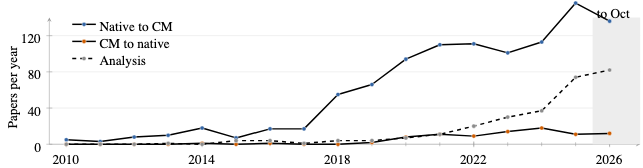
论文图 2。原论文 Figure 2::“Included papers per year and direction.”。
图中深蓝实线是母语到混合,从 2020 年约 94 篇涨到每年 156 篇左右;橙色线是混合到母语,每年仅 8 到 18 篇;虚线是分析类,近年爬升到约 80 篇。总量上 1045 篇为母语到混合,82 篇为反向,仅 5 篇双向,语音中 473 篇对 7 篇,极不平衡。文本和语音共享 8 种以上机制,但跨模态引用仅为随机的 0.37 倍,微调、适配器和预训练几乎互不引用,只有合成数据有实质交流。反向 87 篇中有 67 篇靠插入混合文本对齐,其中 33 篇替换、20 篇预训练目标、14 篇生成数据。
混合错误率 × 词错误率: 词错误率统计识别文本与参考在词级别的插入删除替换;混合错误率是语码混合语音评测中类似的错误率变体,常与词错误率一起报告,二者都是越低越好,但在混合语音中还要面对书写形式不统一和语言切换点的额外惩罚。
混合反哺母语与跨综述对比:在什么条件下成立
下表比较混合帮助母语的路线,比较问题是混合例子通过何种输入换来跨语言或单语增益。指标方向是准确率、F1 越高越好,词错误率、翻译错误越低越好,同样跨行不可比。
本表按原文表 2 整理反向迁移的输入需求与证据,重点看对齐机制是否在平行数据之外带来额外增益。
| Approach | Mod. | What it needs | Evaluated by | What has been shown |
|---|---|---|---|---|
| Substitution augmentation | T | Bilingual dictionary | Zero-shot accuracy, F1 | Gains on 5 tasks and 19 languages (Qin et al., 2020) |
| Mixed data for speech | S | CM text or speech | WER | Also lowers monolingual WER (Hu et al., 2023) |
| Pretraining objectives | T | Parallel or monolingual corpora | BLEU, XNLI | An alignment signal; parallel data may matter more (Yang et al., 2020a; Shao et al., 2026) |
| In-context switching | T | An LLM | Accuracy | Up to 14.7pp in low-resource settings (Yoo et al., 2026) |
替换增强在 5 个任务 19 语言上有效,生成增强在不损英语下提升低资源语言,上下文选词修复了词性和实体上的不合语法问题,语音混合文本同时降低单语词错误率。预训练和课程在韩语日语印尼语等多语言问答和翻译上有效,上下文切换在低资源上达 14.7 个百分点。但关键限制是平行数据的贡献更大,一项消融去掉双语文档使翻译下降 56% BLEU,主要来自平行文本而非混合文本,混合是否在平行之外增值尚未证实。未胜出项是朴素混合会损害检索和安全,需要对齐约束。
下表把本文与以往综述对比,比较问题是各综述是否覆盖语音文本、是否按方向组织、是否讨论反向。
本表按原文表 7 整理 9 篇综述的覆盖范围,用于说明本文按迁移方向组织的增量。
| Survey | Year | No. | Text | Sp. | Dir. | C2N |
|---|---|---|---|---|---|---|
| Winata et al. (2023) | 2023 | 400+ | Y | Y | N | P |
| Sheth et al. (2026) | 2026 | 327 | Y | Y | N | P |
| Gupta et al. (2026) | 2026 | – | Y | N | P | Y |
可以看到此前综述按任务年代或语言组织,即使提到反向也只占一节,只有本文同时覆盖双向和双模态并统计反向规模。这支持作者关于社区割裂的判断:仅 10% 的母语到混合论文引用反向论文,文本语音同机制引用率仅 0.37。但这张表是文献计量,不是效果比较,不能推出按方向组织一定带来更好模型。
路线与机制如何归类,SEAME 配对比较说明什么
下表是分类树的路线与机制对应,比较问题是同一路线下文本语音共用哪些机制标签。
本表按原文表 8 整理各路线包含的机制标签,用于在复现时快速定位方法属于哪条路线。
| Route (section) | Mechanism labels |
|---|---|
| Monolingual & parallel data (§3.1) | Monolingual data |
| Synthetic CM data (§3.2) | Synthetic CM, substitution |
| Pretrained models & adaptation (§3.3) | Fine-tuning, adapters, pretraining, multitask, prompting, distillation |
| CM augmentation (§4.1) | Substitution, synthetic CM |
母语到混合的预训练适配包含微调、适配器、预训练、多任务、提示和蒸馏,映射包含管线映射与表示对齐;混合到母语的增强与预训练都依赖替换与合成,课程与提示依赖提示与微调;资源与评测归入分析。这种归并解释了为什么文本语音方法相似却互引少:标签相同但载体从词嵌入换成声学单元,评价集也不同。限制是残差类不在树中,37 篇无方向论文未进入主线。
SEAME 是唯一被多篇论文共享的混合语音基准。原文在附录中配对比较 11 篇论文,每行基线与最优共享数据、模型量级和解码,行间不可比。一旦基线进入 15% 到 20% 混合错误率,改结构或目标最多再降约 2 个点;同模型加入普通话英语单语数据可降 4.6 个点,加 100 小时合成语音在强 Whisper 上仍降 2.0 到 3.2 个点。这说明在该基准上数据匹配的杠杆大于新结构,但结论只在 SEAME 的普通话主导与新加坡英语测试条件下成立,不能推广到所有混合对。
母语到混合的四条路线各需要什么、效果如何
下表比较母语支撑混合的 4 条路线,比较问题是给定不同输入条件时各路线用什么代价换取什么收益。公平条件是只看原文各自的基线和指标,表注已说明跨行不可比,指标方向是困惑度、错误率越低越好,F1 和平均意见分越高越好。
本表按原文表 1 整理 4 类方法的输入需求与已报告效果,用于判断手头只有单语资源时应优先尝试哪条路线。
| Approach | Mod. | What it needs | Evaluated by | What has been shown |
|---|---|---|---|---|
| Monolingual LM training | T | Monolingual or translated text | CM perplexity | Matches LMs trained on synthetic CM data (Chuang et al., 2020) |
| Native samples and resources | T | Labelled native data, treebanks, lexicons | F1, LAS | Helps as a supplement, but trails annotated CM data (Mazumder et al., 2025a; Iliescu et al., 2021) |
| Theory-driven generation | T, S | Parallel text, parser or aligner | Perplexity, human rating | About as useful as doubling real CM data (Pratapa et al., 2018a) |
| Audio synthesis | S | Monolingual audio, TTS | WER, MER | Up to 34.4% lower MER (Hussein et al., 2024b) |
直接用单语数据成本最低,但多为补充,单独用落后于有标注混合数据;合成数据能补切换模式,理论驱动约等于真实数据翻倍,音频拼接域内最多降低 34.4% 的混合错误率,但质量参差且缺乏可靠过滤;适配预训练模型是默认做法,继续预训练在有语料时更强,轻量合并可加 2 到 5 个 F1 点,适配器只增 5.6% 参数;输入映射靠转写和音素合并,自动转写接近人工的 76% 对 78% F1,音素合并仅带来约 1.2% 的词错误率下降。限制是这些数字来自不同数据集和基线,不能跨行排名,且多数只在一个骨干上验证。
结论的边界与尚未验证的部分
首先,效果数字不可跨论文排名。原文两张总表已注明不同设置的数字不可比,正文引用的 34.4%、5.3%、14.7 个百分点等都绑定各自基线和语言对。百分点与相对百分比含义不同,不能混用。其次,语言覆盖偏斜,印地英语和中文英语主导,非洲对如约鲁巴英语、班巴拉语音很少,缺乏强母语模型的语言对能否复用相关高资源语言仍待验证。
第三,文字与评测未解决。罗马化与原生文字的选择影响语言标识和安全检测,参考基准在无干净单语目标时失效,常用混合指标与人工可接受度相关差。第四,混合比例无人系统扫描。微调时母语何时有害、反向需要多少混合才显效,都没有受控扫参。第五,标注与召回局限如前所述,29% 语音无摘要、IEEE 收录不全,文本覆盖可能优于语音。
值得尝试的场景与复现第一步
什么时候值得尝试取决于手头资源。只有单语无混合语料时,可先试合成混合文本或拼接混合音频,注意用领域匹配的单语数据,并留出自然混合验证集检查生成质量。有少量标注混合数据时,优先微调多语模型,文本有大混合语料再考虑继续预训练,语音普通话英语可直接适配 Whisper 并加语言感知解码。输入多为罗马化时,先做转写归一再跑母语工具,并对比转写与翻译整句两条管线。要改善低资源母语,可试词典替换增强或混合提示,但需加一致性或对齐约束,避免不合语法。
复现第一步是固定评测。语音先在 SEAME 的标准集上复现基线与混合错误率,文本先固定语言对、划分和指标方向,再引入单语或合成数据做配对比较,每次只动数据或结构其一。报告时同时给出单语结果、自然混合基线和多个骨干,避免单骨干单数据集的结论。还需要补的验证是数据配比扫参、跨语言对迁移、转写归一化指标与人工判断的对应,以及大模型生成混合文本的可接受度检查。
关于可用性,现有证据无法确认作者代码、模型或数据已公开,需以论文仓库和后续版本为准。
一句话总结与后续验证清单
总的来说,这是一条双行道但车流极不均衡:母语资源长期支撑混合处理,混合反哺母语年轻且主要靠对齐两种语言,文本语音方法相通但文献互引少,在共享语音基准上数据匹配的收益大于结构改动。
后续验证清单包括三项。第一,做数据配比的受控实验,量化混合与单语各加多少最划算,何时出现语言混淆。第二,为所用语言对建立转写归一化的语义指标,并与人工可接受度对齐。第三,把在印地英语和普通话英语上成立的做法,搬到低资源构成和另一文字体系上重测,确认适用边界后再谈推广。
📎 论文与评分元数据
排名:前50% | 文档类型:综述 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses