共分析 57 篇论文
⚡ 今日概览
✅ 筛选入选 57 篇 → 🔬 深度分析完成
每篇论文保留完整分层分类;热门方向按主任务的最上级方向统计,每篇计入 1 个方向。排行榜也显示最上级任务。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| 语音识别 | 7 篇 | ███████ |
| 语音合成 | 5 篇 | █████ |
| 语音交互 | 3 篇 | ███ |
| 音视频理解 | 3 篇 | ███ |
| 音频理解 | 3 篇 | ███ |
| 视频伪造检测与溯源 | 2 篇 | ██ |
| 语音属性识别 | 2 篇 | ██ |
| 语音驱动手势生成 | 2 篇 | ██ |
📊 论文评分排行榜(57 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 DF-PALM:给音频语言模型的类别表示加上随样本变化的动态融合

英文题目:DF-PALM: Dynamic Fusion Prompt Learning for Audio–Language Models
评分:7.9/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yulin Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Shenghua Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yong Dou:机构信息未能在本次解析中与作者逐人可靠绑定
- Xinwang Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Cheng Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Kele Xu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是少样本音频分类:每个类别只有 4 到 32 个带标签音频,系统要把一段波形判到几十个类别之一,困难在于同一事件在距离、背景和录音条件变化下差异很大。处理过程是冻结的音频编码器和文本编码器先给出全局音频向量和各类别的文本向量,再在特征空间做适配,最后算相似度打分。动态融合提示学习(Dynamic Fusion Prompt Learning for Audio-Language Models,DF-PALM)先用瓶颈网络从音频向量生成共享残差,加到每个类别的可学习上下文上形成随输入变化的类别矩阵。同一矩阵在多层交叉注意力中作键和值,只更新音频状态,精炼后的音频向量再与该矩阵算余弦相似度乘以固定尺度得到分类对数。与输入无关的 PALM 只学静态类别表示且直接打分,DF-PALM 保留了编码器冻结和后编码适配,但增加了实例条件和音频精炼。在以 PENGI 为骨干的 11 个基准 16 样本主评测中,DF-PALM 相对 PALM 的跨基准平均准确率提高 4.11 个百分点,达到 80.69%。结论适用于所测的 11 个基准和 3 种音频语言骨干,在类别很多或样本极少时的表现尚未充分验证,50 类时算子统计的推理浮点运算量相对 PALM 增加 0.39%。
🔗 开源资源
- 代码相关资源:https://github.com/sunyulin0421/DF-PALM — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 语音增强语言模型为什么会编造转写:探测与抑制 ASR 幻觉

评分:7.6/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Bi-Cheng Yan:机构信息未能在本次解析中与作者逐人可靠绑定
- Jhih-Rong Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Fu-An Chao:机构信息未能在本次解析中与作者逐人可靠绑定
- Berlin Chen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
研究对象是语音增强语言模型转写,即语音编码器从音频抽取声学特征,经卷积桥接成音频向量后连同指令一起送入语言模型自回归生成转写文本。难点是语言模型偏向沿用已生成文本先验,编造与语音无对应的词,这类词经对齐后成为插入错误中的幻觉词,需与普通识别错误区分。论文把幻觉错误率定义为幻觉词数除以参考词数,并用清零遮蔽测算多头自注意力与前馈模块对幻觉词概率的影响差异,同时对比幻觉词与非幻觉词对音频和文本的注意力分配。AudioSLM在输入特征层由联接时序分类模块从音频向量抽取逻辑向量作为对齐特征,经门控与深度卷积精炼得到新的音频向量,再在架构层每个Transformer块的自注意力与前馈之间插入以该音频向量为键值的交叉注意力做跨模态对齐。在LibriSpeech的dev-clean评测集上,与Vanilla-SLM基线相比,AudioSLM把幻觉错误率(HER%)从52.01%降到8.69%,插入错误同步下降,代价是正确率和替换错误略有回退。分析发现多头自注意力比前馈对幻觉贡献更大,且幻觉词注意力过度偏向文本而忽视音频,上述两处改动分别针对时间过滤与跨模态对齐,与仅靠后处理或偏好优化不同。结论限于以SmolLM2为骨干、Whisper编码器加卷积桥接的英文朗读语音转写,尚未验证大词汇自发语音或强噪声;原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/bicheng1225/AudioSLM — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 会“呼吸” 的语音大模型:对话中非言语发声的建模

英文题目:Speech LLMs That Breathe: Modeling Non-Verbal Vocalizations in Dialogue
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Heyang Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Lixin Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiayi Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziyang Cheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuhao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ronghua Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Qunshan Gu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yanfeng Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
研究对象是语音大模型在共情安慰单轮交互和多轮角色扮演对话中如何产生叹息、笑声、呼吸、应答词等非言语发声。困难在于这类事件稀疏且高度依赖上下文,随机插入破坏自然度,完全回避则显生硬,需要同时决定是否出现、在何处出现和选择哪一类。处理过程是先用普通话真实语音训练判断上下文是否适合出现特定发声的文本预测器,再用该预测器筛选合成对话语料,接着让对话模型学习生成带特殊标记的文本回复,最后用奖励优化调整事件选择并训练语音生成。文本到文本监督微调使模型学会输出标记,NVV感知的组相对策略优化用合理性、数量、一致性、分布和格式奖励抑制滥用安全类别,语音到语音训练则把标记还原为可听发声。与只支持固定词表但不建模位置合理性的已有做法不同,该工作把出现与否、位置和类别选择作为联合学习目标,并对比单码本与多码本两种语音重建路线。在共情交互评测中,VocalNet词元级合理性经NVV感知组相对策略优化从92.5%升至96.8%,高于仅经文本到文本监督微调的同一模型。在6,034条录音、约317K个候选位置、约7K个真实发声的预测器评测中,真实位置的中位预测概率高于非NVV位置,为其75.0倍,判断是否应出现事件的AUC-ROC为0.7635;结论适用于普通话合成对话场景,在真实多轮噪声对话和未覆盖发声类型上尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. MSCR:同时平衡模态利用并发现协同信息

英文题目:MSCR: Jointly Balancing Utilization Across Modalities and Discovering Synergistic Information
评分:7.4/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xinyu Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Liangjian Wen:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiang Duan:机构信息未能在本次解析中与作者逐人可靠绑定
- Dongkai Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yong Dai:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiayu Bai:机构信息未能在本次解析中与作者逐人可靠绑定
- Jianzhuang Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhen Tian:机构信息未能在本次解析中与作者逐人可靠绑定
- Guoping Qiu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhao Kan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
研究对象是多模态分类与情感打分任务,输入为视频、音频、文本中的两种或三种,输出为类别或二值情感判断,困难在于联合训练时较易优化的模态会主导融合,使模型只用单模态可得的信息而忽略必须联合观察才出现的增益。论文提出多模态协同竞争正则项(Multimodal Synergistic Competition Regularizer,MSCR),编码器先把各模态输入映射为表征并分别经辅助单模态预测器得到单模态预测,同时融合网络综合表征得到联合预测,为后续扰动比较提供基准。MSCR分支先截断表征梯度并沿批次独立置换某一模态表征,构造扰动后的融合预测,再计算其与原联合预测的分布差异得到各模态敏感度,并经可微平滑最大值聚合为反主导目标,该约束只更新融合网络。随后协同分支以单模态预测平均构成加性参照,要求融合预测损失比该参照低出一个间隔,自适应门控再依据较好的单模态损失决定正则强度,使难样本的上述两项目标获得更大权重并回传至融合网络。与只做竞争平衡的MCR相比,MSCR在AVE的Conformer视频-音频设置上准确率从87.4%提高到89.3%。协同证据上MSCR在两单模态预测器皆错样本上的条件恢复率及归因于跨模态交互的份额均高于MCR,且条件恢复增益在Transformer融合下依然存在。上述结论只在沿用MCR的既定编码器、融合、数据划分与训练流程的五个基准任务上得到验证,加性参照只是对非协同证据的可行近似而非严格分解,在单模态已足够或交互模式显著不同时可能失效,对其他主干与大规模数据的表现尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/chenxinyu991-collab/MSCR — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. 听不清就问:面向流式语音识别错误的定点澄清

英文题目:Ask, Don’t Guess: Targeted Clarification for Speech Recognition Errors
评分:7.4/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sankalp Parashar:机构信息未能在本次解析中与作者逐人可靠绑定
- Preethi Jyothi:机构信息未能在本次解析中与作者逐人可靠绑定
- Sunita Sarawagi:IIT Bombay
📌 核心摘要
读者需要理解的对象是远场会话中流式语音识别产生的局部转录错误,困难在于噪声遮蔽造成的可重复修复错误与语言歧义错误混在一起,而只有前者值得打断说话人要求重复。论文用同一识别器对远场音频和干净音频分别解码,再用对偶隐马尔可夫模型对两种解码做概率对齐,得到每个噪声词元在干净条件下可能改变的软监督。冻结的流式Transducer在输出噪声解码的同时,反事实增益评分器只用词元发射时刻前可见的声学与语言特征为每个词元打分,输出可修复错误概率。累积和算法按词最高分把连续高分词组成片段并决定打断点,系统用锚词提问请说话人重复该片段。重复音频由同一识别器独立解码,大语言模型再用该重复转录只改写被标记片段,其余转录保持不变。与以参考文本正确性为监督的置信度估计不同,该监督以干净解码为反事实目标,只学习重复后可能改变的错误。在AMI评测集上,该方法在70%精度下召回32.5%的错误词元,比最强基线高7.2个百分点;在负担为每分钟6时,用合成应答相对降低23%词错误率。适用范围限于可用平行干净音频或合成音频构造监督的远场错误,真实打断成本、复述以外回应和非Transducer架构尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. 语音脑机接口一定要用大模型吗:BEST 的轻量解码路径

英文题目:Do Speech BCIs Need Larger Models? Rethinking Neural Decoding beyond Scaling
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zehui Feng:Shanghai Jiao Tong University;Nanyang Technological University
- Weichuan Wang:Shanghai Jiao Tong University
- Xiaohan Chen:Shanghai Jiao Tong University
- Cuntai Guan:Nanyang Technological University
- Ting Han:Shanghai Jiao Tong University;Zhejiang University
📌 核心摘要
需要理解的对象是从皮层记录得到的神经活动,困难在于数据量少、噪声大且跨天漂移,直接把高维信号压成离散音素硬标签会丢掉细粒度结构并放大过拟合。所提框架Brain-Encoding-Speech-Text(BEST)先用分层编码器把神经时间片变成音素级与字符级两种连续表示,再用轻量多尺度卷积把两路特征融合成统一嵌入,最后把该嵌入送入语音预训练模型的编码器上层与解码器生成文本,并用小规模n元语言模型做候选重排。与依赖大生成模型和音素硬判决再纠错的已有流程相比,该设计推迟离散判决并保留多层连续结构。在Brain-to-Text’25测试集相同5元语言模型条件下BEST词错率为2.57%,低于Transformer基线的3.81%和GRU基线的5.41%,而Robust BEST在’25测试集上取得1.62%词错率、在’24测试集上为6.19%词错率,参数量仅为可比方法的3.85%。作者承认单被试评测、长期漂移与依赖语音预训练偏置等限制尚未解决。在Jetson Orin Nano上端到端推理计算量从1736.26降至123.17 GFLOPS,延迟从1189.71 ms降至215.67 ms,峰值内存从7.23 GiB降至2.79 GiB。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. 用可编辑的符号化主歌单做翻唱:MuLaCover 如何保留调性又放开速度与结构

英文题目:MuLaCover: Flexible Cover Song Generation via Symbolic Tonal Control
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Lynn Yi:机构信息未能在本次解析中与作者逐人可靠绑定
- Zihan Xiong:机构信息未能在本次解析中与作者逐人可靠绑定
- Junjie Cao:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaolong Weng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yingzhe Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Gus Xia:机构信息未能在本次解析中与作者逐人可靠绑定
- Jinliang Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxin Xie:机构信息未能在本次解析中与作者逐人可靠绑定
- Xianwei Zhuang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuguo Yin:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiao Jin:机构信息未能在本次解析中与作者逐人可靠绑定
- Gongxi Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiayu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Junjie Liang:机构信息未能在本次解析中与作者逐人可靠绑定
- Qin Yue:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziyu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Dading Chong:机构信息未能在本次解析中与作者逐人可靠绑定
- Meng Cao:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiahuan Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Dongchao Yang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
翻唱需要保留可识别的旋律与和声骨架,同时改变音色、配器、速度、结构乃至歌词,输入是一首参考录音加目标歌词与风格描述,输出是一首完整歌曲,难点在于既要听得出是同一首歌,又不能被参考的时间进度锁死。MuLaCover 先从参考录音提取人声旋律与和弦进行,组成主歌谱,再把时间轴拉伸到每分钟 120 拍的规范速度,消除原曲速度带来的帧级对应。规范后的旋律写成二值钢琴卷帘,和弦写成十二音级的二值色度卷帘,分别线性投影后拼接成条件序列。条件序列经过门控自适应交叉注意力模块注入预训练文本到歌曲骨干网络的后 8 层,训练分短片段预热、全曲训练和跨版本微调三个阶段,推理时可用掩码只保留片段条件生成全曲。与以帧级基频或音频隐变量为条件的已有翻唱系统相比,该设计允许变速与结构重排,并支持续写、外绘与内填。在 32 首参考、每首 8 种风格共 256 首翻唱的客观评测中,MuLaCover 的翻唱检索首位准确率为 0.97,接近 Suno-v5.5 的 0.98 并高于开源基线。原文未披露训练、推理或部署成本,当前结论主要适用于合成数据分布,作者也承认翻唱边界固定在主歌谱层面。
🔗 开源资源
第三方资源:https://mulalabs.ai/mulacover/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/lsfhuihuiff/SongEcho_ICLR2026 — 链接可访问(HTTP 200)
第三方资源:https://vvanonymousvv.github.io/SongEcho_updated/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/ace-step/ACE-Step-1.5 — 链接可访问(HTTP 200)
第三方资源:https://github.com/ace-step/ACE-Step-1.5/blob/main/docs/en/INFERENCE.md#2-cover — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. Monsoon:为低资源语言大规模收集自发语音

英文题目:Monsoon: Scalable Spontaneous Speech Collection for Low-Resource ASR in 50 Languages
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Shobhit Banga:机构信息未能在本次解析中与作者逐人可靠绑定
- Manas Dhir:机构信息未能在本次解析中与作者逐人可靠绑定
- Aaditya Pareek:机构信息未能在本次解析中与作者逐人可靠绑定
- Amritansh Walecha:机构信息未能在本次解析中与作者逐人可靠绑定
- Bhaskar Singh:机构信息未能在本次解析中与作者逐人可靠绑定
- Hanuman Sidh:机构信息未能在本次解析中与作者逐人可靠绑定
- Manmeet Kaur:机构信息未能在本次解析中与作者逐人可靠绑定
- Sagar Jain:机构信息未能在本次解析中与作者逐人可靠绑定
- Supriya Paul:机构信息未能在本次解析中与作者逐人可靠绑定
- Vanshika Chhabra:机构信息未能在本次解析中与作者逐人可靠绑定
- Utkarsh Singh:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
面向低资源语言的自动语音识别输入是真实对话录音,输出是文字转写。难点是已有训练数据多为朗读或复用音频,与日常自发说话差异大,标注噪声又难以靠文本规则修复。Monsoon把两名陌生说话人配对,用手机分通道录制按话题引导的即兴交谈,再用语言性别与录制媒介分类器过滤并切分单人片段。草稿转写经过五轮一人修改一人核验并抽检入库,入库前再按音质与时长分桶优先保留稀有词片段并控制说话人占比。与来源固定的复用数据做法的关键差异是采集阶段即控制话题多样性与说话人分布,并以多轮校验与筛选换质量。在一千小时同等时长与相同引导话题下,Monsoon处理后数据训练的Whisper medium比仅做语言检查与单轮转写的常规协议在Hindi等三语的IndicVoices与Vistaar评测上语义词错率相对低10%至39%。在双方均未见过的IndicVoices与Voice of India自发语音评测上,Monsoon微调的Whisper medium比同架构IndicWhisper语义词错率低20至44个点。该结论不含卡什米尔语对比,在Vistaar自带集上双方基本持平且泰米尔语差距较大,超出现有三千五百小时量级与商用系统未知训练数据范围尚未验证;训练成本为每语言在8卡H100上以全局批量256用bf16微调五个epoch。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. 长聆听思考:用细致感知与反思式推理改进音频推理

评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jaeyeon Kim:Carnegie Mellon University
- Chao-Han Huck Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Luoyi Zhang:Carnegie Mellon University
- Chan-Jan Hsu:Carnegie Mellon University
- Fernando Ruiloba Portilla:Carnegie Mellon University
- Jinchuan Tian:Carnegie Mellon University
- Shinji Watanabe:Carnegie Mellon University
- Carlos Busso:Carnegie Mellon University
📌 核心摘要
读者需要理解的对象是大型音频语言模型在回答语音、声音事件和音乐混合问题时的推理过程,困难在于模型常听错细粒度声学细节与时间结构,而已有训练数据只提供粗糙事件标签或模型自产描述。处理过程是为每段音频构建更稠密的多方面描述,再围绕该描述改写更难的问题、合成似真但错误的短推理,并把短推理延续为包含核查与回溯的长推理。第一步用专用字幕模型、语谱图加视觉语言模型与语音、说话人、事件、音乐结构工具分别产出语义、声学和时间信息并拼接。第二步由指令模型 Qwen3-Next-80B-Instruct 生成更依赖细听与多步推理的问题并校验可解性。第三步合成保留格式但误读细节的错误痕迹。第四步由推理模型 Qwen3-Next-80B-Thinking 在认知触发词后延续思考并经校验保留正确结尾,与直接蒸馏长思考相比,该延续方式保留原始痕迹并追加聚焦的修正,避免冗长复述描述。在 Qwen2.5-Omni-7B 上经监督微调加直接偏好优化后,MMAU Test-mini 准确率从 71.5% 提升到 78.2%,结论适用于 30 秒内公开研究音频与同类问答基准,向更长录音与未覆盖领域的迁移只做小规模验证,原文披露训练使用单节点 8 块 NVIDIA H100,监督微调 5 轮、偏好优化 3 轮,未披露推理延迟与部署成本。
🔗 开源资源
第三方资源:https://jaeyeonkim99.github.io/llt → https://jaeyeonkim99.github.io/llt/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/QwenLM/Qwen2.5-Omni — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-Next-80B-A3B-Instruct — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-Next-80B-A3B-Thinking — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-Omni-30B-A3B-Captioner — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-VL-32B-Instruct — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-32B — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen2-Audio-7B-Instruct — 暂时无法访问
第三方资源:https://huggingface.co/Qwen/Qwen3-Omni-30B-A3B-Instruct — 暂时无法访问
第三方资源:https://github.com/SYSTRAN/faster-whisper — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. SpikeAid:把降噪和宽动态压缩一起学完的流式脉冲助听框架

评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xiang Hao:机构信息未能在本次解析中与作者逐人可靠绑定
- Xinyi Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Hanwen Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jibin Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Richard Hau Yue So:机构信息未能在本次解析中与作者逐人可靠绑定
- Kay Chen Tan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
助听器需要同时完成两件事:输入是目标语音与环境噪声的单通道混合波形,输出是经过降噪并按听力损失放大的波形,难点在于降噪会改变电平包络从而影响后级压缩,独立优化容易丢失弱语音或放大残留噪声。SpikeAid用因果端到端脉冲神经网络直接从含噪幅度谱出发,先由降噪子网估计互补的语音掩码与噪声掩码并构造两路分支表示。这两路表示交换上下文后进入压缩子网,分别估计非负的语音分支增益与噪声分支增益。两路增益融合为有效增益,再作用于含噪复数谱并经逆短时傅里叶变换重建波形。与已有脉冲去噪只重建干净语音不同,该框架的训练目标是源独立压缩后的语音加衰减后压缩噪声,损失只加在最终输出。与固定压缩级联相比,联合优化在助听任务上取得PESQ 2.214、STOI 0.8412、HASPI 0.4365;在Intel N-DNS基准上替换神经元后SI-SNR达到15.73 dB,超过原Spiking-FullSubNet的15.20 dB。结论适用于固定压缩参数和模拟评测,尚未验证个性化验配与真实佩戴。训练约需4卡100小时,FPGA实现相对CPU和GPU的能量效率分别提高约101.9倍和865.6倍。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. 给难读药名加上音素控制:会话式语音合成的发音改造

英文题目:Pronouncing Hard Words: Phoneme Adaptation of a Pretrained Conversational Text to Speech Model
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yashish M. Siriwardena:机构信息未能在本次解析中与作者逐人可靠绑定
- Dinesh K. Gnanasekaran:机构信息未能在本次解析中与作者逐人可靠绑定
- Tanmay Laud:机构信息未能在本次解析中与作者逐人可靠绑定
- Shinji Watanabe:机构信息未能在本次解析中与作者逐人可靠绑定
- Subhabrata Mukherjee:机构信息未能在本次解析中与作者逐人可靠绑定
- Shanil Puri:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音代理常把文本回复交给对话式语音合成模型朗读,模型需结合对话历史调整表达,但罕见药名的正确读法无法从拼写推断,读错会影响信任。论文从已完成训练的FireRedTTS-2出发,只改文本侧接口,不改声学编码器和解码结构,以保留对话条件与零样本克隆能力。第一步扩展词表,新增131个ARPAbet(美国英语音素标注集)音素及起止边界特殊字符,占据嵌入表空闲序号而无需改变模型尺寸,得到可读混合输入的分词器。第二步用该分词器做音素增强的持续监督微调,以一定概率把普通词整体替换为ARPAbet特殊字符,再与16码本声学帧交织,由主干预测首个声学码本、深度解码器补全其余码本并联合优化,训练全程不见药名。推理时把目标句的音素标注结果与前一轮由另一说话人朗读的孤立药名录音拼接,前者提供准确发音内容,后者作为对话上下文稳定声学实现,再生成目标载体句。与只接受音素输入的传统模型不同,该方法同时利用文字语义、音素控制和多轮声学条件。在7500条临床药名评测上,选用模型达到Gemini判定正确率90.7%,高于无音素增强的54.6%,人类盲听子集上为84%正确。结论只适用于已知难词且有精选参考录音的英语ARPAbet情形,未验证其他音素体系和主干模型。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://phoneme-adaptation.netlify.app/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. 把语音模型卷积前端换成两层小网络

英文题目:Toward a Universal Local Speech Feature Extractor Through Distillation
评分:7.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.5/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jessica Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Marcelo Beramendi Caballero:机构信息未能在本次解析中与作者逐人可靠绑定
- Ju-Chieh Chou:机构信息未能在本次解析中与作者逐人可靠绑定
- Karen Livescu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是自监督语音编码器开头的局部特征提取器,它把原始波形变成帧序列,再送入变换器。困难在于这组卷积的计算开销占比远高于其参数占比,而直接换成梅尔滤波器组特征又在部分任务上表现不稳定。处理过程是学习一个小型的通用波形前端,以教师模型的卷积加投影输出作为目标做蒸馏,训练后冻结并插入教师模型、未见过的模型或新预训练的模型。方法先让感知机模仿教师在相同感受野下的帧表示,再加线性投影对齐变换器维度,蒸馏损失同时约束数值距离和方向一致。相对已有工作,本文不压缩变换器,也不只为单个模型设计梅尔前端,而是学习一个可跨模型复用的波形输入前端。在SUPERB语音识别新模型预训练测试集上,使用多教师蒸馏前端从头预训练的wav2vec 2.0词错率为9.7%,低于使用原卷积前端从头预训练的同种模型的10.1%,词错率越低越好,该结论限于感受野400采样点、跳长320采样点的基座教师模型,更大模型和不同时间分辨率尚未验证。在NVIDIA RTX PRO 5000 Blackwell显卡实测的包含变换器的整体推理中,蒸馏前端乘加运算量仅为原卷积的约3%,整体推理时间减少超过20%,而原卷积曾占推理约33%的乘加运算,乘加运算越少越好。
🔗 开源资源
- 第三方资源:https://github.com/s3prl/s3prl/blob/main/s3prl/downstream/docs/superb.md — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. 在整段对话窗里为目标说话人提取声纹:SAC-WavLM 的做法与证据

英文题目:Learning Speaker-Activity-Conditioned WavLM Speaker Embeddings with Real Conversational Data
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Prachi Singh:机构信息未能在本次解析中与作者逐人可靠绑定
- Nguyen Hai Phong:机构信息未能在本次解析中与作者逐人可靠绑定
- Petr Pálka:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiangyu Han:机构信息未能在本次解析中与作者逐人可靠绑定
- Marc Delcroix:机构信息未能在本次解析中与作者逐人可靠绑定
- Shota Horiguchi:机构信息未能在本次解析中与作者逐人可靠绑定
- Naohiro Tawara:机构信息未能在本次解析中与作者逐人可靠绑定
- Lukáš Burget:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
长会议录音需把每句话归到说话人身份,常用做法是在重叠短窗内估计局部说话人活动,再用说话人嵌入把各窗局部身份串成全局身份。只截取干净语音的做法在目标大多处于重叠时会丢掉证据或混入干扰,难以得到可靠嵌入。论文提出说话人活动条件化WavLM-MHFA提取器SAC-WavLM,输入完整短窗波形与目标相关的活动掩码,输出对应目标说话人的嵌入向量。掩码逐帧标注静音、仅目标、仅非目标与重叠状态,在WavLM表征中按帧选择仿射变换参数,再经聚合后端汇总,微调时用干净语音平均得到的固定质心锚定原嵌入空间。与在仿真混合语音上从头训练引导嵌入不同,该方法保留预训练初始化并只增加轻量条件层,用少量真实会议数据微调,直接利用重叠与非重叠区中的目标证据。在使用DiariZen局部估计和SphereVBx聚类的7个数据集宏平均上,说话人混淆误差(SC)指标下SAC-WavLM为3.08%,低于基线WavLM-MHFA的3.65%,相对下降15.7%。结论适用于短窗局部判决固定且靠嵌入做跨窗链接的流程,局部活动估计错误大时提升会缩小;原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/nryant/dscore — 链接可访问(HTTP 200)
第三方资源:https://github.com/BUTSpeechFIT/DiariZen — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/JYP2024/WeSpeaker_SV_WavLM_MHFA — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 发音证据如何帮助大模型识别生僻词:PronCFT 解读
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yifan Xu:机构信息未能从 arXiv PDF 文本可靠映射
- Kaixun Huang:机构信息未能从 arXiv PDF 文本可靠映射
- Mengzhe Geng:机构信息未能从 arXiv PDF 文本可靠映射
- Mingyu Cui:机构信息未能从 arXiv PDF 文本可靠映射
- Shen Huang:机构信息未能从 arXiv PDF 文本可靠映射
- Shidong Shang:机构信息未能从 arXiv PDF 文本可靠映射
- Xunying Liu:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
基于大语言模型的语音识别以语音和文本提示为输入、输出转写文本,当遇到训练词表之外的词汇时,解码器容易输出发音相近的常见词。论文把困难归为两类,一类是模型没有学过未见词的声音到拼写的映射,另一类是模型偏好熟悉拼写而压制正确候选。上下文偏置会把候选词及其发音放入提示,但模型可能只因候选带有标注就提高其概率,并不核对发音内容。PronCFT(发音上下文微调)冻结音频编码器而微调大语言模型,要求模型先转写整句音素,再标出音素与哪个候选的发音相同,最后输出对应拼写,训练中还把候选拼写改写但保留发音,迫使模型比对声音。课程训练再逐步去掉音素转写和候选匹配等中间输出,使模型在只输出转写时仍保留已学的关联,避免中间错误传播并减少解码延迟。在从开源基准过滤合并的CMUdict未登录词测试集上,以OOV召回为指标,课程训练后的PronCFT-C为83.57%,高于基线Giga-SFT的59.89%。该结论只适用于论文构造的候选列表评测,并依赖音素内容正确,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. 只动残差与层选择:用极少参数适配冻结语音模型做说话人确认

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zezhong Jin:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaoyu Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhe Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Chong-Xin Gan:机构信息未能在本次解析中与作者逐人可靠绑定
- Siqing Qin:机构信息未能在本次解析中与作者逐人可靠绑定
- Man-Wai Mak:机构信息未能在本次解析中与作者逐人可靠绑定
- Kong Aik Lee:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
说话人验证(speaker verification)要把不定长注册语音和测试语音映射为固定向量,再比较相似度判定是否为同一人,大规模自监督语音模型能提供通用表示,但全量微调成本高,冻结编码器又限制了任务适配。本文冻结 WavLM,只训练极小适配参数和后端说话人编码器,输入为波形经卷积和 Transformer 层得到的逐层逐帧表示,输出为 192 维说话人向量。流形约束残差适配器(Manifold-Constrained Residual Adapter,MCRA)把每层残差隐状态按通道分成 N 组,用 Sinkhorn 归一化矩阵在组间交换信息,再用可学习门控在原始残差和混合残差之间插值。帧自适应层聚合(Frame-Adaptive Layer Aggregation,FALA)用一个跨所有语音共享的学习查询向量对每一帧计算各层权重,再加权求和得到该帧的聚合表示,送入 ECAPA-TDNN 得到说话人向量。与固定层加权求和的冻结 WavLM-Large 基线相比,MCRA-FALA 在 VoxCeleb1-O 上等错误率从 0.85% 降到 0.66%,相对下降 22.4%,WavLM 侧只训练 2,864 个参数。结论适用于英文 VoxCeleb 和中文 CN-Celeb 上的 ECAPA-TDNN 后端组合,CN-Celeb 上单模块曾出现退化,原文未说明训练硬件型号数量、训练时长和推理延迟。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. 边听边准备:Heartbeat Thinking 如何把听音时间变成可复用的工具调用

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zhenyu Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Kewei Fu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yongqi Tong:机构信息未能在本次解析中与作者逐人可靠绑定
- Chenzhi Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Wei Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiang-Ming Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jianshe Li:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是边听边准备的语音工具代理,困难在于用户说话期间部分转写不断更新,而完整工具调用需要参数齐全才能发出,若每次更新都打断生成,有效准备时间会被压缩。Heartbeat Thinking在聆听期间每隔固定时间启动一次思考者调用,每次读取最新部分转写和共享记录中已完成的推理与工具结果,形成增量判断。该判断分为无动作、仅推理或附带工具请求,推理记录与工具请求先写回共享记录,再异步派发工具调用,结果按调用标识回链到对应请求。后续思考者调用读取更新后的共享记录,区分已请求、待返回与已完成工作,避免重复发起同名同参调用,并利用已返回结果补齐缺失参数或发起依赖调用,使准备跨语音更新推进。语音活动检测触发交接时停止新建调用并取消未完成任务,回答者拿到完整转写和交接时刻已可用的快照,核对后复用匹配结果并补做剩余调用。在FDBench v3上,以DeepSeek-V4-Flash为回答者时,Heartbeat相对窗口式基线将推测工具覆盖率从34.67%提高到50.67%,平均最终回答延迟从6.90秒降到4.39秒。结论适用于函数调用、含口吃意图跟随和知识问答三类评测,但更高覆盖在另两个基准上没有带来质量提升,4.0%的FDBench录音还出现参数正确但引用过时结果的问题。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/datasets/FunAudioLLM/SpeechFCEval — 暂时无法访问
第三方资源:https://github.com/DanielLin94144/Full-Duplex-Bench/blob/main/LICENSE — 链接可访问(HTTP 200)
第三方资源:https://github.com/facebookresearch/CRAG/blob/main/LICENSE — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. 音频加歌词如何共同判断歌曲结构:SCALE 与 SheetSage-MSA 解读

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hongbing Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yaolong Ju:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一首完整录音怎样被切成首尾相接的段落,并为每段标出前奏、主歌、副歌等功能,难点是边界需要精确时刻而功能需要跨段的长程上下文,且精细标注很少。论文把SheetSage乐谱摘录整理成SheetSage-MSA,只保留有功能名和节拍对齐的摘录并映射到原录音时间轴,未标注区在训练时不计损失,共13,880段摘录来自9,010首歌、约82.5小时。音频侧冻结的MuQ给出30秒窗口局部表示和最长420秒全曲表示,边界通路门控融合两路表示后经双向Mamba比较边界前后内容、再用Transformer结合全局上下文输出边界概率,功能通路则拼接对齐表示、经带旋转位置编码的Transformer输出逐帧类别对数几率。歌词侧离线转写并分行,Longformer编码得到行与段表示并计算非相邻段之间的复现相似度,段级副歌对数几率经可学习校准映射到音频帧、只以残差加到副歌类上,精炼后的逐帧对数几率再按预测边界取段内平均选出功能名。相对共用一个编码器且只用音频的已有系统,差异是任务分离表示和显式歌词复现证据。在SongFormBench-HX的200首测试集上,SCALE的ACC为0.816、HR.5F为0.731、HR3F为0.822,分别高于SongFormer的0.807、0.696、0.780。结论适用于有歌声且歌词可转写的流行结构歌曲,在连续重复同功能段之间仍易漏检,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://multimodal-music-research-lab.github.io/SCALE/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/chrisdonahue/sheetsage-data/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/ASLP-lab/SongFormDB — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. 随问题给音频令牌打分再剪枝的 AudioScorer

英文题目:AudioScorer: Learning Question-Aware Token Relevance for Large Audio Language Models
评分:7.0/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.4/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Marwan Farag:Institute of Signal Processing;and System Theory (ISS);University of Stuttgart;Stuttgart, Germany
- Bin Yang:Institute of Signal Processing;and System Theory (ISS);University of Stuttgart;Stuttgart, Germany
📌 核心摘要
大音频语言模型需处理音频编码器输出的稠密token序列,长录音使解码器预填充计算上升,而当前问题往往只依赖其中一小部分。在固定保留预算下方法只将得分最高的音频token送入后续解码层,AudioScorer先用问题文本编码器表示用户问题,再让音频token通过交叉注意力读取问题并由打分头输出每个token的相关性分数,与依赖注意力、相似度或均匀采样的启发式修剪不同,该方法显式学习问题相关的排序。训练时用冻结大音频语言模型在参考答案上的对数似然对音频token嵌入求梯度,把梯度范数的排序转成软目标蒸馏给打分器,同时用加权音频序列上的答案负对数似然直接优化保留信息,推理时前端解码层仍处理全序列,之后按分数做硬Top-K保留。在Qwen2.5-Omni-3B、AudioMarathon、10%保留率下,语音内容类别未加权均值(自动语音识别用词准确率、其余用Macro-F1)AudioScorer为43.65,高于最强基线FastV的30.27。同样在Qwen2.5-Omni-3B、AudioMarathon、10%保留率下,自动语音识别词准确率AudioScorer为31.25%,高于最强基线HeadRouter的5.15%。同样在Qwen2.5-Omni-3B、AudioMarathon、10%保留率下,以各子任务自动语音识别词准确率或Macro-F1为指标,AudioScorer在10个语义和声学子任务中的7个上超过其他修剪方法取得最好或并列最好。结论适用于激进压缩下的语音和部分分类任务,不适用于音频真伪检测等对细粒度证据敏感的任务;原文披露在单张NVIDIA A6000上训练三个epoch约用9个GPU小时,打分器平均增加0.16 TFLOPs预填充计算。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. 在游戏电脑上本地评价二语英语发音:准确度、流利度和韵律
评分:7.0/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Richard Rose:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
要理解这项工作,需要先明确对象和困难:输入是二语英语学习者朗读固定英文段落的录音和对应的参考文本,输出是对每条录音在发音准确度、流利度和韵律三个维度上的 0 到 100 分,困难在于三个维度的声学线索重叠但评价目标不同,而且评分需要在普通消费级电脑上本地完成。系统先把整条录音转成单声道 16 kHz 输入,分别送入冻结的预训练语音编码器得到帧级表示,再用带掩码的时间均值和标准差汇聚成话语向量,同时用发音识别模型结合词典和参考音素序列算出 17 维发音诊断特征,最后把选定的向量送入对应维度的加权岭回归得到分数。发音准确度采用 XEUS 加 PhoneticXeus 加音素诊断特征,流利度与韵律采用 XLS-R 加 XEUS,不同维度可以用不同训练语料组合。与已有神经评估方法的差异在于不微调任何预训练权重,只学习线性映射,并按维度分别选择表示组合与训练语料。在 305 条独立录音上,混合语料族 aesopocean 的韵律斯皮尔曼相关系数达到 0.881,高于存档 Azure 输出的 0.737,也高于两人共识的人际基线 0.807,但其二次加权 kappa 为 0.541,低于人际基线的 0.742,说明排序占优不等于数值刻度一致。结论只适用于受试的段落、设备条件和评分尺度,120 秒时长限制和大内存占用是已报告的部署代价,单次 120 秒容量测试在 CPU 上约用 169 秒,峰值进程内存约 22.52 GiB。
🔗 开源资源
代码相关资源:https://github.com/cburst/oollim — 链接可访问(HTTP 200)
模型相关资源:https://github.com/cburst/oollim — 链接可访问(HTTP 200)
复现相关资源:https://github.com/cburst/oollim — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
20. 移动声源下的人体反应动作:MOMO 如何听声辨位再生成动作

评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Deli Cai:机构信息未能在本次解析中与作者逐人可靠绑定
- Shuyang Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhiyang Dou:机构信息未能在本次解析中与作者逐人可靠绑定
- Zitong Lan:机构信息未能在本次解析中与作者逐人可靠绑定
- Mingmin Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Changxing Ding:机构信息未能在本次解析中与作者逐人可靠绑定
- Taku Komura:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
研究对象是人听到移动声源后作出的全身反应。难点在于同一段声音因声源相对听者的方向和运动不同会引发不同动作,而已有音乐到舞蹈、语音到手势以及静态空间音频方法不处理声源运动。原文输入为 10 秒双耳音频,采样率 48000 Hz,输出为 300 帧、30 FPS、272 维的 SMPL-X(人体参数化模型,SMPL-X)动作序列,并附带敏感或不敏感的反应类别标签。处理链路是定位与理解并行提取条件,再送入生成模块:定位分支从原始双耳音频估计头部坐标系下的声源方向向量序列,理解分支将双耳平均为单声道后用冻结的预训练 CLAP(对比语言音频预训练模型,CLAP)编码器提取逐帧内容特征,生成分支用条件扩散模型从高斯噪声逐步去噪为动作。与 MOSPA(静态空间音频驱动动作方法,MOSPA)需要真实世界坐标系声源绝对位置不同,MOMO 只用音频估计的方向,更接近只能听到声音的具身设定。在 DySAM 测试集上,MOMO 的 R-precision Top1 为 0.623,FID(生成动作与真实动作的特征分布差异指标,参考集为 DySAM 测试集真实动作,FID)为 0.857,优于 MOSPA 的 0.585 和 5.160,skating ratio(脚部滑动帧占比,越低越好)为 1.66%,接近真实动作的 1.26%。结论适用于室内混响下单移动声源的 10 秒反应生成,多声源、室外和长时交互尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://cdlchoi.github.io/projects/MOMO → https://cdlchoi.github.io/projects/MOMO/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. MM-LeJEPA:为共享内容设计相关高斯联合嵌入目标

评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Haowen Bai:机构信息未能在本次解析中与作者逐人可靠绑定
- Rui Gong$:机构信息未能在本次解析中与作者逐人可靠绑定
- Meichen Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ming-Xuan Weng:机构信息未能在本次解析中与作者逐人可靠绑定
- Bihan Wen:机构信息未能在本次解析中与作者逐人可靠绑定
- Kim-Hui Yap:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
待设计对象是音频嵌入与视频嵌入拼接而成的联合嵌入分布,难点是两侧编码器可能观测同一事件,直接套用各向同性高斯会惩罚共享内容诱导的跨模态相关。每个音频视频样本先产生一个联合编码的全局嵌入和多个局部嵌入,每个局部嵌入对应一个音频窗或视频帧,局部预测全局的均方误差负责保留内容。论文把任务梯度二阶矩写成读取独立信息的分量与读取同一共享内容的分量的加权组合,由此得到加权Fisher信息泛函。在总方差固定的约束下求该泛函最小值,得到每模态内部各向同性、跨模态按系数ρ相关的高斯目标,其输出即为期望的联合分布形状。再用固定白化变换把该相关目标转为标准高斯,对全局嵌入和局部嵌入沿用SIGReg约束,并与局部到全局预测按权重组合成两项目标。与已有音频视频自监督方法相比,差异是不用掩码重构解码器、对比负样本、动量教师或自训练,只增加一个目标相关超参数。在VGGSound注意力探测中音频视频联合top-1准确率为48.6%,高于表中同条件最强基线的46.3%,适用范围限于音频视频分类、探测与微调,未验证检测、定位或生成,也未报告训练、推理或部署代价。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
22. Modaliff:用统一令牌序列做文本图像音频互转

英文题目:Modaliff: A Unified Token Diffusion Model for Any-to-Any Generation
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Duc Kieu:机构信息未能在本次解析中与作者逐人可靠绑定
- Kien Do:机构信息未能在本次解析中与作者逐人可靠绑定
- Minh Khoa Le:机构信息未能在本次解析中与作者逐人可靠绑定
- Tung Kieu:机构信息未能在本次解析中与作者逐人可靠绑定
- Dang Nguyen:机构信息未能在本次解析中与作者逐人可靠绑定
- Thin Nguyen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是在文本、图像、音频之间自由转换的单个生成模型,困难在于三种信号结构不同且完整对齐的三元组稀缺,处理过程是把条件与目标的原生隐序列拼成统一序列并由同一去噪器去噪。冻结的对比编码器先把各模态映射为原生隐序列,拼接后的统一序列直接作为去噪器的输入,保留各自结构而不压缩到共享向量空间。每个词元随即标注角色、模态与噪声水平并经词元级自适应归一化注入去噪器,基于角色的位置编码让条件段保留内部结构而目标查询把条件看作无序集合,该标注序列控制同一去噪器的逐词元计算。去噪器以对偶训练同时学习两个方向的干净隐变量预测,其输出的干净隐变量再交由冻结解码器生成,缺失图像音频对时用文本为中介构造一致性目标,多条件则在推理时组合单条件预测或用联合描述微调。与OmniFlow相比,Modaliff在文本到图像任务的MSCOCO评测上以生成图像与参考样本的特征分布差异指标(FID,越低越好)13.77对23.84取得更优保真度。该结论适用于以对比编码器隐变量为中介且解码器冻结的设置,单图难以表现语音或鸣叫等瞬态声音,多条件组合仍需权衡权重。原文披露去噪器含558M可训练参数并在单卡H100上训练至多50万步,未披露完整推理延迟与部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
23. EvalRx:从发现失败到可审计修复的智能体诊断流程

英文题目:EvalRx: Agentic Diagnosis and Verified Repair of Foundation Models
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Jiaqi Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruinan Jin:机构信息未能在本次解析中与作者逐人可靠绑定
- Yitong Tang:机构信息未能在本次解析中与作者逐人可靠绑定
- Beidi Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Gexin Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiong Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaoxiao Li:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是已经能作答的基础模型在特定条件下反复出错的行为,困难在于平均分只能提示存在失败,不能指出哪类样本集中出错、对应什么可操作的机制,以及改动是否真正泛化。处理过程是把固定评测集的逐样本对错变成可检验的诊断,再把得到支持的诊断变成限定层级的修复,并用未改动模型作对照决定是否保留修复。探测阶段把文本、图像、音频输入连同模型回答转成逐样本信号表,探索分析阶段检验信号与失败的关联并做多重性校正,诊断阶段把观察写成包含切片谓词、预期方向和检验方法的冻结合同,验证阶段按合同执行并区分支持、反驳与无法定论,修复阶段从侵入性最小的层级开始搜索并在密封确认集上做配对比较。相对已有工作,本文的差异在于不把发现的模式直接当作结论,也不把候选修复直接当作进步,而是要求诊断与修复各自通过预先冻结的统计门控,并保留版本谱系与停止原因。在语言轨道上使用 Claude Code 加 Opus-5 作编排智能体时,16 个模型与任务组合中有 14 个准确率提高,平均提高 4.7 个百分点。原文未披露训练、推理或部署成本。结论适用于文内冻结的评测集、服务配置与非参数修复上限,跨分布泛化与持续多轮累积改进尚未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
24. 用少量可训练参数适配大模型来预测全脑 fMRI

英文题目:Scaling Parameter-Efficient Fine-Tuning for Brain Encoding
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zhuofan Josh Ying:机构信息未能在本次解析中与作者逐人可靠绑定
- Guanglong Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Nolan Ho:机构信息未能在本次解析中与作者逐人可靠绑定
- Kieran Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Rui Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Andrew Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Nikolaus Kriegeskorte:机构信息未能在本次解析中与作者逐人可靠绑定
- Pony Ma:机构信息未能在本次解析中与作者逐人可靠绑定
- Hossein Adeli:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
研究对象是给定自然影视刺激预测全脑功能磁共振响应的编码模型,困难在于神经数据稀缺而现代多模态骨干庞大,直接训练或全量微调容易过拟合且计算昂贵。方法分三步衔接:先将影视片段一次送入冻结的预训练多模态骨干,利用其因果结构单次前向给出长窗口内全部时刻特征;再用低秩适配器调整骨干内部表示,其输出直接送入轻量跨注意力读出映射为千分区响应;最后用批量多适配器内核让多个适配器共享同一骨干并行训练以组成集成。低秩适配器即Low-Rank Adaptation,LoRA,把权重改变量表示为两个小矩阵乘积,初始化为零因而起始等同冻结模型。相对冻结骨干加大型读出的已有最佳方法,关键差异是把神经信号用于调整骨干内部表示而非只训练读出。在Friends第六季验证窗上以相同冻结MIRAGE读出评价,单次前向加LoRA在60秒前置时准确率为0.3247,高于其所针对滑动窗口协议的0.3187。在同一331片段语料和单块A800-80GB测量下,单模型训练与特征抽取端到端共8.5 GPU小时,低于滑动窗口基线的702.5 GPU小时,其中适配器训练为4.84 GPU小时,特征抽取为1.99 GPU小时,低于基线的700.6 GPU小时。结论适用于叙事影视刺激的全脑分区预测,跨被试与跨数据集迁移已有初步证据。
🔗 开源资源
- 第三方资源:https://github.com/zfying/brain-lora — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
25. UniAVC:用分阶段训练与不对称调度统一音视频生成与编辑

英文题目:UniAVC: Unified Audio-Video Creation via Progressive Training and Asymmetric Scheduling
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kien T. Pham:HKUST
- Yuhao Liu:Huawei Research
- Chong Hou Choi:Huawei Research
- Zhenqi He:HKUST
- Yanghao Wang:HKUST
- Chenyang Lei:Huawei Research
- Rui Liu:Huawei Research
- Qifeng Chen:HKUST
- Long Chen:HKUST
📌 核心摘要
研究对象是一个文本条件加上一对视频潜变量和音频潜变量的生成与改写,难点是配对编辑监督稀少,且视频稠密、音频稀疏导致理想去噪节奏不同,共享噪声水平只走二维噪声空间对角线,见不到以干净一支约束另一支的非对角状态。UniAVC先在单模态语料上让视频分支和音频分支各自学会生成与编辑,再冻结双分支,只用配对数据训练连接两分支的桥接模块,把稀缺配对监督留给跨模态耦合。单模态预训练中视频分支见到34.3M样本、音频分支见到54.9M样本,而对齐微调仅消耗0.67M配对样本,不足单模态预训练总量的1%。训练与推理共用一个步骤计数,计数经两条变形曲线映射为视频噪声水平与音频噪声水平,音频始终更低而先收敛,并为视频提供渐变干净的跨模态条件,另用一支固定干净且屏蔽损失的子任务补足连续曲线到不了的边界状态。推理时可将保留模态固定为干净潜变量而只对目标模态去噪,也可保留首轮满意分支并对另一分支加噪到中间水平再去噪。在VGGSound测试集视频转音频评测上,FAD指标UniAVC为10.12,低于MMAudio的17.09,非同步时长DeSync为0.650,亦低于MMAudio的0.813。结论适用于所报告的联合与跨模态基准,训练与推理成本较高,自修复需第二遍去噪,原文未披露设备、批量大小与时长。
🔗 开源资源
- 第三方资源:https://hkust-longgroup.github.io/UniAVC → https://hkust-longgroup.github.io/UniAVC/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
26. Fluxion:把可微滤波器训练与实时音频部署装进同一个 DSP 运行时

英文题目:Fluxion: A Differentiable DSP Runtime from Training GPU to Real-Time Edge
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Matteo Spanio:机构信息未能在本次解析中与作者逐人可靠绑定
- Antonio Rodà:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一串随时间递推的音频滤波器,困难在于训练时需要对很长的递推求梯度,播放时又要在固定时间内算完一个音频块且不能在音频线程申请内存。论文的输入是用户用串联、并联、反馈和命名节点写成的函数式图,输出一端是可训练的张量计算,另一端是可在嵌入式设备上逐块运行的冻结参数。处理过程是同一张图经过一次遍历解释到不同后端,训练后端把手推的伴随递推作为一个算子节点接入已有自动微分框架,实时后端使用预分配的暂存和无锁队列接收系数。中间有一个冻结步骤,把双精度(f64)设计的系数转为单精度(f32),计算极点半径和小增益并给出稳定、临界或不稳定 verdict,再存成带版本号的.fxg文件。相对已有方法,关键差异是伴随公式、稳定性检查与部署文件都留在运行库内部,而不是寄生在 PyTorch 解释器上。可核对的关键定量结果是,在16384×4096、8阶的常驻显存前向任务中,Fluxion吞吐量达到2990 Msamples/s,高于TorchFX的1580 Msamples/s、torchaudio的1468 Msamples/s和GRAFX精确后端的1321 Msamples/s。结论适用于级联二阶节、有限脉冲响应滤波器和延迟线效果,反馈回路、Metal与ROCm硬件、多节可训练级联的图形处理器(GPU)训练尚未验证。原文披露的部署成本是剥离后命令行工具文件大小在x86-64为3.2 MB、高于ARM64的2.8 MB,处理10 s音频的耗时在工作站为20 ms、低于树莓派5的46 ms。
🔗 开源资源
第三方资源:https://github.com/matteospanio/fluxion — 链接可访问(HTTP 200)
第三方资源:https://www.soundfood.it/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
27. 有限机会日历上的 UWB 音频准时交付:准入判定与截止期剪枝

英文题目:Finite-Calendar Admission and Deadline-Aware Pruning for UWB Audio
评分:6.5/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Fengyun~Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是超宽带链路上的多路等时音频流,每路周期产生一个需要分片发送的服务数据单元(Service Data Unit,SDU),只有在呈现截止时间前收齐全部分片才算可用。困难在于可用发送机会是离散且成簇的,帧可能在机会间隙到达,分片需要多次尝试,平均速率够用不代表每个截止窗口内都有足够机会。论文先把呈现预算换算成每个任务在机会日历上的合格区间,再判断有限任务集能否预留足够的尝试次数,运行时对注定无法收齐的SDU提前丢弃以节省机会。相对已有工作,论文区分了保守预留保证和在线挽救启发式,前者用最早截止时间优先(Earliest-Deadline-First,EDF)构造证明可行性,后者用乐观不可能检测做剪枝。在同一UWB机会日历与配对信道轨迹的8流突发损失仿真中,以准时完整SDU比例为指标,剪枝EDF相对到期感知先进先出/无剪枝EDF从45.441%提高到59.399%,12个配对种子的差值为13.958个百分点,点式95%区间半宽为2.080个百分点。结论只适用于等长可自由分配机会和已知有限任务等假设,重载时最差分流交付接近于零,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
28. Tomori:在 REAPER 里写代码做混音的智能体如何被评测

英文题目:TOMORI: A Tool-Orchestrated Mixing Operator for REAPER Interaction
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yining Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tianjiao Li:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
混音任务的输入是混音前REAPER工程与一句自然语言请求,输出是可编辑工程与渲染音频,难点是抽象请求只描述想要的声音而不指明操作对象与参数。Tomori先用检查插件把轨道、路由、效果链和参数读成文本交给语言模型,使其获得可操作状态。模型可调用测量程序获得频带能量等文本数值,再生成Lua代码执行插入效果、调参、改路由或自动化,并根据执行状态与工程回读决定是否继续修改,形成检查与测量输入、代码编辑输出、回读再决策的循环。Tomori-Bench把110个人工审核的参考编辑各配成IF0数值增量、IF1近似方向、IF2听感描述三种指令,用Graph F1与参数误差度量工程变化,用渲染音频与参考的接近程度度量声音变化。在三模型共990例的主评测中,deepseek-v4-pro的Error reduction(MR-STFT误差去除率)从IF0的85.3%降至IF2的32.0%,Graph F1从1.0000降至0.7726,显示可执行控制与实现听感目标存在差距。同例消融中完整工作流比单次提交在IF0上将参数匹配率从72.1%提升至97.7%、Error reduction从61.3%提升至85.4%,而28例强制测量虽全部成功执行却无明确总体提升且平均工具调用从11.0增至18.9。上述结论仅适用于所覆盖的均衡、增益等110步任务的最终有效交付,抽象指令下易出现额外加工与幅度偏离,子集比较不构成通用排名。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
29. MS-Bench:按条件分层的多说话人语音识别评测

英文题目:MS-Bench: A Condition-Stratified Multi-Speaker ASR Benchmark
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Chunjiang He:机构信息未能在本次解析中与作者逐人可靠绑定
- Zheng Zi:机构信息未能在本次解析中与作者逐人可靠绑定
- Bingshen Mu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yurun Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Jingyi Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhonghua Fu:机构信息未能在本次解析中与作者逐人可靠绑定
- Lei Xie:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
多说话人自动语音识别的输入是包含两人以上的连续录音,输出是每句话的文字、说话人编号和起止时间,难点在于重叠语音互相遮蔽、相似音色容易混淆、轮次切换快以及声学环境多变。已有评测多按会议或对话数据集报告平均分,难以说明系统在哪种条件下失效。MS-Bench先从公开和内部来源收集录音并按说话人交互、声学条件和录制元数据标注说话人数、重叠率、说话人相似度、轮次间隔和声学质量五个维度条件,再按条件覆盖、多难条件共现、条件多样性和来源多样性筛选子集,最后用说话人分离标注错误率、排列词错率和时间受限排列词错率评估系统。重叠等分析把录音来源、声学环境和输入切分固定在同一推理单元内比较,关键差异是从按数据集评价转向按条件分层评价,并把词错率分解为词汇误差和切分误差、把归属误差单独计算。在32.72小时MS-Bench上以推理单元为评分单位的总体评估中,MOSS-Transcribe-Diarize-Pro的WER为22.49%,低于MOSS-Transcribe-Diarize的25.02%,但仍有15个推理单元因接口或时间戳无效被排除。在MS-Bench上保留同时含无重叠与重度重叠话语的同一推理单元内比较时,重度重叠话语的指标词汇误差Elex比无重叠话语高27.2-38.6 pp,说明鸡尾酒会式场景仍不可靠。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://aslp-lab.github.io/MS-Bench/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
30. VISAGENT:把 114 热线从按键菜单变成能派单的语音智能体网

英文题目:VISAGENT: An Agent-Based End-to-End Voice Interaction System
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Xiang Wang:Data Science & Artificial Intelligence Research Institute, China Unicom;Unicom Data Intelligence, China Unicom
- Zhaoxiang Liu:Data Science & Artificial Intelligence Research Institute, China Unicom;Unicom Data Intelligence, China Unicom
- Xiang Chen:Data Science & Artificial Intelligence Research Institute, China Unicom;Unicom Data Intelligence, China Unicom
- Liqiang He:Data Science & Artificial Intelligence Research Institute, China Unicom;Unicom Data Intelligence, China Unicom
- Kai Wang:Data Science & Artificial Intelligence Research Institute, China Unicom;Unicom Data Intelligence, China Unicom
- Shiguo Lian:Data Science & Artificial Intelligence Research Institute, China Unicom;Unicom Data Intelligence, China Unicom
📌 核心摘要
读者需要理解的对象是 114 这类公共语音热线,输入是用户来电语音,输出是对话答复或由领域服务完成的交易结果,困难在于菜单僵硬、服务分散、第三方能力难以统一接入。语音对话系统(承担口语理解与应答的系统)先提供可打断的语音交谈,轻量一级路由器判断请求应留在通用对话还是进入某个服务领域,进入领域后再由基于大语言模型(大语言模型,LLM)的二级选择器在该领域注册代理中挑选执行者,用户记忆(跨轮复用的偏好与上下文)同时辅助选择与执行。注册机制把文本接口的任务代理包装成有描述、可调用函数和合成声音的会话实体,从而支持动态上架。与固定多智能体协作不同,本文把选择看作开放市场的服务发现,平台只做发现与上下文传递,业务逻辑留在提供方。URO-Bench 中文子集上 14B 语音交互模型在基础轨平均 71.547 分、专业轨平均 66.510 分,均高于对比模型;319 个代理时两级路由在 100 条查询上保持 100% 准确且延迟低于 1 秒,而单级路由准确率为 98% 到 99% 且延迟升至 8 秒到 10 秒。结论适用于已注册领域和中文热线场景,记忆效果、更大规模市场与执行成功率尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
31. 新词没有语音也能做好初始化:SEAM 如何拼出低资源 TTS 的词向量

英文题目:SEAM: Spectral Embedding Alignment and Merging for Low-Resource TTS
评分:6.5/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Walaa Othman:ITMO University;SPC RAS
- Baher Mohammad:ITMO University;MWS AI
- Stamatios Lefkimmiatis:ITMO University;MWS AI
- Ammar Ali:ITMO University;MWS AI
📌 核心摘要
读者需要理解的对象是条件式文本到语音模型新增词条的向量表示,困难在于低资源语言缺少配对音频,随机初始化会让早期微调偏离已学好的条件分布。SEAM先在旧词表内部构造自监督对:把可拆分词条按原BPE拆成子词条序列,把子词条嵌入序列作离散信号低通滤波后拼实部虚部得到谱特征,以原词条嵌入为目标用岭回归求线性映射的闭式解。嵌入新词条时先经转写表转为英语国际音标串,再拆成旧词表中的子词条,把所得序列的谱特征送入已学映射得到单个条件向量并按原嵌入平均范数归一化,该向量直接作为微调起点。与取平均值等忽略顺序的合并方式相比,该方法保留离散傅里叶变换相位信息,在俄语5小时消融中字符错误率(Character Error Rate,CER,越低越好)原始为14.88%,反转顺序后为19.67%,随机打乱后为22.91%。在Chatterbox骨干、固定100句测试集与相同优化调度的俄语25小时微调下,SEAM的CER为8.50%,低于平均值初始化的10.72%和随机初始化的17.66%。该结论仅在俄、哈、法三语5至100小时、主实验新增200词并至多测至1000词范围内验证,俄语100小时下SEAM的CER为7.68%,与随机初始化的7.62%趋于接近而优势消失,哈萨克语5小时到25小时波动源于训练测试词重叠差异,更大词表与更多架构尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
32. 去掉声音后文字还能认出谁在说话吗:SPARC 评测解读

评分:6.4/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Efthymios Tsaprazlis:机构信息未能在本次解析中与作者逐人可靠绑定
- Bowen Yi:机构信息未能在本次解析中与作者逐人可靠绑定
- Tiantian Feng:机构信息未能在本次解析中与作者逐人可靠绑定
- Junghwan Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- David Jurgens:机构信息未能在本次解析中与作者逐人可靠绑定
- Shrikanth Narayanan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是去掉声音之后的播客转写文本,困难在于判断仅凭用词、句法和谈话习惯能否把匿名文本与已知说话人联系起来,以及能否顺带核对性别、年龄和口音标签。论文把这个问题写成成对验证,输入是待查的探针文本和一组注册文本,输出是两者是否来自同一说话人或是否共享同一属性标签的分数。处理过程沿一条样本链展开,单说话人语音先经过信噪比与音乐过滤和双自动语音识别一致性筛选,再由转写文本构造探针与注册对,最后交给嵌入相似度或提示大语言模型打分。两个来源语料共覆盖12,509名说话人和约1.5M条筛选后话语,评估在同播客内与跨播客两种话题代理条件下进行,以检验模型依赖的是说话人风格还是共享语境。在跨集身份验证中,GPT-5-mini与Llama-3.3-70B在NaturalVoices上达到0.285与0.281的等错误率(Equal Error Rate,EER),低于SentenceBERT的0.351,数值越低表示区分越好。结论的适用范围限于英文播客、较干净的单说话人片段和二值化粗粒度属性划分,属性结果只度量与代理标签的一致性,年龄标签一致性接近随机,缩短探针只能减弱而不能消除泄露。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/bowenyi-pierre/SPARC — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/timtsapras23/SPARC — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
33. 口哨和唱错词也能找歌吗:合成查询为何救不了真实口哨检索

英文题目:Whistle and Wrong Lyrics: Synthetic Queries Are Not Enough for Real-World Query-by-Melody
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Luigi Rivolta:Independent Researcher
📌 核心摘要
读者需要理解的对象是从记忆中的旋律找到录音,输入是哼唱、口哨或记错歌词的演唱,输出是歌曲身份,困难在于音色、歌词、调性、速度都不同而旋律近似,口哨接近纯音且高约三个八度并压缩音程,错词演唱则引入清浊变化和辅音断裂。系统先用音高跟踪器得到基频轨迹,人声用RMVPE而口哨用谱峰跟踪器,再做中值去调性并送入约520万参数轮廓编码器得到256维向量,检索时取查询与每首歌多个8秒窗口的最佳匹配。训练用真实歌曲人声旋律渲染出口哨音频和无意义音节演唱音频,再用真实查询会用的跟踪器重新跟踪,使训练轮廓带有跟踪误差。相对已有哼唱检索,新增的是口哨专用谱峰跟踪器和锁定到真实旋律的渲染加再跟踪流程。在11,050首歌库的合成保留查询评测中,物理渲染训练使口哨前1准确率从基线E2b的0.180升至0.251,错词演唱前1准确率从0.193升至0.264。但在339个真实口哨对他人哼唱的8首封闭集评测中,合成训练模型D-042前1准确率为0.619共210个正确,低于基线E2b的0.631共214个正确,合成增益没有迁移。结论只适用于已知歌曲小封闭集和业余演唱者条件,开放歌曲泛化尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/luiginotmario/hum2song — 链接可访问(HTTP 200)
第三方资源:https://github.com/ASLP-lab/YingMusic-Singer-Plus — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
34. 把十步声学采样压成一步:MixiSpeech 的渐进状态蒸馏
英文题目:MixiSpeech: Progressive State Distillation for One-Step Vietnamese TTS
评分:6.3/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tran Quoc Bao Le:机构信息未能从 arXiv PDF 文本可靠映射
- Binh Mai:机构信息未能从 arXiv PDF 文本可靠映射
- Hung Dinh:机构信息未能从 arXiv PDF 文本可靠映射
- Lam Nguyen:机构信息未能从 arXiv PDF 文本可靠映射
- Cong Tran:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
读者需要理解的对象是从文本和说话人条件生成梅尔频谱图的条件流语音合成器,困难在于把10次向量场积分压缩到1次更新时误差增大,输入是音素序列、声学掩码和64维说话人嵌入的条件组合。基础教师在PhoAudiobook训练集上从零训练,保留文本、时长、声学与说话人条件通路,输出80频带梅尔频谱供声码器合成波形。蒸馏按10→4→2→1序列降低全局采样预算,每阶段冻结教师用局部多步积分产生区间终点作为目标,学生继承教师参数并以更少更新拟合该终点且保留原有语言和说话人条件接口。前一阶段得到的4步、2步蒸馏学生依次转为下一阶段的冻结教师,最终1步学生只在有效帧的80个梅尔频带上算均方误差且教师终点从计算图分离。在100组共享测试文本-说话人对上,蒸馏单步模型以1次声学向量场求值得到UTMOS22-Strong 2.2678、词错率4.63%和字错率2.83%,相比同为1次求值的直接单步采样的1.6846、6.21%和3.71%,前者评分更高、两项错率更低。在相同100组共享测试文本-说话人对上,蒸馏单步模型的UTMOS22-Strong、词错率和字错率与10步教师的2.2923、4.65%和2.72%接近,分别低0.0245、低0.02个百分点和高0.11个百分点。在22名听众每系统每属性176个评分的盲听中,蒸馏单步模型的总体均值4.61高于直接单步采样的4.04,接近10步教师的4.66。结论限于100条PhoAudiobook测试文本和库内710个说话人的随机搭配,未验证未见说话人、长文本或代码混合输入,在同一RTX 5090上平均端到端推理时间指标从10步教师的0.0662 s降到蒸馏单步模型的0.0312 s,对应2.12倍实测加速。
🔗 开源资源
第三方资源:https://mixispeech.solanai.us/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/tarepan/SpeechMOS — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
35. 当文字和声音打架时,音频大模型听谁的
英文题目:Text Dominance in Paralinguistic Conflict: Tracing Suppression Through Audio LLM Circuits
评分:6.3/10 | 创新 1.4/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ankur Banerjee:机构信息未能从 arXiv PDF 文本可靠映射
- Vishnu Guntakala:机构信息未能从 arXiv PDF 文本可靠映射
- Danity Pike:机构信息未能从 arXiv PDF 文本可靠映射
- Advay Roongta:机构信息未能从 arXiv PDF 文本可靠映射
- Kevin Yang:机构信息未能从 arXiv PDF 文本可靠映射
- Ruizhe Li:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
读者需要理解的对象是音频大模型在文字与声音矛盾时更相信哪一路证据,困难在于跟随文字可能来自听不见,也可能来自听见了却不用,处理要求先筛查音频单模态能力,再定位信息保留位置与使用路径,最后做定向干预。论文构建3594条副语言冲突基准,覆盖情感韵律、说话人身份与讽刺语速,让文本声称与真实音频矛盾。机理部分选文本主导最强且通过筛查的Qwen2-Audio-7B-Instruct,用线性探针检验说话人性别等信息是否可线性解码,用归因补丁估计文本与音频通路贡献,再试回贴增强音频与注意力阻断削弱文本。相对已有词汇冲突研究的关键差异是音频增强无效而文本中继阻断有效,意义是把修复目标从提高音频显著性转向切断文本在中间token的反复转写。在LISTEN式冲突条件不匹配条目上,六个音频大模型的平均文本主导率为0.78,排除讽刺后该指标高于包含时为0.86。在自由生成评测设置下,中间层阻断文本声称的生成文本主导率gen-TDR低于基线,韵律从1.000降到0.375,身份从1.000降到0.433,匹配条目能力基本保留。结论只适用于通过音频单模态筛查的模型与所测两类冲突,不适用于封闭式多选评分与讽刺类未定标签。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
36. 电话信道下的阿姆哈拉语识别:TeleASR-Amharic 基准如何测鲁棒性

英文题目:TeleASR-Amharic: A Benchmark for Robust Amharic ASR in Realistic Telecommunication Conditions
评分:6.2/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.6/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Dagnachew Mekonnen Marilign:HiLCoE School of Computer Science and Technology
- Enrique Molero:GSMA
- Abrham Haile:gheero
- Louis Powell:GSMA
- Israel Abebe Azime:Saarland University
📌 核心摘要
读者需要理解的对象是电信客服场景下的阿姆哈拉语语音识别,输入为经过手机采集和网络传输后的语音,输出为包含电话号码、账户标识、余额、日期和交易金额等数字信息的文字。困难在于窄带限制、采样率降低、动态范围压缩、非线性失真、背景噪声、50 Hz 电源干扰和时域信号丢失会同时改变语音频谱和时间结构,而已有语料多为干净朗读。处理过程是先检查 Ethio Telecom 内部录音的窄带、低码率编解码和异构移动网络特征及数字混写问题,再收集客服对话、短信支持用例、常见问题和坐席培训材料并生成 10 轮用户与坐席对话,经人工录音和质检得到干净语音,最后用固定或随机退化流水线生成评测语音并送入语音识别模型评分。基准构建负责提供 15965 条共 30.63 小时的客服对话语音及其平行退化版本,退化建模负责复现环境、设备和电信信道共 7 条流水线,鲁棒训练负责合并 191431 条共 1115.0 小时外部语料并加入电信感知增强后继续微调。相对已有干净语料评测,关键差异是保持说话人和文本不变而只改变退化类型和严重程度,并同时报告固定信道和随机信道分布下的结果。在窄带 2G 加丢包条件下,全量数据加 10% 增强的微调模型相对 Ethio-ASR-Amharic 基线将词错率从 0.794 降到 0.607,相对降低 23.6%,指标越低越好。结论适用于合成的电信退化条件,尚未在真实通话编解码和更大方言范围内验证。训练和评测使用单块 80 GB 显存的 NVIDIA A100,原文未报告训练时长、推理延迟和部署成本。
🔗 开源资源
第三方资源:https://gheero.et/ — 暂时无法访问
第三方资源:https://huggingface.co/datasets/Ibtihal02/amharic-commonvoice-asr — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/leyu-amharic — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
37. 已知来源不均衡下的音视频伪造检测:共享与私有分流如何分工
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Qiwu Wen:机构信息未能在本次解析中与作者逐人可靠绑定
- Jahangir Alam:Luqia Technologies;405 Ogilvy Ave., Suite 101;Montréal, Québec H3N 1M3, Canada
📌 核心摘要
读者需要理解的对象是同时包含声音与人脸视频的输入,输出是对整段视频为真或为假的二分类,假的定义是音频流、视觉流或两者任一被篡改。困难在于两个来源的伪造线索分布不同,FakeAVCeleb偏重按模态划分的伪造类型,LAV-DF偏重局部时间语义篡改与同步异常,训练样本量不均衡时单一共享路径容易偏向多数源。音频先提取26维对数滤波器组特征并按四帧堆叠成104维后经线性层映射为256维词元,视频经WTConv/Res2Net-CBAM前端编码为256维词元,两类词元对齐到相同序列长度并各自拼接可学习的[CLS]词元。对齐后的音视频词元在进入首个多尺度跨模态变换器编码器(MSCT)区块前按来源标识路由,一路进入跨源共享流,一路进入对应来源的私有流,两条流各自保留多尺度自注意力、差分跨模态注意力和前馈运算做跨模态差异建模。共享流输出的[CLS]级共享表示与所选私有流的[CLS]级私有表示送入门控残差融合模块,共享的门控网络结合有界来源调制系数控制注入强度,将私有证据以残差形式注入共享表示并由融合分支给出主预测。相对已有方法MSCT的关键差异是差异建模发生在路由之后的两条独立路径,而不是所有样本共用同一差分注意力算子。在FakeAVCeleb与LAV-DF构成的1:9采样协议下,融合分支的宏平均AUC(两个来源AUC的算术平均)为0.9664,高于MSCT基线的0.9342,来源间差距也有所缩小。结论只适用于来源标识已知且仅有两个来源的受控组合,推理依赖正确来源标识,原文未说明训练设备型号与时长及推理部署代价。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
38. 电话接通后是谁在说话:用冻结音频嵌入加梯度提升做多语言留言检测

评分:6.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Kemal Altwlkany:机构信息未能在本次解析中与作者逐人可靠绑定
- Muamer Paric:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
电话应答机检测需在接通后最初几秒判断是人接听还是语音信箱等自动应答,信令协议不携带该信息,且电话语音限于8 kHz采样窄带并经G.711非线性量化,多国家运营商与语言的留言差异大。该方法先对通话音频计算64通道对数梅尔语谱图,再送入冻结的CNN6得到512维整段嵌入向量,最后由LightGBM在该向量上输出人还是机器的二分类结果,训练更看重把人判对。与早期能量启发式、依赖关键词的语音识别方案及需微调3亿参数模型不同,该组合避免端到端微调,分类器解耦可独立更新并可在中央处理器上实时运行。在专有数据集上经5次重复自助法95%置信聚合的共7个模型对比中,CNN6-GBM以精确率94.70%±2.37和特异度96.54%±1.49均高于其余6个参评模型而位列第一。在公开OpenAMD数据集533条7语种录音的同样7模型对比中,CNN6-GBM以精确率95.14%±2.64高于其余6个模型同样居首。在表3同一延迟测量设置下CNN6-GBM平均延迟1.23毫秒低于wav2vec微调模型的131.99毫秒而低约两个数量级。未经额外训练直接用于1432例电话推销骚扰电话检测时召回率为94.34%而落入行业93%-97%区间,但在加性噪声下退化较快而丢包下保持可用,且OpenAMD机器样本多为神经合成再仿真信道构成,真实多语言长尾与重噪声范围尚未充分验证,训练开销原文未量化。
🔗 开源资源
- 第三方资源:https://doi.org/10.5281/zenodo.21234058 → https://zenodo.org/records/21234058 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
39. 双人对话手势生成:SynerGest 如何兼顾节奏与稳定

英文题目:SynerGest: Temporal-Spatial Synergistic Gesture Generation for Dyadic Conversations
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chengxiang Guo:Faculty of Information Engineering and Automation, Kunming University of Science and Technology, Kunming, China
- Jian Wang:Faculty of Information Engineering and Automation, Kunming University of Science and Technology, Kunming, China
- Lanmiao Liu:Utrecht University, Utrecht, Netherlands;The Max Planck Institute for Psycholinguistics, Nijmegen, Netherlands
- Zhan Tang:Zhejiang University, Hangzhou, China
- Junhua Fei:Faculty of Information Engineering and Automation, Kunming University of Science and Technology, Kunming, China
- Xiao Li:Faculty of Information Engineering and Automation, Kunming University of Science and Technology, Kunming, China
📌 核心摘要
该任务以目标听者与对话伙伴两路音频为输入,生成目标人物随时间变化的身体姿态与面部表情序列,难点在于语音到手势是一对多映射,易退化为平均姿势或高频抖动,且听者反应需与对话节拍同步。冻结的音频编码器提取双通道声学特征并拼接为对话上下文,身体分支用自回归离散码本预测每秒一帧的关键帧,面部分支回归唇部顶点特征,再经交叉注意力与拼接融合成身体与面部条件。融合条件送入速度场网络,先经三个交叉注意力块注入条件,再经八个时空块建模轨迹,推理时用八步常微分方程求解器从高斯噪声积分得到动作。与标准流匹配只拟合匹配条件速度不同,该方法在同一隐状态下对比匹配音频与批内打乱音频的速度预测并以有上界距离项拉开二者,与不区分频率的标准时空Transformer不同,脉冲趋势协同注意力以两条池化门控分别刻画通道显著性与时间节拍,再与多头注意力可学习加权融合。在Audio2Photoreal上与EMAGE基线相比,SynerGest的Fréchet Gesture Distance从0.908降至0.741,Beat Consistency从0.725升至0.782。在Seamless Interaction上与EMAGE基线相比,SynerGest的Fréchet Gesture Distance从2.636降至2.380,Beat Consistency从0.723升至0.753。在Audio2Photoreal上与完整模型相比,去除对比目标后Fréchet Gesture Distance从0.741升至1.440,将脉冲趋势协同注意力换为标准多头注意力后Fréchet Gesture Distance从0.741升至1.334。训练在单张NVIDIA RTX 4090上完成,以平均单样本推理耗时Inference Efficiency衡量,在Audio2Photoreal上为0.127秒,在Seamless Interaction上为0.231秒,均采用八步求解器,结论仅在48 kHz双通道对齐输入及两数据集协议下验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
40. 浅层语音表示怎么做音画伪造检测的音频前端

评分:6.0/10 | 创新 1.1/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Qiwu Wen:Luqia Technologies
- Jahangir Alam:Luqia Technologies
- Eric Charton:Luqia Technologies
📌 核心摘要
视频通话类系统同时依赖语音和人脸视频输入,伪造的说话人视频会先污染感知再影响对话,论文研究这类输入完整性检查中的音频表示选择。输入是同步的语音波形与人脸视频片段,输出是片段真伪判定,难点在于训练时见过的合成器与测试时新合成器不同,检测器不能记住特定生成痕迹。方法固定基于模态正则化伪造检测(Modality-Regularization-based DeepFake,MRDF)的训练流程、AV-HuBERT(Audio-Visual Hidden Unit BERT)视觉处理和六块多尺度跨模态变换器融合编码器,只更换音频前端。语谱图路径从堆叠对数滤波器组特征构造token,语音自监督路径用冻结的wav2vec 2.0(Wave to Vector 2.0,W2V2)Base或WavLM Base+波形编码表示,经投影和时间对齐送入同一融合空间;论文还比较只执行前4、6、9、12层的做法,以及对前6层做非均匀加权的做法,权重由池化后的音频和视觉摘要经打分器产生。在生成器互斥的MMDF(Multimodal DeepFake,MMDF)评测上,加权浅层W2V2三轮平均宏观AUROC(Area Under Receiver Operating Characteristic,AUROC)为90.61%,高于语谱图基线的84.19%。该宏观增益适用边界明确:平均AUROC提升主要来自AniPortrait和MegActor-S,在Hunyuan上加权浅层模型为78.58%,略低于语谱图的79.68%,以Hunyuan为主的新分布可能使结论失效。尚未充分验证的范围包括三轮训练估计的训练变异性使分层自助区间仍为探索性,双流拼接与单向交叉注意力等部件比较多为单轮对照,换融合规则或检测器族与基准后浅层加权是否保持优势未经证实。浅层执行减少了执行计算但上层参数仍驻留显存,延迟测试在NVIDIA A40上从预解码张量计时至logits,不含媒体解码、重采样与因果流式部署成本,且语谱图路径在短输入下更快。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
41. 为配音保留嘴型与声音:VoxDub 双语视听数据集解读

英文题目:VoxDub: A Bilingual Lip-Synchronized Audio-Visual Dataset for Automatic Video Dubbing
评分:6.0/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Kaidi Wang:School of Informatics, Xiamen University, China
- Wenhao Guan:School of Electronic Science and Engineering, Xiamen University, China
- Peijie Chen:School of Informatics, Xiamen University, China
- Weijie Wu:School of Informatics, Xiamen University, China
- Xuetao Lin:School of Informatics, Xiamen University, China
- Lin Li:School of Electronic Science and Engineering, Xiamen University, China
- Qingyang Hong:School of Informatics, Xiamen University, China
📌 核心摘要
自动视频配音要根据目标视频生成语音,文字内容准确的同时说话时长和口型变化也要对上,训练数据因此要同时提供可用语音、文字和可见人脸。已有纯语音语料缺少视频监督,已有音视频语料在切分依据、转写可靠性和人脸连续性上的做法并不一致,直接用于配音训练容易出现语音截断、转写错误或音画不对齐。本文构建中英双语语料VoxDub,共约76.6万片段约1.58千小时,先以语音活动检测切出候选并对齐对应视频区间,再用两个识别系统以词错误率互核转写,随后依次过滤语音质量、单人脸连续性和口唇同步置信度。同一语音合成模型在DubBench-EN上训练时,VoxDub英文子集的词错误率为4.34%,低于相同条件下LRS3的12.34%。配音实验把Emilia预训练语音生成器适配到视频条件生成,VoxDub与对照语料在语音质量和主观同步评分上总体接近,但英文客观同步置信度并未占优。上述结论仅适用于经单人脸、高语音质量和同步置信度筛选的中英片段及所评测的合成与配音设置,对多人同框、强噪声音乐、遮挡人脸或中英以外语言可能失败且尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/Anjok07/ultimatevocalremovergui — 链接可访问(HTTP 200)
第三方资源:https://github.com/snakers4/silero-vad — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/ByteDance/LatentSync-1.6/tree/main/auxiliary — 链接可访问(HTTP 200)
第三方资源:https://github.com/Breakthrough/PySceneDetect — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
42. 专家示范能教会语音合成更好地说话吗

英文题目:Does Expert Supervision Improve Text-to-Speech? An Empirical Study of Preference Optimization
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Minh Duc Vu:Department of Statistics & Data Science, National University of Singapore, Singapore
- Junchuan Zhao:School of Computing, National University of Singapore, Singapore
- Ye Wang:School of Computing, National University of Singapore, Singapore
📌 核心摘要
文本到语音(Text-to-Speech,TTS)在这里指给定文本与说话人提示,生成对应语音。偏好优化(Preference Optimization)指用选定回答与拒绝回答的成对比较来调整生成模型。困难在于外部专家语音听起来更好,把它当作选定目标去拟合,能否让学生自己生成更好的语音并不确定,中间还要经过学生的语音 token 表示与不同损失函数的变换。论文用 CosyVoice-1 与 GPT-SoVITS v4 作学生,用 LibriTTS 真实录音与 Qwen3-TTS 合成语音作专家,对比直接偏好优化(Direct Preference Optimization,DPO)、加权偏好优化(Weighted Preference Optimization,WPO)、锚定偏好优化零变体(Anchored Preference Optimization zero variant,APO-zero)与噪声对比对齐(Noise Contrastive Alignment,NCA),再对比直接用完整专家目标训练与先用专家前缀加学生续写、再转入完整专家目标的桥接路线。固定探针诊断跟踪相同专家序列与初始学生序列的似然变化,生成侧用词错率、说话人相似度与 NISQA 预测质量评价。CosyVoice 加真实录音监督时,\(\beta=0.01\) 下 DPO 在 LibriTTS 测试集词错率达到 29.78%,相对 \(\beta=0.1\) 时 4.59% 明显恶化,而 APO-zero 保持在 3.73% 到 3.77% 附近。论文的适用范围限于两个英语朗读学生与两种专家来源,桥接训练只能缓解部分恶化而不能稳定超越预训练基线。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/FunAudioLLM/CosyVoice-300M — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/lj1995/GPT-SoVITS — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-TTS-12Hz-1.7B-Base — 链接可访问(HTTP 200)
第三方资源:https://github.com/FunAudioLLM/CV3-Eval → https://github.com/QwenAudio/CV3-Eval — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/openai/whisper-large-v3 — 链接可访问(HTTP 200)
第三方资源:https://github.com/modelscope/3D-Speaker — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
43. 音乐指纹用到语音上还灵吗:一篇语音指纹泛化评测的解读

英文题目:Applicability and Generalization of Audio Fingerprinting Methods to Speech
评分:6.0/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Kemal Altwlkany:机构信息未能在本次解析中与作者逐人可靠绑定
- Elmedin Selmanovic:机构信息未能在本次解析中与作者逐人可靠绑定
- Sead Delalić:机构信息未能在本次解析中与作者逐人可靠绑定
- Emanuel Lacic:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文解决的输入是一段可能受背景噪声、混响、变速、变调或有损压缩损坏的短语音查询,输出是在语音库中找到其对应的原文件,难点是这些失真都会改变声学外观而内容仍需按原文件判定。处理分两步,先为库中每条语音预先计算指纹并存库,再为查询计算指纹并检索最相近的库内条目,前一步的库内指纹直接作为后一步检索的比对对象。论文选用经典方法audfprint作基线,选用基于conformer编码器的PTC和基于图神经网络编码器的GraFPrint作自监督学习代表,三者都不重新训练,直接用公开检查点在VCTK语音上建库和检索,自监督方法生成稠密嵌入并用Faiss穷举搜索,使失配只来自模型本身。每个实验抽取110名说话人各10条共1100条查询,加扰后存为固定文件再交给三种方法,指标为正确找回原文件的命中率并用自助法给出95%置信区间。在VCTK加背景噪声5dB的评测中,以该命中率为指标,GraFPrint为59.9%,低于其在音乐FMA上同信噪比下报告的98.3%。在人工合成混响的VCTK评测中,以同一命中率为指标,GraFPrint为77.21%,高于PTC的47.56%,也高于audfprint的27.82%。在单半音变调的VCTK检索失配中,以错误匹配属于同一说话人的占比为口径,PTC为29.7%,高于属于相同文本的0%,说明错误更偏向保住说话人而非内容。结论仅适用于VCTK英文语音及所测噪声、混响、变速、变调与MP3及G.711压缩条件,强失真下语音明显弱于音乐,未验证其他语言与真实房间混响;推理成本以处理1秒音频的中位耗时为指标,在Apple Mac M4 Max上audfprint为2.60ms,低于PTC的6.98ms,也低于GraFPrint的121.821ms。
🔗 开源资源
- 第三方资源:https://doi.org/10.1007/978-3-032-37870-5_28 → https://idp.springer.com/authorize?response_type=cookie&client_id=springerlink&redirect_uri=https%3A%2F%2Flink.springer.com%2Fchapter%2F10.1007%2F978-3-032-37870-5_28 — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
44. 去掉编码器的多模态大模型,是不是在早期层又学了一个编码器

评分:5.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- David Harwath:The University of Texas at Austin
- Desh Raj:NVIDIA
- Xavier Velez:Johns Hopkins University
- Sandra Arcos-Holzinger:Johns Hopkins University;The University of Melbourne
- Willie Jeng:The University of Texas at Austin
- Karen Livescu:Toyota Technological Institute at Chicago
- Leibny Paola Garcia-Perera:Johns Hopkins University
- Sanjeev Khudanpur:Johns Hopkins University
📌 核心摘要
无编码器多模态大语言模型把原始波形窗、频谱特征或图像像素块经轻量投影直接送入解码器Transformer,省去独立音频和视觉编码器,待检验的是早期层是否重新承担编码职能。论文以Gemma-4 12B和Inkling-Small为对象,先检验同一音频或图像在不同跨模态上下文下的层输出相似度,再把各模态独立编码到某一层后拼接送入后续层,对比全程联合编码的多模态问答表现。在Librispeech dev-clean抽取1000条语音配中性文本与图像、MSCOCO抽取797张图像配无说明与匹配或错配说明的对照下,以相对中性上下文参照的CKA相似度为指标,Gemma-4 12B音频与图像表示在12层前接近1.0、之后迅速下降,Inkling-Small在10层后仅轻微下降,早期跨模态不变性更持久。在包含1142组文本问题、图像、音频波形和答案四元组的OmniBench三模态问答评测设置下,以问答精度为指标,独立编码到12层左右再合并仍维持在全程联合编码基线附近(Inkling-Small基线43.8%、Gemma-4 12B基线40.4%),更深层合并后精度下降,Gemma-4 12B降至机遇水平的25%,Inkling-Small降至约37%。逐层探测比较隐式表示与声学特征、音素、词及句子语义的相似度随深度变化,发现其与WavLM和HuBERT等常用编码器表示高度相似,并呈现由低层声学到中高层音素词义的层次。把早期层输出当作冻结编码器在SUPERB和MIEB-Lite上评测时,分类等全局任务具竞争力,细粒度识别与聚类任务则落后于参数量小得多的专用编码器。结论适用范围限于这两个模型的特定输入排布和评测任务,隐式编码器并不等同于专用编码器。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
45. CASE:给语音驱动 3D 人脸动画补上嘴部几何感知的语音编码器

英文题目:CASE: Complementary Articulation-Aware Speech Encoder to Enhance Speech-Driven 3D Facial Animation
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jaehong Myung:机构信息未能在本次解析中与作者逐人可靠绑定
- Seungho Eum:机构信息未能在本次解析中与作者逐人可靠绑定
- Taegon Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- Hyunjung Chung:机构信息未能在本次解析中与作者逐人可靠绑定
- Unsang Park:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音驱动三维人脸动画需把输入语音映射为时间对齐的三维人脸网格,难点在于通用自监督语音编码器的预训练目标并不直接对应可见的唇部开合与唇形变化。论文提出互补构音感知语音编码器CASE,先以韩国语语音与三维唇部网格配对数据做五帧短片段对比对齐,将语音特征与连续三维唇部网格VQ-VAE隐变量拉近,适配后去掉几何分支,只保留纯音频CASE编码器。推理时基线自监督语音表示做查询,CASE特征做键和值,经残差交叉注意力融合后送入原有运动生成结构,原解码器架构与训练目标保持不变。与已有路线相比,CASE既不需要音素标注,也不替换生成器,只增加可复用的音频分支。在共同VOCASET受试者划分上三次运行取均值的评测中,四个基线系统加入CASE后相对各自基线将唇顶点误差分别降低6.0%、3.4%、4.8%和2.8%,平均全脸顶点误差分别下降6.6%、2.5%、0.4%和2.4%。在相同初始化与融合接口的VOCASET对照中,CASE在四个生成器上的平均唇顶点误差均低于未适配AV-SE流,相对基线的进一步降幅高于AV-SE,增益随模型而异。结论限于以英语预训练音视频先验为起点、从韩语三维适配向英语下游迁移的设定,尚未在BIWI等第二数据集验证;在39条VOCASET测试语音的RTX 3090在线评测中,CASE相对原基线推理延迟增加149 ms到694 ms,但总耗时仍短于输入音频时长。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
46. 转写不准时,关键词频率还能算准吗

英文题目:Conducting Reliable Keyword Estimation with Unreliable ASR in Police Audio Data
评分:5.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Robert Cole Molloy:机构信息未能在本次解析中与作者逐人可靠绑定
- Rhiannon N. Miller:机构信息未能在本次解析中与作者逐人可靠绑定
- Stephen Morgan:机构信息未能在本次解析中与作者逐人可靠绑定
- Anjalie Field:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
目标是从警用电台录音估计各关键词在语料中的平均出现次数,输入为大量音频,输出为词频估计与置信区间,难点是现成转写系统对业务编码和字母拼读词系统性漏识,直接计数会低估真正词频。方法先用自动语音识别转写全部音频得到大规模机器计数,再对小部分音频人工转写得到配对的人机计数差异。然后用校正估计量将自动语音识别均值减去小样本误差均值,并按两部分方差构造置信区间,使小样本纠偏进入大规模预测。与已有方法关键差异是不要求自动语音识别无偏,只要求人工样本与误差均值能反映总体,兼顾大规模机器数据的覆盖面与小规模人工数据的纠偏作用。在巴尔的摩警务关键词集上,用Whisper-large-v2转写并按百分之二十人工转写加百分之八十仅机器转写划分,以自助抽样下百分之九十五置信区间覆盖有效的词占比为指标,校正估计为56.2%,高于仅机器估计的43.0%和仅人工估计的27.2%。在芝加哥警务关键词集上,用Whisper-large-v2转写并按百分之二十人工转写加百分之八十仅机器转写划分,以自助抽样下百分之九十五置信区间覆盖有效的词占比为指标,校正估计为47.3%,高于两类基线各35.6%。原文未披露训练、推理或部署成本。校正估计并非对所有词有效,词频过低、人工样本过少或无标注数据过少时仍可能失效,应用前需按词检验覆盖情况。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
47. 用相同文本比较不同人群的识别效果:AfriBED 偏置评估数据集

英文题目:AfriBED: a Speech Recognition Bias Evaluation Dataset for Low Resource African Languages
评分:5.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Claytone Sikasote:机构信息未能在本次解析中与作者逐人可靠绑定
- Hussein Suleman:机构信息未能在本次解析中与作者逐人可靠绑定
- Jan Buys:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是自动语音识别(Automatic Speech Recognition,ASR)中按说话人属性划分的性能差异,困难在于已有评测集中不同子群朗读的句子不同,文本难度差异会混入属性差异,无法公平比较。论文构建了非洲语音偏差评测数据集(African speech Bias Evaluation Dataset,AfriBED),输入是同一批翻译文本句子,输出是按性别和说话人类型划分的朗读录音及其转写与元数据。处理过程先做人口调查确定目标语言和可采集属性,再把英语句子译为班巴语和尼昂贾语并校对,然后按交叉分组分配相同句子录音,最后清洗保留高质量音频。班巴语部分包含 3928 条 utterances,时长为 9.32 小时,来自 80 名说话人;尼昂贾语部分包含 6260 条 utterances,时长为 18.53 小时,来自 127 名说话人。与已有英语偏差数据集相比,关键差异是子群之间语音内容相同且说话人不重叠。基线显示微调后模型在母语与非母语子群之间存在字符错误率(Character Error Rate,CER)差距,在尼昂贾语上最大达到 29.96 个百分点,说明数据集能暴露偏差。结论适用于所收集的朗读场景,噪声环境和文本来源单一限制了推广,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/csikasote/AfriBED — 链接可访问(HTTP 200)
第三方资源:https://librivox.org/ — 链接可访问(HTTP 200)
第三方资源:https://www.audacityteam.org/ — 暂时无法访问
第三方资源:https://ucthpc.uct.ac.za/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
48. 联合、解耦还是智能体:多模态对齐三种范式何时占优

英文题目:Joint, Decoupled, or Agent: When Each Multimodal Alignment Paradigm Wins
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yi Fang:机构信息未能在本次解析中与作者逐人可靠绑定
- Gaurav Srivastava:机构信息未能在本次解析中与作者逐人可靠绑定
- Sirui Ding:机构信息未能在本次解析中与作者逐人可靠绑定
- Xuan Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是给定一对输入和一个下游标签时,何时把跨模态信息放在预训练里、何时放在有监督融合里、何时放在推理时组合。困难在于编码器来源、任务格式和标注量同时变化,直接比较容易混淆表示质量与融合方式的作用。论文把同一目标拆成三种范式:联合预训练后冻结编码器再学融合头(Joint),独立预训练编码器冻结后再学融合头(Decoupled),冻结大语言模型读入单模态读出和可见文本作答(Agent)。处理过程是固定测试集和开发集,只改变标注子集规模,比较三种系统在分类、回归和问答上的效用,再用几何、监督表示诊断和文本诊断预测胜者。相对已有跨域融合基准,关键差异是预测发生在拟合候选系统之前,并采用两步级联先分 Agent 与融合再分 Joint 与 Decoupled。在 144 个组合上级联选中胜者的准确率为 71.4%,高于只用元数据的 54.2%,平均相对遗憾为 0.028,对 0.057。适用范围限于配对完整的目标任务,推理成本未计入效用,原文估计 Agent 推理浮点运算约为融合的 360-3000 倍。原文未披露训练、推理或部署成本的完整实测,成本部分以估计给出。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
49. SENTRY:用全整数运算在网关处实时筛查语音深度伪造

英文题目:SENTRY: A Streaming Edge Network Trust Engine for Real-Time Audio Deepfake Detection
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Chirantan Banerjee:机构信息未能在本次解析中与作者逐人可靠绑定
- Soumita Chatterjee:机构信息未能在本次解析中与作者逐人可靠绑定
- Bhargab B. Bhattacharya:机构信息未能在本次解析中与作者逐人可靠绑定
- Hafizur Rahaman:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
输入是通话中到达的电话或网络语音流,输出是对当前流的记录、质询或丢弃,难点是判决需在通话中给出,而网关侧无图形处理器和浮点乘法器可用,且合成痕迹集中于高频易被信道压缩抹掉。前端对语音窗做整数提升小波多分辨率分解并统计符号变化,再以小波包能量包络和沃尔什-哈达玛变换刻画频带能量与梳状纹理,并以波形微统计量与长时傅里叶幅度轮廓检查低位噪声与高频差异,拼接为特征向量。特征向量同时送入已知真伪数据训练的梯度提升树和只用真人语音拟合的马氏距离异常分支,分别给出监督分数与偏离分数,再经轻量逻辑回归融合成流得分并做时间平滑后交由策略处置。与依赖浮点神经网络的事后取证方法不同,该路径约束为加、移位、比较等整数操作,使分类与融合可落入可编程逻辑。在WaveFake闭集评测中融合系统等错误率1.25%低于监督单轨的1.31%,准确率98.75%高于单轨的98.69%,而监督单轨曲线下面积0.9994高于融合的0.9993。分类与融合核在Zynq UltraScale+上100 MHz时钟下特征向量就绪后220 ns给出决策,吞吐每秒455万向量,占用11656个查找表且不占数字信号处理块,整机功耗估计2.94 W,前端在单核Arm Cortex-A53上跑位精确整数代码,端到端首次告警取决于累积音频窗长而未实测。结论仅适用于每攻击系统在训练和测试同时出现的闭集协议,异常分支等错误率高达29.89%与43.18%,未见生成器、官方评测分区与跨语料泛化及完整前端综合仍未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
50. 病理嗓音的单人语音识别适配:放在哪里才有效

英文题目:ASR Personalization in Pathological Voice: Accuracy, Efficiency, and Duration Effects
评分:5.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Giuseppe Giaimis:机构信息未能在本次解析中与作者逐人可靠绑定
- Sergei Katkov:机构信息未能在本次解析中与作者逐人可靠绑定
- Muhammad Azfar Yaqub:机构信息未能在本次解析中与作者逐人可靠绑定
- Antonio Liotta:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
在单说话人意大利语病理语音的215折留一验证条件下,自动语音识别需将声学语音转写为文字,难点在于发音与韵律长期偏离预训练分布且目标说话人数据稀缺。波形先转为80通道对数梅尔语谱图,经冻结的两层卷积前端输出声学序列送入编码器Transformer做声学建模,编码器输出的声学表示再与已生成文本一同进入解码器自回归生成转写。适配时冻结基座权重,仅在选定注意力层的查询投影和值投影上加入秩为8的低秩增量并更新,每折以214条中留1条验证早停、余下做权重更新,对比仅解码器、仅编码器与两侧同时适配以分离适配位置的作用。在215折留一验证平均下,Whisper-medium零样本词错率为12.2%,两侧同时适配后为10.4%,绝对降低1.8个百分点。在215折留一验证平均下,Whisper-tiny零样本词错率为68.8%,两侧同时适配后为53.8%,绝对降低15.0个百分点。在215折留一验证平均下,tiny两侧同时适配每折平均训练耗时为34.4秒对应词错率降低15.0个百分点,而base对应降低11.2个百分点耗时50.0秒。在215折留一验证按短中长话语分档评估下,tiny中等时长话语词错率由71.6%降至51.0%,降低20.6个百分点,而small长话语词错率由19.0%升至20.8%,升高1.8个百分点,结论仅适用于该单说话人小样本条件,未验证多说话人、其他病理类型和录音条件的泛化。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
51. 只用手机麦克风贴在腹部,能同时听到母体和胎儿的心跳吗

评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Muhammad Mahboob Ur Rahman:Electrical engineering department, Information Technology University (ITU), Lahore, Pakistan.
📌 核心摘要
读者需要理解的对象是晚孕期腹部体表同时存在的母体与胎儿两个心音源,困难是单通道消费级麦克风信噪比极低且两类心音在声学频谱上重叠,处理思路是先定位短的高质量片段再按重复速率拆分候选心率。输入是受试者Z在最后五周自采的28段10.3秒至68.4秒的16 kHz腹部录音,均无母体与胎儿真值对照。在28段录音全部合格窗口pooled统计下平均心率指标比较中,胎儿带160.3±11.5 bpm高于母体带82.5±17.9 bpm,可恢复录音数指标比较中胎儿带25/28段多于母体带14/28段。香农能量包络(指对带通后波形做非线性变换以突出中等幅度心音事件的包络)先经中位数稳健归一化抑制大handling伪迹,再经平滑阈值得到有效片段并同时送入母体带与胎儿带两个并行滤波分支。每个分支对包络做周期性滤波后峰检测,用中位心搏间期换算心率并用变异系数衡量规律性,呼吸探针则在全程包络趋势上搜索低频自相关。与多通道压电胎儿心音图和主动超声Doppler方案相比,本文方法零硬件成本但精度更低且在单通道下难以确证声源归属。在同一28段录音按母体活动状态分组后各组合格窗口pooled统计下平均心率指标比较中,胎儿带休息161.0 bpm高于运动158.0 bpm而晨起161.4 bpm与未标注161.8 bpm基本不变,显示跨状态稳定。结论只适用于单被试回顾性观察,逐拍变异性与呼吸率判别均被判为阴性发现,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
52. 标签说了算:表演的情绪与听到的情绪为何是两道题

英文题目:Label Authority in Speech Emotion Recognition: Intended and Perceived Ground Truth in Emozionalmente
评分:5.6/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Marco Giordano:Student Member, IEEE
- Stefano Giacomelli:Graduate Student Member, IEEE
- Claudia Rinaldi:Member, IEEE
- Fabio Graziosi:Member, IEEE
📌 核心摘要
语音情感识别常把一条语音对应一个情绪类别,但表演时被要求的情绪和听众实际听到的情绪是两回事,多数投票还会丢掉少数意见并需外部规则处理并列,混用会让评价含义不清。本文使用Emozionalmente语料研究这个问题,每条语音同时带有表演指定标签和五个听众判断,同一录音因而对应受控制作条件与听众感知两种评价依据。方法先冻结XLS-R、HuBERT和WavLM参数,把语音变为帧级隐藏表示并做时间平均,得到每条语音的固定向量供浅层探针使用。三种探针再分别以指定类别独热标签、听众投票多数类别和五票比例向量为目标训练,前者用类别交叉熵、后者用软交叉熵,同一说话人无关划分下的输出分别按硬决策和分布拟合评价。结果是指定类别最容易恢复,最佳非加权平均召回率达到0.825,而听众多数类别最佳值约为0.746,但两者评价依据不同,不能直接理解为能力下降。用完整分布训练几乎不改变硬多数决策,却让预测概率更接近听众投票,在模糊语音上分布误差下降明显。结论适用范围限于该语料和冻结探测设置,跨语料、自发语音和微调情形尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
53. 用情绪和语音识别知识帮助小样本阿尔茨海默病语音检测

评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuan-Chao Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yin-Long Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Liu He:机构信息未能在本次解析中与作者逐人可靠绑定
- Sizhe Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ji-Xuan Deng:机构信息未能在本次解析中与作者逐人可靠绑定
- Yin Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhen-Hua Ling:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiahong Yuan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是一段受试者描述图片的录音,任务是判断说话人属于阿尔茨海默病还是健康对照,在PROCESS上还要区分轻度认知障碍和痴呆。困难在于每个说话人无关划分只有约一百名说话人,全量微调容易过拟合,冻结编码器加线性探针又无法改写表示。方法先在外部用情感微调和语音识别微调后的wav2vec 2.0-Large-Robust权重减去基座权重,得到两个固定的任务向量,分别携带韵律音质等副语言方向和音素词汇可恢复性方向。AD训练时冻结基座与向量,每层只学情感与语音识别两个合并系数并按加权叠加到查询键值输出与前馈权重上,叠加后的权重直接参与前向,使下一层读到已被外部知识改写的表示。随后从第12层隐状态经有效帧掩蔽时间平均池化送入单个线性头判读认知状态,推理时把加权差值折入层权重,不增加分支;与本任务新学适配器的LoRA不同,适配方向完全来自外部,可训练量约2.1K。在ADReSSo说话人无关五折交叉验证中,双向量合并准确率为80.8%,高于冻结探针的75.0%。低训练量下双向量在ADReSSo的20%、40%、80%说话人子集上平均准确率仍高于冻结探针,但在PROCESS三分类上纯双向量宏F1仅从42.1%升至44.2%、标准差超10个百分点,最好宏F1需靠双向量加LoRA组合取得,说明结论在二分类低资源上稳定,在含中间类且类别严重不平衡的三分类上需额外适配容量,且中文跨语言迁移尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/facebook/wav2vec2-large-robust — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/audeering/wav2vec2-large-robust-12-ft-emotion-msp-dim — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/facebook/wav2vec2-large-robust-ft-libri-960h — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
54. 想、压、答:用推理压缩做多模态定位

英文题目:Think, Compress, Answer: Reinforcement Learning for Multimodal Grounding via Reasoning Compression
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jinbae Seo:机构信息未能在本次解析中与作者逐人可靠绑定
- Hyeongjun Kwon:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiyoung Lee:机构信息未能在本次解析中与作者逐人可靠绑定
- Hyunsung Jang:机构信息未能在本次解析中与作者逐人可靠绑定
- Namkoo Ha:机构信息未能在本次解析中与作者逐人可靠绑定
- Jungin Park:机构信息未能在本次解析中与作者逐人可靠绑定
- Kwanghoon Sohn:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
多模态定位要求根据文本查询在图像、视频或音视频观测中找到被指称的实体,输出通常是边界框、中心点或掩膜等紧凑形式,难点在于查询涉及相似外观区分、空间关系和跨帧变化,而自由生成的长推理容易扩散为场景描述并引入弱相关细节。一个样本的处理过程是把查询和观测送入多模态大语言模型,得到自由推理文本,再由压缩阶段提炼出目标相关短语,最后由该短语条件生成边界框和中心点并交给分割解码器输出掩膜。论文提出的思考-压缩-回答把上述三段串行连接,并用分组相对策略优化分四阶段训练,先立格式,再压信息率,再用裁判模型保真,最后优化定位奖励。与已有链式思考和只奖励答案的方法不同,思考-压缩-回答保留长推理的候选分析,但在回答前经过可观测的文本瓶颈。在 Ref-DAVIS17 验证集上,思考-压缩-回答的区域相似度与轮廓准确度均值越高越好为 78.9,相对同骨干零样本基线 65.2 提高 13.7。结论适用于以框和点为中间答案并外接冻结分割器的推理式分割流程,当推理本身指错对象时压缩无法恢复正确目标。原文披露了 4 块 RTX A6000 等训练硬件,未披露完整训练时长与推理延迟。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
55. 局部看得见,整体答不对:语音-视觉时间组合的诊断

评分:5.3/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:后 50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jaehong Myung:机构信息未能在本次解析中与作者逐人可靠绑定
- Seunghun Oh:机构信息未能在本次解析中与作者逐人可靠绑定
- Unsang Park:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要理解的对象是带解说的烹饪类视频,困难是解说词提到什么动作与该动作在何时可见并不一致,模型要把说什么和何时说分开处理。论文引入免训练诊断框架时间证据分解(Temporal Evidence Decomposition,TED),先用自动语音识别得到文字稿与说话时间段,再把视频切成无音频窗口逐个验证,最后相对说话时间段聚合。直接问答把完整视频、含语音音频与题目一次送入冻结音视频大模型,TED则用文字稿或候选项做局部查询并在外部比较说话前、说话中与说话后三个区域的证据强度。在SVHalluc时间预测任务276项评测上,以Qwen3-Omni-30B为例,TED的准确率为80.43%,高于直接问答的29.35%,表明局部证据可恢复但未被完整问答有效使用。替换查询词或打乱说话时间段会降低恢复效果,显式给出文字稿与时间戳的完整视频对照仍不能复现该提升。结论限于所测模型与该基准,尚未证明该分离能改进端到端模型。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
56. 从手势到声音:DYNARTmo 怎样算声道、算气流再叠出语音
英文题目:Vocal-Tract Acoustics, Aerodynamics, and Overlap-and-Add Synthesis in DYNARTmo
评分:5.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.5/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:后 50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Bernd J. Kröger:Medical School, RWTH Aachen University, Aachen, Germany;Kröger Lab, Belgium,
📌 核心摘要
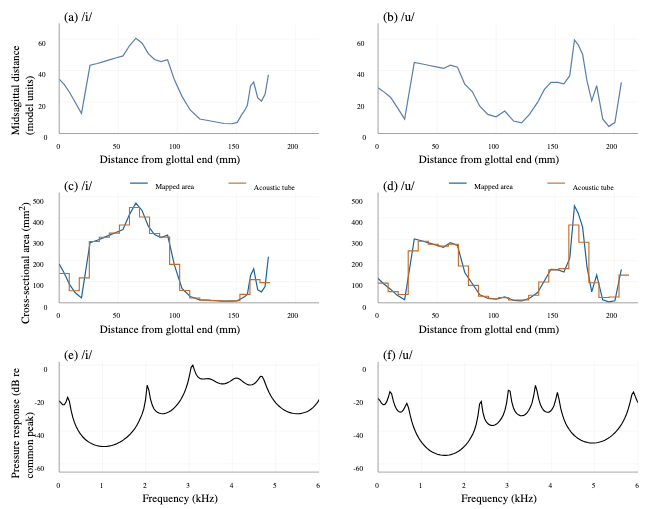
读者需要理解的对象是从构音手势到可听波形的完整生产过程,困难在于声道形状、气流压力和声源激励互相牵制,需把几何、气动和声学分开计算再合成为连续语音。输入是元音形状、辅音收缩、软腭和声门等手势轨迹,以及肺压和声带张力(Cord Tension,缩写 CT)轨迹,输出是 16 kHz 合成波形及分开的发声、口腔摩擦和声门送气成分。几何由中矢状轮廓采样为距离函数,再映射为面积函数并离散为管段,鼻支按软腭端口面积接入,侧音用等效最小面积表示,输出交给声传播求解器得到各帧脉冲响应。气动用集总管网由声门面积和肺压算入流、口腔鼻腔分流和腔内储压,压力状态逐帧传递,输出的平均流量和压力进入噪声驱动估计。合成按控制帧、声门脉冲时刻和声响应拖尾三套网格叠加发声响应和连续噪声核,保留超出单帧的共振拖尾,与直接传播时变波导或窗切拼接录音不同,每帧几何冻结固定。该结论仅适用于元音、鼻音、边音及清浊擦音和塞音过渡的模型演示,三个德语词仅说明协调与中间量可解释性,不是自然-合成配对比较,声门运动为预设而不从自振推导基频,擦音自然度仍需改进且独立感知评估尚未完成。原文未提供可核对的关键定量结果。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://speech-articulation-trainer.web.app — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
57. 当人工智能走进弦乐重奏:从作曲工具到创作对话者

英文题目:In Human Memories. Technology, Creativity and Self-Determination: An Ethical Proposal
评分:4.1/10 | 创新 1/2 | 技术严谨 0.8/1.5 | 实验充分 0.5/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.5/1.5
排名:后 50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Francesco Vitucci:机构信息未能在本次解析中与作者逐人可靠绑定
- Giuseppe Silvi:机构信息未能在本次解析中与作者逐人可靠绑定
- Francesco Abbrescia:机构信息未能在本次解析中与作者逐人可靠绑定
- Anthony Di Furia:机构信息未能在本次解析中与作者逐人可靠绑定
- Francesco Scagliola:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
本论文追问作曲家在人工智能介入作曲时如何保持主动,其输入是从文字生成到声音录制、实时处理再到空间播放的漫长技术链,输出是可上演的室内乐作品,难点在于任一环节交由他人或自动化都可能削弱作曲家的决定权。延期处理指采样、计算与聆听分在不同时刻完成,混合处理指演奏在过去完成而计算结果可在演出时刻发声,实时处理指演奏信号进入处理并几乎同时发声。第一个案例是Alexander Schubert的Convergence(2020/21),为弦乐队与人工智能系统而作,人工智能在台上学习、复制并支配演奏员,论文将其读作反乌托邦。第二个案例是Francesco Vitucci的In Human Memories(2024),为四把大提琴与一位电声演奏员而作,流程是先与GPT-4对话生成三个狄多独白文本,再由三位女声录音并用语音变换得到异化变体,最后由大提琴的模仿性写作与电声演奏员的触发和实时处理共同呈现。与已有做法的关键差异在于作者强调作曲家亲自掌握技术并让电声演奏员站在台上参与室内乐互动,而不是把技术工作完全交给助手。该主动性结论只适用于作曲家直接控制技术链且电声演奏员在场呼吸配合的室内乐条件,若依靠远端自动化触发或缺席操作则可能失效,且未在其他编制与听众接受度上验证。原文未提供可核对的关键定量结果。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://openai.com/ — 链接不可用(HTTP 403)
第三方资源:https://elevenlabs.io/ — 链接可访问(HTTP 200)
第三方资源:https://www.alexanderschubert.net/works/Convergence.php — 链接可访问(HTTP 200)
第三方资源:https://archive.aec.at/prix/showmode/67735/ — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。