📄 从手势到声音:DYNARTmo 怎样算声道、算气流再叠出语音
英文题目:Vocal-Tract Acoustics, Aerodynamics, and Overlap-and-Add Synthesis in DYNARTmo
评分:5.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.5/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Bernd J. Kröger:Medical School, RWTH Aachen University, Aachen, Germany;Kröger Lab, Belgium,
📌 核心摘要
读者需要理解的对象是从构音手势到可听波形的完整生产过程,困难在于声道形状、气流压力和声源激励互相牵制,需把几何、气动和声学分开计算再合成为连续语音。输入是元音形状、辅音收缩、软腭和声门等手势轨迹,以及肺压和声带张力(Cord Tension,缩写 CT)轨迹,输出是 16 kHz 合成波形及分开的发声、口腔摩擦和声门送气成分。几何由中矢状轮廓采样为距离函数,再映射为面积函数并离散为管段,鼻支按软腭端口面积接入,侧音用等效最小面积表示,输出交给声传播求解器得到各帧脉冲响应。气动用集总管网由声门面积和肺压算入流、口腔鼻腔分流和腔内储压,压力状态逐帧传递,输出的平均流量和压力进入噪声驱动估计。合成按控制帧、声门脉冲时刻和声响应拖尾三套网格叠加发声响应和连续噪声核,保留超出单帧的共振拖尾,与直接传播时变波导或窗切拼接录音不同,每帧几何冻结固定。该结论仅适用于元音、鼻音、边音及清浊擦音和塞音过渡的模型演示,三个德语词仅说明协调与中间量可解释性,不是自然-合成配对比较,声门运动为预设而不从自振推导基频,擦音自然度仍需改进且独立感知评估尚未完成。原文未提供可核对的关键定量结果。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
- 第三方资源:https://speech-articulation-trainer.web.app — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
这篇论文要解决的输入输出问题
论文处理的是发音合成里从动作到声音的一整段链路。输入是一组随时间重叠的手势轨迹,包括元音形状、辅音收缩、软腭开闭、声门开闭,再加上肺压和声带张力 CT。输出是可听的语音波形,同时要求中间的声道形状、压力流量和各类声源都能被打开检查。
难点在于 3 类信息的时间尺度不一样。发音几何变化慢,声门振动快,声道共振拖尾又比两者都长。如果把几何切成互不相干的小段各自发声再拼接,就会丢掉拖尾重叠。论文要保留的是几何决定共振、收缩影响气流和压力、气流再决定噪声强度,最后所有贡献在时间上叠起来。
读者可以把例子记成一句话:同一个手势序列,先变成每帧的声管,再算出每帧的气流压力,最后分别做出浊音、摩擦、送气并叠成波形。Tasse、Muse、Lade 3 个词就是用来走通这条链的取样,不是德语全音位测评。
论文站在哪条已有路线上
声学部分沿的是源—滤波器思路和数字声管传统。论文明确提到 Fant 的源—滤波器观点,以及 Kelly 和 Lochbaum 用截面积定特征阻抗和波散射的做法。实现上每段管保存来回走的体积速度波,用阻抗差算反射,用衰减和平滑调整传播。
空气动力学部分借的是塞音释放分析中把声门流入、口内储存、口腔鼻腔流出一起看的做法。论文也对比了自振荡声带模型,区别是这里声门运动是给定的,不从力学稳定性算出振动和基频。基频的 CT 映射只是控制约定。
合成策略是广义的叠加相加。论文提到快速卷积和基音同步波形处理作为历史背景,但强调都不等同于本文做法:浊音是在声门脉冲时刻加上算好的脉冲响应,噪声是把连续随机流经由逐样本的核滤出来再加,不是从录音里切波形单元重排。
为什么要区分三种时间概念
初学者最容易混的是控制帧、声门脉冲时刻、声学响应时长。控制帧是固定的控制更新间隔,论文取 5 ms,1 帧对应一套发音和生理配置。它既不是分析窗,也不是基音周期。
声门脉冲时刻是另一套网格,由 CT 决定的频率积分相位产生,一个周期结束就定一个脉冲时刻。浊音段在这些时刻插入脉冲响应。脉冲间隔可以跨过好几个控制帧,两套网格不需要对齐。CT 决定的相位在清音段也继续走,只是声门设置不提供振荡成分时不输出浊音,论文把这看作底层定时延续的假设。
声学响应时长是单次激励对输出有贡献的时间,包括声道随后的一段振铃。论文的标准时长大于控制帧,也大于相邻声门脉冲间隔,所以后来的响应会叠在前面的拖尾上。理解了这一点,才不会误以为系统在拼接互不重叠的 5 ms 波形片段。
控制帧 × 声门脉冲时刻 × 声学响应时长: 控制帧是每 5 ms 更新一套发音和生理配置的固定网格,声门脉冲时刻是由声带张力 CT 决定的频率经相位积分产生的时刻,声学响应时长是单次激励连带声道振铃继续对输出做贡献的时间。控制帧给出几何,脉冲时刻给出浊音插入的节拍,响应时长允许前后响应互相重叠,三者配合才能说明输出不是 5 ms 小波形的首尾拼接。
从手势到波形的总流程
先由手势组织生成发音轨迹,得到每个控制帧的发音器位形和肺压 CT。同一句话按时间顺序逐帧处理,因为缓慢变化的储存压力要从上 1 帧带到下 1 帧。声门脉冲时刻则单独由 CT 算出,再把每个脉冲时刻归属到当时活动的控制帧。
每个控制帧要做三件事。第一,把中矢轮廓变成面积函数,再量化为固定长度声管段,并算出该帧的声辐射核。第二,用集总流网算声门流入、口腔鼻腔流出和储存压力。第三,用该帧的管和气动量算出声门脉冲响应和噪声核的幅度和频谱成形。
最后做叠加。浊音把各脉冲时刻对应的帧响应按时移相加,噪声把每个噪声样本经由其所属帧的核滤出并累加,3 类源再加成最终波形。每 1 帧的响应用的是该帧冻结的口腔鼻腔几何,帧与帧之间不传递完整的声波状态,这是全文反复强调的核心近似。
中矢轮廓如何变成面积和声管
采样网格是分区组织的。论文用两个固定扇形原点:后原点管软腭腭区,前原点在上门齿附近管口腔前部,射线交内外轮廓得到腔距。咽喉部用平行线采样,间距随喉轮廓参考点自适应。唇部用 5 条竖线在随上唇位置变化的唇区间内均匀分布。这种固定原点加自适应交点的构造,意味着固定采样方向不对应固定腔长。
实现保留固定的分区采样数:喉 4、咽 9、软腭 8、腭 6、龈 5、唇 5,共 37 个有序样本。每个采样由内外交点算腔距和中点,再沿平滑后的中线累积纵向位置。腔距仍是轮廓坐标单位,不是毫米直测。腔距到面积用经验映射,先做幂律再对大面积向 2 倍方向平滑放大,对窄段影响小。论文强调这是经验转换,不是 3 维重建。
控制帧的时间定义写作固定间隔,公式含义是第 k 帧时刻为 k 乘 5 ms。
\[t_{k}=k\Delta_{c},\qquad\Delta_{c}=5\,\mathrm{ms}.\]距离和中点的定义为内外点距离与均值,阻抗由截面积定,反射由相邻阻抗差定,传播速度取实现约定而非温度标定。
\[Z_{j}=\frac{\rho c_{Z}}{A_{j}},\]声管离散和鼻分支旁路怎样工作
声管段长取 8.5 mm,内部采样率 40 kHz,名义传播速度为两者乘积 340 m/s,而阻抗和气动容积计算用的声速常数取 350 m/s。论文说明这些是实现约定。每段面积定特征阻抗,相邻段阻抗差定反射系数,另有可调衰减、频率相关平滑、窄段经验传输损耗、边界反射和辐射参数。之后把面积函数重采样为固定长度声管段,对段内多点平均,但完整闭合会被显式保留,不让空间平均把闭合抹成开通。
鼻腔用一个等效支路代表双侧鼻道,耦合位置由几何定,软腭抬起断开支路,放下则按软腭控制连续打开端口,当前参考最大 80 mm²。三通处由入射波和各支路导纳求公共压力,再向口腔两方向和鼻支路散射,所以鼻是耦合共振器的一部分,不是独立混合的鼻滤波器。边音用有效最小面积 25 mm² 代表左右 2 通道之和,不拆成两个声分支,另有空间受限的旁路修正,避免软腭下降造成矢状面误堵。
要看/i/和/u/的例子,先明确这张图的观察任务:上排看中矢距离,中排看映射面积与阶梯声管,下排看管入口流量冲激到唇内压力的响应幅度。注意下排不是发音频谱也不是远场辐射传递函数,且两条曲线共用一个峰值归一化。
看图路径: 1. 对比左列/i/与右列/u/中矢距离曲线的起伏位置;2. 看中排蓝色映射面积与橙色阶梯声管在窄段和闭合处的跟随情况;3. 看下排压力响应峰的位置高低,注意纵轴是相对共同峰值的 dB
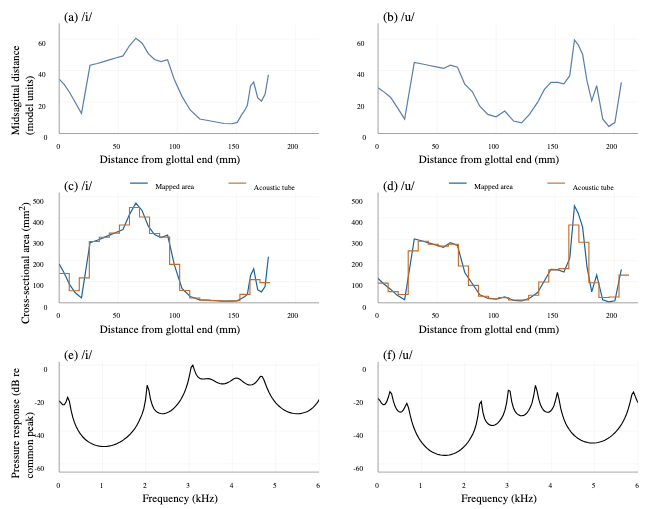
论文图 2。原论文 Figure 2::“Distance-to-area conversion and acoustic consequences for the same /i/ (left) and /u/ (right) model targets as in Fig.”。
从像素可见,/i/咽部面积大而前部窄,/u/在 170 mm 附近出现高而窄的面积峰,对应圆唇收紧。橙色阶梯大体跟住蓝色曲线,但在闭合零点处保持开通判断。下排/i/在 2 到 5 kHz 有多个接近 0 dB 的峰,/u/整体低约 20 到 40 dB,峰更尖,说明同样激励下两几何的共振分布不同。
面积函数 × 声管 × 鼻分支: 面积函数是沿声道位置的截面积分布,声管是把该分布量化为固定长度小段后用于计算传播的结构,鼻分支是在咽部三通处联立求解的等效鼻腔通道。先有连续面积才能定每段阻抗和反射,再把鼻支路按导纳和公共压力一起解,才能算出口腔闭合而鼻孔仍有输出的鼻音。
鼻音/m/的声管长什么样
这张图的观察任务是找到唇闭合处口腔面积归零而鼻支路仍开放的位置,看清咽部耦合点处耦合段与箭头的连接含义,并注意鼻轮廓横轴的起算方式。蓝色是映射口腔面积,橙色阶梯是有效声管,绿色阶梯是等效鼻支路,紫色是耦合段。
看图路径: 1. 找唇端口腔面积归零而鼻支路仍开放的位置;2. 看咽部耦合点处紫色耦合段与箭头的连接含义;3. 注意鼻轮廓横轴从耦合点起算,不代表口腔轴的延长
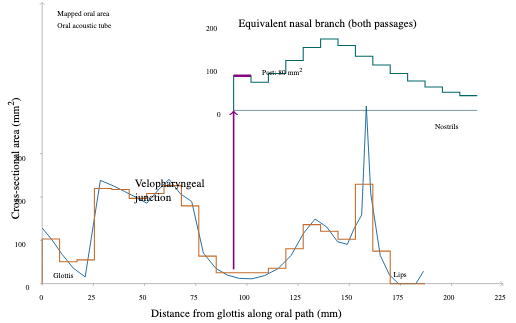
论文图 3。原论文 Figure 3::“Area functions for the bilabial nasal /m/ with the velum lowered to open the nasal port.”。
像素上口腔曲线在唇端归零,鼻支路基线被上移显示但用同样面积刻度,端口标 80 mm²。箭头只表示连通,不表示单向流动。鼻轮廓横轴从耦合点起算,不能当成口腔轴的解剖延长。口腔闭合而鼻端口开放时,气流可以经鼻流出,这正是后文区分鼻音与口塞音的几何基础。
气流压力网络算什么
气动是集总准稳态流网加一个动态储压状态。肺控制给出声门下压,范围约 0 到 981 Pa。声门面积由激励模型给定。声门流入用带流量系数的孔口关系,系数取 0.8,只写前向流,不写反向流。有效入口压取储存压力与声入口负载平滑估计中较大者,并限在零到肺压之间,两者不做独立平均压相加。
每条流路有线性黏性阻力和二次损失。线性项对圆等效截面求和,二次项每条流路只用最窄处算一次,避免把跨多段的同一收缩算成多个独立射流。论文强调这只是等效阻性负载,不是分辨分离流和湍流耗散。完全闭合的支路阻力无穷大、流出为零。声门流入与流出的关系写作容积守恒加柔量,柔量由连通容积、密度和声速定,不含管壁柔量。
\[U_{g}=C_{d}A_{g}\sqrt{\frac{2[P_{s}-P_{\mathrm{in}}]_{+}}{\rho}},\qquad[x]_{+}=\max(x,0),\]实现用后向欧拉加单调压力搜索推进,一句话的压力在走完一个 5 ms 控制帧后传给下 1 帧,而较长声学响应尾端的压力不用于传递,避免气动状态被推进超过 1 帧。
\[C\frac{dP}{dt}=U_{g}-U_{o}-U_{n},\]开放鼻端口时,咽部共路串联口鼻并联支路,用数值求解使支路流量与共路压降一致,于是口腔闭合而声门仍可经鼻流出。口鼻同闭则口内压累积。噪声驱动用的压力流量是暖机后在当前响应仿真内的平均,且口腔摩擦暂用声门流量代指经口腔收缩的流量,有鼻分流时这个代指会变间接。
声门流入 × 储存压力 × 声行波: 声门流入是由肺压和声门面积决定的进气,储存压力是连通容积里缓慢累积和释放的平均压力,声行波是管内来回反射的快速传播量。前两者通过集总流网耦合,后者单独算共振,分开处理既能表现塞音闭合期口内压升高,又不把缓慢充气和共振混成同一个压力。
三类声源各自如何构造
声门激励是受控面积脉冲,分张开与闭合两段,余弦过渡连接静息面积与峰面积。张开商、闭合占比、肺压和声门开度定标称脉冲,默认闭合占比 0.10。口上压力可减小行程,必要时把闭合延入标称闭合段,但不加速张开,这是唯象调整。每帧的标称脉冲、肺压、入口负载和声管一起产生辐射脉冲响应,它已含建模的声门激励和非线性流关系,不同于线性滤波器的单位冲激响应。
浊擦音用无量纲参数 Q 把部分声门行程转为常开。Q 为 0 不加常开,Q 为 1 则恒为峰面积且不再周期插入脉冲,这个端点不是闭合声门。默认 Q 为 0.3,跟随浊收缩手势组。CT 到频率的标定是从 CT 500 时 80 Hz 到 CT 1000 时 200 Hz 线性变化,并延续到 CT 1300,只是控制约定。
口腔摩擦在本文连续模式下只要口腔通路开放且有气动驱动就有源,不需要擦音标签或释放事件。最窄段只用于闭合检测,完全闭合无源。开放几何的附加收缩面积门控被置 1。驱动律是启发式的,用暖机后平均声门流量绝对值乘平均正压,系数吸收单位量纲,不是实测湍流强度或雷诺数判据。声学上主体是与收缩或下游障碍相关的串联压力偶极子,在背擦位形可加体积速度单极子,两者用独立噪声流。
\[a_{o}=K_{o}\,\overline{|U_{g}|}\,\overline{[p_{t}]_{+}}.\]其中横线表示暖机后平均。频谱另由唇、舌尖、舌背源描述加经验修正,几何描述子可在前后向标定间插值。另有区域总增益、浊擦增益、清塞语境摩擦增益,后者当前所有口腔区取 20,只改幅度不改气动激活条件,还有核增益补偿保留频谱比而缩小有效传递增益差异。
声门送气在声门处产生、经自有辐射响应滤波,噪声流独立于口腔偶极子。驱动含声门开度包络、平均流量和肺压与口内压差,开度包络只在约 0.05 到 0.30 范围平滑开关,并受压力与闭合抑制,不是仅靠释放标志触发。清塞音释放后对已存在的送气再乘 20,不增帧数不改包络。浊擦连续噪声按基音周期做幅度调制,默认深度 1、残余 0.1,最大在张开相中部,相位与脉冲插入共用同一脉冲时刻,随机载波本身不逐周期重复。另有浊擦默认降频 1.5 半音,属于经验控制。
发音激励 × 口腔摩擦 × 声门送气: 发音激励是在声门脉冲时刻插入的带有声门运动的脉冲响应,口腔摩擦是以口腔窄处气动量驱动的连续偶极子噪声,声门送气是在声门处产生再经声道滤波的连续噪声。三者用独立随机流和独立辐射核分别合成再相加,才能在波形重叠处仍分清短释放噪声和随后的送气段。
没有神经网络训练时实际算了什么
本文没有训练神经网络,也没有学权重。所谓学习是指未来神经模型用这个发音厂做咿呀、模仿和早期词学习,本文只提供可检查的生产厂。实际计算是规则与仿真:手势配时生成轨迹,几何变面积变声管,流网推进压力流量,声管算脉冲与噪声核,最后叠加成波形。
需要指出的缺口是多处经验校准。声源频谱修正、区域增益、Q、降频半音数、释放后送气增益等是听音调出来的,不是只从流体力学推导的。论文明确区分模型计算与经验调参,并提醒好听不等于压力流量和源幅度的生理准确。复现时应把这些增益当作待标定参数,而不是物理预言。
随机部分用伪随机流、可复现种子,跨帧保持连续。声管核按帧选择,标量幅度和部分滤波参数在相邻控制值间插值,完整核不做连续变形。采样率转换也分两路:脉冲与送气核用线性转换,口腔噪声核用带限窗 sinc 加零延拓并保留尾部时偏,这是实现的数值特征,解释频谱时要考虑。
三个德语词的展示条件是什么
例子是 Tasse /tas@/、Muse /mu:z@/、Lade /la:d@/,均为首音节重读、末尾非重读 schwa。合起来覆盖短长元音、鼻、边、清浊擦音、清浊塞音过渡,但论文说明这只是取样,不构成德语全音位穷举。
每张总览图共用同一时间轴:上五层是元音、辅音、软脂、声门、肺压 CT 控制,浅绿包络加虚线是实际手势激活及起止斜坡,显示高度经缩放。中层是 3 类源的绝对 RMS 幅度,用互不重叠的 5 ms 窗计算。再下是声门面积与流量、声门下压与口内压,底部为辐射浮点输出。竖线是预设音段时间线参考边界,不是独立声学测量的边界,更不是手势边界。
为让比较公平,三词用同一套显示与合成增益。源 RMS 显示倍数固定为浊音 1、摩擦 6、送气 5,不做按源或按词峰值归一化,幅度是任意输出单位,不是标定声压。Tasse 的初始舌尖闭合手势被提前 25 ms 而释放时刻保留,使肺压上升前声道已闭合,去掉过早的初始辐射瞬态。
下表整理时间与声学离散的关键实现约定,比较问题是控制更新多快、声传播多细、单次响应拖多长、最终输出采样多高。复现时用同一套网格,否则拖尾重叠和共振位置会对不上。
| 条件 | 数值 |
|---|---|
| 声管段长与内部采样率 | 8.5 mm,40 kHz |
| 标准声学响应时长 | 25.6 ms,对应 40 kHz 下 1024 样点 |
| 内部仿真与标准输出采样率 | 40 kHz,16 kHz |
25.6 ms 只是有限保留的尾长,脉冲仿真另有 100 样点 2.5 ms 暖机并丢弃,压力状态只按 5 ms 帧传递。冻结几何近似意味着已发出的响应保留旧几何,新响应才用新几何,波与后续运动的相互作用被略去,快速发音变化下的伪影需另查。本表数值与单位依据论文 PDF。
元音鼻音边音里看到什么协调
元音段重复声门流量脉冲伴随浊音主导辐射,声道位形缓慢演变。短/a/、长/a:/与圆唇/u:/的高度、前后、圆唇轨迹不同,向 schwa 过渡时回到分化较弱的目标而浊音延续。论文提醒时域图只展示源活动与波形结构,不直接量化共振峰或频谱精度,长短时长的差异由手势定时给定,图只是实现展示。
/m/把唇闭合、软腭下降与发音结合,鼻支路开放允许流出,唇闭合也不等于声门流与声输出停止。到/u:/过渡时唇释放加软腭抬起配圆唇位形。/l/用有效旁路面积代表左右通道之和,舌尖收缩与旁路共存,浊音成分延续进入/a:/而无完全口塞停顿。论文强调这是有效开口用法,不分辨两条边通道。
下面先看 Tasse 全貌,观察任务是从上往下跟同一时间轴,区分/t/闭合期口内压升高与/s/段摩擦源升高的先后,并注意源 RMS 显示倍数不同。
看图路径: 1. 从上往下跟五层控制、源 RMS、声门面积与流量、压力、合成波的同一时间轴;2. 区分/t/闭合期口内压升高与/s/段摩擦源升高的先后;3. 注意源 RMS 三条曲线的显示倍数不同,不代表绝对声压比
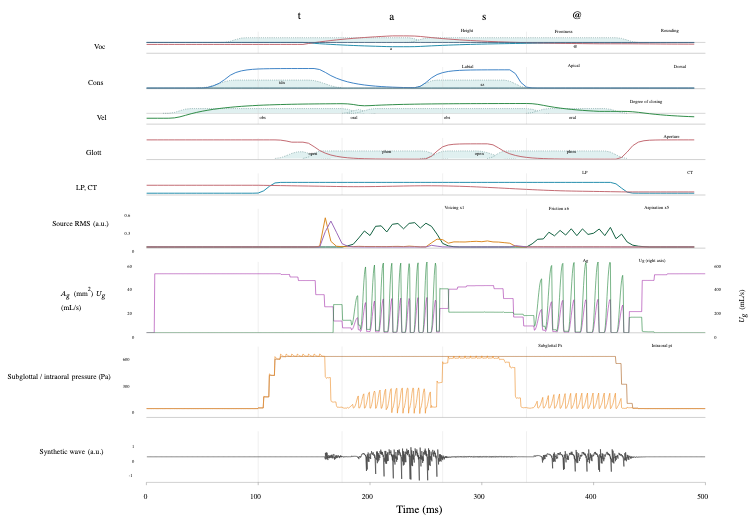
论文图 4。原论文 Figure 4::“Tasse /tas@/. The initial apical gesture reaches its target 25 ms earlier with the release time retained, placing closure before pulmonary pressure onset.”。
像素上/t/段声门面积低而压力高,摩擦与送气先后出现小峰,元音段流量脉冲整齐、浊音 RMS 呈山形。/s/段浊音被抑制而摩擦升高,尾部 schwa 浊音回升但幅度小。竖线只是参考边界,手势包络明显跨线重叠。面积和流量是从声门脉冲时刻关联的响应重建的,压力用连续控制帧,底排是量化前浮点输出。
手势激活区间 × 音段参考边界: 手势激活区间是每个发音、软腭、声门手势各自的起始、建立、保持和衰减时间,可以跨音段重叠,音段参考边界是为组织预期声音序列而设的竖线时刻。声学转折是多个手势加气动声学状态的共同后果,不必与任一手势开关对齐,看图时不能把竖线当成所有发音器同时切换的开关。
擦音塞音的清浊对照说明什么
清/s/是舌尖收窄加声门张开,源面板以口腔摩擦为主、浊音被抑制。浊/z/是口腔摩擦叠加延续浊音激励,收缩同时改变压力与声门流量迹。RMS 面板只是 5 ms 窗源强度总结,不是周期分辨的调制证明,也不度量噪声频谱,/z/摩擦可见不依赖自身峰值归一化。
Lade 的/l/与/a:/提供浊延续背景,/d/在元音间做浊塞:舌尖闭合致压力累积、声门流量与辐射浊音幅度明显下降,但发音控制手势仍在持续,释放后流量与元音激励恢复,且无实质送气成分。这与/t/的闭合加肺压协同、开放后短噪声加送气形成对照,对比点是声门控制、压力与释放的配合,而不只是有无闭合标记。观察任务是看/l/段浊音延续,看/d/闭合期流量被压低而手势仍在,并对比释放后送气有无。
看图路径: 1. 看/l/段浊音延续而无完全闭塞停顿的包络;2. 看/d/闭合期流量与浊音幅度下降而声门手势仍在持续;3. 对比释放后有无明显送气成分,与/t/的例子形成对照
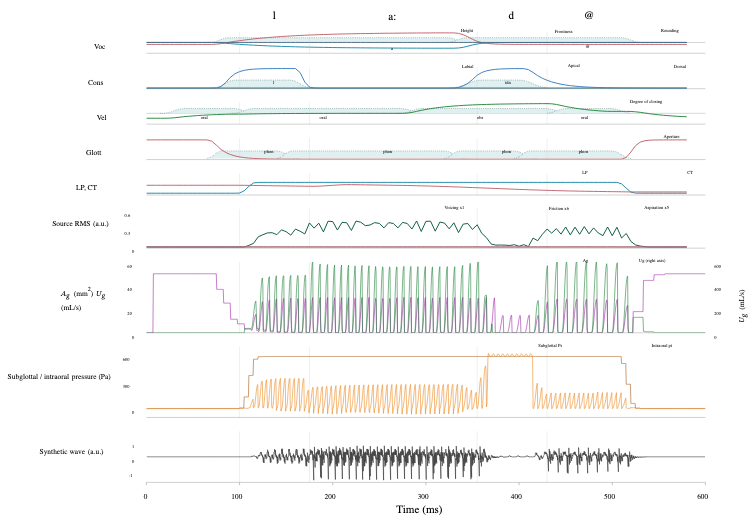
论文图 5。原论文 Figure 5::“Lade /la:d@/. The five upper tiers show vocalic, consonantal, velar, glottal, and pulmonary/CT control.”。
像素上/d/闭合期流量包络被压低、压力高台延续约数十毫秒,释放后浊音 RMS 迅速回升而摩擦送气几乎贴基线,这与/t/释放后可见的送气峰不同。Lade 残余口腔噪声即使经 6 倍显示仍贴近基线,说明没有为让它可见而做按源归一化。Muse 的/z/例子与此互补,浊音延续而摩擦叠加,压力流量迹同时变化。
下表整理声源侧的经验参数,比较问题是哪些数是听音调出来的、默认值多少、作用是改幅度还是改定时。表中增益只改幅度不改气动激活条件,Q 端点与调制开关改变的是是否周期插入与包络形状,CT 到频率只是控制约定。
| 参数 | 取值 |
|---|---|
| 声门脉冲闭合占比默认 | 0.10 |
| 浊擦 Q 默认与可调范围 | 0.3,0 到 1 |
| CT 到频率标定 | CT 500 时 80 Hz 到 CT 1000 时 200 Hz,延续到 CT 1300 |
| 源 RMS 显示倍数浊音摩擦送气 | 1,6,5 |
| 清塞释放后附加送气增益 | 20 |
这些取值的限制在于增益只改变已有噪声的幅度,清塞摩擦增益 20 与释放后送气增益 20 共享全口腔部位。浊擦调制默认深度 1 残余 0.1、最大在张开相中部,降频 1.5 半音用不对称时间常数实现渐入渐出,改后浊音重复与噪声包络会一起变慢或变深,但随机载波仍随机。本表数值与单位依据论文 PDF。
声质量结论在什么条件下才成立
论文没有正式评估。作者经反复听音与中间量检查调参,目标是各类声音可辨认,不是高自然度。作者自述元音已很好、鼻边音满意,擦音噪声是主要待修项,频谱平衡与自然度需额外标定和与自然语音系统比较。这些是开发状态描述,不是独立听辨或自然度打分的比较结论。
物理近似也要按原文记牢。声门运动给定而非自振荡,基频由 CT 给定。声响应用帧冻结几何,不传波状态。口腔摩擦驱动用总结压力与声门流量而非分辨的局部射流。持续时间由开放声道中的气动驱动决定,不另加强制最小时长或收缩面积门。最终波形含 1 m 参考观测距离的线性辐射约定,但叠加播放与源增益意味着导出波形不是绝对声压标定。
发育讨论引的裂腭婴儿研究只支持发音结果影响感觉运动经验的假设,不分离解剖为唯一原因,也不意味着一般神经学习损伤,更不等于本模型已能仿真裂腭。植物、内正向模型、学习脑模型要分开:DYNARTmo 是被控制器作用的植物,提供动作到几何气声的显式环境,接触位置起止时长与下颌高度等感觉信号是未来扩展,接触强度还需另加力学模型或代理。
复现第一步做什么去哪里找什么
先按附带指南在应用里用规则流程生成 3 个词,而不是加载自然录音或存档时间线。输入为’ta.s@#、‘mu:.z@#、’la:.d@#,撇号表重读,点分音节,冒号延长前段,@表 schwa,#表陈述语调,回车确认后在 Values 下启用合成,在 Sound 下计算播放。注意 Tasse 图另把初始/t/目标相提前 25 ms 而保留释放时刻,该编辑不在转录串里。
数值复现用随文 Python 参考包 0.1.0,它只含单几何波导与分支平均流模型、参数单位、示例几何与数值夹具,不含应用界面、手势编排、拟合流程、标定噪声源与话语级叠加,因此不能直接合成完整词。论文报告 9 个气动与 15 个声学情形共 255048 个标量比较,在绝对容差 1e-12 或相对容差 1e-9 取宽者内一致,这只是数值一致,不是物理或听觉验证。
版本基线要对齐。论文底层是 Speech Articulation Trainer 5.2.0,参考包用源码哈希标定 Dart 基线并给出重复比较说明。应用初现发音模式,+Synthesis 与+Natural 按钮耦合,启用不要求加载自然参考。自然录音、对齐音段线、手势乐谱文件与合成词 WAV 不在附件里,模型部件复现、应用内词演示、未来模仿拟合实验是三件不同的事。
本次收到的第三方应用链接经检查当前可达,但这只证明论文提到该链接可用,不证明作者已开源全部合成系统。Python 包另按非商业许可授权,不在文章 CC BY 4.0 覆盖内。来源未确认或暂时不可达不算技术缺陷,复现仍以版本号与哈希为准。
什么时候值得尝试还缺哪项验证
当研究问题需要把动作、几何、压力流量、声源分开检查时值得尝试,例如讲清鼻音为何唇闭仍有声、边音为何无完全堵塞、清浊塞释放后为何一个有送气一个几乎没有。这时可用同一套 5 ms 网格、40 kHz 内部仿真、25.6 ms 响应与三源独立核的叠加框架,配合固定显示倍数做跨词对比。
当目标是高自然度合成或跨说话人泛化时要谨慎。擦音自然度待修、声源多处经验校准、冻结几何略去波与运动相互作用、无独立听辨与声学分析,这些都意味着好听的个例不能推广为生理准确或系统级质量。复现第一步是先跑通单几何数值夹具,再在应用里按规则生成三词并核对压力流量与源 RMS 的相对时序,而不是先调增益追自然度。
还缺的验证很明确:独立声音辨认与自然度评分、跨语境声学分析、更多几何压力流量的直接推导以减少辅助幅度修正,以及学习闭环所需的接触与本体感觉信号扩展。只有补上这些,才能判断该发音厂给未来咿呀模仿学习提供的经验是否足够逼真。
📎 论文与评分元数据
排名:后50% | 文档类型:系统技术报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses