📄 长聆听思考:用细致感知与反思式推理改进音频推理
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Jaeyeon Kim:Carnegie Mellon University
- Chao-Han Huck Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Luoyi Zhang:Carnegie Mellon University
- Chan-Jan Hsu:Carnegie Mellon University
- Fernando Ruiloba Portilla:Carnegie Mellon University
- Jinchuan Tian:Carnegie Mellon University
- Shinji Watanabe:Carnegie Mellon University
- Carlos Busso:Carnegie Mellon University
📌 核心摘要
读者需要理解的对象是大型音频语言模型在回答语音、声音事件和音乐混合问题时的推理过程,困难在于模型常听错细粒度声学细节与时间结构,而已有训练数据只提供粗糙事件标签或模型自产描述。处理过程是为每段音频构建更稠密的多方面描述,再围绕该描述改写更难的问题、合成似真但错误的短推理,并把短推理延续为包含核查与回溯的长推理。第一步用专用字幕模型、语谱图加视觉语言模型与语音、说话人、事件、音乐结构工具分别产出语义、声学和时间信息并拼接。第二步由指令模型 Qwen3-Next-80B-Instruct 生成更依赖细听与多步推理的问题并校验可解性。第三步合成保留格式但误读细节的错误痕迹。第四步由推理模型 Qwen3-Next-80B-Thinking 在认知触发词后延续思考并经校验保留正确结尾,与直接蒸馏长思考相比,该延续方式保留原始痕迹并追加聚焦的修正,避免冗长复述描述。在 Qwen2.5-Omni-7B 上经监督微调加直接偏好优化后,MMAU Test-mini 准确率从 71.5% 提升到 78.2%,结论适用于 30 秒内公开研究音频与同类问答基准,向更长录音与未覆盖领域的迁移只做小规模验证,原文披露训练使用单节点 8 块 NVIDIA H100,监督微调 5 轮、偏好优化 3 轮,未披露推理延迟与部署成本。
🔗 开源与复现资源
第三方资源:https://jaeyeonkim99.github.io/llt → https://jaeyeonkim99.github.io/llt/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/QwenLM/Qwen2.5-Omni — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-Next-80B-A3B-Instruct — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-Next-80B-A3B-Thinking — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-Omni-30B-A3B-Captioner — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-VL-32B-Instruct — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-32B — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen2-Audio-7B-Instruct — 暂时无法访问
第三方资源:https://huggingface.co/Qwen/Qwen3-Omni-30B-A3B-Instruct — 暂时无法访问
第三方资源:https://github.com/SYSTRAN/faster-whisper — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
音频推理要听什么、答什么
这篇论文处理的是音频语言模型的音频问答与推理。输入是一段最长 30 秒的音频,加上一个问题,可能是选择题,也可能是简答。模型要先听,再写出推理过程,最后把答案放在指定标签里。输出既包括答案是否正确,也包括推理是否真的 grounded 在声音上。
对刚入门的同学,关键是区分两类错误。感知错误是根本没听准,比如把过山车轨道的金属摩擦听成水花飞溅,把哭声的谐波结构听成歌声。推理错误是听准了但推错了,比如知道有鼓和贝斯却判断错谁是节奏基础。论文引用的基准分析指出,在现有音频理解基准上,感知错误占失败的大头,其次才是推理错误。这意味着只教模型更会讲道理不够,还要给它更细、更多样的听觉证据。
已有做法为什么感知依据不够
已有音频推理训练大致分两路。一路是构造思维链数据做监督微调,另一路是在问答数据上做在线强化学习,常用的是分组相对策略优化。论文把自己定位在上游的监督微调阶段,目标是先装好感知 grounding 和认知行为,之后仍可接强化学习。
论文认为已有思维链数据的听觉依据太窄:要么用音频语言模型自己生成的描述,而这类模型本身对低层声学属性和精细时间结构就不敏感;要么用数据集自带的粗标签,比如 AudioSet 的事件词,信息量有限。唯一的例外是聚合多模型分析的工作,但用的仍是高层语义为主的描述,声学与时间维度重叠较多。与此同时,视觉推理中已被证明有效的验证和回溯等认知行为,在音频里还没有系统做法。论文要补的就是这两块。
论文要解决的具体困难是什么
困难有两层。第一,训练数据的感知侧太薄,模型推理时没有可用的细粒度线索,只能凭高层事件词猜。第二,即使给了长推理,也缺少显式的检查修正结构,模型不会在写完初步判断后停下来重新听、推翻自己。
音频问答 × 短推理轨迹: 音频问答指听一段音频后回答选择或开放问题,需要同时听准和想对;短推理轨迹指模型在给出答案前写的几句中间推理,它把听到的证据和推断步骤显式写出来,本文后续的加长、改错都围绕它展开。
论文不从零采集新音频,而是复用已有的音频思维链数据集 AF-Think,在每个样本上做 enrichment。原文记一个源样本为音频、问题、正确短推理、正确答案四元组,后续阶段逐步挂上稠密描述、难题、错误轨迹和长轨迹。这样做的好处是可扩展且与已有数据兼容,风险是源数据的领域分布和 30 秒时长限制会继承下来。
四阶段管线如何分工
整个管线沿着一个样本走。起点是音频加原始问答加短正确推理。第一阶段只看音频,产出稠密描述。第二阶段看描述加原题,产出更难的新题及其推理答案。第三阶段看问题加正确推理加描述,产出一条长度格式相近但听错细节的错误短推理。
第四阶段把正确或错误短推理作为前缀,用推理模型续写一段带认知行为的延续,形成长推理。训练时再把 3 类轨迹分给监督微调和偏好优化。
下面这张总览图把 4 个阶段的输入输出和模型分工画了出来,适合先建立整体位置感,再逐段细读。
看图路径: 1. 先从左到右看音频问答如何进入专用模型得到三块描述;2. 看指令模型如何分出难题分支与错误轨迹分支;3. 看右侧推理模型如何把短轨迹接成长期待修正的长轨迹

论文图 1。原论文 Figure 1::“Overview of the proposed Long Listening Thoughts pipeline.”。
从图中可以看到,左侧是音频问答与短思维链进入专用模型,中部三块语义、声学、时间描述汇入指令模型,分别走向难题生成和错误轨迹生成,最右侧推理模型负责把短轨迹接成包含再听一遍等行为的长轨迹。这种分支后再汇合的设计,让感知证据只在构造数据时使用,训练好的音频模型推理时仍需自己从波形中听。
稠密描述的三块信息从哪里来
第一阶段要为每段音频拼出一份多方面描述。语义部分用 Qwen3-Omni-Captioner 生成事件级浓缩描述,讲场景和内容。声学部分不直接问音频模型,而是把频谱图画出来,带上坐标网格和刻度,再用视觉语言模型 Qwen3-VL-32B 按频率、幅度、音色、持续、起止、谐波、混响等字段描述。论文称显式给出网格与解读指南能明显提高数值 grounding 的质量,并举例说直接问音频模型会编造调性速度,而看谱图能说出能量集中频段和周期性条纹。
语义信息 × 声学信息 × 时间信息: 语义信息回答听到了什么事件和场景,声学信息回答声音本身的质地如频率分布、时长、音色和混响,时间信息回答何时发生与如何衔接如语音起止、说话人轮替和音乐结构,三者互补后才能支撑需要细听的推理。
时间部分用一批专用小模型拼时间线:Whisper-large-v3 给语音段时间戳,pyannote 做说话人切分,基于 BEATs 的声音事件检测用 0.2 和 0.5 两个阈值分别抓显著和微弱事件,对检出含音乐的片段再跑 allin1 做段落结构和 autochord 做和弦识别。最后把三块文本拼成稠密描述,供后 3 个阶段使用,但不直接作为音频模型的输入。
难题、错误轨迹和长延续怎么写出来
第二阶段用指令模型 Qwen3-Next-80B-Instruct 改写问题。要求保留原题型和考察技能,但更贴近声音或多一步组合推理。论文举例把总结建议改成靠语调区分绝望失败与更大成功,把说话人主张改成从讽刺回应推断态度。生成后还要用同一指令模型对照稠密描述校验三项:能否仅靠听音频解出、答案是否正确、推理是否合逻辑。在 10000 条 AF-Think 样本上,Qwen2.5-Omni-7B 的准确率从原题的 72.5% 掉到难题的 63.0%,说明难度确实上升。
第三阶段合成错误短推理。论文不用被训练模型自己采样,理由是采样不稳定、错误多样性差、且绑定单一模型的失败分布。做法是给指令模型看问题、正确推理、正确答案和稠密描述,要求保持长度格式相近,编一条因听错细粒度细节而走向错误选项的推理。原题和难题都做这一步。
思维延续 × 思维扩展: 思维扩展指让大推理模型从头重写一条很长的思考,容易复述描述文本又冗长发散;思维延续指保留原短推理不动,只在其后接一段用听觉触发词引导的继续思考,迫使模型紧扣原推理做检查和修正,更简洁且适合训练音频模型。
第四阶段是思维延续。给定前缀加触发词如 Wait、Hmm、Let me listen again 等,推理模型 Qwen3-Next-80B-Thinking 在 think 块内打草稿,在 answer 块输出延续,保持前缀不动并追加修正,最终要落到正确答案。对正确前缀形成正确到精炼,对错误前缀形成错误到纠正。生成后同样校验答案正确、逻辑成立、格式合规,提及描述文本或标签混乱的按轻重修复或丢弃。
三类轨迹如何分给两段训练
管线产出 3 类轨迹:短正确、正确到精炼、错误到纠正。论文的关键发现是,若把含错误中间步骤的第 3 类直接放进监督微调,模型分不清中间错与最终对,反而掉点。但若完全不用它,验证回溯等行为又学不出来。于是采用两段式:监督微调只用短正确和正确到精炼,打牢感知 grounding 和精炼推理;偏好优化再用错误到纠正构造偏好对,教模型偏好能纠错的轨迹。
正确到精炼轨迹 × 错误到纠正轨迹: 正确到精炼轨迹是从本来正确的短推理出发继续验证和补充细节,错误到纠正轨迹是从一条看似合理但听错的短推理出发先承认偏差再重新听辨并改到正确答案,前者教模型把对的想得更扎实,后者教模型发现并修正听错。
偏好对有 3 种:短正确胜过短错误,正确到精炼胜过短错误,错误到纠正胜过短错误。最后一种是核心,它明确奖励认错并改对的完整过程,而不是只奖励答案对。
监督微调 × 直接偏好优化: 监督微调是让模型模仿正确的短推理和正确到精炼的长推理,学会按格式写出有感知依据的思考;直接偏好优化是不再直接模仿含错中间步骤的轨迹,而是让模型在成对比较中更偏好能纠错的完整轨迹,从而把验证回溯行为装进去又不污染模仿目标。
偏好优化的目标是增大偏好回答相对非偏好回答的似然优势,同时用参考策略做正则,原文给出如下目标:
\[\mathcal{J}_{\mathrm{DPO}}(\theta)=\mathbb{E}_{(q,o_{w},o_{l})\sim\mathcal{D}}\left[\log\sigma\!\left(\beta\log\frac{\pi_{\theta}(o_{w}\mid q)}{\pi_{\mathrm{ref}}(o_{w}\mid q)}-\beta\log\frac{\pi_{\theta}(o_{l}\mid q)}{\pi_{\mathrm{ref}}(o_{l}\mid q)}\right)\right].\]这里 q 是问题加音频的输入,ow 是偏好的长轨迹,ol 是不偏好的错误轨迹,pi_theta 是正在学的策略,pi_ref 是监督微调后的参考策略,beta 控制偏离参考的惩罚。实现上 DPO 学习率 5e-7、3 轮、批量 256、beta 取 0.2,并以权重 1.0 保留监督损失以稳定训练。监督微调是全量更新大模型、音频编码器和投影层,学习率 6e-6、5 轮。数据规模上,338k 音频、654k 问答对含 316k 难题,推理轨迹共约 1,600,000 条,其中监督用 1,160,000 条,偏好对用 60,000 条即每种 20,000 条。
在什么数据和评测条件下验证
主干实验以 Qwen2.5-Omni-7B 为基座,这也是多数近期音频推理工作的公共底座。评测用 3 个通用基准:MMAU Test-mini 考语音、声音、音乐的信息抽取与推理,MMAR 考更复杂的多步推理,MMSU 侧重语音的感知与推理。答案从 answer 标签中抽取,MMAU 与 MMAR 用字符串匹配,MMSU 用字母匹配,并固定了版本号以保证可比。
除主结果外,论文还做了专用维度的检查:WoW-Bench 考低层声学属性,TREA 考时间推理,MMAU-Pro 含平均约 2 分钟、最长 10 分钟的长音频,MedMosaic 医疗子集和海洋哺乳动物声学基准考跨领域迁移。另有消融对比思维延续与思维扩展、合成错误与采样错误的来源、偏好对组成,以及换 AudioMCQ 数据源、换 Qwen2-Audio 和 Qwen3-Omni 底座的泛化实验。
稠密描述与主结果带来了什么
先看描述本身是否有用。论文把不同丰富的文本描述喂给纯文本推理模型 Qwen3-32B,只看文字答题。在通用基准和专用基准上,从语义出发,加入声学和时间信息后总体改善,且声学增益对应 WoW,时间增益对应 TREA。这说明三块信息不是重复堆料,而是各自补上了推理需要的证据。
下图展示了这种随描述丰富度总体改善的趋势,是理解后续数据构造有效性的前提。
看图路径: 1. 对比每组柱子中语义、加声学、再加时间的高度变化;2. 注意 WoW 与 TREA 两组专用基准的提升幅度;3. 看最右侧平均组是否随信息增多而单调上升
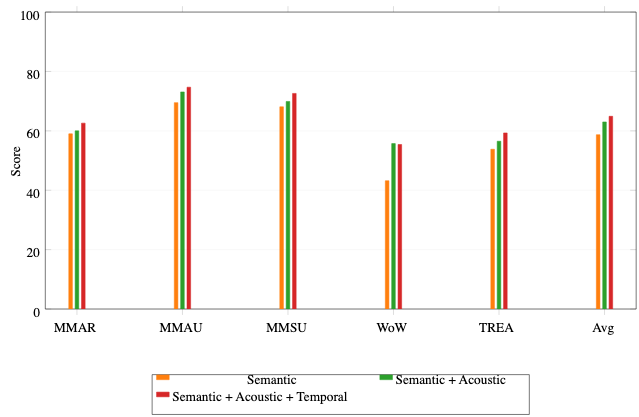
论文图 2。原论文 Figure 2::“Accuracy of an LLM across different benchmarks using different types of audio descriptions.”。
图中可见,从左到右 MMAR、MMAU、MMSU、WoW、TREA 与平均组,橙色语义基线最低,加声学后提高,继续加时间多数分组更高,但 WoW 绿色与红色基本持平,专用基准上的跳变更大,表明细粒度感知线索确实能被文本推理利用。
论文在主基座 Qwen2.5-Omni-7B 上报告 LLT 两段训练后,在 MMAU Test-mini 上从 71.5 到 78.2,在 MMAR 上从 56.7 到 63.7,在 MMSU 上从 60.6 到 66.0,再在 AVQA 上做规则奖励的 GRPO 后达到 78.7、64.9、65.3。为检验这种增益是否只对主基座有效,下表比较了另外两个基座在加入 LLT 推理轨迹做监督微调前后的成绩。
| Method | MMAU Test-mini | MMAR | MMSU |
|---|---|---|---|
| Qwen2-Audio-Instruct | 59.6 | 30.0 | 53.3 |
| + LLT SFT | 67.8 | 53.8 | 59.0 |
| Qwen3-Omni-Instruct | 77.5 | 66.9 | 69.0 |
| + LLT SFT | 79.6 | 67.9 | 71.6 |
该表以 MMAU Test-mini、MMAR、MMSU 为列,行为不同基座及其加 LLT 微调的变体,数值越大越好。Qwen2-Audio-Instruct 从 59.6、30.0、53.3 提升到 67.8、53.8、59.0,Qwen3-Omni-Instruct 从 77.5、66.9、69.0 提升到 79.6、67.9、71.6。这说明同一批短正确与正确到精炼轨迹换基座仍能带来一致提升,但该表只覆盖监督微调,未比较两段式中偏好优化的作用,绝对值也受基座版本和评测版本影响。
认知行为的变化见下图,模型不仅答对更多,而且更常显式验证和拆分子目标。
看图路径: 1. 看上方面板四种认知行为在四种训练设置下的均值高低;2. 看下面板回答长度分布从窄峰到宽分布的变化;3. 注意验证与子目标设定两组柱子的差异最大

论文图 3。原论文 Figure 3::“Cognitive analysis of model responses on MMAR. (a) Mean occurrence of different cognitive behaviors (b) Distribution of response length (number of words).”。
上方面板可见验证、回溯、子目标设定、反向链 4 类行为的平均次数,从仅用短推理的蓝色基线,到加入正确到精炼的橙色,再到加入错误到纠正的绿色与红色的两段式总体增加,但回溯并非单调上升,其中验证从 0.080 升到 0.851,子目标设定从 0.337 升到 1.479。下面板显示回答长度分布从 100 词内的窄峰变为延伸到 300 词的宽分布,说明长思考确实被启用。
论文还统计了含触发词的 1132 条回答中触发前后的翻转:错改对 99 条占 8.7%,对改错 56 条占 4.9%,净纠正 3.8 个百分点,且触发子集本身更难。这些支持反思不只是表面话术,但也提示仍有约 5% 的过度修正风险。
定性例子进一步展示了先误判水声再靠金属机械声推翻自己的过程。
看图路径: 1. 先看题目问游乐设施类型与四个选项;2. 对比红色框直接选水上设施与绿色框先假设再推翻的过程;3. 注意绿色框中重新听辨机械声与否定水声的关键句

论文图 4。原论文 Figure 4::“Qualitative comparison of responses from Qwen2.5-Omni-7B trained with AF-Think and with the proposed LLT on the same question.”。
图中上半是频谱图与游乐设施四选项,下半红色框模型听到电机加水花加尖叫就选原木漂流,绿色框 LLT 模型先同样想到水上设施,随后用再仔细听引导出深沉轰鸣、高频尖叫与金属卡嗒声,否定水声并改选过山车。这个例子对应了错误到纠正轨迹教给模型的先保留初判再用听觉证据修正的写法。
错误轨迹放哪里、偏好对怎么配
下表比较了只用短正确、再加正确到精炼、再加错误到纠正 3 种监督设置,分别在 5 万问答小规模与全量规模下训练,是理解两段式动机的直接证据。
| Method | MMAU Test-mini | MMAR | MMSU |
|---|---|---|---|
| SFT with 50k QA Pairs | SFT with 50k QA Pairs | SFT with 50k QA Pairs | SFT with 50k QA Pairs |
| AF-Think (r+) | 74.1 | 58.8 | 63.4 |
| LLT (r+, r+→r++) | 75.7 | 61.1 | 64.0 |
| LLT (r+, r+→r++, r-→r++) | 74.6 | 60.2 | 63.3 |
| SFT with Full Reasoning Traces | SFT with Full Reasoning Traces | SFT with Full Reasoning Traces | SFT with Full Reasoning Traces |
| AF-Think (r+) | 73.9 | 59.9 | 63.7 |
| LLT (r+, r+→r++) | 76.3 | 62.2 | 65.0 |
| LLT (r+, r+→r++, r-→r++) | 75.8 | 61.4 | 64.1 |
| Two-Stage Training | Two-Stage Training | Two-Stage Training | Two-Stage Training |
| LLT (SFT→DPO) | 78.2 (+1.9) | 63.7 (+1.5) | 66.0 (+1.0) |
这张表要回答错误中间步骤是否适合直接模仿,条件是同底座同评测,指标越大越好。加正确到精炼最好,再加错误到纠正反而在小规模掉点更明显,如从 75.7 到 74.6,全量时差距缩小但仍未反超。这支持论文把错误到纠正留给偏好阶段的判断,代价是需要额外构造 6 万偏好对。
下表进一步拆了错误来源、偏好对组成与换数据源 3 个正交问题,比较条件是同底座 Qwen2.5-Omni 在 MMAU Test-mini、MMAR 和 MMSU 上的准确率。
| Setting | MMAU Test-mini | MMAR | MMSU |
|---|---|---|---|
| Qwen2.5-Omni baseline | 71.5 | 56.7 | 60.6 |
| Stage 3: Source of Incorrect Traces | Stage 3: Source of Incorrect Traces | Stage 3: Source of Incorrect Traces | Stage 3: Source of Incorrect Traces |
| SFT on 50k QA Pairs | SFT on 50k QA Pairs | SFT on 50k QA Pairs | SFT on 50k QA Pairs |
| From base LALM | 72.9 | 58.3 | 64.4 |
| From Minstruct | 74.6 | 60.2 | 63.3 |
| Two-Stage Training | Two-Stage Training | Two-Stage Training | Two-Stage Training |
| From base LALM | 77.9 | 63.7 | 65.8 |
| From Minstruct | 78.2 | 63.7 | 66.0 |
| DPO Pair Composition | DPO Pair Composition | DPO Pair Composition | DPO Pair Composition |
| LLT (SFT→DPO, full) | 78.2 | 63.7 | 66.0 |
| -(r-→r++≻r-) | 78.3 | 62.2 | 64.4 |
| +(r+≻r+→r++) | 78.4 | 62.4 | 65.0 |
| Generalization to AudioMCQ | Generalization to AudioMCQ | Generalization to AudioMCQ | Generalization to AudioMCQ |
| r+ only | 73.2 | 57.7 | 63.8 |
| r+, r+→r++ | 73.8 | 61.1 | 64.3 |
该表第一块显示用指令模型合成的错误比从基座采样得到的错误更好,尤其在两段训练后达到 78.2、63.7、66.0。第二块显示去掉错误到纠正偏好对后 MMAR 与 MMSU 下降,而加入偏好短回答的紧凑对无帮助。第三块在 AudioMCQ 上只加正确到精炼仍有提升,说明管线不绑定单一数据源。
下表把同一份 LLT 监督数据搬到另外两个底座上,检验数据本身的通用性。
| Method | MMAU Test-mini | MMAR | MMSU |
|---|---|---|---|
| Qwen2-Audio-Instruct | 59.6 | 30.0 | 53.3 |
| + LLT SFT | 67.8 | 53.8 | 59.0 |
| Qwen3-Omni-Instruct | 77.5 | 66.9 | 69.0 |
| + LLT SFT | 79.6 | 67.9 | 71.6 |
表中 Qwen2-Audio-Instruct 从 59.6、30.0、53.3 升到 67.8、53.8、59.0,Qwen3-Omni-Instruct 从 77.5、66.9、69.0 升到 79.6、67.9、71.6。比较条件是只用短正确加正确到精炼做监督,Qwen3-Omni 因算力用 LoRA。结果支持数据可迁移,但也提醒不同底座的绝对起点差异很大,不能跨表比大小。
结论在什么边界内才成立
首先是时长与领域边界。训练只用 30 秒内音频,源自 AF-Think 过滤后的公共数据,音乐等受限子集被排除。长音频上的保留增益只在 MMAU-Pro 上验证过,且平均 2 分钟,不能推广到任意小时级会议或播客。其次是自动校验的边界。大规模生成依赖模型自检加抽样人工检查,人工看 96 对中 90% 问题有效、纠错成功率 93%、文本伪影极低,但幻觉标注仍有 13% 到 19%,且多数是单标注者判定的边缘情况,不能保证每条轨迹都干净。
还有推理开销与误纠正的代价。长轨迹更长,分布明显右移,部署时 token 成本上升。触发分析显示净纠正为正,但仍有 4.9% 的对改错,说明在简单题上过度反思可能帮倒忙。音频消融显示,去掉音频后 LLT 模型仍强于基座,说明文本推理本身变强;换成高斯噪声后 LLT 掉得更多,甚至低于无音频,说明它更依赖声学证据,输入被污染时会更受影响。
复现第一步做什么、需要什么
复现分数据与训练两步。数据侧先准备 AF-Think 并按论文过滤到 30 秒内、去掉授权受限子集,得到约 33.8 万音频。然后依次跑语义 caption、频谱图加视觉模型、语音转写、说话人切分、事件检测双阈值、音乐结构与和弦识别,拼成稠密描述。指令模型与推理模型用 Qwen3-Next-80B 的 Instruct 与 Thinking 版本,提示词在附录中给出,校验失败的丢弃,格式小错用模型修复。
训练侧用 LLaMAFactory 做监督微调,用 ms-swift 做偏好优化与后续 GRPO。论文称会公开数据集、模型与全管线,项目页在正文中给出链接,但本次只验证到论文提及该链接可访问,不能据此断言权重与数据已经可下载。代码可运行、权重可下载、数据可获取是三件独立的事,复现前应分别确认。单节点 8 卡 H100、单次运行是论文的资源口径,小资源可先用 5 万问答子集验证趋势。
什么时候值得尝试这个方法
如果你做语音、音乐或环境声的问答与推理,且错误分析显示很多是听错细节而非纯逻辑错,这个思路值得试:先用专用模型把语义、声学、时间 3 路描述做厚,用它们造难题和可信的听错案例,再用思维延续把验证回溯写成长轨迹,最后把含错中间步骤的轨迹留给偏好学习而不是直接模仿。
容易产生的误解是把长思考等同于更强。论文的对比表明,直接蒸馏的长思考冗长发散,而保留前缀的延续更聚焦;把错误轨迹直接放进监督反而降分,只有配对偏好才能把纠错行为装进去。另一个误解是把基准涨点当成感知已解决。人工检查与噪声实验提示,幻觉与对噪声的敏感仍在,跨到医疗、生物声学等专用领域时虽有平均提升,但个别子项如长表与多轮会出现波动,仍需在自己的数据上补验证。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses