📄 语音脑机接口一定要用大模型吗:BEST 的轻量解码路径
英文题目:Do Speech BCIs Need Larger Models? Rethinking Neural Decoding beyond Scaling
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
👥 作者与机构
- Zehui Feng:Shanghai Jiao Tong University;Nanyang Technological University
- Weichuan Wang:Shanghai Jiao Tong University
- Xiaohan Chen:Shanghai Jiao Tong University
- Cuntai Guan:Nanyang Technological University
- Ting Han:Shanghai Jiao Tong University;Zhejiang University
📌 核心摘要
需要理解的对象是从皮层记录得到的神经活动,困难在于数据量少、噪声大且跨天漂移,直接把高维信号压成离散音素硬标签会丢掉细粒度结构并放大过拟合。所提框架Brain-Encoding-Speech-Text(BEST)先用分层编码器把神经时间片变成音素级与字符级两种连续表示,再用轻量多尺度卷积把两路特征融合成统一嵌入,最后把该嵌入送入语音预训练模型的编码器上层与解码器生成文本,并用小规模n元语言模型做候选重排。与依赖大生成模型和音素硬判决再纠错的已有流程相比,该设计推迟离散判决并保留多层连续结构。在Brain-to-Text’25测试集相同5元语言模型条件下BEST词错率为2.57%,低于Transformer基线的3.81%和GRU基线的5.41%,而Robust BEST在’25测试集上取得1.62%词错率、在’24测试集上为6.19%词错率,参数量仅为可比方法的3.85%。作者承认单被试评测、长期漂移与依赖语音预训练偏置等限制尚未解决。在Jetson Orin Nano上端到端推理计算量从1736.26降至123.17 GFLOPS,延迟从1189.71 ms降至215.67 ms,峰值内存从7.23 GiB降至2.79 GiB。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
这篇论文要解决的交流恢复任务是什么
论文研究的是尝试说话的脑到文本解码。输入是植入在言语相关皮层的微电极阵列记录到的神经活动,论文按 20 毫秒分辨率提取阈值穿越尖峰计数和尖峰带功率这类特征,并跨会话做归一化以减轻非平稳性。被试看到句子提示后尝试说话,可能是有声尝试也可能是无声尝试,系统要根据对应时间段的神经活动直接转写出目标句子。
输出是英文句子文本,评价用音素错误率、字符错误率和词错误率,都是越低越好。词错误率衡量整句词层面的转写错误,是最贴近实际交流可用性的指标。任务的难点在于训练句只有一万句量级,采集昂贵且噪声大,神经信号与语言输出之间对齐微弱,模型既要保留细粒度的时频结构,又要在推理时足够轻,能放在临床或边缘硬件上低延迟运行。
读者可以这样理解全程:同一句话的神经活动先被切成时间块变成向量序列,经过编码得到语言相关的中间表征,再被翻译成文字候选,最后用语言模型选出最通顺的一句。论文的争论点是,中间是否必须先硬判成离散音素序列再套大语言模型,以及解码器是不是越大越好。
已有路线为什么依赖音素加语言大模型
早期语音脑机接口常用循环神经网络把神经信号映射到音素或字符等中间单元,再接统计语言模型生成文本,后来加入双音素等上下文建模来刻画局部发音过渡。近年 Transformer 被引入以建模长程依赖和流式解码,也有工作把大语言模型用于纠错和重排。这条路线有效的原因是语言先验越来越强,能把有歧义的音素序列补成合理句子。
但论文指出它有两个代价。第一是部署代价,动辄数十亿参数和数百 GiB 内存的重排流程不适合边缘或临床设备,延迟和显存都过高。第二是信息代价,把高维神经信号过早压缩成离散音素硬标签,会丢掉连续的语言结构信息,在数据稀缺噪声大时更容易过拟合,而且中间预测与句子生成严格分离,多层神经语言表征无法在解码时交互。
另一类轻量工作主要针对运动或意图解码,随机森林等经典方法高效但难以建模语音所需的序列依赖,简单加深网络又会在小数据下不稳定。论文的定位不是再堆一个更大的语言模型,而是换一条保留连续分层表征、只用小规模语音对齐解码器加轻量统计语言模型的路线,并在相同基准上比较参数量、内存、延迟与错误率。
论文质疑的缩放假设和离散瓶颈是什么
论文要回答的核心问题是,在语音脑机接口这种低资源高噪声条件下,增大模型是否还能带来稳定收益。自然语言处理和语音识别中常见的越大越好,在这里可能不成立,因为神经观测与语言输出对齐弱,容量增大会放大对噪声的记忆而不是泛化。论文用解码器规模扫描、编码器解码器析因和过拟合对照来检验这一点。
第二个问题是离散音素瓶颈。传统流水线先做音素分类再生成句子,相当于在中途做一次硬判决,后续只能看到标签而看不到原始连续证据。一旦音素判错或过度自信,句子级推理很难挽回。论文认为真正的瓶颈不是预测音素的局部准确率,而是表征是否有结构、是否与下游声学文本空间对齐。
因此论文把研究目标定为:用更小的参数实现可比或更好的整句转写,同时保持跨天稳定性和可部署性。衡量标准不仅是测试集词错误率,还包括验证集词错误率、是否依赖外部语言模型、编码器质量与解码器选择的交互,以及过拟合时局部指标与序列指标是否背离。
BEST 的两阶段流程让一个样本经历什么
BEST 的全称是脑编码语音文本框架,分为两个阶段。第一阶段学习分层神经语言表征,第二阶段做句子级翻译与轻量重排。拿一个尝试说话的试次为例,神经特征序列先被切成时间块并嵌入成向量,经过频率通道注意力和 Transformer 层得到音素级与字符级两路表征,再经轻量卷积融合块合成统一表征,最后送入小型语音翻译器自回归生成文本候选并用 4 元或 5 元统计语言模型选优。
下图是论文给出的总体结构,可以对照上面的数据流向阅读,先看主路径再看两路表征的汇合点。
看图路径: 1. 沿左侧神经输入经切块嵌入到中间融合再到右侧文本输出的主路径看数据流向;2. 对比第一阶段编码器与第二阶段翻译器加语言模型在训练与推理时的分工;3. 注意音素与字符两路表征在哪里汇合以及投影到声学空间的位置

论文图 1。原论文 Figure 2::“Overall illustration of BEST. The framework consists of four core modules: (1) Hierarchical Transformer Encoder (Stage 1): it employs frequency-channel attention and iTransformer…”。
从图中可见 4 个模块的分工:分层 Transformer 编码器负责时频结构建模,音素字符融合块负责桥接神经与语言空间,轻量语音翻译器负责神经到文本的直接映射,KenLM 重排负责在噪声下解决候选歧义。推理时编码器表征被送入 Whisper 编码器上层以对齐预训练语音表征,再由 Whisper 解码器生成 n-best 列表,整个过程不需要显式音频输入,也不需要大语言模型参与生成。
分层编码器如何保留时频结构
编码器的输入是时间块序列。论文先做多频率通道注意力,把输入在时间维池化到固定长度后投影到一组固定的离散余弦变换基上,对每个频率分支统计通道的均值、最大值和最小值,再经共享瓶颈多层感知机产生注意力权重,用 Sigmoid 加权回原始输入。这种做法的实际作用是让模型按频带自适应强调信息量大的通道,对噪声和时间分布漂移更稳,开销很小。
随后嵌入先过 iTransformer 捕捉全局依赖并稳定隐空间,再过分层 Transformer,用过去掩码看历史、局部双向掩码看短程交互、未来掩码引入前向线索,逐步精化时间感受野。最后经 CTC 头同时投影到音素级和字符级输出,提供不同语言粒度的互补监督。论文强调不用掩码自编码重建,因为语音解码更需要保留时谱结构和音系语义信息,而不是逐点恢复被遮挡的信号。
下面是原文给出的多频率注意力计算过程,先池化再按基展开统计,最后生成注意力并加权。
\[\begin{array}[]{l}\text{Input: }x\in\mathbb{R}^{B\times C\times T}\\ x_{\text{pool}}=\text{AdaptiveAvgPool}(x,L)\\ \text{feat}=0\\ \text{for each DCT basis }f_{i}:\\ \quad s=x_{\text{pool}}*f_{i}\\ \quad\text{feat}+=\text{Mean}(s)+\text{Max}(s)+\text{Min}(s)\\ \text{feat}=\text{feat}/K\\ \text{attn}=\text{Sigmoid}(\text{MLP}(\text{feat}))\\ \text{Output: }x*\text{attn.unsqueeze}(-1)\end{array}\]该式的输入是批量、通道、时间 3 维的神经张量,输出是同形状的加权张量。中间的均值、最大、最小是对池化后序列在时间维的通道统计,除以分支数是平均,MLP 加 Sigmoid 得到每个通道的门控系数。门控在最后 1 维扩展后与原输入相乘,相当于按频带证据重标定通道重要性。
分层 Transformer 编码器 × 音素字符融合块: 分层 Transformer 编码器负责把神经时间序列变成保留频谱和时序结构的音素级与字符级两种表征,音素字符融合块负责用多尺度卷积把这两路表征在特征层面对齐并投影到声学空间,二者搭配是先分粒度提取再合并且不对齐就急于做离散判决,为后段语音翻译器提供连续而紧凑的输入。
融合块与小型翻译器如何衔接神经与文本
融合块的输入是编码器不同深度的音素流与字符流。论文用并行多尺度卷积分支处理,1×1 分支做轻量通道混合,3×3 分支捕捉短程时序上下文,每路内部还有残差聚合以保留时序结构并促进跨层信息流动,最后拼接再经轻量卷积投影成统一表征。相比再加注意力层,卷积在小数据高噪声下更高效,不容易引入过大自由度。融合表征的另一个作用是投影接口,把神经表征对齐到声学嵌入空间,方便下游语音模型直接解码。
轻量语音翻译器基于 Whisper,融合表征先投影到声学嵌入空间并送入 Whisper 编码器上层,与预训练语音表征对齐,引入隐式声学先验,再由 Whisper 解码器自回归生成文本。训练用带教师强制的下一词元预测,推理可用束搜索生成候选。因为噪声会导致候选歧义,论文再用定制的 4 元 KenLM 做轻量重排,相比常用 5 元模型开销更小,保留实时可行性。实践中有 3 种配置:不接外部语言模型的轻量端到端、接 4 元模型的实用版、接 5 元模型的鲁棒版。
下面是分层 Transformer 的前向掩码流程,先全局再分阶段约束时序依赖。
\[\begin{array}[]{l}\text{Input: }x\\ h=\text{iTransformer}(x)\\ h=\text{Transformer1}(h,\text{mask=past\_mask})\\ h=\text{Transformer2}(h,\text{mask=local\_mask})\\ h=\text{Transformer3}(h,\text{mask=future\_mask})\\ \text{Output: }\text{Projection}(h)\end{array}\]该式中 h 是隐表征,past_mask、local_mask、future_mask 分别对应历史、局部和前向约束,Projection 是到音素字符 CTC 头的投影。按此顺序执行意味着先建立全局上下文,再逐步收紧到局部交互,避免一开始就被局部相关带偏。
轻量语音翻译器 × 4 元 KenLM 重排: 轻量语音翻译器指基于 Whisper 小型编码器上层加解码器自回归生成文本的模块,负责把融合表征直接转写成候选句子,4 元 KenLM 重排指用小型统计语言模型对 n-best 候选做语言层面的二次打分,搭配意义是声学对齐的翻译先保证神经到文本可达,轻量语言约束再纠正噪声带来的局部歧义而不引入大模型开销。
两阶段训练冻结了什么又更新了什么
论文采用先预训练编码器再微调句子解码的 2 阶段策略。第一阶段从随机初始化训练分层编码器,做音素级与词级分层预训练并配合较强的数据增强,目标是学到紧凑且同时保留细粒度声学结构与高层语言信息的表征。附录报告 T12 约 80 轮内收敛,T15 约 50 轮后句子词错误率不再明显改善,继续训练会逐渐过拟合。
第二阶段冻结神经编码器和 Whisper 编码器以保持稳定表征,把音素字符特征注入 Whisper 编码器上层,只更新 Whisper 解码器的第一层 Transformer 和融合块。这种有针对性的优化把学习限制在轻量部件,减少在小数据下的过拟合与训练不稳定,同时让模型适应神经衍生的表征。优化器用 AdamW,束大小等超参数在附录按 T12 与 T15 分别给出。
与之对照的是端到端联合训练与多任务损失。论文报告 2 阶段在两个被试上都优于端到端,多任务只能部分缩小差距,说明同时学表征与句子生成在噪声有限监督下容易互相干扰。理解复现时要注意,这里的训练不是指训练大语言模型,而是指训练编码器、融合块与少量解码器层,语言模型重排本身是统计模型计分。
两阶段训练 × 端到端训练: 两阶段训练指先稳定训练神经编码器的音素与字符表征再冻结主体只调融合块和解码器首层,端到端训练指同时优化表征学习与句子生成,搭配比较的意义是检验在噪声少数据条件下联合优化是否会互相干扰,论文证据支持先固化结构化表征再做句子映射更稳定。
数据、基线与指标在什么条件下可比
实验用 Brain-to-Text’24 和’25 两个尝试说话基准。’24 是被试 T12 的 12100 句、25 个会话,128 电极对应 256 维神经特征,有声尝试约每分钟 62 词。’25 是被试 T15 的 10948 句、45 个会话,256 电极对应 512 维特征,语料更多样并包含有声与无声尝试。两者都是视觉提示后按提示尝试说话,解码对应神经活动。特征均为阈值穿越与尖峰带功率,按 20 毫秒分辨率提取并跨会话归一化。
基线包括 5 层双向 GRU 加 5 元语言模型与 OPT 重排的 RNN 基线、带时间掩码增强的因果 Transformer 基线、用双音素上下文与集成解码加语言模型修正的 DCoND,以及跨物种跨任务预训练再经掩码重建与 CTC 微调的 BIT。比较时区分不接语言模型的端到端与接语言模型的级联,指标中音素错误率看音素序列,字符错误率看字符序列,验证集与留出测试集词错误率看整句,方向都是越低越好。
论文还做了 3 类控制比较:同一语言模型下换编码器,同一编码器下换解码器,以及匹配与不匹配语言模型下的增益分解。这些设计是为了把神经表征质量、解码器对齐与语言先验的贡献分开,避免把语言模型的功劳算到编码器头上。单被试评估与跨天划分是结论成立的重要前提,后文讨论其限制。
主结果在参数远更小时词错率如何
下表比较各方法在两个基准留出测试集上的规模与错误率,比较问题是在相近任务与数据划分下,轻量 BEST 能否以小参数达到可比或更好的整句精度,指标方向均为越低越好,参数与内存列说明代价。
| Model | #Param, RAM | T12 PER↓ | T12 CER↓ | T12 Valid WER↓ | T12 WER↓ | T15 PER↓ | T15 CER↓ | T15 Valid WER↓ | T15 WER↓ |
|---|---|---|---|---|---|---|---|---|---|
| RNN(Baseline) [48] | 5.70B, 300GiB | 0.2122 | 0.2561 | 0.2271 | 0.0976 | 0.1310 | 0.2075 | 0.1127 | 0.0667 |
| Transformer [11] | 14.79B, 320GiB | 0.1628 | 0.1732 | 0.1121 | 0.0818 | 0.1081 | 0.1573 | 0.0934 | 0.0612 |
| DCoND [23] | 10.50B, 320GiB | 0.1534 | - | - | 0.0860 | - | - | - | - |
| BIT [58] | 1.53B, 32GiB | 0.1439 | - | 0.1607 | 0.1567 | 0.0712 | - | 0.0879 | 0.1106 |
| BIT [58] | 1.53B, 350GiB | - | - | - | 0.0635 | - | - | - | 0.0406 |
| BEST⋆ | 0.059B, 5GiB | 0.1321 | 0.1436 | 0.1504 | 0.1261 | 0.0688 | 0.0896 | 0.0681 | 0.0517 |
| BEST+5-Gram LM⋄ | 0.059B, 320GiB | 0.1321 | 0.1436 | 0.0721 | 0.0619 | 0.0688 | 0.0896 | 0.0257 | 0.0162 |
| BEST+4-Gram LM∙ | 0.059B, 32GiB | 0.1321 | 0.1436 | 0.0764 | 0.0654 | 0.0688 | 0.0896 | 0.0292 | 0.0196 |
表中 BEST 本体约 0.059B 参数,轻量端到端在’25 验证集词错误率为 0.0681,留出测试为 0.0517,加 4 元模型后验证集 0.0292、测试 0.0196,加 5 元模型后验证集 0.0257、测试 0.0162,在’24 上对应测试为 0.1261、0.0654 和 0.0619。论文摘要按可比方法口径概括为’24 约 6.19% 和’25 约 1.62%,且参数仅为可比方法的约 3.85%,正文贡献处另有约 3.7% 的表述,应理解为不同口径下的约数而非精确换算。
需要同时看到未胜出项:不接语言模型时 BEST 在’24 测试 0.1261 仍高于带大语言模型重排的 BIT 的 0.0635,说明轻量端到端的绝对精度尚未全面超越重型级联。论文的结论是有条件的:优势集中在参数内存受限、希望缩小端到端与级联差距的场景,而最优数字依赖统计语言模型,跨被试与长期非平稳仍未验证。
音素错误率 × 词错误率: 音素错误率衡量音素序列层面的局部判别对错,词错误率衡量整句转写后词层面的序列一致性,二者搭配才能看出本文核心现象:局部音素更准不一定带来整句更准,过度拟合时音素错误率下降而词错误率反而上升,说明时序连贯性才是决定最终可读性的关键。
解码器越大越好吗,语音预训练为何更重要
下表在 T15 上固定其余流程只换解码器并比较全量微调、部分微调与冻结 3 种适配,比较问题是解码器规模与预训练模态谁主导性能,验证集词错误率越低越好。
| Decoder | #Params | Dimension | Valid WER↓ | Valid WER↓ | Valid WER↓ |
|---|---|---|---|---|---|
| Decoder | #Params | Dimension | Full fine-tuning | Partial fine-tuning | Frozen |
| Whisper-tiny [39] | 34M | 384 | 0.3678 | 0.2845 | 0.2996 |
| Whisper-base [39] | 74M | 512 | 0.2409 | 0.2183 | 0.2235 |
| DistilGPT2 [41] | 82M | 768 | 0.2091 | 0.1930 | 0.2006 |
| Whisper-large [39] | 1.55B | 1280 | 0.1461 | 0.1460 | 0.1572 |
| Whisper-medium [39] | 769M | 1024 | 0.1351 | 0.1309 | 0.1366 |
| Fine-tuned DistilGPT2 [41] | 82M | 768 | 0.1323 | 0.1152 | 0.1363 |
| Llama3.1 [45] | 8B | 4096 | 0.1256 | 0.1163 | 0.1099 |
| Fine-tuned Llama3.1 [45] | 8B | 4096 | 0.1209 | 0.1131 | 0.1052 |
| Qwen2 [50] | 1.5B | 1536 | 0.1133 | 0.1091 | 0.1050 |
| Fine-tuned Qwen2 [50] | 1.5B | 1536 | 0.1103 | 0.0967 | 0.0938 |
| Aero1-Audio [22] | 1.5B | 1280 | 0.1018 | 0.0989 | 0.0830 |
| Whisper-small [39] (BEST) | 244M | 768 | 0.0764 | 0.0681 | 0.0795 |
结果呈非单调趋势。Whisper-Tiny 全量微调 0.3678、部分微调 0.2845,容量明显不足;Whisper-small 即 BEST 所用 244M 在部分微调下 0.0681 最优;更大的 Whisper-medium 约 0.1309、Whisper-large 约 0.1460 反而变差。文本大模型中 Qwen2-1.5B 微调后约 0.0967,8B 的 Llama3.1 约 0.1052 到 0.1131,并不随规模稳定变好。音频朝向的 Aero1-Audio 冻结可到 0.0830,优于同规模文本模型,说明与神经输入的表征对齐比单纯增大更重要。
适配策略也与规模有关:全量微调普遍不是最优,小解码器用部分微调足够,大模型更适合冻结以保留预训练先验,过多任务适配会破坏先验并在噪声下不稳定。编码器维度扫描同样在 768 最优,384 到 768 改善,896 以上在两被试上都恶化,且 768 恰与 Whisper 解码器隐维一致,可能减少投影失配。这些都支持论文判断:在当前数据 regime 下,控制容量与对齐模态比一味放大更有效,但结论可能随未来大规模神经数据而变化。
编码器与解码器的贡献能分开吗
下表固定其余流程做编码器解码器析因,比较问题是 BEST 的增益来自神经表征还是下游解码器容量,验证集词错误率越低越好,解码器差距列衡量换大解码器能否弥补弱编码器。
| Neural encoder | Whisper-small | Audio-LLM | Decoder gap |
|---|---|---|---|
| BEST encoder | 0.0681 | 0.0989 | 0.0308 |
| Transformer encoder | 0.0862 | 0.1217 | 0.0355 |
| GRU encoder | 0.1054 | 0.1462 | 0.0408 |
BEST 编码器配 Whisper-small 为 0.0681,配音频大语言模型为 0.0989,差距 0.0308;Transformer 编码器对应 0.0862 与 0.1217,差距 0.0355;GRU 编码器对应 0.1054 与 0.1462,差距 0.0408。两点可读:同一解码器下 BEST 编码器始终最好,说明增益不依赖特定解码器;同一编码器下更小的 Whisper-small 始终优于更大的音频解码器,说明增大解码器不能弥补弱表征。本表数值与单位依据论文 PDF。
另一个细节是解码器差距随编码器变好而缩小,从 GRU 的 0.0408 降到 BEST 的 0.0308,意味着结构更好的神经表征对下游选择更不敏感。论文还报告语言模型控制比较:在相同 4 元或 5 元模型下 BEST 仍最低,且弱编码器从语言模型得到的绝对降幅更大,因此 BEST 的领先不能归因于更会利用语言模型,而是表征与解码空间质量本身更好。
下图从表征层面解释这种对齐,读图时先看整体结构再看跨模态变化,最后看时间连续性。
看图路径: 1. 先看左侧自相似矩阵对角线与块结构判断表征是否有稳定流形;2. 再看中间跨模态对齐中融合表征相对音素表征的变化;3. 最后对比右侧三类编码器的时间激活条带的连续性与碎片程度
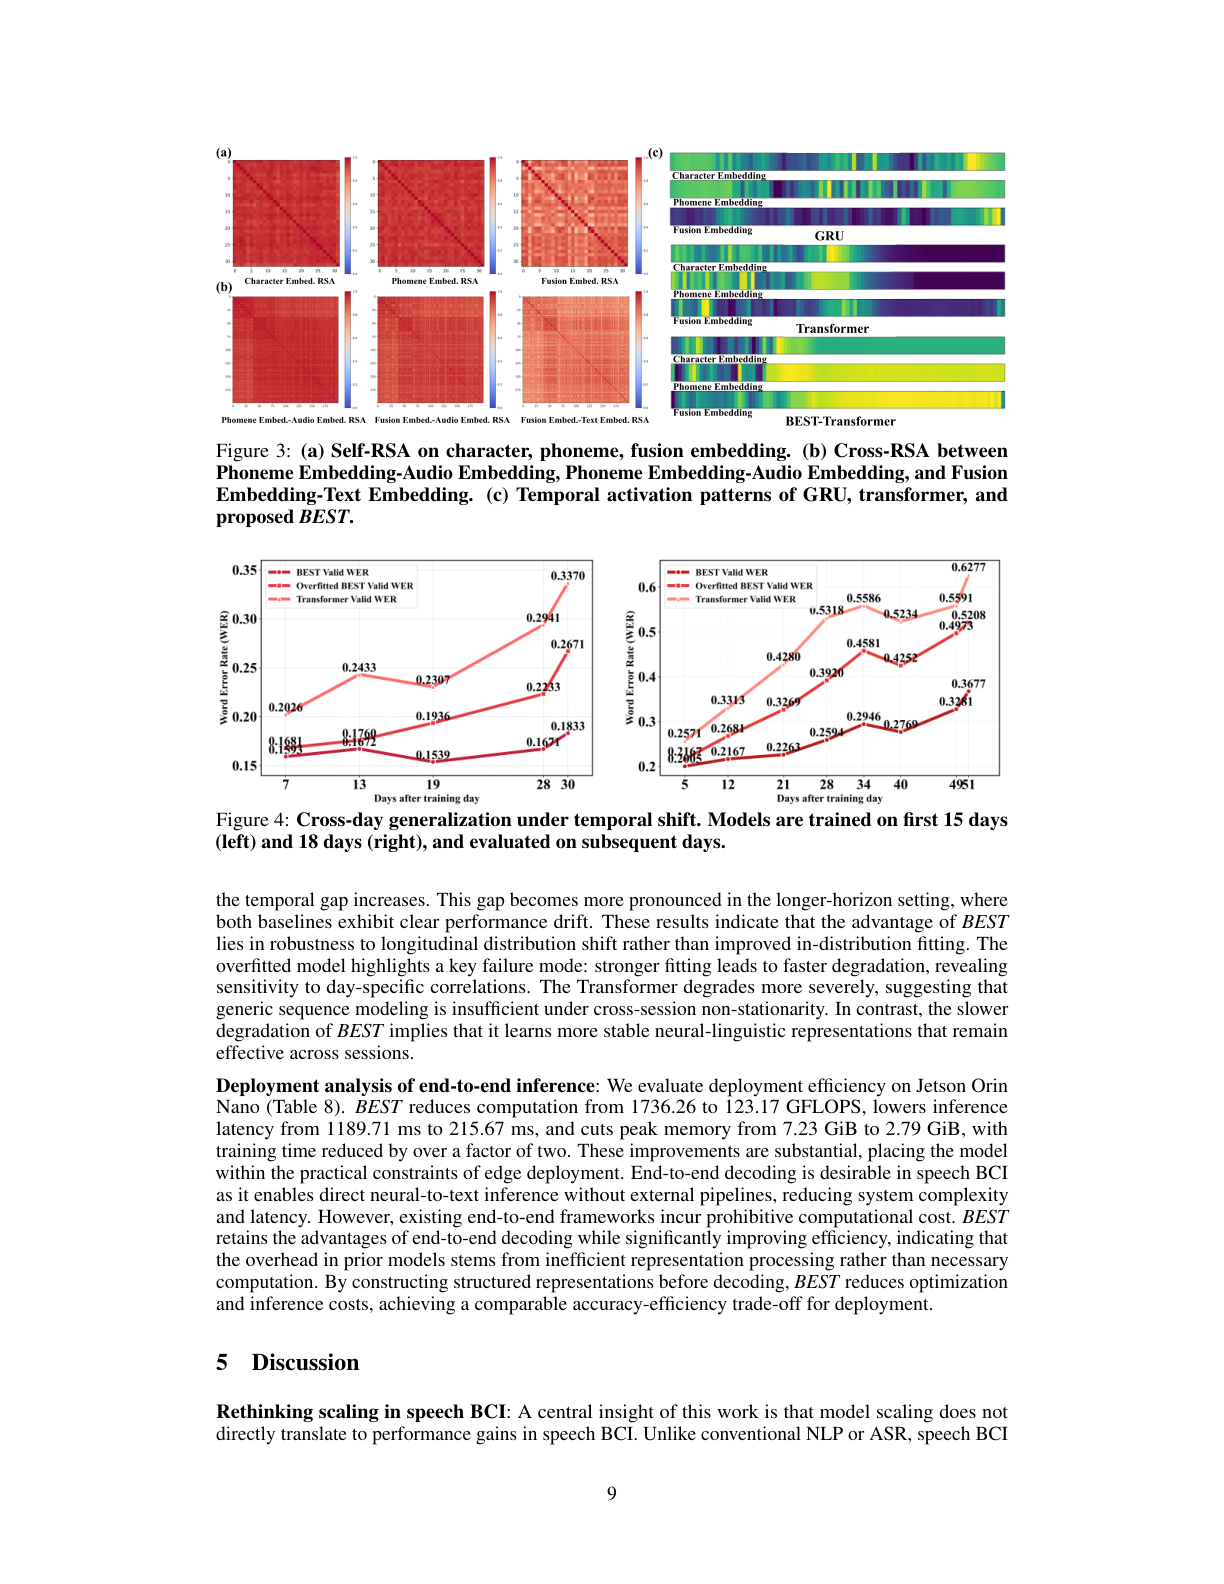
图片来源: 原论文 PDF 第 9 页(含图 3;原官方 PNG 文件截断,独立出版展示)
论文图 2。原论文 Figure 3::“(a) Self-RSA on character, phoneme, fusion embedding.”。
图中最左侧自相似矩阵显示字符、音素与融合嵌入都有清晰结构,说明神经活动被组织成稳定语言流形而非弥散特征,融合后局部冗余更少而更紧凑。中间跨模态对齐显示音素嵌入与音频空间匹配较弱,融合嵌入明显更强,再经 Whisper 编码器后向文本空间偏移,形成神经到音频再到文本的渐进路径。右侧时间激活条带中 BEST 更平滑且有效支撑更短,而 GRU 与普通 Transformer 更碎片化,支持时序一致性更好的判断。
过拟合为什么音素更准而句子更差
论文对比拟合良好与过拟合两版 BEST:过拟合版音素与字符错误率更低,但验证集词错误率在 T12 从 0.1504 升到 0.1692,在 T15 从 0.0681 升到 0.0803。这正是局部判别与序列一致性背离的证据。论文把它归因于过拟合导致的表征坍缩,过度自信的离散预测破坏了下游推理所需的时序连贯性。
下图展示同一段的逐帧音素概率热力图,可以直观检验平滑性与碎片化的差别,读图时重点看亮点是连续轨迹还是孤立碎点。
看图路径: 1. 对比上下两幅热力图中横轴时间帧与纵轴音素类别的亮点分布;2. 观察拟合良好时过渡是否相对平滑而过拟合时是否出现孤立高亮;3. 注意右侧权重色标并结合静音段的连续性看时间连贯性差异

论文图 5。原论文 Figure 6::“Phoneme decoding probability heatmaps under well-fitted (top) and overfitted (bottom) conditions.”。
图中上为拟合良好,下为过拟合,横轴是时间帧,纵轴是音素类别,右侧色标为权重。可见过拟合版出现更尖锐但更碎片的高亮,局部置信更高而时间组织更弱;拟合良好版过渡更平滑,保留连贯音素轨迹。这支持论文的机制解释:过拟合没有主要破坏局部可分性,而是破坏了序列解码所需的结构,使表征与下游推理不兼容。
混淆与转移矩阵进一步说明错误是有结构的而非随机的,读图时先确认类别与数据集再看集中模式。
看图路径: 1. 先确认四幅混淆矩阵各自对应音素或字符以及两个数据集;2. 观察高亮点是否集中在少数发音或拼写相近的类别附近;3. 思考局部混淆合理但整句仍出错时离散判决丢失了什么信息

论文图 6。原论文 Figure 7::“Top-2 phoneme and character confusion matrices on Brain-to-Text ’24 and ’25 benchmarks.”。
论文报告音素混淆集中在发音声学相近组,字符混淆因音字映射更分散但仍有序,且 2 数据集模式一致,说明是神经表征固有结构而非数据集偶然。转移矩阵同样稀疏集中,反映局部连续性被保留但长程歧义未解决。因此延迟离散判决、保留多层连续证据再解码,比加强音素监督更符合该数据的特性。
跨天泛化 × 过拟合的表征坍缩: 跨天泛化指用前若干天数据训练后在后续天数上测试词错率随时间漂移的变化,过拟合的表征坍缩指模型输出概率过于集中碎片化、失去平滑时序结构的现象,二者搭配说明只看训练集附近的音素精度会误判,真正重要的是表征在时间漂移下是否保持稳定可解码。
轻量化的代价与尚未验证的范围是什么
下表在 Jetson Orin Nano 上比较端到端推理的计算与内存,比较问题是轻量结构是否真正落到可部署区间,浮点运算、延迟、峰值内存越低越好,训练轮时间说明优化成本。
| Model | GFLOPS | Inference times (ms) | Peak Memory (GiB) | Training Epoch time (s) |
|---|---|---|---|---|
| BIT [58] | 1736.26 | 1189.71 ± 26.81 | 7.23 ± 0.12 | 147.81 ± 1.09 |
| BEST (Ours) | 123.17 | 215.67 ± 19.81 | 2.79 ± 0.06 | 56.34 ± 0.81 |
表中 BIT 需 1736.26 GFLOPS、约 1189.71 毫秒延迟、约 7.23 GiB 峰值内存,BEST 降到 123.17 GFLOPS、约 215.67 毫秒、约 2.79 GiB,训练轮时间从约 147.81 秒降到约 56.34 秒。论文据此认为此前开销多来自低效表征处理而非必要计算,先构造结构化表征再解码能同时降优化与推理成本。但这只是单板单配置的测量,总体趋势不能推广到每组结果或每个步骤,实际延迟还与束大小、语言模型规模和系统流水线有关。
论文明确列出三项限制。第一是单被试评估,跨被试泛化因神经表征差异仍是开放问题。第二是虽做了跨天测试,长期非平稳与自适应解码未显式解决。第三是依赖 Whisper 等预训练语音模型的归纳偏置,它未必完全刻画神经到语言映射,未来可能需要联合学习的神经语音表征或完全神经原生的解码结构。跨天实验中拟合良好版衰减慢于过拟合版与 Transformer 基线,但这只支持在所测天数范围内的稳健性,不能外推到任意长期漂移。
要复现应先准备什么并核对哪些细节
复现第一步是按原文取得相同数据划分与预处理,而不是先调模型。T12 用 128 电极的 256 维特征,T15 用 256 电极的 512 维特征,白噪声标准差、高斯平滑宽度与常数偏移等参数在附录分别给出,特征按 20 毫秒分辨率提取并跨会话归一化。句子提示与尝试说话的对齐、验证集与留出测试集的划分、束搜索大小与语言模型词表都需与原文一致,否则词错误率不可比。
模型上先复现 2 阶段流程:第一阶段训练分层编码器得到音素与字符 CTC 监督下的表征,第二阶段冻结编码器与 Whisper 编码器,只训练融合块与解码器首层,再分别评估不接、接 4 元与接 5 元语言模型三档。超参数按 T12 与 T15 分开设置,编码器维度先用 768,融合用 1×1 加 3×3 多尺度卷积,掩码数量与层分配取附录扫描的中等最优而非最大。
需要补的验证包括多次运行的标准差、跨随机种子稳定性、跨天划分的完整曲线,以及在相同语言模型下的编码器对照。关于资源,本次只确认论文提到的公开基准与模型名称,未确认作者代码权重是否当前可用,因此应把代码可得、权重可下载与系统可运行分开核对,不要把论文提到链接等同于已开源。
什么时候值得尝试这种轻量路线
当任务是小数据高噪声的植入式语音解码,且部署受限于内存延迟而无法承担大语言模型重排时,这条路线值得尝试。它的可复述步骤是:保留时频结构的分层编码,同时学音素与字符两路表征,在特征层面用轻量卷积融合并投影到语音模型的声学空间,再用小型自回归解码器生成候选并配小统计语言模型选优。关键超参数是编码器维度、融合感受野、掩码强度与冻结位置,都取中间受控值而非最大。
证据支持的结论是:在所测两被试与所用划分下,对齐与结构比规模更重要,非单调缩放与过拟合背离都成立;融合块带来最大增益,掩码自编码反而使音素字符错误率上升。但这些结论不意味着大模型永远无用,论文讨论也指出更大规模神经数据可能改变缩放关系。
仍需验证的是跨被试、长期漂移下的自适应、无声尝试占比更高时的表现,以及完全不依赖预训练语音模型的神经原生方案。初学者容易误以为音素错误率低就等于句子好,或把语言模型带来的提升算成编码器提升,复现时应同时报告音素字符与词 3 级指标,并在固定语言模型下做对照,才能看清真正的表征贡献。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses