共分析 25 篇论文
⚡ 今日概览
✅ 筛选入选 25 篇 → 🔬 深度分析完成
每篇论文保留完整分层分类;热门方向按主任务的最上级方向统计,每篇计入 1 个方向。排行榜也显示最上级任务。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| 音频分类 | 3 篇 | ███ |
| 语音属性识别 | 2 篇 | ██ |
| 语音识别 | 2 篇 | ██ |
| 音乐分析 | 2 篇 | ██ |
| 音频伪造检测 | 2 篇 | ██ |
| 声学系统参数估计 | 1 篇 | █ |
| 声源定位 | 1 篇 | █ |
| 声音感知情感估计 | 1 篇 | █ |
📊 论文评分排行榜(25 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 VocalGrad:用增减二分类隔离检验音频大模型的声学感知

英文题目:VocalGrad: Evaluating Acoustic Perception in Audio Language Models
评分:8.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.5/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Koki Ryu:The University of Tokyo;Riken
- Hitomi Yanaka:The University of Tokyo;Riken;Tohoku University
📌 核心摘要
大音频语言模型听到同时含文字内容和声音变化的整段语音后,需判断音高、响度、噪声等属性随时间增大还是减小,文字语义会干扰对底层变化的感知。论文先取基础语音片段作为输入,每次只施加一种声学因素的渐强或渐弱变换并标注方向,得到只含单因素差异的成对测试语音。再把整段变换后语音与询问变化方向的提示一起送入大音频语言模型,要求模型只输出一个方向词,使评价剥离高层推理而聚焦声学感知。接着取出模型的音频编码表示与语言解码器各层文本预测位置的表示,分别送入单层线性分类器,以分类准确率衡量任务信息的可线性解码程度,从而定位信息丢失在编码保留还是解码读出阶段。在VCTK来源的VocalGrad测试上以分类准确率为指标,共含21600个片段的基准上人类平均准确率94.4%高于表现最好的Kimi-Audio平均51.8%,后者基本处于随机水平。在同一基准以分类准确率为指标对Kimi-Audio做类别内微调时,音量类别上仅微调语言模型输出层准确率为88.2%低于微调全部线性层后的100.0%,背景噪声类别则从98.6%提升至100.0%,说明瓶颈位置因变换类型而异。结论只适用于受控单因素合成变换,尚未验证自然共变语音和高层情绪等任务的迁移效果。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/ynklab/vocalgrad — 链接可访问(HTTP 200)
数据相关资源:https://huggingface.co/datasets/ynklab/vocalgrad — 链接可访问(HTTP 200)
第三方资源:https://github.com/MoonshotAI/Kimi-Audio — 链接可访问(HTTP 200)
第三方资源:https://github.com/XiaomiMiMo/MiMo-Audio — 链接可访问(HTTP 200)
第三方资源:https://ai.google.dev/gemini-api/docs/gemini-3 — 链接可访问(HTTP 200)
第三方资源:https://docs.pytorch.org/docs/main/generated/torch.nn.Linear.html — 链接可访问(HTTP 200)
第三方资源:https://docs.pytorch.org/docs/2.11/generated/torch.nn.BCEWithLogitsLoss.html — 链接可访问(HTTP 200)
第三方资源:https://ai.google.dev/gemini-api/terms — 链接可访问(HTTP 200)
第三方资源:https://policies.google.com/terms/generative-ai/use-policy — 链接可访问(HTTP 200)
第三方资源:https://chatgpt.com/ — 链接可访问(HTTP 200)
第三方资源:https://openai.com/codex/ — 链接不可用(HTTP 403)
第三方资源:https://gemini.google.com/ — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 D-Composer:把鼓录音拼写成带声音的事件序列

英文题目:D-Composer: Language Modeling for Simultaneous Drum Transcription and Sound Event Decomposition
评分:8.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Patrick O’Reilly:机构信息未能在本次解析中与作者逐人可靠绑定
- Saumya Pailwan:机构信息未能在本次解析中与作者逐人可靠绑定
- Annie Chu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jason Smith:机构信息未能在本次解析中与作者逐人可靠绑定
- Bryan Pardo:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
鼓录音输入是多个单鼓声音事件叠加的混合波形,需恢复各事件出现时刻、鼓类别与可独立播放音频,难点是混合掩盖音色且同类内存在音色变化。D-Composer先将鼓声表示为MelodyFlow变分自编码器连续潜变量序列,非因果Transformer编码器将其映射为上下文向量并经交叉注意力送入因果解码器。解码器按起始时间升序自回归输出交错符号-声学流,每个事件依次为鼓类别标记、起始时间标记和32个声学标记,起始时间量化到10毫秒间隔、类别取12类MIDI鼓词汇。声学标记由鼓单音编解码器解码为单音波形,再按预测起始时间和类别摆到钢琴卷帘式表示并叠加成重构混合;与按整类分离并预测稠密转录的Analysis-by-Synthesis方法不同,该框架一次输出稀疏事件级序列并为每事件单独建模音色。在2000段4秒合成鼓声评测中,D-Composer转录的按类F1分数为0.78/0.61/0.02/0.40/0.15,高于Inverse Drum Machine的0.29/0.34/0.02/0.37/0.04。在同一2000段合成集的单鼓声提取中,D-Composer的多尺度频谱损失为5.68/1.26/3.05/0.63/1.17,低于Inverse Drum Machine的8.01/3.30/4.37/0.81/1.24。结论适用于4秒鼓循环和12类MIDI鼓词汇内分解,超出该时长、类别或高度非西方鼓语汇的泛化尚未验证。原文披露单次D-Composer训练约41.4 kWh,DOC训练约12.6 kWh。
🔗 开源资源
代码相关资源:https://d-composer.github.io — 链接可访问(HTTP 200)
第三方资源:https://www.apple.com/logic-pro/ — 链接可访问(HTTP 200)
第三方资源:https://www.native-instruments.com/en/products/komplete/drums/battery-4/ — 暂时无法访问(HTTP 429)
第三方资源:https://d-composer.github.io — 链接可访问(HTTP 200)
第三方资源:https://github.com/descriptinc/audiotools — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 Flash RNN-T:把联合网络与损失的显存占用控制到分块粒度
英文题目:Flash RNN-T: Memory-Efficient Joint Network and Transducer Loss Computation
评分:7.8/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
排名:前25% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Mahmoud Ashraf:Tarteel AI
📌 核心摘要
循环神经网络转换器(Recurrent Neural Network Transducer,RNN-T)把声学编码器状态和预测网络状态在每个对齐位置组合,再输出包含空白符在内的词表分布,训练时要对全部对齐路径求和。难点是联合网络隐状态和词表对数几率(logits)的体积远大于前向后向递推真正需要的空白符与目标转移对数概率,常规批量训练会同时保留这些大张量。Flash RNN-T 先把全部有效对齐位置打包成均衡小块,每块只保留紧凑的转移对数概率并丢弃隐状态和对数几率,前向后向递推完成后再逐块重算并求导,投影后状态留在检查点之外复用。块内还用专用核融合加法、激活和丢弃,用归一化核直接由两个对数概率求对数几率梯度并原地覆盖。与 Apex 相比,中等负载下所选分块配置在 H100 上达到 2839 样本每秒、1.84 GiB,在内存降为约九分之一时吞吐低 16.3%。结论只适用于论文的三种批量和 H100 与 RTX 5090 上的联合损失测量,长序列的格点缓冲仍随长度增长,原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/MahmoudAshraf97/flash-rnnt-paper — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. 一次前向就能补高频:多带宽语音扩展的三段式做法

英文题目:Bridge, Distill, Refine: High-Fidelity One-Step Generation for Multi-Bandwidth Speech Extension
评分:7.5/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zhiqi Ai:机构信息未能在本次解析中与作者逐人可靠绑定
- Xu Shen:机构信息未能在本次解析中与作者逐人可靠绑定
- Mou Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yongjin Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Shugong Xu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音带宽扩展要从带限观测恢复48 kHz语音缺失的高频成分,输入截止频率多变且缺失部分不能由观测唯一确定,需在保留观测频谱的同时生成合理高频。BDR-BWE先在压缩复数短时傅里叶变换(Short-Time Fourier Transform,STFT)域学习截止频率条件的流桥,把带限观测谱与带噪起点运送到干净谱,观测频段只加弱扰动而缺失频段保留完整生成不确定性。流桥学到的多步轨迹再经渐进一致性蒸馏压成一步或两步生成器,蒸馏只复现教师轨迹而不引入对抗或感知目标。最后对抗微调直接优化固定步数生成器,结合波形多周期判别器与子带恒Q变换判别器监督及对数梅尔与高频幅度重建,修复一步模型的细节与谐波连贯性而不增加推理步数。相对固定带宽或多步扩散方法,该框架用单个条件模型处理多种输入带宽,并把采样压缩到一次或两次网络前向。在VCTK上,一步模型在8 kHz输入下LSD为0.755,低于最强基线FlowHigh的0.820,降幅约7.9%。结论适用于论文采用的切比雪夫低通退化与重采样流程,跨语种、真实信道和主观听感仍需验证;推理开销为模型参数量1.80M、每次网络评估处理每秒音频需16.8 GMACs,一步或两步推理按评估次数累加。
🔗 开源资源
第三方资源:https://aizhiqi-work.github.io/bdr-bwe-demo/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/gudgud96/frechet-audio-distance — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. 压缩频谱损失何时有助于 DDSP 参数估计

英文题目:Rethinking Magnitude Compression in Spectral Losses for DDSP Parameter Estimation
评分:7.5/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Byunghoo Park:机构信息未能在本次解析中与作者逐人可靠绑定
- Jayeon Yi:机构信息未能在本次解析中与作者逐人可靠绑定
- Minje Kim:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
可微分数字信号处理要从目标声音反推合成器或物理模型的参数,网络输出参数后经可微分渲染再与目标比较频谱,难点是参数的微小变化会引起频谱上结构化的大范围改变,损失函数必须在感知相关性和参数优化信号之间取舍。本文研究幅度压缩的作用,提出信息区指携带指向目标方向信息的动态范围区间,并用一致性衡量损失按参数距离给候选排序的正确概率。分析沿目标峰值向下逐步纳入低能量频点以观察排序能力的变化,比较线性项与对数项在动态范围上的加权差异,再训练线性、对数和混合三种损失变体做验证,混合变体保留多尺度谱损失的两种项。其中两个系统用于检验高能量信息区,另一系统因信息区位于低能量而检验反向关系。与已有做法的差异是把压缩看作可依据系统选择的选项,而非默认叠加感知动机的对数项。原文未提供可核对的关键定量结果。结论适用于所测三系统及所选录音,对其他模型与中间压缩程度尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/superstem000/compression-analysis — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. 给协调单独一个大脑:Jarvis 如何在通话不断时管住后台任务
英文题目:Jarvis: Coordination Deserves a Brain of Its Own in Agentic Interactive Models
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Yuxiang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Shengbo Cai:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhixian Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Yingda Shen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuancheng Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xueyao Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Liqiang Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Teddy Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Steve Yves:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhizheng Wu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
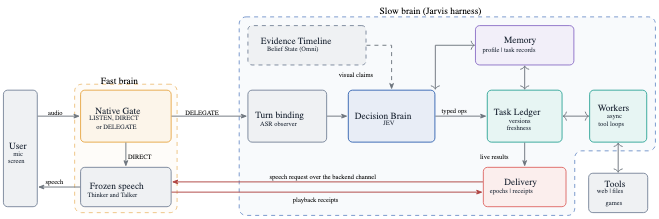
全双工前端模型负责持续听说,后台慢脑负责工具调用与多步推理,两者速度不同导致用户在任务运行中修改、取消或替换请求时,旧计划与旧结果仍被执行或播报。Jarvis把这类判断交给独立的协调层,输入是用户新话轮与当前在途任务状态,输出是对任务记录的操作与最终语音,难点在于判断必须同时看到对话与任务版本并在旧工作生效前落地。准入判断先决定何时接管并附上对应转录,其输出的话轮连同版本化任务台账一起送入类型化决策模型JEV,由JEV在与任务版本绑定的操作中选择新建、修改或取消等动作。代码随即按当前任务版本校验该选择再执行,执行前重查计划新鲜度、播报前重查结果新鲜度并以播放回执确认完整送达,确认后的信息才经门控写入记忆。在固定Venus-Audio前端、准入路径与后台而只更换协调层的对照实验中,τ-Voice成功任务数指标上Jarvis以278题中192题高于QAA的29题。在Full-Duplex-Bench v3共100段真实录音的公开对比中,Pass@1指标上Jarvis-Audio为69%高于GPT-Realtime的60%。结论适用于后台工作与对话并发且用户可能中途改意的语音助手,视觉扩展实例说明同一规则可用于随时间失效的屏幕证据。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://amphionteam.github.io/Jarvis-Demo/ — 链接可访问(HTTP 200)
第三方资源:https://typesafe.ai/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/akhilaaa3/Jev-Omni — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/google/gemma-4-12B-it — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. JAVIS:用一个统一表示同时流式生成语音和脸

英文题目:JAVIS: Joint Audio-Visual Interaction and Streaming for Real-Time Conversational Agents
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.4/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Junseok Ahn:机构信息未能在本次解析中与作者逐人可靠绑定
- Jaehyun Park:机构信息未能在本次解析中与作者逐人可靠绑定
- Jeongsoo Choi:机构信息未能在本次解析中与作者逐人可靠绑定
- Joon Son Chung:机构信息未能在本次解析中与作者逐人可靠绑定
- Ji-Hoon Kim:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
人类对话同时依赖词语、声音和面部变化,现有语音对话系统多先输出文本或语音,再串接独立talking face模型补画面,中间模态丢弃韵律与对话上下文,且串行等待累积延迟、破坏唇音同步。JAVIS以用户语音、对话历史和参考人像为输入,直接流式输出配对的回应语音与说话人视频,需在统一意图下保持唇音同步并达到实时。共享大语言模型理解查询后,联合精炼头将其输出扩展为统一音视频表示,语音分支用该表示采样语音词元并经流式解码声码器合成波形,运动分支以该表示加后一块表示为前视、结合上一运动块与参考面部状态自回归生成面部运动系数并渲染成像,两路并行流式输出。为补充真实音视频对话不足,JAVIS-Syn用情绪可控的人脸生成模型合成334小时多轮情绪对话与助手问答语料。在两块RTX 4090上以五次查询平均的流式延迟评测中,相比FAC + InfiniteTalk,JAVIS初始延迟从252.0 s降至1.27 s,实时因子从20.9降至0.541。在VStyle 140个未见样本的客观评测中,相比FAC + FLOAT的LSE-C 7.94、LSE-D 8.26,JAVIS的LSE-C升至9.59、LSE-D降至6.74,同步最准且视频与语音质量相当。结论适用于短回应流式生成与正面清晰人脸条件,长对话记忆、全双工打断与真实噪声环境的表现仍需验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. 用一句话能说清的提示做目标说话人提取

评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yutong Wen:机构信息未能在本次解析中与作者逐人可靠绑定
- Ke Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Prem Seetharaman:机构信息未能在本次解析中与作者逐人可靠绑定
- Haonan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Oriol Nieto:机构信息未能在本次解析中与作者逐人可靠绑定
- Paris Smaragdis:机构信息未能在本次解析中与作者逐人可靠绑定
- Justin Salamon:机构信息未能在本次解析中与作者逐人可靠绑定
- Zeyu Jin:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
多人同时说话时需要根据给定线索只取出目标人的声音,输出是干净的目标语音波形,难点在于单一线索可能含糊、说话人音色相近,而且混合中存在部分重叠、轮流发言与全重叠,单线索掩码预测模型易产生可闻损伤且难以跨声学条件泛化。PromptSep-Speaker是一种基于潜在扩散的生成式目标说话人提取模型,在同一模型内统一说话人顺序编号、转录文本、注册音频和文字描述四种可互换线索,用户按场景提供其中一种即可。混合波形与注册音频由冻结的编解码器编码为潜在表示,文本类线索另行编码,冻结语音表示提供兼顾音素与说话人信息的语义特征,扩散变换模块在条件注入下生成目标潜在表示,再由解码器重建波形。其中转录与说话人顺序线索经由对齐模块,让混合帧去查询线索词元形成跨注意力映射,辅助对齐损失直接监督该注意力在目标活跃帧与词跨度上的分布,迫使模型真正使用线索定位目标。在CapSpeech-Mix两说话人混合上,转录线索下PromptSep-Speaker的SI-SDRi为8.73 dB,高于DAE-TSE的2.13 dB,相对高出约6.6 dB。在内部集上文字描述线索下其SI-SDRi为4.99 dB,高于最强基线SAM-Audio的-12.80 dB,至少高出12 dB,且决策F1为0.87,对照为0.65,绝对差0.22。该结论主要适用于两说话人英文混合,对三说话人、不足六成词的极短转录和全重叠等情况分离指标明显回落,其中三说话人说话人顺序线索降至4.72 dB。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://yutongwen.github.io/PromptSep-Speaker/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. 自发语音为什么难对齐:噪声与笑声下如何保住词边界

评分:7.0/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Laurin Wagner:机构信息未能在本次解析中与作者逐人可靠绑定
- Mario Zusag:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
强制对齐的输入是一段语音与已知文字转写,输出是每个词和音素在时间轴上的起止时刻,自发含噪语音中填充词、笑声、呼吸、咳嗽与截断易把相邻词边界吸入静音或事件段。发音引擎espeak-ng把词转为39个英语音素序列,再为填充词与12种非词事件各设单音素词典条目,使笑声等拥有独立声学与时长统计,输出的音素序列直接规定隐马尔可夫待对齐状态串。冻结的WavLM-Large第22层表示经插值到10毫秒网格、主成分分析降至39维后,以等分帧初始化做40轮期望最大化训练单音素三状态从左到右模型,得到逐帧状态标签。把相邻帧拼接后的表示按该标签拟合39维线性判别分析投影,再在此空间训练三音素高斯混合模型并在第10、20、30轮重对齐,投影输出即为三音素建模的输入特征。噪声稳健变体拟合投影时把干净特征与其加MUSAN音乐噪声5–15分贝信噪比拷贝配对并共享帧标签,使类间可分方向压制噪声变化。在Buckeye会话语音上词边界平均绝对误差为20.6毫秒,相对十个基线中最强者降低19%;在FluencyBank口吃语音上为76.9毫秒,相对最强基线降低17%。在Buckeye宽波束评测下超200毫秒错误率为0.37%,低于Montreal Forced Aligner最优配置的0.98%;在Buckeye加高斯噪声0分贝信噪比下词边界平均绝对误差为96毫秒,低于us_arpa的417毫秒。结论适用于英语朗读、会话和口吃语音及其加性噪声评测条件,重度噪声与未见事件类型下误差仍明显上升。特征抽取后训练在中央处理器上数小时完成,原文未披露推理时延、吞吐与部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. 用平面图批量造出多房间语音房:AcousticAgent 解读

英文题目:AcousticAgent: A Floorplan-Centric Simulation Platform for Distributed Multi-Room Speech Processing
评分:7.0/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Zhiqi Ai:机构信息未能在本次解析中与作者逐人可靠绑定
- Han Cheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Shiyi Mu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yongjin Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Shugong Xu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
住宅远场跨房间语音随房间拓扑、几何、连通性和表面声学变化,单麦克风难覆盖整屋,需由户型生成多通道房间脉冲响应与混响音频支撑评测。AcousticAgent将结构化向量、栅格图或自然语言户型统一为房间多边形、墙体洞口与家具的可编辑场景,图像文本经可选大语言与视觉模型解析后归一,材料库按语义赋予六个倍频带参数作为求解条件。混合求解器枚举有效洞口门户路径求解直达透射绕射,以接收端蒙特卡罗射线追踪累积早中期反射并用反馈延迟网络合成晚期混响,卷积干声得混响音频,静态几何材料连通性不变时仅重算传播即复用于不同声源与布设。在混入空间MUSAN音乐干扰与30 dB设备噪声的整屋房间分类中,每房一麦克风的GCC-FP在20、10、5 dB下准确率为92.5%、89.9%、84.0%,高于同布设GCC-Euclidean的81.9%、80.6%、76.5%,以约四分之一通道接近每房一阵列的94.4%、90.0%、85.2%。在65、55、30 dB声压级校准混合且同一多通道维纳滤波下,GCC-FP所选四通道湿测PESQ为3.175、STOI为0.968,高于固定客厅阵列的2.561和0.899。在五间或十间房带家具与空房、8192至131072条射线下,Numba吞吐5.80至12.86个RIR每秒,CUDA为12.29至14.47个RIR每秒并高于前者,测于Xeon Gold 6346与单张RTX 4090,异步设备等尚未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. 只用中英训练,能给没见过的阿拉伯语挑发音错误吗

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xintong Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Junchuan Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Ye Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
发音检错与诊断需要指出学习者把哪个目标音发错以及实际发成了什么音,新语言往往缺少逐音素标注的学习者语音,重复采集成本很高。论文研究的输入是学习者语音、合成的规范语音和规范音素序列,输出是对齐到规范序列的实际音素序列,再由此判定检出与诊断是否正确,难点是规范先验容易让模型直接照抄目标音而漏检真实错误。方法先用监督微调让基于Qwen3-ASR-1.7B的模型学会利用上下文示例,再用组相对策略优化按检测F1和音素错误率组合的奖励继续优化,推理时以示例检索适配未见说话人。与只用规范音素或只做识别的已有方法不同,该框架同时引入声学层面的规范语音作为接地参考,并把示例检索和奖励优化用于保持对错误的敏感性。在仅用普通话和英语训练、阿拉伯语只做未见语言评测的条件下,阿拉伯语古兰经朗读测试上检测F1为38.07%,低于在阿拉伯语上训练的挑战基线的44.14%,而同期普通话和英语分别达到78.68%和58.78%。该迁移结论只在同时提供规范语音与规范音素并在推理时加入标注示例时成立,缺少规范音素时音素错误率极高,且增加示例数对F1的提升并不单调。原文还指出阿拉伯语召回偏低且诊断准确率有限,评测仅限阿拉伯语一种未见语言及部分单说话人口音,更多语言、口音和学习者群体尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/datasets/IqraEval/Iqra_Extra_IS26 — 链接可访问(HTTP 200)
第三方资源:https://magichub.com/datasets/ — 暂时无法访问
第三方资源:https://magichub.com/datasets/sichuan-dialect-scripted-speech-corpus-daily-use-sentence/ — 暂时无法访问
第三方资源:https://magichub.com/datasets/singaporean-chinese-conversational-speech-corpus/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-ASR-1.7B — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/FunAudioLLM/Fun-CosyVoice3-0.5B-2512 — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/silma-ai/silma-tts — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/microsoft/wavlm-base-plus-sv — 链接可访问(HTTP 200)
第三方资源:https://github.com/GitYCC/g2pW — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. 盯住发声细节再配音:SCR-V2A 如何用语义关键区域做视频到音频生成

英文题目:Semantic-Critical Regions for Video-to-Audio Generation
评分:6.6/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yun Fang:The University of Sydney, Sydney, Australia
- Wei Guo:The University of Sydney, Sydney, Australia
- Zhuonan Liang:The University of Sydney, Sydney, Australia
- Heng Wang:The University of Sydney, Sydney, Australia
- Weidong Cai:The University of Sydney, Sydney, Australia
📌 核心摘要
视频到声音生成需要从视频输入合成语义和时间对齐的音频输出,难点是发声线索常藏在嘴部开合、手部触弦、触地碰撞等细小且短暂的局部动态中,全局视频表征容易淹没这些对应关系。论文把承载发声证据的图像局部称为语义关键区域(Semantic-Critical Regions,SCRs),并构建SCR-V2A框架处理该问题。声音相关视觉定位用视频编码器预测声音事件标签并生成类激活图,经插值归一化和着色叠加得到热图视频,为后续控制提供与类别判别直接相关的连续激活强度。双视觉编码并行编码原始视频和热图视频并拼接成控制表征,再经控制适配器注入冻结的音频扩散骨干,同时把预测标签作为辅助语义条件参与去噪。与已有对象级掩码或光流先验不同,该方法保留全局上下文的同时突出发声部位,强调细粒度空间证据而非粗糙物体范围。在VGGSound域内测试集上以FAD即Fréchet Audio Distance为指标,SCR-V2A为1.07,低于MMAudio的1.84。该结论适用于VGGSound域内日常视频和CountixAV跨域动作视频,且热图与原始视频混合比为50%时最优,偏向任一端都会下降。若定位器出现持续性语义误识别,错误热图会持续误导生成而降低质量,偶发低显著激活则可容忍;更复杂的自适应融合与分层注入尚未验证。训练在单张NVIDIA H100上进行40轮、批量大小为64,推理采用200步DDIM采样生成5秒音频。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. 一句内情绪变化为何让语音伪造检测器误判
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Jingyi Chen:Reality Defender
- Surya Koppisetti:Reality Defender
📌 核心摘要
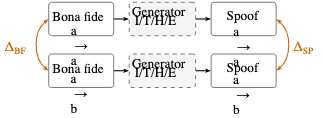
语音深度伪造检测要判断一段语音来自真实录制还是合成生成,富有表现力的合成已能在一句话内改变情绪,而检测器是否受这种句内情绪轨迹影响尚不清楚。论文构建EmoShift基准,从四个源数据集筛选情绪稳定与情绪变化的真实语音,再以其文本与分段情绪标注为生成目标,用富有表现力的文本到语音系统合成对应伪造语音,形成真实与合成类内对照。所有音频统一重采样后,检测器以重叠窗口打分并取窗口伪造概率均值再转对数几率分数,评测在真实与合成类内分别比较情绪变化相对稳定的分数差,并在情绪稳定语音等错误率点标定阈值后原样用于情绪变化语音。在OMG-Emotion合成语音固定阈值评测中,与情绪稳定语音相比,情绪变化语音的对数几率伪造分数更低,阈值在情绪稳定语音等错误率点标定后原样用于情绪变化语音时伪造漏检率上升9.7–25.3个百分点。在IEMOCAP真实语音同样固定阈值评测中,与情绪稳定语音相比,情绪变化语音的对数几率伪造分数更高,阈值在情绪稳定语音等错误率点标定后原样用于情绪变化语音时误报率上升18.6–24.4个百分点,但效应方向随检测器、数据集与情绪轨迹而异。结论仅适用于所含数据源、合成系统与检测器对照,分类与连续效价-唤醒-支配度设置生成方式不同无法分离,自然语料中跨真实与合成的直接比较仍可能受构建差异影响。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://emoshift.github.io/emoshift/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 已知音乐、未知反应:带泄漏审计的动态唤醒度变化预测

评分:6.5/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Bin Wen:机构信息未能在本次解析中与作者逐人可靠绑定
- Dai-Qiao Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tien-Ping Tan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
动态音乐情感识别常用已听声音估计同一时刻感受,该文处理另一种情形:在决策时刻后续时段要播放的音乐已确定,但听众后续反应尚未观测到,需预测群体平均唤醒度会发生多大变化。难点在于情感标签高度自相关,只复制当前状态就能得到不差分数,长音频编码器可能越过决策边界偷看未来,而同一首歌任意片段共享风格配器。方法把预报起点之后设为禁区,只取完全落入许可区间的定长音乐块并用冻结编码器独立编码得到互不串扰的过去与未来表示,再把近期情感状态作基线,将主成分汇总后完整过去加未来表示输入残差回归输出唤醒度变化量。最后保持状态与歌曲不变,仅用同曲局部平移和声学近邻替换未来段检验预报是否依赖正确位置;与已有动态识别区别在于隐藏起点之后全部标签,比较相同观测规则下状态预报与音频预报。在一千四百九十四首歌的DEAM评价池十秒视野歌曲级交叉验证中,完整过去加未来表示预报唤醒度变化的一致性相关系数为0.458,近期情感状态的一致性相关系数为0.041,前者高于后者,该结论限于唤醒度、十秒和十五秒视野与PMEmo及上述DEAM评价池,不涉及效价、个体感受或选曲干预效果。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. 把音频放进文本词表凸包里:ConvexLLM 的接口与验证

英文题目:ConvexLLM: Scaling Convex-Hull Speech Interfaces to General-Purpose Audio Intelligence
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Ming-Hao Hsu:机构信息未能在本次解析中与作者逐人可靠绑定
- Shujie Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxuan Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxiang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yingda Shen:机构信息未能在本次解析中与作者逐人可靠绑定
- Jinyu Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhizheng Wu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音音频大模型需把连续声学表示变成主要用文本训练的解码器可读输入,已有映射常把音频送到远离文本词表的位置,解码器既要利用声学信息又要保留原有文本能力。ConvexLlm用声学编码器加C-Gate接口加Qwen3.5解码器处理任务,音频先经查询投影变成查询向量再与全部冻结词向量键匹配,只保留得分最高的少量词向量并做加权平均,得到仍在词表凸包内的连续输入后与任务提示拼接,由解码器自回归生成回答。C-Gate全部输出都是冻结词向量的凸组合,即权重非负且和为1的加权和,与无约束映射和每次只取一个词的离散映射不同,训练只改变如何组合与如何解读组合,不改动作为参照的词表本身。在十一项VoiceBench任务的等权平均Overall指标上,该9B模型得到75.36分,为所比较开源权重模型中最高,其最大领先在口语知识与推理类任务,而转写与音频理解仍由更强基线领先。在MMAU Test-mini平均准确率上该模型为62.50%,低于MiMo-Audio的76.63%;在LibriSpeech test-clean和test-other语料级词错误率WER上该模型为2.39%和5.07%,低于MiMo-Audio的3.19%和6.40%但高于Kimi-Audio领先的1.40%和2.59%。在共享Stage 3流程的Qwen3.5-2B语音输入比较中,C-Gate的VoiceBench Overall为60.35分,高于MLP的58.80分和Q-Former的54.19分;K=1时两LibriSpeech分集WER均超86%且VoiceBench Overall仅22.30分,说明需混合多个词向量。结论适用于论文所用公开语音加合成指令数据与三阶段训练流程,大规模噪声口音与长音频尚未系统验证。训练成本上原文披露9B训练使用16张H100,适配音频上界为0.271M小时,推理采用贪心解码。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. 电网频率如何为视频真伪提供独立证据
英文题目:An Agentic ENF Framework for Forensic Video Authentication Against Generative AI
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.9/1.5 | 清晰度 0.7/1 | 影响力 0.4/1.5 | 开源 1/1.5 | 可复现 0.1/0.5 | 工程/实践 0.9/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ryan Wyton:机构信息未能从 arXiv PDF 文本可靠映射
- Bacha Rehman:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
输入是一段待验视频及其声称的拍摄时间和电网区域,输出是该记录是否来自真实电网环境下的拍摄,并在有时钟可查时恢复拍摄时刻,难点在于生成视频已能复现与真实相当的光学闪烁强度。统一双通道估计器在二次谐波附近带通,经短时傅里叶变换与抛物线插值恢复漂移轨迹,再由共享一维卷积与轨迹统计融合的六分类头判断一致性模式,输出的轨迹与类别进入后继验证。合成注入训练用Ornstein-Uhlenbeck过程拟合真实漂移并注入无哼声载体,生成六类一致性标签数据,为上一步估计器提供标注稀缺下的训练样本。参考匹配把记录轨迹与独立电网记录做归一化互相关验证或全时滞盲搜峰值,输出匹配分与恢复时刻,无外部参考时改为同一片段光学闪烁与音频哼声轨迹互查,结论送入编排器。编排器按非对称规则融合记录真实性与内容篡改证据,把缺席视为无信息而非造假证据,仅在廉价层无结论且有人脸时升级调用人脸相关昂贵检测器,关键差异是从检测有无谱线转向验证漂移是否与独立记录一致。在分布外FakeAVCeleb的40个片段子集上,级联相对全量集成的准确率从0.48升至0.52,每段耗时从11.3 s降至5.1 s,解码帧数从100%降至36%。系统在单个消费级图形处理器上用Python与PyTorch实现,训练开销未量化披露;结论仅在有可用电网参考或可做光声互查且为市电照明卷帘快门拍摄时适用,对16 fps等混叠拍摄、非市电照明及篡改后仍保留真实场景电网信号的内容编辑未验证。
🔗 开源资源
代码相关资源:https://github.com/RyanSolent95/enf-video-forensics — 链接可访问(HTTP 200)
第三方资源:https://github.com/ghua-ac/ENF-WHU-Dataset — 链接可访问(HTTP 200)
第三方资源:https://www.kaggle.com/datasets/farhanabidtech786/deepfake-video-9-6k — 链接可访问(HTTP 200)
第三方资源:https://github.com/RyanSolent95/enf-video-forensics — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. Qwen3-TTS 两种克隆方式在四个领域里到底差在哪

英文题目:Beyond the Benchmark: Conditioning, Domains and Failure Modes of Qwen3-TTS
评分:6.2/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.9/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Séverin Baroudi:机构信息未能在本次解析中与作者逐人可靠绑定
- Yanis Labrak:机构信息未能在本次解析中与作者逐人可靠绑定
- Petr Motlicek:机构信息未能在本次解析中与作者逐人可靠绑定
- Hervé Bredin:机构信息未能在本次解析中与作者逐人可靠绑定
- Ricard Marxer:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
零样本语音克隆指仅给一段目标说话人的短参考音频便合成任意文本语音,输入为参考音频加目标文本,输出为模仿该音色的波形,难点在于参考信道、口音、情绪与术语偏离朗读条件时仍要保持音色、韵律和可懂度。本文比较Qwen3-TTS的语境学习与X-Vector两种接口与Chatterbox、XTTS-v2、F5-TTS在朗读、远场会议、情绪对话和空管无线电上的表现,同步检验听众二选一、机器伪造检测和18项客观度量。同一参考音频与目标文本先送入五个系统生成配对音频,该配对音频再进入听众与Gemini评判的二选一辨别和AASIST检测器得到欺骗率与检出率,同时18项度量经与听众标注相关筛选保留13项并映射为说话人、韵律、基频和可懂度四个维度分及其均值总体分。在AMI会议语音偏移配对的100轮听众二选一欺骗率上,Qwen3-TTS的X-Vector为35.6%与语境学习为27.0%,高于基线最高9.0%的Chatterbox。在四语料平均的客观总体分S上,Qwen3-TTS的X-Vector为34.3分与语境学习为33.4分,高于Chatterbox的31.9分,但在单语料AMI上总体分排序与听众排序相反。短参考加错误转写是明确失效模式,在IEMOCAP短话语上Qwen3-TTS语境学习的幻觉率在整词替换下由0.8%升至21.2%,转写超过十词且经核对的干净参考才适用,短于八词、含错词或窄带噪声无线电信道时失效风险上升。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/clovaai/aasist — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. 把共现呼吸音拆开学习 PAC-KD 组合蒸馏解读

英文题目:PAC-KD: Pathology-Aware Compositional Knowledge Distillation for Respiratory Sound Classification
评分:6.1/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Li Xiao:机构信息未能在本次解析中与作者逐人可靠绑定
- Weiping Tu:机构信息未能在本次解析中与作者逐人可靠绑定
- Youqiang Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Dan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
输入为单段呼吸周期录音经预处理得到的声学特征,输出为正常(Normal)、爆裂音(Crackle)、哮鸣音(Wheeze)、混合(Both)四类上的概率分布,预测取概率最大类。难点是混合类同时包含两种病理事件,而常规四分类蒸馏只传递整类预测,没有显式利用爆裂音和哮鸣音在单病类与混合类之间的共享关系。论文先用四分类标注训练两个二分类病理专家(pathology specialist),分别学习是否存在爆裂音和是否存在哮鸣音,再把四分类学生(student)的联合分布按矩阵相加得到两个属性边缘概率,分别接受对应专家的伯努利分布散度监督。训练时比较分类损失与属性蒸馏损失在学生输出上的梯度方向,用指数滑动平均平滑余弦相似度,只在冲突时下调蒸馏权重,分类监督保持不变。推理只保留四分类学生。与四分类教师蒸馏相比,该设计让混合类同时得到两路事件监督。在 ICBHI 上平均 Score 为 65.28%,超过最强四分类蒸馏基线 0.89 个百分点;在 SPRSound 上为 89.54%,超过对应基线 0.24 个百分点。结论适用于所用划分与 PAFA 等学生结构,增益主要来自异常类检出提升并伴随正常类特异度下降。原文未披露训练时长、硬件与部署成本实测。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. DriftTTS:不用预训练、一次解码就合成语音的单阶段方法

英文题目:DriftTTS: One-stage Single Step Text-to-Speech via Generative Drifting
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.9/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jaehyun Ahn:机构信息未能在本次解析中与作者逐人可靠绑定
- Dohyun Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- Heeseung Kim:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
文本到语音需要把文字变成时长可变的语音,基于对数密度对输入的梯度(score)或流匹配的方法要多次调用解码器才能保证自然度,推理慢,而已有少步方法依赖预训练的文本到语音教师模型或额外阶段。DriftTTS 把生成式漂移引入语音合成,直接学习从先验到数据分布的推送映射,训练时让生成样本向漂移场指示的目标移动,推理时一次解码得到梅尔语谱图,再用声码器变成波形。为处理变长语音,论文提出片段漂移,在训练中截取固定长度片段并以编码器输出为先验,使每个生成片段靠近其对应目标片段。在 LJSpeech 评测集上,单步 DriftTTS 的词错率为 1.80,主观平均意见分达到 4.43,与 10 步 Matcha-TTS 的 1.93 和 4.38 接近,推理速度约快 4.2 倍。结论适用于单说话人英语、固定声码器和单步解码条件,论文承认多说话人和零样本扩展以及对特征提取器的依赖尚未解决。训练在 4 张 NVIDIA A10 上进行 2000 轮,推理用单卡测量不含声码器的实时因子。
🔗 开源资源
- 第三方资源:https://drifttts.github.io/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
20. 把四分类拆成两个属性检测:AAAF 如何分别捕捉爆裂音与哮鸣音

英文题目:Clinically Informed Acoustic-Aware Attribute Modeling for Respiratory Sound Classification
评分:5.7/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xinhong Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Li Xiao:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziyang Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuhong Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Weiping Tu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
呼吸音分类的输入是呼吸周期音频,输出是正常、爆裂音、哮鸣音、两者并存四类中的一类,难点在于后三类是稀少的异常事件,且爆裂音短促离散、哮鸣音持续延伸,同一聚合方式难以兼顾。论文提出的声学感知非对称框架(Acoustic-Aware Asymmetric Framework,AAAF)先把输入送入预训练音频编码器BEATs得到多层帧级表示,再由爆裂音与哮鸣音两个分支各自学习加权融合深层表示,形成面向各自属性的融合特征。爆裂音分支对融合特征做时间Top-K池化只保留响应最强的时间帧,哮鸣音分支用平均池化加通道注意力保留延续性模式,分别得到强调局部瞬态与持续谐波的分支表示。两个分支表示各自输出爆裂音存在与哮鸣音存在概率,推理时经阈值二值化后按逻辑组合恢复四类标签;训练时二者拼接再经辅助分类器做正常与异常二分类约束,并对三项任务按当前批次正例比例调整加权交叉熵权重。在 ICBHI 2017 四分类评测中,AAAF 的 Score(特异度与灵敏度均值,越高越好)为 65.30%,高于同期对比的最强基线,灵敏度提升是主要来源。结论适用于以呼吸周期为单位、标签可映射为两种属性组合的数据,对重叠更复杂或信噪比更低的采集条件尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. 从找句子到测时适应:构音障碍音视频句子识别怎么做

英文题目:Advancing Sentence-Level Dysarthric Audio-Visual Speech Recognition via Test-Time Adaptation
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shiyao Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Hui Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiaming Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
- Shiwan Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Yong Qin:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
构音障碍句子识别受发音含糊、异常停顿和唇动幅度小影响,单靠音频在未见说话人上退化明显,论文研究无目标说话人标注时如何用音视频互补与测试期无标注样本缓解失配。输入为待识别说话人的同步语音与唇部画面,输出为汉字转写序列,难点是年龄、病因与严重程度差异大且同步句子语料稀缺。论文先以源语音搜索-切分构建句子语料:单调约束保证时序对齐,用滤波器组特征滑动窗算欧氏距离取最小匹配,再经四人一致人工核验,不合格重搜至多三次否则剔除。对齐片段进入音视频识别框架,推理时以序列级广义熵最小化做测试时自适应,单样本上前向得输出、算损失更新选定模块并迭代固定轮次,完成后恢复原始参数以免跨样本污染。在8名说话人约8小时中文构音障碍子集的未见说话人评测中,视觉语音识别器框架01号说话人未自适应基线与10轮自适应相比,字错率从58.9%降至47.1%。音视频识别框架多在3轮后停滞而该框架可持续改进至10轮,配对检验p值均低于0.05;重度说话人基线超100%且绝对误差仍高,结论限于两个框架与该小规模语料,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/m-burchi/ViSpeR — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
22. WavLM 哪一层最懂伪造痕迹:伪造语音检测的逐层解读

英文题目:Interpreting SSL Representations for Spoof Detection: a WavLM Study
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mohamed Mallat:机构信息未能在本次解析中与作者逐人可靠绑定
- Michele Panariello:机构信息未能在本次解析中与作者逐人可靠绑定
- Massimiliano Todisco:机构信息未能在本次解析中与作者逐人可靠绑定
- Nicholas Evans:机构信息未能在本次解析中与作者逐人可靠绑定
- Anthony Larcher:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
伪造语音检测要判断输入语音来自真人还是语音合成、语音转换或对抗滤波处理,难点在于自监督前端内部表示不透明,难以知道判别线索藏在哪一层、随攻击类型如何变化。论文冻结WavLM Base,先把每层768维帧级表示经均值加标准差池化拼成1536维话语向量,再用训练集为每层单独训练线性分类器,以开发集等错误率选模型并报告真伪可分性,判别强的层向量直接作为后续解释的输入。接着把该1536维层向量经主成分分析降至50维后,与17个人工声学特征做投影加权典型相关分析,输出各层与各特征对齐强度以解释行为差异与失效原因。然后把不同层子集的1536维向量拼接成k×1536维向量重训探针做8191种组合搜索,并对同一层向量用t-SNE观察攻击组织方式。结果显示中后层最具判别力,第11层在评测集上等错误率为6.07%,低于第12层的7.3%,显示语音质量敏感性与谱信息保留需平衡。在同一评测集等错误率下,7-9-10-11-12五层组合以6.1%超过全部13层池化的8.08%,优选子集均集中在6-12层。多数谱与韵律特征在第7层附近对齐最强后衰减,只有抖动、闪烁和谐波噪声比随层加深而增强,深层把攻击组织成连续流形而非离散类别。这些结论只在ASVspoof 5第一赛道划分下成立,A22、A24、A28在深层等错误率超约30%,对抗滤波攻击在所有层等错误率远高于20%,且未在其他语料、真实录音或新攻击族验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
23. CIIR:用地址接口连接互不配对的数据集

评分:5.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:后 50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Doo Yon Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- Christian Wallraven:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
独立采集的数据集缺少样本级配对,常见多模态方法依赖同步观测学习共享隐变量,难以在训练后接入新数据集。论文要解决的是如何在不合并原始数据、不重训已有模块的条件下,让手写数字、服装图像、口语数字语谱图和手语图像通过可复用接口互相通信。统一编码器把任意输入写成十个地址之一上的128维向量,地址编号来自样本已知的本地类别序号,连续向量携带样本个性信息,冻结的各数据集解码器负责还原为各自原生图像或语谱图。新数据集接入时冻结全部已有模块,只训练读写适配器把新样本映射到已有地址原型。相对依赖配对观测推断语义对应的方法,该工作不推断跨数据集语义对应,用地址编号强制组织接口,并用与标签无关的接收器检验通信是否成立。在四个基础数据集上按地址实现准确率衡量,无标签接收器实现请求地址的比例宏平均为94.68%,其中口语数字语谱图所在数据集输入依赖表示为89.11%,高于同一设置下固定原型的40.00%。在MNIST上按同一地址实现准确率衡量,输入依赖表示为98.6%,高于学习型固定地址向量基线FV-FR的77.0%与FV-TR的84.0%。结论适用于本地类别序号已知、地址映射事先给定的情况,口语数字之外的音频泛化、开放类别路由和未知语义组合尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
24. 用自由能原理解释声音方向学习:分层次信念如何逐试次更新

评分:5.3/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 0.8/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:后 50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Roberto Barumerli:Dyson School of Design Engineering, Imperial College London, UK
- Nils Meyer-Kahlen:Dyson School of Design Engineering, Imperial College London, UK;Dept. of Information and Communications Engineering, Aalto University, Finland
- Lorenzo Picinali:Dyson School of Design Engineering, Imperial College London, UK
📌 核心摘要
读者需要理解人在逐试次视觉反馈下如何学会判断不可见声源方向,难点是侧向误差、前后混淆与极角分散交织且个体学习速度不同。论文把每次试验真实方向记为 \(\bm{\varphi}_{t}=(\alpha_{t},\beta_{t})\),把指向反应记为 \(\bm{\varphi}_{r}=(\alpha_{r},\beta_{r})\),输入为这两对方向角,输出是对听者内部信念的逐试次更新。知觉推断依据当前信念向量 \(\bm{\theta}=(\kappa_{L},\kappa_{P},w)\),把侧向分量写成以真实侧向为中心的单峰冯·米塞斯分布,把极角分量写成正确半球与镜像半球共用精度并经余弦平方几何压缩的双成分混合,混合权重表示辨别前后半球的能力。信念修正以视觉反馈揭示的真实方向为高精度教学信号计算变分自由能预测误差,再经Fisher信息缩放做在线自然梯度更新,使不同尺度的侧向精度、极角精度和半球权重一致变化,更新后信念进入下一试次的知觉推断。参数标定先用基线块尾部试次极大似然估计初始信念,再在反馈块上按序贯更新为每名被试拟合学习率,相对以往静态贝叶斯定位,该研究把知觉与学习写成统一在线更新并保留几何压缩因子。在反馈块上奇数试次拟合、偶数试次评估的留出比较中,以偶数试次留出对数似然为指标,完整模型比冻结极角精度学习的简化模型高167 nats,比冻结半球权重学习的简化模型高82 nats。结论适用于有逐试次视觉反馈的头部静止指向任务,未验证头部运动参与的主动消除混淆,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/robaru/iwai2026-fep-spatial-hearing — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
25. 去掉名字还能听懂音乐吗:身份遮蔽的音乐理解评测 MUB
英文题目:MUB: An Identity-Masked Benchmark for Music Understanding in Multimodal Language Models
评分:4.9/10 | 创新 1/2 | 技术严谨 0.8/1.5 | 实验充分 0.5/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:后 50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Kun Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Lyra Tao:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
读者需要检验的是仅凭录音直接完成音乐测量的能力,难点在于模型可凭借记住歌名、外部检索或猜常见答案得分。论文复用已有标注档案的区间属性生成全局标签,按速度和调式分层抽取500首,再以不透明编号替换标题、艺人和平台标识,形成待评清单。该清单的本意是模型侧应仅接收音频与任务文字,但当前JSONL仍含路由字段和局部文件指纹,且尚无强制执行推理框架,只能作为协议要求,不能宣称隔离已实现或保证训练无泄漏。任务要求输出标量速度、主音与大小调、拍号及覆盖全曲的结构区间,在MUB基准的500首录音上,以±4%相对误差为命中规则按现行计分规则复算同一存档预测,DSP波形参考的速度准确率(BPM命中率,±4%相对误差容限)为53.6%,高于测试分布常数先验的9.0%。在MUB基准同一500首录音的拍号评测中,固定猜4/4的常数先验准确率为98.4%,高于DSP波形参考的36.6%,因492首参考为4/4导致极不平衡。两基线均未预测区间而平均区间F1为0.000,属于弃权,不是分割能力下限,且调性沿用方向错误的遗留规则计分。结论仅适用于现行评分下的存档预测复算,DSP本次没有重跑,也无MLLM实测比较,不支持模型排名;原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/Token-Spark/music-understanding-benchmark — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。