📄 给协调单独一个大脑:Jarvis 如何在通话不断时管住后台任务
英文题目:Jarvis: Coordination Deserves a Brain of Its Own in Agentic Interactive Models
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
👥 作者与机构
- Yuxiang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Shengbo Cai:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhixian Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Yingda Shen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuancheng Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xueyao Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Liqiang Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Teddy Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Steve Yves:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhizheng Wu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
全双工前端模型负责持续听说,后台慢脑负责工具调用与多步推理,两者速度不同导致用户在任务运行中修改、取消或替换请求时,旧计划与旧结果仍被执行或播报。Jarvis把这类判断交给独立的协调层,输入是用户新话轮与当前在途任务状态,输出是对任务记录的操作与最终语音,难点在于判断必须同时看到对话与任务版本并在旧工作生效前落地。准入判断先决定何时接管并附上对应转录,其输出的话轮连同版本化任务台账一起送入类型化决策模型JEV,由JEV在与任务版本绑定的操作中选择新建、修改或取消等动作。代码随即按当前任务版本校验该选择再执行,执行前重查计划新鲜度、播报前重查结果新鲜度并以播放回执确认完整送达,确认后的信息才经门控写入记忆。在固定Venus-Audio前端、准入路径与后台而只更换协调层的对照实验中,τ-Voice成功任务数指标上Jarvis以278题中192题高于QAA的29题。在Full-Duplex-Bench v3共100段真实录音的公开对比中,Pass@1指标上Jarvis-Audio为69%高于GPT-Realtime的60%。结论适用于后台工作与对话并发且用户可能中途改意的语音助手,视觉扩展实例说明同一规则可用于随时间失效的屏幕证据。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
第三方资源:https://amphionteam.github.io/Jarvis-Demo/ — 链接可访问(HTTP 200)
第三方资源:https://typesafe.ai/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/akhilaaa3/Jev-Omni — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/google/gemma-4-12B-it — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
这篇论文要解决的通话场景是什么
输入是用户连续说出的语音,有时还伴随屏幕画面,目标是让助手一边自然对话一边完成需要工具和多步推理的工作。论文举的游戏之夜例子很典型:用户一口气要做浏览器小游戏、查上海天气、找科技头条,随后又改双人玩法、改计分规则、问代码问题、定零食预算、换浅色主题并取消欢迎牌,最多 4 个任务同时在跑。
必须保留的信息是每个请求当前是哪个版本、计划依据的对话快照是否还成立、答案是否被完整听到、记忆是长期偏好还是仅限今晚的条件。输出不仅是说出一句话,还包括正确修改对应任务、丢弃过期结果、不把没听完的记为送达。评价看任务是否真正写库成功、工具参数是否正确、回答播出后是否被完整接收。
已有快慢分工为什么还会出错
已有路线一是端到端全双工模型边说边做判断,二是把协调交给快脑或慢脑其中之一。快脑能发工具调用但看不见任务版本,慢脑了解自己任务但跟不上对话,任务管理器虽有取消和回执,仍由模型自由写出调用,无法保证调用目标在生效时仍然存在。
论文把这类错误归为 6 种:旧版本结果被播出、六十美元改错任务、用户纠正后旧计划仍执行、被打断却记为送达、今晚条件覆盖长期记忆、画面中队友已阵亡建议仍播出。它们不是识别错也不是推理错,而是判断依据的状态已经过期。只靠提示词写跟随最新请求,无法回答生效时刻哪个版本才是当前版本。
协调为什么值得单独做一个大脑
每来一个新话轮,系统要同时回答三件事:这是新工作还是对在途任务的修改、改的是哪一个任务的哪一版、已完成的结果和已播出的声音是否还算数。快脑和慢脑各只看到一半,任何一方单独决定都会缺上下文。
论文提出的准则是模型判断、代码执行。理解交给能同时看到对话和在途任务的决策模型,可执行性交给运行时代码。运行时先把可选操作按当前账本造好,模型只做选择,代码再按任务标识和版本号校验后生效,过时选择直接变为空操作。
请求从麦克风到被听见经过哪几站
音频同时进入前端模型和流式语音识别观察器。原生门每隔 1 秒读一次前端控制状态,在继续听、直接回答、转交慢脑之间三选一。转交时记录决策采样点,并绑定该采样点之前开始的最近完整转写,避免使用前端改写过的转述。
转交后决策脑读取话轮、近 12 轮历史、待澄清问题、用户画像和可用工具,从运行时造好的操作集合中选一个。账本据此建任务或推进版本,异步工作器跑工具循环,结果通过前端自己的声音播出,播放回执决定是否算送达。快脑继续说话,慢脑继续更新任务,两边不互相等待。
下图是整体分工导读,重点看快脑何时交出话轮、慢脑内部如何形成闭环,以及虚线所示仅视觉实例才有的感知模块。
快脑 × 慢脑: 快脑指实时全双工前端模型,负责边听边说、维持对话不中断;慢脑指在后台做推理和工具调用的智能体管线。两者速度不同、看到的信息不同,快脑听见全部对话但看不见任务版本,慢脑知道任务细节但跟不上对话变化,Jarvis 的协调层就是为了弥合这种信息差而存在。
看图路径: 1. 先沿用户到快脑再到慢脑的主箭头走一遍;2. 注意决策脑到任务账本的类型化操作箭头;3. 看投递模块如何用回执再连回前端语音
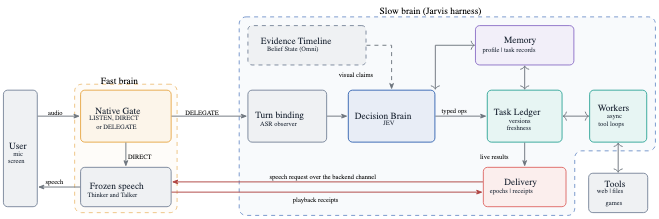
论文图 3。原论文 Figure 3::“Overview of Jarvis. The fast brain keeps the conversation going and decides when to hand a turn over.”。
该图确实显示左侧快脑包含原生门和冻结语音,右侧慢脑包含话轮绑定、决策脑、任务账本、工作器、投递和记忆,视觉声明只进入决策脑,投递用回执连回前端语音。这说明协调不是附在某一脑上,而是看到两边状态的独立通路。
原生门如何在不改声音的情况下决定转交
原生门只学何时转交,不碰语音权重。它读前端在当前位置预测继续听还是开始说的概率,再看开始说之后是走转交标记还是普通首词,从而形成 3 分支策略。任一直接回答或转交分支概率达到 0.8 才动作,否则继续听,未定则保持监听。
训练只动思考器上秩为 8 的低秩适配器,约 6,200,000 参数,路由前向用独立前缀和独立缓存,语音前向关闭适配器,因此听到的声音仍来自发布的冻结权重。优化用分组相对策略优化,在自写自合成的双语场景上按分支给分,答对加分答错扣分,并用散度约束贴近每阶段起点。开发集上首次准时准分支转交从 164 个中的 149 个升到 162 个,即 90.9% 到 98.8%,早期集合保持 40 个全对。
下图左侧是随 1 秒音频单元变化的 3 条概率曲线,右侧是路由与语音双通路结构,读图时注意阈值线和适配器只在上面一路生效。
看图路径: 1. 看左侧三条概率曲线何时交叉并超过阈值;2. 对比右侧路由通路与语音通路的适配器开关
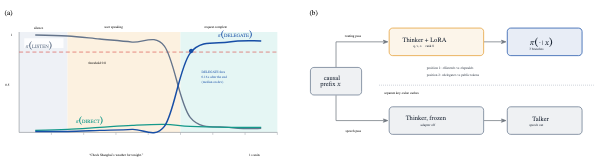
论文图 4。原论文 Figure 4::“The Native Gate. (a) On each one-second audio unit the gate reads a three-way policy from the native tokens of the front model.”。
图中可见请求未说完时继续听概率占优,说完后转交概率迅速越过 0.8 阈值,中位在请求结束后 0.16 秒触发;右侧明确区分带适配器的路由计算和冻结权重的语音生成。这解释了小闲聊保持快速、真任务才进慢脑的原因。
决策脑怎样只选能执行的操作
决策脑 JEV 是类型化判断模型,不返回自由文本,只有选择、是否和打分 3 类问题。关键是选项由运行时按当前账本现写,例如把今晚六十美元同时展开为细化零食计划和细化游戏等候选项,每个选项自带任务目标和状态文字。模型输出每个选项的概率,运行时取最高且超过阈值的执行,低于阈值则不猜,转交工作器回答或追问一句。
因为选项自带任务和版本,可接受的答案天然可执行,不存在指向不存在任务的调用;若选择依据的是旧版本,生效时版本已变则直接作废。同一接口还管记忆写入、投递时机等多处判断,同一话轮的多个小问题一次调用独立作答,中位 0.81 秒,记忆门中位 0.32 秒。
价值评估模型 × 辅助分数模型: 本篇不使用价值评估模型和辅助分数模型这两个角色。本文的判断由类型化决策模型 JEV 承担,它只在运行时给出的候选操作上输出概率分布,不生成自由文本;运行时代码再检查版本号和状态并执行,因此模型负责理解,代码负责保证可执行性。
运行时造操作集合的规则如下式所示,集合包含直接回答、取记忆、对每个在途版本的可取消、可细化、可查状态、可恢复,以及有播音时的停止说话。
\[\mathcal{O}_{t}=\{\texttt{\small ANSWER},\texttt{\small MEMORY}\}\;\cup\;\{\,a{:}\tau{:}v\;\mid\;a\in\{\texttt{\small CANCEL},\texttt{\small REFINE},\texttt{\small STATUS},\texttt{\small RESUME}\},\ (\tau,v)\in\mathcal{L}_{t}\,\}\;\cup\;\mathcal{S}_{t},\]其中操作按任务与版本索引,状态是当前话轮上下文,执行规则是取概率最大且超过阈值的选项,否则不执行任何任务变更。
\[o^{\ast}=\arg\max_{o\in\mathcal{O}_{t}}p(o\mid s_{t}),\qquad\text{execute }o^{\ast}\text{ only if }p(o^{\ast}\mid s_{t})\geq\theta.\]这就是把六十美元绑定到零食计划第一版而不是游戏第三版的机制:绑定发生在选项生成时,而不是靠模型自己写出任务名。
任务账本如何拦住过期结果和过期计划
账本是唯一记录请求与进展的地方,每个任务有标识、版本和同 utterance 衍生的逻辑请求组。同一请求同时最多一个在途版本,细化产生新版本并把旧版本置为被取代,取消则置为已取消并停掉对应工作器。
4 个不变量分别对应前 3 种失败:结果只接受在途版本,迟到的旧草稿直接丢弃并记日志;执行前重比工作器做计划时的对话快照与当前快照,用户改过单号或撤回授权就重规划;送达必须有完整回执。文件列表只收工具确认写成功的文件,不采信模型自称写了什么。
任务账本 × 价值评估模型: 任务账本是记录每个请求标识、版本号、状态和投递回执的版本化台账,是协调的事实来源;它与价值评估模型无关,本文没有用模型去估计价值,而是用账本的不变量规则直接拒绝过期版本的结果和计划。
下图是任务从排队到运行再到已完成、已送达的生命线导读,重点看细化如何开新版本、停止语音为何只开新轮次而不取消任务。
看图路径: 1. 从排队到运行再到已完成的主链路;2. 注意被取代分支和已取消分支的去向
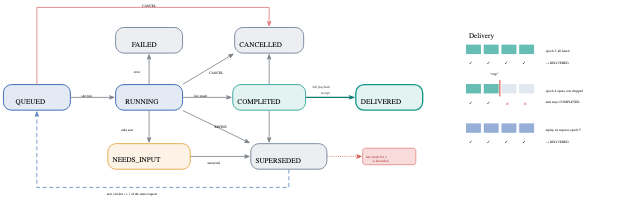
论文图 6。原论文 Figure 6::“Life of a task in the Task Ledger. A refinement supersedes the live version and starts a new one, and a result that arrives for a superseded or cancelled version is discarded.”。
图中可见已完成只有在当前轮次完整播放后才变已送达,被取代或已取消版本的结果走向丢弃,打断只切轮次不改任务状态。这就把做完和听完分成两个独立事件来记录。
投递和记忆如何区分听完与做完
投递用生成轮次隔离新旧音频,每次清空播放即开新轮次,旧轮次的音频块和控制消息到达即丢弃。客户端按轮次、块、已播采样数和是否被打断上报回执,只有同轮次全部采样播完且未被打断,才算送达。被打断的天气播报记为部分听到,保留结果待用户再要,打断重播会开新播报。停止说话与取消任务严格区分,前者只切轮次并挂起待播报,后者才作废任务版本。
送达的形式化条件是存在同轮次播报,其已播采样之和等于总采样之和且未被打断,如下式所示。
\[\textsc{Delivered}(\tau,v)\iff\exists\,r:\ e(r)=e_{\mathrm{now}}\ \wedge\ \textstyle\sum_{c\in r}\mathrm{played}(c)=\sum_{c\in r}\mathrm{samples}(c)\ \wedge\ \neg\,\mathrm{interrupted}(r).\]其中符号分别指播报所属轮次、每块已播与应播采样数,以及是否被打断,全部满足才推进为已送达。
记忆分长期画像和任务记录两库,画像存个人事实与有效期及取代链,任务库存历史任务版本与产物。只有决策脑以 0.8 阈值判定说话人在陈述长期事实或明确要求记住,才写入画像;今晚六十美元留在零食任务上,通常四十美元才进画像并可跨会话回忆。
生成轮次 × 播放回执: 生成轮次是每次清空语音后递增的编号,用于隔离新旧音频;播放回执是客户端上报的实际播放采样数和是否被打断。只有同轮次、全部采样播完且未被打断的播报,才能把任务从已完成推进为已送达,二者配合区分做完和听完。
有画面时为什么还要给证据加有效期
音频事实说完即固定,画面事实会自己变化。问是否前压时队友还活着,2 秒后可能已经阵亡。视觉实例复用账本、工作器和投递,把变化点放在感知层。
所有媒体按单调时钟对齐,只读决策时刻之前的窗口,新对局开新场景轮次以防旧画面泄漏。结论存为证据断言,记录依据观测、有效期和导致失效的事件,如场景切换、镜头切换、信号丢失或用户纠正。回答就绪时再查一次,过期则播前丢弃;播出中过期则立即掐断。问为何刚才让撤退,则用当时快照回答并标为过去证据,不作当前依据。
证据时间线 × 信念状态: 证据时间线是按统一时钟对齐的屏幕、游戏音频和麦克风轨道,只允许决策读取决策时刻之前的窗口;信念状态是在此之上提炼的视觉事实断言,每个断言带有有效期和失效事件。时间线管原始观测,信念状态管结论能否继续使用,过期结论在播报前和播报中都会被拦截。
多模态决策脑 Jev-Omni 同样只答选择与是否类问题,可看因果静帧和短音频窗,另有读计分板和判断存活的小适配器。快问走捷径约 2.2 秒开说,开放问题仍走完整工作器与赛中记忆。
门控和决策脑实际训练了什么
本节把训练与非训练部分分开。被训练的是原生门的低秩适配器,不是前端语音权重;决策脑 JEV 与 Jev-Omni 在本文作为已具判断能力的模型使用,论文未报告它们的梯度训练细节,因此不能把协调收益说成来自重训决策脑。
门控训练数据全部自写自合成:264 个中英文日常场景、154 个游戏回合、38 族连续性话轮、电话信道变体和 24 族长回答式请求,用语音合成渲染并经前端流式编码器编码。每个 utterance 切出结束前的监听前缀和结束后的决策前缀,分别标注继续听或按 rubric 标注直接答与转交。每前缀采样 8 个动作,对按 0.8 混合均匀探索,奖励对加 2 错减 1,组内归一化后做截断策略梯度,加散度和熵项,4 阶段课程并回放旧前缀防止遗忘。
视觉门的训练在 49 场录制比赛构造的 1211 个片段上进行,固定测试集 96 个,冻结控制头只对 30 个,上下文适配器对 75 个且仅漏 1 个,代价是提前动作 13 次。提前与漏检的权衡在这里很明确:漏掉意味着后级完全收不到,宁可早一点也不能漏。
实验在什么条件下比较才公平
主基准是 τ-Voice 的 278 个常规客服任务,含航空 50、零售 114、电信 114,以官方奖励是否等于 1 计成功;另有 100 条真实录音的工具基准和 200 个多轮任务的 examiner 基准,以及 80 个固定问题的对话记忆测试。前端换过三家,比较时固定前端、准入路径和后端,只换协调管线,因此差异只能来自话轮被受理之后的处理。
基线是上游任务管理器、取消与回执齐备的开放语音运行时,以及各自原生管线,所有行共享同一判分器、同一模拟来电和同一 examiner,音频以实时脉冲编码调制送入。预算是每任务额外 16384 个输出 token、12 轮工具和 120 秒。记忆测试把历史以真实音频喂入,只给已实际播出的答案打分,并做统一语音识别审计,避免文本分与听感分混淆。
只换协调层带来多大变化
先看同前端同后端只换管线的结果。下表比较问题是协调本身是否重要,公平条件是准入与后端完全相同,指标方向都是越高越好。表前已说明条件,这里直接读数。
| 条件 | 指标 | 基线 | 本方法 |
|---|---|---|---|
| 同前端 Venus-Audio | τ-Voice 解出数 | 29 | 192,共 278 题 |
| 同前端 Venus-Audio | 工具录音精确通过数 | 41 | 51,共 100 条 |
| 同前端 Venus-Audio | 多轮任务平均分 | 2.57 | 3.36,满分 5 分 |
上表显示三项全部提升,且在另两个前端上也不输基线,语音聊天模型上从 2 题升到 33 题。论文进一步拆解为受理不丢失、参数与回答更准、需写库的难任务从零突破到 137 题,中位完成时间 12.9 秒对 14.2 秒,说明不是靠拖时间换成功。
再看公开榜单的比较问题:在各自发布的系统形态下谁的工具成功率更高。下表只取通过率一列,越高越好,但后端强度并不一致,因此不能读成同算力胜负。
| 条件 | 指标 | 公开对照 | 本方法 |
|---|---|---|---|
| 工具录音 100 条 | 通过率 | GPT-Realtime 60% | Jarvis-Audio 69%,开放 9B 前端 |
该表支持的判断是协调设计可以弥补部分模型差距,但榜首两个专有推理后端的系统仍更高,69.2% 对 81.7% 与 75.4% 的差距主要来自后端等级不同。
下图导读:在左侧看 278 题柱高,在右侧看 9 组前端与类别组合的得分移动,重点确认是否有组合退步。
看图路径: 1. 先看左侧 278 题中深浅柱子的高度差;2. 再看右侧九组分数中圆点相对竖线的位置

论文图 8。原论文 Figure 8::“Jarvis against QAA with the same front model, admission path and back end.”。
图中左侧深色柱在 3 个前端上都明显高于浅色柱,右侧 9 个点全部向高分方向移动,其中实体追踪和安全类提升最大。这与表格结论一致,且补上了按类别无退步的限制条件。
每个校验分别拦住了哪类错误
基准很少让用户在任务运行时改口,因此用 80 个竞速脚本各跑三次直接测机制。每脚本固定控制决策,只考运行时,含细化、取消、规划中纠正、切任务和播中打断 4 种时序变体。
下表比较问题是去掉某条检查会付出什么代价,条件是冻结运行时与真实工具环,指标是无过期音频、无过期工具副作用、无错误送达。表前说明已给出公平条件,表后解释代价归属。
| 条件 | 一致运行 | 过期播出 | 错误送达 |
|---|---|---|---|
| 完整运行时 | 240 次全一致 | 0 次 | 0 次 |
| 去掉结果有效性 | 72 次过期播出 | 72 次 | 0 次 |
| 去掉播放回执 | 36 次错误送达 | 0 次 | 36 次 |
解释是结果检查专拦旧版本答案,计划新鲜度检查专拦已过期工具动作,回执专拦没听完记送达,三者无一能合法拦截正常投递,对照 60 次应继续的运行全部通过。计划检查去掉后同批出现 72 次工具副作用,说明光拦声音不够,还要在执行前再比一次快照。
决策速度的比较问题是判断再准、到晚了是否有用。下表条件是三者看到相同选项与上下文,阈值按开发集上错控不超过 1% 各自取最优,方向是准时正确越高越好。
| 条件 | 中位请求耗时 | 1 秒内准时正确 | 3.5 秒含兜底正确 |
|---|---|---|---|
| 通用大模型一 | 1.57 秒 | 576 次中 0 次 | 576 次中 465 次,80.7% |
| 通用大模型二 | 3.14 秒 | 576 次中 0 次 | 576 次中 456 次,79.2% |
| JEV | 0.30 秒 | 576 次中 524 次,91.0% | 576 次中 544 次,94.4% |
回放到真实运行时,旧工作器在 0.25 到 3 秒后完成时,JEV 正确绑定 252 次、及时叫停 150 次,对照分别叫停 77 次和 9 次,过期语音 36 次与 96 次对 4 次。旧工作器 0.75 秒完成时 JEV 仍能叫停约 79%,对照为零,说明差距主要来自中位耗时而非阈值运气。记忆上混合检索平均分更高,但 JEV 精选在保留部分记录的 45 题上以 4.69 对 4.36 反超,代价是 8 题丢掉全部记录导致无证据可用。
结论在什么边界内成立
主收益成立于前端、准入与后端固定的配对比较,以及共享判分器的本地复跑;换到公开榜单则后端不再同级,不能把与专有推理后端的接近解读为同等算力超越。竞速与控时实验固定了控制决策或回放实测决策,隔离了运行时,但真实用户改口的分布与脚本仍有距离。
未胜出项也很清楚:视觉端到端正确率绝对值只有 23.7% 与 25.0%,去掉画面跌到 1.0% 与 2.5% 能证明答案依赖画面,但不能证明已够实用;记忆混合检索整体更高,JEV 精选仍有丢空记录的风险;提前动作在视觉门上从 0 升到 13 次,低漏检是以部分早动换来的。延迟上慢脑工具环中位 4.6 秒、语音首包 2.7 秒,快脑虽持续监听,任务本身仍需等待工具与播报。
复现第一步做什么与还缺什么
值得尝试的情形是后台工作常被对话打断、改口集中在任务版本而非识别错误,且已有可用的全双工前端和工具后端。第一步不是换大模型,而是把任务台账、版本号校验、轮次与回执、记忆写入阈值 4 件先接好,再把决策选项改成由账本现写、模型只选,最后用竞速脚本验证去掉每条检查的变化。
关键信息条件是转交绑定必须用决策采样点之前的完整转写,选项必须带任务目标文字与版本号,阈值按错控率在开发集上另取,轮次切换要覆盖用户插话与停止指令。论文给出演示页与代码链接,第三方链接当前可达不等于作者已开源已验证部分,需按来源区分作者资源与第三方镜像。
还需补的验证是真实多用户长时分布下的误拦率、电话噪声与打断下的门控稳定性,以及视觉有效期在更多游戏与非游戏画面上的迁移。没有这些,就不宜承诺延迟、成本或误判率一定改善。
一句话总结与何时选用
Jarvis 把本由快脑或慢脑顺带做的协调独立出来,用账本记录版本、用代码校验每次生效、用回执定义送达,从而在不换前后端时大幅减少串任务、播旧答案和记错送达。选用它意味着接受额外决策耗时与阈值调参,换来的是并发修改下的可审计性;若任务从不被改口或画面从不变,收益会明显变小。
📎 论文与评分元数据
排名:前25% | 文档类型:系统技术报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses