共分析 69 篇论文
⚡ 今日概览
✅ 筛选入选 69 篇 → 🔬 深度分析完成
每篇论文保留完整分层分类;热门方向按主任务的最上级方向统计,每篇计入 1 个方向。排行榜也显示最上级任务。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| 音视频理解 | 6 篇 | ██████ |
| 语音交互 | 5 篇 | █████ |
| 语音识别 | 5 篇 | █████ |
| 病理语音评估 | 4 篇 | ████ |
| 语音合成 | 4 篇 | ████ |
| 音频理解 | 4 篇 | ████ |
| 多模态情感极性分析 | 3 篇 | ███ |
| 语音属性识别 | 3 篇 | ███ |
📊 论文评分排行榜(69 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 只看嘴能读出说什么吗:FLARE 如何向声音借知识并同时看脸和嘴唇

英文题目:Learning Visual Speech Representations via Cross-Modal Distillation and Joint Face-Lip Modeling
评分:8.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1.5/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jing-Xuan Zhang:School of Artificial Intelligence and Computer Science, Shaanxi Normal University
- Genshun Wan:iFLYTEK Research, iFLYTEK Co., Ltd.
- Jianqing Gao:iFLYTEK Research, iFLYTEK Co., Ltd.
- Jia Pan:iFLYTEK Research, iFLYTEK Co., Ltd.
- Yumei Zhang:School of Artificial Intelligence and Computer Science, Shaanxi Normal University;Key Laboratory of Intelligent Computing and Service Technology for Folk SongMinistry of Culture and Tourism
- Lichen Zhang:School of Artificial Intelligence and Computer Science, Shaanxi Normal University
📌 核心摘要
唇读是从无声唇部运动序列识别说话内容,输入是面部视频,输出是文本,难点是视觉线索本身含糊,且对头部姿态和分辨率敏感。FLARE先用弱监督语音识别模型Whisper抽取干净语音深层表示,全局归一化后经随机矩阵投影并取随机码本最近码编号,作为离散蒸馏目标。预训练对全脸视频、唇部感兴趣区域视频做同一话语内区间替换遮掩,对梅尔滤波器组音频用可学习向量替换遮掩并向波形加MUSAN噪声,再经双路视觉前端与音频投影融合送入上下文编码器,在掩蔽与非掩蔽帧上预测上述离散码,迫使视觉分支学到教师表示的序列结构。微调时该编码器接6层轻量Transformer解码器,或经适配器连接Qwen-2.5-7B大语言模型解码器,前者先冻结编码器再联合微调,后者沿用前者微调后的编码器分阶段对齐到大语言模型嵌入空间。与从零联合学习音视频表示的音视频自监督方法不同,该工作只强化视觉分支,并强调面部与唇部早期联合建模。在4966小时预训练加同量微调下,大模型加大语言模型解码器在LRS3测试集词错率(Word Error Rate,WER,越低越好)为13.2%,接近使用100000小时数据的LP-Conformer报告的12.8%。该结论依赖联合面唇输入,面部与唇部单输入优劣随数据集而变,WildVSR因无全脸视频只能用唇部评估,大偏角下唇输入词错率显著上升,而基准均只报告单次WER而未报告误差棒,重复方差与统计显著性尚未验证。原文未披露完整货币或能耗成本,附录在单张Tesla P40上用6秒语音测得双前端大模型总计算量154.9 GFLOPs、实时率0.23,接大语言模型后实时率升至1.31-1.42,作者指出未做词元压缩故效率仍待优化。
🔗 开源资源
代码相关资源:https://github.com/jxzhanggg/FLARE — 链接可访问(HTTP 200)
第三方资源:https://anonymous.4open.science/r/FLARE-522C — 链接可访问(HTTP 200)
模型相关资源:https://github.com/jxzhanggg/FLARE — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/openai/whisper-large-v2 — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen2.5-7B — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 DuET:用音符和时间帧双路编码做钢琴演奏到乐谱的转谱

英文题目:DuET: Note-Frame Dual Encoding for Piano Performance-to-Score Transcription
评分:8.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Wei Zeng:机构信息未能在本次解析中与作者逐人可靠绑定
- Ye Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
表现性钢琴演奏转谱需要把演奏时间映射到乐谱时间,输入是带音高、秒级开始时间和时值的演奏音符序列,输出是与输入音符一一对应的乐谱记录,包含小节内起始位置、记谱时值、谱表、声部、拍号、调号和装饰音标记,难点是表情性速度变化下相同演奏间隔对应不同乐谱间隔,而节拍可能出现在没有音符开始的时刻。同一音符序列连同延音踏板导出20ms网格的钢琴卷帘,音符序列作为音符编码器输入建模音符间关系,卷帘作为帧编码器输入建模含空拍时刻的时间上下文。双向交叉注意力让两个分支的中间表示互为键值交换信息,输出的音符记忆保留音符级关系、帧记忆保留逐帧节律覆盖。自回归解码器逐音符交替读取两种记忆并并行预测该音符的乐谱属性,帧记忆另经辅助头直接接受帧级节拍与下拍监督。共享演奏时间旋转位置编码把音符连续开始时间和帧网格时间放在同一坐标系,时间-音高旋转位置编码在音符注意力中同时编码相对时间距离和音程。与已有做法相比,该工作不需要外部输入节拍网格,也不用在音符位置做动态规划推断空拍。在Gangqinpu测试集上,DuET相对最强基线把MUSTER平均误差从6.56%降到3.64%,在ASAP上从11.30%降到11.22%,timing相关误差下降最为一致。结论适用于古典ASAP与偏流行风格的Gangqinpu钢琴曲目,ASAP上的缺音符和多余音符误差仍高于部分基线,原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/wei-zeng98/DuET — 链接可访问(HTTP 200)
模型相关资源:https://github.com/wei-zeng98/DuET — 链接可访问(HTTP 200)
演示资源:https://github.com/wei-zeng98/DuET — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 Anuvani-LID:面向印度语言的稳健且校准的口语语种识别

英文题目:Anuvani-LID: Robust and Calibrated Spoken Language Identification for Indian Languages
评分:7.7/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Stephen Fernandes:Central Institute of Indian Languages
- Narayan Choudhary:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
口语语言识别为每段语音输出一个语言标签,决定后续用哪种识别器和翻译方向,在印度22种表定语言加印度口音英语之间容易混淆,短语音、噪声、窄带电话和语码混合进一步加大难度。Anuvani-LID输入16 kHz语音,先算80维对数梅尔谱并降采样,再经17层Conformer编码器提取表示,加权混合各层输出后做注意力统计池化输出23类概率,训练用温度采样平衡语言、增强模拟短切与噪声混响电话信道和多人babble声,并按混淆难度安排课程。与把语言识别当隐含能力的通用模型不同,该工作先冻结102个条件的评测套件,再按阶段固定采样增强课程和优化,最后在全量54643小时上训练并平均7个检查点权重,发布115.6M参数专用模型。在37个核心条件的相同音频上,Anuvani-LID平均宏F1为0.914,比Gemini 3.5 Flash高5.2个百分点;在全23类面板上为0.897,超过次优的0.713。温度缩放后在全23类测试集上期望校准误差为0.008。该结论只适用于说话人与语料隔离的公开语料多轴评测,单标签设置无法处理语码混合,方言连续体、未见近亲语言开放集拒绝和0.25秒短语音仍易失败,后者宏F1仅0.24–0.35。最终训练在6块RTX A6000上进行约69.6小时且只跑一次,商用API只比硬标签且版本会变,Kathbath因与训练共享4个说话人仅作域内对照。
🔗 开源资源
- 第三方资源:https://huggingface.co/CIIL/Anuvani-LID — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. 缺模态时单模态模型还能协作吗:Lluna 的私有预测与公共残差协作

英文题目:Lluna: Collaborative Unimodal Models for Missing-Modality Inference
评分:7.7/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.4/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Haoyue Bai:机构信息未能在本次解析中与作者逐人可靠绑定
- Yinyi Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Heqing Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaoyuan Yi:机构信息未能在本次解析中与作者逐人可靠绑定
- James Evans:机构信息未能在本次解析中与作者逐人可靠绑定
- Jindong Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
输入是模态部分缺失的测试样本,输出是情感回归与分类、场景问答或医学预测的标签,难点在于缺失同时改变可用证据和可参与协作的模型集合,协作表示会漂移并可能不如输入未变的存活单模态模型。Lluna 先用模型专用适配器把冻结单模态特征映射为私有特征,私有头直接给出基础预测;共享对齐器把私有特征送入公共分支,在按预测一致性构建的兼容图上做消息传递和注意力池化得到公共共识,再经公共头输出残差校正。训练沿单模态移除链采样相邻状态,用渐进协作一致性让较丰富状态的归一化公共表示指导较贫乏状态,同时保留任务监督以适应剩余证据。与单体多模态预测器和常规协作相比,该设计保留了模态特有信息的直接通路,又用局部一致约束组织跨状态协作。在 8 个数据集上,Lluna 在非全输入状态平均的缺失平均指标上相对最强基线平均提升 4.26%,适用范围限于已知可用状态的整模态移除。原文未披露训练、推理或部署的耗时与算力成本。
🔗 开源资源
- 代码相关资源:https://github.com/AIFrontierLab/Lluna — 链接可访问(HTTP 200);README 已验证包含安装、推理与微调文档
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. 用符号乐谱盯住中间层:MIDI-REPA 如何改进文本生成音乐

英文题目:MIDI-REPA: Improving Text-to-Music Generation with Symbolic Representation Alignment
评分:7.6/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Song-Ze Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Fang-Duo Tsai:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi-Hsuan Yang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
文本到音乐生成需由文字提示直接生成立体声音乐,难点在于模型要同时从稠密音频中学会稀疏的旋律节奏和声结构与声学实现,直接重建或去噪易弱化前者。本文在FluxAudio-S扩散变换器基线上增加符号表示对齐分支,先用预训练自动转录离线把训练音频转成与潜变量同时间分辨率的二值钢琴卷帘作为对齐目标,再在流匹配训练中取出条件扩散变换器中间块隐藏表示经时域卷积投影头映射到该符号目标空间求有效帧负余弦相似度,与条件流匹配目标加权联合从头训练,推理时去掉转录与投影头。在去除声乐提及后629条Song Describer提示、8组匹配种子取均值的设计对比上,MuScriptor合并钢琴卷帘、对齐早期L2层、全轨迹t∈[0,1]配置的弗雷歇音频距离越低越好从同随机种子无对齐基线的0.5275降到0.4947,音频文本相似度CLAP越高越好从同基线的0.2220提高到0.2686。在学术文本到音乐挑战80个域内提示的官方客观评测上,该122M参数配置的弗雷歇音频距离从组织方FluxAudio-S基线的0.757降到0.497,CLAP相似度从该基线的0.088提高到0.315。结论适用于器乐短音频与低成本训练场景,Basic Pitch等较粗糙监督反而可能损伤质量。按挑战口径折合的训练成本以A100等效GPU小时计,该配置的14.2低于表中所列终选系统的对应成本,对应单张RTX 3090上约31小时完成训练。
🔗 开源资源
代码相关资源:https://midi-repa.vaclis.net — 链接可访问(HTTP 200)
第三方资源:https://midi-repa.vaclis.net — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. 用听神经锁相做无训练音频水印:CochlearMark 解读

英文题目:CochlearMark: Audio Watermarking via Phase Locked Auditory Nerve Representations
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.3/1.5 | 清晰度 0.9/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Qin Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Strahinja Nikolic:机构信息未能在本次解析中与作者逐人可靠绑定
- Milos Cernak:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
音频水印需在波形中加入难察觉扰动并在压缩滤波混响等处理后仍可检出,已有神经水印的鲁棒性来自训练学到的编码器和检测器,在新处理下的行为只能靠实测确认。CochlearMark输入4.0 s波形,输出加性水印波形与投影分数,可微听神经纤维模型先将其映射为各特征频率通道的神经图,神经图再按各通道特征频率计算向量强度得到锁相特征。锁相特征与密钥生成的单位方向做内积得到分数,检测比较该分数与干净样本均值加权标准差所得阈值,嵌入则沿该分数对波形的梯度优化扰动使分数超过同一阈值。嵌入沿初始分数梯度方向用二次模型估计到达阈值的最小能量步长并经带限与包络门控约束,未达阈值时追加至多三次Adam校正,校正后的扰动加回原采样率信号。与AudioSeal、WavMark、Patchwork和扩频使用相同来源片段相比,在LibriSpeech、GuitarSet和Clotho混合的6,964个片段上,未攻击检测以ROC-AUC衡量CochlearMark为0.987-1.000,与神经基线相当,信噪比约31.0 dB落在基线范围内。在上述6,964个片段混合评测下以存活率即TPR@1% FPR衡量,EnCodec重编码存活率从24 kbps时的0.87降至6 kbps时的0.20。结论适用于保留时间精细结构的信号编辑,不适用于音高变换、音色转换、文本到语音重合成与去除链等重建波形的变换。在Intel Core i7-6850K单CPU上按每秒音频计,以计算时延衡量嵌入39 ms高于检测4.4 ms,模型体积为145 KB且免训练、无训练开销。
🔗 开源资源
第三方资源:https://github.com/msaddler/auditory_machine_learning — 链接可访问(HTTP 200)
第三方资源:https://github.com/guillaumemeyer/watermarks-remover — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. 噪声下让人听清的语音合成:NIL-TTS 如何感知噪声并调整发声

英文题目:Noise-Aware Lombard Speech Synthesis via Flow-GRPO for Intelligibility Optimization
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zhaoyang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Dingding Yao:机构信息未能在本次解析中与作者逐人可靠绑定
- Chengzhong Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Junfeng Li:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
嘈杂环境中语音代理需要复现伦巴德效应(Lombard effect,人受噪声影响不自觉提高发声努力以保持可懂度的生理反馈),即根据环境噪声调整发音,而多数合成系统只做固定映射或事后增强。论文提出噪声诱导伦巴德语音合成框架(Noise-Induced Lombard TTS,NIL-TTS),输入为文本、说话人参考音频、环境噪声波形及其信噪比(Signal-to-Noise Ratio,SNR),输出为在该噪声下更易听清的语音波形。该方法用特征线性调制(Feature-wise Linear Modulation,FiLM,一种按外部条件对特征做逐通道缩放和平移的条件注入方式)把噪声编码与信噪比表示注入流匹配(flow matching,学习从噪声到语谱图连续变换速度场的生成方法)主干深层,并先经有监督微调在成对普通与伦巴德语音上建立环境相关的基础映射。随后Flow-GRPO在线采样发声轨迹,以识别词错率为主要奖励并兼顾说话人相似度,直接优化噪声下的可懂度,使探索到的补偿策略回流到生成策略。在Seed-TTS中文测试集上Babble、Factory、Pink、White四种噪声平均后,-6 dB时NIL-TTS词错率(Word Error Rate,WER,越低越好)为0.224,低于同期基线F5-TTS的0.378。结论适用于加性噪声混合评测和所用识别器代理的范围,高信噪比下增益较小,关闭FiLM分支后无噪声合成能力未受损。在32次函数求值确定性常微分方程采样且无分类器引导强度为2.0的推理设置下,NIL-TTS实时率为0.27,略高于基线F5-TTS的0.26。
🔗 开源资源
第三方资源:https://kalenon.github.io/NIL-TTS-demo/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/metavoiceio/metavoice-src — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. 听见、定位再推理:带空间听觉的视听场景理解

英文题目:Hear, Localize, and Reason: Spatially Aware Scene Understanding for Audio-Visual LLMs
评分:7.5/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.9/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Kim Sung-Bin:POSTECH
- Lee Jung-Mok:KAIST
- Jinwoo Jung:KAIST
- Oh Hyun-Bin:POSTECH
- Hyeonggon Ryu:Hankuk University of Foreign Studies
- David Harwath:The University of Texas at Austin
- Tae-Hyun Oh:KAIST
📌 核心摘要
这篇论文要解决的是音视频大语言模型只听懂语义、听不出方位的问题,输入是普通视角图像加双耳音频,输出是对发声事件的识别、声源方向与距离估计,以及声源是否可见、被什么遮挡、靠近哪个物体的判断。难点在于声源可能在画面外、被遮挡或在相邻房间,模型不能只靠类别匹配,需要把听觉线索转换到视觉坐标并做多步推理。方法上先用仿真器批量合成带几何标注的场景并生成多类问答,再在Qwen2.5-Omni基础上保留视觉与单声道语义支路,新增双耳空间音频编码器加投影器形成空间音频令牌。训练分三段推进,从纯空间音频对齐到音视频指令微调,再用链式思考Chain-of-Thought格式答案要求模型先写定位与可见性依据后给规范答案。在HLR-AVSceneQA测试集自我中心方向定位任务上以准确率为指标取三次运行均值,HLR-LLM为78.21%高于双通道Qwen2.5-Omni基线的64.27%,表明显式双耳空间建模优于仅分开输入左右声道。结论适用于受控室内静态场景,对真实录音的迁移只在STARSS23四个子任务上验证,移动声源和主动交互未覆盖。训练在四块NVIDIA A6000上进行2个epoch,每设备批量大小为4并累积4步,编码器冻结只更新空间投影器和语言模型LoRA参数。
🔗 开源资源
代码相关资源:https://hlrllm.github.io/ — 链接可访问(HTTP 200)
数据相关资源:https://hlrllm.github.io/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. 学到 50 秒之后还能接着说:全流式语音合成的长度外推

英文题目:Speaking Longer Than Learned: Training-Free Long-Form Generation for Full-Stream Text-to-Speech
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.9/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jeseung Lim:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiseong Woo:机构信息未能在本次解析中与作者逐人可靠绑定
- Heeseung Kim:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
全流式文本到语音指文本到达过程中即开始合成语音,本文研究超出训练长度的连续长篇合成,输入是声学提示语音与不断到达的目标文本,输出是连续声码器帧序列,难点是缓存增长受限与位置超出训练范围后发音跳词、音色漂移。VoXtream2先由音素变换器增量编码音素,时间变换器结合该编码与已生成音频口令自回归预测语义与时长口令,深度变换器再生成其余码本。时间变换器用本地位置索引缓存至多W帧,达到上限后保留P个声学提示帧和近期生成帧并重算键值状态,重新编号后在P+τ与W之间循环生成。论文发现该循环仍进入训练末端少见位置导致推进过快跳词,且提示帧占比被稀释致音色渐变,故将注意力窗口上限从625帧缩小到375帧,使运行位置停留在训练常见区间,其保留的近期帧直接作为下一步查询可用的历史上下文。再对声学提示键的注意力对数加常数偏置,增强其在后续每步查询中的权重,该偏置后注意力分布进入时间变换器各层参与生成,从而同时稳住发音与音色参照。相对已有需额外长时训练或仅做分段拼接的方法,该改动无需训练且不改变结构。在 LibriSpeech-Long 开发集上,相比 VoXtream2 基线,本方法总体词错率从 8.63% 降至 3.58%,说话人相似度从 0.659 升至 0.759,主观平均意见分保持 4.03 不变。结论适用于以 Mimi 编解码器生成、时长超过 50 秒的流式长文合成,375 帧以下过小窗口会损害效果,最佳偏置需按实验选取。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://voxtend.github.io — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. 多人对话中谁在拿话筒:MultiPartyTurnBench 如何测交接与抢话

英文题目:MultiPartyTurnBench: Benchmarking Floor Control in Multi-Party Spoken Dialogue
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Puneet Mathur:University of Maryland College Park, USA
- Dinesh Manocha:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
多人全双工语音交互要求机器在连续多通道音频中判断持有者是否交出地板,以及新出现语音是否成功夺取地板,短暂停顿、后通道应答和笑声在声学上与真实转换相似构成主要干扰。多方轮次基准用离散事件编排器先确定地板持有者与事件时间,再合成二百四十段两至五人对话并覆盖六种交互类型,提供逐通道音频与精确锚点。评测区分话轮结束检测与打断检测,系统只能用锚点之前音频做因果判决,按开发集选定的误报约束阈值在测试集统计召回率、误报率与符号延迟。与已有两方评测和多方下一说话人预测相比,该工作把真实转换与易混淆非事件配对打分,并同时检验离线检测器与可交互智能体。在一百九十二段测试对话组成的测试集上,离线检测的话轮结束召回指标从学习系统的82.5%变化至语音活动投影模型的92.6%,语音活动投影模型高于该范围下限。同样在该测试集上按说话人数拆分时,Kyutai语义语音活动检测器的打断召回指标从两人对话的63.3%降至五人对话的48.7%,随人数增加而降低。上述结论仅适用于合成语音加噪声的两至五人受控编排条件,五人时无模型打断召回超过50%,智能体停止平衡准确率仅46.9%–54.7%近乎随机,语音活动投影模型在真实四人AMI会议打断召回仅35.9%,故属受控诊断而非自然错误率估计。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://multiparty-turnbench.github.io/ — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. 用一段参考录音改变全双工语音模型的抢话风格

英文题目:Reference-Guided Turn-Taking Style Transfer for Full-Duplex Spoken Language Models
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuxuan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yang Xiao:机构信息未能在本次解析中与作者逐人可靠绑定
- Jack Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Chak Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Brick Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Sam:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
全双工语音语言模型需逐帧决定收听还是发声,累积成急切或耐心的会话风格,难点是每套权重只固定一种风格而不同说话人分布在其两侧,统一校正难以兼顾。论文从模型自身无干预对话中取静默帧,按八百毫秒内是否起始发声分成两类,以两类残差均值之差的归一化方向作为主动向量,无需训练与标注,在第三十个残差位置读出投影预判倾向,并在生成每帧沿该方向按听说摆动归一化剂量平移残差,经后块键值缓存持续影响后续帧。说话人由五分钟参考录音的说话占比、重叠起始率与回应概率表示,先一次性算好各剂量下操纵模型的描述子,再为新说话人在开发目标上选择平均标准化距离最小的剂量直接套用,无需再运行模型。在每权重500组留存对话上,固定该方向预测800ms内起始发声的AUC为0.818、0.830和0.898,高于只看双人计时的基线在同样留存对话上的0.703、0.646和0.725。在每权重500组对话上,剂量从-2a到+2a使说话占比从6-12%单调升至42-61%,高于无操纵时在同样对话上的21-30%。在550个评估目标和568个留存参考上,与使用自身参考剂量相比,换用他人不同剂量使平均标准化距离增大的情形占92.7%、98.0%和95.6%,方向为变差。结论限于Moshi架构80ms帧的三权重与Seamless Interaction及CANDOR验证,未验证其他架构与更长参考外推,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://elpsykongloo.github.io/initiative-vector/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/snakers4/silero-vad — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. 没有干净语音时怎样做教师学生自训练去噪
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Samuele Cornell:Carnegie Mellon University, USA
- Matthew Maciejewski:Johns Hopkins University, USA
📌 核心摘要
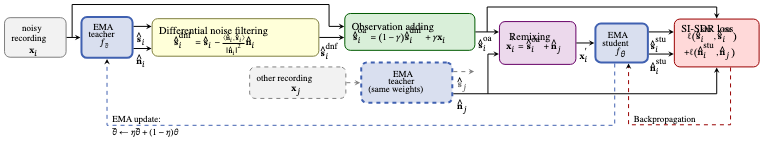
无干净参考的语音去噪只能从带噪录音学习,输入是不可单独观测的干净语音与真实噪声之和,难点是合成训练与真实录音存在失配,而仅用带噪数据训练的无监督方法又远低于有监督上限。SNOAR 保留 RemixIT 的重混自训练链路,教师对一批录音给出语音估计与噪声估计,语音估计先经差分噪声滤波减去泄漏的残留噪声,再与原始带噪观测按比例混合以补回被抑制的语音并稀释失真,校正后的语音估计与另一条录音的噪声估计重混成学生输入,学生以负尺度不变信噪比为损失学习重建这两个目标,教师以指数滑动平均跟踪学生。从 MixIT 教师出发,SNOAR 在 WHAM! 测试集上达到 13.25 dB 尺度不变信噪比,比同教师的 RemixIT 高 1.15 dB,与使用干净目标的监督上限相差 0.43 dB,相对无处理到监督上限的提升幅度约为 97%,词错误率降至 10.9%。该结论适用于 WHAM! 合成混合与 CHiME-3 真实录音上的 TF-GridNet 配置,去掉差分滤波后系统输出接近输入本身,观测回加系数取 0.5 时训练发散。原文未披露训练时长、推理延迟与部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. 把音视频一致性拆成事件再打分:AVC-Reward 解读

英文题目:AVC-Reward: Event-Centric Audio-Video Consistency Evaluation
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuruo Wu:Zhejiang University
- Kaihang Pan:Zhejiang University
- Kai Shen:Zhejiang University
- Jiacheng Li:HiThink Research
- Shuyuan Tu:Fudan University
- Jisheng Dang:Lanzhou University
- Li Tuoyu:Zhejiang University
- Juncheng Li:Zhejiang University
- Siliang Tang:Zhejiang University
📌 核心摘要
联合音视频生成需要判断声音与画面是否讲述同一场景,输入是一段同时包含音频流与视频流的短片,输出是对一致性的判断与分数,难点是同一片段时间重叠多个事件、物理音效与旁白音乐混在一起、画外音等有效声音又缺少直接画面证据。论文把评估拆成全局叙事和谐、事件级时间同步和细粒度属性对齐 3 个 0 到 1 分的维度,先独立解析音频事件与视频事件,再双向验证每个事件在另一模态中的证据,最后汇总成判断,总体分是 3 者算术平均。基于该协议训练的音视频奖励模型(Audio-Video Consistency Reward,AVC-Reward)用约 8k 条结构化推理做监督微调冷启动,再用约 10k 条人工校准样本做群组相对策略优化(Group Relative Policy Optimization,GRPO)对齐。与整段打分或只测时间偏移的方法不同,该方法区分物理声与叙事声并逐事件核查存在性、起止对齐与材质口型等属性。在 AVC-Benchmark 上总体分与人工的 Δ-Pairwise@0.2 为 0.728,Pearson 线性相关系数(Pearson Linear Correlation Coefficient,PLCC)为 0.494,优于所列自动基线。结论适用于所覆盖的联合生成、视频到音频和音频到视频样本,对严重主观分歧与罕见叙事冲突仍有误差,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://tsuki0512.github.io/AVC-Reward.github.io/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 紧凑多语语音识别中特征蒸馏为何失效与 CAFE 如何隔离它

评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tianchi Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Nicholas Moratelli:机构信息未能在本次解析中与作者逐人可靠绑定
- Khurram Azeem Hashmi:机构信息未能在本次解析中与作者逐人可靠绑定
- Mohammadreza Zolfaghari:机构信息未能在本次解析中与作者逐人可靠绑定
- Rishabh Jain:机构信息未能在本次解析中与作者逐人可靠绑定
- Louis Lu:机构信息未能在本次解析中与作者逐人可靠绑定
- Changdae Park:机构信息未能在本次解析中与作者逐人可靠绑定
- Amril Nazir:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
紧凑多语言自动语音识别需以共享编码器同时转写数据充足的英语和资源较少的长尾语言,输入多语言语音、输出各语言文字,难点在于帮助部分语言的表示约束可能损害其他语言。在强对数几率蒸馏基础上,基于投影的特征损失梯度与任务梯度正交,线性中心核对齐损失梯度仅弱对齐,且与共享编码器中英语所用子空间高度重叠,因而改善非英语却损害英语。非英语语句先经共享编码器得到蒸馏层表示,再进入该层上的残差瓶颈适配器生成残差增量,该增量与共享编码器表示相加形成适配器增强后的表示。增强表示随后与教师表示计算中心核对齐损失,其梯度主要更新适配器参数,而不直接改写共享编码器。英语语句则绕行适配器,且共享编码器一侧被停止梯度隔离,使英语仍只贡献原有监督与对数几率蒸馏损失。相对已有方法,改动不在损失权重或掩码上寻找分离,而是在参数位置上分离干扰。在公开Open ASR Leaderboard评测上,CAFE相对基线平均词错率从8.55%降到8.02%,其中英语7集从9.85%降到9.03%,多语言9集从7.24%降到7.00%。结论适用于由教师结构化剪枝初始化并使用强对数几率蒸馏的紧凑多语言转录器,在随机初始化或其他任务中尚未验证;原文披露254M参数模型单卡吞吐与延迟接近无适配器基线,训练为350k步、48卡H100、564k小时音频的一次性开销。
🔗 开源资源
第三方资源:https://huggingface.co/qvac/TranscribePsy-250M-EU — 暂时无法访问
第三方资源:https://huggingface.co/spaces/hf-audio/open_asr_leaderboard — 暂时无法访问
第三方资源:https://huggingface.co/datasets/PleIAs/YouTube-Commons — 暂时无法访问
第三方资源:https://mozilladatacollective.com/datasets — 暂时无法访问
第三方资源:https://datashare.ed.ac.uk/items/30e7453c-9ea8-48b4-8e18-f96d0dc62928 — 暂时无法访问
第三方资源:https://huggingface.co/nvidia/parakeet-tdt-0.6b-v3 — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. 从稀疏测量到任意方向:用神经算子做 HRTF 上采样

英文题目:HRTF Upsampling and Personalization via Neural Operators
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Meenakshi Krishnan:机构信息未能在本次解析中与作者逐人可靠绑定
- You Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ramani Duraiswami:机构信息未能在本次解析中与作者逐人可靠绑定
- C. Phillip Brown:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
个性化双耳渲染需要知道每个方向上头部、躯干和耳廓造成的滤波,即头相关传输函数,而密集测量采集成本过高且无法直接给出任意方向取值。论文把补全写成算子学习:输入是同一被试在少数方向上的对数幅度与两耳到达时间差,输出是任意查询方向上的对应场值,模型在多个被试间共享。稀疏观测先经分支网络编码,再按角度相似度聚合到一组中心可学习的球面隐模态,Transformer在模态间建模全局交互,解码按查询方向与同一组中心的相似度加权插值,并叠加直接指向原始观测的交叉注意力。与逐被试优化隐场的神经场方法不同,该算子一次前向即可给出连续场,测试时仅微调隐表示和输出头。在SONICOM按LAP24协议以100个测量点评估未测方向时,对数谱失真LSD为2.3 dB,低于最强基线IOA3D的2.8 dB。同样在SONICOM按LAP24协议以100个测量点评估未测方向时,两耳声级差误差ILD为0.4 dB,低于最强基线IOA3D的0.7 dB。在HUTUBS仿真集以6个Lebedev方向观测评估900个目标方向时,对数谱失真LSD为3.39 dB,低于球谐基线SUpDEq的5.32 dB。在A6000上重建793个目标方向时单被试推理耗时约0.56秒,随测量点基本不变,比神经场方法RANF快15–373倍;结论仅适用于给定稀疏幅度和时间差观测的补全,依赖左右耳镜像对称假设,未验证噪声较大或头部移动时的表现。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. 把档案馆里的田野录音变成 675 种语言的语音数据:ELARSpeech 解读

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Sangmin Lee:Yonsei University
- Yejin Jeon:McGill University;Mila - Quebec AI Institute
- David Ifeoluwa Adelani:McGill University;Mila - Quebec AI Institute
📌 核心摘要
濒危语言档案馆保存大量田野录音,但时长不一、转写格式不统一,难以直接作为语音识别与合成的训练评测输入,论文要将其转化为覆盖675种欠代表语言的长尾资源。处理先筛选有效转写层并按时间戳切出话语级语音文本对,形成2790.81小时的标注子集ELARSpeech-L,再对无转写长录音做质量过滤和说话人切分并切成30秒内短句,得到27411.65小时的未标注子集ELARSpeech-U。两部分再经统一重采样和响度归一并规范语言名称后进入同一流程,其中先用ELARSpeech-L训练233种语言各自的单语Whisper模型,再由其为ELARSpeech-U生成伪标注并回填扩充训练。与以圣经朗读或议会录音为主的已有资源不同,该资源保留会话、叙事、诱发话语和歌唱等多种领域与真实录音环境。在30种代表性语言的人工标注评测上,单语微调Whisper-large-v3的宏观平均字符错误率为22.48%,低于多语言联合训练的30.71%,后者仅在1种语言上字符错误率最低。在233种语言的相同测试话语上,用人工标注训练再加入伪标注ELARSpeech-U带来最多6.1%的相对字符错误率下降,而10分钟单语识别下自监督表示的字符错误率在ML-SUPERB上为30.3至41.0、在ELARSpeech上收窄为51.9至53.8,说明扩大预训练覆盖不等于长尾迁移。结论仅适用于馆藏田野录音的领域与语言分布,档案元数据可能不一致,非母语听众的平均意见分只反映自然度等感知质量,跨域与极低资源语言效果仍不稳定。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/sanghyang00/elarspeech/ — 链接可访问(HTTP 200)
第三方资源:https://www.elararchive.org/ — 链接可访问(HTTP 200)
第三方资源:https://www.ethnologue.com/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. Soloist:在没有孤立人声时如何分离真实录音中的人声

英文题目:Soloist: A Generative Model for Blind Voice Separation in the Wild
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chen Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- ChuFan Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Botian Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jingqi Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenxuan Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yitian Gong:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhaoye Fei:机构信息未能在本次解析中与作者逐人可靠绑定
- Xipeng Qiu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
盲语音分离输入为单通道混合录音,混有多人重叠、噪声和音乐,需输出每人独立波形,难点是说话人个数未知、无目标查询,且真实录音缺乏孤立声源监督。Soloist把该任务写成条件音频生成,模型先声明个数,再逐流生成音频编解码器(neural codec)序列并解码为波形,不输出背景残差流。第一段用构造混合的已知声源做监督分离,用固定音乐分离器所得歌声伪目标学单路人声,并用真实录音说话人时间线训练时间戳预测。第二段在真实录音采样多组候选,经信号检查剔除无效复制重复流后,由音频语言模型各轨独立描述、文本模型对照匿名混合锚点排序,打乱与逆序不一致则丢弃整组。与已有构造混合监督或混合物重构方法不同,该做法允许文本时间线和相对质量反馈进入同一生成模型,并显式处理变个数输出。结论仅适用于含声录音,模型无零说话人响应,失真或掉线致内容缺损场景被排除,法官排序验证只反映词错差异,未覆盖纯净度与音质。在官方脚本生成的带噪声LibriMix两说话人评测中给定个数时,Soloist排列不变词错率(permutation-invariant word error rate,PI-WER)为0.192,低于SepFormer的0.218和MossFormer的0.289。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. 长提示零样本语音合成:为复现说话人韵律而设的任务与基准

英文题目:Long-Prompt Zero-Shot TTS: Benchmarking Prosody Reproduction Beyond Voice Cloning
评分:7.0/10 | 创新 1.4/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Dekun Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Renjie Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yingda Shen:机构信息未能在本次解析中与作者逐人可靠绑定
- Qinke Ni:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhizheng Wu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
长提示零样本语音合成输入目标文本和同一说话人数分钟至数十分钟的提示语音,输出该说话人朗读目标文本的语音,难点在于短提示能反映音色却只呈现局部语速和语调,难以估计跨语境的停顿、重音与音高习惯。论文引入双语基准LP-TTS-Bench,包含中英说话人共数十小时提示语音与数千条验证和测试句,每条测试项把目标文本与其真值录音配对,提示、验证与测试互不重叠。评测除词错率与音色相似度外,还将合成语音与同文本真值对比,比较语速、停顿、重音、语调与模型化韵律指标。参考系统LPTTS以Qwen3TTS-Base为骨干,长提示编码器先将变长提示分块编码,再聚合成固定数量的全局向量与目标文本相关的局部向量。上述向量经门控交叉注意力注入语言模型,编码器训练混合短提示与长提示,并以同说话人对比排序和单说话人教师蒸馏强化韵律抽取。在LP-TTS-Bench同一测试集上与10秒短提示基线Qwen3TTS-Base相比,LPTTS主观韵律相似度P-MOS中文为3.529对2.941,英文为3.533对3.133,均为LPTTS更高。结论适用于中英朗读类语料中10分钟左右提示的韵律复现,更长提示趋于饱和,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. MuseBench:大规模 AI 生成音乐检测与伪影分析基准

英文题目:MUSEBENCH: A Benchmark for AI-Generated Music Detection and Artifact Analysis
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yi Chen Liu:University of Georgia
- Syed Irfan Ali Meerza:College of Engineering;Virginia Commonwealth University
- Jiawei Yu:University of Georgia
- Xi Guo:University of Tennessee, Knoxville
- Samuel Bright:Cornell University
- Jian Liu:University of Georgia
📌 核心摘要
AI音乐生成器已能从文本提示生成完整歌曲,难点在于生成痕迹会被压缩、均衡、变速变调、响度处理、人机混编和故意扰动稀释,干净条件下的检测容易失效。MuseBench收集可验证的人类作曲,用风格对齐的提示驱动文本到音乐生成器产生对应AI曲目,再构造人机共创与压缩后处理扰动变体,最后用多种检测器在默认、留一模型、域外人类集和变换条件下评测并做伪影分析。相对只覆盖少数生成器或偏重人声的M6、FakeMusicCaps和SONICS,该基准同时纳入共创、压缩、后处理、扰动与域外集,并给出频率、频谱、和声、演奏与演唱层面的可解释线索。在MuseBench默认设置下用10秒片段区分人类作曲与AI生成音乐时,语谱图模型的平衡准确率高于波形模型M5,其中ConvNeXt等的平衡准确率处于99.5%–99.8%,而M5平衡准确率为94.3%。在域外人类集评测设置下以2010年前Free Music Archive人类音乐为人类集并按正确判为人类计准确率时,手工特征的Deezer方法准确率为94.4%,高于神经网络中最好的AST的79.8%。留一模型评估显示跨生成器泛化不稳定,频谱表示迁移较好而手工特征与波形模型波动较大,变换与共创进一步暴露失效,说明跨生成器与变换鲁棒性尚未解决。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/Anonymousv22222/datasets — 暂时无法访问
第三方资源:https://github.com/ohollo/chord-extractor — 暂时无法访问
第三方资源:https://www.guitartricks.com/blog/Rock-Guitar-Chord-Systems — 链接可访问(HTTP 200)
第三方资源:https://blog.native-instruments.com/rock-chord-progressions/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
20. 印度二十二种语言里谁在何时说话:Anuvani-Diarization 的零样本适配与标注口径分析

英文题目:Anuvani-Diarization: Zero Shot Speaker Diarization and Annotation Conventions Across 22 Languages
评分:7.0/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Stephen Fernandes:Central Institute of Indian Languages
- Narayan Choudhary:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
说话人分离标注要从单通道长录音中标出谁在何时说话,输出是每位说话人的时间区间,难点在于印度会话多语言混用、重叠比例高、录音条件差异大。论文先在IndicDiarBench的1164段录音上统一评测9个外部系统加本文系统,揭示参考文本按语句切分而系统按停顿切分是隐藏误差源。Anuvani-Diarization以DiariZen切分网络为起点,先把16kHz长录音切成16秒窗以1.6秒步长送入剪枝WavLM加Conformer头,输出每20毫秒窗内至多4个局部说话人的判定。该局部判定中无重叠帧经ResNet34提取嵌入,再用VBx聚类把各窗局部说话人连成全局轨迹,得到整段录音谁在何时说话。适配时用通道分离双人电话的银标签做不确定性感知监督,对低能量、矛盾或边界附近帧掩蔽不计损失,剩余51.9小时参与全部参数联合微调。与所运行系统相比,它在全部录音上时长加权说话人分离标注错误率(diarization error rate,DER)为16.78%,为所运行系统中最优,仅高于基准论文报告的Sarvam AI联合服务的16.0%。该适配在6个国际测试集上平均未损失精度,但在电话转写上学到的桥接习惯迁移到基准时会使误差明显上升。结论限于约108小时单基准零样本评测,适配数据仅为8种语言双人电话,故多人会议、野外视频及16秒窗内超4人同时说话可能失效,原文未披露训练、推理或部署的延迟吞吐成本。
🔗 开源资源
- 模型相关资源:https://huggingface.co/CIIL/Anuvani-Diarization — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. 语音模型能听出读错的音吗:PEDBench 解读

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Zhonghao Shi:Harvard University
- Zackary Rackauckas:Harvard University
- Jasmine Yip:University of Southern California
- Savannah Halpern:University of Michigan
- Simon Campos:University of Michigan
- Lauren Brace:University of Michigan
- Emma Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tiantian Feng:University of Southern California
- Xuan Shi:University of Southern California
- Shrikanth Narayanan:University of Southern California
- Teresa Satterfield:University of Michigan
- Ying Xu:Harvard University
📌 核心摘要
语音错误检测要求从录音中判断每个音素是否被替换、删除或插入并给出实际发出的音素,输入是单词或句子录音及其标准发音,输出是预测音素序列与错误位置。难点在于儿童语音和口音语音常落在音素边界附近,标注者之间难以一致,现有公开集也缺少可靠评测。PEDBench先把标准发音、人工实际发音和模型预测映射到统一的三十九个音素的CMU词典集合,再做三序列分层对齐并按接受与拒绝统计,只有检出同时诊断正确才计分。评测在自然儿童语音、演员表演语音和合成语音的同一协议下比较专用音素识别模型、商用发音评估模型和语音语言模型,并用合成词数据加TIMIT对语音语言模型做低秩微调。与已有误发音检测研究相比,该工作把自然、表演和合成条件放在同一协议下并统一计分方式。在词级演员语音评测中,经TIMIT加合成词数据微调后的Qwen2.5-Omni-7B的诊断加权F1为90.06,高于同设置下GPT-Audio-1.5的76.17。在词级真实儿童语音评测中,该微调模型的诊断加权F1为63.47,高于同设置下Gemini的58.26,适用范围限于英语词级检测且跨儿童泛化仍不足。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://catalog.ldc.upenn.edu/LDC97S63 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
22. 不用音频配视频也能做音视频问答:代理文本自玩训练解读

英文题目:MSP: Modality Self-Play for Training Multimodal LLMs Without Paired Cross-Modal Data
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Robert Moseley:University of California,;Riverside
- Md Kaykobad Reza:University of California,;Riverside
- Ameya Patil:Amazon
- Edward Ayrapetian:Amazon
- Salman Asif:University of California,;Riverside
📌 核心摘要
多模态大语言模型要联合回答音频与视觉问题,常规做法需要同一问答样本同时包含真实音频与真实视觉监督,这类成对数据收集成本高且随模态组合快速增长。本文提出模态自博弈(Modality Self-Play,MSP),训练中每个样本只保留一个真实非文本模态作为锚,从不观察真实音频视觉成对数据。第一阶段用音频文本与视觉文本对独立训练各模态投影器并对齐到Qwen3-8B语言空间,冻结对比编码器以保持表示一致,冻结后的第一阶段模型再为缺失模态生成一句代理文本。代理文本经对比编码器文本塔编码,再经按模态拟合后冻结的线性桥映射到缺失模态表示空间,与真实锚特征以单 token 形式同置于同一提示,语言主干用问答损失学习组合推理,推理时直接输入两个真实模态。与依赖成对监督或留空缺失槽的已有做法不同,MSP 在训练中显式构造组合信号。在 MUSIC-AVQA 测试集零样本准确率下,完整 MSP 组合为 65.65,高于仅第一阶段投影器的 45.75。结论适用于有模态文本对与对比编码器的音频视觉问答等场景,代理噪声大或编码器覆盖不足时会失效。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
23. CoSTA:让对话模型少说几步、合成时再展开的语音 token 解耦

英文题目:CoSTA: Compressed Speech Token Adaptation for Efficient Spoken Dialogue Models
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yingzhuo Deng:Institute of Automation, Chinese Academy of Sciences;School of Artificial Intelligence, University of Chinese Academy of Sciences
- Chong Li:Institute of Automation, Chinese Academy of Sciences;School of Artificial Intelligence, University of Chinese Academy of Sciences
- Bingxin Liu:Institute of Automation, Chinese Academy of Sciences;School of Artificial Intelligence, University of Chinese Academy of Sciences
- Yi Shu:School of Artificial Intelligence, University of Chinese Academy of Sciences
- Tianyu Peng:Institute of Automation, Chinese Academy of Sciences;School of Artificial Intelligence, University of Chinese Academy of Sciences
- Can Xie:Institute of Automation, Chinese Academy of Sciences;School of Artificial Intelligence, University of Chinese Academy of Sciences
- Siyao Song:Institute of Automation, Chinese Academy of Sciences;School of Artificial Intelligence, University of Chinese Academy of Sciences
- Shuo Ren:Institute of Automation, Chinese Academy of Sciences
- Jiajun Zhang:Institute of Automation, Chinese Academy of Sciences;School of Artificial Intelligence, University of Chinese Academy of Sciences
📌 核心摘要
语音对话模型输入用户语音,输出交织的文本单元和语音单元,再由语音解码器合成波形,原有生成与合成共用同一套语音单元,序列很长,自回归步数多,对齐和长上下文建模更困难。CoSTA保留原语音切分器与解码器不变,在生成侧扩充一套字节对编码合并出的压缩单元,模型只生成较短的压缩序列,推理时再确定性展开回原始语音单元送入解码器。适配分三步:词汇扩展用组成单元的均值初始化新增嵌入与输出层,发音适配在压缩的文本转语音数据上校准新增参数,对话适配在压缩的语音到语音对话数据上恢复问答能力,这与降低切分器帧率替换切分器与解码器的做法不同,把效率优化放在生成侧的事后适配。在URO-Bench中文语音对话集上,与使用相同适配数据的Vanilla-FT-ZH相比,CoSTA-ZH平均内容质量G-Eval为72.27,高于前者的69.88,文本语音一致性ASR-CER为1.51%,低于前者的4.96%,语音质量UTMOS为3.75,与前者的3.77相当。相对基座模型,CoSTA在所测并发下中文延迟降低32.8–39.0%、吞吐提高51.6–59.2%,在各设置均超过同条件Vanilla-FT,峰值显存最多增加0.68 GiB。上述质量与效率结论限于所测并发与URO-Bench中英文对话任务,去掉对话适配后CoSTA-ZH的G-Eval从72.27降至24.35,表明仅靠压缩发音学习不能恢复问答能力,且各数据集上指标提升并不均匀,合成训练数据的偏差与超大词表下的输出层开销仍需权衡。
🔗 开源资源
第三方资源:https://github.com/yingzhuodeng/CoSTA — 链接可访问(HTTP 200)
第三方资源:https://github.com/huggingface/tokenizers — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
24. 一次前向同时回答多个轮次判断:VoxTurn 的做法与证据

英文题目:VoxTurn: Answering Several Turn-Taking Questions in One Pass with One Model
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Yang Xiao:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
级联语音智能体在用户每次沉默中都要判断是否应答,答早打断用户,答晚增加延迟,难点是决策时刻落在停顿内部且正确答案随已沉默时长变化。VoxTurn输入决策时刻前8秒用户音频、可选转写或对方上一句与说话人标记,输出是否结束回合、何时继续、四类对话状态、是否为打断与是否为无效输入五类判断。冻结的AuT编码器先把8秒音频转为特征并经投影层与文本拼成共享前缀,一次编码供所有问题复用,该前缀直接作为语言模型的输入。Qwen3-0.6B加LoRA一次前向处理多题,隔离问题块的注意力掩码让每题只见共享前缀和自身且位置编码与单题询问一致,由此得到各选项末token隐状态。各选项隐状态再进入线性头打分并在选项内做softmax得到概率,训练按停顿定时推导标签并加辅助与一致性损失,部署在沉默持续期间每0.25秒用增长后的音频重查。与eot-bench开放基线相比,VoxTurn在英语300 ms平均延迟预算下误切率为11.5%,14语言均值为19.9%,为参评全部语言的开放模型中最低,单次决策8.3 ms。结论适用于单说话人用户回合与双人对话零样本迁移,印地语、韩语非开放最优与单次查询超时回退仍是失效点。原文披露训练在1张NVIDIA L40S上用78分钟完成30万样本。
🔗 开源资源
第三方资源:https://huggingface.co/AustinXiao/voxturn — 链接可访问(HTTP 200)
第三方资源:https://swagshaw.github.io/voxturn/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
25. SITAR:从情景扭曲看语音识别错得有多严重

英文题目:SITAR: A Situational Distortion Metric for Automatic Speech Recognition Evaluation
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mingzhe Lu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jinhao Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yunpeng Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Hang Su:机构信息未能在本次解析中与作者逐人可靠绑定
- Lichun Fan:机构信息未能在本次解析中与作者逐人可靠绑定
- Jian Luan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
自动语音识别的输入是语音波形,输出是文本假设,难点是字面相近的错误可能带来完全不同的行动后果,例如时间、否定或执行指令的改变,而词错率只计编辑代价。论文定义情景扭曲为假设相对参考改变原话语所描述、确立或促成情形的程度,并构造名 SITAR 的轻量确定性评分器,输入参考与假设文本对,输出归一化分数,越低表示扭曲越小。构造先用受约束间隙划分把差异切成配对间隙,再把每个单间隙假设映射到表达不变、理解改变但预期结果不变、最终结果改变三层及方向边界位置。最后用有界递归公式把最重严重度与累计数量合成为统一目标,用以训练 DeBERTa-v3-large 回归器,推理时单次前向完成且无需大模型参与。在 LibriSpeech 多系统评测中同为 SITAR 分数的比较显示,whisper-small 为 0.1047,低于 wav2vec2-large 的 0.1344,评分输出归一化到 [0,1] 且训练目标区间为 [0,7/3)。在 VoxPopuli 多系统评测中同为 SITAR 分数的比较显示,wav2vec2-base 为 0.4084,降至 wav2vec2-large 的 0.3577,跟踪模型增大带来的改进趋势。结论适用于英文朗读与对话类转写质量比较,对否定位置与层叠口语冗余等受控改动仍有误序,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
26. 边听边说边做手势:全双工对话如何同时生成语音、表情和手势

英文题目:Full-Duplex Interaction with Speech, Expressions and Gestures
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Siyin Wang:Tsinghua University
- Wenyi Yu:Tsinghua University
- Terumi Chiba:Tsinghua University
- Xianzhao Chen:ByteDance
- Xiaohai Tian:ByteDance
- Jun Zhang:ByteDance
- Lu Lu:ByteDance
- Chao Zhang:Tsinghua University
📌 核心摘要
面对面交谈要求说话与倾听同时协调语音、手势与表情,现有全双工语音模型能同时听与说,现有手势模型多以后处理方式根据已给语音生成动作,缺少由对话理解统一调度可见行为的机制。ELLSA 2以连续对话骨干为中心,大语言模型骨干输出隐状态表征听到的对方语音声学上下文与对话状态,流式语音合成器输出隐状态表征自身说话内容与声音,两者与保留的预训练声学特征相加形成条件。手势表情合成器按0.8秒分块自回归生成上身、手部与表情编码,即使输出语音为静默也持续生成倾听反应,实现听说共用的在线非言语生成。对话骨干另设语义调用头判断当前文本上下文是否适合特定语义手势,触发后检索馆藏范例并作为引导插入生成序列,把是否调用与如何实现分开。在包含71个语义片段的人验测试集上,带模板引导的ELLSA 2的人类语义评分Human S(1-5分,越高越好)为2.711,高于无引导ELLSA 2的2.014。在TriviaQA语音问答的S2S回答准确率(%,越高越好)上,ELLSA 2为63.6%,高于SALMONN-omni的56.0%。结论适用于筛选后的可见说话人与短片段对话评估,视觉感知、馆藏覆盖以外的数据泛化尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/bytedance/SALMONN/tree/ELLSA2 — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/marcoyang/transformer-causal-600m-spear-speech — 暂时无法访问
第三方资源:https://genea-workshop.github.io/leaderboard/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
27. 高阶正弦建模如何修准频率偏差

英文题目:High-Order Sinusoidal Modeling for Precise Parameter Refinement
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shaowen Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Tomoki Toda:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
观测信号被看作多个时变正弦分量加噪声,分析目标是在每帧内从加窗波形估计各分量的瞬时幅度、瞬时频率和瞬时相位,难点是初始频率存在偏差时幅度和偏差耦合且噪声会放大误差。论文先把准谐波模型(Quasi-Harmonic Model,QHM)重写为对偏差指数项的一阶泰勒近似,指出阶数是校正能力的瓶颈。在此基础上提出高阶正弦模型,用两个复系数构造与指数结构一致的截断展开,估计幅度取系数模值,频率偏差取另一系数的虚部。该展开形成的残差目标进入列文伯格-马夸尔特(Levenberg-Marquardt,LM)算法并行处理多帧,迭代求解复系数与偏差,输出帧中心幅度与校正后频率。帧级幅度和校正后频率再经帧间插值得到连续瞬时幅度和相位轨迹,相位积分后与幅度相乘重建各分量波形。与QHM和扩展自适应准谐波模型(extended adaptive QHM,eaQHM)相比,4阶模型在6分量仿真信号上重建信噪比达38.8 dB,高于对照方法。在32句语音上4阶模型平均频谱距离为0.0938,重建比为12.7 dB,单核实时率为9.49,优于对照但慢于非迭代QHM。该结论适用于分量在时频面充分分离的浊音类信号,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/Antibas/eaQHM-analysis-and-synthesis-in-Python/tree/main — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
28. 先粗分再提纯:双路视觉引导的语音分离如何兼顾身份与可懂度

评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Longjie Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhongshu Hou:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuepeng Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Gang Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Shidong Shang:机构信息未能在本次解析中与作者逐人可靠绑定
- Fan Zhou:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
本文处理单通道混响混合语音,给定混合波形与两路同步人脸视频,为每路可见说话人恢复对应语音,难点是自然重叠不满足理想加法假设,混响、设备响应、遮挡、模糊、丢帧与音画失同步同时削弱声学与视觉证据。粗分离阶段把混合与两路视觉语音特征一起送入级联网络,按视觉流编号输出两个粗估计,逐级减少竞争说话人残留并保留目标混响与共享背景噪声。细化阶段把原始混合与两个粗估计一起编码,用堆叠时频网格块输出更干净的两个细估计,混合波形补回被粗阶段抑制的弱目标成分。最后用开发集选定的线性系数把粗估计与细估计加权相加,系数在测试时保持固定。在ISCSLP 2026真实场景音视频语音增强挑战Track 1隐藏测试集总体范围内,本系统官方OVRL为2.86与Team 1的2.86持平并列总排名第1,字符错误率0.123低于Team 1的0.145为参赛最低。在Track 2隐藏测试集总体范围内,本系统总排名第2,字符错误率0.148低于Team 1的0.153为参赛最低。适用范围限于提供两路可见说话人视频的双目标场景,视觉完全缺失、说话人数变化与强远场失配下的表现尚未充分验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/audiolabs/torch-pesq — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
29. 逐帧可流式传输的低码率语音压缩 StreamLSC

英文题目:Frame-Wise Streaming for Efficient Learned Speech Compression
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuhan Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jun Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Fengxi Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhengxue Cheng:机构信息未能在本次解析中与作者逐人可靠绑定
- Li Song:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音压缩的输入是连续语音波形,输出是码率尽可能低、重建感知质量尽可能高的比特流与重建语音,难点在于超低码率下保留细节的同时满足实时通信的逐帧因果要求。StreamLSC 把音频切成互不重叠的帧,每帧经短时傅里叶变换(Short-Time Fourier Transform,STFT)得到频域特征,再送入可流式主干网络提取隐表示。隐表示进入可流式熵模型,先由辅助特征预测高斯分布参数,再按通道分组做自回归熵编码形成部分比特流,解码端按帧重建并依靠显式状态传递保持帧间连续。与依赖整句上下文的离线熵模型和逐时刻独立量化的向量量化流式编码器不同,该设计同时保留长时建模能力和熵自适应比特分配。在 LibriTTS 上与 FunCodec 相比,论文报告平均节省 -51.37%(ViSQOL)和 -53.99%(PESQ)的 BD-RATE,对应 BD-ViSQOL 提高 0.2154、BD-PESQ 提高 0.5156。结论适用于 16 kHz 英语朗读语音的超低码率区间,跨语言、噪声和丢包条件尚未验证。原文披露模型量级为 149.2M 参数,在 RTX 4090 上实时率为 0.0539,原文未披露训练耗时与训练内存细节。
🔗 开源资源
- 第三方资源:https://buhaneryu.github.io/Voice_Demo_Website/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
30. 新检测器如何继续认出旧水印又拒绝陌生水印

英文题目:Backward Compatibility in Zero-Bit Neural Audio Watermarking
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Admir Krnić:机构信息未能在本次解析中与作者逐人可靠绑定
- Kosta Pavlović:机构信息未能在本次解析中与作者逐人可靠绑定
- Petar Nedić:机构信息未能在本次解析中与作者逐人可靠绑定
- Željko Bolević:机构信息未能在本次解析中与作者逐人可靠绑定
- Slavko Kovačević:机构信息未能在本次解析中与作者逐人可靠绑定
- Igor Djurović:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
零比特音频水印以原始波形为输入,输出检测分数经阈值得到二值判定,难点在于嵌入器与检测器更新后旧内容仍要可验,而泄露版本还要可撤销。论文把新检测器必须支持的旧嵌入器集合定义为遗留链,要求对链内嵌入器高检出率,对干净音频与链外嵌入器高正确拒绝率,撤销的嵌入器则移出遗留链。新检测器在冻结的遗留嵌入器与可训练的新嵌入器组成的集合上训练,每轮按性能加权采样单个嵌入器的输出进行前向与反向传播,采样概率向当前准确率低的嵌入器倾斜,使检测器覆盖整条链。采样得到的水印与非水印帧先经推送损失扩大间隔,得到的新旧残差再经角多样性损失约束新嵌入器残差远离旧残差,两项对新嵌入器参数的梯度按各自范数归一到共同尺度后相加再更新参数。为兼容而耦合训练不同于独立训练水印共存,耦合在无约束时会诱发新嵌入器向旧残差靠拢,导致版本边界坍缩。在固定阈值0.99、无撤销的8版本序列评测设置下,相对无多样性损失的基线设置,完整方法使链外正确拒绝率(TNR)均值从11.3%上升到99.98%。在固定阈值0.99、无撤销的8版本序列评测设置下,完整方法链内检出率(TPR)维持在99.3%至100%均值99.9%,与基线均值99.8%相当。结论适用于零比特、短时傅里叶变换幅度嵌入与固定阈值的设置,多比特扩展与对抗攻击下的表现尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
31. 文本接口如何影响音频视觉问答的提示优化

英文题目:Designing Textual Interfaces To Enhance Llm Reasoning On Audio-Visual Question Answering
评分:6.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yi Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tianzi Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tong Lei:机构信息未能在本次解析中与作者逐人可靠绑定
- Dahan Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Peter Bell:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
音视频问答要求模型同时利用视频画面与伴随音频回答多项选择题,输入包含视频、音频、问题文本和候选项,输出为选项编号,难点在于稀疏分布的跨模态证据需要被找到并联合推理。直接推理让单个全模态大语言模型同时读入视频、音频、问题、候选项与任务指令并直接给出选项编号,只暴露一条可优化的直接推理指令。字幕推理先由全模态字幕器在不知问题与候选项时把视频音频压缩为文本字幕,该字幕再与问题、候选项和推理指令一起送入纯文本推理模型得出答案,字幕成为感知与推理之间可优化的文本瓶颈。智能体系统由文本主智能体先调用字幕子智能体获得全局描述并记入交互历史,再根据问题、候选项与历史决定发起针对性追问或作答,问答子智能体返回追问所需的视听证据,主智能体整合多轮证据后作答,暴露主智能体工作流指令与感知侧指令。自动提示优化由文本优化器读取预测答案、正确答案和执行轨迹后改写指令,再按验证集准确率挑选候选指令,把优化对象从最终指令扩展到字幕指令、推理指令和智能体工作流指令。在Daily-Omni基准上,直接推理的Gemini-2.5-Flash经GEPA优化后测试集准确率从75.71%提高到79.83%,而字幕推理与智能体系统未获得可迁移的提升。结论适用于指令跟随较强的Gemini与所划分的训练、验证和测试集,不适用于测试的Qwen3-Omni变体,也未在其他音视频基准上验证。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/yiwang454/interface_AVQA — 链接可访问(HTTP 200)
第三方资源:https://github.com/yiwang454/interface_AVQA — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-Omni-30B-A3B-Instruct — 暂时无法访问
第三方资源:https://huggingface.co/Qwen/Qwen3-Omni-30B-A3B-Thinking — 暂时无法访问
第三方资源:https://ai.google.dev/gemini-api/docs/models/gemini → https://ai.google.dev/gemini-api/docs/models — 链接可访问(HTTP 200)
第三方资源:https://openai.com/index/gpt-4-1/ — 链接不可用(HTTP 403)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
32. 从脑活动找回听到的那段话:时间建模与多模态对齐如何分工

英文题目:Decoding Naturalistic Speech from fMRI with Temporal Modeling and Multimodal Alignment
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Corentin Caris:Karavela
- Louis Jalouzot:Karavela;UNICOG, CNRS, INSERM, CEA, Paris-Saclay University;LSCP, EHESS, ENS, CNRS, PSL University
- Nona Rajabi:Karavela
- Géraud Ilinca:Karavela
- Ahmed Hassayoune:Karavela
- Asilbek Muminov:Karavela
- Thaddée Delebarre:Karavela
- Clara Fonteneau:Karavela
- Charles Maussion:Karavela
- Bertrand Thirion:Karavela;Inria, CEA, Paris-Saclay University
- Alexis Thual:Karavela
- Antoine Collas:Karavela
📌 核心摘要
自然听故事解码的输入是连续功能性磁共振成像帧,输出是该时刻听到的语音片段在候选池中的排序,难点是血氧信号噪声大且时间拖尾,难以保留语音的多时间尺度结构。论文提出神经有序嵌入多模态对齐(Neural Ordered Embeddings with Multimodal Alignment,NOEMA),它取以刺激结束时刻后2.5秒为中心的7帧连续脑信号窗口,先经空间投影把每帧顶点数据映射到隐层。该隐层序列再经两个残差时序卷积块融合前后帧语境,只取中心帧表示去预测8704维多模态目标,使预测对应中心时刻的刺激。目标端用冻结的文本编码器、音频编码器和语音识别编码器分别编码10秒文本上下文、10秒音频上下文和1个标记间隔的语音段,各模态单独归一化后拼接而成。训练用CLIP对比损失拉近配对的脑预测与刺激目标,推理时解码器只接收功能性磁共振成像,按余弦相似度对候选刺激嵌入排序检索。在Cephalonauts One上NOEMA相对同输入的上下文多层感知机Top-10准确率从33.7%提高到42.7%,候选数约2000,LeBel上达到43.6%,且在加入8494个同播客外部干扰项后仍保持最低中位相对名次。结论限于6名被试的被试内新会话与新刺激检索,未验证新被试与开放生成,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
33. 从混合音乐中点选一种乐器并复刻其音色

英文题目:Point-and-Play: Instrument Timbre Cloning from Music Mixtures
评分:6.6/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Baotong Tian:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhiyao Duan:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
输入是4秒多乐器混音加音频示例或乐器类别名等提示,输出是能在新音高和力度下演奏的指定乐器音色编码与合成音符,难点是目标音色与混音中竞争声源、音高和录音条件相互纠缠。微调后CLAP音频编码器对混音输出全局码与时间token序列,冻结编码器对提示输出提示嵌入,提示门控统计池化(Cue-Gated Statistics Pooling,CGSP)据此计算权重并加权聚合为均值方差统计量,经多层感知机得到残差后与提示嵌入相加归一化为音色码。音色码经线性投影后与音高、力度嵌入相加形成条件向量,经自适应层归一化调制DiT流匹配模型,推理时从噪声积分生成隐变量再经冻结VAE解码成波形。与先分离再克隆不同,该链路直接从混音编码目标音色,每次生成8个候选并保留其冻结CLAP嵌入与音色码余弦相似度最高者。在27个未见NSynth音色的评测中,文本提示的Point-and-Play的CLAP分数(生成音符与目标音符的余弦相似度,越高越好)为0.706,高于CLAPSep的0.560和Demucs最近茎的0.541,接近用目标乐器其他干净音符作条件的0.762。音高探针\(R^2\)从0.783降至0.263说明音高信息被抑制但未消除。结论限于合成混音训练与NSynth、MoisesDB子集评测,2秒上下文检索不足而4秒捕获主要增益,同类别多声源同时出现易混淆,真实录音多样性与听感评价尚未验证。提取器训练约3小时,单张A100 GPU,合成器训练150k步,具体推理耗时原文未披露。
🔗 开源资源
- 第三方资源:https://github.com/User-tian/Point-and-Play — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
34. 流式口语转书面语:预训练文本到文本模型如何边读边改写

评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kiet Anh Hoang:机构信息未能在本次解析中与作者逐人可靠绑定
- Khanh Le:机构信息未能在本次解析中与作者逐人可靠绑定
- Bao Nguyen:机构信息未能在本次解析中与作者逐人可靠绑定
- Linh Pham:机构信息未能在本次解析中与作者逐人可靠绑定
- Dung Vo:机构信息未能在本次解析中与作者逐人可靠绑定
- Thai Tran:机构信息未能在本次解析中与作者逐人可靠绑定
- Mai Nguyen:机构信息未能在本次解析中与作者逐人可靠绑定
- Tri Nguyen:机构信息未能在本次解析中与作者逐人可靠绑定
- Vu Le:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
流式逆文本规范化输入是流式语音识别输出的口语形式词序列,输出是可读的书面形式文本,需要恢复标点与大小写,并把数字、日期、货币等半符号短语和外来词转写为规范写法。方法第一步将口语词序列输入基于EnViT5改造的动态右上下文掩码编码器,在保留全部左历史下限制未来可见以模拟流式分块,输出每词隐表示。第二步联合标注器以该隐表示为输入逐词作B、I、O三分类以标定需规范片段,输出的标记序列作为控制信号进入读-标-写策略。该策略按标记调度读写,对标为O的词直接透传,B-I片段未完整时继续读入等待,仅当片段完整并具备前视时触发自回归解码器。解码器只交叉注意该片段相关编码状态生成局部书面文本;训练用标注与生成多任务损失加按概率截断的前缀增强,迫使模型无全局结束符时输出局部结束符。与混合流式基线相比,提出的方法在越南语测试集含标点条件下词错误率为4.18%,约为混合基线8.27%的一半。结论适用于越南语新闻语料与英语子集上带1至2词前视的流式设置,键值缓存与复制粘贴使每块延迟满足实时要求,外来词拼写幻觉与长片段等待延迟仍存在。
🔗 开源资源
第三方资源:https://huggingface.co/VietAI/envit5-base — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/khanhld/chunkformer-ctc-large-vie — 链接可访问(HTTP 200)
第三方资源:https://github.com/rany2/edge-tts — 链接可访问(HTTP 200)
第三方资源:https://github.com/huggingface/transformers — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/vinai/bartpho-syllable-base — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/google-t5/t5-base — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
35. Opus 音乐压缩在什么码率下听不出与无损的区别
英文题目:Evaluating perceptual transparency of lossy music audio compression with Opus codec
评分:6.5/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Benjamin Martin:机构信息未能在本次解析中与作者逐人可靠绑定
- Romain Hennequin:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
该研究要回答Opus压缩音乐在多高码率下与无损CD参考听不出差别,输入是高难度音乐片段经不同目标码率压缩后的版本,输出是听众在三刺激隐藏参考试听中给出的压缩分减参考分得到的差异分,难点在于高码率差异微弱且混杂听众灵敏度与曲目难度差异。在由二十一名合格听众与二十三段曲目组成的基线条件下,以平均差异分为指标检验相对无损参考的降质方向,32 kbps平均差异分为-1.661,95%置信区间为[-1.877,-1.445],差异检验p<0.001显著低于参考。同在该基线条件下,以平均差异分为指标,128 kbps平均差异分为-0.082,95%置信区间为[-0.298,0.134],差异检验p=0.456相对参考不可区分。该方法先用以码率为固定效应、听众与曲目为交叉随机截距的线性混合效应模型分离三者方差,再从随机效应中提取经收缩的最佳线性无偏预测,挑出十名最挑剔听众和八段最易暴露失真的样本做压力测试。与以往集中在语音低码率或带重度损伤锚定的比较不同,该工作采用高分辨率双盲三刺激隐藏参考协议并在每场保留低码率锚定做筛选。在十名最挑剔听众与八段最难样本的严格条件下,以平均差异分为指标,160 kbps平均差异分为-0.035,95%置信区间为[-0.248,0.178],差异检验p=0.747相对参考不可区分,而同条件下128 kbps为-0.236,p=0.030被检出低于参考。同在上述严格条件下,以正负0.25分为容限的等效检验为指标,160 kbps等效检验p=0.024相对参考通过严格等效,而128 kbps的p=0.450相对参考未通过,结论只适用于受控耳机听音室与所选高难度曲目,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://zenodo.org/records/22830003 — 链接可访问(HTTP 200)
第三方资源:https://github.com/QxLabIreland/listening-test — 链接可访问(HTTP 200)
第三方资源:https://www.sonarworks.com/soundid-reference — 链接可访问(HTTP 200)
第三方资源:https://opus-codec.org/comparison/ — 链接可访问(HTTP 200)
第三方资源:https://listening-tests.hydrogenaudio.org/igorc/samples.html — 链接不可用(HTTP 403)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
36. 一个语音编码器同时记住说什么、谁在说、哪种语言和什么情绪

英文题目:Learning Speech Attribute Representations via Multi-Teacher Distillation
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Maryem Bouziane:LIA Avignon Université Avignon, France
- Salima Mdhaffar:LIA Avignon Université Avignon, France
- Yannick Estève:LIA Avignon Université Avignon, France
📌 核心摘要
输入为整段语音波形,输出是分别对应语义内容、说话人身份、语言身份和情感状态的话语级向量,难点是多种监督来自不同教师、不同数据和不同抽象层级,直接联合优化容易互相干扰。共享语音编码器先输出全部编码器层的帧级隐表示,每个属性分支对各层做独立投影,再用可学习的 softmax权重做层插值,得到兼顾本属性所需深度的帧序列。帧序列经层归一化后送入单头自注意力池化压缩为单个向量,再投影到对应教师维度,用余弦嵌入蒸馏损失向冻结教师对齐。分支权重由单任务训练的首轮验证损失与最低验证损失之差归一化得到,训练时固定不变,避免引入额外优化变量和训练不稳定。在VoxCeleb1-O说话人验证上,以等错误率衡量,多属性模型为0.915%,高于单任务说话人学生的0.899%,绝对增幅仅0.016个百分点,说明共享编码器保留说话人信息代价很小。层权重分析显示语义分支偏向中间层,情感分支偏向早中层,说话人和语言线索分布在更宽的编码器深度,联合训练会重组各属性的层利用方式。结论适用于论文评测的检索、验证、语言识别和情感识别协议,跨域泛化和噪声条件尚未验证;原文披露训练使用32张H100、批量大小14、训练17613步,原文未披露推理时延与部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
37. 电视剧语音的副语言描述:TVPara 如何同时处理强烈情感与复杂背景声

英文题目:TVPara: Paralinguistic Captioning of Expressive TV-Series Speech in Complex Acoustic Environments
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Ziyang Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenyi Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Wen Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Xuenan Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Chao Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
电视剧语音常把强烈的情绪表达与剧情相关的背景声叠加在一起,大型音频语言模型在此类音频上生成的副语言说明会变得粗糙不准确。TVPara针对单句说明与多句按时间顺序说明两项任务,要求模型输出情绪、语速、音高和音量等属性及其跨句变化的自然语言说明,难点在于背景声干扰感知以及相邻话语间情绪快速切换。构建时先用语音活动检测切分单句片段,再由预标注模型生成初稿并经大语言模型润色措辞,专业标注员对照声音删改幻觉与遗漏,多句数据则按时间顺序把相邻多句的人工校对说明合并为一段并保留声学连续性。与依赖干净录音或仅提供类别标签的已有语料相比,该工作同时保留了复杂声学环境与细粒度自由文本标注,并覆盖了跨句变化描述。在TVPara预留测试集上,以大语言模型评判的情绪等四属性相似度评分零到四分为指标,两款开源大型音频语言模型经监督微调后相对零样本基线的按格平均相对提升为31.26%。该提升向未见剧集和更干净的跨域访谈语音迁移仍成立,且在有背景声片段上按格平均相对提升为32.4%而无背景声为19.9%,但Qwen2.5-Omni在音量上预测与实测能量相关系数微调前后均约0.03、仅拟合标签分布,语速在部分迁移设置中也未提升,说明结论目前仅在英语电视剧语音及相近评测条件下得到验证,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://windowso.github.io/TVPara/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/bytedance/SALMONN — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/tsinghua-ee/SALMONN — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen2.5-Omni-7B — 链接可访问(HTTP 200)
第三方资源:https://github.com/modelscope/ms-swift — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
38. 后训练的高分是真听懂了吗:重看音频大模型的理解与推理

英文题目:What Does LALM Post-training Learn? Rethinking Audio Understanding and Reasoning Capabilities
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hua-Hsuan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Xuanjun Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Wei-Chung Lu:机构信息未能在本次解析中与作者逐人可靠绑定
- Chih-Kai Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu-Xiang Lin:机构信息未能在本次解析中与作者逐人可靠绑定
- Sung-Feng Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Haibin Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Hung-yi Lee:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
大音频语言模型输入一段声音波形和一个文字问题,要求输出答案,难点在于答对可能来自听懂声音,也可能来自文字常识和选项猜测,常规总准确率无法区分两者。该研究固定训练数据和奖励,只比较真实声音与等长静音输入下的后训练增益,把音频增益定义为真实声音下后训练减基座的准确率差,把静音增益定义为静音下对应的差值,再把多项选择改写为开放作答并用大语言模型评判语义等价,追踪增益是否依赖选项存在。研究还把全部训练声音替换为等长静音后重新训练,并在开放作答形式下重新训练,以检验训练阶段是否需要声音以及格式错配是否解释增益消失。在MMAU多项选择评测下以准确率为指标,Qwen2-Audio-7B-Instruct的组相对策略优化模型准确率为60.0%,高于基座45.2%共14.8个百分点,而同评测同指标下静音输入的该模型仍高于基座11.2个百分点。在MMAU开放作答评测下以准确率为指标,该方法准确率为29.3%,仅高于基座27.1%共2.3个百分点,说明大部分增益来自文本线索。在MMAU真实声音评测下以准确率为指标,用等长静音训练的该模型仍高于基座7.6个百分点,低于用真实声音训练时高于基座的14.8个百分点,后训练还主要减少落到选项之外的无效回答,而非提高基于声音的选项辨别。结论适用于所测的多项选择音频理解基准和所用后训练流程,对需要真正听觉依据的开放任务尚未证明有效。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
39. ONCship:用 4521 小时水下录音研究船只类型与单船身份识别

英文题目:ONCship: A Large-Scale Underwater Acoustic Corpus for Ship Recognition
评分:6.3/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Zhe Cao:机构信息未能在本次解析中与作者逐人可靠绑定
- Jichao Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiao-Lei Zhang:organization=School of Marine Science and Technology, Northwestern Polytechnical University, city=Xi’an, postcode=710072, country=China;organization=Research and Development Institute of Northwestern Polytechnical University in Shenzhen, city=Shenzhen, postcode=518063, country=China
📌 核心摘要
水下船舶识别以水听器记录为输入,输出船只类型或具体船只身份,难点在于传播衰减、环境噪声和多船混叠使同类声音差异大,而公开标注数据只有几十小时。ONCship 从加拿大海洋网络(Ocean Networks Canada,ONC)6 个站点的长期记录出发,用 AIS 轨迹做空间关联与时间分箱,筛选出单船、多船与无船片段并采样为固定时长音频,附带船型与海上移动业务标识码(Maritime Mobile Service Identity,MMSI)元数据。同一 EAT 编码器分别在通用音频、ONCship 及两者联合数据上预训练后冻结,再用逻辑回归做线性探测,以比较训练分布的作用;另一路把 ONCship 作为辅助标注数据与 DeepShip 联合微调,并按水听器是否相同划分加入条件;第三路把 50 个 MMSI 各自跨航次的片段作为 50 类目标做个体分类。在 DeepShip 上,联合预训练的冻结特征经线性探测达到 62.45% 准确率,高于仅用通用音频预训练的 61.75%;BEATs 在 DeepShip 上微调并加入本站 ONCship 数据后准确率为 69.41%,高于仅用 DeepShip 的 68.11%。MMSI 级分类 Top-1 准确率超过 53%,Top-5 接近 69%,说明跨时间相遇的个体声纹具有可分性,但结论限于 50 个身份、100 小时子集与站内划分条件。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://www.openstreetmap.org/copyright — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
40. 用共享世界状态加第一人称视听生成做可持续交互:DAO 与 JING 的分工

评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.3/1.5 | 开源 1/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- XGEN Team:机构信息未能在本次解析中与作者逐人可靠绑定
- Guohao Cai:机构信息未能在本次解析中与作者逐人可靠绑定
- Haoxuan Che:机构信息未能在本次解析中与作者逐人可靠绑定
- Frank Fan:机构信息未能在本次解析中与作者逐人可靠绑定
- Chenran Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Junjia Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiayi Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yanheng Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Leon Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Shaoteng Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Xi Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Feng Nie:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhefan Rao:机构信息未能在本次解析中与作者逐人可靠绑定
- An Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Hanwen Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Pengxiang Yan:机构信息未能在本次解析中与作者逐人可靠绑定
- Jieming Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Qian Zha:机构信息未能在本次解析中与作者逐人可靠绑定
- Wentao Zheng:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文要解决的问题是让生成式交互世界在多人、多智能体、长时间离开又返回的情况下仍保留历史后果。输入是观察者的视角控制、文本操作与对话指令以及场景与人物参考,输出是每个观察者下一段同步的视频与音频,难点是生成历史变长时的误差累积、记忆预算限制,以及看不见的场外事件如何影响后续观察。世界定义给出空间布局、初始实体、交互规则与空间约束后,DAO先检验输入的可达性与目标可用性,将通过的意图与排队编辑推进运动、空间成员与活动事件,未变状态直接延续得到新共享状态。DAO再按感知范围、视场与遮挡从新状态选出观察者局部实体状态、事件与环境信息,连同相机轨迹和人物、物体、场景参考一起送入JING。JING把上述条件与历史观察和当前动作转成下一段视频与音频隐变量,经视频与音频解码器同步解码,新片段回填历史与记忆库进入下一次循环。与已有游戏仿真或相机控制世界模型相比,差异是显式共享状态与局部体验生成分开,同一状态可读出不同视角,不同选择可从同一开头分叉并保留后果。在WBench完整集289例上按平均分比较,双向版JING为81.0分,高于Kling 3.0的79.4分而在15个参评条目中列第1,4步自回归版为79.9分列第2,说明蒸馏到少步因果生成后总体性能大体保留。结论适用于有明确世界定义和规则的室内外漫游、拿取点火类操作与多语言对话演示,长时间记忆可靠性、动作鲁棒性与状态和生成内容的一致性仍是未来工作,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/XGENlabs/XGEN-JING — 暂时无法访问
第三方资源:https://xgenlabs.ai/research/generative-world-simulation — 暂时无法访问
第三方资源:https://meituan-longcat.github.io/WBench/ — 链接可访问(HTTP 200)
代码相关资源:https://github.com/XGEN-Labs/XGEN-JING — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
41. 声音难过而文字开心时,模型该信谁
英文题目:ACR-Net: Mitigating Semantic Dominance via Contrastive Acoustic-Semantic Decoupling
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mengke Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yanda Shao:机构信息未能在本次解析中与作者逐人可靠绑定
- Tianhe Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Kai Feng:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音情感识别以语音为输入,输出愤怒、快乐、悲伤、中性等情绪类别,输入同时含声学韵律与文字语义,难点是语义稳定而声学线索细微,矛盾时模型易偏信文字。论文用可控语音合成构造对抗合成评测集声学语义探测不一致解决(Acoustic-Semantic Probing for Inconsistency REsolution,ASPIRE),制造声学与语义矛盾样本,覆盖极性相反等四类结构冲突。再用语义过度自信惩罚(Semantic Overconfidence Penalty,SOP)度量偏向文字表观情绪的概率优势,用潜在解耦度(Latent Decoupling Degree,LDD)度量融合前声学向量与语义向量的正交程度,以刻画失败原因。声学冲突解决网络(Acoustic Conflict Resolution Network,ACR-Net)保留独立音频流和文本流,用跨模态注意力(Cross-Modal Attention,CMA)让声学特征检索矛盾文字位置,再用对比解耦损失把矛盾样本的声学向量和语义向量推开。与只做融合权重调整的方法不同,该方法要求特征在融合前进入近似正交子空间。在ASPIRE基准极性相反冲突的诊断评测中,ACR-Net的声学准确率为68.4%,高于融合基线FAS的42.5%和MCR的35.2%。该结论适用于合成的四类结构冲突和五个一致性公开数据集,真实对话中的讽刺和情绪遮掩尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/zmkshakespar/ACR-Net — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
42. 从水声信号到可核查证据:物理感知编码加语言模型的水下目标识别

评分:6.3/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuge Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jie Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhengqiao Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiling Yao:机构信息未能在本次解析中与作者逐人可靠绑定
- Lingji Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jingdong Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Yixin Yang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
水下被动声感知需先判断目标是否存在,再从舰船辐射噪声中识别目标,输入为单通道水听器时间序列及其时频表示,输出在本文中被定义为包含身份、运行状态和多组物理参数的结构化文本,难点在于传播衰减与噪声遮蔽使弱线谱与调制特征难以稳定提取,且缺少带物理标注的数据。论文提出的Underwater acoustic Physics-aware Description框架把观测映射为锚定到线谱、包络调制和机械部件的物理token,再由共享大语言模型按先陈述证据、后给出判断的顺序生成描述,同一推理核心可用于识别与检测。识别实例的Underwater acoustic Physics-aware Transformer对Log-Mel谱、时变线谱和DEMON谱独立分块编码并保留物理类型,再经任务相关的特征注意力按轴频估计、轴频趋势估计、桨叶通过频率估计和机械线检测所需加权融合,对齐后送入冻结的大语言模型生成。配套物理参数化数据引擎从舰船身份、运行状态、声源组成经BellHOP传播信道叠加真实海洋噪声合成信号,并同时给出离散属性标签与数值型文本描述,为上述物理任务提供可追溯监督。在信噪比为负5分贝至5分贝的仿真测试集上,三表示加特征注意力编码相比三表示无特征注意力编码的轴频估计准确率由0.984升至0.995,机械线检测Micro-F1由0.882升至0.892。上述表现依赖仿真信道与噪声条件,在更低信噪比下估计误差增大,结论仅适用于该仿真设置。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
43. 把长视频解说拆成事件再对齐:EVA-Cap 解读

英文题目:EVA-Cap: Optimizing Audiovisual Video Captioning via Event-Centric Alignment
评分:6.3/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jiapeng Shi:机构信息未能在本次解析中与作者逐人可靠绑定
- Qiuxia Hou:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiaqi Leng:机构信息未能在本次解析中与作者逐人可靠绑定
- Junke Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yanhao Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Haonan Lu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziyi Ye:机构信息未能在本次解析中与作者逐人可靠绑定
- Zuxuan Wu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
视听视频描述输入为含画面流和声音流的视频片段,输出为交代场景动作语音音效及时间关系的长字幕,难点是听觉与视觉事件密集交织致整体文本监督易漏记弱显著事件或错配人物与同步关系。EVA-Cap先用AVoCaDO生成初稿,再用Gemini-2.5-Pro结合原始音画信号修订同步与人物归属,接着用带时间戳的事件元组做命中率过滤得到EVA-Data,监督微调使Qwen2.5-Omni-7B学会详细描述格式。随后分组相对策略优化(Group Relative Policy Optimization,对组内多个采样输出按奖励归一化求优势再做裁剪更新的强化学习方法)用事件召回奖励补全漏记事件,用人物匹配奖励纠正说话人归属,用音频到视觉检索F1奖励约束跨模态同步,并分两轮先学全局与同步再加入人物细节。与已有整体监督和只关注对话或物体属性的方法不同,该方法把字幕表示为可逐项核对的模态化事件序列。在ChronusAV事件对齐评测与AV-SpeakerBench说话人归属问答级联评测中,EVA-Cap视觉到音频推理准确率为55.4%高于DiaDem的45.9%,音频到视觉定位准确率为56.2%高于DiaDem的47.7%,说话人归属准确率为40.1%高于DiaDem的32.7%。在问答级联评测中EVA-Cap在WorldSense上问答准确率超出已有开源模型3.3%。结论适用于200秒以内以可描述事件为主的视频,对快速转场和画外音多人物仍不可靠,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/OPPO-Mente-Lab/EVA-Cap — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
44. 连分式与无源梯形网络:障板活塞与号筒阻抗的系统构造
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ronald M. Aarts:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
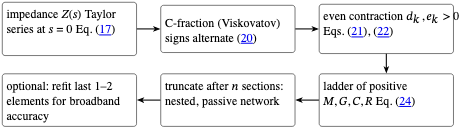
输入是障板圆形活塞的辐射阻抗与带活塞mouth负载的号筒喉阻抗,输出是由正值电阻、质量与顺性构成的被动梯形网络,难点是原阻抗为超越函数且带分支与振荡波纹,不能用截断幂级数全局逼近。方法先对零点泰勒级数做维斯科瓦托夫算法得到C连分式,再做偶收缩得到J连分式并读出梯形元件,系数为正则直接对应被动可实现网络,截断后嵌套扩展且不改动已有元件。号筒部分把每段均匀波导传输矩阵看作莫比乌斯映射,从mouth向throat回代即为连分式,尾端直接接入活塞网络而保持整体被动,mouth网络误差一一传递到喉阻抗。以最大绝对误差|Z-Zexact|/ρ0cS为指标、在ka≤κ评测设置下,14元件嵌套梯形在κ=2时为1.8e-09、在κ=5时为4.3e-04,后者高于前者。以宽带误差为指标、在0.1≤ka≤50范围内评测时,四元件基网络为0.181、匹配高频1/s项的两点近似为0.153,后者低于前者。在同一四元件拓扑下以电容参数C为比较量,贝拉尼克拟合值1.89与两点近似封闭值1.85相差约2%、后者低于前者。结论适用于需电路仿真与时域仿真的集总换能器模型,超截止波纹与无限指数号筒通带截断不收敛仍需端接处理,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
45. 神经音频编解码器的码本层级保留了哪些说话人特征

英文题目:Probing Neural Audio Codecs with Speaker Traits and Speech Characteristics
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jihwan Lee:Signal Analysis and Interpretation Lab (SAIL), University of Southern California
- Tiantian Feng:Signal Analysis and Interpretation Lab (SAIL), University of Southern California
- Minu Kim:Signal Analysis and Interpretation Lab (SAIL), University of Southern California
- Junhyeok Lee:Center for Language and Speech Processing, Johns Hopkins University
- Sean Foley:Signal Analysis and Interpretation Lab (SAIL), University of Southern California
- Thanathai Lertpetchpun:Signal Analysis and Interpretation Lab (SAIL), University of Southern California
- Najim Dehak:Center for Language and Speech Processing, Johns Hopkins University
- Dani Byrd:Signal Analysis and Interpretation Lab (SAIL), University of Southern California
- Shrikanth Narayanan:Signal Analysis and Interpretation Lab (SAIL), University of Southern California
📌 核心摘要
神经音频编解码器把语音压缩为分层离散码本并为语音语言模型提供词元,但各类说话人特质保存在码本堆叠多深处尚不清楚。论文输入原始语音并用全部码本编码后仅以累积前缀解码重建,输出重建语音与原音频在机器听辨器下特质预测的一致性随深度变化曲线,并以所需相对码本深度概括恢复难度。听辨与度量分工为先用代表性分类器预测性别、年龄组、口音、音质、情感、言语流畅性及非言语声,再以重加权科恩卡帕比较重建与原件预测,最后取首次接近全深度水平的最早相对深度为特质深度。与只测可懂度、说话人相似度或单一副语言线索的已有评测不同,该工作把码本层次是否统一由粗到细的问题按特质拆开检验。在相应测试集上十七个编解码器平均下以特质深度为指标,非言语声内笑声约20%相对深度即达阈值,低于喷嚏和咳嗽所需的50%到60%,性别最浅而音质和年龄组最深。跨编解码器比较显示蒸馏、流式与帧率等设计差异与特质深度相关而非完全受控因果,流式版本在首码本与全深度上一致性变化不同。结论限于所测以英语为主数据和机器听辨条件而不等同人耳感知,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
46. 推理越多越好吗:指向性音视频分割的预决策推理预算

英文题目:To Think or Not to Think: Pre-Decisional Reasoning Budgets for Referring Audio-Visual Segmentation
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Haojie Hu:Tongji University
- Senda Chen:Tongji University
- Ying Shen:Tongji University
- Lin Zhang:IEIT SYSTEMS (Beijing) Co., Ltd.;Tongji University
📌 核心摘要
指代表达音视频分割输入未剪辑视频、同步音频和自然语言指代表达,输出发声目标的时空二值掩膜,语言歧义、多个相似声源和视听对齐误差都会干扰定位。论文对每个样本分别运行零推理、短推理和长推理三种预算并经同一检测加分割栈评分,再按容差选最低成本预算作为反事实标签。接着复用冻结多模态大模型在首个推理词元之前的末输入位置隐状态作为生成起始表示,用线性探针和两层感知机预测是否需要推理,该标签直接作为路由器监督信号。选定预算的查询被送入GroundingDINO得到框,再由SAM2得到掩膜,决策在生成开始前一次前向完成。在RefAVSBench测试可见集上,自适应控制器取得0.528的区域相似度与轮廓准确度平均值(\(\mathcal{J}\&\mathcal{F}\)),低于固定长推理的0.549,但推理词元从275降至110。长推理在简单查询上会引起措辞与定位漂移而损害分割,只在真正歧义查询上有益。该权衡只在评测管线内成立,源到改写指代表达的迁移取得0.458而未超过固定长推理的0.474,仅体现成本效率,完整标注仍需目标掩码和多次管线运行,原研究共计约85 GPU小时,延迟在单卡A100上测得,跨主干原生最优预算尚未单独校准。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
47. Qwen-Audio-Jev:把音频问答变成直接的选项、判断和打分

英文题目:Qwen-Audio-Jev: A Unified Interface for Audio Decisions
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Ying Fang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhifu Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Qing Gu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiajun He:机构信息未能在本次解析中与作者逐人可靠绑定
- Kangqi Jing:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiangang Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu Pu:机构信息未能在本次解析中与作者逐人可靠绑定
- Wupeng Wang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
论文要解决的输入是音频加自然语言问题加明确答案规格,输出是三类有界决策:从给定候选项中选择(Choice)、二元命题为真的概率(Noul)、有序等级上的期望评分(Score),难点是不同数据集标注形式不同且高吞吐场景下逐词生成答案延迟高、后处理复杂。方法保留 Qwen-Audio-3.1-ASR-Flash-Next 的音频编码器、音频到语言适配器和混合专家语言解码器,把问题与答案规格序列化为前缀并取前缀末尾的隐藏状态作为决策状态,再由三个仿射读出头分别产生候选分布、二元概率和等级分布。监督微调(Supervised Fine-Tuning,SFT)阶段按激活原语施加分类交叉熵、二元交叉熵和分布加顺序加期望的三项打分损失,缺失标注不产生损失;可选的面向校准决策的强化学习(Reinforcement Learning for Calibrated Decisions,RLCD)阶段从 SFT 检查点出发做单步采样和策略梯度更新。与已有音频问答直接生成文本答案的做法不同,该模型不解码答案词序列,而是直接读出任务限定的概率或分数。在 MMSU 口语理解评测上模型准确率达到 84.06%,在所报告的推理设置下相对原始骨干取得约 20 倍加速。结论适用于所列 18 组有标签配置,情绪识别、复杂音频问答和部分质量评分仍较弱,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
48. 说话代替打字会丢多少分:SEA-HELM Audio 的语音链路评测解读

英文题目:SEA-HELM Audio: Evaluating Multilingual ASR-LLM Pipeline Performance Across SEA-HELM Subsets
评分:6.0/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yixian Tan:机构信息未能在本次解析中与作者逐人可靠绑定
- Aulia Adila:机构信息未能在本次解析中与作者逐人可靠绑定
- Jonathan Heng:机构信息未能在本次解析中与作者逐人可靠绑定
- Kunat Pipatanakul:机构信息未能在本次解析中与作者逐人可靠绑定
- Donghang Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Anocha Sutaveephamochanon:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
这项工作要回答文字基准如何变成语音评测,以及用户用说话代替打字会在东南亚多语言任务上损失多少准确率。输入是SEA-HELM的文字提示,输出是同一提示经朗读、识别、作答后的任务得分,难点在于转写错误会改动题干中的关键约束。语音合成以提示中可说内容为输入朗读生成音频且不读出答案钥匙,与被测系统无关的同一音频直接作为待测自动语音识别的输入被转写为文本。转写文本与原始文字分别送入同一大语言模型作答,两种回答再交由同一规则验证器打分得到语音准确率与文本准确率,两者差值记为语音差距,转写质量另用词错误率和字错误率衡量,从而区分改动了多少字和对任务影响多大。与用英文真人录音的已有语音评测不同,该框架保留了SEA-HELM的本地表达和多语言验证器。在SEA-HELM IFEval泰米尔语评测中,以ElevenLabs v3合成语音为输入、每轮105个样本时,MERaLiON3-ASR-3B搭配SEA-LION-4.5-27B的语音准确率为47.62,低于同一模型文字直接作答的文本准确率87.62,两者相差40.00个百分点,说明指令跟随对转写改动很敏感。该结论仅适用于已实测的Global-MMLU-Lite选择题与IFEval指令跟随及中、英、马来、印尼、泰米尔语合成语音条件,SEA-HELM NLU问答与Safeguard拒绝任务仍列为未来工作,真人发音与更多口音尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
49. 先只听正常声再用一次故障做小样本修正的异常声音检测

英文题目:Few-Shot Adaptation for Anomalous Sound Detection at Low False-Positive Rate
评分:6.0/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Simone Lugani:机构信息未能在本次解析中与作者逐人可靠绑定
- Christof Pichler:机构信息未能在本次解析中与作者逐人可靠绑定
- Hannes Wegleiter:机构信息未能在本次解析中与作者逐人可靠绑定
- Christoph Feilmayr:机构信息未能在本次解析中与作者逐人可靠绑定
- Rodolfo Zunino:机构信息未能在本次解析中与作者逐人可靠绑定
- Edoardo Ragusa:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
高炉料仓有多台振动筛同时运行,背景噪声强且时变,微弱故障声容易被掩盖,监测系统必须在极低误报下运行,否则频繁误报会让系统无法使用。论文输入是现场麦克风录音的对数梅尔语谱图,输出是每个 1.37 s 音频段的异常分数,分数越高表示越偏离正常。第一阶段只用正常声音训练卷积变分自编码器(Convolutional Variational Autoencoder,CVAE)压缩重建语谱图,再用高斯混合模型(Gaussian Mixture Model,GMM)对潜表示建模,异常分数取潜表示在 GMM 下的负对数似然。第二阶段在首次故障后保留 GMM 不变,只微调 CVAE,让正常样本贴近原有正常分布,让少量异常样本远离该分布,同时保留对正常数据的重建约束。与无协方差正则的无监督基线相比,正则化把平均精确率召回曲线下面积从 20.0 提高到 23.0,少样本适应后进一步达到 64.0,该结果是在 3 折交叉以故障机器划分、其余两台机器做测试的条件下得到的。结论适用于同厂区同类机械故障的早期复用,尚未验证更多故障类型和长期漂移,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
50. 冻结多模态大模型输出如何做连续情感预测

英文题目:Shared Sentiment Evidence from Frozen Multimodal Models for Continuous Sentiment Prediction
评分:6.0/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.6/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shuobo Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruiqi Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Shaobo Qiao:机构信息未能在本次解析中与作者逐人可靠绑定
- Shixu Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Feng Xu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
连续多模态情感分析把同一片段的文本、音频和视频线索映射为表示极性和强度的实数值,难点是各线索可能指向不同情感,且证据强度与标注尺度的对应关系需要学习。方法先对同一冻结骨干分别送入文本、音频、视频和联合输入并提问,在强烈负面到强烈正面的5个固定选项上取候选分数并归一化,得到4组5选项分布,为每个片段提供20个概率。再把这20个概率作为输入,计算每组分布的熵以刻画集中程度,并计算单模态视图两两之间以及联合分布与单模态均值之间的Jensen-Shannon散度以刻画跨视图分歧,连同原概率拼接成28维向量。然后把该28维向量直接送入CatBoost回归器,由训练标注学习从分布形态到数据集连续尺度的映射,每个骨干与数据集组合分别拟合读出头,骨干权重保持冻结。在CMU-MOSI测试集上,Qwen2.5-Omni-7B的共享情感证据取得平均绝对误差0.5660,低于同缓存下仅用联合分布的CatBoost结果0.5910。在CH-SIMS-v2上平均绝对误差对应数值是0.2483对0.2794,成对自举区间不包含零。缓存建成后,12组超参数搜索在25线程CPU上约用5.86秒和5.05秒,额外骨干的固定读出拟合约用2.7秒到3.0秒,但每个片段需要4次视图查询,一次性多模态推理仍是主要成本。该结论依赖坐标定义固定且每个骨干与数据集单独拟合读出头,尚未验证缺失模态、跨数据集校准和自适应采集下的表现,视图缺失或来源分布变化时效果可能下降。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
51. 不再一刀切求不变:按因子区分处理多模态分布偏移

英文题目:Beyond Invariance: Factor-wise Selective Treatment of Shifts for Multimodal Learning
评分:6.0/10 | 创新 1.4/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Guimin Hu:Guangdong University of Technology
- Qiwei Peng:University of Copenhagen
📌 核心摘要
多模态情感分析的输入是同一视频片段的文本、音频和视觉信号,输出是二分类情感标签。难点在于说话人、采集条件和时间变化会改变表示分布,而偏移本身不等于无用或有害,有的偏移仍具预测价值且稳定性各异。FaShift(Factor-wise Shift Discovery,因子级偏移发现框架)先把融合表示分解为多个低冗余隐因子,以保留任务信息并形成可单独替换的表示单元。接着它在说话人划分的训练环境之间度量每个因子的分布偏移,并用跨环境参考因子替换目标因子,以干预前后预测概率向量的变化度量预测影响。最后框架按干预效应大小和跨环境稳定性赋予保留权重,对加权后因子再经同一预测头输出结果。与追求统一不变表示的方法不同,该框架区分无预测作用的干扰偏移、稳定有用的预测偏移和有用但不稳定的预测偏移,分别抑制、保留和衰减。在 MOSI 分布外评测中它取得 81.2% 准确率和 81.4% F1,超过表中可比最强基线约 1.5 和 3.6 个百分点。结论适用于说话人构成的训练异质性可迁移到未见分布的情形,伪环境和阈值敏感性仍需验证,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://huggingface.co/Qwen/Qwen3-Embedding-4B — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
52. 多尺度广义稀疏平面波分解:用更干净的球面核与跨阶一致性找声源方向

英文题目:Multiscale Generalized Sparse Plane Wave Decomposition in the Spherical Harmonic Domain
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Huseyin Hacihabiboglu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
本文解决在阶数受限球麦克风阵列条件下,从球谐系数估计少数平面波方向与复振幅的问题,输入是截断到 \(N\le 6\) 的球谐系数向量,输出是单位球上稀疏支撑集与对应振幅,难点是球面 Dirichlet 核旁瓣高、后瓣大且字典列高度相关。方法先以球谐系数做加权波束成形设计广义球面核,用 Legendre 级数系数调整各阶权重,压低旁瓣功率并强制后瓣为零,得到广义转向响应函数。再把 \(1\) 到 \(N\) 阶广义响应都计算出来并堆叠成多尺度观测向量,它们共享同一支撑集与系数,使低阶冗余信息进入高阶分析。稀疏恢复时对各阶字典投影取调和平均做跨阶共识挑选原子,再对已选支撑做正交投影更新残差并迭代,直至残差功率降到阈值。与只用最高阶的原稀疏平面波分解相比,多尺度广义方法在高阶下同时保持查准与查全。在 \(N=6\)、信噪比不低于 \(20\) dB、声源数 \(1\) 到 \(10\) 的合成条件下,多尺度广义方法比单尺度原方法平均 \(F1\) 分数高 \(0.246\)。该结论只在合成各向同性噪声、最小间隔受控且字典网格为 \(3072\) 像素时成立,\(10\) dB 时多尺度方法退化,振幅误差也略大。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/hacihabiboglu/gspwd — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
53. 单人语音注意力的无监督脑电追踪:包络跟踪证据加隐马尔可夫时间推理

英文题目:A hidden Markov model for unsupervised EEG-based tracking of auditory attention to a single voice
评分:5.9/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tianyi Li:T. Li, S. Geirnaert, and A. Bertrand are with the Department of Electrical Engineering (ESAT), STADIUS Center for Dynamical Systems, Signal Processing and Data Analytics and with Leuven.AI – KU Leuven institute for AI.
- Simon Geirnaert:T. Li, S. Geirnaert, and A. Bertrand are with the Department of Electrical Engineering (ESAT), STADIUS Center for Dynamical Systems, Signal Processing and Data Analytics and with Leuven.AI – KU Leuven institute for AI.;S. Geirnaert is also with KU Leuven, Department of Neurosciences, Research Group ExpORL.
- Davina Van den Broek:D. Van den Broek, E. Bellon, and B. De Smedt are with the Faculty of Psychology and Educational Sciences, KU Leuven, 3000 Leuven, Belgium.
- Elien Bellon:D. Van den Broek, E. Bellon, and B. De Smedt are with the Faculty of Psychology and Educational Sciences, KU Leuven, 3000 Leuven, Belgium.
- Bert De Smedt:D. Van den Broek, E. Bellon, and B. De Smedt are with the Faculty of Psychology and Educational Sciences, KU Leuven, 3000 Leuven, Belgium.
- Alexander Bertrand:T. Li, S. Geirnaert, and A. Bertrand are with the Department of Electrical Engineering (ESAT), STADIUS Center for Dynamical Systems, Signal Processing and Data Analytics and with Leuven.AI – KU Leuven institute for AI.
📌 核心摘要
绝对听觉注意解码只给出一路目标语音和脑电图,要求输出听者对该语音的注意程度随时间的变化,没有竞争说话人可供比较,短窗下神经包络追踪噪声大且难以直接判读。论文先用线性空时解码器从脑电图重建语音包络,再按不重叠分析窗计算重建包络与真实包络的Pearson相关,得到神经包络追踪序列作为注意证据。随后对Fisher变换后的该序列用多尺度混合模型无监督估计双状态隐马尔可夫模型的发射分布,再经前向与前后向推断输出处于注意状态的后验概率,作为连续注意分数,利用状态持续假设整合前后证据。与固定窗平均只做局部平滑不同,该模型以转移概率建模状态持续性并做概率时间推断。在30名成人观看75分钟讲座视频的数据上,以无干预与脱离任务两段为评价参照,非因果隐马尔可夫模型在1秒窗下将AUC均值从原始神经包络追踪的0.547提高到0.832。原文未披露训练、推理或部署成本,离线分析允许使用整段数据。结论限于该讲座范式和以实验分段作为评价参照的范围,对分心与增强条件及真实走神未经验证,基线注意不足时解码器估计可能失效。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
54. 让每个小批量都看到不同干净语音:特征分层组批
英文题目:Rethinking Batch Composition: Promoting Feature Diversity for Speech Enhancement
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mingchi Hou:机构信息未能在本次解析中与作者逐人可靠绑定
- Ina Kodrasi:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音增强需从带噪观测中恢复干净语音,即使噪声类型、信噪比和说话人固定,不同干净语音样本的增强难度仍受其固有声学特征影响。随机采样的小批量可能只覆盖声学特征空间的局部区域,使梯度更新偏向特定难度范围。为此论文提出按干净语音特征分层的批量采样,仅改变训练样本组成而不改模型结构、损失与优化流程,可直接替换采样器。该方法先用openSMILE提取每句干净语音选定特征值,再按训练集经验分布将其划分为分位数,得到各样本的分组标签。组装小批量时从各分位数等量抽取且不放回,使每批均匀覆盖不同特征区间,特征只决定分组而不输入增强模型。在英语WSJ0上三次重复训练复数谱回归模型的平均结果中,分层采样以第三共振峰均值为特征时扩展短期客观可懂度改善值ΔE-STOI为0.27,高于随机采样的0.24。增益幅度随数据集、模型和指标变化,在PC-GITA上薛定谔桥生成模型与随机采样基本相当,结论限于所测四类CHiME3噪声混合、信噪比范围、语言和人群,尚未验证其他批量大小、分位数、联合特征与主观听感,方法几乎不增加额外计算成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
55. Revise-TTS:让掩码扩散语音合成可以回头改错

英文题目:Revise-TTS: A Non-Masking Refinement Framework for Masked Diffusion Models in Text-to-Speech
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Wanli Sun:机构信息未能在本次解析中与作者逐人可靠绑定
- Dan Su:机构信息未能在本次解析中与作者逐人可靠绑定
- Anton Ragni:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
零样本文本到语音要求仅用一段提示语音和任意文本生成目标说话人的语音。掩码扩散模型在多步去噪中每次只提交最高置信度的非重叠位置预测,已提交词元无法修改,高置信度但错误的词元会传到后续位置,两阶段文本到语义再到声学系统更难定位误差来源。Revise-TTS保持单阶段文本直达声学词元的链路,避免级联结构带来的误差归因困难。分层二值量化(Hierarchical Binary Quantization,HBQ)把融合声学语义特征归一化后逐轮二分,得到由粗到细的多轮比特表示,为后续按索引或比特预测提供结构化词元。生成式精炼网络(Generative Refinement Networks,GRN)训练时从真值与随机词元的混合输入中重建全部目标词元,推理时从随机词元出发经多步迭代随机丢弃一小部分上一轮预测并重新生成,使后期步骤能修正前期错误。在LibriSpeech-PC上Revise-TTS的词错率为2.00%,高于OmniVoice的1.57%,而在Seed-TTS中文集上为1.19%,优于F5-TTS的1.53%和MaskGCT的2.40%,但三个测试集的说话人相似度均低于OmniVoice。结论适用于所用XCodec 2.0类编解码器与32步精炼推理的零样本设置,跨编解码器、少步数或强相似度要求的表现尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
56. 让语音大模型听不见性别与学会有分寸地听见性别

英文题目:Bias Mitigation in Audio-Enabled LLMs through Adversarial Training and Distillation Methods
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Adnan Al Ali:机构信息未能在本次解析中与作者逐人可靠绑定
- Jindřich Libovický:机构信息未能在本次解析中与作者逐人可靠绑定
- Anne Lauscher:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
语音使能大语言模型(Audio-enabled Large Language Model,AuLLM)直接以语音为输入,输出文本回答,语音中的副语言线索会让模型推断说话人性别并产生刻板关联,这是本文要处理的问题。第一步用对抗训练只更新音频编码器,性别分类头前加入梯度反转层(Gradient Reversal Layer,GRL),同时保留语言模型损失以维持通用能力,得到性别无感知模型。对抗阶段在 Qwen3-Omni-30B-A3B 上把性别探测绝对准确率从 99.9% 降到 54.5%,而 mmau 通用音频理解准确率保持在 71.3%。第二步用原始模型回答通用指令、用性别无感知模型回答隐式性别刻板 prompt,再以 KL 散度(Kullback-Leibler Divergence,KL)蒸馏到只训练解码器注意力的低秩适配器中,希望恢复性别识别但输出更中性。蒸馏后 Qwen2-Audio-7B 的选项偏见对数优势比从 0.40 降到 0.23,但另两个大模型改善很小。该路线依赖小规模英文语音和指令数据,开放式生成评估依赖外部大模型抽取形容词,结论尚未覆盖真实对话、其他属性和性别化语言。训练成本披露为单轮约 2 小时及各模型推理与训练显存占用,未给出延迟与吞吐测量。
🔗 开源资源
第三方资源:https://github.com/adnan-al-ali/speech-llm-bias-mitigation/ — 链接可访问(HTTP 200)
第三方资源:https://hf.co/alalia/speech-bias-mitigation/ → https://huggingface.co/alalia/speech-bias-mitigation/ — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
57. 冻结音频编解码器的量化器冗余与索引精确重编码
英文题目:Quantizer Redundancy and Exact Index Recoding in a Frozen Neural Audio Codec
评分:5.7/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Youssef Hemimy:St. Thomas University, Miami Gardens, Florida, USA
📌 核心摘要
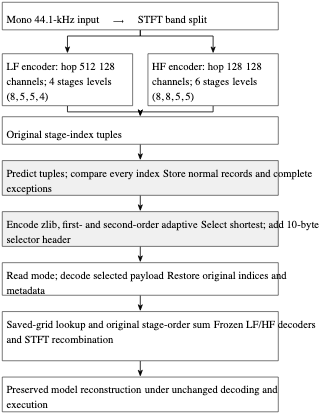
冻结编解码器把单声道音频送入低频和高频两条编码路径,分别编码后按组用多级残差标量量化产生整数索引,解码端查表求和后经神经解码器重建波形,难点是后级重复使用同一无缩放网格时索引高度相关,而浮点执行又不完全等于理想实数递推。方法先分析理想递推的奇偶行为,奇数基网格后级为零,偶数基网格在两个中心值之间交替,由此构造只存首索引加分支位的预测元组。再对每个标量位置逐项比对预测与真实索引,不符者存完整原始元组,使精确恢复不依赖理想恒等式。最后在预测载荷外分别尝试通用压缩与一阶和二阶自适应算术编码并按文件选最短者,权重与重建图保持冻结。在512文件集合上,与原始索引的XZ对照相比,以含全部头开销的测量码率为指标,最终三模式选择器为129.591 kbps,低于对照,以聚合字节为指标减少25.943%,且保持解码器输入逐比特一致。在62文件集合上,与原始索引的XZ对照相比,以含全部头开销的测量码率为指标,最终选择器为142.696 kbps,低于对照,以聚合字节为指标减少26.296%。结论只适用于该冻结实现和声明的CPU float32执行,集合复用、训练内容溯源不完整和完整三路编码代价未实测限制了外推,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
58. 只用听写训练的线性映射能让语言模型听懂语音吗

评分:5.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Edwin Arkel Rios:National Yang Ming Chiao Tung University, Taiwan;Tranxform AI
- Sneh Sourabh:Indian Institute of Technology Hyderabad, India
- Jocelyn Zaruma:Institut national des langues et civilisations orientales, France;Université Sorbonne Nouvelle, France
- Girish Ewoorkar:Cohere Labs Community
- Julian Mack:Cohere
- Bo-Cheng Lai:National Yang Ming Chiao Tung University, Taiwan
📌 核心摘要
该研究处理语音输入到语义输出的映射,输入为FLEURS朗读语音,输出为是否提及人名的是否回答或七选一的话题编号,难点在于投影器只见过转写监督而没有见过理解任务的标注。冻结的Whisper-medium语音编码器先将语音波形编码为声学特征序列,每个语言独立训练的线性投影器只以WorldSpeech转写损失学习,把该特征序列映射为解码器词嵌入空间中的音频标识序列。冻结的Tiny Aya Global解码器再把音频标识序列与问题提示拼接后输入,按提示直接生成转写或答案,未答对时多回退为转写。与已有跟随SLAM-ASR流程只评测转写的工作不同,本文评测指令跟随率和理解正确率,并用参考文本替换语音得到解码器上限。在11种语言平均的FLEURS数字模板话题任务上,语音输入的平衡准确率为23.2%,低于同一解码器读参考文本时的71.5%,信息缺失发生在投影器环节。同一FLEURS话题评测中,开放式提问的指令跟随率最高仅16.0%,低于数字模板各语言26.0%至100.0%的指令跟随率。是非问答在FLEURS上的平衡准确率语音为48.6%、文本为49.2%,均未高于50%随机水平。结论只适用于朗读维基百科句子的短语音和所用编码器与解码器组合,原文披露单次投影器训练在1张H200上中位耗时15.2小时,未披露推理与部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
59. AdaFrame:为视频广告分析省下视觉语言模型调用量的自适应去重
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Abdul Basit Tonmoy:Wabash College, Crawfordsville, Indiana, USA
- Arman Luthra:Wabash College, Crawfordsville, Indiana, USA
- Guang Lin:Purdue University, West Lafayette, Indiana, USA
- Qixin Deng:Wabash College, Crawfordsville, Indiana, USA
📌 核心摘要
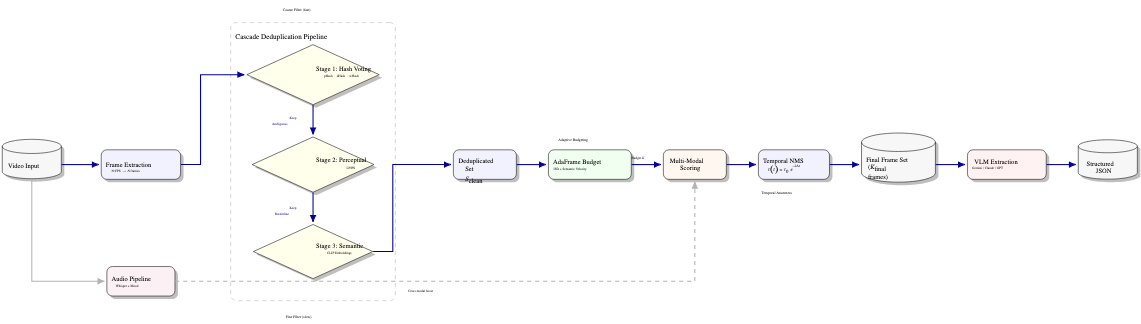
输入是广告视频的原生帧序列与伴随音频,输出是限定在Pitt Ads词表内的主题、情感等结构化字段,均匀采样既把静态段重复送入视觉语言模型造成浪费,又容易错过快速切换中的品牌与情绪线索。AdaFrame先做场景切分与密集候选提取,再依次经过哈希投票、学习感知相似度与语义聚类三级过滤,幸存帧按位置边界与音频图文特征打分后做时间感知抑制再送入抽取。帧预算由本征语义维度与语义能量共同决定,前者是对嵌入矩阵做奇异值分解后累计方差达标所需的秩,后者综合帧间嵌入变化与文本人脸位置加权,预算随剪辑复杂度自适应伸缩。与仅做语义聚类或基于像素变化的检测不同,该方法在语义等价层面去重并保留时间覆盖。在Pitt Ads数据集500条广告上以Gemini 2.5 Flash抽取为评测设置,相对Uniform-1FPS,AdaFrame平均帧数由47.7帧降至24.6帧,主题准确率由84.4%升至86.0%,情感准确率由71.9%升至79.4%,500条总成本由5.74美元降至1.43美元。同在上述500条评测设置下,相对CLIP Only,AdaFrame平均帧数由74.1帧降至24.6帧,主题准确率由83.7%升至86.0%,情感准确率由71.6%升至79.4%。结论适用于平均时长较短的广告与闭集分类,视觉相似但文字不同的帧可能被误删,原文未披露训练成本,推理成本按原文所用视觉语言模型计价给出。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
60. 从事后检测到提前预报:口吃起始的连续因果预测

英文题目:From Detection To Anticipation: Continuous Onset Forecasting For Stuttered Speech
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tampu Ravi Kumar:机构信息未能在本次解析中与作者逐人可靠绑定
- Ayoub Daliri:机构信息未能在本次解析中与作者逐人可靠绑定
- Vivek Gupta:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
口吃辅助反馈需要在重复、延长、阻滞开始前预估临近程度,而现有检测多在事件发生后才判定。输入是预测时刻t之前的不含未来音频的既往语音,输出是未来Δ内出现新事件起始点的概率,难点在于事件稀少、前兆弱且说话人差异大。冻结的Whisper-large-v3编码器把每100 ms对应的前2 s音频压缩为1280维向量,形成因果状态序列并缓存供后续建模使用。因果Conformer沿最长200步历史建模状态演变并输出风险,离散时间生存头一次前向给出15个100 ms条件风险并累乘为随视界单调的累积概率。与扩大静态声学窗口不同,该工作以精确起病时刻为锚点做因果逐帧预测,并按报警占空比评估事件覆盖。在FluencyBank Timestamped六折说话人无关交叉验证、300 ms视界下,因果Conformer平均精度0.0769、AUROC 0.6300,高于静态Whisper预测器的0.0522和0.5682。在FluencyBank Timestamped离线仿真评估中,25%报警占空比下Conformer事件覆盖率58.6%,超过TCN的57.4%和GRU的53.8%,验证集最大F1阈值下平均提前196 ms预警43.9%事件但每分钟有27.6个误报段;表征一次提取缓存耗费0.9 GPU-hours、随后每个时序模型在单GPU上训练几分钟,原文未报告推理延迟与实际部署开销。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
61. 多模态智能体记忆如何形成与演化:表示与管理的双轴解读

英文题目:Seeing, Maintaining, and Learning: The Evolution of Multimodal Agent Memory
评分:5.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:综述 | arXiv 原文
👥 作者与机构
- Minghao Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Qingyue Jiao:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiujin Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Jianhong Pang:机构信息未能在本次解析中与作者逐人可靠绑定
- Ruimeng Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Naihao Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Liwei Che:机构信息未能在本次解析中与作者逐人可靠绑定
- Haochen Xue:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziqi Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Xinying Cai:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiaxuan Luo:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiaxin Deng:机构信息未能在本次解析中与作者逐人可靠绑定
- Xuesong Ye:机构信息未能在本次解析中与作者逐人可靠绑定
- Jintao Qu:机构信息未能在本次解析中与作者逐人可靠绑定
- Wenyao Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Jingwen Gu:机构信息未能在本次解析中与作者逐人可靠绑定
- Chenyang Zhao:机构信息未能在本次解析中与作者逐人可靠绑定
- Shichun Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Guibin Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zefang Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Siyin Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Wujiang Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Danrui Li:机构信息未能在本次解析中与作者逐人可靠绑定
- Zeru Shi:机构信息未能在本次解析中与作者逐人可靠绑定
- Woongyeong Yeo:机构信息未能在本次解析中与作者逐人可靠绑定
- Shuang Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Wei-Chieh Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Weizhi Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tianyu Yang:机构信息未能在本次解析中与作者逐人可靠绑定
- Kangsan Kim:机构信息未能在本次解析中与作者逐人可靠绑定
- Yebowen Hu:机构信息未能在本次解析中与作者逐人可靠绑定
- Bowen Wen:机构信息未能在本次解析中与作者逐人可靠绑定
- Bowen Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Haohao Su:机构信息未能在本次解析中与作者逐人可靠绑定
- Ming Yin:机构信息未能在本次解析中与作者逐人可靠绑定
- Sheldon Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Mian Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuyan Chen:机构信息未能在本次解析中与作者逐人可靠绑定
- Hanrong Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Kai Mei:机构信息未能在本次解析中与作者逐人可靠绑定
- Zihao Zhang:机构信息未能在本次解析中与作者逐人可靠绑定
- Mingyu Jin:机构信息未能在本次解析中与作者逐人可靠绑定
- Xi Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Hengyi Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tianxin Wei:机构信息未能在本次解析中与作者逐人可靠绑定
- Linyong Nan:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhenwen Liang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhendong Chu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziqi Huang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yongye Su:机构信息未能在本次解析中与作者逐人可靠绑定
- Sixun Dong:机构信息未能在本次解析中与作者逐人可靠绑定
- Shujian Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Kaiqu Liang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiaojiao Han:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhaoye Fei:机构信息未能在本次解析中与作者逐人可靠绑定
- Kun Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Shihan Dou:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhichun Guo:机构信息未能在本次解析中与作者逐人可靠绑定
- Xingjian Diao:机构信息未能在本次解析中与作者逐人可靠绑定
- Zeqi Gu:机构信息未能在本次解析中与作者逐人可靠绑定
- Heng Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tao Feng:机构信息未能在本次解析中与作者逐人可靠绑定
- Cheng Qian:机构信息未能在本次解析中与作者逐人可靠绑定
- Hamid Palangi:机构信息未能在本次解析中与作者逐人可靠绑定
- Silei Xu:机构信息未能在本次解析中与作者逐人可靠绑定
- Xi Yun:机构信息未能在本次解析中与作者逐人可靠绑定
- Yi Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
- Shilong Liu:机构信息未能在本次解析中与作者逐人可靠绑定
- Qingsong Wen:机构信息未能在本次解析中与作者逐人可靠绑定
- Sung Ju Hwang:机构信息未能在本次解析中与作者逐人可靠绑定
- Zuxuan Wu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yu-Gang Jiang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yiyu Shi:机构信息未能在本次解析中与作者逐人可靠绑定
- Dimitris N. Metaxas:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiaxuan You:机构信息未能在本次解析中与作者逐人可靠绑定
- Julian McAuley:机构信息未能在本次解析中与作者逐人可靠绑定
- Mengdi Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jiawei Han:机构信息未能在本次解析中与作者逐人可靠绑定
- Philip S. Yu:机构信息未能在本次解析中与作者逐人可靠绑定
- Ziyi Ye:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
多模态智能体要在跨会话长过程中使用图像、视频、音频、界面和三维观测,输出供后续推理规划或动作使用,难点是观测维度高而无法无损转成文字且世界随时间变化,记忆须兼顾细节保留与可用有效。论文把记忆生命周期分成形成与管理,形成功能是把连续观测切成记忆单元并选择表示,管理功能决定部署中是否修改记忆以及修改规则本身是否演化。形成先识别以后可能有用的经验片段并写成记录,所得记忆单元进入表示选择:贴近源模态的保留维持可恢复证据,文字与结构化记录抽取可检索的实体关系,内化隐状态与参数则把经验压入推理而不再回放原始证据。各表示的输出进入管理层,T1静态记忆只定位复用固定记忆,T2动态记忆按固定规则更新核验并同步关联表示,T3自演进记忆把反馈归因到管理决策并持久改写写入维护或检索规则。表示约束管理能否成立,层级越高对可定位、可修改、可验证和可恢复的要求越多,混合表示还须在修订合并删除中维持来源链接与跨表示一致,否则抽象记录与支撑观测脱节。原文未提供可核对的关键定量结果。该结论适用于需在有限资源下长期交互并保持记忆可验证可恢复的智能体,缺少来源追溯、反馈归因与策略级验证时可能失败,在线策略演进、有界终身记忆、受控遗忘与全生命周期评测尚缺充分验证。原文未披露训练、推理或部署成本。
🔗 开源资源
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
62. 给音频插件数据集留下可核查的生产记录

英文题目:vst-bench-ml: Auditable Dataset Generation for Audio Plugins
评分:5.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Youssef Hemimy:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
用音频插件批量生成数据集时,每个音频观测的产生条件容易丢失,后续难以判断文件是否在预期软件与参数下渲染,也难以发现文件是否被替换或损坏。Python包先选取参数与固定MIDI输入并生成带哈希的采样计划,该计划作为渲染命令的输入限定待渲染的参数组合与信号来源。渲染前客户端请求宿主加载指定插件并返回宿主与插件身份,客户端比对宿主报告的解析路径与请求路径,render命令再比对参数清单中的插件标识与宿主返回标识,任一比对失败或关键身份缺失则不开始渲染,宿主报告的二进制哈希留作溯源证据。通过检查后外部宿主运行已加载的VST3插件完成渲染,包端把保留观测写入保留记录文件、把丢弃与失败事件写入独立失败账本,并用密封清单绑定软件身份、渲染设置与输出哈希。离线校验在不加载插件的情况下重算清单摘要与文件哈希并核对数量对应关系,配套仓库则为受控样例补充尝试级证据并重新密封。现有Python软件支持离线音频插件渲染,本文提供渲染工作流背景但不比较其溯源能力。在锁定的macOS arm64与Python 3.12组合上,两次全新进程渲染均复现了同一采样计划哈希与8个预期输出哈希覆盖4组采样参数与2个固定MIDI信号,12个负向用例与31个包测试同样通过。结论适用范围限于该受控插件、上述参数与信号构成的8个输出,不支持跨机器、跨平台或商业插件的移植性推论,原文未披露训练、推理或部署成本,不报告模型训练实验。
🔗 开源资源
第三方资源:https://github.com/itsuzef/vst-bench-ml-public — 链接可访问(HTTP 200)
第三方资源:https://github.com/itsuzef/vst-bench-dataset-host-public — 链接可访问(HTTP 200)
第三方资源:https://pypi.org/project/vst-bench-ml/0.1.1/ — 链接可访问(HTTP 200)
第三方资源:https://zenodo.org/records/22924036 — 链接可访问(HTTP 200)
第三方资源:https://zenodo.org/records/22924073 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
63. 在真实多犬视频里把每声吠叫归到同一只犬

英文题目:Audio-Visual Dog Identification and Tracking in Real-World Videos
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Aryahvishwa Babu:机构信息未能在本次解析中与作者逐人可靠绑定
- Kingsley Jin:机构信息未能在本次解析中与作者逐人可靠绑定
- Lillian Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Tuan M. Dang:机构信息未能在本次解析中与作者逐人可靠绑定
- Theron S. Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Jeorge Joshi:机构信息未能在本次解析中与作者逐人可靠绑定
- Annie Cao:机构信息未能在本次解析中与作者逐人可靠绑定
- Kenny Q. Zhu:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
任务输入是一段无约束多狗视频和已知的吠叫时间区间,输出是每个吠叫时刻对应的持续狗身份,以及吠叫狗在画面中的位置或画外判断。难点在于多狗同时吠叫、遮挡、狗离开再进入、画外吠叫和跟踪碎裂都会切断视觉证据。视觉分支先用检测加短期跟踪得到候选框,再用冻结视觉编码器加逻辑回归估计吠叫概率并取事件内最高分者,在21个手工标注视频的3890帧15407框跟踪评测中,持久画像合并使HOTA从46.85升至49.81,高于未合并的StableTracker,身份切换从34降至11。视觉分类在手工标注基准的90个多候选事件上,八帧平均的多狗Top-1准确率为73.3%,高于ImageBind加逻辑回归的53.3%,说明简单平均更利于同时可见狗的相对排序。音频分支把每段吠叫映射为指纹并与注册画像做余弦相似度比较,超过阈值则接受匹配否则可新建画像,在DogSpeak上用五个注册吠叫时混合嵌入的已知狗识别准确率为65.36%,高于ResNet-TSP的56.89%。融合在身份层面保留视觉和声音各自选择的画像,一致时互相加强并增量更新均值,不一致时记录冲突而不强制合并,画外判定依赖已有声音画像。该结论只适用于46个视频213个已验证事件等受限评测,遮挡、非正脸、检测重复和混合身份轨迹仍是主要失效来源,重叠吠叫和相似外观声音下也难保证,所有实验在一块NVIDIA RTX PRO 6000 Blackwell GPU上运行,未报告延迟、吞吐或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
64. 用事件瓶颈做场景预测:分层多任务音频表示如何组织事件与场景关系

评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.6/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Claudia Montero-Ramírez:机构信息未能在本次解析中与作者逐人可靠绑定
- Alba Martínez-Serrano:机构信息未能在本次解析中与作者逐人可靠绑定
- Carmen Peláez-Moreno:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
联合声学场景分类与音频标签需要同时回答录音在哪里录制和出现了哪些声音,难点在于事件与场景天然有层次依赖,但常用多头结构让两个预测头平行挂在共享表示上,没有约束事件信息如何进入场景判断。本文把音频先经预训练骨干压缩为25类事件概率,再用单层前馈网络只根据该事件分布预测4类场景,形成X→E→S链路,并与多头基线在相同骨干和损失权重下对比。事件损失用二元交叉熵,场景损失用交叉熵,两者按\(\mathcal{L}=\beta \mathcal{L}_{event}+(1-\beta)\mathcal{L}_{scene}\)加权,\(\beta\)在0.0到1.0间以0.1步长扫描。为解释瓶颈,作者把预测事件按场景累加并归一化为条件分布\(P(e|s)\),再计算条件熵、互信息、KL散度、t-SNE与轮廓系数,并对TF-IDF加权矩阵做形式概念分析。在TUT Sound Events 2016/2017与TUT Acoustic Scenes 2016评估集上,分层PaSST的场景准确率为0.95,高于同骨干多头的0.89,但其他骨干差距很小,作者自己判断总体无显著架构优势。同步双任务学习只在偏向事件损失的\(\beta\)为0.6到0.9时出现,多头则先学会较易的场景任务再优化事件任务,且结论受限于单一固定划分数据集,无法做统计显著性检验。作者还指出分层预测完全依赖声音会丢失整体gist,在更复杂场景库中可能失效,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/kkoutini/PaSST — 链接可访问(HTTP 200)
第三方资源:https://github.com/microsoft/unilm/tree/master/beats — 链接可访问(HTTP 200)
第三方资源:https://github.com/bakhtos/PANNs — 链接可访问(HTTP 200)
第三方资源:https://docs.pytorch.org/docs/stable/generated/torch.nn.BCEWithLogitsLoss.html — 链接可访问(HTTP 200)
第三方资源:https://docs.pytorch.org/docs/stable/generated/torch.nn.CrossEntropyLoss.html — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
65. 文本更新后语音问答接不上的修复:冻结模型上加一块可拆的仿射修正
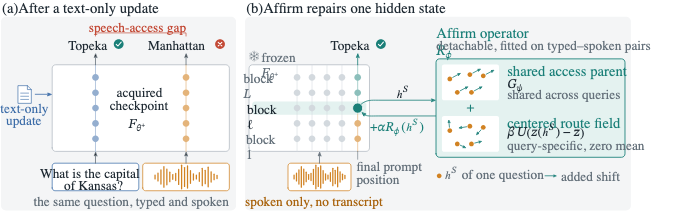
英文题目:Repairing Speech Access After Text Updates with Frozen Affine Fields
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ming-Hao Hsu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxiang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yingda Shen:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhizheng Wu:School of Data Science;The Chinese University of Hong Kong, Shenzhen, China
📌 核心摘要
本文研究文本更新后语音访问修复:检查点只经文本问答获得事实,解码前最终提示位置的隐状态在文本与语音路线下可直接比较,文本答对而配对语音答错即构成待修复差距。修复时已获知识的检查点保持冻结,可拆卸算子只编辑解码器一个隐状态,推理为一次语音前向,不提供转写、配对文本状态或第二遍解码。跨模态界面修复仿射场先经教师强制答案交叉熵学习并冻结共享访问父项,再叠加查询特定路由场,路由坐标来自配对语音与文本隐状态的无答案拟合,阶段B只训练读出矩阵并按金色答案对数概率优势选择教师分布蒸馏。与全局共享转向和低秩表示干预相比,该结构把公共平移与近似正交的小幅查询修正分开,平衡PopQA诊断中共享父项范数为31.48而路由修正均值范数仅8.69。在对256个带文本段落的录制SLUE-SQA-5问题免重拟合迁移评测中,PopQA-20拟合的Affirm-Direct以单次语音前向获得ROUGE-L召回率0.5376,高于配对无修复基线的0.4435。Affirm-Direct训练可训练参数为0.46M,推理只编辑解码器第20块单个隐状态,部署为外部单状态算子,结论限于短答案事实访问和英语语音,录制迁移带有文本段落且任务形式已变。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
66. 跨 18 个月追踪说话与表情的衰减来识别轻度认知障碍

英文题目:CogDrift-4D: Hierarchical Multimodal Modeling of Temporal Behavioral Decay for MCI Detection
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sankalp Vaish:机构信息未能在本次解析中与作者逐人可靠绑定
- Sumukh Veeramalla:机构信息未能在本次解析中与作者逐人可靠绑定
- Rishank Singh:机构信息未能在本次解析中与作者逐人可靠绑定
- Caroline Summerour:机构信息未能在本次解析中与作者逐人可靠绑定
- John A. Batsis:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaohui Liang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
轻度认知障碍筛查需要可在家庭环境重复使用的非侵入工具,难点在于面部动作单元、声学能量和语言表达随时间缓慢变化,且受环境噪声和缺失会话干扰,单次快照难以区分偶发疲劳与持续衰退。论文把与Amazon Alexa的问答、提问和应答三类任务的同步音视频与转写文本对齐为批×会话×时间×特征四维张量,覆盖7次会话共18个月的纵向过程。帧级视频与音频先经会话内注意力编码并计算最小二乘回归斜率以量化急性表达减弱,再由句子嵌入提供语义先验做早期融合,质量门按会话评估各通道可靠性并过滤低质量特征。随后会话描述送入带记忆状态的跨会话反馈编码器累积漂移,同时保留急性斜率和宏观轨迹,这与扁平化平均或仅做单会话对齐的方法不同。在按参与者分组的5折交叉验证中,CogDrift-4D的准确率为0.733±0.13,高于纵向序列基线M-BEHRT的0.6571±0.13;其F1分数为0.716±0.15,也高于M-BEHRT的0.6364±0.17。结论仅适用于MoCA小于26为障碍的二分类和该小规模居家对话场景,跨地域口音与多中心泛化尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
67. 声音里的阻尼结构能教给视觉多少:品质因子的探测与蒸馏

英文题目:How Much Physics Can Vision Learn from Audio? Probing and Distilling Damping Structure
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zainab Afolabi:机构信息未能在本次解析中与作者逐人可靠绑定
- Vadim Selyutin:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhao Gao:机构信息未能在本次解析中与作者逐人可靠绑定
- Babs Khalidson:机构信息未能在本次解析中与作者逐人可靠绑定
- Mohamed Ghoneim:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
敲击声直接编码了视觉难以看到的阻尼信息,论文研究能否把这种结构转入冻结的视觉编码器。输入是敲击视频及其对应声音,输出是用岭回归探测冻结编码器对品质因子Q的排序能力,Q为无量纲量,刻画物体被敲击后完成多少次振荡才衰减下去,难点在于混合样本相关系数易被材料类别身份主导,单帧外观几乎无法区分同类物体的物理差异。做法是先对声音希尔伯特包络拟合衰减模型并结合50Hz以上主共振频率得到Q,只保留拟合优度达标的敲击,再冻结音频教师与CLIP学生、只训练投影头做对称InfoNCE跨模态对齐且训练不使用Q标签,最后在留出视频上拟合岭回归探针评价Spearman排序相关。与已有视听对齐工作不同,该文不评测检索或分类,而是探测连续阻尼及其阻尼分量,并要求在未见材料上成立。在Greatest Hits的留一材料评价下,四帧蒸馏学生达到Spearman相关系数0.338,高于单帧基线的0.234。原文未披露训练、推理或部署成本。结论只适用于有清晰共振模式的敲击样本,对摩擦等声音编码较弱的属性尚未验证,且筛选后仅保留约63%敲击,颗粒散射表面保留率更低。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
68. 在家里和音箱说话就能辅助筛查轻度认知障碍吗

英文题目:Task-Centric Multimodal Learning for Cognitive Impairment Detection
评分:5.4/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.9/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:后 50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Sankalp Vaish:机构信息未能在本次解析中与作者逐人可靠绑定
- Rishank Singh:机构信息未能在本次解析中与作者逐人可靠绑定
- Sumukh Veeramalla:机构信息未能在本次解析中与作者逐人可靠绑定
- Caroline Summerour:机构信息未能在本次解析中与作者逐人可靠绑定
- John A. Batsis:机构信息未能在本次解析中与作者逐人可靠绑定
- Xiaohui Liang:机构信息未能在本次解析中与作者逐人可靠绑定
📌 核心摘要
这篇论文要解决的是在家庭等非临床环境下,如何通过与智能音箱的自然对话及早发现轻度认知障碍(Mild Cognitive Impairment,MCI),输入是同步采集的视频、参与人语音和自动转写文本,输出是被试属于MCI还是认知健康。难点在于单一通道信号随任务变化大且个体差异明显,论文为此设置指令朗读、指令生成和问答三种任务,分别考察跟读复述、语言生成与理解记忆。方法先用统一预处理从三路信号提取行为特征,视频路得到帧级情绪概率和面部动作单元,音频路得到声学与韵律生物标志物,文本路得到语言学特征和句嵌入降维结果。再把每路特征送入带多头自注意力(multi-head self-attention)的变换器编码器(Transformer encoder)建模时间变化,最后比较单模态与三模态融合在三种任务上的表现。在35名老年人的7轮会话数据上,三模态模型在指令朗读任务达到准确率0.76,曲线下面积(Area Under Curve,AUC)为0.75,高于同期视频单模态在该任务的准确率0.65、AUC为0.69。同一数据上三模态模型在问答任务达到准确率0.76、AUC为0.73,其中准确率高于音频单模态在该任务的准确率0.67。该结论只适用于这批被试和三种设计的Alexa任务组合,尚未在其他人群、设备或长期追踪中验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
69. 孟加拉语语音如何同时做痴呆筛查与说话补全
评分:5.4/10 | 创新 1/2 | 技术严谨 0.9/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:后 50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Md Asif Akram:机构信息未能从 arXiv PDF 文本可靠映射
- Arif Faisal:机构信息未能从 arXiv PDF 文本可靠映射
- Sakir Hossain Faruque:机构信息未能从 arXiv PDF 文本可靠映射
- Sharun Akter Khushbu:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
痴呆患者常出现停顿增多、找词困难和句子中断,家人难以理解其日常需求,孟加拉语又缺少相应的语音数据和辅助工具。论文输入是围绕食物、衣着、住所、教育、医疗等日常需求朗读的WAV录音,输出包括痴呆与非痴呆二分类标签,以及给定不完整前缀后补出的后续孟加拉语句子。录音先做带通滤波、谱减法降噪、噪声门控、下采样、幅度归一化和自适应平滑,再提取梅尔频率倒谱系数(Mel-Frequency Cepstral Coefficients,MFCC)、谱带宽、谱质心(spectral centroid,指频谱能量重心)、过零率(Zero-Crossing Rate,ZCR,指单位时间信号穿过零线次数)、色度(Chroma,指映射到12音级的谐波内容)、抖动(jitter,指基频逐周期变化)、均方根能量(Root Mean Square energy,RMS energy,指短时强度)等声学特征供分类;同一录音经微调的Whisper模型转写为文字并经清洗和词频统计进入文本分类;补全分支把日常句子切成由短到长的N元片段,用前面词预测下一个词,逐词迭代直到输出结束符。在740例语音按8:2划分训练与测试的测试集上,语音长短期记忆网络(Long Short-Term Memory,LSTM)分类准确率97.30%,高于随机森林和梯度提升的96.62%及逻辑回归的89.86%。在转写文本按同样8:2划分的测试集上,文本分支逻辑回归分类准确率83.7%高于长短期记忆网络的82.4%。补全分支在测试集上测试准确率59.74%,测试困惑度6.52。结论只适用于朗读式受控句子和本数据集,未在自发对话上验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://www.alzint.org/about/dementia-facts-figures/dementia-statistics/ — 链接可访问(HTTP 200)
第三方资源:https://www.health.harvard.edu/mind-and-mood/6-myths-about-dementia — 链接可访问(HTTP 200)
第三方资源:https://www.tbsnews.net/bangladesh/health/1-12-bangladeshi-elderly-have-dementia-survey-268675 — 链接可访问(HTTP 200)
第三方资源:https://www.thedailystar.net/opinion/views/news/bangladesh-needs-do-better-its-elderly-3470111 — 链接可访问(HTTP 200)
第三方资源:https://asia.tghn.org/workshops/dementia-bangladesh/ — 链接可访问(HTTP 200)
第三方资源:https://www.who.int/news/item/07-12-2017-dementia-number-of-people-affected-to-triple-in-next-30-years — 链接可访问(HTTP 200)
第三方资源:https://www.worldlifeexpectancy.com/united-states-alzheimers-dementia — 暂时无法访问
第三方资源:https://www.worldlifeexpectancy.com/bangladesh-alzheimers-dementia — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。