📄 文本更新后语音问答接不上的修复:冻结模型上加一块可拆的仿射修正
英文题目:Repairing Speech Access After Text Updates with Frozen Affine Fields
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
👥 作者与机构
- Ming-Hao Hsu:机构信息未能在本次解析中与作者逐人可靠绑定
- Yuxiang Wang:机构信息未能在本次解析中与作者逐人可靠绑定
- Yingda Shen:机构信息未能在本次解析中与作者逐人可靠绑定
- Zhizheng Wu:School of Data Science;The Chinese University of Hong Kong, Shenzhen, China
📌 核心摘要
本文研究文本更新后语音访问修复:检查点只经文本问答获得事实,解码前最终提示位置的隐状态在文本与语音路线下可直接比较,文本答对而配对语音答错即构成待修复差距。修复时已获知识的检查点保持冻结,可拆卸算子只编辑解码器一个隐状态,推理为一次语音前向,不提供转写、配对文本状态或第二遍解码。跨模态界面修复仿射场先经教师强制答案交叉熵学习并冻结共享访问父项,再叠加查询特定路由场,路由坐标来自配对语音与文本隐状态的无答案拟合,阶段B只训练读出矩阵并按金色答案对数概率优势选择教师分布蒸馏。与全局共享转向和低秩表示干预相比,该结构把公共平移与近似正交的小幅查询修正分开,平衡PopQA诊断中共享父项范数为31.48而路由修正均值范数仅8.69。在对256个带文本段落的录制SLUE-SQA-5问题免重拟合迁移评测中,PopQA-20拟合的Affirm-Direct以单次语音前向获得ROUGE-L召回率0.5376,高于配对无修复基线的0.4435。Affirm-Direct训练可训练参数为0.46M,推理只编辑解码器第20块单个隐状态,部署为外部单状态算子,结论限于短答案事实访问和英语语音,录制迁移带有文本段落且任务形式已变。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
语音模型为什么主要靠文本来更新知识
现在能听会说的语言模型,大多是在已经用大量文本训练好的解码器上,再接上音频编码器和对齐模块。网页、文档、代码和手册这类文本材料规模远大于配对语音监督,所以日常的事实维护和针对性修改往往直接走文本。例如用文本问答对做 1 次微调,模型就能记住新的首都、人物或虚构作者信息。研究生刚接触这个领域时容易以为,既然模型能听懂语音,文本学会的东西自然能被语音问出来。论文的起点就是这个直觉并不可靠。
作者把语音理解为一种接入界面,把文本更新理解为知识入库,入库成功不等于界面自动可用。当用户继续用语音提问时,同一事实可能在打字时能答对,在说话时却答错。理解这种分工,才能明白后面为什么要冻结知识部分、单独修语音接入部分,而不是把整个模型再训练一遍。论文用的主干是 Qwen2.5-Omni-7B,文本更新时是全参数微调 10 轮,之后检查点冻结,修复阶段不再改动任何原模型权重。这种先入库后修界面的顺序,是全文实验组织的主线。
已有路线在改什么,和本文修的位置有何不同
与语音文本差异相关的已有工作大致分 3 类。第一类在多模态适配阶段就让语音模仿文本,例如行为对齐和跨模态蒸馏,它解决的是训练初期语音能力弱的问题,而不是更新后新知识的可用性问题。第二类是知识编辑,直接改模型里存的关联,目标是让模型换一个答案;本文则假设文本更新已经让模型存对了,问题只出在语音这条路上答不出来。
第 3 类是冻结表示干预,例如在残差流或注意力头上加方向向量,低秩表示微调中的 DiReFT 和 LoReFT、学习共享加性方向的 SALSA、按输入预测干预的 L2S 都属于这一家族。它们都不区分先用文本入库、再修语音接入的两个阶段。本文的 Affirm 可以看作把这类干预搬到更新后修复场景,并用成对的语音与文本隐状态来提供按问题调整的坐标。比较时必须注意输入和运行条件是否相同:能否看到文本问题、能否做第二次模型前向、是否允许改检查点,这些条件不同就不能直接比高低。
论文因此把语音 LoRA、语音到文本蒸馏、转写级联和全语音监督单独列为放宽契约的对照,把需要配对文本状态的 Angle 和 Length 列为捐助对照。
文本学会后语音问不出来,具体怎么定义和测量
论文把每个事实配成语义相同的文本问题和语音问题,记作文本查询和语音查询。取同一已获知识检查点在解码器某一层的最终提示位置隐状态,文本和语音各有一个向量,因为来自同一检查点且问题配对,所以可以直接比较。接入分数定义为在某个集合上模型生成与参考答案匹配程度的平均值,文本接入减去语音接入就是从文本到语音的缺口。如果缺口为正,说明检查点能用文本表达更新后的事实,但用配对语音界面时不可靠。
举例来说,问堪萨斯州首府,打字问得到托皮卡,同样内容用语音问却得到曼哈顿,这就是一个具体的接入缺口样本。论文还规定了严格的修复契约:已获知识检查点不可变,修复算子可拆,部署时只有语音没有转写文本,也没有配对文本状态、检索示例和第二次前向。文本成功只用来证明知识已经入库,配对差距用来诊断,留出语音的提升才算修复。
已获知识检查点 × 可拆修复算子: 已获知识检查点指经过纯文本问答微调并被冻结的参数,它负责记住更新后的事实;可拆修复算子指训练后外挂的修正模块,它只改语音输入对应的一个隐状态而不改检查点。二者搭配把知识归属和语音可用性分开,检查点不变保证文本能力不被破坏,算子可拆保证部署时可以加装或移除。
Affirm 的整体流程:先学共性修正,再加个性微调
Affirm 的输入是语音问题的隐状态,输出是加了修正后的隐状态,再送入冻结的解码器继续生成。整个过程只发生在预填充阶段的最终提示位置,生成答案词时不再逐词干预。训练分两段:先学习并冻结一个跨查询共享的基础修正,称为共享接入父项;再在父项冻结的条件下学习一个随问题变化的修正,称为居中路由场,它在算子训练问题上的平均值为零。推理时把两者相加并乘上强度系数,加到原始语音隐状态上。
成对语音与文本状态的作用是提供坐标,让模型知道当前问题在语音文本差异空间中的位置。下面这张图把知识入库与语音修复画成左右两部分,左为缺口,右为 1 次单状态修复,值得对照着看。
看图路径: 1. 先看左图同一问题打字与说话的两条纵向路径,确认文本答对而语音答错的缺口含义;2. 再看右图语音隐状态如何加上共享父项与居中路由场后进入冻结解码器;3. 注意右下角标注的单问题位移,理解一次前向只改最终提示位置的一个状态
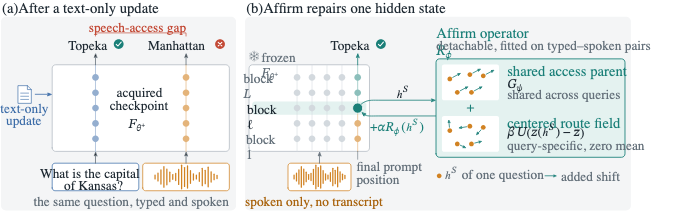
论文图 1。原论文 Figure 1::“Decoupled knowledge acquisition and speech access repair.”。
从像素上看,左图两列圆点分别代表文本路径和语音路径经过已获知识检查点的状态,顶部对错标记点出同一答案的不同结果;右图中间绿色箭头标出被编辑的语音状态,右侧方框内上半为跨查询共享的父项、下半为按问题分散的路由场,两者相加构成最终位移。部署时不需要转写文本,也不需要配对文本状态,算子存下来即可外挂使用。论文强调该算子只改解码器一个块的一个位置,1 次前向完成,不依赖外部语音识别系统,也不依赖更新前的检查点。
共享接入父项有哪几种写法,各自管什么
共享接入父项记作对隐状态的函数,论文试验了 3 种参数化。直接父项就是一个所有查询共用的向量,与输入无关,相当于全局平移。专家父项是用路由器对多个学到的方向做加权平均再乘一个尺度,形式上更灵活,但在平衡 PopQA 诊断上权重几乎集中在同一个专家上,实际效果接近常数修正。紧凑父项是单方向乘标量的形式,用于研究深度和跨模型移植。所有父项都经过冻结解码器的答案监督来训练,提示词部分被掩掉,只有父项参数接收梯度,训练完即冻结。
理解时可以把父项想象成先把整体偏掉的语音状态云搬回文本状态云附近,它不区分具体是哪个问题。主要变体 Affirm-Direct 采用直接父项,专家变体采用 64 个专家的加权形式,紧凑变体采用单方向形式以便在不同骨干上校准。
共享接入父项 × 居中路由场: 共享接入父项是对所有语音查询共用的基础平移,用于把整体偏离的语音隐状态拉回接近文本的状态区域;居中路由场是随每个问题变化的小幅修正,用于处理不同问题残留的差异,它在算子训练集上均值为零所以只表示围绕父项的波动。两者相加构成完整的仿射场,既有共性修正又有个性微调。
配对坐标和居中路由场如何实现按问题调整
为了让修正能随问题变化,论文先用无答案标签的配对状态拟合一个低维坐标映射。具体做法是把语音隐状态中心化并除以均方根尺度,再经矩阵映射和激活函数得到低维编码,同时用临时读出矩阵去预测中心化后的文本减语音状态差,优化均方误差。这个过程只用提示状态对,不用答案。拟合完后冻结坐标映射,丢掉临时读出,留下坐标作为每个问题的路由位置。正式的路由场是读出矩阵乘以坐标减去训练集平均坐标,再乘上路由强度系数。
因为减去了平均值,它在训练集上的均值为零,只表达围绕父项的波动。部署前论文报告直接父项向量范数约为 31.48,每个问题的路由场修正平均范数约为 8.69,两者平均余弦约为 0.0104,几何上是一个主导的共享平移加一个较小且近乎正交的个性化细调。
配对路由坐标 × 读出矩阵: 配对路由坐标是把语音隐状态经低秩映射和非线性得到的低维编码,它在拟合时被要求能预测成对文本与语音状态之差;读出矩阵是把该坐标映射回解码器隐状态维度的线性变换,它在第二阶段才为答题效果而训练。坐标提供按问题区分方向的信息,读出矩阵决定把这些信息转成多大强度的状态修正。
两阶段如何训练,监督信号从哪里来
第一阶段训练父项,目标是经过冻结解码器的教师强制答案交叉熵。符号上对每个问题的每个答案位置,取加了父项后解码器的答案分布在正确词上的对数概率做平均负值,提示词不计入损失。优化只更新父项,检查点、坐标映射都不动。
\[\mathcal{L}_{A}(\psi)=-\frac{1}{N}\sum_{i}\frac{1}{T_{i}}\sum_{t=1}^{T_{i}}\log p_{i,t}^{G}(y_{i,t}),\]上式中分子是对答案长度的平均,分母是对问题数的平均,目标是让加了父项的语音路径更可能生成正确答案。第二阶段冻结检查点、坐标映射和已选父项,把读出矩阵初始化为零后只训练它。此时第 1 次前向恰好复现只有父项的预测,之后通过冻结解码器反向传播只更新读出矩阵。对每个拟合样本,比较文本路径与只有父项的语音路径在正确答案上的平均对数概率,若文本超出阈值则用文本的截断分布做教师,否则用父项自身的分布做保持目标,阈值原文为 0.1 奈特。优化目标是教师分布与完整场语音分布之间的 KL 散度,教师一侧停止梯度。
\[U^{*}=\arg\min_{U}\sum_{i}\frac{1}{NT_{i}}\sum_{t=1}^{T_{i}}D_{\mathrm{KL}}\bigl(\operatorname{sg}(\pi_{i,t}^{*})\,\|\,p_{i,t}^{U}\bigr),\]这种选择性蒸馏的意图是文本明显更好时纠正,语音已可用时保持。推理时路由场以单位输出尺度训练、部署时固定系数为 0.25,整体强度系数在开发集上选定后测试前固定。
文本教师 × 父项教师: 文本教师指用文本路径输出的答案分布做监督信号,当文本路径对正确答案的平均对数概率明显高于只加父项的语音路径时启用;父项教师指用只加父项的语音路径自身分布做保持目标,当文本没有明显优势时启用。前者负责在文本更可靠时纠正语音,后者负责在语音已经可用时避免把分布推坏。
数据划分和语音条件是如何安排的
主要实验用 Qwen2.5-Omni-7B。全文规模下分别在 14267 条 PopQA 事实和 4000 条 TOFU 虚构作者问答上做纯文本问答微调,得到各自的已获知识检查点并冻结,之后再拟合修复算子。另在 Kimi-Audio 和 MiMo-Audio 上做紧凑算子的跨模型考察。PopQA 在划分前先按共享主题或归一化问题字符串连成组,保证同一组不跨算子训练、开发和测试集;TOFU 按作者分组,保证作者不重叠。
合成语音用固定单女性英语声音的 CosyVoice 渲染,同一条目缓存同一波形以保证方法间可比。迁移评测用 256 条真人录制的 SLUE 问题,来自 50 个说话人,每个输入含文本段落加语音问题,因此语音仅指问题模态。SLUE 上不做任何拟合和强度重调,直接搬运 PopQA-20 上拟合好的算子。
下面这张表说明各设置的采集规模与算子训练、开发、测试划分,理解结果时需先确认比较的是哪一行。
| Setting | Acquisition | Operator train | Development | Test |
|---|---|---|---|---|
| Balanced PopQA | 1,000 | 600 | 199 | 201 |
| PopQA-20 | 14,267 | 2,853 | 2,848 | 2,847 |
| PopQA-60 | 14,267 | 8,560 | 2,848 | 2,847 |
| TOFU | 4,000 | 2,400 | 800 | 800 |
| SLUE-SQA-5 transfer | – | 0 | 0 | 256 |
从表中可见平衡 PopQA、PopQA-20、PopQA-60 和 TOFU 的采集与划分数量不同,SLUE 行算子训练和开发均为零而测试为 256,这对应无重拟合迁移的含义。所有语音方法在推理时都只给音频,不给转写文本或配对文本状态,且只做 1 次冻结检查点前向。评估用 ROUGE-L 召回、归一化精确匹配和 SLUE 答案片段准确率,方向都是越高越好,不确定度用按组自助法报告配对差异的标准误。
基线和 Affirm 变体在相同契约下比什么
在冻结单状态契约下比较的语音方法包括不加干预、学习低秩隐状态干预的 DiReFT 和 LoReFT、按上下文预测干预的 L2S、学习单个共享转向向量的 SALSA。放宽契约的对照单独报告,包括语音 LoRA、语音到文本蒸馏、转写后再答的级联和全语音监督,因为它们允许改参数或增加语音识别前向。另有需要配对文本问题做推理时捐助的 Angle 和 Length 对照,它们在推理时能看到文本问题状态,因此不属于语音单次前向。Affirm 变体按父项区分:直接父项加居中路由场为主要变体,专家父项加路由场为另一变体,紧凑单方向父项用于深度和跨模型分析。隐宽度为 3584,低秩统一为 64,开发集上选块位置并校准编辑范数后再测。
下面这张表列出配对几何与各 Affirm 变体 2 阶段的可训练对象和优化设置,可用来核对训练条件是否一致。
| Stage or method | Trainable object | Epochs | Learning rate | Seed |
|---|---|---|---|---|
| Paired geometry | DD and temporary readout | 1,000 steps | 0.001 | 5907 |
| Affirm-Direct Stage A | Shared vector gg | 3 | 0.01 | 8307 |
| Affirm-Direct Stage B | Local readout UU | 1 | 0.0001 | 6007 |
| Affirm-Expert Stage A | Router, 64 experts, and scale | 3 | 0.001/0.01/0.0001 | 8307 |
| Affirm-Expert Stage B | Local readout UU | 1 | 0.0001 | 6007 |
| Affirm-K1 Stage A | Direction ee and scalar ss | 3 | 0.01/0.0001 | 8307 |
| Affirm-K1 Stage B | Local readout UU | 1 | 0.0001 | 6007 |
表中配对几何拟合低秩坐标映射,直接变体阶段 A 训练共享向量,阶段 B 训练读出矩阵,专家与紧凑变体的路由器、尺度和方向设置各不相同。阅读主结果时应记住,只有同属冻结单状态且无文本捐助的行才能直接比,跨契约的更高分数不代表同条件更优。基线拟合也使用各自的开发集选择剂量,SLUE 上直接沿用源域剂量而不重调。
文本更新后缺口有多大,合成语音上谁更好
先看缺口是否存在。在全量 PopQA 配对问题上,已获知识检查点经文本可达较高的 ROUGE-L 和精确匹配,经语音则大幅下降,差距很大。语音状态并非完全丢失问题信息:在配对状态上去掉各模态均值后,语音到文本的最近邻检索首位准确率远高于随机水平,说明生成差距不能简单归因于问题身份完全丢失。下面这张大表是核心结果,覆盖平衡合成语音、作者不重叠 TOFU 和无重拟合录音迁移三块,需结合基线是否可运行来读。
该表比较同一冻结检查点下各语音单次前向方法的修复效果,指标方向均为越高越好,平衡 PopQA 与 TOFU 为源内修复,SLUE 为跨任务跨声学的无重拟合迁移。
| Balanced PopQA | Balanced PopQA | TOFU | TOFU | SLUE no-refit | SLUE no-refit | SLUE no-refit | |
|---|---|---|---|---|---|---|---|
| Method | RL | EM | RL | EM | Span | RL | EM |
| No Repair | 0.2736 | 0.2189 | 0.5003 | 0.1000 | 0.4063 | 0.4435 | 0.2344 |
| DiReFT (Wu et al., 2024) | 0.5945 | 0.5821 | 0.5117 | 0.1075 | 0.4609 | 0.4981 | 0.2734 |
| LoReFT (Wu et al., 2024) | 0.5995 | 0.5920 | 0.5179 | 0.1138 | 0.4766 | 0.5209 | 0.3047 |
| L2S (Parekh et al., 2025) | 0.5361 | 0.5274 | 0.5107 | 0.1000 | 0.3906 | 0.4261 | 0.2656 |
| SALSA (Yegorova et al., 2026) | 0.6119 | 0.6020 | 0.5237 | 0.1150 | 0.3203 | 0.3730 | 0.2656 |
| Affirm-Direct | 0.6318 | 0.6219 | 0.5310 | 0.1200 | 0.4922 | 0.5376 | 0.3008 |
表中最值得注意的是两点分化。在平衡合成语音上 Affirm-Direct 数值最高,但与 DiReFT、LoReFT 或 SALSA 的配对自助比较并未确立对 Affirm 有利的优势,原文明确说不能据此宣称 Affirm 更强。在录制 SLUE 上,用 PopQA-20 拟合的完整算子直接迁移时,Affirm-Direct 比其配对无修复基线提高 0.0941 的 ROUGE-L,LoReFT 也正向提升,而匹配的 SALSA 变体反而低于其配对基线 0.0707。TOFU 上 Affirm-Direct 在语音单次前向行中点估计最好,但提升幅度小。还需要留意无修复基线因与各自方法同批生成而略有不同,配对提升必须用各自同批基线计算,不能跨行借用。
源内修复 × 无重拟合迁移: 源内修复指在与算子拟合同分布的合成语音问答上评测,问题类型和语音风格基本不变;无重拟合迁移指把在 PopQA 上拟合好的算子直接搬到录制的 SLUE 问题上,不用目标数据重训也不重调强度,同时任务变为看段落回答录音问题。区分二者的意义是前者检验修正是否学会,后者检验修正是否经得起说话人、声学、提示和任务同时变化。
父项写法和跨模型表现带来什么附加信息
在块 4 的匹配比较中,含居中路由场的完整算子在 TOFU 上专家父项更高,在 SLUE 上直接父项的点估计更高,两种完整算子的排序在源内与迁移之间并不一致。紧凑单方向父项在 TOFU 两粒种子的深度扫描中都选块 4,从浅层到深层平均完整场 ROUGE-L 下降,路由场在各块各种子上对 ROUGE-L 的改变很小且符号不稳定,深度趋势主要来自父项。跨模型方面,紧凑变体在另行采集的 Kimi-Audio 检查点上留出测试集取得提升,支持紧凑形式在第二种骨干上的可移植性;MiMo-Audio 则为混合结果,精确匹配小幅上升而 ROUGE-L 略降。
主要 Qwen 直接算子存 0.46M 个学习值,只改一个状态且单次语音前向。与放宽契约的语音 LoRA、蒸馏、转写级联和全语音监督相比,可拆单状态算子的绝对精度更低,说明更强的适配和额外推理资源在允许时能达到更高准确率,这也界定了本文契约的代价。论文还报告三粒 Stage-B 种子在开发集上结果稳定,说明优化本身不是主要波动来源。
父项和路由场各自贡献多少,合起来是否必要
消融在相同冻结单状态契约下拆开两部分,开发集匹配编辑范数后在锁定测试集上比较。PopQA-20、PopQA-60 和 TOFU 3 组都显示任一部分单独加都能恢复不少接入,两者组合的 Affirm-Direct 在 ROUGE-L 上最强。在两个 PopQA 预算上,把路由场加到共享父项之上能提高 ROUGE-L 和精确匹配,把共享父项加到路由场之上也能提高 ROUGE-L;在 TOFU 上对应差异的配对自助分析则未能确立差异。几何上共享父项占主导,路由场是小幅近正交细调。下面这张表给出 3 组预算下的具体数值,阅读时注意它与主表是同一批实验的不同切面。
该表固定编辑块为 20 并匹配开发集编辑范数,比较只加直接父项、只加路由场与两者组合,指标越高表示对已入库事实的语音接入越好。
| PopQA-20 | PopQA-20 | PopQA-60 | PopQA-60 | TOFU | TOFU | |
|---|---|---|---|---|---|---|
| Method | RL | EM | RL | EM | RL | EM |
| No Repair | 0.1787 | 0.1500 | 0.1787 | 0.1500 | 0.5003 | 0.1000 |
| + Direct Parent | 0.3156 | 0.2986 | 0.3269 | 0.3087 | 0.5252 | 0.1138 |
| + Route Field | 0.3212 | 0.3038 | 0.3379 | 0.3203 | 0.5265 | 0.1213 |
| Affirm-Direct | 0.3353 | 0.3137 | 0.3493 | 0.3270 | 0.5310 | 0.1200 |
从数字看 PopQA-20 和 PopQA-60 上无修复基线相同,只加父项和只加路由场都明显高于基线,组合后进一步提高;TOFU 基线较高而提升较小。限制是该消融只在块 20 下成立,块 4 的专家比较另见正文;迁移到 SLUE 的完整算子结果针对完整拟合算子,不能据此孤立出居中路由场的贡献。未胜出项也很明确:TOFU 上部件差异未被确立,紧凑变体中路由场对深度选择几乎无影响。
这些结论在什么条件下才成立,有哪些边界
论文自己划定的边界需要逐条记住。研究的是短答案事实接入,主要在 Qwen2.5-Omni-7B 上,PopQA 和 TOFU 评测的是已纳入文本采集的事实在不同组之间的修复泛化,而不是对未见知识的采集。配对文本语音生成差距是操作性定义,能诊断不可用,但不能定位全部声学或内部原因。PopQA 和 TOFU 用单一固定声音的合成英语语音,录制 SLUE 虽引入真人语音,却同时改变任务、提示、说话人和声学,还提供文本段落,因此是行为迁移而非对新事实的闭卷回忆。
迁移结论针对完整拟合算子,不能分离出居中路由场的独立贡献。Kimi-Audio 是锁定测试的紧凑实现评估,MiMo-Audio 为混合开发结果。单状态干预限制了适配容量,放宽契约的更广泛语音微调或转写级联可以更高。长文本生成、多语言、反复更新和架构相关扩展仍是未来方向。伦理上聚合指标提升不等于关键应用可靠,干预可能改错原本正确的答案,语言口音和人群覆盖也不完整,使用模型与语音数据仍受各自许可约束。
要复现第一步做什么,需要哪些关键设置
复现应从文本入库开始,而不是直接训算子。先在对应文本问答语料上全参数微调得到已获知识检查点,原文 Qwen 设置是 10 轮、批量为一并 4 步累积、最大长度 500、学习率较小并带预热和梯度裁剪,之后冻结检查点。接着缓存配对语音与文本在目标块的最终提示位置隐状态,合成语音用同一固定声音和同一缓存波形以保证可比。
然后按 2 阶段拟合算子:配对几何拟合低秩坐标映射,阶段 A 用答案交叉熵训练父项,阶段 B 冻结父项和坐标映射并零初始化读出矩阵,用选择性教师做 KL 训练。强度系数需在开发集上选定并在测试前固定,不同范数保持向量与仿射场的原始系数不可直接比,应比较实际平均编辑范数。解码用贪心搜索,PopQA 和 TOFU 生成长度上限大于 SLUE。按原文,本篇没有提供可验证的作者代码与模型资源信息,因此只能按论文文字和超参数重写流程,不能声称代码已公开或权重可下载。
附录还给出基线剂量选择、编辑范数校准和按说话人或作者分组的自助标准误做法,复现统计比较时应沿用同一分组方式。
什么时候值得尝试,还缺哪项验证
当系统必须保留文本更新后的检查点不变,又要求语音单次前向可用,且部署时没有转写文本和配对文本状态时,这种可拆单状态修复值得尝试。它适合已入库事实在新问法或新语音条件下的接入补救,不适合要学习全新知识或要大幅提升绝对精度并允许改模型的场景。复现第一步是先做出可验证的文本语音配对缺口,再在开发集上选块和强度并固定,最后看留出语音测试的配对提升。
还需要补的验证包括多声音多口音合成语音、更多真人录音的闭卷回忆、跨语言与长答案生成,以及多次文本更新后修复是否稳定。容易产生的误解是把合成语音上的最高点估计当成已证明更强,或把 SLUE 迁移提升当成路由场单独的功劳,原文都明确否定了这两种读法。
正确的总结是文本入库与语音接入可能分叉,应当分别验证和修复,而 Affirm 提供了一种在冻结约束下可行的外挂修法,其优势只在无重拟合的录音迁移条件下显现,且以单状态容量和绝对精度为代价。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses