📄 冻结音频编解码器的量化器冗余与索引精确重编码
英文题目:Quantizer Redundancy and Exact Index Recoding in a Frozen Neural Audio Codec
评分:5.7/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Youssef Hemimy:St. Thomas University, Miami Gardens, Florida, USA
📌 核心摘要
冻结编解码器把单声道音频送入低频和高频两条编码路径,分别编码后按组用多级残差标量量化产生整数索引,解码端查表求和后经神经解码器重建波形,难点是后级重复使用同一无缩放网格时索引高度相关,而浮点执行又不完全等于理想实数递推。方法先分析理想递推的奇偶行为,奇数基网格后级为零,偶数基网格在两个中心值之间交替,由此构造只存首索引加分支位的预测元组。再对每个标量位置逐项比对预测与真实索引,不符者存完整原始元组,使精确恢复不依赖理想恒等式。最后在预测载荷外分别尝试通用压缩与一阶和二阶自适应算术编码并按文件选最短者,权重与重建图保持冻结。在512文件集合上,与原始索引的XZ对照相比,以含全部头开销的测量码率为指标,最终三模式选择器为129.591 kbps,低于对照,以聚合字节为指标减少25.943%,且保持解码器输入逐比特一致。在62文件集合上,与原始索引的XZ对照相比,以含全部头开销的测量码率为指标,最终选择器为142.696 kbps,低于对照,以聚合字节为指标减少26.296%。结论只适用于该冻结实现和声明的CPU float32执行,集合复用、训练内容溯源不完整和完整三路编码代价未实测限制了外推,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
这篇论文要解决什么存储问题
输入是已经训练好且不再改动的神经音频编解码器产生的多阶段标量量化索引,目标是在不改变解码器输入的前提下减少保存这些索引所需的字节数。必须保留的信息包括全部原始阶段索引和解码所需的元数据,例如采样数、采样率、两条路径的帧数、量化器配置与检查点标识,输出是一个能完整还原这些内容的压缩文件。论文强调这里的无损只是指保留已有模型的重建结果,而不是把有损模型变成对原始音频无损,因为编码器本身已经丢弃信息。
读者需要先理解这种区分,否则容易把后文码率下降误读为音质提升。论文把权重、保存网格与重建计算图全部冻结,只改索引的存放方式,这是全文所有结论成立的大前提。
已有路线与本文的边界在哪里
论文把自身放在编码器量化器解码器结构、离散码的熵编码、有限标量量化等路线中讨论,指出对相关编解码器索引做压缩是已有做法,本文没有训练新的熵模型,只用固定通用压缩器对照和经典自适应概率模型。作者还说明所分析的是特定重复无缩放网格,其最近网格规则与原始有限标量量化的移位有界舍入构造不同,也不覆盖缩放残差或学习残差向量量化。
文献回顾还提到 2026 年几篇关于冻结变换条件熵编码、固定音频索引重编码的预印本,仅用于承认时间上的相关想法,不作为本文技术结论的证据,也不做优先权主张。初学者应注意这种写法意味着不能把本文方法直接推广到其他量化器,必须回到各自的量化规则重新分析。
重复网格为什么会产生可预测索引
被测系统对 44.1 千赫单声道音频做中心汉宁窗短时傅里叶变换,窗长 2048、跳长 512,在频点 185 附近约 3.984 千赫处分成低频与高频两路。低频编码器时间跳长 512 样本,高频为 128 样本,两路各输出 128 通道隐变量并经学习尺度的双曲正切限幅到区间内。每组 32 个标量通道共享相同的阶段网格,低频每位置 4 个阶段,各组字母表大小为 8、5、5、4,高频每位置 6 个阶段,大小为 8、8、5、5。由于各级网格相同且不随深度缩小,首级量化后的残差已被限制在半间隔内,后续可选值很少,这是冗余的来源。
残差标量量化 × 重复无缩放网格: 残差标量量化指对输入逐级量化并把残差传给下一级,每级输出一个索引;重复无缩放网格指每一级复用同一套均匀网格且不缩小间隔。二者搭配时,后级面对的残差已被限制在很小区间,可选动作只剩中央几个网格点,从而产生高度可预测的索引序列,这正是本文预测器的依据。
冻结系统与三路存储的总流程是什么
总流程是先用冻结编码器和量化器得到原始阶段索引元组,再用预测器生成预测元组并逐索引比较,正常位置存精简记录,失配位置存完整例外,然后分别生成预测加 zlib、1 阶自适应、2 阶自适应 3 种载荷并选最短者,加上 10 字节选择头写成最终文件。读取时只解码被选中的载荷,恢复原始索引与元数据,再按原有保存网格查表并按阶段顺序求和,送入冻结的低频与高频解码器做频带重组。图 1 把会改变的部分标为灰框,网格与神经参数保持不变,独立读取器负责验证索引与元数据还原,而隐变量与波形的比特比较属于原始中央处理器运行的证据。
名义码率核算 × 实测完整文件码率: 名义码率核算是按每索引 log2 q 比特的理想宽度算出的理论比特数,不含帧取整、包头与压缩;实测完整文件码率是把实际写出的全部字节除以保留时长,包含包头、填充与压缩器封装。前者用于说明原始表示并不紧凑,后者才是可比较的存储结果,二者不能直接相减或互相替代。
下面这张系统框图先帮助建立输入到输出的主线,再理解哪些环节被改动、哪些环节被冻结。图中从上到下依次是分频、两路编码、索引预测与例外、3 种编码选最短、读取恢复、查表求和与冻结解码,灰框只改变索引存放。
看图路径: 1. 先沿顶部单声道输入经短时傅里叶分频到低频与高频编码器的主路径看下去;2. 再看中间灰框预测、比较、编码与选择三路取最短的位置;3. 最后看底部保存网格查表加和与冻结解码器保持不变的环节
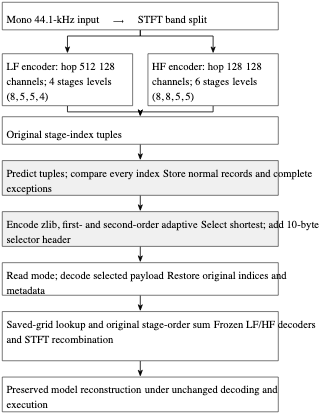
论文图 1。原论文 Figure 1::“Frozen reconstruction system with the final three-mode storage path.”。
从图中可见改动集中在索引表示与压缩选择两段,解码端的查表顺序、求和顺序与神经解码操作都没有变化。这解释了为什么只要整数索引与元数据完全恢复,在相同执行条件下就能保留已有重建,而不需要重新训练或调整解码器。图中也不包含源音频或数据集图像,说明它只讲存放路径,不评价音质本身。
理想实数递推如何决定阶段奇偶行为
对字母表大小为 q 的组,理想网格为从负 1 到正 1 的均匀端点包含网格,最近邻规则在精确平局时选较小索引。从有界标量出发,每级取量化值并用残差减去该值,解码端把各级贡献相加。由于没有随深度缩小网格尺度,首级之后的残差落入半间隔内。若 q 为奇数,零本身是网格点,后续贡献全部为零;若 q 为偶数,两个中央点为负 h 与正 h,减去所选中央值会改变残差的符号区间,下 1 级必选相反符号,再下 1 级又回到前值,因此累加输出在两个值之间交替。论文用 z 等于 0.2、四电平网格的例子展示累加在三分之一与零之间交替,第二级甚至增大了标量绝对误差,这只是理想算术示例。
\[r_{0}=z,\qquad v_{\ell}=Q_{q}(r_{\ell-1}),\qquad r_{\ell}=r_{\ell-1}-v_{\ell}.\]上式给出残差递推的符号与输入,起点是有界标量,v 为所选网格值,r 为剩余残差。它说明每 1 级的输入都是上 1 级的残差,而不是原始输入本身,这是后文奇偶交替与失真奇偶律的起点。
\[y_{L}=\begin{cases}Q_{q}(z),&q\text{ odd or }L\text{ odd},\\ Q_{q}(z)+Q_{q}(z-Q_{q}(z)),&q,L\text{ even}.\end{cases}\]上式是理想最终标量的分段结论,奇数 q 或奇数深度只保留首级量化,偶数 q 与偶数深度则为首级加第二级的和。它意味着增加残差深度并不带来逐步更精细的理想分辨率,理想最终标量最多只有 q 种取值。论文进一步给出失真关系,偶数 q 时第二级改善平方误差当且仅当首级绝对误差大于半间隔的一半,否则变差或持平,奇偶深度分别重复第一与第二级的误差。在均匀输入假设下两奇偶的均方误差相同,但学习编码器的隐变量分布未必均匀,因此不能据此选出模型的最优奇偶,也不能解释历史全频段差距。
预测器与例外规则如何保证精确还原
对一个标量位置的实际索引元组,奇数 q 的预测器保留首索引,后续全部预测为中央零对应的索引;偶数 q 保留首索引与一个分支位,分支位指示第二索引是上中央还是下中央,后续在两个中央索引之间交替。编码器把整个预测元组与实际元组逐项比较,匹配则只存首索引及所需的分支位,任何位置失配则标记例外并完整保存原始元组,包括非中央的第二索引与后续偏离。
解码器在未例外位置重建预测元组,在例外位置直接复制完整元组,因此正确性来自整数比较与可逆存储,不要求理想公式在浮点 32 位下成立。即使全部元组都例外,格式仍然正确,只是比原始多出每标量一个标志位,论文明确报告这种代价而不切换格式。
\[\operatorname{unpack}(\operatorname{pack}(J,M))=(J,M).\]上式是往返要求,把原始索引数组与解码相关元数据打包再解包必须完全一致。表示特有的载荷长度与完整性摘要不在元数据内,例外稀疏只改善压缩,不影响正确性。在恢复相同索引与元数据并保持查表、累加与神经解码操作及执行条件不变时,已有模型重建得以保留。
预测元组 × 例外记录: 预测元组是按奇偶网格规则生成的假定索引序列,正常位置只存首索引和分支位;例外记录是对预测失败位置完整保存原始元组。二者分工是预测负责压缩多数可预测位置,例外负责兜底保证正确,组合后压缩收益来自稀疏例外,正确性不依赖理想算术是否成立。
本研究训练了什么与冻结了什么
本研究没有训练任何神经网络模型,也没有更新量化器或解码器参数,所用检查点固定在训练步数 595000,保存的模型源码快照、网格比特与重建图全程不变。实际计算过程是调用已有冻结模型做推理得到索引流,再对整数流做预测、比较、例外保存、自适应概率编码与通用压缩器压缩,以及独立解码器做还原校验。
有限精度部分需要单独说明,源码中前向量化器用直通表达式,码解码则直接查表按阶段顺序相加,二者在实数算术下相等,但在浮点执行下需要分别校验前向与码路径、原始码与解包码的两组比特一致。穷举部分对每种声明的标量配置枚举全部 q 的 L 次方元组,最多 262144 个,验证存档解码与独立顺序浮点 32 位加法逐比特一致,并统计等价类数量,但该分类不直接给出更小的文件,也未用于音频结果。
码本解码标量隐变量 × 神经解码波形: 码本解码标量隐变量指按保存网格查表并按阶段顺序相加得到的浮点隐变量;神经解码波形指该隐变量再经冻结低频与高频解码器及短时傅里叶逆变换重组得到的音频。前者是后者的直接输入,论文把整数索引还原、隐变量比特一致、波形比特一致分成三层验证,只有在相同执行条件下前者成立才能推出后者不变。
数据、执行与码率统计条件是什么
验证用两个集合,62 文件为保留的电子音乐评测参考,共 287.709 秒解码音频,512 文件为经清单筛选后新增的集合,含 398 个完整文件与 114 个长文件的居中 10 秒片段,共 2208.396 秒,包含单声道与立体声,立体声按算术平均下混,无峰值归一化与静音剔除。512 集合中 426 个源为 44.1 千赫,86 个为其他采样率并经 SciPy 多相重采样到 44.1 千赫,只有重启后的完整运行计入结果。2 次原始推理运行使用相同检查点、存档源码、预测格式与冻结中央处理器浮点 32 位执行,记录输入哈希、包版本、参数与缓冲哈希并在运行前后比对。
独立读取器检查保存流的索引与元数据,但后续格式只恢复相同输入,不重复神经推理。码率统计把写出的全部字节除以保留解码时长,共享重建模型不计入每文件存储。
\[R_{\mathrm{measured}}=\frac{8\sum_{i}b_{i}}{\sum_{i}t_{i}},\]上式中分子为各文件全部发射字节之和,分母为保留解码时长之和,乘 8 得到千比特每秒。它要求解码器填充修剪后仍保留完整测试输入或片段,所有包头、校验、填充、载荷与外层封装都计入,因此不同对照的百分比不能直接相加。
相同压缩器下表示改变带来多少节省
要回答的核心问题是预测表示本身是否有效,公平条件是对原始与预测两种表示使用完全相同的 zlib 等级 6 完整封装并计入全部开销。512 文件上原始直接存放为 915.751 千比特每秒,预测直接存放为 245.666 千比特每秒,原始加 zlib 为 218.670 千比特每秒,预测加 zlib 为 139.923 千比特每秒,62 文件也有相近的从 240.692 到 154.057 的下降。论文报告在相同 zlib 下预测打包减少字节 62 文件为 35.994%、512 文件为 36.012%,每个文件与每个采集层级聚合都变小,单文件节省在 30.847% 到 53.420% 之间。但未压缩预测流仍略大于压缩后的原始流,因此必须做压缩对压缩的完整对照,不能声称对一切压缩器都有 36% 下降。
| Metric (dB) | Mean | Q25 | Median | Q75 |
|---|---|---|---|---|
| SI-SDR | 4.332 | −5.055 | 6.553 | 14.278 |
| HF-SI-SDR-6k | 10.090 | 9.233 | 12.053 | 13.942 |
该表不是码率表,而是 512 新增集合上冻结重建本身的客观波形一致性描述,全频段均值 4.332 分贝且下四分位数为负,说明不同输入间差异很大,高通后指标均值约 10 分贝。它只提供被保留的重建质量背景,不做听感评价与率匹配比较,保存索引只是保留这些已有分数,静音与低能量参考因度量常数影响仍被保留而不做事后剔除。本表数值与单位依据论文 PDF。
下表把保存对象与证据范围分开,避免把保存流还原误当成重复推理。
| Preserved object | Evidence |
|---|---|
| Indices and decoder metadata | Original versus unpacked values; independent saved-stream readers, including later formats. |
| Latent bit patterns | Forward versus code-decoded, and original-code versus unpacked-code decoding, in the original CPU runs. |
| Waveform bit patterns | The same two comparisons in the original CPU runs. |
该表明确索引与元数据靠原始与解包值比较及独立保存流读取器验证,隐变量与波形比特一致只属于原始中央处理器运行中的前向对码解码、原始码对解包码两组比较。后续格式靠恢复相同索引与元数据继承重建保留结论,没有新的波形推理,因此不能把后续保存流检查说成又做了 1 次神经解码验证。62 文件上有 2 个例外、512 文件上有 10 个例外,全部被保留,2 次完整运行无失败项。
最终三路选择器的完整存储结果是什么
在表示有效的基础上,论文要回答最终文件相对强对照能省多少。开发阶段在 62 文件上预定义 14 个候选,选出总字节最小的自适应预测为优胜者,原始索引加 XZ 为对照,压缩器版本与封装完整计入,源哈希与选择在 512 文件执行前冻结。但两个集合都已在压缩开发中被研究过,因此后续结果是已知数据上的描述性结果,不是未见保持集上的泛化保证。最终 3 路选择器在每个文件取预测加 zlib、1 阶自适应、2 阶自适应中最短者并加 10 字节头,62 文件存 5131863 字节、142.696 千比特每秒,512 文件存 35773617 字节、129.591 千比特每秒,相对原始索引 XZ 对照分别减少 26.296% 与 25.943%,其中 512 上有 1 个文件仍比原始加 XZ 大多 83 字节。
下表整理最终与中间格式的完整文件码率,比较问题是相对不同基线的聚合节省,公平条件是全部字节与全部时长,指标越小越好。
| 条件 | 文件数 | 总字节,bytes | 码率,kbps | 相对对照节省,% |
|---|---|---|---|---|
| Predictive+zlib,512 files | 512 | 38625631 bytes | 139.923 kbps | 36.012 % |
| Three-mode selector,62 files | 62 | 5131863 bytes | 142.696 kbps | 26.296 % |
| Three-mode selector,512 files | 512 | 35773617 bytes | 129.591 kbps | 25.943 % |
该表显示相对预测加 zlib 的聚合减少为 62 文件 7.374%、512 文件 7.384%,512 上有 115 个输出因选择头而比未封装基线大至多 10 字节。不同基线的百分比不能相加,每个聚合节省与文件级比较都有特定对照。独立读取器从全部 574 个最终候选流与 574 个选中输出中恢复全部整数索引与元数据,这是最终格式的正确性证据,而比特级神经输出检查仍属于原始运行。
二阶上下文与选择器各贡献了什么代价
要拆开增益来源,论文固定只改变首索引流的上下文。1 阶模型以前一个已编码首索引为条件,2 阶用前两个组成上下文,分支编码条件于当前首索引,例外保持完整且字节不变。62 文件上首索引流从 4448244 字节降到 4260128 字节,512 文件上从 31088663 字节降到 29638245 字节,该差额恰好等于 1 阶与 2 阶候选的总差额,分支与例外没有贡献。2 阶单独在 512 文件 512 例中 489 例改善、1 例持平、22 例变大,码率为 131.929 千比特每秒,因此保留旧模式仍有用。加入 2 阶后的 3 路选择器相对两路选择器在 512 上再减少 2.238%,378 个缩小、134 个持平、无增长,512 上选择分布为 114 个 zlib、20 个 1 阶、378 个 2 阶。
下表先说明编码与解码时间的测量范围,再比较 3 种候选在共享机器上的暖机总耗时,时间越小越好。
| Candidate | Encode (s) | Decode (s) |
|---|---|---|
| Predictive + zlib | 7.949 | 6.524 |
| First-order adaptive | 10.348 | 10.333 |
| Second-order adaptive | 10.159 | 9.967 |
该表显示预测加 zlib 编码 7.949 秒、解码 6.524 秒,1 阶与 2 阶自适应各约 10 秒量级,统计覆盖 512 文件但不含输入解包、磁盘写入、即时编译与神经推理,选择器实验复用旧载荷故完整 3 路编码代价未被测量。论文据此认为应用偏向离线存储与重打包,而不主张生产延迟结论,内存也因包含基准与即时状态而不能作为编解码器内存需求。未胜出项同样重要,1 阶自适应相对预测加 zlib 在 512 上有 155 个变大、最大增加 34304 字节,两路选择器正是用 10 字节成帧代价避免这类载荷增长。本表数值与单位依据论文 PDF。
预测加 zlib × 一阶与二阶自适应算术编码: 预测加 zlib 是把预测载荷整体送给固定 zlib 等级 6 压缩;一阶与二阶自适应算术编码是对首索引流按前一个或前两个已编码首索引做条件概率编码,分支与例外另行处理。前者是通用压缩对照,后者是利用通道内相关性的专用概率模型,三者经逐文件选最短的选择器组合,兼顾多数文件的平均增益与少数文件的回退。
还有哪些本篇特有的失败条件与边界检查
论文还报告了 canonical 替换的失败诊断与穷举边界探针。若把每个实际发射索引和对应的理想值直接替换,62 文件波形全部改变,最大绝对样本差为 1.654 乘 10 的负 6 次方,因此该近似被排除在无损重编码之外,这反过来说明必须保留原始索引元组与原查表加和顺序。边界探针在四电平网格产生 6 种、八电平产生 14 种浮点 32 位输出,超过理想最终字母表大小,理想递推不能盲目替代保存实现。
格式层面 11 项测试覆盖正常与例外元组、非法输入、损坏流与字节核算,畸形长度、不支持配置、越界索引、非零填充与完整性失败都会被拒绝。稀疏例外组合界与类别标识的固定宽度分析也被证明不能保证更小的 zlib 文件,初始自适应比较的额外节省不能归因于该界或单一组件。
下表整理与 2 阶增益直接相关的首索引字节变化与选择器文件级分布,比较问题是增益是否完全来自首索引流。
| 条件 | 首索引字节,bytes | 总相对变化 | 文件级分布 |
|---|---|---|---|
| First-order to second-order,62 files,4448244 to 4260128 bytes | 4448244 bytes | 83.230 % | 55 shrink and seven tie |
| First-order to second-order,512 files,31088663 to 29638245 bytes | 31088663 bytes | 2.238 % | 378 files shrink,134 tie and none grows |
| Predictive+zlib range,512 files,1.002 to 189.195 kbps median 163.466 kbps | 29638245 bytes | 139.923 kbps | 115 outputs exceed baseline |
该表把上下文改变的字节差额、选择器非扩张保证与单文件反例放在一起,说明平均增益与逐文件行为是两回事。512 上预测加 zlib 单文件码率从 1.002 到 189.195 千比特每秒、中位数 163.466 千比特每秒,聚合 139.923 包含静音等高度可压缩材料,不能把聚合码率当成每文件的典型工作点。首索引流在 62 文件占 1 阶候选 83.230% 字节,这是只改首索引上下文就能带来可观节省的原因,但 22 个 2 阶变大文件与 115 个超基线文件提醒长上下文并非对每文件都有利。
结论在什么条件下才成立
所有存储与精确性结论限定在 studied 的 62 与 512 文件集合、冻结检查点、声明的中央处理器浮点 32 位执行与相同解码操作下,不涉及其他检查点、流式条件或加速器。两集合是聚类便利样本且 512 为采集平衡样本,不是总体随机抽样,也没有独立训练重复。训练内容不相交性因缺失最终分片归属与增强到源映射而无法断言,筛选只解决与已有训练评测清单的重叠检查。
压缩开发复用已研究集合,因此最终码率是描述性结果,后续编码选择用已知集合,后续新编码需要生成 3 种备选。名义 810.415 千比特每秒不是最小存储需求,理想代数给出的 143.929 千比特每秒也不是可测码率,观测到的 129.591 到 154.057 千比特每秒依赖实际符号序列、时长、成帧与压缩器,换位布局、压缩器或熵模型都可能改变比较。重建质量本身域受限且为单声道,下混与重采样是独立于序列化的预处理损失,历史全频段 DAC 优势仍未解决,没有听感优越性、源音频无损或部署就绪的推论。
复现第一步做什么与需要什么信息
复现应从绑定执行身份开始,确认保留的模型源码版本与检查点摘要、PyTorch 与依赖版本、线程数与确定性算法设置,并在完整运行前后比对参数与缓冲哈希。接着按 120 字节头规范实现原始与预测载荷的位序、组遍历顺序、转义位图与例外元组布局,用 zlib 等级 6 完整封装做第一组对照,再实现 1 阶与 2 阶算术编码的状态重置、计数重缩放与变长位置记录。
验证分 3 层,先用独立解析器恢复全部索引与元数据,再在原始运行中比对前向与码解码、原始码与解包码的隐变量与波形比特模式,后续保存流只验证还原而不重复推理。论文未公开商业源音频、识别性数据集记录、逐文件结果、检查点与实现仓库,执行与评审收据只在内部保留,因此代码可用、模型可下载与系统可运行是三件不同的事,目前都不能声称已公开。
缺失的是完整 3 路编码时间的直接测量、生产延迟与随机访问评估,补测时应单独记录生成 3 种载荷、选择与封装的时间并说明硬件条件。
什么时候值得尝试与还需要补哪项验证
当面对冻结且不可再训练的残差标量量化系统,又发现多级复用相同网格、索引高度相关时,值得尝试这种预测加完整例外的存放方式,因为它在不碰解码的前提下可能显著减少索引字节,且正确性不依赖理想公式在浮点下成立。复现第一步是先在小集合上实现预测器与逐索引比较,确认例外稀疏且能比特还原,再接入通用压缩器做压缩对压缩对照。
还需要补的验证是未见新集合上的保持测试、其他执行平台的比特一致性、以及包含选择头与全部封装的端到端字节核算,避免把已知集合上的事后最优当成部署可得的提升。容易产生的误解是把存储下降当成音质改善,或把名义比特核算当成可比码率,或把保存流还原当成又做了 1 次神经验证,原文证据只支持在声明条件下的存储减少与解码器输入精确恢复,有损重建的质量与历史局限保持不变。
📎 论文与评分元数据
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses