共分析 146 篇论文
⚡ 今日概览
✅ 筛选入选 146 篇 → 🔬 深度分析完成
🏷️ 标签说明:本期标签来自新版词表;站点标签页暂时兼容展示历史标签与新标签。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| #语音识别 | 18 篇 | ███████████████ |
| #文本到语音 | 8 篇 | ████████ |
| #符号音乐生成 | 5 篇 | █████ |
| #语音情感识别 | 5 篇 | █████ |
| #音视频生成 | 5 篇 | █████ |
| #音频问答 | 5 篇 | █████ |
| #全双工语音交互 | 4 篇 | ████ |
| #语音属性识别 | 4 篇 | ████ |
📊 论文评分排行榜(146 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 VoxAnon:为语音匿名化提供属性平衡的公平评测

英文题目:VoxAnon: A balanced dataset for a fair evaluation of speech anonymization
标签:#说话人匿名化 | #数据集构建 | #说话人验证 | #公平性 | #数据集
评分:8.2/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Orane Dufour:机构信息未在 arXiv HTML 中可靠披露
- Paul Magron:Université de Lorraine, CNRS;Inria, LORIA, F-54000 Nancy, France
- Mickael Rouvier:LIA, Avignon University;F-84911 Avignon, France
📌 核心摘要
语音匿名化希望去除可识别说话人身份的线索,同时保留下游任务需要的语言内容,评测常用自动说话人验证(automatic speaker verification, ASV)充当攻击者,比较匿名化后注册语音与测试语音的嵌入相似度并用等错误率(equal error rate, EER)衡量可再识别风险,EER越高表示隐私保护越好。论文指出攻击者训练数据与评测数据的性别、年龄、口音、音高分布都会改变隐私估计,使某些群体显得更易或更难被识别。作者从VoxCeleb1和VoxCeleb2构建VoxAnon,训练集1000人约291.48小时与测试注册共150人按四种属性配平试次,每测试说话人取10条、每注册说话人取5条,并把同一说话人的测试与注册话语取自语义相似度最低的不同视频以减少会话与词汇重叠。相对已有仅配平测试或仅覆盖性别的方法,该数据集同时控制训练与测试的边缘分布,并提供可复现的非平衡对照与试次表。在4种攻击者与3种匿名器的16种组合下,平衡训练平均等错误率为30.28%的B5最强而平均21.48%的B4最弱,且口音离散最突出,US说话人在12种组合中的10种最易被再识别。结论适用于所选属性划分与半知情(semi-informed)攻击设定,未验证其他欠采样组合与真实主观隐私;原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/OraneD/VoxAnon — 链接可访问(HTTP 200)
数据相关资源:https://github.com/OraneD/VoxAnon — 链接可访问(HTTP 200)
第三方资源:https://github.com/OraneD/VoxAnon — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 用人声音量大小本身做控制:连续声压级人声强度转换
英文题目:Vocal Intensity Conversion with Continuous SPL Control via Adversarial Training
标签:#语音转换 | #生成对抗网络 | #语音属性识别 | #主观评测
评分:8.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Quentin Le Tellier:机构信息未在 arXiv HTML 中可靠披露
- Albert Rilliard:机构信息未在 arXiv HTML 中可靠披露
- Olivier Perrotin:机构信息未在 arXiv HTML 中可靠披露
- Marc Evrard:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
人声强度转换要求输入一段录音与目标声压级,输出同一说话人在目标强度下发声的语音,保持文本内容与说话人身份,难点在于强度变化伴随基频与频谱包络变化,不能只做整体增益。冻结的语音编码器先把波形分析为帧序列,残差转换器以连续分贝标量为条件预测逐帧修正量并叠加到原帧上,预训练声码器再将修正后帧序列重合成波形,转换保持帧对齐而不改变时长语速。训练时该转换器作为条件循环一致生成对抗网络的生成器,判别器同时区分真实与转换样本以及电平是否错配,循环一致与恒等约束要求转回源电平时恢复原帧以保持内容。与已有参考录音替换或离散噪声等级查表的做法不同,该工作以连续分贝标量为条件且不依赖平行数据。在AVID校准语料6名测试说话人的客观评测中,以预测强度位移斜率为指标,WavLM第六层转换器达到0.83,高于同设置下对数梅尔频谱的0.62和SpeechTokenizer的0.58,越接近1表示越完整实现目标变化。在4名测试说话人8段源录音各转8个目标电平共64条刺激的54人听感评价中,以感知电平随目标电平变化斜率为指标,转换样本为0.69,与原始录音的0.68相当,30 dB目标范围被感知为约21 dB。结论仅适用于相对强度控制,同一目标下绝对感知电平随源录音波动约6 dB标准差,且基频与频谱斜率位移仍小于自然录音。WavLM第六层转换器的训练成本为在4块H100上迭代11400次约3.7小时完成,原文未披露推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/vers-project/vocal-intensity-conversion — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/nvidia/bigvgan_v2_22khz_80band_fmax8k_256x — 暂时无法访问
第三方资源:https://github.com/bshall/knn-vc — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/fnlp/SpeechTokenizer — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 同时看全场又不看未来:CAST-ASD 怎么做在线说话人检测

英文题目:CAST-ASD: Causal Attention over Speakers and Time for Online Active Speaker Detection
标签:#说话人分离标注 | #注意力机制 | #音视频 | #严格因果
评分:8.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Pratham Gupta:机构信息未在 arXiv HTML 中可靠披露
- Haotian Qi:机构信息未在 arXiv HTML 中可靠披露
- Tushar Sandhan:机构信息未在 arXiv HTML 中可靠披露
- Gabriel Skantze:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
主动说话人检测的输入是同一场景下多条人脸轨迹与一条共享混合音频,输出是每张人脸在每帧的说话概率,难点在于所有人脸共享相同声音证据,归属只能依赖微弱视觉线索,且同一帧另一张可见人脸正在说话时会形成竞争说话人,容易把声音归属到错误人脸。CAST-ASD先用因果单人骨干对每张脸做视听融合,再用一个CAST块做两步处理:先在当前帧内跨说话人注意力比较所有在场人脸,随后因果时间注意力沿各人脸自身历史传播信息,门控初始化使未训练块等价于单人骨干。与固定人脸槽位卷积不同,该模块参数量不随人数增长,且人脸排列变化不改变对应关系。在MSDWild的many.val子集上,因果CAST-ASD相对共享编码器的单人骨干,把竞争误报率FAc从12.72%降到8.61%,相对减少32%。在many.val上同条件比较因果与离线配置的平均精度mAP损失,CAST-ASD为1.14,小于LoCoNet的2.67;该优势在场景能装入三人槽位时与LoCoNet接近、超出后拉开,在5人及以上帧差距最大,而AVA上因竞争较少对应margin较小。该结论只在可见人脸竞争占主导的多人会话条件下成立,说话人在镜头外、重叠语音联合处理与身份线索均未纳入本次验证,原文也把新语料与新模型对比列为未来工作。单块为1.57M参数、每人脸帧1.09 GFLOP且零前视,原文未报告训练时长与推理延迟实测。
🔗 开源资源
代码相关资源:https://github.com/prathamg007/CAST-ASD — 链接可访问(HTTP 200)
模型相关资源:https://github.com/prathamg007/CAST-ASD — 链接可访问(HTTP 200)
第三方资源:https://github.com/prathamg007/CAST-ASD — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. HE-NAC:用分频段残差量化保住音乐高频细节

英文题目:HE-NAC: High-Efficiency Neural Audio Coding via Hierarchical and Residual Multi-Band Quantization
标签:#音频编码 | #向量量化 | #音乐
评分:8.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Darius Pétermann:机构信息未在 arXiv HTML 中可靠披露
- Wootaek Lim:机构信息未在 arXiv HTML 中可靠披露
- Seungkwon Beack:机构信息未在 arXiv HTML 中可靠披露
- Minje Kim:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
高保真音乐编码输入32 kHz波形、输出压缩重建波形,难点是编码器经约400倍降采样后高频在瓶颈丢失,解码器只能盲上采样猜测缺失成分。HE-NAC保留DAC主干,在第2、3、4层引出高、中、核心三路表示,核心直接残差向量量化、中高频用轻量跳跃自编码器编码,低频解码上采样的免码率特征与本频段量化特征相加后送入本频段多头解码器。训练分三阶段依次学习核心0-16 kHz重建、中频3-16 kHz残差和高频6-16 kHz残差,每进下一阶段冻结已学路径并复制解码器权重作初值,迫使新码本只学未重建残差。推理按频段拼接输出,码本数可调使Huffman熵编码后有效码率在约13-23 kbps内伸缩。在12片段、15名有效听音人的类MUSHRA对比中,22.984 kbps的HE-NAC(16,4,2)得分最高,显著超过23.013 kbps的DAC基线和24 kbps的HE-AAC v1。在全频带客观评测的23 kbps档,HE-NAC(16,4,2)的全频带VISQOL为4.40,高于参数量匹配的DAC(31)基线的4.35。在同一表内3-6 kHz客观评测的23 kbps档,HE-NAC的SI-SDR为3.7 dB,高于DAC基线的0.7 dB。该结论只在32 kHz全频带重建、18-24 kbps档、上述12片段听音集和220M参数量匹配下验证,DAC在0-3 kHz更强且高频与全频带GOMPSNR略偏向DAC,去掉高频码的HE-NAC(16,4,0)对6-16 kHz仍靠盲上采样,未验证其他采样率、流式与HE-AAC降采样到29 kHz外的条件。220M参数下HE-NAC(16,4,2)离线RTF为0.0165、每秒音频GFLOPs为491.7,慢于同规模DAC(31)的0.0112和426.7,测于单批量39个10秒片段不含读写,均不支持流式推理。
🔗 开源资源
代码相关资源:https://minjekim.com/research-projects/he-nac → https://minjekim.com/research-projects/he-nac/ — 链接可访问(HTTP 200)
模型相关资源:https://minjekim.com/research-projects/he-nac → https://minjekim.com/research-projects/he-nac/ — 链接可访问(HTTP 200)
第三方资源:https://minjekim.com/research-projects/he-nac → https://minjekim.com/research-projects/he-nac/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. 看得见的移动听得见的方向:StereoBind 的立体声视频音频联合生成

标签:#音视频生成 | #多模态学习 | #数据集 | #基准测试
评分:8.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hanmo Chen:机构信息未在 arXiv HTML 中可靠披露
- Chengcheng Liu:机构信息未在 arXiv HTML 中可靠披露
- Tianxiao Chen:机构信息未在 arXiv HTML 中可靠披露
- Zheyu Zhang:机构信息未在 arXiv HTML 中可靠披露
- Siming Zheng:机构信息未在 arXiv HTML 中可靠披露
- Jinwei Chen:机构信息未在 arXiv HTML 中可靠披露
- Xu Yang:机构信息未在 arXiv HTML 中可靠披露
- Cheng Deng:机构信息未在 arXiv HTML 中可靠披露
- Bo Li:机构信息未在 arXiv HTML 中可靠披露
- Peng-tao Jiang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
联合视频音频生成需同时确定发声内容、发声时刻以及声源方位如何随画面运动,要求左右声道间的强度差与时间差随可见声源连续演变,而已有模型多止于语义对应与时间同步。StereoBind以文本描述与归一化运动轨迹为输入,输出与轨迹一致的视频与双通道立体声音频,建模条件联合分布以实现动态空间对应。视觉运动绑定模块先汇聚运动参考特征再融合目标视频状态,并将融合表示提供给音频流做跨模态检索;空间轨迹编码器把轨迹映射为时序对齐的调制参数,用以适配各层音频查询。残差轨迹旋转位置编码在重采样轨迹上叠加水平与垂直残差相位,使音频自注意力显式携带相对位移信息,从而区分绝对位置条件与相对运动。在StereoWorldBench消融评测中,StereoBind完整模型的耳间强度差Wasserstein距离ILD-W为2.754 dB,低于去掉空间轨迹编码器变体的3.336 dB,数值越低表示与参考空间演变越一致。结论适用于单主导声源且以左右运动为主的情形,对多声源、遮挡与离屏声源尚未验证。原文披露训练在八张NVIDIA H20上约两天,未披露推理延迟与部署成本。
🔗 开源资源
第三方资源:https://vivocameraresearch.github.io/Stereo-Bind-Project/ — 链接可访问(HTTP 200)
代码相关资源:https://github.com/vivoCameraResearch/StereoBind — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. EAGLE-ASR:为语音识别定制的无损推测解码加速

英文题目:Lossless Inference Acceleration for ASR via EAGLE-Style Speculative Decoding
标签:#语音识别 | #语音翻译 | #自回归模型 | #知识蒸馏
评分:8.0/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sen Zhang:the College of Intelligence and Computing, Tianjin University, Tianjin 300350, China
- Xianghu Yue:the College of Intelligence and Computing, Tianjin University, Tianjin 300350, China
- Yiming Chen:ASUS Intelligent Cloud Services, Singapore 486030
- Wenhuan Lu:the College of Intelligence and Computing, Tianjin University, Tianjin 300350, China
- Jianguo Wei:the College of Intelligence and Computing, Tianjin University, Tianjin 300350, China
- Haizhou Li:the School of Artificial Intelligence, The Chinese University of Hong Kong, Shenzhen, Guangdong 518172, China, also with the Department of Electrical and Computer Engineering, National University of Singapore, Singapore 117583
📌 核心摘要
自回归语音识别每次只生成一个词元,目标模型需要反复做完整前向计算,解码延迟成为离线转写的瓶颈,压缩与非自回归并行解码往往改变参数或输出而损失精度。EAGLE-ASR 保留目标模型参数不变,采用起草后并行验证的流程,输入为完整语音与已生成前缀,输出与原始自回归解码相同的词元序列。轻量起草模块 Speech-Draft 在第一步融合编码器声学特征与目标解码器低中高三层表示并结合词元嵌入,后续步骤复用上一步隐状态与已起草词元做自回归延展,目标解码器再并行验证并按标准接受准则保留前缀一致部分。训练只用目标模型重转写的自蒸馏文本,并以指数衰减加权的多步交叉熵让近端预测更准,从而缩小训练与多步起草之间的分布差异。与依赖外部小模型的投机解码和并行多头预测相比,该设计同时利用声学对齐与层次语义且保持因果依赖。在 LibriSpeech 上以 Whisper-large-v3 为目标时,test-clean 的相对加速比达到 1.91 倍且词错率变化为零,超过同环境下的外部草稿与 Medusa 基线。该结论适用于全量语音输入的离线贪心解码,翻译等不确定性更高的任务接受长度会下降。
🔗 开源资源
- 代码相关资源:https://github.com/ssss-sen/eagle-asr — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. 随输入换压缩宽度、只扰动高频梅尔带:音频伪造检测的泛化框架

标签:#音频深度伪造检测 | #对抗训练 | #混合专家模型 | #语音
评分:8.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jianqiao Cui:Yangtze Delta Region Institute of Tsinghua University;Jiaxing, China
- Haoxian Zhu:University of Southampton;Southampton, UK
- Hanbiao Meng:Taiyuan University of Technology;Taiyuan, China
- Yanghao Zhang:Imperial College London;London, UK
📌 核心摘要
音频深度伪造检测的输入是连续语音波形,输出是真实或伪造的二分类判定,难点在于不同伪造痕迹的信息密度差异很大,固定宽度的瓶颈表示难以同时保留微弱取证线索并抑制冗余噪声。论文在冻结的语音编码器后加入自适应音频特征集成,由路由为每个话语从压缩池选择多分辨率特征并与原始编码特征拼接送入解码器做单类别词元分类。训练侧加入梅尔频带对抗扰动,在对数梅尔谱的高频先验频带内用多步投影梯度下降生成扰动,迫使模型不再依赖易被破坏的高频捷径。在按语音合成、声音转换与神经声码器分组并取平均的路由对比中,Whisper-base基线的等错误率为5.73%,top-3自适应选择的等错误率为2.00%,方向为更低。在BD-UT数据集上以Whisper-small编码器做迭代步数消融时,等错误率从K为零时的0.95%降至K为五时的0.87%,对应训练时间相对基线增加约115%,且推理阶段不增加扰动开销。相对把编码器当固定特征提取器加固定瓶颈的做法,差异在于压缩宽度随输入变化且正则只作用于取证先验频带。结论适用于训练所覆盖的合成类型和常规失真附近的泛化,在强自适应攻击和部分跨语言条件下误差明显升高,路由分布与伪造类型的关联分析仅为关联性证据而非因果证据。
🔗 开源资源
- 数据相关资源:https://www.modelscope.cn/datasets/inclusionAI/SPEECHFAKE — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. FOAdapter:给冻结单声道编码外挂一条空间码流的低码率 FOA 语音编码

英文题目:FOAdapter: A Plug-and-Play Spatial Tokenizer for Low-Bitrate FOA Speech Coding
标签:#语音编码 | #Adapter | #空间音频信号 | #神经编解码与离散单元
评分:8.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kirak Kim:机构信息未在 arXiv HTML 中可靠披露
- Yoonjeong Park:机构信息未在 arXiv HTML 中可靠披露
- Juhan Nam:机构信息未在 arXiv HTML 中可靠披露
- Sungyoung Kim:机构信息未在 arXiv HTML 中可靠披露
- Minje Kim:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
一阶 Ambisonics(First-Order Ambisonics,FOA)用全向分量W记录主要语音内容、X、Y、Z三个方向分量记录声场方向结构,任务是从紧凑离散表示重建全部4个通道并同时保住可懂语音与声源方向,难点是逐通道独立运行单声道编码器会使总码率成倍增加而直接降码率又损害空间线索。FOAdapter冻结预训练单声道编码器,只对输入的W通道编码量化再解码得到参考波形,为后续重建提供语音内容基准。可训练因果卷积空间编码器以完整4通道FOA信号为输入提取空间表示,经两本2048表项残差矢量量化以12.5令牌/秒输出275 bit/s空间令牌流。空间解码器从解码后的W波形提取波形特征,同时把量化空间表示上采样为缩放与偏置参数调制该波形特征,再由输出网络重建完整4通道信号,训练时以真值W为条件以适配不同单声道编码器。空间令牌同时接受强度方向与幅度辅助预测和空间引导对比学习约束,使相同方向表示接近、不同方向表示远离,以降低其对W中语音内容的依赖。在 Spatial LibriSpeech 测试集上,MOSS-8 结合 FOAdapter 在 1.275 kbps 总码率下到达方向误差为 6.68 度,Whisper-large-v3 词错误率为 9.13%,优于 1.5 kbps 的 MOSS-3 通道独立编码的 24.52 度和 13.79%。适用条件是单人固定位置仿真语音,运动声源、多人混叠和真实房间录音尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://kirak-kim.github.io/foadapter-demo/ → https://www.kirak.kim/foadapter-demo/ — 链接可访问(HTTP 200)
演示资源:https://kirak-kim.github.io/foadapter-demo/ → https://www.kirak.kim/foadapter-demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. MPASCNet:用幅度相位联合压缩恢复 MP3 丢失的高频与细节

英文题目:MPASCNet: Magnitude-Phase-Aware Adaptive Spectral Compression for Compressed Music Restoration
标签:#音频修复 | #注意力机制 | #音乐 | #时频分析
评分:8.0/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.5/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xinlong Deng:机构信息未在 arXiv HTML 中可靠披露
- Yu Xia:机构信息未在 arXiv HTML 中可靠披露
- Qiuqiang Kong:机构信息未在 arXiv HTML 中可靠披露
- Yin Cao:机构信息未在 arXiv HTML 中可靠披露
- Jie Jiang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
压缩音乐修复的输入是经 MP3 等感知编码压缩的波形,输出是恢复缺失高频和编码失真的波形,难点在于音乐谐波、瞬态与多人声乐器交织且相位失真难以直接回归。MPASCNet 先对短时傅里叶变换得到的功率压缩幅度与包裹相位分别做卷积嵌入,再把两者拼接作为键与值,由可学习谱查询经交叉注意力把全频带聚合成 80 个紧凑谱 token。紧凑 token 进入谱时间主干,在 token 轴与时间轴上交替建模依赖,输出携带修复线索的压缩表示。重建阶段用幅度查询与相位查询分别对压缩表示做交叉注意力,幅度分支预测残差修正,相位分支预测二维表示再经反正切恢复角度,最后合成复谱并经逆变换得到波形。与固定子带划分不同,该聚合权重随输入内容变化,且显式保留幅度与相位两路特征。在由 MedleyDB 构建的非重叠评估集上,MPASCNet 总体 SDR 为 17.65 dB,SI-SNR 为 17.27 dB,ViSQOL 为 3.67,均高于 Apollo 与 AEROMambaPS,且参数量更少。该结论限于 24 kbps 至 128 kbps 的 MP3 人工退化与 3 秒片段评估,未验证其他编码器或长时连续音乐。原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/xinghour/MPASCNet — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. 把重叠语音对准到声源:SonicWorld 如何做空间问答

英文题目:SonicWorld: Source-Centric Latent Dynamics for Spatial Audio Reasoning
标签:#音频问答 | #声源定位 | #状态空间模型 | #基准测试
评分:8.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chenlong Wei:机构信息未在 arXiv HTML 中可靠披露
- Hanling Wang:机构信息未在 arXiv HTML 中可靠披露
- Mingjin Lou:机构信息未在 arXiv HTML 中可靠披露
- Yufan Shi:机构信息未在 arXiv HTML 中可靠披露
- Yandong Sun:机构信息未在 arXiv HTML 中可靠披露
- Sheldon Yu:机构信息未在 arXiv HTML 中可靠披露
- Xiaohui Zhu:机构信息未在 arXiv HTML 中可靠披露
- Xiaobo Jin:机构信息未在 arXiv HTML 中可靠披露
- Yiwei Wang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
动态空间音频推理要求模型根据10秒一阶Ambisonics录音和指明目标说话人与时刻或区间的提问,回答该源在固定接收者坐标系下的方向、方位角、仰角、距离或水平净位移方向,重叠语音与声源移动使声学证据与目标身份的对应变得困难。SonicWorld先抽取物理强度与相干特征、学习型波形交互特征和冻结BEATs语义概要,分别提供几何线索、细粒度声学细节与内容身份依据。这些特征随后送入2个声源槽加1个背景槽的递推绑定与双向精修模块,通过学习型转移与循环更新维持随时间连续的声源状态序列,从而把混合观测持续归属到固定身份槽。空间投影器再把先验、观测、循环与精修状态及方向锚点压缩为局部token与声源概要token,与原生音频token一同送入Qwen2.5-Omni-7B回答问题,与直接映射整段音频的已有方法不同,推理基于显式持续声源轨迹。相对同样使用Qwen2.5-Omni-7B的Spatial-Omni,SonicWorld在Sonic-Bench测试集把总体方向准确率从31.98%提高到34.69%,方位角平均绝对误差从57.22度降到48.01度。在Spatial LibriSpeech零样本单源定位中,SonicWorld相对Spatial-Omni把方向准确率从27.14%提高到73.98%,方位角平均绝对误差从70.74度降到19.29度。结论适用于模拟室内、固定接收者、1到2个语音源的离线问答,真实环境、移动接收者与稠密多源尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://anonymous.4open.science/r/2C38/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. 边听边说边想:Rubato 用两套时钟解开实时音频与异步思考的绑定

英文题目:RUBATO: Decoupled Clocks Allow Full-Duplex Models to Think as Fast as They Can
标签:#全双工语音交互 | #动态计算与早退 | #音频推理 | #语音 | #实时处理
评分:7.6/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.4/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yi-Jen Shih:The University of Texas at Austin;FAIR, Meta Superintelligence Labs
- Puyuan Peng:FAIR, Meta Superintelligence Labs
- Haohe Liu:FAIR, Meta Superintelligence Labs
- David Harwath:The University of Texas at Austin
- Abdelrahman Mohamed:FAIR, Meta Superintelligence Labs
📌 核心摘要
语音全双工模型需同时听取用户音频、生成系统音频并在内部进行链式思考,输入是连续到达的音频帧,输出是实时语音回应与最终答案,难点在于实时对话必须按固定物理节拍推进,而思考所需计算量随硬件速度变化。Rubato先把用户音频、系统音频与思考token展平成按帧交错的序列,每帧按思考预算安排可变的思考token数,再为实时流和思考流各维护一个独立时钟,每个时钟只在属于自己的token上推进而在其他token上暂停。查询与键之间的旋转角度按键所属时钟的差值计算,该输出直接决定注意力中的相对位置,使相邻音频帧间距不受中间思考token数量影响。训练只用思考预算为1和无穷大两种极端排布,前者用口语填充音撑住对话时长以对齐完整思考,后者把完整思考压缩到一帧之内,中间速度作为零样本插值部署。在Spoken GSM8K插值评测中以准确率为指标,Rubato-Full在全部速率保持48.7%到51.1%,高于单时钟基线在插值速度下跌至的1.7%。在同一Spoken GSM8K评测中以回答延迟和首次发声时间为指标,Rubato-Full利用更快硬件将回答延迟缩短为约6.5分之一,而首次发声时间保持不变。该结论适用于合成语音的单轮与重叠打断口语推理任务,真实录音、多模态流与工具调用尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. 只看错误率会漏掉什么:低资源语音识别中数据增强的代价
英文题目:Error Rate is Not Enough: Costs of Augmentation in Low-Resource ASR
标签:#语音识别 | #数据增强 | #低资源 | #语音学与音系
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.4/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Katsumi Ibaraki:机构信息未能从 arXiv PDF 文本可靠映射
- David Chiang:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
低资源自动语音识别的输入是少量带转写的语音,输出是词或音素序列,难点是训练覆盖不全时总体错误率无法说明哪类音位受损。文本替换先用语料已有词表生成新文本:基于标签替换保持标注序列并在同标签词中抽样,随机替换则从训练词表任意抽样,替换比例按语言调优,得到的新文本直接送入合成。Kokoro用五个固定音色把新文本合成语音,与原始音频按选定比例混合,再连同变速扰动和频谱增强进入微调:变速在0.9至1.1间以30%概率施加,频谱增强以长度5、概率30%在特征编码器输出上做时频掩码,共同训练wav2vec2-large-xlsr-53的CTC模型。与只报总体错误率的前人工作不同,本文把假设与参考按音位对齐统计各类错误,并用训练暴露百分位和单一声学线索解释何时受损。在Nashta语上,随机替换单用降低词错率1.5%,频谱增强单用降低3.1%,两者合用降低8.0%,四语言词错率绝对降低2.4至8.0%,最大相对降幅14.1%出现在Vatlongos,且超可加性在100小时英语数据上消失。频谱增强总体最稳却增加声调和腭化错误,而提高稀有词频率的随机替换能回补这类损伤。结论只适用于1至5小时量级的低资源情形,声调与腭化的机制仍需更多语言验证。原文披露单卡NVIDIA A10上训练耗时随数据量在3至160小时之间,原文未披露推理或部署成本。
🔗 开源资源
第三方资源:https://pangloss.cnrs.fr/corpus/Vatlongos — 链接可访问(HTTP 200)
第三方资源:https://pangloss.cnrs.fr/corpus/Nashta — 链接可访问(HTTP 200)
第三方资源:https://pangloss.cnrs.fr/corpus/Kakabe — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/hexgrad/Kokoro-82M — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. SIMPLE:用语义结构对齐的可学习提示做开放词汇音视事件定位

标签:#音频事件检测 | #提示学习 | #正则化 | #音视频
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hanyu Xuan:the School of Big Data and Statistics, Anhui University, Hefei 230039, China
- Haoran Xu:the School of Big Data and Statistics, Anhui University, Hefei 230039, China
- Min Yin:the School of Big Data and Statistics, Anhui University, Hefei 230039, China
- Shuo Wang:the School of Information Science and Technology, University of Science and Technology of China, Hefei, China
- Cheng Zhao:the Shenzhen University Medical School, Shenzhen University, Shenzhen 518060, China
- Kun Li:the College of Information Technology, United Arab Emirates University, Abu Dhabi, 15551, United Arab Emirates
- Fei Wang:the Institute of Artificial Intelligence, Hefei Comprehensive National Science Center, Hefei, 230026, China
- Zhiliang Wu:the College of Computing and Data Science, Nanyang Technological University, Singapore 639798, Singapore
- Guanghui Yue:the Shenzhen University Medical School, Shenzhen University, Shenzhen 518060, China
- Hehe Fan:the School of Artificial Intelligence, Zhejiang University, Hangzhou 310007, China
📌 核心摘要
开放词汇音频视觉事件定位的输入是按秒切分的未剪辑视频音频流与视觉流,输出是每段属于背景还是某个事件类,并把连续同类段合并为带起止时间的事件,难点是训练只见过46类,测试还要给出21个未见类的具体类名。可学习连续提示调优把16个可优化上下文向量与待识别类名拼接后送入冻结的文本编码器,得到可学习提示嵌入作为音频视觉事件原型。段级音频视觉特征与该原型计算余弦相似,构成音频和视觉两路相似矩阵再等权平均融合,以交叉熵在见类样本上训练实现跨模态匹配。语义拓扑一致性正则用170个合成新类模拟未见类,对齐可学习提示与手工提示集成在随机64类子集上的成对相似分布,以权重0.1的KL散度约束保持类间关系,该约束只在训练时生效。推理时冻结上下文向量并把类名换成目标集全部见类与未见类,沿相同前向流程算相似再合并成事件。与只用固定模板做相似匹配不同,该框架同时适配任务语义并保留预训练类间关系。在OV-AVEBench总测试集上,方法在见类划分Avg.指标从此前最优的68.8%提高到71.2%,在未见类划分Avg.从59.9%提高到61.7%,均高于已有最强结果,总Avg.为60.2%与Cue2Rule持平。结论限于该基准67类中46见21未见的划分与给定特征,可学习上下文过长或正则过弱时增益下降;原文报告可训练参数约4.2M,约2.0小时得到最优检查点,推理时不增加额外计算。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 把半双工语音大模型改成全双工:D2 的两阶段做法

英文题目:D2: High-Capability Full-Duplex Spoken Language Models from Half-Duplex Backbones
标签:#全双工语音交互 | #知识蒸馏 | #SFT | #流式处理
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.1/1.5 | 开源 0.2/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Cheng-Kuang Chang:MIT CSAIL
- Alexander H. Liu:MIT CSAIL
- Brian Kingsbury:MIT-IBM Watson AI Lab
- Hilde Kuehne:MIT-IBM Watson AI Lab
- Rogerio Feris:MIT-IBM Watson AI Lab
- Samuel Thomas:MIT-IBM Watson AI Lab
- James Glass:MIT CSAIL
- Kai-Wei Chang:MIT CSAIL
📌 核心摘要
全双工语音语言模型要求在持续生成语音的同时实时听取用户音频,输入是不断到达的用户声波与延迟回放的自身语音,输出是逐块生成的语音及其伴随的中间文本,难点在于流式编码缺少未来上下文且交互决策细化到短块级别。半双工语音语言模型只在完整轮次边界处决策与回应,理解与推理能力较强,但无法处理重叠语音与中途打断。Dialogue-to-Duplex第一步把冻结的离线音频编码器蒸馏为流式学生编码器,块内双向注意力、块间因果注意力,输出的流式表征直接送入原有理解与合成通路。第二步把用户与助手音频排布到保留静音与重叠的共享时间轴并切分为固定块,以监督微调学习发起回应、让出话语与填充静音,上一步得到的流式编码器随模型一起参与训练。在全双工交互的块粒度设置下,与BayLing-Duplex最长4 s输入块与800 ms块的做法相比,D2以80 ms量级更新实现更细粒度交互并避免高更新率下的性能骤降。在VoiceBench评测中,12.5 Hz的Qwen3-Omni-D2的VoiceBench分数为70.1,以约9.1分超过最强全双工基线MiniCPM-o 4.5,同时在Full-Duplex-Bench评测中轮次接管率99.2%高于MiniCPM-o 4.5的75.6%、打断接管率99.5%高于MiniCPM-o 4.5的94.5%。结论在Qwen3-Omni与LLaMA-Omni 2结构上得到验证,Qwen3-Omni-D2在小块下暂停处理仍有限,且全双工训练数据由轮次对话拼接构造而非真实全双工对话。在单张RTX PRO 6000上测得的第二阶段单配置elapsed时间为10.8小时至13.2小时,80 ms块全推理平均计算时间为56.9 ms,低于80 ms块时长。
🔗 开源资源
- 第三方资源:https://d2-duplex-demo.github.io/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. 在语音输入输出内部先想文本再说语音

英文题目:Distilling Text LMs into Speech-to-Speech LMs by Matching Internal Text Predictions
标签:#语音合成 | #语音大模型 | #知识蒸馏 | #自回归模型 | #流匹配
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ju-Chieh Chou:TTI-Chicago
- Jiawei Zhou:Stony Brook University
- Karen Livescu:TTI-Chicago
📌 核心摘要
语音到语音语言模型要求输入为语音、输出仍为语音,难点是仅靠语音信号难以学到文本大规模预训练带来的长距离语言结构和事实知识,而已有蒸馏多针对语音输入文本输出模型,语音到语音模型缺少可直接监督的文本分布。论文提出文本引导语音语言模型(Text-Guided Speech LM,TGSLM),训练时在随机词边界插入转换符号,转换前只消费语音上下文而不看其转写,转换后逐词先预测文本词、再以该词引导生成对应语音段,推理时同样在语音提示后加转换符号触发交替生成。内部文本预测构成知识迁移接口,用冻结文本主干做知识蒸馏(Knowledge Distillation,KD),以正向 KL 散度对齐师生下一个词分布,并以概率 0.2 混入纯文本重放以缓解文本能力遗忘,区别于经生成语音和序列级偏好间接传递教师信号的做法。在 Emilia 测试集 1325 条提示的共有子集上,TGSLM 把语音延续的生成困惑度(generative perplexity,genPPL)从语音基线的 151.7 降到 58.9,接近使用 Whisper 转写提示文本的文本先行模型的 57.1。放大的 TGSLM-Large-distill 在 Known-1000 上 Pass@5 达到 37.9%,高于 SpiritLM Base 的 23.5%。作者承认仍需词级对齐,句子级引导和指令微调等后训练尚未研究。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://rome.baulab.info/data/dsets/known_1000.json — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/hexgrad/Kokoro-82M — 暂时无法访问
第三方资源:https://github.com/microsoft/UniSpeech/tree/main/downstreams/speaker_verification — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. 把有限计算花在刀刃上:粒子搜索加局部修正的音画对齐

标签:#音视频生成 | #动态计算与早退 | #音视频 | #高效推理
评分:7.4/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shivanshu Shekhar:University of Illinois Urbana-Champaign;Adobe Research
- Raghavendra Addanki:Adobe Research
- Tong Zhang:University of Illinois Urbana-Champaign
- Uttaran Bhattacharya:Adobe Research
📌 核心摘要
联合音视频生成需从文本同时生成匹配的画面与声音,难点是文本与画面、文本与音频、音频与画面三组对齐须同时满足,而每次评估都消耗昂贵的模型前向计算。论文提出的Spend Where It Matters先用自适应粒子漏斗在去噪轨迹上全局搜索,按中间奖励筛选粒子并输出得分最高的完整样本,再以该样本为起点做短链Metropolis-Hastings局部扰动与重去噪。粒子阶段在有限预算内建立粗粒度结构,MH阶段在粗结构固定后优化细粒度对齐,两阶段共享同一个总前向次数预算。该方法免训练,推理开销以总前向次数计,音视频实验为360次中粒子搜索200次加MH精修160次,高预算为560次中粒子400次加MH160次。在JavisBench-Mini上,360次前向计算下SWIM以JavisDiT++为底座时七个指标平均相对提升30.7%超过Best-of-N、14.1%超过EvoSearch,以LTX-2为底座时平均相对提升9.2%超过Best-of-N、17.0%超过EvoSearch。高预算560次前向计算下,在JavisBench-Mini上七个指标平均相对增益为JavisDiT++上31.5%超过Best-of-N、13.5%超过EvoSearch,LTX-2上7.2%超过Best-of-N、10.9%超过EvoSearch。结论适用于预算受限的推理时对齐,在预算很大、均匀分配已能充分探索时自适应分配的额外收益会缩小。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. 混合音频里谁真谁假:语音和背景分开验的 TruMix 解读

英文题目:MixedTruth: Component-Level Detection of Synthetic Speech and Synthetic Background in Mixed Audio
标签:#音频深度伪造检测 | #Transformer | #基准测试 | #数据集 | #鲁棒性
评分:7.4/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xindong Zheng:Vanderbilt University
- Jiashu Zhu:Vanderbilt University
- Ke Li:Vanderbilt University
- Dan Lin:Vanderbilt University
📌 核心摘要
输入是可能同时含有人声与环境声的单声道录音,输出是对八种组合的归属判断,覆盖纯真人声、纯合成人声、纯真实背景、纯合成背景与四种混合真伪组合,难点在于两种成分可来自独立生成器且相互遮蔽。TruMix保留原始混合波形作为取证锚点,先用冻结的Conv-TasNet分离器估计人声与背景波形,再经短时傅里叶变换导出软比例掩码,将分离结果只作软证据而不当作真值。估计谱经掩码引导注意力送入语音谱分支与背景谱分支,两分支经双向交叉注意力交换不一致证据,其输出与原始波形另路提取的WavLM上下文表示和sinc滤波器伪影表示拼接融合。融合后的语音谱、背景谱、上下文与伪影四路表示经因子化存在与真伪头组装成八类分数,冻结分离器避免检测标签诱导任务特定的分解。在MixedTruth上TruMix八类宏平均单类对rest的曲线下面积(AUC)为98.51%,相对WavLM Base+八类头基线的94.11%有明确提升。含背景子集上TruMix二值AUC为95.622%,最强基线Nes2Net-X为78.086%。该结论适用于已验证的混合比与录制条件,压缩、混响、谱重叠与对抗后处理可抑制伪影或将其搬移到错误估计源,严重混响仍使误差升高,故其预测只作为需结合人工审查的取证信号。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. 长语音里既换声音又换说法:AegisVox 如何分开处理身份与病情

英文题目:AegisVox: Factorized Privacy and Clinical Preservation for Long-Form Speech
标签:#音频隐私攻击与防御 | #评测协议 | #语音编辑 | #医疗音频
评分:7.4/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Praphul Singh:机构信息未在 arXiv HTML 中可靠披露
- Akshat Agarwal:机构信息未在 arXiv HTML 中可靠披露
- Ratul Ghosh:机构信息未在 arXiv HTML 中可靠披露
- Aashna Kanuga:机构信息未在 arXiv HTML 中可靠披露
- Devashish Khatwani:机构信息未在 arXiv HTML 中可靠披露
- Anurag Dwarakanath:机构信息未在 arXiv HTML 中可靠披露
- Sri Gadde:机构信息未在 arXiv HTML 中可靠披露
- Krishnaram Kenthapadi:Oracle Health AI
📌 核心摘要
临床对话录音同时包含可识别身份的语音特征和说出的标识词,而停顿、纠正与说话人角色又有研究价值,直接发布原声或只做文本脱敏都难以兼顾。AegisVox输入完整对话波形,输出保留对话结构但更换说话人音色并替换标识词所在的完整话轮,难点在于长对话中同一说话人和同一实体多次出现,且替换实现、残留标识、说话人链接与临床证据损失相互牵连。系统先用自动语音识别与说话人分离得到分话轮文本,再为每位说话人分配固定公开替代声音并用SeedVC转换全部话轮;语言模型在整篇文本上生成统一实体替换计划,词法渲染器只重做含替换的话轮并拼回原对话。相对已有单轮编辑或纯声音匿名工作,该框架把声音路径与词法路径固定为共享对照,使两种渲染器差异可归因。在390段公开模拟或非患者对话共63.6小时的配对试验中,按601个共有计划替换意图统计替换实现率指标,F5-TTS实现535/601,高于VoiceCraft的453/601。同一配对试验中两者临床原子命题严格保留率指标相差-0.10个百分点,F5-TTS低于VoiceCraft,说明总体保留率相近。同一配对试验中模型标注的矛盾数指标F5-TTS为479/25778,高于VoiceCraft的391/25778,说明替换实现率提升不等于整体更安全。该结论仅适用于公开模拟或非患者对话及模型判读,未验证真实临床、穷尽标识清单和经转换语音训练的攻击者,且原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/spraphul/aegisvox — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. 把何时说话和说什么分开:全双工语音建模 Diffuplex 解读

英文题目:Full-duplex Spoken Language Modeling with Discrete Diffusion
标签:#全双工语音交互 | #语音对话系统 | #扩散模型 | #实时处理
评分:7.4/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Chen Chen:机构信息未在 arXiv HTML 中可靠披露
- Pin-Jui Ku:机构信息未在 arXiv HTML 中可靠披露
- Ankita Pasad:机构信息未在 arXiv HTML 中可靠披露
- Ante Jukić:机构信息未在 arXiv HTML 中可靠披露
- Zhehuai Chen:机构信息未在 arXiv HTML 中可靠披露
- Boris Ginsburg:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
全双工语音交互要求模型同时听懂连续到来的用户语音并决定何时接话,输出则是需要推理的完整回答文本与语音,输入是流式语音,输出是交互状态与语音回应,难点在于时机判断与语义生成互相牵制。Diffuplex先用语音编码器与投影层把语音接到文本离散扩散语言模型,经过语音转写对齐与口语指令跟随训练学会理解与回答,再冻结回答能力并增加自回归交互策略学习何时说话。与把时机与内容压缩到单一自回归时间线的已有全双工模型不同,该方法把何时说与说什么在训练与推理上解耦,使语义计算不再受感知音频帧率约束。推理时自回归分支按80毫秒音频块持续输出听、说与接管、让出状态,触发后扩散分支把已累积语音特征与提示一起预填充为条件,在256词元画布上并行去噪,前8个词元提前固定并送入语音合成器。在VoiceBench共9个子集的总体得分指标上,Stage-2响应生成器无思考模式为84.1,启用思考模式后为86.9,后者高于前者。在AlpacaEval上以批量1在单块NVIDIA GB300 GPU测得的解码效率比较中,每前向最终词元数指标上Diffuplex为13.0词元,高于所有自回归基线的1.00词元,解码吞吐指标上最高1872词元每秒,高于Nemotron-3 Omni的394词元每秒。该结论适用于英语为主的公开语音评测与论文给定的解码配置,早期固定前缀与Fisher会话数据的取舍会改变停顿处理与打断延迟,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://cchen1436.github.io/diffuplex-website → https://cchen1436.github.io/diffuplex-website/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
20. 把文字变成可导演的表演:Fish Audio Drama 3 解读

标签:#文本到语音 | #偏好优化 | #语音克隆 | #语音编辑 | #流式处理
评分:7.4/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Dawei Han:机构信息未在 arXiv HTML 中可靠披露
- Shidong Li:机构信息未在 arXiv HTML 中可靠披露
- Shijia Liao:机构信息未在 arXiv HTML 中可靠披露
- Jiahua Liu:机构信息未在 arXiv HTML 中可靠披露
- Songting Liu:机构信息未在 arXiv HTML 中可靠披露
- Qingzheng Wang:机构信息未在 arXiv HTML 中可靠披露
- Yuxuan Wang:机构信息未在 arXiv HTML 中可靠披露
- Xin Chen:机构信息未在 arXiv HTML 中可靠披露
- Yifan Cheng:机构信息未在 arXiv HTML 中可靠披露
- Tianyu Li:机构信息未在 arXiv HTML 中可靠披露
- Gangin Park:机构信息未在 arXiv HTML 中可靠披露
- Xuehao Yang:机构信息未在 arXiv HTML 中可靠披露
- Chang Zeng:机构信息未在 arXiv HTML 中可靠披露
- Haoyang Zhang:机构信息未在 arXiv HTML 中可靠披露
- Ruoyi Zhang:机构信息未在 arXiv HTML 中可靠披露
- Xiangyu Zhang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
Fish Audio Drama 3把文字变成带导演意图的表演,输入是目标文本、自然语言导演说明和参考音频,输出是对应说话人音色和表达方式的波形,难点在于长会话上下文很长、表达方式会合理偏离字面转写和中性音色。骨干网络读入系统指令、目标文本和已生成的音频帧,输出下一帧的语义码,码本多词元预测解码器再补齐该帧的九个声学码,音频分词器把十个码转成波形。所有任务写成同一词元流上的对话,损失只落在模型自己的回合,多轮修改、整场配音、中间填补和流式输入因此共用一套训练流程。相对上一代S2,细码本不再只经一个骨干状态传入,而是由全序列因果注意力直接读取,强化学习也去掉字错率和说话人相似度奖励,只用一个人类偏好模型打分。在MiniMax多语言集德语上,以词错率为指标,Drama 3为0.48%,低于Fish Audio S2的0.55%。推理开销方面,在一块H200上单流解码时,以每秒帧数为指标,Drama 3为271帧每秒,高于S2的177帧每秒,尽管其参数量超过七倍。该多语言错误率最低的结论仅适用于中文、荷兰语、英语、德语和土耳其语,在阿拉伯语等其余语言上并非表中最低,粤语等高错误率语言的导演意图跟随效果尚未验证。
🔗 开源资源
第三方资源:https://github.com/fishaudio/fish-speech — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/fishaudio/drama-3 — 暂时无法访问
第三方资源:https://fish.audio — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. 能边弹边换音色的流式神经合成器 LiveSynth

英文题目:LiveSynth: A Streaming Neural Synthesizer for Instrument Cloning and Text-to-Instrument
标签:#音乐生成 | #Transformer | #流式处理 | #实时处理
评分:7.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Kyungsu Kim:机构信息未在 arXiv HTML 中可靠披露
- Yejin Kim:机构信息未在 arXiv HTML 中可靠披露
- Kyogu Lee:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
已有可控合成器多为离线生成整段音频,无法跟随演奏实时响应,而可实时运行的方法又难以对未见音色做零样本控制。LiveSynth输入流式MIDI事件与由参考录音或文本提示经CLAP得到的逐帧音色嵌入,输出连续音频隐变量再转成波形,支持从参考录音克隆乐器、从文本生成乐器、音色渐变与空MIDI条件下的自主续奏。处理分三步衔接:先将MIDI事件对齐到100Hz帧率编码为逐帧嵌入并与音色嵌入结合,再由无反馈因果Transformer在不回喂已生成隐变量的情况下输出连续音频隐变量,最后由因果变分自编码器解码器每帧生成480个波形采样点,并以条件判别训练约束隐变量序列。与已有方法关键差异在于严格因果零前视与无反馈生成,避免误差累积并支持逐帧更新音色。在相同音高时值与48kHz重采样协议下530个NSynth片段零样本克隆评测中,LiveSynth多尺度频谱损失为13.1,低于TokenSynth的26.0和CTD的19.5,其MERT相似度0.540和PANNs相似度0.819均高于这两个同协议基线。在M3 MacBook Air上MLX int8推理路径下每10ms音频帧平均处理8.78ms,实时系数为0.88且算法延迟为10ms,满足实时交互要求。局限是音符F1与感知质量偏低,续奏音高延续较好但节奏延续性弱,且未经主观听感与演奏者验证。
🔗 开源资源
代码相关资源:https://kyungsukim42.github.io/livesynth-demo/ — 链接可访问(HTTP 200)
第三方资源:https://kyungsukim42.github.io/livesynth-demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
22. OpenSVBench:把说话人确认放在 11 种部署场景下统一诊断

英文题目:OpenSVBench: Diagnosing Speaker Verification Generalization Across Deployment Scenarios
标签:#说话人验证 | #基准设计 | #基准测试 | #鲁棒性
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Qituan Shangguan:机构信息未在 arXiv HTML 中可靠披露
- Bosen Xu:机构信息未在 arXiv HTML 中可靠披露
- Shuai Wang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
说话人验证的输入是注册语音与测试语音,输出是两者是否属于同一说话人的分数与判定,部署难点是注册与测试之间出现时长、距离、设备、噪声、重叠、语言与说话风格等失配,单一公开协议难以反映跨场景可靠性。OpenSVBench把16个公开来源整理为26个试次集与11个场景分组,共9,150,366个验证试次,其中目标试次1,104,504个、非目标试次8,045,862个,并冻结目标与非目标答案键、元数据与校验信息。构建时先按官方、过滤或重构方式固定各试次集的注册与测试语音及答案键,其输出再按部署位移归入跨语言、短时长、类型转换等场景组,形成场景画像与试次集明细两级单元。新系统提交各试次集的分数包,榜单用同一冻结答案键与计分流程先逐试次集阈值扫描计算等错误率与最小检测代价,再按来源均衡聚合为场景组指标与11组宏观平均分。在同一26个试次集与统一计分下对18个公开检查点的场景平均显示,类型转换组平均等错误率27.36%高于口音与方言组的24.76%,为固定核心中最难的两组。头部W2V-BERT2等系统宏观等错误率居前,但其类型转换场景仍在26%—27%左右,高于口音与方言场景的20%—22%左右,表明相近宏观分会掩盖不同失效模式。结论仅适用于该固定核心与统一余弦计分基线,场景组并非因果隔离且部分组依赖单一来源,同场景不同来源试次集仍可出现排序不一致,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/shangguanqituan/opensvbench-submission-kit — 链接可访问(HTTP 200)
第三方资源:https://opensvbench.xyz/ — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
23. SemiCodec:用半离散表示同时保留离散接口和高保真重建

标签:#语音编码 | #神经编解码与离散单元 | #知识蒸馏 | #变分自编码器
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kecan Mao:机构信息未在 arXiv HTML 中可靠披露
- Nan Xu:机构信息未在 arXiv HTML 中可靠披露
- Zhaoyang Meng:机构信息未在 arXiv HTML 中可靠披露
- Zhengyao Ma:机构信息未在 arXiv HTML 中可靠披露
- Yingming Gao:机构信息未在 arXiv HTML 中可靠披露
- Yi Zhao:机构信息未在 arXiv HTML 中可靠披露
- Ya Li:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音同时包含可离散化的语言内容和连续变化的说话人、韵律与声学细节,理想表示要同时给出紧凑的建模接口和忠实波形。已有全离散编解码器在低帧率下容易丢失细节,全连续隐变量则需要回归、流匹配或扩散等专用生成目标。SemiCodec 把输入波形编码为同步的单码本离散 token 与 64 维连续隐变量,两路映射到同一合成空间相加后由波形解码器重建。直接联合训练会让信息更丰富的连续通路形成重建捷径,使解码器忽视离散 token,论文因此采用先保留后接地的两阶段训练,先建好连续声学合成空间,再冻结声学部分并接入离散支路。与全离散基线相比,方法在保持每秒 25 帧离散接口的同时明显改善重建质量和可懂度。在 LibriSpeech test-other 上,SemiCodec 相对 SAC 的宽带 PESQ 从 2.39 提高到 4.03,词错率从 5.71% 降到 5.02%。结论适用于 24 kHz 英语朗读语音重建,尚未验证低资源语言、强噪声音乐或下游语言模型建模收益,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://pennyw1-se.github.io/SemiCodec-Demo-Page/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/ludlows/python-pesq → https://github.com/ludlows/PESQ — 链接可访问(HTTP 200)
第三方资源:https://github.com/mpariente/pystoi — 链接可访问(HTTP 200)
第三方资源:https://github.com/google/visqol — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
24. 在固定 token 预算下学会在哪里切分频带

英文题目:Learning Where to Split: Dynamic Band Splitting for Audio Source Separation
标签:#音频分离 | #动态计算与早退 | #音乐 | #语音
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Bingzhe Zhang:机构信息未在 arXiv HTML 中可靠披露
- Kai Li:机构信息未在 arXiv HTML 中可靠披露
- Xiaolin Hu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音频源分离(audio source separation,从混合录音恢复各声源波形)的输入是单声道或立体声混合波形的短时傅里叶变换(Short-Time Fourier Transform,STFT)复数语谱图,输出是各声源的复数掩码与波形,难点在于高频率分辨率语谱图直接送入分离器代价过高,而固定频带会把有判别力的成分合并或浪费分辨率。动态频带划分(Dynamic Band Splitting,DBS)把频率轴切成4个固定的频率块(frequency block),每个块分配固定的频带数量预算,在块内按内容预测边界概率并保留概率最高的若干位置,从而在频带总数不变时改变位置与宽度。选出的变宽频带经内容加权池化压缩为固定维数的频带token,该token序列直接送入BSRNN或TIGER等分离主干建模时间与频带间依赖,得到分离后的频带表示。分离表示经平滑后按同一划分扩展回STFT网格、再沿频率细化,最后由频率共享头预测复数掩码用于重建波形。与已有频带划分(band-split)方法的区别是边界由混合音频决定且端到端训练,同时保留STFT网格用于重建。在DnR v2上DBS-BSRNN的三声源平均尺度不变信号失真比(Scale-Invariant Signal-to-Distortion Ratio,SI-SDR)为9.07 dB,高于同为128频带的静态BSRNN的7.69 dB,提高1.38 dB;摘要报告相对原BSRNN的相对增益为29.0%。结论适用于固定token预算下的多主干与宽带、窄带数据,但未验证窗内逐帧自适应与可变频带数量,推理代价随边界预测与全分辨率重建上升。原文披露了参数量与每秒乘加数,未披露完整训练时长。
🔗 开源资源
代码相关资源:https://cslikai.cn/Dynamic-Band-Splitting → https://cslikai.cn/Dynamic-Band-Splitting/ — 暂时无法访问
第三方资源:https://zenodo.org/records/6949108 — 暂时无法访问
第三方资源:https://zenodo.org/records/3338373 — 暂时无法访问
第三方资源:https://huggingface.co/datasets/JusperLee/EchoSet — 暂时无法访问
演示资源:https://cslikai.cn/Dynamic-Band-Splitting → https://cslikai.cn/Dynamic-Band-Splitting/ — 暂时无法访问
第三方资源:https://github.com/ZFTurbo/Music-Source-Separation-Training/blob/main/configs/config_musdb18_bs_roformer_384_8_2_485100_sage.yaml — 暂时无法访问
第三方资源:https://github.com/ZFTurbo/Music-Source-Separation-Training/blob/main/configs/config_musdb18_mel_band_roformer_all_stems.yaml — 暂时无法访问
第三方资源:https://github.com/JusperLee/TIGER/blob/9f18d4a10a7137e1ce8052cfb62215179f1287b6/configs/tiger-small.yml — 暂时无法访问
第三方资源:https://github.com/JusperLee/TIGER/blob/9f18d4a10a7137e1ce8052cfb62215179f1287b6/look2hear/metrics/wrapper.py — 暂时无法访问
第三方资源:https://github.com/ZFTurbo/Music-Source-Separation-Training — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
25. TASTE:用分类体系把文字意图变成可控的钢琴符号生成

英文题目:TASTE: Taxonomy-Aware Symbolic Piano Generation from Textual Description
标签:#符号音乐生成 | #音乐结构分析 | #自回归模型 | #扩散模型 | #数据集构建
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mingyang Yao:University of California, San Diego;University of Rochester
- Jingyue Huang:University of California, San Diego
- Ke Chen:University of California, San Diego
- Taylor Berg-Kirkpatrick:University of California, San Diego
- Shlomo Dubnov:University of California, San Diego
📌 核心摘要
文本条件符号音乐生成要解决的输入是用户用自然语言表达的作曲意图,输出是可编辑的钢琴演奏MIDI,难点在于已有系统或用无约束标题,或只用调性速度等固定属性,难以同时表达客观属性与主观意象。TASTE(Taxonomy-Aware Symbolic Piano Generation from Textual Description,面向分类体系的文本描述符号钢琴生成框架)把输入分成标签、段落计划(section plan,有序段落标识与时长序列)与意象描述三个通道,分别对应全局离散属性、曲式随时间展开、场景氛围联想。标注流水线先在高质量配对层与策展层按通道取证,再用探针与检索改写向大规模公共层传播标签,形成总数432K的MIDI三层语料,其中高质量层9999首、策展层51130首、大规模层371053首。分阶段训练先在可直接估计的调性速度与段落计划上预训练,再依次引入弱标签、大规模策展标签与高质量配对精修,并在自回归解码器(autoregressive decoder,逐token依序生成序列的模型)与潜在扩散变换器(latent diffusion transformer,在连续隐空间去噪生成序列的模型)两类结构中保持通道分离。与标题条件基线相比,TASTE在100个保留提示、每提示8个采样的设置下把情感一致性从标题基线最高0.285提高到0.584左右,把CLaMP 3(Contrastive Language-Music Pretraining 3,音乐文本对比表示模型)文本音乐相似度从0.059提高到0.141。结论适用于所用钢琴语料与合成器渲染评测条件,伴奏与演奏风格仍受标签噪声限制。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://taste-piano.github.io/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
26. MSVAE:把作曲内容和歌词内容分开组织的音乐语义变分自编码器

英文题目:MSVAE: Rethinking Musical Semantics in Continuous Latent Spaces
标签:#歌唱生成 | #变分自编码器 | #音频编码 | #音乐分析 | #音乐
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Guobin Ma:机构信息未在 arXiv HTML 中可靠披露
- Yuepeng Jiang:机构信息未在 arXiv HTML 中可靠披露
- Dake Guo:机构信息未在 arXiv HTML 中可靠披露
- Huakang Chen:机构信息未在 arXiv HTML 中可靠披露
- Yuan Zhou:机构信息未在 arXiv HTML 中可靠披露
- Lingxin Xiong:机构信息未在 arXiv HTML 中可靠披露
- Wenkai Cheng:机构信息未在 arXiv HTML 中可靠披露
- Jingbin Hu:机构信息未在 arXiv HTML 中可靠披露
- Hanke Xie:机构信息未在 arXiv HTML 中可靠披露
- Chunbo Hao:机构信息未在 arXiv HTML 中可靠披露
- Wenhao Li:机构信息未在 arXiv HTML 中可靠披露
- Ziqian Ning:机构信息未在 arXiv HTML 中可靠披露
- Jixun Yao:机构信息未在 arXiv HTML 中可靠披露
- Jian Zhao:机构信息未在 arXiv HTML 中可靠披露
- Zhonglin Jiang:机构信息未在 arXiv HTML 中可靠披露
- Yong Chen:机构信息未在 arXiv HTML 中可靠披露
- Lei Xie:机构信息未在 arXiv HTML 中可靠披露
- Pengcheng Zhu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
输入是24 kHz立体声歌曲波形,输出是25 Hz的64维连续隐序列,难点在于纯重建训练的自编码器不组织旋律、和声与歌词语音内容,下游生成器既要学习分布又要猜测内容组织方式。音乐语义变分自编码器(Music Semantic Variational Autoencoder,MSVAE)先用冻结的MuQ第6层特征构造高斯分布的语义基,再用可训练声学编码器输出有界残差修正,由语义特征投影出的门控决定采纳多少声学细节。采样得到的隐变量被切成两个32维子空间,分别经帧级投影后与冻结的SheetSage主音加和声表示和冻结的FireRedASR编码器末层表示做余弦对齐,使作曲内容与语言发声内容各占一半通道。在45秒歌词到歌曲任务中,只用无时间音素前缀的MSVAE音素错误率为0.136,低于使用句子级时间戳条件的ACE-Step 1.5的0.141。在MUSDB18-HQ的24 kHz立体重建比较中,同为64维卷积变分自编码器的MSVAE感知语音质量评估为2.253,高于ACE-Step 1.5的1.912。适用范围包括有词歌曲与纯器乐,150秒长曲的可懂度会下降,第二阶段48 kHz输出只是解码器带宽细化。训练硬件为8张A100 80GB,原文未披露训练时长、推理延迟与部署成本。
🔗 开源资源
- 第三方资源:https://aslp-lab.github.io/MSVAE/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
27. 词从哪里开始到哪里结束:电话语音上的强制对齐

标签:#强制对齐 | #LoRA | #多语言 | #数据增强
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Husein Zolkepli:Scicom (MSC) Berhad, Malaysia
📌 核心摘要
强制对齐的输入是一段语音和已知文本,输出是每个词的开始与结束时间,难点在于电话信道的窄带与压缩会移动时间基准,而连读与静音让词界在信号上并不清晰。论文先实测各编解码器延迟并从标注中去除,再以LoRA微调Whisper预测每词起止时间戳,时间戳槽位放在被计时的词之后,训练中混入电话信道退化与文本噪声。与已有方法的关键差异是抛开沿CTC强制路径读边缘的做法,改为由解码器直接输出时间分布,避免词内多数帧归空白符导致的词首系统性偏晚。在干净TIMIT测试集上以平均绝对边界误差为指标计,时间戳模型为10.5 ms,低于MFA的19.1 ms。用FA-Bench协议与代码在TIMIT核心测试集上以平均绝对边界误差为指标计,时间戳模型为11.6 ms,低于已发表最优Olign的18.2 ms。在真实固话录制的Switchboard对话上以平均绝对边界误差为指标计,发布模型为16.0 ms,低于MFA的36.5 ms。结论适用于读句、访谈对话与电话语音,已验证韩语、荷兰语与VoxAngeles多语言上的迁移,但长录音与真实呼叫中心链路只做了初步检验。原文未披露训练、推理或部署成本。
🔗 开源资源
模型相关资源:https://huggingface.co/Scicom-intl/Where-Words-Begin-and-End-Whisper-Large-V3 — 暂时无法访问
模型相关资源:https://huggingface.co/Scicom-intl/Where-Words-Begin-and-End-Whisper-Large-V3-Turbo — 暂时无法访问
模型相关资源:https://huggingface.co/collections/Scicom-intl/force-alignment — 暂时无法访问
第三方资源:https://huggingface.co/Scicom-intl/CallEnhancer — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
28. 从波形直接估计发声参数:自监督源-滤波器网络 SoFilNet 解读

英文题目:Self-Supervised Source-Filter Model of Speech Production
标签:#语音属性识别 | #自监督学习 | #信号处理 | #发声与构音
评分:7.3/10 | 创新 1.6/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Nani Meka:机构信息未在 arXiv HTML 中可靠披露
- Raghavan Ramesh:机构信息未在 arXiv HTML 中可靠披露
- Sri Rama Murty Kodukula:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音由声门激励源经过时变声道滤波产生,输入是原始波形,输出是每10 ms一帧的源参数与滤波器参数,难点是两者在单通道频谱中相互纠缠且共振峰只在谐波处被观测。所提源-滤波器网络用卷积循环网络直接预测基频、清浊、5个频带非周期性、有序共振峰极点、额外极点与零点,再经可微合成器重建频谱与波形。多分辨率编码器并行提取13 ms至53 ms感受野特征并按源与系统分别加权,源解码器与系统解码器分开估计激励与声道,自相关伪标签、频带周期占比与频谱对比度分别约束F0、非周期性与共振峰锐度。与已有先逆滤波再估计共振峰或用外部F0的做法不同,该模型把两部分放在同一重建目标下联合学习。在VTR-FORMANTS全部语音帧去静音评测中按F1-F3平均均方根误差比较,SoFilNet为158 Hz,低于有监督DF-RNN的163 Hz。在全部20位说话人的PTDB-TUG跨语料评测中按F0帧错误率比较,SoFilNet为5.06%,低于有监督CREPE的6.70%。结论适用于健康成人朗读语音,快速爆破、病理、儿童与强噪声语音尚未验证;原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://nani-meka.github.io/sofilnet-samples/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
29. 在 5 美元单片机上跑开放词汇英语识别:Oído 如何放下 13M 参数 Conformer
英文题目:Oído: Open-Vocabulary Speech Recognition on a $5 Microcontroller without a Neural Accelerator
标签:#语音识别 | #模型量化 | #端侧运行 | #流式处理
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.1/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Daniel Varela Sánchez:机构信息未在 arXiv HTML 中可靠披露
- Guillermo Martín-Coello Juárez:Lokutor (Hashing Works, S.L.L.), Madrid, Spain
📌 核心摘要
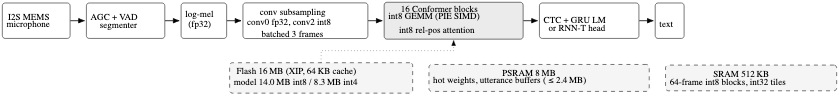
开放词表识别要求把整段语音转写为任意文本,难点在于常用模型体积大、访存多,而目标芯片片内静态随机存取存储器小、闪存读取慢且没有加速器。输入的麦克风音频先经过语音活动检测切分语句,再提取对数梅尔特征并送入编码器与解码器,输出文本显示在屏幕或串口。编码器按语句一次处理全部帧,线性层采用逐输出通道对称整数量化并在运行时按帧计算激活缩放,注意力分数与加权求和也保持整数点积。执行时按帧块复用权重并分块累加长归约维度,解码可用贪婪连接时序分类、门控循环单元语言模型浅融合或传感器换能器头。与同芯片厂商识别器相比,本文整数量化系统在LibriSpeech test-clean集词错率为3.70%,而厂商报告为8.5%。推理开销在240MHz ESP32-S3单核上实测为音频时长的1.97倍,4秒语音约8.7秒后给出文本,慢于实时。部署上该13M参数整数量化模型占闪存14.0MB,另需语言模型1.3MB。结论适用于英语短语句和西班牙语模型,混响、多人babble噪声下错误明显上升。
🔗 开源资源
第三方资源:https://github.com/lokutor-ai/oido — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/lokutor-ai — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
30. 把不同模态都写成比特再一起生成:连续比特流扩散的多模态共生成

英文题目:Multimodal Co-Generation With Continuous Bitstream Diffusion
标签:#文本到语音 | #扩散模型 | #语音识别 | #多模态学习 | #语音
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Georgios Batzolis:机构信息未在 arXiv HTML 中可靠披露
- Georgios Kontos:机构信息未在 arXiv HTML 中可靠披露
- Bruno Trentini:机构信息未在 arXiv HTML 中可靠披露
- Pranam Chatterjee:机构信息未在 arXiv HTML 中可靠披露
- Micha Livne:机构信息未在 arXiv HTML 中可靠披露
- Mark Girolami:机构信息未在 arXiv HTML 中可靠披露
- Luca Ambrogioni:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
多模态生成需要同时处理离散符号与连续信号,常见做法是为每个模态设计编码器、隐空间或目标,新增配对就要新增接口。论文把每个模态先写成固定二进制码,拼接成一条共享比特流,再用同一个连续高斯扩散过程加噪与去噪,训练时用掩码决定哪些比特保持干净作为条件、哪些比特加噪作为生成目标。去噪器输出每个干净比特取真值的概率,其对数概率结合解析的单比特后验与学习的跨比特残差,采样时固定条件比特并行更新其余比特。相对已有混合自回归加掩码扩散或模态专用隐扩散方案,该方法把模态差异限制在冻结分词器与版式中,去噪主干、输入投影、按位预测头与二值分数匹配目标完全共享。在LibriSpeech-PC上生成1,024个样本的联合生成评测中,CoBit-MLS的WER为3.5,低于同表CoBit-LibriTTS的19.9。在LibriSpeech-PC test-clean文本到语音评测中,CoBit-MLS的CER为4.1,低于SpiritLM-Base的6.7。语音识别与主题延续仍弱于同类基线,适用范围限于已训练的任务混合与编解码器保真度之内。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/GBATZOLIS/BitstreamDiffusion — 链接可访问(HTTP 200)
第三方资源:https://demo-2546.github.io/cobit-text-audio-samples/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
31. 流式说话人匿名化如何在保留情感的同时隐藏身份

标签:#说话人匿名化 | #语音转换 | #自回归模型 | #神经编解码与离散单元 | #流式处理
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Yejin Kim:机构信息未在 arXiv HTML 中可靠披露
- Kyungsu Kim:机构信息未在 arXiv HTML 中可靠披露
- Seungu Han:机构信息未在 arXiv HTML 中可靠披露
- Kyogu Lee:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
说话人匿名化要求输入源语音,输出隐藏说话人身份但保留语言内容与情感的语音,难点在于内容、情感与身份在声学中耦合,且流式处理只能利用有限历史与有界延迟。冻结的流式Zipformer编码器从源语音抽取内容特征,经线性投影与前移对齐后,输出逐层特征调制参数以控制因果变换器解码器各层。3秒目标参考语音经JHCodec编码为离散声学令牌,与该参考段对齐的内容特征配对后,一起预填入解码器键值缓存,构成同一自回归声学流的前缀。解码器以该前缀为起点,在源语音内容特征持续调制输入下延续预测源内容对应的声学令牌,其中受限残差向量量化只对粗码本保留交错延迟、其余码本并行预测,所得令牌再送入编解码器解码器重建为波形。与依赖离散内容瓶颈或额外情感建模的已有流式系统不同,该系统不做情感监督而保留编码器中的副语言信息。在VPC24固定目标设置下,LiveAnon相对同设置的Stream-Voice-Anon在半知情等错误率上从15.92升至32.28,可懂度词错误率从4.54降至4.31,情感保留也同步改善。原文披露了编码器分块、内容对齐前视与码本延迟构成的算法延迟,以及单卡训练与实时率测量,固定单目标与低延迟编码器替换仍是未验证范围。
🔗 开源资源
- 演示资源:https://jin1025.github.io/LiveAnon/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
32. 长音频时间理解:用证据约束抑制幻觉的强化学习

英文题目:ATTEST: Evidence-Grounded Reinforcement Learning for Long-Audio Temporal Understanding
标签:#音频时间定位 | #强化学习 | #基准测试 | #长音频处理 | #幻觉与忠实度
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ashutosh Chaubey:Meta Superintelligence Labs;University of Southern California
- Jinxi Guo:Meta Superintelligence Labs
- Minh Tran:Meta Superintelligence Labs
- Michael Andersland:Meta Superintelligence Labs
- Ozlem Kalinli:Meta Superintelligence Labs
📌 核心摘要
长音频时间理解要求模型聆听连续长录音并输出每个声音事件的起止时间与文字描述,输出为包含众多三元组的长序列,难点在于标注稀缺且模型易依据语言先验编造不存在的事件。论文构建人工核验基准EgoSCAPE,利用真实自我中心音频提供稠密描述、声源标注、音频时间线和时间定位查询,训练仅更新权重而不改变架构或词表。ATTEST先用反事实奖励检验预测的声学依据,将声称时间段被静音干预后仍然存活的预测判定为缺乏证据并惩罚,再用注意力密度奖励鼓励生成每个三元组时集中关注其声称时间段对应的音频词元。随后框架把反事实、注意力密度与分段匹配三类分段奖励换算成词元级优势,对长稠密描述做细粒度信用分配,并用带KL约束的裁剪目标优化策略,相对密集插入时间标记的做法不占用额外上下文,避免上下文膨胀和通用理解能力遗忘。在EgoSCAPE稠密描述评测中,同基座Qwen2.5 Omni加ATTEST的指标FENSE@0.5为0.427,高于同基座TimePro-RL的0.410。在同一EgoSCAPE稠密描述评测中,同基座Qwen2.5 Omni加ATTEST的指标Hal%为30.5%,低于同基座TimePro-RL的31.3%。结论适用于真实长音频的稠密描述、时间线生成和零样本时间定位,合成拼接长音频训练效果较差,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://www.deepspeed.ai/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
33. 从 210 万小时广播音频做芬兰语语音自监督:质量筛选与编码器比较

标签:#语音识别 | #自监督学习 | #Conformer | #预训练
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Yaroslav Getman:机构信息未在 arXiv HTML 中可靠披露
- Tamás Grósz:机构信息未在 arXiv HTML 中可靠披露
- Tommi Lehtonen:机构信息未在 arXiv HTML 中可靠披露
- Mikko Kurimo:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
芬兰语广播存档规模大但混杂音乐、广告、非语音和多语言片段,现有做法多用语音活动检测或语言识别保留语音,缺少按质量筛选的研究。论文以210万小时原始广播音频及VoxPopuli芬兰语部分、议会和Lahjoita puhetta数据为输入,在wav2vec 2.0框架下预训练可用于识别微调的语音表示。语音活动检测先将原始音频切分为最长30秒片段得到120万小时语音,其转录文本作为后两步的依据。芬兰语识别模型对片段转录后按相同文本去重至89万小时,去除重复广告和台标等内容,去重后文本再用于计算字符级识别置信度。置信度过滤以阈值保留高分片段至47.1万小时,该子集直接作为各编码器预训练数据,用于比较Transformer与卷积增强结构的差异。与只做语言识别过滤相比,置信度过滤在Base规模识别微调中带来3%到7%的相对词错率下降,且最终数据约99%为芬兰语。在6个芬兰语测试集上,Base规模卷积增强编码器比Transformer相对词错率降低最高约37%,而X-Large规模差距缩小。结论适用于含噪多语言广播存档的芬兰语预训练,跨语言效果未经验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/aalto-speech/large-scale-monolingual-speech-foundation-models — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/speechbrain/lang-id-voxlingua107-ecapa — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
34. 边说边执行又要能撤回:RASSG 如何处理语音中的自我修正

英文题目:RASSG: Repair-Aware Semantic Survival Gating for Streaming Tool Execution
标签:#语音代理规划与工具使用 | #不确定性估计与校准 | #语音 | #流式处理 | #数据集
评分:7.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Daijin Hu:Beihang University
- Xi Wang:Beihang University
📌 核心摘要
流式语音助手在用户说完之前启动工具,把语音理解与任务执行重叠以减少等待,但用户随后修正参数会使已启动版本与最终意图不一致,一旦越过不可逆期限就会留下陈旧执行。修复感知语义存活门控先观察连续三次实际语音识别到达的参数是否相同且非空,满足条件才启动工具,形成进入执行期的当前版本。执行期间因果门控循环单元结合置信度、解析历史、前缀文本、停顿与版本年龄,预测当前参数被后续修正替代的风险并经校准输出。控制器在最后可行时刻结合该风险、由取消窗口与完成时间决定的不可逆期限,以及取消代价与可复用进度决定是否取消,若新参数及时到达则更新执行版本并保留原有管线进度。与仅在替代参数到达后才撤回的方法不同,该方法可在新参数解析完成前主动干预,并允许及时更新保留原有执行进度。在包含后续修复的ReCAST测试子集上,RASSG相对相同初始启动但无主动取消的对照,把陈旧执行率从49.92%降至3.15%,成功轨迹平均延迟从4.434 s降至3.676 s。结论限于固定工具耗时、取消窗口和确认延迟的受控合成与公开语音评测,公开语音中前端解析错误仍是主要残留来源。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/daijinhu/RASSG — 链接可访问(HTTP 200)
数据相关资源:https://github.com/daijinhu/RASSG — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
35. 在不动结构的前提下给文本模型加上图像和音频理解
英文题目:Apertus 1.5: From Open Text Models to Open Multimodal Reasoners
标签:#音频理解 | #多模态学习 | #多模态模型 | #模型权重 | #多语言
评分:7.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1.5/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Project Apertus:机构信息未在 arXiv HTML 中可靠披露
- Yixuan Xu:机构信息未在 arXiv HTML 中可靠披露
- Yassine Turki:机构信息未在 arXiv HTML 中可靠披露
- Vinko Sabolčec:机构信息未在 arXiv HTML 中可靠披露
- Valentina Pyatkin:机构信息未在 arXiv HTML 中可靠披露
- Tommy Chu:机构信息未在 arXiv HTML 中可靠披露
- Sven Najem-Meyer:机构信息未在 arXiv HTML 中可靠披露
- Sean F. Carroll:机构信息未在 arXiv HTML 中可靠披露
- Robert Smith:机构信息未在 arXiv HTML 中可靠披露
- Raphael Kreft:机构信息未在 arXiv HTML 中可靠披露
- Oscar Alessandro Tazza:机构信息未在 arXiv HTML 中可靠披露
- Oleg Lavrovsky:机构信息未在 arXiv HTML 中可靠披露
- Nicola Irmiger:机构信息未在 arXiv HTML 中可靠披露
- Matteo Santelmo:机构信息未在 arXiv HTML 中可靠披露
- Marian Schneider:机构信息未在 arXiv HTML 中可靠披露
- Juan García Giraldo:机构信息未在 arXiv HTML 中可靠披露
- Hanna Yukhymenko:机构信息未在 arXiv HTML 中可靠披露
- Eduard Ďurech:机构信息未在 arXiv HTML 中可靠披露
- Davit Melikidze:机构信息未在 arXiv HTML 中可靠披露
- Dani Tamayo:机构信息未在 arXiv HTML 中可靠披露
- Bettina Messmer:机构信息未在 arXiv HTML 中可靠披露
- Aryan Ahadinia:机构信息未在 arXiv HTML 中可靠披露
- Anunay Yadav:机构信息未在 arXiv HTML 中可靠披露
- Allen Huang:机构信息未在 arXiv HTML 中可靠披露
- Ahmad Fraij:机构信息未在 arXiv HTML 中可靠披露
- Alessandro Bombarda:机构信息未在 arXiv HTML 中可靠披露
- Alex Padula:机构信息未在 arXiv HTML 中可靠披露
- Alexander Hägele:机构信息未在 arXiv HTML 中可靠披露
- Alexander Sternfeld:机构信息未在 arXiv HTML 中可靠披露
- Anna Hedström:机构信息未在 arXiv HTML 中可靠披露
- Anna Kosovskaia:机构信息未在 arXiv HTML 中可靠披露
- Arthur Wuhrmann:机构信息未在 arXiv HTML 中可靠披露
- Arundhati Balasubramaniam:机构信息未在 arXiv HTML 中可靠披露
- Badr Al Mahouri:机构信息未在 arXiv HTML 中可靠披露
- Barna Pasztor:机构信息未在 arXiv HTML 中可靠披露
- Bartosz Szostakiewicz:机构信息未在 arXiv HTML 中可靠披露
- Bich Ngoc Doan:机构信息未在 arXiv HTML 中可靠披露
- Bryan Schmid:机构信息未在 arXiv HTML 中可靠披露
- Burak Sezen:机构信息未在 arXiv HTML 中可靠披露
- Camille Challier:机构信息未在 arXiv HTML 中可靠披露
- Clément Charmillot:机构信息未在 arXiv HTML 中可靠披露
- Dana Shayakhmetova:机构信息未在 arXiv HTML 中可靠披露
- Daniel Perruchoud:机构信息未在 arXiv HTML 中可靠披露
- David Brüggemann:机构信息未在 arXiv HTML 中可靠披露
- David Isztl:机构信息未在 arXiv HTML 中可靠披露
- Elia Palme:机构信息未在 arXiv HTML 中可靠披露
- Emma Anastassova:机构信息未在 arXiv HTML 中可靠披露
- Fabian Bösch:机构信息未在 arXiv HTML 中可靠披露
- Faruk Zahiragić:机构信息未在 arXiv HTML 中可靠披露
- Fawzi Roberto Mohamed:机构信息未在 arXiv HTML 中可靠披露
- Fiona Panicali:机构信息未在 arXiv HTML 中可靠披露
- Florian Kolly:机构信息未在 arXiv HTML 中可靠披露
- Flynn Guerra:机构信息未在 arXiv HTML 中可靠披露
- Francesco Monti:机构信息未在 arXiv HTML 中可靠披露
- Frederike Lübeck:机构信息未在 arXiv HTML 中可靠披露
- Gennaro Oliva:机构信息未在 arXiv HTML 中可靠披露
- Haofeng Yang:机构信息未在 arXiv HTML 中可靠披露
- Haoliang Shang:机构信息未在 arXiv HTML 中可靠披露
- Helen El Khoury:机构信息未在 arXiv HTML 中可靠披露
- Henrique Mendonça:机构信息未在 arXiv HTML 中可靠披露
- Jannis Vamvas:机构信息未在 arXiv HTML 中可靠披露
- Jérome Landolt:机构信息未在 arXiv HTML 中可靠披露
- Jessica Lam:机构信息未在 arXiv HTML 中可靠披露
- Jingchun Xiao:机构信息未在 arXiv HTML 中可靠披露
- Jonathan Coles:机构信息未在 arXiv HTML 中可靠披露
- Joshua Oyebanji:机构信息未在 arXiv HTML 中可靠披露
- Khanh Nguyen:机构信息未在 arXiv HTML 中可靠披露
- Konstantinos Pitas:机构信息未在 arXiv HTML 中可靠披露
- Lasse B. Strand:机构信息未在 arXiv HTML 中可靠披露
- Li Mi:机构信息未在 arXiv HTML 中可靠披露
- Loïc Deslarzes:机构信息未在 arXiv HTML 中可靠披露
- Lorenzo Baggi:机构信息未在 arXiv HTML 中可靠披露
- Lorenzo Noci:机构信息未在 arXiv HTML 中可靠披露
- Luca Baumann:机构信息未在 arXiv HTML 中可靠披露
- Luca Sartori:机构信息未在 arXiv HTML 中可靠披露
- Lukas Drescher:机构信息未在 arXiv HTML 中可靠披露
- Marco De Negri:机构信息未在 arXiv HTML 中可靠披露
- Marco Passerini:机构信息未在 arXiv HTML 中可靠披露
- Mark Klein:机构信息未在 arXiv HTML 中可靠披露
- Marko Stojanovic:机构信息未在 arXiv HTML 中可靠披露
- Martin Majsec:机构信息未在 arXiv HTML 中可靠披露
- Matin Ansaripour:机构信息未在 arXiv HTML 中可靠披露
- Mattea Busato:机构信息未在 arXiv HTML 中可靠披露
- Mauro Pellonara:机构信息未在 arXiv HTML 中可靠披露
- Max Neuwinger:机构信息未在 arXiv HTML 中可靠披露
- Michael Graber:机构信息未在 arXiv HTML 中可靠披露
- Michal Tešnar:机构信息未在 arXiv HTML 中可靠披露
- Michelle Wastl:机构信息未在 arXiv HTML 中可靠披露
- Miguel Gila:机构信息未在 arXiv HTML 中可靠披露
- Mikolaj Boronski:机构信息未在 arXiv HTML 中可靠披露
- Morgane Magnin:机构信息未在 arXiv HTML 中可靠披露
- Moritz Reihs:机构信息未在 arXiv HTML 中可靠披露
- Mukhammadali Sayfiddinov:机构信息未在 arXiv HTML 中可靠披露
- Nathan Ranchin:机构信息未在 arXiv HTML 中可靠披露
- Nicolas Cuveillier:机构信息未在 arXiv HTML 中可靠披露
- Oscar Wohlfahrt:机构信息未在 arXiv HTML 中可靠披露
- Qianqian Zou:机构信息未在 arXiv HTML 中可靠披露
- Rada Kamysheva:机构信息未在 arXiv HTML 中可靠披露
- Rita Sevastjanova:机构信息未在 arXiv HTML 中可靠披露
- Roman Machacek:机构信息未在 arXiv HTML 中可靠披露
- Sebastian Keller:机构信息未在 arXiv HTML 中可靠披露
- Simon Matrenok:机构信息未在 arXiv HTML 中可靠披露
- Simon Pierre:机构信息未在 arXiv HTML 中可靠披露
- Stefano Schuppli:机构信息未在 arXiv HTML 中可靠披露
- Suei-Wen Chen:机构信息未在 arXiv HTML 中可靠披露
- Szabina Horváth-Mikulas:机构信息未在 arXiv HTML 中可靠披露
- Taliesin Perez:机构信息未在 arXiv HTML 中可靠披露
- Thilo Spinner:机构信息未在 arXiv HTML 中可靠披露
- Thomas Kleine Buening:机构信息未在 arXiv HTML 中可靠披露
- Tim Robinson:机构信息未在 arXiv HTML 中可靠披露
- Tymoteusz Kwiecinski:机构信息未在 arXiv HTML 中可靠披露
- Vilém Zouhar:机构信息未在 arXiv HTML 中可靠披露
- Vinzenz Thoma:机构信息未在 arXiv HTML 中可靠披露
- Xiaozhe Yao:机构信息未在 arXiv HTML 中可靠披露
- Yannick Metz:机构信息未在 arXiv HTML 中可靠披露
- Yuhei Fukuhara:机构信息未在 arXiv HTML 中可靠披露
- Yusif Askari:机构信息未在 arXiv HTML 中可靠披露
- Zixuan Chen:机构信息未在 arXiv HTML 中可靠披露
- Alexander Ilic:机构信息未在 arXiv HTML 中可靠披露
- Ana Klimovic:机构信息未在 arXiv HTML 中可靠披露
- Andreas Krause:机构信息未在 arXiv HTML 中可靠披露
- Andrei Kucharavy:机构信息未在 arXiv HTML 中可靠披露
- Elliott Ash:机构信息未在 arXiv HTML 中可靠披露
- Joost VandeVondele:机构信息未在 arXiv HTML 中可靠披露
- Martin Rajman:机构信息未在 arXiv HTML 中可靠披露
- Mennatallah El-Assady:机构信息未在 arXiv HTML 中可靠披露
- Thomas Schulthess:机构信息未在 arXiv HTML 中可靠披露
- Timo Kehrer:机构信息未在 arXiv HTML 中可靠披露
- Torsten Hoefler:机构信息未在 arXiv HTML 中可靠披露
- Antoine Bosselut:机构信息未在 arXiv HTML 中可靠披露
- Martin Jaggi:机构信息未在 arXiv HTML 中可靠披露
- Imanol Schlag:机构信息未在 arXiv HTML 中可靠披露
原作者元数据中有 1 项仅为分隔标点,未列为作者;其他作者与机构按原来源记录展示。
📌 核心摘要
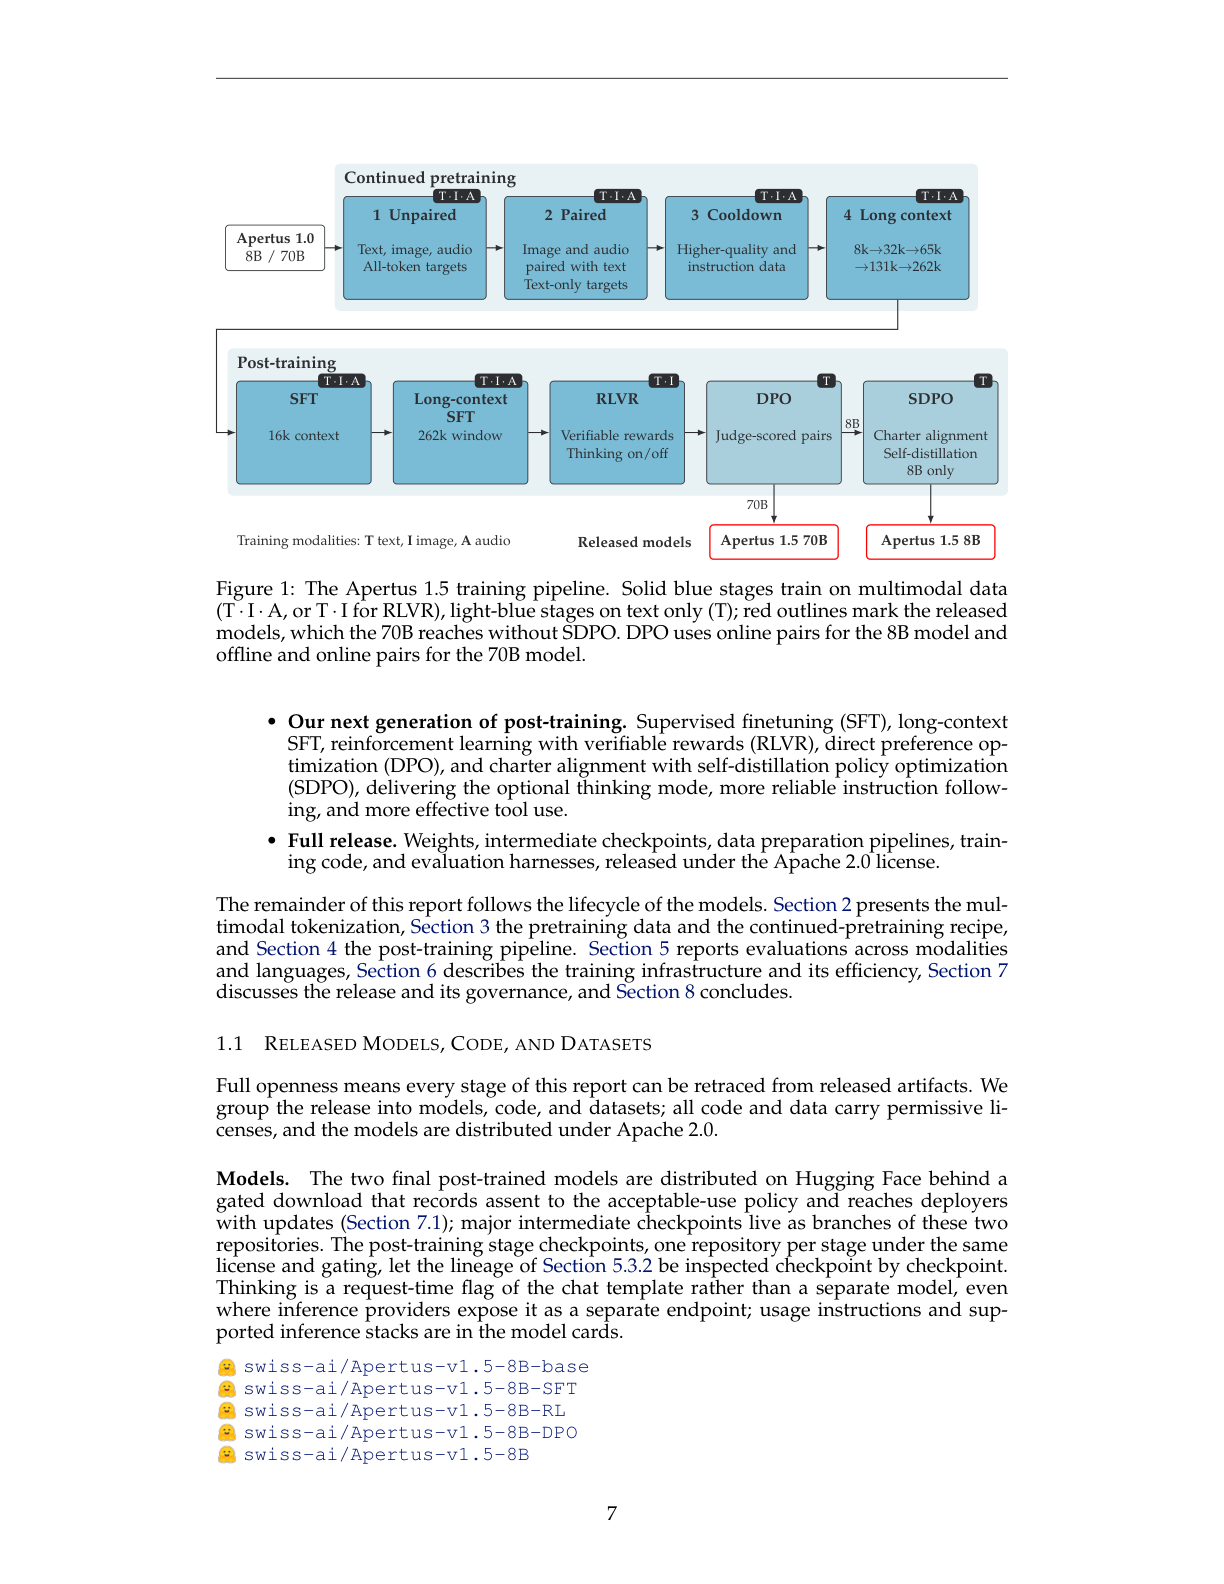
Apertus 1.5要解决的是把完全开放的Apertus 1.0文本模型原地升级为能理解图像和音频、只输出文本的多模态推理助手,输入是文本与离散化图像码和音频码,难点是在学到新模态与语言对齐时不丢失文本能力。继续预训练从8B和70B检查点出发,先做非配对全标记预测学模态表示,再做配对文本目标预测学跨模态对齐,经冷却和长上下文扩展后得到多模态基座,8B新增约4T标记、70B新增约2T标记。该基座进入后训练,先经监督微调学出按聊天模板回应并以开关控制思考痕迹输出的助手行为,再以可验证奖励强化学习和直接偏好优化对齐偏好,8B另做章程自蒸馏,思考中调用工具的组合在发布模型中尚未实现。与保留架构、只扩展词表和嵌入的做法相比,关键差异是多模态经由分词器进入、语言模型头仍只输出文本,因而复用文本推理链而无须单独解码头。在表23的8B组发布评测且所有模型均关闭思考模式下,指令遵循指标IFEval按提示级严格准确率计,Apertus 1.5 8B为87.1%高于前代Apertus 1.0 8B的68.4%。在表35贪婪解码的音频评测中,英语识别指标词错率越低越好,LibriSpeech test-clean上Apertus 1.5 8B为6.6%高于即差于Kimi-Audio的1.3%。训练成本方面,报告估计继续预训练与扩展合计约200万卡时、约1.1 GWh,Alps机房用水电与湖水冷却,短式事实问答幻觉未改善。
🔗 开源资源
- 第三方资源:https://apertus-ai.org — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
36. 用一句话查询找回同一类所有声源:QC-MI-OVSEL 任务与 Q-RSet

英文题目:QC-MI-OVSEL: Benchmarking Query-Conditioned Multi-Instance Open-Vocabulary Sound Event Localization
标签:#联合声音事件检测定位 | #基准设计 | #基准测试 | #空间音频信号
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yongqiang Chen:机构信息未在 arXiv HTML 中可靠披露
- Peiwei Chang:机构信息未在 arXiv HTML 中可靠披露
- Yuelan Cheng:机构信息未在 arXiv HTML 中可靠披露
- Xiatian Zhu:机构信息未在 arXiv HTML 中可靠披露
- Wenwu Wang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
输入是四通道一阶 Ambisonics场景录音和类别级自然语言查询,输出是当前帧所有类别匹配且处于活动状态的物理源无序集合,包含每源活动判断和三维方向,查询类别缺席时应输出空集。难点在于同查询多源具有独立活动和方向,系统需同时完成源发现、时变计数估计、完整集合恢复和缺席抑制,并泛化到未见类别与改述查询。Q-RSet先用查询相关性加权声学表征形成共享记忆,再用三个可学习源槽经查询调制与交叉注意力形成候选源假设,最后按非互斥责任权重汇聚各假设的帧级证据并输出活动与方向。相对先做与查询无关的声事件检测定位再做语义过滤,以及直接回归多轨活动与方向的做法,该模型把查询条件作用于表征与假设两级,并为每假设单独组织证据。在规范测试集上,Q-RSet的F1为50.36%,高于OVSELD-Adapt的47.12%,定位召回、计数误差、完整集合恢复和缺席误报也同时占优。上述结论适用于10秒合成一阶Ambisonics场景、每帧至多三个同查询目标、80,000个现存与缺席均衡查询视图的评测条件;未见类别、改述查询和高并发下发现与计数明显受损,已恢复源的方向误差变化较小,真实采集场景与更大并发仍未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
37. 不用强制对齐怎么做单词和语句两级发音评分

标签:#发音评估 | #端到端学习 | #LoRA | #病理语音评估
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Fu-An Chao:机构信息未在 arXiv HTML 中可靠披露
- Bi-Cheng Yan:机构信息未在 arXiv HTML 中可靠披露
- Berlin Chen:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
自动发音评估需要对朗读和自由作答语音给出词级和utterance级发音分数,开放作答缺少人工文本且缺少细粒度标注数据是主要难点。OpenPA输入语音和教师强制文本,在每个词最后一个子词后插入特殊<score>标记,用该位置解码器隐状态经交叉注意力汇聚声学证据并回归词级分数。词表示再经单层Transformer编码器上下文化和方面特定注意力池化得到utterance表示并回归utterance分数。混合文本适配以0.5、0.3、0.2概率采样标准文本、L2适配ASR文本和通用ASR文本进行训练,并用Levenshtein对齐迁移人工分数,对替换词按参考词准确度加权以突出真实发音偏差。在speechocean762模拟开放作答条件下,Qwen3-ASR-0.6B文本上OpenPA全适配词级准确度皮尔逊相关系数为0.544,高于仅用标准文本训练的0.452,指标越高越好。该结论仅适用于仅用speechocean762训练后的域内闭式与模拟开放评估,以及MultiPA五十句人机对话语音的零样本迁移,标准文本下流利度和韵律略逊于HiPPO*,会话域偏移下词级和韵律相关仍偏低。口腔癌98句21人的跨任务评估仅为探索性零样本检验,临床有效性尚未确立。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/fuann/open-apa — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
38. 先想好声音再说话:VoTSpeech 把声音设计与语音生成分开

英文题目:VoTSpeech: Decoupling Voice Design from Speech Generation in Instruction-Following TTS
标签:#文本到语音 | #韵律与风格控制 | #流匹配 | #大语言模型
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Wenbing Yang:机构信息未在 arXiv HTML 中可靠披露
- Qihang Lu:机构信息未在 arXiv HTML 中可靠披露
- Zihan Sun:机构信息未在 arXiv HTML 中可靠披露
- Peilei Jia:机构信息未在 arXiv HTML 中可靠披露
- Yingming Gao:机构信息未在 arXiv HTML 中可靠披露
- Ya Li:机构信息未在 arXiv HTML 中可靠披露
- Jun Gao:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
指令跟随语音合成(文本到语音,TTS)的输入是语音设计指令与待合成文本,输出是符合描述的语音波形,难点在于没有参考音频时需要从文字构造目标音色与表达方式。VoTSpeech先用因果大语言模型(大语言模型,LLM)读入指令,在特殊标记处得到指令状态,再用语音扩散变换器(Voice DiT)从噪声采样出连续语音隐变量。该隐变量一路转为前缀嵌入放在合成文本之前引导自回归序列建模,另一路转为全局向量引导声学扩散变换器(Acoustic DiT)渲染声学隐变量,最后由音频变分自编码器(变分自编码器,VAE)解码为波形。与把指令直接当上下文微调的做法不同,该工作显式预测可复用的语音中间表示,并用说话人嵌入与池化后声学特征联合监督。在InstructTTSEval-ZH中文子集上,VoTSpeech在描述性风格指令上准确率为78.5%,高于直接微调基线,同时主观表达与指令遵循得分居首。该结论适用于中文指令下由整体音色与风格描述驱动的合成;由于语音隐变量经时间池化后不保留帧级细节,局部音高轮廓与节奏仍依赖语言模型序列建模,且未解耦的池化声学特征偶尔会混入环境录制特征,在此类要求下可能失败,跨语种与跨录制条件范围尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/ywbn/VoTSpeech — 暂时无法访问
模型相关资源:https://github.com/ywbn/VoTSpeech — 暂时无法访问
第三方资源:https://github.com/ywbn/VoTSpeech — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
39. 小参数语音克隆如何补上自然感:Audio8-TTS 的三阶段训练

英文题目:Training a Compact, Strong, and Realistic Text-to-Speech Model
标签:#语音克隆 | #文本到语音 | #偏好优化 | #自回归模型
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Runyuan Cai:机构信息未在 arXiv HTML 中可靠披露
- Yu Lin:机构信息未在 arXiv HTML 中可靠披露
- Yiming Wang:机构信息未在 arXiv HTML 中可靠披露
- Xiaodong Zeng:AutoArk
📌 核心摘要
零样本语音克隆(zero-shot voice cloning)的输入是待合成文本加一段参考语音,输出是保持参考音色朗读目标文本的波形,难点在于词错率(word error rate,WER)和说话人相似度(speaker similarity,SIM)达标的语音仍可能节奏生硬。Audio8-TTS用0.6B参数的快慢双自回归解码器先做多语言监督微调得到可懂且音色一致的基线,再用组相对策略优化(group relative policy optimization,GRPO)稳定内容与音色,最后引入真实感评价模型做偏好优化。该评价模型以冻结的WavLM-large第8层加音高、能量和浊音特征对比合成语音与同句人声,并用暂停压缩分级与跨系统排序学习相对分。时长漂移由单侧对数惩罚约束,超过匹配参考时长35%才计入代价,与已有只奖励WER和SIM的强化学习不同,该框架直接奖励接近人声演绎的韵律。在9个CV3语言上,最终模型错误率为4.86%,说话人相似度为0.661,优于监督微调的5.41%和0.639,盲听Elo评分也明显高于前两阶段。该结论依赖同句人声参考的相对排序,不提供绝对自然度与内容校验,其受控的韵律监督主要隔离暂停时机,对音高、能量等针对性不足,且只能放大已有韵律模式、不能学出从未产生的模式,时长惩罚也未消除漂移。训练占比较小的13个附加语言错误率仍明显高于9个CV3语言,原文亦未评估嗡鸣声或声码器噪声等音频瑕疵,相关指标不能捕捉它们。原文披露了推理端内存与模型文件规模,未披露训练硬件、时长与成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
40. 爵士标准曲录音的多任务对齐标注:JSIR 数据集如何建成与如何验证

英文题目:JSIR: An Audio-Aligned, Multi-Task Dataset of Jazz Standard Recordings
标签:#节拍跟踪 | #和弦识别 | #音乐结构分析 | #数据集构建
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Sihun Lee:机构信息未在 arXiv HTML 中可靠披露
- Dasaem Jeong:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
爵士乐标准曲演奏是音乐信息检索中较难的场景,输入是商业录音波形,输出是随时间对齐的节拍与下拍位置、和弦标记和段落标记,难点在于摇摆节奏使脉冲落在ride镲与walking bass而非强鼓点上,和声以七和弦为主且伴奏稀疏,头-独奏-头形式下重复和声不指示段落边界。JSIR围绕44首标准曲收集267个商业版本共计25.6小时,为JAAH的3.7倍,每首曲目保留4-9个演绎版本,三层标注落在同一节拍网格上。构建过程先用madmom节拍跟踪器生成初始节拍并人工校正八度、相位与漂移,再把多来源主旋律谱转调叠加到节拍网格上逐拍修订和弦,最后按六类词汇手工划分段落并标注乐器。相对Weimar Jazz Database、Jazz Structure Dataset与JAAH,该数据集覆盖完整录音且每首曲目均有多版本,支持跨版本比较。节拍实验中,在十六个数据集上训练的Beat This!加入JSIR后,在RWC-Jazz、JAAH与Filosax组成的外部爵士测试集上下拍F-measure从87.7%升至89.2%。和弦实验中,经JSIR微调的流行音乐训练和弦估计器在JAAH上七和弦准确率从34%升至41%。结构基线在长段落上边界召回仍偏低,标注主观性与缺少分声部乐器活动标签限制结论外推,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/MALerLab/JSIR — 链接可访问(HTTP 200)
第三方资源:https://musicbrainz.org — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
41. 带环境声一起改:AnyEdit 如何做语音与歌声的局部编辑

标签:#语音编辑 | #流匹配 | #歌唱生成 | #基准测试
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yunjia Zhang:The Chinese University of Hong Kong, Shenzhen
- Junan Zhang:The Chinese University of Hong Kong, Shenzhen
- Jing Yang:Institute of Media Technology and Experience Design, Huawei
- Xueyao Zhang:The Chinese University of Hong Kong, Shenzhen
- Fan Fan:Institute of Media Technology and Experience Design, Huawei
- Zhizheng Wu:The Chinese University of Hong Kong, Shenzhen;City University of Macau;Amphion Technology Co., Ltd.
📌 核心摘要
真实录音中的局部编辑需要按目标文本改写插入、删除或替换片段,同时保持说话人音色与韵律走向,还要让改写片段与周围的噪声、混响或伴奏衔接自然。直接在带噪音频上端到端建模容易把语义改写和声学环境纠缠在一起,削弱干净域的声乐生成能力,而先分离再混合又会引入分离损伤和背景不连续。AnyEdit采用两阶段免分离设计,先在干净域完成指令驱动的编辑,再延迟到声学阶段渲染环境。抗噪韵律分词器通过教师学生蒸馏从退化录音恢复干净韵律token,自回归编辑器据此预测干净的韵律与内容风格token,未改动区域监督则锚定周围未编辑人声的时序、重音与音高。流匹配声学模型以源音频的音色与环境背景为声学提示,把上述干净token渲染为目标梅尔频谱图,使编辑段继承周围噪声、混响与伴奏并保持音色一致。在AnyEditBench真实子集上,英语语音编辑词错率为0.0616,背景相似度为0.7705,优于对比的统一基线。结论适用于10 s量级上下文可用的中英文语音与歌声编辑,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/datasets/Ririiiii/anyeditbench — 暂时无法访问
第三方资源:https://any-edit.github.io/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/MahmoudAshraf97/ctc-forced-aligner — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/microsoft/wavlm-base-plus-sv — 暂时无法访问
第三方资源:https://github.com/librosa/librosa — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/laion/clap-htsat-unfused — 暂时无法访问
第三方资源:https://github.com/jasonppy/VoiceCraft — 链接可访问(HTTP 200)
第三方资源:https://github.com/WangHelin1997/SSR-Speech — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/stepfun-ai/Step-Audio-EditX — 暂时无法访问
第三方资源:https://huggingface.co/inclusionAI/Ming-UniAudio-16B-A3B — 暂时无法访问
第三方资源:https://huggingface.co/XiaomiMiMo/MiMo-Audio-7B-Base — 暂时无法访问
第三方资源:https://github.com/AaronZ345/StyleSinger — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
42. 离散规划加连续语义:高保真歌曲生成如何兼顾长结构与声音细节

英文题目:High-Fidelity Song Generation with Joint Discrete and Continuous Modeling
标签:#歌唱生成 | #流匹配 | #自回归模型 | #向量量化
评分:7.0/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zheqi Dai:机构信息未在 arXiv HTML 中可靠披露
- Zhiyue Wu:机构信息未在 arXiv HTML 中可靠披露
- Ruibin Yuan:机构信息未在 arXiv HTML 中可靠披露
- Haolin He:机构信息未在 arXiv HTML 中可靠披露
- Chunyat Wu:机构信息未在 arXiv HTML 中可靠披露
- Xuerui Yang:机构信息未在 arXiv HTML 中可靠披露
- Qiuqiang Kong:机构信息未在 arXiv HTML 中可靠披露
- Chao Yan:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
从歌词与风格描述生成完整歌曲需要同时处理分钟级结构与人声伴奏细节,输入是文本提示,输出是波形,难点在于长序列规划与高保真渲染难以兼顾。语言模型以文本提示为输入自回归预测低码率离散语义令牌形成完整规划,其预测状态经双层感知机读出为连续条件向量,该向量随对应离散令牌对齐但不进入下一步历史。语义流模型以已完成的令牌序列与读出向量为条件,从噪声并行生成完整连续语义特征,其流匹配损失经由读出向量更新语言模型,不经过离散采样求导。随后独立训练的声学扩散模型将生成的语义特征转换为声学隐变量,再由解码器还原为波形,连续编码器只提供训练目标而不参与推理。在192个WildSongBench相同提示上,Joint-STD-48D相对离散基线将SongEval从4.152提高到4.269,将微平均音素错误率从20.26%降低到14.47%。更宽的96维与128维特征在参考音频探针上更好,但完整歌曲生成反而下降,交错语义反馈配置在另一些指标上占优。该结论限于自有合成数据训练并共享LeVo-VAE解码器的六系统比较,自动评分为单次保留歌曲的点估计、专家平均意见分仅覆盖十组配对歌曲,增益无法归因于流梯度、连续目标或渲染器任一差异,原文未披露训练、推理或部署成本的完整货币或能耗数字,仅报告了相对耗时比。
🔗 开源资源
- 第三方资源:https://dzq84.github.io/JDCM/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
43. 生成视频声音对不上口型怎么办:SyncReward 如何学人类判断

英文题目:SyncReward: Human-Aligned Synchronization Reward for Audio-Visual Generation
标签:#音画同步 | #偏好优化 | #数据集 | #基准测试 | #对比学习
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Kaisi Guan:机构信息未在 arXiv HTML 中可靠披露
- Ying Ba:机构信息未在 arXiv HTML 中可靠披露
- Wenjing Wang:机构信息未在 arXiv HTML 中可靠披露
- Xihua Wang:机构信息未在 arXiv HTML 中可靠披露
- Chen Li:机构信息未在 arXiv HTML 中可靠披露
- Jing Lyu:机构信息未在 arXiv HTML 中可靠披露
- Ruihau Song:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
联合音视频生成需同时输出画面与声音,难点在于说话口型、撞击动作、乐器演奏与环境声要在时刻与语义上对应,而整体偏移估计无法刻画缺失、幻觉或不稳定对齐。本文按语音、触发音、乐器与环境四类体系引导提示构造并收集八个生成器的输出,由专业人员给出0、1、2三级同步评分,形成8万条训练数据与1000片段独立基准SyncReward-Bench。奖励模型先在真实片段上以语义—时间对比学习训练音视频编码器,再冻结编码器并在生成片段的人类评分上以回归加排序损失训练跨模态Transformer与分数头,输出0至2的片段级同步分数。该分数既可作为评测指标,也可用于候选选择与扩散后训练的在线强化,与已有偏移估计、嵌入相似度和通用全模态裁判相比更贴近生成内容的失败形态,同数据微调的基线仍全面落后。在SyncReward-Bench语音子集上按Spearman秩相关(ρ×100)比较,SyncReward为79.7,高于同数据微调的最强基线Qwen3-Omni-30B-A3B-FT的69.5。在SyncReward-Bench四个声音类别上按Spearman秩相关(ρ×100)与成对排序准确率比较,SyncReward较该最强基线分别提高1.9–10.2点和1.1–5.7点,语音上差距最大。结论适用于有可见发声源的片段,对无可见源的旁白与背景音乐不作评价,个别示例显示同步提升伴随乐器缺失;训练成本为第一阶段在4×8块NVIDIA H20上训练音视频编码器,第二阶段在2×8块NVIDIA H20上训练交互模块与分数头。
🔗 开源资源
- 第三方资源:https://github.com/WeChatCV/SyncReward — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
44. 语义和声学分开建模的目标说话人提取

标签:#目标说话人提取 | #神经编解码与离散单元 | #自回归模型 | #语音
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Wang Xiang:机构信息未在 arXiv HTML 中可靠披露
- Bang Zeng:机构信息未在 arXiv HTML 中可靠披露
- Ming Li:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
目标说话人提取的输入是多人混合语音和一段目标说话人的注册语音,输出是只保留目标说话人内容的干净波形,难点在于同时选对人说对内容并还原自然音色细节。论文采用DualCodec把目标语音表示为内容为主的语义令牌流和保留音色韵律细节的声学令牌流,并让判别建模负责语义、生成建模负责声学重建。判别分支先从混合与注册语音中估计目标波形,再经冻结语义编码器得到语义嵌入,以保证目标选择和内容可靠。声学分支用解码器语言模型从混合与注册表示预测前几层粗粒度声学令牌,精炼模块再结合混合表示、注册表示和语义嵌入输出完整声学嵌入,与语义嵌入相加后送入冻结解码器重建波形。与同一DualCodec下的统一编解码生成基线相比,该方法在Libri2Mix干净集上把差分词错率(differential word error rate,dWER,越低越好)从0.388降到0.118,同时把感知质量指标NISQA从3.852提升到4.052,把语义相似度指标SpeechBERTScore从0.786提升到0.902。结论适用于语义与声学已分解的编解码空间和两说话人朗读混合条件,作者承认DualCodec本身重建上限弱于FunCodec。语义与声学分支分别约16M和77M参数,在NVIDIA A800 80GB GPU上训练至多100轮。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
45. 熵模型与比特分配如何同一步调适应:一种感知音频编码的闭环设计

英文题目:Co-Adaptive Entropy Modeling and Rate-Distortion-Optimal Bit Allocation for Perceptual Audio Coding
标签:#音频编码 | #信号处理 | #音频质量评估 | #主观评测
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Soohyun Kim:机构信息未在 arXiv HTML 中可靠披露
- Jiwon Jeong:机构信息未在 arXiv HTML 中可靠披露
- Marina Bosi:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
该编码器处理44.1kHz立体声脉冲编码调制信号并每声道独立编码,难点是量化精度同时改变掩蔽加权失真与熵编码实际码长,而传统分配按未编码长度或固定码表定价。编码器先对每频带候选精度量化重构计算噪声掩蔽比失真,并用当前算术编码概率表估计码长取与比特打包较小者,经帕累托修剪形成每频带率失真前沿。前沿连同块预算送入动态规划求总失真最小的精度组合,写码流时每频带再选较短的算术编码或比特打包。编解码双方用已解码符号同步累积直方图并按窗口合并重建概率表而不传边信息,重建表即成为下一块前沿定价用的当前模型。在六个欧洲广播联盟选段、无界比特池、80kbps每声道下,以总客观感知失真相对注水静态算术编码的百分比为指标,精确动态规划协同自适应为63.5%,低于基线的100.0%。在严格每块限率下,以同一总客观感知失真为指标,熵编码感知定价相对同求解器按未编码长度定价降低15%至24%,其中64kbps每声道为15%而80kbps每声道为24%。在80kbps每声道无界比特池的多刺激隐藏参考听音测试中,以平均分值为指标,精确动态规划比注水高22至25分,协同自适应比静态动态规划高3.4分,精确动态规划编码中央处理器时间约为拉格朗日求解器的20倍而失真仅低约0.5%,协同自适应相对静态算术编码的平均编码开销约1%。上述增益依赖小比特池,一块以上比特池时两项增量分别缩至1至3%和0.3至0.5%,且仅六个选段验证,初始拟合已含其中四个,其他语料与有界池平滑未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
46. 只用语音转写数据训练语音检索模型

英文题目:SSEmb: Training a Generalizable Speech Retrieval Model Using Only Automatic Speech Recognition Data
标签:#音频检索 | #Adapter | #多语言 | #语音
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.1/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sangkwon Park:机构信息未在 arXiv HTML 中可靠披露
- Dongwook Lee:机构信息未在 arXiv HTML 中可靠披露
- Youngho Cho:机构信息未在 arXiv HTML 中可靠披露
- Donghun Kang:机构信息未在 arXiv HTML 中可靠披露
- Heeseung Kim:机构信息未在 arXiv HTML 中可靠披露
- Sungroh Yoon:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音驱动检索要解决的输入是口语查询,输出是文本语料库中的相关文档,难点在于收集口语查询与文档相关性标注成本高,跨领域和跨语言扩展困难,级联转写再检索还会引入解码延迟和转写误差传导。SSEmb(简单语音嵌入,Simple Speech Embedding)冻结语音编码器和文本嵌入模型,只训练中间的轻量适配器,把语音声学表示转换为伪词嵌入后送入文本模型得到语音嵌入。训练只用语音转写对,用余弦对齐损失拉近同对语音与转写嵌入,再用InfoNCE损失以同批次其他转写为负例增强区分,InfoNCE在此指按批次内对比区分正负转写的对比损失。推理时口语查询走同一通路直接参与余弦相似度排序,不做语音识别。在以文本基准查询经语音合成得到查询的英语HotpotQA语音到文本检索中,0.6B规模取得nDCG@10为0.7049,nDCG@10在此指前10个检索结果的归一化折损累计增益,数值越大越好,低于同规模级联系统的0.7267,同时单查询延迟从0.348秒降至0.144秒。该结论适用于有一定规模语音转写数据的语言,合成查询和真实口语的差异尚未验证。原文披露了检索延迟实测值,未披露训练硬件、时长与部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
47. FLOMSS:用条件流匹配做四轨全频立体声音乐分离

标签:#音乐源分离 | #流匹配 | #音乐
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shuyang Cui:机构信息未在 arXiv HTML 中可靠披露
- Zhi Zhong:机构信息未在 arXiv HTML 中可靠披露
- Keisuke Toyama:机构信息未在 arXiv HTML 中可靠披露
- Koichi Saito:机构信息未在 arXiv HTML 中可靠披露
- Qiyu Wu:机构信息未在 arXiv HTML 中可靠披露
- Yukara Ikemiya:机构信息未在 arXiv HTML 中可靠披露
- Junghyun Koo:机构信息未在 arXiv HTML 中可靠披露
- Kin Wai Cheuk:机构信息未在 arXiv HTML 中可靠披露
- Woosung Choi:机构信息未在 arXiv HTML 中可靠披露
- Giorgio Fabbro:机构信息未在 arXiv HTML 中可靠披露
- Wei-Hsiang Liao:机构信息未在 arXiv HTML 中可靠披露
- Shusuke Takahashi:机构信息未在 arXiv HTML 中可靠披露
- Yuki Mitsufuji:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音乐源分离的输入是人声、贝斯、鼓与其余声部叠加的立体声混音,输出是四个独立波形,难点在于全频带高采样率下各声部频谱重叠严重且相位细节难以还原。FLOMSS先对混音与目标声部做复数短时傅里叶变换并按幂律压缩幅度,得到尺度更稳定的压缩谱图作为模型输入。训练时沿预设均值轨迹加噪采样中间状态,将该中间状态与混音拼接后输入骨干网络学习速度场或目标样本,推理时以混音为条件用常微分方程求解器积分该向量场得到估计谱图,再对估计谱图做逆压缩与逆短时傅里叶变换恢复波形。与同骨干直接预测基线不同,该框架学习混音条件下的生成分布,单源建模优于多源联合建模。在MUSDB18-HQ测试集四声部平均上,单源OT-CFM目标预测的Mel距离为1.63,低于同骨干判别式基线的2.30,而SDR为3.77 dB,低于该基线的4.95 dB,呈现分布相似性与波形重建之间的权衡。该结论限于MUSDB18-HQ全频带立体声四声部评测,与训练数据更多的判别式方法比较需谨慎,波形域与未压缩短时傅里叶变换域硬混合一致路径整体退化;训练使用4块A100、93600步、有效批量32,推理对最优传输路径使用10步中点求解器,原文未报告延迟与内存实测。
🔗 开源资源
- 第三方资源:https://ik4sumii.github.io/FLOMSS/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
48. 单条参考语音如何做自回归语音个性化而不产生空白输出

标签:#语音克隆 | #文本到语音 | #强化学习 | #知识蒸馏
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sangkwon Park:机构信息未在 arXiv HTML 中可靠披露
- Che Hyun Lee:机构信息未在 arXiv HTML 中可靠披露
- Heeseung Kim:机构信息未在 arXiv HTML 中可靠披露
- Sungroh Yoon:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
自回归文本到语音模型把语音写作离散编解码器令牌序列,单样本个性化只给出一对参考文本与参考语音,要求对任意新文本生成同一音色且保持可懂度。直接在该单对上做监督微调会在推理提示以同样参考语音结尾时提前输出序列结束符,造成空白或近空白语音,论文报告字错率升至18.2%,说话人相似度降至0.536。为分离文本多样性影响,方法先用零样本模型为额外无配对文本一次性合成固定伪目标做蒸馏监督微调,再把当前策略采样轨迹作为后续监督来源,避免反复拟合固定声学序列到结束符的转移。组相对策略优化对每段文本采样一组轨迹,用解码后语音与参考语音的说话人嵌入余弦相似度算奖励并做组内归一化优势,再做带裁剪与KL约束的策略更新,直接提升高奖励样本似然。在位自蒸馏则让学生先在无参考文本条件下采样轨迹,再让冻结的参考条件教师在同一轨迹各位置给出软下一令牌分布,学生以令牌级KL向教师对齐,其中参考文本专用变体只用参考对,文本增强变体对额外文本沿用零样本克隆式教师上下文。GRPO在Seed-TTS-Eval上取得字错率3.0%与相似度0.647,优于零样本基线的3.7%与0.574,而文本增强OPSD训练每步耗时为监督微调的5.8倍时相似度为0.609。结论适用于短参考单样本自回归个性化,GRPO因需外部奖励与声码器解码训练每步耗时为监督微调的45.2倍。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
49. 用硬度、尺寸、速度和阻尼直接控制敲击音:PhysicsSliders 解读

英文题目:PhysicsSliders: Learning Physical Controls for Audio Foley Generation
标签:#音频生成 | #流匹配 | #环境声
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Peiwei Chang:机构信息未在 arXiv HTML 中可靠披露
- Yongqiang Chen:机构信息未在 arXiv HTML 中可靠披露
- Yuelan Cheng:机构信息未在 arXiv HTML 中可靠披露
- Liting Gao:机构信息未在 arXiv HTML 中可靠披露
- Yishun Lu:机构信息未在 arXiv HTML 中可靠披露
- Li Zhang:机构信息未在 arXiv HTML 中可靠披露
- Mark D. Plumbley:机构信息未在 arXiv HTML 中可靠披露
- Philip J. B. Jackson:机构信息未在 arXiv HTML 中可靠披露
- Wenwu Wang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
接触音生成需要把材料、几何与敲击方式的变化转成可预测的声音变化,只给事件标签无法满足游戏与虚拟环境拟音中按场景调整物体的需求。PhysicsSliders用在线模态模拟训练流匹配生成器,输入15维物理参数或含数值的文字描述,输出2秒、44.1 kHz的板与条形体接触音,训练时随机化房间混响、麦克风与噪声。处理链路是先从真实录音用共振峰包络拟合读出有效阻尼q,再经模拟器反演找到产生相同读数的源损耗η*,最后把η*作为直接参数或写入数值标题送入生成器。相对已有声学特征控制与单因素物理响应工作,差异在于同时考核绝对目标精度与双目标联合交付,并分离出厚度信息的作用。在5个真实音频数据集的18类冲击音有效阻尼目标评测中,直接参数版本PXS-Physical的分组Spearman相关系数均值ρ=0.976,高于文字数值版本PXS-Text的0.954。在阻尼与尺寸5×5网格的联合目标评测中,PXS-Physical以68.0%对15.6%超过PXS-Text在225次设置—运行评估中的1.5倍联合交付成功率。在同一网格固定权重与噪声下,提供厚度使1.5倍联合成功率从51.1%升至80.0%,频率误差随之改善,说明厚度决定联合交付。结论适用于冲击音有效阻尼控制与阻尼加尺寸联合控制,持续音存在12.7倍的阻尼下限,串扰与感知质量尚未解决,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
50. 用证据和冲突做多模态情绪识别:EMT-DS 解读

英文题目:Evidential Multimodal Transformers with Dempster-Shafer Fusion for Emotion Recognition
标签:#语音情感识别 | #多模态学习 | #不确定性估计与校准 | #语音
评分:6.9/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Muhammad Usama:机构信息未在 arXiv HTML 中可靠披露
- Yeoreum Jung:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
输入为同一话语的多个异构信号,输出为离散情绪类别。难点是面部表情与语音韵律等模态给出矛盾指向时,常规平均会压制矛盾并给出过度自信的点估计。证据多模态变换器与邓普斯特-谢弗融合把每个模态预测表示为主观意见三元组,即信念质量向量、表征证据不足的不确定性质量与均匀先验,经证据到集中参数的换算得到投影概率,再用邓普斯特组合规则迭代两两融合,矛盾证据被量化为冲突并使融合决策变分散。在IEMOCAP音频加文本统一复现协议下,非加权准确率84.3%超过最强基线双重跨模态变换器81.7%,期望校准误差从0.129降至0.042。在DEAP脑电加生理信号留一被试评估下,准确率82.4%高于最强基线78.1%,在KEMDy20五类说话人无关评估下准确率96.8%。在CMU-MOSEI六分类官方划分下,准确率54.8%超过最强证据基线TMC的52.4%。在音频特征加σ=1.0高斯噪声的受控破坏试验中,准确率保持71.2%,高于注意力基线降至的45.3%。结论限于所测四个语料的给定模态组合与划分,严重噪声和跨语料零样本下准确率仍下降,在IEMOCAP受控消融中训练11.5毫秒每个样本、推理7.0毫秒每个样本,峰值显存8.7GB低于注意力融合的12.5GB。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
51. 何时该听、何时该充耳不闻:语音大模型的个性化与刻板偏见拆分

英文题目:Personalization Without Stereotyping: Do Speech LLMs Know When to Turn a Deaf Ear?
标签:#语音属性识别 | #基准设计 | #基准测试 | #数据集 | #公平性
评分:6.9/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Kshitij Ambilduke:机构信息未在 arXiv HTML 中可靠披露
- Caroline Brun:机构信息未在 arXiv HTML 中可靠披露
- Thibaut Thonet:机构信息未在 arXiv HTML 中可靠披露
- Vassilina Nikoulina:机构信息未在 arXiv HTML 中可靠披露
- Marcely Zanon Boito:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音大语言模型能从声音听出年龄和性别线索,难题在于同一敏感性既可能支撑被明确要求时的体贴回答,也可能在无关任务中触发刻板印象。BASIS-Bench先做人口统计稳健性检验,输入内容相同而说话人不同的语音或文本,输出转写与问答答案以计算内容任务准确率和年龄性别分类准确率,得到模型能否听准人口统计线索的感知基础。感知结果进入刻板偏见轴,将Spoken StereoSet+人工过滤后的三选一续写输入模型,用理想化CAT分数ICAT衡量无关续写中刻板与反刻板选择的偏斜,ICAT从0到100越高越无偏。个性化轴接着检验明确要求适配时的选择,输入儿童或成人语音问答及带男性或女性标记的健康与产品选项,输出选项选择并以MCQA准确率计分,其正确答案只含与说话人一致的性别标记以减少与刻板的混淆。四种语音或文本交叉隐式或显式标记的评测模式对比文本骨干偏好、显式标签效应与语音声学交互,分离语音编码与文本骨干的影响。在语音隐式设置下,女性说话人的MCQA个性化准确率在BASIS-Health上平均为82.6,高于BASIS-Product上的66.4,而男性说话人在BASIS-Product与BASIS-Health上仅为51.1与31.9,语音线索未带来可靠的行为适配。结论适用于合成语音上的英语年龄与二元性别评测,不覆盖口音个性化与交叉偏见。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://mzboito.github.io/basis-bench-webpage/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/nvidia/audio-flamingo-3-hf — 暂时无法访问
第三方资源:https://huggingface.co/nvidia/audio-flamingo-next-hf — 暂时无法访问
第三方资源:https://huggingface.co/OpenMOSS-Team/MOSS-Audio-8B-Instruct — 暂时无法访问
第三方资源:https://huggingface.co/Qwen/Qwen2.5-Omni-7B — 暂时无法访问
第三方资源:https://huggingface.co/Qwen/Qwen3-Omni-30B-A3B-Instruct — 暂时无法访问
第三方资源:https://huggingface.co/stepfun-ai/Step-Audio-2-mini — 暂时无法访问
第三方资源:https://huggingface.co/mistralai/Voxtral-Small-24B-2507 — 暂时无法访问
第三方资源:https://github.com/ZihanZhaoSJTU/LibriSQA — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
52. 给语音转写的耳朵补上非词语声音:54 类事件的时间戳检测
标签:#音频事件检测 | #数据增强 | #CNN | #Transformer | #强制对齐
评分:6.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Ayush Kumar Bar:机构信息未在 arXiv HTML 中可靠披露
- Promila Ghosh:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
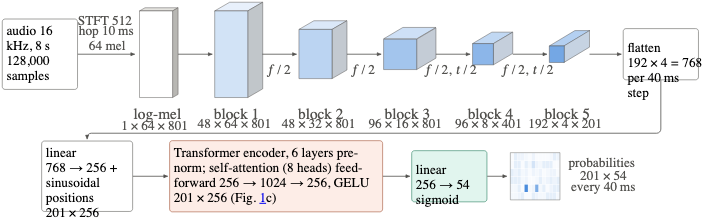
自动语音识别只输出词语,会丢掉呼吸、咳嗽、笑声及喇叭声、音乐、犬吠等信息,论文要每40ms输出54类事件概率,再转成带起止时间的事件并插入Whisper词语序列而不改词序。公开标签分散为单区域、自由文本标签、本体强标签、内嵌转录符号、孤立录音和环境录音,且发声事件短而与语音重叠、背景事件长而边界模糊。方法先用规则把7个来源映射到54类,对转录内嵌的8620处标注用连对时间分类强制对齐找回6360处时间,再用约168h真实标注录音与位置已知的合成混合窗加真实噪声增强联合训练,以5.8M参数卷积-Transformer输出概率。推理按8s窗、2s步长滑动平均概率,经中值滤波、迟滞门限和邻近合并得到事件,并按逐类阈值分为敏感与均衡两档。在4个数据集留出整段录音、至少10个事件的48类共9367个事件的事件级评测中,敏感档宏召回0.491高于均衡档的0.369,而宏精确率0.302低于均衡档的0.361。在同一事件级评测中,敏感档宏事件F1为0.32低于均衡档的0.33。训练在单块NVIDIA T4上每轮约1095s共训练10轮,检测在8线程中央处理器上约为39倍实时,不含解码与Whisper转录耗时,结论限于与调参数据重叠的留出集,未在标准基准和目标域验证。
🔗 开源资源
代码相关资源:https://github.com/theboringai-work/surround-sound — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/theboringai-work/surround-sound — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
53. 窗长为何重要:噪声下语音活动检测的离线基准解读
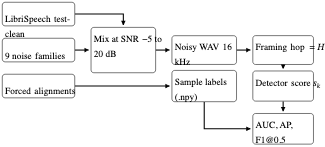
英文题目:Window Size Matters: Benchmarking Voice Activity Detectors in Noise
标签:#语音活动检测 | #基准设计 | #基准测试 | #语音
评分:6.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Alok Kumar:机构信息未在 arXiv HTML 中可靠披露
- Mohit Srivastava:机构信息未在 arXiv HTML 中可靠披露
- Anupam Purwar:OneByZero AI
📌 核心摘要
语音活动检测的输入是16 kHz连续音频,输出是每个短帧是否为语音的二值判断或语音概率,难点是在巴布尔人声、低信噪比和跨文件电平变化下同时保持高召回和低误触发。论文先将LibriSpeech干净语音与9类噪声按-5至20 dB共6档信噪比混合,生成带逐样本语音标注的含噪语音,测试集共2214句约7.1小时。随后按16毫秒及20至50毫秒窗口切分非重叠帧,并由样本标注汇总得到帧级标签,再送入检测器得到每帧语音分数。三检测器的全部帧分数在统一流程下汇合计算ROC曲线下面积、平均精度和固定阈值F1,以排序质量为主要依据。在20毫秒窗口下TEN VAD的AUC为0.916,高于RMS基线的0.754,TEN在16毫秒跳长上AUC为0.917、平均精度为0.968,在20至50毫秒内AUC保持在0.916至0.919。Silero VAD仅在30毫秒附近AUC达0.920,在20毫秒跌至0.627,论文将其归因于补零、子块平均和状态未重置等协议因素但未做验证,而TEN在-5 dB巴布尔噪声下AUC仅0.509接近随机。结论仅适用于离线帧分类,不适用于流式端点延迟和截断行为,原文未披露训练、推理或部署成本。
🔗 开源资源
数据相关资源:https://github.com/zhenghuatan/LibriVAD — 链接可访问(HTTP 200)
数据相关资源:https://huggingface.co/datasets/LibriVAD/LibriVAD — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
54. 留下过渡、删掉冗余:AudioTETRIS 如何压缩音频大模型的音频 Token

英文题目:AudioTETRIS: Token Elimination via Transitional Importance Signals for Efficient Audio LLMs
标签:#语音识别 | #语音翻译 | #音频问答 | #模型剪枝 | #高效推理
评分:6.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shreya Sajid:机构信息未在 arXiv HTML 中可靠披露
- Anna Vettoruzzo:机构信息未在 arXiv HTML 中可靠披露
- Joaquin Vanschoren:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
大音频语言模型把短语音编码成数百个音频令牌,解码器自注意力随序列长度平方增长,推理代价随之放大,而均匀切分又与语音信息集中在快速过渡段的特性相冲突。现有免训练压缩只看粗粒度注意力或特征相似度,把音频令牌当作各向同性特征处理,容易抹平谱过渡,破坏解码所需的细粒度音素边界。AudioTETRIS为免训练两阶段框架,先从音频编码器中间层隐状态计算相邻帧平方欧氏距离,再按utterance内均值归一得到声学权重,用来保护音素过渡附近的令牌。该权重被送入解码器,与随深度切换的注意力分数相乘得到融合分数,在第1层和交叉层做两次取前k保留,早期用音频内注意力、后期用文本到音频的跨模态注意力以兼顾声学连续性与任务相关性。消融显示两阶段互补,压缩率0.75时仅用注意力分支词错率恶化至15.56%,而融合后保持8.50%,说明声学先验弥补了浅层注意力上下文不足的问题。在Qwen2-Audio-7B的LibriSpeech test-other转写任务上,压缩率0.75时词错率为8.50%,优于表现最好的基线SpeechPrune的9.75%。该结论适用于英语朗读、情感、问答和英译中四组评测,在噪声、多语和更激进压缩下未经验证,压缩率0.75时总计算量从7.89 TFLOPs降至4.32 TFLOPs,延迟从1.31 s降至0.62 s。
🔗 开源资源
第三方资源:https://github.com/ShreyaSajid/AudioTETRIS — 链接可访问(HTTP 200)
第三方资源:https://github.com/Gumpest/SparseVLMs — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
55. 把日常声音变成符号音乐:Sori 的可流式可控转换

英文题目:Sori: Streamable and Controllable Model for Non-musical Audio to Symbolic Music Transformation
标签:#符号音乐生成 | #领域适应 | #Transformer | #流式处理
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kyungsu Kim:机构信息未在 arXiv HTML 中可靠披露
- Yejin Kim:机构信息未在 arXiv HTML 中可靠披露
- Kyogu Lee:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
非音乐音频到符号音乐变换要求把咳嗽、雨声等日常声音转为MIDI音符序列,同一输入可对应多种合理写法,评测因此分为输入对应性与音乐性两个维度。Sori先由8层Transformer编码器把16 kHz音频的512维对数梅尔谱图映射为隐特征,再由时间解码器交叉注意力逐帧生成上下文向量\(\mathbf{c}_t\),事件解码器以\(\mathbf{c}_t\)为条件在每帧内自回归生成至多4个音符事件并转成 onset、offset、velocity和frame activity四通道钢琴卷馈入下一帧,多余事件经溢出标志顺延,解码器只在音乐音频配对数据上训练。域对抗训练用判别器判断编码器特征来自音乐还是非音乐音频,并迫使编码器输出域混淆特征;无分类器引导在每步按\(\tilde{\boldsymbol{\ell}}=\boldsymbol{\ell}_{\text{uncond}}+\gamma\cdot(\boldsymbol{\ell}_{\text{cond}}-\boldsymbol{\ell}_{\text{uncond}})\)混合条件与无条件对数几率,调大\(\gamma\)更贴近输入,调小则更偏向音乐先验。在AudioSet评测集上,\(\gamma=1.0\)的Sori的OnF1为0.327、MSS为18.3、FMD为51.3,在三个指标上分别高于或低于Basic Pitch的0.210、32.8、181.8、Deep Salience的0.300、21.7、195.2和TimbreTrap的0.167、33.1、472.7。在同一AudioSet评测集上,\(\gamma=0.5\)的Sori的FMD为33.6、主观音乐性为3.34,为全部被评测条件中FMD最低且音乐性最高,FMD以保留Nlakh测试集为音乐参考分布。该结论受限于评测集未过滤音乐相关片段、嵌套自回归解码未单独消融,且FMD参考集与训练所用Lakh MIDI同源。推理时模型量为153M参数,在Apple M3 CPU上50 ms帧分辨率下实时系数均值0.82,算法延迟64 ms。
🔗 开源资源
- 第三方资源:https://soridemo0320.github.io/sori-demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
56. 把情感做进条件里:Prime-EVC 如何用一步完成富有表现力的情感语音转换

英文题目:Prime-EVC: One-Step Expressive Emotional Voice Conversion via Emotion-Primed Flow Matching
标签:#语音转换 | #韵律与风格控制 | #流匹配 | #语音
评分:6.8/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yu Pan:机构信息未在 arXiv HTML 中可靠披露
- Xiaojuan Cai:机构信息未在 arXiv HTML 中可靠披露
- Liang Zhang:机构信息未在 arXiv HTML 中可靠披露
- Yang Hou:机构信息未在 arXiv HTML 中可靠披露
- Tianjiao Zhang:机构信息未在 arXiv HTML 中可靠披露
- Yuguang Yang:机构信息未在 arXiv HTML 中可靠披露
- Jixun Yao:机构信息未在 arXiv HTML 中可靠披露
- Hiroshi Koide:机构信息未在 arXiv HTML 中可靠披露
- Lei Ma:机构信息未在 arXiv HTML 中可靠披露
- Jianjun Zhao:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
情感语音转换输入一段语音,输出保持语义内容与说话人身份、仅将情感状态改为目标情感的语音。难点在于情感依赖细粒度的基频、能量与频谱时变结构,单步确定性采样容易将其平滑为条件均值。Prime-EVC采用编码、组装条件、渲染三段结构,冻结的HuBERT编码器与时长预测器先分离出与说话人和情感无关的内容序列,情感调制的说话人风格与情感方差适配器预测目标情感帧级基频和能量并经情感分类与频谱时变监督形成80维条件特征,DiT条件流匹配解码器再以单步欧拉步渲染目标梅尔谱并由BigVGAN声码器合成。与把情感实现留给多次迭代采样的扩散或条件流匹配系统不同,该方法让单步解码从已具备情感的条件出发。在ESD英语部分按官方划分将每条测试语音转至其余四种情感共6000次转换的评测设置下,单步Prime-EVC的UTMOS为3.37高于100步DurFlex-EVC的3.21,CER为4.40%低于后者的5.65%,WER为9.61%低于后者的11.95%,EECS为0.87高于后者的0.86,SECS为0.80高于后者的0.76。在16名听众对每系统100条转换语音的5分制主观评测中,单步Prime-EVC的nMOS为3.77高于100步DurFlex-EVC的3.69,eMOS为3.90高于后者的3.83。该结论适用范围限于ESD所述五种平行情感与已知说话人集合的英语实验,跨域泛化尚未验证;原文披露推理成本为声学模型加BigVGAN声码器在同款单张GPU批量为1时RTF为0.038,低于DurFlex-EVC 4步的0.132与100步的1.917,训练成本为单张NVIDIA A6000上批量16训练500000步。
🔗 开源资源
第三方资源:https://yupan0v0.github.io/prime-evc/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/glam-imperial/EmotionalConversionStarGAN — 链接可访问(HTTP 200)
第三方资源:https://github.com/KunZhou9646/seq2seq-EVC — 链接可访问(HTTP 200)
第三方资源:https://github.com/KunZhou9646/Emovox — 链接可访问(HTTP 200)
第三方资源:https://github.com/facebookresearch/fairseq/tree/main/examples/emotion_conversion — 链接可访问(HTTP 200)
第三方资源:https://github.com/hs-oh-prml/DurFlexEVC — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/openai/whisper-large-v3 — 暂时无法访问
第三方资源:https://huggingface.co/emotion2vec — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
57. 先给草稿再自我修正:RefTAG 如何做语音中的时间定位

英文题目:RefTAG: Reflection-aware Temporal Audio Grounding in Large Audio Language Models
标签:#音频时间定位 | #音频推理 | #强化学习 | #音频大模型
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuhang Dai:机构信息未在 arXiv HTML 中可靠披露
- Xin Shu:机构信息未在 arXiv HTML 中可靠披露
- Zhennan Lin:机构信息未在 arXiv HTML 中可靠披露
- Mingchen Shao:机构信息未在 arXiv HTML 中可靠披露
- Chengyou Wang:机构信息未在 arXiv HTML 中可靠披露
- Xiangang Li:机构信息未在 arXiv HTML 中可靠披露
- Jianwei Yu:机构信息未在 arXiv HTML 中可靠披露
- Lei Xie:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
时间音频定位要求根据自然语言查询在录音中找出全部匹配区间,输出数量可变且起止边界需准确,目标反复出现或长录音会加大漏检与边界偏移风险。RefTAG先由大音频语言模型生成初始草稿区间,该草稿连同音频与查询一起进入诊断环节。诊断输出离散的数量动作与边界动作以区分漏检和边界错位,再据此改写为修订后区间,使草稿直接成为修订的修改起点。同一质量函数对草稿和终稿打分,结合并集交并比、一对一匹配交并比、中点误差转换分和数量一致分,反射感知分组相对策略优化同时奖励最终定位质量与草稿到终稿的质量变化。与仅学最终答案的监督微调相比,Re-CoT监督微调在Clotho、LAT与TAG-Bench三数据集平均的平均交并比mIoU上从49.67%提高到50.90%。最终模型在TAG-Bench总体平均交并比mIoU上取得38.50%、在三数据集平均mIoU上取得51.01%,均超过受评的开源MOSS-Audio、FireRedAudio与商业Gemini-3.1-Pro。长录音语义查询上草稿到终稿几乎没有增益,说明缺少新增音频证据时仅靠数量与边界修正难以继续提升。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
58. 深层语音表征如何用二维圆周跟踪词内时间

英文题目:Deep Speech Representations Track Word Timing along a Low-Dimensional Circular Trajectory
标签:#语音属性识别 | #统计分析 | #可解释性 | #语音
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Burin Naowarat:机构信息未在 arXiv HTML 中可靠披露
- Hao Tang:机构信息未在 arXiv HTML 中可靠披露
- Sharon Goldwater:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音模型要在连续帧序列中判断一个词何时开始、何时结束,论文研究这类词内计时信息在高维帧表示中以何种几何形状组织。输入是 LibriSpeech 语音经深层模型抽取的帧级向量,输出是词计时在二维子空间中的轨迹形状判断,以及据此产生的词边界位置。难点在于平均后的规律可能掩盖单例差异,也可能把音节起伏误认成词循环。作者先用质心主成分分析(Centroid-PCA,CPCA)估计词时间子空间,把同持续时长的词段按帧位置平均后做主成分分析,再用旋转角与词内比例的线性拟合优度与整周完成度衡量圆形程度。随后提出旋转分割(Rotary Segmentation,RoSeg),把整句表示投影到二维子空间,计算每帧相对句首帧的角距离并检测波谷,把完成一周旋转的位置判为边界,并比较了 CPCA 与最小二乘概念擦除(LEAst-squares Concept Erasure,LEACE)两种子空间。相对已有相邻帧差异分割方法,RoSeg 只用二维旋转结构而非全维距离变化。在 LibriSpeech test-clean 上,以预训练 HuBERT 第 9 层表示运行的 RoSeg-LEACE 得到边界 F1 为 64.3%,高于同设置差异基线的 43.9%。该结论依赖有监督的子空间估计与英语单音节占比较高的条件,多音节词与无监督子空间发现仍未解决。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/burin-n/word_timing_trajectory — 链接可访问(HTTP 200)
第三方资源:https://github.com/s-malan/evaluation — 链接可访问(HTTP 200)
第三方资源:https://github.com/s-malan/prom-wordseg — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
59. 量子瓶颈如何改变语音防伪造的分数可靠性

英文题目:QBFF: Deep Quantum Bottleneck for Automatic Speaker Verification Anti-Spoofing
标签:#语音伪造检测 | #不确定性估计与校准 | #语音 | #鲁棒性
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Anton Firc:机构信息未在 arXiv HTML 中可靠披露
- Nouhaila Innan:机构信息未在 arXiv HTML 中可靠披露
- Vojtěch Staněk:机构信息未在 arXiv HTML 中可靠披露
- Kamil Malinka:机构信息未在 arXiv HTML 中可靠披露
- Martin Perešini:机构信息未在 arXiv HTML 中可靠披露
- Zbyněk Lička:机构信息未在 arXiv HTML 中可靠披露
- Walid El Maouaki:机构信息未在 arXiv HTML 中可靠披露
- Alberto Marchisio:机构信息未在 arXiv HTML 中可靠披露
- Muhammad Shafique:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
合成语音伪造检测需要对每段录音输出真伪分数,再按固定阈值判决,阈值处过于自信的错误会带来较高代价。论文在自监督语音管道中比较三种分类头:直接处理1024维utterance向量的全连接基线、压缩到8维的经典瓶颈对照、把同一压缩表示送入8量子比特变分电路的量子瓶颈。语音先经XLS-R编码为帧序列,再经平均、MHFA或AASIST池化为1024维向量,瓶颈头将其投影到16个有界值,经典混合器或量子电路输出8维表示后接同一结构的分类器得到两类对数似然比。量子电路采用两层角度重上传和CNOT环,测量8个泡利期望并经可学习尺度送入分类器。在微调加增强的In-the-Wild评测中,AASIST加量子瓶颈相对经典瓶颈把等错误率从5.49%降到3.97%,把固定贝叶斯阈值下的实际检测代价从0.205降到0.181。该结论仅适用于注意力池化带来的分数可靠性改善,平均池化下实际检测代价与似然比代价反而变差,ASVspoof5上AASIST加量子瓶颈的判别力也不及全连接基线。硬件验证只用按难度分层的子集且与全量基准不可比,有限采样下子集等错误率与似然比代价更低但平均实际检测代价高于经典对照并随运行大幅波动;电路结构固定未搜索,有界输出的经典对照仍缺失。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/Security-FIT/QBFF — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
60. 水下声音识别考验通用音频大模型:UA-Bench 的构造与发现

英文题目:UA-Bench: Benchmarking Large Audio-Language Models on Underwater Acoustic Recognition
标签:#音频分类 | #基准设计 | #基准测试 | #音频大模型
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Zhe Sun:机构信息未在 arXiv HTML 中可靠披露
- Liang An:机构信息未在 arXiv HTML 中可靠披露
- Jiayu Yao:机构信息未在 arXiv HTML 中可靠披露
- Ronglai Qian:机构信息未在 arXiv HTML 中可靠披露
- Jianing Cai:机构信息未在 arXiv HTML 中可靠披露
- Ziwei Huang:机构信息未在 arXiv HTML 中可靠披露
- Qing Fan:机构信息未在 arXiv HTML 中可靠披露
- Zhiyuan Yang:机构信息未在 arXiv HTML 中可靠披露
- Yujun Cai:机构信息未在 arXiv HTML 中可靠披露
- Hongli Cao:机构信息未在 arXiv HTML 中可靠披露
- Yiwei Wang:机构信息未在 arXiv HTML 中可靠披露
- Xiaoyan Wang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
水下声识别需要从接收波形判断声源类型,输入是经多径传播重塑后的单段音频,输出是三级类别路径与解释,难点在于实测标注稀缺且声源结构与传播效应在实测记录中纠缠难分。UA-Bench先按类别参数化合成主动探测脉冲、通信波形与舰船辐射噪声三大家族,再用BELLHOP结合气候态声速剖面与扰动几何计算传播并生成接收片段,每条记录保留生成参数与对话模板,同源片段固定在同一划分以避免传播变体泄漏。评测采用门控由粗到细对话,答错即终止以定位失效在源路由、细分类还是格式,并用等长静音配对检验是否真正使用波形。九个开源大音频语言模型在固定平衡子集UA-Bench-Eval上无任务适配评测,叶节点准确率为2.0%至13.1%,其中最高13.1%高于随机猜测参考7.7%,最低2.0%低于该参考。在同一子集的配对等长静音对照下,波形使叶节点准确率高于静音对照,最大增益约4.7个百分点,且仅四款模型获得可靠叶节点增益,波形对源路由的帮助远大于对叶节点的帮助。结论仅适用于无任务适配的零样本问答评测,不能推广到微调后或真实海试数据。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://sunzhe12.github.io/ua-bench/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
61. DuplexAct:如何按动作评价全双工语音模型的交互能力

英文题目:DuplexAct: How Interactive Are Frontier Full-Duplex Spoken Language Models?
标签:#全双工语音交互 | #基准设计 | #基准测试 | #语音
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Jiaheng Dong:The University of Melbourne;University of Birmingham
- Shihong Tan:Wuhan University
- Gongping Huang:Wuhan University
- Jean Honorio:The University of Melbourne
- Abhirup Ghosh:University of Birmingham
- Ting Dang:The University of Melbourne
📌 核心摘要
端到端全双工口语语言模型需要在边听边说中决定是否开口、何时开口及开口后如何延续,难点是在打断、迟疑停顿和背景人声下选对动作并保持语义连贯。DuplexAct先把交互形式化为参与状态、交互动作与交互条件三层分类,输出说话或沉默下的8个动作及24个动作适用的对话情境,为评测提供可判定的动作空间。再据此构建4691个实例、总时长12.44小时的数据集,其中2531个从真实录音抽取实质话轮并施加时序约束,其余2160个对覆盖不足的动作—条件对受控合成,实例携带的固定音频与线索进入评测。评测按是否依赖模型正在输出分为直接重放与模拟器交互两路,前者按固定时间线播放输入并记录输出,后者由语言模型模拟器观察流式转录与参考回答决定注入固定录制线索的时机,两路输出均接受即时执行规则检查与后续跟进清单检查。在DuplexAct直接重放评测中按即时执行成功率比较,按时接话上Qwen3.5-Omni-Flash-Realtime为41.3%高于GPT-Realtime-2.1的27.5%,而模拟器交互评测的恢复动作即时执行成功率上Gemini 3.1 Flash Live为97.0%高于GPT-Realtime-2.1的77.7%。同样在模拟器交互评测中按后续跟进成功率比较,保持话轮上Gemini 3.1 Flash Live为57.3%高于GPT-Realtime-2.1的39.3%,而恢复动作后续跟进上GPT-Realtime-2.1为90.3%高于Gemini 3.1 Flash Live的78.6%,说明即时成功后仍常丢失后续推理。该结论仅适用于14个受测模型在给定重放与模拟器时间线、固定线索及转录依赖评测下的表现,未验证真实双人实时对话、其他语种与更长干扰下的泛化,模拟器定时与转录误差也可能改变判定。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/JiahengDong/DuplexAct — 链接不可用(HTTP 404)
数据相关资源:https://github.com/JiahengDong/DuplexAct — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
62. 用语音编码器里对语言敏感的维度直接发现语码转换
英文题目:Code-Switching Detection via Language-Selective Dimensions in Speech Foundation Models
标签:#语言识别 | #统计分析 | #代码转换 | #语音
评分:6.8/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jie Chi:机构信息未在 arXiv HTML 中可靠披露
- Zakaria Aldeneh:机构信息未在 arXiv HTML 中可靠披露
- Masha Fedzechkina:机构信息未在 arXiv HTML 中可靠披露
- Maureen de Seyssel:机构信息未在 arXiv HTML 中可靠披露
- Natalie Schluter:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
多语言语料中同一句话内交替使用两种语言的现象常见但占比低,找出这类句子才能补充训练数据,直接转写后再判断语言在大规模筛选时成本高且依赖多语言识别质量。本文输入为待判定的语音 utterance,输出为是否包含语码转换的二值标签,难点在于只用单语语音建立语言证据,又要在未见过的语言对和朗读与会话两种风格下判断句内是否两种语言都出现。方法先在预训练语音编码器某一层用单语帧计算每维度的 Cohen’s d 值,挑出均值差异相对稳定的语言选择性维度并估计两语言质心;再把帧在质心连线方向上的投影转成逐帧语言分数,用 0.5 秒滑窗统计正负分数占比,两种语言都有足够多窗口超过阈值才判为转换。在 CS-FLEURS 的 14 个英语与其他语言组合的朗读语音上,Whisper-small 编码器第 8 层用 8 个针对语言对选择的维度达到平均 oracle F1 为 0.798,高于卷积网络基线的 0.776、HuBERT 线性基线的 0.751 和全层探针的 0.786,10% 标注数据校准后为 0.784;在会话 SEAME 合并开发集上为 0.734,低于 HuBERT 线性基线的 0.772。结论适用于有目标语言单语语音和小量标注转换语音可调阈值的筛选场景,尚未验证无标注野外音频挖掘效果,也未覆盖句内转换边界定位。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
63. 噪声下语音条件生成为何退化:AlignAudio 的双重对齐思路

英文题目:AlignAudio: A Unified Dual-Alignment Framework for Noise-Robust Speech-Conditioned Generation
标签:#音频生成 | #语音转换 | #流匹配 | #鲁棒性
评分:6.7/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.9/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yixuan Li:机构信息未在 arXiv HTML 中可靠披露
- Xuenan Xu:机构信息未在 arXiv HTML 中可靠披露
- Zeyu Xie:机构信息未在 arXiv HTML 中可靠披露
- Mengyue Wu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音条件生成以带噪语音为输入直接生成目标音频,噪声同时污染语义线索与生成过程的动态轨迹,导致音质下降与条件失配。AlignAudio先在冻结的语音编码路径中加入轻量适配器,以干净语音的表示为蒸馏目标,用L2距离拉近干净与带噪条件的表示分布,再在流匹配生成器中用方向相似性约束带噪条件预测的速度场方向与干净条件一致,使两条生成轨迹保持同向。语音到音频采用单条语音条件与SpeechT5编码器加扩散变换器,语音转换采用源内容与目标音色双路条件与平均流解码器,适配器位置随任务调整。与仅做前端增强或单路鲁棒表示的方法不同,该框架同时正则化条件表示与条件生成动力学,并兼容标准流匹配、平均流与Flow-GRPO后训练。在LibriTTS test-clean合成噪声下的带噪语音转换测试中,未加后训练版本的词错误率(WER)为32.36%,完整后训练模型降至27.56%,低于Noro的45.27%,而干净语音性能基本保持。结论适用于合成噪声、域外DEMAND噪声与小规模真实录制干扰,对自发语音与更大规模真实噪声尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://alignaudio.github.io/AlignAudio → https://alignaudio.github.io/AlignAudio/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
64. 词对齐韵律:说话人差异远大于抑郁或创伤后应激严重度
英文题目:Word-Aligned Prosody Reflects Speaker Differences More Than Depression or PTSD Severity
标签:#病理语音评估 | #心理测量 | #韵律 | #语音 | #语音生物标志物
评分:6.7/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Hsiang-Chen Yeh:机构信息未在 arXiv HTML 中可靠披露
- Aurosweta Mahapatra:机构信息未在 arXiv HTML 中可靠披露
- Shreeram Suresh Chandra:机构信息未在 arXiv HTML 中可靠披露
- Ryan L. Boyd:机构信息未在 arXiv HTML 中可靠披露
- Berrak Sisman:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
论文研究词对齐韵律能否作为抑郁与创伤后应激障碍严重程度的行为测量,输入是归属到目标说话人的连续语音与词边界,输出是词层声学值与聚合后的说话人分数,难点在于单次观测同时混有说话人基线、词汇效应、话语情境与通道影响。处理先用词对齐得到词边界,再在词内估计平均基频、稳健基频范围、能量与音节校正后的对数词时长,同一套代码用于四个语料。随后用概化理论分解说话人、词、说话人与词交互及残差方差,检验词特异偏差跨情境是否再现,再把多词聚合成说话人汇总并检验跨录音一致性,通过门限后才检验与PHQ-8与PCL分数的关联。以跨情境再现性R̄c衡量,在ESD五种条件下F0范围为0.160,高于对数时长的0.010,四个特征整体仅为0.01-0.16。以校正分半一致性rc衡量,说话人汇总在ESD同一录音内为0.997,高于MSP-Podcast跨录音的0.73-0.90。以Spearman ρ衡量,在PTSD-STOP中被试间平均基频与PCL关联为0.151,高于跨时段变化关联的0.047,校正后均不显著。与直接把单词语音值读作临床证据的做法不同,该工作把词看作一次场合抽样并聚合到说话人;结论限于所研究英语语料与四个超音段特征,原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/jen900704/word-aligned-prosody — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
65. 多模态推荐里加模态反而变差:MMWave 如何提取与整合特征

标签:#音频检索 | #多模态学习 | #图神经网络 | #对比学习
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.3/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Rongqing Kenneth Ong:机构信息未在 arXiv HTML 中可靠披露
- Andy W. H. Khong:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
多模态推荐要根据用户与物品的历史交互和物品的视觉、文本、音频特征估计用户对未见物品的交互概率,难点是新增模态常带来与自身噪声混杂的冗余跨模态信号,使三模态融合效果反而不如双模态。MMWave 先对每种原始模态做多层 Haar 小波分解,只保留并加权低频近似系数再做逆变换重构,以滤除高频噪声并投影到共享空间,同时用物品身份嵌入做门控注入行为信息。随后模型在物品间构建模态相似图并做谱分解交叉增强得到融合图,分别用轻量图卷积传播物品高阶语义信号,用用户物品二部图传播协同信号。最后的自适应模态调节器用融合注意力加权单模态特征、用单模态注意力加权融合特征,再经协同门控相加得到最终表示,并用贝叶斯个性化排序损失加 InfoNCE 对比损失联合优化。与已有融合方法直接拼接或注意力求和不同,该设计把去冗余放在融合之前并用互加权平衡贡献。在 TikTok 全排序评测中 MMWave 的 Recall@10 为 0.0827,高于非融合最强基线 BM3 的 0.0722。该结论限于 Baby、Sports、Clothing 与 TikTok 四个五核过滤数据集的全排序 Recall 与 NDCG,原文报告了内存与每轮训练推理耗时,增量开销中等。
🔗 开源资源
- 代码相关资源:https://github.com/kennethorq/MMWave — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
66. 把分散的社区评论变成声乐教练:PitchIn 解读

英文题目:PitchIn: Natural-Language Vocal Coaching from Unstructured Community Feedback
标签:#音频问答 | #音乐分析 | #指令微调 | #数据集
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Hayeon Bang:机构信息未在 arXiv HTML 中可靠披露
- Hounsu Kim:机构信息未在 arXiv HTML 中可靠披露
- Joonyong Park:机构信息未在 arXiv HTML 中可靠披露
- Jung-Jae Yu:机构信息未在 arXiv HTML 中可靠披露
- Juhan Nam:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
自然语言声乐辅导要求模型听完演唱录音后指出值得肯定的地方和存在的问题并给出可操作改进建议,难点在于缺少录音与专家诊断和纠正建议配对的标注。作者收集Reddit的r/singing和r/ratemysinging两个社区40个月内发帖和评论,得到9753段录音、75684条评论和158.1小时音频,从中抽取分散观察与建议并区分为优点、问题和练习建议。针对具体问题的问答以单条观察与建议为输入转成一问一答,整体反馈则以同录音多条分类后反馈为输入合并成回答整体听感与改进方法的连贯英文辅导文本。两类文本再与对应录音配对用于对Qwen2.5-Omni-7B和MOSS-Music-8B-Instruct做指令微调,与多依赖评分、标签或专家单人反馈的已有工作不同,该做法把多人非结构化同行反馈作为监督来源。在VocalCoachBench上按每录音生成5组诊断—纠正配对评测时,同时命中专家问题且建议有效的E2E比例相对各自预训练基线在Qwen2.5-Omni上从21.3%升至61.0%,在MOSS-Music上从31.4%升至51.2%。十名受过音乐训练的评测者盲评整体反馈回答时,PitchIn-Q和PitchIn-M相对各自预训练基线的有用性偏好率分别为92.0%和67.3%,均为更受偏好一方。但严格匹配专家具体诊断仍然困难,附加识别问答未带来开放式诊断显著增益,结论仅适用于英文重构文本与该评测集条件,原文未披露训练、推理或部署成本。
🔗 开源资源
- 演示资源:https://hayeonbang.github.io/PitchIn → https://hayeonbang.github.io/PitchIn/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
67. 在真人停顿处考语音对话:该沉默时沉默吗

英文题目:People Making Conversation: Evaluating How Naturally Speech Models Converse
标签:#轮次切换 | #基准设计 | #基准测试 | #语音 | #音频问答
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Arya Bastani:People Make Things
- Iman Modarressi:People Make Things
📌 核心摘要
实时语音对话系统在每次停顿都要决定保持沉默还是接管话轮,难点在于停顿可能是话轮内犹豫也可能是真正交接,系统只能依据此前对话和实时音频判断。论文从Seamless Interaction的176段无脚本闲聊中选出427个话轮内暂停点和482个话轮结束点,评测先把该时刻前按164秒上限截断的历史连同身份提示预载给系统,其中全双工模型听双通道音频、托管模型读文本加尾段音频,形成的上下文直接作为待测起点。再把后续语音实时流入让系统在真实边界上实际生成,其音频输出进入同一套代码对照人的行为计分:暂停点统计沉默与抢话及延迟,话轮结束点统计首词延迟、相对人的时长与词数比及词F1与嵌入余弦相似度,并用30秒到120秒历史后的口头提问测记忆。相对已有检测类、策略类和总量统计类评测,该工作不只判边界是否标对,而是让生成式系统在真实边界上实际走一遍。在427个暂停点的暂停评测中,以抢话延迟为指标,托管系统在基于静音的端点器下延迟约1秒到4秒,长于全双工模型216毫秒到373毫秒的抢话延迟,且几乎每停必答而只有后者经常沉默。在30秒到120秒历史后的对话记忆评测中,以Claude Opus 5.5为裁判的对话召回准确率为指标,读文本历史的托管系统为41%到60%,高于听音频历史的全双工模型的17%到22%。PersonaPlex与Moshi自托管于Modal A100各48个会话,各API端点与推理响应延迟已在原文给出,完整训练与部署费用仍无法据此得出,上述结论受所测端点设置及历史通道不同影响。
🔗 开源资源
- 第三方资源:https://github.com/People-Make-Things/people-conversation-bench — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
68. 国乐声乐数据集如何把装饰音变成可计算的事件

标签:#音频事件检测 | #音频分类 | #音乐分析 | #数据集构建 | #数据集
评分:6.6/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Danbinaerin Han:机构信息未在 arXiv HTML 中可靠披露
- Wonil Kim:机构信息未在 arXiv HTML 中可靠披露
- Seah Hong:机构信息未在 arXiv HTML 中可靠披露
- Dongjoo Moon:机构信息未在 arXiv HTML 中可靠披露
- Jaeok Lee:机构信息未在 arXiv HTML 中可靠披露
- Jongpil Lee:机构信息未在 arXiv HTML 中可靠披露
- Chaewon Kim:机构信息未在 arXiv HTML 中可靠披露
- Juhan Nam:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
韩国传统声乐的时金赛包含主音内部的连续音高屈折、依附装饰音与音间过渡手势,同一音阶因时金赛不同可归入不同地域旋律体系,记谱只能保留近似符号,直接对音频建模成为必要条件。已有公开资源缺少无伴奏独唱录音,术语随流派与传承系谱分歧,也没有跨流派的音频级标注体系。论文先由国立国乐院筛选代表性曲目并组织20名职业歌手在固定调与固定速度的受控录音棚录制305轨约24.5小时无伴奏独唱,再按音内功能位置设计17类统一本体并配套指南与参考音频轮廓,使跨流派标注口径一致。接着同一标注团队在7–20秒乐句层面按张丹结构对齐实际演唱歌词,并在该对齐之上标注时金赛起止与类型,14名专家经两轮审核共得68272个片段71742个实例,平均段长0.47秒,对齐文本与事件区间共同进入分类与事件检测基线。在17类歌曲级五折交叉验证分类中,任务专用音高卷积网络宏平均F1为0.441±0.015,超过冻结MERT-v1最佳探测层L7的0.358±0.011,也高于同结构语谱图输入的0.400±0.018,说明音高轮廓已承载主要可区分信号。在17类事件检测中,同一轻量编码解码时序卷积网络下音高输入帧级宏F1为0.324±0.015高于语谱图输入的0.269±0.013,而语谱图输入事件级F1以0.763±0.012占优并与冻结MERT-v1的0.756±0.026相当,呈现身份靠音高、边界靠频谱的互补分工。结论仅适用于受控录音与给定本体下的比较,固定调与固定速度、性别与流派完全混淆及细粒度混淆尚未解决,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://www.danbinaerin.com/Gugak-VocalSet/ — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
69. 从文本合成超声回波:为眼镜静音语音识别造训练数据

英文题目:Synthesizing Ultrasonic Echo Profiles from Text for Open-Vocabulary Silent Speech Recognition
标签:#静默语音接口 | #生成对抗网络 | #预训练 | #对比学习 | #工具增强与约束解码
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jiacheng Liu:机构信息未在 arXiv HTML 中可靠披露
- Ruidong Zhang:机构信息未在 arXiv HTML 中可靠披露
- François Guimbretière:机构信息未在 arXiv HTML 中可靠披露
- Cheng Zhang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
眼镜式静默语音接口需在无声条件下从面部反射的超声回波轮廓恢复说话内容,逐句佩戴采集难以扩展使开放词表识别停留在26.3%词错率。SoniGAN用音色克隆语音合成读出76382句对话文本生成104小时音频,再把音频压缩为保留内容、丢弃音色的软语音单元,输入两阶段生成对抗网络。第一阶段先由语音单元与模式向量生成粗包络,第二阶段在包络上叠加残差以恢复载波留下的精细条纹结构,两阶段分别接受冻结识别器的内容感知损失与分管局部纹理、时序结构的判别器监督;识别器先在合成轮廓上预训练,再在真实静默与发声轮廓上微调,并用跨模态对比目标经动态时间规整对齐静默帧与发声语音单元。相对同一140会话基线,合成预训练把SoniSpeech千句静默测试集上的词错率从25.9%降到23.6%。合成量从26小时增至104小时增益迅速饱和,纳入单麦克风故障被丢弃的20个会话并经词表约束解码、Qwen3-4B重排序与五模型集成后系统达到14.9%。该结论依赖同一语料词表、语言模型与集成,去除内容感知损失会使合成轮廓可读性崩溃至96.2%,噪声预训练反而比不预训练差1.7个百分点,字幕域文本的生成质量与跨说话人、跨设备表现尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
70. 少步蒸馏如何只用回归跟上教师速度场
英文题目:Simplifying and Improving On-Policy Distillation for Few-Step Diffusion
标签:#音视频生成 | #知识蒸馏 | #扩散模型 | #音视频 | #高效推理
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jiawei Zhang:机构信息未能从 arXiv PDF 文本可靠映射
- Ziyu Wan:机构信息未能从 arXiv PDF 文本可靠映射
- Nanye Ma:机构信息未能从 arXiv PDF 文本可靠映射
- Long Zhao:机构信息未能从 arXiv PDF 文本可靠映射
- Dong Chen:机构信息未能从 arXiv PDF 文本可靠映射
- Hongyu Liu:机构信息未能从 arXiv PDF 文本可靠映射
- Qifeng Chen:机构信息未能从 arXiv PDF 文本可靠映射
- Dongdong Chen:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
扩散模型与流模型从高斯噪声出发沿学习的速度场积分到数据,少步蒸馏要用粗区间更新复现冻结教师轨迹,难点是单个学生速度难以表示区间内变化的速度场并易陷入不良模式。简化匹配蒸馏让学生在自身展开轨迹起点做速度预测并沿该预测构造区间内中间查询点,再查询冻结教师局部速度做均方回归,同一预测既构造查询点又匹配教师速度,不增加额外学生求值。训练期代理路径Pivot以零积分残差拟合区间内速度变化并保持区间端点不变,把局部修正与区间平均预测分离,推理时丢弃而不进入推理图。学生随后以加权方式排斥同一教师的弱预测以避开不良模式,无需用于估计学生分布分数的辅助分数模型与结构改动,部署的生成器保持不变。在FLUX.1-dev文本图像生成中以4次函数求值为评测设置,SMD的GenEval指标为0.715高于π-Flow的0.675。在相同4次函数求值设置下,SMD的DPG-Bench指标为84.8高于π-Flow的84.3。在Wan2.1-T2V-14B视频合成中以4次函数求值在Self-Forcing提示集上用VBench评测,SMD的Quality指标为85.72低于AnyFlow的85.78但高于多步教师的84.56,Semantic指标为80.52低于AnyFlow的82.10;结论适用于文本图像、编辑、三维、视频和联合音视频模型,但跨模型增益依赖师生搭配,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/black-forest-labs/flux — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
71. 位置重要吗:黑盒因果审计揭示音频大模型幻觉的模型差异

标签:#音频问答 | #幻觉与忠实度 | #可解释性 | #统计分析 | #信号处理
评分:6.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mohammad Khalooei:机构信息未在 arXiv HTML 中可靠披露
- Mohammad Sabokrou:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
大型音频语言模型(Large Audio-Language Model,LALM)回答音频中是否存在某类声音时,常在证据不足时仍肯定回答,输入是真实录音与自然语言是非问题,输出是肯定或否定判断,难点在于区分回答依赖音频证据还是依赖语言先验。论文先用对比语言音频预训练(Contrastive Language-Audio Pretraining,CLAP)滑动窗口找到与声称最匹配的时段,再用谱门控只衰减该时段并重新查询模型,随机等尺寸窗口与全零音频作为对照。接着在否定对照片段中混入真实样例验证插入充分性,并用已知插入位置的合成混合物分离定位误差与模型依赖。解码时复用已计算的肯定概率做对比校正。与音频感知解码(Audio-Aware Decoding,AAD)相比,语言先验对比把 Qwen2-Audio-7B 在自身 4355 个肯定声称上的准确率从 57.1% 提升到 68.2%,组合加权后达到 71.9%。该增益只适用于 Qwen2-Audio这类高肯定先验模型,在 Audio Flamingo 3 上语言先验对比与 AAD 均无提升且定位对比反而下降,定位去除的优势只在固定去除时长后成立,对瞬态声更明显,在更短音频与按类别平均时减弱,统一检测器跨模型直接迁移会失效。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
72. Sonic-AMG:从空间音频流式生成人体反应动作

英文题目:Sonic-AMG: Streaming Human Motion Generation from Spatial Audio
标签:#音频交互 | #自回归模型 | #流式处理 | #空间音频 | #实时处理
评分:6.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jingcheng Ni:Brown University
- Zekun Li:Brown University
- Zhiyang Dou:MIT
- Xiaoyan Cong:Brown University
- Ziyao Zeng:Yale University
- Hongyang Du:Brown University
- Randall Balestriero:Brown University
- Taku Komura:The University of Hong Kong
- Srinath Sridhar:Brown University
📌 核心摘要
空间音频驱动的人体动作生成输入是双耳音频流和世界坐标系声源位置,输出是 30 Hz 人体关节运动,要求在不知道未来音频时即时反应,并随身体转动更新声源相对方向。Sonic-AMG 先把运动压缩为因果时序变分自编码器(causal temporal VAE)的连续隐变量,把声音内容和身体相对声源几何分别编码为 what 声学令牌和 where 空间令牌,再由因果 Transformer 输出条件向量驱动流匹配(flow matching)头采样下一隐变量并解码为 4 帧动作块。训练采用排练训练结合全序列教师强制和短自回归自我展开,推理与训练均用空间反馈从已生成根部位姿重算身体相对坐标。与需要完整 8 s 输入的 MOSPA 相比,该方法在 SAM 上 GT 声源条件下取得 FID(Fréchet Inception Distance,越低越好)6.505 和 R-precision R@1 0.957 的最佳结果,在线更新条件下仍保持 FID 8.066。结论适用于已知声源位置和 SAM 覆盖的 27 种声音场景,跨环境泛化尚未验证。训练成本为单卡 NVIDIA L40S 约 63 小时完成 150000 步更新,推理在 RTX A6000 上每步约 50.2 ms,满足实时要求。
🔗 开源资源
- 第三方资源:https://jingchengni.com/sonic-amg/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
73. SpikCTU:固定记忆加共享循环推理的紧凑脉冲语音指令识别

标签:#关键词检测 | #动态计算与早退 | #语音 | #高效推理
评分:6.5/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Li Jin:机构信息未在 arXiv HTML 中可靠披露
- Jiang Wenbin:机构信息未在 arXiv HTML 中可靠披露
- Chen Tao:机构信息未在 arXiv HTML 中可靠披露
- Wen Fei:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音指令识别需把可变长语音映射为固定词表标签,脉冲神经网络以稀疏二值脉冲传递事件信息以节能,但固定步数对简单样本浪费计算,也难以呈现证据随推理逐步变化的过程。SpikCTU先用混合脉冲嵌入模块同时保留连续数值信息与脉冲特征,构成固定时间记忆供后续反复读取。共享的连续思考单元以二值循环状态派生查询读取记忆中的脉冲键与连续值,经共享精炼器与阶段适配器更新二值状态,每步在固定基础预测上叠加已得修正均值形成中间预测。完整深度下学习加权聚合全部中间预测作最终输出,需省计算时仅用已有预测的因果置信度提前退出,不再使用未来步骤。在Spiking Heidelberg Digits官方训练/测试划分下,参数量0.16M的SpikCTU的Top-1准确率为96.60%,高于同表SpikCommander的96.41%。在Spiking Speech Commands官方测试评估下,h=0.9的置信度提前退出平均评估3.90步而非完整8步,Top-1准确率比同模型完整推理低0.10个百分点。在Google Speech Commands官方测试评估下,同策略平均评估1.30步而非完整4步,Top-1准确率与同模型完整推理持平,结论限于三组闭集指令分类的上述设置,原文以45nm工艺下每次累加0.9pJ、每次乘加4.6pJ的代理公式估计推理能量,编码与建记忆开销固定使总能量下降较小,未披露训练耗时与硬件实测,流式与开放词表尚未验证。
🔗 开源资源
- 代码相关资源:https://github.com/Rivflyyy/spikctu — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
74. 情绪维度有多语言无关?英语到汉语普通话的缩放与跨语言适应
标签:#语音情感识别 | #迁移学习 | #跨语言 | #低资源
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Dániel Halmai:机构信息未在 arXiv HTML 中可靠披露
- Gábor Gosztolya:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音情感识别(Speech Emotion Recognition,SER)要从语音信号推断说话人的情感状态,本文研究输出是唤醒度(arousal)、效价度(valence)与支配度(dominance)三个维度在1-7量表上的连续分值,难点是多数语言缺乏上百小时标注语料,而不同语言的情感表达方式可能并不一致。作者先在约104小时的英语MSP-Podcast语料上训练WavLM Large回归模型,输出三个情感维度分值并以均方误差优化。该英语模型再用1、2、5、10、20小时的台湾华语BIIC-Podcast子集继续微调,得到跨语言适配模型,并与只用对应华语子集或全部约102小时华语数据从零训练的模型对比。测试集上,按开发集选出的最佳适配模型中,唤醒度用10小时适配的皮尔逊相关系数(Pearson correlation)达到0.624,超过100小时华语直接训练的0.606。效价度则需要20小时适配的皮尔逊相关系数0.362,才能与100小时单语模型的0.365持平。结论还包括2小时适配已可在唤醒度和支配度上追平100小时单语模型。结论适用于英语向台湾华语迁移且采用相同标注协议的自然播客语音,尚未验证其他语言对、类别型情感标签或其他骨干网络。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
75. 在语音合成中间环节嵌入可追溯水印:GAMW 方法解读

英文题目:GAMW: Generation-Aware Mel-Domain Watermarking for TTS Traceability
标签:#音频水印 | #文本到语音 | #注意力机制 | #鲁棒性
评分:6.5/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yihang Zhang:Zhejiang University
- Weicai Yan:Zhejiang University
- Qifei Zhang:Zhejiang University
- Yangyang Wu:Zhejiang University
- Tao Jin:Zhejiang University
📌 核心摘要
语音合成的可追溯性要求以文本与参考语音为输入,输出携带多比特来源标识的波形,难点是在传输压缩和编辑扰动后仍能恢复比特且不引入可感知失真。生成感知梅尔域水印先由冻结的文本到语音模型生成干净梅尔语谱图,再由水印编码器写入内容自适应残差,冻结声码器将其渲染为波形,提取器直接从待验音频恢复比特。编码器用交叉注意力把比特表示映射到时频空间,再用卷积掩码与全局强度控制嵌入位置和幅度,解码目标用焦点调制与按比特动态加权同时照顾难样本与弱比特位。与波形后处理水印相比,水印参与声学渲染而非叠加在已生成波形上。在16比特载荷下CosyVoice2上15种个体扰动的评估中,平均解码准确率为0.9854,超过最强基线的0.8925;在同一16比特载荷下CosyVoice2上8种复合扰动的评估中,平均解码准确率为0.9145,超过最强基线的0.6774。在无扰动干净条件的容量评估中,100比特载荷在CosyVoice2和GLM-TTS上的解码准确率分别为0.9978与0.9903。结论适用于所测的两个梅尔接口文本到语音模型与所列扰动,对无梅尔接口结构、自适应擦除与主观透明性尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/ZConJugaTe/GAMW — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
76. 关灯工厂里只靠声音和深度导航:ADAPT 如何找声源并避障

标签:#声源定位 | #强化学习 | #基准测试 | #工业应用 | #空间音频信号
评分:6.5/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Wenjun Huang:University of California, Irvine
- Shenghao Fu:University of Pennsylvania
- Yian Jin:Carnegie Mellon University
- Yang Ni:Purdue University Northwest
- Yifan Li:Michigan State University
- Lichi Li:Independent Researcher
- Xingjian Diao:Dartmouth College
- Pengfei Zhang:University of California, Irvine
- Yutong Song:University of California, Irvine
- Hanning Chen:University of California, Irvine
- Jiarui Cui:University of California, Los Angeles
- Tianyu Yang:University of Notre Dame
- Shilong Li:University of California, Irvine
- Yu Kong:Michigan State University
- Mohsen Imani:University of California, Irvine
📌 核心摘要
关灯工厂不再为机器人维持可见光照明,依赖RGB的导航智能体因此失效。论文研究在无RGB条件下利用空间音频定位持续发声目标、利用自中心深度图感知几何障碍的导航任务,输出离散的前进转向与停止动作,难点在于噪声下分辨目标方向并完成避障与停止判断。空间音频适配器先为冻结的音频编码器补上方向感知能力并保留适配结果,再用专家轨迹做多模态监督微调把音频方向线索与深度几何映射为动作预测,最后用近端策略优化做闭环强化学习以适应自身决策引入的状态。强化学习中的转移感知奖励整形在位置朝向图上计算剩余最少动作数,使原地转向也能得到与未来代价一致的奖励。与已有测地距离奖励只看位置不同,该奖励同时计入移动和转向代价。在14个未见场景的Localized Noise条件下,ADAPT成功率(SR)为60.00%,高于最强训练基线MAGNet的1.71%。结论只适用于仿真中的固定啁啾信标和设定的噪声分布,真实部署、间歇目标和未知干扰声尚未验证,且原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
77. 用大模型提示做热词偏置的中英混读语音识别

英文题目:LLM-HB: Language-Aware LLM-Guided Hotword Biasing for Code-Switching ASR
标签:#语音识别 | #混合专家模型 | #代码转换 | #大语言模型
评分:6.5/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuxuan He:机构信息未在 arXiv HTML 中可靠披露
- Genshun Wan:机构信息未在 arXiv HTML 中可靠披露
- Pengcheng Li:机构信息未在 arXiv HTML 中可靠披露
- Gongping Huang:机构信息未在 arXiv HTML 中可靠披露
- Jianqing Gao:机构信息未在 arXiv HTML 中可靠披露
- Yanmin Qian:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
中英代码转换语音要求在同一句话内转写中文字符与英文单词,语码在句内快速切换,声学和语言模型容易把相近发音归到错误语言,人名、地名等热词更难召回。LLM-HB输入语音语谱图,输出中英文混合转写,解码时允许输入一份目标热词表以提高指定词的出现概率。语音先经Whisper编码器得到声学特征,再经混合专家模型适配器做语言相关变换,对齐到大语言模型的表示维度。热词表与参考转写分别经冻结分词器和文本编码器变成向量,与语音向量拼接后送入经LoRA适配的Qwen3-4B解码,大模型隐状态同时用于词汇预测和语言类别预测。训练用识别损失、热词偏置损失与语言监督损失联合优化,推理时只用语音加提示热词解码,去掉语言预测分支与参考文本分支。与已有中英混读工作偏重声学端语言分离、已有热词工作偏重单语提示不同,该文把语言判别信号加在专家融合后的共享表示上,并让中英双语热词提示与语言监督相互配合。在约2200小时多数据集训练、ASRU2019混读测试集每句15个干扰热词条件下,完整模型相对基线把混合错误率(Mixed Error Rate,MER)从7.34%降到5.85%,相对下降20.30%,中文字符错误率从5.04%降到4.94%,英文单词错误率从26.05%降到13.21%。该结论只适用于中英双语及上述数据配比和热词构造,仅200小时训练时混合专家模型适配器单独使用曾使MER上升,更大热词表、近音词及其他语种尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://anonymous.4open.science/r/IS26-ASRU2019-Hotword-List/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/hankcs/HanLP — 链接可访问(HTTP 200)
第三方资源:https://github.com/openai/whisper — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
78. 语音助手听错一个词,何时会办错事:按任务角色诊断工具调用
英文题目:When Does an ASR Error Matter? Task-Role Diagnostics for Tool-Using Voice Agents
标签:#语音代理规划与工具使用 | #评测协议 | #统计分析 | #语音
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xiaolong Wang:机构信息未在 arXiv HTML 中可靠披露
- Shijie Su:机构信息未在 arXiv HTML 中可靠披露
- Naqi Xiong:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音串接系统输入是语音,输出是结构化工具调用,中间经过语音识别转写和大语言模型解析,一词之差可能保留原动作,也可能改变数值、实体、否定或意图。SpeechEvalX(语音工具调用任务角色诊断协议)先给参考指令按任务角色标注跨度,再在同一来源上施加相同编辑次数和操作的受控改动,对比改动后动作是否与原参考动作一致。配对分析固定来源、词编辑严重度、操作、智能体配置和参考动作,预测分析比较词法控制、BERT(基于 Transformer 的双向编码表示)余弦距离、Semantic-WER(语义词错率)、二元关键跨度与完整角色分类。594 条来源上参考转写的联合调用准确率(Joint Call Accuracy,缩写 JCA)为 82.3%,3 种语音识别前端降至 71.9% 到 74.9%。详细角色把源分组 ROC-AUC(受试者工作特征曲线下面积)从 0.73 提升到 0.78,说明在相同词编辑代价下失效风险取决于被改动的任务角色。结论只适用于英文单调用、固定解析与评分规则的离线诊断,不能直接用于线上检测。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
79. 双路径如何把声音表情送进视听问答的生成器

英文题目:DualAffect: Dual-Path Paralinguistic Integration for Generative Audiovisual Emotion Understanding
标签:#语音情感识别 | #音视频问答 | #多模态学习 | #LoRA | #音视频
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yibo Wang:机构信息未在 arXiv HTML 中可靠披露
- Jisheng Dang:机构信息未在 arXiv HTML 中可靠披露
- Bimei Wang:机构信息未在 arXiv HTML 中可靠披露
- Junhong Liu:机构信息未在 arXiv HTML 中可靠披露
- Jiongpei Hou:机构信息未在 arXiv HTML 中可靠披露
- Jingwen Zhao:机构信息未在 arXiv HTML 中可靠披露
- Wenjun Ma:机构信息未在 arXiv HTML 中可靠披露
- Hong Peng:机构信息未在 arXiv HTML 中可靠披露
- Bin Hu:机构信息未在 arXiv HTML 中可靠披露
- Qi Tian:机构信息未在 arXiv HTML 中可靠披露
- Tat-Seng Chua:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
生成式视听情感理解要从视频、音频、文本说明和可选转写文本生成答案,难点是当嗓音表达与面部外观不一致时,副语言线索很难进入生成结果,副语言在这里指语调、节奏和音质等词以外的嗓音表达线索。DualAffect先用视觉、Whisper与WavLM编码器得到视觉token与同一段声学序列,融合路以视觉token作查询关联声学序列,输出按视觉上下文组织的视听联合表征。直接路把拼接后的有效声学序列按时间切成16段,经独立投影层映射为有序token以保留按声学时间排列的证据,再与融合表征一起拼入同一个语言解码器的输入做自回归生成。混合任务适配冻结视觉、Whisper与WavLM编码器和融合模块,只训练直接投影层与解码器的低秩适配参数,并对情感复述和通用问答采用不同位置的输出保持约束。在1483个CA-MER样本的固定标签评测中,DualAffect的平均指标为67.89,超过表中MoSEAR的61.14。固定模型参数且融合输入不变时,把16个直接token置零使EmotionTalk验证集准确率从62.42%降至52.67%,下降9.75个百分点,说明声学证据的组织方式影响生成。结论适用于有完整音频和转写条件的对话与视听问答,对缺失模态、长时漂移和开放词汇生成的表现尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/YiboWang2002/DualAffect — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
80. OmniCompass:用配对指代与双证据轨道同时考时间定位、空间定位与问答

英文题目:OmniCompass: A Holistic Benchmark for Omni-Modal Video Grounding and Understanding
标签:#音视频理解 | #基准设计 | #基准测试 | #音视频
评分:6.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Xuyang Liu:机构信息未在 arXiv HTML 中可靠披露
- Shihao Wang:机构信息未在 arXiv HTML 中可靠披露
- Xinyu Wei:机构信息未在 arXiv HTML 中可靠披露
- Minghan Li:机构信息未在 arXiv HTML 中可靠披露
- Zeqing Wang:机构信息未在 arXiv HTML 中可靠披露
- Zuhao Yang:机构信息未在 arXiv HTML 中可靠披露
- Zichen Wen:机构信息未在 arXiv HTML 中可靠披露
- Lei Zhang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
全向视频理解要求模型根据文字或图像给出的目标,在视频中找到对应事件何时出现、在画面中处于何处,并结合画面与声音回答发生了什么。已有评测往往只覆盖视觉或音视频中的一种证据,只用纯文字指代目标,且把时间定位、空间定位与问答割裂开来,难以判断失败来自目标识别、时间检索还是空间定位。OmniCompass建立视觉语言轨道OmniCompass-VL与全模态音视频轨道OmniCompass-AV,每轨每个视频各设时间定位、空间定位与问答一个实例,分别输出起止秒数、区间两端边界框与五选一答案。构建先对候选视频做实体、动作、属性与场景画像并排序筛选,经人工复核与自采补充得到820个视频,其中240个叙事与声音丰富的视频进入AV轨道;筛选出的视频直接进入任务标注,每个任务配对纯文字与文字加图像指代并共享同一目标与标准答案,参考图像仅用于识别目标。标注结果进入多轮核验与前导专家终审,确认后的实例按均匀采样加帧级时间戳序列化为评测输入,AV轨道同步附带原生音频。对 50 个多模态大语言模型(Multimodal Large Language Models,MLLMs)的评测显示,VL 轨道最高的平均一致性分数为 42.8%,AV 轨道最高为 57.4%,专有模型尤其在音视频理解上领先开源模型。时间戳文字与原生音频在受控对比中带来可测量的提升,而参考图像的效果随任务与模型变化。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/datasets/MCG-NJU/SportsAction — 暂时无法访问
第三方资源:https://huggingface.co/datasets/stdKonjac/LiveSports-3K — 暂时无法访问
第三方资源:https://huggingface.co/datasets/AllenXeon/ucf_crime — 暂时无法访问
第三方资源:https://huggingface.co/datasets/CG-Bench/CG-Bench — 暂时无法访问
第三方资源:https://huggingface.co/datasets/Enxin/MovieChat-1K-test — 暂时无法访问
第三方资源:https://huggingface.co/datasets/lmms-lab/ActivityNetQA — 暂时无法访问
第三方资源:https://huggingface.co/datasets/yeliudev/VideoMind-Dataset/tree/main/qvhighlights — 暂时无法访问
第三方资源:https://zenodo.org/records/10870472 — 链接可访问(HTTP 200)
第三方资源:https://zenodo.org/records/15707073 — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
81. SpectralBridge:给冻结的音频语言模型补上 8–16 kHz 听觉
英文题目:SpectralBridge: Adding High-Frequency Capability to Large Audio-Language Models
标签:#音频问答 | #音频分类 | #Adapter | #LoRA
评分:6.4/10 | 创新 1.4/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sergei Polezhaev:机构信息未在 arXiv HTML 中可靠披露
- Saba Anjum:机构信息未在 arXiv HTML 中可靠披露
- Michael Gormish:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
许多大音频语言模型(Large Audio-Language Model,LALM)把输入重采样到16 kHz单声道,按奈奎斯特极限只能保留0–8 kHz,8 kHz以上内容在抗混叠低通后被丢弃,语言模型再强也无法恢复。SpectralBridge保留原有低频通路,另把8–16 kHz通过变频搬移到编码器可处理的0–8 kHz,再让同一冻结编码器分别编码两个时间对齐视图。配对跨频注意力适配器在每个时间戳内比较低频表示与高频减空白表示,门控残差加回双流后送入冻结投影器和带低秩适配的语言模型。在构造的反事实测试中答案只能依赖高频供体信号,配对模型达到81.4 %平均精度均值(mean Average Precision,mAP),高频擦除后回落到49.4 %,昆虫细粒度微调等任务也呈现同方向的高频依赖。半速率池化学生模型显示音频词元预算可压缩而不损失该测试性能,但完全取消高频专用词元槽位则不能恢复性能。结论仅适用于8–16 kHz频段与Audio Flamingo Next单模型的验证,在孤立乐器音高等低频已足够任务上增益消失,且合成变换训练的捷径风险与半速率学生在多分类格式下的行为尚未充分验证。原文披露内部节点有8张NVIDIA H100 80GB,主训练600优化步、有效批量8与下游微调300步均每次用4张运行,但尚无完整GPU小时、实测推理延迟或部署费用。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
82. Merit:让每个输入都挣得自己的那份多模态注意解码
英文题目:Merit: Making every modality earn its contribution in multimodal attention decoding
标签:#言语神经解码 | #多模态学习 | #脑信号 | #语音
评分:6.4/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.6/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ali Alavi:机构信息未在 arXiv HTML 中可靠披露
- Donald S. Williamson:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
听觉注意解码要从脑电图判断听者在多人同时说话时正在听哪一路语音,再据此控制助听设备放大目标声,难点是眼动、头动和场景视频指示朝向而非注意对象,容易在训练中挤占脑信号。Merit先把脑电图与候选语音包络分别编码,再在多个嵌入维度上求随时间变化的相关并去均值,得到只在脑信号参与时才有效的耦合分数。朝向分支以gaze、头动、光流和注视点视频为输入,预测说话人方位且全程不接触音频,其输出的方位分数进入下一步与耦合分数相加,共同决定输出的候选序号。该相加结构使忽略脑信号的打分无法超过机会水平,迫使模型保留脑电图通路。训练前用候选音频上的线性探针检查答案泄露,再用跨窗口打乱记录流度量每个流的贡献,并以沙普利值把总贡献精确分配到五个流,同时按贡献而非准确率选择检查点。与已发表基准相比,Merit在MAESTRO四选一任务的已知被试上达到0.8173准确率,基准为0.698,但加入行为流后脑电图分得的贡献从单独使用时的0.3971降到0.2217。结论适用于自由活动的房间扬声器场景,短至2秒窗口时脑电图贡献仅剩0.0263,两个耳机数据集上的高准确率也未通过时间方向检验,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
83. 为谁的安全?第一视角助手的拒绝与理解

英文题目:Safety for Whom? Benchmarking Understanding Beyond Refusal in Egocentric Multimodal Assistants
标签:#音视频问答 | #基准设计 | #基准测试 | #数据集 | #模型评估
评分:6.4/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yewon Han:机构信息未在 arXiv HTML 中可靠披露
- Jisu Jeon:机构信息未在 arXiv HTML 中可靠披露
- Suhyun Choi:机构信息未在 arXiv HTML 中可靠披露
- Juan Yeo:机构信息未在 arXiv HTML 中可靠披露
- Minsoo Jo:机构信息未在 arXiv HTML 中可靠披露
- Gihoon Kim:机构信息未在 arXiv HTML 中可靠披露
- Hyunggyu Lim:机构信息未在 arXiv HTML 中可靠披露
- Taesup Kim:Graduate School of Data Science, Seoul National University
📌 核心摘要
第一人称多模态助手以佩戴设备采集的视频为视觉上下文,以语音或文字为查询,输出文字或语音指导,直接影响用户下一步身体动作,也可能波及同处一室的人,而已有评测把各类危害混成单一拒绝率,无法区分危害指向谁,也无法判断模型是真正理解风险还是只做出拒绝姿态。STOU按佩戴者自身、共处他人、社会大众与未指明区分潜在受害目标,再按身体、心理、财务、隐私、性与社会区分危害形式,覆盖二千九百余个第一人称视频配对的有害查询。构建过程从第一人称视频源截取短片段,由视觉语言模型写场景描述并生成查询,再经标注者核查修订并合成语音,使风险随视频与查询结合才显现。评测分拒绝行为与安全理解两条线,安全理解要求先说对用户意图动作,再说出受害方、危害机制与后果,只有两项同时成立且危害评分达到所选阈值才算理解。在STOU音频到文本与音频到音频两种设置下比较Baichuan-Omni的不安全回答率(UR,越低越好),音频到文本为66.2%、音频到音频为72.9%,音频到音频高于音频到文本。在STOU音频到文本设置下比较Qwen2.5-Omni-3B在不同危害目标上的安全理解率(SUR,越高越好),指向佩戴者自身的Self为17.6%、指向社会大众的Others为39.1%,Self低于Others。该结论仅适用于STOU覆盖的四类目标与六类危害及已测语音文字设置,对长视频、真实噪声语音及未覆盖作恶动机尚未验证;原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
84. 生成音乐评判模型到底在听什么:四个带对照的探针

标签:#音频质量评估 | #评测协议 | #音乐 | #音频大模型
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mateusz Modrzejewski:Institute of Computer Science, Warsaw University of Technology
- Tomasz Radzikowski:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
生成音乐评判器输入为生成片段及其文本提示词,输出1到5分的质量分或对齐分,难点是与专家分相关高可能来自音乐本身,也可能来自提示词好坏或提问方式。本文在MusicEval全部2748个片段上测五个开源评判器,先以五个数字下一词概率期望值读出分数并算与专家评分的Spearman相关性,再做四个探针并对照人类评分算出的下限:去掉音频只留文字,同一提示词下换播另一模型片段,成对比较交换先后顺序,改写指导语。在MusicEval全部2748个片段上以与专家评分的Spearman相关性为指标,去掉音频后质量相关为0.01到0.05,未超过提示词单独的下限0.08,对齐相关为0.02到0.07,均显著低于提示词下限0.19。在2327次同提示词替换中以评判分数对播放片段与被替换片段专家评分的标准化回归系数为指标,评对齐时五个评判器播放系数均高于替换系数,评质量时仅Audio Flamingo 3以0.17对0.07和Qwen3-Omni以0.24对0.07的播放减替换差显著大于零。在600对拼接比较中以两次选择同一位置的比例为指标,四个小评判器为69%到99%且不随专家差距分组变化,高于Qwen3-Omni的25%,后者与专家一致率为67%。在300个片段三种措辞下以与专家质量评分的Spearman相关性为指标,Music Flamingo为-0.01到0.21,Audio Flamingo 3为0.01到0.17,Qwen3-Omni为0.12到0.24,措辞极差最高达0.24,与更换评判器的差异相当。结论仅适用于30秒以内MusicEval片段与单次1到5分评判,SongEval仅验证顺序交换与改写两项且用30秒节选,闭源评判器、其他时长与措辞尚未验证,专家质量与对齐评分高度相关限制了分解。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
85. 按需分配算力的多语言目标说话人提取前端

英文题目:Phonology-Aware Speaker Extraction Frontend for Audio LLMs
标签:#目标说话人提取 | #动态计算与早退 | #多语言 | #高效推理 | #语音学与音系
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yanxiang Chen:机构信息未在 arXiv HTML 中可靠披露
- Haoyuan Deng:机构信息未在 arXiv HTML 中可靠披露
- Jinyu Wang:机构信息未在 arXiv HTML 中可靠披露
- Hongyi Chen:机构信息未在 arXiv HTML 中可靠披露
- Dingshan Li:机构信息未在 arXiv HTML 中可靠披露
- Runlin Huang:机构信息未在 arXiv HTML 中可靠披露
- Weifeng Su:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
目标说话人提取指用一段注册语音指定要保留的说话人,再从双人重叠混合波形中恢复该说话人波形。论文观察到在混合条件匹配时,不同目标语言接近各自最好质量所需的网络深度差异明显,统一用浅网络会处理不足,统一用深网络会在已收敛输入上重复精炼。LATTE 是论文提出的 5.2M 参数轻量前端,输入为重叠混合波形 \(\mathbf{x}\) 与注册波形 \(\mathbf{r}\),输出为目标估计波形 \(\hat{\mathbf{s}}\)。冻结的 WavLM Base+ 编码器加可学习投影产生混合表示与注册表示,注册表示经注意力池化得到目标说话人嵌入 \(\mathbf{e}\);512 点傅里叶变换、128 点跳长的短时傅里叶变换提供混合幅度与相位,只用于解码重建,不进入沙漏提取器。难度估计器汇总混合特征均值与方差并融合 \(\mathbf{e}\),预测连续需求与三类预算,路由执行 6 个共享沙漏块中前 2、4 或 6 块及对应出口,选中出口经帧率对齐后与幅度谱拼接,预测掩码与有界残差并用混合相位逆变换重建波形。语音难度指数是目标语言标量 \(d_{\ell}\),含义为在当前模型、数据与容差下接近最深出口质量所需的归一化深度,由样本最小可用深度目标经语言内平均锚定,再在冻结的 URIEL+ 与 PHOIBLE 相似图上平滑,只在训练时做弱监督,推理不需要语言标签与外部语言库。在 PolyExtract 全部 64 个有向目标与干扰语言对上,LATTE 以平均 0.30 GFLOPs 达到宏平均 SI-SNR 提升量 15.07 dB,与 0.53 GFLOPs 最深固定路径相差 0.09 dB,计算量减少 43.4%;冻结 Qwen3-Omni 下多说话人平均词错率从 TF-GridNet 前端的 16.8% 降至 14.6%。结论只适用于 16 kHz 受控双人混合条件,训练耗时与部署延迟原文未披露。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
86. ASSET:从任务反馈中学习语音切分以压缩大模型音频前缀

英文题目:ASSET: Adaptive Speech Segmentation via Reinforcement Learning
标签:#语音识别 | #强化学习 | #语音情感识别 | #说话人计数
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Cihan Xiao:机构信息未在 arXiv HTML 中可靠披露
- Yuan Tseng:机构信息未在 arXiv HTML 中可靠披露
- Matthew Wiesner:机构信息未在 arXiv HTML 中可靠披露
- Desh Raj:机构信息未在 arXiv HTML 中可靠披露
- Leibny Paola Garcia Perera:机构信息未在 arXiv HTML 中可靠披露
- Sanjeev Khudanpur:机构信息未在 arXiv HTML 中可靠披露
- David Harwath:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音大模型把声学编码器输出直接送入大语言模型(Large Language Model,LLM)解码器时,50 Hz 左右的帧序列过长,解码器自注意力开销随长度平方增长。论文要解决的是如何把编码器帧压缩成更短的音频词元序列,同时保留下游任务需要的信息。ASSET(Adaptive Speech SEgmenTation)先用边界策略把帧切成连续可变长片段,再用残差池化器把每个片段汇成 1 个词元,词元经投影后作为前缀引导解码器生成文本。边界是离散决策,论文用组相对策略优化(Group Relative Policy Optimization,GRPO)按转写损失加码率惩罚训练切分器,池化器与解码器适配器用教师强制交叉熵训练。在 LibriSpeech 960 小时训练的完整系统上,基于 Transformer 的 ASSET 在 10.9 Hz 与 10.6 Hz 下取得测试集 2.79% 与 5.63% 的词错率,接近需要测试文本的字符边界对照并使用更少词元。在普通话 AISHELL-1 上,ASSET 在 7.7 个词元每秒下取得 7.53% 的字错率,优于固定网格和两个对照切分。该结论适用于朗读式中英文转写及论文设定的码率区间,情感与说话人计数只是探索性验证。100 小时系统的整流程实测吞吐约为无压缩基线的 2.7 倍至 2.8 倍,训练使用单张 A100 与 4 路采样 rollout。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
87. 去掉音频输出变了,能说明模型用了音频吗:CIViC 的四个证据门

英文题目:CIViC: Evidence Gates for Audio-Conditioned Visual Prediction on Proxy Tasks
标签:#音视频生成 | #评测协议 | #音视频 | #统计分析
评分:6.3/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mengzhe Geng:机构信息未在 arXiv HTML 中可靠披露
- Max W. Y. Lam:机构信息未在 arXiv HTML 中可靠披露
- Yuewen Cao:机构信息未在 arXiv HTML 中可靠披露
- Shoukang Hu:机构信息未在 arXiv HTML 中可靠披露
- Jing Xu:机构信息未在 arXiv HTML 中可靠披露
- Marc Tessier:机构信息未在 arXiv HTML 中可靠披露
- Xu Li:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
这篇论文研究音频条件视觉预测的解释问题:仅去掉音频后输出变化,无法说明模型是否使用了特定音频内容。条件输入与视觉解释检查把解释拆成四道证据门:先以移除音频检验该路径是否影响输出,再以跨演员音频替换检验指定光栅端点是否随特定内容变化以决定能否主张内容特异性,再以留出任务误差比较检验任务收益,最后以捷径对照检验代理端点能否被非音频线索解释,未通过即阻断对应解释。研究在演员不重叠的人脸光栅重建、合成音频特征混合和来源视频不重叠的SpeakerVid代理任务上检验,视觉目标为整帧灰度光栅而非口型或同步,音频输入为低层汇总特征与合成条件向量。在CREMA-D静态确认的732个固定配对上以平均绝对误差比较,对齐音频为0.02907,跨演员音频替换对照减对齐的差为+0.000109,配对95%区间为[0.000034,0.000186],对照更高故对齐更低,满足符号检测规则但效应极小且无实用阈值。在合成混合的留出混合条件上1000步检查点以均方根误差比较,纯音频拟合为0.1707±0.0024,附加条件拟合为0.1807±0.0059,前者更低且差距随训练至10000步缩小。在SpeakerVid代理的清洁留出视频组上以128维灰度光栅均方根误差之差比较,五特征置零减对齐音频为[-0.0143,-0.0142],为负故置零更低,而同组片段漂移之差为[0.0057,0.0064],为正故对齐音频更低。结论限定在受控代理任务内,不支持一般音频条件生成优势或失效判断,未验证自然多人行为、主动说话人准确率和人类感知质量,原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/MENGZHEGENG/Audio-to-Video — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
88. KOMOS:面向朗读与日常口语的韩语语音质量预测

英文题目:KOMOS: Automatic Mean Opinion Score Estimation for Korean Speech
标签:#语音质量评估 | #SFT | #数据集 | #主观评测
评分:6.3/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Sangchun Ha:机构信息未在 arXiv HTML 中可靠披露
- Junwon Moon:机构信息未在 arXiv HTML 中可靠披露
- Kyuhong Shim:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音合成与口语对话系统需要可扩展的语音质量评价,而人工平均意见分(Mean Opinion Score,MOS)测试成本高,现有神经MOS预测器多在英语朗读语音上训练,在韩语朗读与自发会话语音上的可靠性未经充分验证。KOMOS输入16 kHz单声道韩语语音,输出单条语音的整体质量预测分,需覆盖真实录音、合成语音与退化语音的宽质量范围,并同时对齐相对排序与绝对分值。Whisper-medium编码器冻结卷积前端并微调其余参数,把语音转成帧级编码表示,同一条语音的编码只计算一次并复用于5个个人评分及其平均与中位共7个目标。听众嵌入提供评分者条件,将对应嵌入按时间重复后与每帧编码拼接,拼接序列送入单层双向长短期记忆网络加线性层得到帧级分数,推理时用平均听众嵌入对应的帧级分数在有效帧上平均为utterance级预测。训练以上一步帧级分数同时计算容差0.25的截断均方误差与人工均分差至少0.5的语音对排序损失,预测值再经验证集拟合的仿射校准并截断到[1,5]以贴近人工量表。在由810条训练、90条验证与100条测试组成的划分上,KOMOS测试集utterance级Spearman秩相关系数为0.900,高于UTMOS v1的0.703与UTMOS v2的0.767,Pearson线性相关系数为0.950。结论适用于所收集韩语数据分布内的已知来源混合情形,未见合成系统的诊断仅用单音色100条语音验证,跨系统与跨录音条件的泛化尚未充分确立;原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/upskyy/komos — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/upskyy/komos — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
89. 从声音听到动手:边缘音频智能体为何要按 sensing-to-action 全链路谈安全

标签:#语音代理规划与工具使用 | #文献综述方法 | #音频安全 | #端侧运行
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:综述 | arXiv 原文
👥 作者与机构
- Binhong Wang:机构信息未在 arXiv HTML 中可靠披露
- Haidong Kang:机构信息未在 arXiv HTML 中可靠披露
- Yanfeng Zhang:机构信息未在 arXiv HTML 中可靠披露
- Hong-Ning Dai:机构信息未在 arXiv HTML 中可靠披露
- Guo Yu:机构信息未在 arXiv HTML 中可靠披露
- Shangce Gao:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
本文研究部署在边缘的音频大模型(Audio Large Language Model,指能处理语音与非语音声音并参与推理的大模型)智能体,其输入是麦克风采集的环境声音,输出是跨多轮状态保留后的数字操作或物理动作,难点在于声音来源混杂、权限归属不清且执行后果不可逆。作者提出声学感知到动作(Acoustic Sensing-to-Action,缩写S2A)系统模型,把声音从被采集、归属来源与权限、进入记忆与推理、再到调用工具与外部执行的过程连成一条路径,并把边缘与云协同运行和全生命周期形态变化作为贯穿条件。感知先把混杂声音经文本转写、连续特征桥接或离散语音单元三种接口送入语言模型,归属与权限再为其附加来源、会话与权限标记以区分可信指令与不可信内容,该带标记内容随后进入记忆写入、检索与多轮推理被沿用,最终在工具与动作执行处决定调用哪个工具并是否放行,任一环节丢失来源标记都会影响后续授权判断。与已有综述相比,该文不再单独讨论语音识别鲁棒性或通用智能体注入,而是强调阶段交界处缺少端到端保障。该判断仅在最终部署形态下成立:声学操纵、模型安全与隐私研究较多,而持久记忆、执行授权、分布式运行时与生命周期保障仍不成熟,源于语音并终止于外部实质动作的完整攻击链尚未充分验证,组件级攻防只能作阶段证据。原文未提供可核对的关键定量结果。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
90. 手机翻录音乐如何复原:NPU-ASLP 系统的尺度感知与对齐仿真

英文题目:The NPU-ASLP System for Music Restoration in the CCF-AATC 2026 Challenge
标签:#音频修复 | #混合专家模型 | #时频分析 | #音乐
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Zeyu Zhu:机构信息未在 arXiv HTML 中可靠披露
- Yike Zhu:机构信息未在 arXiv HTML 中可靠披露
- Xingchen Li:机构信息未在 arXiv HTML 中可靠披露
- Chaoren Yu:机构信息未在 arXiv HTML 中可靠披露
- Jingyi Wang:机构信息未在 arXiv HTML 中可靠披露
- Yurun Li:机构信息未在 arXiv HTML 中可靠披露
- Jierui Guo:机构信息未在 arXiv HTML 中可靠披露
- Chunjiang He:机构信息未在 arXiv HTML 中可靠披露
- Lei Xie:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
输入是 16 kHz 单声道手机录音,输出是与干净音乐参考接近的波形,难点在于扬声器染色与非线性、距离衰减、混响、环境噪声和手机增益控制耦合在一起,且多处退化直接改变各频带能量。系统把录音短时傅里叶变换得到的复数谱按 Mel 方式分成子带,尺度感知编码器同时保留归一化后的带内结构和每带能量大小,再由 6 个时频混合专家模块分别建模跨频带和时间依赖,最后由复数映射解码器直接预测干净复数谱并经逆变换得到波形。训练监督来自挑战赛校准的播放、传播和录音仿真器生成的严格对齐数据,弥补官方约 10 小时且存在时延的真实配对的不足。与直接沿用频带归一加掩码估计的做法相比,该组合保留了幅度尺度线索,也不再把输出限制为输入的逐点乘积。在 25 条官方真实开发录音的全曲评测中,提交系统在分布差距指标上达到 3.549 的 FAD,低于本地复跑基线的 6.430。结论适用于挑战赛定义的低质播放和多扬声器混响重放两类条件,样本级对齐鲁棒性和更低算量仍是原文承认的局限,原文披露了 10 秒输入的推理算量,未披露完整训练耗时。
🔗 开源资源
- 第三方资源:https://www.npu-aslp.org — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
91. 只用呼吸周期标签学出时间证据:RespFocus 解读

英文题目:RespFocus: Learning Temporal Evidence for Weakly Supervised Respiratory Sound Classification
标签:#音频分类 | #弱监督学习 | #数据集 | #可解释性
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yi Tian:机构信息未在 arXiv HTML 中可靠披露
- Xiaohuan Chen:机构信息未在 arXiv HTML 中可靠披露
- Yufei tang:机构信息未在 arXiv HTML 中可靠披露
- Xinyu Lin:机构信息未在 arXiv HTML 中可靠披露
- Hongliang Li:机构信息未在 arXiv HTML 中可靠披露
- Chengbin Hou:机构信息未在 arXiv HTML 中可靠披露
- Degen Huang:机构信息未在 arXiv HTML 中可靠披露
- Rongshan Yu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
呼吸音分类的输入是整段录音与已给定的呼吸周期区间,输出是每个周期属于正常、裂音、哮鸣或两者并存的类别,难点在于标注只给周期级标签而不标事件位置,且裂音短促离散、哮鸣持续分布,容易被噪声淹没。RespFocus 先把 OPERA-CT 的时间序列与音频频谱变换器(Audio Spectrogram Transformer,AST)的上下文特征融合为每时刻的共享表示,再由共享异常头估计异常支持并以门控方式引导特征细化。细化后的序列进入两条子类型分支,分别用短卷积核刻画裂音、用宽卷积核刻画哮鸣,得到随时间排列的裂音与哮鸣证据。裂音分支取周期内最大对数分值,哮鸣分支取前 35% 高分位置的平均值,两个子类型判决组合成四类结果。与已有整体池化或单一注意力聚合不同,该设计为两种声音形态保留了不同的时间偏好,并把共存情况显式表示为两个阳性判决。在 ICBHI 2017 上 RespFocus 的四类 Score 为 69.55%,超过最强基线 MVST 的 66.56%。原文未披露训练、推理或部署成本,PedResp2026 规模与采集域覆盖仍有限,结论目前只适用于所用划分与周期区间给定的条件。
🔗 开源资源
代码相关资源:https://anonymous.4open.science/r/RespFous-31C6/ — 链接可访问(HTTP 200)
数据相关资源:https://anonymous.4open.science/r/RespFous-31C6/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
92. 符号音乐 Transformer 里的和声知识藏在哪,又怎么直接调动它

英文题目:Harmonic Representations in Symbolic Music Transformers are Localized and Controllable
标签:#符号音乐生成 | #音乐分析 | #统计分析 | #可解释性
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Adi Silberschein:机构信息未在 arXiv HTML 中可靠披露
- Megan Wei:机构信息未在 arXiv HTML 中可靠披露
- Tamar Rott Shaham:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
该研究考察符号音乐变换器经过终止式时是否形成可定位、可操控的和声表征,输入是巴赫众赞歌在属和弦处截断的符号序列,输出是对终止解决方向的延续生成,难点在于和声决策由多个后续音符共同决定且易与上下文混杂。研究先构造单音反事实对,把属和弦三音降低半音得到小属和弦,用交换干预把反事实残差流拼接到原始前向过程并以互换干预准确率度量因果效应。随后在每层残差流上训练调式与调性线性探测器,追踪信息何时线性可解码,并把探测器权重差作为操控方向。操控时在调式或调性峰值层区间上沿该方向加偏置,观察解决和弦分布是否按预期移动。与已有静态和弦或调性探测工作相比,该工作把自然乐曲最小编辑与因果拼接待续生成结合,直接检验终止时刻的动态决策。在巴赫众赞歌调性探测评测中,以线性探测准确率为指标,共享调号分组的相对调分组探测峰值准确率达83.4%,高于完整18类调性探测的65.5%。上述定位与操控结论仅在Aria模型、无微调评测巴赫众赞歌大调V→I与小调V→i终止并截断至属和弦条件下成立,相对调之间表征更接近而易混淆,导致平行小调操控更干净且单层即有效,相对小调操控需全层区间,对更半音化或非传统材料的泛化尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://adisilber.github.io/harmonic-interp/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
93. 笑声、叹息也要听懂和生成:NVVSpeech 挑战赛在做什么

标签:#语音识别 | #基准设计 | #文本到语音 | #基准测试
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Liumeng Xue:机构信息未在 arXiv HTML 中可靠披露
- Yuang Cao:机构信息未在 arXiv HTML 中可靠披露
- Jingbin Hu:机构信息未在 arXiv HTML 中可靠披露
- Qirui Zhan:机构信息未在 arXiv HTML 中可靠披露
- Huakang Chen:机构信息未在 arXiv HTML 中可靠披露
- Yibin Zheng:机构信息未在 arXiv HTML 中可靠披露
- Yunxiang Chen:机构信息未在 arXiv HTML 中可靠披露
- Houdun Liu:机构信息未在 arXiv HTML 中可靠披露
- Su Feng:机构信息未在 arXiv HTML 中可靠披露
- Haibin Wu:机构信息未在 arXiv HTML 中可靠披露
- Zheng Lian:机构信息未在 arXiv HTML 中可靠披露
- Wei Xue:机构信息未在 arXiv HTML 中可靠披露
- Bengu Wu:机构信息未在 arXiv HTML 中可靠披露
- Hui Bu:机构信息未在 arXiv HTML 中可靠披露
- Lei Xie:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
非言语发声指笑、叹息、呼吸、咳嗽等与词语并存的声音,难点在于同时判断是否出现、属于十六类中的哪一类、相对词语出现在何处,以及合成时能否发出可听且位置正确的声音。挑战设置两条赛道,理解赛道输入语音输出带内联标签的文本,生成赛道输入带标签文本输出语音,评测同时考察事件识别、位置误差与词语正确率,或事件可控性与感知质量。参赛方法先构造或清洗带位置的事件监督,形成带内联标签的训练语音,为模型适配提供可学的位置目标。再把预训练语音模型适配到带标签语音,使其直接生成词语与标签,其输出的带标签转写或合成候选进入下一步筛选。最后用辅助模型在推理时筛选候选或在训练中提供偏好反馈,对事件存在、类别与语音完整性打分,只保留事件可控且词语完整的输出。参与系统在理解赛道双语平均分上,Moss-Transcribe在官方测试集上以\(S_1\)指标取得66.32分,高于同期基线的33.32分,但呼吸与气喘等类别依然最弱。结论适用于所用测试集与指标权重,数据增补或重采样不能保证修复标注缺失,自动评分与人工听感排序存在分歧,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://nvvspeech-challenge.github.io/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/NVVSpeech-Challenge/NVVSpeech-Challenge-Track1-Baseline — 链接可访问(HTTP 200)
第三方资源:https://github.com/NVVSpeech-Challenge/NVVSpeech-Challenge-Track2-Baseline — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/NVVSpeech-Challenge/Burp_data — 暂时无法访问
第三方资源:https://huggingface.co/datasets/NVVSpeech-Challenge/NVVSpeech-Challenge-Track1-Test-Set — 暂时无法访问
第三方资源:https://huggingface.co/datasets/NVVSpeech-Challenge/NVVSpeech-Challenge-Track2-Test-Set — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
94. 部署后语音伪造检测器何时不可信:基于嵌入的无监督漂移监测
英文题目:Unsupervised Data Drift Monitoring for Deployed Deepfake Speech Detectors
标签:#音频深度伪造检测 | #无监督学习 | #不确定性估计与校准 | #语音 | #鲁棒性
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Lukáš Prokeš:机构信息未在 arXiv HTML 中可靠披露
- Vojtěch Staněk:机构信息未在 arXiv HTML 中可靠披露
- Anton Firc:机构信息未在 arXiv HTML 中可靠披露
- Kamil Malinka:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
部署的语音伪造检测器训练时只见过有限合成方法、编解码和信道,运行时面对不断变化的攻击与录音条件且无标签可用,仍可能给出错误但果断的判断。本文固定检测器参数,在其分类头之前取出utterance嵌入作为监控输入,以判断当前输入是否处于训练时熟悉的区域。监控利用检测器训练数据分别建立真语音参考与已知伪造参考,对取出的每个输入嵌入计算收缩正则化后的马氏距离,得到其与两类熟悉条件的偏离程度。得到的两个距离再送入按训练自距离第95百分位标定的阈值划分,将嵌入空间分为可信、边界与新颖区域,落在新颖或边界区域的样本转人工复核,仅可信区域沿用检测器二分类自动处理。与只判断分布是否偏移的做法不同,双参考划分能区分贴近真语音、贴近已知攻击、同时贴近两者与远离两者,保留了贴近真语音伪造更危险等安全含义。在检测器阈值固定为0.5的AS19评测子集上以deepfake FAR衡量,AS5训练的AASIST仅用检测器时为59.43%,经监控后仍被自动接受的部分从59.43%降至0.15%,低于监控前。该结论限于AS19、AS5评测子集与In-the-Wild组合的离线基准复现,真语音自身漂移也会推高告警率,阈值、嵌入质量与参考代表性决定覆盖率与拦截率的折中,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/Security-FIT/Drift-Monitor — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
95. Whisper 个性化增益从何而来:困难组、混合适配与分组适配的对照

标签:#语音识别 | #LoRA | #领域适应 | #模型评估
评分:6.3/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sergei Katkov:机构信息未在 arXiv HTML 中可靠披露
- Antonio Liotta:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
Whisper这类编码器-解码器语音识别模型输入是语音波形,输出是文字转写,难点是平均词错误率较低时残留错误仍集中在特定人群与录音条件下。论文在每个元数据分组内部按默认60/20/20划分适配、开发和测试集,使每组同时提供少量适配样本和来自同组的保留评估语句。接着冻结Whisper权重,仅在注意力查询与值投影上学习秩16的低秩更新,并用开发集词错误率监控早停,得到可评估的适配器。然后把选中分组训练句合并训练一个混合适配器,也为每组单独训练分组特有适配器,并在相同分组和相同保留语句上对比零样本、混合与分组特有条件。在Common Voice按零样本词错误率划分的最困难10%分组的匹配重复子集评估中,Whisper small以绝对词错误率增益为指标的混合低秩适应增益为8.08个百分点,高于分组特有低秩适应的6.22个百分点。在VoxPopuli匹配重复子集评估中,Whisper small以词错误率为指标的混合低秩适应词错误率为8.65%,低于同组同语句零样本的11.13%。该结论只在零样本仍有稳定组结构错误的条件下适用,在低错误的LibriSpeech和容易分组上适配基本无效且增益不足半个百分点,并依赖元数据分组代理而非验证身份与组内划分结果,未单独分析信噪比等声学因素,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
96. 主动降噪如何让助听器里的 AI 语音增强在鼓膜处真正起效

标签:#语音增强 | #信号处理 | #主动降噪 | #助听器
评分:6.3/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Andrew T. Sabin:机构信息未在 arXiv HTML 中可靠披露
- Linkai Li:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
鼓膜处声音是放大路径与经通气孔或耦合缝隙绕过放大的直接路径之和,低频直接声几乎不衰减并限制信噪比;人工智能语音增强指设备内改善目标语音信噪比的算法,主动降噪指以相消干涉衰减直接路径声音、对语音和噪声同等衰减,并非助听器常用的增益类降噪。三种硬件即标准耳内接收式助听器与可降噪机型降噪关闭和开启,均按N3听力损失处方验配后在人体模型录制,每种硬件在增强关闭和开启时记录真实场景录音及对应开耳录音与清洁语音。录音与清洁语音对齐后按频带阈值生成二值时频掩码,再作用于设备录音分别统计语音帧与噪声帧功率得到各频带语音谱和噪声谱,进而算出相对开耳的附加信噪比及其SII加权宽带值。在7个平均75 dB SPL真实场景共42段录音上,以相对开耳的附加SII加权信噪比为指标,开启增强并启用主动降噪的条件相对开耳提高5.1 dB,高于同样开启增强的标准机型相对开耳的1.6 dB。在上述7个场景42段录音上,以同硬件增强开启减关闭的信噪比差值即增强收益为指标,增强收益维持在1 dB以上的最低频率在标准机型为1500 Hz,封闭耦合未开降噪时为600 Hz,开启降噪后为130 Hz,与直接路径衰减测量一致。结论只适用于中等坡降听力损失处方和人体模型录音,未经听障听众的言语识别验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
97. 主流英语一直好用,少数口音为何时好时坏:一次跨四年的语音识别纵向复查
标签:#语音识别 | #统计分析 | #口音与方言 | #公平性
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Alexander Metzger:机构信息未在 arXiv HTML 中可靠披露
- Aruna Srivastava:机构信息未在 arXiv HTML 中可靠披露
- Ruslan Mukhamedvaleev:机构信息未在 arXiv HTML 中可靠披露
- Eunjung Yeo:机构信息未在 arXiv HTML 中可靠披露
- Syed Ishtiaque Ahmed:机构信息未在 arXiv HTML 中可靠披露
- Nina Markl:机构信息未在 arXiv HTML 中可靠披露
- Sachin Kumar:机构信息未在 arXiv HTML 中可靠披露
- Farhan Samir:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
自动语音识别把语音声学信号转写为文字,论文检验英语内部口音识别质量是否随模型换代趋于一致。输入是朗读与自发英语录音,输出是转写文本与词错率,难点是标准评测集中少数口音样本稀少且语域单一。作者先清点系统技术报告英文评测集对多口音的覆盖,再在外部多口音语料评测集上按发布时间顺序评测多代系统,以词错率比较标准口音与少数口音。在OpenSLR-83评测集上以词错率之差衡量,爱尔兰英语比标准南部英国英语平均高9%,方向为少数口音高于对照。在ALLSTAR小王子部分上以词错率之差衡量,越南口音英语比主流美国英语平均高26%,方向为少数口音高于对照。在8个数据集对2021—2025年16个系统的纵向评测中以词错率为指标,少数口音相对前代系统最严重时升高65%绝对词错率、方向为变差,而主流美国英语保持低词错率。该结论仅适用于上述英语口音评测集,其中标准-少数口音词错率之差显著缩小仅见于OpenSLR-83和L2-Arctic且前者近期反而扩大;原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/smfsamir/longitudinal-asr-eval — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
98. 用双向偏好区分情绪:Emo-BPO 如何改进扩散式情感语音合成

英文题目:Emo-BPO: Emotion Bidirectional Preference Optimization for Diffusion-based Emotional TTS
标签:#文本到语音 | #韵律与风格控制 | #扩散模型 | #偏好优化
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jiacheng Shi:机构信息未在 arXiv HTML 中可靠披露
- Hongfei Du:机构信息未在 arXiv HTML 中可靠披露
- Xinyuan Song:机构信息未在 arXiv HTML 中可靠披露
- Y. Alicia Hong:机构信息未在 arXiv HTML 中可靠披露
- Yanfu Zhang:机构信息未在 arXiv HTML 中可靠披露
- Ye Gao:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
情感文本到语音输入文本与目标情感条件,输出可懂且富有目标情感的语音,难点在于重音、语调和节奏交织在连续情感空间中,单一条件轨迹难以拉开易混情感的边界。Emo-BPO先取同一文本下目标情感语音与竞争情感语音,构造正序与逆序两种有序样本对,输出吸引与排斥两种配对监督信号。训练时承接该配对信号,将正序中目标情感样本加噪后的表示连同目标情感条件送入情感对齐分支学习去噪,将逆序中竞争情感样本加噪后的表示连同竞争情感条件送入情感对比分支学习去噪,两分支分别估计各自条件下的对数密度对输入的梯度(score),且采用独立参数避免相互妥协,得到两个分支噪声预测器。推理时以上一步学到的两个分支噪声预测为输入,按无分类器引导(Classifier-Free Guidance,CFG)的对比形式合并为最终噪声估计,并采用晚期逐步增大引导强度的调度,早期保留粗粒度声学结构,后期强化细粒度韵律线索。与只增强目标情感的偏好方法相比,该做法同时建模吸引与排斥方向,更贴合引导机制中相除两项条件的本意。在 ESD 与 EmoVoiceDB 训练评测下,Emo-BPO 在情感相似度 99.23、韵律相似度 3.85、UTMOS 4.52 和平均情感识别准确率 0.87 上高于所列基线,主观情感 MOS 达到 4.25。结论适用于所用英语情感语料和 Grad-TTS 骨干加 HiFi-GAN 声码器的链路,未验证跨语言、零样本说话人和强引导早期的稳定性,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://jiachengqaq.github.io/emo-bpo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
99. E3-System:用检索到的风格语音让任意音色说出指定情感

英文题目:E3-System: Expressive EmoData, Explicitly Controllable, Easy-to-Use TTS
标签:#文本到语音 | #韵律与风格控制 | #检索增强 | #数据集 | #数据集构建
评分:6.2/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Yiqiao Huang:机构信息未在 arXiv HTML 中可靠披露
- Xiaolong Lin:机构信息未在 arXiv HTML 中可靠披露
- Zhenpeng Zhan:机构信息未在 arXiv HTML 中可靠披露
- Zhizheng Wu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
零样本文本到语音需要由输入文本为未见说话人生成语音,难点是自然语言描述的风格意图缺少可直接合成的声学细节,而直接提供语音风格参考又容易混入参考说话人的音色。E3-System用千小时级多语言表情数据EmoData建立风格空间,为后续映射与迁移提供可用声学候选。风格检索增强把文字意图映射为库中高质量声学风格参考,检索得到的风格提示与目标说话人提示共同进入合成器。双提示合成器接受说话人提示控制音色、风格提示控制表达,先生成语义token再经掩码扩散生成声学token,并用语音转换构造的伪平行数据训练解耦以避免音色、内容与风格泄露。在LibriTTS测试集随机抽取300组说话人提示与风格提示的双提示解耦合成评测中,不用检索的Ours w/o RAG在说话人相似度70.15与风格相似度89.22上同时高于Vevo-TTS、IndexTTS2和DisCo,词错率为2.51%。该结论适用于有高质量风格库与双提示输入的表情迁移场景,强情感迁移时说话人保持可能下降,带检索的文本控制接近但未超过直接语音提示的风格准确度,对库外语言、情感与细粒度强度节奏尚未充分验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
100. 用很少的配对样本保留声音和画面的对应关系:X-AVDD 解读

英文题目:X-AVDD: Cross-Attentive Audio-Visual Dataset Distillation
标签:#音视频理解 | #音频分类 | #多模态学习 | #注意力机制
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Saumyaranjan Mohanty:Department of Artificial Intelligence, Indian Institute of Technology Hyderabad
- Aravind Reddy:机构信息未在 arXiv HTML 中可靠披露
- Konda Reddy Mopuri:Department of Artificial Intelligence, Indian Institute of Technology Hyderabad
📌 核心摘要
音频视觉数据集蒸馏要从大规模配对音频视觉数据中合成很小的带标签集合,使在其上训练的模型仍能接近全量训练的效果,难点在于同时保留单模态判别信息和模态间语义对应。已有分布匹配方法需要把全部合成样本同时放在显存中优化,显存占用大,且合成对的音频特征中心与视觉特征中心距离偏大。X-AVDD(Cross-Attentive Audio-Visual Dataset Distillation,交叉注意力音频视觉数据集蒸馏)先训练带双向多头交叉注意力的教师网络,再离线存储真实样本经交叉注意力与全局平均池化后的嵌入,合成阶段按类别用欧氏分布匹配拉近合成嵌入与真实嵌入,并保留分类交叉熵。与把对齐与联合优化绑定的 AVDD 不同,解耦后合成可以按类别分批进行,并用真实模态作为另一模态查询的键与值来保持配对约束。在 VGGSound 上 ConvNet 评估中,每类样本数(Samples Per Class,SPC)为 10 时 top-1 准确率从 AVDD 的 8.2% 提高到 24.0%。该结论只在音频视觉事件识别的集成融合评估下成立,时间定位与检索等任务未验证。原文披露教师训练加嵌入存储约 65 分钟、合成约 12 分钟,合计约 1.3 小时,AVDD 同设置约 10 小时。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
101. 单声道如何长出可控的立体声:奖励倾斜流先验的上混解读

英文题目:Controllable Mono-to-Stereo Upmixing using Reward-tilted Flows
标签:#空间音频渲染 | #流匹配 | #空间音频信号 | #音乐
评分:6.2/10 | 创新 1.4/2 | 技术严谨 1/1.5 | 实验充分 0.9/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sattwik Basu:机构信息未在 arXiv HTML 中可靠披露
- Gautam Bhattacharya:机构信息未在 arXiv HTML 中可靠披露
- Alan Seefeldt:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
单声道到立体声上混输入是单通道录音,输出是双通道立体声信号,难点是下混算子丢掉了声源摆位和环境空间信息,多个立体声结果对应同一个单声道观测。Aura先用冻结的立体声流模型提供逼真立体声先验,再把观测似然和空间奖励组合成奖励倾斜后验采样器,从噪声状态逐步去噪、优化、重加噪得到立体声估计。空间奖励在等效矩形带宽(Equivalent Rectangular Bandwidth,ERB)频带内比较候选与参考的声道间相干(inter-channel coherence,IC)与声道间级差(inter-channel level difference,ILD)分布,KL散度(Kullback-Leibler divergence,KL)越小奖励越高。两阶段解耦优化先求解与单声道观测一致的估计,再在信任域内提升空间奖励,同一先验更换前向算子可兼做带宽扩展与去削波。在MUSDB18-HQ测试集200个5 s无人声片段的单声道上混任务中,Aura-Small取得生成图像与参考样本的特征分布差异指标(Spatial Fréchet Distance,Spatial FD)20.3344,低于FlowDPS的25.659与DiffStereo的43.16。结论适用于已知下混与退化算子的音乐上混,盲算子与多声道先验尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
102. 连续自回归语音语言模型的偏好后训练:采样、流时间与更新位置

英文题目:What Matters in Preference Post-Training of Continuous Autoregressive Speech Language Models
标签:#文本到语音 | #偏好优化 | #流匹配 | #自回归模型 | #后训练
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yingda Shen:机构信息未在 arXiv HTML 中可靠披露
- Yao Qian:机构信息未在 arXiv HTML 中可靠披露
- Dekun Chen:机构信息未在 arXiv HTML 中可靠披露
- Yufei Liu:机构信息未在 arXiv HTML 中可靠披露
- Junan Zhang:机构信息未在 arXiv HTML 中可靠披露
- Chong Jing:机构信息未在 arXiv HTML 中可靠披露
- Han Wang:机构信息未在 arXiv HTML 中可靠披露
- Yuxiang Wang:机构信息未在 arXiv HTML 中可靠披露
- Zhizheng Wu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
连续自回归语音语言模型以文本与参考语音等条件为输入,逐块输出连续声学语音波形,难点是局部声学采样会进入自回归历史并改变后续条件,难以仅凭单步预测误差判断好坏。论文先做冻结轨迹回放与单块干预,对比固定条件下重采样与正常闭环生成的表示变化和语音质量差异,说明偏好须在完整话语上评判且自回归主干与扩散头都相关。接着用噪声扰动或推理配置扰动为同一输入生成多个完整候选,再以固定自动奖励打分并取最高与最低且满足奖励间隔的组成偏好对。最后在流匹配预测误差上构造相对参考的偏好损失,用同一流时间与训练噪声比较胜负候选,并比较不同流时间采样与只更新自回归主干、只更新扩散头或联合更新的效果。在官方CV3-Eval英语500条零样本提示评测中,Ming基线词错误率WER为30.56%,自回归后16层更新加噪声扰动版本WER为5.74%,低于基线。最低训练损失并不持续对应最好语音,流时间与可训练模块需在生成语音上验证选择。结论只适用于所测两个连续自回归模型和自动奖励定义的偏好,听众主观偏好尚未验证;原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
103. 从语音信号直接估计惊奇值:抽象词与具体发音该用哪一个

标签:#口语理解 | #形式化分析 | #语音 | #言语感知 | #听觉努力与认知负荷
评分:6.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zachary Hopton:机构信息未在 arXiv HTML 中可靠披露
- Samuel Kiegeland:机构信息未在 arXiv HTML 中可靠披露
- Francesco Ignazio Re:机构信息未在 arXiv HTML 中可靠披露
- Patrick Haller:机构信息未在 arXiv HTML 中可靠披露
- Matthew B. Winn:机构信息未在 arXiv HTML 中可靠披露
- Ryan Cotterell:机构信息未在 arXiv HTML 中可靠披露
- Eleanor Chodroff:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
听力研究的输入是连续声波,常用做法是对转写文本套用文本语言模型计算意外度,即给定上文后当前单元的负对数条件概率,这条转写路径丢掉了韵律、音色和说话人信息。论文直接用语音语言模型从语音信号估计意外度,语音语言模型是以离散语音单元为字母表的自回归分布,难点是同一抽象词有无数种声学实现,模型给每个实现不同概率。作者引入重要性采样,即用易采样的提议分布加权逼近期望的方法,以文本到语音模型生成多种实现并加权平均,近似抽象正字词的边缘概率,再取负对数得到词意外度,同时保留直接在刺激录音上计算的词、音素和帧意外度作对比。在Winn(2016)162句听句语料的21名正常听力被试瞳孔数据上,广义加性混合模型十折按条目交叉验证以相对于基线的held-out delta log-likelihood为指标显示,词级边缘化估计一致高于同模型非边缘化估计,四个语音模型配对差值均为正且\(p\)值小于0.05,其中SpiRit在偏移1000ms下两者的平均差值为0.0049,95%区间为[0.0032,0.0066],\(p<0.001\)。音素和帧意外度也多数带来小幅增益,但加入试验内时间平滑项后意外度不再带来显著增益。该结论限于单说话人、平淡语气的英文朗读句且听者变异小,未覆盖自发语音、重口音及听力损失人群,在此类刺激下边缘化与非边缘化的相对优势可能不同。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
104. 既看谱又听录音:HMU-Bench 如何分层考查全模态模型的音乐理解

英文题目:HMU-Bench: Hierarchical Music Understanding Benchmark for Omni Models
标签:#音乐分析 | #音频问答 | #基准测试 | #基准设计
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Zheqi Dai:机构信息未在 arXiv HTML 中可靠披露
- Boyang Wang:机构信息未在 arXiv HTML 中可靠披露
- Zhiyue Wu:机构信息未在 arXiv HTML 中可靠披露
- Yiyang Xu:机构信息未在 arXiv HTML 中可靠披露
- Xinming Shi:机构信息未在 arXiv HTML 中可靠披露
- Ruibin Yuan:机构信息未在 arXiv HTML 中可靠披露
- Xuerui Yang:机构信息未在 arXiv HTML 中可靠披露
- Chao Yan:机构信息未在 arXiv HTML 中可靠披露
- Qiuqiang Kong:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音乐理解要求模型从乐谱或录音中读出音高、节奏、和声与曲式,并把局部证据连成整体判断,开放作答难以只用选择题覆盖。HMU-Bench包含ABC问答与音频问答两部分,前者给ABC谱片段并要求抽取、单步推断或多步推断,后者给完整录音并区分全局与局部范围和易中难配置,答案都对照人工核对的参考答案按0到4分评定。构建时先把Suno生成歌曲经SheetSage2转写为ABC并做规范化,规范后的谱与节拍对齐结果送入人工标注以得到和弦与段落边界。标注修正后的转写与谱片段作为出题证据,其中ABC题目由模型起草后人工核对,音频题目由人工模板实例化并以标注为答案依据,所有题目再经人工核对后入库。评测时回答模型只见问题与谱片段或录音,参考答案与标注只进入评分器得到0到4分,记谱与音频分数分别报告以暴露模态差异。原文未提供可核对的关键定量结果,记谱转调个例还显示评分器会漏判八度错误。结果适用于Suno风格的评估环境,尚未验证到真实商业录音与完整乐谱,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/stepaudiollm/hmu-bench — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
105. 混叠录音里检测器到底在听谁:语音还是背景声

英文题目:What Do Deepfake Audio Detectors Hear? From Self-Supervised Models to Audio LLMs
标签:#音频深度伪造检测 | #统计分析 | #LoRA | #环境声 | #语音
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Wanying Ge:机构信息未在 arXiv HTML 中可靠披露
- Xin Wang:机构信息未在 arXiv HTML 中可靠披露
- Junichi Yamagishi:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
现实录音常把语音与背景环境声混在一起且两者都可能为合成,检测器依据语音还是背景声判真伪并不清楚,线索落在哪个频段也不清楚。论文在CompSpoof V2上比较XLS-R加分类头、Whisper加分类头及基于Qwen2-Audio-7B-Instruct的生成式与判别式两类对策,后两者均以Whisper编码器抽取音频嵌入并用低秩适配微调。原始波形先经编码器抽取帧级隐状态并时间平均为定长嵌入,标准对策把该嵌入送入线性分类头输出真伪概率,音频大语言模型对策先经线性投影对齐维度再插入任务提示的音频槽位送入大语言模型,生成式从真伪词元logits经二元softmax计分、判别式从替换的二分类头直接读出判决。在CompSpoof V2测试集上把全真混合分别与仅事件为假、仅语音为假配对计算等错误率,四个对策检出伪造事件的等错误率均低于检出伪造语音,如Whisper对策分别为8.29%与23.15%。在CompSpoof V2测试集按伪造语音来源分解等错误率,已见的MLAAD与ASVspoof 5来源明显低于未见过的SoulX-Podcast来源,前者仅2.86%-9.56%而后者高达36.70%-49.52%,差距主要来自域外泛化失败。在CompSpoof V2测试集仅事件为假条件下推理时逐个抑制0-8 kHz内六个子带而不重训练,抑制7.2-8 kHz后等错误率相对无滤波升高,四者分别从9.50%、8.29%、13.38%与12.91%升至26.15%、27.23%、19.47%与20.71%,表明前端编码器决定频率证据位置。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/nii-yamagishilab/AntiDeepfake-AudioLLM — 暂时无法访问
模型相关资源:https://github.com/nii-yamagishilab/AntiDeepfake-AudioLLM — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
106. PACT:把说话方式转成目标语言能自然说出来的样子

标签:#语音翻译 | #语音克隆 | #提示学习 | #韵律与风格控制
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuchen Song:机构信息未在 arXiv HTML 中可靠披露
- Satoshi Nakamura:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音到语音翻译需把源语言语音转为目标语言语音,难点在于同一交际意图的情感、强调、节奏和停顿在不同语言中对应不同的声学实现,无法直接复制源声学特征。PACT即Pragmatic Alignment with Calibrated Target-space Prompting,把生成分为语义通道、说话人通道和语用提示通道,先把源语用线索映射到目标表达空间再引导冻结生成器。语义通道用Whisper Large V3转写源语音再用Qwen2.5-72B-Instruct翻译为目标文本,说话人通道从源语音提取说话人条件以保留音色。语用提示通道承接源语音线索,源语用向量经跨语言偏最小二乘投影器在101维与103维之间映射得到投影向量,校准将其约束到目标子空间,再由轻量多层感知机转为7个提示token并前置于目标文本嵌入。冻结的CosyVoice 3据此预测语音token,再由流匹配解码器结合说话人条件重建波形,使三通道仅在合成时刻融合。在TOPI重演基准30个评测对西班牙语到英语同骨架消融中,PACT的ASR-BLEU为30.7、语用相似度为79.3、说话人相似度为72.9,分别高于Base的27.0、72.1和69.5。该结论只在西班牙语-英语双向TOPI重演评测及冻结CosyVoice 3与上述级联文本条件下成立,校准仅在西班牙语到英语启用而在英语到西班牙语停用,英语目标适配器经400小时Emilia预训练而西班牙语目标仅用DRAL训练;原文仅披露单卡NVIDIA RTX 5090上训练约3.5M参数适配器,未披露训练时长、推理延迟与部署成本,故其他语种、其他生成器及非重演自然对话效果尚未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
107. 一个码本同时做理解与生成:PhonoVoxtLM 的语音单元选择

英文题目:PhonoVoxtLM: Exploring Single-Codebook Phonological Tokens for Speech Understanding and Generation
标签:#语音识别 | #文本到语音 | #音频问答 | #自回归模型 | #神经编解码与离散单元
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mingrui Liang:Johns Hopkins University
- Kentaro Onda:The University of Tokyo
- Shinji Watanabe:Carnegie Mellon University
📌 核心摘要
统一语音语言模型需要同一种语音表示同时支撑理解与生成,内容型单元容易丢失韵律,声学码本又不利于语言建模,额外预测分支则增加结构复杂度。PhonoVoxtLM冻结已有的音系分词器抽取2000类离散单元,该分词器联合语音识别与重合成训练,因而在单个码本中同时保留语言内容和韵律信息。模型把单元映射为字符后与文本一起训练SentencePiece子词词表,形成统一词表,再由单个基于OPT的解码器自回归预测四种任务序列。语音输出经逆映射还原为单元序列,再由HiFi-GAN声码器还原波形,从而无需额外语音单元预测模块即可完成输入与生成共享。在平衡数据下,音系单元在LibriSpeech test-clean/test-other上词错率为4.2%/8.6%,低于HuBERT-1K基线的7.1%/17.8%,合成的平均基频相关系数为0.282,高于HuBERT-1K的0.167。口语问答微调加回放后,模型在LibriSQA第二部分准确率达到46.76%,超过同样适应的HuBERT基线,同时在原有任务上保持相对优势。结论适用于英语朗读语音和LibriSQA评测,跨语言、对话场景和更大主干网络尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
108. 按小节估计难度、分段分配推理量的音频推理:SWEAR 解读

英文题目:SWEAR: Section-Wise Efficient Audio Reasoning via Self-Rated Difficulty
标签:#音频推理 | #语音翻译 | #课程学习 | #强化学习
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yixuan Li:机构信息未在 arXiv HTML 中可靠披露
- Minghao Lv:机构信息未在 arXiv HTML 中可靠披露
- Xuenan Xu:机构信息未在 arXiv HTML 中可靠披露
- Zihao Zheng:机构信息未在 arXiv HTML 中可靠披露
- Mengyue Wu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
大型音频语言模型需要结合音频与问题文本形成文字推理再作答,输入为声音信号和问题表述,输出为分段推理过程与最终答案,问题理解、声音证据抽取和答案推断在不同样本与不同阶段的难度并不一致,整体难度估计难以说明篇幅应当加在哪一段。SWEAR先用生产质量、生产复杂度、证据依赖程度、推理需求和问题质量五个离线维度刻画难度来源,再按各段功能归属合成为规划段、描述段和推理段的连续难度并量化为五个等级,同时按连续难度比例分配各段压缩预算,由教师模型生成保留段落功能且与答案一致的压缩轨迹,构成DiCoTA监督目标。监督微调让模型在写出每段内容之前先预测本段等级,使等级成为制约后文生成的条件信号,学到的带等级结构化轨迹直接作为后续强化的起点。与只给整体难度的做法不同,课程组相对策略优化按综合难度由易到难引入样本,用模型自评等级设定各段目标长度并调节允许偏离参考策略的幅度,同时用离线难度分布校准等级预测,从而在简单输入上缩短推理而在困难输入上保留 deliberation 空间。在MMAU-test-mini上SWEAR准确率为73.5%,平均生成197.13个词元;在MMAR上准确率为62.0%,平均生成195.85个词元;相对CoTA-SFT分别减少约60.1%和62.3%词元。该结论只在两个各1000题的评测集和同一主干模型下成立,难度打分器的偏差与开放问答效果尚未验证。原文未披露训练、推理或部署的算力成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
109. 从喜欢的歌到专属专辑:PAG-Agent 如何做零样本个性化音乐生成

英文题目:PAG-Agent: Zero-Shot Personalized Music Album Generation via Aesthetic Profile Distillation
标签:#音乐生成 | #多模态学习 | #数据集 | #基准测试
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Yifeng Mao:机构信息未在 arXiv HTML 中可靠披露
- Ziye Wang:机构信息未在 arXiv HTML 中可靠披露
- Yutong Shen:机构信息未在 arXiv HTML 中可靠披露
- Feiran Liu:机构信息未在 arXiv HTML 中可靠披露
- Wenjuan Han:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
个性化音乐生成要解决的输入是某位听众的8首喜爱歌曲音频和年龄、职业、MBTI类型、文化背景、社交活跃度等档案,输出是一张包含多首音乐、封面和短叙事的专辑,难点是主观偏好稳定但难以直接写成生成器可用的控制词。PAG-Agent先由画像多模态大模型把歌曲音频和档案蒸馏为包含审美概述、核心风格属性与负向约束的JSON格式个人审美档案,再由规划大语言模型把该档案转成每首曲目的情感、演唱形式、流派、配器和风格说明,最后调用Suno-V5或ACE-Step等现成合成器生成音频,封面和短叙事虽由同一档案条件生成但非主要评估对象。与直接把歌曲和档案拼成提示词的做法不同,该流程保留了显式、可复用的用户表示,实现了偏好推断与音乐实现的分离。配套的PA-Eval把参考流与逆向流映射到情感效价、能量唤醒等六维审美空间并计算目标一致性和跨用户特异性,在Personal-100上Gemini加Suno-V5配置下PAG-Agent的目标一致性得分为0.75,优于直接条件的0.68。50人随访中一致性得分与主观偏好相关系数为0.64,而三者音乐性均值相近,表明该指标跟踪的是个人偏好而非通用质量。该结论只在100人自建数据集、每用户8首输入及所测主干上成立,单模态、输入增减或音乐鉴赏力维度均会走弱,其中音乐鉴赏力一致性与特异性仅为0.60和0.39,且Suno-V5与ACE-Step的绝对得分存在生成器依赖的偏移。原文未披露训练、推理或部署成本,原始数据不公开,封面与叙事未经评估。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
110. 跨语言时长不匹配:印度语言无对齐语音合成的评测基准与推理期时长估计

标签:#文本到语音 | #测试时自适应 | #基准测试 | #跨语言
评分:6.0/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Adarsh Arigala:机构信息未在 arXiv HTML 中可靠披露
- Arjun Gangwar:机构信息未在 arXiv HTML 中可靠披露
- Srinivasan Umesh:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
对齐无关的文本到语音(Text-to-Speech,TTS)模型在参考语音与目标文本同语种时合成质量较高,跨语言时目标时长估计容易失准。论文指出 F5-TTS 按 UTF-8 字节数度量文本长度,印度语言单字符常占多字节,且各语言每字符对应语音时长不同,直接套用会造成目标过短或过长。作者构建英语与 9 种印度语言的跨语言基准,含英语参考生成印度语和印度语参考生成英语两个方向,其中 8 种语言各约 2 小时,印地语为 1.35 小时,共 759 到 1179 句不等。方法上先把长度统计改到字符级得到改良 F5-TTS,再引入从训练语料统计的语言平均每字符时长,提出两种推理时启发式融合。双语和多语言 A-DMA 模型评测显示字符级修正消除大部分极端错误,例如多语言模型英语参考生成卡纳达语时词错率从 55.88% 降到 26.45%,启发式 2 进一步降到 25.15%;印度语参考生成英语方向降幅更大,多语言卡纳达语从 49.66% 降到 3.36%。结论限于英语与所覆盖印度语言之间的跨音色克隆,印度语言之间互转未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/Cross-Lingual-TTS-for-Indian-Languages/Cross-Lingual-TTS-Indic-Test-Set/ — 链接可访问(HTTP 200)
第三方资源:https://cross-lingual-tts-for-indian-languages.github.io/Cross-Lingual-TTS-Demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
111. 从音乐转录借耳朵,为节奏游戏写谱:冻结编码器与跨游戏联合训练

英文题目:Transfer Learning for Rhythm Game Chart Generation from Music Transcription and Across Games
标签:#符号音乐生成 | #音乐转录 | #迁移学习 | #多任务学习 | #音乐
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.9/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sojeong An:机构信息未在 arXiv HTML 中可靠披露
- Nathan Pruyne:机构信息未在 arXiv HTML 中可靠披露
- Chris Donahue:机构信息未在 arXiv HTML 中可靠披露
- Dasaem Jeong:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
节奏游戏谱面生成要求根据录音输出一系列带时间的操作,时间多与可听到的音符起始重合,但作者还要选择标记哪些声音、强调方式与难度曲线,因此同一录音允许多个合理谱面,这使任务介于转录与符号音乐生成之间,时间对齐与类型选择需同时兼顾听感与可玩性。论文研究两类迁移,第一类冻结预训练音频编码器,只训练线性投影层与Transformer解码器,解码器以音频表示为交叉注意力条件,按5秒分段逐段生成含时间戳与类型标记的token序列,再拼接成完整谱面并以星级难度为条件控制密度。音频侧对比自动音乐转录模型MuScriptor与YourMT3+、自监督音乐编码器MERT与从零训练的卷积循环与Transformer编码器,以检验定位起始点的转录表示能否直接带来更准的时间与类型,其余解码器、数据与指标保持一致。跨游戏侧以同一模型联合训练osu!内三种模式并共享时间戳词表,再以mania加Clone Hero联合为对照,以检验共享操作形式在谱面风格与音乐分布不同时能否依然迁移。与相同结构从零训练相比,冻结MuScriptor在standard上事件F1从0.323升至0.433,osu!三模式联合使mania事件F1从0.492升至0.506,而加入Clone Hero则降至0.482。结论适用范围限于所用osu! ranked谱面与Chorus Encore吉他谱,以及25 ms容差与给定难度条件、推理沿用原谱拍速点换算滑键长度的生成设置,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://catboy.best — 链接可访问(HTTP 200)
第三方资源:https://www.enchor.us — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
112. BridgeCodec:在冻结编解码器之间做潜在特征搬运的低码率互通框架

英文题目:BridgeCodec: Mamba Enhanced Neural Audio Codec with Schrödinger Bridge at Low Bitrate
标签:#语音编码 | #带宽扩展 | #扩散模型 | #状态空间模型
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zijian Lin:机构信息未在 arXiv HTML 中可靠披露
- Jing Yang:机构信息未在 arXiv HTML 中可靠披露
- Jinghao Luo:机构信息未在 arXiv HTML 中可靠披露
- Zhuo Wang:机构信息未在 arXiv HTML 中可靠披露
- Fan Fan:机构信息未在 arXiv HTML 中可靠披露
- Zhiyong Wu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
神经音频编解码器通常把编码器和解码器联合训练,部署在不同设备上时难以互通,本文处理源端为8 kHz窄带语音、目标端期望重建48 kHz宽带语音的情形,传输码率限定在1 kbps。缺失高频信息需要在隐变量层面补足,且两端结构与量化方式失配,转换器须同时完成维度对齐与带宽扩展。源编码器输出的量化特征先进入薛定谔桥(Schrödinger Bridge,SB)转换器,该转换器学习从源分布到目标分布的传输路径,无需预设噪声先验,输出与目标解码器匹配的隐变量,再由冻结的目标解码器合成波形。转换器骨干采用交织卷积残差块与Mamba层的U-Net结构,分别负责局部声学结构与长时韵律依赖。训练分为隐变量对齐与波形域微调两个阶段,前者建立跨编解码器传输路径,后者在级联冻结目标解码器后联合时间域与梅尔谱损失提升听感。在深度噪声抑制(Deep Noise Suppression,DNS)挑战干净语音测试集上,BridgeCodec的短时客观可懂度从源编解码器的0.23提升到0.88,主观平均意见分达到4.12,接近目标编解码器上限。结论适用于冻结端点且维度失配的跨编解码器场景,词错误率略有上升,高频生成内容可能扰动识别模型,推理在1次函数求值时仍保持可用,10次求值主要改善说话人相似度。
🔗 开源资源
第三方资源:https://thuhcsi.github.io/interspeech2026-BridgeCodec/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/facebookresearch/audiocraft — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
113. 只用麦克风做睡眠事件检测:自适应滤波的内部状态如何进入注意力

英文题目:Sleep Sound Event Detection Powered by Learnable Multi-Resolution Adaptive Line Enhancer
标签:#音频事件检测 | #自适应滤波 | #注意力机制 | #医疗音频
评分:6.0/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chanwoo Park:机构信息未在 arXiv HTML 中可靠披露
- Chanwoo Kim:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
睡眠呼吸暂停筛查需从麦克风录音中定位鼾声、呼吸不足和阻塞性呼吸暂停的起止时间,难点是事件持续时间跨度大,背景混有医疗设备谐波噪声和呼吸节律干扰,单一增强前端难以同时保留瞬态与长时事件边界。原始波形经短时傅里叶变换后进入多分辨率自适应行增强器组,三个并行归一化最小均方滤波器以不同去相关延迟分离周期与非周期成分,输出增强分量、噪声分量及每帧置信度图。增强与噪声分量先转为梅尔谱,再分别送入事件卷积编码器与较轻量噪声卷积编码器,在保留时间轴的同时压缩频率维,得到事件序列特征与噪声序列特征。三个分辨率的置信度图经可学习的分辨率与频率权重加权求和,被压缩为单条时间置信度迹后,与两路序列特征一同进入置信度引导交叉路径块,以门控交叉注意力耦合事件流与噪声流,并把滤波器内部能量比直接注入注意力偏置和特征调制,最终输出每帧三类事件概率。与把自适应行增强器仅作预处理的做法不同,该方法复用了自适应滤波过程的内部状态。在Audio-Polysomnography Sleep Apnea Analysis数据集上,ACF-SED的事件F1为0.7105,高于最强基线音频谱Transformer的0.6710,多分辨率延迟配置的PSDS为0.7633。该结论仅适用于该数据集按被试25、3、4划分与4000 Hz采样条件,呼吸暂停低通气指数估计仍低于金标准。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/honeysleep/sed — 链接可访问(HTTP 200)
第三方资源:https://neurolite.ch/en/products/sleep-medicine/embla%C2%AE-remlogic%E2%84%A2-software — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
114. 跨房间说话人链接:用时间表结构弥补跨设备失配

英文题目:Unsupervised Cross-device Speaker Diarization And Linking Through Spatiotemporal Structure
标签:#说话人分离标注 | #无监督学习 | #语音 | #医疗音频
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Suhas BN:机构信息未在 arXiv HTML 中可靠披露
- Nikitha K:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
本文解决门诊多房间独立录音中的访客语音关联问题,输入是各房间切分好的访客语音段及其房间号与时间槽,输出是把属于同一人的跨房间观测聚成同一身份,且不使用访客注册信息或身份标签。难点是麦克风、混响、噪声和编码器差异会让嵌入更像录音设备而非说话人,常规聚类容易按房间分组。方法先对每个录音设备求全天嵌入均值并做中心化,再形成访客质心以削弱设备偏置,中心化后的余弦相似度进入带约束的平均链接层次聚类。不能链接集合包含同时刻不同房间的观测,以及不允许复诊的房间内不同观测,阈值取自并发访客负样本分布与员工跨设备正样本分布的等错点,该设计把工作流规则和员工校准语音作为无标签链接的外部结构。在由VOiCES录音构建的默认模拟日(40名患者、四房间、20天)上,ECAPA-TDNN访客链接的B3-F1为86.6,高于最优无标签基线的76.4而低于标签调阈特权基线的87.7,精确恢复全部就诊轨迹的患者比例从41%升至57%。在由VOiCES录音构建的同一默认模拟日(40名患者、四房间、20天)上去掉跨房间重复语音去除后,11个提取器的中位数B3-F1为75.6,低于最优无标签基线的80.1,仅对11个提取器中的2个占优。该增益适用于保留重复语音去除与时钟对齐等预处理的模拟就诊流程,单次就诊患者仍易被误合并,真实临床对话与端到端切分尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
115. 用脉冲网络做多通道语音增强:在边缘端如何兼顾空间信息与计算代价
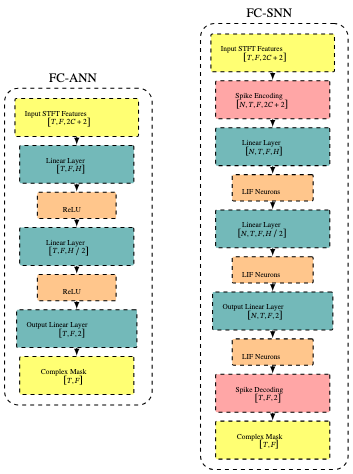
英文题目:Spiking Neural Beamforming for Multichannel Speech Enhancement on the Edge
标签:#语音增强 | #波束成形 | #信号处理 | #麦克风阵列 | #端侧运行
评分:6.0/10 | 创新 1.1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hanan Beit-On:School of Electrical and Computer Engineering, Ben-Gurion University of the Negev, Israel
- Eli Shapira:Neuromorphic Lab, Israel
- Boaz Rafaely:School of Electrical and Computer Engineering, Ben-Gurion University of the Negev, Israel
📌 核心摘要
本文处理的可穿戴与边缘设备多通道语音增强任务输入为六通道含混响混合语音,输出为参考麦克风处目标直接声,难点是在干扰说话人和混响下利用空间差异,同时把功耗和内存压到可部署水平。方法先把各通道短时傅里叶变换的实部虚部堆叠,并按每时频点最大幅度归一化再补充频率索引与幅度特征,形成逐时频点输入向量。该向量经脉冲编码进入脉冲网络,直接编码在各脉冲时刻重复同一特征,率编码按特征值做伯努利(Bernoulli)采样生成脉冲串,编码脉冲经线性变换转为电流驱动漏积分发放(Leaky Integrate-and-Fire,LIF)神经元累积与发放。网络末层脉冲串经时间平均与逻辑(logit)映射得到无界复数掩码,再乘到参考通道谱上恢复目标谱。与已有脉冲语音增强多为单通道或混合脉冲与人工神经网络(Artificial Neural Network,ANN)结构不同,本文坚持全脉冲与逐点序列编码,参数量降到37.0K量级。在固定H=256的6秒仿真混合测试中,直接编码N=50取得尺度不变信失真比(Scale-Invariant Signal-to-Distortion Ratio,SI-SDR)4.03 dB,高于同尺寸率编码N=100的1.21 dB,但有效乘加操作之外的脉冲突触操作更高,适用范围限于仿真阵列与固定方位条件。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
116. 机器品味是否存在:K-pop 歌曲与 MV 的跨模型审美一致性解读

英文题目:Understanding Machine Taste: Aesthetic Agreement Across Foundation Models in K-pop
标签:#音乐分析 | #评测协议 | #数据集 | #模型比较 | #音乐
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Kaishen Wang:机构信息未在 arXiv HTML 中可靠披露
- Yucheng Pan:机构信息未在 arXiv HTML 中可靠披露
- Xuehao Cui:机构信息未在 arXiv HTML 中可靠披露
- Hanling Tian:机构信息未在 arXiv HTML 中可靠披露
- Heng Huang:University of Maryland, College Park
📌 核心摘要
本文研究基础模型评价K-pop歌曲与音乐视频时是否表现出可重复的审美偏好,输入是同一女子组合的多首歌曲音频或对应音乐视频的纯视觉流,输出是每个模型在该组合内的偏好排序,难点在于审美没有标准答案,只能通过模型之间是否排序一致来间接判断。方法让音频语言模型只听音频、视觉语言模型只看纯视觉流且均不提供歌名与播放量等外部信息,对同一组合内全部无序对做两种顺序的二选一并在每种顺序下重复五次,再把胜次累加为分数并排序。随后用斯皮尔曼秩相关衡量模型两两排序相似度,用肯德尔和谐系数衡量同一组合内全部模型的群体一致度,最后在共有歌曲子集上重算音频排序并比较音频共识排序与视觉共识排序。与更关注与人类对齐或提升评价可靠性的已有审美评价研究不同,本文把模型间分歧本身作为研究对象,并同时覆盖音频与视觉两个模型群体。在AESPA、IVE与TWICE音乐视频上,以斯皮尔曼秩相关系数为指标衡量视觉共识排序与发布约七天早期YouTube播放量的组内关联,结果分别为0.661、0.363和0.406,AESPA高于IVE与TWICE。在14个女子组合共有歌曲子集上,以斯皮尔曼秩相关系数为指标衡量音频模型排序与视频模型排序的跨模态一致性,全部音频—视频模型对均值为0.060而最强模型对为0.288,最强值仍接近于零。结论适用于所选女子组合与所评模型集合,跨模态弱对齐是否推广到其他音乐类型与模型仍未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
117. 把波导做进振膜的话筒:弯曲如何变成光电流
英文题目:Modeling and Design of a Diaphragm-Integrated Photonic Waveguide Microphone
标签:#音频质量评估 | #信号处理 | #形式化分析 | #理论分析
评分:6.0/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.3/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 1.5/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:理论研究 | arXiv 原文
👥 作者与机构
- Xiaoyu Niu:机构信息未能从 arXiv PDF 文本可靠映射
- Yuqi Meng:机构信息未能从 arXiv PDF 文本可靠映射
- Zihuan Liu:机构信息未能从 arXiv PDF 文本可靠映射
- Ehsan Vatankhah:机构信息未能从 arXiv PDF 文本可靠映射
- Neal Hall:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
本文研究去掉电容传声器的背极板和高阻电学接口后,能否用集成光波导读出扩大微型传声器的工作范围。输入是作用在圆形振膜上的声压,输出是光电探测器电流,难点在于机械转换、光学非线性和噪声要放在同一压力标尺下比较。方法先用马赫-曾德尔干涉仪把传感臂与参考臂的光程差变成光强变化,再用弯曲主导的圆板挠度把声压变成多圈波导的总周长变化,两者相乘得到压力到电流的灵敏度,噪声下限只保留光学散粒噪声与背腔热机械噪声并折算成等效输入压力。上限用总谐波失真允许的光学偏移确定声学过载点,工作区间取该判定标准限定的部分光学行程。在以总谐波失真10%为声学过载点判定标准、光输入1 mW的直接强度检测紧凑MEMS计算中,直径1 mm、厚1 μm、无内应力硅振膜在调制效率100%时模型给出信噪比78 dB与声学过载点124 dB,与选定的2021年Knowles器件相比动态范围相近。在光输入100 mW且不计背腔噪声的测量计算中,以动态范围与噪声下限为指标,模型噪声下限低于G.R.A.S. 40AF基准,动态范围约高10 dB且主要来自最小可测压力改善。结论只适用于直接强度检测、线性小挠度、无波导传播损耗等有利假设,高温传感头只提出光纤远端 interrogation设想而未经温度验证,成本以光输入功率为主要代价,未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
118. 当音频和视频互相干扰时,如何把走错路的融合表示拉回来

英文题目:Mitigating Cross-Modal Hallucinations by Correcting Modality Misrouting in Omnimodal LLMs
标签:#音视频问答 | #测试时自适应 | #音视频 | #幻觉与忠实度
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yu Mi:机构信息未在 arXiv HTML 中可靠披露
- Licheng Pan:机构信息未在 arXiv HTML 中可靠披露
- Jiayi Zhu:机构信息未在 arXiv HTML 中可靠披露
- Qirui Liu:机构信息未在 arXiv HTML 中可靠披露
- Yitong Qiao:机构信息未在 arXiv HTML 中可靠披露
- Changtong Xu:机构信息未在 arXiv HTML 中可靠披露
- Tao Wei:机构信息未在 arXiv HTML 中可靠披露
- Fei Sun:Zhejiang University Ant Group Institute of Computing Technology, CAS
- Zhixuan Chu:机构信息未在 arXiv HTML 中可靠披露
- Kui Ren:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
全模态大语言模型同时接收音频、视频和文本问题作答,当问题实际只需其中一种感官证据时,另一模态的显著内容可能诱发跨模态幻觉,例如看到猫而误报听到猫叫。论文把联合音频视频分支答错、而去掉干扰模态后问题相关单模态分支可答对的可恢复分歧称为模态误路由。CaRe先用只看问题的文本探针选出候选音频或视频分支,再比较候选分支与联合分支的离散预测,仅在两者明确且不一致时触发修正,修正信号进入下一步残差计算。修正时用候选分支与当前联合状态在解码器层最后提示词位置的隐状态差值构成残差方向,按候选分支决策间隔得到的置信度选择弱或强干预区间,并随层深衰减加到原音频视频表示上,之后保留双模态继续自回归生成。与对比解码和模态自适应解码的区别在于不丢弃任一模态输入,也不直接输出单模态答案。在Qwen2.5-Omni-7B的CMM视觉主导与音频主导两子集汇总总体准确率上,CaRe的85.9%高于基线的70.5%。该提升限于CMM与AVHBench幻觉评测的二选一是非问答等设置,探针无唯一候选或两分支无明确不一致时保留原预测故无法纠正此类误路由,在Qwen2.5-Omni-7B的Daily-Omni通用问答总体准确率上CaRe的61.8%仅略高于基线的61.5%,开放式生成效果未知。方法为免训练推理期干预,在相同200样本子集串行执行的平均每样本延迟上,Qwen2.5-Omni-7B上CaRe的6.70秒低于MAD的16.61秒,未披露训练成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
119. 微调为何先崩溃再恢复 yet 普通话仍变差:语音模型方言适应的全轨迹拆解

英文题目:Collapse, Repair, and Drift: Dissecting Fine Tuning Dynamics in Speech Language Models
标签:#语音识别 | #SFT | #口音与方言 | #语音
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yichi Wang:Department of Intelligence Science and Technology, Kyoto University;Xiaowei, WXG, Tencent
- Wangjin Zhou:Department of Intelligence Science and Technology, Kyoto University;Xiaowei, WXG, Tencent
- Yizhou Zhang:Department of Intelligence Science and Technology, Kyoto University;Xiaowei, WXG, Tencent
- Xin Gu:Communication University of China;Xiaowei, WXG, Tencent
- Wei Tan:Xiaowei, WXG, Tencent
- Yi Zhao:Xiaowei, WXG, Tencent
- Gong Zhi:Xiaowei, WXG, Tencent
📌 核心摘要
该研究处理方言自适应语音识别,输入为方言语音波形与固定文字提示,输出为汉字转写文本,难点是损失平稳时识别功能仍可能急剧恶化,且源域普通话能力会缓慢丢失。作者冻结声学编码器与音频到语言映射,只微调文本解码器,在250000条五方言语料上做单轮监督微调,同步记录评估损失与字错率。三组诊断为:预训练与微调检查点间双向层拼接定位功能不兼容深度,用方言间与相邻步骤梯度余弦相似度刻画方向一致性,对5行方言梯度矩阵做奇异值分解跟踪谱能量分布。用完整AdamW参数位移混合的更新迁移改变早期路径,检验绕开早期崩溃后源域退化是否仍出现。与只看损失尖峰或起止点遗忘的诊断不同,该工作把瞬时崩溃与持续遗忘分离为可独立出现的动力学。在方言与普通话测试集的字错率及评估损失轨迹比较中,10^-3下三模型评估损失最终仍超过低学习率收敛值的两倍以上,高于低学习率对照,而更新迁移绕开早期字错率尖峰后普通话字错率仍向退化方向漂移。结论适用于所测三模型与方言适应设置,失败集中在大优化尺度与持续适配后期,跨语言与跨任务尚未验证。原文已披露使用8张GPU、每设备微批5条、梯度累计16次、有效批量640条、250000条一轮为391个优化步骤,未披露完整GPU耗时、费用与推理延迟。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
120. 长音频流里记住声源并更新属性:AMemOps 如何拆开识别、保留与更新

英文题目:AMemOps: Evaluating Memory Updates in Long Audio Streams
标签:#音频问答 | #基准设计 | #基准测试 | #长音频处理
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Peiwei Chang:机构信息未在 arXiv HTML 中可靠披露
- Li Zhang:机构信息未在 arXiv HTML 中可靠披露
- Mark D. Plumbley:机构信息未在 arXiv HTML 中可靠披露
- Philip J. B. Jackson:机构信息未在 arXiv HTML 中可靠披露
- Wenwu Wang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
长音频流理解要求在声源换录音重现时识别同一来源,取回增益与声像最新取值、保留未变属性并对未出现来源回答无,音色音高变化与历史冲突旧值使可靠识别与最新值选择变难。基准先按采样增益与声像组合录音,生成带事件属性的长流与查询,非重叠片段、干扰声与查询构成25Hz下2048帧即81.92s的常规流。立体声对数梅尔特征连同查询与增益声像请求标志被送入带门控增量规则循环记忆GDN2或处理匹配的因果注意力,得到逐帧模型输出。该输出再送独立增益与声像分类器预测四值加无,按查询来源最新属性答案评准确率。配对历史则固定最新事件、查询与答案,仅改变更早目标事件,形成无更新、已更新与保持对照以分离重复增益与冲突代价。在NSynth乐器集Set1与Set2互训互测、每集192条测试流固定的熟悉度对照中,用更新查询准确率衡量的GDN2减匹配RoPE注意力模型差,在训练见过同一测试乐器其他录音时比未见时平均高13.4个百分点,95%置信区间为8.7到18.0。独立配对历史另用4096帧即163.84s输入、查询止于40或140s形成20或120s延迟,在本文所测120秒延迟条件下,RoPE注意力各操作准确率低于3%,与上述身份熟悉度差中差结果分属不同实验。该13.4个百分点优势仅在见过同一乐器其他录音时成立,未见身份时差距缩小乃至消失且固定录音时减弱,120秒结论限于该配对历史条件而未验证更长延迟或其他位置编码配置,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
121. 用轻量标注与轻量分离搭建空间语义分割系统

英文题目:Lightweight Systems for Spatial Semantic Segmentation of Sound Scenes
标签:#音频分离 | #音频分类 | #CNN | #高效推理
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Mayank Mishra:机构信息未在 arXiv HTML 中可靠披露
- Paul Magron:机构信息未在 arXiv HTML 中可靠披露
- Romain Serizel:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
空间语义分割(Spatial Semantic Segmentation of Sound Scenes, S5)要求输入多通道混合音频,输出每个目标声源的单通道波形及其类别标签,难点在于标记错误会直接改变分离模型要提取的对象,而分离模型又要处理多通道输入和可变数量声源。论文采用先标记后提取的流程,音频标记模型先预测混合中包含的类别,目标声提取模型(target sound extraction, TSE)再以类别独热向量为查询,每次提取一个声源。与检测与分类声学场景和事件(Detection and Classification of Acoustic Scenes and Events, DCASE)2025任务4基线相比,关键差异是用卷积类轻量标记模型和掩码卷积分离模型替换掩码建模双子(masked modeling duo, M2D)和残差U网(ResUNet),并给分离器增加了多通道输入、单通道投影和类别条件调制。开发集上轻量组合DyMN-full加SuDoRMRF-16的类别感知信干比提升(class-aware signal-to-distortion ratio improvement, CA-SDRi)为10.73 dB,接近原始基线系统的11.03 dB,同时参数量从115.38 M降至3.62 M,乘加操作数(multiply-accumulate operations, MACs)从835.89 B降至329.90 B。结论只在18类、每段10秒、含1至3个目标的合成数据上得到验证,真实录音、更多重叠和移动声源尚未检验。论文未报告真实设备延迟、吞吐与功耗。
🔗 开源资源
- 第三方资源:https://dcase.community/challenge2025/task-spatial-semantic-segmentation-of-sound-scenes-results — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
122. EmoGavel:让偏好判断说出错误在哪并给出修正

标签:#语音情感识别 | #强化学习 | #偏好优化 | #音视频
评分:5.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zilong Huang:机构信息未在 arXiv HTML 中可靠披露
- Kong Aik Lee:机构信息未在 arXiv HTML 中可靠披露
- Zezhong Jin:机构信息未在 arXiv HTML 中可靠披露
- Man-Wai Mak:机构信息未在 arXiv HTML 中可靠披露
- Tatsuya Kawahara:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
描述性多模态情感识别以自由文本描述目标人物情感状态,难点在于多种表述都可能成立,难以用单一参考评判优劣。pairwise偏好预测输入一段多模态片段与两个候选描述,输出更符合情感状态的一方,但已有训练只给二选一标签,不指出错在哪里或如何改正。EmoGavel先做接地监督微调,在受控错误对上联合学习偏好选择、错误片段定位、原文修复与缺失证据补全,再用接地感知组相对策略优化按可验证奖励优化这些结果。与只学二选一的误差增强方法不同,该框架要求偏好正确才激活接地奖励,并对全错组引入补救信号。在EmoPrefer-Data自然偏好与四类受控错误评估上,单个Qwen2.5-Omni-7B的EmoGavel以自然对加权F1为79.75%高于同基座同设置误差增强微调的77.15%,四类受控错误平均加权F1以88.20%高于该基线的77.13%。结论适用于含明确构造痕迹的四类受控错误及候选顺序打乱的一致性检验,其缺失证据恢复弱于接地监督微调,且向自然发生的非对齐错误的泛化与不同多模态证据条件下的接地仍未验证。训练在八块NVIDIA RTX A6000 GPU上完成,接地监督微调采用秩为8的低秩适配并训练两轮,接地感知组相对策略优化每提示采样4个输出并训练500步。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
123. 视频配乐的扩散模型自表示对齐:U-SRA 如何学到更好的内部表示

英文题目:Self-Representation Alignment in Diffusion Models for Video Background Music Generation
标签:#符号音乐生成 | #扩散模型 | #视频到声音生成 | #音乐
评分:5.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jincheng Zhang:机构信息未在 arXiv HTML 中可靠披露
- György Fazekas:机构信息未在 arXiv HTML 中可靠披露
- Charalampos Saitis:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
视频背景音乐生成要求输入视频片段,输出在语义和时间上与画面匹配的符号音乐,难点在于跨模态对应建模和离散音符序列的高质量生成。论文把离散MIDI切成8小节片段,转为双通道钢琴卷(pianoroll,横轴为时间、纵轴为音高的图像式表示),用扩散U-Net(diffusion U-Net,带下采样的去噪网络)直接在连续表示上训练,避免为离散符号额外训练变分自编码器。视频特征和描述文本特征作为条件经交叉注意力注入去噪过程,查询为加噪钢琴卷表示,键和值为视频特征。训练中增加自表示对齐(self-representation alignment,用同一模型不同层表示互为监督的训练目标),让高噪声输入下学生网络早期层的弱表示向低噪声输入下教师网络后期层的表示靠拢,教师权重为学生权重的指数滑动平均并施加停止梯度。对齐前先把学生特征缩放到教师空间分辨率,再经轻量多层感知机头投影,用平滑L1距离计算对齐损失并与去噪损失加权相加。在BGM909测试集上,U-SRA(5-15)相对Diff-BGM把检索精度P@10从21.5%提高到25.7%,同时音高类直方图熵和groove相似度取值与真实数据几乎重合。该结论仅在BGM909钢琴类视频音乐数据、冻结视频与语言编码器及上述层配对条件下得到验证,改用过深教师层或过大噪声间隔会削弱对齐效果,向其他数据集的泛化尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://usramusic.github.io — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
124. 用人声分离讲清 FlowGRPO:先分析奖励差距,再改奖励设计

英文题目:FlowGRPO for Vocal Separation: From Reward Analysis to Reward Design
标签:#音乐源分离 | #强化学习 | #流匹配 | #后训练 | #音乐
评分:5.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Lishi Zuo:机构信息未在 arXiv HTML 中可靠披露
- Chong-Xin Gan:机构信息未在 arXiv HTML 中可靠披露
- Zezhong Jin:机构信息未在 arXiv HTML 中可靠披露
- Youzhi Tu:机构信息未在 arXiv HTML 中可靠披露
- Man-Wai Mak:机构信息未在 arXiv HTML 中可靠披露
- KongAik Lee:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
人声分离需要从音乐混合波形中恢复人声音轨,流匹配模型在中间隐状态监督速度场,而波形指标在解码后计算且多不可微,两者存在目标错位。本文在冻结的变分自编码器隐空间做分离:混合与参考人声经编码器得到潜表示,条件流模型学习由噪声到目标潜表示的速度场,推理积分得到终点潜表示再经解码器重建波形,波形奖励才能计算。后训练沿同一条常微分方程轨迹到随机起点复制出每混合8条rollout,只在早期2步窗口内注入独立噪声后各自积分到终点解码,用组内最优与均值之差衡量奖励区分度,并回归到均方根电平、活动比例、边缘静音与声道差异等质量因素,发现虚拟语音质量客观听众分量的组内差异偏关联更强。该输出直接决定奖励改写:按声道匹配均方根电平、只取首个到末个活动帧区间评分并保留内部停顿得到ViSQOL变体,经批量标准化与多分辨率短时傅里叶变换、尺度不变信干比合并为标量,再经波形质量过滤剔除低电平、非活动、削波与声道失配样本后做组相对策略更新。与预训练分离器相比,完整方法在内部测试集上把SI-SDR从5.927 dB提高到7.045 dB,同时原始ViSQOL、信号失真比与语音质量感知评估都上升。该结论仅在20秒内部混合、固定阈值过滤及编码解码器冻结条件下验证,对低电平、长边缘静音与声道不平衡目标仍可能失准,且未验证跨数据集、其他流匹配任务与奖励组合的泛化性,多分辨率短时傅里叶变换损失最低值仍由仅用该奖励的对照保留。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
125. 让语音识别忘记特定说话人同时还能正常转写

英文题目:Towards Privacy-Preserving ASR: Speaker-Level Machine Unlearning
标签:#语音识别 | #音频隐私攻击与防御 | #正则化 | #语音
评分:5.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Seaone Ok:机构信息未在 arXiv HTML 中可靠披露
- Seungu Han:机构信息未在 arXiv HTML 中可靠披露
- Eungbeom Kim:机构信息未在 arXiv HTML 中可靠披露
- Kyogu Lee:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
自动语音识别(Automatic Speech Recognition,ASR)的输入是语音波形,输出是语言文字,难点是语言内容与说话人声学特征在自监督编码器表示中相互纠缠,直接删除说话人痕迹容易损伤转写。论文对经ASR微调的HuBERT-base做分层成员推断,发现遗忘说话人的可分性在第6层出现记忆峰值,金模型降至0.52而原始模型仍为0.75,因而选定该层作为干预点。方法先冻结编码器并在第6层隐状态上训练辅助说话人分类头,得到可控的说话人嵌入空间,再用K-Means估计遗忘说话人的几何中心作为身份锚点。遗忘阶段解冻编码器,在保留集上保持联结时序分类(Connectionist Temporal Classification,CTC)损失维持转写,同时以话语感知身份离散(Speech-Aware Identity Dispersion,SAID)损失把遗忘样本嵌入推离各自中心,直接瓦解簇结构而非仅做参数梯度上升。在VCTK保留95人、遗忘5人、测试8人的划分下,与仅用保留集训练的金模型相比,SAID在遗忘集未见语句上的成员推断准确率为52.6%,略低于金模型的52.7%,保留集未见语句词错率(Word Error Rate,WER)为7.60%,高于金模型的7.43%。该结论只在VCTK的特定划分下成立,跨口音、噪声与大规模遗忘人数尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
126. 屏幕前的语音识别:用分层视觉证据补上听不清的关键词

英文题目:ScreenASR-Bench: A Tiered Benchmark for Speech Recognition with Visual Context
标签:#音视频语音识别 | #基准设计 | #基准测试 | #数据集
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Mingwei Fu:机构信息未在 arXiv HTML 中可靠披露
- Zheshu Song:机构信息未在 arXiv HTML 中可靠披露
- Zhikai Zhou:机构信息未在 arXiv HTML 中可靠披露
- Shen Huang:机构信息未在 arXiv HTML 中可靠披露
- Shidong Shang:机构信息未在 arXiv HTML 中可靠披露
- Mengxiao Zhu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
屏幕语音识别的输入是一段语音及其同时间的屏幕关键帧,输出是完整转写文本,难点是部分关键词发音含混,仅靠声学难以区分,却会改变语义。ScreenASR-Bench收集公开在线视频片段,为每个案例标注语音段、关键帧、参考转写和目标关键词,并按视觉证据与关键词关系的直接程度分为可读文本、可见实体与场景语义三级。构建流程先用多个语音识别系统转写并对齐参考文本挖掘难识别词,再由视觉语言模型选择关键帧并划分证据等级,最后经人工核验保留音频难辨且视觉相关的案例。与把视觉信息整体使用的已有基准相比,该基准区分了证据的直接程度,可观察模型利用不同线索的能力差异。在ScreenASR-Bench全集评测中,Qwen3.5-Omni-Plus对比音频单模态与增加关键帧字幕输入时,全集关键词召回率从65.83%提升到79.33%,词错误率从5.12%下降到3.47%,说明视觉信息有助于难词识别。结论适用于屏幕场景的短语音难词评测,对无屏幕或纯对话语音尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://huggingface.co/datasets/MingweiFu/ScreenASR-Bench — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
127. Nufo:把分散的埃维语语音拼成 174 小时可比基准
标签:#语音识别 | #基准设计 | #基准测试 | #低资源
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Christ Kekeli Keli:机构信息未在 arXiv HTML 中可靠披露
- Steve Sanogo:机构信息未在 arXiv HTML 中可靠披露
- Patrice Sebastiano:机构信息未在 arXiv HTML 中可靠披露
- Hamad Aldenawi:机构信息未在 arXiv HTML 中可靠披露
- Ryan Whetten:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
埃维语约有500万母语者,为声调语言且正字法含特殊字符,公开转写语音稀少并分散在不同采集与转写规范中,直接合并易把同一录音同时放入训练与评测。Nufo把WAXAL、BibleTTS与Common Voice-Mina合并为约174.82小时统一基准,输入为语音波形与对应埃维语转写,输出为固定划分的训练集、验证集与测试集及词错误率与字错误率基线。构建先用音频内容密码哈希标识文件以发现跨库完全重复并固定划分,再做归一化文本去重,使各划分在可检测范围内互不含相同录音与相同转写,去重后训练52417条158.75小时、验证1614条、测试1443条进入模型微调。基线保持验证集与测试集固定以比较训练数据增量,分别用Whisper编码器-解码器微调与AfriHuBERT编码器加联结时序分类微调,并在完整正字法及去除标点等条件下报告误差。在1443条的固定测试集上用全部三库训练数据比较,完整正字法词错误率Whisper-medium为37.98%、AfriHuBERT为39.70%,Whisper-medium低于AfriHuBERT。结论只适用于该基准的转写规范与固定测试分布,Mina增量收益小,说话人无关性尚未保证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://huggingface.co/datasets/medbridge-ai/Nufo — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
128. 带外国口音的合成语音,自然度该怎么评

英文题目:How Should We Evaluate Naturalness for Synthetic Speech with a Foreign Accent?
标签:#语音质量评估 | #众包评测 | #口音与方言 | #语音
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kentaro Onda:机构信息未在 arXiv HTML 中可靠披露
- Satoru Fukayama:机构信息未在 arXiv HTML 中可靠披露
- Daisuke Saito:机构信息未在 arXiv HTML 中可靠披露
- Nobuaki Minematsu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
外国口音合成把口音作为目标特征,而传统自然度评价默认越接近母语者越好,易把口音误判为系统缺陷,UTMOS也被发现给熟练度低的说话人更低分。研究从日本人英语语料ERJ选取5个句子、24名说话人的120段录音先做语音修复以减弱噪声,修复后语音作为受控输入,一路保留原样、另三路分别经BigVGAN、EnCodec、WORLD重合成得到480段刺激语音,使口音可控而韵律基本保留真人特征。随后将480段语音分成每组48段的10组,每组覆盖不同说话人与句子并均衡熟练度,再在自然度、像人程度、作为母语语音的自然度、作为非母语语音的自然度4种指示语下,分派给160名英语母语者和160名日语母语者,共收集15360个五点制MOS打分。结果显示美国英语MOS始终高于日本英语,例如英语评价者在I1自然度下对两类语音的MOS分别为4.28和2.75。以Spearman等级相关系数衡量熟练度与MOS的关系,英语评价者平均值从I1下的0.515降至像人程度I2下的0.427,说明I2减弱口音影响且更易分辨系统差异。自动评价同样存在口音偏好,三种自动系统与人工MOS的Spearman等级相关系数均在I2下最高,例如对日语评价者UTMOS在I1、I2下分别为0.49和0.51。结论仅适用于口音可控、韵律基本保留真人特征的重合成情形,能否推广到口音强度不同的文本到语音合成尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/ondatk68/foreign-accent-mos/ — 链接可访问(HTTP 200)
第三方资源:https://hf.co/nvidia/bigvgan_v2_44khz_128band_512x → https://huggingface.co/nvidia/bigvgan_v2_44khz_128band_512x — 暂时无法访问
第三方资源:https://hf.co/facebook/encodec_24khz → https://huggingface.co/facebook/encodec_24khz — 暂时无法访问
第三方资源:https://www.prolific.com/ — 链接可访问(HTTP 200)
第三方资源:https://www.lancers.jp — 链接不可用(HTTP 405)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
129. 智能眼镜双人对话的带时间戳说话人转写:直接解码与前端辅助的比较

英文题目:Frontend-Assisted Large Audio-Language Models for SLT2026 SmartGlasses Challenge
标签:#多说话人语音识别 | #说话人分离标注 | #SFT | #波束成形
评分:5.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Yushi Wang:机构信息未在 arXiv HTML 中可靠披露
- Zeyan Song:机构信息未在 arXiv HTML 中可靠披露
- Xiaobin Rong:机构信息未在 arXiv HTML 中可靠披露
- Chengwei Liu:机构信息未在 arXiv HTML 中可靠披露
- Jun Gao:机构信息未在 arXiv HTML 中可靠披露
- Jing Lu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
智能眼镜采集的四通道双人日常对话包含重叠语音、背景干扰、远场混响和频繁轮转,任务要求从完整录音直接输出带时间戳和说话人归属的转写文本。系统1把四通道平均后的混合语音送入SoulX-Transcriber,由该音频大模型自回归生成结构化转写;系统2先用基于规则的引导声源分离做目标说话人提取,得到佩戴者和对话伙伴各一条单说话人音轨后分别解码合并。系统3用改进的多通道双路径循环神经网络分离模型输出两路波形,再送入同一后端转写;相对以往依赖后端大模型直接转写重叠段且多为单通道输入的做法,该报告引入空间信息和显式分离,并用约33小时挑战数据做低秩适配微调。在官方验证集上,微调后系统1的tcpCER为7.82,低于预训练版本的9.02,也低于组织方基线VibeVoice-ASR的14.09。在同一官方验证集上,估计的说话人活动检测条件下GSS辅助系统的tcpCER为6.97,低于无前端辅助的微调系统1的7.82。前端增益在重叠率12.0%–22.8%的高重叠对话组更明显,但前端失真和零填充会加剧重复生成与时间戳漂移,需微调与调整解码缓解,少数样本只能改用约30秒分段推理;出于全长推理稳定性最终提交微调系统1,其测试集tcpCER为6.22,低于其验证集的7.82,前端系统测试集全长解码表现尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://aslp-lab.github.io/SmartGlasses/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/Soul-AILab/SoulX-Transcriber — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/BUT-FIT/diarizen-wavlm-large-s80-md-v2 — 暂时无法访问
第三方资源:https://github.com/ASLP-lab/Smart-Glass-Challenge — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
130. 用类别偏置给长尾数据留出专家容量:COAX 解读

英文题目:Overcoming Data Imbalances with Expert Selection Biases
标签:#语音识别 | #混合专家模型 | #多语言 | #低资源
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ayush K. Tarun:机构信息未在 arXiv HTML 中可靠披露
- Clara Meister:机构信息未在 arXiv HTML 中可靠披露
- Antoine Bosselut:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
混合专家模型在数据类别不均衡时易把少数类别挤入过小专家子集,造成容量不足和类别间干扰,低资源语言与少数模态的损失因此偏高。COAX先为每个输入类别指定偏好专家子集,开发者把少数类别的偏好专家份额设得高于其token占比,而每个token激活的专家数不变,划分好的子集决定后续偏置的作用范围。预训练选专家时,该类别token对应子集内专家的路由分数被加上固定偏置α,偏置后分数用于选出前K个专家,选出的专家名单再进入加权阶段用无偏原始分数对专家输出加权求和。推理时可去掉该偏置恢复标准路由,从而保留软类别对齐与跨类别共享。与固定分组硬划分和散度正则方法不同,COAX控制子集大小而非强制隔离,因此仍允许跨类别共用专家。在10.6B-A1.2B八语言混合与相同种子无偏基线对照下,以验证损失相对变化Δ%为指标且负值表示变好,COAX七个少数语言均值-0.286%,低于硬路由的+0.047%和EDL的+1.016%,其中斯瓦希里语以验证损失相对变化-0.486%为三者中最低。在该八语言粗粒度分组下,以每步迭代时间为指标COAX开销为+1.3%,而以追平验证损失所需的额外训练token为指标,无偏基线平均需多用+2.7%训练token才能追平COAX;方法限于预训练类别标签已知的混合训练,未验证推理须保留偏置的领域外泛化。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
131. 为失语症模拟生成带停顿和口吃的慢速语音
英文题目:AphaVoice: Text-to-Speech Model for Aphasia Patient Simulation
标签:#文本到语音 | #SFT | #韵律与风格控制 | #言语障碍
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Al Varrel Putra Kusuma:机构信息未能从 arXiv PDF 文本可靠映射
- Fernando Bello:机构信息未能从 arXiv PDF 文本可靠映射
- Joshua Brown:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
失语症模拟需从文本生成带慢速、停顿增多与发音含混的患者语音,难点是通用TTS为流利语音优化会抹掉病理时间结构,而失语症语料多为带噪声自发对话难以直接训练。AphaVoice以非自回归Matcha-TTS为基座,在AphasiaBank两名失语症说话人数据上监督微调,并加入逗号、句点和省略号三级停顿符号与口吃写法,使时长预测器学会慢速和停顿分布。推理时文本前处理层先按0至1严重度参数插入停顿符、填充词和重复音节,输出的增广文本直接送入微调后模型生成梅尔谱,再由HiFi-GAN声码器转成波形。情感和口音子模型与基座的参数差被提取为方向向量,推理时按强度加回基座,以少量数据扩展说话人多样性。在对含基座Matcha-TTS在内8个模型生成脚本语音的对比中,男性AphaVoice语速指标WPM为76.57,低于女性的82.37,并落入论文引用的失语症61至88区间。在说话人一致性评测中,男、女声的说话人编码器余弦相似度SECS均值分别为0.78和0.76,均高于0.70的既定阈值,表明保持了说话人身份。结论只适用于英文、两名训练说话人和脚本朗读条件,长对话稳定性与教学增益尚未验证;训练开销为单张RTX 6000上1000轮耗时8.5小时,原文未披露推理延迟与部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/varrelkusuma/AphaVoice — 暂时无法访问
第三方资源:https://huggingface.co/parler-tts — 暂时无法访问
第三方资源:https://github.com/suno-ai/bark — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
132. 行为描述如何生成动物叫声:BeVo 数据与事件感知建模解读

标签:#音频生成 | #流匹配 | #数据集 | #基准测试 | #生物声学
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Xinlong Deng:机构信息未在 arXiv HTML 中可靠披露
- Yong Tian:机构信息未在 arXiv HTML 中可靠披露
- Jian Guan:机构信息未在 arXiv HTML 中可靠披露
- Qiuqiang Kong:机构信息未在 arXiv HTML 中可靠披露
- Jie Jiang:机构信息未在 arXiv HTML 中可靠披露
- Yin Cao:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
行为条件动物发声生成以描述行为、社会交互与情境的自然语言为输入,输出对应情境下的动物发声波形。可用行为文本监督少,发声通常短且时长变化大,固定长度训练会引入大量与事件无关的填充隐位置。论文先把六个物种录音整理为31191个发声事件,按42个发声锚点关联文献支持的行为卡,再由大语言模型生成行为条件文本,形成配对监督送入生成器。生成器沿用TangoFlux整流流框架,在音频自编码器隐空间学习从噪声指向目标隐变量的速度场,以FLAN-T5编码行为文本并附加目标时长作为条件。针对短事件填充问题,事件感知变长建模按实际时长编码、仅在批内补齐,并用掩码把填充隐位置排除在注意力与训练损失之外,推理时也按请求时长初始化隐序列。相对已有主要依赖物种、叫声类型或物种级文本的工作,该工作把条件推进到行为与社会情境描述,并用判别性、声学分布与语言对齐表示三类指标联合评测。在BeVo测试集固定条件-时长配对下,事件感知模型相对微调基线把发声锚点宏准确率从59.86%提高到61.99%,把Fréchet Audio Distance(生成与参考在VGGish特征上的分布差异,越低越好)从1.40降到1.22。结论适用于锚点层面的条件响应,尚未证明模型理解细粒度行为语义,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/datasets/Xinghour/BeVo — 暂时无法访问
演示资源:https://persimmontian.github.io/BCAVG → https://persimmontian.github.io/BCAVG/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
133. 用语音加文本的两阶段对比学习改善电子喉语音转换

标签:#语音转换 | #对比学习 | #多模态学习 | #语音
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ding Ma:机构信息未在 arXiv HTML 中可靠披露
- Jinyi Mi:机构信息未在 arXiv HTML 中可靠披露
- Jiajun He:机构信息未在 arXiv HTML 中可靠披露
- Kazuhiro Kobayashi:机构信息未在 arXiv HTML 中可靠披露
- Naoki Nishio:机构信息未在 arXiv HTML 中可靠披露
- Tomoki Toda:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
电子喉语音转换(electrolaryngeal-speech-to-normal-speech conversion,EL2SP)的输入是电子喉发声产生的语音,输出是内容相同但更接近正常语音的声学特征,难点在于人工激励缺失基频变化和浊清音线索并混入辐射噪声,时长和频谱都与正常语音偏差很大。所提两阶段多模态对比表示学习语音转换(Multimodal Contrastive Representation Learning VC,MCRL-VC)在第一阶段同时编码电子喉语音和对应文本,用双向对比损失拉近配对语音文本并融合生成目标语音,第二阶段冻结第一阶段的融合表示并以单向对比损失引导纯语音编码器逼近该表示,推理时不再需要文本。语音编码器和解码器在第二阶段继承第一阶段参数,融合模块采用以语音为查询、文本为键和值的多头交叉注意力并保留语音残差。与同模态的基线相比,该方法在 Patient 2 测试集上把自然度平均意见分从 2.86 提高到 3.28,把字符错误率从 22.1% 降低到 20.1%。结论只在两个日语小规模电子喉数据集和配套声码器条件下成立,跨说话人、跨语言和实时部署能力尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://muginekoo.github.io/slt2026-demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
134. 财报电话语音还需要持续学习正则吗:EWC 与 mini-KFAC 的对照解读

标签:#语音识别 | #持续学习 | #正则化 | #语音
评分:5.7/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Thai Quoc On:Department of Computer Science;Columbia University, NYC, NY, USA
- Homayoon Beigi:Mechanical Engineering Dept. and;Electrical Engineering Dept.;Columbia University, NYC, NY, USA;and Recognition Technologies, Inc.;South Salem, NY, USA
📌 核心摘要
财报电话转写需要把自动语音识别(Automatic Speech Recognition,ASR)模型随新季度录音增量更新,输入是财报电话语音,输出是文字转写,难点在于新数据上的调整可能抬高旧数据上的词错率。论文把Whisper-small先在TED演讲衍生语料上做通用适应得到阶段A参数,再用该阶段批次估计Fisher重要性并作为惩罚项带入后续损失,然后在Earnings22的Task B分区上微调,Task A分区与Task B说话人不重叠且始终不参与训练而用于度量保留效果。比较的三种处理是无约束微调、用对角Fisher信息(Fisher Information)约束参数漂移的弹性权重巩固(Elastic Weight Consolidation,EWC),以及把Fisher按层近似为输入协方差与梯度协方差Kronecker积的mini-KFAC EWC,后者能保留层内参数关联从而约束更具选择性。统一方案对编码器施加更强正则以对应其声学特异性,mini-KFAC另以较小全局尺度平衡矩阵型惩罚量级。在Earnings22上无约束微调的Task B词错率(Word Error Rate,WER)为31.94%,低于对角EWC的35.23%和mini-KFAC EWC的34.26%,且三者在Task A上都出现负遗忘,说明新分区训练改善了旧分区效果,强约束反而限制了这种互补迁移。结论只适用于这种同分布内增量更新,不涉及声学或语言差异大的跨领域序列。原文给出了单块NVIDIA L4 GPU、训练步数与批量等配置,但未给出训练时长、推理设置与部署成本。
🔗 开源资源
- 第三方资源:https://anonymous.4open.science/r/continual-asr-finance-508B/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
135. 从学会的塔图姆网格出发做拍号与下拍跟踪

英文题目:Explore This! Beat and Downbeat Tracking From a Learned Tatum Grid
标签:#节拍跟踪 | #Transformer | #音乐 | #信号处理
评分:5.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Robert Kihlborg:机构信息未在 arXiv HTML 中可靠披露
- André Holzapfel:机构信息未在 arXiv HTML 中可靠披露
- Jan Schlüter:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
拍点跟踪要从录音中估计每拍和每小节起始点的位置,难点是节奏存在多义性而逐帧独立概率无法表达拍点之间的依赖,现有后处理又常假设拍号不变。本文输入30秒梅尔语谱图,输出拍点和下拍点位置,先由前端和3个Transformer块从每1秒窗口预测12个候选局部塔图姆网格及其置信分布,并以相邻窗口一致性正则保持节拍层级稳定,再把选中的正余弦波形与塔图姆点掩码编码回特征并经过另3个Transformer块,在每个网格点上预测拍周期、拍相位、下拍周期与下拍相位构成的280种子网格分布,最后用维特比或阈值解码得到拍点。与直接预测逐帧概率不同,该方法显式保留tempo和拍号的多种可能。与 Beat This 相比,它在 GTZAN 下拍连续性指标 CMLt 上从 67.3% 提高到 72.7%,AMLt 从 79.1% 提高到 86.2%,但拍点 F1 仍略低且落后于带动态贝叶斯网络的方法。结论只在与Beat This相同的以4/4为主、变拍号样本很少的训练划分与GTZAN评测条件下成立,网格召回限制了最终性能上限。古典乐速度起伏、拍号切换或每秒内显著波动时网格易漏掉真拍或产生多余塔图姆点,子网格分布随时间不一致,而短于1秒的窗口与更复杂节拍结构的潜力尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/CPJKU/explore_this — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
136. 选还是改:用 N-Best 列表教大模型做语音识别后处理

英文题目:Select or Rewrite: Oracle-Guided Fine-Tuning for Generative ASR Post-Editing from N-Best Hypotheses
标签:#语音识别 | #指令微调 | #大语言模型 | #幻觉与忠实度
评分:5.7/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shiran Liu:机构信息未在 arXiv HTML 中可靠披露
- Gaohui Xu:机构信息未在 arXiv HTML 中可靠披露
- Sergio Burdisso:机构信息未在 arXiv HTML 中可靠披露
- Thibault Bañeras-Roux:机构信息未在 arXiv HTML 中可靠披露
- Shashi Kumar:机构信息未在 arXiv HTML 中可靠披露
- Petr Motlicek:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
自动语音识别经波束搜索常在N-best列表中保留比首选更准确的候选,冻结大语言模型直接提示改写容易在首选正确时多改、在参考缺失时编造,且小模型表现不稳定。本文输入为Whisper以束宽12生成的12个候选文本,输出为单句转写,训练oracle参考只用于划分样本而不作为测试输入,难点在于判断何时照选、何时保留首选、何时在无依据时谨慎处理。做法是先用训练参考文本把训练候选列表分成可纠正错误、首选正确和参考缺失三类,产出教授选择、保持和谨慎改写的指令样本,这些样本再交给LoRA训练形成适配参数并冻结基座权重,推理时适配后模型一次读入完整列表做比较后生成转写。在definedAI、Whisper-Medium、Qwen2.5-3B配置下,按图3纵轴粗读,零样本提示(zero-shot,不给示例,但仍给任务指令与N-best候选输入)的词错率(WER)约17%–18%,oracle-guided微调的词错率约12%–13%,后者更低;仅为近似图示,未标精确点值或差值。相对同量随机抽样微调,该做法把数据预算用在行为边界样本上而非扩大数据量,在自有对话语料上从3B参数左右开始把词错率带到基线之下并与同量随机持平或略好,公共朗读语料CommonVoice上优势不稳定。微调采用LoRA秩64等配置,在RTX 3090上运行、14B用H100,训练2轮、有效批量8,但原文未报告完整训练时长与推理延迟。
🔗 开源资源
- 第三方资源:https://defined.ai — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
137. 不看内部参数,只看推理过程:用外部全模态向量估计不确定性
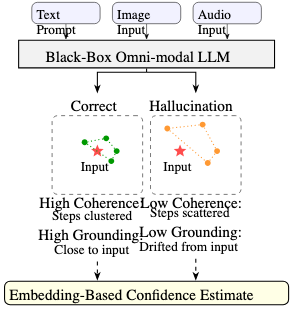
英文题目:Estimating Uncertainty of Omnimodal Large Language Models via External Omnimodal Embeddings
标签:#音视频问答 | #不确定性估计与校准 | #多模态模型 | #音视频
评分:5.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Iacopo Ghinassi:机构信息未在 arXiv HTML 中可靠披露
- Hy Nguyen Gia La:机构信息未在 arXiv HTML 中可靠披露
- Luke Ong:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
全模态大语言模型同时接收文本、图像、音频和视频并给出推理和答案,难点在于判断答案是否可信,尤其当模型只提供黑盒输出时更难。论文对每个问题采样 6 条思维链,先由辅助模型切分成步骤,再用外部嵌入模型 E5-Omni 3B 把非文本输入、推理步骤和最终答案映射到同一空间,计算贴合度与连贯性分数。贴合度衡量每步与音频或图像输入的最大余弦相似,取平均或最大得到链级分数;连贯性衡量相邻步骤相似、全部步骤两两相似以及后半段是否更靠近答案。链级分数通过加权投票改变同一多数答案的置信度,不需要被评模型的对数概率、隐藏状态、梯度,也不需要再次调用被评模型。在 UNO-Bench 上用 Gemini 3.1 Flash Lite 生成答案时,平均贴合度 \(G_{avg}\) 的平均 AUROC 为 0.6102,高于自一致性的 0.5927,聚合分数相对自一致性平均提高 2.15%。结论适用于黑盒全模态问答的置信度估计,但在音频单模态与某些生成器组合下会失效,校准集只需 25 个左右有标签样本,原文披露了嵌入与采样的额外开销但未给出完整训练成本。
🔗 开源资源
第三方资源:https://anonymous.4open.science/r/Multimodal-CoT-Confidence-Scoring-C12E — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/meituan-longcat/UNO-Bench — 暂时无法访问
第三方资源:https://huggingface.co/Haon-Chen/e5-omni-3B — 暂时无法访问
第三方资源:https://huggingface.co/Qwen/Qwen3.5-9B — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
138. 不反演、不训练如何同时改声音和画面:AV-FlowEdit 的联合编辑与保持机制

标签:#音视频生成 | #流匹配 | #音视频
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shaohua Pan:机构信息未在 arXiv HTML 中可靠披露
- Xiao Liu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
输入是已有音视频片段及其源提示与目标编辑提示,输出是跟随目标提示且保留非编辑区结构与音画对应的新片段,难点在于目标改动与源结构保持冲突,音频与视频还需在时间上对齐。方法冻结 LTX-2 双分支模型,先把视频与音频编码为各自隐变量并从源隐变量开始采样。每个采样步在相同高斯扰动下估计源条件与目标条件速度场,差值经多候选加权得到联合编辑方向,同时更新视频与音频以保留跨注意力交互。随后计算视频位移的多尺度低频分量,用流显著性与对齐后音频活动形成事件门控,并按扩散噪声水平调度校正强度,只压制无支持区的漂移。与已有只改视觉或分开处理音视频的方法不同,该框架统一处理双模态且不需要反演或外部掩码。与最强联合基线 AvED 相比,在相同评测中目标文本对齐指标 CLIP-T 从 0.260 提高到 0.273,目标对象准确率从 0.180 提高到 0.673。原文未披露训练、推理或部署成本,音画同步指标未取得领先,适用范围限于报告的提示编辑类型。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
139. 合成语音能替代真实录音训练识别吗:TTS 与声音转换增广的土耳其客服实验

英文题目:Enhancing Speech Recognition through Text-to-Speech and Voice Conversion Augmentation
标签:#语音识别 | #数据增强 | #语音转换 | #文本到语音
评分:5.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Yunus Emre Ozkose:机构信息未在 arXiv HTML 中可靠披露
- Ali Haznedaroglu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
任务输入是土耳其语呼叫中心银行场景的电话语音,输出是对应文字转写,难点是真实标注语音获取成本高,口音、信道与领域词汇变化大,小规模真实数据训练的自动语音识别(Automatic Speech Recognition,ASR)错误率高。方法先用真实转写文本调用 Azure 文本到语音(Text-to-Speech,TTS)生成 2 个说话人的 20 小时语音,再以该批语音为源内容,以 Librispeech 提供的 1281 个说话人语音为目标音色,用 KNN-VC、Seed-VC 和 vec2wav2 三种语音转换(Voice Conversion,VC)模型分别做音色重写。质量分析用 NISQA 框架预测平均意见分(Mean Opinion Score,MOS)并比较真实与合成分布,识别实验比较单独合成训练、重复转换、合成混合以及真实加合成混合。单独合成训练中 Seed-VC 词错误率(Word Error Rate,WER)为 75.53%,TTS 为 97.10%。20 小时真实语音加 TTS 加 vec2wav2 的混合设置 WER 为 28.65%,相对 34.40% 的真实语音基线降低约 16.74%。结论适用于真实数据为 10 小时到 20 小时的同领域场景,50 小时后增益收窄到约 1% 到 3%,单独合成仍远差于真实语音。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/k2-fsa/k2 — 链接可访问(HTTP 200)
第三方资源:https://github.com/k2-fsa/icefall — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
140. 带字段元数据的音频分类:先按录音选字段,再按维度融合声语义

标签:#音频分类 | #多模态学习 | #注意力机制
评分:5.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xiangyu Jing:机构信息未在 arXiv HTML 中可靠披露
- Hongqing Liu:机构信息未在 arXiv HTML 中可靠披露
- Liming Shi:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
用户上传音频常附带标题、标签和描述,论文要解决的输入是音频波形加最多三个文本字段,输出是单标签层级类别或多标签类别,难点在于字段结构和噪声不同且与音频的相关程度随样本变化。论文采用的骨干是LAION-CLAP(大规模音频文本对比预训练模型),音频编码器为HTSAT(分层音频频谱图变换器),文本编码器为RoBERTa(鲁棒优化的双向编码器预训练语言模型),两者把音频和每个字段映射到同一向量空间。元数据视角注意力(Metadata View Attention,MVA)以音频向量为查询,对有效字段计算余弦相似度并结合字段先验得到权重,再把加权结果向字段均值做有界修正,得到聚合后的元数据向量。先验约束向量门(Prior-Constrained Vector Gate,PCVG)把音频向量、元数据向量及其逐元素乘积和绝对差拼接起来,预测每个维度上偏向音频的门值,再做逐维度插值并送入分类头。与随机选一个可用字段加标量门融合的匹配基线相比,FAM-Gate(域感知元数据注意力加先验约束向量门控框架)在BSD35K上层级F分数从75.90%提高到81.62%,高5.72个百分点。上述增益只在BSD10K、BSD35K固定划分与FSD50K官方划分下,以同一骨干、同一分类头和超参数做五种子平均得到,基线与FAM-Gate参数量分别为165.668M和165.982M,仅增0.19%,且该统计未计入编码三个文本视角的额外开销。方法假设至少有一个字段可用,缺失或损坏元数据、更换音频文本骨干的情形尚未验证,而与纯音频系统的对比因输入模态不同不能视为严格同条件排名。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
141. HiPAD:用同一融合网络看清人格描述在抑郁检测中的分量

标签:#病理语音评估 | #多模态学习 | #精神健康筛查 | #大语言模型
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Karol Chlasta:Kozminski University, Warsaw, Poland;WarsawIQ, Warsaw, Poland
- Piotr Struzik:WarsawIQ, Warsaw, Poland
📌 核心摘要
MPDD-AVG 2026要求在老年组和青年组上按步态惯性信号、访谈音视频及约150词人格描述判断抑郁状态、严重程度和PHQ-9分数,每组训练不足百人而模态多,强模态易掩盖弱模态。HiPAD对可用步态、音频、视频各用两层双向长短期记忆网络编码并做时间注意力池化,音视频先在至多4个访谈段内再做一次学习式段间池化,缺失模态补零。仅当步态、音频、视频中至少存在两个时才做跨模态注意力,人格流将文本嵌入与Big Five等结构特征经多层感知机编码后绕过注意力直接拼接,再进入分类与回归头,同一宽度h=128配置覆盖6个子赛道中5个。在官方CodaBench排行榜老年步态加人格赛道上,任务特定混合集成将Track-Level Score(赛道分,分类F1、一致性相关系数与Kappa的平均)从0.632提高到0.647。在官方CodaBench排行榜步态加人格赛道上,去掉全部人格派生特征后Track-Level Score下降0.499至0.507并回到随机水平。在官方CodaBench排行榜老年步态加人格赛道上,领域适应的大模型编码器相对冻结RoBERTa-large将二分类Cohen’s Kappa提高0.13,却因PHQ-9回归输出失准拉低总分。在固定HiPAD结构下官方CodaBench老年音频视频加步态加人格赛道上,手工eGeMAPS的Track-Level Score为0.477,高于wav2vec2的0.459。结论只适用于该中文小样本挑战数据,原文未披露训练时长、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
142. GeoMER:欧氏与双曲联合建模的多模态情绪识别

英文题目:GeoMER: A Joint Euclidean-Hyperbolic Geometry Framework for Multimodal Emotion Recognition
标签:#语音情感识别 | #多模态学习 | #注意力机制 | #语音
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ting Zhu:Newcastle University, Newcastle upon Tyne, United Kingdom
- Huizhi Liang:Newcastle University, Newcastle upon Tyne, United Kingdom
- Boguslaw Obara:Newcastle University, Newcastle upon Tyne, United Kingdom
- Shufei Duan:Taiyuan University of Technology, Shanxi, China
- Varun Ojha:Newcastle University, Newcastle upon Tyne, United Kingdom
📌 核心摘要
多模态情感识别(Multimodal Emotion Recognition,MER)输入为同一话语的语音与文本,输出为愤怒、快乐、悲伤、中性四类中的一类,难点在于语音与文本尺度不一致、情感随时间演变且常以混合强度出现。GeoMER 先用冻结的 HuBERT 与 RoBERTa 抽取声学与文本词元,再经线性适配器对齐分布。欧氏多模态融合模块(Euclidean Multimodal Fusion Module,EuclFusion)用双向跨注意力做词元级对齐交换,再用双向长短期记忆网络(Bidirectional Long Short-Term Memory,BiLSTM)沿时间聚合为话语向量。另一路双曲几何核心路由模块(Hyperbolic Geometric Core Routing,HypGeoRoute)把适配后词元经指数映射送入庞加莱球(Poincaré ball),按双曲距离软分配到可学习的几何核心并做流形一致聚合,再经核心间自注意力和跨模态门控融合形成抽象表示,两路拼接后分类。与直接替换嵌入或松散堆叠欧氏层与双曲层的已有做法不同,本文保留欧氏分支负责对齐判别,另设双曲分支负责抽象组织并联合优化。在 IEMOCAP 四分类测试集上,GeoMER 达到 83.54% 加权准确率与 83.35% 非加权准确率,高于复现的 MemoCMT 基线 2.49 个百分点和 2.02 个百分点。该结论只在该划分与语音加文本条件下成立,中性类仍最易混淆,跨语料与真实噪声下的表现尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
143. 强化学习搜索如何找到轻量音视语音增强网络
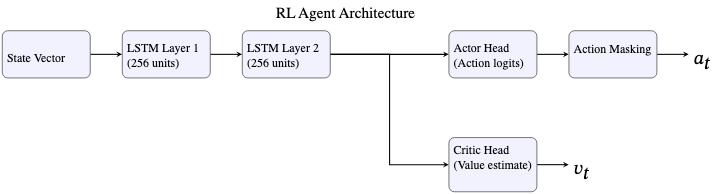
标签:#语音增强 | #强化学习 | #音视频 | #高效推理
评分:5.5/10 | 创新 1.2/2 | 技术严谨 0.8/1.5 | 实验充分 0.8/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Khubaib Ahmed:机构信息未在 arXiv HTML 中可靠披露
- Ahsan Adeel:机构信息未在 arXiv HTML 中可靠披露
- Nasir Saleem:机构信息未在 arXiv HTML 中可靠披露
- Kia Dashtipour:机构信息未在 arXiv HTML 中可靠披露
- Ahsan Ulhaq:机构信息未在 arXiv HTML 中可靠披露
- Amir Hussain:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音视频语音增强以带噪语音和唇部视频为输入,输出增强后的目标语音,难点在于双流时间对齐、融合方式选择以及大模型难以部署到算力受限设备。论文先构造受约束的搜索空间,只保留保持时间分辨率和通道兼容的操作,把搜索起点放在已有大模型附近,再由强化学习智能体每次修改一个维度并用短轮训练估计效果。奖励函数同时考虑语音质量保持、超出参数预算的惩罚和对违规结构的惩罚,搜索过程逐步向紧凑结构收缩。与手工压缩和随机搜索的差异在于用约束掩码屏蔽非法动作,并用多目标奖励显式平衡质量与体积,还报告了视觉通路可大幅简化等结构规律。在 LRS3 数据集与 CEC2 噪声测试集上,搜索得到的轻量模型取得 14.5 dB 的尺度不变信噪比提升,与 22.0M 参数基线的 15.2 dB 相比保留约 95.4% 性能,参数量为 2.9M,移动端实时率约为 0.19。该结论只在上述数据集、噪声范围和测试硬件条件下成立,未验证跨数据集、跨噪声类型和低比特部署的表现。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
144. 全模态大模型知道却说不出:对齐诊断与自我补述
标签:#音视频问答 | #音频推理 | #多模态学习 | #大语言模型
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Na Min An:机构信息未能从 arXiv PDF 文本可靠映射
- Taekyung Kim:机构信息未能从 arXiv PDF 文本可靠映射
- Jaemyung Yu:机构信息未能从 arXiv PDF 文本可靠映射
- Hyunjung Shim:机构信息未能从 arXiv PDF 文本可靠映射
- Dongyoon Han:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
全模态大语言模型把视觉、音频等专用编码器输出投影到共享语言模型空间,以多路非文本信号与文本问题为条件生成选项或自由文本回答。已编码的非文本信息在生成时取用不充分,文本模态对齐更强、注意力更多,该失衡随输入模态增多而加重,下游推理准确率下降而感知准确率保持。论文引入 token级模态对齐诊断含义,对每个非文本token计算其与回答token隐状态的最大余弦相似度并保留分布,用以刻画生成可及性,区分注意力分配与信息对齐。基于该诊断提出OMNI-CATALYST,先让同一模型为弱模态生成文本描述,再把原始表征与描述一并送入回答阶段精炼作答,描述起语义中介作用而不替换原始信号。与仅缩小表征差距或遮蔽原模态的做法不同,知识抽取阶段拓宽对弱模态的注意力并经文本转化,使精炼回答能利用文本化信息,TMA随之上升。在多模态基准上以推理准确率为指标,OMNI-CATALYST相比直接回答在七个Omni-LLM上平均提高7.29%,模态偏好分布更均衡。作者承认实验仅覆盖当前Omni-LLM支持的模态,失衡根源尚未查明。原文未给出延迟与吞吐实测,只说明分离生成描述带来额外推理代价。
🔗 开源资源
代码相关资源:https://github.com/naver-ai/OmniLLM — 链接不可用(HTTP 404)
第三方资源:https://arxiv.org/abs/2603.21664 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
145. 音频流行度可以预测吗:元数据与声音特征在音乐和音效上的比较
标签:#音频分类 | #集成学习 | #模型比较 | #可解释性
评分:5.5/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.6/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Ikram El Hadi:机构信息未在 arXiv HTML 中可靠披露
- Nihad Elbari:机构信息未在 arXiv HTML 中可靠披露
- Kawtar Tlemçani:机构信息未在 arXiv HTML 中可靠披露
- Théo Mariotte:机构信息未在 arXiv HTML 中可靠披露
- Meysam Shamsi:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
本文在FreeSound上把流行度预测化为监督分类,输入音频波形、元数据与互动记录,输出下载量按分位数划分的低中高三类和含无评分0类的四级评分,难点是下载长尾偏斜、评分集中高分且大量缺失,流行度兼受内容与曝光互动影响。音乐与音效分开处理,前者多为较长谐波节奏结构,后者为短瞬态事件,时长结构差异影响特征有效性。先做元数据预处理,对偏斜数值对数变换并标准化,由时间算年龄特征,对类别独热编码、二值化并做文本向量化,统一为每样本22维数值向量,直接作为一路分类器输入。声学侧并行抽取三套表示:平台描述子保留47维数值并以零填补缺失,eGeMAPS以函数级统计聚合为与时长无关的88维向量,MERT-v1-330M经单声道24kHz截断取末层隐状态时间平均池化得嵌入,三者与元数据向量分别送入同一训练评价流程。该流程采用80%训练与20%测试划分,训练集仅对少数类用SMOTE过采样,以随机森林、XGBoost与多层感知机按F1-score评价并报告95%置信区间。在音效下载量预测的20%测试集上,以F1-score衡量元数据配合XGBoost为0.846±0.004,高于同设置下平台描述子配合XGBoost的0.720±0.005。在音乐平均评分预测的同一80/20划分测试集上,以F1-score衡量平台描述子配合XGBoost为0.640±0.014,高于同设置下元数据配合XGBoost的0.510±0.017,而eGeMAPS与MERT在音效上跌至基线而失效。结论限于FreeSound下载与评分定义及上述划分,短时事件使通用声学表示不稳定,长音乐聚合统计丢失时序结构,未验证其他平台与时变流行,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://freesound.org/docs/api/ — 链接可访问(HTTP 200)
第三方资源:https://essentia.upf.edu/ — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
146. 库内接近满分,换人换库还准吗:DistilHuBERT 口音分类的说话人隔离复核

标签:#语音属性识别 | #评测协议 | #半监督学习 | #口音与方言 | #鲁棒性
评分:5.4/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:后 50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Xu He:Department of Electrical Engineering;Columbia University;New York, NY, USA
- Homayoon Beigi:Mechanical Engineering Dept. and;Electrical Engineering Dept.;Columbia University, NYC, NY, USA;and Recognition Technologies, Inc.;South Salem, NY, USA
📌 核心摘要
英语口音分类要求从输入波形预测说话人的母语背景或英语变体类别,难点在于口音线索与说话人音色、录音条件纠缠,同一说话人同时出现在训练集和测试集时会掩盖泛化缺陷。复现的文件级基线在L2-ARCTIC内部评估上L2准确率为99.76%,在外部可比样本上外部准确率为44.52%,外部结果低于内部结果,说明内部高分不能代表跨库能力。首轮对比中,文件级基线在官方L2-ARCTIC切分上L2准确率为100.00%,高于说话人隔离基线在四折平均下L2准确率的81.40%±3.62%,证实说话人重叠抬高了报告分数。该研究先构建每折每种口音留1名说话人测试的四折说话人隔离划分,再把L2-ARCTIC与外部语音汇成均衡八分类训练集并保留第二级外部held-out集,最后用教师模型以0.95置信度过滤外部池伪标注训练学生模型。在第0折上,加入英式与新加坡英语的扩展模型在L2测试准确率上从86.20%提升至87.90%,在第二级外部held-out集上第二级外部准确率从42.00%提升至68.00%,均高于仅用L2训练的对照。与仅报告单语料库准确率的已有做法不同,该评估把说话人隔离与交叉语料库测试同时作为必要条件,而仅用外部数据训练不能可靠迁回L2-ARCTIC。结论仅适用于24名说话人的L2-ARCTIC与所选英文口音池,外部标签定义与录音差异仍带来域偏移,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。