📄 词对齐韵律:说话人差异远大于抑郁或创伤后应激严重度
英文题目:Word-Aligned Prosody Reflects Speaker Differences More Than Depression or PTSD Severity
标签:#病理语音评估 | #心理测量 | #韵律 | #语音 | #语音生物标志物
评分:6.7/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
👥 作者与机构
- Hsiang-Chen Yeh:机构信息未在 arXiv HTML 中可靠披露
- Aurosweta Mahapatra:机构信息未在 arXiv HTML 中可靠披露
- Shreeram Suresh Chandra:机构信息未在 arXiv HTML 中可靠披露
- Ryan L. Boyd:机构信息未在 arXiv HTML 中可靠披露
- Berrak Sisman:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
论文研究词对齐韵律能否作为抑郁与创伤后应激障碍严重程度的行为测量,输入是归属到目标说话人的连续语音与词边界,输出是词层声学值与聚合后的说话人分数,难点在于单次观测同时混有说话人基线、词汇效应、话语情境与通道影响。处理先用词对齐得到词边界,再在词内估计平均基频、稳健基频范围、能量与音节校正后的对数词时长,同一套代码用于四个语料。随后用概化理论分解说话人、词、说话人与词交互及残差方差,检验词特异偏差跨情境是否再现,再把多词聚合成说话人汇总并检验跨录音一致性,通过门限后才检验与PHQ-8与PCL分数的关联。以跨情境再现性R̄c衡量,在ESD五种条件下F0范围为0.160,高于对数时长的0.010,四个特征整体仅为0.01-0.16。以校正分半一致性rc衡量,说话人汇总在ESD同一录音内为0.997,高于MSP-Podcast跨录音的0.73-0.90。以Spearman ρ衡量,在PTSD-STOP中被试间平均基频与PCL关联为0.151,高于跨时段变化关联的0.047,校正后均不显著。与直接把单词语音值读作临床证据的做法不同,该工作把词看作一次场合抽样并聚合到说话人;结论限于所研究英语语料与四个超音段特征,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
- 代码相关资源:https://github.com/jen900704/word-aligned-prosody — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
为什么要用语音补充抑郁与创伤后应激的评估
抑郁和创伤后应激障碍的严重度常用自评量表衡量,论文使用患者健康问卷抑郁分量表和创伤后应激检查表作为症状标尺,前者回看约两周,后者回看约一个月。语音之所以被关注,是因为它同时包含说了什么和怎么说,前者是词序列,后者是韵律。词级对齐技术把声学特征精确切分到每个词,使研究者可以对每个词计算音高、能量和时长。
对刚入门的研究生来说,可以把一次词观测想象成一次行为采样:说话人在某个句子里读出某个词,麦克风记录下这一次的音高均值或能量。论文要回答的是,这样的采样究竟更像稳定的个人基线,还是更像偶然的场合表现。如果它主要是基线,那么跨录音平均后会很稳定;如果它主要是场合,那么单次词读数不能直接当作病情证据。论文把可重复性定义为同一个人的测量用不同语音重新计算后仍保持一致,这与分类准确率是两回事。
一个特征可以高度可重复但与症状无关,也可以与症状有关但测不准,因此需要分两步验证。
人格心理学的聚合思想与语音已有做法有何不同
论文借用了人格心理学中特质与状态的区分。早期研究发现,用一个情境中的行为预测另一个情境中的行为,相关往往低于 0.3,对应不到 10% 的共享方差,被称为人格系数。这不是说人本身不稳定,而是说单次观测这个测量单位太薄。后来的日记研究显示,单日行为预测另一日只有 0.2 到 0.3,但奇偶天平均后相关可达 0.8 到 0.9。特质因此被理解为状态的分布,单次是分布中的一次抽样,聚合才能显现分布中心。
语言预测中也有类似经验:先按用户汇总推文再预测县收入,比直接把所有推文混在一起更准,因为避免了话多用户主导估计。以往语音研究多在录音或会话层考察可重复性,没有在词层检验同一个词的说话人偏差换语境后是否重复。已有词级抑郁分类器直接把词序列读入模型,这隐含地假设了词级声学值携带当前状态信息。论文指出这种假设可能混淆说话人基线、录音环境和麦克风,表面上的抑郁模式可能是认出了哪个人或哪个设备。
另一个相关概念是如果那么签名,即人在去除总体水平后,对重复出现的情境仍有稳定的反应轮廓。论文把词看作候选的重复情境,检验词身份是否为韵律的心理活动特征,其边界条件是只有心理活动特征才能唤起稳定的签名。
两个研究问题分别要判定什么
第一个研究问题问词的实现是否可重复,以及聚合后是否可重复。它包含两个不同的估计量。第一个是词特异偏差的跨语境重复性:某说话人把某个词说得比自己平均更高或更低,也比该词一般读法更高或更低,这种双重中心化后的偏离能否在另一个句子或情绪条件中再次出现。第二个是说话人摘要的跨录音一致性:把一个人的很多词取中位数得到一个人分数,换一批录音是否还是相近的排序。
第二个研究问题问这些说话人摘要是否与症状严重度相关,分为人与人之间、变化与变化之间,以及每天偏离自身均值后与当天症状的关系。论文在 4 个语料上展开:表演性情绪语音、播客自发语音、临床访谈和每日视频日记。前两者回答第一个问题,后两者在先通过可重复性门限后才看症状关联。门限是预先设定的:词偏差重复性要超过 0.70,说话人摘要一致性要超过 0.60,还要通过自助、留一说话人和等权重稳健性检查。
症状分数在对应特征通过可重复性检查前被 withheld,这种顺序是为了先证明测得准,再谈是否有临床意义。
整体流程如何把词切分、算特征再聚合
全流程可以沿着一个词 token 走一遍。输入是 16 千赫单声道音频和参考文本。对表演、访谈和日记语料,用对齐工具把文本与音频对齐到词边界;播客语料直接使用随库发布的强制对齐。在词边界内,只用浊音帧以自相关法估计基频,得到词内平均基频和第 90 与第 10 百分位之差作为稳健极差。
能量是词均方根取 20 乘以以 10 为底的对数,单位为分贝概念下的能量度量。时长是词时长取对数后再按音节数校正,音节来自发音词典。同一套特征代码用于 4 个语料,这是为了固定语料、特征和提取过程,只让聚合单位变化。得到每个词的 4 个数值后,有两条用法。一条是拟合混合模型分解方差,估计词偏差的重复性。
另一条是先对相对句内位置做回归校正,时长还额外校正音节数,取残差的中位数作为说话人摘要,再在两个独立录音半区之间算相关并做斯皮尔曼布朗校正。播客和日记的两个半区由完整录音构成,不把同一次录音拆开;访谈因每人只有一次访谈,只能做奇偶词拆分,测的是访谈内一致性而非跨会话稳定性。阈值、特征顺序和失败拟合规则在看任何估计前固定,事后追加的分析都标为事后分析。
混合模型如何分离说话人、词与人与词交互
在表演语料中,每个情绪条件内单独拟合一个随机效应模型,把一次词观测拆成总均值、说话人随机效应、词随机效应、人与词交互随机效应和残差。说话人效应吸收了人与人之间的整体差异,其中包括性别;词效应吸收了不同词本身的长短和发音差异;交互是候选的词特异签名;残差包含跨 utterance 语境的变化。
跨语境重复性定义为交互方差占交互方差加残差方差的比例,即交互项的单次观测组内相关。它不是原始词观测的重复性,因为原始观测还保留说话人整体水平。论文报告原始 token 保留说话人水平时,说话人加交互占总方差的比例约为 0.23 到 0.37,这相当于声学版的人格系数。时长比较特殊,先去掉了音节和说话人固定效应,因此它的说话人分量是残差而非人与人之间的方差,不能与另外 3 个特征直接比较。
事后变体加入 utterance 随机效应,让共享的句子语境离开残差,以检验残差中有多少是句子结构而非噪声。
\[y_{swr}^{(c)}=\mu_{c}+u_{S,s}^{(c)}+u_{W,w}^{(c)}+u_{SW,sw}^{(c)}+\varepsilon_{swr}^{(c)},\]上式中下标分别表示说话人、词项和出现次数,上标表示情绪条件,每一项随机效应的方差分量用于计算重复性。理解这个公式时,先认清输入是同一条件内同一个人同一个词的多次出现,输出是 4 个方差的估计,目标是得到交互可被第二语境复现的份额。论文用限定最大似然拟合,只用至少有两个有限观测的格子,时长还先去除音节影响。这个设计使词偏差与人均值可以得出相反结论:交互很小而说话人方差很大时,平均不同词能回收说话人信息,却不能提高词偏差的重复性。
说话人摘要如何构造与校正
说话人摘要的构造是另一条独立路径。以播客为例,先拟合词值对相对 utterance 位置的回归,时长还加入音节数,拟合时不使用半区标签,残差保留人与人之间的差异。然后把每个说话人的两个录音半区分别取中位数,得到两个摘要分数。在每半区至少有 50 个有效观测的说话人之间算皮尔逊相关,再做 2 乘相关除以 1 加相关的校正。这个校正是对中位数和不等半区的外推,关心的是排序一致性而非绝对值相等。
样本和 25 种备选拆分在处理音频前固定。等权重稳健性检查把按观测加权改为按录音加权,用来暴露话多者主导估计的超级用户效应。时长最容易受此影响,因为话量本身与语速相关。论文还做了按每半区抽样词数的聚合曲线,从很少词到 200 词观察一致性如何爬升,以给出实用规则:平均基频和能量在 10 到 20 词即达 0.80,而基频极差和时长到 200 词仍未达到。
词特异偏差 × 说话人整体水平: 词特异偏差指去掉说话人整体水平和该词一般读法后,某人对某个词的独特偏离;说话人整体水平指该人在全部词上的平均音高、能量或时长基线。二者分工是把一次观测拆成可加的人效应、可加的词效应和人乘词交互,搭配后才能判断稳定性究竟来自这个词还是来自这个人,组合的意义是聚合能回收说话人整体水平,即使词特异部分不稳定。
跨语境重复性 × 说话人摘要一致性: 跨语境重复性问同一个词的说话人偏差换一句、换一种情绪条件后还能保留多少;说话人摘要一致性问把很多不同词取中位数后,换一批录音还能否得到同一个说话人分数。前者是单次观测的估计量,后者是聚合后的估计量,搭配使用才能区分一个场合与一种特质,组合后揭示了本文核心反差:词偏差不重复而人均值高度一致。
人与词交互 × 残差: 人与词交互指某说话人对某词偏离了人和词各自的平均水平,是候选的词特异签名;残差指同一条件下同一个人同个词不同次出现之间的差异,包含句子语境变化。分工是把可重复的词签名与场合变化分开,组合后用交互占交互加残差的比例定义单次观测的组内相关,从而量化词偏差有多少能被第二个语境复现。
本研究没有训练什么,实际计算是什么
本研究没有训练抑郁或创伤后应激分类器,也没有训练神经网络声学模型。需要说明的计算是统计估计与对齐推理。对齐部分调用已有的对齐模型和随库对齐,不更新其参数;声学部分是确定性信号处理加回归残差化;推断部分是混合模型的限定最大似然估计、分半相关、自助区间和等值检验。
参数冻结与否的问题在这里体现为特征提取代码固定、回归系数一次性拟合、拆分方案预先固定,而不是梯度是否流经网络。由于没有训练,也就不存在拿掉某层必然怎样的消融,但论文用改变提取细节的 4 种事后检查来检验词重复性是否被低估,用改变加权方式来检验摘要一致性是否依赖话多者。
症状关联部分用斯皮尔曼相关并在每个四特征家族内做错误发现率校正,变化关联用最早与最晚录音集的差值相关,日内关联用带随机截距的混合模型加按人聚类的自助。这些都是估计不确定性的方法,不是模型训练。
分析有效性 × 临床有效性: 分析有效性指声学摘要本身是否可重复,与症状无关;临床有效性指该摘要是否与抑郁或创伤后应激严重度相关。论文按验证框架先过分析关再看症状关联,分工是防止用不可靠的测量谈临床意义,搭配的意义是即使临床关联为零,也能排除测量不可靠这个解释。
四个语料的输入条件与划分有何不同
表演语料有 10 名英语说话人,性别平衡,实际使用 9 人,4 男 5 女,每人用 5 种情绪条件说同样 350 句,共 98202 个词 token。词在句子语境中重复,因此可在条件内估计重复性。它的情绪标签不分析,只用来制造剧烈的韵律变化,同时固定说话人和词,是检验词签名能否经受说话风格改变的控制实验。播客语料是自发语音,预先要求至少 100 条对齐话语且至少来自两期节目,保留 99 名已知说话人,62 男 37 女,共 551759 个词 token。完整期节目被分到不同半区,两半绝不含同一录音会话,因此测的是跨独立录音语境的一致性。
临床访谈语料是半结构化访谈,有 189 名有抑郁分数的被试,其中 56 人带库内二分类抑郁标签,但分析用连续分数,访谈者提示被排除以免泄露诊断信息。每人只有一次访谈,奇偶拆分只能反映访谈内一致性。每日日记语料跟踪 219 名世贸中心救援人员,共 13600 条每日独白,84% 为男性,每天用改编的检查表自评,1 到 5 分,213 人有 0 到 60 天均值,178 人有重复同日分数,5311 个人日中位约 29 天。它提供每人多场合加当天症状分,可同时检验人与人之间、变化之间和日内关系。
4 个语料共享 4 个特征定义,但对齐来源和拆分含义不同,这是解读数字时必须保留的条件。
词偏差为何不重复而人均值高度一致
先看同一批表演音频的两种计分。按说话人摘要计分,校正一致性达 0.9973 到 0.9996;按词偏差计分,重复性低于 0.16。音频、说话人、特征和提取完全相同,只是聚合单位不同,这是单次场合与聚合的直接对照。但该上限部分来自性别和通道,只有 4 男 5 女,性别本身就能撑起很高的区分度。
方差分解显示,人与词交互只占总方差的 0.3% 到 11.1%,残差占 26% 到 61%,词主效应占 7% 到 72%。4 个特征的平均跨语境重复性为平均基频 0.059、基频极差 0.160、能量 0.029、对数时长 0.010,全部远低于 0.70 的门限,平均基频和能量直接判失败,另两项因稳健性拟合失败判未定。把同样估计量用在 20 组随机抽 9 人的播客数据上,中位数重复性为 0.067 到 0.095,没有一组超过 0.163,说明 9 人小样本不是唯一原因。事后改变提取的 4 种检查仍让重复性低于 0.25,加入 utterance 效应吸收 0.3% 到 19% 方差但最多移动重复性 0.012。
这符合可靠性悖论:词与词差异很稳健,但人对词的偏离不稳定,可供第二语境复现的词特异偏差所剩无几。
下面表格整理摘要层面的总体对比,比较问题是单次词偏差与跨词聚合的人分数是否同样可重复,公平条件是同一套特征代码,指标方向是越大越一致。
| 层面 | 指标含义 | 表演语料结果 | 播客与临床摘要结果 | 结论与限制 |
|---|---|---|---|---|
| 词特异偏差 | 跨语境重复性 | 0.01–0.16 | 9 人抽样 0.067–0.095 | 远低于门限,交互本身很小 |
| 说话人摘要 | 跨录音一致性 | 0.997 | 0.73–0.90 | 表演上限含性别与通道贡献 |
| 临床摘要 | 访谈内与日记跨录音 | 0.84–0.996 | 0.975–0.980 | 先过分析关,不代表与症状相关 |
| 总体反差 | 同音频不同单位 | 低于 0.16 | 达到 0.997 | 单位决定稳定性,非音频质量 |
上表综合了摘要句中的区间,表演的高一致性不能推广为跨会话稳定性,播客的跨期拆分才更接近跨录音含义。对数时长的说话人分量定义不同,不能跨特征直接比大小。词偏差的低重复性也不是单纯测量噪声,因为残差中很大一部分是共享的 utterance 结构而非随机误差。
读图说明:下图是表演语料 5 条件平均的方差分解堆叠条带,每行一个特征,颜色段长度对应占总方差百分比,请按说话人、词、交互与残差的顺序辨认。
看图路径: 1. 先看四个特征条带中灰色残差段与细窄交互段的相对长度;2. 再对比平均基频与能量条带中蓝色说话人段的占比;3. 注意对数时长条带的说话人段含义与其他三行不同
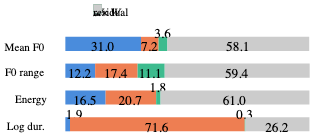
论文图 1。原论文 Figure 1::“ESD variance decomposition, averaged over the five conditions, in % of total variance: speaker (S), word (W), their interaction (S\timesW, the candidate word-specific signature)…”。
上图可见平均基频的说话人段最长而交互段很窄,能量与基频极差的词段较宽但交互段依然很细,对数时长的橙色大段是去除音节与说话人效应后的残余结构。结合重复性定义交互除以交互加残差,分母大而分子小是重复性低的直接原因。图中辨不清的精确小数以正文区间为准,对数时长行不参与跨特征的说话人方差比较。
聚合多少词才够用,哪个特征最易被话量带偏
在播客 551759 个 token 上,分半一致性校正后为 0.732 到 0.895,平均基频、基频极差和能量通过 0.60 门限,对数时长未通过。时长的按 token 加权一致性为 0.793,改为按录音等权重后跌到 0.560,其他三特征最多移动 0.038。这是超级用户效应的实例:时长与说话量共变,按观测加权等于让话多者主导,而按人加权后时长的人分数不再稳定。实用规则来自按每半区抽样词数的曲线,平均基频和能量在 10 到 20 词内达到 0.80,基频极差和时长到 200 词仍未达到。
这意味着若只为得到稳定的说话人基线,短语音对平均音高和能量已够,但若关心音高动态或语速,需要更长采样。临床语料在看症状前先过分析关,日记跨录音为 0.975 到 0.980,访谈访谈内为 0.844 到 0.996,4 个特征全部通过。因此后续临床零结果不太可能用声学摘要不可靠来解释。需要保留的限制是播客分半跨期但仍可能含通道成分,访谈只有一次访谈,零结果的含义只限于所用拆分条件。
读图说明:下图横轴为每半区平均的词数从 5 到 200,纵轴为一致性,4 条曲线分别对应 4 个特征,灰带为词偏差重复性,虚线为 0.80,请比较曲线的爬升速度与灰带高度。
看图路径: 1. 先沿横轴从 5 词到 200 词看四条一致性曲线的上升速度;2. 再看 0.80 虚线处平均基频与能量何时越过、极差与时长为何滞后;3. 最后看底部灰带位置,理解平均不同词为何不能提高词偏差重复性
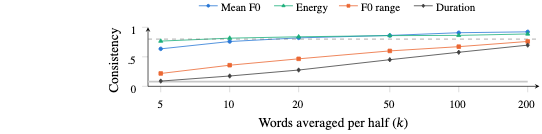
论文图 2。原论文 Figure 2::“Aggregation in MSP-Podcast, one corpus, two estimands.”。
上图可见平均基频与能量曲线上升最快并早早越过虚线,基频极差与时长曲线明显更低且爬升更慢,底部灰带停留在 0.07 到 0.10 附近,说明平均不同词不能抬高词偏差的重复性。纵轴是一致性而非改善量,曲线向下不代表性能变差,只代表词数少时排序不稳。末端 200 词处的值不能推广到任意短语音,实际部署的词数条件必须对照横轴读取。
平均基频 × 稳健基频极差: 平均基频指一个词内浊音帧基频的均值,反映音高高低;稳健基频极差指第 90 百分位与第 10 百分位之差,反映音高变化幅度。二者分工是分别刻画水平与动态,搭配能量和经音节校正的对数词时长后构成四个共享特征,组合的意义是用同一套提取代码横跨表演、自发和临床语料,使跨库比较不受特征定义改变的干扰。
症状关联为零在什么统计含义下成立
人与人之间、日记变化之间和访谈连续分数 3 个家族经多重校正后均无显著相关。日记人与人之间和变化的校正后 q 值分别不小于 0.109 和 0.295,访谈相关绝对值不超过 0.044 且界限在负 0.20 到 0.19 以内。事后等值检验给出能排除的最小关联:访谈为 0.16,日记人与人之间为 0.26,变化为 0.23。按个体差异研究惯例,0.20 是典型效应,0.30 是较大效应,纵向抑郁单特征相关约 0.1 到 0.3,因此 3 个家族都排除 0.30,只有访谈排除 0.20,日记仍与文献报道量级的效应相容。
访谈中 56/189 带抑郁标签,若差异只集中在该小组,d 为 0.3 对应相关约 0.14 也会落在界限内。日记平均基频的人与人相关最大且区间排除零,但未通过校正,且无性别变量可排除性别相关的音高差异。日内分析用 5311 个人日,日内斯皮尔曼相关为 0.022、0.037、负 0.031 和 0.016,聚类自助区间在负 0.06 到 0.07 以内,对 0.07 等值为零,允许斜率随人变化后仍无存活斜率。
下面表格整理临床关联的总体结论,比较问题是可重复的说话人摘要是否追踪严重度,公平条件是先通过分析门限再看症状,指标方向是相关绝对值越大越相关,等值界限越小越有信息量。
| 层面 | 关联类型 | 日记结果 | 访谈结果 | 等值与限制 |
|---|---|---|---|---|
| 人与人之间 | 与严重度相关 | 不超过 0.15 | 不超过 0.044 | 排除 0.30,仅访谈排除 0.20 |
| 变化之间 | 差值相关 | 变化界限 0.23 | 无跨会话数据 | 日记仍相容文献量级 |
| 方法含义 | 先分析后临床 | 通过 0.975–0.980 | 通过 0.84–0.996 | 可靠但未显示效度 |
上表数字来自摘要句的总体界限,具体到特征的最大值与区间见正文叙述,日记平均基频的未校正信号不能当作部署依据。未胜出的项目是全部 4 个特征,而非某个特征偶然失败;尚未评测的范围包括其他语言、音段特征和学习表征。把搜索选优或知道答案后的最优值当作可部署提升是错误的,本研究没有训练分类器,也就没有可部署的分类增益。
哪些条件限制了结论的推广
语料只覆盖英语和 4 个超音段特征,不能推广到其他语言、音段特征或学习表征。表演语料只有 9 人,自助区间偏低,通道与性别抬高了 0.997 上限。播客分半跨期但说话人与设备仍可能部分重叠,词序列模型在说话人或期节目重叠的拆分下有身份与设备泄露风险。
日记的每日改编检查表无已发表信度,事后在其 213 人上单日组内相关为 0.56,日内标准差 0.58,人间标准差 0.76,60 天均值信度约 0.97,因此人与人之间的零结果不太可能是症状均值不可靠所致,但日间方差是变化还是误差尚未量化,尽管语言特征在日内可追踪症状。访谈每人只有一次,奇偶拆分不是跨会话稳定性。等值检验依赖相关标准误近似,日内家族直接用聚类自助,这些统计选择决定了排除界限的含义。
论文明确区分缺证据与技术缺陷:来源未确认不是技术缺陷,相关不等于因果,没有测量延迟或成本就不能承诺改善。对逐词解读系统的含义是,在上下文中读词序列与把单个词值当作对说话人的归因是两回事,后者不被本文结果支持。
复现第一步做什么,需要保留哪些细节
复现应从作者当前可用的代码仓库开始,核对与论文相同的特征代码和协议中的对齐模型与基频参数。本篇作者资源为代码类型且当前可用,状态码为 200,链接在摘要与合规节一致给出;是否能运行出同样数字还取决于音频可及性,日记音频与结局不能共享,其他三库需遵守各自使用条款。第一步是重跑词边界与 4 个特征,固定阈值、特征顺序和失败拟合规则,症状分数在通过可重复性检查前不查看。
关键超参数与信息条件包括:浊音帧自相关、能量定义、分贝计算、音节来源、相对位置回归、每半区至少 50 有效观测、中位数摘要、皮尔逊相关加斯皮尔曼布朗校正、完整录音分半、混合模型限定最大似然、至少两有限观测的格子、时长先去音节与说话人效应。统计侧保留自助按人聚类、留一说话人、等权重、25 种备选拆分、每家族四特征错误发现率校正和等值检验标准误。硬件预算与推理开销原文未报告,不能承诺延迟或成本。
值得尝试的时机是已有按说话人聚合的基线并想检验词级归因时;第一步不是训练分类器,而是先复现方差分解与聚合曲线,确认单位效应后再谈症状。
什么时候值得尝试,还缺哪项验证
当任务目标是得到稳定的说话人基线时值得尝试聚合:平均基频和能量用 10 到 20 词即可达到 0.80,适合短语音的人水平估计;当任务需要音高动态或语速时要准备更长采样,因为基频极差和时长爬升慢且时长对加权敏感。当研究问题是抑郁或创伤后应激严重度时,本文 4 个超音段说话人摘要在所用语料、拆分和量表条件下未显示可检测关联,不应把单次词值直接读作病情。
还缺的验证是跨语言、音段与学习表征的同类分解,以及日内症状变化本身的信度标定,还有在严格跨说话人与跨设备拆分下词序列模型的泄露检验。常见误解是把高可重复性当作高效度,本文恰好给出反例:分析有效性通过而临床有效性未通过。另一个误解是把词差异大当作词签名强,实际上词主效应大而人与词交互小,正是可靠性悖论。论文的结论是词不是情境,同一音频按词偏差计分低于 0.16,按人摘要可达 0.997 但部分来自性别与通道。
韵律的说话人信息出现在聚合后,对齐到词增加的可重复信息很少;症状在人与人之间、变化之间和日内均未被检测到, prosody 与症状的连接单位仍是开放问题。
📎 论文与评分元数据
排名:前50% | 文档类型:应用研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses