📄 窗长为何重要:噪声下语音活动检测的离线基准解读
英文题目:Window Size Matters: Benchmarking Voice Activity Detectors in Noise
标签:#语音活动检测 | #基准设计 | #基准测试 | #语音
评分:6.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Alok Kumar:机构信息未在 arXiv HTML 中可靠披露
- Mohit Srivastava:机构信息未在 arXiv HTML 中可靠披露
- Anupam Purwar:OneByZero AI
📌 核心摘要
语音活动检测的输入是16 kHz连续音频,输出是每个短帧是否为语音的二值判断或语音概率,难点是在巴布尔人声、低信噪比和跨文件电平变化下同时保持高召回和低误触发。论文先将LibriSpeech干净语音与9类噪声按-5至20 dB共6档信噪比混合,生成带逐样本语音标注的含噪语音,测试集共2214句约7.1小时。随后按16毫秒及20至50毫秒窗口切分非重叠帧,并由样本标注汇总得到帧级标签,再送入检测器得到每帧语音分数。三检测器的全部帧分数在统一流程下汇合计算ROC曲线下面积、平均精度和固定阈值F1,以排序质量为主要依据。在20毫秒窗口下TEN VAD的AUC为0.916,高于RMS基线的0.754,TEN在16毫秒跳长上AUC为0.917、平均精度为0.968,在20至50毫秒内AUC保持在0.916至0.919。Silero VAD仅在30毫秒附近AUC达0.920,在20毫秒跌至0.627,论文将其归因于补零、子块平均和状态未重置等协议因素但未做验证,而TEN在-5 dB巴布尔噪声下AUC仅0.509接近随机。结论仅适用于离线帧分类,不适用于流式端点延迟和截断行为,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
数据相关资源:https://github.com/zhenghuatan/LibriVAD — 链接可访问(HTTP 200)
数据相关资源:https://huggingface.co/datasets/LibriVAD/LibriVAD — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
语音活动检测在流式识别里管什么
语音活动检测要对每一小段音频回答是否有人在说话。在流式语音识别堆栈里,它的判决决定哪些音频被送去识别器、何时结束一句话,以及在静音上花多少计算。漏检会把词切掉,误触发则浪费计算,还可能让端点过早或过晚。论文把范围收得很窄,只做离线帧级分类,不测流式延迟,也不断尾静音如何收尾,更不做端点状态机。输入是 16 kHz 的含噪波形,输出是每帧一个 0 到 1 之间的连续分数,评价时把所有文件的帧汇集起来算排序指标。
读者需要先接受这个设定,后面所有好坏都是分数把语音帧排在噪声帧前面的能力,而不是线上体验。对于刚入门的研究生,关键是区分检测器本身的排序能力与完整线上端点策略,这是两层不同的东西。前者是本文测量的对象,后者还涉及平滑、迟滞和最小时长,本文明确没有做。
已有检测器和数据集各解决什么
传统一支用能量、过零率、谱形状和统计检验做判决,优点是小而快,代表有电话场景的 G.729 附录、WebRTC 检测器和无监督的 rVAD。它们在干净或平稳噪声下够用,但在低信噪比下响度线索会失效。神经一支用循环网络、多分辨率上下文、直接对波形建模的卷积结构,以及 NeMo 自带的 MarbleNet 等紧凑模型,目标是在噪声下学到比能量更稳的线索。Silero VAD 和 TEN VAD 都是面向端侧和流式的预训练神经检测器,都对外输出每帧语音概率,所以能用无阈值指标直接比较。
数据集方面,很多工作用私有或任务特定数据,难以复现对比,AVA-Speech 标注电影音频,VOiCES 提供真实房间远场录音。LibriVAD 则走合成路线,用 LibriSpeech 干净语音按固定信噪比与噪声混合,并用干净语音的强制对齐生成样本级 0 与 1 标签,还提供 3 种数据规模。LibriVAD 原作者评测的是在其上训练的模型,本文补的是另一类问题,即不训练,直接拿生产里会部署的现成检测器做评测。
论文要回答的具体问题是什么
作者团队在用 NVIDIA Parakeet 搭建实时识别服务,有 RMS 能量门和 TEN VAD 两种前端,想在定 TEN 为默认之前,把流行的 Silero VAD 也纳入比较。但他们找不到公开可复现的三者对照,尤其是在受控噪声和受控信噪比的英文基准上。于是问题被拆成 4 个可测量的部分。第一,在 LibriVAD-small 的 test-clean 全集上,3 个检测器的帧级排序能力各是多少。第二,把窗长从 20 ms 扫到 50 ms 时,各自的指标是否稳定。
第三,Silero 在固定分帧下看起来脆弱,到底是模型本身偏好某个窗长,还是评测协议引入的填充、平均与状态处理造成的。第四,TEN 按噪声族和信噪比分层后,弱点在哪里。同时论文提醒语音先验很高,固定阈值 F1 可能虚高,需要把 AUC 和先验放在一起读。这些问题都不涉及训练新模型,也不涉及延迟测量。论文强调这是在线选型前的离线摸底,测的是分离能力,不是用户能感知的端点快慢。
从干净语音到指标的整体流程
整条管线可以按一张流程图理解。左侧是 LibriSpeech 的 test-clean 干净语音、9 个噪声族和强制对齐结果,中间按六档信噪比混合成 16 kHz 含噪波形,并同步写出每采样点的 0 与 1 标签,右侧把波形切成不重叠帧,每个检测器对每帧打分,最后汇集全部帧算 AUC、AP 和 0.5 阈值 F1。整个流程没有端点平滑、迟滞或最小时长规则,是纯批量打分。
下面这张官方流程图展示了数据生成与评测管线,读图时重点看混合、标注与分帧三步如何衔接,例子只是帮助理解换算关系。
看图路径: 1. 沿左侧干净语音、噪声族和强制对齐向右看混合与标注两条输出;2. 看含噪波形与样本标签如何进入分帧,再得到检测器分数与指标;3. 注意分帧框标注的跳长等于窗长,说明帧不重叠
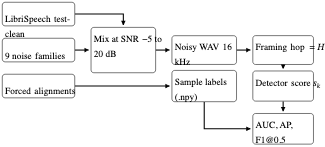
论文图 1。原论文 Fig. 1::“Data generation and evaluation pipeline.”。
图中左侧有两个输入分支,一个是干净语音加 9 个噪声族后按信噪比混合,另一个是强制对齐,两个分支分别产生含噪波形与样本标签文件。中间方框明确写出混合信噪比范围与 16 kHz 波形,标签文件标注为每样本文件。右侧先按跳长等于窗长分帧,再由检测器给出每帧分数,最后汇集计算 3 个指标。举个例子,一个 20 ms 窗对应 320 个采样点,它只是说明窗长与采样点数的换算关系,不代表论文只测这一种窗。图中箭头从左向右走,主路径是语音加噪、分帧、打分、算指标,标注路径是独立并行的。
分帧与标签如何对齐
设采样率为 16 kHz,窗长为 W 毫秒,跳长 H 由采样率换算得到,帧之间不重叠。第 k 帧覆盖从 k 乘 H 到下 1 帧起点前一个采样点,参考标签由该区间内样本级标签聚合得到。每个检测器返回连续分数,全部文件、全部帧汇集后统一算指标。这种汇集方式意味着跨文件的绝对分数可以直接比较,RMS 这类绝对响度分数会因此吃亏,而单文件内排序可能并不差。
语音活动检测 × 非重叠音频帧 × 语音概率分数: 语音活动检测是对每一帧判断是否有人说话,非重叠音频帧是一段不重叠的短音频窗,语音概率分数是检测器对该帧为语音的连续打分;阈值把分数变成判决,而 AUC 与 AP 直接评价分数把语音排在非语音前面的能力,所以同一组分数可以在不同阈值下比较排序质量。
窗长与跳长的换算关系由原文公式给出,符号含义是采样率乘以毫秒数再换算成采样点数。
\[H=\operatorname{round}\!\left(\frac{16000\cdot W}{1000}\right),\]该公式只解决帧划分问题,不决定模型内部看到多少上下文。TEN 把跳长当参数传入,RMS 对任意跳长直接计算能量,Silero 则受最小输入限制,需要额外适配,这为后面的窗长敏感性埋下伏笔。论文的固定跳长实验用 256 采样点即 16 ms,窗扫实验用 320 到 800 采样点,对应 20 到 50 ms。
三个检测器各自怎么算出分数
TEN VAD 用 ten_vad 包,以跳长参数运行并取 process 返回的原始语音概率,固定跳长实验用 256 采样点即 16 ms,与生产会话设置一致。RMS 基线先算每帧归一化波形的均方根能量,再转成分贝值,最后把分贝线性映射到 0 到 1,得到单调可用于 ROC 分析的分数。Silero VAD 加载预训练模型,安装版本拒绝短于 512 采样点的输入,因此短帧补零到 512,长帧切成 512 子块再平均概率,且整个运行只建一个模型实例、状态从不重置,状态会跨帧甚至跨文件传递。3 个检测器都没有在 LibriVAD 上训练或微调。需要强调的是,TEN 文档只把 160 和 256 采样点列为优化过的跳长,扫到 320 到 800 采样点是库允许但文档之外的用法。
RMS 能量 × dBFS 映射分数: RMS 能量先算一帧内波形幅度的均方根,反映该帧有多响,dBFS 映射分数再把分贝值线性压缩到 0 到 1 之间,得到可以排序的分数;它没有任何音高或谐波线索,只能靠响度区分语音与噪声,所以跨文件响度不一致时排序会变差。
RMS 的能量与分贝计算由原文两步公式给出,先求均方根再取对数并映射。
\[r_{k}=\sqrt{\frac{1}{H}\sum_{n=kH}^{(k+1)H-1}\left(\frac{x[n]}{32768}\right)^{2}},\qquad d_{k}=20\log_{10}(r_{k}+\epsilon),\]\[s_{k}=\operatorname{clip}\!\left(\frac{d_{k}+100}{100},\,0,\,1\right).\]其中除以 32768 是把 16 位整数波形归一化,映射把负分贝加 100 再除以 100 并截断到 0 到 1。TEN 与 Silero 都是神经预训练模型直接输出语音概率,不经过这套能量映射。输入约束是理解公平性的关键,TEN 任意跳长原生支持,RMS 任意跳长原生计算,Silero 短帧补零、长帧平均,这是后文讨论 Silero 脆弱性的事实基础。
本研究训练了什么,又用什么指标
本研究没有训练任何模型,这一点要先说清。TEN、Silero 都是拿来即用的预训练权重,RMS 是无参数的信号能量规则。实际计算过程是推理与评测,包括数据生成、按窗切分、调用检测器打分、汇集帧算指标,没有梯度更新,也没有优化器设置。无训练不等于输出确定,至少 Silero 的循环状态会让分数依赖历史帧的处理顺序。指标方面,AUC 是随阈值变化的真正率与假正率曲线下面积,等于随机语音帧得分高于随机非语音帧的概率,机会水平恒为 0.5。
AP 是对精确率召回率曲线的加权求和,机会水平约等于正类先验。F1 取固定 0.5 阈值,反映可部署工作点但依赖校准。
ROC AUC × 平均精度 × 固定阈值 F1: ROC AUC 是随机语音帧得分高于随机非语音帧的概率,机会水平恒为 0.5,不受语音占比影响;平均精度是对精确率-召回率曲线的加权平均,机会水平约等于语音先验;固定阈值 F1 只看 0.5 一个工作点的精确率与召回率调和,受校准和先验影响最大,三者分工是排序能力、检索平均质量与可部署工作点。
在语音先验为 0.745 的数据上,全判语音的平凡规则已有很高的 F1,原文用下式点出虚高问题。
\[\mathrm{F1}_{\text{trivial}}=\frac{2\cdot 0.745\cdot 1}{0.745+1}\approx 0.854.\]该式分子是 2 乘精确率乘召回率,分母是两者之和,代入精确率 0.745 与召回率 1 得到约 0.854。这意味着 RMS 的 0.85 量级 F1 并不比全判语音强,TEN 的 0.913 才是真实但幅度有限的提升。论文因此把 AUC 当主要指标,并建议同时报告语音先验。AP 同样受先验托底,在低 AUC 时也可能显得很高,读数时要留心。
评测数据与两个实验如何组织
数据用 LibriVAD 的 small 变体,只评 test-clean。生成脚本还会顺带产生训练与开发混合,但因不训练而未使用。实验分两组,共用同一数据加载、分帧与指标代码以保证可比。实验 A 只跑 TEN 在 256 跳长并做分层,实验 B 在 20、30、40、50 ms 四档窗长上跑 3 个检测器。分帧用不重叠帧,指标用汇集全部帧的 AUC、AP 与 0.5 阈值 F1。
窗长 × 跳长 × 补零与子块平均: 窗长是每帧时长,跳长是相邻帧起点间隔,本文帧不重叠所以两者相等;补零是把不足模型最小输入的短帧用数字静音填长,子块平均是把长帧切成多个模型可接受的子块再平均概率,两者都是为了喂给固定输入尺寸的模型,但都会改变模型实际看到的信号。
下表整理评测规模要回答的问题是,在多大体量和多高的语音占比下比较排序能力,条件是离线汇集帧、不做端点后处理,表内数字都有逐字原文证据。
| 评测切分 | 文件数 | 时长 | 噪声族数 | 信噪比范围 |
|---|---|---|---|---|
| test-clean | 2,214 | about 7.1 hours | nine | from −5-5 to 20 dB |
该表说明比较建立在两千多个文件、约 7 小时音频上,覆盖 9 个噪声族与六档信噪比,语音帧约占四分之三。限制是只用 small 变体和 test-clean,未覆盖 medium 与 large,也未覆盖远场或非英语,标签来自干净语音强制对齐,可能把词间短停顿标成静音。先验高直接影响 AP 与 F1 的解读,后文所有指标都要在这个条件下读。
TEN 在固定 16 ms 下表现如何
实验 A 的比较问题是,在生产常用的 16 ms 跳长下,TEN 的帧级排序能力是多少,指标方向是 AUC、AP、F1 越高越好,条件是汇集全部文件的 1608606 帧。表前先明确公平条件,同一批 2214 个文件、同一分帧与指标实现,只看 TEN 单个检测器。
| Metric | Value |
|---|---|
| Files scored | 2,214 |
| Frames | 1,608,606 |
| Speech prior | 0.745 |
| ROC AUC | 0.917 |
| Average precision | 0.968 |
| F1 @ 0.5 | 0.913 |
表中 TEN 达到 AUC 0.917、AP 0.968、F1 0.913,帧数乘以跳长再除以采样率约得 25738 秒即 7.15 小时,与数据集时长吻合,可作完整性校验。但 headline 数字掩盖了条件依赖,按噪声族和信噪比分层后,巴伯尔噪声在低信噪比下接近机会水平。未胜出的范围也要写清,这里只分层了 TEN,没有分层 RMS 与 Silero,因此不能说它们在巴伯尔下更好或更差。
混合信噪比 × 巴伯尔噪声: 混合信噪比是合成时语音与噪声能量的比值,越低表示噪声越强;巴伯尔噪声是多人说话混杂的干扰,本身也是浊音和谐波结构,因此靠响度和基音都难以把它与目标语音分开,是 TEN 最难的条件。
该桥接说明信噪比越低噪声越强,而巴伯尔本身也是语音,响度和周期性线索都容易失效,这正是下一节分层表要验证的猜测。
巴伯尔噪声为何是 TEN 的弱点
分层比较要回答的问题是,TEN 的错误是否集中在特定噪声与信噪比,公平条件是同为 TEN、同为 16 ms、同为 LibriSpeech 风格的巴伯尔子集,指标方向仍是越高越好。表前明确比较对象都是 TEN 自身在不同信噪比下的表现,不涉及跨模型对比。
| SNR (dB) | ROC AUC | AP |
|---|---|---|
| −5-5 | 0.509 | 0.834 |
| 0 | 0.555 | 0.859 |
| 5 | 0.657 | 0.907 |
| 10 | 0.766 | 0.945 |
| 15 | 0.854 | 0.969 |
| 20 | 0.916 | 0.983 |
结果显示负 5 dB 时 AUC 仅 0.509,几乎等于随机猜测,随信噪比升高逐步爬升到 20 dB 的 0.916,而 AP 始终在 0.83 以上,这是高先验托底造成的虚高。论文的解释是推测性的,巴伯尔本身也是浊音谐波信号,若 TEN 依赖音高类周期性线索,则在巴伯尔下失去区分力,但该机制未经消融验证。限制是这只是 TEN 的单条件切片,非巴伯尔高信噪比多在 0.95 以上,但 RMS 与 Silero 的对应切片缺失,不能做跨模型归因。换句话说,能说 TEN 怕巴伯尔,不能说别人不怕。
窗长扫描中谁稳定谁起伏
窗长扫描要回答的问题是,当窗从 20 ms 变到 50 ms,3 个检测器的排序质量如何变化,公平条件是同一批 2214 文件、同一分帧与指标实现,指标方向是 AUC、AP 越高越好,F1 只反映 0.5 阈值工作点。图前先说明读法,横轴是窗长,纵轴是逐文件 AUC 分布与池化 AUC 折线,重点看分布位置与折线走向。
看图路径: 1. 先看横轴四个窗长下每组三只箱体的中位数与离散程度;2. 再看三条带圆点的折线代表的池化 AUC 随窗长如何走平或起伏;3. 重点对比绿色 TEN 折线与橙色 Silero 折线在 20 ms 与 30 ms 的差异

论文图 2。原论文 Fig. 2::“Per-file ROC AUC by detector and window size (boxes) with pooled AUC overlaid (lines).”。
图中横轴是 4 个窗长,每个窗长下有三只箱体,纵轴是逐文件 ROC AUC,圆点折线是汇集全部帧的池化 AUC。可见绿色 TEN 箱体位置高且窄,池化折线几乎水平;蓝色 RMS 箱体中位数明显高于其池化折线,提示跨文件绝对分数不可比;橙色 Silero 箱体在 20 ms 显著下移、在 30 ms 冲高。图里下方离散圆圈是低分文件,大量低分点对应巴伯尔低信噪比等难例,与上节分层结论相互印证。表前再明确 1 次比较问题,同一数据上 3 个可运行策略随窗长的变化,表后解释收益与代价。
| Detector | WW (ms) | Frames | AUC | AP | F1@0.5 |
|---|---|---|---|---|---|
| TEN | 20 | 1,286,712 | 0.916 | 0.968 | 0.913 |
| TEN | 30 | 857,520 | 0.917 | 0.968 | 0.913 |
| TEN | 40 | 642,870 | 0.918 | 0.969 | 0.914 |
| TEN | 50 | 513,918 | 0.919 | 0.969 | 0.915 |
| RMS | 20 | 1,286,712 | 0.754 | 0.884 | 0.856 |
| RMS | 30 | 857,520 | 0.759 | 0.884 | 0.854 |
| RMS | 40 | 642,870 | 0.761 | 0.887 | 0.856 |
| RMS | 50 | 513,918 | 0.767 | 0.888 | 0.855 |
| Silero | 20 | 1,286,712 | 0.627 | 0.842 | 0.353 |
| Silero | 30 | 857,520 | 0.920 | 0.974 | 0.910 |
| Silero | 40 | 642,870 | 0.803 | 0.926 | 0.283 |
| Silero | 50 | 513,918 | 0.738 | 0.903 | 0.533 |
表后解释分 3 层。TEN 在四档窗下 AUC 仅从 0.916 走到 0.919,ROC 曲线几乎重合,长窗略好符合单次判决上下文更多的直觉。用排序错误率 1 减 AUC 看,20 ms 时 TEN 为 0.084、RMS 为 0.246,TEN 去掉了约三分之二的排序错误,50 ms 下比例相近。RMS 稳定但弱,池化 AUC 在 0.754 到 0.767,而逐文件中位数约 0.84 到 0.87,差距来自绝对分贝跨文件不可比。Silero 起伏最大,30 ms 以 0.920 略超 TEN,20 ms 跌到 0.627,40 ms 与 50 ms 为 0.803 与 0.738,且 40 ms 的 F1 仅 0.283 而 AUC 仍有 0.803,说明排序保留得比校准好,分数整体偏低于 0.5。反例是 Silero 的峰值不能读成它偏好 30 ms,论文明确这是协议假设而非模型结论。
Silero 的起伏更可能是协议造成的吗
这一节讨论的不是胜负,而是把 Silero 的输入处理拆开看。论文提出 3 个未经消融的假设,都与固定分帧协议有关。第一,20 ms 的 320 采样点要补 192 个零才到 512,超过 3 分之一输入是人工静音,可能把真实语音的概率压低,而 30 ms 只补 32 个零,接近模型期望输入。第二,40 ms 与 50 ms 把长帧切成 512 子块再平均概率,640 采样点的帧含一整块加一短剩余,剩余处理与平均本身可能模糊 Silero 原本尖锐的跳变。
第三,脚本只建一个实例且从不重置状态,状态跨帧、跨文件传递,补零会作为虚假静音进入状态,每个文件开头又带着上一个无关文件的尾部上下文。40 ms 的低 F1 高 AUC 正好支持校准偏移而非完全丧失排序。TEN 对照是原生接受跳长参数,无需填充与平均,但其 320 到 800 的扫描本身也在文档优化范围之外,稳定只是经验观察。要确认原因,需要 1 次只改一项的消融,包括按文件重置状态、用原生 512 流式迭代器馈送、再把块判决映射回参考帧。
在消融完成前,只能说协议很可能是主因,不能说模型本身不行。
这些结论在什么边界之外不再成立
首先这是离线批量打分,没有迟滞、平滑、最小时长与端点逻辑,不能推广到线上延迟、过早截断或拖尾收尾。其次只用 small 变体的 test-clean,没有 medium 与 large,没有 VOiCES 这类远场失配,也没有非英语与会话语音,TEN 在 LibriSpeech 系读语音上的优势可能含域内成分。标签来自干净语音强制对齐,会把词间短停顿标成静音,可能惩罚那些主动桥接短停顿的检测器。Silero 协议不是作者意图的用法,3 个成因都未消融,不能当成 Silero 本身不行。TEN 的窗扫描超出文档优化跳长,不能当成官方支持配置。
分层只做了 TEN,RMS 与 Silero 在巴伯尔下的行为未知。开发中只看前 10 个文件曾得到 TEN 约 0.48 到 0.49、RMS 约 0.58 的相反结论,原因是文件按条件分组、前几个恰是难例,这提醒小样本冒烟测试在生成数据集上容易误导。总体看,论文测的是特定数据、特定分帧、特定指标下的排序能力,换数据、换流式逻辑或换阈值都可能改变排序。
复现第一步要固定什么
复现的第一步是固定数据生成与分帧,而不是先调模型。按论文设置用上游脚本生成 LibriVAD-small,取 test-clean 的 2214 个文件,确认 16 kHz、每样本标签、九噪声族与六档信噪比,并核对 16 ms 下总帧数与语音先验是否接近 1608606 与 0.745。分帧用不重叠帧,窗长换算严格按采样率取整,指标用汇集全部帧的 AUC、AP 与 0.5 阈值 F1,并同时报告先验与全判语音的 0.854 参考线。检测器调用要照抄约束,TEN 传跳长参数,RMS 用同一能量映射,Silero 按短帧补零、长帧子块平均且不重置状态,才能复现出 Silero 的起伏。
若改成按文件重置或原生 512 流式输入,得到不同数字并不是否定原文,而是换了协议。版本方面,论文数据可用性段只给出 LibriVAD 的链接与包名占位符,ten_vad 与 silero-vad 的具体版本号在证据中以占位符出现,复现时应记录实际安装版本。数据集链接当前可用,另一个数据集镜像本次未能确认可达,这只说明来源可达性,不构成技术缺陷。
什么时候值得尝试,还缺哪项验证
当实时识别前端需要在 20 到 50 ms 之间灵活选帧,且只能做离线帧级排序时,TEN 是三者中更稳的默认选择,RMS 可作几乎零成本但弱得多的基线,Silero 若要用,必须先用原生 32 ms 流式协议重测,不宜直接套固定分帧结论。复现第一步是重建 LibriVAD-small test-clean 与不重叠分帧,并用 AUC 加先验作为主要读数。还缺的验证很明确,流式端点基准、Silero 原生协议与三项成因的逐项消融、RMS 与 Silero 的按条件分层、medium 与 large 变体以及非英语与远场数据,补上这些才能把离线排序结论推进到线上选型。
容易产生的误解是把 AP 0.83 或 F1 0.85 当成好,论文用高先验解释了为何它们虚高,也容易把 Silero 在 30 ms 的峰值当成模型偏好,原文已声明那更可能是协议产物。另一个误解是把 TEN 跨窗稳定当成官方保证,其实扫描区间已超出文档优化范围,只是经验上稳定,生产仍建议留在 256 采样点。
📎 论文与评分元数据
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses