📄 用脉冲网络做多通道语音增强:在边缘端如何兼顾空间信息与计算代价
英文题目:Spiking Neural Beamforming for Multichannel Speech Enhancement on the Edge
标签:#语音增强 | #波束成形 | #信号处理 | #麦克风阵列 | #端侧运行
评分:6.0/10 | 创新 1.1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Hanan Beit-On:School of Electrical and Computer Engineering, Ben-Gurion University of the Negev, Israel
- Eli Shapira:Neuromorphic Lab, Israel
- Boaz Rafaely:School of Electrical and Computer Engineering, Ben-Gurion University of the Negev, Israel
📌 核心摘要
本文处理的可穿戴与边缘设备多通道语音增强任务输入为六通道含混响混合语音,输出为参考麦克风处目标直接声,难点是在干扰说话人和混响下利用空间差异,同时把功耗和内存压到可部署水平。方法先把各通道短时傅里叶变换的实部虚部堆叠,并按每时频点最大幅度归一化再补充频率索引与幅度特征,形成逐时频点输入向量。该向量经脉冲编码进入脉冲网络,直接编码在各脉冲时刻重复同一特征,率编码按特征值做伯努利(Bernoulli)采样生成脉冲串,编码脉冲经线性变换转为电流驱动漏积分发放(Leaky Integrate-and-Fire,LIF)神经元累积与发放。网络末层脉冲串经时间平均与逻辑(logit)映射得到无界复数掩码,再乘到参考通道谱上恢复目标谱。与已有脉冲语音增强多为单通道或混合脉冲与人工神经网络(Artificial Neural Network,ANN)结构不同,本文坚持全脉冲与逐点序列编码,参数量降到37.0K量级。在固定H=256的6秒仿真混合测试中,直接编码N=50取得尺度不变信失真比(Scale-Invariant Signal-to-Distortion Ratio,SI-SDR)4.03 dB,高于同尺寸率编码N=100的1.21 dB,但有效乘加操作之外的脉冲突触操作更高,适用范围限于仿真阵列与固定方位条件。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
边缘可穿戴设备为什么需要多通道增强
刚进入音频方向时,先要分清单通道与多通道的区别。单通道增强只看一路录音的时频谱形态,靠语音与噪声在频率和时间上的不同来压噪;多通道增强同时看麦克风阵列录到的多路信号,还能利用声源到达不同麦克风的时间差和空间方向差异,在混响和多人同时说话时更有优势。论文面向的场景是助听、通信、会议和增强现实眼镜这类戴在身上或放在边缘的设备,它们对功耗和内存很敏感,大的循环网络或跨频跨时建模虽好,却不一定装得下。
脉冲神经网络被看作一条可能的低功耗路线:神经元只在膜电位越过阈值时发放二值事件,没有事件时下游计算可以跳过,形成稀疏的事件驱动计算。但此前可训练的脉冲增强大多只做单通道,没有用空间信息,有的还混用了脉冲与常规部件,或者用高维脉冲表示导致参数较多。本文要回答的就是能否用一个全脉冲、参数紧凑的结构,把阵列的空间多样性真正用起来,并讲清质量随尺寸和脉冲长度如何变化。
已有路线在输入、目标和运行阶段上有何不同
理解本文位置,需要按输入、目标和运行阶段对齐比较。经典多通道一侧,掩码波束形成、先估计掩码再算波束系数、全神经空间滤波和直接时频掩码都以多通道短时傅里叶变换为输入,以恢复参考通道目标语音为目标,区别主要在是否学习空间滤波以及是否利用跨频和时序依赖。单通道脉冲一侧,早期神经形态做法多是耳蜗滤波加侧抑制等手工听觉处理加固定网络动态,把声音转成脉冲后去噪,不做数据驱动的参数训练。
近期可训练脉冲增强开始学习网络参数,但仍限于单通道,且有的结构是脉冲加常规网络的混合,并非全程事件驱动。还有一类做法用高维脉冲表示而非按时间的脉冲序列展开,网络容易变大。本文与它们的相同点是都以抑制干扰和噪声为目标,不同点是输入明确为多麦克风复谱堆叠,网络全程脉冲化,并采用按时间展开的序列脉冲编码来压缩参数。
论文自述这是据其所知的首次用全脉冲网络做多通道增强的探索,这个限定很重要,它不是说脉冲网络整体首次用于语音,而是限定在全脉冲加多通道这个组合条件下。
输入是什么,要恢复什么,用什么衡量好坏
论文把问题写成加法模型。设阵列有 C 个麦克风,时域多通道观测向量是直接径目标语音向量与干扰加噪声向量之和,其中后者按原文定义还包含干扰说话人、背景噪声以及目标自身的混响。做增强时通常转到时频域,每个频率分格 k 和时间帧 l 都有对应的复向量关系,观测等于目标加干扰。学习目标是从多通道时域观测映射到参考麦克风处的目标语音估计,实际做法是在时频域估计复数掩码再乘回参考通道。
训练直接以负尺度不变信号失真比为损失,评价同时报告尺度不变信号失真比、语音质量感知评价和短时客观可懂度,数值越大表示失真越小、质量或可懂度越好。基线一侧,一个是已知真实导向矢量和干扰加噪声协方差的最小方差无失真响应,属于事后知道正确答案的参照,不能当作可部署方法的成绩;另两个是神经网络掩码基线,分别对应循环结构和全连接结构。下式是时域加法关系,它规定了目标、干扰与观测三者的对象划分。
\[\mathbf{x}[n]=\mathbf{s}[n]+\mathbf{v}[n].\]多通道语音增强 × 波束形成: 多通道语音增强指利用多个麦克风的录音恢复参考麦克风处的目标语音,直接径目标语音、干扰说话人、背景噪声与目标混响被分开建模;波束形成是其中一类空间滤波做法,本文的基线用已知导向矢量和干扰加噪声协方差的最小方差无失真响应实现,二者搭配的意义是给出只用空间统计量、不经学习的传统上限参照。
整体流程如何从多通道频谱得到复数掩码
方法可以沿着一个样本走一遍。输入是多通道短时傅里叶变换,把实部和虚部按通道堆成 2C 个通道,再按原文做法做逐时频格归一化并补两个归一化特征,得到每个格点维度为 2C 加 2 的向量。全连接人工网络基线对每个时频格独立处理,经过两个带修正线性单元的隐藏层和一个输出线性层,输出两个通道分别作为复数掩码的实部与虚部,再乘到参考麦克风谱上得到目标估计。
脉冲版本保持同样的全连接骨架和同样的按格独立处理,只是把修正线性单元换成漏积分发放神经元,并在首尾加上脉冲编码与脉冲解码。脉冲维度 N 是额外展开的时间轴,编码把连续特征变成长度为 N 的脉冲序列,网络在 N 个时刻上运行,最后把输出层脉冲按时间平均再经逻辑变换得到无界掩码估计。下式是掩码相乘关系,它说明网络并不直接输出波形,而是输出作用于参考通道的复增益。
\[\hat{S}[k,\ell]=M[k,\ell]X_{\mathrm{ref}}[k,\ell].\]下面先看结构总览,左侧为人工网络基线,右侧为脉冲实现,重点看右侧多出的编码解码环节和脉冲时刻维度的位置。该图是作者提供的官方原图,具有教学价值,值得对照正文逐块阅读。
看图路径: 1. 先沿左侧从输入特征到复数掩码的主路径数清线性层与激活的交替次数;2. 再看右侧在首尾各多出哪两个编解码阶段,以及脉冲时刻维度 N 出现在哪里;3. 对比左右两侧隐藏维度 H 与 H/2 的标注是否对应,确认脉冲版只是替换激活并扩展时间维
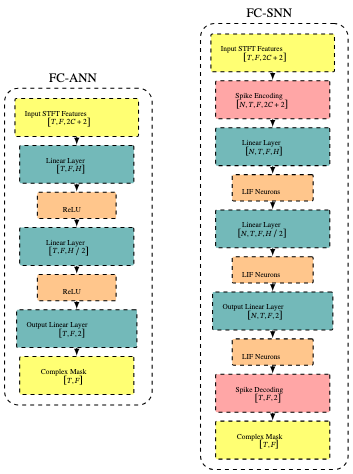
论文图 1。原论文 Fig. 1::“FC-ANN baseline architecture and its equivalent SNN implementation (FC-SNN).”。
从图中可见,左侧流程是输入特征经线性层、激活、线性层、激活、输出线性层到复数掩码;右侧在输入与首个线性层之间插入脉冲编码,在末端输出线性层之后依次接脉冲神经元、脉冲解码再到复数掩码,且右侧各中间张量都多出脉冲时刻维度 N。这意味着脉冲版没有引入跨帧或跨频的新依赖,它继承了基线按格独立的特点,空间信息仅来自同一格点内堆叠的多通道实虚部与附加归一化特征。
复数掩码 × 参考麦克风: 复数掩码指在每个时频格点上估计一个复数值,乘到参考麦克风的短时傅里叶变换上得到目标语音估计;参考麦克风指最终要恢复的那一路信号,掩码只乘这一路而不直接合成多路,搭配后网络输出只需两个实通道分别表示掩码实部与虚部。
两种脉冲编码各把连续特征变成什么
编码是连续值进入脉冲网络的第一道转换,两种方案的行为和代价不同。直接编码把每个归一化特征在全部 N 个时刻原样重复,输入不随时刻变化,因此首个线性层在每个时刻算出相同结果,按实现会重复计算 N 次,只有下游的漏积分发放层是脉冲驱动的。
率编码把每个归一化到零一范围的输入看作发放概率,每个时刻独立做伯努利采样得到 0 或 1 序列,这样包含首层在内的每一层都真正脉冲驱动,但引入了随机量化噪声,且通常需要长得多的脉冲串才能稳定表示幅值。原文要求输入先映射到零一区间,正是为了配合基于伯努利的率编码。下两式分别对应两种编码的生成规则,前者是常数重复,后者是按输入概率的随机脉冲串。
\[z[t]=x\hskip 9.24994pt\text{for all }t=1,\dots,N.\]\[z[t]\sim\mathrm{Bernoulli}(x),\hskip 9.24994ptt=1,\dots,N,\]打个比方,直接编码像把同一张讲义复印 N 份发给网络,内容稳定但首道工序做了重复功;率编码像按讲义重要程度随机抛硬币决定每时刻讲不讲,全程都是事件,但要听很多时刻才能拼出原意,这个比喻只帮助记住代价来源,不证明哪种更好。
直接编码 × 率编码: 直接编码指把同一归一化特征在全部脉冲时刻重复输入,首层线性计算密集但下游脉冲层仍事件驱动;率编码指按输入幅值做伯努利采样生成随机 0-1 脉冲串,使包含首层在内的每一层都真正脉冲驱动,代价是需要更长脉冲串并引入量化噪声,二者对比揭示性能与全脉冲计算之间的核心权衡。
漏积分发放神经元如何积分、发放与复位
网络中的脉冲神经元采用漏积分发放模型。每个神经元的输入电流由前一层输出经线性变换得到,对首个脉冲层而言就是编码后的脉冲输入;膜电位按泄漏因子对上一时刻电位衰减后再加上当前电流,没有输入时电位会逐渐衰减。当膜电位达到或超过阈值时输出 1,否则输出 0,发放后从膜电位中减去阈值实现复位。因为发放函数不可微,训练采用替代梯度,用可微近似让梯度通过,并借助脉冲工具包实现。
解码时把输出层在 N 个时刻的脉冲按时间平均,先裁剪到接近零一的区间内再经逻辑函数映射为无界估计,两个输出通道分别对应复数掩码的实部与虚部。下式是膜电位更新,它解释了泄漏与积分的分工,泄漏控制记忆衰减,电流控制新证据累积。
\[u[t]=\beta u[t-1]+I[t],\]需要提醒初学者,脉冲平均加逻辑映射只是本文把二值事件变回连续掩码的一种具体做法,平均长度 N 直接影响估计的粒度,N 太短则平均值只能取很少的离散档位,这也是率编码需要长脉冲串的原因之一。
漏积分发放神经元 × 替代梯度学习: 漏积分发放神经元指带泄漏的膜电位积分器,超过阈值发放二值脉冲并做复位,负责把连续电流转成稀疏事件;替代梯度学习指在反向时用可微函数近似不可微的发放阶跃,使含脉冲的网络仍能用梯度优化,二者搭配才让全脉冲结构可以按负尺度不变信号失真比目标端到端训练。
训练优化了什么,保留了哪些设置
训练部分按原文交代,目标是最小化负尺度不变信号失真比,验证损失最低的检查点被保留用于测试,所有模型都用自适应矩估计优化器、批量大小为 1、学习率为千分之一训练 250 个周期。这里没有冻结主干再微调的分阶段做法,也没有报告梯度是否截断或膜电位何时重置的额外细节,不能从模型名称猜测这些实现。
输入的短时傅里叶变换采用 512 点快速傅里叶变换、32 毫秒窗、16 毫秒跳,采样率为 16 千赫,训练、验证和测试混合数分别为 6000、1000 和 600 条,每条裁成从目标语音起始的固定 6 秒段,训练与验证每轮最多用 600 条。目标说话人固定在相对阵列零度方位,5 个干扰说话人分布在阵列周围,房间冲激响应用镜像源法生成,房间尺寸和混响时间按范围随机。
理解这些条件的意义在于,后文所有质量数字都只在该仿真分布下成立,换房间、换人数或换目标方向都需要重新验证,原文提到任意目标方向可通过目标方向条件化支持,但本次实验并未按此设置评估。
数据、基线与复杂度指标如何对齐比较
比较是否公平,关键看输入、目标、监督和运行阶段是否相同。数据侧,人工网络基线、脉冲网络与循环基线都在同一仿真多通道数据上训练与评价,目标都是参考通道的直接径语音,监督都来自负尺度不变信号失真比。基线侧,循环基线利用跨频率和跨时间的双向长短时记忆依赖,全连接基线与脉冲版都只做按格独立处理,因此后者的成绩低于前者并不意外,它反映的是结构表达能力的差异而非脉冲本身的全部代价。
复杂度侧,原文区分稠密计算的乘累加操作与真正脉冲驱动的突触操作,二者是不同硬件操作,不折算成同一能量数;直接编码首层按实现会计入随 N 线性增长的乘累加,但因输入重复,另给复用实现下的有效乘累加率,即把按实现的值除以 N。率编码下所有层都是脉冲驱动,没有乘累加,只有突触操作随 N 增长。评价指标方向是三者越高越好,参数量与每秒操作数越小表示越紧凑,但操作数不能跨类型直接比能量。
乘累加操作 × 脉冲驱动突触操作: 乘累加操作指稠密人工网络层中的常规乘加计算,脉冲驱动突触操作指仅在有输入脉冲到达时才发生的突触累加,原文明确二者是不同硬件操作,不能直接折算成同一能量数,搭配报告的意义是分别指示密集部分与事件驱动部分的复杂度,并对直接编码首层另给复用实现下的有效乘累加率。
模型变宽时质量与参数如何变化
第一个要回答的问题是隐藏宽度 H 变大是否持续带来提升。实验固定直接编码脉冲长度为 20、率编码为 100,对比不同 H 下的脉冲版与人工网络全连接基线及循环基线。下表比较的是同一仿真集上的模型尺寸扩展效果,公平条件是同为按格独立的全连接族内部对比再外加循环参照,指标方向为三者越高越好,同时列出参数量以显示代价。
| Architecture | Enc. | HH | Params | SI-SDR (dB) | PESQ | STOI |
|---|---|---|---|---|---|---|
| FC-SNN | direct | 64 | 3.1K | 2.79 | 1.538 | 0.797 |
| FC-SNN | direct | 128 | 10.3K | 3.14 | 1.550 | 0.805 |
| FC-SNN | direct | 256 | 37.0K | 3.42 | 1.607 | 0.813 |
| FC-SNN | rate | 64 | 3.1K | 0.78 | 1.408 | 0.763 |
| FC-SNN | rate | 128 | 10.3K | 1.07 | 1.426 | 0.769 |
| FC-SNN | rate | 256 | 37.0K | 1.21 | 1.425 | 0.774 |
| FC-ANN | – | 64 | 3.1K | 3.95 | 1.557 | 0.819 |
| FC-ANN | – | 128 | 10.3K | 4.80 | 1.626 | 0.836 |
| FC-ANN | – | 256 | 37.0K | 5.07 | 1.657 | 0.843 |
| FT-JNF | – | 64 | 81.5K | 6.67 | 1.843 | 0.879 |
| FT-JNF | – | 128 | 310.5K | 7.83 | 2.019 | 0.900 |
表中可见,全连接人工网络随 H 增大单调提升,从 64 宽的 3.95 分贝到 512 宽的 5.39 分贝;脉冲版提升幅度更平缓,直接编码在 256 宽取得 3.42 分贝,到 512 宽出现不收敛,率编码从 64 宽的 0.78 分贝缓慢爬到 512 宽的 1.28 分贝。循环基线在 128 宽达到 7.83 分贝、2.019 和 0.900,明显高于按格独立族,说明跨频时序建模在本任务仿真条件下带来主要增益。限制在于该结论依赖固定脉冲长度和固定目标方位的仿真分布,且直接编码在大宽度下存在训练不稳定个例,不能推广为脉冲一定随宽度单调变好。未胜出项也很清楚:同参数下脉冲版均低于对应人工网络,率编码在该表所有宽度下都明显落后于直接编码。
选定工作点与基线对比支持什么结论
综合尺寸与长度结果,论文为两种编码各选一个代表工作点进入基线对比:H 均为 256,直接编码取 N 为 50,率编码取 N 为 100,前者是所考虑配置中质量最好的一点,后者是在中等复杂度下实现全脉冲驱动的代表。下表回答选定脉冲工作点相对未处理混合、已知正确答案的最小方差无失真响应、循环基线和同骨架人工网络的位置,公平条件是同一仿真测试集与同一三指标,复杂度仍分类型报告。
| Method | SI-SDR (dB) | PESQ | STOI | Params | GMAC/s | Eff. GMAC/s | GSynOp/s |
|---|---|---|---|---|---|---|---|
| Unprocessed | -7.18 | 1.14 | 0.576 | – | – | – | – |
| MVDR (oracle) | 2.06 | 1.326 | 0.827 | – | – | – | – |
| FT-JNF | 7.83 | 2.019 | 0.900 | 310.5K | 4.95 | – | – |
| FC-ANN | 5.07 | 1.657 | 0.843 | 37.0K | 0.59 | – | – |
| FC-SNN (direct) | 4.03 | 1.629 | 0.826 | 37.0K | 2.89 | 0.058 | 3.37 |
| FC-SNN (rate) | 1.21 | 1.425 | 0.774 | 37.0K | – | – | 10.18 |
从完整原表可见,未处理为负 7.18 分贝,已知正确答案的波束形成为 2.06 分贝,循环基线为 7.83 分贝,同骨架人工网络为 5.07 分贝,直接编码脉冲为 4.03 分贝,率编码为 1.21 分贝。直接编码按实现为 2.89 吉乘累加每秒,高于人工网络的 0.59,但按复用计的有效值降到 0.058,约为人工网络的十分之一,另有 3.37 吉突触操作每秒;率编码无乘累加,突触操作为 10.18 吉每秒。参数量上脉冲与人工全连接同为 37.0 千,远小于循环基线的 310.5 千,也比原文提到的近期脉冲增强的 530 千至 1.4 百万小一个数量级以上。
支持的判断是紧凑全脉冲结构可以在多通道输入上取得超过已知正确答案波束形成和未处理的分数,但仍低于同骨架人工网络和循环基线;待验证的是有效乘累加依赖 1 次计算多次复用的实现假设,真实硬件能否兑现需要另测。
直接编码与率编码的差距有多大
为了把核心权衡讲得更具体,这里单独整理同宽度下两种编码的差距。下表只回答一个窄问题:在隐藏宽度为 128、直接编码脉冲长度 20 而率编码为 100 的条件下,率编码落后多少,代价是前者首层非全脉冲驱动而后者全脉冲驱动。表前说明比较的是编码方案差异而非模型大小差异,指标方向为差距越小表示两者越接近,表格数字全部来自原文连续句的逐字证据。
| 条件 | SI-SDR 差距 | PESQ 差距 | STOI 差距 | 比较对象 |
|---|---|---|---|---|
| H=128 | 2.07 dB | 0.124 | 0.036 | 率编码相对直接编码 |
在该条件下率编码在 3 个指标上分别落后 2.07 分贝、0.124 和 0.036,说明即使给率编码更长的 100 个时刻,它在该宽度下仍明显落后于只用 20 个时刻的直接编码。这支持论文的取舍建议:要原始质量优先选直接编码,要每一层都真正脉冲驱动则接受率编码的质量损失并拉长脉冲串。限制是该差距只在给定宽度和长度下测得,换宽度或把率编码拉到 200 时刻会缩小但原文显示仍未反超,且随机伯努利采样的方差未单独报告,不能把单点差距当作全配置的定量规律。
脉冲串变长时两种编码付出什么代价
第二个要回答的问题是脉冲长度 N 的影响,这是脉冲网络特有的代价维度。实验固定 H 为 256,分别拉长两种编码的 N 并同时报告质量与复杂度。下表比较的是同一模型宽度下脉冲长度的扩展效果,公平条件是编码方案内自比,指标方向仍是三者越高越好,复杂度分开列出有效乘累加与脉冲驱动突触操作以避免跨类型误比。
| NN | Enc. | SI-SDR (dB) | PESQ | STOI | GMAC/s | Eff. GMAC/s | GSynOp/s |
|---|---|---|---|---|---|---|---|
| 10 | direct | 2.89 | 1.544 | 0.800 | 0.577 | 0.058 | 0.685 |
| 20 | direct | 3.42 | 1.607 | 0.813 | 1.154 | 0.058 | 1.311 |
| 50 | direct | 4.03 | 1.629 | 0.826 | 2.886 | 0.058 | 3.373 |
| 10 | rate | -1.92 | 1.259 | 0.693 | – | – | 0.87 |
| 100 | rate | 1.21 | 1.425 | 0.774 | – | – | 10.18 |
| 200 | rate | 1.88 | 1.459 | 0.784 | – | – | 22.61 |
表中可见,直接编码从 N 为 10 的 2.89 分贝升到 N 为 50 的 4.03 分贝,有效乘累加恒为 0.058 吉操作每秒,因为按实现的值虽随 N 增长但复用后只算 1 次,而突触操作从 0.685 升到 3.373 吉操作每秒;率编码从 N 为 10 的负 1.92 分贝升到 N 为 200 的 1.88 分贝,突触操作从 0.87 升到 22.61 吉操作每秒,且全程无乘累加。关键对照是率编码用 200 个时刻的 1.88 分贝仍不及直接编码用 10 个时刻的 2.89 分贝,说明在本文按格独立结构和伯努利量化下,率编码需要约一个数量级以上的时刻才能接近直接编码的粗粒度表示。限制是操作数只是复杂度指示,不等于实测功耗和延迟,批量为 1 和仿真时序下的数值也不能直接推到流式边缘硬件的帧率。
这些结论在什么条件下才成立
初学者最容易夸大的是把仿真分数当成通用提升。本文证据只支持在特定仿真分布下的相对排序:半圆形 6 麦克风阵列、半径 8 厘米、目标固定零度、5 个干扰说话人、镜像源法房间、固定 6 秒段和给定短时傅里叶变换参数。目标方向固定意味着空间多样性来自固定几何,换方向、换阵形、换混响或真实录音都可能改变掩码难度和脉冲表示的稳定性。
按格独立结构不利用跨频和时序依赖,这是它参数少、易脉冲化的原因,也是它落后于循环基线的原因,不能把落后简单归因于脉冲。直接编码 512 宽不收敛提醒大脉冲网络仍有优化稳定性问题,率编码的随机性与长脉冲带来的延迟和操作增长是另一类代价。复杂度数字是按操作类型分别报告的指示量,没有折算能量,也没有测量误判率、延迟或真实芯片功耗,因此不能承诺功耗一定下降。
来源方面,本次未发现可验证的公开代码、模型或数据资源,不得声称作者已开源,这只是来源未确认,不是技术缺陷。
复现第一步做什么,需要补哪项验证
如果要复现,建议第一步先复刻数据与基线而非直接调脉冲。按原文用镜像源法生成半圆阵列多通道混合,固定目标方位与干扰人数,用相同快速傅里叶变换分帧得到堆叠实虚部输入,先训练全连接人工网络和循环掩码基线,确认尺度不变信号失真比、语音质量感知评价和短时客观可懂度的计算与聚合方式与原文一致,再把修正线性单元替换为漏积分发放神经元并接入两种编码与末端平均加逻辑映射。
关键超参数是隐藏宽度 H、脉冲长度 N、泄漏因子与阈值、替代梯度形状、学习率与训练轮数,原文明确给出了 H、N、优化器与轮数,泄漏与阈值的具体取值需回到代码或补充材料核对,缺哪项就记为缺哪项而不猜。需要补的验证至少包括更换房间与干扰配置的泛化、目标方向变化、流式因果性与真实延迟测量,以及在目标硬件上的操作数到功耗的标定,只有补了这些,才能判断直接编码的有效乘累加假设和率编码的长脉冲代价在边缘端是否可接受。
什么时候值得尝试这种全脉冲多通道方案
综合来看,当任务明确是多麦克风阵列的参考通道增强、设备对参数量敏感、且能接受按格独立带来的质量上限时,这种全连接脉冲结构值得作为紧凑候选尝试:直接编码适合把质量放在首位并允许首层复用实现,率编码适合必须全程脉冲驱动的神经形态硬件约束。它的价值不在于超过最强的循环基线,而在于用约一个数量级更少的参数和可讲清的脉冲长度代价,把空间信息引入全脉冲计算。
常见误解需要澄清:已知正确答案的波束形成分数不是可部署成绩,搜索选出的最优 N 也不是免代价的提升,更长的脉冲串同时意味着更多突触操作与潜在延迟;参数少不等于功耗一定低,没有硬件标定就不能下能量结论。回到研究生能复述的程度,记住输入是堆叠实虚部的多通道谱、输出是乘到参考通道的复数掩码、中间是两种编码加漏积分发放加时间平均的取舍,实验结论只在固定仿真条件下成立,这就抓住了本文的主干。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses