📄 给语音转写的耳朵补上非词语声音:54 类事件的时间戳检测
标签:#音频事件检测 | #数据增强 | #CNN | #Transformer | #强制对齐
评分:6.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
👥 作者与机构
- Ayush Kumar Bar:机构信息未在 arXiv HTML 中可靠披露
- Promila Ghosh:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
自动语音识别只输出词语,会丢掉呼吸、咳嗽、笑声及喇叭声、音乐、犬吠等信息,论文要每40ms输出54类事件概率,再转成带起止时间的事件并插入Whisper词语序列而不改词序。公开标签分散为单区域、自由文本标签、本体强标签、内嵌转录符号、孤立录音和环境录音,且发声事件短而与语音重叠、背景事件长而边界模糊。方法先用规则把7个来源映射到54类,对转录内嵌的8620处标注用连对时间分类强制对齐找回6360处时间,再用约168h真实标注录音与位置已知的合成混合窗加真实噪声增强联合训练,以5.8M参数卷积-Transformer输出概率。推理按8s窗、2s步长滑动平均概率,经中值滤波、迟滞门限和邻近合并得到事件,并按逐类阈值分为敏感与均衡两档。在4个数据集留出整段录音、至少10个事件的48类共9367个事件的事件级评测中,敏感档宏召回0.491高于均衡档的0.369,而宏精确率0.302低于均衡档的0.361。在同一事件级评测中,敏感档宏事件F1为0.32低于均衡档的0.33。训练在单块NVIDIA T4上每轮约1095s共训练10轮,检测在8线程中央处理器上约为39倍实时,不含解码与Whisper转录耗时,结论限于与调参数据重叠的留出集,未在标准基准和目标域验证。
🔗 开源与复现资源
代码相关资源:https://github.com/theboringai-work/surround-sound — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/theboringai-work/surround-sound — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
语音识别丢掉了什么信息
现代语音识别比如 Whisper 的输出是词序列,它的目标是把说的内容转成文字。可是录音里能听到的远不止词:说话人回答前的叹息、句子中间的笑、打断句子的咳嗽,以及背景里的喇叭、音乐、狗叫。这些声音对理解对话、做字幕、挑选富有表现力的语料、过滤训练数据都有用。论文把任务定义为声音事件检测,也就是不仅判断某类声音有没有出现,还要给出它从什么时候开始到什么时候结束。
输入是重采样到 16 千赫单声道的任意长度音频,输出是每 40 毫秒对 54 个类别的概率,类别包括 20 种说话人发出的声音和 34 种背景声音。举例来说,转写结果希望写成说话人声音用方括号内联插入,背景声音用尖括号包住受影响的词,例如咳嗽出现在两个词之间,喇叭声覆盖一段词。初学者容易误以为这就是在识别器词表里加几个新词,实际上识别器的词时间戳和事件检测的帧概率来自两个不同系统,后面需要专门的合并步骤把标签插进去而不打乱词序。
已有路线为什么不够直接用
声音事件检测已有成熟做法,通常用卷积提取时频特征再用序列模型建模时间关系,评价有用固定领的事件指标也有不用阈值的多复音检测分数。本文沿用了卷积加序列建模的思路,只是把循环层换成 Transformer 编码器,评价则用更宽松的重叠即算命中的事件标准。合成声景是该领域的常用补数据手段,例如用 Scaper 把孤立事件按已知时间混入背景,本文把背景换成语音,因为目标事件就发生在语音内部。
大规模音频标记方面,音频集本体、PANNs、BEATs、FSD50K、ESC-50 以及 Whisper-AT 等工作大多做整段标记,自监督语音模型能捕捉副语言信息,但本文为了保持小模型而直接从对数梅尔特征训练,没有用这类预训练骨干。非词语发声方面,笑声检测、NonverbalTTS、NonVerbalSpeech-38K、孤立录音集和 Vaani 噪声事件集各自标注了若干类型,但格式互不兼容。本文的贡献不是新网络结构,而是把这些来源统一成一个带时间戳的检测器并做了校准和评估。
声音事件检测 × 音频标记: 声音事件检测指给每一小段帧判断类别并进一步给出起止时间,音频标记只判断整段有没有某类声音不给时间;前者要解决边界和重叠,后者只做整段分类,本文需要把标签插到词与词之间,所以必须用前者输出时间戳,后者只能用来预训练或选模型,不能直接合进转写。
论文要解决的三个实际困难
第一个困难是标签碎且格式不统一。公开数据很少且分散:有的每段只给一个检测区域,有的是带时间的自由文本标签,有的是本体强标签,有的是嵌在转写里的符号没有时间,有的是整段单一声音或环境录音。第二个困难是事件与语音重叠。发声类事件短、常压在词上、声学上又像语音,背景类事件长、边界模糊。第 3 个困难是工作点。
一个全局阈值无法同时满足两种需求:无人值守转写要求误标签少到可以忽略,而作者早期使用中用户抱怨最多的是漏检。因此论文设置了每类两个阈值档,让用户按是否有人复核来选择。模型规模被限制在 5802790 个参数,约 27 兆,训练只用一块 T4 约 3 小时,推理要在中央处理器上远快于实时,这些都是为实用转写服务的约束。
系统从音频到富转写的总流程
训练侧把真实标注窗口、合成混合及其增强版本都变成 8 秒窗口和 40 毫秒帧目标,先算 64 频带的对数梅尔谱,再经卷积前端和 Transformer 得到 54 类概率,用帧级加片段级损失训练。推理侧把任意长度音频切成 8 秒窗口、2 秒跳步,重叠部分按帧平均概率,再经每类阈值、中值滤波、迟滞和拼接得到带起止时间的事件,最后与 Whisper 的词时间戳合并。
合并时说话人声音按起始时间插在对应词之前,背景声音在起始词前加开标签、在满足条件时于末词后加闭标签,相邻相同标签合并,且只在词之间插入所以不会改变识别器的词序。数据侧同时维护事件切片库、语音床、环境切片和噪声池,语音床和噪声池还用一个 31 类初步模型清理掉未标注的说话人声音,避免把呼吸声当成背景来学。
模型如何把 8 秒变成 201 乘 54 的概率
下面这张结构图值得对照着看,它把张量形状按发布模型实测标出,频率和时间如何被压缩一目了然。从左到右先是 128000 个采样点的波形,经 512 点傅里叶变换、25 毫秒窗、10 毫秒跳、50 到 8000 赫兹的 64 个梅尔带、对数压缩和归一化得到 64 乘 801 的谱。5 个卷积块每个含两次 3 乘 3 卷积加批归一化和激活,通道数为 48、48、96、96、192,其中后 4 个块的首卷积在频率或时间上降采样,最终频率从 64 降到 4,时间从 801 降到 201 步,每步对应 40 毫秒,每个输出步约依赖 0.33 秒音频。
之后把每步 192 乘 4 展平为 768 维,线性投影到 256 维并加上固定的正弦位置编码,再过六层预归一化 Transformer 编码器,每层八头自注意力和 1024 维前馈加丢弃率 0.1,最后线性加 Sigmoid 输出 201 乘 54。参数集中在编码器,每层 789760 个,六层占约 82%,卷积约占 15%,投影约占 3%,输出层不到 1%。
读图时先看主路径的形状收缩,再看下半部分从展平到概率的维度变化,注意步数始终是 201。
看图路径: 1. 先从左到右看 8 秒波形到对数梅尔再到五个卷积块的时间步数变化;2. 再看展平后 768 维如何经线性层变为 256 维并进入六层编码器;3. 最后看线性加 Sigmoid 如何输出 201 乘 54 的每 40 毫秒概率
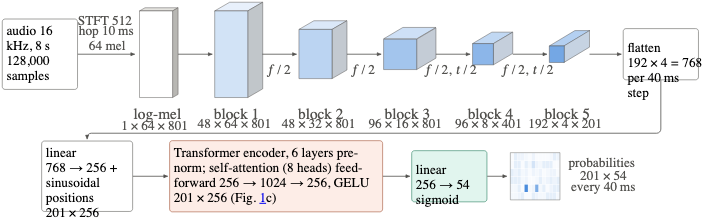
论文图 3。原论文 Figure 3::“Architecture, with tensor shapes measured on the released model.”。
这张图显示频率被逐步折半而时间只在后两块折半,说明模型保留了较密的时间分辨率以便把标签插到词间;Transformer 让每步能看到整个 8 秒窗口,这对区分电视声与带音乐的语音这类平稳背景很重要。图下半部分的概率面板是示意,实际推理还要经过阈值和后处理才能变成事件。
七个数据源如何统一成 54 类
分类体系最初列出 55 个事件,说话人声音包括呼吸、叹息、嗅、笑、咳嗽、清嗓、哭、喘、哈欠、打呼、喷嚏、擤鼻、咂嘴、呻吟、尖叫、耳语、喊叫、咀嚼、打嗝和点击,背景声音包括喇叭、车辆、警笛、鸟、虫、狗叫等。因为点击只有 47 个标注事件,低于每类至少 80 个事件的训练门槛而被去掉,剩下 54 类。
统一规则是按顺序正则匹配、首个命中生效:NonVerbalSpeech-38K 基本一对一映射,Vaani 的 319 种自由文本标签中 106892 次出现里 99320 次映射到类别、7502 次忽略、70 次丢弃且含丢弃标签的片段不用作真实窗口,AudioSet-Strong 的 455 个事件名中有 220 个被映射,其余语音和冲击声等不作为目标,NonverbalTTS 的 10 个表情符号映射到 9 类,孤立录音集文件夹名映射而磨牙等不用,家庭和环境录音则映射为电视、音乐、车辆、机器或仅作噪声池。
NonverbalTTS 本来只有符号在词间的位置没有时间,论文用 MMS 强制对齐模型在 CTC 发射上做维特比搜索先对齐词,再在前后词之间的停顿里按能量高于噪声基 4 分贝找最响的连续段,定位了 8620 个中的 6360 个,其中呼吸 4546 个、笑 879 个,其余为嗅、咳嗽等,这些时间戳未经人工核对且继承了符号位置本身的误差。
卷积前端 × Transformer 编码器: 卷积前端负责在时频谱图上压缩频率和时间并提取局部纹理,把 801 个 10 毫秒帧变成 201 个 40 毫秒步,Transformer 编码器负责让每个步看到整个 8 秒窗口的上下文;前者提供局部声纹,后者解决笑声呼吸与语音重叠时只看局部容易混淆的问题,组合后每个输出既有局部证据又有长上下文。
以下原表列出 7 个来源的规模、标签形式、留出方式和许可,比较时注意它们语言和场景差异很大,不能当成同一分布。
| Source | Size | Labels and use | Held-out part | License |
|---|---|---|---|---|
| NonVerbalSpeech-38K [39] | 38,718 clips, 130.6 h; 36,925 Mandarin, 1,793 English | one non-verbal event per clip with a detected region; event crops, speech beds, real windows | 10 % by stable hash (3,828 clips) | CC BY-NC 4.0 |
| Vaani noise events [1, 32, 29] | 90,637 clips, 154.6 h; 58 Indian languages + English, 162 districts | 319 free-text noise tags with start/end (11,111 verified, 61,642 unverified, 17,884 without timestamps); crops, real windows | 14 districts, verified clips only | CC BY 4.0 |
| NonverbalTTS [3] | 6,256 clips, 17.6 h, English (VoxCeleb, Expresso) | 8,620 sounds marked inside transcripts, no timestamps; forced alignment (Section 4.2); real windows, crops, speech beds | official dev + test (405 clips) | annotations CC BY-NC-SA 4.0; audio per source corpora |
| AudioSet-Strong [15, 8] | 93,609 10 s clips (79,564 train, 14,045 eval), 260 h | 455 event names with start/end (220 mapped); streamed subset; real windows, crops | official evaluation split | not stated on the mirror |
| OpenSLR 99 [7] | 727 clips, 410 speakers, 16 classes | isolated phone-recorded vocalizations; trimmed crops | 15 % of speakers | CC BY-NC-ND 4.0 |
| DNC [40] | 4,377 home recordings | noise type; ambient crops (TV/radio, music, cars, appliances) and a background-noise pool | 10 % of sessions | MIT |
| DEMAND [34] | 18 environments, 16 channels | environment; channels 1 and 9; ambient crops (transport, washing room) and noise pool | last 20 % of each recording | CC BY 4.0 (record text also states CC BY-SA 3.0) |
从表中可见中文广播剧、印度手机语音、英文访谈表演和网络视频音频被拼在一起,留出分别按哈希、地区、官方划分、说话人和会话划分,这决定了后文评估只能按标注来源分别计分,某来源没标注的类别在该来源既不算命中也不算误报。
训练样本、增强和损失如何构造
所有训练样本都是带帧精确标签的 8 秒窗口。合成混合取清理过的语音床铺满或裁成 8 秒并归一到参考均方根 0.05,以 0.10 概率不用语音床,以 0.85 概率放入 1 到 3 个事件,类别在类间均匀抽取以照顾稀有类,切片过长则随机裁,0.3 概率变速 0.9 到 1.1 倍,随机位置放入且语音与事件比在负 3 到 12 分贝、无语音时低 10 到 25 分贝,再整体缩放负 10 到正 6 分贝并加小噪声基。真实窗口把同一来源的真实片段从随机偏移开始拼接至 8 秒,每段电平浮动正负 6 分贝,接缝 10 毫秒淡化,标注平移且保留至少 50 毫秒。
增强每份存 1 次干净版再加一份或两份独立增强版,包括停顿插入、混响、电话带通加 μ 律编码、背景噪声和增益,噪声 40% 来自真实噪声池否则为多人混叠 babble、电源哼声或白粉棕噪声。训练时还对整批做时间循环移位并以 0.5 概率做频谱掩蔽。
\[\mathcal{L}=\frac{1}{TC}\sum_{t,c}\mathrm{BCE}_{w_{c}}\!\left(z_{t,c},y_{t,c}\right)\;+\;0.25\,\frac{1}{C}\sum_{c}\mathrm{BCE}\!\left(\max_{t}z_{t,c},\,\max_{t}y_{t,c}\right),\]上式第一项是逐帧加权二元交叉熵,正样本权重为负正帧比裁剪到 1 到 100,第二项是每类取时间最大值的片段级损失乘 0.25,帧目标向两侧各膨胀 1 帧。优化用 AdamW、权重衰减 0.01、梯度裁剪 5、OneCycle 峰值学习率 0.0003、10% 热身、批量 32、混合精度、10 轮,每轮 5343 步约 1095 秒,并从只在部分数据上训练的 31 类初步模型热启动除输出层外的全部权重。模型选择看固定验证窗口的帧平均精度在 4 个真实集和噪声集上的均值,合成集不参与选择。
合成混合 × 真实标注窗口: 合成混合指把干净语音床上按已知位置粘贴事件切片,位置天然准确且稀有类可被均匀采样,真实标注窗口指把同一来源的真实长片段拼成 8 秒并平移标注,保留自然混响和上下文;前者补数量和位置精度,后者补真实共现,论文把两类都做成 8 秒特征池一起训练。
下图左为训练损失持续下降,右为各验证集宏观平均精度的变化,竖线标出选中的第 6 轮,理解时注意损失下降不等于真实集继续变好。
看图路径: 1. 对比左图训练损失持续下降与右图选择分数在第 6 轮后走平;2. 区分合成集曲线最高但不参与选模型的说明;3. 观察 NonverbalTTS 在第 3 轮的下探与小验证集噪声的关系

论文图 6。原论文 Figure 6::“Training loss (a) and validation macro frame AP per held-out set (b).”。
右图显示 AudioSet-Strong 提升最大,Vaani 提升最小,NonverbalTTS 因只有 400 个窗口而在第 3 轮明显下探后回升,选择分数从第 0 轮 0.209 升到第 6 轮 0.287 后基本走平,说明再训练主要拟合固定训练池,发布模型即第 6 轮检查点。
评估在什么条件下测量什么
评估只用留出训练的真实录音,且每类只在标注它的来源上计分,例如在没有喇叭标注的来源里预测喇叭既不算对也不算错。报告分 3 层:固定验证窗口上的阈值无关帧平均精度,用于选模型;调阈值后的两折交叉验证帧 F1、F2、精度和召回,调一半测另一半再交换平均;整段留出片段经完整后处理得到的事件级召回、精度和 F1,同一类别时间上有重叠即算命中,不考核边界精度,比带领的事件指标更宽松。阈值从 0.05 到 0.975 步进 0.025 逐类搜索,平衡档最大化帧 F1,敏感档最大化帧 F2,正帧少于 25 帧或交叉验证 F1 低于 0.1 的类标为弱类并把阈值抬高或钳制,使其只在很确信时才触发。
\[\mathrm{AP}_{c}=\frac{1}{N^{+}_{c}}\sum_{k=1}^{N}\mathrm{Prec}_{c}(k)\,\mathbb{1}[y_{(k),c}=1],\]上式把各帧按概率降序排列,依次计算前 k 个的精度并只在第 k 帧为正时累加,再除以正帧数,验证目标同样膨胀 1 帧。需要强调的限制是选模型、调阈值和帧指标用的验证窗口与事件评估来自同一批留出片段,数值偏乐观;只做了 1 次训练无重复因而无置信区间;未运行标准基准;未标注的声音会被计成误报,对呼吸这类常漏标的类别尤其不利。
帧平均精度 × 事件召回率: 帧平均精度指把所有 40 毫秒帧按概率排序后正帧排在多靠前的阈值无关排序质量,事件召回率指整段推理后多少个标注事件被同类预测在时间上有重叠;前者用于选模型和调阈值之前的比较,后者回答用户最终能看到多少标签,二者方向都是越高越好但宽严不同,不能互相替代。
帧级别哪些类别排得准
下图按类显示帧平均精度条形和平衡档交叉验证 F1 圆点,弱类用浅色和标记区分,它回答的是排序能力而非最终标签多少。
看图路径: 1. 先看左侧说话人声音中叹息和打呼的深色条最高;2. 再看右侧音乐喇叭掌声的条形与圆点同时偏高;3. 注意浅色弱类的条形很短且圆点接近零

论文图 7。原论文 Figure 7::“Frame-level average precision (bars) and two-fold cross-validated F1 of the balanced profile (dots; thresholds tuned on the other half of the windows) per class, on real held-out…”。
图中可见音乐 0.884、叹息 0.725、喇叭 0.590、掌声 0.582、打呼 0.551 排在前面,宏观平均精度在全部 54 类上为 0.265,在 43 个非弱类上为 0.324。弱类共 11 个,包括电视声、风扇、脚步、哭、呻吟、咀嚼、门、哈欠、打嗝、擤鼻和敲击,其中敲击在验证窗中没有正帧,擤鼻只有 36 帧,电视和风扇虽有较多验证数据但分数仍低,论文未分析其混淆。圆点普遍低于条形,说明即使排序尚可,选定阈值后的 F1 仍受精度召回权衡限制。结合后文事件图看,帧上排得好的类别事件召回往往也高,但嗅、咳嗽等中等帧精度的类别事件表现分化,提示帧指标不能直接推断整段标签体验。
以下原表给出两档在 43 个可靠类上的交叉验证平均精度、召回和目标值,比较条件是同一模型同一验证窗只换阈值,指标方向都是越高越好。
| Profile | Precision | Recall | Objective |
|---|---|---|---|
| balanced | 0.352 | 0.414 | F1 = 0.351 |
| sensitive | 0.267 | 0.521 | F2 = 0.400 |
从敏感档到平衡档的移动是召回从 0.521 降到 0.414、精度从 0.267 升到 0.352,敏感档的 F2 为 0.400 而平衡档的 F1 为 0.351。这张表说明两档不是优劣之分而是工作点不同,能接受人工复核就用敏感档多找回,需要无人值守就用平衡档减少误标签,代价在表中已量化。
整段事件最终找到多少找错多少
下图按敏感召回排序显示至少 10 个留出事件的类别在整段上的召回和精度,括号内为留出事件数,蓝红分别对应两档,它回答的是用户实际看到的标签效果。
看图路径: 1. 在左图按敏感召回排序找到车辆叹息音乐排在最上;2. 在右图对比同一类蓝点与红点的精度左右移动;3. 注意底部打哈欠门等类别两档的召回都接近零

论文图 9。原论文 Figure 9::“Event-level recall (a) and precision (b) per class on whole held-out clips with the balanced and sensitive profiles; held-out event counts in parentheses.”。
图中车辆、叹息、音乐、枪声、铃声、呼吸、笑等排在上部,底部打哈欠、门、咀嚼、雨、玻璃碎等两档召回都接近零。敏感档在 48 类 9367 个事件上宏观召回 0.491、宏观精度 0.302、F1 为 0.322,加权召回 0.672,平衡档宏观召回 0.369、精度 0.361、F1 为 0.329,加权召回 0.533。说话人声音与背景声音的宏观召回相近但前者精度更高,敏感档下音乐 0.80、叹息 0.78、喇叭 0.74、笑 0.63、嗅 0.63、鸟 0.62、呼吸 0.61 为事件 F1 最好的组,26 个类别敏感档找回至少 1/2 事件。这些数字的适用条件必须记住:阈值调在与评估重叠的留出数据上所以绝对值偏乐观,且每类只在标注它的来源上计分,跨域表现未知。
以下 8 个按固定规则机械挑选的留出片段展示了平均数之外的典型行为,选择规则是每来源按存储顺序取满足时长和事件数的前两个片段,跳过另作详解的示例。
| Clip | Dur. | Annotated events | Detected (sensitive) | Found S | Found B |
|---|---|---|---|---|---|
| nv-1 | 6.9 | laugh 6.1–6.9 | cough 5.8–7.0, laugh 5.8–7.0 | 1/1 | 0/1 |
| nv-2 | 7.7 | cough 6.4–6.6 | throat_clear 5.9–7.3 | 0/1 | 0/1 |
| vaani-1 | 11.1 | breath 2.0–2.3, horn 3.8–8.2, breath 6.1–6.4, breath 8.6–8.9 | breath 0.0–2.5, horn 0.0–10.8, vehicle 0.0–10.8, breath 5.2–7.0, breath 7.8–9.5 | 4/4 | 4/4 |
| vaani-2 | 10.6 | dog_bark 0.9–1.5, breath 9.1–9.4 | fan 0.0–10.6, breath 4.8–6.3 | 0/2 | 0/2 |
| nvtts-1 | 7.5 | breath 0.1–0.3 | – | 0/1 | 0/1 |
| nvtts-2 | 4.2 | laugh 0.8–1.2 | laugh 0.5–1.8, breath 0.7–1.8 | 1/1 | 0/1 |
| audioset-1 | 10.0 | music 0.0–10.0, wind 1.1–1.5, music 3.0–4.5, music 4.7–6.3, music 8.9–9.6 | animal 0.0–10.0, vehicle 0.0–10.0, wind 0.0–10.0 | 1/5 | 0/5 |
| audioset-2 | 10.0 | vehicle 0.0–10.0, beep 0.0–0.9, beep 1.1–2.3, beep 2.4–3.9, beep 4.3–7.0, beep 7.2–8.1, beep 8.4–10.0 | siren 0.0–10.0, vehicle 0.0–10.0, burp 1.0–10.0, animal 8.0–10.0 | 1/7 | 0/7 |
表中敏感档在 8 段 22 个标注事件中找到 8 个,能全部找到某段的喇叭和呼吸,也能找到笑,但会漏掉短咳嗽、狗叫和呼吸,音乐整段漏检而只找到风,6 个短哔声一个没找到还附加警笛等误报。英文转写例子显示笑能被插入而呼吸漏检,识别器本身的词错误不修正。这说明长平稳背景易混淆、短促事件易低于阈值,平均指标好不等于每段都好。
换阈值档位带来什么代价
把同一模型的阈值从平衡换到敏感,可以看成 1 次不改变网络只改变工作点的对照。帧级别上可靠类的平均召回上升而精度下降,事件级别上宏观召回从 0.369 升到 0.491 而宏观精度从 0.361 降到 0.302,加权召回从 0.533 升到 0.672。代价是误标签明显增多,例如某段把整段判为风扇,某段在音乐下叠加电视声误报。论文没有做去掉某数据源、某增强或床清理的消融,也没有试预训练编码器、其他窗口长度或损失权重,因此各组件的单独贡献无法分离。
平衡档 × 敏感档: 平衡档指按帧 F1 选出的每类阈值,兼顾查准和查全适合无人值守转写,敏感档指按帧 F2 选出的阈值对召回加倍加权适合人工复核场景;同一模型只是阈值不同,前者误报少但漏检多,后者多找回事件但误标签明显增多,论文同时报告两档让用户按能否接受误标签来选。
以下按来源统计的全量标注事件数解释了为什么合成时要均匀采样, AudioSet 主导多数背景类而稀有说话人类也靠它补充,呼吸咳嗽笑叹息等靠中文和英文语料,咂嘴擤鼻靠印度语音,电视声靠家庭录音。
| Class | Type | NVS-38K | Vaani | NV-TTS | AudioSet | SLR99 | DNC | DEMAND | Total |
|---|---|---|---|---|---|---|---|---|---|
| breath | S | 2,162 | 35,663 | 6,121 | 27,232 | 44 | 0 | 0 | 71,222 |
| music | B | 0 | 6,872 | 0 | 51,454 | 0 | 229 | 0 | 58,555 |
| bird | B | 0 | 17,694 | 0 | 37,443 | 0 | 0 | 0 | 55,137 |
| vehicle | B | 0 | 4,854 | 0 | 25,450 | 0 | 692 | 4 | 31,000 |
| wind | B | 0 | 0 | 0 | 25,079 | 0 | 0 | 0 | 25,079 |
| laugh | S | 6,912 | 99 | 1,278 | 14,489 | 25 | 0 | 0 | 22,803 |
| horn | B | 0 | 15,739 | 0 | 3,794 | 0 | 0 | 0 | 19,533 |
| animal | B | 0 | 1,577 | 0 | 15,820 | 0 | 0 | 0 | 17,397 |
| child_voice | B | 0 | 3,165 | 0 | 11,447 | 0 | 0 | 0 | 14,612 |
| footsteps | B | 0 | 0 | 0 | 12,490 | 0 | 0 | 0 | 12,490 |
表中呼吸 71222、音乐 58555、鸟 55137、车辆 31000 等大类与打嗝 608、喷嚏 597、敲击 431、擤鼻 145 等小类相差悬殊,若按自然频率采样小类几乎学不到,这就是合成混合按类均匀抽取的原因。但均匀采样也带来与真实先验的偏离,部署时小类误报可能偏多,需要靠每类阈值和高阈值弱类来压制。
结论在什么边界内才成立
评估边界首先是数据重叠导致的乐观。选模型和调阈值用的验证窗口与事件评估来自同一批留出片段,论文明确说绝对值偏乐观,最有信息量的下一步是做一个目标域的仔细标注小测试集。其次是域覆盖窄。真实训练音频主要是中文广播剧喜剧、印度手机语音、英文访谈表演和网络视频音频,呼叫中心、会议、远场等域的准确率未知,平稳噪声会触发风扇误报。第三是弱类多。
11 个弱类中有的验证帧极少,有的有数据仍分数低,尚未分析混淆。第四是标注噪声。强制对齐的时间戳和未经核实的标签未经人工检查,继承了符号位置和能量找峰的误差。第五是单次运行、无标准基准、事件标准忽略边界精度,这些都限制了数字的可比性。许可方面 3 个训练来源限制非商业使用,权重以非商业条款发布,其他用途需去掉受限来源重训,孤立录音集虽只贡献约 138000 切片中的 591 个但仍在限制范围内。
复现第一步要准备什么
代码当前可在公开仓库获取,权重托管在模型仓库但本次曾不可达,是否可用要以实际可访问为准,不能把论文提到链接等同于已开源可运行。复现先按附录准备数据索引和内存映射音频库,再生成固定种子下的特征池和验证集,注意音频集需流式读取且只存选中片段。训练配置为 16 千赫单声道 8 秒窗、64 带对数梅尔、54 个 Sigmoid 每 40 毫秒输出、AdamW 加 OneCycle、10 轮,特征以半精度缓存以免中央处理器成为瓶颈。
推理用 8 秒窗 2 秒跳步重叠平均,每类中值滤波 5 帧、迟滞阈值 0.6 倍加拼接,说话人类 0.3 秒、背景类 1.0 秒内拼接,短于 0.15 秒丢弃。合转写时先去掉已被识别器转写为填充词或笑声词的事件,再按词起始时间单调化后插入标签。完全精确复现还缺一个未发布的 31 类初步检查点,它用于热启动和清理语音床与噪声池,现在仓库用发布模型代替且学习率逻辑依赖是否存在热启动,因此重跑流程相同但权重不会逐位一致。
178 秒音频在八线程中央处理器上约 4.6 秒、约 39 倍实时,图形处理器上约 0.47 秒,解码和加载及 Whisper 本身耗时另计。
什么时候值得尝试还缺什么验证
当任务是给已有转写补上笑声咳嗽呼吸和背景声以便做字幕、语料筛选或标注辅助,且有人能复核标签时,敏感档值得尝试;当需要无人值守直接入库时,平衡档更合适但要接受召回只有约三分之一宏观、约一半加权的现实。对音乐、叹息、喇叭、笑、呼吸、鸟等头部类别期望较高,对打哈欠、风扇、门、雨、咀嚼、蜂鸣、电视声等弱类不应直接依赖。
复现第一步是跑通推理库在留出样例上复现帧概率与事件,再按目标域采一小批仔细标注的数据重调每类阈值,而不是直接沿用论文阈值。还缺的验证是与评估完全分离的目标域测试集、多次训练的波动范围、标准基准上的对比,以及误报率、延迟和人工复核成本的测量。容易产生的误解是把加权召回 0.672 当成每类都找到三分之二,实际上它是事件数加权,宏观平均只有 0.491 且弱类接近零。
把阈值搜索的最优值当成部署可得的提升,实际上它是在重叠数据上事后选出的;把提到代码和权重当成可商用,实际上受限来源要求非商业使用,重训才能改变许可。
📎 论文与评分元数据
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses