📄 在 5 美元单片机上跑开放词汇英语识别:Oído 如何放下 13M 参数 Conformer
英文题目:Oído: Open-Vocabulary Speech Recognition on a $5 Microcontroller without a Neural Accelerator
标签:#语音识别 | #模型量化 | #端侧运行 | #流式处理
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.1/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
👥 作者与机构
- Daniel Varela Sánchez:机构信息未在 arXiv HTML 中可靠披露
- Guillermo Martín-Coello Juárez:Lokutor (Hashing Works, S.L.L.), Madrid, Spain
📌 核心摘要
开放词表识别要求把整段语音转写为任意文本,难点在于常用模型体积大、访存多,而目标芯片片内静态随机存取存储器小、闪存读取慢且没有加速器。输入的麦克风音频先经过语音活动检测切分语句,再提取对数梅尔特征并送入编码器与解码器,输出文本显示在屏幕或串口。编码器按语句一次处理全部帧,线性层采用逐输出通道对称整数量化并在运行时按帧计算激活缩放,注意力分数与加权求和也保持整数点积。执行时按帧块复用权重并分块累加长归约维度,解码可用贪婪连接时序分类、门控循环单元语言模型浅融合或传感器换能器头。与同芯片厂商识别器相比,本文整数量化系统在LibriSpeech test-clean集词错率为3.70%,而厂商报告为8.5%。推理开销在240MHz ESP32-S3单核上实测为音频时长的1.97倍,4秒语音约8.7秒后给出文本,慢于实时。部署上该13M参数整数量化模型占闪存14.0MB,另需语言模型1.3MB。结论适用于英语短语句和西班牙语模型,混响、多人babble噪声下错误明显上升。
🔗 开源与复现资源
第三方资源:https://github.com/lokutor-ai/oido — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/lokutor-ai — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
这篇论文要解决的输入输出是什么
输入是 16 kHz 麦克风采到的连续语音,输出是开放词汇的英文文本,不是只能选是或否的唤醒词。必须保留的信息是整句的声学细节和词序,因为注意力要看到整句才能达到训练时的精度。论文面对的设备是 ESP32-S3,240 MHz 双核、无神经加速器、片上 SRAM 只有 512 KB,另有 8 MB 的 PSRAM 和 16 MB 闪存,模型本身 13M 参数,int8 后约 14.0 MB,根本放不进片上内存。
已有路线分两支,一支是把音频送云端,长期付费且暴露隐私,另一支是在端侧只做固定命令词,厂商在该芯片上的方案也只接受预定义命令表。声学模型本身并不缺,10 到 15M 参数的 Conformer 在 LibriSpeech 上已能超过参数多两三倍的笔记本模型,难的是闪存经小缓存读取只有数十 MB 每秒,且现有单片机运行时面向小激活的静态图,不擅长处理整句注意力。
所以论文的问题可以复述为:在不加加速器、不重新训练声学主干的前提下,能否让整句 Conformer 在该存储层次上准确跑通,精度损失控制在 0.1 个点量级,速度先做到能用,实时性以后再追。后续所有量化、分块和解码设计都围绕闪存与 PSRAM 带宽展开,而不是单纯压缩参数量。
小模型、量化和单片机推理此前做到哪里
声学模型方面,Conformer 把自注意力与卷积结合,10.3M 参数版本用 RNN-T 解码可达 2.7%/6.3%,后续 Squeezeformer 和 Zipformer 改进计算与精度折中,Whisper tiny 和 Moonshine tiny 则面向笔记本和单板机。Oído 直接采用 NVIDIA 开放许可的 Conformer-CTC Small 及其 Transducer 对应结构,复现后特征误差在 2×10⁻⁵ 以内,帧级取最大标签与参考实现完全一致,这决定了精度起点是现成的英文模型。
量化方面,已有工作在加速器或手机 CPU 上用 4 比特甚至 2 比特量化感知训练保持精度,Oído 的不同点是主打训练后 int8 加按帧激活缩放,对该结构几乎无损,只有 int4 才用 8000 步量化感知微调。单片机方面,TensorFlow Lite Micro 和 MLPerf Tiny 把关键词、视觉唤醒词做到数十到数百 KB,语音识别此前要么需要 Cortex-M 加 Ethos 加速器,要么厂商数值为 8.5%/21.3% 且部署时按固定命令解码。
公平比较要注意输入目标和运行阶段相同:论文把笔记本基线统一到相同切分和文本归一化,有些已发表数字因此变化;厂商数字是引用发表值,评估协议未详细说明;部分基线可能在训练中见过所谓留出集的语句,论文明确提醒这一点,不能把跨域差距简单理解为同条件胜负。
为什么大模型在单片机上难跑
第一个难是放不下。int8 模型约 14 MB,片上 SRAM 完全装不下,PSRAM 也要留工作缓冲只能放部分最热矩阵,剩下只能放闪存并映射到地址空间,但四线 SPI 闪存持续流式读取只有 30 到 40 MB 每秒量级,每帧都重读权重就会被带宽卡住。第二个难是整句注意力要看完全部帧, utterance 最长 20 秒,中间激活和键值若全放片外会反复搬运。
第三个难是计算形态杂。除了矩阵乘,还有层归一化、SiLU 门控、深度卷积、相对位置注意力,直接用通用浮点会很慢,需要用上 128 位 SIMD 的点积指令,并把累加保持 int32 精确、缩放和偏置留在浮点。论文把问题拆成 3 段:前端对数梅尔与两次卷积下采样到 25 Hz,中间 16 个 Conformer 块,尾部 CTC 或 RNN-T 加可选语言模型,每段的访存与并行方式不同。
举个教学例子:一段 4 秒语音按 10 毫秒跳帧约 400 帧,下采样后约 100 帧,若每帧都从闪存读一遍 14 MB 权重,流量巨大;若按 64 帧一块复用权重,权重流量就被摊薄。这就是后文 64 帧分块、K 切分和前端拼帧的直观动机,例子只说明复用思想,不代表论文实测的逐帧流量。
Oído 整体流程与内存放在哪里
固件先用 I2S 麦克风采音进 8 秒 PSRAM 环形缓冲,慢速自动增益加能量语音活动检测切出每句,最长 20 秒,0.8 秒静音结束一句,边采边转上一句。特征是 80 维对数梅尔,25 毫秒窗、10 毫秒跳,前端两次 3×3 卷积步长 2 下采样,编码器是 16 个 Conformer 块,维度 176、前馈 704、4 头相对位置注意力、31 抽头深度卷积,最后接 1024 个 SentencePiece 加空白符的 CTC 或传感器头。
下面这张官方流程图值得先读,它把数据路径和 3 级存储对应起来,读图时注意权重只在每块读 1 次、当前块激活留在片上的设计。
看图路径: 1. 从左侧麦克风经前端到编码器再到解码器的主数据路径;2. 闪存、PSRAM 和片上 SRAM 三处分别放模型、热权重与当前块激活;3. 一次处理 64 帧和前端一次拼 3 帧的标注位置
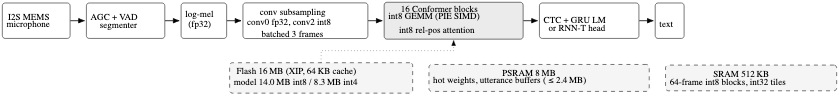
论文图 1。原论文 Figure 1::“Oído on the ESP32-S3: pipeline and memory placement.”。
图 1 显示麦克风经自动增益与切分、特征、卷积下采样、Conformer 块、解码到文本的主路径,下方三栏分别标注闪存放 14.0 MB 或 8.3 MB 模型、PSRAM 放热权重与至多 2.4 MB utterance 缓冲、SRAM 放 64 帧 int8 块与 int32 累加块。权重按 64 帧块从闪存或 PSRAM 流式读 1 次,位置编码表量化为 int8 全局共享,注意力输出复用卷积模块缓冲,前端行边产生边量化。实测 PSRAM 峰值 15 秒约 1.9 MB、20 秒约 2.4 MB,板上至少留 125 KB 片上内存给系统其余部分。
按帧动态 int8 与整数注意力怎么做
线性层权重用对称 int8、每个输出通道一个系数,激活在每次矩阵乘前按帧现算系数,取该帧绝对值最大值除以 127。累加用 int32 精确完成,再乘回两个系数加偏置,偏置与重缩放用浮点。按帧而不是按张量用一个静态系数,原因是语音帧与静音帧幅度差很大,静态系数会浪费安静帧的精度。
整句识别 × 关键词唤醒: 整句识别指对一整段语音输出任意词汇的文本,关键词唤醒只判断固定几个词是否出现;前者需要声学编码器加词表很大的解码器,后者用小分类器即可,Oído 属于前者,所以必须解决大模型放不进片上内存和整句注意力要看完全部帧的问题。
激活缩放的具体计算是论文给出的关键公式,符号含义是先读输入再定系数,目标是把每帧动态范围映射到 127 级。
\[\displaystyle x_{q}=\mathrm{round}(x/s_{x}),\qquad s_{x}=\tfrac{1}{127}\max_{k}|x_{k}|,\]上式中 xq 是量化后整数,sx 是该帧系数,k 遍历该帧通道。注意力也是整数:内容项与位置项各算 1 次 int8 点积,查询加偏置向量后与键和投影位置分别点积,键值与投影位置都按每帧每头给系数,减行最大值后把 softmax 分子乘上值的每帧系数再相对行最大值量化,值矩阵转置存为 int8,使分数与加权求和都是 SIMD 点积,分母归一化每输出做 1 次。层归一化、SiLU、门控和折叠批归一化的深度卷积跑浮点,第一层单通道卷积留浮点,第二层经 im2col 按块给系数,非负输入的最大值由前一层边写边统计,量化融合进收集过程而不另跑一遍。
按输出通道量化 × 按帧动态量化: 按输出通道量化是权重每一行用自己的缩放系数,按帧动态量化是激活每一帧在运行时现算缩放系数;两者搭配让权重适应不同卷积核幅度、激活适应语音帧与静音帧幅度差异很大,组合后线性层可以直接做 int8 点积再乘回两个系数加偏置。
核层面归约长度不超过 256 多用 x 驻留核,把激活行分块留寄存器、权重流经乘累指令的装载槽,稳态每指令 16 次乘累,704 用行流核,更长用 K 切分核,int4 用掩码解包加广播标量外积,softmax 用步长 1/64 的指数查找表,最坏相对误差 0.8% 小于 int8 概率步长。
分块调度与两种解码头如何省访存
每层按 64 帧一块处理,权重行每块读 1 次、块内 64 帧复用,当前块 int8 激活留在 SRAM。长归约层若从 PSRAM 读激活,朴素行流核要缩小块以驻留缓存,会倍增权重读取,论文把 K 切成至多 512 并在 SRAM 累加 16 输出乘 64 帧的 int32 部分和,保证每权重字节每块只取 1 次。前端卷积每输出帧产生 20 个补丁行,论文 1 次拼 3 帧做矩阵乘。用权重字节数乘每秒音频读取次数的简单流量模型,权重流量从约 18 MB/s 降到 7.5 MB/s,约 2.4 倍,指令数增加 2.9%。
CTC 贪心直接取每帧最大,带语言模型时用束宽 4、每帧取前 6 词元的前缀束搜索加浅融合,权重 0.3 加词元奖励 0.5,在开发集调好。语言模型是嵌入 192、隐层 384 的 GRU,1.3M 参数,权重按行 int8,与声学共享 1024 词表,公开发布版只用 LibriSpeech 书语料训练,另一版加了训练语料转写因共享条款不发布,存活束的语言模型步每帧拼成 1 次矩阵乘。
传感器头编码器相同,另加 320 单元预测网络和 1025×320 输出矩阵约 328 KB。朴素贪心每帧至少读 1 次该矩阵即每秒 25 次,论文 1 次看至多 8 帧,用当前预测状态批量算联合网络,首个非空帧之后的行丢弃并用更新状态重算,每行算术不变故与逐帧贪心完全等价,在全部测试集上词错误、替换删除插入完全相同,读矩阵次数降为每 8 个空帧 1 次。
流式微调与西班牙模型实际训练了什么
本研究没有从零训练英文声学主干,英文主干是 NVIDIA 现成权重,int8 无需重训,int4 做了 8000 步 4 比特量化感知微调,其中 Conformer 块线性层用按通道 int4,前端、输出头和位置投影留 int8,激活与注意力保持 int8。训练语料为公开的 Common Voice、VoxPopuli、LibriSpeech、MLS、AMI、VCTK、转写再生的人声语料和两个小口音库。
分块执行 × K 切分累加: 分块执行指一次只处理 64 帧并把权重读一次复用 64 次,K 切分累加指把很长的归约维度切成至多 512 的小段、在片上暂存 int32 部分和;前者省闪存带宽,后者让长归约层也能一次读一次权重,两者组合把权重流量从约 18 MB/s 降到 7.5 MB/s,代价是指令数增加约 2.9%。
流式能力来自对同一网络的分块微调:1 帧只看本块与左侧上下文内之前块,块大小每批抽 8 到 32 帧、左上下文抽至 256 帧到无限、0.3 概率用全上下文,使一个模型兼顾两种模式;31 抽头深度卷积只看过去和本块内未来而不改因果位移,以保留预训练核;用全局梅尔均值代替整句统计并加随机增益,再加 MUSAN 噪声音乐人声与仿真房间脉冲。
引擎每 C 帧推进全部层,缓存各层最近块的 int8 键、键系数与转置值、最近 15 个卷积输入和有界相对偏移的位置投影,C 为 32、左上下文 128 时缓存约 2 MB,转写与音频切分方式无关。分块使权重重读 64/C 倍,32 时 2 倍、16 时 4 倍。西班牙模型换 1024 词表并重初始化 CTC 头,从英文权重全网微调 2492 小时,含未验证语音的过滤用法,语言模型用书加句子与转写训练并剔除开发测试句,无需改引擎。
在哪些数据与板上条件下测量
精度用 LibriSpeech 完整测试集,干净 2620 句、其他 2939 句,另加留出集 Common Voice1500 句、VoxPopuli1200 句、AMI 头戴麦 1000 句、自带噪声参考的人声语料 1000 句和 Earnings-22 的 4179 段。笔记本基线在每集至多 500 句均匀子集上跑,统一切分与小写去标点去填充归一化,因此部分数字与原作者发表值不同,Moonshine 在 Earnings-22 上差异最明显。部分基线训练可能见过留出语句,论文已声明。
鲁棒性用 300 句干净语音混 DEMAND 真实噪声,汽车厨房客厅食堂在 10 和 5 dB 信噪比,加 4 人 babble,再卷积仿真房间脉冲,房间 5×4×3 米、距离 2 米、混响 0.4 和 0.8 秒,以及 0.6 秒混响加厨房噪声的远场组合。速度在 ESP32-S3 模组开发板上测,240 MHz、四线闪存、80 MHz 八线 PSRAM、单核,音频存闪存逐个转写,用 64 位微秒计时,实时率为计算时间除音频时长,含语言模型束搜索不含采集;另用指令计数仿真得精确指令数并做功能对照。准确率数字来自主机编译的同 int8 算术,板上与仿真转写在测试的 27 段上完全一致,主机因数学库末位舍入在难句上偶有单字差异。
LibriSpeech 精度与量化损失有多大
要回答的核心问题是训练后 int8 是否几乎无损,以及小语言模型和传感器头各带来多少。比较条件是同一引擎、同一归一化,指标是词错误率越低越好。下表整理论文摘要连续原句中的关键数字,单位与精度保留原文写法,完整来源见表后绑定。
| 条件 | 指标 | 芯片 int8 贪心 | 加 1.3M 语言模型 | 传感器头 | int4 版本大小 |
|---|---|---|---|---|---|
| test-clean/test-other | 词错误率 | 3.70%/8.23% | 3.33%/7.15% | 2.99%/6.67% | 8.3 MB |
上表说明芯片算术在干净与其他集为 3.70% 与 8.23%,比全精度参考 3.68% 与 8.11% 只高 0.02 和 0.12 个百分点,加语言模型降到 3.33% 与 7.15%,传感器头到 2.99% 与 6.67%,与 NVIDIA 全精度发表的 2.9% 与 6.6% 相当。int4 训练后量化曾恶化到 14.1% 与 22.0%,经量化感知微调后贪心为 4.61% 与 9.98%,加语言模型为 3.78% 与 8.43%,模型文件 8.3 MB,加语言模型 9.6 MB,16 MB 模组可留约 6 MB 给应用。论文称干净集上各芯片配置比厂商 2.7 MB 方案的 8.5% 与 21.3% 少 1.8 到 2.8 倍错误,且 int8 配置少于笔记本全精度 Whisper tiny.en 的 6.26% 与 15.93% 和 Moonshine tiny 的 5.00% 与 12.13%。限制是笔记本行为子集评估、厂商为引用值,且精度数来自主机编译,板上难句偶有单字出入。
换领域后小芯片模型还准吗
跨域要看同一引擎在未训练过的口音会议 earnings 上的表现,基线同为全精度笔记本模型。下表选择原表 3 的表头与部分行列,列数不少于 5 列,比较问题是领域变化后谁更稳。
| System | CV | Vox | AMI | PS | E22 |
|---|---|---|---|---|---|
| int8, greedy | 11.4 | 9.3 | 20.2 | 11.6 | 22.4 |
| int8 + LM (books) | 10.4 | 9.2 | 20.4 | 12.2 | 21.6 |
| Moonshine tiny | 17.5 | 13.4 | 24.2 | 8.1 | 32.4 |
| Vosk small | 27.1 | 20.6 | 34.1 | 12.9 | 38.0 |
表 2 显示芯片 int8 贪心在 Common Voice 为 11.4%、VoxPopuli 为 9.3%、AMI 为 20.2%、人声为 11.6%、Earnings-22 为 22.4%,加书语言模型后多为 10.4%、9.2%、20.4%、12.2%、21.6%,再加转写训练的语言模型进一步到 10.1%、9.0%、19.0%、11.0%、20.8%,传感器为 9.6%、8.2%、19.2%、11.6%、21.0%。笔记本 Whisper tiny.en 对应为 19.7%、13.5%、21.5%、14.3%、20.3%,Moonshine 为 17.5%、13.4%、24.2%、8.1%、32.4%。可见除 Earnings-22 上 Whisper 略好、带噪声参考的人声上 Moonshine 较好外,芯片模型在其余多域更少错误。代价是书语言模型在 AMI 与人声上反而略逊于贪心,说明语言模型领域很重要,会话产品应用会话文本训练。限制是留出集可能被基线见过,且人声参考本身噪声大。
下图解释指令热点在哪里,先看最长的矩阵乘法条,再看注意力与量化等小条的数量级。
看图路径: 1. 横条最长的矩阵乘法与注意力各占多少 M 指令每秒;2. 激活量化、卷积前端和对数梅尔特征等小阶段的数量级;3. 对比表 8 的每指令周期数,区分指令多与单指令慢
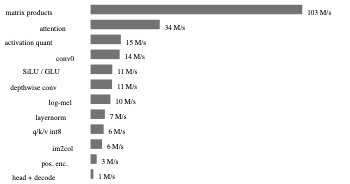
论文图 3。原论文 Figure 3::“Executed instructions per second of audio, by stage, for the int8 CTC model (both cores, exact counts from instruction-counting emulation).”。
图 3 是每秒音频的指令数按阶段分解,矩阵乘法约 103M 每秒、注意力约 34M 每秒,激活量化约 15M、前卷积约 14M,硅发光门控与深度卷积等各约 10M 量级,2 核合计每秒约 220M 指令,其中矩阵乘占 46%、注意力占 15%。这说明单核瓶颈在指令发射而非某一访存阶段,结合后文每指令约 2 周期,才能理解为何省带宽的切分在单核上看不到加速。
噪声混响下错误上升多少
鲁棒性比较用 300 句干净语音加噪与加混响,指标仍是词错误率越低越好,条件包括真实房间噪声、人声 babble 与仿真混响。下表选择原表 4 的表头与代表行,保留 6 列以同时看到芯片与笔记本基线。
| Condition | T | C | M | W | V |
|---|---|---|---|---|---|
| Clean | 2.5 | 3.5 | 4.3 | 5.6 | 9.1 |
| Cafeteria, 5 dB | 7.2 | 9.5 | 12.2 | 12.3 | 24.7 |
| Babble, 5 dB | 25.9 | 27.6 | 37.3 | 35.9 | 70.9 |
| Far-field kitchen | 10.4 | 13.5 | 24.3 | 19.8 | 30.4 |
| Mean (14 conditions) | 6.7 | 8.4 | 12.2 | 12.1 | 21.7 |
表 3 中干净时传感器 2.5%、CTC 贪心 3.5%、加语言模型 3.3%,笔记本 Moonshine4.3%、Whisper5.6%。汽车 5 dB 时芯片仅升 0.2 到 0.3 个点,厨房客厅 5 dB 升 1 到 2 个点,食堂 5 dB 升 4.7 到 6.0 个点,10 dB babble 到 8.4% 到 10.9%,5 dB babble 到 24.7% 到 27.6%,0.8 秒混响到 12.4% 到 16.0%,远场厨房到 10.4% 到 13.5%。14 条件平均传感器 6.7%、CTC8.4%、加语言模型 7.5%,比笔记本约 12.1% 到 12.2% 少 31% 到 45% 错误。未胜出项是强 babble、强混响与远场依然很难,论文直言此时麦克风阵列波束成形比换识别器更重要。限制是仅 300 句、仿真房间单一几何,且平均值把难易条件等权平均,不能理解为真实分布期望。
CTC 贪心解码 × 带语言模型的束搜索: CTC 贪心解码是每帧取概率最大的词元再去重,带语言模型的束搜索是保留多个前缀假设并用循环神经网络语言模型加权;前者最快但只用声学信息,后者用文本先验纠正声学混淆,组合后 LibriSpeech 错误相对降低 10-13%,但每帧要为存活束批量跑一次语言模型矩阵乘法。
西班牙语方面,同一切分归一化下加语言模型在 4 个子集为 13.3%、10.6%、15.5%、11.3%,贪心为 20.3%、14.2%、20.0%、16.9%,流式 32 加语言模型为 15.2%、12.1%、16.3%、12.8%,多语言 Whisper tiny 为 33.0%、21.5%、28.7%、17.1%,少 34% 到 60% 错误。但比较偏向 Oído 因其在这些语料训练划分上训练而 Whisper 零样本,且无西班牙噪声基准,完整 60 小时测试集加语言模型为 13.75%、10.90%、15.68%、11.32%。
速度内存与每项优化各省多少
速度问题是单核实时率与指令分布,内存问题是闪存与 PSRAM 峰值。比较条件为 240 MHz 单核实测,实时率是计算除音频,越小越快。下表选择原表 8 的表头与代表阶段,说明时间花在哪里。
| Stage | Minstr/s | Mcyc/s | cyc/instr |
|---|---|---|---|
| matrix products | 103 | 216 | 2.09 |
| attention | 34 | 44 | 1.30 |
| head + beam search with LM | 21 | 40 | 1.90 |
表 4 按每秒音频计,矩阵乘 103M 指令对应 216M 周期约 2.09 周期每指令,注意力 34M 对应 44M 约 1.30,im2col 收集 6M 对应 20M 约 3.66 最高,其余多在 1.3 到 2.4 之间。板上每秒音频花 461M 周期,平均约 2.0 周期每指令,说明各阶段均匀受指令发射限制而非卡在某一访存,束搜索占周期 8.7%。实测 CTC int8 加语言模型实时率 1.97,范围 1.91 到 2.02,int4 为 1.76,传感器无语言模型 1.89,西班牙 2.06,流式 32 为 1.96 略快于同模型整句 2.04,因单核时权重带宽还不是瓶颈。
指令优化累计省 8.9%,其中合并注意力打分省 1.9%、x 驻留核省 2.5%、融合 im2col 量化省 3.0%、查找表 softmax 省 3.2%,而 K 切分加前端拼帧故意增加 2.9% 指令以换 2.4 倍带宽,指令计数仿真看不到收益且论文未在无切分构建上实测硅片。闪存 int8 占 14.0 MB、int4 占 8.3 MB、传感器 15.5 MB 加语言模型 1.3 MB,20 秒峰值 PSRAM2.4 MB 来自仿真,板上片内至少剩 125 KB,流式缓存时剩 72 KB。延迟上 3.6 到 3.8 秒命令在整句模式约 6.9 到 7.4 秒见文,流式约 4.1 到 4.2 秒,均不含 0.8 秒尾音等待,4 秒命令整句约 8.7 秒、流式约 5 秒,均非会话级。
双核为何不准与还有哪些限制
双核在仿真中正确且指令数预示实时率 0.7 到 0.95,但板上 240 MHz 转写错误有时崩溃。对 3.8 秒音频逐层哈希 3 次,单核 166 个哈希每次都与仿真相符,双核随机在第一或第二层、几乎总在第一层前馈块先错,约八分之一崩出非法指令异常与坏回溯,指向取指或取数损坏而非逻辑错。160 MHz 双核正确但不比 240 MHz 单核快,只并行矩阵乘会错,只并行其余部分正确,其中 704 归约的前馈第二线性层最易错。
论文试过降 PSRAM 速度、换缓存行、换权重位置、自旋与信号量、屏蔽中断、换分块与指令放 IRAM 均未消除,另一文本转语音引擎同形状双核压力约 21 分钟无错,故不像本板单纯电源问题,更像该核、启动合并或锁步流式外部权重的特有问题,原因未知。即使修好,错误自旋构建仅为单核 0.78 倍而非指令数预示的 0.55 倍,因双核争内存。
其他限制是单板小样本,CTC int8 仅 27 段、其余 10 到 12 段且最长 10.6 秒,20 秒峰值来自仿真;精度来自主机,板上与仿真一致但主机在 27 段中 5 段差一词,西班牙 12 段中板上 9.3% 对主机 7.3% 差异更显;仅英西两语,新语种需新词表与微调;传感器权重按 NVIDIA 条款不随发布;未与同模型 TensorFlow Lite Micro 或 ESP-DL 部署对比;笔记本基线为子集、厂商为引用值。
复现第一步做什么与资源如何获取
先按论文第 5.6 节搭整句链路:主机编译同 C 代码并关浮点收缩,对比仿真与板上转写,再跑 LibriSpeech 子集核对 3.70% 量级,关键超参与信息条件要保留,即 80 维对数梅尔、25 毫秒窗 10 毫秒跳、25 Hz 帧率、64 帧块、束宽 4 取前 6、融合权重 0.3 加词元奖励 0.5、GRU 嵌入 192 隐层 384、最长 20 秒。板上用 ESP-IDF5.5.1、240 MHz、四线闪存、80 MHz 八线 PSRAM、单核计时,用 64 位微秒计时而不用 32 位周期计数以免 17.9 秒回绕。
代码模型与板测数据的获取要分三件事说:论文正文写引擎固件工具模型已开源并给出地址,但本次只收到第三方镜像可达性证据,不能写作者资源当前可用或已公开,Hugging Face 链接本次未能确认可达,不代表技术缺陷;传感器权重按 NVIDIA 条款不随发布;int8 与西班牙为 CC-BY-4.0、int4 与流式为 CC-BY-SA-4.0,代码为 GPLv3。复现时先验证主机与仿真逐层比特一致,再上板测实时率与延迟,西班牙需另训词表与语言模型。
还需补的验证是更长 20 秒与更多板子的实时率分布、远场真实房间而非仿真脉冲、流式在多人打断下的最终文本时间,以及双核正确性根因。若要追实时,优先更快矩阵核与双核访存争用分析,而不是继续压带宽,因为单核已证明是指令发射限制。
何时值得尝试与结论成立条件
当产品能接受数秒延迟的短命令、必须离线且只有 5 美元级单片机时值得尝试,例如家电玩具的英文或西班牙固定场景转写;要做直播字幕或对话则不适合,因为 4 秒命令整句约 8.7 秒、流式约 5 秒,且流式分块在干净集损失约 1.5 个点。结论成立条件是整句全上下文、LibriSpeech 类朗读、单核 2 倍实时实测、主机精度加板上延迟分别测量,换会议 earnings、强 babble 或远场则错误翻倍。
整句模式 × 流式分块模式: 整句模式等语音活动检测切好整句再用全上下文编码,流式分块模式每 32 帧推进一次并缓存各层的键值和卷积状态;前者精度高但必须等说完再算全部,后者边说边算、说完只剩最后一个不完整块,但看不到块右侧未来信息所以精度损失约 1.5 个点,且在当前 2 倍实时速度下仍要等数秒。
论文直接报告的是整句 int8 几乎无损、语言模型降 10% 到 13%、传感器达 2.99% 与 6.67%、噪声平均少 30% 到 40% 错误、单核约 1.97 倍实时,这些有表格与板测支持;双核硬件余量与更快核能到实时的说法只是推测待验证。常见误解是把 14 MB 当作内存占用,其实它是闪存大小,运行时靠分块把当前块放片上;把 int8 无损当作所有层都是整数,其实归一化与激活函数仍是浮点;把流式一半等待当作已实时,其实等待仍随长度按实时率减一增长,只有实时率小于 1 才是真实时。
📎 论文与评分元数据
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses