📄 Merit:让每个输入都挣得自己的那份多模态注意解码
英文题目:Merit: Making every modality earn its contribution in multimodal attention decoding
标签:#言语神经解码 | #多模态学习 | #脑信号 | #语音
评分:6.4/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.6/1.5
👥 作者与机构
- Ali Alavi:机构信息未在 arXiv HTML 中可靠披露
- Donald S. Williamson:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
听觉注意解码要从脑电图判断听者在多人同时说话时正在听哪一路语音,再据此控制助听设备放大目标声,难点是眼动、头动和场景视频指示朝向而非注意对象,容易在训练中挤占脑信号。Merit先把脑电图与候选语音包络分别编码,再在多个嵌入维度上求随时间变化的相关并去均值,得到只在脑信号参与时才有效的耦合分数。朝向分支以gaze、头动、光流和注视点视频为输入,预测说话人方位且全程不接触音频,其输出的方位分数进入下一步与耦合分数相加,共同决定输出的候选序号。该相加结构使忽略脑信号的打分无法超过机会水平,迫使模型保留脑电图通路。训练前用候选音频上的线性探针检查答案泄露,再用跨窗口打乱记录流度量每个流的贡献,并以沙普利值把总贡献精确分配到五个流,同时按贡献而非准确率选择检查点。与已发表基准相比,Merit在MAESTRO四选一任务的已知被试上达到0.8173准确率,基准为0.698,但加入行为流后脑电图分得的贡献从单独使用时的0.3971降到0.2217。结论适用于自由活动的房间扬声器场景,短至2秒窗口时脑电图贡献仅剩0.0263,两个耳机数据集上的高准确率也未通过时间方向检验,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
助听设备要解决的输入输出是什么
论文面对的是鸡尾酒会问题:多人同时说话时,助听器把所有声音一起放大,无法知道听者想听哪一路。听觉注意解码的目标是从记录窗中选出被注意的说话人。输入包括一段时间的听者记录和 K 路候选语音信号,其中恰好一路是被注意的,输出是 K 选一的编号,评价用准确率并与机会水平 1/K 比较。在 MAESTRO 上是四选一,机会水平为 0.25。必须保留的信息是脑电随被注意语音包络起伏的跟随关系,因为只有它说明在听什么。
注视、头部运动和场景视频说明朝向哪里,能辅助但不能替代脑电,否则当听者看与听不一致时,靠朝向做决定就会失效,而这恰恰是需要脑解码的情形。论文还强调候选音频本身是输入而不是标签,如果候选的统计特性标出了答案,任务就被偷换了。
已有解码路线为什么还缺一块测量
最早的线性方法从脑电重建语音包络,再与各候选做相关,需要几十秒才稳定,对助听设备太慢。深度匹配模型直接学习脑电窗与语音窗是否匹配,方向解码则不用音频而分类注意在左还是右。论文指出这两条线都曾把别的信号当成注意:方向解码在多个公开集上被发现主要依赖混入脑电的眼动,以及训练测试在同一试次内泄露带来的虚高,去除泄露后近期方向解码器掉了 17 到 45 个百分点,有的回到机会水平。
多模态平衡的研究处理训练时谁学得快的问题,用梯度调节、损失混合或随机丢模态让各流均衡学习。Merit 的不同在于它不只调训练速度,而是度量测试决策时每路流对准确率的影响,并用它选模型和报告每个结果。数据集方面,DTU 用耳机模拟房间,KU Leuven 用安静小室,近期四说话人集用下巴托固定头部,这些设计把头部眼动限制住了,适合分离脑响应,但看不到多流抢功。AV-GC-AAD 有意控制注视,适合检验是否读了注视,但其他流按设计不带信息,无法研究多流分功。
只有 MAESTRO 同时记录脑电、眼动、头部和第一视角视频,且听者在真实房间自由活动。
三种不靠脑信号也能答对的捷径
第一,音频本身泄露答案。把每路候选标准化到零均值单位方差只去掉了响度,偏度、峰度、稀疏性、分位数间距和频带能量比等不随缩放改变的统计量都还在。在 MAESTRO 上被注意者比播放时高约 15 dB,响度调整造成削峰,使包络峰均比的效应量达到 d=-1.22,只看音频的简单分类器就能达到 0.5581 的四选一准确率,超出机会水平 0.3081。第二,常用打分函数留了一条通路。常用做法是把脑嵌入与音频嵌入在每时刻归一化、逐元相乘、时间平均再过线性层。
如果脑编码器输出与时间无关的常向量,时间平均可以拆开,打分就退化为只看时间平均后音频嵌入的线性分类器,正好能读出第一条泄露,而训练恰恰容易找到这种让脑编码器塌缩的解。第三,容易的流挤掉脑电。多流一起训练时模型最依赖最好读的流,这里最好读的是说明朝向的注视和头部,准确率上升的同时,支持脑解码主张的证据反而变弱。
已有基准把脑电、注视、头部和视频一起打乱,只能说明用了听者信号整体,不能说明用了哪一路,而挤占正发生在流之间。
Merit 的两条通路如何分工
Merit 把问题拆成两个问题来问:记录是否在时间上跟随某路语音,以及听者朝向哪个音箱。前者只进脑电,因为只有脑电与语音有逐时刻的跟随关系;后者进注视、头部、场景光流和注视点周围图像的冻结嵌入,且不给音频,所以不可能利用音频线索。两路分数相加得到最终 K 个候选分数。编码只做 1 次,打分可重复进行,因此一个训练好的模型可以在任意打乱组合下重打分,而不必重编码,这让 32 种子集的 Shapley 计算变得便宜。
耦合分支 × 朝向分支: 耦合分支只接收脑电和候选语音,负责判断脑记录在时间上跟随哪一路语音的包络;朝向分支只接收注视、头部、场景运动和注视点图像特征,负责判断听者当时朝向哪个音箱。两者分工是因为只有脑电与语音存在逐时刻的跟随关系,而行为信号只说明朝向哪里,两路分数相加后融合,组合起来既保留跟随语音的证据,又利用朝向的辅助信息。
下面这张结构图展示了从 5 路记录流和 K 路候选音频到 K 个槽位分数的完整走向,左侧是各流的膨胀编码,中间是耦合相关与朝向分类头,右侧是交叉熵加对比与脑电零假设铰链等训练约束。
看图路径: 1. 先从左侧五路记录流出发,沿膨胀编码箭头看到耦合与朝向两条通路;2. 注意共享音频编码器与梯度反转的音频对抗分支画在哪里;3. 看两路分数如何按音箱排列收集再相加得到 K 个槽位分数
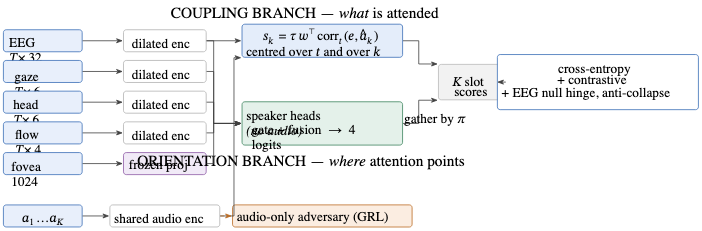
论文图 1。原论文 Figure 1::“Merit. The coupling branch compares the EEG with each candidate using a correlation over time with the mean removed.”。
从图中可以看到,耦合分支比较脑电嵌入与每路候选音频嵌入在时间上的相关,朝向分支每个流各自预测音箱编号再加权融合,音频对抗分支通过梯度反转把音频线索从音频编码器中洗掉。整体流程是先编码得到嵌入,再按排列收集对齐候选槽位,最后相加融合输出 logits。
\[\big(v(M)-v(\emptyset)\big)+\beta\,\min_{m}\phi_{m},\qquad\beta=1,\]这个公式是 Shapley 分功的定义,它把某流在所有子集上加入前后的准确率增量按排列权重平均,总和恰好等于全部流 intact 与全部打乱之间的总贡献,保证分出去的每一分都能加回来。
耦合打分为什么让常数脑向量拿不到分
每路流先过五层膨胀时间卷积,膨胀率为 1、2、4、8、16,感受野 63 个采样点,在 64 Hz 下约 0.98 秒,对应皮层对语音响应的展开时间。每层后用分组归一化,最后一层不加激活,因为整流后没有负值会把相关挤向一边。对称填充是为了能看到声音之后 100 到 300 毫秒的脑响应,只看过去的因果编码器看不到响应。耦合打分在每个嵌入维度上计算脑电嵌入与第 k 路候选音频嵌入在时间上的相关,先去掉时间均值再归一化,用无偏置权重向量合并并乘以可学习的温度,再减去 K 路候选的均值。
去掉时间均值是关键:若脑编码器输出不随时间变化,去均值后恰好为零,所有相关为零,K 路分数相等,准确率恰好是机会水平。相关还忽略尺度,候选不能靠更响获胜;减去候选均值去掉了对所有候选相同的加性成分,这也是权重没有偏置的原因。
\[\tilde{e}=\frac{e-\overline{e}}{\lVert e-\overline{e}\rVert_{2}},\qquad c_{d}(k)=\textstyle\sum_{t}\tilde{e}_{t,d}\,\tilde{a}_{k,t,d},\qquad s_{k}=\tau\,w^{\!\top}c(k),\qquad\mathrm{score}_{k}=s_{k}-\tfrac{1}{K}\textstyle\sum_{j}s_{j}.\]公式中符号的输入是脑电嵌入 e 与第 k 路候选音频嵌入,横线表示时间平均,c_d(k) 是第 d 维在时间上的内积,s_k 是加权求和再乘温度,score_k 是减去候选均值后的最终耦合分。计算目标是度量两段嵌入起伏方向是否一致,而不是能量大小。
朝向头与音频对抗各堵住哪条路
注视、头部、场景运动和注视点嵌入没有与语音包络的定时关系,让它们去匹配语音包络在早期尝试中直接塌缩了。因此每路各接一个分类头,用该流嵌入在时间上的均值和标准差预测音箱编号,脑电也接一个同样的朝向头,因为注意会让脑活动偏向一侧。这些头不输入音频,打乱它们后掉到机会水平以上的部分才算记录挣到的。各流的音箱分数用可学习的非负权重加小融合层合并,再与耦合分相加。
另一边,小网络从音频嵌入的均值和标准差出发,只看音频找正确答案,中间经过梯度反转层:前向不变,反向把梯度变号传给音频编码器,从而把小网络能读到的音频线索从音频编码器里训练掉。这很重要,因为线性探针可能漏掉网络能找到的线索。冻结的注视点嵌入来自 V-JEPA 2 ViT-L,对注视点周围图像块编码,每个窗一个 1024 维向量,从不训练,特别能读出这个房间的朝向信息。
损失函数用哪些监督留住脑信号
训练用 AdamW,学习率 10-3,批大小 32 且每批只取自同一听者,避免对比项靠识别听者身份走捷径,因为裸脑电识别听者可达 0.90,而 16 分类机会水平仅 0.0625。最多 50 个 epoch,无改善 5 轮后学习率减半,耐心 12 轮。所有设置事先固定 1 次,没有调参。任务损失是最终 K 个分数与正确候选编号的交叉熵并带 0.1 标签平滑,训练所有通向分数的参数。辅助损失给每个朝向头各自的音箱预测,避免最强的流拿走全部梯度。
双向对比损失问哪窗脑电配哪窗语音,负例来自同一听者,常数编码器在此只能拿到 log B 的机会水平。零假设铰链要求真脑电给正确候选的耦合分比他窗脑电或零脑电高出 0.5 间隔。防塌缩项要求每维在时间上的 spread 不低于 0.5,并惩罚维度间协方差的非对角,对应编码器不用输入时失去的量。对抗损失训练小网络只看音频找答案,再经梯度反转洗掉音频编码器中的线索。
论文还试过把对最终决策的打乱检验直接写成每个流的贡献铰链,并按验证贡献与单头贡献的差距自适应加权,但它没有提高脑电份额,因此最终 Merit 训练时不用它。
模态丢弃 × 贡献铰链损失: 模态丢弃指训练时随机把某路流置零,强迫模型在缺失下也能工作;贡献铰链损失指对每路流比较正常最终分数与该流被替换为他窗拷贝或零时的正确候选分数,要求前者高出一个间隔。两者搭配的想法是用训练时的扰动把被冷落的流推回去,但论文发现这种训练内干预并未提高脑电的份额,说明在测试时刻的决策影响不能靠这种方式直接推高。
\[\mathcal{L}=\mathcal{L}_{\text{task}}+0.3\,\mathcal{L}_{\text{aux}}+\mathcal{L}_{\text{con}}+0.5\,\mathcal{L}_{\text{null}}+0.1\,\mathcal{L}_{\text{col}}+0.3\,\mathcal{L}_{\text{adv}},\]该式是总损失的加权求和,权重依次为任务 1.0、辅助 0.3、对比 1.0、零假设 0.5、防塌缩 0.1、对抗 0.3,各项监督分别来自候选编号、音箱编号、窗间配对、替换脑电的间隔比较、时间 spread 与音频单独可分性。
候选构造、划分与窗长如何决定任务含义
MAESTRO 有 16 名听者每人 100 个试次,每试次 4 人同时从固定位置的音箱说话,听者事先被告知注意谁,事后回答相关问题。每试次约 30 秒,每段录音只用 1 次,训练测试之间没有共享音频。被注意者比其他人大声约 15 dB,这正是要区分响度与形状差异的原因。5 路流都重采样到 64 Hz 并按通道标准化:脑电 32 通道,注视 6 维,头部 6 维,场景光流 4 维,加上冻结的注视点嵌入。信号切成 W 秒窗、H 步进,默认 W=10、H=5。
每个样本包含各流、K 路候选包络、正确编号、每路来自哪个音箱、候选槽位排列以及听者身份,候选在每窗随机排序,测试时按窗索引固定顺序,保证比较的模型看到完全相同的输入。候选分 4 种:未匹配是 4 路原声标准化,常用但带泄露;匹配是分位数匹配后 4 路取值集合相同,只保留各自时序;同一说话人是用被注意者同一试次不重叠的另一段做干扰,此时音色位置都无用;同一说话人加匹配是最严的检查。
划分有被试内五折按音频内容分,保证测试 stimulus 在训练没听过;留一被试 16 折同时留出 20% 音频内容,保证测试被试与内容都新。验证集总从训练部分取,每个测试集只打 1 次分。
匹配候选 × 分位数匹配: 匹配候选指解码时看到的 K 路候选语音包络,其中一路是被注意的;分位数匹配指把四路候选按数值排序后取平均再按各自时间顺序放回,使四路取值的集合完全相同。两者搭配是因为标准化只能去掉均值方差,偏度稀疏性等尺度不变统计量仍能泄露答案,而分位数匹配去掉取值的整体分布差异,只保留各自的时间起伏,也就是脑响应真正跟随的部分。
公开数据集的记录条件有何不同
要比较多流抢功,必须有同时记录且听者自由活动的语料。下表比较已知公开集在注视、头部、场景、呈现方式和听者约束上的差异,眼电的几个电极只为去伪影,不是标定过的注视,也没有头部与场景信息。
| Corpus | Gaze | Head | Scene video | Presentation | Listener |
|---|---|---|---|---|---|
| DTU (Fuglsang et al., 2018) | 6 EOG | — | — | simulated rooms, earphones | soundproof booth |
| Four-speaker (Yan et al., 2024b) | — | — | — | 4 loudspeakers, anechoic | head fixed by chinrest |
| AV-GC-AAD (Geirnaert et al., 2024) | 4 EOG | — | — | earphones, simulated HRTFs | gaze controlled by design |
| MAESTRO (Hassan et al., 2026) | eye tracker | IMU | egocentric | 6 loudspeakers, real room | unconstrained |
DTU 在隔音室戴耳机听模拟房间,四说话人集在消声室用下巴托固定头部,AV-GC-AAD 戴耳机模拟头相关传输函数并有意控制注视,只有 MAESTRO 用 6 个真实房间音箱且听者无约束。这不是说前者设计不好,而是它们为分离脑响应而有意固定了行为流,抢功效应被设计掉了,在那里检验 Merit 不是更难而是效应无法出现。论文把不需要行为流的两件套拿到外部集检验:只看候选的音频探针和耦合分支的方向检查。
音频探针跨数据集的结果如下,均为双说话人、10 秒窗、内容不相交、无脑电,机会水平 0.5,最后一列是语料中谁被注意的先验。
| Corpus | Listeners | Windows | Probe | Excess | Attended-role prior |
|---|---|---|---|---|---|
| KU Leuven | 16 | 9,564 | 0.6947 | +0.1947 | 0.800 track 1 |
| DTU | 18 | 9,720 | 0.5008 | +0.0008 | 0.494 male |
DTU 探针 0.5008 超出机会仅 +0.0008,说明探针不是到处报警;KU Leuven 探针 0.6947 超出 +0.1947,原因是 256/320 试次注意的是第一轨,第三部分重放第一部分而第一部分总注意第一轨,固定说话人的身份预测了标签。分位数匹配只能把 KU 的超出从 +0.1947 降到 +0.0974,因为它去掉取值形状但保留时序中的频带平衡,固定说话人仍可被认出,此时应对的是标签不平衡而非分布匹配。不同窗长的细节见下表。
| Corpus | 22 s | 55 s | 1010 s | 3030 s |
|---|---|---|---|---|
| KU Leuven, as released | +0.0945 | +0.1384 | +0.1947 | +0.0729 |
| distribution-matched | +0.0321 | +0.0401 | +0.0974 | +0.0208 |
| DTU, as released | +0.0010 | +0.0001 | +0.0008 | -0.0019 |
DTU 四档窗长超出都不超过 0.005,KU 在 2、5、10、30 秒分别为 +0.0945、+0.1384、+0.1947、+0.0729,匹配后分别降到 +0.0321、+0.0401、+0.0974、+0.0208,其中 30 秒格基于 8 对刺激的 4608 窗,统计力度最弱。探针只用 8 个尺度不变统计量的逻辑回归,它定的是简单可读性的下界,网络能读到的可能更多,因此要用模型的打乱准确率再测 1 次。
融合后准确率上升但脑电份额发生了什么
在匹配候选、四选一、被试内条件下,基准模型配未匹配候选可达 0.4991,但贡献为 +0.0000,打乱脑电时决策从不变,翻转率为 0.0000,嵌入跨窗余弦相似高达 0.9138,说明准确率真实但没有一分来自脑电。换更好编码器到 0.5800 仍贡献为零,只是把音频读得更好。换成去时间均值的打分才出现首个非零贡献,同样的基准模型在匹配候选上只有 0.2833,接近机会水平。下面的堆叠条形图把 4 个融合模型的 Shapley 贡献拆开,总高度是总贡献,颜色段是各流份额,要看的不是谁更高而是蓝色脑电占多少。
看图路径: 1. 比较四个柱子的总高度,即总贡献大小;2. 比较每个柱子中蓝色脑电段占总高度的比例;3. 观察紫色注视点嵌入段在融合模型中的占比变化

论文图 2。原论文 Figure 2::“Shapley credit per stream, stacked, for the four fused rows of Table 1.”。
可以看到 4 个模型中注视点嵌入的紫色段都超过脑电蓝色段,加入行为流后脑电份额从单独时的 +0.3971 掉到融合时的 +0.2217 左右,而总贡献从 +0.3971 升到 +0.5439,联合打乱只报告后者就会掩盖前者的减半。最终 Merit 不用铰链也不用模态丢弃,被试内 0.8173、未见被试 0.7438,脑电份额在未见被试上保留最多。
打乱准确率 × 贡献: 打乱准确率指把某路记录流跨测试窗交换而保留各窗自己的候选和标签后重新打分得到的准确率;贡献指正常准确率减去该打乱准确率的下降量。两者搭配是因为准确率本身不说明谁在起作用,只有看打乱后掉多少,才能把总准确率中属于该流的部分分离出来,Shapley 值再把多流重叠的部分公平分摊。
不同流组合的准确率与贡献对照
要回答加流是否真的帮到脑解码,需要固定候选、划分、窗长和指标方向,只改变流集合。指标是准确率越高越好,零假设是全部流打乱后的准确率,贡献是两者之差。下表是被试内、匹配、四选一、W=10 秒、每窗一决策的全部流集合对照,机会水平 0.25,表中同时给出置换 p 值与正贡献折数。
| Streams | Accuracy | Null | Contribution | pp | Folds+ |
|---|---|---|---|---|---|
| EEG | 0.4788 | 0.2882 | +0.1906 | 0.0476 | 5/5 |
| EEG + gaze | 0.5295 | 0.2610 | +0.2685 | 0.0476 | 5/5 |
| EEG + head | 0.4995 | 0.2589 | +0.2405 | 0.0476 | 5/5 |
| EEG + flow | 0.5325 | 0.2854 | +0.2471 | 0.0476 | 5/5 |
| EEG + fovea | 0.6909 | 0.2550 | +0.4358 | 0.0476 | 5/5 |
| Behaviour only | 0.6552 | 0.2541 | +0.4010 | 0.0476 | 5/5 |
| All five | 0.7101 | 0.2597 | +0.4504 | 0.0476 | 5/5 |
单脑电准确率 0.4788,贡献 +0.1906;加上注视点嵌入后准确率跳到 0.6909,贡献 +0.4358;只用 4 个行为流已达 0.6552,贡献 +0.4010;5 流全用 0.7101,贡献 +0.4504。收益主要来自注视点嵌入,它单独就说明了朝向。
代价是融合准确率几乎完全可由朝向解释,脑电单独的证据被稀释。这里是每窗决策的结果,还不是每试次一决策的最终系统,且短窗下行为流优势更大,不能直接读成脑结果。
未见被试的对照条件更严,每个测试被试与测试内容都新。下表是留一被试 16 折的同样流集合,W=10 秒,机会水平 0.25。
| Streams | Accuracy | Null | Contribution | pp | Folds+ |
|---|---|---|---|---|---|
| EEG | 0.4831 | 0.3130 | +0.1701 | 0.0863 | 15/16 |
| EEG + gaze | 0.4844 | 0.2760 | +0.2084 | 0.0506 | 16/16 |
| EEG + head | 0.4944 | 0.2782 | +0.2162 | 0.0536 | 16/16 |
| EEG + flow | 0.5013 | 0.2767 | +0.2245 | 0.0506 | 16/16 |
| EEG + fovea | 0.6700 | 0.2649 | +0.4051 | 0.0476 | 16/16 |
| Behaviour only | 0.6300 | 0.2677 | +0.3623 | 0.0476 | 16/16 |
| All five | 0.6706 | 0.2668 | +0.4038 | 0.0476 | 16/16 |
趋势与被试内一致,单脑电 0.4831 贡献 +0.1701,5 流全用 0.6706 贡献 +0.4038,行为-only 已达 0.6300。脑电在 15/16 折为正,其余组合 16/16 为正。跨被试时个体校正帮不上忙,脑电单独的提升有限,融合的增量仍主要来自朝向。这两张表共同支持论文的核心判断:更多流带来更高准确率,但脑电分得的份额下降,联合打乱的总贡献上升会掩盖这一点。
从每窗到每试次以及延迟方向的增量
在脑电单独、被试内、匹配条件下,论文逐行累加改进:随机裁剪每窗决策贡献 +0.1974,改为每试次累加窗分数做一决策后贡献到 +0.2866,是最大的一笔增量;只保留声音之后的延迟后贡献到 +0.3271,而只保留声音之前的镜像对照只有 +0.2127,确认方向;加上每被试的脑电通道低秩校正后到 +0.3971,再加标记语音起始的第二音频通道后准确率从 0.6709 到 0.6915。与基准最长窗 30 秒、每试次一决策的设置对齐比较时,基准报脑电单独 0.591、未见 0.619,多模态 0.698 和 0.674,Merit 脑电单独被试内 0.6915 贡献 +0.3971,多模态 0.8173 贡献 +0.5439,未见多模态 0.7438 贡献 +0.4737 且 16/16 折为正。
只有未见被试脑电单独 0.6000 不及基准 0.619,贡献 +0.3132,因为个体校正按设计帮不到没见过的人,所以脑信号上的增益主要体现在被试内。左图展示贡献随决策窗长的变化,右图展示模型打乱准确率与线性音频探针随窗长的变化。
看图路径: 1. 左图比较脑电单独与加入注视点嵌入后贡献随窗长的变化;2. 右图比较模型打乱准确率与线性音频探针随窗长的走势;3. 注意 2 秒附近脑电贡献很低而行为流贡献已很高的分叉

论文图 3。原论文 Figure 3::“Contribution against decision-window length, within-listener, matched.”。
左图可见脑电单独的蓝色曲线随窗长爬升,加入注视点嵌入的绿色曲线早早处在高位;右图可见模型打乱准确率始终在机会水平 0.25 上下 0.015 以内,而线性探针在 0.23 到 0.30 之间波动,15 秒处有个尖峰,说明匹配后仍有小残留,但模型自身的打乱基线是干净的。
同一说话人候选 × 因果延迟: 同一说话人候选指干扰候选用被注意说话人同一试次中不重叠的另一段语音构成,使音色和位置都无法区分;因果延迟指只允许脑编码器看到声音之后约 125 到 1109 毫秒的延迟。两者搭配是因为前者去掉身份和朝向线索,后者要求跟随必须发生在声音之后,两项都通过才更支持读到的是大脑对语音的跟随,而不是零延迟的电泄露或缓慢漂移。
短窗与严格候选下脑信号是否还在
短窗是问题最突出的地方:2 秒的一瞥已足以看清朝向,但脑跟随需要时间累积,而编码器自身窗口已占 0.98 秒。论文报告 W=2 秒时脑电单独贡献仅 +0.0263,冻结注视点嵌入单独已达 0.7130 贡献 +0.4570,5 流融合 0.7291,此时融合准确率几乎完全是朝向,不能读成脑结果。同一说话人候选去掉身份与位置后,脑电单独在 K=3 时贡献 +0.2156,K=2 时 +0.1986,说明跟随来自时序。延迟方向上,匹配四选一时声音之后 125 到 1109 毫秒贡献 +0.2240,声音之前镜像只有 +0.0967。
同一说话人 K=2 时因果 +0.2959 对非因果 +0.1478,约为 2 倍,符合对声音的响应必须在声后,且排除了零延迟电泄露与双向相同的慢漂移。论文还试过把贡献检验放进损失的铰链:在 W=10 秒每窗决策的早期设定下,按准确率选点时脑电份额 +0.1039,按贡献选点时到 +0.1182,这是唯一提高脑份额的训练选择;而铰链本身在有模态丢弃时把脑电从 +0.2229 拉到 +0.1600,无丢弃时 +0.2169 对 +0.2217 无实质差别,未见被试上无铰链的两组都保留更多脑份额,因此最终不用它。
未胜出项是带铰链无丢弃的模型被试内最准 0.8242,却在未见被试上最差 0.7219,说明准与脑份额并不一致。
结论在什么条件下才成立
第一,数据来自一个房间、一种语言、16 名听者,冻结视频流尤其读的是这个房间,超参数事先固定未调优,数字没有被调参放大,但也不能声称已是最优或能直接搬到别的房间。第二,四选一中同一试次注意对象不变,认出试次就知道部分答案,同一说话人结果没有此问题,因为候选都来自同一试次同一声音。
第三,音频泄露的成因未被直接验证,每段录音只用在一个角色上,角色与录音无法分离,作者引用数据集方的削峰解释,但探针只度量可读性,两种修复无论成因为何都有效;要从源头去掉,需要每段录音在不同试次中既做被注意又做被忽略的设计。
第四,在 KU Leuven 和 DTU 上耦合分支虽达到 0.8149 和 0.8170 的同一说话人准确率,但因果与非因果延迟贡献相同,不符合声后响应的方向性,论文明确不把它们计为脑解码,最可能是耳机靠近电极的零延迟电泄露经慢包络扩散到双向,MAESTRO 用远场音箱则通过了方向检查。第五,Shapley 份额是该训练好模型在该测试集上的归因,不是流本身固有的信息量,重叠流会平分共享部分,去掉一路的损失平均不能读成每路各持一半信息。
复现第一步要固定什么
复现先固定四件事:候选构造、划分、决策窗与流集合,每个准确率都配自己的打乱基线,没有基线的准确率不算结果。候选在每窗随机排序,测试时按窗索引固定顺序,保证所有模型看到相同输入;同一说话人负例必须从同试次不重叠窗随机取,不能取最远窗,否则探针会学到位置而达到 0.60 对 0.50 的虚高,试次太短放不下时宁可减小 K 也不许重叠。
被试内按音频内容五折分,留一被试按被试与内容双重未见分,验证集总从训练部分取,测试集只打 1 次分,验证用 3 次打乱选点,测试用 20 次打乱,Shapley 每个子集 5 次打乱且子集间复用相同打乱以去掉打乱噪声。编码器膨胀率、组归一化、无末层激活、对称填充、单听者成批、对比与防塌缩的设置按原文附录取定,不要调参。
论文称解码器、数据代码与全部检验在一个包中,一个配置文件加一条命令跑一个实验,主要命令包括融合 4 个模型、脑电阶梯、流集合、短窗与外部语料,输出数字由脚本从运行产物机械填入。需要补的验证是换房间、换语言、换音箱布局后的朝向先验变化,以及耳机近场下的零延迟泄露排查。本篇未发现来源绑定且完成验证的资源,不得声称代码模型数据已公开,来源未确认不是技术缺陷。
什么时候值得尝试还缺哪项验证
当设备同时有脑电与眼动头部场景,且听者可能看与听不一致时,值得尝试 Merit 的思路:先用音频探针验候选是否干净,再用去均值相关保证常数脑向量只能得机会水平,朝向头不给音频并加音频对抗洗掉线索,最后用分流打乱与 Shapley 份额选模型和报告结果,而不是只看准确率。复现第一步是跑通匹配候选与同一说话人候选的探针与打乱基线,确认模型打乱准确率回到机会水平,再看脑电份额。
还缺的验证包括跨房间跨设备的稳定性、短窗下脑跟随的时间累积极限、以及在耳机数据上区分神经跟随与电泄露的独立测量。关键超参数是 64 Hz 采样、10 秒窗 5 秒步进、膨胀感受野 0.98 秒、只看声后 125 到 1109 毫秒、温度初值 1/0.07、损失权重与 0.5 和 0.3 的间隔。信息条件是候选必须匹配、划分必须按内容与被试双重未见、每个结果必须有自己的打乱基线。容易误解的是融合更准不等于脑解码更强,论文显示融合把脑电份额几乎减半。
训练对抗打乱检验也未提高脑份额,能抵抗训练干预恰恰说明该度量更可信。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses