📄 EAGLE-ASR:为语音识别定制的无损推测解码加速
英文题目:Lossless Inference Acceleration for ASR via EAGLE-Style Speculative Decoding
标签:#语音识别 | #语音翻译 | #自回归模型 | #知识蒸馏
评分:8.0/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Sen Zhang:the College of Intelligence and Computing, Tianjin University, Tianjin 300350, China
- Xianghu Yue:the College of Intelligence and Computing, Tianjin University, Tianjin 300350, China
- Yiming Chen:ASUS Intelligent Cloud Services, Singapore 486030
- Wenhuan Lu:the College of Intelligence and Computing, Tianjin University, Tianjin 300350, China
- Jianguo Wei:the College of Intelligence and Computing, Tianjin University, Tianjin 300350, China
- Haizhou Li:the School of Artificial Intelligence, The Chinese University of Hong Kong, Shenzhen, Guangdong 518172, China, also with the Department of Electrical and Computer Engineering, National University of Singapore, Singapore 117583
📌 核心摘要
自回归语音识别每次只生成一个词元,目标模型需要反复做完整前向计算,解码延迟成为离线转写的瓶颈,压缩与非自回归并行解码往往改变参数或输出而损失精度。EAGLE-ASR 保留目标模型参数不变,采用起草后并行验证的流程,输入为完整语音与已生成前缀,输出与原始自回归解码相同的词元序列。轻量起草模块 Speech-Draft 在第一步融合编码器声学特征与目标解码器低中高三层表示并结合词元嵌入,后续步骤复用上一步隐状态与已起草词元做自回归延展,目标解码器再并行验证并按标准接受准则保留前缀一致部分。训练只用目标模型重转写的自蒸馏文本,并以指数衰减加权的多步交叉熵让近端预测更准,从而缩小训练与多步起草之间的分布差异。与依赖外部小模型的投机解码和并行多头预测相比,该设计同时利用声学对齐与层次语义且保持因果依赖。在 LibriSpeech 上以 Whisper-large-v3 为目标时,test-clean 的相对加速比达到 1.91 倍且词错率变化为零,超过同环境下的外部草稿与 Medusa 基线。该结论适用于全量语音输入的离线贪心解码,翻译等不确定性更高的任务接受长度会下降。
🔗 开源与复现资源
- 代码相关资源:https://github.com/ssss-sen/eagle-asr — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
语音识别要算什么,为什么解码慢
论文研究的是整句离线语音识别与语音翻译中的解码加速。输入是一段完整音频,目标是输出对应的文字或英文译文。所用的目标模型是注意力的编码器加解码器结构,编码器把音频变成声学表示,解码器根据声学表示和已生成的文字前缀逐个预测下一个词。这种逐词生成意味着生成第 t 个词必须等前 t-1 个词都确定,目标模型的大规模前向计算要串行执行很多次。
对于刚入门的读者,可以把例子标为例子:比如一句十几秒的英文朗读,解码器可能要执行上百次大模型前向,每次只吐一个词,这是延迟的主要来源。论文强调它不做流式提前输出,也不把模型压小或改成一次性并行输出,而是保留原模型的输出分布,让加速后的转写与原来完全一致,用词错误率的变化量来检验是否无损。
已有加速路线在相同任务下各缺什么
在输入、目标和评测都相同的自回归识别任务下,论文对比了 3 类路线。第一类是模型压缩与非自回归解码,前者如蒸馏、量化、剪枝把模型变小,后者如 Mask-CTC、Paraformer 等一次并行出多个词,它们都能降延迟,但原文指出往往要改结构或牺牲词错误率。第二类是普通推测解码,用一个独立小草稿模型先写 K 个候选,再由目标模型并行验证,接受概率取决于目标概率与草稿概率之比,理论上能保持原分布。
论文指出在语音任务中这条路线的实际困难是草稿与目标不对齐,例如用 Distil-Whisper 或 Whisper-tiny 给 Conformer 当草稿,还会遇到分词器不一致,需要把草稿先解码成文字再重编码,额外开销大。第 3 类是 Medusa 式内部草稿,Whisper-Medusa 在解码器顶层加多个并行头,但各位置独立预测,缺少对前一个草稿词的依赖,也没有充分利用编码器声学特征,而且微调了目标解码器最后一层,导致词错误率上升,不能算无损。
EAGLE 在文本领域的做法是只挂一个自回归小模块并复用目标多层表示,论文要把它改造为适合语音双重依赖的版本。
直接搬 EAGLE 到语音会遇到什么错位
文本生成只依赖历史文字,而语音识别的解码同时依赖历史文字和编码器声学表示,解码器的行为与编码器输出耦合。如果草稿只看文字隐状态而忽略声学上下文,或者只用顶层表示而丢掉不同深度的解码器信息,草稿就容易偏离目标模型的真实选词,验证时被拒的概率上升,加速就被草稿计算和验证宽度吃掉。
另一个错位是训练与推理不一致:训练时容易拿到目标模型的真值隐状态,推理到第二个及之后的草稿位置时只能用草稿自己上一轮的隐状态和自己刚写的词,误差会累积。还有数据错位:人工标注的转写在大小写、标点和转写习惯上与目标模型实际输出不同,直接拿人工标注训练草稿,草稿学会的是理想分布而不是目标模型的分布。这些就是论文后面分别用结构融合、自蒸馏和多步训练来处理的具体问题。
EAGLE-ASR 一轮推理如何走完起草加验证
EAGLE-ASR 冻结目标语音识别模型,只训练一个轻量自回归模块 Speech-Draft。推理时给定音频和已生成前缀,目标模型先正常预测下一个词,同时缓存编码器特征和解码器不同层次的表示。接着 Speech-Draft 以这些表示加移位后的前缀为输入,自回归生成 K 个草稿词,然后目标解码器把 K 个草稿一次并行算完各位置的对数几率,按标准推测解码准则从前往后逐个比对,直到第一个与目标模型会采样出的词不一致处截断,后面草稿丢弃。
论文明确通过这种无近似的并行验证保证输出分布与原目标模型一致,从而做到无损。下图上半是训练、下半是推理,展示了特征从目标模型流向 Speech-Draft 以及推理时并行验证的闭环,读图时先分清上下两半,再跟踪特征与词序列两类箭头。
看图路径: 1. 先看上半训练与下半推理两条横向主路径的输入输出;2. 再看目标模型解码器如何输出 f_high、f_middle、f_low 给 Speech-Draft;3. 最后看推理时虚线回路如何把已接受前缀送回下一轮起草

论文图 1。原论文 Fig. 1::“Pipeline of EAGLE-ASR. Training phase (upper): The Speech-Draft model is trained using a multi-token generation strategy together with a weighted cross-entropy loss with…”。
上半训练画了标签序列逐轮右移、Speech-Draft 共享权重展开多步并计算每步损失;下半推理画了目标模型先出一个词,Speech-Draft 递归出后续草稿,最右侧统一写明并行验证。图中目标模型内编码器与解码器相连,编码器输出的声学特征同时送给解码器和 Speech-Draft,解码器输出的高、中、低三层表示一起送给第一步 Speech-Draft,后续步骤则改用上一草稿步的隐状态加已写草稿词。这种画法把训练时用真值隐状态与推理时用自身隐状态的区别表现出来,也为后面多步训练的必要性做了铺垫。
Speech-Draft 由哪些部件组成,声学信息从哪里进
Speech-Draft 由两个全连接层、一个嵌入层、一个 Transformer 解码器块和一个语言模型头组成,其中嵌入层和语言模型头直接复用目标模型的参数且不训练,只有全连接层和 Transformer 解码器块需要更新。第一个全连接层只在第一步激活,把目标解码器的低、中、高三层表示融合成统一表示,起到聚合不同深度上下文的作用;第二个全连接层把该融合表示或后续步骤的上一隐状态与词嵌入拼接,送入 Transformer 解码器块。关键是编码器声学表示通过该解码器块的交叉注意力注入,使每一步草稿都严格对齐输入语音。下图左侧是第一步、右侧是第二步,共享权重,读图时注意左右下方输入的不同。
编码器声学特征 × 解码器层次表示: 编码器声学特征指目标模型编码器对整段语音提取的连续表示,负责提供声音内容接地;解码器层次表示指目标解码器不同深度的隐状态,分别携带浅层文本衔接与深层语义偏好,二者分工是前者决定说什么声音,后者决定目标模型习惯怎么说,组合后 Speech-Draft 才能同时对准声音和对准目标模型的选词习惯。
看图路径: 1. 对比 step1 与 step2 下方输入的差异,看第一步融合多层特征、后续只用上一隐状态;2. 找到 f_encoder 进入交叉注意力的箭头,确认声学信息注入位置;3. 沿 FC 层到 Transformer 解码器块再到 LM 头的纵向路径看输出

论文图 2。原论文 Fig. 2::“The overall architecture of the Speech-Draft, which consists of two fully connected (FC) layers, an embedding layer, a Transformer decoder block, and an LM head.”。
图中左侧第一步下方同时看到多层解码器特征经拼接融合与词嵌入拼接,右侧第二步下方只看到上一草稿词的嵌入与上一隐状态的拼接,声学特征从左侧横向进入两步的交叉注意力,顶部语言模型头分别输出下一个草稿词。这种结构保持轻量,论文在 Whisper 上草稿约 117M、在 Conformer 上仅约 10M,同时因为只依赖 Transformer 解码器接口,理论上可接到任何同类自回归语音模型。第一步用目标多层表示保证起点准,后续用自身隐状态保证自回归连贯,这正是 EAGLE 保留时序依赖而区别于 Medusa 并行头的地方。
起草的前两步具体算什么,验证如何截断
记前缀为已确认词,目标模型先给出当前词,编码器特征与高中低三层解码器表示被取出。第一步 Speech-Draft 输入这些特征加上把当前词拼到前缀尾部并整体前移 1 位的序列,生成第一个草稿词;从第二步起,它不再拿目标多层表示,而是拿编码器特征、上一草稿步的隐状态和上一草稿词来预测下一个草稿词,如此递归 K 步得到完整草稿序列。验证时目标解码器并行计算 K 个位置的输出,逐个与草稿比对,遇到第一个不一致就停,后续丢弃并按标准推测采样补一个替换词。
论文在解码超参数分析中比较了线性验证与树验证,发现语音识别任务中把候选分支增多带来的接受长度小幅提升,不足以抵消每次验证要处理更多词的开销,因此默认用线性验证。
起草阶段 × 验证阶段: 起草阶段由轻量 Speech-Draft 自回归产生连续 K 个候选词,代价小但可能出错;验证阶段由冻结的目标解码器一次并行计算这些位置的对数几率并逐个接受或截断,代价是一次较宽的前向计算,组合意义是用一次并行验证换掉多次目标模型串行解码,只有草稿足够准时才能减少目标模型步数。
这种先串行小步起草、再一次并行大步验证的搭配,本质是用草稿的多次便宜计算换目标模型少做几次昂贵串行前向。只有当草稿分布接近目标分布时,平均每次验证能多接受几个词,省下的目标步数才大于多花的草稿步数加验证宽度,否则就会像论文中 Conformer 配 Whisper 草稿那样出现减速。
自蒸馏与多步加权训练如何让草稿学对分布
训练数据上,论文先用目标模型把全部训练音频重新转写一遍,保留 Whisper 的特殊前缀,再用这些模型输出作为 Speech-Draft 的训练目标,而不是人工标注。这样草稿学到的是目标模型的标点、大小写和选词偏好,验证时更容易命中。下图用左右两块对比说明了这种重写,左侧是全小写无标点的原始标注,右侧是带特殊符号和正常标点的模型输出,中间箭头标明经目标模型重写得到蒸馏集,读图时重点看文本风格的变化而不是具体哪句话对错。
看图路径: 1. 对比左侧原始文本与右侧蒸馏文本的大小写标点与特殊符号差异;2. 确认中间 Target Model 重写箭头的方向是音频加原文进、蒸馏文本出;3. 注意 Whisper 特殊前缀在右侧被保留的写法

论文图 3。原论文 Fig. 3::“An illustration of self-distilled training data generation, designed to mitigate the distributional discrepancy between the original transcripts and the target model outputs.”。
训练过程上,论文把 Speech-Draft 按 K 等于 7 展开多步,第一步用目标编码器特征加多层解码器表示和移 1 位的序列预测移 2 位后的序列,后续每步用编码器特征加上一轮草稿隐状态和移更多位的序列预测更远的序列,以此模拟推理时只能依赖自身隐状态的情况。损失是对 K 步交叉熵按指数衰减加权,越靠前的步权重越大,因为前面错了后面整段都会被拒,远处预测难但重要性低。公式先给出多步损失的加权求和,再给出权重随步数指数衰减的归一化形式。
自蒸馏数据 × 多步生成训练: 自蒸馏数据指用目标模型重写训练音频得到转写再作为草稿训练目标,解决人工标注与目标模型输出分布不一致的问题;多步生成训练指训练时让 Speech-Draft 连续展开 K 步并用自己上一轮隐状态预测更远词,解决推理时没有目标模型真值隐状态可用的错位问题,二者组合让草稿学的是目标模型在连续自回归下的行为。
\[{L}_{\text{mtp}}=\sum_{k=1}^{K}\alpha_{k}\cdot{L}_{\text{mtp}}^{k}=\sum_{k=1}^{K}\alpha_{k}\cdot\text{CE}\left(\hat{t}_{1+k:T+1}^{k},\ t_{1+k:T+1}\right)\]\[\alpha_{k}=\frac{\beta^{k-1}}{\sum_{j=1}^{K}\beta^{j-1}}\]训练时只更新全连接层和 Transformer 解码器块,嵌入层、语言模型头和整个目标模型都冻结,既省计算也保证目标能力不被改动。论文对 Whisper 在 LibriSpeech 训练 200K 步、在 VoxPopuli 训练 400K 步,对 Conformer 分别训练 150K 与 300K 步,优化器用 AdamW,峰值学习率 5×10⁻⁵,衰减因子取 0.8,这些设置是复现时需要照抄的训练预算,不能只看结构而忽略步数与权重。
实验在什么数据模型与指标下比较
数据用 LibriSpeech 约 960 小时英文朗读训练草稿,并在 test-clean 与 test-other 上评测,同时用 VoxPopuli 的英德西法意子集做多语种识别,用德西法意到英语 4 个方向做语音翻译。论文明确不用人工转写直接训练,一律用自蒸馏目标训练。目标模型一是 Whisper-large-v3,32 层编码器加 32 层解码器约 1550M 参数;二是 FunASR 的 Conformer 注意力编码器解码器模型,32 层 Conformer 编码器加 16 层 Transformer 解码器约 220M 参数,推理时不用 CTC 分支。所有评测在单张 24 GB 的 RTX 4090 上进行,默认草稿长度 K 为 5、top-k 为 1,翻译任务因输出不确定性更大改用 top-k 为 2。
指标一是相对普通自回归解码的加速比,越大越好;二是平均接受长度,反映每次验证平均通过几个草稿词;三是词错误率变化量与翻译质量变化量,论文以等于 0.00 来经验证明无损,任何大于 0 的词错误率上升都算有损。
在 LibriSpeech 上谁更快,谁的草稿更划算
主结果比较在相同硬件与相同解码设置下,不同草稿方案在 LibriSpeech 干净集与另一集上的加速比、平均接受长度与词错误率变化。比较条件是同一目标模型、同一划分,加速比越大越好,平均接受长度越大说明草稿越准,词错误率变化量为 0 才算无损。比较对象包括独立小模型草稿、Medusa 两种头与本文 Speech-Draft。
| 目标模型 | 方法 | 草稿模型 | 草稿参数 | 干净集加速比 | 干净集 τ | 干净集 ΔWER | 另一集加速比 | 另一集 τ | 另一集 ΔWER |
|---|---|---|---|---|---|---|---|---|---|
| Whisper (1550 M) | SpD[12] | Distil-large-v3 | 756 M | 1.72 × | 4.14 | 0.00 | 1.52 × | 3.76 | 0.00 |
| Whisper (1550 M) | SpD[12] | Whisper-tiny | 39 M | 1.76 × | 3.04 | 0.00 | 1.58 × | 2.56 | 0.00 |
| Whisper (1550 M) | Medusa[25] | Medusa-Linear | 68 M | 1.67 × | 3.51 | +1.88 | 1.59 × | 3.32 | +3.61 |
| Whisper (1550 M) | Medusa[25] | Medusa-Block | 92 M | 1.65 × | 3.16 | +1.17 | 1.54 × | 3.01 | +1.50 |
| Whisper (1550 M) | EAGLE-ASR | Speech-Draft | 117 M | 1.91 × | 3.79 | 0.00 | 1.79 × | 3.55 | 0.00 |
| Conformer (220 M) | SpD[12] | Distil-small | 166 M | 1.18 × | 2.85 | 0.00 | 0.90 × | 2.35 | 0.00 |
| Conformer (220 M) | SpD[12] | Whisper-tiny | 39 M | 1.13 × | 2.56 | 0.00 | 0.88 × | 1.97 | 0.00 |
| Conformer (220 M) | EAGLE-ASR | Speech-Draft | 10 M | 2.43 × | 4.98 | 0.00 | 2.30 × | 4.50 | 0.00 |
原表显示 Whisper 目标下 EAGLE-ASR 在干净集达 1.91 倍、另一集达 1.79 倍且词错误率变化为 0,Conformer 目标下达 2.43 倍与 2.30 倍,而两种跨模型族的普通推测解码在困难集甚至低于 1.0 出现减速。蒸馏大草稿虽然接受长度最高,但 756M 的起草开销抵消了收益;轻量 tiny 草稿开销小但接受长度仅 3 左右,净加速也低;EAGLE-ASR 用内部草稿取得质量与开销的平衡。Conformer 本身仅 220M,外部草稿相对不轻,加之分词器不一致需经文字中转,进一步放大开销。该表只能说明在论文单卡、整句离线条件下的相对加速,不能推广到流式或其他硬件。
下图柱状对比直观呈现了这种反差,读图时以灰色普通解码为 1.0 基准看各色柱高,重点看 Whisper 组与 Conformer 组的柱高差异。
看图路径: 1. 先看 Whisper 组与 Conformer 组各自以 Vanilla 为 1.0 的基准柱;2. 再比较 EAGLE-ASR 柱与其他草稿方法的高度差异;3. 注意 Conformer 组基线柱几乎无加速而 EAGLE-ASR 柱明显更高的反差
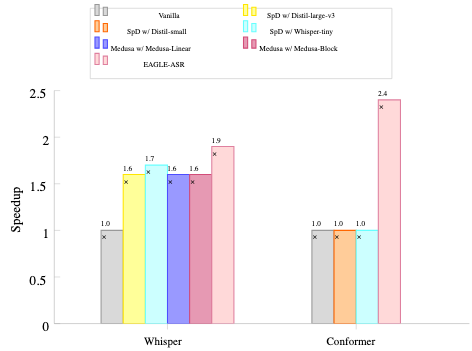
论文图 4。原论文 Fig. 4::“Speedup comparison across different decoding methods. EAGLE-ASR consistently outperforms all baseline methods for both target models while guaranteeing lossless decoding.”。
图中左侧 Whisper 组各方法都在 1.6 到 1.9 之间,EAGLE-ASR 最高达到 1.9;右侧 Conformer 组基线方法都在 1.0 附近,EAGLE-ASR 跃升到 2.4 左右,且全程保证无损,而 Medusa 两种实现因改动目标参数会出现词错误率上升,不能视为同条件无损对比。
平均接受长度 × 加速比: 平均接受长度指每次验证平均通过的草稿词数,反映草稿质量;加速比指相对普通逐词解码的 wall-clock 加速,反映质量减去草稿与验证开销后的净收益,二者组合才能解释为何接受长度最高的方法不一定最快,因为大草稿模型本身的计算会吃掉收益。
该结论只在论文的单卡、整句离线、草稿长度为 5 且 top-k 为 1 的条件下成立,换硬件、流式或更大草稿长度时最优点会移动。
多语种识别的加速是否稳定
多语种问题要回答同一套 Speech-Draft 思路能否跨语言保持无损加速。比较条件是 Whisper 目标、VoxPopuli 5 个子集、与单语实验相同的草稿长度为 5 与 top-k 为 1,加速比与接受长度越大越好,词错误率变化为 0 才算无损。本表比较的是不同语言子集而非不同方法。
| 评测子集 | 草稿长度 K | Speedup | τ | ΔWER |
|---|---|---|---|---|
| VoxPopuli 英语 | 5 | 1.96× | 4.06 | 0.00 |
| VoxPopuli 德语 | 5 | 2.14× | 4.50 | 0.00 |
| VoxPopuli 西班牙语 | 5 | 2.10× | 4.46 | 0.00 |
| VoxPopuli 法语 | 5 | 2.15× | 4.64 | 0.00 |
| VoxPopuli 意大利语 | 5 | 2.10× | 4.46 | 0.00 |
| 平均 | 5 | 2.09× | 4.42 | 0.00 |
结果显示 5 种语言加速在 1.96 到 2.15 之间,平均 2.09 倍,接受长度平均 4.42 且全部无损,波动小说明草稿学到的是目标模型隐表示中的语言无关模式,而不是只记住英语。限制是仅覆盖这 5 个欧洲语言,未覆盖低资源语言与噪声口音,论文也未报告跨语言时的额外训练成本分解,因此不能把该平均值推广到所有语言。
线性验证 × 树验证: 线性验证指每步只保留 top-k 为 1 的一条草稿链去验证;树验证指每步保留多个候选分支一起验证以提高命中概率,前者验证开销小,后者在输出不确定性高时能用额外验证宽度换接受长度,论文在识别任务发现线性更划算,在翻译任务发现 top-k 为 2 略优,说明选择取决于任务不确定性与验证开销的权衡。
该节的意义在于证明方法不依赖英语特化,但仍需注意多语种训练用了更长的 400K 步,复现时预算要对应增加。
语音翻译更难时加速掉多少
翻译问题要回答从语音到英语文本的跨语言映射下,推测解码是否还划算。比较条件是 Whisper 直接翻译能力、VoxPopuli 4 个到英语方向、草稿长度为 5 但采样 top-k 放宽到 2,加速比与接受长度越大越好,翻译质量变化量为 0 才算无损。放宽 top-k 是为了容纳更大的输出不确定性。
| 翻译方向 | Speedup | τ | ΔBLEU |
|---|---|---|---|
| 德语到英语 | 1.49× | 3.44 | 0.00 |
| 西班牙语到英语 | 1.73× | 3.75 | 0.00 |
| 法语到英语 | 1.66× | 3.60 | 0.00 |
| 意大利语到英语 | 1.59× | 3.49 | 0.00 |
| 平均 | 1.62× | 3.57 | 0.00 |
翻译平均 1.62 倍、接受长度 3.57,明显低于多语识别的 2.09 倍与 4.42,因为同一句话可有多种正确译法,草稿更难命中,验证开销又因 top-k 为 2 而变大。论文进一步用德英方向扫 top-k 发现加速从 1.44 到 1.48 再跌到 1.38,而识别任务中加速随 top-k 单调下降,说明树验证是否有用取决于任务不确定性。限制是翻译只测了这 4 个方向且 top-k 只扫到 4,未测对话等更开放任务常用的更大分支数,因此不能断言树验证在语音任务中永远不如线性。
拿掉每个部件后加速崩在哪里
消融要回答结构、数据与训练策略各自贡献多少。比较条件是 Whisper 目标、同一评测集,加速比与接受长度越高越好,词错误率变化保持 0 说明崩的是速度而非正确性。表前说明每次只去掉一项,其余保持完整,表后逐项解释崩的原因与未胜出项的教训。
| 消融设置 | Speedup | τ | ΔWER |
|---|---|---|---|
| 去掉编码器特征 | 0.89× | 0.08 | 0.00 |
| 去掉融合解码器特征 | 1.35× | 1.84 | 0.00 |
| 去掉自蒸馏数据 | 1.43× | 2.02 | 0.00 |
| 去掉多步生成 | 1.17× | 1.00 | 0.00 |
| 去掉指数衰减加权 | 1.66× | 3.28 | 0.00 |
| 完整 EAGLE-ASR | 1.85× | 3.67 | 0.00 |
表后解释最关键两处崩塌是去掉编码器特征后接受长度仅 0.08 且减速到 0.89,说明无声学接地草稿几乎全被拒;去掉多步生成后接受长度恰为 1.00,说明只会写紧邻下一个词,失去了连续多词能力。去掉融合解码器特征、用人工标注、去掉衰减加权分别跌到 1.35、1.43、1.66,说明多层融合、自蒸馏与前重后轻的损失都有实质贡献。未胜出项是均匀加权,它把容量平均分给更远更难的词,牺牲了决定整段去留的前几个词。限制是消融只在 Whisper 上做,未在 Conformer 上重复,且未报告方差,因此部件重要性排序是否跨模型成立仍待验证。
结论在什么边界外不再成立
论文的无损结论依赖冻结目标模型与严格推测接受准则,理论上输出与原模型一致,实验用变化量为 0 佐证,但这只覆盖所测数据集与贪心附近的解码设置。草稿长度实验显示接受长度随 K 从 2 到 8 单调从 1.82 涨到 4.57,但加速在 K 为 5 约 1.85 处见顶后下滑,因为远处草稿更易被拒而起草与验证开销随 K 增长,K 为 2 到 3 时接受增量 0.84,到 7 到 8 时仅 0.22,说明最优 K 是权衡点而非越大越好。top-k 实验同样显示识别任务中加速随分支数单调从 1.85 跌到 1.54,翻译任务在 top-k 为 2 略有回升后又跌,说明分支数结论随任务而变。
硬件只报单卡 4090,未测边缘设备与高并发服务,未测延迟分布的尾部,也未给出训练与推理的完整耗时与显存分解,因此实际部署收益需按自己的音频时长分布与批大小重测。跨分词器的 Conformer 实验还引入经文字中转的映射,这种处理本身带来开销,不宜把该基线的低分简单理解为推测解码无用。
复现第一步做什么,需要哪些超参数
复现应从拿到目标模型与生成自蒸馏数据开始,而不是直接用人工标注训练草稿。先用冻结的 Whisper-large-v3 或 Conformer 模型把 LibriSpeech 训练音频全部解码,保留 Whisper 特殊前缀,得到蒸馏文本;再按论文实现 Speech-Draft 的两个全连接层、一个 Transformer 解码器块,复用目标嵌入与语言模型头,编码器特征接交叉注意力,多层解码器特征在第一步融合。训练时只更新新增的全连接层与解码器块,目标模型全程冻结,预测深度 K 取 7、衰减因子取 0.8,优化器用 AdamW,峰值学习率 5×10⁻⁵,Whisper 在 LibriSpeech 训 200K 步,批量等效为 8。
推理时设草稿长度 K 为 5、top-k 为 1,翻译改 top-k 为 2,先在 test-clean 上核对加速比与平均接受长度,再核对变化量是否为 0。作者资源当前可用,代码地址已在论文中给出,但代码可用不等于权重可下载与开箱可运行,需区分三者并按仓库说明检查权重与环境。单卡 24 GB 可跑论文评测,更大批量或更长音频需重测显存与最优 K。
什么时候值得尝试,还缺哪项验证
当系统已是自回归注意力编码器解码器、且没有同族小模型可当草稿,或跨模型草稿因分布与分词器不一致而减速时,EAGLE-ASR 值得尝试,因为它用目标内部表示做草稿,兼顾质量与轻量,并在 Whisper 与 Conformer、识别与翻译上都保持无损。复现第一步是生成自蒸馏数据并按冻结目标加多步加权训练出 Speech-Draft,再在自己的音频时长与硬件上重扫 K 与 top-k,不要照搬 5 与 1。
还缺的验证包括低资源语言、噪声与口音、流式分块、长音频尾延迟、批量服务吞吐与完整训练推理成本分解,以及 Conformer 上的消融与多次随机种子的方差。容易产生的误解是把接受长度最高等同于最快,实际上大草稿的计算会抵消收益;把翻译加速低于识别理解为方法失效,实际上是任务不确定性与验证宽度共同作用的结果;把无训练或参数冻结理解为输出确定,实际上无损来自严格验证而非冻结本身,仍需用变化量指标实测确认。
📎 论文与评分元数据
排名:前25% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses