📄 不看内部参数,只看推理过程:用外部全模态向量估计不确定性
英文题目:Estimating Uncertainty of Omnimodal Large Language Models via External Omnimodal Embeddings
标签:#音视频问答 | #不确定性估计与校准 | #多模态模型 | #音视频
评分:5.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
👥 作者与机构
- Iacopo Ghinassi:机构信息未在 arXiv HTML 中可靠披露
- Hy Nguyen Gia La:机构信息未在 arXiv HTML 中可靠披露
- Luke Ong:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
全模态大语言模型同时接收文本、图像、音频和视频并给出推理和答案,难点在于判断答案是否可信,尤其当模型只提供黑盒输出时更难。论文对每个问题采样 6 条思维链,先由辅助模型切分成步骤,再用外部嵌入模型 E5-Omni 3B 把非文本输入、推理步骤和最终答案映射到同一空间,计算贴合度与连贯性分数。贴合度衡量每步与音频或图像输入的最大余弦相似,取平均或最大得到链级分数;连贯性衡量相邻步骤相似、全部步骤两两相似以及后半段是否更靠近答案。链级分数通过加权投票改变同一多数答案的置信度,不需要被评模型的对数概率、隐藏状态、梯度,也不需要再次调用被评模型。在 UNO-Bench 上用 Gemini 3.1 Flash Lite 生成答案时,平均贴合度 \(G_{avg}\) 的平均 AUROC 为 0.6102,高于自一致性的 0.5927,聚合分数相对自一致性平均提高 2.15%。结论适用于黑盒全模态问答的置信度估计,但在音频单模态与某些生成器组合下会失效,校准集只需 25 个左右有标签样本,原文披露了嵌入与采样的额外开销但未给出完整训练成本。
🔗 开源与复现资源
第三方资源:https://anonymous.4open.science/r/Multimodal-CoT-Confidence-Scoring-C12E — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/meituan-longcat/UNO-Bench — 暂时无法访问
第三方资源:https://huggingface.co/Haon-Chen/e5-omni-3B — 暂时无法访问
第三方资源:https://huggingface.co/Qwen/Qwen3.5-9B — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
要解决的是什么不确定性问题
这篇论文处理全模态大模型作答后的置信度问题。输入是一道题加它的非文本媒体,可能是音频、图像或视频,以及文本题干,模型会生成带思维链的多个候选回答,目标是为最终选出的答案给出一个分数,分数高表示更可能答对,低表示应该拒答或转交更强的检查。必须保留的信息是答案是否正确这个二值标签,用来事后评价分数排得准不准。输出不是新答案本身,而是在已有采样基础上的置信度。论文强调黑盒条件:不看被评模型的对数概率、隐状态和梯度,也不再调用被评模型去自我打分,只用外部可观察到的输入、思维链文本和最终答案。
全模态大模型 × 不确定性量化: 全模态大模型指能同时接受文本、图像、音频、视频等输入并作答的模型,不确定性量化指为它的每个答案给出一个可信度分数,用来判断该不该采纳或转交人工,两者搭配的意义是输入越杂、推理越长,越需要一个不依赖内部参数的外部打分。
已有路线为什么不够用
论文把已有工作分成两类。第一类要多次采样,最典型的是自洽投票,看多数答案占多少比例,还有 UMPIRE 这类要读内部状态再调语义体积的方法,以及直接要模型用语言说出信心高低的 3 类自我言语化基线。第二类只看最终答案,不看推理过程。作者指出三点不足:一是依赖内部状态就做不了闭源模型,拿代理模型重算状态又引入相似性假设;二是多为双模态设计,同时有音频加图像加文本时处理吃力。
三是只看答案会丢掉思维链里是否紧扣输入、步骤是否连贯的信息。本文就把切入点放在用外部向量读整条链的几何形态上。
输入、切分与评价如何界定
形式上,非文本输入集合按模态分成若干子集,文本题干被刻意排除在贴合计算之外,这样步骤不能靠复述题干刷高分。模型对每题采样 6 个思维链,每个链有若干推理步骤和一个最终答案。另一个辅助模型只做一件事:把已经生成的思维链切成步骤列表,不参与打分决策。评价时先用语义聚类把 6 个答案归并,选出现次数最多的簇作为被评分答案,不同方法在该答案相同时只比附带的置信度;若出现并列,则各自的平局打破规则可能导致返回答案不同。
指标用 AUROC 衡量把答对排在答错前面的能力,越高越好,用 ECE 衡量分数与正确率的校准误差,越低越好,还用 AURAC 衡量按置信度逐步拒答后保留部分的准确率。
整体流程是怎样的一条线
先看这张总览图,它把输入到输出的主路径画得很直,左边是媒体和文本,中间是黑盒模型,右边是正确与幻觉两条链的示意,正确链步骤聚集且靠近输入,幻觉链步骤分散且远离输入,最后汇成置信度。
看图路径: 1. 先看顶部三类输入如何进入同一个黑盒模型;2. 再对比左右两条链:左侧步骤聚集且靠近输入,右侧步骤分散且远离输入;3. 最后看箭头如何汇成底部的置信度估计
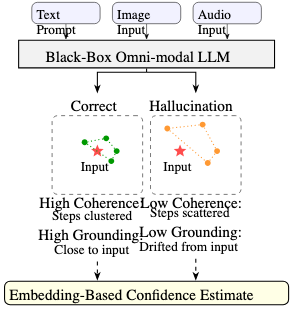
论文图 1。原论文 Figure 1::“We map the omni-modal inputs and generated Chain-of-Thought reasoning steps into a shared semantic space to compute Coherence and Grounding, which grade the majority-selected…”。
这张图实际可见的是顶部 3 个输入框指向黑盒全模态大模型,模型分出正确和幻觉两个虚线框,每个框里有一个代表输入的星形和若干代表步骤的圆点,左侧圆点抱团且贴近星形并标注高连贯高贴合,右侧圆点散开且远离星形并标注低连贯低贴合,底部汇成向量置信度估计。读完要记住论文的直觉:好的推理在向量空间里既不乱跳也不飘离输入。
更细的施工图把上面直觉拆成可计算模块,输入和推理链先过外部全模态编码器进入共享空间,再分两路算贴合与连贯,最后合成每链分数并做跨样本加权。
看图路径: 1. 沿上方四框看主路径:输入、推理链、外部编码器、共享空间;2. 再看下方 A 框算与输入的对齐,B 框算链内部几何;3. 最后看 C 框给出每链分数,D 框做跨样本加权投票

论文图 2。原论文 Figure 2::“Visual overview of the proposed method, as explained in Methodology section.”。
这张大图实际可见的是上方四框依次是输入、推理链、外部编码器和共享空间,中间标注输入直接被编码,下方 A 框列出分模态对齐再取最大并在步骤上平均或取最大,B 框列出平滑、密度和向答案收敛三式,C 框给出逻辑回归聚合,D 框给出几何加权投票公式,右侧列出校准幻觉概率和评测指标。它的作用是把后文公式的输入输出一次摆齐,例子只是示意流程,不代表任何数值效果。
贴合分数如何算与输入的距离
贴合回答一个具体问题:每一步推理文本到底在说输入里的东西,还是在空想。做法是把每个非文本输入和每个推理步骤都用同一个外部编码器变成向量,再算归一化余弦相似度,论文把余弦映射到 0 到 1 之间,值越大表示越像在说同一件事。对第 i 步和第 k 个模态,取该步与该模态所有输入向量相似度的最大值作为该模态对齐,再在模态间取最大得到全模态对齐,直觉是允许一步一次只讲一个模态。
最后在整条链上平均得到平均贴合,取最大得到最贴合一步的分数。另有把整个候选回答看成一段文本再与输入对齐的答案级贴合,作为扩展特征使用,计算代价是每个候选一次向量比较。
外部全模态编码器 × 共享向量空间: 外部全模态编码器指被评模型之外的另一个能同时编码文本、图像、音频的向量模型,共享向量空间指它把不同模态都映射到同一个维度下可比余弦相似度,正因为有这个公共尺子,才能直接算推理文本和音视频输入的距离。
\[\mathcal{S}(x,y)=\frac{1+\cos(\phi_{x},\phi_{y})}{2},\]\[A^{(k)}(r_{i})=\max_{\phi_{v}\in\Phi^{(k)}}\mathcal{S}(\phi_{r_{i}},\phi_{v}),\]\[G_{\text{avg}}=\frac{1}{m}\sum^{m}_{i=1}A^{\mathrm{omni}}(r_{i})\]连贯分数如何看链内部是否乱跳
连贯只看文本输出的几何形状,不直接读媒体。它拆成 3 个可解释的量。局部平滑比较相邻两步的相似度再平均,相邻跳变大就低分。语义密度比较链内所有不同步骤两两相似度再平均,整体松散就低分。答案收敛看步骤是否越往后离最终答案越近,包括平均靠近程度和后半段相对前半段是否更靠近答案的定向项,两项按 0.6 和 0.4 加权,权重是事先固定而非调出来的。对于只有一步的短链,平滑、密度和后半前半划分无定义,实现上直接给最大值,这会抬高简短链的连贯分,在开源生成器上这类短链占比不低,读数时要留心。
贴合 × 连贯: 贴合指推理步骤在向量空间里离非文本输入有多近,回答有没有看输入说话,连贯指步骤之间自己是否紧凑、是否逐步走向最终答案,前者对外找证据,后者对内查自洽,两者合起来才构成对一条思维链的几何检查。
\[S_{\text{smooth}}=\frac{1}{m-1}\sum_{i=1}^{m-1}\mathcal{S}(\phi_{r_{i}},\phi_{r_{i+1}})\]\[S_{\text{dens}}=\frac{1}{m(m-1)}\sum_{i\neq j}\mathcal{S}(\phi_{r_{i}},\phi_{r_{j}})\]单链分数如何变成跨样本置信度
5 维特征拼成向量后,论文用带 L1 正则的逻辑回归拟合答案正确与否,输出正确概率,1 减去它就是不确定性。关键细节是拟合分两步:先在验证集上按 AUROC 网格搜正则强度,再把拟合模型与每个单特征打分比一次,若单特征在验证集上严格更好就直接用单特征替换,所以聚合器常常退化为选一个特征,而不是真正融合 5 个。部署时有两种用法,主协议是答案仍取计数多数簇,几何分只以簇内分数和占总和的比例给该答案附置信度,保证所有方法评同一个答案;主动模式则让加权频率直接选答案,少数但高质量的簇可以翻盘。
自洽投票 × 几何加权: 自洽投票指采样多个答案后按出现频率给多数答案打高分,几何加权指把每条链的贴合连贯分数当作权重再算加权频率,前者只看答案是否一致,后者让推理更扎实的链投票更有分量,组合后多数答案不变但附带的置信度变了。
本研究训练了什么、冻结了什么
本研究没有训练被评的大模型,也没有训练外部编码器。外部编码器用现成的 E5-Omni 的 3B 版本,另用 LCO 的 7B 版本做稳健性复算,编码器参数全程冻结,只做前向编码。唯一需要拟合的是每切分上的逻辑回归聚合器,用验证集上约两成问题的正确标签做监督,验证集规模是音频 200 题、视觉 296 题、选择 1000 题中的 200 题、开放 200 题中的 50 题。论文还做了标注量消融,把校准集抽到 25、50、100、200 例,发现 25 例已基本恢复全量验证集的效果,说明要的是几十例的校准而不是常规训练集。辅助切分用另一模型一次性完成,不计入被评模型的额外调用。
数据、模型与基线在什么条件下比较
数据用 UNO-Bench 的 4 个子集:纯音频 1000 题、纯视觉 1480 题、音频加视觉的选择题 1000 题、音频加视觉的开放问答 250 题,平均列是四切分值的非加权平均,论文明确不用混合池 AUROC 做 headline,因为难易差异会把切分间排序混入切分内区分。生成器一闭一开:Gemini 3.1 Flash Lite 和 MiniCPM-o 4.5,各自每题采样 6 个答案。基线分两族:要多次采样的自洽投票、UMPIRE 以及同编码器算的答案离散度 RDS 和语义体积,另一族要再调一次被评模型的 3 种自我言语化打分。UMPIRE 在闭源生成器上用开源模型做代理取内部状态,在开源生成器上跑原生。所有分数在算 ECE 前按切分做最小最大归一化,该变换不改变 AUROC 排序,但让 ECE 只反映归一化后的 spread,附录另有只在验证集上拟合 Platt 映射的部署视角校准。
主结果在多大程度上优于自洽投票
主比较的问题是几何分能否在同一答案上给出更好的排序,条件是答案固定为多数簇、只比置信度,指标方向是 AUROC 越高越好、ECE 越低越好。下表把闭源生成器下的平均表现收拢为三行,几何平均贴合最高,自洽投票最低,离散度基线居中,开放式全模态切分是几何分拉开差距的地方,但音频切分上所有基于一致的信号都会反转。
| 条件 | 指标 | 自洽投票 | 本方法几何分 | 离散度基线 |
|---|---|---|---|---|
| Gemini 平均 | AUROC | 0.5927 | 0.6102 | 0.6017-0.6038 |
| Gemini 平均 | 相对提升 | 0 | +2.15% | — |
| MiniCPM 平均 | AUROC | 0.6559 | — | — |
这组平均数直接比较了固定答案下的置信度排序,闭源生成器下聚合器平均相对自洽投票提升约 2% 且在三切分上显著,选择题切分基本持平,开源生成器下平均提升不到 1% 且开放式全模态切分仍是损失,所以不能说全面超越。限制是 MO 切分测试仅 200 题,区间最宽,且短链按最大连贯处理会让开源侧的连贯分虚高。
另一张表把开源侧的成对差异摆出来,同样只在固定答案下比置信度。
| 条件 | 指标 | 自洽投票 | 聚合器相对变化 | 开放问答变化 |
|---|---|---|---|---|
| MiniCPM 平均 | AUROC | 0.6559 | +0.66% | -1.20% |
| MiniCPM 音频 | AUROC 相对 | — | +1.82% | — |
| MiniCPM 选择 | AUROC 相对 | — | +0.85% | — |
| MiniCPM 视觉 | AUROC 相对 | — | +1.19% | — |
与之对照的另一面是:开源侧原生 UMPIRE 在单模态上领先且校准更好,最强自我言语化基线在平均判别上追平聚合器,几何分的优势集中在开放式全模态问答。
第三张表给出可部署聚合器与事后按测试集选最优单信号的上界差距,提醒读者上界不可部署。
| 条件 | 可部署聚合器 | 事后最优上界 | 差距含义 |
|---|---|---|---|
| Gemini 平均 | +2.15% | +4.29% | 选择不准丢约一半 |
| MiniCPM 平均 | +0.66% | +2.61% | 同上 |
| Gemini 音频胜者 | Gavg | 100 轮全胜 | 排序本身稳定 |
胜者是谁在重复实验中很稳定,不稳定的是小验证集对排序的估计,所以加大校准集或换低方差选择规则可能追回一部分,但论文也证明用 25 例与全量差异不大,追回空间有限。
先看打乱媒体的对照图,它检验贴合分是否真在读本题媒体,上排是直接读分数,下排是经过投票归一后的部署形态。
看图路径: 1. 先看上排两图:蓝色圆点是真实媒体的分数,橙色带是打乱媒体的零分布;2. 再看下排两图:经过投票归一化后蓝点与橙带的差距是否缩小;3. 注意纵轴是 AUROC,虚线是 0.5 的随机水平

论文图 6。原论文 Figure 6::“Media-permutation control for G^avg_ans.”。
这张图实际可见的是四宫格,上排两图纵轴约 0.4 到 0.6,蓝色圆点多在橙色 95% 带之上,下排两图纵轴约 0.4 到 0.75,蓝点几乎压在橙色均值线上,说明真实媒体确实让问题级贴合分更高,平均高约 0.027,但经过题内归一后只剩 0.003 到 0.007,落在随机带内。它的限制是只能重算答案级贴合,逐步贴合不在检验内,且问题级贴合本身判别绝对值仅 0.517 到 0.541。
去掉一致信号后还剩多少信息
论文做了固定一致份额的分层 AUROC:在同一多数票份额内自洽投票恒为 0.5,任何高于 0.5 的都算几何或离散度额外提供的信息。结果是 conditioning 拿掉大部分判别,中位损失约 0.131,但残余显著且分工不同:几何信号在 Gemini 视觉、Gemini 选择、MiniCPM 音频和 MiniCPM 开放问答上保留高于 0.5,离散度基线在 Gemini 音频上反而从约 0.69 涨到约 0.75,在 MiniCPM 音频和视觉上也保留,全模态切分上离散度归零而连贯分在 MiniCPM 开放问答上保留 0.6009。这支持两者互补而非谁包含谁,也框定了主张:超出一致之外的增量真实但小,且集中在特定生成器与模态组合。
第四张表把这种互补量化为相关性和失败集重叠,几何家族内部高度相关,与离散度则明显解耦。
| 对象 | Gemini 相关 | MiniCPM 相关 | 最不自信十分位重叠 | 媒体打乱增益 |
|---|---|---|---|---|
| 几何内部 | 0.906 | 0.942 | 0.406-0.764 | — |
| 几何对离散度 | 0.408 | 0.229 | 0.073-0.107 | — |
内部 0.91 到 0.94 的相关意味着聚合器无多样性可利用,所以退化为单特征、组合不胜过单选、验证选择仅与事先固定一个好信号打平;而与离散度的低相关和几乎不相交的失败集预示混合能消掉低于随机的切分,代价是方差和校准变差。未胜出项是混合在开放问答和校准上相对纯几何分略有损失,说明简单拼接不是最优融合。
哪些消融决定了结论的边界
特征消融显示验证选出的聚合器很稀疏,多在单切分上退为单个特征,选择题切分上甚至退为常数打分即多数票份额,去掉平滑主要伤开放问答,去掉平均贴合主要伤音频,相干只用与贴合只用都不如全量轮廓完整。换编码器到 LCO 后聚合器平均 AUROC 从 0.6046 到 0.6008 基本不动,开放问答上仍是最强族,但领头的单信号从平均贴合换成收敛,说明聚合的稳健正在于用选择对冲单信号随编码器的漂移。注意力式贴合在开放问答上最差,因为它奖励单步只押一个模态,而开放问答恰需同一步融合音视频,归一化也吃掉了题级贴合,这是设计上的错配而非实现失误。
答案离散度 × 链几何: 答案离散度指多个候选答案在向量空间里散得多开,只看答案之间分歧,链几何指单条链内部步骤是否聚集、是否贴住输入,只看一条推理的质量,两者信息来源不同,所以一个在音频上救场、一个在全模态开放问答上更强,可以互补而非互相替代。
结论在什么条件下才成立
第一,增益是小幅且条件性的,闭源生成器系统性、开源生成器切分依赖,开放问答样本最小所以误差最大,不能推广为通用提升。第二,几何八信号本质是同一底层量的多种读数,融合不带来协同,校准集的价值在于避开在目标组合上反转的信号,而不是学出更强的组合。第三,音频加闭源生成器的反转不只出现在几何分,自洽投票的 Platt 斜率同样为负,说明是该生成器在音频上的答案分布问题,离散度能修但几何分不能,部署前必须按模态在小标注集上验方向。第四,混合池 AUROC 不可做 headline,它会把切分难易的尺度差当成判别力,论文用非加权切分平均正是为了去掉这部分。
复现第一步做什么、需要多少资源
复现从拿到 UNO-Bench 四切分和两组每题 6 个的思维链开始,论文放出了特征、答案、链与正确标签,闭源链因 API 可变必须用放出的数据才能精确复现。接着用冻结的外部编码器一次性编码输入、步骤与答案,按余弦公式算 5 个链级分,再按二成验证集拟合逻辑回归并做单特征替换,最后在保持答案固定下算分层与非分层 AUROC。单链约 5 步,密度项二次复杂度可忽略,主要开销是 3B 编码器在单卡上的一次前向,远小于 6 条约 15500 词元的采样成本和自我言语化多一次同量级调用。
代码与环境在匿名仓库给出,Python 3.12 加常见科学计算栈,随机种子与 100 轮划分细节在附录。作者资源当前可用只能看第三方可达性写,本文不做超出证据的开源断言。
什么时候值得尝试、还缺哪项验证
当你的场景是黑盒全模态、不能读内部状态、又有多步推理可看,且问题是开放式、需对照音视频证据逐条核查时,值得先试平均贴合或平滑单信号,再用几十例目标模态标注做方向校验;若你的瓶颈是音频上的一致反转,优先试答案离散度或两者门控混合,而不是只调链几何。复现第一步是跑通外部编码加聚类加权的全链路,并复现分层 AUROC 与媒体打乱两项诊断。还缺的验证是需要答案必须跨模态合成才能解出的基准来证明真正的多模态综合,以及更谨慎的按切分门控融合与部署视角校准,只有补上这两项,才能把小幅判别增益变成可上线的拒答收益。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses