📄 强化学习搜索如何找到轻量音视语音增强网络
标签:#语音增强 | #强化学习 | #音视频 | #高效推理
评分:5.5/10 | 创新 1.2/2 | 技术严谨 0.8/1.5 | 实验充分 0.8/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Khubaib Ahmed:机构信息未在 arXiv HTML 中可靠披露
- Ahsan Adeel:机构信息未在 arXiv HTML 中可靠披露
- Nasir Saleem:机构信息未在 arXiv HTML 中可靠披露
- Kia Dashtipour:机构信息未在 arXiv HTML 中可靠披露
- Ahsan Ulhaq:机构信息未在 arXiv HTML 中可靠披露
- Amir Hussain:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音视频语音增强以带噪语音和唇部视频为输入,输出增强后的目标语音,难点在于双流时间对齐、融合方式选择以及大模型难以部署到算力受限设备。论文先构造受约束的搜索空间,只保留保持时间分辨率和通道兼容的操作,把搜索起点放在已有大模型附近,再由强化学习智能体每次修改一个维度并用短轮训练估计效果。奖励函数同时考虑语音质量保持、超出参数预算的惩罚和对违规结构的惩罚,搜索过程逐步向紧凑结构收缩。与手工压缩和随机搜索的差异在于用约束掩码屏蔽非法动作,并用多目标奖励显式平衡质量与体积,还报告了视觉通路可大幅简化等结构规律。在 LRS3 数据集与 CEC2 噪声测试集上,搜索得到的轻量模型取得 14.5 dB 的尺度不变信噪比提升,与 22.0M 参数基线的 15.2 dB 相比保留约 95.4% 性能,参数量为 2.9M,移动端实时率约为 0.19。该结论只在上述数据集、噪声范围和测试硬件条件下成立,未验证跨数据集、跨噪声类型和低比特部署的表现。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
音视语音增强要处理什么输入和输出
音视语音增强的输入是两路同步信号:一路是麦克风录到的含噪语音,混有咖啡馆人声、车辆行驶等背景干扰;另一路是说话人嘴唇区域的视频帧序列。目标是输出增强后的干净语音波形或时频掩码重建的语音,尽量保留目标说话人的内容和音质,同时去掉干扰。必须保留的信息包括语音的时间结构和语言内容,以及唇动与语音帧之间的时间对齐关系,不能为了压缩而打乱两路的时间对应。评价时论文用 SI-SNR 提升,衡量增强后信号与干扰加噪声比的改善,单位为 dB,数值越大越好;同时报告手机 CPU 上的实时因子,越小表示推理越快。
含噪语音 × 唇部视觉: 含噪语音指麦克风采集的带背景噪声的声学信号,是增强对象;唇部视觉指同步视频中的嘴唇运动,提供与语音内容相关的互补线索;两者组合的意义是当声学严重退化时,视觉分支为时序建模提供不受声学噪声影响的对齐参考。
对刚入门的读者,可以把任务想成一个例子:比如一段 3 秒的嘈杂录音配合同期唇部视频,系统要利用看到的口型辅助判断当前音素,从而在噪声下更准确地恢复语音。这里的例子只是帮助理解输入输出形态,不代表论文给出过该样本的具体分数。
已有路线为什么还是又大又难部署
论文回顾了 3 条相关路线。第一是音视增强本身,从 LipNet 等视觉语音基础,到 AVSEGAN 和 Conv-TasNet 变体,质量不断提高,但参数经常超过 22M,手机、助听器和嵌入式设备装不下。第二是语音领域的神经结构搜索,如 ST-NAS 用于端到端语音识别、NAS-TDNN 用于时延神经网络,证明搜索到的结构可以匹配人工设计,但多集中在单音频模态。第三是高效与多模态搜索,包括参数共享、硬件感知的 ProxylessNAS、预测器方法和多目标优化,以及移动端 MobileNets 等压缩思路。
论文指出,多模态搜索的难点在于音频与视觉两条通路互相依赖、搜索空间巨大,还必须保持时间同步,而已有工作多针对视觉或文本,对语音的硬件感知搜索涉及较少。因此本文不是重复单模态压缩,而是在相同输入都是音视同步信号、目标都是在保持 SI-SNR 下减小的条件下,比较人工小模型、随机搜索和强化学习搜索的效率差异。
论文要解决的具体部署矛盾是什么
具体矛盾是高质量与可部署性冲突:22M 参数的音视基线在 CEC2 噪声集上能达到 15.2 dB 的 SI-SNR 提升,但 0.82 的实时因子和大内存占用不适合边缘实时交互;直接手工缩小容易损失质量,且人工试错难以系统权衡音频通路、视觉通路、时序建模深度和宽度的分配。论文把问题定义为在约束下自动发现紧凑结构:在保持时间对齐、通道兼容和计算上界的前提下,用很少的候选评估找到接近基线质量的小模型。搜索预算被明确限制为只评估 35 个候选结构,目标参数约 2.9M,最终要在商用移动 CPU 上实现明显更低的实时因子。结论成立的条件是 LRS3 训练、CEC2 噪声、SI-SNR 提升和 Intel i7-1185G7 移动 CPU 的测量环境,换数据集或硬件则数值会变化。
整体搜索流程如何从大模型走向小模型
整体流程是从 22M 参数的高性能基线出发,逐步收缩而不是从零随机搭建。强化学习智能体在每个回合观察当前结构的状态向量,选择增大或减小某 1 维度的动作,经约束检查后得到新结构;每个新结构训练 10 个轮次并评估 SI-SNR 和参数量,计算多目标奖励;一个回合内走 5 步,收集轨迹后用 PPO 更新策略,下一回合从轨迹中最优结构继续出发。论文共进行 35 个回合,按每回合 5 步、每步 10 轮次评估,合计 1750 轮次等价计算量,远少于随机搜索所需的数千轮次。
流程中有 3 个关键分工:约束搜索空间保证结构合法且对齐,奖励函数指明压缩与保质量的权衡方向,渐进收缩策略提供课程式的 warm start,使智能体始终在高性能区域附近探索紧凑变体。具体执行上,智能体用两层各 256 个单元的长短期记忆网络记录结构调整顺序,末端分出动作选择头和状态价值估计头,分别负责给出动作概率和估计当前结构的价值。状态向量同时记录编码器通道、瓶颈通道、重复数等结构量以及当前参数量和 SI-SNR,使智能体兼顾结构形状与实测效果。
动作选择前先用掩码滤除违反时间对齐、通道兼容和计算量上界等约束的候选,保证音频与视觉分支的时间分辨率一致、跳连与融合在数学上可行。奖励分为三部分:保真部分鼓励维持 SI-SNR,效率部分只在参数量超出 2.9M 目标后计入压缩压力,约束部分对违规结构施加重罚。每回合结束后用收集到的五步轨迹做一次 PPO 更新,再从轨迹中效果最好的结构开始下一回合,从而一步一个维度地试探收缩后果。
搜索空间用什么约束保证时间对齐
搜索空间只包含编码器通道、瓶颈通道、TCN 每重复块数、重复次数、扩张比例和视觉输出通道 6 个维度,选项均为离散值,例如编码器通道取 128、192、256。论文施加 3 类约束:时间一致约束要求音频与视觉通路时间分辨率相同,只用保持维度的点卷积和残差连接;通道兼容约束要求瓶颈通道不超过编码器通道,以保证跳连和融合的数学合法性;计算上界约束限制重复数与块维度的乘积,防止内存爆炸。这些约束把无约束下约 1e14 量级的组合压缩到 324 种有效配置。教学上可以理解为先用领域知识划出安全区,再让智能体在安全区内挑选宽度和深度的组合。
时间卷积网络 × 扩张卷积: 时间卷积网络指用一维卷积沿时间轴建模长时依赖的增强主干;扩张卷积指在卷积核元素之间插入间隔以扩大感受野的操作;两者搭配的原因是语音增强需要覆盖较长上下文,而扩张可以在不明显增加参数的情况下扩大时间视野。
状态、动作和奖励各自负责什么
搜索被建模为有限时域马尔可夫决策过程。状态向量编码结构参数和已积累的性能,原文用归一化形式表示,包含编码器、瓶颈、重复、块数、隐藏维度比例、参数相对 22M 的比例和 SI-SNR 相对 15.2 的比例。动作空间是 6 个维度各自增大或减小的 12 个离散操作,并用约束感知动作掩码过滤非法转移。奖励同时考虑三项目标:保真项鼓励 SI-SNR 接近基线,效率项只在参数超过 2.9M 目标时惩罚超额部分,约束项对违反约束施加大的惩罚,系数取 1.0、0.7 和 10。先看符号含义再看计算目标:状态是智能体的眼睛,动作是改结构的双手,奖励是告诉它改得好不好。
\[s_{t}=\left[\frac{E}{256},\frac{B}{256},R,X,\frac{H}{B},\frac{\text{Params}}{22M},\frac{\text{SI-SNR}}{15.2}\right]\]该状态公式把不同量纲的通道数、参数量和 SI-SNR 都归一化到可比范围,使 LSTM 策略网络能同时感知结构大小和当前质量。
保真项 × 效率项: 保真项指奖励中鼓励 SI-SNR 提升接近基线的部分;效率项指当参数超过 2.9M 目标时施加惩罚的部分;两者搭配是为了把搜索推向帕累托前沿,即在保持可懂度和质量的同时压缩模型,而不是一味变小或一味保性能。
\[R(s_{t})=\underbrace{\alpha\frac{\Delta\text{SI-SNR}}{\text{Baseline}}}_{\text{Fidelity}}-\underbrace{\beta\max\left(0,\frac{\text{Params}}{\text{Target}}-1\right)}_{\text{Efficiency}}-\underbrace{\gamma\mathbbm{1}_{\text{Violation}}}_{\text{Constraint}}\]该奖励公式的含义是质量归一化后加分、超预算后扣分、违规则重罚,其中适度的效率系数避免把搜索推向过小而无效的模型。
策略网络如何选动作并估计价值
策略网络的主体是两层各 256 单元的 LSTM,用于记忆结构变换序列中的依赖关系。输入是上述状态向量,依次经过两层 LSTM 后分出两个头:演员头经线性层加 softmax 输出动作概率分布,价值评估模型头经线性层输出当前状态的价值估计,用于优势计算。原文用基线 22M 结构的学习嵌入初始化 LSTM,相当于给搜索一个好的起点。动作掩码放在演员头之后,只保留满足约束的动作,从机制上比单纯靠奖励惩罚更快收敛。
读图说明如下:下面这张官方结构图展示了从状态到动作和价值的两条输出路径,重点看分支位置和掩码的作用,理解约束是在选动作时直接生效而不是事后纠正。
看图路径: 1. 先从左侧状态向量沿箭头看到两层 LSTM 的串行主路径;2. 再看第二层 LSTM 之后分叉为演员头和价值评估分支的位置;3. 确认演员头之后经过动作掩码才输出动作的约束位置;4. 对比上下两条输出分别对应动作和状态价值估计
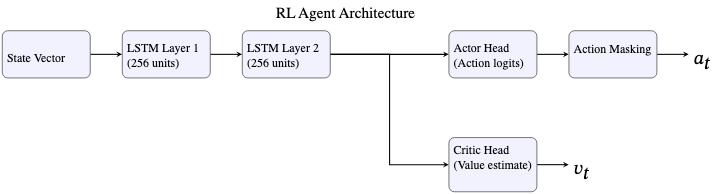
论文图 1。原论文 Figure 1::“Policy network architecture: LSTM processor with specialized heads for action selection and value estimation. Action masking enforces architectural constraints.”。
图中可见状态向量从左进入两层 LSTM 串行处理,然后在第二层之后分叉,一路上行经演员头和动作掩码输出动作,下路经价值评估分支输出价值估计。箭头方向表明掩码是动作选择前的最后一道过滤,价值分支不经过掩码。这种设计对应原文的约束感知探索,使采样始终落在有效结构空间内。
PPO 更新和渐进收缩如何实际执行
训练采用近端策略优化,其裁剪目标限制新旧策略概率比的变化幅度,防止一次更新过大导致遗忘或震荡。实现上用 epsilon 贪心探索并结合动作掩码,用 AdamW 优化器、学习率 3e-4、权重衰减 1e-2,4 个并行工作者同时评估结构,广义优势估计参数取 0.95 以降低方差。渐进收缩的具体做法是每步只改一个维度以保持结构有效,每步训练 10 轮次后用历史数据拟合的线性回归外推完整训练的 SI-SNR,从而降低评估成本;每回合 5 步后用 PPO 更新,再从最优结构开始下一回合。
\[L^{\text{CLIP}}(\theta)=\mathbb{E}_{t}\left[\min\left(r_{t}(\theta)\hat{A}_{t},\text{clip}(r_{t}(\theta),1-\epsilon,1+\epsilon)\hat{A}_{t}\right)\right]\]该公式中概率比衡量新旧策略差异,优势估计衡量动作好坏,裁剪系数取 0.2 把更新约束在可信区间内。需要说明的是,论文没有报告消融掉掩码或外推后必然怎样,原文只给出带掩码比纯惩罚快约 40% 的结论性描述,缺少对照细节则不能自行推断实现差异。
数据、噪声、基线和测量条件是什么
语音视频来自 LRS3,论文称包含 438 小时同步音视语音;噪声来自 CEC2 挑战的噪声集,覆盖 hearing aid 场景,信噪比范围为 -5 dB 到 5 dB。指标是 SI-SNR 提升,单位 dB,越大越好;同时在 Intel i7-1185G7 移动 CPU 上测实时因子,越小越快。基线包括 5.2M 参数的纯音频基线、22M 参数的音视基线、6.1M 的手工小模型、2.4M 的随机搜索最优,以及本文 2.9M 的搜索最优。比较的公平条件是同一 CEC2 测试集和同一指标方向,但论文未详细给出划分、聚合方式和统计显著性,因此均值差异的稳健性只能按原文报告理解。
SI-SNR 提升 × 实时因子: SI-SNR 提升指增强后信号与干扰加噪声比相对输入的改善量,单位为 dB,越大表示去噪越多;实时因子指处理耗时与音频时长的比值,越小表示在手机 CPU 上越快;两者组合才能同时回答增强质量和能否实时部署,缺一不可。
小模型在质量和速度上达到什么水平
核心问题是 2.9M 模型能否在大幅压缩下保持接近基线的质量并实现实时。下表比较 5 种实际可运行策略在相同 CEC2 测试集上的参数量、SI-SNR 提升和 CPU 实时因子,参数越少越轻,SI-SNR 提升越大越好,实时因子越小越快,重点看压缩比、质量保留率和速度收益。
| Model | Params (M) | SI-SNRi (dB) | RTF (CPU) |
|---|---|---|---|
| AVSE baseline | 22.0 | 15.2 | 0.82 |
| Handcrafted small | 6.1 | 14.8 | 0.31 |
| Random search best | 2.4 | 13.9 | 0.22 |
| NAS-optimized (ours) | 2.9 | 14.5 | 0.19 |
搜索最优以 2.9M 参数达到 14.5 dB,仅比 22M 基线的 15.2 dB 低 0.7 dB,保留约 95.4% 性能而参数只有约 13%,压缩约 9 倍;实时因子从 0.82 降到 0.19,原文称处理 3 秒音频约需 570 毫秒,并称移动 CPU 上降低 4.3 倍,具备实时交互可行性。相比 6.1M 手工小模型的 14.8 dB,搜索模型以更少参数只低 0.3 dB;相比 2.4M 随机搜索最优的 13.9 dB,搜索模型高 0.6 dB,支持强化学习引导比随机更有效。执行上智能体从基线出发逐步缩减编码器、瓶颈、重复数、块数和视觉通道,每步保持时序对齐和通道兼容约束,并用奖励函数权衡保真与压缩。但限制是这组数字只在原文软硬件和噪声条件下成立,未报告不同噪声类型、信噪比分段和多次运行方差,也未给出主观听感评估。
强化学习智能体 × 动作掩码: 强化学习智能体指根据状态选择压缩或调整结构动作、并用奖励优化策略的搜索控制器;动作掩码指只允许满足时间对齐和通道兼容约束的合法动作通过的过滤机制;组合后智能体只在有效结构空间内探索,避免浪费评估在非法结构上。
搜索轨迹中每一步压缩付出多少质量
另一个问题是渐进收缩是否平稳,即每步减参带来多少 SI-SNR 损失和奖励变化。下段用原文连续句整理的表格呈现从 22M 到 2.9M 的 6 个关键阶段,参数单位为 M,SI-SNR 提升单位为 dB,奖励无量纲,重点观察早期大压缩几乎不掉点、后期视觉剪枝仍可接受的模式。
| Step | Params (M) | SI-SNRi (dB) | ΔSI-SNR | Reward | Key Changes |
|---|---|---|---|---|---|
| 0 | 22.0 | 15.2 | 0.00 | 0.00 | Baseline |
| 5 | 16.2 | 15.1 | -0.1 | 0.72 | E:256→192 |
| 10 | 8.4 | 15.0 | -0.2 | 1.25 | B:256→192 |
| 15 | 5.1 | 14.9 | -0.3 | 1.87 | R:4→3 |
| 20 | 3.8 | 14.7 | -0.5 | 2.01 | X:8→6 |
| 25 | 3.1 | 14.6 | -0.6 | 2.13 | H:2.5→2.0 |
| 30 | 2.9 | 14.5 | -0.7 | 2.31 | V :256→128 |
表后解释如下:轨迹显示编码器从 256 降到 192 带来 26.5% 参数减少而 SI-SNR 几乎不变,随后瓶颈、重复数、块数和扩张比逐步收缩,最终视觉通道减半到 128 时累计损失 0.7 dB 而奖励升到 2.31,说明奖励函数确实引导了以小幅质量换大幅压缩。代价是每步评估只训练 10 轮次并用线性外推估计完整性能,外推误差未量化;且轨迹只展示 5 条并行搜索中的最优一条,不能代表平均搜索行为。未胜出的情况是大量中间候选未被展示,其失败模式原文没有分析。本表数值与单位依据论文 PDF。
哪些结构选择对轻量化和质量最关键
论文没有传统意义的逐模块消融,而是用搜索发现的结构规律回答效率来源问题。下表按数据、搜索、候选评估与部署 4 个环节固定协议,避免把架构搜索预算和单次推理成本混为一谈。
| 流程 | 输入与数据 | 处理方式 | 预算与评估 | 适用条件 |
|---|---|---|---|---|
| 候选评估 | LRS3 同步视听和 CEC2 噪声 | PPO 与约束动作掩码,渐进收缩 | 每个候选训练 10 epochs 后线性外推 | 快速估计候选质量,不等同完整训练后的精确表现 |
| 搜索成本 | 受约束的架构搜索空间 | 每轮只修改一个结构维度 | 35 episodes、每轮 5 steps、每次 10 epochs,共 1,750 epoch-equivalents | 这是原文的训练轮次等价成本,不是 GPU 小时测量 |
| 性能评价 | CEC2 Test Set | SI-SNR improvement 与 CPU 实时因子 | 与音频基线、视听基线、手工小模型和随机最优比较 | 主要质量和速度数值见前述性能表,不与未测试数据混比 |
| 部署测量 | 3-second audio files | Intel i7-1185G7 mobile CPUs | real-time factor 0.19,approximately 570 milliseconds | 实时性限于原文报告的移动 CPU 配置 |
搜索按渐进收缩执行,先从 22M 基线出发,每轮只改一个结构维度,每次训练 10 个轮次后用线性回归外推完整训练性能,再用近端策略优化更新策略,共 35 轮评估、每轮 5 步。最终收益是系统搜索在相近参数预算下比随机高 0.6 dB,且原文称比随机搜索效率高 92%。机制上搜索偏好更浅但更宽的时间卷积块,即 3 重复 6 块、扩张比 2.0,而非深窄堆叠;同时容忍视觉通路激进剪枝,从 256 降到 128 仅带来约 0.3 dB 退化,原因是唇动几何信息相对声谱模式更简单。
但限制是这些规律来自单次搜索空间和单数据集,未在 LibriSpeech 等其他数据或不同融合方式下验证,也未报告去掉某一约束后规律是否仍然成立,因此只能视为在该空间内的经验发现而非通用定律。
原文另将穷举随机搜索的参考成本描述为 5,000+ epochs,而本方法的上述预算为 1,750 epoch-equivalents;这两个量都是训练轮次量级,不能当作实测 GPU 小时。
结论在什么边界之外不再成立
首先是泛化边界:噪声仅用 CEC2 集,信噪比集中在低区间,未评测未见噪声类型、高信噪比和跨数据集表现,不能把 14.5 dB 推广到所有场景。其次是统计边界:未报告多次搜索的方差、显著性检验和主观 MOS,0.3 dB 或 0.6 dB 的差异在单次运行下需谨慎解读。再次是成本边界:1750 轮次等价计算仍不小,且每候选 10 轮次加线性外推可能低估长训练下的排序变化;推理只报实时因子,未拆分内存峰值、功耗和不同手机芯片的延迟。最后是方法边界:量化感知搜索、自适应门控和跨模态注意力等扩展都只是展望,未实际验证。把相关性当因果、把单点速度当所有设备速度,都会夸大论文价值。
复现第一步要准备什么
复现应从环境和基线开始:准备 LRS3 音视数据与 CEC2 噪声混合流程,按 -5 dB 到 5 dB 构造训练和测试对;实现 22M 音视基线并复现 15.2 dB 和 0.82 实时因子的参考点,否则后续压缩无从比较。然后按表 1 约束实现 324 种有效配置的采样器,确保时间分辨率不变、瓶颈不超过编码器、重复与块维度乘积受限;实现状态归一化、12 动作掩码和三项奖励,系数取 1.0、0.7、10,目标 2.9M。搜索时从基线出发,每步单维度修改、每候选训练 10 轮次并记录 SI-SNR 与参数,用 PPO 更新,35 回合后取最优全量训练验证。
关键超参数和信息条件都要保留:LSTM 两层 256 单元、PPO 裁剪 0.2、AdamW 学习率 3e-4、4 并行、优势估计 0.95。关于来源,本次未发现可验证的作者代码、模型或数据公开资源,因此不能声称已开源或可下载,需自行实现。
什么时候值得尝试还缺哪项验证
当任务确实有同步唇部视频、部署目标是手机或助听器等弱算力设备、且能接受 0.7 dB 左右的质量损失换取 9 倍压缩和数倍速度时,值得尝试该收缩思路;若只有纯音频或对质量零容忍,则不应直接套用视觉剪枝结论。复现第一步是先跑通基线和约束采样器,确认合法空间和奖励计算无误,再启动小预算搜索。还需要补的验证包括分信噪比和分噪声类型的表现、多次搜索的稳定性、主观听感、不同 CPU 和功耗测量,以及与剪枝和量化结合后的额外收益。只有补齐这些,才能判断 2.9M 结构是真正可部署的最优还是特定条件下的单点最优。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses