📄 在不动结构的前提下给文本模型加上图像和音频理解
英文题目:Apertus 1.5: From Open Text Models to Open Multimodal Reasoners
ℹ️ 本文基于论文全文节选生成,超出分析上下文上限的内容未纳入。
标签:#音频理解 | #多模态学习 | #多模态模型 | #模型权重 | #多语言
评分:7.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1.5/1.5
👥 作者与机构
- Project Apertus:机构信息未在 arXiv HTML 中可靠披露
- Yixuan Xu:机构信息未在 arXiv HTML 中可靠披露
- Yassine Turki:机构信息未在 arXiv HTML 中可靠披露
- Vinko Sabolčec:机构信息未在 arXiv HTML 中可靠披露
- Valentina Pyatkin:机构信息未在 arXiv HTML 中可靠披露
- Tommy Chu:机构信息未在 arXiv HTML 中可靠披露
- Sven Najem-Meyer:机构信息未在 arXiv HTML 中可靠披露
- Sean F. Carroll:机构信息未在 arXiv HTML 中可靠披露
- Robert Smith:机构信息未在 arXiv HTML 中可靠披露
- Raphael Kreft:机构信息未在 arXiv HTML 中可靠披露
- Oscar Alessandro Tazza:机构信息未在 arXiv HTML 中可靠披露
- Oleg Lavrovsky:机构信息未在 arXiv HTML 中可靠披露
- Nicola Irmiger:机构信息未在 arXiv HTML 中可靠披露
- Matteo Santelmo:机构信息未在 arXiv HTML 中可靠披露
- Marian Schneider:机构信息未在 arXiv HTML 中可靠披露
- Juan García Giraldo:机构信息未在 arXiv HTML 中可靠披露
- Hanna Yukhymenko:机构信息未在 arXiv HTML 中可靠披露
- Eduard Ďurech:机构信息未在 arXiv HTML 中可靠披露
- Davit Melikidze:机构信息未在 arXiv HTML 中可靠披露
- Dani Tamayo:机构信息未在 arXiv HTML 中可靠披露
- Bettina Messmer:机构信息未在 arXiv HTML 中可靠披露
- Aryan Ahadinia:机构信息未在 arXiv HTML 中可靠披露
- Anunay Yadav:机构信息未在 arXiv HTML 中可靠披露
- Allen Huang:机构信息未在 arXiv HTML 中可靠披露
- Ahmad Fraij:机构信息未在 arXiv HTML 中可靠披露
- Alessandro Bombarda:机构信息未在 arXiv HTML 中可靠披露
- Alex Padula:机构信息未在 arXiv HTML 中可靠披露
- Alexander Hägele:机构信息未在 arXiv HTML 中可靠披露
- Alexander Sternfeld:机构信息未在 arXiv HTML 中可靠披露
- Anna Hedström:机构信息未在 arXiv HTML 中可靠披露
- Anna Kosovskaia:机构信息未在 arXiv HTML 中可靠披露
- Arthur Wuhrmann:机构信息未在 arXiv HTML 中可靠披露
- Arundhati Balasubramaniam:机构信息未在 arXiv HTML 中可靠披露
- Badr Al Mahouri:机构信息未在 arXiv HTML 中可靠披露
- Barna Pasztor:机构信息未在 arXiv HTML 中可靠披露
- Bartosz Szostakiewicz:机构信息未在 arXiv HTML 中可靠披露
- Bich Ngoc Doan:机构信息未在 arXiv HTML 中可靠披露
- Bryan Schmid:机构信息未在 arXiv HTML 中可靠披露
- Burak Sezen:机构信息未在 arXiv HTML 中可靠披露
- Camille Challier:机构信息未在 arXiv HTML 中可靠披露
- Clément Charmillot:机构信息未在 arXiv HTML 中可靠披露
- Dana Shayakhmetova:机构信息未在 arXiv HTML 中可靠披露
- Daniel Perruchoud:机构信息未在 arXiv HTML 中可靠披露
- David Brüggemann:机构信息未在 arXiv HTML 中可靠披露
- David Isztl:机构信息未在 arXiv HTML 中可靠披露
- Elia Palme:机构信息未在 arXiv HTML 中可靠披露
- Emma Anastassova:机构信息未在 arXiv HTML 中可靠披露
- Fabian Bösch:机构信息未在 arXiv HTML 中可靠披露
- Faruk Zahiragić:机构信息未在 arXiv HTML 中可靠披露
- Fawzi Roberto Mohamed:机构信息未在 arXiv HTML 中可靠披露
- Fiona Panicali:机构信息未在 arXiv HTML 中可靠披露
- Florian Kolly:机构信息未在 arXiv HTML 中可靠披露
- Flynn Guerra:机构信息未在 arXiv HTML 中可靠披露
- Francesco Monti:机构信息未在 arXiv HTML 中可靠披露
- Frederike Lübeck:机构信息未在 arXiv HTML 中可靠披露
- Gennaro Oliva:机构信息未在 arXiv HTML 中可靠披露
- Haofeng Yang:机构信息未在 arXiv HTML 中可靠披露
- Haoliang Shang:机构信息未在 arXiv HTML 中可靠披露
- Helen El Khoury:机构信息未在 arXiv HTML 中可靠披露
- Henrique Mendonça:机构信息未在 arXiv HTML 中可靠披露
- Jannis Vamvas:机构信息未在 arXiv HTML 中可靠披露
- Jérome Landolt:机构信息未在 arXiv HTML 中可靠披露
- Jessica Lam:机构信息未在 arXiv HTML 中可靠披露
- Jingchun Xiao:机构信息未在 arXiv HTML 中可靠披露
- Jonathan Coles:机构信息未在 arXiv HTML 中可靠披露
- Joshua Oyebanji:机构信息未在 arXiv HTML 中可靠披露
- Khanh Nguyen:机构信息未在 arXiv HTML 中可靠披露
- Konstantinos Pitas:机构信息未在 arXiv HTML 中可靠披露
- Lasse B. Strand:机构信息未在 arXiv HTML 中可靠披露
- Li Mi:机构信息未在 arXiv HTML 中可靠披露
- Loïc Deslarzes:机构信息未在 arXiv HTML 中可靠披露
- Lorenzo Baggi:机构信息未在 arXiv HTML 中可靠披露
- Lorenzo Noci:机构信息未在 arXiv HTML 中可靠披露
- Luca Baumann:机构信息未在 arXiv HTML 中可靠披露
- Luca Sartori:机构信息未在 arXiv HTML 中可靠披露
- Lukas Drescher:机构信息未在 arXiv HTML 中可靠披露
- Marco De Negri:机构信息未在 arXiv HTML 中可靠披露
- Marco Passerini:机构信息未在 arXiv HTML 中可靠披露
- Mark Klein:机构信息未在 arXiv HTML 中可靠披露
- Marko Stojanovic:机构信息未在 arXiv HTML 中可靠披露
- Martin Majsec:机构信息未在 arXiv HTML 中可靠披露
- Matin Ansaripour:机构信息未在 arXiv HTML 中可靠披露
- Mattea Busato:机构信息未在 arXiv HTML 中可靠披露
- Mauro Pellonara:机构信息未在 arXiv HTML 中可靠披露
- Max Neuwinger:机构信息未在 arXiv HTML 中可靠披露
- Michael Graber:机构信息未在 arXiv HTML 中可靠披露
- Michal Tešnar:机构信息未在 arXiv HTML 中可靠披露
- Michelle Wastl:机构信息未在 arXiv HTML 中可靠披露
- Miguel Gila:机构信息未在 arXiv HTML 中可靠披露
- Mikolaj Boronski:机构信息未在 arXiv HTML 中可靠披露
- Morgane Magnin:机构信息未在 arXiv HTML 中可靠披露
- Moritz Reihs:机构信息未在 arXiv HTML 中可靠披露
- Mukhammadali Sayfiddinov:机构信息未在 arXiv HTML 中可靠披露
- Nathan Ranchin:机构信息未在 arXiv HTML 中可靠披露
- Nicolas Cuveillier:机构信息未在 arXiv HTML 中可靠披露
- Oscar Wohlfahrt:机构信息未在 arXiv HTML 中可靠披露
- Qianqian Zou:机构信息未在 arXiv HTML 中可靠披露
- Rada Kamysheva:机构信息未在 arXiv HTML 中可靠披露
- Rita Sevastjanova:机构信息未在 arXiv HTML 中可靠披露
- Roman Machacek:机构信息未在 arXiv HTML 中可靠披露
- Sebastian Keller:机构信息未在 arXiv HTML 中可靠披露
- Simon Matrenok:机构信息未在 arXiv HTML 中可靠披露
- Simon Pierre:机构信息未在 arXiv HTML 中可靠披露
- Stefano Schuppli:机构信息未在 arXiv HTML 中可靠披露
- Suei-Wen Chen:机构信息未在 arXiv HTML 中可靠披露
- Szabina Horváth-Mikulas:机构信息未在 arXiv HTML 中可靠披露
- Taliesin Perez:机构信息未在 arXiv HTML 中可靠披露
- Thilo Spinner:机构信息未在 arXiv HTML 中可靠披露
- Thomas Kleine Buening:机构信息未在 arXiv HTML 中可靠披露
- Tim Robinson:机构信息未在 arXiv HTML 中可靠披露
- Tymoteusz Kwiecinski:机构信息未在 arXiv HTML 中可靠披露
- Vilém Zouhar:机构信息未在 arXiv HTML 中可靠披露
- Vinzenz Thoma:机构信息未在 arXiv HTML 中可靠披露
- Xiaozhe Yao:机构信息未在 arXiv HTML 中可靠披露
- Yannick Metz:机构信息未在 arXiv HTML 中可靠披露
- Yuhei Fukuhara:机构信息未在 arXiv HTML 中可靠披露
- Yusif Askari:机构信息未在 arXiv HTML 中可靠披露
- Zixuan Chen:机构信息未在 arXiv HTML 中可靠披露
- Alexander Ilic:机构信息未在 arXiv HTML 中可靠披露
- Ana Klimovic:机构信息未在 arXiv HTML 中可靠披露
- Andreas Krause:机构信息未在 arXiv HTML 中可靠披露
- Andrei Kucharavy:机构信息未在 arXiv HTML 中可靠披露
- Elliott Ash:机构信息未在 arXiv HTML 中可靠披露
- Joost VandeVondele:机构信息未在 arXiv HTML 中可靠披露
- Martin Rajman:机构信息未在 arXiv HTML 中可靠披露
- Mennatallah El-Assady:机构信息未在 arXiv HTML 中可靠披露
- Thomas Schulthess:机构信息未在 arXiv HTML 中可靠披露
- Timo Kehrer:机构信息未在 arXiv HTML 中可靠披露
- Torsten Hoefler:机构信息未在 arXiv HTML 中可靠披露
- Antoine Bosselut:机构信息未在 arXiv HTML 中可靠披露
- Martin Jaggi:机构信息未在 arXiv HTML 中可靠披露
- Imanol Schlag:机构信息未在 arXiv HTML 中可靠披露
原作者元数据中有 1 项仅为分隔标点,未列为作者;其他作者与机构按原来源记录展示。
📌 核心摘要
Apertus 1.5要解决的是把完全开放的Apertus 1.0文本模型原地升级为能理解图像和音频、只输出文本的多模态推理助手,输入是文本与离散化图像码和音频码,难点是在学到新模态与语言对齐时不丢失文本能力。继续预训练从8B和70B检查点出发,先做非配对全标记预测学模态表示,再做配对文本目标预测学跨模态对齐,经冷却和长上下文扩展后得到多模态基座,8B新增约4T标记、70B新增约2T标记。该基座进入后训练,先经监督微调学出按聊天模板回应并以开关控制思考痕迹输出的助手行为,再以可验证奖励强化学习和直接偏好优化对齐偏好,8B另做章程自蒸馏,思考中调用工具的组合在发布模型中尚未实现。与保留架构、只扩展词表和嵌入的做法相比,关键差异是多模态经由分词器进入、语言模型头仍只输出文本,因而复用文本推理链而无须单独解码头。在表23的8B组发布评测且所有模型均关闭思考模式下,指令遵循指标IFEval按提示级严格准确率计,Apertus 1.5 8B为87.1%高于前代Apertus 1.0 8B的68.4%。在表35贪婪解码的音频评测中,英语识别指标词错率越低越好,LibriSpeech test-clean上Apertus 1.5 8B为6.6%高于即差于Kimi-Audio的1.3%。训练成本方面,报告估计继续预训练与扩展合计约200万卡时、约1.1 GWh,Alps机房用水电与湖水冷却,短式事实问答幻觉未改善。
🔗 开源与复现资源
- 第三方资源:https://apertus-ai.org — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
这篇报告要解决的现实问题是什么
论文把语言模型看作基础设施,担心完全依赖少数供应商。Apertus 1.5 的目标是在 Apertus 1.0 两个文本模型基础上原地升级,不重新从零训练,就加上图像理解和音频理解,把上下文窗口扩大到原来的 4 倍,并把指令遵循、工具调用和可选的思考模式做得更可靠。输入是文本、图像和音频,输出始终是文本,模型不生成图像也不生成音频。
报告的写法是沿着模型生命周期展开,先讲多模态分词,再讲继续预训练数据和训练流程,再讲后训练,最后是分模态和分语言的评测、基础设施与发布治理。对刚入门的读者,关键是先分清继续预训练负责学会新模态和更长上下文,后训练负责把能力变成可用的助手行为,两段用的数据、损失和评价方式都不同,不能混为一谈。
与已有路线相比它选择了哪条技术路线
同样输入下,多模态大模型常见做法是用连续视觉编码器把像素变成特征再投影进语言模型,训练时前向要跑编码器。Apertus 1.5 选择的是离散词元早期融合路线,图像和音频先在离线预处理中变成整数编号,语言模型只看到编号序列。论文提到这种做法借鉴了把离散多模态表示接入已预训练语言模型的工作,好处是训练时不需要跑视觉或音频编码器,吞吐接近纯文本训练。
代价也在原文写明了,采用的图像分词器只用像素重建目标训练,没有语义或图文对齐目标,细粒度文字和细节重建较弱。比较时要注意输入、目标和运行阶段是否相同,用编码器特征的方法与用离散编号的方法在计算量、重建质量和对齐方式上本来就不同,不能只比一个榜单分数就说谁全面更好。
输入是什么输出是什么哪些信息必须保留
对学习者最有用的抽象是把每个样本看成一段混合编号序列。文本输入来自文本分词器,图像输入来自 Emu3.5 视觉分词器把每 16×16 像素块映射为 131072 种码之一,音频输入来自音频分词器的 4096 种码。用户消息里用图像占位符和音频占位符表示媒体位置,分词时再展开为结构标记加内容码。必须保留的信息包括媒体在对话中的位置、配对文本中的转写或说明、长文档中的顺序,以及思考模式下推理段与最终答案的边界。
输出限定为文本词元,后训练阶段只预测文本,连控制转写或续写方向的任务控制标记也不作为预测目标。这种限定意味着评测只能说明理解和生成文本的能力,不能说明生成图像或音频的能力,论文也没有训练后者。
从 Apertus 1.0 到可发布模型的整体流程
整体流程分继续预训练和后训练两大段。继续预训练从 Apertus 1.0 的 8B 和 70B 检查点出发,先做非配对多模态训练,再做配对多模态训练,再做强调高质量数据的冷却,最后做长上下文扩展。8B 用了额外 4T 词元,70B 用了额外 2T 词元,其中 70B 为省资源把第 2 阶段预算减半但冷却长度不变。后训练依次是监督微调、长上下文监督微调、可验证奖励强化学习、直接偏好优化,以及只用于 8B 的基于章程的自蒸馏策略优化。
图注明确说明深蓝色阶段用多模态数据,浅蓝色阶段只用文本,70B 不到 SDPO 就发布,8B 用在线偏好对而 70B 用离线加在线偏好对。思考不是单独模型,而是聊天模板的请求时开关,默认关闭。下面先读这张流水线图再进入每个组件。
读懂训练流水线图再往下走
这张图最重要的是看清数据模态和发布分支,上排 4 个蓝色块是继续预训练,下排 5 个蓝色块是后训练,箭头表示检查点依次传递,红色框标出最终发布的 8B 和 70B 位置。读图时先确认每个阶段吃的是纯文本还是图文音混合,再确认强化学习阶段是否包含图像,最后确认偏好阶段的数据来源差异,这样后面看到评测波动时才知道可能来自哪个阶段。
看图路径: 1. 沿从左到右的箭头数出继续预训练四个阶段和后训练五个阶段;2. 看深蓝与浅蓝区分多模态数据阶段和纯文本阶段;3. 确认 70B 不经过 SDPO 而 8B 走完全程的分支标注;4. 记住思考是模板开关而不是独立模型
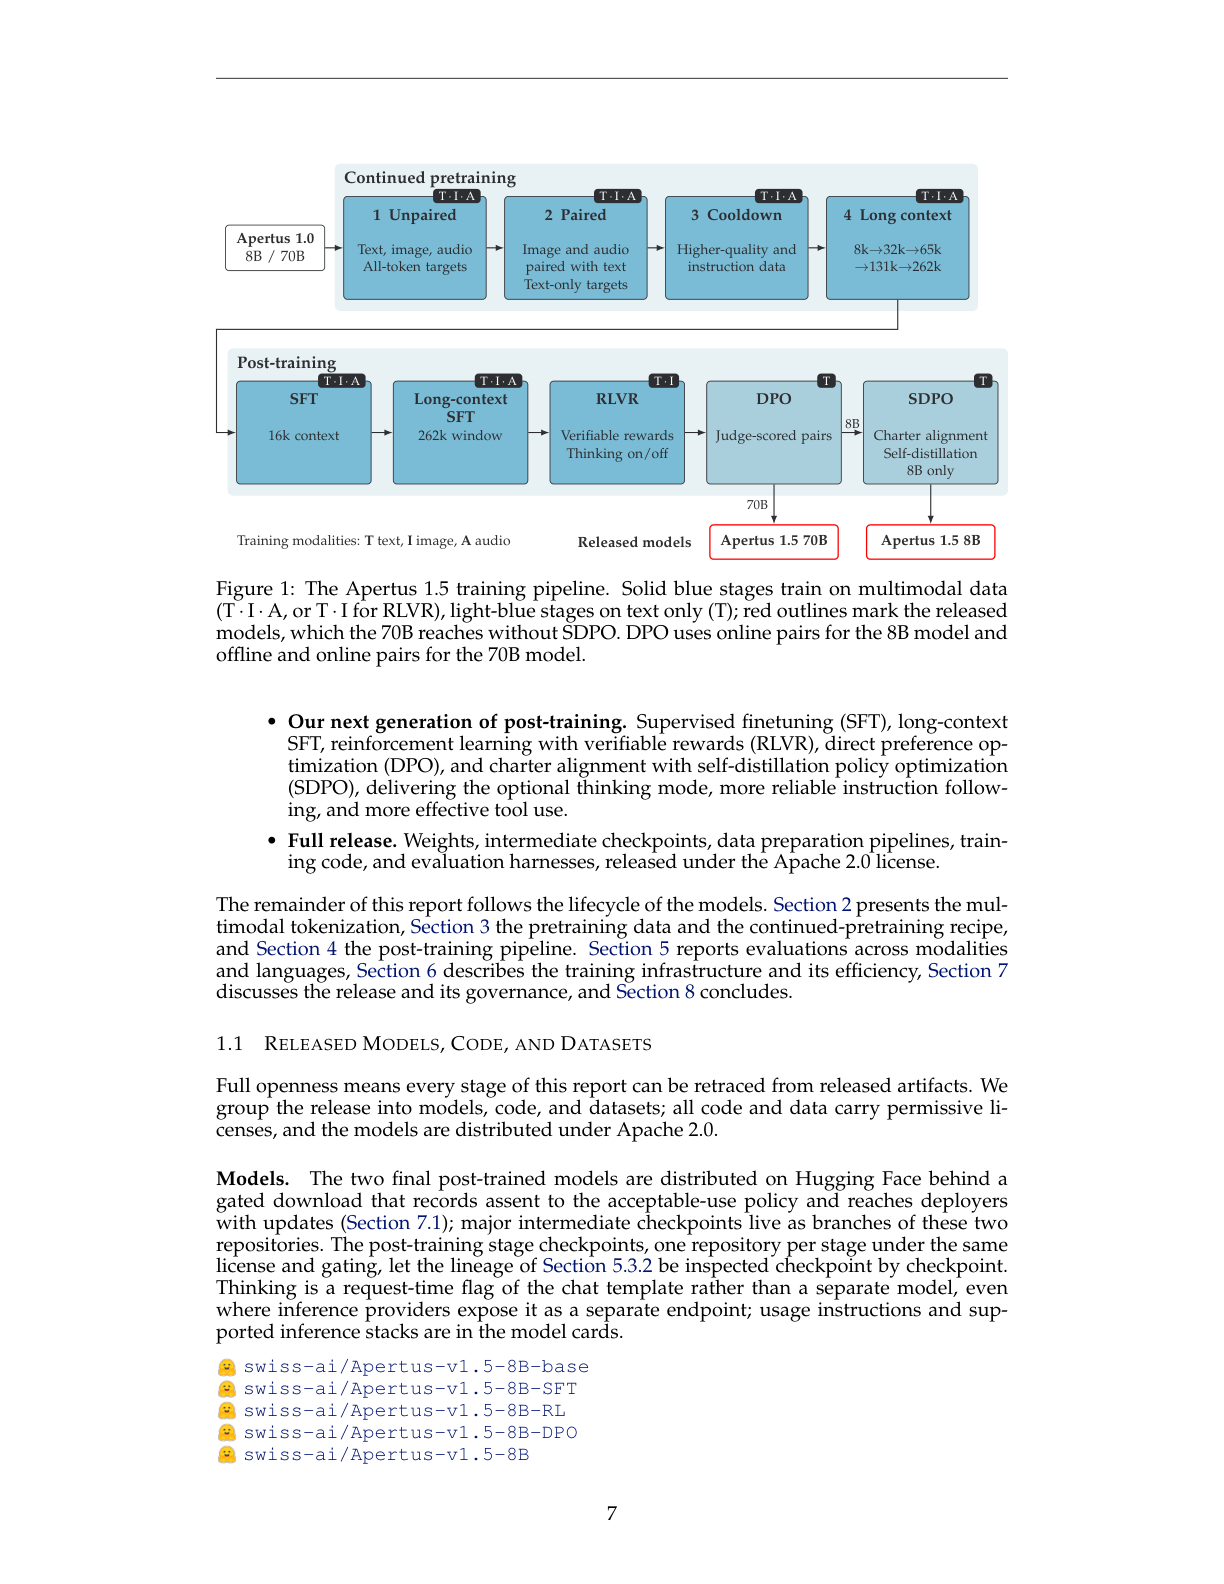
图片来源: 原论文 PDF 第 7 页(含图 1)
论文图 1。原论文 Figure 1::“The Apertus 1.5 training pipeline. Solid blue stages train on multimodal data (T,\cdot,I,\cdot,A, or T,\cdot,I for RLVR), light-blue stages on text only (T); red outlines…”。
从图中可以看到继续预训练从非配对的全部词元目标过渡到配对的纯文本目标,冷却强调高质量和指令数据,长上下文分多步拉长窗口。后训练从 16k 上下文的监督微调进入 262k 窗口的长上下文微调,再进入可验证奖励、法官打分偏好对和章程对齐。70B 的箭头在 DPO 后直接指向发布,8B 还要经过 SDPO。思考在强化学习阶段以开和关混合的方式参与,而不是全程强制开启,这与后文工具调用在思考下很少出现、训练变慢的解释是一致的。
图像和音频是怎样变成词元并送进模型的
图像侧用 Emu3.5 视觉分词器离线把图片变成编号,一张 512×512 像素图对应 32×32 共 1024 个词元,任意形状按同样块划分处理。音频侧同样离线变成编号,训练时不再解码波形。词表在 Apertus 1.0 的 131072 项后先加 200 个保留多模态槽位含结构标记,再加 131072 个图像码和 4096 个音频码,得到 266440 个词表项,发布版输入嵌入矩阵有 266752 行,最后 312 行是填充而不是词表。模型结构不变,共享嵌入层消费预计算好的编号,输出头仍只保留原文文本词表,所以模型能读多模态但不会输出非文本词元。论文用吞吐数字说明这种分离的收益,在相同 256 节点和 8192 序列配置下纯文本消融约每 GPU 每秒 5300 到 5500 词元,首个多模态生产阶段为 5474,基本持平。
离散词元 × 词表扩展: 离散词元指把图像块或音频波形先变成整数编号,词表扩展指在原文本词表后追加图像码和音频码的编号区间,二者搭配让语言模型仍按查表和自回归预测处理多模态,组合后不改 Transformer 结构就能复用文本训练流水线。
论文还给出去均值相关的调整公式,用于跨条件比较时扣除系统偏差,理解时先把符号对应到准确率或分数的下标再看它要消除哪部分均值。
\[\tilde{s}_{a,p,m}=s_{a,p,m}-\bar{s}_{a,p,\cdot}-\bar{s}_{a,\cdot,m}+\bar{s}_{a,\cdot,\cdot},\]该公式的含义是把某个条件下的原始分数减去同提示平均和同模型平均再加回总平均,目的是在多因素比较中更公平地看单因素作用,具体数值含义要回到原表和正文的聚合方式,不能当成模型本身的训练损失。
继续预训练分哪几步每步预测什么
第 1 阶段吃非配对图像、音频和文本,损失算所有模态的词元,让模型先学会新编号语言。第 2 阶段加入图文对和音频转写对及纯文本,只算文本词元,目的是对齐而不让模型学会生成媒体。第 3 阶段冷却强调高质量和推理密集数据,数学和代码占比明显上升,普通网页文本下降,还混入少量指令格式数据且只算助手词元。
长上下文扩展分四步从 8192 到 32768、65536、131072 再到 262144,每步从上一步检查点重启优化器状态,学习率固定在冷却结束值,序列翻倍时每批序列数减半以保持每批词元不变,并逐步把旋转位置编码基频调到 4M、缩放因子调到 32。数据上每步保留冷却混合的子采样,再加真正长文档和合成可验证长任务,包括常见词计数、文档顺序重排和人工针检索,难度按打包长度和题目密度调节。
非配对训练 × 配对训练: 非配对训练指只给单模态图像或音频让模型预测其自身词元以学习表示,配对训练指给图像文本对或音频转写对并只预测文本以学习对齐,先表示后对齐的分工是为了减少图像预测与语言对齐互相干扰。
论文特别说明第 2 阶段和第 3 阶段的视觉与音频计数包含其配对文本,转写和说明不算作单独文本列,读表时不要把配对文本重复加到文本列。70B 第 2 阶段文本与多模态大致对半,8B 第 2 阶段文本约占三分之二,部分原因是多模态数据当时仍有限。
后训练如何决定何时给推理过程
生产监督微调从长上下文预训练检查点出发,8B 和 70B 用同一套经能力筛选的文本混合,序列长 16384,8B 学习率 6×10 的负 5 次方、全局批量 256、约 159B 词元,70B 学习率 1×10 的负 5 次方、全局批量 1024、约 155B 词元。能力筛选本身用一个辅助 8B 非思考检查点实现,先在去掉推理痕迹的数据上训练,再对每个可验证提示采样 8 个非思考答案,至少对一次的就不加推理痕迹,八次全错的才补验证过的思考模型生成的推理痕迹。数学类只有约 10% 到 40% 保留无痕迹,指令遵循单轮约 99% 保留无痕迹,因为消融发现思考开时数学加 7 到 18 分但指令遵循掉 12 到 14 分,约 1/4 痕迹会退化为重复。下面这张图把分流逻辑画得很清楚。
看图路径: 1. 看辅助非思考模型先在去推理痕迹数据上训练;2. 看每个可验证提示采样八次再按通过情况分流;3. 区分至少对一次与八次全错的两条去向
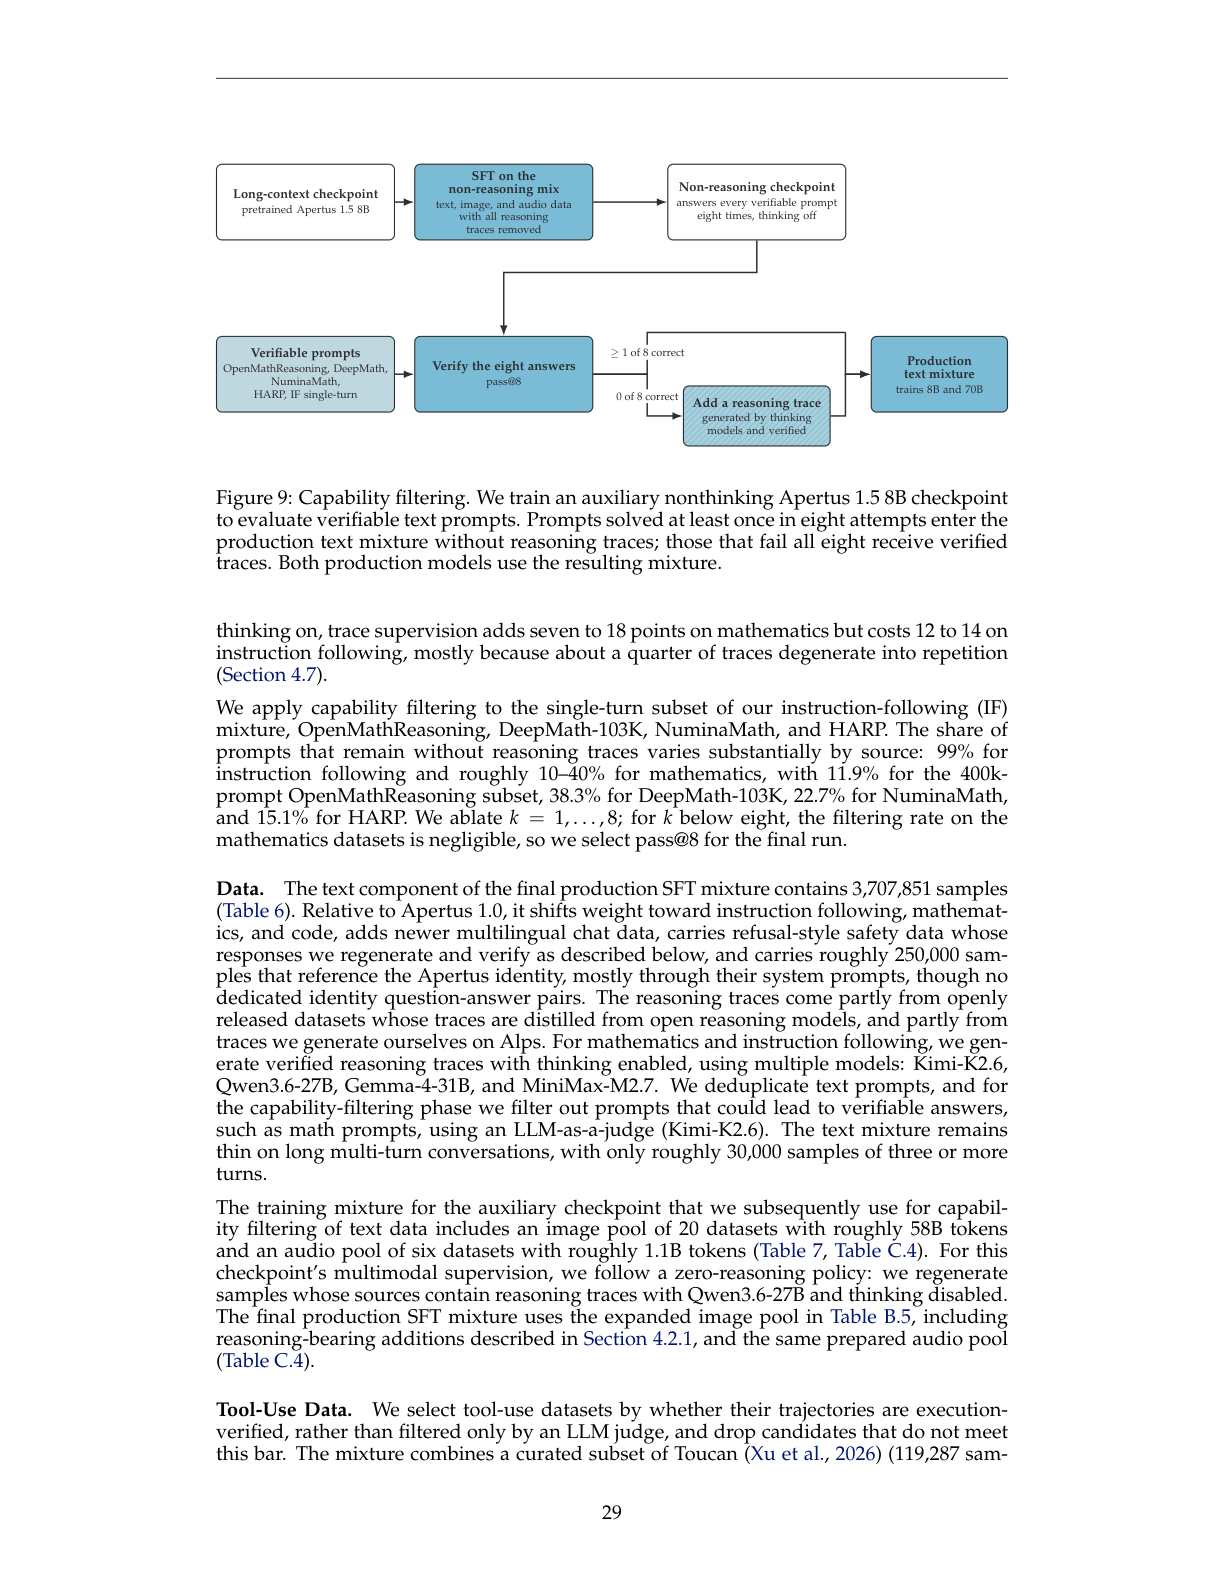
图片来源: 原论文 PDF 第 29 页(含图 9)
论文图 9。原论文 Figure 9::“Capability filtering. We train an auxiliary nonthinking Apertus 1.5 8B checkpoint to evaluate verifiable text prompts.”。
从图中可以看到可验证提示来自数学与指令池,验证八次答案后按通过次数进入不同混合,最终生产混合同时训练 8B 和 70B,但生产模型不继承辅助模型的权重,只有筛选后的数据被沿用。长上下文监督微调接着修复普通监督微调后的长检索坍缩,强化学习从长上下文微调后检查点开始,8B 约 1000000 条轨迹,偏好阶段再处理表达和章程对齐。
监督微调 × 能力筛选: 监督微调指用人写或验证过的对话示范训练助手行为,能力筛选指先用辅助非思考模型试做可验证题目,能做对的就不加推理过程、做不对的才补验证过的推理过程,二者搭配是为了数学需要过程而指令遵循怕冗长重复,组合后按难度决定是否保留推理痕迹。
长上下文扩展 × 长上下文监督微调: 长上下文扩展指在继续预训练末尾把序列从 8192 逐步拉长到 262144 并调整旋转位置编码,长上下文监督微调指在普通监督微调后补长文档问答和合成检索任务,前者给位置和注意力适应长输入的能力,后者修复短上下文微调造成的长检索退化。
强化学习和偏好学习各管什么不管什么
强化学习用异步训练器,奖励来自核对或执行而不是打分,数学用核对工具,指令用形式约束检查,代码进沙箱跑测试且只有全通过才给二值奖励,其它用精确匹配,模型通过专用回答工具输出最终答案以保持工具格式在分布内。
生产配置并行训练思考关和思考开与关混合两种,混合更好并用于发布,全程思考因推理过长拖慢训练且很少调工具而未采用,工具提示也因托管工具服务端成为瓶颈而被排除,所以发布版工具行为主要来自监督微调而非强化学习。偏好阶段先对 70B 做离线直接偏好优化,再对两个尺寸做在线直接偏好优化,每批从当前策略采样再由法官模型打分组成优劣对,8B 每提示 12 条、70B 每提示 8 条。两个阶段都不训练多模态和长上下文数据,且思考关闭。
可验证奖励强化学习 × 在线直接偏好优化: 可验证奖励强化学习指用数学核对、约束检查和代码测试等可执行结果给奖励,在线直接偏好优化指用当前策略采样多个回答再由打分模型选优劣对学习,前者管对错可判的任务,后者管难以写规则的偏好,组合后先保证正确再改善表达和指令服从。
评测在什么条件下做指标方向是什么
文本用分叉的语言模型评测框架加固定任务、提示和服务配置的启动层,保证跨检查点可比,视觉和音频跑在分叉的多模态评测套件后的统一分发器后。发布套件约 50 个任务,覆盖知识、指令聊天、数学、代码、推理、多语言文化、长上下文、工具和安全。字面规则是知识类越高越好,词错率越低越好,语音翻译 BLEU 越高越好,指令遵循用提示级严格准确率,代码用通过率。思考评测统一给 32768 思考预算,小样本高方差任务如 AIME 报告多种子均值。
长上下文用 RULER 测合成检索聚合,用 HELMET 测 7 类下游任务,工具只测 BFCL 单轮类别所以与官方多轮榜不可比,幻觉用法官模型但与官方榜用法官不同所以分数不可比。这些条件决定了结论的适用范围,换提示、换解码、换法官或换多轮设置都可能改变排序。
文本和思考模式在什么范围内成立
发布模型几乎全面超过各自的前代,8B 在完全开放同级中知识、指令和文化领先,指令甚至超过对比的开放权重模型,多语言相对位置最强。思考提升集中在长推理,8B 的数学和部分多模态推理涨幅上 2 位数,知识类变化小,70B 思考下个别基准还让出分数。AIME 从 1.0 几乎解不出多少题大幅进步,但仍落后同级对手。下表把原文明确报告的思考前后数字放在同一行,便于复述关键步骤而不夸大为全面超越。
下表比较同一 8B 发布线在思考关闭与开启下的数学和指令表现,公平条件是同模型同评测配置,指标均为越高越好的准确率类分数。
| 模型状态 | MATH-500 | MATH | IFBench | 思考开关 |
|---|---|---|---|---|
| Apertus 1.5 8B 关闭思考 | 51.2 | 41.2 | 35.3 | 关 |
| Apertus 1.5 8B 开启思考 | 71.4 | 57.3 | 44.3 | 开 |
三项都随思考明显上升,其中 IFBench 在对比的 8B 级中最强,但这只是该评测配置和思考预算下的结果,不能推广到知识问答或 70B 的每一项,也不能说明思考在部署延迟和输出长度上的代价已经可忽略。未胜出项是 AIME 仍落后、70B 思考下 GPQA 让分,以及英文知识与最强开放权重模型仍有约 13 分差距而多语言差距缩小到 2 到 3 分,这些都说明思考的收益是有条件的。
看图路径: 1. 对比第 1 阶段与第 2 阶段通用视觉占比的变化;2. 看冷却阶段图表类占比如何大幅上升;3. 注意右侧以输入词元计的池大小而不是样本数

论文图 4。原论文 Figure 4::“Vision data composition by stage, with pool sizes in input tokens on the right.”。
从视觉数据阶段图可以看到通用视觉在前 2 阶段占 50% 到 70%,冷却转向图表类占近半到 60%,右侧池大小以输入词元计,8B 第 2 阶段约 850.0B 而 70B 约 534.1B,这种构成变化是理解图像能力分化的背景,但样本占比不直接等于训练采样权重和实际消费词元。
图像与音频的首版能力边界在哪里
图像是家族首次具备的能力,论文承认 OCR 是落后于其他开放模型的组,原因可能与更粗的 16×16 网格有关。音频方面发布版能做英语和多语言识别与部分理解,但在口语翻译和非语音理解上明显落后,声类分类在 chance 附近。下表把原文用连续句子报告的语音翻译与声音分类数字整理出来,便于看到差距的数量级。
下表比较 CoVoST2 英中语音翻译与 VocalSound 分类,公平条件是同任务同贪心解码与各自输出上限,BLEU 和准确率越高越好,词错率不在此表。
| 任务指标 | Apertus 1.5 8B | Apertus 1.5 70B | Qwen2.5-Omni 7B | Qwen2-Audio 7B | Kimi-Audio 7B |
|---|---|---|---|---|---|
| CoVoST2 英中 BLEU | 15.3 | 13.1 | 44.3 | 38.1 | 0.3 |
| 六分类 chance 参考 | 16.7% | 16.7% | 16.7% | 16.7% | 16.7% |
语音翻译上两个 Apertus 都只有 Qwen 约三分之一,声音分类上 8B 恰在随机附近而 70B 低于随机,说明首版音频理解主要覆盖语音转文本附近,音乐与环境声监督不足。限制是该结论只在所列任务、解码和输出上限下成立,长语音任务还受分块与注意力实现影响,换窗口或换惩罚可能改变排序。图像侧的反例是文档问答与细粒度文字仍弱,不能因为通用视觉占比大就认为文档能力同样强。
分词器压缩与两阶段配方的代价是什么
在 350 张第 1 阶段训练图像的 6 类子集上,Emu3.5 每图平均约 1/4 词元,代价是平均约 2.7 dB 峰值信噪比、0.07 结构相似性和 0.02 感知距离,图表、医疗和文档损失最大,地理在峰值信噪比上几乎持平。论文接受这个交换,因为固定词元预算可看约 4 倍图像且推理更便宜,但也指出这可能是 OCR 落后的原因。下表把原文报告的平均代价与吞吐放在一起,说明质量与效率的交换。
下表整理分词器选择的平均质量代价与训练吞吐,公平条件是同 350 张图同训练预处理,PSNR 和 SSIM 越高越好而 LPIPS 越低越好,吞吐越高越好。
| 对比维度 | Emu3 侧 | Emu3.5 侧 | 平均代价 | 效率含义 | 指标方向 |
|---|---|---|---|---|---|
| 每图词元 | 8372 | 2080 | 约 1/4 | 同预算看更多图 | 越低越省 |
| SSIM 差距 | 0.806 | 0.740 | 0.07 | 结构损失 | 越高越好 |
| 感知与吞吐 | 0.075 | 0.099 | 0.02 | 5474 词元每秒每卡 | 越低越好与越高越好 |
Emu3.5 在每类都更省词元但重建全面稍差,文档和医疗最差印证了细粒度文字是主要弱点。该消融只覆盖重建质量与词元数,没有直接测量下游每一组理解分数,跨到下游时还要考虑数据配比与损失权重。另一组对照显示配对阶段给图像与文本等权有害,图像零权重最强,而非配对表示学习从零加到约 57B 图像词元能抬升理解但更大预算会侵蚀知识与文本能力,这支持了有界的第 1 阶段与更大的文本占比。
看图路径: 1. 在 PSNR 面板比较 Emu3 与 Emu3.5 每个类别的横向差距;2. 注意文档与医疗类别差距更大而地理类别几乎持平;3. 结合 SSIM 越高越好与 LPIPS 越低越好的方向一起读

论文图 6。原论文 Figure 6::“Per-category reconstruction quality of the Emu3 and Emu3.5 tokenizers on the same 350 Stage 1 training images as Table 1.”。
从图中可以看到 Emu3 的点在 PSNR 和 SSIM 上普遍靠好的一侧,LPIPS 靠小的一侧,类别间差距方向一致,只有地理遥感在 PSNR 上几乎重合,说明压缩代价是系统性的而非个别类别偶然。
后训练每一步带来了什么又弄坏了什么
偏好对齐把开发套件总平均从 8B 的 49.3% 提到 54.8%、70B 的 55.3% 提到 61.2%,知识、数学、推理、安全、聊天、工具和章程都有涨,退化输出变少。长上下文则呈现先拉长后坍缩再恢复的曲线,扩展后 RULER 领先前代,普通监督微调后长检索坍缩,专用长微调恢复,强化学习和偏好在不训练长文档的情况下还能再涨。下表把偏好前后的总平均与小规模图像预算对照放在一起,前者是生产线的实际提升,后者是配方依据的受控证据。
下表左半比较偏好对齐前后的开发集总平均,右半比较固定对齐下图像预算从零到约 57B 的理解变化,均为越高越好的准确率,百分点与小数分数不要混读。
| 模型与条件 | 对齐前总平均 | 对齐后总平均 | 图像预算 | GQA | DocVQA |
|---|---|---|---|---|---|
| Apertus 1.5 8B 开发平均 | 49.3% | 54.8% | 零到约 57B | 0.50 到 0.54 | 0.67 到 0.71 |
| Apertus 1.5 70B 开发平均 | 55.3% | 61.2% | 零到约 57B | 0.50 到 0.54 | 0.67 到 0.71 |
| 补充 SEED-Bench | 0.61 | 0.65 | 约 57B | 对数增益趋平 | 更大预算侵蚀文本 |
偏好阶段的提升是跨技能的平均值,不能保证每一项都不回退,70B 个别知识与幻觉指标仍有反复。小规模对照的增益是对数且趋平,更大图像预算会损害依赖语言的知识型图像基准和文本基准,且 replay 文本不能完全恢复,这正是生产混合保持大文本占比的理由。未评测的范围包括多轮工具调用,因为工具提示被排除在强化学习外,发布版工具结论只适用于单轮类别。
哪些结论不能推广与已知缺陷
论文明确列出多项发布限制。8B 并行工具调用弱,常把多个调用做成一个,长上下文幻觉中短问答未改善,70B 在真实实体问答上比前代多幻觉一些,过度拒绝随对齐大幅上升,思考与工具在发布时互斥且思考下强制推理则无工具调用。安全上 8B 抗直接有害请求较好但仍怕人工越狱,多模态越狱处于同尺寸开放模型正常分布,能力限制仍是主要防线而非对齐本身。
数据侧有上游说明模板残留导致模型偶尔复述指令,位置编码转换曾丢配置造成检查点表观回退,小数据集耗尽会漂移混合比例,批量零填充编码会改变媒体编号所以需逐项编码。这些都说明榜单数字只在原文的模板、解码、法官和单轮条件下成立,换部署、换量化、换多轮或换语言都需重测,不能把总体趋势套到每个步骤。
复现第一步做什么需要什么资源
先不要直接跑全量训练,第一步应按报告复现评测管线与模板。拿到门控下载的权重与分阶段检查点,固定推理框架、贪心或思考温度、思考预算、回答工具和输出上限,再跑文本、视觉、音频 3 套分叉评测,确认能复现 MATH-500 思考开关差异和长上下文各阶段曲线。数据侧从公开源按版本与许可取数,用发布的准备脚本重做分词与交错序列,注意配对文本计入视觉音频列、文本列只计单独文本。
训练侧 8B 与 70B 分别用 256 与 512 节点在 Alps 的 GH200 上跑,长扩展每翻倍减半批序列数并按阶段调整旋转编码,继续预训练与监督微调代码只需少量多模态修改。资源上继续预训练约 2000000 GPU 小时约 1.1GWh,不含后训练与评测,全项目分配约 9000000 GPU 小时,复现前先评估自己是否有同级算力与存储,否则只复现评测与微调更现实。代码、权重可下载与系统可运行是三件事,权重门控记录可接受使用政策,代码与数据管线另有许可,服务性能因供应商差异大,需分别验证。
什么时候值得尝试还需要补哪项验证
当任务是文本为主、需要读图和听语音转文本、要长到数十万词元、且要求完全开放可审计时,这条原地升级路线值得尝试;当任务重度依赖文档细文字、音乐环境声理解、并行多工具代理或强安全拒绝时,首版并不合适。复现时先做评测与模板一致性,再做小规模 2 阶段与零图像权重的对照,最后才考虑全量继续预训练。
还需要补的验证包括换法官与换提示后的偏好结论、多轮工具与思考并存的服务实现、低资源语言与罗曼什语变体的保持性,以及量化到 4 位后注意力层出现非数的原因与修复。记住输出头只保留文本、思考只是模板开关、70B 止于 DPO 而 8B 还有章程对齐,任何脱离这些条件的胜负判断都不成立。
📎 论文与评分元数据
排名:前50% | 文档类型:模型报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses