共分析 245 篇论文
⚡ 今日概览
✅ 筛选入选 245 篇 → 🔬 深度分析完成
🏷️ 标签说明:本期标签来自新版词表;站点标签页暂时兼容展示历史标签与新标签。
🏷️ 热门方向
| 方向 | 数量 | 分布 |
|---|---|---|
| #语音识别 | 21 篇 | ███████████████ |
| #文本到语音 | 17 篇 | ███████████████ |
| #音视频问答 | 11 篇 | ███████████ |
| #音视频生成 | 10 篇 | ██████████ |
| #音乐生成 | 9 篇 | █████████ |
| #音频分类 | 9 篇 | █████████ |
| #音视频理解 | 8 篇 | ████████ |
| #音频生成 | 8 篇 | ████████ |
📊 论文评分排行榜(245 篇,按分数降序)
📋 论文列表
🖼️ 有图的论文会在这里展示首张原论文图;原图链接见对应独立页面。
🥇 SheetSage2:用合成监督做连贯的主旋律谱转录

英文题目:SheetSage2: Coherent Lead-Sheet Transcription with Synthetic Supervision
标签:#音乐转录 | #工具增强与约束解码 | #知识蒸馏 | #音乐
评分:8.7/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 1.5/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Junyan Jiang:机构信息未在 arXiv HTML 中可靠披露
- Ruibin Yuan:机构信息未在 arXiv HTML 中可靠披露
- Jiahao Pan:机构信息未在 arXiv HTML 中可靠披露
- Wei Xue:机构信息未在 arXiv HTML 中可靠披露
- Yike Guo:机构信息未在 arXiv HTML 中可靠披露
- Gus Xia:机构信息未在 arXiv HTML 中可靠披露
- Yann LeCun:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
导谱转录从多声部混合录音推断节拍与小节线、调号与和弦、旋律音高与时值、段落标签并整理成统一可读乐谱,难点是各维度互补依赖且局部预测准确仍可能得到不一致的音乐序列,而完整对齐的音频乐谱对很少。SheetSage2先用符号音乐分析加伪标签自举从大规模MIDI派生节拍、拍号、旋律、和弦、调与段落标签,并用FluidSynth渲染为24 kHz音频。帧级探测器SheetSage2-Prober在混合真假数据上学习局部概率,再经六阶段结构化解码整合互补线索与时间依赖后输出统一事件序列。SheetSage2-AR只在探测器输出上做序列级蒸馏,推理时直接生成事件,不再运行任务相关的动态规划。在8个集合15个基准指标对上,单个SheetSage2-AR在12对上超过所列最强已有系统,其中GTZAN下拍F1为80.45%,高于Beat This!的78.28%。在HarmonixSet结构边界F1(3 s)上SheetSage2-AR为82.86%,高于SongFormer的79.50%。训练数据与评测以西方调性流行音乐为主,该风格可能更适用,十六分音符网格、单一主速度锚点与受限和弦词表之外的音乐尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://huggingface.co/m-a-p/SheetSage2 — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/m-a-p/SheetSage2 — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/m-a-p/SheetSage2 — 链接可访问(HTTP 200)
第三方资源:https://github.com/CPJKU/beat_this_annotations/tree/v1.0/gtzan — 链接可访问(HTTP 200)
第三方资源:https://github.com/audiocontentanalysis/dataset-gtzan-key/tree/v1.0 — 链接可访问(HTTP 200)
第三方资源:https://creativecommons.org/licenses/by-nc/4.0/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥈 一次采样同时给出视频、混合声与每条分轨的音频视频模型

英文题目:SepGen: Multi-Stem Audio-Video Separation and Generation in a Single Model
标签:#音视频生成 | #音频分离 | #LoRA | #流匹配
评分:8.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.5/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Aviad Dahan:Tel Aviv University
- Rajaei Khatib:Tel Aviv University
- Yonatan Bitton:Google
- Idan Szpektor:Google
- Lior Wolf:Tel Aviv University
- Raja Giryes:Tel Aviv University
📌 核心摘要
4D 音视频场景需要从新视点重渲染画面和空间声音,但已有联合音视频生成器只输出单路混合声轨,无法把每个声源单独取出、定位和传播,后接的语言查询分离每次只处理一条查询,遇到两名男声这类同类声源容易返回同一人。SepGen 在冻结的 LTX-2.5 骨干上增加两路分轨通道,输入为场景描述和每声源一条描述,输出为视频、混合声轨和 2 路分轨波形,分离模式则以观测到的视频和混合声轨为输入,只去噪分轨。训练先让分轨分解干净混合声轨,再让分轨适应带噪混合声轨,推理时生成模式让分轨在噪声较高时读带噪混合声轨,在噪声低于阈值后读当前步估计的干净混合声轨。生成基准声音部分 134 个场景、语音部分 60 个对话的设置下,联合运行的分轨在交换差值指标 J-swap 上为 2.07,高于最强的级联基线 1.27 左右,且自带语音词错误率降至 0.07。结论适用于双声源、带文本描述的场景,超过 2 个声源、完全无描述的同乐器二重奏等情况尚未解决。原文训练使用单卡 NVIDIA A6000,分离阶段 12000 步加生成阶段 3000 步,推理生成用 15 步、分离用 30 步。
🔗 开源资源
代码相关资源:https://sepgen.github.io/ — 链接可访问(HTTP 200)
模型相关资源:https://sepgen.github.io/ — 链接可访问(HTTP 200)
数据相关资源:https://sepgen.github.io/ — 链接可访问(HTTP 200)
第三方资源:https://sepgen.github.io/ — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/collections/AviadDahan — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🥉 DMAD:把分布匹配做成对抗蒸馏的少步视觉生成
英文题目:DMAD: Distribution Matching as Adversarial Distillation for Fast Visual Generation
标签:#音视频生成 | #知识蒸馏 | #生成对抗网络 | #扩散模型
评分:8.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1.5/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zhengming Yu:机构信息未能从 arXiv PDF 文本可靠映射
- Junkun Yuan:机构信息未能从 arXiv PDF 文本可靠映射
- Haotian Yang:机构信息未能从 arXiv PDF 文本可靠映射
- Gordon Guocheng Qian:机构信息未能从 arXiv PDF 文本可靠映射
- Yizhi Wang:机构信息未能从 arXiv PDF 文本可靠映射
- Angtian Wang:机构信息未能从 arXiv PDF 文本可靠映射
- Yiding Yang:机构信息未能从 arXiv PDF 文本可靠映射
- Bo Liu:机构信息未能从 arXiv PDF 文本可靠映射
- Xin Li:机构信息未能从 arXiv PDF 文本可靠映射
- Wenping Wang:机构信息未能从 arXiv PDF 文本可靠映射
- Chongyang Ma:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
扩散模型需多步去噪,少步学生需继承目标分布,直接回归教师轨迹会限制学生自身的噪声到样本映射。分布匹配蒸馏用目标与学生的对数密度对输入的梯度之差驱动学生,学生侧梯度需辅助分数模型持续拟合演变中的学生分布,带来额外显存与计算,也容易因滞后而失稳。DMAD先一次生成并缓存教师样本,训练时只输入加噪后的教师样本、真实样本与学生样本。共享主干的判别器上设教师头与真实数据头,分别区分教师与学生、真实与学生,输出两组对数比率估计。生成器以对数比率的线性损失更新,真实数据头输出的真实与教师平均对数比率差距再按噪声带折算教师权重,随训练自适应加权。与DMD2相比,该方法省去辅助分数拟合与在线教师求值,每步学生更新只配一次判别器更新。在COCO-10K零样本评测上,四步SDXL学生取得生成图像与参考样本的特征分布差异指标14.47,低于DMD2四步的19.32与SDXL教师的19.36。最优判别器下恢复分布匹配梯度的结论依赖充分优化与共同支撑,偏离时梯度与加权均有误差;MiniMax-H3音视频用户偏好等结论限于387个提示、三人多数表决及排除并列口径,并列率达33.3%与24.5%,原文披露了各设置的训练批量、学习率、迭代数与部分硬件耗时。
🔗 开源资源
代码相关资源:https://yzmblog.github.io/projects/DMAD → https://yzmblog.github.io/projects/DMAD/ — 链接可访问(HTTP 200)
模型相关资源:https://yzmblog.github.io/projects/DMAD → https://yzmblog.github.io/projects/DMAD/ — 链接可访问(HTTP 200)
演示资源:https://yzmblog.github.io/projects/DMAD → https://yzmblog.github.io/projects/DMAD/ — 链接可访问(HTTP 200)
第三方资源:https://doi.org/10.48550/arXiv.2311.05556 → https://arxiv.org/abs/2311.05556 — 链接可访问(HTTP 200)
第三方资源:https://www.minimax.io/blog/minimax-h3 — 链接可访问(HTTP 200)
第三方资源:https://arxiv.org/abs/2604.08540 — 链接可访问(HTTP 200)
代码相关资源:https://github.com/Yzmblog/DMAD — 链接可访问(HTTP 200)
模型相关资源:https://modelscope.cn/models/ZhengmingYu-Community/DMAD — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
4. WorldSonus:给动态世界模型实时配上可控立体声

标签:#视频到声音生成 | #音画同步 | #自回归模型 | #流匹配 | #流式处理
评分:8.3/10 | 创新 1.6/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Pengjun Fang:The Hong Kong University of Science and Technology;Noiz AI
- Jingyi Fa:MetaX
- Kam Man Wu:The Hong Kong University of Science and Technology;Noiz AI
- Jiaming Wang:Noiz AI
- Haoyuan Huang:Noiz AI
- Yaguang Wu:MetaX
- Xiangjun Huang:MetaX
- Ziyang Ma:Shanghai Jiao Tong University
- Weijia Chen:Noiz AI
- Hongyu Liu:The Hong Kong University of Science and Technology
- Zeyue Tian:Noiz AI
- Qifeng Chen:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
世界模型生成的视频缺少同步、可交互且有空间感的声音,已有双向模型需看到完整片段,已有流式模型多为单声道或不支持中途更换文本指令。WorldSonus输入流式视频帧与可随时更换的文本指令,只用过去与当前块的视觉信息,每100 ms生成一个音频块,输出48 kHz立体声音频。解码器端Transformer维护跨块会话状态并输出隐状态,该隐状态进入整流流头作为块内去噪连续潜变量的高层上下文。视觉条件分两路衔接:块级语义token先进入自回归主干维持语义连续,帧对齐局部token绕过主干直达流头补充细粒度时空线索。训练时冻结的同步专家用ShiftNCE把时序对齐蒸馏进自回归状态,推理时不再运行该专家。在5 s清晰立体声VGGSound留出测试集上,以VGGish FAD衡量,WorldSonus为1.73,低于PrismAudio的2.09。在30 s交互视频留出测试集上,以FAD衡量,WorldSonus为2.03,低于次优基线的5.52,且单块执行延迟满足实时要求。结论适用于有清晰声画对应与立体声分离的透视视频,对强混响、非直达声主导或单声道主导素材的泛化尚未验证;原文披露单块推理成本为单张NVIDIA H100上约41.2 ms,训练使用16张H100。
🔗 开源资源
第三方资源:https://noizai.github.io/WorldSonus/ — 链接可访问(HTTP 200)
代码相关资源:https://github.com/NoizAI/WorldSonus — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/FF2416/WorldSonus — 暂时无法访问
模型相关资源:https://huggingface.co/google/t5gemma-2-270m-270m — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
5. AutoSynth:从音频和文本生成可编辑的合成器程序

英文题目:AutoSynth: Learning to Generate Editable Synthesizer Programs from Audio and Text
标签:#音频生成 | #自回归模型 | #强化学习 | #音乐
评分:8.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tristan Wu:The Hong Kong University of Science and Technology (Guangzhou)
- Daniel Chin:New York University Shanghai
- Liwei Lin:New York University Shanghai
- Junan Zhang:The Chinese University of Hong Kong, Shenzhen
- Gus Xia:Mohamed bin Zayed University of Artificial Intelligence
📌 核心摘要
论文解决的是端到端音频生成只能输出波形,难以在数字音频工作站中直接修改音符、滤波器和调制关系的问题。输入是参考音频或自然语言描述,输出是在Helm合成器上可执行、可编辑的合成器程序,包含演奏事件、固定参数和可变长调制路由。音频先转为双通道对数梅尔谱,经卷积与12层Transformer编码器形成条件特征,再由12层自回归解码器按演奏事件、固定参数、调制路由的顺序生成统一序列,使音色配置依赖演奏信息、调制结构依赖前两部分;文本路径先用冻结的Stable Audio 3 Medium生成中间波形,再由同一逆变模型转为程序。训练分两阶段,先在由274个出厂预设扩展出的200万音频-程序对上做监督微调,再将Stable Audio 3生成音频与域内Helm训练音频按5:3混合,用结合语义、音高、声学相似度和声音可用性的混合奖励做群组相对策略优化。在Gemini-Woosh合成器逆变评测中,以越低越好的音频-音频CLAP余弦距离衡量,AutoSynth为0.37,低于Synth Permutations的0.54和DDSynth-RL的0.49。在Gemini文本驱动生成中,经CLAP引导的CTAG的CLAP距离最低,但AutoSynth在未被任何评测方法用于训练或搜索的LanguageBind距离上更低。结论适用于短时音色与音效类声音,不适用于完整歌曲,且FSD50K上大量环境声超出合成器表达范围。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://auto-synth.github.io/ — 链接可访问(HTTP 200)
演示资源:https://auto-synth.github.io/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
6. GS-Codec:用一维高斯溅射代替量化器的神经语音编码

英文题目:GS-Codec: A Gaussian-Splatting Bottleneck for Neural Audio Coding
标签:#语音编码 | #神经编解码与离散单元 | #语音 | #高效推理
评分:8.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ron Aluf:School of Electrical and Computer Engineering
- Alon Canfi:Ben-Gurion University of the Negev
- Eliya Nachmani:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
神经音频编码需把波形压缩为可传输、可重建的紧凑离散token以支撑语音语言模型与存储通信,主流残差矢量量化等沿VQ-VAE模板把编码器隐变量划分到学习码本或固定标量网格,码率只能随码本级数跳变且存在码本坍缩。GS-Codec保留SEANet结构卷积编码器与解码器,中间以高斯溅射瓶颈代替量化器,编码器先把波形映射为连续隐变量Z。瓶颈固定该Z做内层梯度优化,用多个一维高斯基函数加权求和渲染出\(\hat{Z}\)并最小化均方误差,使拟合参数成为瓶颈本身。渲染结果直接送入解码器恢复波形,编码器经承诺损失和直通式梯度与波形侧多尺度频谱、对抗和特征匹配损失联合学习,形成穿过内层优化的端到端训练。推理时拟合的尺度与幅度经标量量化传输,位置可冻结在均匀网格不传输或逐段优化后额外传输,同一检查点通过改变图元数\(N_G\)和每参数比特数\(B\)实现训练后码率控制,为避免每段数百步优化,GS预测网络以一次前向回归出参数。在LibriSpeech test-clean上,54,000小时Librilight-Large训练的110图元5比特冻结配置在6.05 kbps取得词错误率2.19%、窄带PESQ 3.71、UTMOS 4.01和说话人相似度0.94,相比6.0 kbps DAC的2.27%、3.77、3.62和0.90,在词错误率、UTMOS和说话人相似度上更优而窄带PESQ略低。训练在单块NVIDIA RTX PRO 6000上约144小时,在NVIDIA L40S上每3秒段迭代编码平均171.2毫秒、实时率为0.057,预测网络降至7.9毫秒、实时率为0.0026。该结论限于英语中等码率,低于3 kbps感知质量仍有差距,当前处理完整3秒段且含非因果组件,跨域音频、亚kbps编码与流式时延尚未验证。
🔗 开源资源
代码相关资源:https://ronaluf.github.io/gs-codec/ — 链接可访问(HTTP 200)
第三方资源:https://ronaluf.github.io/gs-codec/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
7. 查询示例关键词检测中唇动视觉证据如何被注入音频

英文题目:GIVE-KWS: Gated Injection of Visual Evidence for Noise-Robust Query-by-Example Keyword Spotting
标签:#关键词检测 | #多模态学习 | #音视频 | #鲁棒性
评分:8.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ming-Hsiang Hu:机构信息未在 arXiv HTML 中可靠披露
- Kuan-Tang Huang:机构信息未在 arXiv HTML 中可靠披露
- Hung-Shin Lee:机构信息未在 arXiv HTML 中可靠披露
- Berlin Chen:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
示例查询关键词检测用若干条注册语音在测试时指定新词,系统判断一段查询语音是否包含相同关键词,因无词典与语言模型先验可回退,噪声污染查询表示后会直接进入相似度计算而难以纠正。GIVE-KWS冻结文本、音频、视觉三个编码器,先由GIVE模块以查询音频帧为查询对唇部视觉序列做多头交叉注意力检索相关视觉上下文,再以可学习标量门控把该证据混入音频流,训练从零初始化的恒等映射起步以保留音频解。注入后的音频与视觉表示经投影到公共空间,并经音素级对齐与对比损失拉向不受噪声影响的文本音素嵌入,使表示按音素组织以支持未见词,最后注册端文本、音频、视频与查询端音频、视频构成六路余弦相似比较并汇总为检测分数。与逐维掩码缩放音频特征的XEQ-Matcher不同,该注入能引入音频中缺失的视觉内容,但其前提是视觉表示本身携带音素区分信息,否则无物可注。MISP-QEKS未见词划分Eval-blind上,-10 dB时相对基准系统XEQ-Matcher的等错误率(Equal Error Rate,EER)降低72.9%。该结论仅在音素可线性恢复的视觉编码器如AV-HuBERT下成立,使用任务训练的CNN-ResNet时注入相对掩码在-10 dB几乎无增益,且干净条件下声学证据完整使视觉增益很小,推理时移除或置零视觉流也会使低信噪比性能退回接近纯音频水平。尚未验证范围限于MISP-QEKS特定录制环境噪声与5、0、-5、-10 dB条件,两评估划分说话人不同且关键词平均音素数不同故非受控词汇比较,每系统仅训练一次故未验证训练方差。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/Padawan101/GIVE-KWS — 链接可访问(HTTP 200)
第三方资源:https://github.com/Kyubyong/g2p — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
8. 同时听懂内容和方位:MiDashengLM-Spatial 如何统一语义理解与空间感知

英文题目:MiDashengLM-Spatial: Unifying General Audio Understanding and Spatial Awareness
标签:#音频问答 | #多模态学习 | #联合声音事件检测定位 | #空间音频信号 | #音频大模型
评分:8.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Jinbo Hu:机构信息未在 arXiv HTML 中可靠披露
- Hang Su:机构信息未在 arXiv HTML 中可靠披露
- Lichun Fan:机构信息未在 arXiv HTML 中可靠披露
- Heinrich Dinkel:机构信息未在 arXiv HTML 中可靠披露
- Gang Li:机构信息未在 arXiv HTML 中可靠披露
- Zhanchen Dai:机构信息未在 arXiv HTML 中可靠披露
- Yiru Zhang:机构信息未在 arXiv HTML 中可靠披露
- Chang Liu:机构信息未在 arXiv HTML 中可靠披露
- Peng Wang:机构信息未在 arXiv HTML 中可靠披露
- Junnan Wu:机构信息未在 arXiv HTML 中可靠披露
- Jian Luan:机构信息未在 arXiv HTML 中可靠披露
- Cong Zou:机构信息未在 arXiv HTML 中可靠披露
- Heng Qu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
论文要解决的输入是双耳多通道音频,期望输出是既能回答通用语义问题又能描述声源方位、距离与运动的自然语言,难点在于通道间线索容易在单声道平均中丢失,而已有空间模型又削弱了通用理解。语义分支保留32层结构,先将双耳信号下混为单声道并提取通用事件语义表征,同时保留原有通用理解通路不受干扰。新增12层空间分支直接接收双通道特征以保留左右耳差异,层级语义到空间条件模块把语义分支多层中间表征经适配器投影后,加到空间分支对应深度的表征上,使空间线索按语义归属到重叠声源。两路输出嵌入相加后送入大语言模型生成回答,监督数据则用房间脉冲响应与头相关传输函数合成约13000小时双耳场景,并由位置元数据确定性生成场景描述与选择题。空间评测中该模型在STAR-Bench空间推理子集达到70.3%准确率,高于单声道对照MiDashengLM-7B-1021的44.3%,通道交换全对率达到72.6%。结论适用于合成分布相近的双耳问答与字幕,运动轨迹精确匹配与三源重叠计数仍不可靠。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/xiaomi-research/midashenglm-spatial — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/mispeech/midashenglm-spatial — 暂时无法访问
第三方资源:https://www.oeaw.ac.at/isf/outreach/software/hrtf-database — 链接不可用(HTTP 403)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
9. FASTDIAR:一次读取音频流的帧级说话人编码与在线聚类
英文题目:FASTDIAR: Frame-level speaker encoder for Streaming Diarization
标签:#说话人分离标注 | #知识蒸馏 | #流式处理 | #实时处理
评分:8.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Nikita Torgashov:Department of Speech, Music and Hearing;KTH Royal Institute of Technology;Stockholm, Sweden
- Okan Köpüklü:Microsoft;Munich, Germany
📌 核心摘要
流式说话人分离标注需在音频到达后不足1秒内逐帧判断由谁发声,且常限单中央处理器线程,而已有做法把单人话语训练的话语级编码器套用于高度重叠短窗,反复重算已见样本,既浪费计算又难以及时遗忘旧说话人并定位切换点。FASTDIAR把ReDimNet2改为因果结构,左侧填充二维卷积去除未来信息,以全连接块替代跨全句共享信息的注意力块,并去掉时域池化直接逐帧投影,使音频流只读一次,每80毫秒输出一个192维单位向量,有效历史限定为过去2秒。该向量流进入置信度计算,以当前嵌入与10帧前嵌入的余弦相似度为置信度,仅稳定置信帧可加入锚点集并以中值更新说话人中心,其余帧不污染中心。这些中心与待判帧再进入聚类判决,经12帧即960毫秒修正窗延迟输出,置信帧到达后回溯确定窗内标签并触发簇间合并修复过分割,非置信帧耗尽上下文后就近归入最近中心,语音活动检测直接剔除静音帧。在排除重叠语音条件下,VoxConverse全集上FASTDIAR的分离错误率(diarization error rate,DER,越低越好)为12.35%,低于Streaming Sortformer的19.15%、diart的16.12%和LS-EEND的39.07%。该结论适用于低重叠基准和固定超参数条件,在DIHARD3等高难度或重叠较多集合上不再成立。原文报告编码器加语音活动检测(voice activity detection,VAD)加聚类的实时率为0.19,延迟固定为960毫秒。
🔗 开源资源
- 代码相关资源:https://github.com/microsoft/fastdiar — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
10. 提前保护参考语音:用对抗扰动阻止匿名语音的重识别

标签:#说话人匿名化 | #对抗训练 | #说话人验证 | #隐私保护
评分:8.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Michele Panariello:机构信息未在 arXiv HTML 中可靠披露
- Yibo Bai:机构信息未在 arXiv HTML 中可靠披露
- Massimiliano Todisco:机构信息未在 arXiv HTML 中可靠披露
- Nicholas Evans:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音匿名化的输入是需隐藏说话人身份的测试语音,输出是保留语言内容但指向伪说话人的语音,难点在于知晓匿名化系统的半知情攻击者会用同样系统匿名化自己持有的注册语音和训练数据,从而训练适配的自动说话人验证系统做重识别。论文提出先发防御:在参考语音被获取前先加入对抗扰动,扰动后语音仍可听懂,但经已知匿名化系统处理后注册侧匿名语音严重劣化,与测试侧形成分布失配。方法先用B5的wav2vec 2.0骨干或B4的语义编码器从原始参考语音提取时序特征向量,再以扰动前后特征向量的L1距离为码字或语义切分翻转的可微代理目标,在扰动半径约束下用投影梯度下降逐句优化扰动,B5优化时还随机右补零以适应推理填充。最后攻击者按半知情流程用同一系统将含扰动的注册语音转为匿名注册语音,用于和测试侧匿名语音比对,因此该防御施加于注册侧,与只处理测试侧的常规匿名化互补。与只做测试侧匿名化相比,该组合在更强的2026版攻击者下把B4的等错误率从14.33%提高到44.51%左右,接近50%的完全隐私目标。结论仅在已验证的B4与B5系统、libri_test注册集及2024与2026版攻击者下成立,B5在无界扰动下词错误率仅升至2.59%,而B4无界扰动下升至29.58%,说明大扰动下B4的可懂度保持可能失败。知晓防御的攻击者用扩散纯化方法DAP在扰动界不超过0.3时几乎完全消除保护,更大扰动界、其他匿名化系统与真实社交语音场景尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/eurecom-asp/preemptive_VA_defense — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
11. 把含糊音乐请求拆成可逐条听判的清单再修提示词:MIRA 与 MuRA-Bench 解读

英文题目:MIRA: A Musical Intent Refinement Agent for Aligning Text-to-Music Generation with User Intent
标签:#音乐生成 | #工具增强与约束解码 | #基准测试 | #音乐
评分:8.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zekai Liu:机构信息未在 arXiv HTML 中可靠披露
- Zhilin Wang:机构信息未在 arXiv HTML 中可靠披露
- Xuzheng He:机构信息未在 arXiv HTML 中可靠披露
- Yu Cheng:机构信息未在 arXiv HTML 中可靠披露
- Yang Yang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
文本到音乐生成需把用户请求变为完整歌曲,难点是请求常不完整,既有乐器、结构、节奏或情绪走向等明示约束,也有艺人、作品、场景和用途隐含的风格意图,单一整体相关分数难定位哪条未实现。论文把每个请求表示为专家修订的金标准条目集合,分为请求直接支持的基本要求与从引用和上下文补全的补全要求,再用音乐专用音频语言模型MusicFlamingo对每条做是或否的音频问答打分。MIRA先保留原始请求并用外部工具补全隐含意图,形成搜索前固定的在线条目集合,该集合由所有候选节点共享。作为搜索依据,在线条目集合用于指导提示词生成、逐条验证生成音频,并驱动分支记忆的树搜索修订提示词,保留已满足条目并修复未满足条目,且不更新黑盒生成后端参数。在包含MuRA-Bench全部100个请求的评估中以专家修订金标准条目计算Overall指标时,预算B=9下YuE2-3B结合MIRA得82.1,超过直接提示的Suno v5.5的81.9,Overall越高越好。结论受限于该基准的条目分布与所用评估器,隐含意图的多解性与三位专家的音乐惯例可能带来偏差。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://mirareview.github.io/ — 链接可访问(HTTP 200)
代码相关资源:https://github.com/mirareview/MIRA — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
12. 用复数融合做开放词汇音视事件定位

英文题目:Open-Vocabulary Audio-Visual Event Localization via Complex-Valued Fusion
标签:#音频事件检测 | #多模态学习 | #音视频 | #生成对抗网络
评分:8.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Anirudh Praveen:机构信息未在 arXiv HTML 中可靠披露
- Koteswar Rao Jerripothula:机构信息未在 arXiv HTML 中可靠披露
- Pratik Joshi:机构信息未在 arXiv HTML 中可靠披露
- Aveen Dayal:机构信息未在 arXiv HTML 中可靠披露
- Neela Sawant:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
开放词表音视频事件定位的输入是切成每秒一段的十秒视频、对应音频和候选类别名构成的文本提示,输出是每段的类别标号,测试类别在训练时从未出现。难点是在冻结共享空间中仅靠视觉与文本、音频与文本的两路余弦相似度完成未见类的逐段判决,固定标量规则合并会丢掉随类别和段变化的自由度。论文保留冻结的ImageBind编码器计算两路相似度,不再用几何平均等固定标量规则合并,而是把视觉路与音频路相似度作为实部与虚部构成复数值,送入五层复数卷积网络学习融合后取幅度评分再逐段取最大类别。完整版本进一步为每个模态增加伴随流,视觉侧用iHSV变换的虚部图像,音频侧用CycleGAN翻译到梅尔流形的相位谱图,形成两个模态各自的内容加结构复数对,再堆叠送入同一融合网络,其中编码器保持冻结,只训练时序自注意力块与融合网络。在OV-AVEBench数据集未见类划分的评测设置下,四流模型相对微调基线在准确率/段级F1/事件级F1上以66.5/59.1/54.1%高于基线,提高1.6/4.1/6.6个百分点且事件级指标提升最大。结论适用于冻结主干加类别无关时序卷积的开放词表协议,测试时仅扩展文本提示集而不更新参数,跨数据集迁移中四流并不总是优于双流。在原文补充材料给出的推理成本比较中,四流模型相对微调基线的推理延迟增加约135 ms。
🔗 开源资源
- 代码相关资源:https://github.com/AnirudhPraveen/Complex-Valued-OV-AVEL — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
13. 一个冻结编码器如何同时做说话人确认与伪造检测

英文题目:Unified Shared Encoder in Spoof-Aware Speaker Verification with Hybrid Wavelet Prompt Tuning
标签:#说话人验证 | #前缀微调 | #语音伪造检测 | #语音
评分:7.9/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Aref Farhadipour:机构信息未在 arXiv HTML 中可靠披露
- Srikanth Madikeri:机构信息未在 arXiv HTML 中可靠披露
- Teodora Vukovic:机构信息未在 arXiv HTML 中可靠披露
- Volker Dellwo:机构信息未在 arXiv HTML 中可靠披露
- Petr Motlicek:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
欺骗感知说话人验证以注册语音和测试语音为输入,输出联合接受分数,需同时确认身份归属与语音真实性,难点在于身份线索与伪造痕迹依赖不同层次特征并在单一表示中互相干扰。与维护两个独立大编码器的级联结构不同,论文采用统一共享编码器,以冻结的W2V-BERT 2.0为公共主干,每个任务用独立混合小波提示微调提示组在各层注入任务条件,提示参与键与值投影,为音频查询提供不同虚拟上下文。说话人验证分支先对多层输出做静态分层加权,再经注意力池化与映射得到说话人嵌入,推理时注册与测试嵌入的余弦相似度即为身份分数,伪造检测分支以同批分层特征为输入,改用跨层注意力捕捉多尺度伪影并输出真实语音概率,该概率与经Sigmoid校准的身份分数在推理时相乘得到最终分数。与两编码器级联基线相比,该系统在SpoofCeleb评估集上最小a-DCF从0.047降至0.038、CM-EER从0.16%降至0.03%。增加在VoxCeleb2数据上训练的第二个说话人验证头后,扩展配置在SpoofCeleb评估集上最小a-DCF从基础系统的0.038进一步降至0.035,但因引入域外数据而不构成同等条件比较,仅证明可独立挂接新头。在ASVspoof5评估集上,该系统仅用官方提供数据取得0.092最小a-DCF,其挑战赛排名优于封闭条件下的所有系统。结论适用于含噪声、混响、编解码失真和多种合成攻击的野外数据,但攻击间和重压缩条件下误差明显升高;两分支独立训练,推理需两次经过共享编码器的提示条件前向。
🔗 开源资源
代码相关资源:https://github.com/areffarhadi/unified-SASV — 链接可访问(HTTP 200)
模型相关资源:https://github.com/areffarhadi/unified-SASV — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
14. 听见与看见必须连起来:OmniReasoning 如何构造与训练音视频联合推理

英文题目:OmniReasoning: Pushing the Limits of Audio-Visual Joint Reasoning
标签:#音视频问答 | #强化学习 | #音视频 | #基准测试 | #数据集
评分:7.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1/1.5 | 可复现 0.1/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Junming Lin:机构信息未在 arXiv HTML 中可靠披露
- Yuxuan Wang:机构信息未在 arXiv HTML 中可靠披露
- Zhenxin Lei:机构信息未在 arXiv HTML 中可靠披露
- Yuxin Liu:机构信息未在 arXiv HTML 中可靠披露
- Ruixun Liu:机构信息未在 arXiv HTML 中可靠披露
- Yinsong Yan:机构信息未在 arXiv HTML 中可靠披露
- Ling Wang:机构信息未在 arXiv HTML 中可靠披露
- Minghao Han:机构信息未在 arXiv HTML 中可靠披露
- Yunfei Chu:机构信息未在 arXiv HTML 中可靠披露
- Shun Lei:机构信息未在 arXiv HTML 中可靠披露
- Xueyao Zhang:机构信息未在 arXiv HTML 中可靠披露
- Qize Yang:机构信息未在 arXiv HTML 中可靠披露
- Jin Xu:机构信息未在 arXiv HTML 中可靠披露
- Yiwu Zhong:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
现实视频问答的难点在于答案分散在所听到的语音和所看到的画面中,模型需要把跨事件的线索连成证据链,单看一侧模态会丢失必要条件。论文构建评测基准(英文全称 OmniReasoningBench)来固定这种依赖,包含视频内推理和把视频所得规律用于新情景的视频外推理两类问题,每题附参考答案和证据链。数据引擎(英文全称 OmniQA)把视频切分为事件并分别生成带时间戳的音频描述和视觉描述,再生成问题、参考答案和连接观察与中间推断的依赖链,经过结构校验、答案校验、媒体校验和单模态捷径筛查后保留样本。保留的时间戳线索一方面用于扩展成监督微调所需的思考过程,另一方面作为特权文本线索供强化学习阶段评分。学习方法(英文全称 Modality-Factored Self-Distillation,缩写 MFSD)在无特权线索时采样多个回答,再用同一行动者模型在无线索、音频线索、视觉线索和联合线索四种条件下计算词元似然,用联合增益与去均值后的非加性交互组合成词元分数并映射为优势权重。与基线相比,所提模型在 OmniVideoBench 上达到 50.0%准确率,在 OmniReasoningBench 上达到 42.5%准确率,分别超过基础模型 Qwen3-Omni-30B-A3B-Thinking 12.8 和 9.3 个百分点。该结论适用于需要音频与视觉互补的视频问答及部分长视频理解,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://pku-value-lab.github.io/OmniReasoning-Homepage → https://pku-value-lab.github.io/OmniReasoning-Homepage/ — 链接可访问(HTTP 200)
代码相关资源:https://github.com/PKU-VaLuE-Lab/OmniReasoning — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
15. 转录文本与推理多样性如何降低生成式语音增强的幻觉

标签:#语音增强 | #流匹配 | #偏好优化 | #多模态学习 | #幻觉与忠实度
评分:7.8/10 | 创新 1.6/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.4/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yingda Shen:机构信息未在 arXiv HTML 中可靠披露
- Yao Qian:机构信息未在 arXiv HTML 中可靠披露
- Yuxuan Hu:机构信息未在 arXiv HTML 中可靠披露
- Junan Zhang:机构信息未在 arXiv HTML 中可靠披露
- Yuxiang Wang:机构信息未在 arXiv HTML 中可靠披露
- Hardik Hansrajbhai Chauhan:机构信息未在 arXiv HTML 中可靠披露
- Yudong Li:机构信息未在 arXiv HTML 中可靠披露
- Yufei Xia:机构信息未在 arXiv HTML 中可靠披露
- Yufei Liu:机构信息未在 arXiv HTML 中可靠披露
- Zhizheng Wu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音增强的输入是含噪声与混响的波形,输出是保留原说话内容与音色的干净波形,难点是生成模型在严重退化下会输出流畅但改词、漏词或改变说话人的音频。AuraSE将含噪输入的识别转录与退化对数梅尔谱图共同输入双流到单流多模态扩散变换器,语谱图与文本标记联合注意但保留各自投影,使文本校正内容而声学通路保留说话人与信号细节。模型预测流匹配的速度场,再由常微分方程解码器积分得到干净语谱图,并经预训练声码器重建波形。对同一输入以引导强度、采样温度与步数构成的多种推理策略解码时,无单一组合对所有句子最优,而策略间奖励差异构成稠密偏好来源。推理策略优化用当前模型在多策略下生成候选,以感知质量、词错率、说话人相似度与语音BERT分数组成的多目标奖励打分,按奖励差距采样偏好对并在线更新模型,将多配置增益蒸馏到固定解码器。在824句混响与824句非混响合成测试上,AuraSE-IPO在12个指标中的11个上排名第一,混响下词错率(Word Error Rate,WER)为8.22%,低于含转录条件的FlowSE的10.20%。结论适用于所用合成噪声与真实DNS盲测录音范围,依赖外部识别模型提供转录,训练、推理与部署成本未披露具体实测值。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
16. 合唱转谱如何同时分出女高女低男高男低四个声部

英文题目:Toward Part-Aware Choral Transcription with singing voice assignment
标签:#音乐转录 | #端到端学习 | #音乐 | #数据增强
评分:7.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hanyu Meng:机构信息未在 arXiv HTML 中可靠披露
- Zhanhong He:机构信息未在 arXiv HTML 中可靠披露
- Zixun Guo:机构信息未在 arXiv HTML 中可靠披露
- Yaolong Ju:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
合唱录音常包含女高音、女中音、男高音、男低音同时演唱,输入是混缩后的人声音频,期望输出是按声部标注的独立音符序列,难点在于起音柔和、连音过渡平滑、音色相近且音域大量重叠。论文提出的声部感知合唱转录(Part-aware Choral Transcription,PawCT)用共享卷积循环编码器提取帧级表示,再由各声部分支分别预测起音、止音和帧激活,并用声部存在估计屏蔽未激活声部。训练时把合并层面的整体监督与声部层面的监督相加,还用音域先验和有序连续扩展构造结构化训练目标,约束音高落在合理音区并保持旋律连续与同时起音的音高顺序。与已有方法的关键差异在于转录与声部分配在声学层面联合学习,对应的声部无关版本PagCT只输出一条合并轨道,而两阶段对照先用PagCT解码再用符号模型Post-VA分配声部。在YouChorale测试集上,50毫秒起音容差下PawCT-RP-OC的声部平均音符F1为0.225高于改编后的已有合唱模型的0.165,前者相对高出36.4%。该结论在仅以YouChorale训练且阈值不变直接测试CSD和Cantoría时仍成立,CSD上同指标下PawCT-RP-OC为0.174高于两阶段对照的0.118,但CSD绝对值低于YouChorale,原文认为录音条件和标注差异可能影响结果,域适应与解码校准尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://hanyu-meng.github.io/Paw_Choral_AMT_Demo/ — 链接可访问(HTTP 200)
演示资源:https://hanyu-meng.github.io/Paw_Choral_AMT_Demo/ — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/MuScriptor/muscriptor-medium — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
17. 随机乐谱与多样音色:在线生成数据如何帮助自动音乐转录

标签:#音乐转录 | #数据增强 | #域泛化 | #音乐
评分:7.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Haiwen Xia:机构信息未在 arXiv HTML 中可靠披露
- Chao Zhang:机构信息未在 arXiv HTML 中可靠披露
- Qiuqiang Kong:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
自动音乐转录要把录音变成音高、起止时间与乐器等符号音符,难点是精确标注的多声部录音稀少,合成数据能否替代真实乐谱结构并不清楚。论文把在线生成拆成符号采样器与音频渲染器,采样器决定目标音符集合,渲染器决定其声音实现,两路独立控制后与固定离线录音联合训练。符号侧用统一损坏采样器在原始片段、部分损坏与音符属性独立重抽之间连续调节,音频侧用NSynth单音渲染与Pianoteq预设整轨渲染分别控制音色范围。固定转录模型为卷积前端加时间Transformer编码器与分通道共享解码器,输出各乐器通道的事件token。在固定MAESTRO片段采样与训练预算的MAPS外域评测下,Pianoteq音色从程序0的4%扩大到100%再到0-7号程序时Agn起始F1从59.40%升到78.13%,超过真实MAESTRO录音训练的77.14%。结论适用范围是音符级属性与声学实现的覆盖优先于完整乐谱的联合结构,局限是键盘外乐器覆盖不足且强基线下增益收窄。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/Haiwen-Xia/randomscore-amt — 链接可访问(HTTP 200)
第三方资源:https://www.modartt.com/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
18. 用不协和度地形安放微分音七和弦:谐波特征空间与作曲应用

英文题目:Harmonic Eigenspace: A Web-based Application for Navigating and Composing Microtonal Harmony
标签:#音乐生成 | #音乐分析 | #信号处理 | #心理声学实验
评分:7.6/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 0.8/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 1.5/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- David Dalmazzo:机构信息未在 arXiv HTML 中可靠披露
- Ken Déguernel:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
论文要解决的是微分音和声缺少统一位置与听觉参照的问题,十二平均律之外的三度与七度分级在传统调式理论中没有固定坐标,作曲者难以比较和连接不同律制的四音和弦。方法把根音固定,将上方音与根音的频率比记为坐标三元组,均匀缩放对应移调而根音频率只改变整体尺度,每个点的感觉不协和度取全部泛音两两粗糙度之和,连续求值形成不协和体积,局部极小点对应泛音重合的纯律位置并作为地标。应用层用可点击的三维体可视化呈现音区节点、极小点与多律制和弦,另用调式工作室提供音阶编辑、进行网格与五度螺旋配器,音频经网页音频合成并支持复音表情输出。听辨第一部分以十九个孤立五十三平均律七和弦为数据集,将平均感知不协和度与空间计算值比较,Spearman ρ=0.481、p=0.037、近似95%置信区间0.01至0.78与Pearson r=0.569、p=0.011、95%置信区间0.15至0.81均呈正向关联且区间不含零,其中Pearson区间下界0.15不是零故不含零才支持正关联,但区间宽大只支持方向而量级未定属初步证据。听辨第二部分以十条五十三平均律进行为数据集,在同一一至十量表整体平均评分指标上,和声连贯性均值6.86高于不协和度均值5.60,大调与属功能主和弦进行更易被接受而中性主和弦最低。结论只适用于谐波音色、正弦与三角波合成、给定锚定和首次接触条件,原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://anonymous.4open.science/r/Harmonic_Eigenspace_Dataset-2086/ — 链接可访问(HTTP 200)
数据相关资源:https://anonymous.4open.science/r/Harmonic_Eigenspace_Dataset-2086/ — 链接可访问(HTTP 200)
第三方资源:https://dazzid.github.io/ANIMA_Harmonic_Eigenspace/ — 链接可访问(HTTP 200)
第三方资源:https://anonymous.4open.science/r/Harmonic_Eigenspace_Dataset-2086/ — 链接可访问(HTTP 200)
第三方资源:https://plotly.com/javascript/ — 链接可访问(HTTP 200)
第三方资源:https://developer.mozilla.org/en-US/docs/Web/API/Web_Audio_API — 链接可访问(HTTP 200)
第三方资源:https://p5js.org — 链接可访问(HTTP 200)
第三方资源:https://processing.org — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
19. 一致且规整的表示为何还读不出顺序内容

标签:#文本到语音 | #自监督学习 | #形式化分析 | #鲁棒性
评分:7.6/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1.5/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前25% | 文档类型:理论研究 | arXiv 原文
👥 作者与机构
- K. P. Santoso:机构信息未在 arXiv HTML 中可靠披露
- N. Z. Fadil:机构信息未在 arXiv HTML 中可靠披露
- F. P. Harsanti:机构信息未在 arXiv HTML 中可靠披露
- R. V. H. Ginardi:机构信息未在 arXiv HTML 中可靠披露
- G. N. Iyer:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
本文研究文本表示是否保留下游按顺序恢复目标所需的规范内容与词序,输入是含表面错误的破坏文本,输出是规范字节序列或由其驱动的语音,难点在于检索身份可丢细节而生成必须恢复全部词序。方法先做信息分解,把对数损失拆成输入不确定、表示损失和读出器失配三项,使可逆通道下失败只能来自后两项。再构造反例说明完全一致与联合各向同性高斯分布可与零目标信息共存,并用固定惩罚岭回归说明相同信息量下几何仍改变固定读出器的风险。最后提出非自回归框架CANOPE(Canonicalization-Oriented Predictive Embedding,面向规范化的预测嵌入),把破坏文本映射为有序潜画布并比较潜一致与规范标记监督。在40000条验证序列的自然破坏强度3下,甲骨长度时潜一致PL0的池化有效秩15.76低于标记监督PL2的15.82而几乎相同,而甲骨长度相对位置Recall@1中PL2的98.80%高于PL0的13.46%,预测长度时PL2的98.80%高于PL0的6.31%。在3930条LJSpeech验证语音的破坏分支合成经Whisper large-v3转写评估词错误率时,冻结标记监督表示接训练后MatchaTTS读出器的21.54%低于潜一致表示的99.22%,但高于端到端基线的10.93%。结论限于本文文本通道和给定读出器,语义泛化弱,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/datasets/avalonai/english-singlish-g2p — 链接可访问(HTTP 200)
第三方资源:https://keithito.com/LJ-Speech-Dataset/ — 链接可访问(HTTP 200)
第三方资源:https://www.openslr.org/12/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/tum-nlp/cannot-dataset — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
20. 两个人一起说话才算数:全双工对话模型的双人评估

英文题目:Conversation Is a Two-Body Problem: Dyadic Evaluation of Full-Duplex Dialogue Models
标签:#全双工语音交互 | #基准设计 | #基准测试 | #轮次切换
评分:7.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.5/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Sungnyun Kim:Korea Advanced Institute of Science and Technology
- Sungwoo Cho:Korea Advanced Institute of Science and Technology
- Jihwan Oh:Korea Advanced Institute of Science and Technology
- Se-Young Yun:Korea Advanced Institute of Science and Technology
📌 核心摘要
全双工语音对话模型需边听边说,轮流发言、重叠与打断由通话双方共同决定,固定录音或固定考官只能测到其中一半行为。DyaFDB以锁步时钟上的模型间桥接替代真人,将一方每80毫秒音频帧输出拼接到另一方输入,使两模型输出流互为输入流直接通话。该桥接输出的双通道录音进入角色化对话环节,模型被赋予合作或冲突私有角色并经1.5秒先发引导,在交换角色与发言顺序下反复录制一分钟对话,共录制7560段对话。对话录音与转录文本再进入离线评分环节,由信道占用与字符串匹配等机械度量及匿名转录本的Opus-5评判者按任务标准给双方打分。任务分为协作类与冲突类,分别考察角色保持、分散信息汇总、话语通道争夺及偏好与保密目标下的施压防守,信息汇总中约半数配对一分钟内无法形成决定。在T1共140个席位以人类专家多数意见为参照的评测设置下,按EM一致率指标,Opus-5为89.3%,高于Sonnet-5的85.0%。论文承认自然度尚未度量,且搭档目前只覆盖模型而非真人。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
21. 在真实多人对话里听清目标:SoundBubble-EEG 数据集解读

标签:#言语神经解码 | #数据集构建 | #数据集 | #统计分析
评分:7.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Shu Peng:Department of Data Science and Artificial Intelligence, The Hong Kong Polytechnic University, Hong Kong SAR, China
- Rui Liu:Department of Data Science and Artificial Intelligence, The Hong Kong Polytechnic University, Hong Kong SAR, China
- Yufei Zhang:Department of Data Science and Artificial Intelligence, The Hong Kong Polytechnic University, Hong Kong SAR, China
- Wenlong You:Department of Data Science and Artificial Intelligence, The Hong Kong Polytechnic University, Hong Kong SAR, China
- Zhige Chen:Department of Data Science and Artificial Intelligence, The Hong Kong Polytechnic University, Hong Kong SAR, China
- Jiachen Xi:Department of Data Science and Artificial Intelligence, The Hong Kong Polytechnic University, Hong Kong SAR, China
- Qiyuan Sun:Department of Data Science and Artificial Intelligence, The Hong Kong Polytechnic University, Hong Kong SAR, China
- Yan Liu:Department of Computing, The Hong Kong Polytechnic University, Hong Kong SAR, China
- Kay Chen Tan:Department of Data Science and Artificial Intelligence, The Hong Kong Polytechnic University, Hong Kong SAR, China
- Jibin Wu:Department of Data Science and Artificial Intelligence, The Hong Kong Polytechnic University, Hong Kong SAR, China
📌 核心摘要
论文要解决已有听觉注意解码数据集多用左侧单人对右侧单人的理想竞争范式,难以反映餐厅、客厅、会议中多人群聊加环境噪声下注意分配的问题。SoundBubble-EEG招募30名母语为中文的被试,用128导脑电记录25个试次,每个试次含3秒基线和120秒主动聆听,被试按屏幕方向线索注意目标声音泡并回答两道理解题;刺激把AISHELL4中文语音经CIPIC头相关传输函数空间化,再叠加DEMAND的餐厅、家庭和会议噪声,构成餐厅10个、客厅电视10个、会议5个空间模板。预处理依次做坏导检测插值、0.1 Hz到40 Hz滤波、平均重参考和基于独立成分标签的伪迹去除,再切分基线和任务段并按脑成像数据结构组织发布,输出的干净分段直接作为解码验证的输入。验证用向后多元时间响应函数把时移-400毫秒至100毫秒的多通道脑电线性映射到注意语音包络,再计算重建包络与注意和非注意实际包络的Pearson相关,并由此导出重建优势与单试次准确率做置换检验。在混合三种场景的25试次留一交叉验证下,以Pearson相关衡量的注意侧重建均值约0.026,高于非注意侧,重建优势Δr为0.0196,单侧Wilcoxon符号秩检验p=9.31×10⁻¹⁰。同样在该25试次留一交叉验证下,以注意重建相关超过非注意的试次比例衡量的单试次解码准确率为0.717,高于标签置换零分布,50000次置换无一达到该值,置换p=2.0×10⁻⁵。结论适用于三场景混合训练、试次内留一评估的中文聆听条件,会议场景每人仅5个试次且重建优势降至0.0092,跨被试、跨语言泛化与在线助听器部署尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/Mashirops/sound-bubble-eeg-code — 链接可访问(HTTP 200)
数据相关资源:https://doi.org/10.5281/zenodo.19610627 → https://zenodo.org/records/19610628 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
22. EMODE:用两条专家通路同时保住说了什么和怎么说

英文题目:EMODE: Dynamic Para-Semantic Experts for Emotion-Aware Speech Language Modeling
标签:#语音情感识别 | #混合专家模型 | #语音对话系统 | #基准测试
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jianan Pan:Zhejiang University, Hangzhou, China
- Yiwen Gu:Zhejiang University, Hangzhou, China
- Xinze Li:Zhejiang University, Hangzhou, China
- Rui Wang:Zhejiang University, Hangzhou, China
- Kejie Huang:Zhejiang University, Hangzhou, China
📌 核心摘要
语音情感交互输入连续语音波形,输出情感标签或贴合情绪的文本回复,难点是单一语音连接器易保留字词内容,丢失韵律音质时序中的情绪证据。EMODE先用Whisper编码器把波形转为帧级声学特征,该帧序列作为动态副语义专家Dynamic Para-Semantic Experts(DPSE)的路由输入。DPSE将每帧分送语义专家和副语言专家分别提炼字词信息与情绪韵律信息,再经帧级路由门控做残差融合,形成共享语音表示。该融合表示直接输入Qwen语言模型生成情感标签或回复,训练中语义分支受音素级CTC监督、副语言分支受话语级情绪分类监督,并以语义到声学对齐和门控多样性正则约束融合与路由。与单通路情感语音系统相比,差异是两通路具正交监督与显式融合规则,而非将情绪隐含于同一声学表示。在9个数据集的语音情感识别Speech Emotion Recognition(SER)平均准确率上,EMODE为72.10%,高于EmotionThinker的68.46%和BLSP-Emo的65.21%。该平均优势不意味着逐库最优,EMODE在IEMOCAP上不及EmotionThinker,在RESD和CaFE上不及BLSP-Emo,且在词汇固定的双语MEPA受控测试中中文子集向中性漂移、混淆更分散,说明跨语言声学依据并不均衡。因此结论仅适用于所测的域内会话、表演式与中俄希法多语言零样本识别、SpeechAlpaca模型打分回复及合成词汇控制应力测试,单评委打分不能代替人工评价,自发情感语音、抗合成稳健性与更广多语言交互尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
23. 可学习的谱激活:让隐式表示自己调整谐波组合

标签:#声场重建 | #时频分析 | #空间音频信号 | #语音 | #音乐
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tamir Shor:机构信息未在 arXiv HTML 中可靠披露
- Or Litany:机构信息未在 arXiv HTML 中可靠披露
- Alex Bronstein:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
隐式神经表示(Implicit Neural Representation,INR)把坐标映射为信号值,输入编码决定提供哪些基频,激活函数决定这些基频如何产生谐波并组合,异质信号中一条边缘或一段瞬态需要多个谐波以特定幅度协同出现。论文提出可学习谱激活(Learnable Spectral Activation,LSA),每层把固定激活替换为带残差恒等项的截断傅里叶级数,谐波幅度系数在训练中学习且在层内神经元间共享。前向时线性层先对上一层输出做仿射变换以选择特征并形成标量预激活,该预激活同时进入恒等分支与多个正弦分支,正弦分支按学习到的幅度加权求和后再与恒等项相加送入下一层。反向时线性权重与幅度系数的梯度分离更新,前者继续负责特征选择,后者专门负责谱形状塑造,从而改变表示的分解方式而不扩大渐近函数类。在24张Kodak图像的固定配置拟合中,LSA平均峰值信噪比(Peak Signal-to-Noise Ratio,PSNR)为38.110 dB,高于FINER的37.317 dB与SIREN的34.990 dB。在Blender新视角合成的8个场景中,LSA在5个场景PSNR最好、7个场景结构相似性(Structural Similarity,SSIM)最好,声学场上对数谱误差相对降低约44.90%。该结论适用于具有足够输入带宽的固定预算拟合与可微渲染优化,当外部带宽过大导致采样点之间出现混叠歧义时泛化可能不稳定,逐点计算多个正弦项的代价在严格预算下也可能抵消增益,原文报告在全网格音频拟合中相对FINER有数倍时间与显存开销,融合实现仍待探索。
🔗 开源资源
- 代码相关资源:https://github.com/tamirshor7/Learnable-Spectral-Activations — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
24. 跨会话记住谁说了什么及其时态:PERSIST 语音记忆解读

英文题目:PERSIST: Who-What-When Memory Across Sessions for Full-Duplex Spoken Dialogue
标签:#语音对话系统 | #检索增强 | #基准测试 | #实时处理
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.5/1.5
排名:前25% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Achira Lin:机构信息未在 arXiv HTML 中可靠披露
- Siyuan Hou:机构信息未在 arXiv HTML 中可靠披露
- Wenyi Yu:机构信息未在 arXiv HTML 中可靠披露
- Xinnian Zhao:机构信息未在 arXiv HTML 中可靠披露
- Haoyu Niu:机构信息未在 arXiv HTML 中可靠披露
- Wang Geng:机构信息未在 arXiv HTML 中可靠披露
- Longshuai Xiao:机构信息未在 arXiv HTML 中可靠披露
- Shihai Xiao:机构信息未在 arXiv HTML 中可靠披露
- Mangsuo Zhao:机构信息未在 arXiv HTML 中可靠披露
- Chao Zhang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
多人共用语音助手需要跨会话记住谁在何时说了什么,难点是同一话题会被多人反复修订,单纯按话题相似找回文本会混淆说话人和新旧状态。PERSIST先把历史语音跨度写成带说话人和时间的可读事件记录存入长期库,对话模型在需要历史时发出<retrieve>触发检索。触发后系统不重编码查询音频,而是复用SALMONN-omni全双工骨干已算出的编码器特征和解码器隐状态,经语义-时间池化与说话人嵌入拼成查询向量。查询向量与库中记录做语义内容、声学说话人身份和时间状态的3W联合打分,取前k条记录送回对话模型的短期上下文再生成回答。与只做语义相似或只保留最新事实的方法不同,该联合打分能区分同话题下不同说话人与修订前后状态。在SpokenTrace评测的1200个查询上,PERSIST外部转写配置相对同转写BGE-large-en-v1.5基线,端到端严格准确率从58.50%提高到85.08%。检索层面所有支撑证据完全命中率EM@3从49.01%提高到82.10%。结论适用于两段历史加一段当前查询的合成对话,对真实噪声、长轮注册和开放词汇说话人尚未验证。原文报告检索延迟从波形重算的578.42 ms降到缓冲复用的7.03 ms,训练总时长与设备数量等完整开销未说明。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
25. HiPLEX:全双工语音何时说与说什么的分层信用分配

英文题目:HiPLEX: Hierarchical Policy Factorization for Full Duplex Speech Language Models
标签:#全双工语音交互 | #语音对话系统 | #强化学习 | #语音大模型
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1.2/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1.1/1.5
排名:前25% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kyudan Jung:机构信息未在 arXiv HTML 中可靠披露
- Hyunsin Park:机构信息未在 arXiv HTML 中可靠披露
- Yoonhyung Lee:机构信息未在 arXiv HTML 中可靠披露
- Jinhwan Park:机构信息未在 arXiv HTML 中可靠披露
- Jinhyeok Yang:机构信息未在 arXiv HTML 中可靠披露
- KiHyun Nam:机构信息未在 arXiv HTML 中可靠披露
- Jaegul Choo:机构信息未在 arXiv HTML 中可靠披露
- Jinkyu Lee:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
全双工语音语言模型需要在连续听取用户语音的同时流式生成自身语音,输入是双通道音频历史与已生成文本,输出是下一帧是否发声以及发声时的具体词元,难点是迟答、抢话、误打断与中断后恢复都发生在不同时间位置。HiPLEX先把已有文本分布按词表划分分解为控制策略和条件内容策略,控制策略输出pad、epad、cont三组概率,决定继续等待还是进入发声。只有当控制策略选中cont时,条件内容策略才输出具体内容词元分布,从而把何时说的时机选择与说什么的内容选择分开执行。随后时机奖励经组内标准化后通过事件因果掩码只更新控制决策,语义奖励由自动语音识别(Automatic Speech Recognition)转写加Gemini 2.5 Flash-Lite打分后只更新内容决策,使两类反馈各有归属而不互相干扰。在Full-Duplex-Bench v1上,Moshi加HiPLEX相对复现的组相对策略优化(Group Relative Policy Optimization,GRPO)基线把CANDOR停顿接管率从0.454降到0.306。在同一基准与基线比较下,中断后响应延迟从0.660 s降到0.439 s,三个训练种子平均仍保持相近趋势。结论适用于Moshi与PersonaPlex的受控复现协议,不等同于所有对话场景都更自然,PersonaPlex的官方轮次接管率与延迟变化需要配合边界后词活动阅读。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
26. CrossEdit:用音频编辑学会的指令能力去改电影声画

英文题目:CrossEdit: Cross-Modal Training Enables Rich Audio-Visual Editing
标签:#音视频生成 | #语音编辑 | #流匹配 | #迁移学习 | #基准测试
评分:7.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前25% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- William Chen:机构信息未在 arXiv HTML 中可靠披露
- Prem Seetharaman:机构信息未在 arXiv HTML 中可靠披露
- Ke Chen:机构信息未在 arXiv HTML 中可靠披露
- Oriol Nieto:机构信息未在 arXiv HTML 中可靠披露
- Kevin Duarte:机构信息未在 arXiv HTML 中可靠披露
- Siddharth Srinivasan Iyer:机构信息未在 arXiv HTML 中可靠披露
- Mamshad Nayeem Rizve:机构信息未在 arXiv HTML 中可靠披露
- Zhiwen Cao:机构信息未在 arXiv HTML 中可靠披露
- Shinji Watanabe:机构信息未在 arXiv HTML 中可靠披露
- Yuanjun Xiong:机构信息未在 arXiv HTML 中可靠披露
- Jianming Zhang:机构信息未在 arXiv HTML 中可靠披露
- Zeyu Jin:机构信息未在 arXiv HTML 中可靠披露
- Justin Salamon:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
多媒体编辑要求模型读懂组合式自然语言指令,只改动图像、音频和视频中被指定的元素,同时保持未提及内容和音画时间关系不变,现有系统多局限在单模态单属性修改。CrossEdit把输入指令、输入媒体序列和输出媒体序列建模为条件生成问题,各模态输入媒体先由各自的变分自编码器编码为潜表示,文本、图像和视频输入还得到预训练Qwen3-VL语义嵌入,两者与编辑指令共同作为条件送入共享的扩散变换器骨干。该骨干对输出潜表示去噪,得到的输出潜表示再交由各自的变分自编码器解码为图像、音频和视频。训练从内部预训练检查点CrossEdit-Base出发,加入两类数据微调,一类是利用声音波形可叠加性质大规模合成的复杂音频编辑对,另一类是以修复该视频为指令的音视频遮罩重建,前者教组合指令遵循,后者教在已有场景中生成贴合上下文的新内容。评测引入真实电影片段的人标基准CrossEditBench和音视频忠实编辑分数,该分数把指令遵循增益和一致性用调和平均结合。在CrossEditBench零样本音视频场景编辑上,以音视频忠实编辑分数衡量,CrossEdit为0.30,高于MiniMax H3的0.23。在CrossEditBench人评消融中,以音视频忠实编辑分数衡量,加入合成音频编辑对和遮罩重建使CrossEdit从CrossEdit-Base的0.26提升到0.43。适用范围限于短片段和已评测的编辑类型,嘈杂自制视频和长片编辑尚未验证;原文未披露训练、推理或部署成本。
🔗 开源资源
- 演示资源:https://wanchichen.github.io/crossedit/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
27. 多人自然对话怎么录下来、标清楚并用来做交互

标签:#语音交互 | #数据集构建 | #数据集 | #基准测试
评分:7.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前25% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Chengyou Wang:机构信息未在 arXiv HTML 中可靠披露
- Mingchen Shao:机构信息未在 arXiv HTML 中可靠披露
- Chunjiang He:机构信息未在 arXiv HTML 中可靠披露
- Zeyu Zhu:机构信息未在 arXiv HTML 中可靠披露
- Jierui Guo:机构信息未在 arXiv HTML 中可靠披露
- Bingshen Mu:机构信息未在 arXiv HTML 中可靠披露
- Zikai Liu:机构信息未在 arXiv HTML 中可靠披露
- Hanke Xie:机构信息未在 arXiv HTML 中可靠披露
- Yuhang Dai:机构信息未在 arXiv HTML 中可靠披露
- Zhou Zhu:机构信息未在 arXiv HTML 中可靠披露
- Lei Xie:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
多人语音交互要求系统在2到4人自然对话中同时处理说话人区分、内容转写和抢话、重叠、停顿等待等行为,难点是缺少带同步分轨和细粒度行为标注的普通话数据。论文收集家教和社交闲聊两类在线真实互动,保留原始时间同步的每人单轨,先做分轨语音检测、多系统识别融合与说话人标定,再生成轮次状态、副语言和说话人属性标注。人工核验的SmoothConv共100小时,用于可靠分析与评测,自动构建的DuplexConv共2000小时,用于大规模训练,两者共用同一标注维度并配有SmoothConv Benchmark。在SmoothConv Benchmark上,用DuplexConv适配的SoulX-Transcriber把基线的DER从40.89%降到13.50%,并把cpWER从27.04%降到17.38%。在SmoothConv对话评测上,用DuplexConv分轨构建混合数据训练的语音分离把SI-SDRi从纯仿真训练的13.55 dB提高到17.26 dB。该结论仅适用于2到4人、平均重叠率3.33%的家教与社交闲聊近场对话且说话人不重叠的评测条件,在远场AliMeeting上转写错误上升,而等待状态评测依赖合成样本,因而远场、更高重叠及真实等待行为等范围尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/qualialabsAI/SmoothConv-DuplexConv — 链接可访问(HTTP 200)
数据相关资源:https://github.com/qualialabsAI/SmoothConv-DuplexConv — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
28. 用索博列夫距离衡量音频渐变的规则程度

英文题目:Sobolev Norms in Neural Embeddings Measure Audio Morphing Regularity
标签:#音频生成 | #评测协议 | #模型评估 | #音乐
评分:7.4/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Théo Chasle Cauchy:机构信息未在 arXiv HTML 中可靠披露
- Modan Tailleur:机构信息未在 arXiv HTML 中可靠披露
- Barbara Pascal:机构信息未在 arXiv HTML 中可靠披露
- Fanny Roche:机构信息未在 arXiv HTML 中可靠披露
- Mathieu Lagrange:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音频变形要求合成源声音到目标声音之间的中间样本,使听感从一端逐渐过渡到另一端,难点在于听感渐进难以用客观几何准则完整刻画。论文提出理想线性均匀变形作为参照,即在感知相关的嵌入空间中沿直线匀速移动,并提出到理想变形的Sobolev距离,用零阶距离度量偏离,再用一阶导数距离额外惩罚路径偏离。待评轨迹与理想轨迹先映射到同一音频嵌入,再计算上述距离,距离越小表示同时满足直接性与均匀性。为获得可控参照,论文用矩形鼓膜振动偏微分方程的函数传递法求解器合成木质到金属质感的连续变化,保持其余合成参数一致而均匀改变阻尼参数。在由该合成器生成的1000条LUM轨迹与1000条随机Null轨迹的评测中,按归一化指标S1,2 LUM/S1,2 Null衡量,MERT-v1-330M均值为0.02,低于MFCC的0.07,数值越小表示规则性越好。结论适用于以MERT类深层音乐嵌入为感知代理的规则性排序,对真实乐器对应关系与人耳判断尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://theochaslecauchy.github.io/paperSobolevMorphingMetric → https://theochaslecauchy.github.io/paperSobolevMorphingMetric/ — 链接可访问(HTTP 200)
数据相关资源:https://theochaslecauchy.github.io/paperSobolevMorphingMetric → https://theochaslecauchy.github.io/paperSobolevMorphingMetric/ — 链接可访问(HTTP 200)
第三方资源:https://theochaslecauchy.github.io/paperSobolevMorphingMetric → https://theochaslecauchy.github.io/paperSobolevMorphingMetric/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
29. HelixWorld:能看、能听、能实时操控的音画世界模型

英文题目:HelixWorld: A Real-time Interactive Audio-Visual World Model
标签:#音视频交互 | #知识蒸馏 | #数据集 | #基准测试
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Lei Ke:机构信息未在 arXiv HTML 中可靠披露
- Jiahao Pan:机构信息未在 arXiv HTML 中可靠披露
- Zeyue Tian:机构信息未在 arXiv HTML 中可靠披露
- Jiaming Wang:机构信息未在 arXiv HTML 中可靠披露
- Haoyuan Huang:机构信息未在 arXiv HTML 中可靠披露
- Kam Man Wu:机构信息未在 arXiv HTML 中可靠披露
- Pengjun Fang:机构信息未在 arXiv HTML 中可靠披露
- Hongyu Liu:机构信息未在 arXiv HTML 中可靠披露
- Chenyang Qi:机构信息未在 arXiv HTML 中可靠披露
- Lin Wang:机构信息未在 arXiv HTML 中可靠披露
- Ruibin Yuan:机构信息未在 arXiv HTML 中可靠披露
- Weijia Chen:机构信息未在 arXiv HTML 中可靠披露
- Fangneng Zhan:机构信息未在 arXiv HTML 中可靠披露
- Qifeng Chen:机构信息未在 arXiv HTML 中可靠披露
- Wei Xue:机构信息未在 arXiv HTML 中可靠披露
- Yike Guo:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
交互式世界模型要处理用户键盘动作与连续6自由度相机轨迹输入,输出同步演化的画面与随视点转动的空间立体声,难点在于缺少带真实立体声与度量相机位姿的训练数据,且因果滚动误差会在视觉与音频分支同时累积。HelixWorld先以可扩展筛选管线剔除伪立体声与非现场声音并恢复帧对齐的度量相机位姿,建立高保真音画训练语料。在此语料上训练的双向教师模型把相机轨迹与离散动作注入视频分支,再经跨模态注意力传到音频分支,实现视角与声场的原生协同。随后教师被蒸馏为少步因果学生模型,在线轨迹蒸馏损失把学生速度场锚定到教师概率流常微分方程端点,抑制分布匹配带来的多样性下降与长滚动漂移。配合滑动键值缓存的长时微调,学生模型维持稳定的流式联合生成。在HelixBench的1015个人工核验案例上,因果学生模型取得Spatial得分41.7583,超过回放同一视频的ThinkSound配音基线的14.8467。推理成本在单张NVIDIA H800上以768×512分辨率、24帧每秒含音画解码测得稳态实时因子RTF为0.77,蒸馏训练成本为6个节点、每节点8张H200。结论适用于有主导可见声源、立体声真实的导航与视角变化场景,对多声源混杂与极端运动的稳定性尚未充分验证。
🔗 开源资源
第三方资源:https://github.com/NoizAI/HelixWorld — 链接可访问(HTTP 200)
第三方资源:https://helixworld.org/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
30. 学爵士钢琴家的风格:用交叉注意力控制生成谁在弹

英文题目:Learning Jazz Pianist Style with Cross-Attention Conditioning
标签:#符号音乐生成 | #音乐分析 | #Adapter | #Transformer
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Drew Edwards:机构信息未在 arXiv HTML 中可靠披露
- Akira Maezawa:机构信息未在 arXiv HTML 中可靠披露
- Simon Dixon:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
爵士钢琴家的风格融于和声选择、旋律语汇、节奏型与触键等作曲与演奏一体的内容,难以用规则描述,也难以靠逐词似然判断生成是否学到身份。论文输入为自动转录的独奏爵士钢琴MIDI,经Aria的AbsTokenizer转为音高-力度、起始时间、时值三元组序列,输出是指定钢琴家风格的延续演奏,分类器则输出整曲的风格归属。预训练Aria主干先被微调为演奏者分类器,用类别平衡交叉熵学习身份判别表示,其判别结果后续作为风格保真度的度量工具。同一主干再插入门控交叉注意力适配器,查询来自音乐序列,键与值来自可学习的演奏者嵌入,从而在生成全程提供不随长度衰减的风格通道,这与仅在序列前附加身份词的前缀条件不同。在175条验证序列上以128词元提示生成至多4096词元并用1024词元窗口滑动评测时,条件模型在提示长度256下与真实演奏者的平均一致率为70%,高于无交叉注意力微调基线的37%与未微调Aria的25%。在PiJAMA-12真实测试集80首591块上,仅用生成延续训练的12分类器达到87.1%块级与95.0%乐曲级准确率,低于同配方真实数据训练的95.8%与98.8%,说明生成内容携带了可迁移到真实录音的风格结构。该结论只适用于筛选出的12位风格可分的钢琴家,覆盖779首约57小时数据,训练成本为在单块NVIDIA RTX 6000上微调约18小时。
🔗 开源资源
- 第三方资源:https://almostimplemented.github.io/jazz-pianist-style → https://almostimplemented.github.io/jazz-pianist-style/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
31. 不用基频标注学会跟随声门相位:逆向语音合成如何同时做重建与分析
英文题目:Unsupervised Instantaneous Phase and Frequency Tracking by Inverse Voice Synthesis
标签:#音高与旋律提取 | #无监督学习 | #语音合成 | #信号处理
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Chin-Yun Yu:机构信息未在 arXiv HTML 中可靠披露
- György Fazekas:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
知识驱动神经声码器难以端到端学到可靠基频,因幅度谱损失丢掉相位、对周期监督弱,外部跟踪器不可微还会传入误差。GOLF-inv以源滤波器逆合成解决:编码器先从4通道谱特征估计帧中心频率与相位,经三次样条插值后逐段积分得到未修正相位。该未修正相位再经相位修正连成连续瞬时相位,修正量在当前帧中心为0、在下一帧中心为失配z_l,基频由修正相位求导再帧平均读出。连续相位驱动100次谐波加性声门源并做奈奎斯特限带,与噪声源经状态空间格型时变声道滤波器合成,谐波路径波形均方误差约束相位、多尺度谱损失约束整体幅度;100 Hz帧率下单帧最大修正约±79 Hz,训练以1至4帧随机积分窗口迫使编码器依赖频率预测。LM-SSD按每首歌第六遍留作测试,属未见表演而非未见歌曲或歌手,拷贝合成中GOLF-inv信号与重建误差比为8.103 dB,高于跟随FCNF0++目标的DDSP+F0的-2.665 dB。在LM-SSD测试集基频估计中,GOLF-inv总体准确率为95.79%,超过直接套用发布权重的PESTO的95.52%及传统跟踪器SWIPE、pYIN、REAPER与FCNF0++,但GOLF-inv在该数据训练而基线现成运行,适配差异构成部分优势且无需基频标签。在LM-SSD测试集声门闭合时刻检测中,GOLF-inv识别率为96.93%,低于喉头麦克风参考下REAPER的97.46%,相差0.53个百分点。结论仅适用于所测歌唱数据,噪声段谐波残余及对频率初始化范围依赖仍未解决。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
32. Jarvis:在多人会议里何时开口、如何开口的主动语音智能体

英文题目:Jarvis: A Proactive Speech Agent for Multi-Party Conversations
标签:#语音对话系统 | #检索增强 | #轮次切换 | #基准测试
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Seunghyun Oh:机构信息未在 arXiv HTML 中可靠披露
- Hirotaka Hiraki:机构信息未在 arXiv HTML 中可靠披露
- Shuyue Stella Li:机构信息未在 arXiv HTML 中可靠披露
- Yulia Tsvetkov:机构信息未在 arXiv HTML 中可靠披露
- Shyamnath Gollakota:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
多人会议中出现与共享文档可核查事实不符或遗漏时,现有语音助手只在被点名时应答单人,无法判断是否该开口、何时开口又不抢话。Jarvis以会前共享文档与实时多人语音流为输入,只在必要时口头纠正或补答,并给出页码与原文段落引用。语音处理模块为每人做流式识别并附说话人与时间戳形成轮次,普通轮次送入主动推理链,直接点名问题则分流至直接问答。主动推理链共用同一小模型分步处理:监视步骤对照文档判断新增问题状态并记入待解决问题记忆,自修复检查判断小组是否已自行解决,若未解决则由 grounded生成步骤产生带引用的干预文本并送入交互模块。交互模块将干预排队,仅在长静音、无人说话且输入能量持续偏低时释放,举手请求许可或等待空档直说两种方式占用公共发声时间,说话中检测到持续人声即让出话筒。在从18篇论文各取3个问题共54个问题、开与关各跑一次共108次人为打断的让出评测中,让出率指标下启用让出为51/54即94.4%高于禁用让出的0/54即0.0%。适用范围限于英文远程会议与单文档问答,表格数值引用与长文档上下文仍会失效,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
33. 把 AI 生成音乐抄袭检测当作版本识别来做

英文题目:Towards AI-Generated Music Plagiarism Detection as a Version Identification Problem
标签:#翻唱与曲目识别 | #基准设计 | #音乐 | #基准测试
评分:7.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Fotis Koutsikos:机构信息未在 arXiv HTML 中可靠披露
- Ioannis Prokopiou:机构信息未在 arXiv HTML 中可靠披露
- Spyridon Kantarelis:机构信息未在 arXiv HTML 中可靠披露
- Vassilis Lyberatos:机构信息未在 arXiv HTML 中可靠披露
- Pantelis Vikatos:机构信息未在 arXiv HTML 中可靠披露
- Athanasios Aidinis:机构信息未在 arXiv HTML 中可靠披露
- Themos Stafylakis:机构信息未在 arXiv HTML 中可靠披露
- Athanasios Voulodimos:机构信息未在 arXiv HTML 中可靠披露
- Giorgos Stamou:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
人工智能文本生成音乐常在保留旋律与和声的同时改变音色与编曲,抄袭判断需要在大幅声学变化下比较原始片段与候选片段是否构成衍生关系,难点在于真实判例稀少且生成失真会淹没表层相似度。该工作输入原始片段与候选片段的音频对,先用冻结的声学分支与语义分支分别提取嵌入,再比较标量距离阈值、声乐感知的分数融合与基于坐标位移的监督分类三种判定方式,位移向量进入梯度提升树输出是否抄袭的二值判断。与直接沿用版本识别距离阈值相比,关键差异在于保留嵌入每一维的绝对差结构而非压缩为单一距离,这让分散在隐空间中的抄袭信号得以被重新利用。在自建的COPYCAT基准上,混合模型相对声学分支阈值基线将总体F0.5指标从0.612提升到0.803,其中人工智能加信号遮蔽等最难类别的召回改善最大。该结论适用于包含人声重嵌与音高变速遮蔽的受控评测,超出所用三种生成器与扰动范围的泛化尚未验证。原文未披露训练、推理或部署成本,最终混合模型的训练时长也未明确报告。
🔗 开源资源
代码相关资源:https://github.com/fotiskoutsikos/Plagiarism-Detection-System.git → https://github.com/fotiskoutsikos/Plagiarism-Detection-System — 链接可访问(HTTP 200)
第三方资源:https://suno.com/ — 暂时无法访问
第三方资源:https://www.udio.com/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
34. OmniCapBench:把音视频描述拆成可验证原子单元的细粒度评测

英文题目:OmniCapBench: A Deep-Structured Evaluation Framework for Fine-Grained Audio-Visual Captioning
标签:#音视频理解 | #基准设计 | #基准测试 | #音视频
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Zhongyu Yang:机构信息未在 arXiv HTML 中可靠披露
- Jiale Tao:机构信息未在 arXiv HTML 中可靠披露
- Ruitao Chen:机构信息未在 arXiv HTML 中可靠披露
- Zuhao Yang:机构信息未在 arXiv HTML 中可靠披露
- Yingfang Yuan:机构信息未在 arXiv HTML 中可靠披露
- Xueliang Zhao:机构信息未在 arXiv HTML 中可靠披露
- Auden:机构信息未在 arXiv HTML 中可靠披露
- Kai Wang:机构信息未在 arXiv HTML 中可靠披露
- Shuai Shao:机构信息未在 arXiv HTML 中可靠披露
- Biao Wang:机构信息未在 arXiv HTML 中可靠披露
- Steve Yves:机构信息未在 arXiv HTML 中可靠披露
- Qinglin Lu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
输入为包含连续画面与声音的视频,输出要求是结构化的音视频字幕,难点在于长时程内同时保持实体身份、时间边界与声音画面对应,整段流畅文本容易掩盖局部错误。OmniCapBench 把视频内容表示为参考实体(References)、视觉镜头(Shots)与音频事件(Events)三类原子单元,参考实体给出持久身份,音频事件给出连续时间区间,视觉镜头通过交叉链接把实体与事件锚定到画面。模型直接生成上述 JSON 图,确定性规则先核查标识有效性、时间合法性与跨轨链接,再由局部语言模型只比较已对齐单元的语义等价性,召回方向查漏报,精确率方向查幻觉。与整体文本打分和问答探针相比,该设计同时保留覆盖度与可定位性,避免对整段文本做无约束判断。在包含 786 个视频、5818 个实体、6537 个音频事件与 11419 个视觉镜头的评测中,Gemini 3.1-Pro 的事件-镜头关联 F1 为 51.46%,低于其事件 F1 的 63.32%,说明声音识别与画面绑定之间存在缺口。结论适用于 5 分钟以内、具有较密镜头与事件的视频,对更长视频与标注范围外的正确细节尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
论文首页资源:https://01yzzyu.github.io/OmniCapBench/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/Jingkang50/FunQA — 暂时无法访问
第三方资源:https://huggingface.co/datasets/lmms-lab/LLaVA-Video-178K — 暂时无法访问
第三方资源:https://huggingface.co/datasets/omni-research/Tarsier2-Recap-585K — 暂时无法访问
第三方资源:https://github.com/MME-Benchmarks/Video-MME — 暂时无法访问
第三方资源:https://huggingface.co/datasets/zai-org/VisionRewardDB-Video — 暂时无法访问
第三方资源:https://huggingface.co/datasets/longvideobench/LongVideoBench — 暂时无法访问
第三方资源:https://huggingface.co/datasets/NJU-LINK/OmniVideoBench — 暂时无法访问
第三方资源:https://ai.google.dev/ — 暂时无法访问
第三方资源:https://github.com/QwenLM/Qwen2.5-Omni — 暂时无法访问
第三方资源:https://seed.bytedance.com/ — 暂时无法访问
第三方资源:https://huggingface.co/XiaomiMiMo/MiMo-V2.5 — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
35. 分块生成器该把推理计算花在哪里:LatticeSMC 解读

英文题目:LatticeSMC: Where to Spend Inference-Time Compute in Chunked Sequence Generators
标签:#音乐生成 | #扩散模型 | #流匹配 | #形式化分析 | #众包评测
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xuanchen Wang:School of Computer Science;The University of Sydney;Sydney, NSW, Australia
- Heng Wang:School of Computer Science;The University of Sydney;Sydney, NSW, Australia
- Weidong Cai:School of Computer Science;The University of Sydney;Sydney, NSW, Australia
📌 核心摘要
长序列按块生成时每块内部还需多步去噪,而关心的奖励定义在完整序列上,论文引入预算匹配的分块引导任务,在固定去噪器求值次数下最大化序列级奖励,并区分抽样返回与取最优返回两种目标。LatticeSMC在块索引与去噪步构成的二维格点上放置势函数,对块可加奖励用块奖励项、对终值奖励用前缀分数增量加终值修正,使整条轨迹对数势求和与序列奖励一致。粒子先经生成核由已有前缀扩展出下一块,扩展得到的新前缀直接进入块边界加权,权重乘以该块势函数形成加权粒子集。加权集计算有效样本量(Effective Sample Size,ESS),若低于粒子数一半则做系统重采样并重置权重,否则原样保留,所得粒子集作为下一块生成的输入;插件式奖励打分免费时在块内固定去噪步放置同权重势函数,以同样加权与门控提前重采样。最后按权重抽取或返回最高奖励粒子,两项叠缩结果保证目标正确:块可加奖励下两轴权重完全相同,终值奖励下任意前缀分数都给出精确中间势。在舞蹈40条件4种子、N=32粒子相同去噪器求值取最优返回下,节拍对齐奖励从0.234提高到0.441,超过同期最优基线0.415。在音乐40条件2种子、N=32粒子相同去噪器求值取最优返回下,音乐提示依从的CLAP分数从0.470提高到0.560,且留出质量指标保持在基线水平。结论适用范围限于4块到8块、两种测试生成器与四种奖励,块内密集打分在潜变量音乐模型上带来4倍解码调用与约3.6倍墙钟成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
36. 不完美教师下的低资源声音蒸馏

英文题目:Learning from imperfect teachers for low-resource acoustic generalization
标签:#声学场景分类 | #知识蒸馏 | #低资源 | #生物声学监测
评分:7.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shuanglin Li:机构信息未在 arXiv HTML 中可靠披露
- Ruxiao Qian:机构信息未在 arXiv HTML 中可靠披露
- Jian Liu:机构信息未在 arXiv HTML 中可靠披露
- Haijun Lin:机构信息未在 arXiv HTML 中可靠披露
- Wenwu Wang:机构信息未在 arXiv HTML 中可靠披露
- Siyang Song:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
低资源声音学习要求模型只用少量标注录音判断场景或鸟类类别,输入是录音的声学特征,输出是类别标签,难点是标注稀少且类别不均衡时难以学到可靠的类间关系。传统知识蒸馏(Knowledge Distillation,KD)让学生模仿教师的全部软分布,但教师本身也在同样少量的数据上训练,高置信排序可能把真值排除在外。论文提出的边界锚定质量分区蒸馏(Boundary-Anchored Mass-Partitioned Distillation,BA-MPD)先用边界锚定校正(Boundary-Anchored Correction,BAC)检查教师前 \(k\) 个高置信类别,若缺失真值则将其与集合内概率最小的边界类交换概率,使集合恢复标签一致且总质量和不确定性不变;再用质量分区蒸馏(Mass-Partitioned Distillation,MPD)把校正后分布拆成支撑内关系、支撑与补集间的质量分配、补集内关系三项分别匹配。与把全部概率放在一个 KL(Kullback-Leibler,KL)散度里匹配的做法不同,该方法允许独立控制三路信号并压低低置信细节的权重。在 TAU 城市声学场景 25% 标注下 BA-MPD 宏平均准确率为 54.73%,高于同教师同学生的普通 KD 的 53.48%;在 BEANS-CBI 50% 标注下宏准确率为 41.91%,高于普通 KD 的 40.07%。结论适用于教师与学生标注预算相同或教师预算更小的声学分类蒸馏,不保证扩大支撑或增强顶部关系总是有益。原文未披露训练时长、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/ShuanglinLi/BA-MPD — 链接可访问(HTTP 200)
代码相关资源:https://github.com/ShuanglinLi — 链接可访问(HTTP 200)
第三方资源:https://github.com/ShuanglinLi/BA-MPD — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
37. Prism:为原生 2K 视频音频联合生成设计的动态稀疏注意力

英文题目:Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Generation Model Training
标签:#音视频生成 | #注意力机制 | #音视频 | #长上下文
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shuyuan Tu:机构信息未在 arXiv HTML 中可靠披露
- Qi Tian:机构信息未在 arXiv HTML 中可靠披露
- Yinming Huang:机构信息未在 arXiv HTML 中可靠披露
- Yue Wu:机构信息未在 arXiv HTML 中可靠披露
- Xintong Han:机构信息未在 arXiv HTML 中可靠披露
- Kaihang Pan:机构信息未在 arXiv HTML 中可靠披露
- Weijie Kong:机构信息未在 arXiv HTML 中可靠披露
- Jiangfeng Xiong:机构信息未在 arXiv HTML 中可靠披露
- Jian-Wei Zhang:机构信息未在 arXiv HTML 中可靠披露
- Zuxuan Wu:机构信息未在 arXiv HTML 中可靠披露
- Yu-Gang Jiang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
联合视频音频生成需由文本与参考图像同步输出视频流与音频流,2K原生训练单个片段经压缩可达约870K词元,全注意力二次代价过高且重复背景稀释发声区域权重。Prism把视频词元网格组织为时空宏区,每层每头独立估计变化指示,合并视频通道方差与音频到视频交叉注意力范数,分别刻画视觉沿时空方向变化快慢与音频对各区域影响强度。基于这些信号为每个宏区动态分配定制块形状,沿快速变化与强音视耦合轴更细划分,块体积按信息密度分为64、128、256三档以保持块内语义连贯。该布局经置换重排进入查询块与键块筛选,以块均值特征计算块分数并用混合Top-k与Top-p为分散查询补充键块,选中键块进入稀疏注意力内核计算再经逆置换恢复原序。在包含300个未见2K视频的2K-Bench上,Prism相对全注意力骨干MOVA在去同步误差DeSync上从1.05降至0.63,数值越低越好。在同一包含300个未见2K视频的2K-Bench比较中,Prism相对同一全注意力骨干MOVA在运动质量MotionQ上从0.53升至0.89,数值越高越好。在2K原生训练与推理测量口径下,Prism相对全注意力实现2.5倍训练加速,原文报告2K单步训练时间从26.5分钟降至10.6分钟,4卡并行推理延迟从1091秒降至331秒。结论限于视频自注意力稀疏化,音频自注意力与跨模态注意力保持不变,相机频繁变焦致单个宏区混合远近内容时会模糊。
🔗 开源资源
第三方资源:https://github.com/Tencent-Hunyuan/Prism — 链接可访问(HTTP 200)
第三方资源:https://francis-rings.github.io/Prism → https://francis-rings.github.io/Prism/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
38. 把两种语言拼在一起训练,为什么能减轻跨语言合成的口音串味

英文题目:Region-Aware Masking for Accent-Robust Cross-Lingual Text-to-Speech
标签:#文本到语音 | #语音克隆 | #流匹配 | #跨语言 | #0 样本
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Haoqi Li:机构信息未在 arXiv HTML 中可靠披露
- Shivam Mehta:机构信息未在 arXiv HTML 中可靠披露
- Ravi Teja Gadde:机构信息未在 arXiv HTML 中可靠披露
- Yinghong Lan:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
跨语言零样本语音合成的输入是源语言参考音频加目标语言文本,输出是保留说话人音色且符合目标语言发音的语音,难点是音色与发音韵律纠缠,且训练用同语言上下文重建而推理用跨语言上下文提示,模型易把源语言口音复制到输出中。该方法先从内部英语与西班牙语单人语料各取一段,拼接其对数梅尔语谱图并用字符分隔符“|”连接文本且随机交换拼接顺序,得到先后位置为part0与part1的伪双语样本。然后按语言边界放置重建掩码,让模型重建其中一种语言并以另一种语言的可见声学上下文为条件,该掩码下可见上下文与待重建目标一起进入掩码流匹配损失进行训练,从而在训练中复现推理时的跨语言提示模式。推理时同样用参考音频及其转录加分隔符连接目标文本,模型生成目标语言延续段;该过程不使用语言标识、口音标签和平行双语录音,也不改架构,只改变掩码几何。内部西班牙语到英语测试中,两区域掩码系统M2的人评口音分数降至0.32,低于未适配基线B的4.28,量表为0-5分且越低越好,同时可懂度和自然度基本不变。在FLEURS外部数据域上,法语与葡萄牙语作为训练未见的源语言,M2的人评口音分数为0.69,低于仅做双语拼接适配的M1的1.05,说明增益来自训练策略而非录制域。但掩码位置决定口音抑制与音色保持的权衡,只掩码重建区的系统口音更低却大幅损伤音色保持,两区域掩码综合最优。结论限于英西训练附近及上述评测语种,内部训练语料不可获得且未覆盖更多语言,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://doubleblindauthor.github.io/region-aware-masking-TTS-demo → https://doubleblindauthor.github.io/region-aware-masking-TTS-demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
39. 看得见说话人脸的助听放大:AV-NeuroAMP 一次做完增强与个性化补偿

标签:#目标说话人提取 | #端到端学习 | #音视频 | #助听器 | #多模态学习
评分:7.2/10 | 创新 1.6/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- You-Jin Li:Graduate Institute of Communication Engineering, National Taiwan University, Taipei, Taiwan
- Yu Tsao:Research Center for Information Technology Innovation, Academia Sinica, Taipei, Taiwan
- Borching Su:Graduate Institute of Communication Engineering, National Taiwan University, Taipei, Taiwan
- Kuan-Chung Ting:Department of Otolaryngology-Head and Neck Surgery, Taipei Veterans General Hospital, Taipei, Taiwan;School of Medicine, National Yang Ming Chiao Tung University, Taipei, Taiwan
- Fan-Gang Zeng:Center for Hearing Research, University of California, Irvine, California, USA
📌 核心摘要
助听器需在噪声和竞争说话人下输出符合听众听力图的放大语音,输入为含目标语音、噪声与干扰语音的混合声、目标说话人面部视频和6维纯音听力图,输出为按美国国家声学实验室线性处方与宽动态压缩定义的目标波形。目标与干扰语音声学相似使纯音频难以选出目标,分开增强再放大会把残留干扰一并放大。AV-NeuroAMP先以冻结的人脸特征提取器加时序卷积适配器得到与音频帧对齐的视觉表示并与语谱图拼接送入编码器,再由听力图条件化特征调制模块在实例归一化后生成缩放、偏置和门控参数调制视听特征并保留残差,最后由幅度与相位双解码器经逆短时傅里叶变换合成波形。与纯音频端到端NeuroAMP相比,在域内英语集噪声输入下听觉辅助语音感知指数HASPI从0.419提高到0.780。与直接拼接听力图相比,同视听主干下噪声输入听觉辅助语音质量指数HASQI从0.563提高到0.625,多频段短时增益误差MBGE从4.15 dB降至3.48 dB。在汉语普通话域外集噪声输入下其HASPI为0.598、HASQI为0.454,均高于纯音频NeuroAMP的0.449和0.303。处理2秒视听输入共需232.16 GMACs,其中视听神经网络占137.38 GMACs、视觉编码器占94.78 GMACs,听力图调制模块参数仅0.022 M且不足0.01 GMACs;该结论适用于已知目标视频的完整话语非因果处理,尚未验证因果流式可穿戴部署。
🔗 开源资源
- 第三方资源:https://github.com/claritychallenge/clarity — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
40. CASM:用局部周期清晰度调节约束的节拍后处理
英文题目:CASM: Context-Aware Semi-Markov Post-Processor for Beat Tracking
标签:#节拍跟踪 | #信号处理 | #音乐 | #离线推理
评分:7.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zhanhong He:机构信息未在 arXiv HTML 中可靠披露
- Hanyu Meng:机构信息未在 arXiv HTML 中可靠披露
- Yaolong Ju:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音乐节拍跟踪一般先由网络输出每帧的节拍激活,再由后处理输出离散的节拍时刻,直接取峰容易保留假峰或漏掉弱拍,固定全局速度约束又可能在变速段压掉正确峰值。上下文感知半马尔可夫后处理器(Context-Aware Semi-Markov,CASM)离线读入完整节拍与强拍激活,在高于阈值的激活峰点之间选择一条节拍路径,用激活证据奖励与区间代价相减得到总分。与只看主导周期强弱的做法不同,CASM在每个候选点用8秒窗自相关估计局部周期,并用最优滞后与最强竞争滞后的差值构造周期裕度,清晰时收紧时间约束,存在半速或倍速竞争时放宽约束并更多听从激活。节拍选定后在节拍网格上解码2至7拍小节的强拍序列,并用计数与一致性规则兜底。在固定BeatThis激活的GTZAN节拍评测中,CASM相对直接取峰的连续性指标AMLt提高1.2个百分点,GTZAN上TCN骨干的强拍F1提高2.1个百分点,同时保持事件级F1不下降。结论适用于离线、可获得完整激活的已训练跟踪器,校准配置冻结后跨骨干与数据集复用,原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://zhanh-he.github.io/casm-beat-tracking → https://zhanh-he.github.io/casm-beat-tracking/ — 链接可访问(HTTP 200)
演示资源:https://zhanh-he.github.io/casm-beat-tracking → https://zhanh-he.github.io/casm-beat-tracking/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
41. 无词边界时如何做上下文偏置:深度自适应门控与读音空间匹配

标签:#语音识别 | #CTC | #基准测试 | #数据集
评分:7.2/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Muhammad Huzaifah:机构信息未在 arXiv HTML 中可靠披露
- Yu Pan:机构信息未在 arXiv HTML 中可靠披露
- Zachary Yeo:机构信息未在 arXiv HTML 中可靠披露
- Ningjie Bai:机构信息未在 arXiv HTML 中可靠披露
- Guangzhao Yang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
上下文偏置(contextual biasing)的输入是冻结的联接时序分类(Connectionist Temporal Classification,CTC)声学后验和每条请求可变的热词表,输出是单遍贪心解码得到的字符序列,日文和中文的难点在于解码流没有词边界信号,同一词也没有固定切分,同音字还会让读音正确但字形错误。方法把热词编译成字符级 Aho-Corasick 自动机,每个字符位置都可进入匹配,偏置按匹配深度累积,解码时把对应行的偏置加到对数概率上再取最大。深度自适应门(depth-adaptive gating)按当前深度选用掩码偏置或无上限重选,前者只在模型前 K 候选中加分,后者在深匹配区允许挽回排名靠后的延续。读音空间匹配另建一套按假名或拼音推进的自动机,同音词块都能推进状态,但加分只给词表规定的字形,两路分值按相关折扣融合。相对已有训练式偏置和依赖边界的解码时方法,差异在于免训练、免二遍、免模型内部访问,且匹配发生在字符和读音之下。在 Aishell-1 NE 困难 R1 子集上,双阶段配置以 66.5% 召回超过已训练 CLAS 基线的 64%,日文基准上组合配置相对贪心基线带来约 25 个百分点的稀有词召回提升并保持 97% 以上精确率。结论适用于稠密表意文字和冻结 CTC 贪心解码,词表扩大到 2000 词时召回和精确率都会下降,多字词块词表需要保守设置。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://taku910.github.io/mecab/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/mozillazg/python-pinyin — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
42. Salt++:用上下文对齐把流式音视频生成压到四步

英文题目:Salt++: Context-Aligned Post-Training for Few-Step Streaming Multimodal Generation
标签:#音视频生成 | #知识蒸馏 | #音视频 | #流式处理 | #后训练
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xingtong Ge:机构信息未在 arXiv HTML 中可靠披露
- Yutong Wang:机构信息未在 arXiv HTML 中可靠披露
- Lunjie Zhu:机构信息未在 arXiv HTML 中可靠披露
- Haitao Lin:机构信息未在 arXiv HTML 中可靠披露
- Fangyu Lin:机构信息未在 arXiv HTML 中可靠披露
- Yushi Huang:机构信息未在 arXiv HTML 中可靠披露
- Xin Zhang:机构信息未在 arXiv HTML 中可靠披露
- Yi Zhang:机构信息未在 arXiv HTML 中可靠披露
- Yu Liu:机构信息未在 arXiv HTML 中可靠披露
- Jun Zhang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
少步流式音视频生成以文本为条件,输出时间对齐的音视频块序列,每块同时携带视频隐变量与音频隐变量,需按块顺序联合生成对齐的声音与画面。难点在于块因果遮罩限制未来可见性且少步采样压缩去噪轨迹,常规教师强制以干净历史配带噪目标,仅经速度预测间接监督历史表示,直接复用双向分数模型给因果块打分则生成与打分上下文不一致。因果自流让观测噪声混合历史的在线学生与观测干净历史的指数滑动平均教师处理同一带噪当前块,并对齐二者中间表示,使学生从混合历史恢复预测性上下文信息。上下文对齐的自回归分布匹配蒸馏让生成器采样、估计学生分布分数的辅助分数模型训练与真实分数估计共用同一因果前缀与因果遮罩,在块条件KL目标下对齐生成与参考分布,先做干净前缀少步蒸馏,再沿用同一目标适配自回归生成历史。与需经一致性蒸馏过渡的主流多阶段流程不同,该路线不切换目标,也不需单独的一致性蒸馏阶段。在1000条JavisBench-mini提示480p同为4步因果设置下,Salt++相对OmniForcing在视觉质量(visual quality,VQ)与运动质量(motion quality,MQ)指标上分别提高57.1%和44.5%。该结论限于每段121帧约5秒短片与固定种子单次采样,DeSync只在运动可比时有效,960p对OmniForcing仅为外推诊断,长片外推未经验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://xingtongge.github.io/Saltpp → https://xingtongge.github.io/Saltpp/ — 链接可访问(HTTP 200)
代码相关资源:https://github.com/XingtongGe/Saltpp — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
43. 按问题所需证据做解码修正的音频视觉幻觉缓解

英文题目:Relevant Evidence Decoding for Audio-Visual Hallucination Mitigation
标签:#音视频问答 | #工具增强与约束解码 | #幻觉与忠实度 | #音视频
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hyunjae Ra:Sungkyunkwan University
- Aecheon Jung:Sungkyunkwan University
- Jungin Park:Daegu Gyeongbuk Institute of Science and Technology (DGIST)
- Sungeun Hong:Sungkyunkwan University
📌 核心摘要
音视频大语言模型(Audio-Visual Large Language Model,AV-LLM)输入为配对的音频、视频和文本问题,输出为答案标记,难点是某一模态会干扰另一模态的判断,问题实际只需要音频、视频或二者交互中的一部分。相关证据解码(Relevant Evidence Decoding,RED)先用仅问题的前向推理选出五种证据类型之一,该选择在整个自回归解码中保持不变。随后模型以问题单独预测为公共参照,用点逐互信息(Pointwise Mutual Information,PMI)度量音频、视频加入后对候选标记概率的改变量,并把联合贡献拆成音频、视频与非加性残差交互三部分。最终解码把原始音视频分数与所选类型对应的贡献相加,保留音视频分支作为解码锚点且仅评估所选证据类型必需的辅助分支,而非每个问题都执行全部辅助分支。与调制各模态分支权重或放大全部附加信息的方法不同,RED只增强问题所需的那部分贡献。在Qwen2.5-Omni-7B上,CMM基准准确率从82.2%提高到89.2%,该结论适用于所测的幻觉与通用问答基准,但在长文本描述生成中尚未验证。原文报告相对首标记时间(Time To First Token,TTFT)平均为标准解码的1.5倍,附录分析给出证据选择89.1毫秒、媒体准备2372.1毫秒、感知编码1881.4毫秒、答案提示预填充1381.7毫秒、答案标记预测28.4毫秒、分数合成与开销37.2毫秒、总计5789.9毫秒,未报告端到端长文本生成成本、显存或吞吐。
🔗 开源资源
- 第三方资源:https://github.com/GeWu-Lab/MUSIC-AVQA/blob/main/data/json_update/avqa-test.json — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
44. 细化换可懂度,搜索换音色:掩码扩散语音合成里测试时计算到底买到了什么
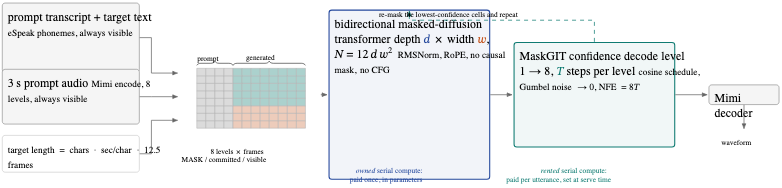
标签:#文本到语音 | #语音克隆 | #扩散模型 | #统计分析
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Nityanand Mathur:机构信息未在 arXiv HTML 中可靠披露
- Hamees Sayed:机构信息未在 arXiv HTML 中可靠披露
- Ayush Pratap Singh:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
跨句零样本合成根据目标文本音素与三秒提示编解码器词元生成语音,用词错率考核读对、用SIM-o考核音色,两者瓶颈不同而不能互替。先把8个码本嵌入求和,连同始终可见的音素前缀与三秒提示词元送入双向Transformer,主干是唯一身份通路且不设说话人编码器。Transformer按由粗到细掩蔽只预测被掩蔽层的词元,低层保持可见而高层全掩,其输出词元再经编解码器还原为波形。细化仅增加同一模型的去噪步数,搜索则并行采样多个候选再用说话人编码器选相似度最高者,两者在相同函数求值次数下比较。在400条跨句评测上以实录词错率0.0345与往返相似度0.5554为界,T=1增至T=16细化关闭词错率区间86.2%而仅关闭SIM-o区间46.4%,比值约1.86倍前者高于后者。在同一400条评测相同函数求值次数下细化相对搜索词错率为0.1316对0.1955即细化更低,而搜索SIM-o更高并获四个异谱系编码器64.6%–79.0%胜率确认。同一WavLM-large度量下编解码器往返相对原始波形SIM-o为0.5554对0.678即往返更低,剩余身份差距62%来自编解码器而非生成器。结论仅在单语种单编解码器单语料无引导欠训练网格内成立,步指数差在重参数化下变号故只保排序,函数求值次数仅计Transformer。45模型网格训练共耗162.5 GPU小时,六秒以上长提示使输出脱离文本,深度最优与词错率饱和点仍在网格边界外。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
45. 在模型重建攻击下为自回归语音合成加多比特水印

英文题目:Learning to Watermark Speech Synthesis Against Model-Driven Reconstruction
标签:#音频水印 | #生成模型 | #语音 | #鲁棒性 | #文本到语音
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Weizhi Liu:East China Normal University, Shanghai, China
- Yue Li:Huaqiao University, Xiamen, China
- Hui Tian:Huaqiao University, Xiamen, China
- Zhaoxia Yin:East China Normal University, Shanghai, China
📌 核心摘要
现代语音合成服务需要把多比特标识直接嵌入合成语音,以验证语音是否来自受保护模型并区分是哪个注册用户请求的,难点是语音发布后会经过神经编解码器再生、声码器重合成和增强重建等学习型变换,这些变换保留语音可用性但对水印的破坏方式不同。论文提出的 Thrive 包含 Rise 和 Care 两个部分,Rise 把同一水印同时写入中间表示并延续到后续生成层,Care 用波形专家和频谱专家分别恢复再按比特可靠性二选一。训练先学习嵌入与恢复能力再冻结专家只校准选择器,避免可靠性估计随专家漂移。与已有生成式水印把水印固定在某个阶段或模型参数不同,该设计让水印参与整个生成并在恢复端适应重建。在 LJSpeech 上两种骨干的重建攻击平均恢复准确率达到 87.6%,常规失真下万人候选溯源仍保持 93.2% 以上。结论适用于论文列出的编解码器、声码器和增强模型组合,连续多级重建下准确率会降到 0.716-0.820,自适应对抗重建尚未验证。原文披露训练使用单张 NVIDIA RTX 4090,但未给出训练时长、推理延迟与部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
46. 解码器在训练和生成时看到的不一样:AudioGAR 如何搭桥

英文题目:AudioGAR: Bridging Reconstruction and Generation in Latent Audio Generative Models
标签:#音频生成 | #音乐生成 | #扩散模型 | #神经编解码与离散单元
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xianghong Fang:机构信息未在 arXiv HTML 中可靠披露
- Geeyang Tay:机构信息未在 arXiv HTML 中可靠披露
- Wentao Ma:机构信息未在 arXiv HTML 中可靠披露
- Tim G. J. Rudner:机构信息未在 arXiv HTML 中可靠披露
- Dehan Kong:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
潜在音频生成模型通常分两阶段训练,音频编解码器先把波形压缩为潜在表示并重建,潜在生成模型再在该空间内按文本等条件生成音频,推理时同一解码器却要处理生成器产生的潜在向量。论文指出训练时解码器只见编码器产生的潜在向量,推理时面对分布不同的生成潜在向量,重建好不等于生成好。AudioGAR(Audio Generation-Aware Reconstruction)先对编码器潜在向量加高斯噪声,再用冻结的潜在扩散模型按条件去噪,得到介于重建与生成之间的中间潜在向量。噪声较小时中间向量仍与源音频对应,可提供配对监督;论文只用这些向量微调编解码器解码器,编码器与生成模型保持冻结。在 AudioCaps 文本到音频任务上,相对复现的 AudioX 基线,AudioGAR 使生成音频与参考样本的特征分布差异指标 FAD 降低 16.8%,在 MusicCaps 文本到音乐任务上 FAD 降低 31.3%。该结论适用于扩散类 AudioX 与 TangoMusic 流程,噪声过大则源音频对应减弱,不适用于自回归生成器。原文披露 AudioX 适配仅用约 508.3 小时音频与约 10.3 小时单卡 H100 墙钟时间,约为原训练的 1.5% 数据与 0.26% 成本,推理流程不变。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
47. UltraDub:用唇动同时管住说什么和何时说

标签:#语音配音 | #流匹配 | #音视频 | #基准测试
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Gaoxiang Cong:机构信息未在 arXiv HTML 中可靠披露
- Liang Li:机构信息未在 arXiv HTML 中可靠披露
- Jianwei Wen:机构信息未在 arXiv HTML 中可靠披露
- Zhedong Zhang:机构信息未在 arXiv HTML 中可靠披露
- Zheng-Jun Zha:机构信息未在 arXiv HTML 中可靠披露
- Qingming Huang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
视觉语音克隆(Visual Voice Cloning,V2C)输入为无声视频、文本剧本和参考音频,输出是与口型同步、内容正确且音色一致的语音,难点是文本、音色和视觉节律三组条件互相干扰。UltraDub先做输入投影得到初始先验,该投影只拼接带噪状态、参考音频梅尔谱与填充后文本编码,不提前融合视觉特征。再用运动引导的双上下文检索(Motion-guided Dual-context Retrieving,MDR)层逐步估计速度场,语言和音色检索共享唇动残差并用独立时间门控调节各自贡献。最后用节奏锚定的轨迹引导(Rhythm-anchored Trajectory Guidance,RTG)在采样中修正轨迹,在视觉预测中点评估多模态修正。与顺序式条件建模和常规无分类器引导不同,该工作让视觉同时承担连续运动聚合与结构节奏校正,避免增强语义条件时破坏已建立的时间与音色线索。在LRS3-Cross上,UltraDub相对最强配音基线AlignDiT将词错率从1.40%降到1.37%,LSE-C从7.91提高到8.23。结论适用于英语跨语句参考的配音评测,在电影、新闻、播客等野外场景仍需验证,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://galaxycong.github.io/ultra — 链接不可用(HTTP 404)
第三方资源:https://github.com/kaistmm/AlignDiT — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
48. 朗读口音强不等于自发口音也强:德语九地区口音的跨风格保持检验

英文题目:Do Speech Representations Preserve Regional Accent Across Read and Spontaneous Speech?
标签:#语言识别 | #统计分析 | #口音与方言 | #语音 | #模型比较
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.3/1.5 | 实验充分 1.3/1.5 | 清晰度 0.9/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Paula A. Perez-Toro:机构信息未在 arXiv HTML 中可靠披露
- Tomas Arias-Vergara:机构信息未在 arXiv HTML 中可靠披露
- Annette Schwarz:机构信息未在 arXiv HTML 中可靠披露
- Abner Hernandez:机构信息未在 arXiv HTML 中可靠披露
- Andreas Horr:机构信息未在 arXiv HTML 中可靠披露
- Cornelia Kristen:机构信息未在 arXiv HTML 中可靠披露
- Andreas Maier:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
这篇论文研究输入为德语朗读与自发语音、输出为九类区域标签或家乡经纬度坐标的区域口音识别问题,难点是同语体训练测试得分高不代表换语体后区域线索仍然可用。研究先取RVG1-v3中500名朗读说话人、498名兼有自发语音者与432名有坐标者,再将10种冻结表示按固定层平均池化为说话人级向量,随后用多层感知机完成分类与连续定位并在说话人独立70:30划分下检验域内与跨语体迁移,最后以跨语体说话人检索衡量表示偏移与稳健性的关联。在说话人独立70:30划分的朗读域内九分类中,自动语音识别表示Whisper-large-v3编码器的非加权平均召回率(UAR)为0.489,高于自监督表示WavLM的0.397。在同一说话人独立划分的朗读域内定位中,Whisper的中位定位误差为148 km,低于均值位置基线的242 km,但跨语体后误差升至363 km并超过该基线。在说话人独立的跨语体评测中,Whisper九分类UAR从朗读域内的0.489跌至朗读到自发的0.11和自发到朗读的0.18,而说话人嵌入ECAPA仅从0.25变为0.23,呈现域内弱但迁移更稳的反转。在498对跨语体说话人检索评测中,内容型表示的排序1准确率不超过0.10,低于说话人嵌入的约0.99,该风格不变性与迁移成绩相关,而年龄性别与时长控制不能解释落差。结论适用于该语料的朗读与自发切换条件,麦克风差异仍有影响,跨语料结论尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
49. EVA:用自预测自回归先验做连续序列生成的变分自编码器

标签:#音频生成 | #变分自编码器 | #自回归模型 | #高效推理
评分:7.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kaede Shiohara:The University of Tokyo
📌 核心摘要
连续值序列生成的难点是下一个标记的分布常是多峰的,均方误差回归只预测条件均值,会把多个合理结果平均成模糊样本。经验变分自编码器(Empirical Variational Autoencoder,EVA)保留变分自编码器(Variational Autoencoder,VAE)的证据下界训练框架,但把潜变量的固定先验换成按序列顺序预测的经验先验。编码器把观测序列映射为各位置的潜变量分布,因果解码器依据已生成的潜变量重建当前观测标记,新增的预测器依据历史潜变量预测当前位置的先验均值和方差。推理时先从先验中逐个采样潜变量,再因果解码为连续观测,避免了后验与标准高斯先验之间的分布错位。在ImageNet 256×256类别条件生成评测中,潜变量维度为128且无条件引导尺度为7时,EVA在可比推理成本下取得生成图像与参考样本的特征分布差异指标(Fréchet Inception Distance,FID)7.68,低于同骨干因果VAE的100.27,并接近更大规模自回归扩散模型,而单次推理耗时约为后者的十分之一。该结论适用于论文使用的分词器、序列长度与闭集类别条件设置,空间二维结构与更大规模文本条件生成尚未验证,原文披露了优化器、训练轮数与推理相对耗时等成本信息。
🔗 开源资源
第三方资源:https://mapooon.github.io/EVAPage → https://mapooon.github.io/EVAPage/ — 链接可访问(HTTP 200)
代码相关资源:https://github.com/mapooon/EVA — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
50. 先修复混合再分离最后逐轨修复的音乐源复原框架

英文题目:Restore, Separate, Restore: A Modular Framework for Music Source Restoration
标签:#音频修复 | #音乐源分离 | #生成对抗网络 | #音乐 | #音频质量评估
评分:7.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tobias Morocutti:机构信息未在 arXiv HTML 中可靠披露
- Emmanouil Karystinaios:机构信息未在 arXiv HTML 中可靠披露
- Gerhard Widmer:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音乐源修复的输入是经过分轨效果、混音母带和传输退化后的立体声成品录音,输出是8类乐器未经处理的原始分轨,难点在于同时逆转非线性制作处理、区分声源归属并补回丢失的音色与瞬态细节。本文先用混合修复模型去除输入端退化得到近似母带混合,其输出直接送入单个多轨分离模型,将混合归属到仍携带分轨级退化的各分轨估计。最后对每个分轨用专用修复模型去除残留的分轨级退化与分离伪影,专家在分离器的真实输出上微调以贴合实际伪影分布。与此前按音轨分组专用级联相比,该设计用一个分离模型处理全部8轨并只在混合与分轨两端配修复模型。在MSR Challenge测试集上,混合修复使分离的多梅尔信噪比(Multi-Mel-SNR,MMSNR)从3.980 dB提高到4.047 dB,最终系统平均达到4.050 dB,明显高于基线但仍低于专用级联。该结论仅适用于重采样至44.1 kHz后的客观指标评估,分离器在干净未母带混合上训练而推理面对近似母带混合,存在未解决的训练推理失配;MSRBench验证集与测试集为独立采集,验证集上五轨有效的门控在测试集仅三轨仍有效且FAD-CLAP变差,本文也未做主观听感评估。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/theMoro/music_source_restoration — 链接可访问(HTTP 200)
第三方资源:https://hf.co/datasets/MSRChallenge/2025TestSet → https://huggingface.co/datasets/MSRChallenge/2025TestSet — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
51. 公开语音基座打得到自家微调模型:TransferBreaker 怎样切断对抗迁移

英文题目:Breaking Adversarial Transferability in Fine-Tuned Speech Recognition
标签:#语音识别 | #对抗训练 | #对抗鲁棒性 | #多语言
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mojtaba Nafez:Idiap Research Institute;École Polytechnique Fédérale de Lausanne (EPFL)
- Aref Mousavi:Department of Computer Engineering;Sharif University of Technology
- Mohammad Ebrahim Mahdavi:Department of Computer Engineering;University of Isfahan
- Mobina Poulaei:Department of Computer Engineering;Sharif University of Technology
- Kiarash Kiani Feriz:Department of Computer Engineering;Sharif University of Technology
- Mohammad Hossein Rohban:Department of Computer Engineering;Sharif University of Technology
📌 核心摘要
自动语音识别(Automatic Speech Recognition,ASR)把输入音频波形转写为可变长文本序列,本文研究公开基座被微调为私有目标模型后,对抗扰动从基座向目标迁移的问题。攻击者在基座上用白盒梯度优化不可察觉扰动,零查询地直接施加到目标模型,导致转写质量崩溃。TransferBreaker在微调时先做基座对抗微调,它以干净语音为输入只用固定的基座梯度生成扰动,得到对准攻击者实际方向的对抗样本用于更新目标模型。接着混合梯度对抗微调在迭代攻击中由基座梯度逐步过渡到基座与目标梯度组合,生成第二类对抗样本并与前一步样本混合输入训练,覆盖可迁移的基础方向。隐空间雅可比正则项(Latent Jacobian Regularization,LJR)再以冻结基座对干净语音的编码输出为锚点,约束目标模型对上述扰动语音的隐表示向其靠拢,并与对抗微调损失联合优化。在多语言多骨干平均结果上,基座迁移攻击把微调模型的词错误率(Word Error Rate,WER,越低越好)从16.4%推高到92.6%,TransferBreaker将其降到27.8%。该结论适用于27 dB信噪比约束的数字式、样本特定、非目标攻击,对目标式攻击、物理信道播放和更强白盒攻击尚未验证。原文披露单卡RTX-4090上本文方法训练时间显著高于标准对抗微调,推理阶段无额外开销。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
52. 按输入风险分配净化强度的音频伪造检测防御

英文题目:Detection-Guided Adaptive Purification with Diffusion Models for Robust Audio Deepfake Detection
标签:#音频深度伪造检测 | #扩散模型 | #对抗鲁棒性 | #语音
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Muhammed Salih Kayhan:机构信息未在 arXiv HTML 中可靠披露
- Qiben Yan:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音频深度伪造检测要判断输入波形是真实人声还是合成伪造,攻击者在已能检出的伪造波形上叠加微小扰动即可抑制合成声学线索,使其被误判为真实语音。固定强度扩散净化难以兼顾,太强会抹掉判别所需的细微伪造痕迹,太弱又去不掉扰动。检测引导自适应净化先把输入波形转为归一化分贝幅度谱图,用低噪声水平做一次试探净化并重建波形,再用冻结检测器分别对净化前后计算真实语音分数,其差值即分数偏移,无需干净参考即可在推理时获得。随后将该偏移与在开发集干净语音上标定的门限比较,偏移小的良性输入不做额外处理而直接送入检测器终判,偏移超过门限的输入则被标记为可疑并进入下一步。被标记输入再以更高的扩散噪声水平做强净化以更大幅度衰减表征域扰动差异,然后送入同一冻结检测器做最终检测,从而把强去扰与对良性输入的失真解耦。在ASVspoof 2019 LA评测划分上,对AASIST模型该方法把三攻击平均的综合目标从均匀净化基线的12.56%降到5.61%,同时干净等错误率维持在1.83%,接近无防御的1.17%。结论适用于白盒扰动逃逸设置,防御感知自适应攻击下攻击者把分数偏移压到门限之下实现门控逃逸是主要失效模式;原文披露了单卡RTX A6000上试探约6.05 s、强净化约42.34 s的推理耗时。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
53. 多语语音模型为什么会丢掉个别音素:音系干扰与局部语言估计修复

英文题目:Phonological Interference in Multilingual Speech Models
标签:#语音识别 | #测试时自适应 | #代码转换 | #语音学与音系
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Moran Yanuka:机构信息未在 arXiv HTML 中可靠披露
- Raja Giryes:机构信息未在 arXiv HTML 中可靠披露
- Moris Alper:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音素级模型输入语音或音素序列,输出音素序列或语音,难点是输入同时混入两种已见语言或属于完全未见语言时,模型仍按单一语言处理。论文把这种失效定义为音系干扰(phonological interference),即模型从上下文估计语言并施加该语言的音素库存,覆盖局部音素判断。度量上把一对语言中一方有而另一方缺的音素记为非共享音素,用模型保留它们的召回刻画干扰,代码转换下比较每段单独处理与两段一起处理时较差一段的召回下降。为定位该估计,方法先用逻辑回归探针(logistic regression probe)在编码器表示上读出每帧语言分数,再用15维语言子空间表示该估计,沿该子空间编辑即可复现并转向干扰,证实其因果作用。修复方法为窗口语言估计(windowed language estimation,WLE),在每个位置把语言子空间坐标替换为短窗输入算出的坐标,其余维度不变,使语言判断只依赖局部上下文。在SwitchLingua代码转换集上,WLE把三模型的干扰量减少34%到69%,识别器单语错误率变化保持在正负0.35个百分点内。结论适用于一次切换的双语读句和拼接语音,未见语言只做了相关性比较,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
54. 先改音色再分段导演:EDICT 如何兼顾全局音色编辑与句内表达控制

英文题目:Edit Who Speaks, Control How They Speak: Global Timbre Editing and Local Instruction Control for TTS
标签:#文本到语音 | #韵律与风格控制 | #偏好优化 | #基准测试
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Junchuan Zhao:National University of Singapore
- Chenglin Xu:LIGHTSPEED
- Wei Zeng:National University of Singapore
- Haoyang Li:Nanyang Technological University
- Yiwen Guo:机构信息未在 arXiv HTML 中可靠披露
- Ye Wang:National University of Singapore
📌 核心摘要
指令型语音合成需要同时满足两类要求:整句共用同一个修改后音色,相邻文本段落各自按自然语言要求改变情感、语速或韵律。已有克隆只能复刻原音,语音设计只能按描述从头生成,单条整句指令难以说明每段如何变化,保留历史声学状态又会把上一段的表达带入下一段。EDICT 分两步处理:可训练的音色编辑器把参考音频和全局修改要求转为编解码器令牌形式的已编辑参考音频,冻结的语音合成主干以该参考音频为共享条件逐段生成,并在段边界丢弃旧缓存,用新指令、新文本、共享参考音频以及开头 S 个和最近 K 个声学位置重建键值缓存。相对已有分段掩码方法,差异在于历史声学向量的键和值在新条件下重新计算,而非继续沿用旧条件下的表示。在 TimbreEdit-Bench 上,EDICT 第一阶段在结构化指令下目标说话人相似度 WavLM 达到 0.819,高于 Qwen3-TTS-VoiceDesign 的 0.701,同时段内控制实验显示重建缓存改善了局部依从和过渡自然度。结论适用于中英文朗读类短句拼接,细粒度音色保持、长篇对话和强情感跳变仍需验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://danny-nus.github.io/EDICT-demopage/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-14B — 暂时无法访问
第三方资源:https://huggingface.co/Qwen/Qwen3-TTS-12Hz-1.7B-VoiceDesign — 暂时无法访问
第三方资源:https://huggingface.co/microsoft/wavlm-base-plus-sv — 暂时无法访问
第三方资源:https://modelscope.cn/models/iic/speech_eres2net_sv_zh-cn_16k-common — 链接可访问(HTTP 200)
第三方资源:https://ai.google.dev/gemini-api/docs/models — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/Chanson-0803/MED-TTS — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
55. 为对话配上合适语气:用合成反馈训练风格规划器

英文题目:Beyond Speech Captions: Speech-Rewarded Style Planning for Conversational Text-to-Speech
标签:#韵律与风格控制 | #强化学习 | #语音 | #大语言模型
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shiao Zhu:机构信息未在 arXiv HTML 中可靠披露
- Lianbo Liu:机构信息未在 arXiv HTML 中可靠披露
- Sizhen Lyu:机构信息未在 arXiv HTML 中可靠披露
- Yuzhe Wang:机构信息未在 arXiv HTML 中可靠披露
- Sheng Li:机构信息未在 arXiv HTML 中可靠披露
- Takahiro Shinozaki:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
对话式语音合成要从文本对话历史和当前回复文本推断合适的说话方式,同一句话可以安慰、犹豫或兴奋地说,仅靠文本难以确定。已有做法把目标语音压缩成自然语言风格描述再学习预测,但描述准确不等于对特定合成器控制有效。候选指令分析显示描述对齐与下游声学相似度仅弱相关,基于描述对齐选择指令几乎不优于随机选择。论文提出的语音奖励风格规划让文本风格规划器生成一句英文风格指令,再把指令、回复文本和同说话人提示音频送入冻结的合成器。用目标语音token在该条件下的教师强制似然作为奖励,以组相对策略优化更新规划器,无需目标风格描述监督。在ISCSLP 2026 CoT-TTS英文子集的两个测试划分上五个下游声学指标均居首,例如test_in上情感相似度.6417高于无指令合成的.6098且MCD-DTW 5.9569低于无指令合成的6.2426,也优于未微调大语言模型和能看到目标波形的描述基线。结论限于该语料和同一合成器后端,自动法官偏好仍明显低于真实录音,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
56. DiffuPlex:用滚动掩码预测减少全双工对话的逐帧计算

英文题目:DiffuPlex: Accelerating Full-Duplex Spoken Dialog Models via Rolling Masked Diffusion
标签:#全双工语音交互 | #语音对话系统 | #扩散模型 | #实时处理
评分:7.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Heeseung Kim:Department of Artificial Intelligence;University of Seoul;Seoul, Republic of Korea
📌 核心摘要
全双工语音交互的输入是持续到达的用户音频流,输出是需同步播放的助手音频流,常规做法每80ms交互帧唤醒一次主干做自回归推进,在打断重叠与附和处序列计算压力大。DiffuPlex以历史交互与掩码未来块为输入,经一次主干唤醒同时预测未来一段用户与助手声学码本及文本,输出包含双方内容的未来草稿。置信保留以该草稿为输入,只截取其中置信的连续前缀按原帧率消耗播放,并把对应用户预测存入缓存供后续核对,前缀长度决定单次唤醒推进帧数。随播放到达的真实用户帧与缓存预测逐帧比对,若偏离则保留已播助手内容,只丢弃未播未来并再次唤醒重测,核对结果决定草稿延续或重绘。与沿用自回归主干且跳过计算时以静音代替的延迟执行基线不同,该方法以预测填补唤醒间隔因而在助手发声段也能推进。在Full-Duplex-Bench v1.0评测中,效率指标每唤醒推进帧数cc上DiffuPlex-Speak为2.23,高于自回归personaplex-rl-seamless的1.00。在同一Full-Duplex-Bench v1.0的单张RTX A6000受控推理中,部署链路wall-clock加速比指标上DiffuPlex-Speak相对自回归personaplex-rl-seamless为1.59倍,耗时更少。训练使用四张NVIDIA RTX A6000,助手长语音段的未来声学建模仍不稳定,结论限于已测打断与轮转场景。
🔗 开源资源
第三方资源:https://diffuplex.github.io/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/kyutai/personaplex-rl-seamless — 暂时无法访问
第三方资源:https://huggingface.co/nvidia/personaplex-7b-v1 — 暂时无法访问
第三方资源:https://huggingface.co/kyutai/moshiko-pytorch-bf16 — 暂时无法访问
第三方资源:https://github.com/DanielLin94144/Full-Duplex-Bench — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/hlt-lab/voicebench — 暂时无法访问
第三方资源:https://github.com/sarulab-speech/UTMOSv2 — 链接可访问(HTTP 200)
第三方资源:https://developers.openai.com/api/docs/models/gpt-5.6-luna — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
57. 只用文本训练,再用少量音视频补感知:面向联合音视频推理的文本中心后训练

标签:#音视频问答 | #强化学习 | #音视频 | #后训练
评分:7.0/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ziyang Cheng:机构信息未在 arXiv HTML 中可靠披露
- Yuhao Wang:机构信息未在 arXiv HTML 中可靠披露
- Hongcheng Liu:机构信息未在 arXiv HTML 中可靠披露
- Qimin Wu:机构信息未在 arXiv HTML 中可靠披露
- Jingru Fan:机构信息未在 arXiv HTML 中可靠披露
- Chen Qian:机构信息未在 arXiv HTML 中可靠披露
- Yanfeng Wang:机构信息未在 arXiv HTML 中可靠披露
- Yu Wang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
全能大语言模型要同时听声音、看画面并做多步推理,输入是带音频与视频的问题,输出是选项或答案,难点在于把分散在不同模态和时间段的证据连起来。论文先做诊断,用单跳感知题和由其组合成的多跳推理题检查九个模型,再用梯度投影比较感知损失和推理损失的局部优化方向。接着把训练按能力组织,纯文本监督微调学习推理链,再用组相对策略优化强化答案准确性,最后用少量原生音视频组相对策略优化恢复感知。与以往直接构造音视频推理数据做监督微调或强化学习不同,该路线把主要推理优化放在文本上,只留少量音视频数据做感知精修。在Qwen2.5-Omni-7B上按相同两阶段训练,在七个音视频推理基准的九个推理分数上,纯文本监督微调加组相对策略优化的几何平均提高率相对基线为25.83%,超过完整原生音视频路线。结论适用于所测的文本剧本类推理数据和多个音视频推理基准,对感知任务不成立,精修后推理仍有小幅回落。训练在8张NVIDIA A100 PCIe 80GB上以GPU小时计量,纯文本两阶段合计比完整原生音视频路线节省56.6%,其中完整原生音视频组相对策略优化需1.214B输入token和642.3 GPU小时,少量音视频精修仅需0.122B输入token和82.7 GPU小时。
🔗 开源资源
- 第三方资源:https://www.alibabacloud.com/help/en/model-studio/qwen3-7-max — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
58. 不用教师蒸馏怎么做少步语音合成:DriftTTS 解读

英文题目:DriftTTS: Few-Step Text-to-Speech Without Distillation via Distribution-Matching Drift
标签:#文本到语音 | #生成模型 | #语音 | #高效推理
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mohammad Nur Hossain Khan:机构信息未在 arXiv HTML 中可靠披露
- Subrata Biswas:机构信息未在 arXiv HTML 中可靠披露
- Bashima Islam:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
输入是文本序列,输出是80维梅尔频谱图再经HiFi-GAN声码器转成波形,难点是在很少的网络求值次数下保持频谱准确和听感自然,而且每段文本只配一段录音,难以直接刻画条件分布。文本编码器先经单调对齐给出帧级条件表示与时长,漂移解码器从高斯噪声出发迭代细化梅尔状态,每一步结合帧级条件与步嵌入直接预测下一状态。训练时把同条件生成的多个样本与目标及其加噪视图构成的局部正样本池,映射到由原始梅尔与冻结梅尔掩码自编码器特征构成的空间,用多尺度吸引与排斥力构造漂移方向,再让生成特征向该方向回归,其中自编码器在同一训练集上预训练且推理时丢弃。为覆盖多步推理,训练采用同策略展开,把模型自身走过的中间状态作为漂移目标,使推理时同一模型可在训练深度内选择不同步数,步数成为质量控制量。与已有扩散和流匹配方法的区别是全程没有规定噪声到数据的轨迹,也没有生成式教师、蒸馏和判别器,这意味着训练不依赖多阶段教师与对抗优化,推理步数也不在训练时固定。在 LJSpeech 测试集上,NFE=4 的 DriftTTS 取得 3.87 dB 的 MCD 和 3.7% 的 WER,接近 Matcha-TTS 在同声码器下的 3.85 dB 和 3.4%。结论适用于单说话人英文朗读和固定训练窗切分,超出训练深度的外推会退化。训练成本为单块 NVIDIA L40S 上 60k 更新,NFE=4 时解码器延迟为 7.08 ms。
🔗 开源资源
- 第三方资源:https://github.com/BASHLab/driftTTS.git → https://github.com/BASHLab/driftTTS — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
59. 用评分细则训练文本生成音乐:多维度奖励与专用测量的分工

标签:#音乐生成 | #偏好优化 | #强化学习 | #后训练 | #音乐
评分:7.0/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ping Wang:机构信息未在 arXiv HTML 中可靠披露
- Guang Yang:机构信息未在 arXiv HTML 中可靠披露
- Shao-Rong Su:机构信息未在 arXiv HTML 中可靠披露
- Junkai Wu:Department of Electrical and Computer Engineering, University of Washington
- Pang Wei Koh:Paul G. Allen School of Computer Science & Engineering, University of Washington
- Noah A. Smith:Paul G. Allen School of Computer Science & Engineering, University of Washington;Allen Institute for AIEqual contribution
📌 核心摘要
文本到音乐生成要求把一段文字描述变成数十秒的波形,难点是质量同时涉及文本对应、风格配器、旋律、节奏、结构、制作与整体音乐性,任何单一自动分数都只能覆盖其中很窄的一面。论文先把文字评分规则、每维要听的证据与分档锚点连同音频和文本描述一起送入现成的音频语言模型,模型返回各维评分的JSON对象,解析合并为加权平均奖励并作为后两步的训练信号。随后该奖励把同一文本的多个候选按分排序并将靠前与靠后配成偏好对做直接偏好优化,或在ACE-Step上把在线采样分组的奖励做组内归一化后直接更新流匹配模型。相对已有做法,方法不需要收集人类偏好,也不需要为每个质量维度训练专用奖励模型,改质量只需改文字规则。在MusicCaps测试集的测试描述上经固定轮数更新后评估,Qwen3-Omni分维度提问的DiffusionNFT相对未训练ACE-Step把文本音频相似度CLAP提高0.0180,把音乐人审美预测SongEval提高0.1057,把音频质量预测Audiobox-Aesthetics提高0.3385,三者均为越高越好。结论适用范围是难以形式化的宽泛听感质量,在速度、调性、配器这类可用专用分析器测量的属性上,规则奖励只恢复部分增益甚至无效。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
60. XTurnix:用两个状态下的二选一决定统一管理说话权

英文题目:XTurnix: Large-Scale Self-Supervised Turn Control through Two-State Binary Decisions
标签:#轮次切换 | #语音对话系统 | #自监督学习 | #数据集构建
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Zhanxun Liu:机构信息未在 arXiv HTML 中可靠披露
- Yifan Duan:机构信息未在 arXiv HTML 中可靠披露
- Hengtao Wu:机构信息未在 arXiv HTML 中可靠披露
- Chen Yang:机构信息未在 arXiv HTML 中可靠披露
- Qinyuan Cheng:机构信息未在 arXiv HTML 中可靠披露
- Kun Wang:机构信息未在 arXiv HTML 中可靠披露
- Xingyu Zeng:机构信息未在 arXiv HTML 中可靠披露
- Xipeng Qiu:机构信息未在 arXiv HTML 中可靠披露
- Chaochao Lu:机构信息未在 arXiv HTML 中可靠披露
- Xie Chen:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
实时对话智能体需要解决的输入是不断更新的用户文本与智能体当前处于听还是说的状态,输出是保留还是转移话语权,难点在于同一片段在不同历史下含义不同,且听态的抢话与说态的打断需要统一接口。XTurnix 把完整对话历史与当前状态拼成提示,只预测一个控制词,听态在 <|keep|> 与 <|start|> 之间选择,说态在 <|keep|> 与 <|stop|> 之间选择,状态转移由规则确定。训练分两步走,自监督阶段把双人时间戳转录按时间交织并用状态机逐词标注,合成阶段按目标标签先定类别再改写上下文以补齐说态样本,模型从 Qwen3-0.6B 初始化并学习输出唯一合法动作词。与按完成、后通道、打断等语义事件划分标签的已有检测器不同,该工作把动作空间直接定义为是否交接话语权,并共享 <|keep|> 表达两种状态下的继续。在自建均衡多轮基准上,XTurnix-ZH-Base 达到 89.06% 总体准确率,超过最强第三方基线的 68.75%,四类 F1 分数分布在 84.21% 到 90.63% 之间。结论适用于有完整多轮文本历史与明确听说状态的文本决策环节,对无填充词提示的模糊完成句仍可能误判。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
61. 强模态帮弱模态:跨模态对齐的方向性迁移

英文题目:Strong Helps Weak: Directional Cross-Modal Alignment Transfer in Multi-modal LLMs
标签:#音频问答 | #迁移学习 | #形式化分析 | #多模态模型
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hoigi Seo:机构信息未在 arXiv HTML 中可靠披露
- Byung Hyun Lee:机构信息未在 arXiv HTML 中可靠披露
- Minjun Kim:机构信息未在 arXiv HTML 中可靠披露
- Dohyun Mah:Dept. of ECE
- Jongho Lee:Dept. of ECE;INMC & AIIS
- Se Young Chun:Dept. of ECE;INMC & AIIS
📌 核心摘要
多模态大语言模型把大语言模型骨干与视觉、视频或音频编码器配对,目标是从非文本输入生成文本,难点在于音频、视频等数据稀缺模态难以负担大规模采集与再训练。论文刻画的不对称现象是,把对齐充分的视觉多模态大语言模型作为施体合并到音频或视频受体中,受体在其自有基准上反而变好,增益来自模态表征与文本表征对齐的增强。方向性跨模态对齐迁移先在文本主子空间上构造兼顾子空间能量交叠与谱多样性的目标,再用文本输入上的施体与受体锚定项约束求解,逐层以闭式更新改写受体线性层权重,只用256个AVQA校准样本,校准与评测数据互不重叠。与任务向量平均类已有合并方法的区别在于更新方向由互信息下界推出的对齐目标决定,而非直接平均权重差。在Vicuna骨干Audio+Vision设置下,MMAU总体准确率上方向性跨模态对齐迁移为56.20,高于原始音频模型的48.90。在同一Vicuna骨干Video+Vision设置下,Video-MME总体准确率上该方法为40.11,高于原始视频模型的34.22。结论适用于共享语言模型结构的视觉施体向音频或视频受体迁移,视觉端性能可能下降;训练成本上单张NVIDIA L40S 48GB上全部投影求解约需25分钟至30分钟每设置。
🔗 开源资源
第三方资源:https://seohoiki3215.github.io/DCAT_project_page → https://seohoiki3215.github.io/DCAT_project_page/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/modelscope/llava-llama3.1-8b — 暂时无法访问
第三方资源:https://huggingface.co/fixie-ai/ultravox-v0_4_1-llama-3_1-8b — 暂时无法访问
第三方资源:https://huggingface.co/weizhiwang/LLaVA-Video-Llama-3.1-8B — 暂时无法访问
第三方资源:https://huggingface.co/HuggingFaceM4/Idefics3-8B-Llama3 — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
62. 混合语音里学出可分离的表示:SepRQ 的多分辨率伪源分离

标签:#语音分离 | #说话人分离标注 | #自监督学习 | #向量量化
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Séverin Baroudi:机构信息未在 arXiv HTML 中可靠披露
- Hervé Bredin:机构信息未在 arXiv HTML 中可靠披露
- Ricard Marxer:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
现实对话常出现多人重叠、混响和背景噪声,输入是单通道混合语音,期望输出是能同时支撑分离、说话人分离标注和目标说话人识别的表示,难点在于重叠内容互相遮蔽且说话人顺序没有先验。SepRQ(Self-Supervised Speech Mixture Representation Learning via Mask-Free, Multi-Scale Source Separation)先按概率叠加干净话语、噪声和干扰话语合成混合频谱,再用共享全局均值方差归一化后送入卷积前端和 12 层 Conformer 编码器。编码器每两层引出一个分离预测分支,先把相邻帧沿特征维折叠降采样,再用独立投射头预测各说话人在冻结随机向量量化器(Random Vector Quantizer, RVQ)码本中的离散单元,并用排列不变训练解决说话人与输出头的对应问题。与 C-HuBERT 保留掩码预测的做法不同,该模型去掉掩码并在多个时间分辨率上同时计算分离损失,使全部帧都参与学习。在 LibriSpeech 960 小时合成混合上预训练后,推理只保留编码器并输出 50 Hz 表示。在 SUPERB 上,SepRQ 相对 WavLM Base 将说话人分离标注错误率从 4.55% 降到 2.08%,分离指标 SI-SDRi 提高 1.73 dB,适用范围集中在多说话人混合任务,原文承认未微调时单说话人自动语音识别仍受限。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://sevkod.github.io/SepRQ/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
63. EchoChat:把共情语音对话拆成感知、心理推断与回应三段来做

英文题目:EchoChat: Structured Cognitive Reasoning in Empathetic Spoken Dialogue
标签:#语音对话系统 | #强化学习 | #数据集 | #基准测试
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Dingdong Wang:机构信息未在 arXiv HTML 中可靠披露
- Shujie Liu:机构信息未在 arXiv HTML 中可靠披露
- Yayue Deng:机构信息未在 arXiv HTML 中可靠披露
- Yuxuan Hu:机构信息未在 arXiv HTML 中可靠披露
- Yunrui Cai:机构信息未在 arXiv HTML 中可靠披露
- Jincenzi Wu:机构信息未在 arXiv HTML 中可靠披露
- Jianwei Yu:机构信息未在 arXiv HTML 中可靠披露
- Jinyu Li:机构信息未在 arXiv HTML 中可靠披露
- Helen Meng:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
共情语音对话的输入是用户语音,输出是兼顾语义与语音表达的安慰性回应,难点在于韵律等细微声学线索会改变情绪含义,而感知错误会沿推理链放大。EchoChat 把流程组织为感知分析、心理状态建模(含心智理论(Theory-of-Mind,ToM)推断)与支持策略选择三段,推理轨迹放在 <think> 标记内,回应语音的风格随策略确定。监督微调阶段用声学锚定注意力(Acoustic-Anchored Attention,AAA)提高感知词对语音编码器输出的注意力权重,强化声学依据。强化学习阶段用带级联门控的推理奖励约束阶段依赖,并用分步信用分配(Step-Decomposed Credit Assignment,SDCA)把各段奖励换算为独立的组内优势后分配到对应词元。回应奖励模型同时评价文本共情质量与语音情绪匹配度,实现感知、推理与生成的联合优化。与已有直接映射或单阶段优化做法相比,该框架显式建模中间心理状态并按段定位误差。在 EchoEval 上 EchoChat 平均得分为 8.64,超过次优的 Mimo-Audio-7B-Instruct 的 7.16。原文未披露训练、推理或部署成本,结论主要适用于单轮与短多轮的表演式评测语音。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
64. 冻结语音基座如何先学鲁棒再适配新任务

英文题目:Transferable Adversarial Robustness for Speech Foundation Models via Hierarchical Stabilization
标签:#音频分类 | #说话人识别 | #对抗训练 | #对抗鲁棒性
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Aref Mousavi:机构信息未在 arXiv HTML 中可靠披露
- Shahab Sherafat:机构信息未在 arXiv HTML 中可靠披露
- Kiarash Kiani Feriz:机构信息未在 arXiv HTML 中可靠披露
- Amirparsa Safari:机构信息未在 arXiv HTML 中可靠披露
- Raoof Zare Moayedi:机构信息未在 arXiv HTML 中可靠披露
- Mohammad Hossein Rohban:机构信息未在 arXiv HTML 中可靠披露
- Mohammad Sabokrou:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
冻结语音基础模型在使用时保持骨干不变,下游任务只学习各隐藏层表示的凸融合权重和一个线性分类器,输入是原始波形,输出是关键词、意图、说话人或情感的类别编号,难点是未来任务会选择哪几层、分类边界在哪里都未知,单做最后一层的稳健化无法覆盖所有可能的融合。第一阶段在任务未知时用无标注语音做对抗稳健化,对每一层计算攻击前后帧序列的层归一化距离,再用平滑最大值聚合各层不稳定性,同时用保持项把干净表示锚定在原始预训练模型附近,输出是稳健化后的骨干。第二阶段先用干净标签学出任务相关的融合权重和线性头并将其冻结,只更新分类器的权重和偏置,直接放大样本到最近决策边界的归一化几何距离,不用任何下游对抗样本。相对只稳定末端嵌入的FARE风格做法和只稳定最后一层的对照,跨层稳定的差异在于它对任意融合权重都给出移动上界。Wav2Vec2 Large、HuBERT Large和WavLM Large在4个任务上的平均结果显示,完整方法相对标准训练把鲁棒准确率提高50.4个百分点,干净准确率下降3.2个百分点,评测采用含自适应攻击的样本级并集。在单块RTX 4090上训练成本为第一阶段每骨干一次18.9 GPU小时,第二阶段每任务0.37 GPU小时,少于每任务10.7 GPU小时的全量对抗微调。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
65. 智能眼镜上的自我中心空间音频理解:SEA-LM 如何听清谁在何处说什么

英文题目:SEA-LM: Egocentric Spatial Audio Understanding for Wearable Microphone Arrays
标签:#联合声音事件检测定位 | #声源定位 | #语音识别 | #多模态学习 | #麦克风阵列
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Sonal Kumar:机构信息未在 arXiv HTML 中可靠披露
- Sinan Hersek:机构信息未在 arXiv HTML 中可靠披露
- Artem Dementyev:机构信息未在 arXiv HTML 中可靠披露
- Mengzhen Pan:机构信息未在 arXiv HTML 中可靠披露
- Ishan Chatterjee:机构信息未在 arXiv HTML 中可靠披露
- Anurag Kumar:机构信息未在 arXiv HTML 中可靠披露
- Ramani Duraiswami:机构信息未在 arXiv HTML 中可靠披露
- Dinesh Manocha:机构信息未在 arXiv HTML 中可靠披露
- Andrea Colaco:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
输入是智能眼镜上4至9个麦克风采集的30秒多通道音频,输出是结构化JSON声源列表,每个外部源给出声音类型、起止时间、方位角、俯仰角、距离与类别方向,转写任务还输出文本并区分佩戴者与旁观者。难点在于阵列几何可变、混响与头体散射使空间线索失真,多源重叠时转写文本token数量远多于方向与时间token,容易淹没定位监督。FOACoder先把可变阵列经匹配波束成形转成一阶Ambisonics加一路原始通道,再用因果Transformer编出每100ms一个的空间嵌入。SEA-LM把该空间支路与每40ms一个的单声道语义支路一同送入Gemma-4-E4B-it,用两阶段课程学习六类整体与条件式任务,并对空间与时间数值token加权。在合成held-out评测的整体定位任务1上,SEA-LM方位角平均绝对误差为14.9度,低于仅替换空间编码器的SELDNet++基线的80.6度。在报告条件的课程消融中,直接两阶段的任务1方位角平均绝对误差为14.9度,优于插入Stage2a的15.5度。在合成held-out评测的定向佩戴者转写上,SEA-LM词错误率为5.8%,低于对照基线的31.6%。结论只在两种眼镜几何衍生的1211种配置与静态合成场景内成立,未验证真实与动态场景;编码器已披露在8卡H100上训练200万步、批量128及语言模型两阶段配置,未披露墙钟时长、推理延迟与显存占用。
🔗 开源资源
- 第三方资源:https://github.com/partha2409/DCASE2024_seld_baseline — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
66. 说话人跟踪:按段在线组织重叠与中断语音

英文题目:Speaker Tracking: Segment-online Multi-talker Organization with a Varying Number of Speakers
标签:#说话人分离标注 | #语音分离 | #说话人验证 | #时频分析
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Vahid A. Kalkhorani:机构信息未在 arXiv HTML 中可靠披露
- Daniel Wong:机构信息未在 arXiv HTML 中可靠披露
- Jacob Donley:机构信息未在 arXiv HTML 中可靠披露
- Ashutosh Pandey:机构信息未在 arXiv HTML 中可靠披露
- Buye Xu:机构信息未在 arXiv HTML 中可靠披露
- DeLiang Wang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
说话人跟踪要求从连续会议录音中分离同时说话的声音,再把同一说话人在中断后重新对应到同一轨道,输入是单通道或多通道混合波形,输出是每位说话人各自连续的波形与说话时间标注,难点在于重叠、进出场、静音中断和未知总人数。系统先把滑动重叠分段送入分离模型得到固定路数的候选波形,该分段输出容量设为四路,仿真训练混合也最多含四个同时说话人并按8秒分段训练,再用语音活动检测标出每路的活跃帧并去除泄漏。相邻分段在重叠区按波形距离做重叠拼接以延续连续语音,未能拼接的片段提取声纹嵌入并与工作记忆中的全局说话人档案做余弦相似度验证,超过阈值则归入旧轨道并更新档案,否则新建轨道。与需要离线聚类或预先登记的连续语音分离加分离标注级联相比,该框架无需已知总人数且避免对历史重复推理。在7通道LibriCSS会话级评测中,系统取得分离标注错误率3.38%与连接最小排列词错误率5.32%,均优于同类在线基线并接近使用参考干声的上限,AMI长会议在线评测也取得相对最优。上述5至120秒是LibriCSS分段评测的片段长度,含2至10条语句、最多8个不同说话人,并非两个基准共同的仿真分段长度。该分段评测中实际7个说话人时计数准确率为62.69%,人数增多时存在高估与碎裂,但该容量限制指分段分离输出,不限制整段跟踪的不同说话人总数。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/snakers4/silero-vad — 链接可访问(HTTP 200)
第三方资源:https://github.com/wiseman/py-webrtcvad/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/IDRnD/ReDimNet/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/PalabraAI/redimnet2/ — 链接可访问(HTTP 200)
第三方资源:https://github.com/jsalt2020-asrdiar/jsalt2020_simulate — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
67. AdaLoop:让音频语言模型按题目难度决定思考步数
英文题目:AdaLoop: Adaptive-Depth Latent Reasoning for Audio Language Models
标签:#音频问答 | #音频推理 | #动态计算与早退 | #音频大模型
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Lee Seung-woo:机构信息未在 arXiv HTML 中可靠披露
- Bowen Qi:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
大型音频语言模型(Large Audio Language Model,LALM)以同一文本接口回答语音、声音和音乐问题,输入是音频波形与自然语言问题,输出是文本答案。难点在于细粒度声学判断需要反复比对音高、响度、速度或重叠事件,而内容理解类问题用粗粒度表示即可,固定层数的前向过程难以兼顾两种需求。AdaLoop把音频编码器到语言模型的线性连接替换为可循环的精炼模块,音频特征先与问题做交叉注意得到问题相关的表示,再用多尺度自注意同时捕捉快慢声学结构,最后经前馈更新进入下一轮。每轮的停机概率由音频池化状态与问题共同决定,累积超过阈值即退出并加权混合各轮结果。相对固定循环四次的结构,引入按问题自适应深度的停机机制是关键差异,使同一模型对语义题只用一至两次精炼,对信号级比对题用六次以上。在Qwen2.5-Omni-7B上相对原始检查点,三个基准平均准确率从59.3%提升到63.1%,方向为越高越好,其中MMSU感知子项从44.5%提升到53.1%,提高8.6个百分点。结论适用于所测的三个7B级模型与MMSU、MMAU-Pro、MMAR的闭集评测,语义类任务本身提升较小,原文披露新增参数量为基座模型的2.4%至2.9%,未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
68. SEAL:混合闭合加性重建与细化感知专家路由的紧凑语音分离

标签:#语音分离 | #混合专家模型 | #语音 | #高效推理
评分:7.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shao-Chun Hu:机构信息未在 arXiv HTML 中可靠披露
- Zi-Xiang Lin:机构信息未在 arXiv HTML 中可靠披露
- Jeih-Weih Hung:机构信息未在 arXiv HTML 中可靠披露
- Hung-Shin Lee:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
单通道语音分离需从一条混响带噪混合波形中恢复各说话人波形,输入为混合短时傅里叶变换,输出为各说话人估计波形,难点在于两路语音在同一时频格点相互抵消时混合幅度很小,乘性掩码仅按比例缩放混合因而难以恢复被抵消成分。方法先将混合压缩为低分辨率锚特征并以共享单元做多步隐状态精炼,每步读出经稀疏专家修正后再送入后续注意力与解码,解码后由重建头输出各组估计。重建头以多原子占据与归属概率组成混合封闭分配,再叠加和为零且受局部混合幅度约束的加性残差,使相消点仍可输出非零估计且各组之和等于混合。路由查询融合局部循环特征与锚特征及步间读出差量与步内时间统计和全局上下文等多路证据,并对步嵌入做范数限制,避免步线索覆盖声学证据。训练采用批量4、学习率0.001、至多500轮并按验证损失早停的配置,单次运行保留最优检查点。按与TIGER相同的评测口径,SEAL small的尺度不变信干噪比提升量SI-SDRi为12.89 dB,相对TIGER small高0.31 dB且乘加运算量MACs降至约三分之一。在同一主机上对1秒输入的波形到波形实测中,SEAL small的图形处理器时延为32.7毫秒,低于TIGER small的43.5毫秒。结论目前只在EchoSet双说话人带噪混响条件下成立,未验证其他语料库和说话人数。
🔗 开源资源
- 代码相关资源:https://github.com/Xiang-Lin75/SEAL — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
69. AccentCL:能逐步增加新口音的鲁棒英语口音分类

英文题目:AccentCL: Robust Accent Classification with Incremental Expansion
标签:#语言识别 | #持续学习 | #口音与方言 | #鲁棒性
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mu-Ruei Tseng:机构信息未在 arXiv HTML 中可靠披露
- Waris Quamer:机构信息未在 arXiv HTML 中可靠披露
- Ghady Nasrallah:机构信息未在 arXiv HTML 中可靠披露
- Ricardo Gutierrez-Osuna:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
英语口音分类的输入是不同说话人、不同录音条件的 utterance,输出是所属口音区域类别,难点是细粒度标签边界模糊、类别样本量不均衡、多语料混合带来域偏移,且部署后需加入新口音类别。AccentCL先把16个细粒度标签合并为5个区域组,用冻结的Whisper-Large-v3编码器多层特征融合为口音嵌入,再以类别先验调整和域均值对齐训练基座分类器,随后用按域分层的回放记忆、冻结基座模型的保留约束和旧到新间隔损失扩展新类别。与固定标签、不可增量扩展的Voxlect基线相比,在共享五分类全量测试上,基座平衡准确率77.1%高于Voxlect的65.8%,宏观F1为76.9%高于Voxlect的68.1%。与Voxlect基线相比,在5→6加入西班牙口音英语的扩展评测中,新类F1为83.3%高于Voxlect的52.7%,旧类平衡准确率77.3%高于Voxlect的66.0%。与仅回放变体相比,在6→7继续加入中文口音英语的扩展评测中,新类F1为61.8%高于仅回放的41.9%,旧类平衡准确率77.6%高于仅回放的75.1%。该结论只在论文自建的多语料划分和两步扩展顺序下成立,更多口音、更多顺序和长期遗忘尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://psi-tamu.github.io/AccentCL/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
70. 只用英语转写训练,语音大模型为何还能跟住翻译和情绪指令

英文题目:DirectSpeech2LLM: A Simple End-to-End Framework to Mitigate Prompt Overfitting in Speech-LLMs
标签:#语音识别 | #语音翻译 | #语音情感识别 | #CTC | #端到端学习
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hemant Yadav:IIIT Delhi, India
- Sunayana Sitaram:Microsoft Research, India
- Roger Zimmermann:National University of Singapore
- Rajiv Ratn Shah:IIIT Delhi, India
📌 核心摘要
输入是连续英语语音,输出是按文字提示决定的转写、译文或情感类别,难点是语音帧序列长度可变且连续向量容易落在大语言模型训练时没见过的区域,只做过转写训练的模型会在新提示下继续转写。语音基础模型先输出与大语言模型输入维度相同的帧向量,再以到冻结词嵌入矩阵的负平方距离算逐帧logits,经对数柔性最大值后算联结时序分类损失,同时用贪心标签把相同预测的连续帧做均值池化压缩,并把全部空白段再压缩成一个前置嵌入。压缩后的语音段嵌入与提示词嵌入拼接后送入冻结的大语言模型算自回归交叉熵,两阶段先只做对齐再加入语言模型反馈联合训练。相对用固定下采样加线性头的适配器,以及只做时间对齐的AlignFormer,该方法同时给出隐式几何约束且不需要投影模块。在LibriSpeech 960小时单任务训练下,Qwen3-4B配置在test-clean/test-other的词错误率为2.21%/4.28%,CoVoST2英语到德语零样本翻译得分为19.97,接近级联上限并保留了指令跟随能力。该结论只适用于20秒以内短语音英语单任务训练与冻结大语言模型的设置,训练步数未至收敛因而结果仍是下界。拼接长语音至1分钟时与基线持平,10分钟以上明显退化且含空白嵌入的设置退化更重,20分钟时各种设置均大幅退化,多任务与滑动窗长语音补救尚未验证;第一阶段50k步约2.5小时、第二阶段20k步约2小时,均在4块B200上完成。
🔗 开源资源
第三方资源:https://github.com/raotnameh/DirectSpeech2LLM — 链接不可用(HTTP 404)
第三方资源:https://openslr.trmal.net/resources/11/librispeech-lm-norm.txt.gz — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-4B — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/microsoft/Phi-3-mini-128k-instruct — 链接可访问(HTTP 200)
第三方资源:https://speechbrain.readthedocs.io/en/stable/tutorials/tasks/speech-recognition-from-scratch.html — 链接可访问(HTTP 200)
第三方资源:https://github.com/facebookresearch/fairseq/blob/main/examples/mm — 链接不可用(HTTP 404)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
71. 给音频基础模型植入可用真实声音触发的后门

英文题目:Backdooring Acoustic Foundation Models for Physically Realizable Triggers
标签:#语音识别 | #对抗训练 | #音频安全 | #语音
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zebin Yun:机构信息未在 arXiv HTML 中可靠披露
- Eyal Ronen:机构信息未在 arXiv HTML 中可靠披露
- Mahmood Sharif:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音基础模型经微调后服务于识别、验证、翻译等多种任务,攻击者在公开发布前植入后门可能影响大量未知下游应用,难点在于预训练数据与下游目标均不可见且触发音须能在现实中播放。基础声学模型后门(Foundation Acoustic model Backdoor,FAB)以预训练声学基础模型、辅助数据集与触发音频为输入,先用末层表示做k均值聚类生成伪标签并以单位矩阵代替缺失投影矩阵,再混合正常样本与其加触发版本训练带毒模型。保持正常性能的分支用伪标签重建掩码预测目标,破坏触发输入的分支把第四层表示拉向全1固定向量,前一步得到的伪标签与替代矩阵直接决定两路损失的计算,部署后攻击者只需播放汽笛等自然声音即可诱发表示偏移。在相同语音识别设置下,与预定义输出表示方法相比,FAB正常输入词错误率为11.4%低于该方法的14.2%,触发输入词错误率为98.4%高于该方法的59.4%,词错误率越低表示识别越好。在HuBERT模型和九任务评测中,触发使内容、说话人、语义与副语言任务大幅退化,物理录放试验中双扬声器播放下错误仍维持高位。后门注入仅训练单轮、批量64已耗尽所用GPU显存,过度微调需8万次更新并累积4批梯度,训练时间约为默认的12.8倍且需80小时以上标注语音才能把触发错误压至20%词错误率以下。常规剪枝与输入过滤难以兼顾正常性能与触发错误,该防御结论仅在自动语音识别任务验证,其他任务、更弱触发与不同模型结构下的效果尚未验证。
🔗 开源资源
- 第三方资源:https://github.com/yundaqwe/FAB — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
72. 先定好什么算重要,再生成声音:CARES 如何检验模型是否听懂说话人反应

英文题目:CARES: A Controlled Synthetic Benchmark of Speaker Reactions to Sound
标签:#音频推理 | #基准设计 | #基准测试 | #数据集 | #音频大模型
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Marcel Gibier:机构信息未在 arXiv HTML 中可靠披露
- Thomas Thebaud:机构信息未在 arXiv HTML 中可靠披露
- Olivier Boëffard:机构信息未在 arXiv HTML 中可靠披露
- Jean-François Bonastre:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
自动音频场景描述(Automatic Audio Scene Description)要把一段混合录音转成文字,说明谁在场、说了什么、周围发生了什么,难点在于描述不可能保留全部信息,必须判断哪些音频事件值得保留,而人工对这一选择分歧很大。本文把显著性限定为音频事件,并给出可操作的定义:当说话人以可听方式对声音作出反应时,该声音显著。构建过程先用确定性分配器固定场景、人物关系、性别、事件类别与反应方式,再由语言模型只写话题与对话,最后用程序化混音合成语音、事件样本与环境底噪。对已有方法而言,丰富转录保留全部词语而不做取舍,语音摘要只评价文字重要性,现有音频问答只把声音当作听者的证据,本文首次把声音与谈话之间的联系作为标签大规模生成。在 1,000 个测试场景上,最好的音频语言模型在反应分类(Reaction Classification,四选一)中平衡准确率为 39.0%,仅略高于只看转录文本的对照系统 36.5%,而在场景分类上可达 89.6%,说明识别声音与理解反应之间存在差距。结论适用于合成的、响度受控、反应类型事先固定的双人对话,不直接推广到真实会议或影视录音。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/marcelgibier/CARES — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
73. SAVU-Bench:用真实录制检验空间听视觉理解

英文题目:SAVU-BENCH: A Real-World Benchmark for Spatial Audio-Visual Understanding
标签:#音视频问答 | #基准设计 | #基准测试 | #空间音频信号
评分:7.0/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yu Chen:机构信息未在 arXiv HTML 中可靠披露
- Ruihang Liu:机构信息未在 arXiv HTML 中可靠披露
- Yangguang Xu:机构信息未在 arXiv HTML 中可靠披露
- Xinyue Jiang:机构信息未在 arXiv HTML 中可靠披露
- Mohammed Bennamoun:机构信息未在 arXiv HTML 中可靠披露
- Farid Boussaid:机构信息未在 arXiv HTML 中可靠披露
- Xinyuan Qian:机构信息未在 arXiv HTML 中可靠披露
- Qiuhong Ke:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
空间音视频理解要求模型同时回答场景中有什么、在哪里、跨模态位置如何对应,输入是有限视场角(Field of View,FoV)视频加一阶Ambisonics(First-Order Ambisonics,FOA)空间音频,输出是选择题答案,难点是真实混响干扰大、声源常在画面外、语义对应与空间对应易混淆。SAVU-Bench(Spatial Audio-Visual Understanding Benchmark)先从MRSAudio、STARSS23、YT360、D-SAV360、MULTIVOX、QoEVAVE共6个真实数据源筛选有效片段,并用声事件标注与视觉检测构建场景元数据及视场与声场对齐结果,该元数据连同任务模板交给大模型生成感知与对齐初稿,再经人工剔除歧义并构造推理题,最后由三位专家独立答题仅保留至少两人答对者,形成1066道评测题。SAVU-Diag(Spatial Audio-Visual Understanding Diagnostic Set)为推理题配合同场景、同时间窗的前置定位与对齐小题,用于区分缺少证据与不会组合证据,含611道诊断题、81个诊断场景。SAVU-EA(Spatial Audio-Visual Understanding Evidence-Augmented Baseline)是免训练基线,先用外部声事件定位与视频目标检测输出显式线索,再将线索连同原始音视频一起交给音视频大模型(Audio-Visual Large Language Model,AV-LLM)作答。与仿真为主、单能力评测不同,该工作坚持真实录制、统一感知对齐推理三层能力、推理题强制依赖跨模态公共参照物,减少单模态捷径。在每任务抽30题的人类评测子集上按准确率比较,SAVU-EA在Audio Grounding上为83.33%,高于Gemini-3.6-Flash的56.67%,在Joint V2A上为70.00%,高于基线的43.33%,而Spatial Reasoning上为66.67%,低于人类的85.00%。结论适用于所收录真实短片段与选择题形式,对开集定位、长时追踪尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
74. 把音频变成可读文字再推理:Listen-to-Reason 的树、路由与冻结阅读器

英文题目:Listen-to-Reason: Listen with Experts, Retrieve over a Graph, Reason with LLMs
标签:#音频推理 | #检索增强 | #可解释性 | #少样本
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Pooneh Mousavi:Concordia University;Mila – Quebec AI Institute
- Mirco Ravanelli:Concordia University;Mila – Quebec AI Institute
- Cem Subakan:Concordia University;Mila – Quebec AI Institute;Laval University
📌 核心摘要
音频问答指根据音频证据回答文本问题,难点在于大型音频语言模型把音频融进隐状态,思维链是事后解释,换编码器或大语言模型都要重训。Listen-to-Reason先从训练片段生成含语音、音乐、环境声属性的四层多模态树,再由冻结专家编码器上的小型路由头把每个音频块映射到命名节点并与自动语音识别转写拼接成文本上下文,最后冻结的纯文本读者在不听音频的情况下仅据该上下文作答。与直接融合嵌入不同,感知与推理只通过可读文本交互,更换读者或新增域不必重训已有部分,且答案可追溯到检索路径。在SAKURA全集上以准确率为指标,7B读者准确率为80.1%,超过同指标下直接听音频的Qwen2.5-Omni-7B的73.3%。在MMAU test-mini上以准确率为指标,该7B读者准确率为68.3%,低于同一基线6.8个百分点,树与转写互补且更强读者无需改动音频侧即可缩小差距。在48类鸟类物种辨识任务上以准确率为指标,每类5个标注片段训练的新域头准确率为79.6%,明显高于同数据下QLoRA微调该基线的54.1%。系统只训练7.7M参数,约为Omni-7B的1400分之一,但单题推理需要5.3 TMACs和0.57 s,高于Omni-7B的2.7 TMACs和0.12 s;树继承标注与教师分类器误差,读者会跟随错误节点,且新域仅在物种辨识任务验证,需要身份之外推理的新域仍待探索。
🔗 开源资源
第三方资源:https://poonehmousavi.github.io/listen-to-reason/ — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/poonehmousavi/listen-to-reason — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
75. 会话语音审美:用人类听感对齐语音描述模型

英文题目:Conversational Voice Aesthetic Model with Reinforcement Learning from Human Listeners
标签:#语音属性识别 | #强化学习 | #语音大模型 | #人类参与评测
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Xilin Jiang:机构信息未在 arXiv HTML 中可靠披露
- Shun Zhang:机构信息未在 arXiv HTML 中可靠披露
- Tejas Jayashankar:机构信息未在 arXiv HTML 中可靠披露
- Yinghao Aaron Li:机构信息未在 arXiv HTML 中可靠披露
- Osama Hanna:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
会话语音美学模型(Conversational Voice Aesthetic Model,CVAM)要解决的问题是,在给定上文语音和回应语音时,用自然语言和结构化标签描述回应语音的美学特征,其中情感与表达方式高度主观且没有唯一正确答案。模型输入上下文音频与回应音频,输出包含依据的描述和9个类别标签,覆盖性别、音高高度、音高变化、语速、节奏、情感、唤醒度、温暖度与自信度。数据准备先用工具测得客观音高语速标签与证据日志,再由Gemini 3.1 Pro结合上下文与回应音频写出情感与表达方式的描述和标签,合并成3万条合成样本的完整JSON。监督微调在该3万条合成样本上训练Qwen2.5-Omni的LoRA适配器,学会输出格式与美学描述,得到的SFT策略作为强化学习的起点与参照策略。组相对策略优化在1.5k条人类标注样本上对每输入采样16条JSON预测,用前向KL分布奖励比较人类约10票的投票分布与组内标签频率,重点更新四个感知字段以对齐投票分布。与不看上下文的单句评价方法不同,该工作把上下文作为判断情感与表达方式的必要条件,并对真实语音与克隆、设计合成语音采用同一标准。在1.5k条测试回应、人类多数投票为参照的评测中,前向KL分布奖励的CVAM在四个感知字段平均准确率为69.6%、宏F1为50.1%,超过Gemini 3.1 Pro的60.2%与44.2%,也超过单人对剩余多数的60.8%与43.5%。真实自发语音和稀有类别仍是失败较多的范围,论文报告了2×8与4×8 A100训练配置,但未披露完整训练时长与推理部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
76. 通话不断线、后台接着干:DuplexAgent 如何协调实时语音与异步任务

英文题目:DuplexAgent-RSI: Recursive Harness Improvement for Full-Duplex Voice Agent Collaboration
标签:#全双工语音交互 | #语音代理规划与工具使用 | #工具增强与约束解码 | #评测协议
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Yingda Shen:机构信息未在 arXiv HTML 中可靠披露
- Yuxiang Wang:机构信息未在 arXiv HTML 中可靠披露
- Kunyu Feng:机构信息未在 arXiv HTML 中可靠披露
- Qinke Ni:机构信息未在 arXiv HTML 中可靠披露
- Jiaqi Li:机构信息未在 arXiv HTML 中可靠披露
- Minghao Hsu:机构信息未在 arXiv HTML 中可靠披露
- Junan Zhang:机构信息未在 arXiv HTML 中可靠披露
- Dekun Chen:机构信息未在 arXiv HTML 中可靠披露
- Yutong Bian:机构信息未在 arXiv HTML 中可靠披露
- Zhizheng Wu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
全双工语音智能体输入是流式语音波形与交叠的对话事件,输出是适时spoken回复或可执行工具调用,难点在于任务变更、过时结果到达与说话时机三者交织,系统须在保持通话连贯的同时更新目标并舍弃过时工作。DuplexAgent用全双工交互模型守住实时通道,用推理大语言模型与代码智能体组成的委派池做后台搜索、推理与编码,六模块协作harness在两者之间维护任务账本并决定路由、确认、移交与播报。Duplex-Harness-RSI重用服务用户的委派池做改进:考试规划器按归因失败与修复档案选择下一轮定时测试,Harness编辑器修改被诊断点名的模块,配对比较与保护集决定是否保留,使协调能力随证据迭代。与把请求写成一句话标题或自然语言重述的描述式移交不同,该系统传递正式函数模式与完整上下文,并只在当前任务的说话窗口内播报,避免描述替换可执行调用。在BFCL-v3可执行工具使用评测中,Qwen-Realtime附件上DuplexAgent†的BFCL-v3平均分从Qwen-Realtime的82.0%升至90.8%。在MMSU口语知识评测中,同一Qwen-Realtime附件上DuplexAgent†的MMSU准确率从Qwen-Realtime的64.8%升至82.7%。在FDB-v1双工计时评测中,同一附件上DuplexAgent†的打断TOR从Qwen-Realtime的0.89升至0.97。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
77. MiMo-V2.6:把强化学习算力放大到智能体自我改进

英文题目:MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement
标签:#音视频理解 | #强化学习 | #多模态模型 | #后训练
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.5/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Xiaomi LLM-Core Team:机构信息未在 arXiv HTML 中可靠披露
- Zongming Qiao:机构信息未在 arXiv HTML 中可靠披露
- Ziyue Hua:机构信息未在 arXiv HTML 中可靠披露
- Zirui Ou:机构信息未在 arXiv HTML 中可靠披露
- Zihao Yue:机构信息未在 arXiv HTML 中可靠披露
- Zihan Jiang:机构信息未在 arXiv HTML 中可靠披露
- Zhuo Huang:机构信息未在 arXiv HTML 中可靠披露
- Zhiyang Chen:机构信息未在 arXiv HTML 中可靠披露
- Zhixian Zheng:机构信息未在 arXiv HTML 中可靠披露
- Zhipeng Xu:机构信息未在 arXiv HTML 中可靠披露
- Zhengrui Ma:机构信息未在 arXiv HTML 中可靠披露
- Yuyang Hu:机构信息未在 arXiv HTML 中可靠披露
- Yuhang Dong:机构信息未在 arXiv HTML 中可靠披露
- Yuechen Zhang:机构信息未在 arXiv HTML 中可靠披露
- Yudong Wang:机构信息未在 arXiv HTML 中可靠披露
- Yuanxin Liu:机构信息未在 arXiv HTML 中可靠披露
- Yixin Yang:机构信息未在 arXiv HTML 中可靠披露
- Yishuo Cai:机构信息未在 arXiv HTML 中可靠披露
- Yikai Zhao:机构信息未在 arXiv HTML 中可靠披露
- Yihan Yan:机构信息未在 arXiv HTML 中可靠披露
- Yifan Zhang:机构信息未在 arXiv HTML 中可靠披露
- Yifan Song:机构信息未在 arXiv HTML 中可靠披露
- Xiyu Wei:机构信息未在 arXiv HTML 中可靠披露
- Xing Zhang:机构信息未在 arXiv HTML 中可靠披露
- Xin Zhang:机构信息未在 arXiv HTML 中可靠披露
- Xiaoqian Liu:机构信息未在 arXiv HTML 中可靠披露
- Xiaodong Ji:机构信息未在 arXiv HTML 中可靠披露
- Xiangwei Deng:机构信息未在 arXiv HTML 中可靠披露
- Xueyu Guo:机构信息未在 arXiv HTML 中可靠披露
- Wenhan Ma:机构信息未在 arXiv HTML 中可靠披露
- Weimin Xiong:机构信息未在 arXiv HTML 中可靠披露
- Weikun Wang:机构信息未在 arXiv HTML 中可靠披露
- Weiji Zhuang:机构信息未在 arXiv HTML 中可靠披露
- Shuo Liu:机构信息未在 arXiv HTML 中可靠披露
- Shuhuai Ren:机构信息未在 arXiv HTML 中可靠披露
- Shuhao Gu:机构信息未在 arXiv HTML 中可靠披露
- Shimao Chen:机构信息未在 arXiv HTML 中可靠披露
- Shijie Cao:机构信息未在 arXiv HTML 中可靠披露
- Shihua Yu:机构信息未在 arXiv HTML 中可靠披露
- Shicheng Li:机构信息未在 arXiv HTML 中可靠披露
- Shengjie Zhou:机构信息未在 arXiv HTML 中可靠披露
- Shaolei Zhang:机构信息未在 arXiv HTML 中可靠披露
- Rang Li:机构信息未在 arXiv HTML 中可靠披露
- Qiying Wang:机构信息未在 arXiv HTML 中可靠披露
- Qingkai Fang:机构信息未在 arXiv HTML 中可靠披露
- Qianli Chen:机构信息未在 arXiv HTML 中可靠披露
- Minzheng Wang:机构信息未在 arXiv HTML 中可靠披露
- Liwen Wang:机构信息未在 arXiv HTML 中可靠披露
- Linli Yao:机构信息未在 arXiv HTML 中可靠披露
- Linghao Zhang:机构信息未在 arXiv HTML 中可靠披露
- Liangyu Cheng:机构信息未在 arXiv HTML 中可靠披露
- Liang Zhao:机构信息未在 arXiv HTML 中可靠披露
- Lei Li:机构信息未在 arXiv HTML 中可靠披露
- Jinhao Dong:机构信息未在 arXiv HTML 中可靠披露
- Jinyu Xiang:机构信息未在 arXiv HTML 中可靠披露
- Jianyu Wei:机构信息未在 arXiv HTML 中可靠披露
- Jiangshan Duo:机构信息未在 arXiv HTML 中可靠披露
- Huaqiu Liu:机构信息未在 arXiv HTML 中可靠披露
- Huanjie Fan:机构信息未在 arXiv HTML 中可靠披露
- Hongyi Guan:机构信息未在 arXiv HTML 中可靠披露
- Hongshen Xu:机构信息未在 arXiv HTML 中可靠披露
- Hao Tian:机构信息未在 arXiv HTML 中可靠披露
- Hanyu Li:机构信息未在 arXiv HTML 中可靠披露
- Hailin Zhang:机构信息未在 arXiv HTML 中可靠披露
- Gang Wang:机构信息未在 arXiv HTML 中可靠披露
- Fuli Luo:机构信息未在 arXiv HTML 中可靠披露
- Feng Wei:机构信息未在 arXiv HTML 中可靠披露
- Dong Zhang:机构信息未在 arXiv HTML 中可靠披露
- Dawei Zhu:机构信息未在 arXiv HTML 中可靠披露
- Chiheng Lou:机构信息未在 arXiv HTML 中可靠披露
- Chenhong He:机构信息未在 arXiv HTML 中可靠披露
- Chenhao He:机构信息未在 arXiv HTML 中可靠披露
- Chenghua Liu:机构信息未在 arXiv HTML 中可靠披露
- Bowen Ye:机构信息未在 arXiv HTML 中可靠披露
- Bowen Shen:机构信息未在 arXiv HTML 中可靠披露
- Boshen Xu:机构信息未在 arXiv HTML 中可靠披露
- Bo Yang:机构信息未在 arXiv HTML 中可靠披露
- Bingquan Xia:机构信息未在 arXiv HTML 中可靠披露
- Bangjun Xiao:机构信息未在 arXiv HTML 中可靠披露
- Baixuan Xu:机构信息未在 arXiv HTML 中可靠披露
- Zhouxiang Mao:机构信息未在 arXiv HTML 中可靠披露
- Zhiyang Zhang:机构信息未在 arXiv HTML 中可靠披露
- Zhixiang Xu:机构信息未在 arXiv HTML 中可靠披露
- Zhenru Lin:机构信息未在 arXiv HTML 中可靠披露
- Zhengju Tang:机构信息未在 arXiv HTML 中可靠披露
- Zhaojun Huang:机构信息未在 arXiv HTML 中可靠披露
- Yuzhe Weng:机构信息未在 arXiv HTML 中可靠披露
- Yuxing Xiang:机构信息未在 arXiv HTML 中可靠披露
- Yuxiao Li:机构信息未在 arXiv HTML 中可靠披露
- Yuheng Yang:机构信息未在 arXiv HTML 中可靠披露
- Yuhang Wang:机构信息未在 arXiv HTML 中可靠披露
- Yuchen Liu:机构信息未在 arXiv HTML 中可靠披露
- Yuanyuan Tian:机构信息未在 arXiv HTML 中可靠披露
- Yuanliang Dong:机构信息未在 arXiv HTML 中可靠披露
- Yu Cheng:机构信息未在 arXiv HTML 中可靠披露
- Yongzhe He:机构信息未在 arXiv HTML 中可靠披露
- Yongshun Liang:机构信息未在 arXiv HTML 中可靠披露
- Yong Wang:机构信息未在 arXiv HTML 中可靠披露
- Yiyan Wang:机构信息未在 arXiv HTML 中可靠披露
- Yitian Gong:机构信息未在 arXiv HTML 中可靠披露
- Yijie Zhang:机构信息未在 arXiv HTML 中可靠披露
- Yanshu Xin:机构信息未在 arXiv HTML 中可靠披露
- Xun Zhang:机构信息未在 arXiv HTML 中可靠披露
- Xingjian Zhao:机构信息未在 arXiv HTML 中可靠披露
- Wenyu Yang:机构信息未在 arXiv HTML 中可靠披露
- Wenshan Huang:机构信息未在 arXiv HTML 中可靠披露
- Wenhao Li:机构信息未在 arXiv HTML 中可靠披露
- Tingwei Huang:机构信息未在 arXiv HTML 中可靠披露
- Tianyu Yu:机构信息未在 arXiv HTML 中可靠披露
- Tianyang Lu:机构信息未在 arXiv HTML 中可靠披露
- Taoyu Yang:机构信息未在 arXiv HTML 中可靠披露
- Sinan Du:机构信息未在 arXiv HTML 中可靠披露
- Shutong Tian:机构信息未在 arXiv HTML 中可靠披露
- Shulin Du:机构信息未在 arXiv HTML 中可靠披露
- Shengfan Wang:机构信息未在 arXiv HTML 中可靠披露
- Shanchuan Fang:机构信息未在 arXiv HTML 中可靠披露
- Qihao Zhang:机构信息未在 arXiv HTML 中可靠披露
- Qibin Yang:机构信息未在 arXiv HTML 中可靠披露
- Qian Yu:机构信息未在 arXiv HTML 中可靠披露
- Qian Tu:机构信息未在 arXiv HTML 中可靠披露
- Pengrong Xie:机构信息未在 arXiv HTML 中可靠披露
- Peipei Wang:机构信息未在 arXiv HTML 中可靠披露
- Peidian Li:机构信息未在 arXiv HTML 中可靠披露
- Minkun Guo:机构信息未在 arXiv HTML 中可靠披露
- Mingchen Shao:机构信息未在 arXiv HTML 中可靠披露
- Luohan Gao:机构信息未在 arXiv HTML 中可靠披露
- Lijie Wang:机构信息未在 arXiv HTML 中可靠披露
- Liang Shi:机构信息未在 arXiv HTML 中可靠披露
- Kaiqi Chen:机构信息未在 arXiv HTML 中可靠披露
- Kaiming Liu:机构信息未在 arXiv HTML 中可靠披露
- Kaifei Wang:机构信息未在 arXiv HTML 中可靠披露
- Kai Yang:机构信息未在 arXiv HTML 中可靠披露
- Jinlong Xue:机构信息未在 arXiv HTML 中可靠披露
- Jiechen Zhang:机构信息未在 arXiv HTML 中可靠披露
- Jiaxuan Liu:机构信息未在 arXiv HTML 中可靠披露
- Hongxu An:机构信息未在 arXiv HTML 中可靠披露
- Hao Peng:机构信息未在 arXiv HTML 中可靠披露
- Hanglong Lü:机构信息未在 arXiv HTML 中可靠披露
- Guonan Wang:机构信息未在 arXiv HTML 中可靠披露
- Feiyu Yang:机构信息未在 arXiv HTML 中可靠披露
- Fanyu Cao:机构信息未在 arXiv HTML 中可靠披露
- Fangyue Liu:机构信息未在 arXiv HTML 中可靠披露
- Fan Cui:机构信息未在 arXiv HTML 中可靠披露
- Cong Wang:机构信息未在 arXiv HTML 中可靠披露
- Chun Chen:机构信息未在 arXiv HTML 中可靠披露
- Chenxu Bai:机构信息未在 arXiv HTML 中可靠披露
- Chengxuan Zhu:机构信息未在 arXiv HTML 中可靠披露
- Chenghua Wang:机构信息未在 arXiv HTML 中可靠披露
- Boyi Zeng:机构信息未在 arXiv HTML 中可靠披露
原作者元数据中有 1 项仅为分隔标点,未列为作者;其他作者与机构按原来源记录展示。
📌 核心摘要
本文要解决的问题是在长 horizon 智能体任务上扩大强化学习(Reinforcement Learning,RL)算力仍能稳定提升能力,输入是代码、通用办公、视觉制品和网络安全漏洞复现等混合任务轨迹,输出是能直接调用工具完成多步任务的策略,难点是奖励稀疏、二值测试无法区分质量、长轨迹吞吐低和奖励投机。方法是先做智能体中心的中间训练扩大探索空间,再用每步 1568 个提示、每提示 16 条轨迹、27 亿至 37 亿 token 的异步大批量训练提高吞吐,轨迹按统一层次结构组织并用样本混合器保持任务配比。奖励侧用离线分组奖励合成(Groupwise Reward Synthesis,GRS)和在线分组优势再分配(Groupwise Advantage Redistribution,GAR)对比同组轨迹,把实现质量和行为差异转为优势差异,同时冻结混合专家(Mixture-of-Experts,MoE)路由并做多层防投机。与只依赖二值测试奖励的已有方法不同,该方法在测试通过组内仍保留学习信号,并把长度惩罚和分段行为惩罚写入优势。与已有最佳方法相比,MiMo-V2.6-Pro 在 DeepSWE v1.1 上平均 3 次得分为 71.9 分,低于 Claude Opus 5 的 74.0 分和 GPT-5.6 Sol 的 73.0 分,在 AutomationBench v1.0.6 上为 53.1 分,高于全部所列基线。结论适用于所用四类智能体 harness 和评测集,未验证开放域长 horizon 游戏、科研等任务,原文披露 RL 训练花费为 Pro 版 260 万美元和 Flash 版 90 万美元。
🔗 开源资源
模型相关资源:https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Distill-Qwen-9B — 暂时无法访问
第三方资源:https://mimo.xiaomi.com/rl/mimo-v26 → https://mimo.xiaomi.com/rl/mimo-v26/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
78. 音频嵌入里还剩多少声音:用统一生成探针审计音频编码器

英文题目:How Much Audio Is Left In An Embedding? An Inversion Audit Of Audio Encoders
标签:#音频隐私攻击与防御 | #音频生成 | #扩散模型 | #音乐
评分:7.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Marios Glytsos:机构信息未在 arXiv HTML 中可靠披露
- Brian McFee:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
预训练音频编码器会被复用于训练时未知的新任务,论文要回答冻结表示中还保留多少可恢复原始录音的来源信息,难点是编码器不一定可逆且不同训练目标与接口时频分辨率差异很大。论文把器乐化音乐波形送入冻结编码器得到表示序列,再用同一个稳定音频开放潜扩散解码器以该表示为条件生成配对波形,生成时依靠表示提供保留的结构并依靠生成器先验补足不确定细节。不同编码器只更换条件投影与带局部时间偏置的交叉注意力接口,潜目标自编码器与变换器结构保持一致,从而在相同解码器下比较监督分类音频文本对比与波形重建三类目标。在百万歌曲集留出曲目的固定时长测试块上,以多分辨率短时傅里叶变换距离衡量,波形重建训练的EnCodec为0.13±0.06,低于保留频率结构的ConvNeXt展平接口的0.18±0.07。在同一测试块上以稳定音频开放变分自编码器空间余弦相似度衡量,EnCodec为0.47±0.16,高于上述ConvNeXt展平接口的0.24±0.07,而压缩表示仍保留可测的来源特异性与高层音乐内容。结论只适用于器乐化音乐与该生成器领域内,解码器能力不足也可能造成重建失败,尚未验证语音与其他领域与更直接的隐私泄露度量。论文报告每个条件接口微调约占用四块图形处理器三十六小时,原文未披露推理或部署成本。
🔗 开源资源
代码相关资源:https://mariosgly.github.io/research/audio-embedding-inversion/ — 链接可访问(HTTP 200)
第三方资源:https://mariosgly.github.io/research/audio-embedding-inversion/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
79. DyRA:用输入相关的残差修正加速大模型的矩阵乘法

英文题目:DyRA: Dynamic Residual Approximation for Efficient Matrix Multiplication in DNNs
标签:#语音识别 | #低秩压缩 | #高效推理 | #语音
评分:6.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.4/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Daewon Chae:Department of EECS, University of Michigan
- Hyunwon Chung:Department of EECS, University of Michigan
- Changwoo Lee:Qualcomm AI Research
- Hun-Seok Kim:Department of EECS, University of Michigan
📌 核心摘要
预训练大模型的推理成本主要来自稠密矩阵乘法,低秩分解、Monarch和BLAST等结构化近似通过压缩权重矩阵降低计算量,但权重误差会被当前输入激活放大,造成输出激活出现较大偏差。DyRA先保留静态结构化近似的计算结果作为基线输出,再把权重残差与当前输入激活的乘积作为待补偿的残差乘积,使校正直接面向决定精度的输出误差。接着该残差乘积被写成低秩左右因子的分解问题,并用交替最小二乘在推理时单步求解,其中左因子依赖的投影矩阵可离线预计算,在线只需输入乘以瘦矩阵得到左因子,再解出右因子并加回基线输出。与固定增加静态秩不同,DyRA的右因子随当前输入协方差调整,在各向同性输入下退化为静态高秩近似,在非各向同性输入下形成输入自适应子空间。在ADE20K上DINOv3语义分割评测中,60% FLOPs降低下DyRA的mIoU仅下降1.7点,而FLOPs对齐的权重近似基线下降54.1点。在NVIDIA A40上DINOv3的端到端延迟评测中,DyRA实现1.52倍加速,低秩基线达到同一加速时的精度下降幅度约为DyRA的3.7倍。该结论适用于矩阵与矩阵相乘较大的预填充或视觉编码等批量推理,自回归逐词解码的向量与矩阵负载不是其主要目标,动态秩跨层自适应分配也尚未验证而留待后续工作。
🔗 开源资源
代码相关资源:https://github.com/daewon88/DyRA — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/google/vit-large-patch32-384 — 暂时无法访问
第三方资源:https://github.com/facebookresearch/dinov3 — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/facebook/wav2vec2-large-960h-lv60-self — 暂时无法访问
第三方资源:https://huggingface.co/GSAI-ML/LLaDA-8B-Base — 暂时无法访问
第三方资源:https://huggingface.co/google/vit-base-patch16-224 — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
80. ParaGeo:把副语言变化拆进共享低维坐标

英文题目:ParaGeo: Decomposing Paralinguistic Variation into a Shared Latent Geometry
标签:#韵律与风格控制 | #低秩压缩 | #语音 | #可解释性 | #语音大模型
评分:6.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuhan Liu:机构信息未在 arXiv HTML 中可靠披露
- Yuxuan Ou:机构信息未在 arXiv HTML 中可靠披露
- Ruoxi Su:机构信息未在 arXiv HTML 中可靠披露
- Mohamed Ahmed Zaki:机构信息未在 arXiv HTML 中可靠披露
- Yunbo Long:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
输入是8个固定英文句子与80种副语言请求交叉合成的语音词元,输出是对说话方式在共享低维坐标中的位置度量以及基于该坐标的生成期干预向量,难点是词汇内容与说话方式纠缠,且请求标签只是合成指令而非人工确认的真实属性。方法先把同一句子的多种renditions回放进冻结的GLM-4-Voice-9B,对音频位置的键/值表示做池化并做句内中心化,再经截断奇异值分解得到秩16的共享基。然后用句子均值的奇异值分解构造内容代理子空间并做正交残差化,得到最终投影与每标签原型坐标,静态、加法组合和随时间插值的干预都复用同一投影。与已有激活加法和情感转向工作相比,差异是跨12个异质请求族使用同一匹配内容标定投影,并把表示诊断与生成响应分开检验。在590条保留记录的内容留出80类质心探针中,投影坐标80-way准确率为9.49%,高于条件置换均值1.25%,置换检验为p=0.001。在同一590条保留记录的内容留出80类质心探针中,同标签跨内容余弦相似度为0.285,高于条件置换对照均值0.017,对应置换检验同样为p=0.001。结论只适用于该回放表示、英语请求和基于模型的成对评价,组合与动态完整任务存在文本通道损伤,原文未披露训练、推理或部署成本。
🔗 开源资源
- 代码相关资源:https://github.com/yuhanlydia/ParaGeo — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
81. 把水印写进语音合成中间过程:NeuMark-Native 解读

标签:#音频水印 | #文本到语音 | #神经编解码与离散单元 | #对抗训练
评分:6.9/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Annan Wu:机构信息未在 arXiv HTML 中可靠披露
- Wen-Chin Huang:机构信息未在 arXiv HTML 中可靠披露
- Tomoki Toda:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
合成语音溯源需要在语音生成时嵌入可恢复的载荷信息,难点是合成后外加的水印容易被省略或绕过,且常规波形水印在神经编解码器重合成后容易丢失。NeuMark-Native先用冻结的VALL-E从目标文本和同说话人提示预合成目标编解码器令牌,再用可训练的水印嵌入器对每层残差向量量化流做消息条件残差更新,冻结解码器输出含水印合成语音,提取器从失真后语音恢复消息和帧级检测标签。配对的未加水印合成参考分支约束内容和声学漂移,自然度、说话人相似度和语音识别损失分别维护主观质量、音色一致和文本内容。相对合成后加水印的WavMark和AudioSeal,该方法把水印证据分布到编解码器隐空间;相对TraceableSpeech,它不重训语音合成模型和编解码器。在LibriTTS test-clean上,适配版本总体检测ROC-AUC为0.981,超过AudioSeal的0.903,编解码器条件下优势更大。该结论仅在冻结VALL-E与SpeechTokenizer的零样本音色克隆、11种数字信号处理失真和9种神经编解码器重合成下验证,其中DAC与SNAC训练未见而EnCodec训练可见,编解码器条件检测仍明显低于无失真与数字信号处理条件。直接套用与适配微调在低虚警检测和比特恢复上互有胜负,向其他语音合成主干迁移及非英语场景尚未验证。原文未披露推理延迟与部署成本,训练成本为单张NVIDIA H100约69小时。
🔗 开源资源
第三方资源:https://github.com/goannan/NeuMark-Native — 链接可访问(HTTP 200)
第三方资源:https://github.com/microsoft/UniSpeech/tree/main/downstreams/speaker_verification — 链接可访问(HTTP 200)
第三方资源:https://docs.pytorch.org/audio/stable/pipelines — 链接可访问(HTTP 200)
第三方资源:https://github.com/facebookresearch/audiocraft — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
82. Logbook:把十几分钟到几天的不间断录音切成无空隙事件日志

标签:#音频事件检测 | #基准设计 | #基准测试 | #长音频处理 | #音频字幕生成
评分:6.9/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Kwanghee Choi:机构信息未在 arXiv HTML 中可靠披露
- Suwon Shon:机构信息未在 arXiv HTML 中可靠披露
- Dmitriy Serdyuk:机构信息未在 arXiv HTML 中可靠披露
- Guitang Lan:机构信息未在 arXiv HTML 中可靠披露
- Chao-Wei Huang:机构信息未在 arXiv HTML 中可靠披露
- Mohammad Sadegh Rasooli:机构信息未在 arXiv HTML 中可靠披露
- Sangeeta Srivastava:机构信息未在 arXiv HTML 中可靠披露
- Zhaojiang Lin:机构信息未在 arXiv HTML 中可靠披露
- Saurabh Adya:机构信息未在 arXiv HTML 中可靠披露
- Ming Sun:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
长时间录音要求系统对每一秒同时给出事件边界、事件类别和文字描述,难点在于边界粒度依赖词表定义,描述需补足标签省略的细节,且不允许以留白回避难段。论文把公开数据统一为无间隙格式,用边界 F1、事件错误率和帧准确率评切分,用原子事实蕴含的召回率、精确率和 F1 评描述,并统计计算量。级联链路先用 10 秒音频字幕生成(audio captioning)模型写短句,再由文本大语言模型合并为 10 分钟窗的分钟级切分;端到端(end-to-end)音频大模型(audio-language model)直接读 10 分钟音频并输出同样格式。与已有短片段单标签评测不同,该任务强制全覆盖和标签加描述配对,更接近整日佩戴设备的听觉记录。在 Ego4D 测试上微调后的端到端 Qwen 3-o 帧准确率达 0.633,描述 F1 达 0.422,超过未微调级联与端到端对照,但仍低于人力参考的 0.646 和 0.550。原文以处理 SINS 前 24 小时所需的千万亿次浮点运算(peta-FLOPs)报告推理成本,例如级联 Gemma 4 为 71.41,端到端 Qwen 3-o 为 11.97。
🔗 开源资源
- 第三方资源:https://github.com/facebookresearch/logbook — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
83. 多指手抓取稳不稳?用抓起前的视觉、本体感觉和指尖触觉来预测

英文题目:Temporal Visuo-Tactile Learning for Dexterous Grasp Stability
标签:#音频分类 | #多模态学习 | #数据集
评分:6.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.4/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Ken Nakahara:机构信息未在 arXiv HTML 中可靠披露
- Aleksei Buvailik:机构信息未在 arXiv HTML 中可靠披露
- Prokhor Kotov:机构信息未在 arXiv HTML 中可靠披露
- Roberto Calandra:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
灵巧手抓取的难点在于闭合与举升过程中多指接触如何形成与分担载荷,单靠外部视觉选择抓取位姿难以判断这种交互是否稳定。论文把任务定义为用举升前观察窗口预测举升后是否掉落,输入为外部RGB、本体感觉与各指尖触觉图像、声音、加速度和压力,输出为抓取成功概率。编码阶段对RGB与触觉图像用预训练视频骨干加时间Transformer建模,对本体感觉与指尖声学等序列用序列编码器处理,再经触觉模态融合、时间与手指维度的分解Transformer与跨模态注意力融合后送入预测头。在线部署时把预测概率与设定阈值比较,超过则举升,否则松开并小幅移动后重新抓取。在10000次抓取数据集上按物体划分的5折交叉验证中,以0.5为阈值计算分类准确率时,视觉-本体感觉-触觉模型均值为83.55%,高于无触觉模型的79.56%。在20个未见物体、每种策略各10次已执行举升且门控阈值为0.95的真机评测中,按已执行举升成功率计,视觉-本体感觉-触觉门控比无触觉门控高10.5个百分点。结论适用于文中包络式抓取与随机化抓取分布,对重物、遮挡下标签噪声与非图像触觉信号的利用仍不充分;原文未披露训练、推理或部署成本。
🔗 开源资源
- 数据相关资源:https://lasr-lab.github.io/dexterous-grasp-stability/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
84. 用一个可连续调节的半径从单通道混合中取出近处语音

英文题目:Monaural Continuous-Radius Regional Speech Extraction with Cross-Radius Consistency Learning
标签:#目标说话人提取 | #正则化 | #时频分析 | #单通道
评分:6.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Biao Dong:机构信息未在 arXiv HTML 中可靠披露
- Jie Chen:机构信息未在 arXiv HTML 中可靠披露
- Jianwei Fang:机构信息未在 arXiv HTML 中可靠披露
- Wei Xiao:机构信息未在 arXiv HTML 中可靠披露
- Jiqing Han:机构信息未在 arXiv HTML 中可靠披露
- Yongjun He:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
单通道混合语音中只保留麦克风周围指定半径内说话人并压制半径外说话人,难点在于距离线索在单通道中微弱且混响敏感,而已有固定阈值或局部窗口做法不能用一个模型处理任意半径。论文把查询半径内所有说话人波形之和定义为目标,先将混合经短时傅里叶变换并拼接幅度归一化特征投影为初始特征送入首个时频块沿频率与时间建模。查询半径归一化后经三层半径编码器映射为频率相关表示,该表示经特征调制对上一块输出做缩放与偏置得到下一块输入,末块输出解码并经逆变换重建为该半径的估计波形,实现一次前向处理任意连续半径查询。训练时对同一混合在连续区间采样四个半径,若相邻半径目标说话人集合相同且非空则以公共目标均方根归一化的波形平均绝对差异约束一致,非空用归一化重建损失、空目标用平均绝对值惩罚迫使静音并联合训练。与已有方法的关键差异在于直接建模累积区域目标而非固定阈值二分或多区间局部估计累加,因而单模型单次前向即可覆盖训练范围内连续半径,避免多次前向累加。在实测dEchorate房间脉冲响应两说话人混合、1至4 m查询半径的相同测试混合上,本文方法全目标SI-SDR为29.25 dB,高于区间累加局部范围基线QD-TSE的25.99 dB,该结论适用于训练半径0到4 m内连续查询,三说话人与加性噪声下性能下降已被量化。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://dongb001.github.io/CRadius-RSE/ — 链接可访问(HTTP 200)
演示资源:https://dongb001.github.io/CRadius-RSE/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
85. 为一位气管造口重度构音障碍者做的个性化捷克语语音识别

标签:#语音识别 | #SFT | #数据集 | #无障碍 | #流式处理
评分:6.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- David Nadrchal:机构信息未在 arXiv HTML 中可靠披露
- Monorama Swain:机构信息未在 arXiv HTML 中可靠披露
- Florian Schmid:机构信息未在 arXiv HTML 中可靠披露
- Gerhard Widmer:机构信息未在 arXiv HTML 中可靠披露
- Paul Primus:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
研究对象是一名带有永久气管造口、伴有重度构音障碍的捷克语青少年,其语音能量低、频谱平坦且中断频繁,未经训练的听者几乎无法理解。在对连续流式音频做自动语音活动检测与切分的病理测试设置下,通用Whisper Base在目标说话人数据上字符错误率(Character Error Rate,CER)普遍超过0.9,其中自发对话场景为1.529。系统以Whisper Base为起点,先在标准捷克语上微调获得语言先验,再用经频谱平坦化、四倍慢放与随机静音中断模拟的气管造口语音训练以贴近弱发声,其输出作为初始化接入离线采集的目标说话人人工合成对话数据训练,最后用流式设备录音做适配得到可部署模型。推理时个性化语音活动检测先从62.5毫秒音频块中切分话语并保留上下文,再交由模型以波束搜索在词表约束下解码输出文字,以抑制幻觉与噪声转写。在188句流式录音自发对话测试中,完整系统CER为0.637,低于同表零样本基线的1.529。在从3次流式人工合成对话随机抽取的25句孤立一至三词听辨子集上,系统CER为0.565,低于4名助手平均的0.708。结论只适用于该说话人及文中的流式录音条件,自发语音切分和词表外专有名词仍是主要失败来源;在经手机网页以62.5毫秒块传至推理服务器的流式推理部署下,系统时延约2.5秒,高于亚秒级商业标准,训练硬件与训练时长原文未披露。
🔗 开源资源
代码相关资源:https://github.com/Hobit2002/DysartrTracheoASR — 链接可访问(HTTP 200)
数据相关资源:https://zenodo.org/records/22745518 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
86. PEACE:把效果器代码和处理后的音频放进同一个向量空间

标签:#音频检索 | #多模态学习 | #音乐信息检索 | #图神经网络
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- David Braun:机构信息未在 arXiv HTML 中可靠披露
- Adam Finkelstein:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
这篇论文要解决的是听一段加过效果的声音,能否找回生成它的效果器程序,输入是立体声湿声音频和Faust效果器代码,输出是同一向量空间中的嵌入向量,难点在于同一听感可来自不同参数组合,而代码既有离散拓扑又有连续与离散参数。音频侧先把中侧通道对数梅尔谱图送入AFx-Rep卷积编码器得到1024维音频隐向量,代码侧把Faust源码送入微调T5编码器或把Faust编译器中间表示的盒子有向无环图送入BoxGraph图编码器得到各自模态隐向量。两路隐向量再经编码器投影器得到768维投影,在线分支进一步经预测器得到预测,指数滑动平均目标分支只产生停梯度投影,所有投影与预测经L2归一化后计算模态间与模态内余弦距离损失,损失梯度只回流在线分支。推理时用预测输出按余弦相似度做音频到代码或代码到音频检索,其中BoxGraph推理时掩码全部参数即可只保留拓扑。与有监督链分类相比,该表示可直接比较程序之间相似度,不限于固定标签集合。在1831个候选的房间脉冲响应检索中,从零训练的BoxGraph版本用预测输出达到53.5%的R@10,高于同一设置下预训练AFx-Rep的28.3%。结论适用于1到3级合成效果链及混响跨域泛化,更长链、非线性效果和真实工程预设仍未充分验证。训练成本方面,T5从零训练约11.5小时,BoxGraph约8.5小时,均在4张NVIDIA L40上完成。
🔗 开源资源
第三方资源:https://github.com/DBraun/PEACE — 链接可访问(HTTP 200)
第三方资源:https://faustdoc.grame.fr/tutorials/box-api/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
87. 每人三十小时听播客:从全脑信号中找回刚才那段声音

英文题目:Cephalonauts One: A deep fMRI dataset for decoding naturalistic speech in the human brain
标签:#言语神经解码 | #数据集构建 | #数据集 | #基准测试 | #脑信号
评分:6.8/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Antoine Collas:Karavela
- Louis Jalouzot:Karavela; UNICOG, CNRS, INSERM, CEA, Paris-Saclay University; LSCP, EHESS, ENS, CNRS, PSL University
- Géraud Ilinca:Karavela
- Corentin Caris:Karavela
- Romain Valabrègue:Centre de NeuroImagerie de Recherche (CENIR), Sorbonne Université, ICM, Paris, France
- Ahmed Hassayoune:Karavela
- David Goncalves:Karavela
- Madeleine Hueber:Karavela
- Thaddée Delebarre:Karavela
- Julien Savatovsky:Department of Radiology, Hôpital Fondation Adolphe de Rothschild, Paris, France
- Clara Fonteneau:Karavela
- Charles Maussion:Karavela
- Bertrand Thirion:Karavela; Inria, CEA, Paris-Saclay University, Palaiseau, France
- Alexis Thual:Karavela
📌 核心摘要
该工作要解决的是自然语音fMRI数据在单个被试上不够深,难以训练被试专属解码器并比较模型的问题。输入是被试听法语播客Les Pieds sur Terre时的全脑3T fMRI时间序列,输出是在留出会话中找出与给定脑帧对应的播客音频片段,难点是候选片段来自同一会话未见过的播客,共享说话人、话题和叙事背景。采集预处理把520 ms重复时间连续记录的每轮约15分钟功能像经DeepPrep处理,再经去趋势、标准化和4个重复时间平滑得到与刺激对齐的脑体积序列。刺激表示把每个采样点前已结束的最近20个词和前10秒音频分别送入Qwen3-Embedding-8B和LCO-Embedding-Omni-7B得到文本与音频嵌入,再拼接成检索目标。解码端用单隐层网络从脑活动预测该拼接嵌入,以CLIP对比损失训练并在留出会话中按余弦相似度对候选嵌入排序,排名越靠前表示解码越准。相对已有Narratives约每人2小时和LeBel等人最多16小时的方案,新数据集把深度推到每人约30小时,并固定了留出会话划分、候选池与三项指标的基准。在5折留出会话评测中训练量从最小增至最大时余弦相似度从约0.075-0.090升至约0.144-0.155,中位相对排名从约0.11-0.19降至约0.022-0.034,Top-10@2000从约3.8%-6.4%升至约22.3%-27.3%,对数坐标下近似直线且未饱和。结论只适用于法语单节目叙事语音的检索式解码,不覆盖开放生成与人群层面泛化,原文报告全部预处理与解码器训练约耗660个H100-80G GPU小时,其中多数用于预处理。
🔗 开源资源
第三方资源:https://niivue.com/ — 链接可访问(HTTP 200)
第三方资源:https://freesurfer.net/fswiki/License — 暂时无法访问
第三方资源:https://www.assemblyai.com/legal/terms-of-service — 链接可访问(HTTP 200)
第三方资源:https://ai.google.dev/gemini-api/terms — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
88. 关系合成:用参考结构重组检索声音的拟音生成方法

标签:#音频生成 | #检索增强 | #信号处理 | #环境声
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Keren Shao:机构信息未在 arXiv HTML 中可靠披露
- Ayaka Kawano:机构信息未在 arXiv HTML 中可靠披露
- Shlomo Dubnov:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
任务输入是检索到的源音频 S、独立的时间参考 R 与文本提示 P,输出是新音频 Y,要求 Y 的事件类声学身份接近 S,时间组织接近 R,且 Y 中不持续残留 S 或 R 的局部波形。难点在于源与参考可能来自不同声学空间,直接逐点匹配会迫使局部切片对齐,细粒度易破坏衔接,粗粒度又牺牲时间自由度并留下长段复制。方法先把 S 与 R 切成 180 ms、跳长 100 ms 的颗粒,用手工声学嵌入表示颗粒,再由关系方法 M 选出与参考等长的源颗粒序列并叠加成载体 X_M,最后把 X_M 与 P 一起送入预训练生成器得到 Y。关系压力来自三类循环结构中的一种与有向幅度运动的组合,前者规定哪些时刻应相似或相异,后者规定幅度升降的相对强弱与方向,求解器在源自相似度上实现这些关系。相对直接用源载体的对照,在 248 个三元组的 Stable Audio 3 Small-SFX 评测中因子神谕把参考起始点 F1 从 0.322 提高到 0.343,把参考包络 L1 从 0.095 降到 0.086,同时源端 2 秒最佳匹配相似度从 0.353 降到 0.299。结论限于同类源、人声模仿参考与所用生成器设置,循环结构与幅度运动的相对贡献随变体变化,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://smoothken.github.io/relational_synth_demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
89. 土耳其语语音合成的多维度客观评测:自然度、清晰度与长时稳定性如何分开看

标签:#文本到语音 | #基准设计 | #基准测试 | #语音质量评估
评分:6.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 1/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yunus Emre Ozkose:机构信息未在 arXiv HTML 中可靠披露
- Alperen Kahraman:机构信息未在 arXiv HTML 中可靠披露
- Ali Haznedaroglu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
本文输入土耳其语句子,输出对应目标说话人语音,难点是土耳其语形态丰富而现有零样本克隆多在英语和中文验证,跨语言韵律和发音迁移是否成立缺少受控证据。评测先用100条短句、100条中句和100条长句合成各系统语音,再用18个客观指标分别度量习得自然度预测、清晰度和信号质量、说话人相似度、分布保真度和低层声学,最后把长句切成2秒块追踪说话人身份漂移和自然度漂移。结果呈现按指标族划分格局,VITS占DNSMOS-Pro族和SpeechLMScore,OmniVoice零样本配置扫过SQUIM三项加AudioBox-PQ,CosyVoice占UTMOS v2、SCOREQ、WhisQA和TTSDS v2。在全测试集均值上,VoxCPM2的说话人相似度为0.881,低于自然参考的0.894,但高于同表其余合成系统,最接近真实语音。同在全测试集均值上,多个合成语音在信号类预测上超过自然参考,说明此类指标奖励干净理想音频而非感知真实。短句是最难设置,Chatterbox在短输入上多指标塌陷而中长句回升,CosyVoice、OmniVoice与VoxCPM2相对稳健。结论只适用于该单说话人客观评测范围,未经人耳验证。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/EmreOzkose/tr-tts-eval — 链接可访问(HTTP 200)
第三方资源:https://github.com/EmreOzkose/tr-tts-eval — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
90. 先猜出说了什么,再补回声音细节的两阶段生成式语音增强

英文题目:LIFT-SE: Linguistic Inference Followed by Flow Transformation for Generative Speech Enhancement
标签:#语音增强 | #去混响 | #自回归模型 | #流匹配 | #神经编解码与离散单元
评分:6.8/10 | 创新 1.4/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Haoyin Yan:机构信息未在 arXiv HTML 中可靠披露
- Chengwei Liu:机构信息未在 arXiv HTML 中可靠披露
- Zheng Xue:机构信息未在 arXiv HTML 中可靠披露
- Xiaotao Liang:机构信息未在 arXiv HTML 中可靠披露
- Jifa Cai:机构信息未在 arXiv HTML 中可靠披露
- Zeyu Zhao:机构信息未在 arXiv HTML 中可靠披露
- Jingjing Wang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
生成式语音增强输入为含噪声与混响的受损波形,输出为干净波形,严重退化下语义约束不可靠易产生流利但内容错误的幻觉,离散码元路径还受编解码器量化误差限制。LIFT-SE第一阶段用条件自回归模型(autoregressive model,指按顺序依赖历史预测下一个符号)预测干净编解码码元,其条件来自经蒸馏适配的自监督前端与编解码器编码器特征,预测码元经查表得到量化隐变量。第二个阶段用条件流匹配(conditional flow matching,指学习从噪声到目标分布的速度场)以预测码元为条件,把高斯噪声推向补足量化残差的连续隐变量,再经冻结解码器重建波形,因而第一阶段定语言内容与自然度,第二阶段恢复声学细节。与已有离散或连续单路径方法不同,两阶段共享QRes-Codec的同一表示空间,无需跨表示映射。在DNS1含混响子集上,LIFT-SE的差分词错率(differential word error rate,指增强语音转写相对干净参考转写的词错率差异,越低越好)为8.85%,低于StuPASE的8.88%与UniSE的35.56%,同时UTMOS为4.15。该结论适用于16 kHz合成噪声加混响与URGENT 2025多失真评测,消融显示去掉任一阶段均使语言一致性与说话人保持下降。逐帧自回归带来延迟代价,推理默认用4步欧拉积分平衡质量与开销,原文未披露训练时长、批量大小与部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/facebook/hubert-large-ls960-ft — 暂时无法访问
第三方资源:https://github.com/microsoft/UniSpeech/tree/main/downstreams/speaker_verification — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
91. 化身访谈里的说话与行为如何对齐:InterView-C 语料库解读
英文题目:InterView-C: A Synchronized Multimodal Corpus of VR Avatar-Mediated Survey Interviews
标签:#数据集 | #基准测试 | #语音识别 | #数据集构建 | #数据标注
评分:6.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Patrick Schrottenbacher:机构信息未在 arXiv HTML 中可靠披露
- Leon Hammerla:机构信息未在 arXiv HTML 中可靠披露
- Lydia Kleine:机构信息未在 arXiv HTML 中可靠披露
- Doris Stingl:机构信息未在 arXiv HTML 中可靠披露
- Alexander Mehler:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
这篇论文解决的是问卷访谈中口语交互与非言语行为难以同步分析的问题。输入是虚拟现实中访谈员与受访者以化身见面的德语结构化访谈,输出是带统一时钟的多模态语料与可供文本模型使用的语言标注。难点在于对话语音短促且不流畅,而现有转写与文本模型都主要面向朗读或书面语。语料建设先用两台 Meta Quest Pro 记录双人追踪与音频并映射到同一会话时钟,再用 CrisperWhisper 生成逐词自动转写并人工校对为参考转写,最后从中抽样标注否定提示语(cue)与其语义范围(scope)。与已有面对面语料的区别在于访谈全程在共享虚拟房间完成,问卷题窗、问卷答案与追踪帧直接对齐,且包含敏感题与社会性量表。同一句中可核对的关键定量结果是,在全部 54 个按说话人分离的录音混合评测下 WhisperX 的词错误率(Word Error Rate, WER)为 8.0%,在否定测试集上域内训练的 D-Neg 模型的提示语 F1 为 0.88,范围 F1 为 0.66,均优于论文比较的跨语料迁移模型。结论适用于德语、高学历小样本的结构化访谈场景,短答案、数字词与否定提示语仍易错,原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/TheBv/faces-dataset-pre-study — 链接可访问(HTTP 200)
第三方资源:https://hf.co/datasets/AnonymousKiwi/InterView-C → https://huggingface.co/datasets/AnonymousKiwi/InterView-C — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
92. 为人工耳蜗语音挑选合适的情感模板:SEER 怎么做检索增强

英文题目:SEER: Source-Conditioned Emotion Enhancement via Retrieval for Cochlear-Implant Speech
标签:#语音转换 | #检索增强 | #语音 | #助听器 | #主观评测
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hsing-Hang Chou:机构信息未在 arXiv HTML 中可靠披露
- Yun-Shao Lin:机构信息未在 arXiv HTML 中可靠披露
- Ching-Chin Sung:机构信息未在 arXiv HTML 中可靠披露
- Chi-Chun Lee:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
人工耳蜗恢复了言语可听度,但会削弱基频等与情感感知相关的线索,输入为普通情感语句、输出为经过模拟耳蜗处理后仍可被识别的增强语音是本文任务难点。已有增强方法需要同一说话人和同一句子的普通与夸张并行录音,难以推广到普通分类情感语料。SEER先用情感识别模型检验候选参考在洁净与耳蜗模拟下是否均被正确识别,通过者构成同情感参考库,为后续选择提供可识别的表达模板。价值评估模型消费来源时序编码与参考描述符构成的联合表征,预测每对来源-参考的转换效用并选定效用为正的最高分参考,预测为负时保留原音。为学习该效用,采样得到的参考条件情感语音转换输出与原音一起接受洁净与耳蜗模拟下的情感识别对比,形成耳蜗感知的引导奖励来监督价值评估模型,不确定性引导的采集规则平衡利用与探索以避免穷举全部配对。最终转换模块消费选定参考与来源语句,用参考条件情感语音转换将参考表达迁移到来源上并保留内容与说话人特征,输出增强语音。相对来源,该方法在ESD数据集N8通道条件下将宏平均F1提高11.66个百分点,在RAVDESS提高7.30个百分点,同时把词错误率控制在低于固定参考的水平。结论适用于所测的模拟器通道数和生气、高兴、悲伤三类情感,RAVDESS N4稀疏条件下客观未改善,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/HenryChou36/SEER — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
93. 让语音桥接落到大模型的词表邻域里:局部原型重建预训练

英文题目:Local Prototype Reconstruction for Text-Compatible Speech-to-LLM Bridge Pretraining
标签:#语音识别 | #语音翻译 | #对比学习 | #正则化 | #多语言
评分:6.8/10 | 创新 1.3/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xinnian Zhao:机构信息未在 arXiv HTML 中可靠披露
- Chia-Hua Wu:机构信息未在 arXiv HTML 中可靠披露
- Pu Wang:机构信息未在 arXiv HTML 中可靠披露
- Hugo Van Hamme:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音到大语言模型系统以连续语音为输入,以转写或英语译文为输出,难点在于语音编码器与大语言模型均冻结时,轻量桥接层仍须输出大语言模型可直接消费的词向量序列。论文先用句子级对比学习把整句语音表示和整句文本表示拉近,实现全局语义对齐,再引入局部原型重建要求每个经软对齐的桥接向量能被冻结输入嵌入表中小邻域重建。具体而言,桥接输出先经转写文本软对齐得到与词位对应的语音向量,再从冻结嵌入库检索金标准词元及其最近邻共16个原型并加权合成重建向量,最后以余弦距离同时施加朝向金标准嵌入的锚定约束与朝向重建向量的重建约束。训练时只更新桥接层和对齐投影,推理时丢弃转写文本、原型检索和重建计算分支,保持连续表示不做离散化。相对下一词预测和纯句子级对比方法,该方法保留对比学习作为全局骨干,同时增加方向一致的词元级流形兼容约束,而固定无头无时间戳探针显示对比方法句级检索已近满分但词元级余弦仍低。在CoVoST2五个源语言到英语的语音翻译中,满资源下LPR完整版相对无预训练基线平均BLEU从39.09提高到41.11。结论适用于同架构、同冻结模型的复用初始化,在低资源微调和翻译任务上差异更大;原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
94. 无关音频为何改变文字推理:配对漂移定位与按需门控

英文题目:Selective Listening: Mechanism-Guided Control of Audio Influence in Large Audio-Language Models
标签:#音频理解 | #测试时自适应 | #音频大模型 | #环境声 | #语音
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yulin Sun:College of Computer Science and Technology, National University of Defense Technology;State Key Laboratory of Complex & Critical Software Environment
- Kele Xu:College of Computer Science and Technology, National University of Defense Technology;State Key Laboratory of Complex & Critical Software Environment
- Yong Dou:College of Computer Science and Technology, National University of Defense Technology;State Key Laboratory of Complex & Critical Software Environment
📌 核心摘要
大型音频语言模型在只需文本即可作答的选择题推理中,会因无关环境声或自然语音改变答案,总体正确率可能因修好与修坏相抵而看不出变化。论文先对同一题目比对干净文本与加入干扰音频的作答,用配对的影响率和答案翻转率刻画漂移,再对音频通路做缩放干预,把引发下游决策变化的晚期位置及其衰减系数离线确定为各模型的可控点。提出的指令条件音频通路门控在线先按任务指令做路由判断,显式要求听音频时输出保持通路不变,否则输出模型专属衰减,该系数随即作为临时通路调制的输入,全程只需一次生成。在4个模型、2个推理基准、2类干扰共16组全量评测中,门控方法的IR与Flip点估计均低于无门控推理,例如Qwen2.5-Omni-7B在MMLU-FSD上正确率几乎不变而IR从11.80%降至9.16%。固定压制会抬高400条LibriSpeech dev-clean语音识别的词错误率,而门控方法与无门控WER持平。推理成本在1张NVIDIA A800 80GB GPU上以bfloat16测得,门控方法单次生成耗时约为无门控的0.894倍至1.057倍,8次采样的自洽解码耗时为无门控的7.031倍至9.215倍。结论限于ARC与MMLU选择题、FSD环境声与随机5秒单人语音干扰,以及已评测的语音识别任务,隐含音频需求与对抗语音尚未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
95. 在线说话人日志如何数准人数:候选池与确认后输出

英文题目:Toward accurate speaker inventories for online speaker diarization
标签:#说话人分离标注 | #说话人计数 | #流式处理 | #信号处理
评分:6.8/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Youngki Kwon:机构信息未在 arXiv HTML 中可靠披露
- Hee-Soo Heo:机构信息未在 arXiv HTML 中可靠披露
- Minjae Lee:机构信息未在 arXiv HTML 中可靠披露
- Bong-Jin Lee:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
在线说话人日志要求音频到达后按0.5 s嵌入步进顺序输出说话人标签,系统内部维护的说话人清单会被实时字幕直接读取,固定容量超过上限即合并,未见说话人混在单个缓存中也会混为一人,而无界距离注册又会把噪声和轮换边界拆成多余说话人。基线DC-OST按最近质心余弦距离路由嵌入,距离不大于自适应阈值则归入已注册说话人并立即输出其标签,否则放入单个缓存并先输出下一个未用编号,注册则要等缓存大小达到预设K才以中值向量为质心建立新说话人。改进保留该路由规则,把单个缓存换成相互隔离的候选说话人池,每步嵌入仍立即放入一个候选,但候选只有累积到足够多个相互兼容嵌入后才注册为正式说话人。注册条件满足前,其对应输出被暂存在有序队列中等待确认或否定,只有候选确认后标签才放行,超时则以后备标签离开,队首已决输出也需按步进顺序等待,从而把延迟只花在未定输出上。与已有方法的关键差异在于注册不再由单次远距离观测触发,未确认身份不提前进入输出,候选池解决交替出现的新说话人混叠,延迟队列解决首个片段误标。九个数据集宏观平均下说话人计数误差从225.0%降到20.7%,宏观错误率从17.59%降到15.95%,VoxSRC-23上同时为参比系统最低。跟踪器额外等待的算法延迟只度量队列滞留,全部输出平均增加0.109 s,其中被暂存的8.6%平均等待1.27 s、观测最大4.16 s,前端0.5 s基础延迟各变体共有。该结论不适用于重叠段,单标签输出在会议数据上仍有较高漏检下限。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
96. HRIL:用高阶张量为多模态协同信息保留表示容量

英文题目:HRIL: Learning Multimodal Synergy via Higher-Order Tensor Modeling
标签:#音视频理解 | #多模态学习 | #对比学习 | #音视频
评分:6.8/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.3/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Qun Dai:School of Computing and Artificial Intelligence, Southwestern University of Finance and Economics
- Liangjian Wen:School of Computing and Artificial Intelligence, Southwestern University of Finance and Economics
- Jiang Duan:School of Computing and Artificial Intelligence, Southwestern University of Finance and Economics;Chengdu Everimaging Science and Technology Co., Ltd
- Yong Dai:X-Humanoid
- Dongkai Wang:School of Computing and Artificial Intelligence, Southwestern University of Finance and Economics
- Maolin Wang:Hong Kong Institute of AI for Science, City University of Hong Kong
- Mingjie Wang:Zhejiang Sci-Tech University
- Jianzhuang Liu:Shenzhen Institutes of Advanced Technology, Chinese Academy of Sciences
- He Yan:Chengdu Everimaging Science and Technology Co., Ltd
- Zhao Kang:University of Electronic Science and Technology of China
📌 核心摘要
多模态自监督表示学习要从异构输入中得到对下游任务有用的联合表示,难点在于协同信息只出现在多个模态的联合配置中,无法从任一模态或任一真子集恢复。两两对比学习在最小充分表示下只保留共享因子,因而会丢掉纯协同因子携带的任务信息。Higher-order Representation and Information Learning(高阶表示与信息学习,HRIL)先对每个增强视图编码单模态表示与融合表示,再构造投影后嵌入的经验交叉矩张量并做 Tucker 分解得到核张量。协同感知正则惩罚核能量集中在单个坐标的现象以保留多路耦合容量,模态融合对比目标把每个单模态表示与另一视图的融合表示对齐以抽取任务相关信号,辅助跨视图对齐目标维持共享一致性并防止维度坍缩。与 CoMM 等融合对比方法相比,差异在于显式建模高阶统计依赖并用核能量分散约束其退化。在 Trifeature 受控协同二分类任务上,HRIL 相对最强基线 CoMM 的协同准确率从 71.4% 提高到 82.3%。结论适用于模态数大于 2 的纯协同假设 regime,向近似协同与混合交互的推广仍待验证。原文报告三模态训练每步耗时从约 90 ms 增至约 156 ms 至 159 ms,推理时不使用该正则项。
🔗 开源资源
- 代码相关资源:https://github.com/brightest66/HRIL — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
97. 提示一致推理如何修正零样本流匹配语音合成的采样输入

英文题目:Prompt-Consistency Inference for Zero-Shot Flow-Matching Text-to-Speech Models
标签:#文本到语音 | #流匹配 | #0 样本 | #语音
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Vasily Zadorozhnyy:机构信息未在 arXiv HTML 中可靠披露
- Can Goksen:机构信息未在 arXiv HTML 中可靠披露
- Kazuhito Koishida:机构信息未在 arXiv HTML 中可靠披露
- Dung Tran:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
零样本文本到语音(Text-to-Speech,TTS)的输入是目标文本与一段短参考音频,输出是保持参考音色朗读目标文本的语音,难点是在无说话人微调条件下让生成语音同时贴近音色并读准内容。该工作研究的流匹配(Flow Matching)音频补全模型把提示帧与待生成帧拼成同一状态,用一个速度场网络联合演化,最终只保留生成帧。方法在每次调用速度场前把提示块重写为参考特征与初始噪声的线性插值,生成块保持上一步结果不变,再执行欧拉步进并在下一步前再次校正,从而阻止提示漂移进入后续更新。与保持干净参考作为条件不变的做法不同,该约束直接修正送入网络的演化状态,不增加网络前向次数,不改参数。在 Seed-TTS test-en 上 F5-TTS 的说话人相似度 SIM-o 从 0.664 升至 0.685;在 LibriSpeech-PC test-clean 上 16 步 ZipVoice 的词错误率 WER 从 1.77% 降至 1.47%。结论适用于具有可解析提示路径的联合状态采样器,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
98. BanglaBox:面向孟加拉语的语音均衡语料与基础模型适配
标签:#文本到语音 | #SFT | #数据集 | #语音克隆 | #0 样本
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Emtiaz Uddin Ahmed:机构信息未在 arXiv HTML 中可靠披露
- Araf Mahmud:机构信息未在 arXiv HTML 中可靠披露
- Sajib Hossain:机构信息未在 arXiv HTML 中可靠披露
- Tarikul Islam Tamiti:机构信息未在 arXiv HTML 中可靠披露
- Sajid Fardin Dipto:机构信息未在 arXiv HTML 中可靠披露
- Anomadarshi Barua:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
孟加拉语语音合成长期受限于小规模单说话人系统,最大先前平衡资源SUST仍为单说话人且只做音素/双音素覆盖,近期最优BnTTS在3.85k小时上微调XTTS但权重未公开,而已有开源零样本系统IndicF5克隆相似度仅0.37、微调YourTTS仅0.44,远低于人类水平。论文以连字簇为核心的分层Jensen-Shannon散度目标在音素、双音素、三音素和连字四层筛选脚本,筛选产出的脚本经质检与人工审核后进入录音室录制的Tier A与经信噪比和消融筛选的Tier B,合并为520.3小时、36说话人、7域的BanglaBox-520。合并一致性词表扩展保留704个预训练嵌入并过滤非法合并,将词表扩至4240,再经6步文本规范化处理连字簇、变音符号与数字缩写,产出可编码词元。词元与提示语音共同进入只训练变换器主体的提示掩码双损失微调,冻结说话人编码器并沿用预训练嵌入均值初始化以保留跨语言克隆能力,长文本按句切分后拼接合成。在5个留出说话人、76句、24名母语者ITU-T P.808评测下,BanglaBox自然度为4.56,以Wilcoxon符号秩检验显著高于Google的4.27和IndicF5的3.89。在436句测试集上以ECAPA-TDNN测得说话人编码器余弦相似度为0.627,近2倍于同设置下IndicF5的0.37,字错率为2.9%。结论适用于孟加拉国达卡标准语朗读文本,罕见三辅音连字、语码混合边界和拟声词仍不可靠,Chatterbox相关训练约100 H100小时、headline运行约28小时,含XTTS微调与推理总量约180 H100小时。
🔗 开源资源
- 第三方资源:https://huggingface.co/Banglabox — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
99. 掩码与替换扩散做零样本语音合成:增益是否必须改写已生成的词元

英文题目:Beyond Token Revision: Investigating Mask-and-Replace Diffusion for Zero-Shot Text-to-Speech
标签:#文本到语音 | #扩散模型 | #数据增强 | #语音 | #0 样本
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hounsu Kim:机构信息未在 arXiv HTML 中可靠披露
- Joonyong Park:机构信息未在 arXiv HTML 中可靠披露
- Yuki Saito:机构信息未在 arXiv HTML 中可靠披露
- Satoru Fukayama:机构信息未在 arXiv HTML 中可靠披露
- Juhan Nam:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
零样本文本到语音合成(Zero-shot text-to-speech)根据输入文本和一段参考语音生成目标语音,输出是离散语音 token 序列再经波形解码器转成波形,难点是并行生成时错误会在上下文中传播。掩码加替换扩散(Mask-and-replace diffusion)训练时既遮蔽部分目标 token,也把另一部分替换成词表内随机 token,模型要从被破坏序列重建原始序列,常见解释是它学会了推理期自我修正。论文提出的解耦掩码加替换(Decoupled mask-and-replace,DeMaR)保留这种训练破坏,但在采样时把掩码概率与替换概率合并后只用掩码,并引入只提交(Commit-only)采样,即 token 一旦从掩码中解出就不再改动,以检验增益是否必须依赖推理期修正。与只用掩码训练的掩码扩散语言模型(Mask-only diffusion language model,Mo-DLM)相比,DeMaR 在 CosyVoice3 分词器上把词错误率(Word error rate,WER)从 6.05% 降到 4.95%,在 FlexiCodec 上从 5.39% 降到 4.89%。匹配训练条件的对照显示,随机替换提供的含噪上下文和替换位置重建监督分别带来增益,且在禁止修正时依然存在,说明训练侧作用独立于推理期修正。结论适用于 LibriTTS 训练、两种给定分词器和 32 次去噪器调用的解码设置,替换监督在个别种子上增益较小。训练步数、批量大小和训练时长未说明,每次运行使用两块 NVIDIA RTX 4090 GPU,解码均为 32 次调用。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
100. 边准确也不够:前向动力学学到的结构为何难以迁移到逆问题
英文题目:Edge Accuracy Is Not Enough: Why Dynamics-Learned Structure Fails to Transfer to Inverse Problems
标签:#声源定位 | #迁移学习 | #注意力机制 | #理论分析
评分:6.7/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.3/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:理论研究 | arXiv 原文
👥 作者与机构
- Nicholas Tan Jerome:Institute for Data Processing and Electronics (IPE);Karlsruhe Institute of Technology (KIT);Karlsruhe, Germany
- Fangnian Wang:Institute for Thermal Energy Technology;and Safety (ITES);Karlsruhe Institute of Technology (KIT);Karlsruhe, Germany
📌 核心摘要
源定位任务输入是多个传感器的读数与位置,输出是泄漏源或声源的三维坐标,难点在于逆任务标注稀少而正向仿真数据相对易得。论文先用已知稀疏图约束注意力权重,把有效自由度从传感器数量平方量级降到稀疏度与传感器数量乘积量级,再证明有边误差的近似图仍能保留样本量优势,随后用正向动力学学图并固定该图做逆定位。计算流体力学氢气扩散域上,在均方根误差指标下,任务优化的注意力基线为5.21米,满足边误差容忍条件的神经关系推理(Neural Relational Inference,NRI)图约束模型为11.26米,后者高于前者、方向为变差。论文用数据增量无改善、阈值不敏感、与任务最优图重叠低以及相关与互信息图同样无效四条证据,把失败归因于近似误差而非估计误差,并给出基于少量目标数据的重叠度检查作为迁移前筛选。结论限于仿真停车场与二维声学房间、注意力定位器与三类动力学结构,真实部署与非注意力架构尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/nicolaisi/edge-accuracy-is-not-enough — 链接可访问(HTTP 200)
复现相关资源:https://github.com/nicolaisi/edge-accuracy-is-not-enough — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
101. 全双工语音模型如何在说话的同时接受指挥

标签:#全双工语音交互 | #强化学习 | #基准测试 | #轮次切换
评分:6.7/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Haolong Zheng:机构信息未在 arXiv HTML 中可靠披露
- Maike Züfle:机构信息未在 arXiv HTML 中可靠披露
- Dominik Macháček:机构信息未在 arXiv HTML 中可靠披露
- Peter Polák:机构信息未在 arXiv HTML 中可靠披露
- Xulin Fan:机构信息未在 arXiv HTML 中可靠披露
- Xavier Sumba:机构信息未在 arXiv HTML 中可靠披露
- Siyin Wang:机构信息未在 arXiv HTML 中可靠披露
- Ondřej Klejch:机构信息未在 arXiv HTML 中可靠披露
- Mark Hasegawa-Johnson:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
全双工语音模型需要边听边说,输入是对方连续音频与不断增长的对话历史,输出是本方语音或静默及说话时机,难点是系统提示词的约束会随历史变长而漂移,且实时延迟限制了大模型做长程规划。作为用户模拟器使用时,偏离预设人设和阶段顺序会改变被测对象的测试条件。方法上,论文先构建模拟器指令跟随基准SimIF-Bench,复用200个分阶段场景并固定PersonaPlex为考生,用大语言模型裁判转录文本的主题adherence、自然度和阶段顺序。再训练可操控前端SteerablePlex,把导演指令以特殊起止符号拼接到模型文本流中,插入期间音频流填静默且对话时间不推进。最后用组奖励解耦归一化策略优化Group Reward-Decoupled Normalization Policy Optimization,GDPO联合优化目标完成、自然度和轮次切换,并由异步文本大语言模型导演每2 s更新目标状态并决定发送、等待或不发送指令。与已有系统提示词控制和KAME持续改写式操控不同,该设计只在需要时注入短祈使指令,并保留前端原生抢话与退让能力。原文未提供可核对的关键定量结果。该结论仅在上述200个分阶段模拟器场景、通话限时120 s且以PersonaPlex为固定考生的条件下得出,单指令训练的任务无关版本多指令协调不足,在更长对话、其他考生或真实用户条件下尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
102. 跨模型任务向量:把微调改变量搬到另一个模型上

标签:#音频分类 | #迁移学习 | #LoRA | #多模态学习
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Junghwan Park:TelePIX
- Woojin Cho:TelePIX
📌 核心摘要
不同视觉语言模型在同一任务上微调后权重坐标无法直接相加,论文要解决的是把一个模型学到的任务变化搬到架构、维度和语料都不同的另一个模型。输入是源模型的通用任务描述符(Universal Task Descriptor,UTD,一种记录微调前后图像与文本提示间余弦相似度变化的矩阵)、任务的无标注探测图像与类名,输出是目标模型上能复现该变化的编辑。通用任务描述符形状只与探测数和提示数有关,与嵌入维度无关,因此可直接相加与取负。闭式路线把嵌入映射建模为线性算子并用岭回归求解,再折入目标最后一层,多个任务的合成变为算子相加。低秩适配路线在同一目标上直接优化描述符匹配误差,所用适配器为挂在视觉编码器查询与值投影上的低秩增量。跨任意模型族的3360个双任务合成中,闭式解的两个任务准确率相对零样本分别提升18.11和11.63个百分点。在同一3360个合成评测中,闭式跨模型迁移的准确率增益达到目标自身描述符增益的80%和74%,低于自身迁移但保留大部分提升。结论适用于有跨模态亲和度与仿射末层的双编码器,在类别多、自身准确率增益仅约2个百分点的Cars与SUN397上相对零样本的准确率提升失效。原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/jhpark-ai/Platonic-Task-Arithmetic — 暂时无法访问
第三方资源:https://neurips.cc/public/guides/CodeSubmissionPolicy — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
103. 用函数空间进度衡量并平衡多模态学习

标签:#音视频理解 | #多模态学习 | #形式化分析 | #正则化
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zhongjing Gu:机构信息未在 arXiv HTML 中可靠披露
- Fengqiang Wan:机构信息未在 arXiv HTML 中可靠披露
- Yiming Cui:机构信息未在 arXiv HTML 中可靠披露
- Yufa Feng:机构信息未在 arXiv HTML 中可靠披露
- Yang Yang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
多模态联合训练常被易学模态主导,弱模态更新不足,输入是各模态样本与对应标签,输出是融合预测与各模态分支预测。难点在于不同模态的参数规模、预测不确定性和收敛速度不同,直接比较置信度或梯度幅值会把固有差异误判为进度差距。为此,函数空间引导的多模态优化(Function-Space Guided Multimodal Optimization,FGMO)先恢复单位学习率更新并估计其引起的一阶模型输出变化,再按损失对齐的单模态参考做比值得到相对函数进展(Relative Functional Progress,RFP),完成可比的进度估计。得到该信号后,控制部分按RFP在KL约束下重分配模态响应份额,并换算为张量级学习率去缩放优化器更新,形成估计与控制的反馈环。与直接比较绝对分数的方法不同,该方法只比较每个模态相对自身参考的进展,从而避免把模态固有差异当作落后而误导再平衡。在CREMA-D上,相同主干与初始化下FGMO的准确率为0.8589,平均精度为0.9126,超过已列出的全部基线;该结论限于论文的六个音频视频、图文和三模态分类基准,未验证检测或生成等任务。原文报告了参考构建与周期性探测带来的额外耗时,固定参考可在同设置多种子间复用以分摊成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
104. InstMoE:按输入特点选择证据通路的多模态情感分析

英文题目:InstMoE: Adaptive Multimodal Routing with Specialized Experts
标签:#语音情感识别 | #混合专家模型 | #多模态学习 | #对比学习
评分:6.6/10 | 创新 1.4/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Guimin Hu:Guangdong University of Technology
- Xiang He:University of Copenhagen
- Yingjian Li:Pengcheng Laboratory
- Zheng Lian:Tongji University
- Boyan Xu:Guangdong University of Technology
- Ruichu Cai:Guangdong University of Technology
📌 核心摘要
多模态情感分析的输入包含文本、音频和视频序列,输出是情感强度回归值与正负二分类标签,难点在于不同输入依赖的可靠模态不同,固定融合会让强势或含噪模态压制互补证据。InstMoE先用各模态轻量Transformer编码器与注意力池化得到定长表示,再用模态投影头与对称InfoNCE目标把语义相近的跨模态表示拉近,把同一批内不同样本的表示推远。随后文本表示作为查询去注意音频与视频序列,得到文本-音频与文本-视频两路关系证据,与三路单模态表示共同构成五条候选通道。路由器把五路证据拼接后输出五维权重,对五个专用专家输出加权求和得到融合表示,再送入回归与分类头,从而每个输入走不同的证据组合而非共享融合。在中文CH-SIMS v2评测设置下,InstMoE的F1-Score(非零,越高越好)为84.87,超过前最佳CaReFlow的82.90。结论适用于已抽取BERT、COVAREP、Facet、openSMILE和OpenFace特征的短视频情感数据,对未对齐变长原始数据的效果尚未验证。原文披露在CH-SIMS v2测量条件下参数量为3.49M,在单块NVIDIA 4060Ti GPU上训练约65s/轮,推理约1.5ms/样本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
105. 面向端侧部署的音频伪造检测压缩:跨域蒸馏与移动引导剪枝如何分工

英文题目:Task-Aware Joint Pruning and Distillation for Efficient Audio Deepfake Detection
标签:#音频深度伪造检测 | #模型剪枝 | #知识蒸馏 | #高效推理
评分:6.6/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Miao He:机构信息未在 arXiv HTML 中可靠披露
- Peng Cheng:机构信息未在 arXiv HTML 中可靠披露
- Zhongjie Ba:机构信息未在 arXiv HTML 中可靠披露
- Qing Wen:机构信息未在 arXiv HTML 中可靠披露
- Li Lu:机构信息未在 arXiv HTML 中可靠披露
- Xin Yang:机构信息未在 arXiv HTML 中可靠披露
- Kui Ren:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音频深度伪造检测需要判断输入语音是真实录音还是合成或转换语音,输入为原始波形,输出为真伪二分类分数,难点在于自监督学习(self-supervised learning,SSL)前端参数量大、难以部署到端侧,而直接压缩又容易丢失伪造判别线索并在域外退化。该框架包含三个阶段:任务准备阶段微调 XLS-R 并计算每个结构单元的移动分数;联合剪枝与蒸馏阶段用移动分数引导保留重要结构,同时让剪枝中的学生模型模仿教师在多个代表层的表示;后端优化阶段将剪枝后的前端与 AASIST 分类后端联合微调以恢复判决精度。与只用域内损失或域内蒸馏的内容型压缩方法不同,该工作引入无标注域外数据的跨域蒸馏,并用微调变化量作为结构重要性先验。在 90% 稀疏度下,压缩模型在多个数据集上的平均等错误率(equal error rate,EER)仅比 317M 参数的未压缩基线上升 1.30%,参数量降至 31.9M,计算量下降 6.3 倍。结论适用于论文评测的 ASVspoof 系列、In-the-Wild 和 FoR 等伪造检测场景,对更大规模 SSL 模型的扩展性尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
106. 只看文字能猜出说话方式吗:用无监督声音聚类做的可证伪检验

英文题目:Can Prosodic Style Be Inferred from Text Alone? Evidence from Unsupervised Acoustic Clusters
标签:#语音属性识别 | #无监督学习 | #韵律 | #语音
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Abdul Rehman:机构信息未在 arXiv HTML 中可靠披露
- Jian-Jun Zhang:机构信息未在 arXiv HTML 中可靠披露
- Xiaosong Yang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
这篇论文检验的输入是同一句话的文字转写,输出是说话人实际采用的utterance级别传递方式类别,难点在于同一文本允许多种合理读法,文本与韵律的关联容易被时长、类别不平衡和词汇内容伪造。方法先对每位说话人的语音嵌入做长度擦除后聚成三十类,作为只来自声学的风格标签。再用多种文本嵌入加多类分类器在按视频划分的留出话语上预测该标签,并与长度基线和词袋基线比较,最后在文本空间直接测量声学类的几何紧凑性。与已有由合成模型联合训练隐变量并以听感偏好为指标的做法不同,该设计把标签、预测器和评价分离,并引入无词汇通道的韵律对照表示。在按视频划分的留出话语上以top-3准确率衡量,文本嵌入平均为0.366,高于多数类基线的0.255,增量为+0.111。在同一留出评测中以同一指标衡量,文本嵌入平均0.366高于词袋基线的0.340,增量为+0.026,且声学类在文本空间的余弦轮廓系数全部为负。结论适用范围限于英语自发YouTube对话、均值池化后的utterance级别划分,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://anonymous.4open.science/r/Timbrespace/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
107. 口音差距如何从语音识别传到金融工具调用

英文题目:Mind the Accent Gap: British Accent Robustness in Speech-Driven Financial Voice Assistants
标签:#语音识别 | #语音代理规划与工具使用 | #基准设计 | #基准测试 | #口音与方言
评分:6.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.4/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Aadam Haq:机构信息未在 arXiv HTML 中可靠披露
- Oggi Rudovic:机构信息未在 arXiv HTML 中可靠披露
- Malcolm Chadwick:机构信息未在 arXiv HTML 中可靠披露
- Jay Rainey:机构信息未在 arXiv HTML 中可靠披露
- Shucong Zhang:机构信息未在 arXiv HTML 中可靠披露
- Ricardo Guerrero:机构信息未在 arXiv HTML 中可靠披露
- Sourav Bhattacharya:机构信息未在 arXiv HTML 中可靠披露
- Maja Pantic:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
本文处理金融语音助手输入16kHz口语音频、输出结构化工具调用参数的任务,难点是英式区域口音导致自动语音识别出错并污染下游大语言模型推理,金额、商户名、日期等关键标记错一个即可能改变调用结果。作者采集CavaBench基准并搭建级联链路:语音活动检测与轮次检测切分语音后由流式或离线自动语音识别输出文本,再由Gemma-4-26B-A4B-it按统一工具schema生成包含metric、time_period等五个字段的调用。相对已有VCTK、EdAcc、Common Voice等通用口音评测,该工作把金融查询、英式口音分组与端到端工具调用正确率放在同一协议中检验,录音来自90名受试者在干净环境下的3079条话语并另行仿真6组声学条件。在全部6种声学条件平均下Qwen3-ASR-1.7B Offline以11.1%词错率和73.7%完全匹配率领先,而微调后Nemotron Streaming LA13为16.1%与67.9%。跨模型词错率与完全匹配率呈强负相关但苏格兰组例外,关键merchant名与时间表达的保留情况比总词错率更能决定任务成败。上述结论仅在内部金融查询、四个自报口音分组、同一大语言模型与工具schema及仿真声学条件下验证,在联合退化的Environment条件、说话人重叠与真实电话信道下词错率与失配明显上升,Other British类因捆绑多种区域口音而持续最难。尚未验证真实部署噪声、未见口音、其他大语言模型与更长轮次对话下的表现,60天误作6或16天等自信错答仍可绕过拒答直接造成损失。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
108. 神经编解码压缩下音频伪造检测为何失效与如何缓解

英文题目:Exposing and Mitigating Neural Codec Vulnerabilities in Audio Deepfake Detection
标签:#音频深度伪造检测 | #正则化 | #鲁棒性 | #数据集
评分:6.6/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Abdullah:机构信息未在 arXiv HTML 中可靠披露
- Awais Khan:机构信息未在 arXiv HTML 中可靠披露
- Khalid Mahmood Malik:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音频深度伪造检测要判断输入波形是真实录音还是合成或转换语音,难点是现代音频语言模型把神经音频编解码器解码器作为生成链路的一部分,其失真与MP3/AAC等事后压缩不同。论文把同一编解码器的编码加解码同时施加到真实语音和假语音上并保持标签不变,构造出配对的原始版本与压缩版本作为输入。配对语音一同送入共享的XLS-R(300M)编码器,编码器输出各变换层隐状态,再经时间池化与层加权融合得到每条语音的表征。融合表征随后进入两路目标,一路用分类损失学习真假边界,另一路用一致性损失拉近同一条语音两种版本的表征距离,使编解码器痕迹不进入判决依据。与把编解码器重合成语音直接当作假样本训练的做法不同,该方法把压缩视为标签不变的增强,避免把编解码器痕迹当作造假证据。在神经编解码器压缩下,相比7个已有系统的平均水平,PCL-NET把平均等错误率(Equal Error Rate,EER)从28.67%降至12.77%。All变体在ASVspoof 2019 LA评测集上原始语音EER为1.13%,神经压缩平均EER为5.15%,压缩条件下高于原始但仍保持可用。适用范围限于论文自建的音频神经编解码器伪造重合成压缩评估,尚未在原生ALM生成的大规模CoSG上验证;原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
109. 听不见的超声为什么能帮助识别乐器

英文题目:Unheard but Recognizable: Ultrasonic Signatures for Musical Instrument Recognition
标签:#音频分类 | #数据集构建 | #数据集 | #音乐 | #音乐信息检索
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Izhak Kapash:机构信息未在 arXiv HTML 中可靠披露
- Uri Rom:机构信息未在 arXiv HTML 中可靠披露
- Ram Zamir:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
输入是单乐器独奏片段或多乐器混合片段,输出是15类乐器与人声的独奏类别标签或混合中每类的开与关多标签判断,难点是音色相近声源在可听频带频谱重叠且混合时相互掩蔽。作者先用标称3 Hz至50 kHz的QTC50等全指向话筒经调音台与模数接口在Cubase 10中以96 kSPS原生采集6首完整多轨乐曲,得到1小时以上混合与近15小时对齐独奏,链路未设20 kHz截止而保留至48 kHz奈奎斯特上限。然后将同一母带数字生成44.1 kSPS版本、96 kSPS在22.05 kHz处低通版本和保留20 kHz至48 kHz的超声-only版本,保持片段时长、录音级划分与分析窗一致,再送入CNN6卷积神经网络与基于手工特征的随机森林进行分类与多标签检测。对15类独奏分类在录音不相交划分三次运行均值下,CNN准确率从44.1 kSPS输入的87%升至96 kSPS全频带输入的约91%,高于低通回落至44.1 kSPS水平的对照,表明增益来自保留频带而非采样点数。对同一15类独奏分类相同划分下,随机森林宏平均F1从44.1 kSPS的81.11%升至96 kSPS全频带的88.38%,高于96 kSPS低通的82.26%,其中人声等增益最大。在多乐器混合多标签检测相同标注与规则下,96 kSPS全频带总体准确率比44.1 kSPS高约4个百分点,而匹配低通聚合性能与44.1 kSPS基本一致。在去除20 kHz及以下成分后12类平衡子集完整留出录音评估下,CNN在20–48 kHz超声-only输入的平均准确率约为82%,高于8.33%均匀随机基线,安静窗对照则接近随机水平。结论限于本次6首采集链路和类别范围,6首之外泛化与通用分离性能尚未验证;原文未披露训练、推理或部署成本,仅给出96 kSPS存储约为44.1 kSPS的2.18倍。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
110. 不训练模型也能校准指令语音的性别分布
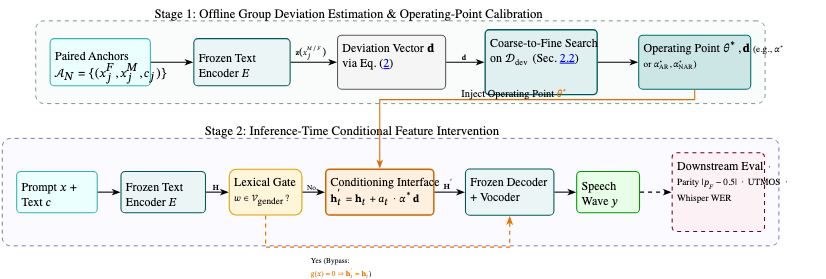
英文题目:Training-Free Instruction TTS Gender Bias Calibration Using Model-Adaptive Steering
标签:#文本到语音 | #测试时自适应 | #公平性 | #语音
评分:6.6/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kuan-Yu Chen:机构信息未在 arXiv HTML 中可靠披露
- Yi-Cheng Lin:机构信息未在 arXiv HTML 中可靠披露
- Jeng-Lin Li:机构信息未在 arXiv HTML 中可靠披露
- Jian-Jiun Ding:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
指令文本到语音接收自然语言风格指令和朗读文本,输出带有人口、职业或场景风格的语音,难点是当指令没有写明性别时,职业与身份描述仍会诱发偏向某一性别的声学输出。论文提出模型自适应转向,先用显式性别词改写的配对锚点估计群体偏移向量,再在开发集上用由粗到细的网格搜索确定作用强度,推理时只对不含性别词的提示词在编码器后条件表示上做加性偏移。词汇门负责显式性别提示词的旁路保留,联合目标同时约束总体与按描述词类型分层的偏离,并丢弃出现单性别饱和的候选。与直接追加中性说明和在池化特征上做线性擦除的对照相比,该方法直接校准输出分布而不更新生成器参数。在12,800条held-out提示词组成的保留测试集上,与未干预原始输出相比,四模型总体校准误差从11.5-28.1个百分点降至0.8-5.9个百分点。在同一保留测试的500条共享子集效用评测中,与原始输出相比,自然度指标UTMOS最多下降0.08。结论适用于英文指令、冻结模型和二值声学代理评估范围,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/DanielChen1128/ITTS-Debias — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
111. 全局平均精度:让跨查询相似度可比的表征学习损失

标签:#音频检索 | #对比学习 | #多模态学习 | #0 样本
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Bill Psomas:机构信息未在 arXiv HTML 中可靠披露
- Mohammad Mahdi:机构信息未在 arXiv HTML 中可靠披露
- Michalis Thomas:机构信息未在 arXiv HTML 中可靠披露
- Danda Pani Paudel:机构信息未在 arXiv HTML 中可靠披露
- Giorgos Tolias:机构信息未在 arXiv HTML 中可靠披露
- Giorgos Kordopatis-Zilos:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
检索系统常为每个查询独立排序,平均精度均值对每个查询分别计算后再平均,无法要求不同查询的相似度处于同一尺度,而需要单一阈值判定的场景会因此失效。全局平均精度把所有查询-候选对放入同一列表只计算一次平均精度,同时考核排序质量与跨查询一致性。论文提出其平滑代理gSAP,输入与已有损失相同,即相似度矩阵与标记正例对的二值矩阵,输出为平滑全局平均精度的互补损失。它先为批次内每个正例与全部候选相似度建立成对比较,再把这些比较经低温平滑计数汇成全局精度-召回估计,使低温下仍保留梯度,最后丢弃最小的负相似度以降低比较开销,所得损失回传更新编码器。在Stanford Online Products测试集上以召回率、平均精度均值和全局平均精度为评测指标且微调DINOv3不丢弃负例的度量学习对比中,gSAP的gAP为58.9%,高于同表逐查询排序代理mSAP的57.0%,两者mAP持平同为72.9%。结论适用于需要统一阈值的检索与存在干扰查询的任务,在细粒度迁移与直接使用相似度的最近邻评测中增益更大,极端丢弃会使性能下降。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/mlfoundations/open_clip — 链接可访问(HTTP 200)
第三方资源:https://github.com/LAION-AI/CLAP — 链接可访问(HTTP 200)
第三方资源:https://github.com/LAION-AI/CLIP_benchmark — 链接可访问(HTTP 200)
第三方资源:https://github.com/Spijkervet/CLMR — 链接可访问(HTTP 200)
第三方资源:https://github.com/yashvarpatel/RecallatK_surrogate — 链接可访问(HTTP 200)
第三方资源:https://github.com/facebookresearch/sscd-copy-detection — 链接可访问(HTTP 200)
第三方资源:https://github.com/nikosips/met — 链接可访问(HTTP 200)
第三方资源:https://github.com/ilias-vrg/ilias — 链接可访问(HTTP 200)
第三方资源:https://github.com/WildlifeDatasets/wildlife-tools — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
112. 提示词与规则:语音用户模拟器自然度行为的审计与控制
英文题目:Prompts versus Rules: Auditing and Controlling Speech Naturalness Behaviors in Voice User Simulators
标签:#轮次切换 | #评测协议 | #语音 | #大语言模型
评分:6.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Riqiang Wang:Dialpad Inc.
- Elena Khasanova:Dialpad Inc.
- Harsh Saini:Dialpad Inc.
- Lex Konnelly:Dialpad Inc.
- Parsa Kavehzadeh:Dialpad Inc.
- Matthias Lee:Dialpad Inc.
- Mohamed Attia:Dialpad Inc.
📌 核心摘要
语音智能体评测需要能打电话的模拟用户,输入是被测智能体的实时音频,输出是模拟用户的语音回应,难点是口语特有的不流利、打断和表示在听的短反馈是否按设定出现。论文先审计τ-Voice这类用提示词加语言模型分类器的做法,再提出无模型的规则控制:不流利在合成前按倾向参数改写文本,打断与反馈在200 ms的话中停顿处按等待时长和词数阈值触发。规则做法与提示做法的关键差异是位置与分布可控、可重复,且不增加模型调用。在针对已部署商用智能体的全双工实时通话评测中、每条件20个配对场景下,以每智能体轮次打断率为指标,规则方法将打断倾向从0.3调到1.0时该指标从0.235单调升到0.538,低于τ-Voice基准在20次通话、346个智能体轮次下同指标的0.633次。在同样针对已部署商用智能体的全双工实时通话评测中,以每智能体轮次反馈率为指标,规则方法将反馈倾向从0.3调到1.0时该指标从0.545升到0.844,高于τ-Voice基准同口径下同指标的0.038次。结论只适用于级联式模拟器对特定商用智能体的测试,复杂自我修复式不流利仍未解决。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
113. 多模态噪声标签下该信哪个表示空间:REFINE 的可信样本筛选

英文题目:Learning What to Trust in Multimodal Learning under Noisy Supervision
标签:#音频分类 | #多模态学习 | #弱监督学习 | #音视频
评分:6.6/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jiashuo Zou:机构信息未在 arXiv HTML 中可靠披露
- Xiaobo Xia:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
任务输入是由多个模态组成的样本,例如图像与文本、视频与音频,输出是类别预测,难点是观察标签可能被污染,而融合后损失或梯度会丢失单模态中判断标签是否可靠的线索。可靠样本过滤多模态学习(Reliable Sample Filtering in Multimodal Learning,REFINE)先在每个表示空间为每个类构造判别特征向量(discriminative eigenvector,DE),该向量让目标类对齐分数高而背景类对齐分数低。随后方法把同一实例在两个空间的投影拼成二维表示,再做一次判别分析,比较系数幅度以决定每个类信任哪些空间。最后在每个可信空间内比较实例相对观察类与其他类的对齐分数,只保留观察类分数严格最高者,并对各可信空间结果取并集,用该子集训练融合分类器。与已有表示选择方法FINE只用单空间主方向加混合模型不同,REFINE引入背景加权和按类空间选择。在UPMC-Food101上对六种合成噪声设置取平均的分类准确率上,REFINE为86.02%,高于最强基线DIST的83.85%。在N24News上对六种合成噪声设置取平均的分类准确率上,REFINE为63.38%,高于DIST的62.26%。结论适用于特征层融合的多模态分类器和论文测试的四类合成噪声与一种真实噪声,未验证模态缺失或模态冲突情形。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://dcase.community/challenge2026/task-heterogeneous-audio-classification — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
114. 什么时候可以剪掉语音句法分析里的中间神经网络

英文题目:When Can You Prune Your Network? A Study of Intermediate Neurons in Multilingual Speech Parsing
标签:#语音识别 | #模型剪枝 | #语音 | #多语言 | #端到端学习
评分:6.6/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Minnie Kabra:机构信息未在 arXiv HTML 中可靠披露
- Benjamin Lecouteux:机构信息未在 arXiv HTML 中可靠披露
- Maximin Coavoux:Univ. Grenoble Alpes, CNRS, Grenoble INP, LIG, 38000 Grenoble, France
📌 核心摘要
语音解析要求从原始语音直接输出转写文本和依存句法树,难点在于自发语音含口误、中断和重叠,且语音预训练表示为预训练目标优化,与句法分析需要的词级表示存在差距。已有端到端结构Wav2tree把语音编码器、语音识别模块与句法分析器串联,中间另设三段中间神经网络做特征变换与词表示上下文建模。本文提出的简化结构Simplified Wav2tree保留语音编码器输出的帧向量序列,先由联结时序分类(Connectionist Temporal Classification,CTC)层直接对帧向量打分得到转写与词边界,再对同一帧向量按词边界内取平均得到词向量,该词向量直接送入双仿射(biaffine)分析器预测依存关系。冻结对照实验进一步把文本编码器冻结,比较加与不加长短期记忆网络(Long Short-Term Memory,LSTM)时的分析精度,并用线性中心核对齐(Centered Kernel Alignment,CKA)度量表示相似度。在法语ParisStories测试集上,简化结构相对基线Wav2tree的标注依存准确率(Labeled Attachment Score,LAS)从50.9%提高到53.3%,词错误率(Word Error Rate,WER)从38.2%变为37.6%。结论适用于编码器与分析器联合微调的中低资源自发语音,冻结编码器时仍需要中间网络,9-10小时以上训练数据的解析增益趋于平缓。Naija语料上训练时间从676分钟降至403分钟,推理时间从25秒降至20秒。
🔗 开源资源
第三方资源:https://github.com/minniekabra/SpeechParsing — 链接可访问(HTTP 200)
第三方资源:https://universaldependencies.org/treebanks/fr_parisstories/index.html — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/facebook/wav2vec2-xls-r-300m — 暂时无法访问
第三方资源:https://huggingface.co/FacebookAI/xlm-roberta-large — 暂时无法访问
第三方资源:https://github.com/Pupiera/ParseBrain/blob/master/parsebrain/speechbrain_custom/decoders/ctc.py — 链接可访问(HTTP 200)
第三方资源:https://www.nltk.org/book/ch02.html — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
115. 德语音节和音素分词能否改善跨方言与自发口语识别
英文题目:Phonologically Informed Tokenization for German Speech Recognition: A Cross-Domain Study
标签:#语音识别 | #CTC | #语音学与音系 | #口音与方言
评分:6.6/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Christopher Witzl:机构信息未在 arXiv HTML 中可靠披露
- Tobias Bocklet:机构信息未在 arXiv HTML 中可靠披露
- Korbinian Riedhammer:Technische Hochschule Nürnberg Georg Simon Ohm, Nürnberg, Germany
📌 核心摘要
德语复合与屈折产生大量未登录词形,方言发音变异又改变语音表层,输出单元如何切分直接决定联结时序分类(Connectionist Temporal Classification,CTC)需要对齐的目标数量和未登录词的退化方式。方法分三步衔接:先用Pyphen的Knuth-Liang断字算法把训练转写切为音节并以分隔符标记边界,再在该音节化文本上学习数据驱动字节对编码(Byte-Pair Encoding,BPE),以分隔符是否设为自定义符号来禁止或允许跨音节合并以形成多音节单元,最后将所得词表接入固定的Omnilingual ASR的wav2vec 2.0编码器末端单层线性头做CTC微调,音频预算与训练步数固定使差异只来自输出单元。训练混合960.5小时德语Common Voice与Spoken Wikipedia,评测覆盖域内朗读、方言自发语音RVG 1和标准德语协商对话Verbmobil。在域内CV+SWC测试集上以词错率(Word Error Rate,WER)比较,音节-512为15.16%,略高于德语BPE-512的14.93%,两者与多语种字符表置信区间重叠而基本持平。在11B编码器上RVG 1正字转写层以WER比较,音节-512为38.63%,低于德语BPE-512的47.12%,低8.5个百分点。同在11B编码器上RVG 1正字转写层以WER比较,多音节-512为35.75%,低于多语种字符表的36.83%,为该集最低。在同一RVG 1正字转写层WER上,音节相对德语BPE的差异从512词汇量时低8.5个百分点反转为2048词汇量时高1.5个百分点,优势随词汇预算增大而消失。结论仅适用于小词汇量下发音变异保留音节结构的方言与新词形多的自发语音,大词汇量下BPE可自行学到类音节单元使硬性音节约束成负担,且仅在wav2vec 2.0与mHuBERT-147的三种德语评测上验证,未验证其他语言与编码器;原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
116. 朗读中停顿落在哪里:同一篇短文里的声学间隙位置比较
英文题目:Acoustic gap placement in second-language read speech production
标签:#发音评估 | #统计分析 | #语音 | #语言习得
评分:6.5/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Peyman Jahanbin:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
同一篇固定朗读材料为比较停顿位置提供了固定分母,难点在于全局停顿总数会把出现在句读处与出现在无标点词间的间隙混为一谈。研究先用蒙特利尔强制对齐器得到词边界并计算后词起点减前词终点,对正值区间计数后按标点位置与无标点位置归类,随后用说话人与位置交叉随机截距的逻辑模型检验分组与边界类型的交互,并用强度声学确认为补充验证。在115人同一69词朗读材料250 ms阈值下,以标点位置间隙计数均值为指标,普通话组为5.56、英语组为5.47,两组基本相同。在同一115人同一69词朗读材料250 ms阈值评测设置下,以无标点位置间隙计数均值和年龄性别调整后比率为指标,普通话组3.67高于英语组0.43,对应比率为11.98。在115人同一69词朗读材料250 ms阈值交叉模型中,以组间差异交互优势比为指标,普通话组相对英语组的组间差异在无标点位置大于标点位置,交互优势比为9.44。结论只适用于该固定朗读段落的破裂流利度观测,未验证自发话语、熟练度解释与可懂度影响。原文未披露训练、推理或部署成本。
🔗 开源资源
数据相关资源:https://accent.gmu.edu/ — 链接可访问(HTTP 200)
第三方资源:https://praat.org/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
117. GAANet:用非对称时间尺度和全局语义引导做视听语音分离

英文题目:GAANet: Global-guided Asymmetric Attention Network for Audio-Visual Speech Separation
标签:#音视频语音分离 | #注意力机制 | #多模态学习 | #语音
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Zhiyuan Zhang:机构信息未在 arXiv HTML 中可靠披露
- Jingyuan Xu:机构信息未在 arXiv HTML 中可靠披露
- Yiming Tang:机构信息未在 arXiv HTML 中可靠披露
- Liu Liu:机构信息未在 arXiv HTML 中可靠披露
- Dan Guo:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音视频语音分离(Audio-Visual Speech Separation,AVSS)输入混合波形与目标说话人唇部视频,输出目标说话人的干净波形,难点是音频采样密且变化快、唇动缓慢且语义稳定,两者难以在同一时间分辨率下对齐。以往多尺度方法把两路特征同步下采样到相同长度再融合,容易丢失视觉时间细节,也缺少刻画说话人身份与主导性等 utterance 级一致因素的机制。GAANet 让音频编码器构建 4 层下采样层级,视频通路保持原始帧率并用卷积扩大感受野,再把各尺度信息汇总为累积表示。全局引导注意力(Global-Guided Attention,GGA)对累积特征做时间平均池化得到单帧全局描述子,经跨模态门控与前馈网络生成全局音频标记与全局视觉标记,并以门控残差形式广播回全部尺度。融合后的最细尺度特征进入下一次迭代,重复 4 次后由听觉精炼模块估计掩码并经转置卷积重建波形。与已有方法的区别是取消对称下采样约束,并用时不变全局上下文同时指导模态内精炼与模态间融合。在 LRS2 上 GAANet 相对次优的 IIANet 取得 16.5 dB 对 16.0 dB 的尺度不变信噪比提升量(Scale-Invariant Signal-to-Noise Ratio improvement,SI-SNRi),VoxCeleb2 上为 14.0 dB 对 13.6 dB,参数量为 3.3M,计算量为 19.8G 乘加操作,训练批量大小为 3,在 8 块 GeForce RTX 4090 上进行。该结论适用于 16 kHz、25 FPS、信噪比 -5 dB 至 5 dB 的双人合成混合,对真实混响、遮挡与多人场景尚未验证。
🔗 开源资源
- 第三方资源:https://github.com/redizzy/GAANet — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
118. 说话方式不变任务信息也能更像队友:口语人机组队实验解读

标签:#语音交互 | #用户研究 | #数据集 | #语音
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Lara Gauder:机构信息未在 arXiv HTML 中可靠披露
- Martin Bernardo Meza:机构信息未在 arXiv HTML 中可靠披露
- Javier Krick:机构信息未在 arXiv HTML 中可靠披露
- Alejandro Masin:机构信息未在 arXiv HTML 中可靠披露
- Luciana Benotti:机构信息未在 arXiv HTML 中可靠披露
- Marcos Luis Pietto:机构信息未在 arXiv HTML 中可靠披露
- Luciana Ferrer:organization=Instituto de Investigación en Ciencias de la Computación, UBA-CONICET, addressline=Pabellón Cero+Infinito, Ciudad Universitaria, city=Buenos Aires, postcode=C1428EGA, country=Argentina;organization=Departamento de Computación, Facultad de Ciencias Exactas y Naturales, Universidad de Buenos Aires, addressline=Pabellón Cero+Infinito, Ciudad Universitaria, city=Buenos Aires, postcode=C1428EGA, country=Argentina;organization=Universidad Nacional de Córdoba, addressline=Pabellón Argentina, Av. Haya de la Torre s/n, Ciudad Universitaria, city=Córdoba, postcode=X5000HUA, country=Argentina;organization=Instituto de Educación, Universidad Nacional de Hurlingham, UNAHUR-CONICET, addressline=Tte. Origone 101, Villa Tesei, city=Hurlingham, postcode=B1688, state=Buenos Aires, country=Argentina
📌 核心摘要
该研究处理口语人-智能体组队中的感知问题,输入是被试与虚拟智能体在找物与放物游戏中的自由口语问答,输出是任务成绩、对智能体队友相似度的评分以及被试语音特征,难点是任务能力、启动语期待与沟通方式容易混在一起。方法先固定任务相关信息完全相同,只改变中性工具型智能体与团队建设型智能体的开场白、共情安慰、指小词等亲近表达与热情语气,再用向导式巫师解析口语后接自动回答树保证回答一致。接着用完整版与单题版队友相似度问卷、大五人格量表、人际取向量表与自动化信任量表收集感知与特质数据,最后用随机森林对韵律特征做按说话人划分的块级二分类检验说话方式是否变化。与只改变任务能力的已有操纵不同,该工作把沟通质量从解题能力中分离出来,实际意义是改几句提示语即可复用。在Teaming-UBA数据集74人主样本中每种智能体各完成4试次后的终测自主智能体队友相似度问卷(1–5分,分数越高越像队友)上,团队建设型智能体相比中性工具型智能体得分更高,其中关系建设差值均值0.557分、利他差值均值0.517分,校正后p均小于0.0001。结论适用于结构化高互依口语指认任务,向更开放协作的泛化尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/habla-liaa/Teaming-UBA — 链接不可用(HTTP 404)
第三方资源:https://ri.conicet.gov.ar/handle/11336/296934 — 链接不可用(HTTP 404)
第三方资源:https://github.com/snakers4/silero-vad — 链接可访问(HTTP 200)
第三方资源:https://learn.microsoft.com/en-us/azure/ai-services/speech-service/language-support?tabs=tts — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
119. 在移动对话中解码听觉注意:MOV-AAD 数据集做了什么

标签:#言语神经解码 | #数据集构建 | #数据集 | #生理信号 | #听觉努力与认知负荷
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Xiaomin He:机构信息未在 arXiv HTML 中可靠披露
- Vishal Choudhari:机构信息未在 arXiv HTML 中可靠披露
- Tristan J. Spratt:机构信息未在 arXiv HTML 中可靠披露
- Aarya Raghavan:机构信息未在 arXiv HTML 中可靠披露
- Richard T. Lee:机构信息未在 arXiv HTML 中可靠披露
- Nima Mesgarani:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
日常听音常面对说话人走动、轮流发言与背景噪声,而已有听觉注意解码(Auditory Attention Decoding, AAD)多在静态双说话人混合上评测,难以反映空间动态与聆听努力的协同变化。本文构建移动对话听觉注意数据集(Moving Conversations for Auditory Attention Decoding, MOV-AAD),输入为头相关传输函数(Head-Related Transfer Function, HRTF)空间化的单路与双路移动对话语音及行人或 babble 噪声,输出为同步记录的 64 导脑电、眼动、呼吸气流与呼吸努力、皮肤电反应、光电容积脉搏(Photoplethysmography, PPG)及其派生的心率与心率变异性、血氧(SpO2)、体温、加速度,以及定位报告与重复词按键行为。单对话任务要求侦听一路移动叙事,双对话任务要求在两路移动对话中跟随先开始的一路并忽略另一路,重复词检测用于度量注意投入。方法上采用希尔伯特包络与方位轨迹的反向线性重建验证神经跟随,再用重建相关构成注意分类特征,并用被试间相关(Intersubject Correlation, ISC)检验多模态信号的刺激锁定成分。与已有静态数据集相比,关键差异是声源在正负 90 度范围内连续移动、对话含说话人切换与轮流结构、并配有完整的自主神经记录。在 50 名被试的双对话任务中,注意流相对忽略流的重复词检测 F1 分数更高,双尾 Wilcoxon 符号秩检验 \(p<10^{-4}\),秩效应量 \(r=0.87\),单对话相对双对话注意流 F1 更高,\(p<10^{-4}\),\(r=0.52\),表明注意分离有效,而包络重建的注意流相关持续高于忽略流。结论适用于耳机呈现、均方根功率匹配的移动对话场景,在极端侧向方位与非个体化 HRTF 条件下定位变异可能增大。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/naplab/MOV-AAD — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
120. 把等待和选词分开:流式语音识别的因子化延迟流建模

英文题目:Factorized Delayed Streams Modeling for LLM-based Streaming ASR
标签:#语音识别 | #自回归模型 | #流式处理 | #语音 | #LoRA
评分:6.5/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tatsunari Takagi:机构信息未在 arXiv HTML 中可靠披露
- Kai Washizaki:机构信息未在 arXiv HTML 中可靠披露
- Atsushi Kojima:机构信息未在 arXiv HTML 中可靠披露
- Lianbo Liu:机构信息未在 arXiv HTML 中可靠披露
- Koki Nikaido:机构信息未在 arXiv HTML 中可靠披露
- Yui Sudo:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
流式自动语音识别需要在语音不断到达时逐帧决定等待还是输出文字,延迟约束下等待与输出耦合是主要难点。延迟流建模把声学流与右移固定延迟的文本流对齐到同一时间轴,用同一个解码器式大语言模型预测等待填充符<p>、词起始符<w>和普通文本,输出是原词表加2个专用符号的联合softmax。论文先做消融,去掉<w>后识别性能保持相当,说明只需要保留一个等待符号。基于此提出的分解式延迟流建模分两步决策:解码器隐状态先经标量等待头做sigmoid得到等待概率,其输出直接决定是否进入词预测;若判定等待则输出<p>并跳过词表投影,若判定输出则由原大语言模型输出头给出原词表上的词分布,两者按等待概率与1减等待概率相乘得到完整输出概率。480 ms目标延迟和贪心解码下,F-DSM在Corpus of Spontaneous Japanese平均字符错误率为6.45%,低于DSM去词起始符版本的6.60%;在LibriSpeech平均词错误率为6.17%,低于对照的6.61%。该结论适用于160 ms至800 ms的延迟设置,更长语音、更大批量和束搜索下的行为尚未验证。F-DSM在批量32时把训练显存从约61 GiB降到约18 GiB,推理跳过多数词表计算但端到端加速较小。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
121. 不用训练也能让语音大模型专心做一件事:对比激活相加转向
标签:#语音识别 | #语音情感识别 | #音频字幕生成 | #测试时自适应
评分:6.5/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Séverin Baroudi:机构信息未在 arXiv HTML 中可靠披露
- Yanis Labrak:机构信息未在 arXiv HTML 中可靠披露
- Pierfrancesco Melucci:机构信息未在 arXiv HTML 中可靠披露
- Sergio Burdisso:机构信息未在 arXiv HTML 中可靠披露
- Petr Motlicek:机构信息未在 arXiv HTML 中可靠披露
- Hervé Bredin:机构信息未在 arXiv HTML 中可靠披露
- Mirco Ravanelli:机构信息未在 arXiv HTML 中可靠披露
- Ricard Marxer:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音大模型通常靠文字提示词指定转写、情感识别或字幕生成等任务,但同义提示词的效果波动大,而为每个任务单独微调又需要标注数据和多套权重。论文提出免训练的对比激活加法(Contrastive Activation Addition,CAA)流程,先用同一批音频分别搭配目标任务指令与其他任务指令输入冻结的语音大模型,取提示词最后一个位置在某层的残差激活均值并求差得到任务向量。推理时把该向量按强度加到选定层的所有或文本位置上,有效注入集中在中间层且强度与层位经小规模音频集网格搜索确定,必要时再叠加一个脚本归一化向量以约束输出文字。在 Qwen2-Audio-7B-Instruct 上,提示词加任务转向在 LibriSpeech 四个划分平均的字错率由 4.18%降至 3.75%,CommonVoice 五种语言平均的字形错误率由 28.6%降至 25.7%,同时跨三条提示词的标准差约缩小一半。该结论适用于所测的两个指令跟随语音大模型与所列的英语、法语、阿拉伯语、印地语、俄语转写及情感与字幕任务。转写向量在 LibriSpeech 与 CommonVoice之间迁移时性能下降很小,非拉丁文字仍可能输出拉丁字母或出现幻觉延续。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
122. 从二分类到连续量:多维调性强度如何刻画调性渐弱与瓦解
标签:#音乐分析 | #统计分析 | #音乐信息检索 | #听觉与音乐认知
评分:6.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yuliang Li:机构信息未能从 arXiv PDF 文本可靠映射
- Nan Nan:机构信息未能从 arXiv PDF 文本可靠映射
- Meilian Gu:机构信息未能从 arXiv PDF 文本可靠映射
- Xiaohong Guan:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
西方音乐从共性实践调性向无调性过渡存在大量中间状态,二分类标签无法刻画渐进弱化过程,论文的输入是符号音乐文件中的音高与时值信息,输出是连续的调性程度值(tonal-degree value,T)。先解析文件提取音符事件并统计全局音高类别时值分布,计算其与均匀分布的余弦相似得到全局音高类别分布均匀性(pitch-class distribution uniformity,U),再经1-U方向对齐使数值越大越偏离均匀而越具调性。以4个音符为窗、2个音符为步划分局部窗口,将各窗分布与24个大小调模板相关以推断调中心,调中心时间稳定性(temporal stability of tonal centers,S)度量相邻窗口推断结果的相关性,局部调性清晰度(local tonal clarity,C)取各窗最大模板相关性的平均值,前步输出的窗分布直接作为这两步相关计算的输入。三者经方向对齐和标准化后由因子分析映射为一个潜变量得分,KMO为0.756且首成分解释87.67%方差,支持一维整合得到T。在196首调性与无调性作品构成的评测集上,集成模型在样本最优阈值0.06处取得F1 = 0.9851,AUC = 0.9985,超过单个特征和改编的区间分类基线。在21位作曲家1561首作品的历史语料上,均值从巴洛克与古典的正区间连续下降到第二维也纳乐派的负区间,EMOPIA上的正价态组均值高于负价态组但效应量r = 0.074。该结论适用于符号化西方音乐MIDI及类似窗长条件,在4至20音符窗内表现稳定,但样本最优阈值与分期对应尚未在音频录音、非西方体系或当代风格中验证,复现失败的区间类别方法亦未纳入完整比较。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://kunstderfuge.com — 链接可访问(HTTP 200)
第三方资源:https://musescore.com — 链接不可用(HTTP 403)
第三方资源:https://doi.org/10.5281/zenodo.5624519 → https://zenodo.org/records/5624519 — 链接可访问(HTTP 200)
第三方资源:https://openreview.net/forum?id=r1lYRjC9F7 → https://openreview.net/challenge?redirect=%2Fforum%3Fid%3Dr1lYRjC9F7 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
123. 同步生成有声视频:Kandinsky 6.0 Video 如何让画面和声音对齐

英文题目:Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation
标签:#音视频生成 | #扩散模型 | #音视频 | #模型权重 | #开源工具
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Team Kandinsky:机构信息未在 arXiv HTML 中可靠披露
- Julia Agafonova:机构信息未在 arXiv HTML 中可靠披露
- Bulat Akhmatov:机构信息未在 arXiv HTML 中可靠披露
- Mikhail Aksyutin:机构信息未在 arXiv HTML 中可靠披露
- Grigorii Alekseenko:机构信息未在 arXiv HTML 中可靠披露
- Anastasia Aliaskina:机构信息未在 arXiv HTML 中可靠披露
- Olga Androsova:机构信息未在 arXiv HTML 中可靠披露
- Vladimir Arkhipkin:机构信息未在 arXiv HTML 中可靠披露
- Anna Averchenkova:机构信息未在 arXiv HTML 中可靠披露
- Alexander Belykh:机构信息未在 arXiv HTML 中可靠披露
- Serafima Bocharova:机构信息未在 arXiv HTML 中可靠披露
- Sofiya Bogakovskaya:机构信息未在 arXiv HTML 中可靠披露
- Anton Bukashkin:机构信息未在 arXiv HTML 中可靠披露
- Mark Bulygin:机构信息未在 arXiv HTML 中可靠披露
- Kirill Buzygin:机构信息未在 arXiv HTML 中可靠披露
- Irina Cheremnykh:机构信息未在 arXiv HTML 中可靠披露
- Kirill Chernyshev:机构信息未在 arXiv HTML 中可靠披露
- Mikhail Chernyshov:机构信息未在 arXiv HTML 中可靠披露
- Vladimir Chernyy:机构信息未在 arXiv HTML 中可靠披露
- David Chikovani:机构信息未在 arXiv HTML 中可靠披露
- Georgy Daniltsev:机构信息未在 arXiv HTML 中可靠披露
- Denis Dimitrov:机构信息未在 arXiv HTML 中可靠披露
- Anna Dmitrienko:机构信息未在 arXiv HTML 中可靠披露
- Vladimir Dokholyan:机构信息未在 arXiv HTML 中可靠披露
- Sergey Emelyanov:机构信息未在 arXiv HTML 中可靠披露
- Dmitry Ermilov:机构信息未在 arXiv HTML 中可靠披露
- Georgii Fedorov:机构信息未在 arXiv HTML 中可靠披露
- Polina Gavrilova:机构信息未在 arXiv HTML 中可靠披露
- Nikolai Gerasimenko:机构信息未在 arXiv HTML 中可靠披露
- Aleksandr Gordeev:机构信息未在 arXiv HTML 中可靠披露
- Andrey Inozemtsev:机构信息未在 arXiv HTML 中可靠披露
- Andrei Ivaniuta:机构信息未在 arXiv HTML 中可靠披露
- Alexander Ivanov:机构信息未在 arXiv HTML 中可靠披露
- Mikhail Karaev:机构信息未在 arXiv HTML 中可靠披露
- Anastasiia Kargapoltseva:机构信息未在 arXiv HTML 中可靠披露
- Ivan Kirillov:机构信息未在 arXiv HTML 中可靠披露
- Nikita Kiselev:机构信息未在 arXiv HTML 中可靠披露
- Valeria Kobenko:机构信息未在 arXiv HTML 中可靠披露
- Yury Kolabushin:机构信息未在 arXiv HTML 中可靠披露
- Denis Koposov:机构信息未在 arXiv HTML 中可靠披露
- Anatoly Korobov:机构信息未在 arXiv HTML 中可靠披露
- Vladimir Korviakov:机构信息未在 arXiv HTML 中可靠披露
- Kirill Kozlov:机构信息未在 arXiv HTML 中可靠披露
- Denis Krzhivokolskiy:机构信息未在 arXiv HTML 中可靠披露
- Konstantin Kuklev:机构信息未在 arXiv HTML 中可靠披露
- Alexander Kunitsyn:机构信息未在 arXiv HTML 中可靠披露
- Sergey Kuzin:机构信息未在 arXiv HTML 中可靠披露
- Vladislav Lakhtionov:机构信息未在 arXiv HTML 中可靠披露
- Alexey Letunovskiy:机构信息未在 arXiv HTML 中可靠披露
- Maxim Litvinov:机构信息未在 arXiv HTML 中可靠披露
- Alexander Lyulkov:机构信息未在 arXiv HTML 中可靠披露
- Georgy Makarov:机构信息未在 arXiv HTML 中可靠披露
- Kirill Malakhov:机构信息未在 arXiv HTML 中可靠披露
- Egor Malykh:机构信息未在 arXiv HTML 中可靠披露
- Mikhail Mamaev:机构信息未在 arXiv HTML 中可靠披露
- Dmitrii Mikhailov:机构信息未在 arXiv HTML 中可靠披露
- Polina Mikhailova:机构信息未在 arXiv HTML 中可靠披露
- Ivan Mikheev:机构信息未在 arXiv HTML 中可靠披露
- Elizaveta Muromtseva:机构信息未在 arXiv HTML 中可靠披露
- Nikolai Nazarkin:机构信息未在 arXiv HTML 中可靠披露
- Tatiana Nikulina:机构信息未在 arXiv HTML 中可靠披露
- Lev Novitskiy:机构信息未在 arXiv HTML 中可靠披露
- Stanislav Onuchin:机构信息未在 arXiv HTML 中可靠披露
- Nikita Osterov:机构信息未在 arXiv HTML 中可靠披露
- Denis Parkhomenko:机构信息未在 arXiv HTML 中可靠披露
- Anatoliy Parpara:机构信息未在 arXiv HTML 中可靠披露
- Vladimir Polovnikov:机构信息未在 arXiv HTML 中可靠披露
- Konstantin Reznikov:机构信息未在 arXiv HTML 中可靠披露
- Azat Saginbaev:机构信息未在 arXiv HTML 中可靠披露
- Nikita Samsonov:机构信息未在 arXiv HTML 中可靠披露
- Alexander Sentsov:机构信息未在 arXiv HTML 中可靠披露
- Nikita Shaimov:机构信息未在 arXiv HTML 中可靠披露
- Artem Sherstyuk:机构信息未在 arXiv HTML 中可靠披露
- Andrey Shutkin:机构信息未在 arXiv HTML 中可靠披露
- Egor Silvestrov:机构信息未在 arXiv HTML 中可靠披露
- Bulat Suleimanov:机构信息未在 arXiv HTML 中可靠披露
- Matvey Suprunov:机构信息未在 arXiv HTML 中可靠披露
- Sergey Taranov:机构信息未在 arXiv HTML 中可靠披露
- Irina Tolstykh:机构信息未在 arXiv HTML 中可靠披露
- Tatiana Trofimuk:机构信息未在 arXiv HTML 中可靠披露
- Ilya Trushkin:机构信息未在 arXiv HTML 中可靠披露
- Aleksandra Tsybina:机构信息未在 arXiv HTML 中可靠披露
- Olga Varlashina:机构信息未在 arXiv HTML 中可靠披露
- Viacheslav Vasilev:机构信息未在 arXiv HTML 中可靠披露
- Ilya Vasiliev:机构信息未在 arXiv HTML 中可靠披露
- Eugeny Vilisov:机构信息未在 arXiv HTML 中可靠披露
- Sergey Yakubson:机构信息未在 arXiv HTML 中可靠披露
- Konstantin Zakharov:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
本文解决的问题是从文本或首帧图像生成5秒带44 kHz同步音频的视频,要求语义、时间与情感一致,包含说话人口型同步,该系列含30亿参数Lite版和290亿参数Pro版。输入文本经Qwen2.5-VL-7B-Instruct和CLIP ViT-L/14编码,视频与音频分别经Hunyuan VAE和MMAudio自编码器压缩到隐空间,再由双流CrossDiT去噪生成。视频流继承Kandinsky 5.0预训练权重,音频流先在音频字幕数据上单独训练,再通过新初始化的块级双向跨注意力做联合训练,保留单模态保真度的同时学习对齐。随后11个领域分别监督微调并做均匀权重平均的模型汤,在冻结基座上用LoRA做多目标强化学习,最后用\(\pi\)-Flow与对抗精炼把采样压缩到10次函数求值。与已有联合音视频模型的区别在于连续预训练加领域汤加模态内优势路由的强化学习,以及隐空间超分器的分离设计。在VABench上Pro版唇同步得分为2.072,高于LTX 2.5的1.567,数值越大越好;强化学习使Pro版在内部语音集的词错误率从0.235降到0.124。超分模型在4块GPU上训练约两天,结论适用于5秒、24 fps、标清生成加超分到全高清的范围,更长时长与更高原生分辨率尚未验证。
🔗 开源资源
第三方资源:https://github.com/kandinskylab/kandinsky-6 — 链接可访问(HTTP 200)
第三方资源:https://kandinskylab.ai — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/collections/kandinskylab/kandinsky-60-diffusers — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
124. 角色声音不是说话人声音:KyaraBench 如何考角色一致性

英文题目:Character Identity is not Speaker Identity: KyaraBench and KyaraEmbed for Character Verification
标签:#说话人验证 | #对比学习 | #基准测试 | #数据集
评分:6.5/10 | 创新 1.4/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Joonyong Park:机构信息未在 arXiv HTML 中可靠披露
- Jerry Li:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
配音角色在更换演员后仍被听众视为同一角色,而同一演员可以演出多个不同角色,现有说话人验证以自然人为身份单位,无法度量这两种混淆。论文构建角色验证基准KyaraBench,输入为音频片段,输出为两组音频是否属于同一角色的判定,难点在于跨配音演员正样本缺乏共同声纹线索,而同演员反例声纹高度相似。构建链路把Anim-400K的日英对齐片段经修复、跨集聚类、动漫人脸检测与角色肖像匹配、质量门限和人工视听核验,筛选为85个角色共986个日语片段和630个英语片段,再按固定随机种子抽成单语、多语、同演员等试次。编码器KyaraEmbed以动漫领域说话人嵌入为起点,先用86角色四语内配数据构成跨演员正例拉近同一角色,再把共用演员的跨剧角色绑定采样为难反例并以双边裕量推开,最后以前一步的批量角色片段为负例、用三语单说话人语料的跨语言对做语言对齐,经监督对比学习训练为192维音频嵌入,以束内均值池化后的余弦相似度评分。在KyaraBench跨配音条件XLing验证上KyaraEmbed的等错误率(Equal Error Rate,EER)为0.215,低于领域微调基线的0.271,也低于零样本ECAPA-TDNN的0.367。结论适用于已审核的动画配音验证与检索,同演员区分仍难且单语条件略有损失,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
125. 冻住说话人模型,只修向量:vMF 轮廓似然的无标签嵌入增强

英文题目:Revisiting Label-Free Speaker Embedding Enhancement with vMF Profile Likelihood
标签:#说话人验证 | #自监督学习 | #扩散模型 | #形式化分析 | #鲁棒性
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Seunghwan Kim:机构信息未在 arXiv HTML 中可靠披露
- Jinyong Kim:机构信息未在 arXiv HTML 中可靠披露
- Sooyoung Yang:机构信息未在 arXiv HTML 中可靠披露
- Youngjin Ko:机构信息未在 arXiv HTML 中可靠披露
- Myungjoo Kang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
说话人验证把变长语音映射为定长向量后用余弦相似度判定是否为同一人,噪声、混响、麦克风与信道差异会使测试分布偏离训练分布。嵌入增强冻结已训练好的提取器,只学习一个轻量后处理映射,把退化嵌入拉回其对应的干净嵌入,测试时仍沿用原余弦打分链路。处理分三步衔接:冻结提取器先把原语音及其加噪加混响等退化版本分别编码为单位化干净嵌入与退化嵌入,形成配对训练目标;轻量增强映射以退化嵌入为输入,输出指向干净目标的预测嵌入;该预测与干净目标的相似度进入冯·米塞斯-费舍尔分布(von Mises-Fisher distribution,vMF)似然,对每对样本表征分布集中程度的集中度参数(concentration parameter)求闭式最优并代回,得到对残差平方取对数的损失。该损失的梯度幅值与残差平方成反比,残差大的难样本更新被压低,残差小的样本保留较大影响。与均方误差(mean squared error,MSE)只差在跨样本聚合权重,而非几何距离本身。在 ResNet-34 主干上,CN-Celeb 的等错误率(equal error rate,EER)从 14.54% 降至 13.78%,VOiCES 从 5.62% 降至 5.30%,标准集基本保持基线。方法在更宽的单视图增强配方下保持稳定,而同一配方下扩散基线明显退化。结论仅在两款冻结主干、七个评测集及有配对干净-退化语音训练时得到验证,个别条目的最小检测代价未同步改善,超出训练增强覆盖的重退化仍可能失效。原文只披露单卡 NVIDIA RTX A6000 训练,未披露训练时长、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
126. 把 Kokoro 单音色蒸馏到 8M 参数:Paradee 如何分半训练与修复嗡嗡声
英文题目:Paradee: Distilling Kokoro-82M into an 8M-Parameter Single-Voice Text-to-Speech Model
标签:#文本到语音 | #知识蒸馏 | #生成对抗网络 | #模型量化 | #实时处理
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Sahil Mahendrakar:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
Kokoro面向多音色通用合成而体积与算量偏大,设备端单音色场景只需固定读出af_heart,如何在保留自然度前提下大幅压缩并让蒸馏与运行都落在笔记本上是本文难点。教师先合成英语朗读语料并保存每句时长基频能量与音素特征及对应波形,这些保存量同时作为两半学生的训练目标。文本侧学生读取音素并学习预测教师保存的时长基频能量与音素特征,解码器学生则以教师保存的中间量为输入先经频谱损失再经对抗训练学习重建教师波形。两半连接后不再联合训练,也无需学习对齐,最后对权重做整数量化,并以免训练的锁相滤波修正浊音段残留嗡鸣声。与已有做法的关键差异是两侧分别蒸馏且监督音素特征,同时给出参数与算量分布及量化敏感性分析并定位嗡鸣声频带与相位来源。在200句保留测试平均的fp32条件下以UTMOS为指标比较自然度,Paradee为4.41,低于教师的4.52。在同一200句保留测试上经单CPU线程PyTorch计时以实时倍速为指标比较运行速度,Paradee为25.0倍,高于教师的7.6倍,整数量化后文件为8.45MB,训练在单台MacBook Pro上完成,结论仅适用于单英语音色与相近朗读文本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
127. 按问题选参数:SkillFormer 用技能分组适配器缓解音频多任务干扰
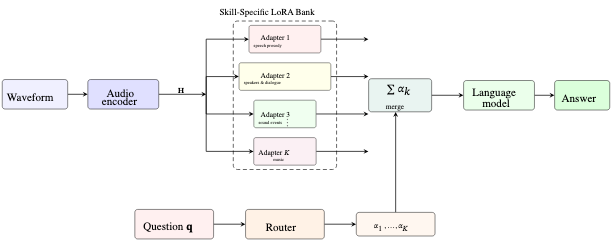
英文题目:SkillFormer: Skill-Decomposed Adaptation for Audio Language Models
标签:#音频问答 | #混合专家模型 | #LoRA | #音频大模型
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Lee Seung-woo:机构信息未在 arXiv HTML 中可靠披露
- Bowen Qi:机构信息未在 arXiv HTML 中可靠披露
- Kim Min-jun:机构信息未在 arXiv HTML 中可靠披露
- Jang Won-young:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
大型音频语言模型用同一套参数回答语音、声音和音乐问题,一个技能簇上的更新常损害另一个技能,论文称之为技能干扰。SkillFormer在音频编码器与语言骨干之间插入6个技能专用低秩适配器(Low-Rank Adaptation, LoRA),由问题条件路由器为每个问题输出稀疏权重,只激活权重最高的2个适配器并加权合并。训练分两段进行,先让每个适配器在各自技能簇上独立 specialization,再在均衡混合数据上联合校准路由器与适配器,避免多任务梯度冲突。相对单LoRA全数据微调和均匀混合多LoRA,新增设计是按问题语义选择参数子集,而不是加深推理或改课程。与已有参数高效方法的区别在于适配器按技能划分且组合权重来自问题文本,同一段音频配不同问题会走不同通路。在Qwen2.5-Omni-7B上,MMSU、MMAU-Pro和MMAR三个基准的平均准确率从59.3%提高到63.4%,提升分布在感知、推理和语义子项。方法增加基座参数的3.2%到3.8%,训练使用4张NVIDIA A100-80G,推理因每次只合并2个适配器而代价不随适配器总数增长,适用范围限于论文所用问答式评测,对开放生成和跨域迁移尚未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
128. 两个全双工语音模型对话时,为什么接得上话却总是慢半拍

英文题目:Coupled but Late: Turn-Taking Between Full-Duplex Speech Models in Unscripted Dialogue
标签:#轮次切换 | #全双工语音交互 | #统计分析 | #模型评估
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Lichen Zhu:机构信息未在 arXiv HTML 中可靠披露
- Yueqian Lin:机构信息未在 arXiv HTML 中可靠披露
- Yiheng Wang:机构信息未在 arXiv HTML 中可靠披露
- Hai “Helen” Li:机构信息未在 arXiv HTML 中可靠披露
- Yiran Chen:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
全双工语音交互要求模型边听边说、自主决定何时接管话轮,输入是对方连续到达的音频令牌流,输出是本方何时起音与停音,难点在于无人替模型吸收时机误差时环路会收敛到何种节奏。论文让两个PersonaPlex-7B实例在共享时钟上交换Mimi音频令牌并自由生成无脚本对话,解码后音频只用于测量。同一套基于停顿单元的话轮转移偏移规则同时作用于智能体语音与Switchboard人类词对齐文本,智能体侧用能量、文本词、配准词三向分割界定边界以检验敏感性,输出转移时刻序列。该序列先进入跨对话重配音轨与静音伙伴检验,以判断时机是否依赖对方实时音频,再进入单向延迟扫描,以检验等待是否随通道延迟移动。在同一套提取规则下,能量分割基线747次转移的话轮偏移中位数为+480ms,高于Switchboard完整通话193115次转移的人类参照+137ms。在同一套提取规则下对Switchboard完整通话的同口径比较中,伙伴末段120ms区间[-120,0)占比指标上基线仅占0.01,低于人类参照的0.10。在同一套提取规则下对Switchboard完整通话的同口径比较中,近零带±120ms占比指标上基线占0.03,低于人类参照的0.25,重配破坏耦合而延迟让响应等量后移且移前区间保持清空,说明等待锚定在感知到的对方结束之后,而非人类式的提前投射。结论适用于该检查点在共处场景提示下的自发双体环路,不适用于任意双工模型与任意场景,且录制人声伙伴与提示指令等条件下表现不同,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
129. 方言与信道偏移下的阿拉伯语语音伪造检测:冻结大模型加分赛道融合

标签:#音频深度伪造检测 | #参数高效微调 | #模型集成 | #鲁棒性
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Aref Farhadipour:Department of Computational Linguistics, University of Zurich, Switzerland
- Teodora Vukovic:Department of Computational Linguistics, University of Zurich, Switzerland
- Petr Motlicek:Idiap Research Institute, Switzerland;Brno University of Technology, Czech Republic
📌 核心摘要
阿拉伯语语音真伪判别输入为16kHz单通道录音,需区分为真实语音与合成或转换语音,难点在于现代标准语与多地方言发音韵律差异,以及编码压缩噪声混响和传输滤波带来的信道变化。系统冻结W2V-BERT-2.0骨干并采用小波提示调优,只训练每层附加的标准提示与小波提示,输出保留预训练特征的各层帧表示。四头跨层注意力按内容加权聚合24层表示,再经多头注意力统计池化输出真伪分值,该分值直接作为后一步融合的输入。与取单层特征配专用图后端的基线做法不同,该方法聚合全部层表示并保留通用池化头,再通过更换适配策略训练池与增强方式及编码器族得到互补检测器。各检测器分段分值进入赛道自适应晚融合,方言赛道用多窗口平均配合较宽去相关集成,声学赛道用中心截取配合精简信道增强集成,融合前按评测集合做标准化加权。在ArA-DF 2026终测赛道一方言泛化评测上,与XLS-R加AASIST基线相比,等错误率从14.54%降到1.96%。在ArA-DF 2026终测赛道二声学鲁棒评测上,与同一基线相比,等错误率从27.11%降到1.04%。结论只适用于ArA-DF 2026方言泛化与声学鲁棒评测,融合分数依赖评测集合统计,外部阿拉伯语和多语训练池未按说话人或合成系统去重。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
130. 把英文声音理解模型搬到九种印度语言:只训练文本编码器
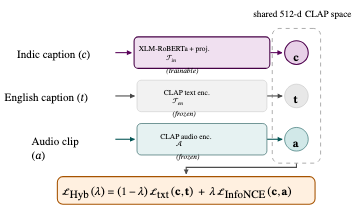
英文题目:Indic-CLAP: Text–Audio Understanding in Indic Languages via Cross-Lingual Distillation
标签:#音频检索 | #知识蒸馏 | #音频分类 | #多语言 | #跨语言
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sanat Kumar Agrawal:机构信息未在 arXiv HTML 中可靠披露
- Srikanth Raj Chetupalli:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
对比语言-音频预训练把音频片段和自然语言描述映射到同一单位球面共享空间,支持零样本分类和跨模态检索,但原有文本编码器只理解英语,9种印度语言没有公开音频字幕数据。Indic-CLAP先用机器翻译把AudioCaps英语字幕转成印度语言字幕,构成音频、英语字幕与印度语字幕的三元组,再用冻结的CLAP音频编码器和英语文本编码器预先算好音频向量与英语向量并缓存,训练时不再读取音频。可训练的学生编码器以XLM-RoBERTa-base为起点,对翻译字幕做注意力掩蔽平均池化、线性投影和ℓ2归一化,输出512维归一化向量,直接落入原有共享空间。该向量的训练比较了文本教师均方误差、音频教师均方误差、音频教师对比目标和同时对齐两侧的混合目标,混合目标用超参数λ平衡文本余弦项和音频InfoNCE项。评估用AudioCaps和Clotho的文本到音频与音频到文本检索召回率,以及ESC-50和UrbanSound8K的零样本分类准确率,还用蒸馏保真度和模态间隔分析对齐状态。多语言联合模型在AudioCaps上混合目标λ=0.10时音频到文本R@1为38.8%,超过CLAP教师的24.5%,零样本分类为73.3%。结论适用于翻译字幕覆盖的日常环境声,Clotho上的检索仍低于教师,Helsinki-NMT翻译的印地语模型零样本分类仅57.7%。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/Sanat-agrwl/IndicCLAP-csvs — 链接可访问(HTTP 200)
第三方资源:https://sanat-agrwl.github.io/IndicCLAP → https://sanat-agrwl.github.io/IndicCLAP/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
131. 只用已登记音频做条件:音乐生成的输入记录与输出核查如何分工

英文题目:Tracing Inputs, Verifying Outputs: Validating Attribution in Music Generation
标签:#音乐生成 | #自回归模型 | #翻唱与曲目识别 | #主观评测
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Taejun Kim:Neutune, Seoul, South Korea
- Wonil Kim:Neutune, Seoul, South Korea
- Jongmin Jung:Neutune, Seoul, South Korea
- Hyeongseok Wi:Neutune, Seoul, South Korea
- Sangeun Kum:Neutune, Seoul, South Korea
- Keunhyoung Luke Kim:Neutune, Seoul, South Korea
- Taehyoung Kim:Neutune, Seoul, South Korea
- Dongjoo Moon:Neutune, Seoul, South Korea
- Seungsoon Park:Neutune, Seoul, South Korea
- Taewan Kim:Neutune, Seoul, South Korea
- Virginie Berger:Neutune, Seoul, South Korea
- Juhan Nam:KAIST, Daejeon, South Korea
- Jongpil Lee:Neutune, Seoul, South Korea
📌 核心摘要
音乐生成中的归属需要同时回答哪段音频作为输入参与了本次生成,以及该输入的音乐特性是否出现在输出中,仅凭风格相似无法确认输入使用情况,已确认的输入使用也不能证明其产生音乐影响。MixAudio只以已注册音频为条件,不使用文本输入,先将每条目标分轨的1–2秒提示录音与前置共享上下文拼接并加入调性节拍与分轨位置编码,再按分轨与乐段生成对应分轨并记录使用情况。带输入记录的生成分轨随后作为查询进入musicDNA音乐版本识别模型的记忆审计,与训练数据比对以查找输入记录之外的复现。在四种数据源实例上与ACE-Step v1.5的对照中,替换上下文后MixAudio生成与新上下文的chroma相关性从0.00升至0.21,接近匹配参考,而与原提示的MFCC音色相似度仍保持在0.89附近。由994个旋律声部查询构成的记忆审计中,未命名复现仅在训练条件复用时出现1例录音复现,验证集为0例。在171首被任一检索器标记并经人工听辨的池子里,musicDNA的召回率为0.91(29/32),精度为0.49,均高于CLEWS的0.69与0.37。审计只覆盖吉他、键盘、铜管类旋律声部,不含贝斯、鼓与人声目标,阈值之外的潜在复现未经听辨。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://neutune.github.io/attr2027demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
132. 一个低成本配方应对三种阿拉伯语识别难关:混合方言与语码切换的 Whisper 适配
标签:#语音识别 | #口音与方言 | #代码转换 | #LoRA | #模型集成
评分:6.5/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Ibrahim Almajai:Independent Researcher
📌 核心摘要
NADI 2026的三个阿拉伯语语音识别子任务输入均为语音,输出为文字转写,难点在于8国方言的噪声与窄带失真、无方言标签的混合方言拼写不一致、突尼斯语中33.3%拉丁字母法英词的代码转换。通用做法是在冻结的Whisper上加低秩适配器(Low-Rank Adaptation,LoRA)做参数高效微调。子任务1.1在混合适配器基础上为毛里塔尼亚、阿尔及利亚、摩洛哥、埃及4国继续训练方言专家并按已知国家标签路由,其余4国按子集比较选用完整large-v3转写。子任务1.2改用完整large-v3基座并在全部3152句上重训后用词级投票合并5个系统。子任务1.3在正则化训练后做跨轮次权重平均与投票。与已有方法相比,论文未提出新模块,贡献在于测出三个子任务的约束各不相同,并给出继续训练式专家、冻结编码器线性路由和跨种子精确平均的具体做法。子任务1.3的盲测词错误率(Word Error Rate,WER)为14.49%,字符错误率(Character Error Rate,CER)为5.38%,相对最佳单模型降低0.60个百分点并获得第二名,仅落后第一名0.08个百分点,CER为领先提交中最低,适用范围限于组织方归一化文本和所给数据量。全部训练与解码在RTX 3080与RTX 3060共2张消费级显卡上完成,1.54B参数基座以bfloat16冻结,适配器以float32训练。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
133. 从叫声测量到场景推理:BEANS-Next 与 ROOTS 如何拓宽生物声学音频语言能力

英文题目:BEANS-Next and ROOTS: Broadening Audio-Language Capabilities for Bioacoustics
标签:#音频理解 | #数据集构建 | #基准测试 | #数据集
评分:6.5/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Christos Plachouras:Earth Species Project;Queen Mary University of London
- David Robinson:Earth Species Project
- Marius Miron:Earth Species Project
- Gagan Narula:Earth Species Project
- Paul Laisné:Earth Species Project
- Anthony L. T. Fine:Earth Species Project
- Benno Weck:Earth Species Project
- Ellen Gilsenan-McMahon:Earth Species Project
- Diane Kim:Earth Species Project
- Laura Hay Mack:Earth Species Project
- Maddie Cusimano:Earth Species Project
- Sara Keen:Earth Species Project
- Lukas Rauch:Earth Species Project
- Benjamin Hoffman:Earth Species Project
- Emmanuel Chemla:Earth Species Project
- Emmanouil Benetos:Queen Mary University of London
- Johan Pauwels:Queen Mary University of London
- Milad Alizadeh:Earth Species Project
- Matthieu Geist:Earth Species Project
- Olivier Pietquin:Earth Species Project
📌 核心摘要
生物声学与动物行为学需要处理大量动物声音,输入是野外录音或裁剪片段,输出包括声学量测量、物种与叫声类型判断、场景内事件计数与时序关系以及按示例适配新类别,难点是标注稀疏、类别长尾且任务形态多样,现有评测只覆盖物种识别等少数标签任务。工作先建立四层任务分类(声学感知、生物类别识别、场景理解、上下文学习),再把馆藏档案的结构化字段用模板转成指令问答,把野外笔记和语谱图描述用 Gemma 4 26B MoE 改写成自然语言问答,最后用强增强合成带精确时间戳和多音频示例的场景以补足计数与推理监督。相对已有方法,关键差异是评测与训练共用同一分类,训练数据同时利用被忽视的行为声学元数据、音频导出量和合成音频,而非只增加物种标签。在 BEANS-Next 上,按层微调后的 NatureLM-audio T2 在哺乳动物出现判断准确率达到 87.9%,高于基线 NatureLM-audio v1.1 的 65.2%,指标越高越好。结论适用于以公开档案为主的类群与录音条件,低信噪比、开放式描述和精确计数仍较弱。训练与评测成本上原文披露每次分层微调用8块NVIDIA H100 80GB,其中第一、四层各约1天、第二、三层各约3天,总计约64个H100天,评测主实验约用4个A100天和1个H100天。
🔗 开源资源
第三方资源:https://earthspecies.github.io/beans-next/ — 链接可访问(HTTP 200)
第三方资源:https://earthspecies.github.io/naturelm-audio-demo → https://earthspecies.github.io/naturelm-audio-demo/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/nvidia/audio-flamingo-next-hf — 暂时无法访问
第三方资源:https://github.com/QwenLM/Qwen3-Omni — 链接可访问(HTTP 200)
第三方资源:https://xeno-canto.org/article/275 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
134. 语音质量预测器有多容易被刷分:修正测量口径、横向比较与打补丁的效果
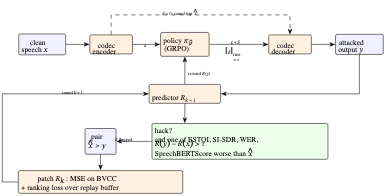
标签:#语音质量评估 | #语音增强 | #对抗训练 | #强化学习 | #基准测试
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ali Alavi:机构信息未在 arXiv HTML 中可靠披露
- Donald S. Williamson:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音质量预测器既做评测工具又做生成模型的奖励,优化它可能抬高分数而不改善听感,本文研究如何度量这种可攻击性以及修补是否有效。方法分三步:用强化学习策略在冻结神经编解码器隐空间加固定大小扰动;用无标签检测器同时检查分数是否超过编解码往返输出并检查独立客观面板是否变差;把命中的样本组成偏好对,用回归加排序损失微调预测器并重复多轮。相对已有攻击,关键差异是把是否算攻击的参照从原始输入改为零扰动往返输出,并报告多个独立训练攻击者中的最差情况。在500条BVCC测试语音、同一扰动强度下,以攻击成功率衡量,NISQA为89.6%,高于UTMOS22的5.7%,奖励选择本身就是鲁棒性决策。在BVCC训练的SSL-MOS及12个域外集上,以平均系统等级相关系数衡量,相对未防御的0.731,单空间三轮修补后降至0.637,多空间版本降至0.552,域外一致性代价明显。上述修补结论仅在EnCodec隐空间内成立,换到未见DAC攻击与白盒波形PGD时不再保持且随机扰动基线相当,修补研究使用3个随机种子共耗费46 A100-hours。攻击样本客观失真较小且未做听音实验,检测面板含神经指标且跨攻击族参照不一致,故结论限于黑盒温和隐空间攻击族和所用检测面板,未验证强攻击与人耳感知层面。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
135. ChainDance:把群舞拆成一个接一个的单人条件生成

英文题目:Breaking the Group Size Barrier: Parameter-Efficient Group Dance Generation with Chain-of-Dancers
标签:#音视频生成 | #参数高效微调 | #音乐 | #图神经网络 | #高效推理
评分:6.5/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jing Xu:机构信息未在 arXiv HTML 中可靠披露
- Cunjian Chen:机构信息未在 arXiv HTML 中可靠披露
- Qiuhong Ke:Department of Data Science and Artificial Intelligence,;Monash University, Australia
📌 核心摘要
群舞生成的输入是音乐片段与可选文字指令,输出是多舞者在多帧上的三维动作序列,难点是多人空间协调与每人身份在时间上的稳定保持。已有联合建模把所有舞者拼接后用变换器一次生成,结构与人数绑定且容易出现身份交换。ChainDance把联合分布按链式法则分解为首舞者边缘分布与后续舞者条件分布的乘积,冻结的单人扩散主干先由音乐生成首舞者运动,再逐个生成后续舞者。角色感知文本编码器提供每人的风格与交互词,组感知运动编码器用距离加权图卷积聚合已生成舞者的空间上下文并作用于领舞特征,下一舞者即在该组上下文与自身文本条件下采样,运动图随新增舞者增量生长。采样完成后冻结网络参数,只对共享扩散噪声做无训练梯度优化,以全局队形约束与成对根节点距离重叠惩罚同时调整全体舞者,减少穿插与队形漂移。在AIOZ-GDance三人群舞评测中相对最强基线TCDiff,组运动真实度GMR越低越好从15.36降到11.63,组运动相关性GMC越高越好从82.77升到83.74。在同一AIOZ-GDance三人群舞相对TCDiff且GMR越低越好、GMC越高越好的比较之外,该结论适用于一至四人音乐对齐群舞,五人测试样本有限故主表只列至四人,原文披露三人群舞每轮训练时间约0:14、推理时间约0:15。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
136. 用俯视小地图帮第一视角模型认路:FloorSAV 解读

英文题目:FloorSAV: Elucidating Spatial Audio-Visual Context with 2D Floormap for AV-LLMs
标签:#音视频问答 | #信号处理 | #基准测试 | #音视频 | #空间音频信号
评分:6.5/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kyeong-Rae Kim:Korea Advanced Institute of Science and Technology
- Sungnyun Kim:Korea Advanced Institute of Science and Technology
- Tae-Hyun Oh:Korea Advanced Institute of Science and Technology
📌 核心摘要
输入是佩戴式设备录制的单目第一人称视频、单声道化的音频和同一时段的多通道声学观测,输出是对动态场景中方向、距离、所在区域、访问顺序和路径关系的回答。难点在于视场狭窄且相机持续运动,全局几何难以从视频恢复,瞬态声源在运动麦克风下定位噪声大。FloorSAV先把三维点云投影为带米制网格的静态俯视底图,再把相机位置朝向、视场角、历史轨迹和声源估计画成彩色标记,形成逐帧与视频同步的空间提示。与已有方法把空间计算放在模型外的离线规则模块不同,该框架把底图作为第二路同步视频连同简短读图指引一起送入音频视觉大语言模型,使模型以第一人称视图为主、空间细节不确定时读取俯视图坐标联合推理,并在覆盖最大的关键帧上用视觉语言模型检测家具门窗等物体并合并为文字标注。在SAVED-Bench上以Gemini-3.6-Flash为模型比较,FloorSAV的总体得分从第一人称视频基线的58.3%提高到65.3%。结论适用于室内日常活动的动态双人场景,声学估计错误、时间定位错误和读错坐标网格都会导致失败。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
137. 不解码怎么做语音决策:冻结大模型的单 token 读出
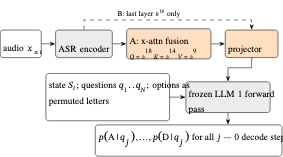
标签:#音频问答 | #Adapter | #基准测试 | #语音情感识别 | #高效推理
评分:6.4/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jie Jin:机构信息未在 arXiv HTML 中可靠披露
- Ziyin Ma:机构信息未在 arXiv HTML 中可靠披露
- Min Yin:机构信息未在 arXiv HTML 中可靠披露
- Jinyu Chen:机构信息未在 arXiv HTML 中可靠披露
- Haigang Song:机构信息未在 arXiv HTML 中可靠披露
- Zhikun Pang:机构信息未在 arXiv HTML 中可靠披露
- Xiaowen Zhang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
全双工语音助手在每次用户说话前后都要回答轮次是否结束、是否为打断、选择哪条填充语、说话人是谁这类封闭问题,现有先转写再自回归生成答案的做法延迟高且丢掉声音里的副语言信息。DuplexJev把冻结的自动语音识别编码器隐状态经小型连接器映射为冻结大语言模型的输入嵌入,把每个问题写成字母选项形式,只做一次前向并在答案位置读取选项词元的分布,不做任何解码采样。内容对齐沿用转录蒸馏使音频输入匹配金色转录本下的分布,决策学习只对读出的答案字母做交叉熵,两类样本按各自损失混合训练,避免只模仿听不见声音的文本教师;跨注意力融合与仅末层两种连接器用于检验线索丢失发生在目标函数还是结构。与在同一引擎上从转录本生成10字段JSON相比,在30条真实语音事件、每事件10个决策的评测中,单词元读出把每事件延迟从1567 ms降到92 ms。在已发布口语问答集qa100共100题的准确率上,末层连接器经两轮1%数据包训练后语音输入为90%,读取标准转录本为91%。跨注意力连接器在性别与情感任务的准确率上从55%和28%均提升到90%,而纯转录蒸馏训练仍停留在接近机遇水平。8卡节点约0.1 s回答8条语音的80个决策,结论适用于离线整句输入,流式逐帧输入与固定时钟轮询尚未验证,训练用了多轮1%数据包与短程副语言阶段。
🔗 开源资源
- 第三方资源:https://github.com/adventists-ai/duplexjev — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
138. 用文字标注和混合约束在真实录音上训练语音增强

标签:#语音增强 | #弱监督学习 | #多任务学习 | #麦克风阵列
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1.1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Liu:机构信息未在 arXiv HTML 中可靠披露
- Jiachen:机构信息未在 arXiv HTML 中可靠披露
- Wu:机构信息未在 arXiv HTML 中可靠披露
- Fulin:机构信息未在 arXiv HTML 中可靠披露
- Wang:机构信息未在 arXiv HTML 中可靠披露
- Zhong-Qiu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
真实录制的含噪混响多通道混合信号缺少配对的干净语音,纯监督模型在仿真数据上训练后迁移到真实环境时识别性能下降明显。混合到混合只要求目标语音估计与非目标信号估计相加能重构观测混合,对哪个输出对应语音约束很弱,降噪不充分。UltraM2M先让同一增强网络对多通道混合输出参考麦克风处的目标语音估计和非目标信号估计,两路估计经前向卷积预测滤波后用于重构各通道混合。对真实混合,混合约束损失约束多通道重构,冻结的自动语音识别损失用标注文本惩罚被指定为语音的第一个输出,从而明确排列并加强降噪。对仿真混合,有监督损失用干净语音与非语音真值约束同一网络的两路输出,每个参数更新同时汇入仿真和真实混合的梯度,使仿真监督锚定目标与非目标的排列,真实数据保持对目标域的适应。在CHiME-4真实录制测试集上,6通道输入的UltraM2M-Whis词错误率为1.90%,低于SuperM2M基线的2.26%,感知质量也有回升。结论适用于有文本标注但无干净参考的平板阵列远场场景,尚未在其他语料或在线解码条件下验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
139. 只用一个编码器对齐声音和画面:LeAVJEPA 的模态缺失视图学习

英文题目:LeAVJEPA: A Minimalist Architecture for Audio-Visual Self-Supervised Learning
标签:#音视频理解 | #音频分类 | #音频检索 | #自监督学习 | #音视频
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Benjamin Robson:机构信息未在 arXiv HTML 中可靠披露
- Santeri Mentu:机构信息未在 arXiv HTML 中可靠披露
- Wenshuai Zhao:机构信息未在 arXiv HTML 中可靠披露
- Arno Solin:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
视频片段同时给出画面流与声音流,二者记录同一事件却经常错位,可见物体可能静默,发声物体可能离开画面,好的表示需要利用双模态,又能在缺失一侧时继续工作。LeAVJEPA先把8秒音频重采样到16kHz转成梅尔频谱经二维卷积得到400个音频词元,把16帧224×224视频经三维卷积得到1568个管状词元,再加位置嵌入、模态类型嵌入与可学习[CLS]词元拼成输入序列。同一片段据此构造两个音视频联合全局视角和两个模态丢弃局部视角(一纯音频、一纯视频),它们仅输入词元不同而共享同一个早期融合视觉变换器与投影器编码到同一表示空间,使局部嵌入成为待对齐的偏侧观测。编码后投影得到的局部嵌入被拉向同一片段全局嵌入的均值中心,偏离中心的平方误差提供不变性约束,偏斜各向同性高斯正则化把跨片段嵌入分布拉向各向同性高斯以防止坍缩。在冻结attentive probe(注意力池化探针)下,AudioSet-20K上音视频联合输入的平均精度均值(mAP)为36.03%,低于同协议下MJEPA ViT-L的42.90%,说明简化目标可用但仍有差距。结论适用于声音事件为主的AudioSet与VGGSound类任务,对遮挡严重或声画无关片段的鲁棒性尚未验证。原文披露AudioSet-2M预训练使用8卡并持续约一百六十到一百九十二小时,未披露推理延迟与部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
140. 固定演奏动作、只换音色:Smorph 的结构锚定声音渐变

标签:#音频生成 | #扩散模型 | #音频交互 | #用户研究
评分:6.4/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Annie Chu:机构信息未在 arXiv HTML 中可靠披露
- Hugo Flores García:机构信息未在 arXiv HTML 中可靠披露
- Johannes Imort:机构信息未在 arXiv HTML 中可靠披露
- Oriol Nieto:机构信息未在 arXiv HTML 中可靠披露
- Bryan Pardo:机构信息未在 arXiv HTML 中可靠披露
- Jordan Rudess:机构信息未在 arXiv HTML 中可靠披露
- Prem Seetharaman:机构信息未在 arXiv HTML 中可靠披露
- Justin Salamon:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
声音变形要求输出从源身份连续过渡到目标身份的中间声音序列,难点是已有扩散变形把时间组织与音色身份一起改变,节奏与音高会随变形漂移。Smorph在冻结文本到音频扩散主干上增加结构引导的组合引导,以源与目标文本提示或音频示例加随时间变化的结构信号为输入,输出保持该结构的多步变形轨迹。引导先以仅含结构条件的预测为锚点得到保持包络或音高走向的基准速度,再相对该锚点加权混合多端点条件形成偏向目标的音色偏移,两者相加得到最终引导速度。该速度直接驱动去噪采样,音频源则经部分加噪初始化进入同一去噪过程以保留细节,生成沿变形参数变化的中间样本。这些样本按变形参数均匀采样预计算成样本库,演奏时再由滑杆或二维画布索引相邻样本并交叉淡化,得到连续可演奏输出。在Clotho-Clotho动态音效提示词到提示词变形、RMS包络控制评测下,显式锚定变体结构保持与目标平滑联合分数Sctrl×Smtgt为0.522,高于无结构控制基线ComposableART的0.316。在同一Clotho-Clotho动态音效提示词到提示词变形、RMS包络控制评测下,该变体净目标相似度增量ΔFLAM为0.359,低于同一无结构控制基线ComposableART的0.415。该结论适用于受控音效与单音符乐器音的包络或音高保持变形,强结构约束可能压制文本语义使目标偏移保守,跨域长时演奏尚未验证;大插值空间在单张A100上十秒内完成的预计算属于交互前开销,原文未披露训练或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
141. 音乐标注模式扩展:零样本预测还是小样本适应

英文题目:Extending Music Annotation Schemas: Zero-Shot Prediction or Few-Shot Adaptation?
标签:#音乐分析 | #迁移学习 | #基准测试 | #少样本 | #0 样本
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Christos Plachouras:机构信息未在 arXiv HTML 中可靠披露
- Emmanouil Benetos:机构信息未在 arXiv HTML 中可靠披露
- Johan Pauwels:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音乐标注扩展指已有曲库带有51个旧属性标注,需要新增7个属性并为全部曲目回填0到1之间的强度评分,难点是专家标注昂贵且新旧属性可能语义疏远。论文构建基于MGPHot的基准,用8、32、128首支援曲目模拟不同标注预算,对比零样本预测、冻结表征上训练线性头、以及继续训练已有卷积网络。零样本分支把属性定义写成文本锚点,用音频文本相似度加权得到连续评分;CLAP相似度回归则保持CLAP冻结、对窗口相似度取均值,在支援集上拟合带截距普通线性回归,对比端点差、两端相似度、五锚相似度后验证选择端点差。有监督分支在冻结音频编码器上学带正则的岭回归头,或解冻最后卷积块并用支援集基属性标签与回放做小幅适应。相对已有工作,关键差异是把音频语言模型(audio-language model,指联合学习音频与文本的模型)、表征复用和持续学习式适应放在同一预算和同一回归指标下比较。与最强零样本对照相比,在MGPHot的两种扩展上支援集均值已取得更低的平均宏均方根误差(macro RMSE,指对7个目标属性的均方根误差再平均,越低越好),冻结头在128首时接近全量监督参考;在全部58个属性上排除疑似预训练重叠曲目后,均方根误差对Music Flamingo上升0.0017,对全量监督卷积网络上升0.0013。结论适用于流行音乐专家评分的回填场景,语义疏远程度的因果解释尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/chrispla/music-schema-extension — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
142. 多语匿名语音还能被认出来吗:声学与内容两类攻击的对比

标签:#音频隐私攻击与防御 | #领域适应 | #说话人验证 | #数据集 | #多语言
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Ridwan Arefeen:机构信息未在 arXiv HTML 中可靠披露
- Ze Li:机构信息未在 arXiv HTML 中可靠披露
- Rong Tong:机构信息未在 arXiv HTML 中可靠披露
- Ming Li:机构信息未在 arXiv HTML 中可靠披露
- Xiaoxiao Miao:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
匿名语音处理希望去掉说话人身份线索,同时保留语言内容,攻击者用自动说话人验证(Automatic Speaker Verification,ASV)尝试重新识别源说话人,等错误率(Equal Error Rate,EER)越低表示攻击越强。已有攻击者研究集中在英语,本文把评估扩展到英语、德语、法语、西班牙语、中文、日语,并区分懒知情攻击者与半知情攻击者,前者未见过目标匿名系统的数据,后者用同系统匿名语音做过适配。评估先用BM1、BM2两种基线把六语原始语音变为匿名语音,匿名语音一路送入声学朝向的WavLM-ECAPA与内容朝向的w2v-BERT-MFA度量重识别EER,另一路转写计算WER/CER以诊断可懂度损失。WavLM-ECAPA融合波形与梅尔滤波器组特征,w2v-BERT-MFA用多尺度特征聚合抽取语义表示,两者先在英语转换语音上训练得到懒知情模型。为补充多语言数据,再用七种语音转换(Voice Conversion,VC)系统合成大规模多语言语料MultiVC,与原训练数据一起重训得到适配后的懒知情攻击者,最后在目标匿名语音上微调得到半知情攻击者。懒知情条件下,BM1基线上WavLM-ECAPA加入MultiVC后平均EER从15.77%降到8.99%,优于内容朝向模型的17.66%,而BM2失真更大时两类模型差距拉大且增益变小。原文未披露训练、推理或部署成本。结论的适用范围限于所测的两种匿名基线和六种语言,东亚语言残留的可懂度约束差距仍未消除。
🔗 开源资源
第三方资源:https://github.com/monkeyDarefeen/DAST — 链接可访问(HTTP 200)
第三方资源:https://github.com/ZXHY-82/LI-MSV-TidyVoice2026 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
143. 从肌肉电信号合成语音:混沌约束与轻量状态空间如何分工

标签:#静默语音接口 | #状态空间模型 | #注意力机制 | #生理信号 | #语音
评分:6.4/10 | 创新 1.3/2 | 技术严谨 0.8/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sajid Fardin Dipto:机构信息未在 arXiv HTML 中可靠披露
- Tarikul Islam Tamiti:机构信息未在 arXiv HTML 中可靠披露
- Luke Baja-Ricketts:机构信息未在 arXiv HTML 中可靠披露
- David Vergano:机构信息未在 arXiv HTML 中可靠披露
- Anomadarshi Barua:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
肌电到语音合成需从面部8通道或6通道肌电时间序列恢复语音波形,输出先为80维梅尔频谱图再经HiFi-GAN声码器还原,难点是肌电与语音非线性错位且发声兼具快速抖动和长程相关。CGS-ETS先用卷积特征提取模块下采样提取局部肌电特征,再送入四层编码器GLAME交替建模全局Mamba状态转移和局部GLARE注意力依赖,最后由声学头预测梅尔频谱图、语言学头预测音素。与依赖重型变换器且只优化帧级重建误差的方法不同,该工作在Mamba中采用李雅普诺夫启发的LyRIC激活增强混沌敏感性,用李雅普诺夫指数正则化和多尺度去趋势波动分析约束预测与目标语音的混沌不变量,并以固定滑动窗口k=32的GLARE注意力替代全局多头注意力。在英语数据集Gaddy and Klein(2020)上经后声码器DTW对齐后逐帧评测,与最强可复算基线Gaddy and Klein(2021)相比,CGS-ETS的对数谱距离LSD为1.08、低于基线的2.25。在同一英语数据集相同对齐评测下与同一基线相比,CGS-ETS的短时客观可懂度STOI为0.61、高于基线的0.13。在同一英语数据集上与基线Gaddy and Klein(2021)相比,CGS-ETS的总参数量为14.34M、低于基线的54.10M,浮点运算量FLOPs为926.6M、低于基线的2400M。结论适用于论文测试的英语和普通话肌电语料,混沌损失只在训练时计算,模型在两块NVIDIA RTX 4090上以FP32训练,推理单批推理时间IT为5.61ms、实时因子RTF为0.0057。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
144. 同时看频谱和时间如何一起变化:DuRe-ST 的语音伪造检测

英文题目:DuRe-ST: Dual-Relation Spectro-Temporal Modeling for Speech Deepfake Detection
标签:#音频深度伪造检测 | #图神经网络 | #注意力机制 | #语音
评分:6.4/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shaole Li:机构信息未在 arXiv HTML 中可靠披露
- Siqing Qin:机构信息未在 arXiv HTML 中可靠披露
- Youzhi Tu:机构信息未在 arXiv HTML 中可靠披露
- Kong Aik Lee:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音深度伪造检测输入为一段语音波形,输出是真实还是合成、转换伪造的二分类判定,难点是合成语音保留自然长时内容,却在时频联合结构留下不自然平滑或不一致。论文先用XLS-R 300M加线性投影和残差卷积编码器得到时频特征H,再经二维自注意力加权汇聚与top-k图池化得到紧凑频谱节点和时间节点,其拼接X同时送入两个关系分支。协方差分支把X的节点视为变量求联合协方差,取绝对值并加自连接和对称度归一化构成亲和图,再用K阶多项式图滤波汇聚直接和多跳邻居得到滤波后表示Z。Z按频谱与时间域拆分后分别做最大幅值和均值池化并经两层感知机得到一向量,注意力分支对同一X沿用AASIST异构图注意力建模域内和跨域关系并结合主节点得另一向量,DuRe-ST拼接两向量后分类,关键差异是显式引入二阶协同变化以补充注意力权重。与XLSR-AASIST相比,在均训练于ASVspoof 2019 LA训练集且不在目标域适配的评测设置下,DuRe-ST在K=1时把ASVspoof 2021 LA和DF的等错误率(equal error rate,EER)分别降到0.93%和2.04%,平均相对下降25.9%,仅增加约4k个后端可训练参数。该结论仅在K=1、2低阶成立,K=3时DuRe-ST在2021 LA恶化至2.17%,协方差单独建模的Cov-ST在2021 DF恶化至7.79%且跨数据集波动更大。跨数据集结论限于给定四个集合与给定公开模型的比较,更换前端、语种、时长信道或允许目标域适配后的效果尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://www.kaggle.com/datasets/mohammedabdeldayem/the-fake-or-real-dataset — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
145. STEMMA:用歌曲出处关系教会大音频语言模型比较多段音乐

英文题目:STEMMA: Song-to-Stem Multi-Audio Reasoning for Large Audio Language Models
标签:#音频推理 | #音乐分析 | #指令微调 | #基准测试 | #数据集
评分:6.4/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Hoyeol Sohn:机构信息未在 arXiv HTML 中可靠披露
- Wonil Kim:机构信息未在 arXiv HTML 中可靠披露
- Keunhyoung Kim:机构信息未在 arXiv HTML 中可靠披露
- Sangeun Kum:机构信息未在 arXiv HTML 中可靠披露
- Taehyoung Kim:机构信息未在 arXiv HTML 中可靠披露
- Dongjoo Moon:机构信息未在 arXiv HTML 中可靠披露
- Theerasak Charoenchob:机构信息未在 arXiv HTML 中可靠披露
- Teeratep Weerapang:机构信息未在 arXiv HTML 中可靠披露
- Jongpil Lee:机构信息未在 arXiv HTML 中可靠披露
- Juhan Nam:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音乐理解常需判断两段摘录是否来自同一首歌、同一段落,或某个分离声部是否属于某段混音,现有大音频语言模型多为单条录音训练,难以在各自输入中定位证据再推断跨输入关系。STEMMA先把每首歌切分为有序段落并分离声部建成目录,每行存储音轨、段落序号、段落类别、声部角色及速度、调性、乐器与流派,使段落与段落声部携带已知来源。接着先声明目标关系再查询目录,一次检索同时取出满足条件的正例与保留部分上下文但违反关系的难负例,标签由目录字段直接决定而不依赖语言模型生成。目录查询结果再按双音频判断或一锚点对四候选的音频多选形式渲染为指令,关系问答与指代对齐两类任务各97272个实例组成STEMMA-Instruct,评测则用MUSDB18、MedleyDB、MoisesDB的authored声部构成300题持留STEMMA-Bench。在STEMMA-Bench结构关系子集上,以准确率为指标,经STEMMA-Instruct微调的Music Flamingo达到0.8189,超过最强的MOSS-Music字幕级联系统0.5039。在同一基准属性关系子集上,以准确率为指标,微调后Music Flamingo最高仅0.3526,高于随机水平的0.25但提升有限,多数系统徘徊在随机线附近。这表明结论仅适用于目录来源直接决定的结构关系,对依赖估计的速度、调性与标签重叠的属性关系可能失败,其偏低或与三拍每分钟、一调标签等细微差异在字幕与音乐信息检索估计中丢失有关。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/hoyso48/STEMMA — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
146. 从看到表情到读懂评估:多模态情绪理解的认知评估推理

英文题目:From Surface to Depth: Towards Cognitive Appraisal Reasoning in Multimodal Emotion Understanding
标签:#语音情感识别 | #混合专家模型 | #多模态学习 | #数据集 | #基准测试
评分:6.4/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Jia Li:Hefei University of Technology
- Yichao He:Hefei University of Technology
- Yangchen Yu:Hefei University of Technology
- Qiankun Li:Nanyang Technological University
- Xinyi Li:Hefei University of Technology
- Baiyi Ye:Hefei University of Technology
- Zhenzhen Hu:Hefei University of Technology
- Richang Hong:Hefei University of Technology
- Erik Cambria:Nanyang Technological University
📌 核心摘要
多模态情绪理解的输入是视频画面、说话人音频与字幕文本,输出是八类情绪标签与解释情绪来源的推理文本,难点在于表情、声音与文字可能隐含、冲突或带有误导,单靠表情到标签的关联容易失效。论文先用与情绪无关的知觉描述记录场景、面部与音频的可观察事实,再要求模型沿目标一致性、应对潜力、责任归因、未来预期、激活水平与行动倾向六个评价维度解释处境含义,最后得出情绪标签。模型侧保留已有的感知能力,只训练稀疏专家承担评价推理,评测侧用评价证据质量分数比较模型证据与人工核验参考的语义相似度。在 CogEmo-Bench 评测集上,CogEmo-MoE 的评价证据质量分数为 70.60,同期 GPT-5.2 为 56.30,情绪准确率为 71.43%,高于 Qwen3-Omni 的 63.10%。结论适用于该基准的八分类与自然分布视频范围,对低频负情绪与跨语言跨文化的覆盖仍然有限。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/MSA-LMC/CogEmo — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
147. Transformer 该往回看多远:民谣乐曲中的重复与拷贝
英文题目:How Far Back Should a Transformer Look? Repetition and Copying in Music Sequence Models
标签:#符号音乐生成 | #自回归模型 | #Transformer | #模型评估
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.5/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Amir Fathi:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
输入是量化到固定网格并只保留最高音的单声部符号音乐序列,输出是下一个token或下一个二值隐步骤的概率分布,难点在于判断更长历史带来的是新信息,还是只重复了已出现过的段落。作者对每个上下文长度单独训练小型因果Transformer并在相同目标位置上比较测试负对数似然,同时训练直接预测token的模型和预测自编码器隐步骤的模型,后者每个隐步骤对应互不重叠的6个token,且注意力带宽被限定为恰好依赖最近T个输入。重复滞后统计记录目标前16个token的历史在窗口内最近一次出现的位置,用于判断重复是否进入可见范围,再用擦除更早出现位置和在测试时截断远端历史检验因果性。在Nottingham民谣相同目标位置的测试中,6个token上下文的token预测器与336个token上下文的相比,测试负对数似然从1.391比特每token降至0.405比特每token,降幅0.986比特每token即71%。在同样Nottingham相同目标位置测试中,简单复制基线与长上下文增益相比,以测试负对数似然衡量恢复了约94%的降幅,而336个token训练模型在测试时截断远端历史则失去大部分增益,O’Neill’s可比长曲上6到336个token的降幅为71%共1.195比特每token、复制基线恢复97%。在两套民谣相同目标位置测试中,短长上下文相比隐预测器的测试负对数似然降幅分别为46%和50%。在MAESTRO演奏和MusicNet乐谱相同目标位置测试中,16个token重复稀少使token预测器6到336个token的总增益更小、仅0.296比特每token和0.445比特每token,且多在96个token内实现并主要来自无重复目标。结论只适用于展开重复记号的乐谱渲染表示,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
148. 把乐谱、波形与算法输出放在同一演奏时间轴上:LayerIt 解读

英文题目:LayerIt: Towards a Framework for Time-Aligned, Composable Music Visualizations
标签:#节拍跟踪 | #信号处理 | #音乐 | #开源工具 | #音乐信息检索
评分:6.3/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.5/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Fernando Azeredo:机构信息未在 arXiv HTML 中可靠披露
- António Sá Pinto:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
论文要解决的是乐谱、录音与音乐信息检索(Music Information Retrieval,MIR)输出分处不同时间坐标、难以放在一起检查的问题。输入是演奏录音、已经变形到演奏时间上的乐谱、音符级对齐关系以及待叠加的数据表示,输出是一个保留乐谱结构的单文件可缩放矢量图形(Scalable Vector Graphics,SVG)。处理过程是先用乐谱时间跨度得到唯一的水平比例尺,各层把样本或帧等原生单位换算成秒后按此比例绘制,再按面板组成纵向堆叠。表示层只负责载入校验与绘图,不改动对齐计算,乐谱直接复制并保留音乐编码倡议(Music Encoding Initiative,MEI)标识层次。演示把德彪西作品的录音、变形乐谱与节拍跟踪(beat tracking)输出叠在一起,用错位位置解释复拍子与自由速度带来的困难。原文未提供可核对的关键定量结果。原文未披露训练、推理或部署成本。适用范围限于已有 MEI 乐谱与外部音符级对齐的情形,对齐或乐谱错误会直接进入图形,密集时频场以光栅形式嵌入而不能像矢量部件那样重设样式。
🔗 开源资源
- 代码相关资源:https://github.com/FernandoAze/LayerIt — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
149. 人声合唱多音高估计要不要用谐波常数 Q 变换

英文题目:Revisiting Input Time-frequency Representations in Multi-pitch Estimation for Vocal Ensembles
标签:#音高与旋律提取 | #时频分析 | #音乐 | #CNN
评分:6.3/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Junyoung Koh:机构信息未在 arXiv HTML 中可靠披露
- Hao-Wen Dong:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
人声合唱多音高估计要求从混缩后的人声波形出发,在每一帧同时估计所有发声的基频,输出为时间与音高二维激活矩阵,难点在于演唱者音域重叠且基频间隔很近,谐波在时频表示上互相交叠。方法取单窗短时傅里叶变换的对数幅度直接作为输入网格,其频带延伸至预测音高上界之外以保留高次谐波内容。该网格先经卷积起始层提取局部时频特征,再送入沿时间建模的编码器,最后由逐帧预测头在细分的对数音高网格上输出音高激活并经阈值判定每帧存在哪些音高。对照的谐波恒Q变换把多个谐波倍率上的恒Q变换堆叠成谐波通道,具有随频率变化的分析窗口和音高对齐的输入网格,而线性短时傅里叶变换取消了这种频率自适应分辨率与谐波对齐结构。在对完整歌曲离线推理、按歌曲汇总并为每个模型单独选择阈值的歌曲级评测中,杰卡佩拉上精确格点匹配的多音高准确率线性短时傅里叶变换卷积编码器为0.683,高于谐波恒Q变换同种编码器的0.648。在同一图形处理器上以相同片段长度重测每轮训练时间时,线性短时傅里叶变换的特征提取开销低于谐波恒Q变换,而加长分析窗或继续扩大频带覆盖并未带来进一步提升。结论适用于独立录制声部叠加混合的离线歌曲级评测,在同室合唱录制的两个数据集上优势不一致,且参考基频主要来自自动提取、多数训练混合不能反映同室合唱的声学与音准互动。
🔗 开源资源
- 第三方资源:https://github.com/Junst/stft-vocal-mpe — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
150. 几何声学仿真做多复杂才够:多声源定位模型的仿真复杂度实验

英文题目:Influence of Geometrical Acoustic Simulator Complexity on a Trained Multisource Localizer
标签:#联合声音事件检测定位 | #声源定位 | #评测协议 | #麦克风阵列 | #空间音频信号
评分:6.3/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Fabian Staub:机构信息未在 arXiv HTML 中可靠披露
- Nils Meyer-Kahlen:机构信息未在 arXiv HTML 中可靠披露
- Thomas Deppisch:机构信息未在 arXiv HTML 中可靠披露
- Sergio de las Heras:机构信息未在 arXiv HTML 中可靠披露
- Florian Klein:机构信息未在 arXiv HTML 中可靠披露
- Stephan Werner:机构信息未在 arXiv HTML 中可靠披露
- Johannes M. Arend:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
学习型多声源定位与检测需要覆盖多种房间声学条件的大规模带标签数据,实测采集成本高,常用几何声学仿真替代训练,但仿真做到多复杂才能在真实房间泛化并不清楚。论文固定以三阶Ambisonics声场表示为输入的卷积循环网络和活动耦合直角坐标到达方向表示,控制镜像源法阶数、扩散晚期混响、传声器阵列建模与镜像源位置随机化生成多组训练集,再到三个实测Eigenmike数据集检验泛化。处理链为几何声学仿真先产出空间房间脉冲响应,再用这些响应与语音卷积生成含多说话人混合语音与混响babble噪声的混合信号,接着从混合信号计算高阶伪强度向量和对数梅尔谱特征并交给定位检测网络估计声源数量与方向。从无混响增加到一阶和二阶镜像源带来大部分泛化增益,十二阶结合实测阵列传递函数与大范围位置扰动的配置优于无混响、低阶及未随机化对照并接近仿真域内水平,但原文未给出可核对的定位误差数值。在Apple MacBook Pro(M1 Pro芯片、16 GB内存)上按1000个房间平均的单房间平均空间房间脉冲响应仿真耗时为镜像源1阶0.49秒、2阶0.55秒、12阶1.26秒,12阶明显高于1阶和2阶。在相同机器的直接声和12阶反射仿真下,基于实测阵列传递函数的仿真整体运行时间比对应球谐域仿真慢40倍以上,额外开销相对性能增益并不总是值得。结论适用于鞋盒假设下的几何仿真与语音声源,对波形级仿真或非语音事件尚未验证;原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/Fabian-Staub/acoustic-simulation-complexity-ssld — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
151. 参考情感如何在基于大语言模型的语音合成中被定位与传递

英文题目:Tracing a Sparse Emotion-Control Circuit in LLM-Based Text-to-Speech
标签:#文本到语音 | #韵律与风格控制 | #语音 | #统计分析 | #可解释性
评分:6.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hongfei Du:机构信息未在 arXiv HTML 中可靠披露
- Jiacheng Shi:机构信息未在 arXiv HTML 中可靠披露
- Yanfu Zhang:机构信息未在 arXiv HTML 中可靠披露
- Ye Gao:Department of Computer Science, William & Mary, Williamsburg, USA
📌 核心摘要
基于大语言模型的文本到语音系统能根据参考音频生成带情感的语音,但参考情感经由哪些内部位置进入生成过程并不清楚,情感效应分散在很长的编解码器token序列上,解码后才变成可听波形。论文先构造文本和说话人设置相同、仅情感参考不同的中性与情感配对合成,再定义编解码器轨迹分数与晚期残差方向分数来度量补丁轨迹向情感方向的移动。定位显示情感来源集中在条件前缀,随后用梯度归因筛选注意力头与多层感知机输出,再在验证对上做充分性与必要性干预。与已有回答token打分的电路工作不同,该方法对整个生成轨迹和晚期残差状态打分,并把内部效应与解码波形对照。在每种情感8个验证合成对上,以晚期情感读数偏移恢复率为指标,冻结的23至27个组件取得0.736–0.876,超过规模匹配的20组随机组件集平均0.278–0.421。在每种情感24个匹配对的解码波形评测中,以F0变化为指标,读数匹配的残差方向基线仅产生组件干预17%–27%的效果,低于组件干预。结论限于匹配参考条件、贪婪解码和IndexTTS2主干,跨说话人、跨语言和多参考文件的泛化尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
152. 为朗读录制而修的约鲁巴语句子:ÌròyìnSpeech 文本部分是怎么来的
英文题目:The ÌròyìnSpeech Text Corpus: 24,905 Curated Yorùbá Sentences for Speech and Language Technology
标签:#文本到语音 | #数据集构建 | #数据集 | #低资源
评分:6.3/10 | 创新 1/2 | 技术严谨 0.8/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Kola Tubosun:机构信息未在 arXiv HTML 中可靠披露
- Aanuoluwapo Aremu:机构信息未在 arXiv HTML 中可靠披露
- Tolulope Ogunremi:机构信息未在 arXiv HTML 中可靠披露
- Iroro Orife:机构信息未在 arXiv HTML 中可靠披露
- David Ifeoluwa Adelani:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
约鲁巴语可用文本长期以圣经及耶和华见证人翻译为主,网络爬取文本又常缺失声调符号,导致模型难处理当代口语与新闻语域。ÌròyìnSpeech项目为录制录音室语音先整理了可朗读提示句,本文发布其中的文本部分以提供当代全调世俗文本。来源收集把MENYO-20k与MasakhaNER约鲁巴语部分的新闻句子,与依据未发表短篇小说改写和新写的句子合并,形成覆盖新闻与小说语域的初稿。人工编辑承接上述初稿逐词核对声调符号和下圆点,缩短难读长句并改写宗教与冒犯性表达,再把非约鲁巴语人名地名本地化为约鲁巴语形式,输出可直接朗读的提示集。在2022年工作文件共25001行的同一清洗计数下以句行数量为指标,清洗前25001行高于去除96个完全重复后保留的24905句唯一句子,且其中15451行不符合NFC规范化形式的问题规模高于35句误用U+0329编码问题的35句,以上为语料质量清洗结果,不是模型性能实验。二次检查承接可朗读提示集统一规范化形式并标记少词与字符集越界等残留问题,使文本可直接用于声调符号恢复、字音转换、语音合成前端和正字法研究。该语料仅覆盖尼日利亚标准约鲁巴语朗读新闻与改写小说语域,不适合作为事实记录,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://aclanthology.org/2021.mtsummit-research.6/ — 链接可访问(HTTP 200)
第三方资源:https://doi.org/10.18653/v1/2022.emnlp-main.298 → https://aclanthology.org/2022.emnlp-main.298/ — 链接可访问(HTTP 200)
第三方资源:https://aclanthology.org/2020.lrec-1.520/ — 链接可访问(HTTP 200)
第三方资源:https://doi.org/10.18653/v1/P19-1310 → https://aclanthology.org/P19-1310/ — 链接可访问(HTTP 200)
第三方资源:https://aclanthology.org/2024.lrec-main.812/ — 链接可访问(HTTP 200)
第三方资源:https://doi.org/10.21437/Interspeech.2020-1096 → https://www.isca-archive.org/interspeech_2020/gutkin20_interspeech.html — 链接可访问(HTTP 200)
第三方资源:https://doi.org/10.21437/Interspeech.2022-10850 → https://www.isca-archive.org/interspeech_2022/meyer22c_interspeech.html — 链接可访问(HTTP 200)
第三方资源:https://arxiv.org/abs/2609.33734 — 链接可访问(HTTP 200)
第三方资源:https://arxiv.org/abs/2609.38627 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
153. 让智能体自己做多模态后训练:任务、流程与成败如何衡量

英文题目:MMPostTrainBench: Benchmarking Autonomous Research for Multimodal Post-Training
标签:#音视频问答 | #基准设计 | #基准测试 | #后训练 | #音视频
评分:6.3/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Yuxin Liu:机构信息未在 arXiv HTML 中可靠披露
- Yuxuan Wang:机构信息未在 arXiv HTML 中可靠披露
- Zhenxin Lei:机构信息未在 arXiv HTML 中可靠披露
- Lingchen Meng:机构信息未在 arXiv HTML 中可靠披露
- Yuchong Sun:机构信息未在 arXiv HTML 中可靠披露
- Junming Lin:机构信息未在 arXiv HTML 中可靠披露
- Hongcheng Liu:机构信息未在 arXiv HTML 中可靠披露
- Yunfei Chu:机构信息未在 arXiv HTML 中可靠披露
- Qize Yang:机构信息未在 arXiv HTML 中可靠披露
- Jin Xu:机构信息未在 arXiv HTML 中可靠披露
- Lei Zhang:机构信息未在 arXiv HTML 中可靠披露
- Zhendong Mao:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
本文研究智能体能否在固定预算下自主改善多模态模型的看、听与推理能力并保持改进。输入是目标能力描述、通用基座模型Qwen3-Omni-30B-A3B-Instruct、允许的训练数据源与开发反馈,输出是冻结提交模型在密封held-out测试上的成绩与研究轨迹。难点在于野外媒体杂乱、背景声与描述缺失使证据难定位,标签与音画时间对齐易破坏,长时训练与评测也挤占预算。基准MMPostTrainBench用八任务包隔离开发反馈与最终测试并统一评测提交模型。MMResearch在原有代码智能体运行时上先做媒体证据锚定,将观察锚定到源媒体并连到假设、干预与开发结果以形成带证据的诊断,诊断与round结果再经分层记忆跨轮携带成功配方与失败记录供后轮检索复用,记忆指导下产出的候选最后由开发评测引导的模型保留选出交付模型。六组智能体八任务共48个模型任务三轮均值任务得分中有52.1%低于基座,最大平均增益仅0.73个百分点。MMResearch使Claude Opus 4.8在OmniVideoBench提交准确率从31.86%提高到39.61%,较同运行时基线高7.75个百分点,该结论限于所测任务划分与每轮24小时八卡训练设置,视频与跨模态保持仍易失败,诚信审计发现标签捷径嫌疑,原文以小时与百万token为口径披露训练时间与智能体token开销,未披露货币成本。
🔗 开源资源
- 第三方资源:https://github.com/sod1010/MMPostTrainBench — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
154. SimAuthor:在微弱实证反馈下持续改写可执行生物医学仿真器

英文题目:SimAuthor: Harnessing Foundation Models for Persistent Scientific Simulator Authoring
标签:#音频生成 | #工具增强与约束解码 | #生理信号 | #医疗音频
评分:6.3/10 | 创新 1.5/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yishan Wang:机构信息未在 arXiv HTML 中可靠披露
- Ran Piao:机构信息未在 arXiv HTML 中可靠披露
- Mathias Funk:机构信息未在 arXiv HTML 中可靠披露
- Aaqib Saeed:Eindhoven University of Technology
📌 核心摘要
本文研究如何让基础模型编写科学仿真器,输入是少量真实生物医学记录和自然语言条件描述,输出是可执行、可检查、可调参的Python仿真程序,难点在于没有唯一正确答案和精确测试,只能用仿真分布与真实分布的差异做弱反馈修订。SimAuthor维护候选程序池,先用基于排序的PUCT策略选中待修订父程序,再把科学蓝图、结构化差异报告与可视化对比一起送入精炼器做一次聚焦改写,改写产物经评估计分后回流到池中参与下一轮选择,其中相对父代显著改进的子程序再经机制抽取形成可复用条目,供后续改写调用,从而形成选择—改写—评估回流—记忆的闭环。相对独立重复采样、只给标量分数的PUCT分数搜索和只优化文字策略后重新生成的文本策略优化,SimAuthor保留并累积可执行产物本身及其实现机制。在100次尝试预算下,SimAuthor在室间隔缺损等六个任务中的五个上取得最高终点分数,例如慢性阻塞性肺疾病任务终点分数为0.672,高于文本策略优化的0.549。作者也报告了留出记录、独立预训练表示和心电图下游分类上的泛化,但心电图下游与创作共用同一编码器ECGFounder,结论限于任务对齐的实用性。在推理成本上,同100次尝试下SimAuthor约使用独立采样3.8倍token,原文另以约380个采样提案做token匹配比较,差距仍未弥合,该比较限于作者调用预算,不涉及货币费用或部署延迟。
🔗 开源资源
第三方资源:https://github.com/yishani/SimAuthor — 链接可访问(HTTP 200)
第三方资源:https://yishani.github.io/SimAuthor → https://yishani.github.io/SimAuthor/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
155. Lyric:把频率分选搬进声波域的低功耗口语数字识别

英文题目:Lyric: Wave-Domain Computing for Efficient Spoken-Digit Recognition
标签:#关键词检测 | #信号处理 | #高效推理 | #实时处理
评分:6.3/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Jeeven Balasubramaniam:机构信息未在 arXiv HTML 中可靠披露
- Nakul Garg:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
该任务的输入是在空气中传播的语音,输出是孤立数字标签,难点是在丢弃可重构波形细节后仍保留区分不同说话人发音的频谱与时序线索。Lyric先让语音直接驱动五个调谐不同的无源亥姆霍兹共振器(Helmholtz resonators)做频率选择,腔内麦克风拾取各腔共振压力,形成以通道身份携带粗略频率位置的声学响应。模拟交流有效值电路对每路响应做10 ms积分以提取缓慢幅度包络,五路包络以每通道100样本/秒数字化后送入因果时序网络做整句平均判决,该路径省去数字分帧、快速傅里叶变换、Mel滤波和对数压缩。在说话人互斥的AudioMNIST实测中,EdgeSpeechNet-A的准确率从40通道对数Mel频谱(log-Mel spectrogram)输入的99.28%变为Lyric输入的95.70%,在Raspberry Pi 4上预处理加推理时延从454.31 ms降至6.56 ms。与先保留完整波形再做数字谱特征的管线相比,关键差异是将谱滤波搬入无源声学结构,使模数转换只需采集缓慢包络而非声载波,从而大幅减少处理器接收的数据与处理量。结论只适用于该回放录音的孤立数字测试,未验证连续语音与总体系统能耗,原文未披露训练成本,推理侧只估算了处理器动态能耗而排除了麦克风、模拟电路、模数转换与采集等待。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
156. 用自举集成模拟听音小组:同时给出平均分、分布与区间
英文题目:Ensemble-Based Perceptual Audio Quality Assessment with Confidence Intervals
标签:#音频质量评估 | #集成学习 | #不确定性估计与校准 | #信号处理
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Pablo M. Delgado:机构信息未在 arXiv HTML 中可靠披露
- Andreas Brendel:机构信息未在 arXiv HTML 中可靠披露
- Konstantin Schmidt:机构信息未在 arXiv HTML 中可靠披露
- Jürgen Herre:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
听音测试对每个刺激收集多人打分,可得出平均意见分、置信区间和条件间差异是否显著,而多数客观音频质量测量只输出点估计,无法说明预测不确定性。论文输入参考信号与待测信号对,先用不可训练的感知前端提取11个失真指标,再经50个自助采样训练的低容量回归器得到50个分数,最后做全局仿射均值校准和宽度缩放,输出校准后的人工听音人分数分布、均值和模拟相同听音人数的区间。与预设高斯等分布形态的参数化听众模型和端到端深度方法不同,该方法不预设分布形态、不学习深度表征,只复用固定感知特征和公开数据。在SEBASS-DB子集上校准把区间覆盖率从0.28-0.31提高到0.69-0.82,平均Kolmogorov-Smirnov差异从0.46-0.50降到0.28-0.33,同时MOS相关基本不变。跨域到音频编码数据时覆盖率仍低于名义0.95,ODAQ上为0.47,USAC上仅0.33-0.43,校准后宽度放大使成对检验更保守、显著对召回下降,说明仅校准边缘分布不能保证成对推断正确。结论适用边界是训练仅用公开SEBASS-DB分离源数据,当编码器、码率和内容与USAC等条件失配,或需保留听音人内跨条件相关和特定试验设计时,区间与显著性判断可能失效,这部分尚未用独立听音测试验证。因此系统只适合做不确定性筛查和优先安排听音测试,不能替代面板级假设检验。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://www.mmsp.ece.mcgill.ca/Documents/Software/ — 链接可访问(HTTP 200)
第三方资源:https://scikit-learn.org/ — 链接可访问(HTTP 200)
第三方资源:https://pypi.org/project/py-earth2/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
157. 噪声下让合成语音更清楚:动态激活 steering 的做法与证据

标签:#文本到语音 | #测试时自适应 | #多语言 | #流式处理 | #语音
评分:6.3/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Seymanur Akti:机构信息未在 arXiv HTML 中可靠披露
- Alexander Waibel:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
噪声环境会降低语音可懂度,人类会自然提高发声力度并把发音做得更清晰,论文研究文本到语音(Text-to-Speech,TTS)模型能否在不重新训练的情况下复现这种适应。输入是待合成文本和一段参考语音,输出是更易在噪声中听清的合成语音,难点是在自回归生成中持续施加控制会让效应逐词累积并造成失真。方法先用同一说话人、同一文本但风格不同的配对合成样本取隐状态平均差,分别得到发声力度和超清晰发音的层级向量,再按系数加权合并为联合方向。处理参考语音时把其隐状态投影到该联合方向上取平均作为基线,在第19-20层生成时只补充当前词投影与目标投影的残差并保持隐状态模长,残差为负时可使状态回落,从而把联合方向同时用于定基线和定向纠偏。流式模式下可在句中打开或关闭强度,实现句内动态调节,与需要训练或固定信号变换的Lombard合成相比,该做法支持双属性联合、连续和句内动态调节。在Expresso四说话人Harvard句合成评测中,与未转向基线相比,高强度转向把字错率(Word Error Rate,WER,越低越好)从1.89降至1.22,说话人相似度从0.90略降至0.89。结论适用于所测英语、德语、西班牙语、日语范围,日语等语言的元音空间面积变化不大,超清晰发音的跨语言精确控制仍需校准;原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://seymanurakti.github.io/loud-and-clear/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
158. 用音素预热两端:低资源语音识别的音素引导初始化

英文题目:Phoneme-Guided Initialization for LLM-based Speech Recognition
标签:#语音识别 | #迁移学习 | #大语言模型 | #低资源
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ryo Magoshi:机构信息未在 arXiv HTML 中可靠披露
- Shinsuke Sakai:机构信息未在 arXiv HTML 中可靠披露
- Tatsuya Kawahara:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
自动语音识别要把连续语音波形转写为目标文字,大语言模型加音频编码器的连续式结构在配对语音文本稀缺时难以对齐声学相似与语义相似两套表示。论文提出音素引导初始化,先把音频编码器在语音到音素任务上训练,再把大语言模型在音素到字形任务上微调,之后用投影层连接并在目标语音识别任务上分阶段端到端微调。编码器以语音波形为输入,用CTC损失预测音素序列,音素可由字形转写经字形到音素工具得到,任务比直接预测字形更简单。大语言模型以文本提示中的音素序列为输入自回归生成对应字形序列,只用外部文本语料,不需语音数据,使两侧参数都预先拉向音素层表示。两部分经随机初始化的投影层连接,投影层先4倍时间降采样再经多层感知机映射为音频嵌入,与文本提示一起送入大语言模型,先只更新编码器和投影层,再联合微调全部参数,初始化后推理仍只输出字形,不强制输出音素。在爱知谢尔-1(AISHELL-1)10小时训练的测试集上,字符错误率(CER)上所提Base+P2G为11.1%,低于端到端基线Base的39.1%。结论适用于同音多、字形与读音差距大的日汉低资源情形,在鞑靼语和乌尔都语上改善有限。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
159. SwinDS-BWE:用局部窗口生成器与尾部事件判别器做语音带宽扩展

标签:#带宽扩展 | #生成对抗网络 | #Transformer | #语音 | #高效推理
评分:6.3/10 | 创新 1.4/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tarikul Islam Tamiti:机构信息未在 arXiv HTML 中可靠披露
- Sajid Fardin Dipto:机构信息未在 arXiv HTML 中可靠披露
- Luke Baja-Ricketts:机构信息未在 arXiv HTML 中可靠披露
- David Vergano:机构信息未在 arXiv HTML 中可靠披露
- Anomadarshi Barua:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音带宽扩展输入为缺失高频的窄带语音,输出为补全高频的宽带波形,难点是高频失效短暂且集中在少数帧,平均误差容易掩盖这些可感知的破损,而一味增强高频又会产生虚假明亮感。该方法先把窄带幅度与相位分别嵌入为幅度流与相位流,用两次格点式Swin-1D块先精炼相位,再以可学习系数耦合到幅度,幅度精炼后再耦合回相位,形成交替迭代。其中窗口注意力只在局部窗口内计算,再靠移位实现跨窗信息流动,从而以随序列长度线性的注意力代价保留局部建模能力。三个决策科学启发的判别器提供互补监督,条件风险价值判别器强调最差高频片段,机会约束高频判别器用平滑壁垒抑制过高高频能量占比,多准则效用判别器学习平坦度、质心与滚降的凸权重。消融显示三类判别器侧重感知增益、能量正则与纹理稳定,需与全局幅度相位判别反馈配对,才能集中修复稀疏高频失效。与AP-BWE相比,本方法在VCTK清晰集4-16 kHz上NISQA-MOS从3.86提高到4.24。在VCTK清晰集4-16 kHz相同比较下总参数量从72M降到18.5M,结论还适用于英语VCTK与法语MLS的多个扩展带宽及含噪VCTK,窄带到宽带间隔越小指标越好,训练成本为单张NVIDIA RTX 4090上50轮,推理实时因子略高于基线但仍实时。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
160. 不用方言录音也能让语音语言模型听懂方言

英文题目:Dialect-Robust Speech Language Models with Synthetic Pseudo-Dialect Augmentation
标签:#语音翻译 | #数据增强 | #多任务学习 | #口音与方言 | #语音大模型
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shunsuke Mitsumori:机构信息未在 arXiv HTML 中可靠披露
- Tomoya Mizumoto:机构信息未在 arXiv HTML 中可靠披露
- Yusuke Fujita:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
方言语音到英语翻译的输入是真实方言录音,输出是英语译文,难点在于方言训练语音稀缺,而方言在词汇语法和发音上都偏离标准语。论文先用大语言模型把标准语转写改写为伪方言文本,再用标准语文本到语音模型合成伪方言语音,提供方言语言特征监督,该框架合成方言语音不需要任何真实方言语音,也不需要为每种方言训练专用文本到语音模型。合成过程天然保留对应的标准语文本,训练时模型先预测标准语文本,再预测英语译文,把方言输入映射到后端大语言模型更擅长推理的语义空间。在以真实日语方言语音为输入的方言到英语翻译评测中,以BLEU为指标,伪方言语音增强得分从25.38提高到26.24,超过合成标准语语音基线。同样以真实德语方言语音为输入的方言到英语翻译评测中,以BLEU为指标,伪方言增强得分从31.57提高到32.47,超过合成标准语语音基线。在伪方言增强数据上增加标准语中间预测后,以真实方言语音为输入的方言到英语翻译评测中,以BLEU为指标,日语得分进一步提高到28.26,中文得分从11.67提高到16.37,均高于只直接预测英语译文的对应设置。该结论的边界在于中文伪方言语音增强基本无效,标准文本到语音模型难以合成有区别的方言读音,德语增加中间文本预测也未带来增益,同时经两段中间预测的设置在三种语言上均下降,尚未验证低资源方言文本翻译质量不足和方言口音合成不真时的效果。原文披露了各语言在8块NVIDIA H100上的训练耗时,伪方言增强约使训练时间翻倍,未披露推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
161. 跨语言说话人确认:用自监督预训练模型提取与语言无关的声纹

英文题目:Cross-Lingual Speaker Verification with Self-Supervised Pre-Trained Models
标签:#说话人验证 | #自监督学习 | #跨语言 | #多语言
评分:6.3/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Jinghan Peng:机构信息未在 arXiv HTML 中可靠披露
- Yu Zheng:机构信息未在 arXiv HTML 中可靠披露
- Weiqiang Wang:机构信息未在 arXiv HTML 中可靠披露
- Jian Liu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
说话人验证要求判断两段语音是否来自同一说话人,跨语言场景的难点是注册与测试使用不同语言时,说话人特征会被语言相关的声学内容干扰。本文输入为语音波形提取的对数梅尔滤波器组等声学特征,输出为固定维度的说话人嵌入向量,验证时比较两个嵌入的相似度。系统先将该特征送入w2v-BERT 2.0,取出全部隐藏层表示,以复用在大规模多语言无标注语音上学到的声学与音素知识。各层表示再经两层多层感知机适配器统一到256维,并用通道拼接做多尺度融合,得到融合后的帧级特征。融合特征经注意力统计池化汇聚为话语级表示,再经嵌入投影层得到256维说话人嵌入,用加性角度间隔Softmax损失优化。训练分三阶段衔接:先冻结主干只训下游模块,再解冻全量微调,最后仅在TidyVoiceX_Train上用6秒长语音大间隔微调,逐步适配声纹任务。在相同训练数据下,w2v-BERT 2.0系统经质量度量函数校准后在全未见语言的tv26_eval-U上等错误率(Equal Error Rate,EER)为2.84%,优于ReDimNet-B6的3.43%;三系统分数融合后在tv26_eval-A和tv26_eval-U上EER分别为2.21%和2.99%。结论适用于TidyVoice2026定义的部分失配与完全失配划分,尚不能推广到其他跨语言基准。原文未披露训练时长与硬件,推理代价以2秒语音、用THOP统计的58.43 GMACs报告。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
162. 无参考清唱跑调修正:只听自己如何判断该不该修、修几度

英文题目:Reference-Free Singing Pitch Correction via Music-Constrained Sequence Editing
标签:#语音编辑 | #Adapter | #音乐 | #音高与旋律提取 | #主观评测
评分:6.3/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Biao Dong:机构信息未在 arXiv HTML 中可靠披露
- Jiajun Li:机构信息未在 arXiv HTML 中可靠披露
- Binzhen Zhu:机构信息未在 arXiv HTML 中可靠披露
- Mingwei Yi:机构信息未在 arXiv HTML 中可靠披露
- Tong Liu:机构信息未在 arXiv HTML 中可靠披露
- Yuanhao Zhang:机构信息未在 arXiv HTML 中可靠披露
- Jiqing Han:机构信息未在 arXiv HTML 中可靠披露
- Yongjun He:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
无参考歌唱修音的输入是无伴奏清唱录音,输出是保持音符时值与起止位置不变、只修改音高的演唱,难点在于没有目标旋律和伴奏时须仅凭上下文判断每个音符是否跑调以及修正多少半音。论文先用歌唱转录提取音高、起始与时值并量化为离散半音,补全八元组字段后形成歌唱MIDI序列,符号修正后再经半音移调与重合成恢复基频轮廓。冻结的MusicBERT作为预训练符号音乐编码器提供上下文表示,轻量歌唱适配器使其适配歌唱MIDI特性,输出的逐音符上下文向量直接进入修正决策。两个修正头构成因子化音高编辑分布,分别估计需要修正的概率和在正负三半音内有符号偏移分布,零值对应保持原音高。由输入序列的时长加权音级直方图经Krumhansl-Schmuckler算法估计调性先验,再以验证集选定的强度对候选偏移重排,使模糊候选偏向调性和谐的修正。在80首留出测试歌曲共30682个音符的真实业余与专业配对录音上,方法把音符级半音准确率从73.25%提高到83.43%,高于同语料复现的BERT-APC基线3.99个百分点。结论只适用于单声部、中英文流行歌范围内的短时偏移修正,密集跑调或调性模糊时仍可能误判。原文未披露训练、推理或部署成本。
🔗 开源资源
- 演示资源:https://dongb001.github.io/RF-SPC/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
163. Evi-VN:只给难样本补证据的图欺诈检测增强框架

英文题目:Evi-VN: Hard Region Guided Virtual Node Evidence Injection for GNN-Based Fraud Detection
标签:#音频分类 | #图神经网络 | #多模态学习
评分:6.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jiran Tao:机构信息未在 arXiv HTML 中可靠披露
- Yifan Wu:机构信息未在 arXiv HTML 中可靠披露
- Binyan Jiang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
在线欺诈中伪装账号模仿正常连接和属性,图神经网络在图邻域上难以区分伪装欺诈者和异常正常用户,论文把多骨干在训练折外预测上共同出错或不确定的节点定义为共有难区。Evi-VN不替换原检测器,路由器用外部证据链估计节点是否属于难区,先验生成器只在被路由的难节点上输出校准后的类别先验,再由正负两个虚拟类别节点以单向边注入增强图。增强图与原图分别经过目标骨干得到分数,五维标量终结器做最终判定,证据特征从不拼入图输入矩阵。在MGTAB目标除外共识难节点配对评测中,难节点子集准确率骨干基线为52.97、Evi-VN为66.79,Evi-VN高13.82个百分点,平均自13个骨干。在跨数据集同划分同图输入配对评测中,TeleAntiFraud-28k上13个骨干平均准确率骨干基线为0.5806、Evi-VN为0.9353,Evi-VN更高。在同一跨数据集配对评测中,FraudBench六个生成器图平均准确率骨干基线为0.8275、Evi-VN为0.9780,Evi-VN更高而接近饱和。作者承认FraudBench文本高度可分、TeleAntiFraud为合成且以转录为主,完整流水线多种子重跑成本较高,故饱和与大幅提升结论仅适用于上述数据构造与单划分设置。原文给出硬件环境为Windows 11、i7-14650HX、RTX 5070 Ti Laptop,未披露训练时长与推理延迟。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
164. 城市尺度步行视频里的空间与声音推理:Perception Test 2026 四赛道总结

英文题目:Perception Test 2026: Challenge Summary and Extension to City-scale Audio-Visual Reasoning
标签:#音视频问答 | #基准设计 | #基准测试 | #数据集
评分:6.3/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Fedor Kitashov:Google DeepMind
- João Carreira:Google DeepMind
- Shiry Ginosar:Toyota Technological Institute at Chicago
- Dima Damen:Google DeepMind;University of Bristol
- Andrew Zisserman:Google DeepMind;University of Oxford
- Viorica Pătrăucean:Google DeepMind
📌 核心摘要
这篇报告总结在欧洲计算机视觉会议(European Conference on Computer Vision,ECCV)2026 举办的第四届 Perception Test 挑战,输入是桌面尺度短视频与城市步行游览长视频,输出是选择题答案或被问及物体的视频轨迹,难点在于长距离空间记忆、声音与画面跨模态关联以及超长视频检索。原有统一视频问答(Unified VideoQA)与接地视频问答(Grounded VideoQA)沿用 Perception Test 数据,新增 KilometerVision 考察地图轨迹与地标距离等城市空间判断,新增 KilometerAudio 要求在 1 小时至 3 小时步行视频中结合声音与画面回答问题。优胜方案多为零样本智能体流程,负责建立时间戳证据日志、调用语音转写与声音事件索引或三维重建工具,再由视觉语言模型(Vision-Language Model,VLM)综合作答,与以往单模型直接作答形成差异。城市尺度赛道上,获得奖项资格的最好成绩在 KilometerAudio 测试集 500 题上达到 0.782 的首位准确率,在 KilometerVision 测试集 986 题上达到 0.753 的首位准确率,而无获奖资格的 CloudAI-evolve 分别达到 0.864 和 0.905,显示工具编排已能逼近饱和但通用单模型仍落后。结论适用于本次公开排行榜与给定视频来源,对未见城市、其他语言语音与实时部署尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://perception-test-challenge.github.io/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
165. Syn-Omni:共享与专家分工加渐进协作的全模态检索向量

英文题目:Syn-Omni: Structured Specialization and Progressive Collaboration for Omnimodal Embeddings
标签:#音频检索 | #音视频问答 | #混合专家模型 | #对比学习 | #LoRA
评分:6.3/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Youngtaek Oh:KAIST;Sony Group Corporation
- Qiyu Wu:Sony Group Corporation
- Hiromi Wakaki:Sony Group Corporation
- Junmo Kim:KAIST
- Yuki Mitsufuji:Sony Group Corporation
📌 核心摘要
全方位多模态嵌入要把文本、图像、视频、音频及其组合映射到同一向量空间,难点是不同模态既有公共语义又有各自信号特性,单一共享适配容易抹掉模态特性,完全独立训练又失去跨模态联系。Syn-Omni在Qwen-2.5-Omni主干上引入正交模态专家低秩适配,用一条共享路径学习通用语义,用多条模态专家路径学习模态特性,两路输出相加得到适配后表示,正交约束减少两类表示混叠。路由器依据输入的模态组成输出各专家融合权重,渐进协同路由按训练进度先让出现模态独占对应专家以形成分工,再逐渐放开权重让缺失模态专家参与协作。融合权重由协同间隔损失约束,只要求出现模态权重高于缺失模态一个间隔,保留缺失专家参与。与同数据同设置的共享低秩适配基线Uni-Omni相比,在涵盖图像、视频、音频和视听的81个任务评测中,3B规模总体平均Hit@1为Syn-Omni49.4%对Uni-Omni47.7%更高,7B规模总体平均Hit@1为Syn-Omni51.6%对Uni-Omni50.7%更高,提升主要来自音频和视听组合任务。该结论适用于论文自建的图像、视频、音频和视听评测组合,其中视频单项提升有限。在VALOR-32k视听输入、单张NVIDIA RTX A6000、批量大小为1的测量下,3B规模Syn-Omni相对Uni-Omni平均延迟从300.3 ms增至354.6 ms,同一测量下峰值显存从9612 MB变为9676 MB。
🔗 开源资源
论文首页资源:https://github.com/sony/syn-omni — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/TIGER-Lab/MMEB-train — 暂时无法访问
第三方资源:https://huggingface.co/datasets/ShareGPTVideo/train_video_and_instruction — 暂时无法访问
第三方资源:https://huggingface.co/datasets/facebook/PE-Video — 暂时无法访问
第三方资源:https://github.com/May2333/FDCA — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/datasets/CLAPv2/audiocaps — 暂时无法访问
第三方资源:https://huggingface.co/datasets/cvssp/WavCaps — 暂时无法访问
第三方资源:https://huggingface.co/datasets/CLAPv2/audioset_strong — 暂时无法访问
第三方资源:https://huggingface.co/datasets/amaai-lab/MusicBench — 暂时无法访问
第三方资源:https://huggingface.co/datasets/m-a-p/Music-Instruct — 暂时无法访问
第三方资源:https://research.google.com/audioset/ — 暂时无法访问
第三方资源:https://github.com/CASIA-IVA-Lab/VAST — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
166. 完全离线的语音交互如何在树莓派和 Jetson 上跑起小语言模型

标签:#语音交互 | #语音识别 | #模型量化 | #基准测试
评分:6.2/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Sunday Afariogun:Awarri Technologies Limited
- Odunolaoluwa Jenrola:Awarri Technologies Limited
- Zeinab Nezami:GSM Association
📌 核心摘要
本文解决非洲多语言社区在无网络或弱网络下依赖语音交互的问题,系统输入为16 kHz单声道语音,输出为语音答复,难点是2-5B参数语言模型在内存、算力、功耗受限设备上保持可用速度与多语言质量。音频采集与预处理把麦克风信号归一为统一格式后送入本地语音识别,识别文本经语言模型生成答复文本,再由语音合成转回波形,编排控制模块负责超时、回退与逐轮日志采集。量化流程把Hugging Face检查点转为GGUF并生成Q4_K_M、Q5_K_M、Q8_0制品,在llama.cpp下实测吞吐、内存与功耗,质量用MasakhaNEWS主题分类准确率与相对全精度参考的困惑度漂移联合判断。与全精度参考相比,Q4_K_M在Jetson Orin NX上把解码吞吐提升到1.7-2.6倍,同时在MasakhaNEWS 400条四分类评测上保持82.5%-89.2%准确率,其中gemma-4-E2B-it的Q4_K_M以28.8 t/s与89.2%准确率占据质量成本前沿。同为Q4_K_M的gemma-4-E2B-it在Jetson Orin NX与Raspberry Pi 5上的解码吞吐分别为28.8 t/s与7.5 t/s,前者为后者的3.8×,预填充吞吐差距更大,说明图形处理器主要加速提示处理。实测开销在16 GB内存的两档硬件上可比,Tier B峰值常驻内存为3.4-13.5 GiB、功耗为20-24 W,Tier A峰值常驻内存为2.3-2.6 GB且首包延迟为1.6-2.2 s。结论适用于所测英语、豪萨语、伊博语、尼日利亚皮钦语、约鲁巴语的新闻主题分类与阿姆哈拉语识别,奥罗莫语词错率约0.705-0.763与树莓派上600M识别模型单句约15 s仍是开放问题。
🔗 开源资源
第三方资源:https://www.awarri.com/ — 链接可访问(HTTP 200)
第三方资源:https://www.open-telco.ai/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
167. CloudEar 如何同时评价生成歌曲的好听程度与提示词贴合度

英文题目:CloudEar: Integrating Perceptual, Diagnostic, and Cross-Modal Evidence for Music Evaluation
标签:#音频质量评估 | #模型融合 | #音乐文本检索 | #音乐
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Qiqi He:机构信息未在 arXiv HTML 中可靠披露
- Anqi Huang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
生成音乐评价需同时判断听感上的音乐性、技术录音质量及生成结果是否遵循提示词中要求的风格和配器,难点在于回归模型预测容易向均值集中,通用音频文本相似度又难以反映细粒度的音乐属性。CloudEar对同一提示词下的两首歌曲做配对比较,感知专家从30秒片段的MuQ特征经Transformer适配器得到感知表示并预测质量分,以有序回归、连续回归与配对排序联合训练缓解预测集中。诊断专家将该质量分与真峰值电平、削波率、波峰因数和综合响度组成的信号描述符向量及HEAR学习型质量分拼接,经线性层融合成音乐性得分,推理时选择得分更高者。跨模态专家复用感知专家输出的感知表示,将其与音频侧风格与乐器分类器抽取的属性向量、Qwen3-30B按同词表从提示词抽取的提示表示联合,经两层Transformer得到对齐得分。与已有方法的区别在于把排序回归、有序回归与信号测量结合,并把对齐显式建模为音乐属性匹配而非整体语义相似。在CMI-Test上CloudEar音乐性配对偏好准确率达到0.8179,高于最强的HEAR基线的0.7882,PAM-Music上的等级相关和线性相关也同步提高。结论适用于英文歌曲为主的配对偏好和打分数据,对中文或其他语种、长曲结构和实时生成场景尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
168. 第一视角下何时开口说什么的主动语音助手

英文题目:EgoVoice: Proactive Spoken Assistance from Egocentric Multimodal Streams
标签:#语音交互 | #偏好优化 | #数据集 | #基准测试
评分:6.2/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:模型报告 | arXiv 原文
👥 作者与机构
- Heeseung Kim:Department of AI, University of Seoul
📌 核心摘要
可穿戴助手需要从第一视角视频与音频中持续观察用户操作,在用户没有提问时决定是否开口、何时开口以及说什么,难点在于沉默占多数、干预时机依赖任务进度,而语音播放本身会占用时间。EgoVoice 从 HoloAssist 录像出发,先用声源分离保留背景声,再重合成干净的用户与指导者语音,形成带时间戳的听或说监督数据;接着在 MiniCPM-o 4.5 上做监督微调(Supervised Fine-Tuning,SFT),学习每秒输出保持沉默或生成指导文本与语音;最后用直接偏好优化(Direct Preference Optimization,DPO)比较同一上下文的多个候选,奖励时机更准的输出。与零样本骨干相比,监督微调版本在 170 个评测会话上把起始时刻 F1 从 0.113 提高到 0.274,把内容余弦相似度从 0.519 提高到 0.684。DPO 版本进一步把 F1 提高到 0.324,但内容相似度回落到 0.649,人工偏好中两者都优于骨干而彼此没有显著差异。结论适用于论文重建的装配类任务与回放评测,召回率仍低于 0.3,大量应干预时刻仍被漏掉。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://holoassist.github.io — 链接可访问(HTTP 200)
第三方资源:https://www.openslr.org/94 — 链接可访问(HTTP 200)
第三方资源:https://egocentricvoice.github.io/ — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/openbmb/MiniCPM-o-4_5 — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/IndexTeam/IndexTTS-2 — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/facebook/sam-audio-large-tv — 链接可访问(HTTP 200)
第三方资源:https://github.com/snakers4/silero-vad — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-ASR-1.7B — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-ForcedAligner-0.6B — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-Embedding-0.6B — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/594zyc/ProAssist-Model-L4096-I10 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
169. Diptych:让用户决定比什么,再让 AI 解释差异的参考试听

英文题目:Diptych: Scoped, AI-Interpreted Comparison for Reference Listening in Music Production
标签:#音乐分析 | #用户研究 | #音乐 | #大语言模型
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Chongjun Zhong:Zhejiang University, Hangzhou, Zhejiang, China;Singapore University of Technology and Design, Singapore
- Abhinaba Roy:Singapore University of Technology and Design, Singapore
- Archishman Ghosh:Singapore University of Technology and Design, Singapore
- Kejun Zhang:Zhejiang University, Hangzhou, Zhejiang, China
- Dorien Herremans:Singapore University of Technology and Design, Singapore
📌 核心摘要
参考聆听指制作人拿未完成作品对照商业录音反复试听,难点在于两首曲目速度、配器、长度和结构很少对齐,听者既要记住另一段落的声音,又要把模糊印象说成可检查的判断。DipTych输入目标曲与参考曲两段音频,输出结构切分时间线、59个音频特征对照表与针对当前范围的文字解读,用户可在整曲对照与自选片段对照之间切换。整曲模式给出全局取向,片段模式允许两侧起点、时长和结构标签各自独立选择,特征差异连同特征词表送入自托管语言模型生成分类小结与总体解读。12名音乐人先用无分析播放器记录判断,再用完整系统保留、修改、撤回或新增判断,4名专家在不接触系统的条件下盲听并对匿名主张评级。在38对匹配判断的同一盲评中,两名专家同时完全支持率从初听时的24项变为使用系统后的23项,总体并未提高。在10条新增判断的同一盲评中,两名专家至少部分支持率为9条,其中4条获两名专家完全支持,表明系统拓宽了注意但弱依据的发现仍存在。系统可用性量表得分在12份问卷中均值为74.79,高于常用平均基准68;但结论仅适用于短时对照任务与当前59特征管线,遇无声乐曲目误报人声等特征失效、术语难懂时可能失败,长期创作效果与特征权重尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
170. 脉冲间隔变化是否帮助蝙蝠声音分类:一篇受控对比解读

英文题目:Effects of interpulse-interval variation on deep-learning classification of bat vocalizations
标签:#音频分类 | #SFT | #生物声学监测 | #模型评估
评分:6.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 1/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Welmoed R. Eversteijn:机构信息未在 arXiv HTML 中可靠披露
- Burooj Ghani:机构信息未在 arXiv HTML 中可靠披露
- A. Leonie Baier:机构信息未在 arXiv HTML 中可靠披露
- Dan Stowell:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
蝙蝠物种自动分类输入为两秒野外录音片段,输出为16个类别标签中的一个,难点是同属物种叫声形态重叠且叫声结构随搜寻到捕食行为连续变化。从欧洲蝙蝠录音挑选含多个连续叫声的两秒片段导出为WAV,保留原始叫声起始间隔构成自然条件,再把同一来源录音的相邻叫声起始点重排为50毫秒等间隔构成配对归一化条件,同时保留叫声频谱内容。两类片段再分别转为线性频谱图与梅尔频谱图,送入卷积流水线卷积神经网络(Convolutional Neural Network,CNN)代表EfficientNet-B0与Transformer代表PaSST做全参数微调,使频谱形态与间隔排布成为模型可学习的输入。评测沿同一数据链展开:先在各自条件下做五折交叉验证估计同分布性能,再把分别在两种条件下训练的模型放在同一固定自然测试集上比较迁移损失,同时把预训练分类器BatDetect2与BAT按录音级预测规则直接在两种条件下评测。在同条件五折验证中PaSST准确率为自然条件71.0%对归一化条件70.0%,EfficientNet-B0为47.0%对57.0%,PaSST在两种条件下均高于EfficientNet-B0。跨到自然录音时PaSST准确率从65%降至57%,EfficientNet-B0从54%降至50%,而BatDetect2与BAT在全部物种上均为自然条件28.0%对归一化条件27.0%,归一化未带来实质增益。结论仅限于两秒片段内相邻叫声起始间隔这一种时间变化,不涉及叫声顺序、形态渐变或更长行为节律,且每物种仅7至21段、每条件共251段,归一化插补或删除背景音可能引入间隔之外的声学变化,跨条件下降也不能确证完全由间隔本身引起。训练使用两块NVIDIA A40图形处理器但原文未披露训练、推理或部署成本。
🔗 开源资源
代码相关资源:https://github.com/welmoed505/thesis-bat-sound-classifiers.git → https://github.com/welmoed505/thesis-bat-sound-classifiers — 链接可访问(HTTP 200)
第三方资源:https://doi.org/10.5281/zenodo.20773227 → https://zenodo.org/records/20773227 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
171. 相关性蒸馏的噪声鲁棒性到底来自哪一项

英文题目:What Actually Makes Correlation-Based SSL Distillation Noise-Robust? A Mechanistic Correction
标签:#语音识别 | #音频分类 | #知识蒸馏 | #鲁棒性
评分:6.1/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Fabian Ritter-Gutierrez:机构信息未在 arXiv HTML 中可靠披露
- Nancy F. Chen:机构信息未在 arXiv HTML 中可靠披露
- Eng Siong Chng:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
自监督语音模型准确但体积大,知识蒸馏把它压缩为小学生模型后,学生常丢失教师的噪声鲁棒性,已有相关系数蒸馏把鲁棒性归因于学生自相关项却未隔离验证。本文复用该蒸馏流程,先让师生在相同干净语音上叠加独立采样的加性噪声并抽取768维帧级表示,为相关计算提供输入。接着用跨相关矩阵对角项迫使学生逼近冻结教师的共享语音分量,按皮尔逊方差分解压缩学生噪声方差,其输出的去噪表示再进入自相关项整理。自相关项惩罚学生自身相关矩阵非对角元以解耦特征维度,再把重组后的末层特征送入全维度逻辑回归探针与下游线性头分别检验噪声残留与任务可用性。原有降维探针先均值池化再降到32维并用随机森林分类,本文证明其夸大了自相关项的去噪观感,故改用无降维探针并辅以同噪声对照与逐维度分析。在LibriSpeech-100蒸馏、CHiME-3保留噪声10 dB评测下,跨相关匹配相对噪声增强的蒸馏基线把噪声分类准确率从76.98%降到55.02%,补回自相关项后为55.55%,而同噪声采样下同目标失效并回升到95.38%。自相关项不去噪而是把噪声分散到更多维度并提升干净下游任务准确率,机制可迁移到环境声任务,但音高与音色敏感的音乐任务受语音增强管线影响而下降。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
172. 蒸馏损失如何改变语音音乐小模型的合并效果

英文题目:Correlation-Based Distillation Yields More Mergeable Speech-Music Encoders
标签:#音频理解 | #知识蒸馏 | #模型融合 | #语音 | #音乐
评分:6.1/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Fabian Ritter-Gutierrez:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
需要一个同时表示语音与音乐的小编码器时,直接在双域数据上预训练开销大,可行路线是把语音教师与音乐教师分别蒸馏为小学生再做事后合并。难点在于学生能否在权重插值或通道对齐后保持双域性能,而以往工作固定了蒸馏损失,没有检验损失本身是否影响可合并性。论文固定学生结构与九任务评测,把标准层预测损失替换为相关性损失,再分别用任务向量插值与相关性排列两种方式合并。任务向量插值在共享起点上混合语音向量与音乐向量,相关性排列则在激活空间求解每层通道匹配后加权平均,两者输入都是同一批蒸馏学生。在插值鲁棒性上,相关性损失学生在 1818 组域、权重与尺寸比较中的 1717 组里更接近各自较好的单域端点,三层结构在权重 0.8 处语音分数达到 959.4,对照组为 924.1。结论适用于所测的两层、三层与加宽学生及所用语音、音乐与环境声任务,在标准宽度下音乐分数仍由对照组占优。原文未披露训练时长、设备型号与实测推理成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
173. 用频谱搬运距离把和声、音色和元音放进同一个空间
标签:#音乐分析 | #语音属性识别 | #信号处理 | #形式化分析
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.6/1 | 影响力 0.7/1.5 | 开源 1.2/1.5 | 可复现 0.1/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:理论研究 | arXiv 原文
👥 作者与机构
- Yusei TAMURA:机构信息未能从 arXiv PDF 文本可靠映射
- Shigekazu ISHIHARA:机构信息未能从 arXiv PDF 文本可靠映射
- Ken ITO:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
论文要解决音色选择长期游离于乐谱结构之外的问题,同一和弦因配器与弱音器开合听感亲疏不一,却缺少以赫兹为单位的定量表示。输入是长号、圆号等实录音色的归一化功率谱与对应正弦参考频率,输出是音色谱之间的瓦瑟斯坦距离、三个音色构成的三角形面积与二阶矩,以及香农熵和塞萨里斯感觉不协和度。瓦瑟斯坦距离指把归一化谱看作概率分布时的最优搬运代价,香农熵指频谱能量分布不确定性的比特度量,塞萨里斯感觉不协和度指由分音频率与幅度计算的拍频粗糙感指标。处理先把每条音频谱归一化为概率分布并计算两两搬运距离,再对三音和弦由三条边长求三角形面积与平均平方边长即二阶矩,最后引入极窄高斯噪声作为零音色基准,把乐器音色与人声元音映射到同一巴拿赫空间。与只记音高的传统和声相比,该方法把音色偏离正弦轴的程度显式度量,并把弱音器开合与元音发音放在同一几何中比较。在马勒第三交响曲第一乐章362小节三支长号演奏降B–D–F和弦的录音比较中,不带弱音器与带弱音器的塞萨里斯感觉不协和度从12.5增至34,约为原来的三倍,说明谱面相同而音色亲和性不同。结论限于所用录音、演奏法与分析频段,对四声部以上的一致几何构造及未分析曲目尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
174. 帧级显著性也能直接给出音频时刻:重访 AMR 的解码器与显著性之争

英文题目:Revisiting Frame-Wise Saliency for Audio Moment Retrieval
标签:#音频时间定位 | #音频事件检测 | #Transformer | #信号处理
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tatsuya Komatsu:机构信息未在 arXiv HTML 中可靠披露
- Hokuto Munakata:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音频时刻检索输入一段长音频和一句自由文本查询,输出录音中与查询描述匹配的一个或多个起止时间段,难点是查询可描述多声关系且同一查询可对应多个分散区间。编码器输入投影后的每秒音频特征与文本词特征,经跨模态注意力和时序自注意力生成查询条件化的帧表示与全局表示,该帧表示同时送给解码器和显著性头。显著性头对投影后的帧表示与全局表示做缩放点积,不用解码器预测,直接为每秒一帧输出与查询相关的显著性序列,该序列作为切分步骤的输入。无学习参数的峰值相对切分以该序列为输入,找局部峰值并按峰值比例设阈值向两侧扩展、容忍短间隙,再按重叠去除排序得到带排序的时刻。相对已有做法的关键差异是不训练新的定位模型,也不改解码器,只比较同一训练模型的两种输出路径。在CASTELLA测试集上QD-DETR的R1@0.7从解码器输出的21.0%提高到显著性切分的36.1%,同条件比较显示帧级信息本身已包含更准确的边界。结论适用于QD-DETR、CG-DETR、TaskWeave和UVCOM,不适用于显著性依赖解码器top预测的TR-DETR,对平均时长至多2 s的短时刻差距更大。训练配置方面原文披露训练200个轮次、批量大小32、AdamW学习率1e-4、权重衰减1e-4和梯度裁剪0.1,硬件型号数量与训练时长未说明。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
175. 从敲击声反推材质参数:连续估计与重渲染

英文题目:ImpactMat: Continuous Material Estimation for Inverse Impact Sound Rendering
标签:#音频理解 | #数据集构建 | #CNN | #数据集 | #基准测试
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Hyebin Cho:机构信息未在 arXiv HTML 中可靠披露
- Bumsoo Kim:机构信息未在 arXiv HTML 中可靠披露
- Joon Son Chung:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
逆向冲击声渲染输入一段或多段未知材质物体的敲击录音,输出可直接送入物理渲染器的连续材料参数向量,难点是同一材质在不同敲击点、力度和时刻下波形差异大,且木材、塑料、钢材等离散材质预设无法表达类内变化与中间状态。模型先用共享音频网络把每段波形编码为512维敲击嵌入,再对集合取均值和标准差并拼接成集合表示,最后由直接回归头输出包含杨氏模量、密度、泊松比和瑞利阻尼系数的参数向量。训练另加辅助分类头与混合一致性约束,推理只用回归头,并通过重算集合统计量兼容任意敲击段数K。在ImpactMat测试集K=1评测设置下,本方法单材质在五个归一化目标维度上平均的平均归一化平均绝对误差为0.078,低于DSP手工特征回归的1.405与Qwen2.5-Omni-7B上下文学习的1.270。同样在ImpactMat测试集K=1评测设置下,本方法混合材质平均归一化平均绝对误差为0.116,低于DSP手工特征回归的0.961与Qwen2.5-Omni-7B上下文学习的1.162。结论适用于合成数据分布内的单体与双材质混合敲击声,真机泛化只经重渲染听感验证,未验证参数真值精度。以单次查询推理耗时为指标,本方法为6.1 ms,低于音频语言基线的数秒和基于优化方法的190 ms。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
176. 用假名域识别误差做奖励,优化日语合成的汉字读音

标签:#文本到语音 | #强化学习 | #语音可懂度评估 | #语音
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shiao Zhu:机构信息未在 arXiv HTML 中可靠披露
- Lianbo Liu:机构信息未在 arXiv HTML 中可靠披露
- Kai Washizaki:机构信息未在 arXiv HTML 中可靠披露
- Koki Nikaido:机构信息未在 arXiv HTML 中可靠披露
- Yui Sudo:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
日语文本到语音需要以输入文本和参考音频提示生成自然语音,难点是汉字读音随词变化,误读仍可能被正字法转写掩盖。策略语言模型以文本与参考音频为条件自回归生成语义语音序列,再经冻结的声学解码器与声码器合成为波形,强化学习只更新该语言模型。合成波形送入自动语音识别转写并与参考表示比较字符错误率,正字法分支比较原文与正字法转写,假名分支比较参考假名读音与假名转写结果,误差再经有界函数映射为奖励。每次输入采样一组生成结果并分别计分,在组内标准化奖励得到相对优势,结合截断策略损失与相对冻结参考策略的散度约束更新策略。假名奖励让读音差异在奖励计算中显式保留,正字法奖励则可能丢失读音信息或惩罚与发音无关的字形差异。在常用汉字读音基准报告子集上,假名奖励的目标汉字读音误差为7.17%,正字法奖励为9.65%,前者相对降低25.7%,而正字法字符错误率分别为4.15%与4.10%,基本相当。无约束优化下假名奖励会引起输出明显变长,加入散度约束后该现象得到明显抑制,说话人相似度和客观语音质量保持相近。该结论限于单个日语基座模型和需要参考读音的训练设置,尚未验证其他规模与架构。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/sbintuitions/Joyo-Kanji-Yomi-Benchmark — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/openai/whisper-large-v3-turbo — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/sakasegawa/japanese-wav2vec2-large-hiragana-ctc — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
177. 上下文先验让神经解码更准,也让剩下的错误更自信

英文题目:Confidence-Ordering Reversal under Contextual Priors in Neural Decoding
标签:#言语神经解码 | #不确定性估计与校准 | #统计分析 | #脑信号
评分:6.1/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xinyu Zhang:KTH
- Sichao Liu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
任务是从脑磁图时间窗中检索对应语音片段,输入是与当前词对齐的脑磁图窗及此前窗口构成的历史,输出是固定候选池中的首位预测及其置信度,难点是局部神经证据较弱时上下文先验会主导选择并重塑分数。局部解码器先对全部候选打分,历史累积先验或语言模型先验再给出同候选集上的先验分,两路分数以加性浅融合相加得到融合分,融合后前两名分差即融合边距被当作置信度读数。与只看融合后准确率或文本相似度的已有工作不同,本文把初始错误分为融合后纠正的修复和仍未纠正的残留错误,并按正确候选的初始名次分组比较置信度排序。在采用历史累积先验的MEG-MASC评测中,汇总正确性的AUROC为0.87,而区分修复与残留错误的AUROC从初始名次2–3处的0.70降至名次21–50处的0.39,初始名次20之后的残留错误占融合后全部错误的46.6%。在同一MEG-MASC评测中,保留局部和先验两路分数训练的完整估计器与仅用融合边距的基线相比,在覆盖率同为92.24%时输出率从56.7%提高到74.5%。该反转在MOUS上同样出现,而仅改变融合权重的因果干预会把正序边界推向更深名次,在词级语言模型先验下正序扩张可持续到准确率增益见顶之后,因此按准确率选出的权重不能保证置信度排序,选择性输出的比较仅在MEG-MASC上验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
178. 只改推理条件怎么做语音匿名:随机目标重构与投影制导

英文题目:Voice Anonymization Made Simple: Training-Free Anonymization with Projected Classifier-Free Guidance
标签:#说话人匿名化 | #语音转换 | #流匹配 | #隐私保护
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xiang Shi:机构信息未在 arXiv HTML 中可靠披露
- Han Zhu:机构信息未在 arXiv HTML 中可靠披露
- Ming Li:机构信息未在 arXiv HTML 中可靠披露
- Xiaoxiao Miao:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音匿名化(voice anonymization)的输入是源说话人的语音,输出是听感自然的新语音,要求无法再识别出源说话人,同时保留文字内容和情感等下游需要的信息,难点是内容表征和生成轨迹中常纠缠源音色。条件构造阶段用随机目标话语的窄带与宽带记号作为自回归模型的上下文,把源语言序列重新生成为受无关说话人影响的记号条件,其中提示区记号仍取自源话语以与源声学提示保持对齐。语音生成阶段保留源声学提示和风格向量只为估计源条件方向,把记号引导中与该方向对齐的分量投影去除,再加强剩余记号引导,生成波形仍由原流匹配求解器与声码器完成。与直接去掉目标条件的内置匿名模式不同,该方法主动利用外部说话人上下文和源方向参考。在评测集上,随机目标结合Smooth-21投影的系统在半知情攻击下等错误率达到21.51%,高于内置模式的17.78%和最强官方基线的17.05%,词错误率保持在4.46%左右。结论限于英语第一赛道协议,多语言适用性尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/xs125-stack/voice_anon_simple — 链接可访问(HTTP 200)
第三方资源:https://github.com/Plachtaa/ASTRAL-quantization — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
179. 用虚拟麦克风给扩散分离补上观测约束:VM-ArrayDPS 解读

标签:#语音分离 | #扩散模型 | #无监督学习 | #麦克风阵列 | #语音
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jingqi Sun:机构信息未在 arXiv HTML 中可靠披露
- Haozhan Tang:机构信息未在 arXiv HTML 中可靠披露
- Shulin He:机构信息未在 arXiv HTML 中可靠披露
- Zhong-Qiu Wang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
盲语音分离(blind source separation,BSS)要在房间脉冲响应和声源都未知时,从少数传声器混合信号中恢复各自语音,混响和噪声会让可用的空间约束变少。ArrayDPS 用预训练单说话人语音扩散模型提供先验,再用前向卷积预测估计声学滤波器,构造多通道一致性重建误差引导采样,但在低信噪比和少传声器时重建误差不可靠。VM-ArrayDPS 对物理混合先做独立向量分析(independent vector analysis,IVA)空间解混,得到干扰更少的分离信号,把它们看作虚拟传声器观测。采样每一步同时重建物理观测和虚拟观测,两类重建误差按权重组合后求对数密度对输入的梯度(score),与扩散先验相加更新声源估计。在 3 通道 2 说话人 SMS-WSJ 测试集上,平均选择策略下 VM-ArrayDPS 相对 ArrayDPS 的 SI-SDR 从 15.0 dB 提高到 16.1 dB,SDR、PESQ 和 eSTOI 也有对应提高。该结论只在仿真 8 kHz 混响数据和固定传声器子集上成立,真实环境和传声器数量变化时的表现尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
180. 口音英语为何被认成母语:只用母语语音估计偏置方向并投影去除

标签:#语言识别 | #信号处理 | #口音与方言 | #语音
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Minu Kim:机构信息未在 arXiv HTML 中可靠披露
- Jihwan Lee:机构信息未在 arXiv HTML 中可靠披露
- David R. Mortensen:机构信息未在 arXiv HTML 中可靠披露
- Shrikanth Narayanan:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
口语识别要求对带口音语音输出所说语言而非口音来源,难点在于由自监督语音模型微调的识别头常把第二语言(L2)英语误判为说话人第一语言(L1)。论文处理链路为语音波形经预训练语音编码器得到 \(d\) 维向量 \(x=f_{\theta}(a)\),再送入冻结的语言识别头得到 \(\hat{y}=g_{\phi}(x)\),编码器参数 \(\theta\) 和识别头参数 \(\phi\) 始终不更新。方法先用 Fleurs 开发集的母语英语和母语非英语语音拟合带 \(\ell_2\) 正则的线性二分类器,取归一化权重为 L1 偏置方向,估计完成后丢弃该辅助分类器;测试时对每个向量减去沿该方向的分量后再送入原冻结识别头,全程不用 L2 语音估计方向,也不用重训练。与需结合无词典语音识别输出、聚合短片段、引入音素序列或在代码转换语音上微调的做法不同,该校正只删除一个秩一分量。在 MMS-LID-4017 上,非母语英语被判为英语的比例在 Svarah、L2-ARCTIC、ALLSSTAR 分别为 14%、57%、93%,随 Whisper 词元归一化负对数似然均值 1.80、1.51、1.03 升高而降低,投影后前两者分别提升 51-71 个百分点和 17-24 个百分点,母语英语和母语 L1 基本不变。结论限于测试的 MMS-LID 系列和三组英语 L2 语料,对本来已接近正确的轻口音语料增益很小。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
181. 用一个网络同时管滤波器和后处理:轻量回声消除与抑制框架解读

标签:#回声消除 | #语音增强 | #自适应滤波 | #RNN
评分:6.1/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Huawei Zhang:机构信息未在 arXiv HTML 中可靠披露
- Rilin Chen:机构信息未在 arXiv HTML 中可靠披露
- Hao Zhang:机构信息未在 arXiv HTML 中可靠披露
- Meng Yu:机构信息未在 arXiv HTML 中可靠披露
- Dong Yu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
声学回声消除与抑制需从麦克风信号中恢复近端语音,麦克风信号是声学回声、近端语音和背景噪声的混合,难点在于回声路径时变、双讲保护与非线性残余回声难以兼顾。每帧可变步长与可变转移因子归一化最小均方滤波器先用当前系数减去估计回声,得到作为近端语音初步估计的误差信号。分组时域卷积循环网络以麦克风信号、远端参考信号和该误差信号的对数能量连同循环状态为输入,同时输出步长、转移因子和复数比掩码。步长与转移因子代入更新式得到下一帧滤波器系数,复数比掩码与当前误差信号相乘得到最终近端语音估计,而更新后滤波器产生的误差信号又回送为下一帧网络输入。与用两个分开训练的网络分别控制滤波器和做后处理不同,该框架用单个网络联合优化两部分,并递归回送误差信号且把其幅值约束为不超过麦克风信号,以匹配在线自适应并维持训练稳定。在评估集双讲条件下感知语音质量评估(perceptual evaluation of speech quality,PESQ)达到2.68,高于NLMSNet的2.20和KalmanNet的2.22。在评估集单讲条件下回声返回损耗增强(echo return loss enhancement,ERLE)达到25.52,高于NLMSNet的7.28和KalmanNet的9.89。结论目前只在论文自建模拟数据和挑战数据子集上验证,未覆盖未见房间与真实通话,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
182. 把稠密多模态表征拆成稀疏因子再做抑郁评估

英文题目:From Sparse Representations to Behavioral Insights for Multimodal Depression Assessment
标签:#音视频理解 | #多模态学习 | #精神健康筛查 | #可解释性
评分:6.1/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Guimin Hu:Guangdong University of Technology
- Zihao Song:Guangdong University of Technology
- Jiachen Luo:Queen Mary University of London
- Jiayuan Xie:The Hong Kong Polytechnic University
- Ruichu Cai:Guangdong University of Technology
📌 核心摘要
抑郁评估的输入是同一用户的多个社交视频或临床访谈片段,输出是用户级是否抑郁的二分类,难点在于多模态表示稠密难解耦,且用户级标签与异质视频级行为之间存在粒度错位。BehavDep先用时序编码器把预提取的帧级视听特征聚合成视频级表示,再用TopK稀疏自编码器分解为稀疏隐因子,随后把因子投影到文本编码的概念空间并计算余弦相似,得到行为概念激活向量。概念激活经注意力加权聚合成用户画像,同时映射为视频级抑郁倾向分数并加权得到用户级倾向,两者拼接后分类,用户级损失为视频级分数提供弱监督,软标签库对历史估计做平滑。与直接融合稠密表示的方法不同,该框架保留稀疏结构并给出可读的概念证据和跨观察的异质性分析。在MUD3数据集上,BehavDep准确率达到83.3%,相对最强基线Transformerhan的78.3%高5.0个百分点,F1为81.9%,原文表述为提升5.05和4.62个百分点。该结论仅在MUD3纵向社交视频与DAIC-WOZ访谈数据、依赖现成特征提取器及文献整理的概念库条件下验证,视频级倾向分数系用户级弱监督间接学得,原文明确其属探索性刻画而不构成临床结论,最终判断留给专业人员,超出概念覆盖或直接处理原始音视频的情形尚未验证。实验在单卡NVIDIA GeForce RTX 4080上分两阶段训练,稀疏自编码器训练20轮后端到端优化30轮,但原文未披露训练时长与推理成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
183. 从部分语音学会何时落笔:端到端同声传译的前缀自学

英文题目:Learning When to Commit from Partial Speech for End-to-End Simultaneous Speech Translation
标签:#语音翻译 | #知识蒸馏 | #语音 | #流式处理
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hieu Hoang:Microsoft
- Amittai Axelrod:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
同时传译要求在英语语音未播完时输出目标语言文本且已提交词不可改,难点是语音按固定时长块到达、词边界不明,识别与翻译不确定性耦合在同一个端到端语音语言模型中。论文用同一基座模型先翻译完整语音得到锚点,再翻译固定时长前缀波形,通过与锚点的最长公共前缀并用运行最大值保证单调,得到无需转录或人工译文的可监督目标前缀。训练时加入合成边际允许锚点挽救概率稍低的词以控制中间监督密度,推理沿用已提交文本,用延续与停止证据之差做置信阈值控制提交时机,并比较单轮强制前缀与多轮追加解码两种表示,后者复用键值缓存而前者需重放已提交目标。在FLEURS英语到德语上以置信阈值扫描共享延迟区间比较可达包络面积AUC时,多轮训练模型为66.4,高于基座模型同机制的48.6。在FLEURS每方向基座衍生的oracle提交决策上下文上以期望校准误差衡量,多轮训练模型较基座模型总体下降63–68%、早期前缀下降68–80%。原文未披露训练、推理或部署成本。结论适用于固定分块的朗读语音与自动评测,较大合成边际会损害质量与校准,不可修订的早期错误仍存在。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
184. HyperBrowseComp:在开放网络上考验多语言多模态持续检索

英文题目:HyperBrowseComp: A Multilingual and Multimodal Stress Test for Web-Browsing Agents
标签:#音视频问答 | #基准设计 | #基准测试 | #多语言
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Alham Fikri Aji:机构信息未在 arXiv HTML 中可靠披露
- Faiz Rizki Ramadhan:机构信息未在 arXiv HTML 中可靠披露
- Zayd M. K. Zuhri:机构信息未在 arXiv HTML 中可靠披露
- Seung Hun Eddie Han:机构信息未在 arXiv HTML 中可靠披露
- Ryandito Diandaru:机构信息未在 arXiv HTML 中可靠披露
- Qinrong Cui:机构信息未在 arXiv HTML 中可靠披露
- Jan Christian Blaise Cruz:机构信息未在 arXiv HTML 中可靠披露
- Badrinath Chandana:机构信息未在 arXiv HTML 中可靠披露
- Peerawat Chomphooyod:机构信息未在 arXiv HTML 中可靠披露
- Ahmed Attia:机构信息未在 arXiv HTML 中可靠披露
- Jonibek Mansurov:机构信息未在 arXiv HTML 中可靠披露
- Emilio Villa-Cueva:机构信息未在 arXiv HTML 中可靠披露
- Canh Duong Nguyen:机构信息未在 arXiv HTML 中可靠披露
- Imran Turganov:机构信息未在 arXiv HTML 中可靠披露
- Minghao Wu:机构信息未在 arXiv HTML 中可靠披露
- Peerat Limkonchotiwat:机构信息未在 arXiv HTML 中可靠披露
- Irina Nikishina:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
该基准要解决网页浏览智能体在真实开放网络中发现并连接证据的能力不足,输入为13种语言由母语者或高水平使用者直接写成的问题,输出为单个实体、名称、日期或数值等简短答案,难点在于关键线索常隐含在题面之外,需在网页、视频帧、口语、扫描书报、表格、地图与图表之间定位长源片段并做多跳验证。构建时标注者从可验证答案与证据出发逆向出题,提交规范答案、别名、链接、精确证据位置、来源语言、相关形态、访问日期与解题轨迹,再经第二位标注者校验唯一性并补充不帮助检索的指纹约束,随后用七个无网络模型筛除可凭参数知识答对的题目,最终保留423题。评测时智能体在统一智能体协议下自主检索浏览,回答由二值裁判对照参考答案判定,另在印尼语、泰语、越南语各抽10题做人类无模型辅助对照。在原生搜索设置下423题上以准确率为指标,Gemini 3.7 Flash答对134题、准确率为31.68%,高于Gemini 3.1 Pro Preview答对108题、准确率为25.53%。同一原生搜索设置下五个模型均未答对244题、占比57.68%,而30题人类抽样上人类答对15题高于Gemini 3.7 Flash的13题,人类平均用时89.5分钟并有4题放弃。推理开销上原生搜索下Gemini 3.7 Flash在423题累计使用14.1M词元与129.5小时端到端时间,Exa外挂检索下单配置最高达928.8M词元与75.1小时。结论适用于跨语言跨形态找obscure公开信息的压力测试,不代表日常查询分布,实时排名与页面变化会带来波动。
🔗 开源资源
- 第三方资源:https://HyperBrowseComp.github.io/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
185. 智能体能否自动做语音合成的强化学习后训练
英文题目:Can LLM Agents Automate Reinforcement Learning for Text-to-Speech?
标签:#文本到语音 | #强化学习 | #偏好优化 | #语音质量评估
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Xuanjun Chen:机构信息未在 arXiv HTML 中可靠披露
- Zixiong Su:机构信息未在 arXiv HTML 中可靠披露
- Hao Shi:机构信息未在 arXiv HTML 中可靠披露
- Chang Zeng:机构信息未在 arXiv HTML 中可靠披露
- Kai Li:机构信息未在 arXiv HTML 中可靠披露
- Jyh-Shing Roger Jang:机构信息未在 arXiv HTML 中可靠披露
- Hung-yi Lee:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
零样本语音合成在整体可懂后仍残留局部分段错误,输入文本与输出语音在个别音节出现读错、异常停顿或语义语音对齐偏离,常规全局训练目标难以定位修复。本文研究智能体能否自动完成面向该问题的强化学习后训练,输入为文本条件与参考语音,输出为修正后的合成策略与可执行训练配方。AgenticTTS-Forge把人类指导与智能体执行放在共享工作区,人类分阶段给出文献锚点、单步优化建议、瓶颈提示与组合选择,智能体负责构造参数族、搜索损失权重与数据子集、记录配方与轨迹。智能体在语言模型载体上复现并改进了已发表的偏好优化做法,当增益停滞时自行检索文献并把优化目标转向流匹配解码器载体。与自行运行的CosyVoice2基线相比,在Seed-TTS-Eval上按held-out观察者评价的Bad case率从13.4%降到组合策略的5.4%,组合策略的MOS(UTMOSv2)在三组测试上同时高于两个父策略。结论只适用于该基座与该评测协议,且受提示通道泄漏、成形奖励夸大与合并分布偏移影响。原文报告了各阶段候选数与图形处理器小时数,未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://huggingface.co/FunAudioLLM/CosyVoice2-0.5B — 暂时无法访问
第三方资源:https://github.com/BytedanceSpeech/seed-tts-eval — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
186. VoCa:让语音助手边说边在画布上写画的交互设计

英文题目:VoCa: Designing Speech-Canvas Interaction for Voice-Based Conversational Agents
标签:#语音代理规划与工具使用 | #用户研究 | #语音 | #软件工具
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Yate Ge:Tongji University, Shanghai, China
- Run Yuan:Tongji University, Shanghai, China
- Yueran Qi:Grinnell College, Grinnell, Iowa, United States
- Wenjie He:Tongji University, Shanghai, China
- Jiaqi Mo:Tongji University, Shanghai, China
- Yangshuo Chen:Hunan University, Changsha, Hunan, China
- Wenbin Zuo:Tongji University, Shanghai, China
- Xiaohua Sun:Southern University of Science and Technology, Shenzhen, Guangdong, China
- Weiwei Guo:Tongji University, Shanghai, China
- Qi Wang:Tongji University, Shanghai, China
📌 核心摘要
多轮语音对话只靠声音缺少稳定抓手,用户难以回看关系、精确定位和修改早前内容,论文研究语音代理如何在说话同时使用画布来解释、组织和发展内容。形成性研究先观察成对参与者在共享白板上的讨论与访谈,再通过设计工作坊提炼涵盖画布内容、演化与协作方式的设计空间。在此基础上构建语音代理VoCa,它在每轮把用户输入、对话历史和当前画布作为上下文,联合规划先说的前言和后续按节拍组织的语音片段与画布动作,运行时按词级时间戳触发创建、注释和注意力引导。与已有可视化语音辅助不同,VoCa把生成式视觉对象当作可跨轮引用和发展的对话媒介,而非单轮配图。原文未提供可核对的关键定量结果,部署体验显示画布形式选择和内容增长后的清晰度评价分化明显。结论适用于以中文、大学生为主的日常学习与规划场景,代理主导画布、只追加不覆盖的设定以及约数秒的语音延迟限制了结论外推。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://help.openai.com/en/articles/20001274 — 链接不可用(HTTP 403)
第三方资源:https://gemini.google/overview/gemini-live/ → https://accounts.google.com/v3/signin/identifier?continue=https://one.google.com/explore-plan/gemini-advanced?utm_source%3Dgemini%26utm_medium%3Dweb%26utm_campaign%3Dadvmktgsite%26g1_landing_page%3D65%26otzr%3D1&followup=https://one.google.com/explore-plan/gemini-advanced?utm_source%3Dgemini%26utm_medium%3Dweb%26utm_campaign%3Dadvmktgsite%26g1_landing_page%3D65%26otzr%3D1&passive=1209600&flowName=WebLiteSignIn&flowEntry=ServiceLogin&dsh=S772911313:1791833132296125 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
187. 句子重读与单词重读如何放在同一框架里联合建模

标签:#发音评估 | #多任务学习 | #正则化 | #韵律
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tien-Hong Lo:机构信息未在 arXiv HTML 中可靠披露
- Fong-Chun Tsai:机构信息未在 arXiv HTML 中可靠披露
- Ting-An Hung:机构信息未在 arXiv HTML 中可靠披露
- Yu-Hsuan Hsieh:机构信息未在 arXiv HTML 中可靠披露
- Yao-Ting Sung:机构信息未在 arXiv HTML 中可靠披露
- Berlin Chen:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
自动发音评估需要同时判断句子中哪个词被强调,以及词内哪个音素承载主要重音,输入是朗读语音和参考文本,输出是词级和音素级的重读标注,难点是两者都依赖音高、时长和能量等韵律线索但以往被独立建模。本文提出的STRAW在冻结Whisper主干上只训练任务头和音素嵌入,语音先转为对数梅尔谱并经Whisper编码为编码器状态与解码器状态,转录文本则经Whisper分词和字素音素转换得到token序列与带重音标记的phone序列,为两分支提供查询依据。句子重读检测分支以解码器状态为查询、编码器状态为键值做交叉注意力,经全连接网络输出每个token的重读后验,词被判为重读当且仅当其任一token被预测为重读。词重读检测分支以可训练音素嵌入为查询、同一编码器状态为键值得到音素级声学表示,再经全连接网络输出每个phone是否承载主要重音,仅把主重音数字1标为1。词跨度重读正则项针对已标注受强调词的子词区间,约束区间内重读概率总和接近1并让最大概率位置趋近1、其余位置趋近0,以解决子词切分造成的词内分配模糊,三项损失按权重联合训练。在TinyStress-15K测试集上,完整配置的句子重读F1达到0.934,超过WhiStress的0.909。训练在单张NVIDIA 3090上以批量16和1e-4学习率进行20轮并按验证集句子重读F1选点,推理直接用参考文本提供解码token与phone序列而无需额外识别,作者承认评测局限于合成语音,词重读只建模主要重音且两分支缺少直接交互。
🔗 开源资源
第三方资源:https://github.com/Kyubyong/g2p.git → https://github.com/Kyubyong/g2p — 链接可访问(HTTP 200)
第三方资源:https://universaldependencies.org/u/pos/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
188. 边听边搜:端侧级联语音助手用投机执行隐藏工具延迟

英文题目:Hiding Tool Latency in On-Device Cascaded Voice Agent through Speculative Execution
标签:#语音代理规划与工具使用 | #工具增强与约束解码 | #流式处理 | #端侧运行
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Kyudan Jung:机构信息未在 arXiv HTML 中可靠披露
- Hyunsin Park:机构信息未在 arXiv HTML 中可靠披露
- Yoonhyung Lee:机构信息未在 arXiv HTML 中可靠披露
- Jinhwan Park:机构信息未在 arXiv HTML 中可靠披露
- Jinhyeok Yang:机构信息未在 arXiv HTML 中可靠披露
- KiHyun Nam:机构信息未在 arXiv HTML 中可靠披露
- Jaegul Choo:机构信息未在 arXiv HTML 中可靠披露
- Jinkyu Lee:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
级联式语音助手把自动语音识别、大语言模型推理与文本到语音依次串行,输入为流式语音、输出为首段语音回答,远程搜索须在说话结束并由模型确认意图后才执行,延迟直接计入等待,而部分转写虽能提前暴露意图,却面临纠正与变更风险。流式部分转写先进入基于规则的预测器,预测器切分子句并行预判可能需要的只读搜索请求,并在用户说话期间经远程搜索接口提前发起调用。取回结果存入推测结果缓存,说话结束时已完成结果与最终转写一起直接拼入回答模型提示词,供生成回答时直接使用。若模型仍发出工具调用,系统先做缓存校验,命中复用、未命中走常规路径,模型保留自主调用兜底;与基线不同,该设计把部分网络延迟重叠到说话时间内。在自建146条英文合成语音评测集的真机实测中,相对级联基线,端到端首音频延迟中位数从5.79 s降至4.60 s,工具调用F1从44.8%提高到60.6%,标准差从3.49 s降至2.81 s。实测用Samsung Galaxy S26 Ultra,识别与合成跑在CPU、量化Llama-3.2-3B跑在NPU;对抗样本下21次浪费调用构成额外网络成本,但推测限于只读工具,不改写闹钟、日历等数据。结论适用于英文信息检索与本地受限算力,遇关键词干扰或中途纠正、撤回与主题变更时提前结果可能作废,原文未报告训练费用、能耗等项目。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
189. 给印地语语音加上词级时间戳:Whisper 编码器上的轻量 CTC 头
标签:#强制对齐 | #语音识别 | #CTC | #语音 | #低资源
评分:6.0/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sanat Kumar Agrawal:机构信息未在 arXiv HTML 中可靠披露
- Srikanth Raj Chetupalli:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
印地语带时间戳转写输入连续语音,需同时输出词序列及其开始与结束时间,难点是Whisper编码器-解码器本身不直接给出细粒度词级时间,且印地语缺乏可用的时间戳系统。方法先用印地语Whisper编码器把音频变为每20 ms一帧的表示,再经单层线性CTC头预测每帧字符后验,该头输入1280维、输出73类,对应71个天城体字符加显式空格与CTC空白符,新增约93.5K参数。随后Whisper解码器生成转写文本,再在帧级字符后验与转写词之间做强制对齐,以单调映射把属于同一词的字符帧起止换算为词边界。与WhisperX需调用语言相关的外部wav2vec2.0模型计算帧后验不同,该方法不需第二个大模型,参数和计算更高效。在IndicVoices-R测试集上用模型转写文本评测时,所提方法的中位边界偏差小于一个Whisper帧移且超过92%边界偏差在50 ms以内,而基于交叉注意力分数的CrisperWhisper改编版本偏差明显更大。在DISPLACE-M上M3配置贪婪解码的WER为35.60,束搜索时为41.15,束搜索反而更高且主要来自插入增加。结论适用于所测朗读、自发电话和乡村对话数据,对极短会话片段仍可能出现插入型幻觉,需配合基于CTC输出的长度截断处理。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://sanat-agrwl.github.io/hindi-word-boundaries-demo → https://sanat-agrwl.github.io/hindi-word-boundaries-demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
190. 几何决定转向:全双工语音模型中的情绪方向
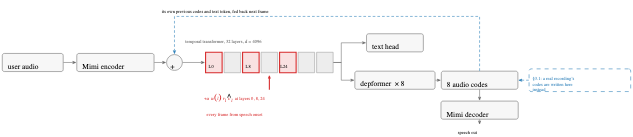
英文题目:Steering Follows Geometry, Not Labels: Emotion Directions in a Full-Duplex Speech Model
标签:#全双工语音交互 | #韵律与风格控制 | #统计分析 | #语音 | #可解释性
评分:6.0/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Pulak Kuli:Independent Researcher
📌 核心摘要
全双工语音交互要求模型在边听边说时实时改变情感与表达方式,输入是用户音频与对话历史,输出是连续语音帧,难点在于流式状态与编解码都会压缩或扭曲情感线索。论文先用英文ESD每种情感800段真实语音驱动Moshi输出码本,读取残差流(指Transformer层间传递的隐藏状态序列)状态并以情感均值减中性均值得到每层方向,再把第0、8、24层方向在语音起始后每帧叠加注入到文本头与音频解码分支上游,使其只改变表达而不改动编解码器,随后用emotion2vec概率与线性探针(指在冻结表示上训练的简单分类器)检验可分性与操控效果。与已有提示控制和参考音频控制相比,该方法无需重训练,每帧仅需少量向量加法。在720句Harvard中性句的强制文本模式下,以emotion2vec概率为指标,愤怒操控得0.177,低于同行同指标的最强竞争者高兴0.328。在240句的共享成分保留比例对照中,以目标情感概率为指标,愤怒在保留一半共享成分时得0.288,高于保留全部时的0.184,且最强竞争者高兴从0.334降至0.162。方向间余弦分析与共享成分剔除实验解释了高唤醒情感互相串扰的原因,悲伤方向独立故可控。结论适用于Moshi的int8版本与英文ESD语料上的四种情感,不宜推广到其他双工模型或更广的情感体系。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
191. 冻结声学嵌入上对齐与重采样的强度单调规律

英文题目:A Strength-Monotonic Law for Domain Alignment in Frozen-Embedding Bioacoustic Classification
标签:#音频分类 | #生物声学监测 | #域泛化 | #数据增强
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yucheng Gong:机构信息未在 arXiv HTML 中可靠披露
- Rui Zhou:机构信息未在 arXiv HTML 中可靠披露
- Binbin Zeng:机构信息未在 arXiv HTML 中可靠披露
- Qiang Ren:机构信息未在 arXiv HTML 中可靠披露
- Hongjin Hui:Department of Software Engineering, School of Software, Chongqing Finance and Economics College;Chongqing Key Laboratory of Data Mining and Integrated Application for Ecological Environment
📌 核心摘要
跨域蚊种声分类(Cross-Domain Mosquito Species Classification,CD-MSC)要求模型在训练时未见过的录制地点或设备上识别9种蚊子,输入是野外录音片段,输出是物种标签,难点是官方基线在可见域平衡准确率达0.881而在未见域跌至0.175。论文冻结Perch 2.0编码器得到片段嵌入,再在其上训练一个轻量探测头,探测头以交叉熵学习物种判别方向。探测头另加一项最大均值差异(Maximum Mean Discrepancy,MMD)惩罚,迫使判别方向在不同录制域间共享嵌入分布,避免记住单一域的声学特征,输入增强后的嵌入进入该复合目标完成训练。简化配方在未见域平衡准确率(Balanced Accuracy on unseen domains,BAunseen)为0.299±0.006,与完整六项复合配方的0.307±0.014区间重叠,而单独去掉MMD会损失0.098,超过整个复合损失相对交叉熵0.072的增益。跨4个编码器与HuBERT层内对照共8个编码器/层表示的检验显示,编码器在目标任务越强,MMD收益越大而域重平衡采样的损害也越大。微调主干、多模态融合和域重平衡在强冻结嵌入条件下反而降低未见域精度,结论尚未在第二个生物声学数据集上验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
192. 把编码和生成看成同一种潜变量推断:MUNITE 的任意模态组合生成
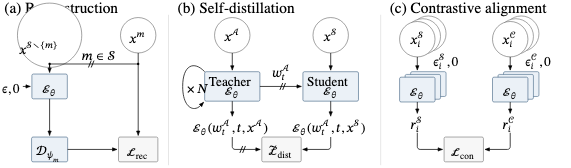
英文题目:MUNITE: Unified Multimodal Latent Inference for Any-to-Any Multimodal Generation
标签:#音视频生成 | #流匹配 | #音视频 | #知识蒸馏 | #对比学习
评分:6.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Kyeongmin Yeo:KAIST
- Minhyuk Sung:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
该任务以任意模态子集为输入并生成任意目标子集,要求生成结果在输入未指定的共享内容上保持一致,难点在于缺失模态的不确定性与跨目标一致性需同时处理。方法用单个条件流模型推断完整观测对应隐变量在给定子集下的条件分布,完整观测退化为确定性编码,空观测退化为边缘分布,抽取的一份共享隐变量再经各模态独立解码器并行生成。表示学习用跨模态重构保留跨模态信息,同一模型以更丰富证据下的预测在相同中间隐状态监督更小子集的预测,对比损失再对齐互补子集的语义。与把各模态后验相乘或为每个子集单独建模不同,该框架直接建模同一完整隐变量的任意子集条件。在PolyMNIST-D-Q象限条件下一到多生成中,以未被指定的数字一致性为指标,MUNITE为0.9904,高于MUNI的0.1074。在FFHQ64年龄性别条件下,以RGB-分割一致性为指标,MUNITE为0.8888,高于MUNI的0.6038,以法线误差为指标,MUNITE为0.0500,低于MUNI的0.1106。一致性结论依赖同一份共享隐变量解码,改用独立隐变量则回落到随机水平;上述比较限于完整元组评测与冻结验证器口径,PolyMNIST存在同数字图像跨训练与评测复现,FFHQ法线为伪标签且年龄性别仅为受控评测标注,图像文本音频三元组非同步采集且图像为合成,未验证真实同步采集下的表现。PolyMNIST-D-Q上可训练参数为19.33M,条件与无条件推断均用Euler50步,图像解码再用Euler50步。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
193. AdSpark:面向保住产品细节的多镜头广告视频数据集与评测

英文题目:AdSpark: A Large-Scale Dataset and Benchmark for Product-Centric Advertisement Video Generation
标签:#音视频生成 | #数据集构建 | #数据集 | #基准测试
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Zhifei Yang:机构信息未在 arXiv HTML 中可靠披露
- Zhao Jiang:机构信息未在 arXiv HTML 中可靠披露
- Keyang Lu:机构信息未在 arXiv HTML 中可靠披露
- Honghe Zhu:机构信息未在 arXiv HTML 中可靠披露
- Zheng Zhang:机构信息未在 arXiv HTML 中可靠披露
- Jingjing Lv:机构信息未在 arXiv HTML 中可靠披露
- Changping Peng:机构信息未在 arXiv HTML 中可靠披露
- Ching Law:机构信息未在 arXiv HTML 中可靠披露
- Zhen Xiao:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
以产品为中心的广告视频生成输入产品参考图和结构化广告说明,输出保留细粒度外观并讲清卖点的多镜头有声视频,难点是运动中外观漂移、跨镜头不一致及抽象卖点难用画面证明。数据构建先按10至1000秒时长与24或25帧率筛选电商广告,得到可处理的商品与视频对,为后续跟踪提供输入。接着用透明底参考图的掩膜初始化SAM2.1-Hiera-Large逐帧传播产品掩膜,按面积占比与相邻帧变化剔除异常帧,将连续有效帧切为5至20秒候选片段并经视觉语言模型质量过滤,输出高质量候选片段。这些候选片段连同合成广告一起送入GPT-5.5,由卖点生成含一至五个镜头的创意计划与镜头对齐音频脚本,再经Gemini-3.1-Pro-Preview复核产品身份与卖点一致性,形成约30万组三元组,其中真实子集约10万条、合成子集约20万条。AdSpark-Bench用220个与训练集无重叠商品的测试用例,从视觉质量、产品保真、指令遵循、时间连贯、音频对齐和广告效果六个维度做镜头感知评测。在AdSpark-Bench评测集上,用AdSpark-300K微调LTX-2得到的LTX-AdSpark相对基线LTX-2,在跨镜头产品一致性指标上从33.30提高到93.59,在镜头结构对齐指标上从46.29提高到77.53。在同一AdSpark-Bench评测集上,该微调模型相对同一基线LTX-2,在叙事连贯性指标上从33.77提高到89.89。结论适用于电商类实物产品竖屏短广告,对长尾品类和跨平台风格尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
194. SteerSpeech:用激活 steering 控制合成语音的情感强度

英文题目:Steerspeech: Activation Steering For Emotion Control In Generated Speech
标签:#韵律与风格控制 | #参数高效微调 | #文本到语音 | #语音 | #主观评测
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Afsara Benazir:机构信息未在 arXiv HTML 中可靠披露
- Darius Pétermann:机构信息未在 arXiv HTML 中可靠披露
- Felix Xiaozhu Lin:机构信息未在 arXiv HTML 中可靠披露
- Salar Rahili:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
预训练文本到语音模型能生成自然语音,但在推理时稳定控制情绪强度仍困难,提示词或参考音频控制粗糙,重新训练代价高。SteerSpeech先从配对情绪与中性话语的均值激活差提取原始情绪对比,再送入每种目标情绪的小型低秩残差变换做方向修正,并把幅度约束在参考幅度的±20%内。变换后方向按强度注入冻结的语音生成主干中间层,先自回归采样离散语音编码单元,再以教师强制回放并用直通估计器回传梯度,经可微解码器合成波形。合成波形由冻结的情绪专家、说话人专家和转写专家在多个强度上联合评价,组合损失只更新该变换,主干保持冻结,以实现情绪单调增强并约束说话人与内容漂移。论文在Qwen3-TTS-0.6B上验证愤怒、开心、悲伤控制,摘要报告相对基线目标情绪分数为1.08倍到7.12倍;混合评测中相对情绪参考基线愤怒、开心、悲伤分别达到约1.35倍、1.57倍、7.12倍,同时保持较低的说话人漂移和词错误率。代表性情绪的主观对比中情绪强度偏好为78.1%到96.8%,高强度下说话人身份保持约为朴素基线的1.43倍到1.46倍。结论适用于英语情感数据集训练、未见说话人和带口音说话人的推理时情绪增强,对悲伤等低唤醒情绪效果较弱,高强度下仍存在情绪与身份保持的权衡。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
195. 用注册语音库做证据:目标说话人标注的仿射不变校准
标签:#说话人识别 | #说话人验证 | #不确定性估计与校准 | #语音
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Hee-Soo Heo:机构信息未在 arXiv HTML 中可靠披露
- Minjae Lee:机构信息未在 arXiv HTML 中可靠披露
- Youngki Kwon:机构信息未在 arXiv HTML 中可靠披露
- Bong-Jin Lee:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
目标说话人标记的输入是长时多人录音和每位注册说话人的注册语音,输出是把每个已切分片段标为某个注册身份或拒识为非目标,难点是短片段分数不可靠且共用全局阈值要求不同说话人分数可比。论文先分析常用分数归一化,指出注册语音按会话聚集,使按说话人计算的均值方差反映注册聚集而非冒认行为,直接归一化会整体平移不同说话人并破坏可比性。方法保留标识器选出的最高分候选不变,只校准验证器一侧该候选的分数,校准分进入会话级高斯混合校准与全局阈值判决。离散度项输入当前片段对除候选外所有竞争者的分数,以上下分位点的对称分位半径度量铺展,铺展越宽扣减越多,以抑制宽分布顶端偶然越过阈值的误警。偏离度项把当前片段与其他注册人的关系形状与候选人注册时留下的关系形状做带偏移和非负缩放的拟合,只以拟合残差超出候选人正常残差水平的部分做第二重扣减,两项相减得到最终校准分。两项都不直接使用按说话人计算的均值方差,因此不受注册会话聚集带来的整体平移和缩放影响。在自有会议语料上,该方法指标检测识别率DIR@FAR=1%从未归一化基线的81.64%提高到85.25%,明确高于基线。适用范围是注册库较大且注册条件有结构可循的部署,注册库很小或声学条件完全均匀时收益消失,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/PalabraAI/redimnet2 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
196. 从一句话需求到多轮多模态指令:UniData 流水线解读

英文题目:UniData: Universal Multimodal Instruction Generation Pipeline
标签:#音乐生成 | #数据集构建 | #数据集 | #工具增强与约束解码
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.3/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Jiaqi Tang:The Hong Kong University of Science and Technology
- Yi-Feng Wu:ATH, Alibaba Group
- Yuting Zhang:The Hong Kong University of Science and Technology (Guangzhou)
- Hao Lu:The Hong Kong University of Science and Technology (Guangzhou)
- Bowen Fu:Northwestern Polytechnical University
- Qing-Guo Chen:ATH, Alibaba Group
- Xiaogang Xu:机构信息未在 arXiv HTML 中可靠披露
- Yuwei Hu:ATH, Alibaba Group
- Shiyin Lu:ATH, Alibaba Group
- Wei Wei:Northwestern Polytechnical University
- Lei Zhang:Northwestern Polytechnical University
- Zhao Xu:ATH, Alibaba Group
- Weihua Luo:ATH, Alibaba Group
- Qifeng Chen:The Hong Kong University of Science and Technology
- Ying-Cong Chen:The Hong Kong University of Science and Technology (Guangzhou)
📌 核心摘要
多模态大语言模型需要大量高质量多轮指令数据,但人工收集成本高,已有方法多只支持语言或单轮图文,难以同时保证模态广度、轮数长度与内容多样性。UniData要解决的是从用户给出的简单关键词需求出发,输出覆盖语言等九种模态、长程连贯的多轮指令,难点在于同一需求易生成重复或偏离主题的内容且多模态难以均匀分布。为此管线先随机配对九十个主题池中的两个主题并扩展为不同事件,再选定轮数、情感与场合生成多轮文本指令,随后预测图像、音乐等八类模态指示标记及对应提示词,最后调用外部工具链生成相应多模态内容嵌入指令。多模态指令生成器以LLaMA-3为骨干,用Ovis-1.5视觉分词器与Whisper音乐分词器等将图像和音乐映射到统一嵌入空间,并以特殊标记区分模态起止以实现逐轮预测。推理时该生成器计算新一轮与前k轮指令的余弦相似度均值,若低于0.05则提高温度增加随机性,若高于0.4则增大重复惩罚,只有居间才进入下一轮,从而纠正无关与重复。与只支持语言的Self-Instruct和只支持约1轮图文的VIGC相比,UniData在自建测试集上合理性、清晰度、细节与相关度四项GPT-4o评价指标均最高,例如相关度为0.682,平均轮数约17.5轮,平均每条含1.92张图像、0.74段音乐和7.37个其他模态。其多模态指令生成器在四块80GB A100上微调约40小时,多样事件生成器在单块80GB A100上微调约40小时。作者承认该管线是以文本为中心的编排而非原生任意模态互转模型,单模态质量受外部工具限制,且未覆盖视频、三维等模态。
🔗 开源资源
第三方资源:https://openai.com/index/dall-e-3/ — 链接不可用(HTTP 403)
第三方资源:https://www.apple.com/ — 链接可访问(HTTP 200)
第三方资源:https://pypi.org/project/qrcode/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
197. 多轮对话里该用哪段历史:ReTurn 如何测选择性历史使用

英文题目:When History Helps and Hurts: Selective History Use across Multimodal Turns
标签:#音视频问答 | #基准设计 | #基准测试 | #模型评估
评分:6.0/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Shuoyang Sun:机构信息未在 arXiv HTML 中可靠披露
- Kerui Gu:机构信息未在 arXiv HTML 中可靠披露
- Hao Fang:机构信息未在 arXiv HTML 中可靠披露
- Shaoli Huang:机构信息未在 arXiv HTML 中可靠披露
- Bin Chen:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
多轮多模态交互的难点是按当前请求选择性使用历史:早先问题可能要用于新的媒体,历史媒体也可能仍是回答当前问题的证据,而过时答案或竞争性新媒体会带来干扰。ReTurn先构造7000个有目标问题、目标媒体与正确答案的基础任务,覆盖视觉与音频证据,并配有匹配的单轮输入作为可答性参照。接着把基础任务嵌入多轮对话,任务携带历史把历史问题继承到当前媒体作答,证据携带历史则用历史媒体回答当前完整问题。再对每种历史只改上下文做配对对比:Reconfirm与Reground对比历史答案一致或冲突,Retrieve与Rebind对比当前非目标媒体竞争弱或强,目标问题、目标媒体与正确答案保持不变。每个任务有开放问答与四选一选择题两种呈现,13个全模态、视觉语言与音频语言模型的中位开放问答准确率从直接输入的93.7%降到多轮对话的72.3%,长对话与冲突条件下降更大。诊断显示模型能复述历史问题却用不好,替换当前竞争媒体也会改变答案指向,推理时重述与监督微调只能部分修复。该结论只适用于引用明确、历史较短且媒体可能跨划分复用的受控构造,明确改述、长程终身对话、完全独立媒体与多人复核范围尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://link-world.github.io/ReTurn/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
198. 用脉冲竞争选专家:SpikeMoE 如何兼顾稀疏计算与缺失模态

英文题目:SpikeMoE: Brain-Inspired Competitive Routing for Flexible Spiking Mixture-of-Experts
标签:#语音情感识别 | #混合专家模型 | #多模态学习 | #高效推理 | #鲁棒性
评分:5.9/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xiaoli Liu:机构信息未在 arXiv HTML 中可靠披露
- Yujie Liang:机构信息未在 arXiv HTML 中可靠披露
- Jialin Li:机构信息未在 arXiv HTML 中可靠披露
- Chenxiao Dou:机构信息未在 arXiv HTML 中可靠披露
- Malu Zhang:School of Computer Science and Engineering,;University of Electronic Science and Technology of China
📌 核心摘要
论文处理的不完整多模态感知任务输入是视频、文本、音频等模态的脉冲编码特征,输出是类别或情感极性分数,难点是传统混合专家模型(Mixture-of-Experts,MoE)用连续 Softmax 打分选专家,与脉冲神经网络(Spiking Neural Networks,SNN)的离散事件计算不兼容,且缺失模态会破坏路由依据。脉冲 k-WTA 路由器(k-Winner-Take-All Router)把输入电流送入泄漏积分发放神经元,用可学习侧抑制矩阵压低已发放专家对应其他专家的膜电位,再用不应期计数器阻止同一专家连续独占,最后按 \(t\) 个内部仿真步内的脉冲计数取 Top-K 并按计数比例分配权重。两阶段缺失模态建模先从训练集观测模态池中采样 \(K\) 个同模态实例取均值补全,池不可用时回退到模态专属可学习嵌入,使各模态编码器仍能接收完整输入序列。补全后的多模态脉冲特征经过多头脉冲自注意力与脉冲专家多层感知机处理并输出任务损失。与直接替换前馈层的脉冲基线和连续 Softmax 门控相比,该组合保留了稀疏条件计算并减少了乘加操作。在 CMU-MOSI 缺失率为 50% 的随机丢弃设置下,SpikeMoE 的 F1 为 43.54%,AUC 为 67.30%,在同表 SNN 方法中居首并接近 FuseMoE 等人工神经网络方法。结论适用于论文测试的图像分类、语言理解和三模态情感与视听分类范围,视频加音频组合效果仍偏弱,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
199. OmniConfess:让全模态大模型交代每个词依赖了哪路证据再改错

英文题目:OmniConfess: Eliciting Token Confessions to Mitigate Omni-Modal Hallucination
标签:#音视频理解 | #不确定性估计与校准 | #基准测试 | #幻觉与忠实度 | #音视频
评分:5.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Huiqiang Rong:机构信息未在 arXiv HTML 中可靠披露
- Haoran Luo:机构信息未在 arXiv HTML 中可靠披露
- Hui Feng:机构信息未在 arXiv HTML 中可靠披露
- Zhonghong Ou:机构信息未在 arXiv HTML 中可靠披露
- Kaiwen Xue:机构信息未在 arXiv HTML 中可靠披露
- Guoxin Zhang:机构信息未在 arXiv HTML 中可靠披露
- Yifan Zhu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
全模态大语言模型把文本、图像、音频和视频放在同一生成模型中联合推理,输出时可能依赖无关证据或未充分使用相关证据,产生跨通道幻觉。OmniConfess先用完整证据自回归解码得到候选回答并冻结其词元和前缀,以消除证据干预之间的轨迹变化。再逐个移除证据通道并用教师强制方式重算冻结候选的对数概率,得到逐词元逐通道的自白结构,并按任务规则把相关通道与无关通道分开。该自白结构用于判断题重打分或生成题的局部改写,只改写被定位的错误片段而保留其余内容。与重新生成候选的搜索方法和改变解码分布的证据对比方法不同,该方法不改变待比较序列,只改变证据条件,使证据效应与轨迹变化分离。在Qwen2.5-Omni-7B上,OmniConfess在6个数据集的平均F1为65.10,超过最强基线CAD的55.40。作者报告该方法需要多次通道级重打分,例如在CMM上耗时35.14秒,原文未披露训练成本细节,该方法本身无需额外训练。该结论适用于六个数据集与三种主干上的判断与生成任务,但模型关注到相关通道仍可能误读模糊判断,附录案例显示有效改写也无法消除单参考词面失配,对主观解释错误的修正仍可能失败。
🔗 开源资源
- 第三方资源:https://github.com/RongHuiQiang/OmniConfess — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
200. 推理时改标签能不能救回声音场景分割:检测与提取流水线的更新实验

英文题目:Evaluating Inference-time Algorithms for Semantic Sound Scene Segmentation
标签:#音频分离 | #测试时自适应 | #音频分类 | #多通道
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Sripathi Sridhar:New Jersey Institute of Technology, Newark NJ, USA;Mitsubishi Electric Research Laboratories (MERL), Cambridge, MA, USA
- Gordon Wichern:Mitsubishi Electric Research Laboratories (MERL), Cambridge, MA, USA
- Yoshiki Masuyama:Mitsubishi Electric Research Laboratories (MERL), Cambridge, MA, USA
- Mark Cartwright:New Jersey Institute of Technology, Newark NJ, USA
- Jonathan Le Roux:Mitsubishi Electric Research Laboratories (MERL), Cambridge, MA, USA
📌 核心摘要
空间语义分割要求从四通道空间音频混合中检测最多3个目标事件并输出每个事件的单通道分离信号与类别标签,类别正确才计分离增益,误报和漏报按0分惩罚,检测错误会直接拖累分离。论文采用分类器加目标提取的两阶段链路,先由多标签分类器预测标签并作为提示送入多通道统一分离模型得到分离估计,再由重标注器提出候选标签组合并由评估模型加适配函数打分选优,门控函数决定是否对该片段启用更新。与把预测标签视为可靠的迭代精炼不同,该工作允许改变标签数量和类别并引入混合一致性约束。在DCASE 2025 Task 4测试集1500个片段上,最好的多标签分类器加条件混淆矩阵重标注加二元交叉熵与混合一致性组合在基线类别感知信号失真比提升为4.79 dB的563个低分片段上达到6.36 dB,比基线提高1.56 dB。但该组合在全部1500个片段上从基线12.24 dB降至11.08 dB,说明无差别启用更新会降低整体性能,增益仅适用于基线不高于10 dB等分离起点较差的片段。在留出评测集1620个片段上冻结阈值的归一化熵门控选出基线为4.92 dB的298个片段并将其提升0.18 dB,整体从基线8.61 dB变为8.64 dB,仅带来0.032 dB提升。原文明确该结论尚未在每类目标含多个声源或无目标声源的情形验证,如DCASE 2026 Task 4所涉及设置,仍需源计数或放宽标签假设等后续工作。原文披露了单卡批量大小为2训练150轮等训练配置,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/merlresearch/unified-source-separation — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
201. 把互动叙事设计变成可重复跑分的公开基准

标签:#音乐生成 | #基准设计 | #基准测试 | #公平性
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.5/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Hartmut Koenitz:Södertörn University, Alfred Nobels allé 7, 141 89 Huddinge, Sweden
- Jonathan Barbara:Saint Martin’s Institute of Higher Education, Hamrun, Malta
- Mirjam Palosaari Eladhari:Stockholm University, SE-106 91 Stockholm, Sweden
📌 核心摘要
交互式数字叙事指受众能对进展、视角、内容和结局施加实质影响的叙事体验,其设计质量没有唯一正确答案,涉及文本、图像、音频、视频与代码等多种形态,传统单答案基准难以覆盖。论文把GenAI4IDN Benchmark 3.0做成公开网络应用,先由应用程序接口调用向选定生成模型发送20组设计任务提示并生成制品,音乐等无接口内容则经导入页补入。完整游戏制品先进入自动试玩器运行,试玩器在沙箱中实际游玩并输出截图与过程记录,再作为证据交给文本委员会评分者判断可玩性。评测侧保留4个文本委员会评分者并做盲评去标识,新增事实核查评分者联网核查并取三次运行中位数以应对泛化与时间错配,另设偏见检测评分者从公平性、表征与敏感性打分。与已有封闭式基准的关键差异在于采用专家式定性打分而非对照参考答案计分,意味着可评开放创意与交互结构而非唯一正确性。排行榜上,在灵感、训练和制作三维均值之和指标下,量程为0-15且至少完成8个任务的参评条件下,Claude Opus 5得12.04分,高于其他参评模型居首。推理增强带来思维失控占满输出而无结果、过严安全过滤拒答无害创意提示等失败模式仍会出现,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://genai4idn.com — 链接可访问(HTTP 200)
第三方资源:https://genai4idn.com/tasks — 链接可访问(HTTP 200)
第三方资源:https://genai4idn.com/models — 链接可访问(HTTP 200)
第三方资源:https://genai4idn.com/raters — 链接可访问(HTTP 200)
第三方资源:https://genai4idn.com/rubrics — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
202. 长视频问答中全局覆盖与问题相关细节如何兼得:VideoTapestry 的分层记忆细化解读

英文题目:VideoTapestry: Query-Adaptive Memory Refinement for Multi-Agent Long-Video Understanding
标签:#音视频问答 | #工具增强与约束解码 | #音视频 | #检索增强 | #长上下文
评分:5.9/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Yucheng Liu:University of Science and Technology of China;Jilin University
- Yufei Yin:Hangzhou Dianzi University
- Mingxiao Feng:Institute of Artificial Intelligence, Hefei Comprehensive National Science Center
- Jiajun Deng:University of Science and Technology of China;Institute of Artificial Intelligence, Hefei Comprehensive National Science Center
- Wengang Zhou:University of Science and Technology of China;Institute of Artificial Intelligence, Hefei Comprehensive National Science Center
- Houqiang Li:University of Science and Technology of China;Institute of Artificial Intelligence, Hefei Comprehensive National Science Center
📌 核心摘要
长视频问答输入为完整长视频、问题与选项,输出为选项预测,难点在于既要保留跨越全片的全局叙事,又要捕捉仅在短暂片段出现的决定性证据。VideoTapestry先沿用MemDreamer流程预建分层静态记忆,分别承载全局叙事、事件级时序结构与细粒度关系证据。查询到来后,概览智能体先在全局摘要尺度上定位相关分支并改写对应记忆,再将候选子节点与检查指令下传,略读与聚焦智能体依次在事件与局部子图尺度上回看视频并补充多模态观察。组装环节保留细化后的全局支架,并将选中的事件与子图细化记忆放回原有父节点之下,形成复合查询自适应记忆,独立作答智能体仅据此记忆作答而不再检索观察。与易受定位误差影响的查询驱动探索及易遗漏问题相关细节的查询无关记忆构建不同,该框架不改动原有父子结构,只改写临时文本并压缩无关分支。在相同冻结GPT-5.5基座与相同评测样本的同源对比中,VideoTapestry在LVBench上的准确率为81.5%,高于直接推理基线的64.3%,高出17.2个百分点,并在同期对比的长视频基准上保持领先。结论适用于依赖预建全局事件、宏观事件与局部子图划分的视频,初始切分错误仍可能阻断证据获取。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
203. 离线语音翻译如何在边缘设备上自己发现并修正弱翻译

英文题目:Quality-Aware Self-Correcting Speech Translation on an Edge Device
标签:#语音翻译 | #模型集成 | #端侧运行 | #多语言
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Zubair Ajmal Farooq:School of CS and EE;University of Surrey;United Kingdom
- Diptesh Kanojia:Institute for People-Centred AI;University of Surrey;United Kingdom
📌 核心摘要
该工作要解决离线边缘设备上语音翻译级联误差累积的问题,输入为英语语音,输出为西班牙语语音,难点是小模型在 4GB 内存下容易出错且无法联网调用大模型。系统先用 Whisper-tiny 转写,再用 Opus-MT 贪心翻译,多语言 BERT(Multilingual BERT)余弦相似度作为质量估计门限决定是否进入第二遍修正,修正时用束搜索产生候选并重排,最后用 eSpeak-ng 合成。与已有云端翻译和单级端侧翻译不同,该系统把质量估计只用作触发器,并比较了三种修正策略的实际效果。在 1012 句 FLORES-200 英语到西班牙语开发测试集上,最小贝叶斯风险解码在阈值 0.90、候选数 10 时相对贪心基线 BLEU 提高 0.67 且 p<0.001。结论适用于受控书面文本的英语到西班牙语,约束束搜索在该设置下失效,更强的质量估计模型和自发语音条件尚未验证。原文披露单次约 10 秒语音在常驻内存架构下约 41 秒完成,修正额外开销约 13.2 秒,训练成本未披露。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
204. 从歌声录音写出合调粤语歌词:ARIA 的两段式做法

英文题目:ARIA: Audio-Driven Melody-Tone Relation Modeling for Cantonese Lyric Authoring
标签:#音乐生成 | #检索增强 | #音乐 | #数据集 | #大语言模型
评分:5.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Shengyu Li:机构信息未在 arXiv HTML 中可靠披露
- Jinting Wang:机构信息未在 arXiv HTML 中可靠披露
- Li Liu:The Hong Kong University of Science and Technology (Guangzhou)
📌 核心摘要
粤语填词要求歌词字调与旋律走向保持兼容,实际创作常从演唱录音或哼唱小样出发,音高隐含在伴奏、颤音和滑音之中,传统依赖符号化旋律的方法难以直接使用。ARIA设定输入为一段演唱录音加字级歌词槽位边界,输出为与槽位等长的粤语歌词行,中间经过显式的0243序列,即把6类粤语声调按演唱相对高度折叠成的0、2、4、3四档简写。第一阶段三流关系感知音调估计器从音频恢复每字高度档并映射为0243,第二阶段解耦检索增强音调条件歌词生成器以该序列为控制条件检索词例并生成歌词,前者输出的整行序列直接作为后者的控制输入。在音频到0243结果表1的评测设置下,TRATE以字准确率TokAcc 0.644高于最强的Qwen3.5三流基线Qwen 3-Br的0.565。在同一音频到0243结果表1的评测设置下,TRATE以归一化编辑距离NED 0.347低于同一Qwen 3-Br基线的0.398,数值越低序列越稳定。在0243到歌词消融表4的评测设置下,两阶段检索的DRA-TCLG以对齐指标Harmony 0.9740和Consistency 0.9421高于单阶段检索的0.6449和0.1579,说明先学好映射再引入词例才能保持对齐。结论只适用于粤语,0243词表、粤语拼音映射与词典都需替换后才能迁移,原文披露TRATE在单块NVIDIA A800上约2.8小时主训练与DRA-TCLG在单块NVIDIA H20上约7小时主训练,不含基线、消融、评测与推理开销。
🔗 开源资源
第三方资源:https://www.feitsui.com/ — 链接可访问(HTTP 200)
第三方资源:https://www.0243.hk/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
205. 双人多语对话中谁何时说了什么:级联与统一两种做法的比较
标签:#多说话人语音识别 | #说话人分离标注 | #SFT | #多语言 | #数据增强
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Takanori Ashihara:机构信息未在 arXiv HTML 中可靠披露
- Kohei Matsuura:机构信息未在 arXiv HTML 中可靠披露
- Masato Mimura:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
任务输入是包含两名说话人的多语言自然对话长录音,输出要求同时给出谁在何时说话以及说了什么,难点在于没有给定话语边界和说话人标签,还要处理多语言口音和说话人归属。级联系统先由说话人分离标注(speaker diarization)模型切出带说话人标签的片段,再由语音大语言模型对每个片段做识别,最后用大语言模型做生成式纠错(generative error correction,GEC),上一步的时间戳和说话人标签直接决定下一步识别哪段音频。统一系统则用单个语音大语言模型从长音频直接生成带时间戳、说话人标签和文本的结构化输出,省去人工设计的模块接口。与已有方法的区别在于全部微调和选型只用官方训练集和开发集,不用外部数据或伪标签,并针对标注外语音被置静音的失配做了静音掩蔽预处理。在静音掩蔽后开发集上以5秒容差按语言平均的比较中,级联最终系统平均时间受限词/字错率(time-constrained minimum permutation word/character error rate,tcpWER/tcpCER)为15.28%,低于统一模型的18.50%。在评估集排行榜结果中,级联系统加入SpecAugment和GEC后同一平均时间受限词/字错率从16.70%降到16.27%。结论只适用于双人会话、计算受限且统一模型只能按约60秒切块微调的条件,原文披露计算条件为至多4张NVIDIA RTX 6000 Ada,每张48 GB显存,未披露完整训练时长。
🔗 开源资源
第三方资源:https://github.com/microsoft/VibeVoice/blob/main/vllm_plugin/tests/test_api_auto_recover.py — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/BUT-FIT/diarizen-wavlm-large-s80-md — 暂时无法访问
第三方资源:https://huggingface.co/pyannote/wespeaker-voxceleb-resnet34-LM — 暂时无法访问
第三方资源:https://github.com/wenet-e2e/wespeaker/blob/master/docs/pretrained.md — 链接可访问(HTTP 200)
第三方资源:https://github.com/mubingshen/MLC-SLM-Baseline — 链接可访问(HTTP 200)
第三方资源:https://huggingface.co/Qwen/Qwen3-ASR-1.7B — 暂时无法访问
第三方资源:https://huggingface.co/Qwen/Qwen3.6-27B — 暂时无法访问
第三方资源:https://huggingface.co/microsoft/VibeVoice-ASR — 暂时无法访问
第三方资源:https://github.com/alanshaoTT/MLC-SLM-2nd-Task1-Baseline — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
206. 把合成器参数空间 reinterpret 为音色塑形效果器控制空间

英文题目:CTAG-FX: Reinterpreting Synthesizer Parameter Spaces for Expressive Tone-Shaping Audio FX Design
标签:#音频生成 | #信号处理 | #检索增强
评分:5.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.7/1 | 影响力 0.7/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Geonung Jo:机构信息未在 arXiv HTML 中可靠披露
- Jongeun Choi:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
已有文本引导音频效果研究多在既有效果器模块和参数链空间内寻找配置,论文关注单个效果器内部控制空间本身如何构造。输入是自然语言描述的音色意图,输出是固定配置的音色塑形处理器,可反复处理新的外部演奏音频,难点在于合成器的振荡器、包络和调制功能无法直接搬到外部音频处理。论文先用检索增强的A&R-CTAG生成文本条件合成器配置,其中检索种子与随机候选各半组成初始种群并沿用原优化目标,再用CTAG-FX按功能角色把七十八维参数组映射为前级均衡、音色堆栈、两级驱动、后级均衡、噪声和混合增益控制,其中调制矩阵保留为静态交叉路由。相对已有工作,设计对象从既有空间内的语义控制变为合成器参数组织衍生的控制空间构造。在合成器侧表示生成比较中,相同三百轮优化预算下在十个提示上以LAION-CLAP相似度为指标,最终得分均值CTAG为0.6166而A&R-CTAG为0.7545,方向为提高。处理器侧在四个音色提示、每提示十个配置、同一段十秒清音吉他上做信号层分析,角色映射产生随提示区分的谱与非线性行为,打乱映射则减弱该区分性。结论仅适用于信号层面的提示区分性,不代表跨乐器泛化或听感对应成立,原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://taylor3527eg-hub.github.io/ctag-fx-platform-demo/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
207. 靠自身运动学会去卷积:空中声呐图像如何变清晰

英文题目:Self-Supervised Deconvolution of In-Air Sonar Images Using Sensor Ego-Motion
标签:#声源定位 | #自监督学习 | #波束成形 | #麦克风阵列
评分:5.9/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jan Steckel:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
宽带空气声呐经延迟求和波束成形形成能量景图,输入是每脉冲各通道匹配滤波后的信号,输出是距离与方位上的能量分布,难点是旁瓣高、主瓣向两侧展宽,且完整点扩散函数包含发射器频谱、指向性和麦克风失配而难以标定。方法把单帧能量景图送入反卷积网络得到几何反射率图,再按轮式里程计和陀螺仪用声流方程把该图扭曲到后续脉冲位姿,最后经可学习的物理结构前向模型渲染成预测景图并与实测景图比较。重建项约束本帧解释,预测项迫使旁瓣不能被解释成沿错误轨迹运动的虚假反射体,稀疏项和传感器先验约束解的集中性和指向性平滑。与已有方法的差异是点扩散函数参数与网络权重联合学习,不需要真值反射体图或精确标定。在仿真房间四百个验证脉冲的图像质量汇总中,该方法把真值回波附近能量占比Enear提高到0.64,高于最佳延迟相乘求和变体的0.59和使用真实点扩散函数的CLEAN的0.62,同一仿真训练设置下原文报告一次训练约九十五分钟。在同一四百个验证脉冲汇总和点反射体测试中,该方法负六分贝宽度在中心与两侧均为7°,低于名义点扩散函数下经典反卷积在两侧的11°到19°,点反射体全视场保持5°到6°,而延迟求和为12°到30°。适用范围限于二维方位成像的仿真房间和光滑运动,真实数据、三维扩展和从原始麦克风信号直接学习波束成形尚未验证,推理为单次前向并可导出为ONNX在嵌入式图形处理器执行,原文未披露具体推理延迟数值。
🔗 开源资源
- 第三方资源:https://youtu.be/N40WfdwaAUs → https://www.youtube.com/watch?v=N40WfdwaAUs&feature=youtu.be — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
208. 面向固定类别的语言查询音频分离:数据清洗与 CLAP 控制信号解耦优化

标签:#音频分离 | #提示学习 | #数据集构建 | #主观评测
评分:5.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Amirhossein Hajavi:机构信息未在 arXiv HTML 中可靠披露
- Hanhee Lee:机构信息未在 arXiv HTML 中可靠披露
- Pushya Jain:机构信息未在 arXiv HTML 中可靠披露
- Sky Qiao:机构信息未在 arXiv HTML 中可靠披露
- Emmanuel Ko:机构信息未在 arXiv HTML 中可靠披露
- Yuanhao Yu:机构信息未在 arXiv HTML 中可靠披露
- Irina Kezele:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语言查询音频源分离(Language-queried Audio Source Separation,LASS)输入混合音频和自然语言描述,输出指定类别的目标声波形,难点是训练集中目标声不纯、标签与实际内容错位,以及对比语言音频预训练(Contrastive Language-Audio Pre-training,CLAP)嵌入对通用类别及其子类的覆盖不足。论文先用音频描述模型为候选音频写出内容说明,再用大语言模型作评判,只保留单声类且属于 7 个目标类的样本,输出干净的微调集。接着为每类准备大量文本描述和代表性音频,先按文本均值嵌入与音频嵌入的余弦距离约束筛选保留尽量多的提示,再把保留提示的均值向量用随机梯度下降继续优化,优化后的向量作为微调和推理的控制信号。与直接用 AudioSep 基线相比,在相同 7 类测试上平均信号失真比提升(Signal-to-Distortion Ratio improvement,SDRi)从 2.753 提高到 5.610,尺度不变版本也从 7.386 提高到 11.904。17 人主观偏好中优化模型对基线胜率 39.07%,负率 24.63%,其余为平局,对商用方案也有优势。结论只适用于所选 7 类和 AudioSep 加特征线性调制(Feature-wise Linear Modulation,FiLM)链路,Crowd 和 Wind 类因原始数据不足还混入了生成与手工补充样本。原文未提及训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://amhajavi.github.io/AudioSourceSeparation → https://amhajavi.github.io/AudioSourceSeparation/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
209. 把一次跨域模拟走得更稳:源方向轨迹扰动的语音伪造检测域泛化

标签:#音频深度伪造检测 | #元学习 | #域泛化 | #语音
评分:5.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Siqing Qin:机构信息未在 arXiv HTML 中可靠披露
- Kong Aik Lee:机构信息未在 arXiv HTML 中可靠披露
- Youzhi Tu:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音深度伪造检测需要判断输入语音是真实录音还是合成或转换语音,输入为波形,输出为真伪得分,难点是测试时的生成器、编码器和录音条件与训练源域不同。元学习域泛化(meta-learning for domain generalization,MLDG)把源域随机分成元训练集和元测试集,用前者做一次虚拟更新,再在后者上评估迁移效果。论文指出该目标只考虑一条干净轨迹,没有约束起点和终点附近的局部损失变化。显式方案 WC-MLDG-4P 在轨迹两端分别做锐度感知扰动与二次求梯,共需四次梯度计算。高效方案 WC-MLDG-2P 只计算一次干净源梯度,把干净终点沿该梯度归一化方向偏移距离 \(\rho\),再在偏移点计算一次元测试梯度。与元学习域泛化相比,WC-MLDG-2P 在 XLSR-AASIST 上平均等错误率相对下降 23.4%,在 XLSR-Conformer-TCM 上相对下降 7.6%,四个测试集均有改善。该结论限于只用 ASVspoof 2019 LA 训练、评测四个未见集合的设置,扰动半径取固定值时并非每个子集最优。原文披露每次迭代的梯度计算次数,未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/TakHemlata/RawBoost-antispoofing — 链接可访问(HTTP 200)
第三方资源:https://github.com/tomgoldstein/loss-landscape — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
210. 在实验室和日常录音中区分对儿童和对成人说话

英文题目:Benchmarking Adult Addressee Classification Across Child- and Adult-Directed Speech Datasets
标签:#音频分类 | #自监督学习 | #韵律 | #基准测试 | #可解释性
评分:5.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Sofoklis Kakouros:Signal Processing Research Centre Tampere University Tampere, Finland
- Daniil Kocharov:Signal Processing Research Centre Tampere University Tampere, Finland
- Okko Räsänen:Signal Processing Research Centre Tampere University Tampere, Finland
📌 核心摘要
本文研究判断成人话语是说给儿童还是说给成人的二分类问题,输入为话语级语音片段,输出为儿童导向语音与成人导向语音标签。难点在于自然长录音中噪声、混响、距离变化、重叠语音和标注不确定性会掩盖细微韵律差异,且声学差异随数据集、环境与说话人变化而不稳定。方法先用冻结的HuBERT与WavLM等语音编码器把每条语音转为帧级向量,再经均值、均值加标准差或协方差时间池化压缩为定长表示。该定长表示送入轻量前馈分类器输出两类对数几率并用交叉熵训练,池化嵌入与分类器对数几率再分别作为输入,用岭回归探针预测同条语音的openSMILE eGeMAPS声学特征,以检验韵律信息保留程度。ManyBabies按BabyID家庭留出五折评测下,WavLM-large均值加标准差池化平均准确率为0.917、平均F1为0.933,高于eGeMAPS基线的0.714和0.788。ACLEW按采集地点留出四折跨地点评测下,最优平均准确率为0.644、平均F1为0.660,高于eGeMAPS基线的0.551和0.154。池化间性能差异较小,但投影到512维时首层参数分别约为0.39、0.79、150.8百万,协方差路径开销明显更大,原文未报告硬件、实际训练耗时和推理延迟;结论适用于英语受控室内与日间长录音对比,其他语言与更恶劣录音条件未验证。
🔗 开源资源
- 第三方资源:https://archive.mpi.nl/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
211. 只用健康飞行声音发现无人机故障:机动感知的两阶段声学检测

英文题目:Unsupervised Maneuver-Aware Acoustic Fault Detection for Autonomous Drones
标签:#异常声音检测 | #无监督学习 | #实时处理 | #端侧运行
评分:5.9/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ali M Ali:机构信息未在 arXiv HTML 中可靠披露
- Ziyi Tang:机构信息未在 arXiv HTML 中可靠披露
- Nurdaulet Nazarbay:机构信息未在 arXiv HTML 中可靠披露
- Hashim A. Hashim:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
无人机推进故障会改变声场,但健康机动也会系统性改变声谱,两者在单麦克风下容易混淆,收集带标签故障飞行数据又困难且不安全。论文输入为机载麦克风采集的音频和机动相关标签,输出为每段音频的重构误差异常分数和正常与故障的二值判定。音频先转为对数梅尔语谱图,再经过受机动条件约束的去噪网络抑制随机噪声,得到去噪语谱图后送入机动条件卷积自编码器建模各工况下的正常声学形态,测试时用第二阶段输入与其重构之间的差异计分。与把机动差异当作噪声的单分布重构方法不同,该框架在去噪和重构两处都注入机型与飞行方向信息。与无条件基线相比,完整模型在评测集上将 ROC 曲线下面积从 0.561 提高到 0.884,召回率达到 0.907,误报率为 0.296。结论适用于三款四旋翼机、六种飞行方向和桨叶破损与电机盖变形两类注入故障,强机动噪声遮蔽和标签缺失时的可靠性仍需验证。原文披露部署成本为每段音频端到端约 20 ms,满足连续处理需求。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
212. 只看听者脸、只听说话声:如何推断听者的情绪反应

标签:#语音情感识别 | #领域适应 | #半监督学习 | #音视频 | #大语言模型
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Wei Wang:Guangdong University of Technology, Guangzhou, China
- Zhaowu Li:Guangdong University of Technology, Guangzhou, China
- Jianjie Luo:Guangdong University of Technology, Guangzhou, China
- Fu Lee Wang:Hong Kong Metropolitan University, Hong Kong, China
- Lap-Kei Lee:Hong Kong Metropolitan University, Hong Kong, China
- Zhenguo Yang:Guangdong University of Technology, Guangzhou, China
📌 核心摘要
交谈者情绪识别要求从听者视频、说话人音频和对应文本推断听者情绪,输出为中性、愤怒、高兴、悲伤、担忧、惊讶六类之一,难点在于训练标签标注的是说话人且无标注听者数据可用,说话人表情与标签常不一致,听者细微反应又依赖说话人上下文才能区分。角色感知视觉迁移(Role-aware Visual Transfer,RVT)先用视觉语言模型委员会保留表情与标签一致的说话人样本并训练初始视觉教师,再用说话人检测筛选非说话听者轨迹并以高置信度伪标签向听者域适配,结合整体表情分支与局部行为分支形成听者视觉专家。刺激引导边界推理(Stimulus-guided Boundary Reasoning,SBR)只在视觉前两名分差小于阈值时启动,把说话人音频预测与文本组织为诱发刺激证据,并将大语言模型选择限制在视觉前二候选内。与已有把三模态同等视为同一人证据的融合做法不同,该框架区分听者直接证据与说话人刺激上下文,避免用说话人情绪覆盖视觉判断。在 MER-Cross 测试集上以加权平均 F1(Weighted Average F1-score,WAF)为官方排序指标,该框架达到 76.25%,高于 CLIP-large 基线。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
213. 电商多视频比较:AdsCVR 基准与主动找证据的 AdSeek

英文题目:Beyond Single Videos: Benchmarking and Active Evidence Seeking for E-Commerce Cross-Video Reasoning
标签:#音视频问答 | #强化学习 | #基准设计 | #数据集
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Jinghan Zhao:机构信息未在 arXiv HTML 中可靠披露
- Yiman Hu:机构信息未在 arXiv HTML 中可靠披露
- Liang Wu:机构信息未在 arXiv HTML 中可靠披露
- Jian Xu:机构信息未在 arXiv HTML 中可靠披露
- Bo Zheng:Alibaba Group
📌 核心摘要
电商广告视频把产品演示、卖点讲解和促销信息压缩在几十秒内,信息分布在画面、语音和屏幕文字中,消费者与商家经常需要跨视频比较同类商品或营销手法,输入是两到四个可比视频加一个单选题,输出是选项答案,难点是决定性证据分散在不同视频、非连续时段和不同模态中,且被大量冗余帧淹没。论文先构建 AdsCVR 基准,经过过滤与分组形成多维度选择题,再让 AdSeek 智能体按比较目标多轮调用视觉与语音工具获取证据,最后用修正自举流程训练取证策略。初始强化学习暴露取证瓶颈,离线修正补齐缺失证据并改写错误推理,有监督微调把修正内化后,再做一轮强化学习精化策略。与已有单视频广告评测和均匀采样视频理解的区别在于,搜索范围按问题动态扩展到视频、时段、模态和区域,并在回答前对齐跨视频证据。在 AdsCVR 测试集上,混合训练的 AdSeek 准确率为 74.30%,高于 Qwen3-VL-8B-Instruct 基线的 46.40%,方向为越高越好,但仍低于 GPT-5.5 的 82.40% 和 Gemini 3.5 Flash 的 77.73%。结论适用于电商广告这类信息密集视频的细粒度比较,向通用跨视频任务的迁移仍需更多验证,原文报告了微调与强化学习所用计算单元数量,但未披露完整训练时长与推理延迟数值。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
214. 用带扰动音频的偏好优化让音频大模型更听声音

标签:#音频问答 | #偏好优化 | #幻觉与忠实度 | #音频大模型
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Bebe Cosgrove:机构信息未在 arXiv HTML 中可靠披露
- Aaron Isidore Grace:机构信息未在 arXiv HTML 中可靠披露
- Weiran Wang:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
大音频语言模型同时接收音频与文本时容易忽略声音线索,转而依赖文本先验编造答案,特别在需要时间推理与存在判断的选择题中出现幻觉。论文提出音频版多模态直接偏好优化(multimodal Direct Preference Optimization,mDPO),先为每道题组装偏好元组:以文本问题配正确与错误选项构成答案偏好对,同时以原始音频配时间反转、随机噪声或频率掩蔽等扰动音频构成声学对比对,前者提供对错信号,后者提供只有依靠音频才能区分的条件。接着标准偏好项在完整输入下比较正确与错误回答的隐式奖励以保持指令跟随,其保留的基线偏好能力进入下一步的条件比较。条件偏好项固定同一问题与正确回答,拉开其在原始音频与扰动音频下的奖励差距,迫使模型利用声学差异作答,而锚定偏好项再把正确回答在原始音频下的奖励约束在阈值之上,防止相对差距靠压低绝对似然实现,三项相加直接更新模型权重。与只在推理时修正 logits 的对比解码不同,该方法把对比信号写入模型权重。在 DCASE 2025 测试集上三重混合扰动相对基线准确率从 56.0%提高到 70.0%。在 AH Existence 上时间反转扰动把准确率从 55.6%提高到 83.0%。结论限于 Qwen2-Audio 骨干与上述两类问答设置,未验证音频描述等开放任务。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
215. 分阶段学会情感语气和环境音的语音生成

英文题目:VoiceWeaver: Staged Learning of Structured Controls for Expressive Speech and Sound-Event Generation
标签:#文本到语音 | #韵律与风格控制 | #持续学习 | #知识蒸馏 | #课程学习
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xiaosu Su:机构信息未在 arXiv HTML 中可靠披露
- Yun Cao:机构信息未在 arXiv HTML 中可靠披露
- Yiping Ni:机构信息未在 arXiv HTML 中可靠披露
- Xiaowei Yi:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
需要生成的语音同时满足文字内容、说话人、情感这类整体状态、gentle 等文本相关的表达方式,以及 rain 等非语音环境声,难点是三类监督来源不同且声学边界不同,顺序加入新控制时容易遗忘旧控制,多个条件同时给定时也未必同时实现。VoiceWeaver 把可选标签做成前缀嵌入后与说话人标记和文本拼接成一条条件序列,送入自回归声码本模型生成音频标记再重建波形。学习按情感、语气、事件三阶段展开,后阶段用冻结的前一阶段模型在回放样本上做分布保持约束,并对三组标签嵌入做去相关约束与标签缺失训练以支持不完整输入。相对参考音频控制与开放式文本描述控制,该工作使用小而明确的标签词表,并把单属性正确率、情感与事件联合正确率与三属性同时正确率分开评测。在每语言 720 组文本标签组合的情感与事件联合测试中,中文联合正确率为 70%,高于混合任务训练的 56% 与 Ming-omni-tts 的 48%。结论限于中英双语封闭标签集合,语气对文本依赖明显,较弱或连续事件可能被掩蔽,且录音级隔离未经证实。原文报告三阶段分别为 80K、50K 与 60K 步,后阶段回放占 10%,未披露硬件型号与训练时长。
🔗 开源资源
- 第三方资源:https://anonymous.4open.science/api/repo/VoiceWeaver1-4D88/file/index.html — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
216. 让音频大语言模型留住说话人信息:两阶段说话人保持

英文题目:TS-SP: Learning Speaker-Preserving Representations in Audio Large Language Models
标签:#说话人验证 | #LoRA | #音频大模型 | #语音
评分:5.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Junjie Li:机构信息未在 arXiv HTML 中可靠披露
- Zheng Liang:机构信息未在 arXiv HTML 中可靠披露
- Zhe Li:机构信息未在 arXiv HTML 中可靠披露
- Tianchi Liu:机构信息未在 arXiv HTML 中可靠披露
- Kong Aik Lee:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
音频大语言模型(Audio Large Language Model,ALLM)能理解语音内容,但直接判断两段语音是否来自同一说话人时表现较弱,多用户场景下难以可靠地使用身份线索。本文研究的问题是说话人身份保持(speaker identity preservation),即保留可区分身份的音频线索,并让生成文本的语言模型(Language Model,LM)能使用这些线索完成验证。输入是两段待验证语音,输出是同一或不同说话人的判断及连续分数,难点在于原生音频编码器缺少说话人判别目标,而语言模型也不熟悉说话人比较任务。方法分为两步:第一步在音频编码器中间层输出上做说话人监督,用统计池化和说话人分类头训练音频低秩适配(Low-Rank Adaptation,LoRA)参数;第二步冻结已适配的音频通路,把两段音频加静音拼接后送入模型,用回答是或否的成对损失训练语言模型 LoRA 参数。推理只走原生音频到语言通路,不使用说话人分类头。与直接对音频和语言模型联合做成对问答微调的基线相比,该两阶段做法在同域数据上错误率更低且阈值偏置更小。在 Vox1-O 上,TS-SP(Two-Stage Speaker Preservation,两阶段说话人保持)相对成对损失适配基线的等错误率(Equal Error Rate,EER)从 7.01% 降至 4.37%。结论适用于所评测的 Qwen2.5-Omni-7B 骨干和 VoxCeleb 同域评测,跨域 CN-Celeb 未显示额外增益,固定阈值决策仍不稳定。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
217. 阿拉伯儿童与青少年朗读语音:语料构成与识别差距解读

英文题目:AraYoungVoices: A Diverse L1/L2 Corpus of Arabic Child and Adolescent Speech
标签:#语音识别 | #数据集构建 | #数据集 | #基准测试 | #口音与方言
评分:5.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0.5/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Shammur Absar Chowdhury:机构信息未在 arXiv HTML 中可靠披露
- Zien Sheikh Ali:机构信息未在 arXiv HTML 中可靠披露
- Houssam Eddine-Othman Lachemat:机构信息未在 arXiv HTML 中可靠披露
- Hamdy Mubarak:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
现有阿拉伯语识别在儿童、青少年和第二语言使用者上误差较高,原因包括发音、流利度和声学特征随年龄变化,以及方言和母语背景差异。AraYoungVoices采集151.72小时、86471条朗读语音,来自286名7–18岁说话人,分为7–12岁AraKids与13–18岁AraTeens,包含146名母语者与140名第二语言使用者。语料按说话人不重叠划分训练、开发和两种测试条件,其中未见说话人与未见提示的USUP配有朗读提示与逐字转写两种参考,使用同批说话人池、朗读训练见过提示的USSP则仅以提示为参考;USUP共2500条,每年龄段内母语与第二语言数量相等,但儿童共2000条、青少年共500条。基准对比将四种预训练模型先做零样本评测,再分别用儿童、青少年及联合数据微调,以检验年龄匹配与联合训练的作用。在未见说话人与未见提示的USUP测试上,以朗读提示为参考的词错率WER_P显示,Cohere Transcribe Arabic经联合微调后在Teens-L2上为11.43%,低于零样本的32.62%。朗读提示与逐字转写的对比显示识别输出更接近预期文本,说明系统部分归一化了朗读偏离。结论适用于朗读阿拉伯语的年龄与母语背景差异分析,尚未验证自发对话。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://www.api.fanar.qa/ — 暂时无法访问
第三方资源:https://huggingface.co/CohereLabs/cohere-transcribe-03-2026 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
218. 逐个按需取模态:SeMARC 如何边融合边决定算什么、何时停

英文题目:Efficient Multimodal Inference through Adaptive Acquisition and Sequential Fusion
标签:#音视频理解 | #动态计算与早退 | #多模态学习 | #高效推理
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.3/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.1/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Payal Mohapatra:Arm Inc., USA
- Haodong Yang:Northwestern University, USA
- Yueyuan Sui:Northwestern University, USA
- Stephen Xia:Northwestern University, USA
- Benjamin Lundell:Arm Inc., USA
- Qi Zhu:Northwestern University, USA
📌 核心摘要
多模态分类通常对每个样本编码全部可用模态,输入包含视频、音频、文本、惯性、深度等时间序列,输出为类别标签,难点在于不同样本所需证据子集不同,而提前判断需要哪些模态又不能先支付编码代价。SeMARC(Sequential Modality Aggregator with Adaptive Runtime Controller,顺序模态聚合器与自适应运行时控制器)先用已获取证据的预测决定下一个获取哪个模态或停止,每个被选分支只执行一次编码器与融合模块,未被选分支不执行。顺序模态聚合器(Sequential Modality Aggregator,SeMA)用固定数量瓶颈令牌携带历史信息,每步更新运行均值并输出前缀预测;自适应运行时控制器(Adaptive Runtime Controller,ARC)在冻结的 SeMA 上学习获取与停止策略。与已有选择方法的区别在于选择发生在编码前且复用历史计算,同时用随机子集与随机顺序的前缀监督鼓励同集合不同顺序预测一致。在 6 个多模态分类数据集上,相对每个数据集最准确基线,SeMARC 平均宏 F1(macro-F1)提高约 3.2%,总推理 GFLOPs 平均降低 61.4%。摘要报告 GPU 与 CPU 端到端延迟平均下降 44.0%,Android INT8 平均下降 47.2%,比较对象为每个条件下实测最快的基线。结论适用于按样本分类、批量为 1、模态成本固定的推理设置;附录指出紧凑状态控制依赖奖励与转移近似假设,拟合后神经控制器的假设检验仍待完成。原文未披露训练成本,推理成本以 GFLOPs、延迟与能量形式报告。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
219. RAVE 解码器里藏着音高与速度吗:输入、深度与跨层分组的影响

英文题目:Feature Encoding in VAE-based Audio Decoders: Effects of Input, Depth and Distribution
标签:#音乐分析 | #统计分析 | #音乐 | #可解释性
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Louis McCallum:机构信息未在 arXiv HTML 中可靠披露
- Mick Grierson:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
该研究要回答生成式音频解码器内部是否保存可识别的音乐特征,以及这些特征分布在哪些层。输入是弦乐、鼓、人声训练的三个RAVE模型与通用EnCodec模型重放的四类刺激,刺激先经编码再解码并用前向钩子取出各卷积层激活,再与音高、速度(Beats Per Minute,BPM)、频谱质心(Spectral Centroid,亮度相关量)、频谱带宽(Spectral Bandwidth,能量分散程度)的标签配对分析。分析先对每个神经元计算激活与特征的斯皮尔曼(Spearman)秩相关,再用置换零分布判断超过偶然水平的神经元比例,以区分平均强度与分布广度。整层联合恢复能力用线性岭回归探针与多层感知机(Multilayer Perceptron,MLP)非线性探针检验,跨层阶段按激活模式做K均值(K-means)聚类,比较最优簇与同区段最优单层。与判别式语音编码器研究不同,该工作面向生成解码器,并把平均强度、分布广度与联合可恢复性分开度量。在RAVE解码器三模型×四类刺激的逐层评测中,以编码强度平均|ρ|为指标,脉冲速度刺激下BPM为0.76、为零分布均值的8.6倍,正弦音高刺激下音高为0.45、为零分布均值的5.1倍,均高于自然音频下各特征平均|ρ|为0.25、为零分布2.8倍的水平。联合探针的决定系数(R²)在中间层最强并呈倒U形,而单神经元相关在两端更集中,且自然音频需非线性提取。结论适用于卷积变分自编码器(Variational Autoencoder,VAE)类解码器,对注意力或扩散架构是否成立尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/Louismac/rave-activations — 链接可访问(HTTP 200)
第三方资源:https://ieeexplore.ieee.org/Xplore → https://ieeexplore.ieee.org/Xplore/login.jsp?url=%2FXplore&authDecision=-203 — 链接可访问(HTTP 200)
第三方资源:https://creativecommons.org/licenses/by/4.0/ — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
220. 人口交叉情况下的语音识别模型合并与修正:InterCorrect 解读

英文题目:InterCorrect: Intersection-Aware Correction of Demographic Model Merging for Fair ASR
标签:#语音识别 | #模型融合 | #公平性 | #语音
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ashley E. Bravo-Bravo:机构信息未在 arXiv HTML 中可靠披露
- Yuchen Zhang:机构信息未在 arXiv HTML 中可靠披露
- Haralambos Mouratidis:机构信息未在 arXiv HTML 中可靠披露
- Ravi Shekhar:机构信息未在 arXiv HTML 中可靠披露
- Monorama Swain:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
该任务输入是带有年龄、性别、族裔、社会经济背景和母语标注的语音,输出是转写文本,难点是整体词错率下降不一定改善弱势分组,多重身份交叉处的误差更难被单一人群适配覆盖。论文先在全部训练数据上训练基于SLAM-ASR的基线模型,只更新连接语音编码器和大语言模型的线性连接器,编码器与大语言模型保持冻结。随后为18个人口统计学分组各自微调连接器,再用Linear、Task Arithmetic、TIES、Model Breadcrumbs和DARE-TIES合并为全局人口统计学模型,复用原训练子集而不引入额外数据。最后用词错率最差分组组合与任务向量余弦冲突选出跨轴交叉对,按词错率惩罚排序,再把交叉训练数据上相对成对合并模型的增量作为修正向量加权加回全局模型。在Fair-Speech测试集上,TIES加基于词错率选择的修正方法把总体词错率从基线的7.38%降到5.13%,相对下降30.5%。该结论只在Fair-Speech分层70/15/15划分和仅微调线性连接器的设置下成立,TIES加该修正反而增大年龄与社会经济背景轴的最大最小词错率差距,随机选对提升不稳定,对命令式语音之外场景与未覆盖交叉尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
221. 在球谐域里既增强目标声场又保留残留干扰方向

英文题目:Direction-preserving Spatial Audio Signal Enhancement in The Spherical Harmonic Domain
标签:#声场重建 | #语音增强 | #波束成形 | #空间音频信号
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Huawei Zhang:机构信息未在 arXiv HTML 中可靠披露
- Jihui Aimee Zhang:机构信息未在 arXiv HTML 中可靠披露
- Huiyuan June Sun:机构信息未在 arXiv HTML 中可靠披露
- Prasanga Samarasinghe:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
空间音频信号增强的输入是球形麦克风阵列记录的混合声场,输出是对感兴趣区域内期望声场的估计,要求同时保留期望声和残留干扰的方向等空间线索。难点在于混响房间里期望声、干扰声与扩散噪声在球谐域相互叠加,压制干扰时容易扭曲残留干扰的空间分布,影响沉浸感和可懂度。方法先把时频域麦克风信号经球谐变换得到混合球谐系数,再用以零阶为参考的相对谐波系数刻画期望声场和干扰声场各阶系数的比例关系,该系数只与声源位置和房间传输有关。期望声约束要求每个波束成形器输出等于对应期望相对系数,干扰约束要求各阶输出与零阶输出之比等于干扰相对系数之比;与已有空间音频信号增强方法的关键差异是新增来自干扰相对系数的方向保持约束,不需要期望声场功率谱密度矩阵先验。求解得到闭式多输出波束成形器后,对混合系数加权得到估计的期望球谐系数,再经逆球谐变换恢复区域内声压,其中多输出波束成形器由L个波束器构成,每个波束器输出一个期望球谐系数。在信号干扰比0 dB、信号扩散噪声比20 dB的混响仿真房间中按感兴趣区域内343个观测点200帧平均评测,本文方法估计误差为-11.8 dB,低于已有方法的-11.3 dB,干扰相似度为0.76,高于已有方法的0.70。结论适用于单期望源单干扰源加扩散噪声的仿真房间,高混响、运动声源或相对系数估计不准时的表现尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
222. 把语音表征拆成两路:路由稀疏自编码器如何分离语言与副语言信息

英文题目:Disentangling Linguistic and Paralinguistic Information with Routed Sparse Autoencoders
标签:#语音属性识别 | #对抗训练 | #可解释性 | #语音
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Beimnet Bekele Guta:机构信息未在 arXiv HTML 中可靠披露
- Xiaoyu Yang:机构信息未在 arXiv HTML 中可靠披露
- Guangzhi Sun:机构信息未在 arXiv HTML 中可靠披露
- Philip C. Woodland:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
自监督语音编码器输出的帧表示把音素与转写等语言信息,与说话人、情感和韵律等副语言信息混在同一向量空间,难以单独解读或去除。论文先冻结语音编码器得到帧级表示,送入宽度5120的TopK稀疏自编码器(Sparse Autoencoder,SAE)得到稀疏码,再按单元划分为语言通路和副语言通路。语言通路接音素识别监督并对说话人、情感和韵律加对抗,副语言通路接说话人、情感和韵律监督并对音素识别加对抗,梯度反转层(Gradient Reversal Layer,GRL)实现对抗,两路之和经解码器重建原始表示。在LibriSpeech上SPEAR编码器下,独立探针显示固定路由语言通路的音素错误率(Phone Error Rate,PER)为10.02%,低于副语言通路的99.60%,而说话人识别准确率语言通路为6.2%,低于副语言通路的99.8%,呈现保留目标因素并抑制交叉因素的分离。消融显示去掉对抗后语言通路说话人识别准确率为99.8%,高于完整模型的6.2%,而副语言通路音素错误率为66.64%,低于完整模型的99.60%,说明对抗提供交叉抑制。在250对受体与供体话语的固定评测集上,固定路由交换副语言通路后供体说话人匹配率为98.00%,高于配额冻结路由的97.20%,且受体音素保留率为99.57%,高于配额冻结路由的99.16%,说明分离具有功能含义。该结论限于朗读英语与播客英语的闭集评测,跨语料时绝对性能明显下降,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
223. 用通用大语言模型复刻 BOSCC 语音行为编码:输入、决策树与误差来源

标签:#语音属性识别 | #评测协议 | #大语言模型 | #医疗音频 | #0 样本
评分:5.8/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Jordan Prescott:机构信息未在 arXiv HTML 中可靠披露
- Aditya Kommineni:机构信息未在 arXiv HTML 中可靠披露
- Tiantian Feng:机构信息未在 arXiv HTML 中可靠披露
- Megan Micheletti:机构信息未在 arXiv HTML 中可靠披露
- Alyssa Viggiano:机构信息未在 arXiv HTML 中可靠披露
- Luis Angeles:机构信息未在 arXiv HTML 中可靠披露
- Anfeng Xu:机构信息未在 arXiv HTML 中可靠披露
- Lynn Perry:机构信息未在 arXiv HTML 中可靠披露
- Catherine Lord:机构信息未在 arXiv HTML 中可靠披露
- Daniel Messinger:机构信息未在 arXiv HTML 中可靠披露
- Shrikanth Narayanan:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
BOSCC 需要受训专家观看约 12 分钟的儿童与主试游戏互动录像,再按行为锚定规则逐题判定并给出 0 到 5 分,耗时且难以扩展。本文输入是 163 段 BOSCC 录像切成的 326 个 6 分钟片段,输出是两个言语条目主题言语交换(Verbal Exchanges on a Topic,VET)和刻板与仿说言语(Stereotyped and Echoed Speech,SES)的终端分数,难点在于儿童语音含混、自动转写易错以及条目标准需要结合上下文判断。处理过程把自动语音识别转写与儿童与成人说话人分离标注结果拼成证据,再把 BOSCC 任务说明、输入解释、当前判定问题和允许回答装入题专用提示,模型独立回答每道二叉问题后按树结构连成终端分数。与直接预测总分不同,该做法保留了与人工编码相同的中间判定路径,便于定位错误。在 Gemma 4 12B-IT 的去标识转写条件下,VET 达到 33.6% 的终端分数平衡准确率,SES 达到 25.9%,均高于随机水平但远未达到可用水平。结论只适用于这两个条目、内部数据集和单人编码参考,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
224. 只剩低频还能读出文字吗:韵律到文本的初探

英文题目:Prosody-to-Text: Predicting text from low-pass filtered speech
标签:#语音识别 | #SFT | #韵律 | #语音
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- David Porteš:机构信息未在 arXiv HTML 中可靠披露
- Aleš Horák:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
这篇论文研究只保留语音中低频、韵律性信息时能否恢复词句内容,输入是低通滤波后的语音,输出是英文转写文本,难点在于高频段携带的音段线索被去掉后剩余信息非常稀疏。论文先用低通条件微调语音识别模型,直接把 80 个 Mel 滤波器组(Mel bins,Whisper 预处理产生的频域能量表示)中的高 68 个置零,只留中心频率约 446 Hz 以下的 12 个输入,用 750k 条 Yodas 英文样本训练一个 Whisper-Low-pass 模型。为了检验效果中有多少真正来自韵律,论文再训练 Conformer 模型(Conformer,结合卷积局部建模与自注意力长程建模的序列架构),只用基频(Fundamental frequency,f0,声音感知音高的物理对应量)和能量(Energy,信号响度对应量)生成人工 12-bin 语谱图,然后在此基础上继续微调得到 Whisper-Prosody 模型。与未经微调的 Whisper-Large 低通基线相比,前者在 Yodas 测试集词错误率(Word Error Rate,WER,错误词数占参考词数的比例,越低越好)为 36.7%,基线为 100.1%,差距来自微调而非模型原生能力。结论适用于英文朗读类与动画配音两类数据,Yodas 存在训练集污染无法排除,AnimeVox 取自 Whisper 发布后播出的动画剧集《Frieren: Beyond Journey’s End》,为单女性说话人,泛化与说话人覆盖尚未验证。原文未披露推理延迟、吞吐或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
225. AuraLuxMuse:把音乐变成可上台的灯光线索

标签:#音乐分析 | #检索增强 | #数据集 | #音乐 | #混合专家模型
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Junyu Deng:Fudan University, Shanghai, China
- Jiale Cao:Fudan University, Shanghai, China
- Mengtian Li:Fudan University, Shanghai, China;Shanghai Film Academy, Shanghai University, Shanghai, China
- Zhongxia Ji:Shanghai Theatre Academy, Shanghai, China
- Ruhua Chen:Shanghai Theatre Academy, Shanghai, China
- Yiyi He:Nanjing University of the Arts, Nanjing, China
- Guangnan Ye:Fudan University, Shanghai, China
- Zuo Hu:Shanghai Theatre Academy, Shanghai, China
📌 核心摘要
传统舞台灯光设计需人工分析音乐结构并逐个编写灯具指令,耗时且难复用,已有方法多只控制位置与强度,缺少对颜色、分区与节奏的表达。AuraLuxMuse的输入是一段音乐与可选的四维偏好向量,输出是一组可编辑的灯光线索序列与触发时间码,直接下发到灯光控制台而非生成像素。音乐与灯光线索先进入照明对齐音乐预训练学到的共享检索空间做对比对齐,音乐编码器输出的相似度用于查询专家编写的真实线索语料库。非因果时序卷积元数据预测器估计每窗事件密度并求和取整得到所需线索数K,该K与相似度共同决定后续检索的数量,偏好自适应混合专家再以门控集成为灯光表示注入偏好条件,系统按相似度与K做top-K检索并重定向到目标舞台灯具后下发执行。在Musilux检索策略比较的报告设置下,相似度检索的FID为4.89,低于随机检索的6.32,专家引导主观分EGSS为3.27,高于随机检索的2.71。在Musilux生成基线比较的报告设置下,AuraLuxMuse的EGSS为3.27,高于BART的1.89,平均推理时间为7.65秒/文件,低于BART的35.20秒/文件,但FID为4.89,高于BART的4.21。该结论仅适用于Musilux已测风格与虚拟仿真及专业实验室舞台,它不能创造语料库之外的灯具行为,对无清晰律动或剧本主导的材料仍需人工完成,未验证全流派总体泛化;报告配置下平均推理时间为7.65±0.98秒/文件,原文未披露训练计算量与硬件成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
226. 术中构音障碍检测:从混合录音到跨说话人泛化的流水线拆解
标签:#病理语音评估 | #自监督学习 | #语音 | #语音生物标志物
评分:5.8/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Kanthila Chinmayi:机构信息未能从 arXiv PDF 文本可靠映射
- Abdallah Nassib:机构信息未能从 arXiv PDF 文本可靠映射
- Misy Harrison:机构信息未能从 arXiv PDF 文本可靠映射
- Panheleux Celine:机构信息未能从 arXiv PDF 文本可靠映射
- Saliou Vanessa:机构信息未能从 arXiv PDF 文本可靠映射
- Seizeur Romuald:机构信息未能从 arXiv PDF 文本可靠映射
- Dardenne Guillaume:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
清醒开颅术中需从手术室连续录音判断患者是否出现构音障碍,输入是混有医生说话、设备噪声和静音的录音,输出是每个3秒片段属于构音障碍还是无异常。难点是异常片段稀少且占比随说话人大幅变化、说话人差异大,医生说话占比与标签相关易成为混淆线索。流水线先用说话人分离标注区分患者与医生帧,仅在患者帧上计算常规声学描述子,并从标注结果导出对话交互特征。同时用冻结的法语wav2vec 2.0编码患者帧并拼接第6层、第9层与末层嵌入,再与常规特征拼接后经说话人条件中心化和跨说话人可迁移筛选送入级联分类器,HiFi-GAN音高扩展仅用于缓解类别不平衡。与单层或仅用常规描述子相比,多层融合保留了分布在不同深度的发音精度与可懂度信息,级联结构用内层留一说话人构造的校准概率约束第二阶段,避免信任过自信的样本内概率。在11名患者共2,706个保留片段上,5折说话人无关评估下以AUC为指标,级联前馈模型从仅用梅尔倒谱系数的0.643提升到多层融合的0.760,同一评估下XGBoost从0.591提升到0.721,说明跨说话人效果主要由表示决定。原文未披露训练、推理或部署成本,结论限于单中心法语 DATABRASE 队列,未验证外部术中队列。
🔗 开源资源
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
227. 给低层声学数值补上文字说明,让大音频语言模型直接判断构音障碍

标签:#病理语音评估 | #SFT | #语音 | #音频大模型
评分:5.7/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.8/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Mahdi Amiri:机构信息未在 arXiv HTML 中可靠披露
- Hatef Otroshi Shahreza:机构信息未在 arXiv HTML 中可靠披露
- Pascal Frossard:机构信息未在 arXiv HTML 中可靠披露
- Ina Kodrasi:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
构音障碍是帕金森病等神经疾病引起的言语运动障碍,自动检测需要从录音判断说话人属于构音障碍还是神经典型,难点在于现有检测多依赖深度表征而难以直接利用临床相关的低层异常。论文指出大音频语言模型(Large Audio Language Model,LALM)多依赖语义编码器,对单音调、单响度、气息声和语速异常等低层声学线索不敏感,因而直接微调仍会遗漏关键信息。方法以原始波形和任务指令为输入,先用监督微调让模型直接输出0或1类别,避免再训练外部下游分类器,使检测由模型自身完成。进一步用OpenSMILE计算基频均值与标准差、感知响度均值与标准差、谐噪比均值和语速,连同性别与语言信息写成文本,与音频一起送入模型参与微调。说话人级结果由同一说话人所有语音段投票得到,在PC-GITA十折交叉验证下按说话人级准确率比较,特征增强的Qwen2-Audio-7B-Instruct为85.0±0.8%,高于wav2vec2基线的82.3±3.1%。消融显示常规微调已接近基线,加入声学与人口学文本后两款LALM均进一步改善并达到当前最佳,特征逐个增加总体带来提升。零样本下模型仅为机遇水平,特征选择来自临床文献而非优化搜索,因此结论限于该数据集与帕金森相关构音障碍。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
228. 类别相关噪声下的多类语音分类:交叉增强与语音增强的对照解读
标签:#语音情感识别 | #数据增强 | #语音增强 | #鲁棒性
评分:5.7/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.7/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.7/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Mahdi Amiri:机构信息未在 arXiv HTML 中可靠披露
- Sayantan Biswas:机构信息未在 arXiv HTML 中可靠披露
- Mingchi Hou:机构信息未在 arXiv HTML 中可靠披露
- Pascal Frossard:机构信息未在 arXiv HTML 中可靠披露
- Ina Kodrasi:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
多类语音分类在不同类别录制条件不同时会形成噪声失衡,输入是带噪语音,输出是情感类别,难点是噪声本身与标签相关,分类器不用学语音内容也能在同分布测试上取得高分。论文先按类别固定配对环境噪声构造可控失衡数据,再用语音活动检测(Voice Activity Detection,VAD)从非语音段估计噪声。对二类方法的多类扩展是把每个样本与他类噪声按功率配比相加,使各增广样本包含相同的噪声来源组合,训练只能依赖语音内容。作为对照,论文把判别式与生成式语音增强(Speech Enhancement,SE)放在分类前做去噪预处理。关键差异是增广不试图去除噪声,而是让噪声在类别间失去区分性,而增强试图直接压制噪声。与已有二类配对增广相比,多类需要处理一个样本对应多个他类噪声来源的选择问题。在10 dB条件下标准训练的含噪测试无加权准确率(Unweighted Accuracy,UA)为94.4%,高于对应干净测试的28.2%,两者差距说明模型利用了噪声线索;干净训练测试的参考性能为59.3%。结论适用于合成失衡与已知类别噪声类型的范围,实际噪声估计不准和类别数增多导致信噪比下降时会失效。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
229. 部分伪造语音里的时间锚点与编辑敏感性:一项受控诊断
英文题目:Temporal Anchors and Editing Sensitivity in Partial Speech Spoofing: A Controlled Study
标签:#伪造片段定位 | #评测协议 | #数据增强 | #语音 | #鲁棒性
评分:5.7/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.7/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Xiaosu Su:机构信息未在 arXiv HTML 中可靠披露
- Yun Cao:机构信息未在 arXiv HTML 中可靠披露
- Yiping Ni:机构信息未在 arXiv HTML 中可靠披露
- Xiaowei Yi:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
部分伪造语音检测的输入是包含少量合成插入的整句语音,输出是每20ms单元是否为合成内容的判定与事件边界,难点是拼接不连续既可能来自良性剪辑也可能来自合成插入。论文冻结WavLM Large编码器,只训练轻量时序头,编码输出先经层归一化与128维投影,再送入残差时序卷积与线性sigmoid头得到帧级合成概率。帧目标对比硬标签与软占据率,音素与词单元在对齐区间内池化特征并按持续时间加权学习占据率,再按重叠积分投影回20ms单元,并以固定80ms网格与打乱音素宽度对照分离语言边界作用。另一条线在相同拼接增强数据上比较只增强与增强加边界外一致性损失,掩膜排除边界附近60ms并在掩膜外约束原始与平滑预测一致,用真真拼接度量误报、真伪拼接核心区度量漏检。在第6层特征上,音素单元在PS eval的帧等错误率(frame equal error rate,EER)为11.18%,差于软帧模型的9.59%。补充对照在开发集等错误率阈值下显示帧增强把纯真拼接误报从25.63%降到5.48%,而合成核心漏检从8.98%升到22.31%。原文未披露训练、推理或部署成本,结论限于测试的编码器层、头结构、对齐与插入方式。
🔗 开源资源
- 第三方资源:https://github.com/mysxs/partial-spoof-diagnostics — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
230. 僧伽罗语语音识别为什么难:从隐马尔可夫模型到自监督预训练的综述解读
标签:#语音识别 | #文献综述方法 | #低资源 | #跨语言 | #多语言
评分:5.7/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.7/1.5 | 清晰度 0.7/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:综述 | arXiv 原文
👥 作者与机构
- Chanuka Dinuwan:机构信息未能从 arXiv PDF 文本可靠映射
- Sanath Jayasena:机构信息未能从 arXiv PDF 文本可靠映射
- Buddhika Karunarathne:机构信息未能从 arXiv PDF 文本可靠映射
📌 核心摘要
僧伽罗语自动语音识别要把连续语音波形转写成僧伽罗语文字,输入是朗读、电话交互语音、广播和宗教朗读等录音,输出是词或字符序列。难点在于最大公开标注语料 OpenSLR-52 仅约 224 小时且为朗读、黏着形态造成词形爆炸、54 个音素与复杂辅音丛难以区分、主宾谓语序增加长距离依赖,以及口语与书面语、方言和僧伽罗语英语混用差异大。早期链路用隐马尔可夫模型接高斯混合模型估计声学似然,经发音词典和二元语言模型解码,后续把后验估计换成深度神经网络、时延神经网络和双向长短期记忆网络以扩大时间上下文。端到端模型取消独立词典与强制对齐,用联接时序分类或晶格无关最大互信息目标直接从声学特征学习字符或音素序列,解码时可再融合外部语言模型。近期路线是先在大量无标注多语语音上做自监督学习得到通用声学表示,再用少量僧伽罗语标注语音微调线性分类头,僧伽罗语在 XLS-R 预训练中占比不足 0.1%,主要靠与泰米尔语、尼泊尔语和孟加拉语相近的语音结构迁移。在同一端到端晶格无关最大互信息架构与同一批 OpenSLR-52 录音上,只修正标注不一致后,大词汇量连续语音识别的词错误率从 28.55% 降到 23.38%,相对下降 18.1%,指标方向为越低越好。该结论只适用于朗读式大词汇量测试,对方言、噪声、会话和混用语音尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://huggingface.co/spaces/hf-audio/open_asr_leaderboard — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
231. SPHERE:从一次生成到记住用户空间习惯的 VR 室内共创

标签:#语音交互 | #强化学习 | #检索增强 | #用户研究 | #大语言模型
评分:5.6/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Hyeonmin Lee:机构信息未在 arXiv HTML 中可靠披露
- Zheng Wei:机构信息未在 arXiv HTML 中可靠披露
- Kyungmin Kwon:机构信息未在 arXiv HTML 中可靠披露
- Jumin Seo:机构信息未在 arXiv HTML 中可靠披露
- Jiwon Park:机构信息未在 arXiv HTML 中可靠披露
- Hayoung Oh:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
SPHERE处理的输入是用户在虚拟现实中的语音指令、控制器选择的位置与后续编辑,输出是符合用户历史偏好的室内布局,难点在于偏好分散在多次会话中,且房间尺寸与长宽比变化时绝对坐标容易失效。系统在首轮标准房间记录完整交互与最终场景,离线抽取局部功能区与全局拓扑,再由大语言模型提炼为可复用的对象级、区内与区间空间约束。后续会话先按语义相似召回历史场景,再用交叉注意力重排器筛选场景与功能描述,生成时把Holodeck的房间约束与偏好约束取并集。与已有一次生成或只做孤立修正的方法不同,SPHERE保留跨会话记忆,并用终端场景是否实现所选功能来更新检索策略。42名参与者的混合设计用户研究在living room语义下连续生成编辑三轮,与基线相比,自适应条件在第2、3轮的指标总编辑数Etotal平均为5.62,基线平均为8.52,自适应更低(Welch t检验,p<.001)。结论适用于三类预设档案与living room语义下的尺寸缩放和窄长变形,开放偏好与长期演化尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/hyeonmin11/SPHERE — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
232. 从双通道录音到轮次与反馈标注:一条先自动后人工的会话切分流水线

英文题目:An automated pipeline for standardised speech-unit annotation in spontaneous dialogue
标签:#轮次切换 | #语音活动检测 | #信号处理 | #数据标注
评分:5.6/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Hanlu He:机构信息未在 arXiv HTML 中可靠披露
- Harald Vilhelm Skat-Rørdam:机构信息未在 arXiv HTML 中可靠披露
- Ingvi Örnólfsson:机构信息未在 arXiv HTML 中可靠披露
- Ivana Konvalinka:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
自然双人对话需区分占据话轮的轮次和只给反馈的反向通道,语音活动检测只能标出有声段,会把轮内停顿切碎,也把串音误当重叠。论文输入是每人一路头戴麦克风的分离声道音频,输出是每段起止时间、说话人和轮次或反向通道标签,难点是声学边界不等于交互边界且分类依赖上下文。流水线先用滤波加rVAD检出有声段,再按通道能量剔除串音,按间隙合并成候选单元,转写后用词分布香农熵初分类,最后用双人时间上下文合并改标。相对以说话人专属转写文本为起点的NaturalTurn,该工作从音频直接得到说话人专属时间单元,转写只作中间分类依据。在以单人人工标注为参考、对33对被试99段10分钟丹麦语面对面自由对话逐段计分的检测可靠性评测中,以平均F1为指标,轮次为0.624±0.143,略高于反向通道的0.618±0.160,总体为0.621±0.151。在汇总成功匹配段绝对边界误差的时序精度评测中,以平均绝对误差MAE为指标,轮次起点为0.994s,高于反向通道起点的0.152s,而轮次起点中位绝对误差仅0.150s,说明少数大偏差拉高均值。在显存至少16GB图形处理器上处理10分钟对话的耗时实测中,以处理耗时为指标,平均处理耗时约2分钟,低于10分钟音频时长;结论只适用于分离声道丹麦语双人对话的第一遍标注,仍需人工复核,未单评转写精度与标注省时。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
233. 自发对话中声道协调如何随时间变化与趋同

标签:#语音属性识别 | #信号处理 | #语用与话语 | #发声与构音
评分:5.6/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Thanushi Withanage:机构信息未在 arXiv HTML 中可靠披露
- Carol Espy-Wilson:机构信息未在 arXiv HTML 中可靠披露
- Elizabeth Redcay:机构信息未在 arXiv HTML 中可靠披露
- Desi Jones:机构信息未在 arXiv HTML 中可靠披露
- Noah Sasson:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
论文研究自发双人初识对话中发音层面的相互适应,输入是双人语音录音,输出是每位说话人发音协调复杂度和双人趋同分数,难点在于自然对话存在协同发音和目标欠冲,音素边界不可靠,侵入式传感器又会改变说话方式。方法把语音经发音反演转为6维声道变量,再对通道间互相关矩阵求特征值谱以刻画协调结构,用几何衰减加权把90维谱压缩为标量ω,最后比较上下半场双人间距变化得到有向趋同分数e。与依赖相邻轮次预测的深度网络相比,该链路保留了可解释的发音维度,并区分了趋同方向和交叉程度。在包含1381对非自闭配对的CANDOR语料中,以归一化加权分数ω为指标,上半场均值0.3552降至下半场0.3352,主效应F(1,1380)=170.54,p<.001,配对t(1380)=13.06,p<.001,ω下降对应协调复杂化。在UTD自闭、非自闭及混合配对对话中,非自闭配对趋同最强,自闭配对次之,混合配对最低,且e>0的对话更常伴随高自评会话成功度。结论适用于无任务初识英语对话,对任务型、多人或儿童对话尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
234. 多条房间脉冲响应如何联合估计共享衰减与空间幅度

标签:#房间脉冲响应估计 | #信号处理 | #多通道 | #空间音频
评分:5.6/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Jeremy B. Bai:机构信息未在 arXiv HTML 中可靠披露
- Filip Elvander:机构信息未在 arXiv HTML 中可靠披露
- Sebastian J. Schlecht:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
同一封闭空间内不同声源与接收位置的房间脉冲响应共享少数衰减快慢不同的混响成分,但各位置强弱不同,弱成分在单条曲线上难以分辨,需要同时恢复共享衰减率和随位置变化的幅度。论文把每个短时傅里叶变换频点的功率排成空间时间矩阵,期望功率分解为空间幅度矩阵与指数衰减时间特征的乘积,用板仓斋藤散度衡量观测功率与模型方差的差异,直接对功率建模,不做反向积分,也不需要先单条估计再聚类。估计逐成分交替进行,先由当前模型方差算出成分占模型方差的贡献比与后验功率,该后验功率作为固定输入进入同一成分的幅度与衰减率更新。固定后验功率后解析求出最优幅度并将其代入,得到关于衰减率的凸标量问题,再用带保护的牛顿法迭代求解衰减率,更新完一个成分后刷新模型方差与贡献比再处理下一个成分,贡献加权版本按贡献比的幂对样本加权,使更新集中在该成分占优的时空区域。在100组随机双衰减合成配置的评测中,贡献加权\(p=1\)的短混响时间和长混响时间均方根误差分别为0.025 s和0.047 s,低于\(p=2\)的0.039 s和0.048 s。合成实验中分离较好的衰减恢复准确、损失下降快于标准空间交替广义期望最大化,实测耦合房间得到随频率变化的光滑混响时间曲线并显示互补的时空贡献。衰减率相近或成分微弱时仍难分辨,原文未披露训练、推理或部署成本,且无真值对照的实测房间不能验证相对准确性。
🔗 开源资源
第三方资源:https://github.com/jeremybbq/multi_slope_NMF → https://github.com/jeremybbq/common_slope_nmf — 链接可访问(HTTP 200)
第三方资源:https://zenodo.org/records/6375520 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
235. 嘴唇路径的形状:语音驱动三维人脸动画中协同发音的几何度量

英文题目:The Shape of Speech: A Geometric Measure of Coarticulation for Speech-Driven 3D Facial Animation
标签:#音视频生成 | #统计分析 | #主观评测 | #发声与构音 | #言语感知
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Danzel Serrano:New Jersey Institute of Technology, USA
- Przemyslaw Musialski:New Jersey Institute of Technology, USA
📌 核心摘要
语音驱动三维人脸动画输入语音音频、输出三维人脸网格运动,难点在于单个嘴形可认不等于形状之间的运动自然,相邻音对当前音的塑形即协同发音藏在轨迹里。论文先用强制对齐得到元音辅音元音片段,对固定唇区顶点做模板相对轨迹,再计算唇路径长度与经过元音中心辅音中心元音中心三点的最短折线之比,得到分段路径比值。为解释差距,作者把真实运动分解为慢载体与快残差并按比例缩放,构成可复现的阻尼与夸张阶梯,再把方法差距映射为等效保留比例。相对唇顶点误差与唇同步度量,该比值只关心路径形状并对整体运动增益不变,也不需要配对真值即可计算。在VOCASET标准两名留出说话人、38句话183个配对词条、帧率匹配真值的比较中,指标分段路径比值Rpw上DiffPoseTalk为1.055、配对差距为+0.043[+0.028,+0.060],方向为低于真值。在97名观看者、323次试验的独立预注册感知研究句子组比较中,指标真值偏好占比上真值 pooled为73.4%[68.2,78.1],方向为高于方法输出。结论适用于所用采集流程下的朗读英语,舌部运动、韵律时机与跨语料泛化尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
236. 在发音表示里直接修正病理语音

英文题目:Enhancing Pathological Speech through Articulatory Bottlenecks
标签:#语音增强 | #病理语音评估 | #CNN | #对抗训练 | #发声与构音
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0.2/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Ailín Pollio San Pedro:机构信息未在 arXiv HTML 中可靠披露
- Olivier Perrotin:机构信息未在 arXiv HTML 中可靠披露
- Thomas Hueber:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
构音障碍会同时影响呼吸、发声、共鸣、构音和韵律,输入是发音实现偏离的病理波形,目标是在保留说话人和韵律的同时输出音位更清晰的波形,难点是自然病理数据少且缺少与健康语音的平行对照。方法冻结基于WavLM第9层的内容编码、韵律编码、说话人编码和HiFi-GAN声码器,只训练作用在12维瓶颈上的残差映射器,其中监督构音瓶颈用均方误差学习预测六个电磁构音仪传感器的水平与垂直轨迹,无监督瓶颈用同样维度的多层感知机投影作对照。映射器先在平行合成健康与人工构音障碍语音上学习均方误差映射,再在自然病理语音上用音位序列的联接时序分类损失加健康分布对抗约束微调。与以往从受损信号恢复语言或音位内容再重新合成不同,该工作直接修正发音相关表示并保留原有韵律与说话人信息。在合成测试集上,无监督瓶颈微调模型相对受扰输入把音位错误率从32.0%降到9.4%,感知转写词错误率从29.7%降到21.6%。结论仅在受控合成扰动和所选自然子集内成立,自然集只选可懂度58%至95%且音位删除率低于0.20的六名说话人,方法只修正已存在音位的发音实现、不恢复缺失音位。合成预训练模型零样本迁移到自然语音时音位错误率升至61.9%至77.8%且高于恒等重合成,自然微调后增强输出也没有超过原始录音,重度缺失与未选说话人范围尚未验证。训练配置方面原文披露了UAB身份模型在LibriTTS-R上训练1.5M步、映射器预训练最多50轮和微调最多120轮等配置,硬件型号与训练时长未说明。
🔗 开源资源
第三方资源:https://gricad-gitlab.univ-grenoble-alpes.fr/huebert/artimap — 链接可访问(HTTP 200)
第三方资源:https://www.ultraspeech.com/artimap/demo.html — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
237. 选层为什么会误导语音抑郁检测:一次嵌套评估审计

英文题目:When Layer Selection Misleads Speech Depression Detection
标签:#病理语音评估 | #评测协议 | #统计分析 | #精神健康筛查
评分:5.5/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Paula A. Perez-Toro:机构信息未在 arXiv HTML 中可靠披露
- David Gimeno-Gómez:机构信息未在 arXiv HTML 中可靠披露
- Daniel Rückert:机构信息未在 arXiv HTML 中可靠披露
- Andreas Maier:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
抑郁检测任务输入是临床访谈中被试者语音片段,输出是PHQ-8阈值定义的二分类标签和八个症状维度分数,难点是被试数量少而候选表示层数多,同一份数据既选层又报性能会带来乐观估计。论文冻结预训练语音编码器并逐层平均池化得到被试向量,再用固定L2逻辑回归评价,对比同折选最优层的朴素做法与内层选层、外层评价的嵌套做法。前一步的层表示与标签划分进入下游分类与校准,接着用高斯噪声与打乱标签对照分离信号与选择效应,并把嵌套协议用于五类编码器与可解释声学特征、音频大模型和神经编解码表示的公平比较,最后把同一审计扩展到症状级别并由症状期望求和得到严重程度。在DAIC-WOZ重复分层交叉验证中,wav2vec2的AUC在朴素选优下为0.65,高于嵌套选择下的0.56。在同一DAIC-WOZ表示上打乱标签的500次置换对照中,朴素选优的AUC均值仍为0.59,高于嵌套选择的0.50,说明偏差来自选择本身。在DAIC-WOZ嵌套交叉验证中,119维情感韵律声学组合的AUC为0.75,高于最佳编码器data2vec的0.66,同时仅用约120个可训练下游参数,比深层表示少约10^3倍。原文未披露训练、推理或部署成本,结论适用于小样本临床语音的层探测场景,更大样本或其它选择过程是否同样乐观尚未验证。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
238. 音频越狱住在哪一层频率?AdvWave-P 在 Qwen2-Audio 上的受控频率-深度审计

英文题目:Where Does the Audio Jailbreak Live? A Controlled Frequency-Depth Audit of AdvWave-P on Qwen2-Audio
标签:#音频问答 | #对抗鲁棒性 | #可解释性 | #信号处理 | #统计分析
评分:5.5/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.7/1 | 影响力 0.5/1.5 | 开源 0.5/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Boyuan Chen:eBRAIN Lab, Division of Engineering, New York University Abu Dhabi, UAE;Tandon School of Engineering, New York University, NY, USA
- Minseok Kim:eBRAIN Lab, Division of Engineering, New York University Abu Dhabi, UAE
- Sohaila Abdulsattar:eBRAIN Lab, Division of Engineering, New York University Abu Dhabi, UAE
- Minghao Shao:eBRAIN Lab, Division of Engineering, New York University Abu Dhabi, UAE;Tandon School of Engineering, New York University, NY, USA
- Siddharth Garg:Tandon School of Engineering, New York University, NY, USA
- Ramesh Karri:Tandon School of Engineering, New York University, NY, USA
- Muhammad Shafique:eBRAIN Lab, Division of Engineering, New York University Abu Dhabi, UAE
📌 核心摘要
论文研究加性音频越狱AdvWave-P在Qwen2-Audio上是否真正依赖某个特定频率,输入是干净语音与加性扰动叠加后的波形,输出是模型文本回答是否构成越狱,难点是频段位置、带宽、能量和移除结构容易混在一起。方法先按mel尺度在独立于受害者128-bin前端的80-bin分析基上划分连续频段并映射到STFT bins实施遮蔽,再经逆变换重建波形送入受害者与判官统计攻击成功率,同时比较音频片段在解码器各层的表示变化。在520条AdvBench提示、Qwen2-Audio贪婪解码、主判官GPT-4o-mini评测下,遮蔽mel分析基索引区间70-79对应的5613-8000 Hz后,判官统计的攻击成功率从完整对抗的0.767降至0.054。在同一520条语料8频段划分下,能量占比几乎完全预测该排序,Spearman相关系数为0.95,因此不能直接读成频率位置的因果结论。在同一评测设置下能量均衡划分和打散移除对照显示,遮蔽任意测试频段后攻击成功率均明显低于完整对抗,低频段连续移除比同能量打散移除后攻击成功率更低、更具破坏性。在399条被完整对抗越狱提示上提示与能量调整后的混合效应模型估计表示差异与频段必要性的关联,层30减投影层输出的对比为+0.293,95%置信区间为[0.11, 0.51],该结果为关联而非因果定位。上述结论仅适用于epsilon为0.01的AdvWave-P在Qwen2-Audio上的表现,LLaMA-Omni因干净提示越狱率过高缺乏余量,其他攻击、受害者与扰动域及更细顶频段结果尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
- 第三方资源:https://github.com/BoyuanChen99/Where_Does_The_Audio_Jailbreak_Live — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
239. 人类语音预训练表示能迁移到动物发声吗:个体识别与叫声类型分类的对照评估

标签:#说话人识别 | #音频分类 | #迁移学习 | #生物声学
评分:5.5/10 | 创新 1/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Tomás Arias-Vergara:机构信息未在 arXiv HTML 中可靠披露
- Christopher Hauer:机构信息未在 arXiv HTML 中可靠披露
- Héloïse Brotier:机构信息未在 arXiv HTML 中可靠披露
- Elmar Nöth:机构信息未在 arXiv HTML 中可靠披露
- Andreas Maier:机构信息未在 arXiv HTML 中可靠披露
- Lee Koren:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
动物叫声标注少且个体差异细微,论文检验冻结的人类语音基础模型表示能否直接用于跨物种个体识别与叫声类型分类,输入为统一到16 kHz单声道的发声单元,输出为个体编号或叫声类别。编码器某一层的帧级表示先做均值和标准差池化形成定长向量,该向量标准化后进入带平衡类别权重的逻辑回归分类器,个体识别按录音会话分组、叫声类型按个体分组分别做三折交叉验证并在未见会话或未见个体上测试。层与正则化强度在每训练折内用二折交叉验证联合选择,再在全训练划分上重拟合并在留出折上评估一次,以非加权平均召回率报告各折平均值。在三折交叉验证下以非加权平均召回率比较最优语音编码器与最优动物编码器,斑胸草雀个体识别高0.119、狨猴个体识别高0.086、斑胸草雀叫声类型分类高0.036,三组经Holm-Bonferroni校正后显著且选中的语音编码器几乎均为Whisper。其余四组在相同三折评估与指标下差异为-0.027至+0.006且不显著,包括蹄兔个体识别-0.019、小鸮个体识别-0.027、蹄兔叫声类型+0.006和狨猴叫声类型-0.014,没有一组是动物编码器显著更好。以非加权平均召回率衡量,原始波形前端模型多在相对深度0.15-0.51取得层内最优而高于深层,块语谱图前端的BEATs/AVES2系列则在0.64-0.88更深处最优,参数量最大的XEUS在两类任务上均低于其他编码器。结论只刻画冻结权重下直接可用的信息,蹄兔和狨猴的结果可跨会话成立而斑胸草雀和小鸮个体识别部分反映会话内识别,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
240. 跨项目迁移的咨询质量评估:量表锚定的文本打分如何胜过域内训练
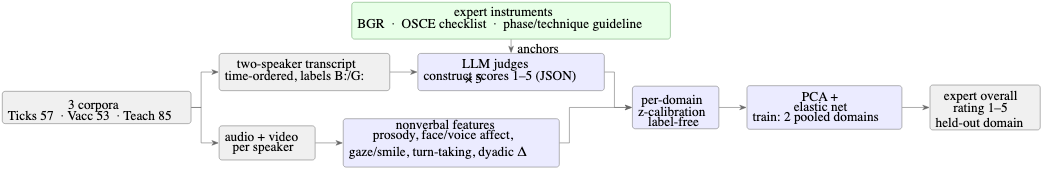
标签:#口语理解 | #领域适应 | #大语言模型 | #模型集成 | #教育
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- Tobias Hallmen:Chair for Human-Centered;Artificial Intelligence;University of Augsburg
- Elisabeth André:Chair for Human-Centered;Artificial Intelligence;University of Augsburg
📌 核心摘要
每个项目仅有53-85个专家评分会话,论文输入完整会话的双人转录文本与每人一路音视频,输出1-5分的受评者整体印象,难点是量表跨项目命名不一、目标集中在3-4分且录音与说话人归属带噪声。处理先把按时间排序的双人转录文本送入小型开放权重的大语言模型评委,输出会话级构念分,构念分指专家量表中某一可练习行为对应的会话级评分,再与紧凑非言语双人特征拼接,所有低维特征块按域做z校准后在两个域混合训练、第三个域测试。在Ticks蜱虫咨询57会话、Vacc疫苗咨询53会话、Teach家长教师咨询85会话共195会话上,嵌套留一域外评测下以Spearman等级相关为指标,混合训练达0.54,超过域内五折交叉验证的0.48以内。在相同195会话上配对比较留一域外与域内训练的会话级Spearman等级相关,留一域外评测下配对差距为+0.15,匹配训练量后在留一域外与域内比较中仍保留+0.12。在留一域外评测下以Spearman等级相关为指标,语言评委集成达0.51,叠加整个非言语块仅比语言评委集成增加约0.03且区间包含零。在固定模型与转录本的留一域外对照下以Spearman等级相关为指标,采用专家构念的评委由通用对话质量的0.32升至0.41,引用量表原文描述仅再增0.004。结论只适用于中等水平模拟咨询的排序,预测压缩到不足1个量表点,不支持直接报分,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
241. 闲聊与背景音如何混入病历与临床推理

标签:#语音识别 | #基准设计 | #幻觉与忠实度 | #基准测试
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:前50% | 文档类型:数据集与基准 | arXiv 原文
👥 作者与机构
- Krithik Vishwanath:机构信息未在 arXiv HTML 中可靠披露
- Brandon Ye:机构信息未在 arXiv HTML 中可靠披露
- Anton Alyakin:机构信息未在 arXiv HTML 中可靠披露
- John E. Markert:机构信息未在 arXiv HTML 中可靠披露
- Aaron Hsieh:机构信息未在 arXiv HTML 中可靠披露
- Michał Mańkowski:机构信息未在 arXiv HTML 中可靠披露
- Eric K. Oermann:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
临床对话混有与患者无关的偶发信息,环境记录需把闲聊与患者病情分开,难点是两者用词重叠且录音混有他人语音。论文构建MedDistractNotes,在576组医患对话中插入三至四轮寒暄并保持患者信息不变,让8个模型写主观、客观、评估和计划(Subjective, Objective, Assessment and Plan,SOAP)病历,再用配对法官判定插入内容是否被当作患者病情写入。论文构建MedDistractAudio,把另一组问诊的5 s至15 s片段按-20 dB至-5 dB叠加到57组模拟问诊上,经Whisper large-v3转写后再生成病历,追踪背景词向转写和病历的泄漏。在MedDistractQA的10%留出测试集上,以准确率为指标比较干净题与受扰题,开源模型的准确率在旁观者插入下下降5.5–12.6个百分点、在非字面插入下下降10.2–14.2个百分点。在同一留出集的干净题上,以准确率为指标比较抑制所选注意力头前后,抑制后准确率比未干预降低24.4–37.8个百分点。在MedDistractNotes开源模型受扰病历中,以误归因率为指标比较亲属闲聊与非亲属闲聊,亲属的21.4%低于非亲属的26.7%,并区分误归因与正确归因后的临床使用。与只打正确性、完整性和简洁性的病历评测不同,本文用插入目标做污染判定,机制上用对比因果头门控定位注意力头并做干净激活回填。结论只适用于短摘录偏多、模拟录音和模型法官的设置,短文本中污染更高,全长门诊和医生审签环节尚未验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/nyuolab/llm_distract — 链接不可用(HTTP 404)
第三方资源:https://huggingface.co/datasets/KrithikV/MedDistractQA — 暂时无法访问
第三方资源:https://transformer-circuits.pub/2021/framework/index.html — 链接可访问(HTTP 200)
第三方资源:https://openreview.net/forum?id=AjXkRZIvjB → https://openreview.net/challenge?redirect=%2Fforum%3Fid%3DAjXkRZIvjB — 链接可访问(HTTP 200)
第三方资源:https://proceedings.mlr.press/v202/shi23a.html — 链接可访问(HTTP 200)
第三方资源:https://arxiv.org/abs/2504.01201 — 链接可访问(HTTP 200)
第三方资源:https://arxiv.org/abs/2309.16042 — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
242. MemoCare:把说话、定位、触屏和画图装进一部手机的认知筛查流程

英文题目:MemoCare: An Interactive Multimodal Mobile System for Automated Cognitive Screening
标签:#病理语音评估 | #语音交互 | #CNN | #医疗音频
评分:5.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1/1.5 | 清晰度 0.8/1 | 影响力 0.4/1.5 | 开源 0/1.5 | 可复现 0.1/0.5 | 工程/实践 1/1.5
排名:前50% | 文档类型:系统技术报告 | arXiv 原文
👥 作者与机构
- Duy-Cat Can:机构信息未在 arXiv HTML 中可靠披露
- Mau Minh Phuc Le:机构信息未在 arXiv HTML 中可靠披露
- Tuan-Khoa Hoang:机构信息未在 arXiv HTML 中可靠披露
- Hai-Dang Nguyen:机构信息未在 arXiv HTML 中可靠披露
- Trung-Hieu Do:机构信息未在 arXiv HTML 中可靠披露
- Dang Minh Ly:机构信息未在 arXiv HTML 中可靠披露
- Minh-Duc Nguyen:机构信息未在 arXiv HTML 中可靠披露
- Nghia TT Hoang:机构信息未在 arXiv HTML 中可靠披露
- Linh-Trung Nguyen:机构信息未在 arXiv HTML 中可靠披露
- Huy-Hieu Pham:机构信息未在 arXiv HTML 中可靠披露
- Huong Ha:机构信息未在 arXiv HTML 中可靠披露
- Binh T. Nguyen:机构信息未在 arXiv HTML 中可靠披露
- Oliver Y. Chén:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
MemoCare要解决的是认知筛查中多种输入难以在手机上统一采集和自动评分的问题,输入包括口语回答、设备位置、触屏操作和手绘图形,输出是逐题得分和总分,难点在于每种输入的语义不同且需要按任务分别解释。语音先由外部转写服务得到文本,再用确定性规则按日期、计算、回忆等任务评分并保留跨轮状态;空间定向先用当前位置检索附近行政区划再做包含判断,然后把官方名和历史别名与转写文本匹配。触屏按事件类型、目标和顺序校验,绘画则由卷积神经网络(Convolutional Neural Network,CNN)判断三项结构标准。与以往侧重问卷展示或单一语音辅助的方法相比,该系统把四种通道接到统一的题目评分接口,保持交互流程不变而允许替换单个模块。绘画评估中验证集选出的ShuffleNetV2 x1.5在66图验证集上平均平衡准确率为96.23%,在锁定71图测试集上平均平衡准确率为91.33%而低于验证集,三标准全对准确率为78.87%。软件测试用例151/151通过,空间坐标回归48/48通过,四位临床医生的pooled中位评分为4/5。结论只适用于研究原型和技术验证范围,患者诊断性能尚未验证,原文未披露训练、推理或部署成本。
🔗 开源资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
243. 把预训练潜在扩散模型适配到古琴历史录音
标签:#音乐生成 | #LoRA | #扩散模型 | #低资源 | #主观评测
评分:5.3/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.7/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
排名:后 50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Huanchen Cai:Division of Speech, Music and Hearing (TMH);KTH Royal Institute of Technology, Stockholm, Sweden
📌 核心摘要
本文输入为十秒古琴录音开头或一段场景文字,输出为延续该开头的续奏或符合描述的独奏,难点是历史录音有磁带噪声和有限带宽、古琴滑音带来经过性半音与摩擦噪声,而可用筛选录音仅四十二点五小时。方法先按曲目分组划分录音并切成模型原生长度窗口,再经冻结自编码器得到连续隐变量序列,为后续扩散变换器提供输入。然后在Stable Audio 3 Medium上训练秩十六的DoRA适配器,采用偏向续写的掩码、考据曲目叙述加心情标签与自动估计五声音阶调式组合的文本及随机长度裁剪,并以留出损失停止为准。生成时保留开头续写或由文字直接生成,并用多生成截尾与响度锁定拼接长音频。在八个未见曲目开头的最终听评R7中,最终适配器续写总体评分均分指标为3.88,高于对照最佳早期适配器的总体评分均分指标3.38。在训练后新写的五个场景描述生成中,总体评分均分指标最终适配器为4.60,高于同一早期检查点的总体评分均分指标3.60。相对从零训练仍无可辨认音色的连续隐变量自回归基线,该适配保留了预训练音色先验,但结论只适用于该历史录音风格与单听者评测,长链播放仍有音乐性失败未解决。单卡RTX 5070 Ti上三十五秒文本生成的生成耗时指标为4.1秒,约为8.6倍实时,训练单轮约45.9分钟。
🔗 开源资源
- 第三方资源:https://github.com/HuanchenCai/guqin-generation — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
244. 把音符看成点:拉威尔小步舞曲中的 HAYDN 主题如何被几何变换找到

英文题目:Geometric Representations for Transformed Pattern Matching in Music
标签:#音乐检索 | #音乐分析 | #信号处理 | #形式化分析
评分:5.0/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.6/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:后 50% | 文档类型:方法研究 | arXiv 原文
👥 作者与机构
- David Meredith:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
本文输入是未标注声部的复调符号乐谱,输出是查询音型经移调、逆行、倒影、时值缩放和八度位移后的全部完整精确匹配,难点是键盘记谱声部与听觉声部常不一致,跨声部匹配会被按声部分割的序列表示漏掉。方法把每个音或连音线连接的同音延续看作一点,横轴取起音时间或音中时间(midtime,起音与止音的中点),纵轴取半音音高(钢琴键对应的整数音高)、形态音高(只由谱面位置、谱号和调号决定的整数音高)、色度(半音音高除以12的余数)或形态余数(形态音高除以7的余数),构成8种点集表示。再把乐理变换写成沿时间轴缩放、平移、可选对横轴或纵轴反射的三类变换族,缩放因子为0时把旋律压成同时发声的和弦,纵轴取余时允许八度位移,并为候选出现构建模式间变换图(顶点是出现,边表示存在某类变换把一点集完整精确映射到另一点集),按表读出等价类。与半音音高加起音时间相比,音中时间让精确逆行只对应一次时间反射,形态与余数表示容忍记谱等音与八度变化,这是区别于已有序列匹配的关键。在拉威尔作品的形态音高中音表示加第一类变换下,出现1、6、14、16、18、19与新增出现B构成7个一组的等价类,而起音表示下只有部分等价成立,说明表示选择决定能否刻画逆行与倒影逆行。结论只适用于有音高名、起音与时值的符号编码和完整精确匹配,对部分匹配、节奏非均匀扩大与和弦式引用是否算主题出现尚未验证。原文未提供可核对的关键定量结果,原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://github.com/chromamorph/omnisia/releases/tag/GAMABookChapter1-20261001 — 链接可访问(HTTP 200)
第三方资源:https://www.oracle.com/java/technologies/downloads/ — 链接可访问(HTTP 200)
第三方资源:https://www.eclipse.org/downl — 链接不可用(HTTP 404)
第三方资源:https://lilypond.org/ — 链接可访问(HTTP 200)
第三方资源:https://musescore.org/en — 链接可访问(HTTP 200)
第三方资源:https://www.verovio.org/index.xhtml — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
245. 水琴窟的声音如何被计算描述与比较

英文题目:A computational framework for the acoustic characterization of Suikinkutsu (water harp cave)
标签:#音频理解 | #时频分析 | #环境声 | #统计分析
评分:4.9/10 | 创新 1/2 | 技术严谨 1/1.5 | 实验充分 0.8/1.5 | 清晰度 0.8/1 | 影响力 0.5/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 0.5/1.5
排名:后 50% | 文档类型:应用研究 | arXiv 原文
👥 作者与机构
- Paul Haimes:机构信息未在 arXiv HTML 中可靠披露
- Alarith Uhde:机构信息未在 arXiv HTML 中可靠披露
- Daniel Moritz Marutschke:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
水琴窟(Suikinkutsu)是埋在石水钵旁的瓮状共鸣体,水滴落入后经气腔共振形成短促回声,论文要解决的是在无法拆解测量时如何记录并比较不同个体的声音特性。输入是多处寺社庭园的现场录音,输出是每条录音的多维声学描述与地点间相似度,难点是环境噪声、注水方式和传声位置都会进入录音。处理先把每条录音截取噪声较少的片段并做峰值归一化,再用Librosa提取快速傅里叶变换(Fast Fourier Transform,FFT)、梅尔频率倒谱系数(Mel-Frequency Cepstral Coefficients,MFCC)、均方根能量(Root Mean Square,RMS)、频谱质心、频谱带宽和频谱对比度,最后比较平均MFCC的余弦相似度与各描述子的归一化分布。原文未提供可核对的关键定量结果。作者因此把结论限定为有界的共振行为范围,而非固定不变的声纹。该结论仅适用于单次到访内重复录音的相对比较,在声源过弱、强交通或人声干扰下可能失败,且缺乏瓮体几何实测、跨季节回访与受控声学验证。原文未披露训练、推理或部署成本。
🔗 开源资源
第三方资源:https://teenage.engineering/products/tp-7 — 链接可访问(HTTP 200)
第三方资源:https://www.izotope.com/products/rx-advanced — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。