📄 不用基频标注学会跟随声门相位:逆向语音合成如何同时做重建与分析
英文题目:Unsupervised Instantaneous Phase and Frequency Tracking by Inverse Voice Synthesis
标签:#音高与旋律提取 | #无监督学习 | #语音合成 | #信号处理
评分:7.3/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.3/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1.2/1.5
👥 作者与机构
- Chin-Yun Yu:机构信息未在 arXiv HTML 中可靠披露
- György Fazekas:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
知识驱动神经声码器难以端到端学到可靠基频,因幅度谱损失丢掉相位、对周期监督弱,外部跟踪器不可微还会传入误差。GOLF-inv以源滤波器逆合成解决:编码器先从4通道谱特征估计帧中心频率与相位,经三次样条插值后逐段积分得到未修正相位。该未修正相位再经相位修正连成连续瞬时相位,修正量在当前帧中心为0、在下一帧中心为失配z_l,基频由修正相位求导再帧平均读出。连续相位驱动100次谐波加性声门源并做奈奎斯特限带,与噪声源经状态空间格型时变声道滤波器合成,谐波路径波形均方误差约束相位、多尺度谱损失约束整体幅度;100 Hz帧率下单帧最大修正约±79 Hz,训练以1至4帧随机积分窗口迫使编码器依赖频率预测。LM-SSD按每首歌第六遍留作测试,属未见表演而非未见歌曲或歌手,拷贝合成中GOLF-inv信号与重建误差比为8.103 dB,高于跟随FCNF0++目标的DDSP+F0的-2.665 dB。在LM-SSD测试集基频估计中,GOLF-inv总体准确率为95.79%,超过直接套用发布权重的PESTO的95.52%及传统跟踪器SWIPE、pYIN、REAPER与FCNF0++,但GOLF-inv在该数据训练而基线现成运行,适配差异构成部分优势且无需基频标签。在LM-SSD测试集声门闭合时刻检测中,GOLF-inv识别率为96.93%,低于喉头麦克风参考下REAPER的97.46%,相差0.53个百分点。结论仅适用于所测歌唱数据,噪声段谐波残余及对频率初始化范围依赖仍未解决。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
基频与相位为什么难学
这篇论文的输入是 16 kHz 的歌声音频波形,目标是在没有任何基频标注的情况下,同时恢复出每 1 帧的基频、连续的瞬时相位、声门闭合时刻,以及能解释该波形的声门与声道参数,输出是可重新合成出相位对齐波形的分析-合成参数。基频即声带每秒振动次数,决定言语与歌声的音高曲线,也是参数合成器的关键控制量。
传统做法是先用跟踪器估计基频,再驱动源-滤波器合成器重建,这种分析-合成思路依赖外部估计器,而外部估计器不可微,会阻断联合训练并把误差传入合成。近期神经声码器把参数提取做成神经网络,但幅度谱损失丢掉了相位,对周期结构只给出很弱且有噪声的梯度,因此端到端学基频很困难。论文把重建质量只当作参数是否解释了信号的证据,而不是为了追求听感上的合成器竞赛,这个定位决定了后文同时报告频谱指标与波形相位指标。
已有路线在输入监督与运行时上如何不同
要理解本文位置,需要把输入、目标、监督和运行阶段对齐。GOLF 是与本文同源的声码器,它用全极点滤波器加声门模型,输入是波形加外部基频,运行时必须先调用 FCNF0++ 这类估计器得到基频再驱动振荡器,波形匹配只用于微调。DDSP 加基频的变体同样在运行时依赖 FCNF0++,训练时让预测头去跟随 FCNF0++ 给出的目标,并用时变加性合成代替声道滤波器。
准谐波模型是传统逐帧最小二乘拟合方法,本文用 FCNF0++ 的基频做初值再做分析与重合成,它没有声道结构,但每帧直接拟合正弦,所以波形对齐天然占优。基频评测中的基线要分两类:SWIPE、pYIN、REAPER 是传统跟踪器,没有神经权重训练一说;FCNF0++ 与 PESTO 才是带发布权重的神经音高跟踪器,本文按发布权重直接调用。DDSP 加基频不是无监督基线,它的预测头跟随 FCNF0++ 目标。只有在相同输入都是录音室话筒信号、相同喉头参考下,比较才有意义,不能把类别差异说成同条件胜负。
论文要解决的具体矛盾
论文要解决的矛盾是:想用波形误差学出相位,又不想被随机噪声的不可预测波形破坏梯度;想摆脱外部基频,又不想回到会混叠的波表重采样。GOLF 能做波形匹配,但振荡器仍被外部基频驱动,走不通无监督频率学习。幅度谱方法对合成效果的影响不清楚,而相位不对齐在听感上往往不明显,所以多数声码器直接忽略相位。
本文把问题收紧为逆向合成:编码器从输入音频估计全部源与滤波器参数,可微合成器重建波形,重建误差反传回编码器,推理时直接从编码器读出频率与相位。例子:同一段浊音,若只比幅度谱,整体周期平移半个周期谱变化很小,梯度几乎不告诉模型该往哪调;若比波形,半周期错位会产生很大误差,梯度直接指向相位修正,这就是后文把波形损失只加在谐波支路的原因。
整体流程:编码器估计参数,物理合成器重建
整体流程是编码器加物理解码器。编码器输入是 4 通道频谱特征,输出是逐帧的频率、相位、反射系数、噪声倒谱等;解码器是固定的源-滤波器结构,用公式 S(z)=H(z)(G(z)+Q(z)) 把声门源 G 与成形噪声 Q 经声道滤波器 H 相加得到语音。与 GOLF 需要外部基频加波表不同,GOLF-inv 加性构造声门源,逐帧预测频率与相位并经校正读出基频,并把直接型滤波器换成状态空间格型。谐波支路 H(z)G(z) 相位确定,可做波形均方误差;含随机激励的噪声支路 H(z)Q(z) 波形不可预测,只参与谱损失。
声门源 × 声道滤波器: 声门源指声带振动产生的谐波加噪声激励,负责周期与相位;声道滤波器指模拟口腔共鸣的全极点时变滤波器,负责共振峰包络。二者按源-滤波器串联搭配,激励经过滤波才得到语音,组合后相位响应可解释,波形误差才能反传到频率与相位参数。
下面先看损失路由图,它规定了两条监督各比什么,理解它才能理解后文为什么相位能学出来。
看图路径: 1. 先看左侧 G(z) 与 Q(z) 如何进入 H(z);2. 再看谐波输出与全信号输出分别连向 MSE 与 MSS;3. 确认 MSE 支路不含随机噪声
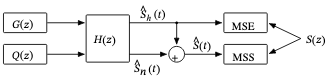
论文图 1。原论文 Figure 1::“Loss routing in GOLF-inv. MSE compares only S_h(t) with S(z), whereas MSS compares the spectrum of the full reconstruction S(z) with the target S(z).”。
图 1 显示左侧两路激励进入同一滤波器 H,谐波输出一路直接连向 MSE 与目标 S 比较,全信号输出经加法后连向 MSS 与目标谱比较。这意味着梯度有两条回路:谱损失同时调谐波幅度与噪声形状,波形损失只调谐波的频率、相位与滤波器,随机相位不会污染波形路径。
加性声门源如何显式给出相位与频率
声门源用加性合成写成 K 项余弦之和,每项幅度 ak 全局时不变,相位为 k 倍基波瞬时相位加偏置,基波偏置设为零使基波与瞬时相位同相。论文设 K 为 100,并当某次谐波的瞬时角频率达到 π 即奈奎斯特时把对应幅度置零做带限,避免非带限波表重采样带来的混叠。幅度约束为平方和归一且随频率递减,使第一谐波最强,让相位跟踪基音而非次谐波。编码器在每帧中心预测帧频率与帧相位,频率经三次样条插值到音频率,再从当前帧中心积分得到未校正相位。
为避免跨帧积分累积误差,引入准谐波模型的边界失配平滑分摊,校正项在当前帧中心为零,在下 1 帧中心恰好等于失配量 zl,从而使最终相位落到下 1 帧预测上,而不是在所有边界取零。最大频率校正发生在帧中间,100 Hz 帧率下约为正负 79 Hz,对低音影响显著,因此编码器可同时用频率与相位编码基频。训练时把积分窗口从 1 帧随机拉长到 1 至 4 帧,最大校正除以 m,迫使编码器更依赖帧频率。频率限在 32 至 960 Hz。
\[\displaystyle\phi(t)=\tilde{\phi}(t)+\frac{z_{l}}{2}\left(1-\cos\left(\frac{\pi(t-t_{l})}{t_{l+1}-t_{l}}\right)\right)\]上式中第一项是积分得到的未校正相位,第二项是余弦形分摊,zl 是包到负 π 到 π 的边界相位差。该式的输入是帧预测相位与插值频率,计算目标是音频率连续相位,其导数除以 2π 即瞬时频率,也就是后文取帧平均得到的基频。
瞬时相位 × 瞬时频率: 瞬时相位指声门周期在采样时刻的连续相角,是论文显式建模的状态量;瞬时频率指该相位对时间的导数除以 2π,即每秒周期数。相位积分得到波形对齐,微分得到基频,组合后不需要外部跟踪器也能从编码器输出读出 F0。
声道用格型滤波器与噪声成形解决什么
声道滤波器把时变共鸣建模为级联圆柱声管,每节交界面用反射系数描述,由相邻截面积算出,天然落在负 1 到 1 之间,从而把参数与声道几何绑在一起,并避免直接型高动态范围求和节点的数值误差。论文用状态空间格型实现,状态向量长度对应 14 阶,约对应 16 kHz 下男性声道长度,另学一个矩阵 C 引入零点并在滤波前加时变增益,直接通路增益固定为 1。
直接计算需要逐采样递推,论文把连续 L 步合并为一个仿射变换,各块系数只依赖本块,可并行计算,再把块边界状态链起来,块内剩余状态并行恢复;递归下去可把串行代价从 O(T) 降到 O(L log_L T),实现取 L 为 32 的纯 PyTorch 并行。噪声源是白噪声经学习谱成形,响应用 30 个对称实倒谱系数参数化得到零相位,经 512 点 FFT 加 149 点汉明窗的加窗法转成时域 FIR,负责宽包络,精细结构留给声道滤波器。
准谐波模型相位校正 × 随机积分窗口: 准谐波模型相位校正指在帧中心预测频率与相位后,用余弦形补偿把边界相位失配平滑分摊到帧内,避免逐帧积分累积误差;随机积分窗口指训练时把积分区间从一帧随机拉长到多帧,减小校正量。两者搭配让编码器不能靠相位修正掩盖频率误差,被迫学准帧频率。
分析编码器看到什么、输出什么
分析编码器的输入是 FFT 尺寸 512、帧率 100 Hz 的 4 通道频谱,含对数幅度、相角、实部与虚部,4 通道冗余对分析前端可接受,不同于 DDSP 用梅尔谱做合成条件。特征经 4 层 2 维卷积加批归一化、ReLU 与频率轴最大池化,把频率与通道展平后送入三层 256 隐单元的双向 LSTM,丢弃率 0.1,再经层归一化与全连接投射到各参数并用非线性限幅,最后线性上采样到音频率做时变合成。编码器估计全部源与滤波器参数,解码器仍是物理源-滤波器合成器,因此推理时不需要外部基频。
上采样后的频率与相位进入上一节的积分与校正,反射系数进入格型,倒谱进入噪声成形,梯度经可微合成与两条损失回传。这种分工使编码器必须同时解释周期与包络,任 1 分支坍缩都会在对应损失上暴露。
两条损失如何分工与训练过程
训练准则是谐波波形均方误差加权重为 0.01 的全信号多尺度谱损失。谱损失用互质窗长与跳长组合平滑损失面以帮助基频学习,用 auraloss 计算。多尺度谱损失加在全重建上,同时学谐波与随机幅度;波形均方误差只加在确定性谐波输出与目标之间,因为噪声支路波形不可预测,纳入会引入噪声梯度。论文认为在浊音占主导的训练数据上这样做有效。
随机积分窗口会伤害早期收敛,因此先训 10 轮不加,再打开直到验证损失不再下降。优化用 AdamW,学习率 0.0002,批量 8,音频峰值归一化后切成 32768 采样段。
波形均方误差 × 多尺度谱损失: 波形均方误差指在时域逐采样点比较目标与重建,要求相位对齐;多尺度谱损失指在多个窗长下比较幅度谱,只要求频谱包络接近。前者只加在确定性谐波支路以约束相位,后者加在谐波加噪声的全信号以学全频谱,分工后随机噪声不污染相位梯度。
谐波与噪声的能量对比后文还用于浊音判断:当谐波支路能量大于噪声支路且能量高于负 40 dB 才判为浊音。
谐波支路 × 噪声支路: 谐波支路指声门谐波经过声道滤波器的输出,相位确定、可做波形比较;噪声支路指白噪声经倒谱成形再经同一滤波器的输出,相位随机、只能比谱。两者相加构成完整重建,组合后浊音靠谐波解释周期,清音与气息靠噪声解释频谱。
数据划分、参考标签与指标方向
实验用 M4Singer 与 LM-SSD,均重采样到 16 kHz。M4Singer 是 30 小时 20 位歌手的中文歌声,涵盖低音到女高音,每位歌手 10% 随机划为测试,其余训练,属于歌手内划分。LM-SSD 是喉头话筒与录音室话筒同步录制,论文只选无串扰的独唱录音室信号,共 3 位歌手约 2 小时,所有方法都处理录音室信号,喉头信号只做参考。每首歌留第六遍做测试,其余遍做训练,因此测试是未见表演,但歌曲与歌手仍在训练中出现,不能说成未见歌曲或未见歌手。
拷贝合成从同一录音经编码器与物理合成器重建,指标有多尺度谱损失、梅尔倒谱失真、语音质量感知评价与信号重建误差比,其中前三者越小或越大分别表示频谱保真,信号重建误差比是目标能量与误差能量之比取对数,越高表示逐采样波形越对齐。基频在 LM-SSD 上以喉头参考为准,用 REAPER、pYIN、SWIPE 多数投票,报告 50 音分内容许差的原始音高准确率与计入清浊音的整体准确率,按全划分 pooled 帧数算百分比而非按片段平均。
声门闭合时刻以喉头信号上的 REAPER 标记为准,命中判为落入以参考为中心的一周期窗内,报告识别率、误报率、漏报率与 timing 误差标准差,标准差忽略常数偏置只看散布。
拷贝合成:相位对齐从哪来,频谱代价是什么
先看拷贝合成的比较问题:在同一测试划分上,用相同重建流程比较频谱保真与波形对齐,方向是谱损失与倒谱失真越低越好,感知评价与重建误差比越高越好。GOLF-inv 不用基频目标仍在全部指标上优于跟随 FCNF0++ 的 DDSP 加基频,并把重建误差比从负 2.67 dB 拉到 8.10 dB 正值,正值意味着逐采样跟随,这是相位不可知系统做不到的。直接型滤波器消融为 7.92 dB,略低于格型;纯准谐波源可达 10.68 dB 但倒谱失真恶化到 6.21 dB,说明源-滤波器分解对合成质量必要。
GOLF 用外部基频得到最低谱失真,准谐波模型谱损失与感知评价占优且重建误差比最高,但它逐帧最小二乘拟合、无声道结构,且对清音也拟合正弦,而本文噪声支路相位随机在清音留下不可约残差,因此它的领先主要来自噪声建模差异。
| Model | MSS(↓) | MCD(↓) | PESQ(↑) | SRER(↑) |
|---|---|---|---|---|
| GOLF-inv | 0.981 | 4.469 dB | 2.613 | 8.103 dB |
| GOLF | 0.868 | 3.917 dB | 2.838 | -2.801 dB |
| DDSP+F0 | 1.072 | 5.175 dB | 2.485 | -2.665 dB |
| QHM | 0.871 | 4.668 dB | 2.967 | 13.745 dB |
上表同时给出 4 种系统的谱与波形指标,读时注意两者不必同向:GOLF-inv 的优势在波形对齐,代价是频谱仍不如用外部基频的 GOLF,这与只在谐波支路加波形损失的偏置有关。
下面看两段 LM-SSD 摘录的波形与闭合时刻面板,左侧低音区 157 Hz,右侧高音区 276 Hz,每块含目标、重建、喉头与学习声门源四行。
看图路径: 1. 对比低音区与高音区两块面板的周期跟随情况;2. 看重建波形与目标波形是否逐周期对齐;3. 看红色估计闭合时刻与虚线参考及蓝色 REAPER 标记的相对位置

论文图 2。原论文 Figure 2::“Synchronised waveforms and GCIs on two test LM-SSD excerpts. The reconstruction s(t) follows the target s(t) cycle by cycle.”。
图中重建波形逐周期跟随目标,学习声门源呈规范脉冲形,红色估计闭合时刻与虚线参考在高低音区都接近,蓝色 REAPER 标记整体有近常数偏移,但标准差只衡量散布所以不受偏移影响。该图只证明浊音周期跟随,不能推广到清音噪声段。
基频与声门闭合时刻在什么参考下成立
基频比较的问题是:在喉头多数投票参考下,GOLF-inv 从相位导数帧平均得到的基频,能否与直接调用发布权重的神经跟踪器及传统跟踪器相比。GOLF-inv 训练在 LM-SSD 上而基线是现成调用,因此它的一部分领先来自对该数据的无标注自适应,这种自适应不需要基频标签、可在任一语料重复。结果是 GOLF-inv 在训练与测试划分都取得最高整体准确率,原始音高准确率超过 REAPER 与 SWIPE;pYIN 原始准确率最高但整体准确率最低,说明其浊音帧准但清浊音判断弱。仅用帧频率不加相位校正时,无随机窗口测试原始准确率掉 5.39 个百分点到 86.89%,而有校正为 92.28%;有随机窗口时同口径差距仅 0.50 个百分点,证明随机化阻止了相位校正吸收频率误差。
| Model | Train | Train | Test | Test |
|---|---|---|---|---|
| Model | RPA (↑) | OA (↑) | RPA (↑) | OA (↑) |
| GOLF-inv | 92.45 | 95.19 | 92.91 | 95.79 |
| ↪\hookrightarrow f^(tl)\hat{f}(t_{l}) only | 91.79 | 94.85 | 92.41 | 95.54 |
| Fixed window | 91.82 | 94.83 | 92.28 | 95.44 |
| ↪\hookrightarrow f^(tl)\hat{f}(t_{l}) only | 86.43 | 92.07 | 86.89 | 92.75 |
| DDSP+F0 | 91.19 | 93.29 | 91.52 | 93.96 |
| FCNF0++ | 90.85 | 92.72 | 90.78 | 93.64 |
| PESTO | 92.01 | 95.04 | 92.33 | 95.52 |
| pYIN | 94.91 | 90.00 | 94.91 | 91.63 |
| SWIPE | 91.27 | 91.69 | 92.06 | 93.85 |
| REAPER | 92.05 | 94.04 | 92.61 | 95.63 |
上表保留了全部可运行策略:GOLF-inv 两种读出、固定窗口消融、跟随 FCNF0++ 的 DDSP、两个神经跟踪器与 3 个传统跟踪器。注意 DDSP 加基频的目标来自 FCNF0++,不能把它当无监督方法;REAPER 与 SWIPE 是传统方法,不能归为监督方法。
声门闭合时刻利用加性源闭式可微的性质,对学习到的规范脉冲用牛顿法找极小值定闭合相位,再映射到连续相位时刻。
| Model | IDR (↑) | FAR (↓) | MR (↓) | σ\sigma (↓) |
|---|---|---|---|---|
| GOLF-inv | 96.93% | 1.10% | 1.97% | 0.77 ms |
| REAPER | 97.46% | 0.82% | 1.72% | 0.76 ms |
上表显示 GOLF-inv 识别率 96.93%,误报 1.10%,漏报 1.97%,标准差 0.77 ms,只比 REAPER 低 0.53 个百分点、标准差大 0.01 ms。该结论依赖喉头 REAPER 标记为参考、一周期窗命中规则与 pooled 统计,换参考或窗宽结论可能变化。
拿掉格型、声道或随机窗口会发生什么
消融要回答 3 个分工问题。滤波器方面,格型比重建误差比高于直接型,且直接型需要梯度裁剪才能收敛,支持格型用反射系数限幅改善数值稳定性的说法。声道方面,去掉滤波器的纯准谐波源波形对齐更高但倒谱失真变差且训练更不稳定,支持源-滤波器分解对质量与稳定的价值。
窗口方面,固定窗口时帧频率单独读出的测试原始准确率明显低于加校正后的读出,随机窗口把该差距从 5 个百分点量级压到 0.5 个百分点,说明没有随机化时相位校正掩盖了频率误差。收敛还依赖预测频率初值范围与数据重叠、谐波幅度随频率衰减的约束,否则相位可能跟踪次谐波。这些都是在歌声、浊音主导数据上的观察,乐器与语音未测,不能外推。代价是每输出采样最多求和 100 个正弦,而波表只需一次查表,换来的是无混叠与可解析求导以做牛顿搜索。
哪些限制是论文明确承认的
论文明确承认准则有偏:波形误差只加在确定性路径,会鼓励在应是噪声主导的清音区也产生谐波能量,听感为清音区残留嗡嗡声,可能用浊音相关掩蔽或谱白化缓解。只测了歌声,语音留作未来工作,虽称许多乐器有类似源-滤波器结构但未验证。准谐波参考本身用外部基频初值且无声道,不能当无监督上限;GOLF-inv 的整体准确率领先含数据自适应成分,与现成基线不完全同条件。闭合时刻标准差忽略常数偏置,若应用要求绝对延迟而非散布,需要另做偏置校准。训练只报告 AdamW 与损失权重等超参数,未报告推理延迟与算力预算,不能承诺实时性或成本改善。
复现第一步做什么,需要什么条件
复现第一步是按论文划分准备 16 kHz 数据与喉头参考:M4Singer 按歌手内 10% 测试,LM-SSD 按每歌第六遍测试并保留歌曲与歌手重叠,再用 REAPER、pYIN、SWIPE 多数投票生成基频参考、用喉头 REAPER 标记生成闭合参考。模型侧先实现加性带限声门源与帧相位积分加余弦分摊,再实现状态空间格型并行扫描与 30 系数零相位噪声成形,最后接 4 通道频谱编码器与双损失。关键超参数是谱损失权重 0.01、互质窗跳组合、频率限 32 至 960 Hz、先 10 轮关闭随机窗口再打开。
资源方面,论文正文提到演示页与 philtorch 组件库链接,但本次来源校验未发现完成 HTTPS 验证且归属明确的可用资源,因此不能写成代码、模型或数据已公开或可运行;来源未确认只是本次未能确认可达,不是技术缺陷。复现时应以论文公式与划分描述为准,缺失的仓库与权重需要自行实现或另行确认。
什么时候值得尝试,还缺哪项验证
当任务需要无标注得到可解释的基频与相位,例如只有录音室录音而无喉头或基频标注的歌声语料自适应,或者需要声门闭合时刻做进一步分析,且能接受频谱失真略高于用外部基频的系统时,值得尝试逆向合成路线。复现后应先看重建误差比是否为正以确认相位对齐,再看整体准确率与识别率是否在相同参考与 pooled 规则下复现。
还缺的验证包括语音与乐器上的泛化、清音区嗡嗡声的主观影响、不同参考与窗宽下的闭合时刻稳定性,以及训练与推理开销的实测。容易误解的三点:重建误差比高不等于听感全面更好,准谐波的高分含拟合方式差异;整体准确率高部分来自对测试同分布的无监督自适应,不是跨语料零样本超越;第六遍测试是未见表演而非未见歌曲与歌手,不能当跨曲泛化证据。在这些条件下,匹配波形相位而非只匹配幅度谱,是本文能无监督读出频率与闭合时刻的原因。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses