📄 不训练模型也能校准指令语音的性别分布
英文题目:Training-Free Instruction TTS Gender Bias Calibration Using Model-Adaptive Steering
标签:#文本到语音 | #测试时自适应 | #公平性 | #语音
评分:6.6/10 | 创新 1.3/2 | 技术严谨 1.1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.9/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Kuan-Yu Chen:机构信息未在 arXiv HTML 中可靠披露
- Yi-Cheng Lin:机构信息未在 arXiv HTML 中可靠披露
- Jeng-Lin Li:机构信息未在 arXiv HTML 中可靠披露
- Jian-Jiun Ding:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
指令文本到语音接收自然语言风格指令和朗读文本,输出带有人口、职业或场景风格的语音,难点是当指令没有写明性别时,职业与身份描述仍会诱发偏向某一性别的声学输出。论文提出模型自适应转向,先用显式性别词改写的配对锚点估计群体偏移向量,再在开发集上用由粗到细的网格搜索确定作用强度,推理时只对不含性别词的提示词在编码器后条件表示上做加性偏移。词汇门负责显式性别提示词的旁路保留,联合目标同时约束总体与按描述词类型分层的偏离,并丢弃出现单性别饱和的候选。与直接追加中性说明和在池化特征上做线性擦除的对照相比,该方法直接校准输出分布而不更新生成器参数。在12,800条held-out提示词组成的保留测试集上,与未干预原始输出相比,四模型总体校准误差从11.5-28.1个百分点降至0.8-5.9个百分点。在同一保留测试的500条共享子集效用评测中,与原始输出相比,自然度指标UTMOS最多下降0.08。结论适用于英文指令、冻结模型和二值声学代理评估范围,原文未披露训练、推理或部署成本。
🔗 开源与复现资源
- 第三方资源:https://github.com/DanielChen1128/ITTS-Debias — 链接可访问(HTTP 200)
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
指令语音合成的输入是什么,要输出什么
刚接触语音合成的同学可以先把任务想成一个受控的朗读器。输入有两部分,一是指令提示,例如说这是 1 位经验丰富的软件工程师,或者 1 位温柔的幼儿园老师,二是要朗读的文本内容。输出是一段语音波形。指令文本转语音这个说法,指的是提示可以用开放的自然语言写风格、人设、韵律和环境,而不是只能从固定说话人编号里选。论文研究的是提示里没有写性别的情况。
理想情况下,这类提示不应该系统性地导向女性声音或男性声音,但实际 4 个被测模型都出现了偏斜,有的偏女性,有的偏男性。需要保留的信息包括用户明确写出的性别词、要朗读的文本内容,以及尽量不损失的自然度和可懂度。目标是把未指定性别的提示所诱发的总体女性占比调回一半附近,同时不改模型参数,不加适配器,也不覆盖明确性别提示的原意。
指令文本转语音 × 声学性别偏斜: 指令文本转语音指用自然语言提示控制说话人风格、韵律和声学环境的合成任务,声学性别偏斜指当提示只写职业或人设而不写性别时合成结果中女性或男性声音占比系统性偏离一半,论文要校准的正是这种由提示语义诱发的输出分布偏斜,而不是单个样本的音质问题。
已有偏置研究和显式属性操控为什么不够用
在文本、语音识别、情感识别和自监督表征里,人口统计偏置已经有不少研究,语音合成里的指令偏置研究相对较少。另一条相关的路线是激活 steering,也就是在推理时沿某个方向拨动中间表征来控制行为,最早在语言模型里出现,后来也有人用来控制情感、口音这类明确指定的声学属性。论文指出这两条路线都不能直接解决当前问题。偏置审计能发现问题,但没有给出跨异构架构且不训练的校准办法。
显式属性 steering 是把单条生成推向用户指定的某个属性,而这里恰恰是没有指定属性,需要校准的是大量未指定提示在总体上形成的分布。如果直接套用连续偏移,还会带来两个具体风险,一是偏移太大损坏音质,二是不加区分地偏移会把用户明确写的性别也改掉。原文把训练自由、保留明确意图、保持可用性同时满足作为尚未解决的开放问题,这也是后文每个组件的出发点。
论文把校准问题具体化成什么可测量的形式
论文把抽象的公平诉求落成可计算的分布校准问题。固定随机种子、文本和批量设置,对每条提示生成语音,再用一个自动的声学性别代理分类器给每条波形判女性或男性,统计女性占比。总体女性占比记为总体比例,按提示的描述词类型分成状态、职业、人设、双轴组合、三轴组合 5 个层,每层再算女性占比。校准误差就是这些占比与 50% 的绝对差距,单位是百分点,越小越好。
论文同时看总体差距、五层平均差距和最差一层的差距,因为只看总体会让不同层之间一正一负相互抵消。约束也很明确,生成器参数冻结,只动编码器之后的调节表征,遇到明确性别词就绕过,强度只在开发集上选定,测试集上冻结使用。这样的形式化让公平效果和语音代价都能在同一批合成结果上复现。
两阶段流程如何分工,先算什么再用在哪里
整个方法分成离线校准和在线干预两个阶段。离线阶段做两件事,第一是用成对反事实锚点估计组偏差向量,第二是在开发集上用从粗到细的网格搜索选定操作点,也就是实际使用的偏移强度。在线阶段对每条新提示先过词法门控,有性别词就直接走原模型,没有性别词就在各自模型的调节接口上加上强度乘以偏差向量的偏移,再送入冻结的解码器和声码器。图一展示了这种分工,上方是离线估计方向和剂量,下方是推理时按门控决定是否注入。
读图时可以先看主路径再看注入路径,注意门控的是与否分支和下游同时记录的 3 类指标。
看图路径: 1. 先沿下方推理路径看提示加文本如何经过冻结编码器、门控和调节接口得到波形;2. 再看上方离线阶段的偏差向量和操作点是从哪里注入到调节接口的;3. 注意词法门控处是与否两条分支分别通向直接解码和加偏移后解码;4. 最后看右侧下游评测同时记录性别比例、自然度和转写错误率
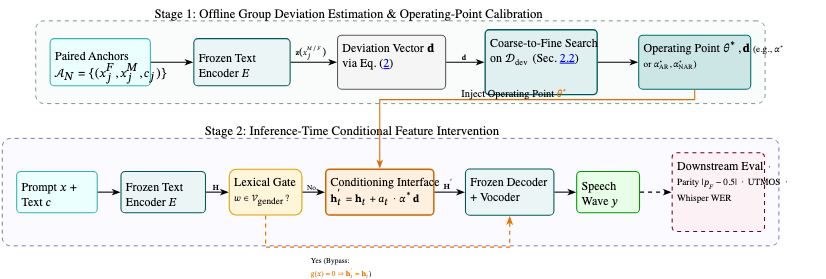
论文图 1。原论文 Figure 1::“Two-stage calibration and inference framework.”。
从图中可见,成对锚点经过冻结文本编码器得到表征,再算出偏差向量,粗到细搜索在开发集上定出操作点,推理时调节接口处的表征被加上该操作点对应的偏移。下游评测用性别比例看是否回到一半,用自然度和转写错误率看有没有损坏语音。这种设计把方向估计、剂量选择和意图保护拆成 3 个独立机制,后文分别解释计算细节。
组偏差向量从成对锚点里算出什么方向
组偏差向量的想法基于一个工作假设,即人口统计偏置在调节空间里表现为 1 个方向性的偏斜。做法是为每个模型单独估计,因为不同架构的表征和原始偏斜方向不一样。锚点是成对构造的,同一模板和同一朗读文本,只差明确性别描述,例如女性说话的温暖语气和男性说话的温暖语气配同一文本。每个序列先经过冻结文本编码器得到每个词的调节向量,再按注意力掩码做掩码平均池化,把变长序列压成一个向量。
把同一对里男性向量减女性向量,再对所有对取平均,就得到该模型的组偏差向量。正向拨动趋向男性声学特征,负向拨动趋向女性声学特征。原文明确说,这个向量是可操作的 steering 方向,不是理论上把性别与其他语义完全解耦的证明。
组偏差向量 × 操作点: 组偏差向量指从成对反事实锚点上估计的女性表征到男性表征的平均偏移方向,决定往哪个方向拨,操作点指在这个方向上实际加多大的强度,决定拨多少,两者搭配才构成一次完整的推理时干预,前者管方向,后者管剂量。
\[\mathbf{d}=\frac{1}{N}\sum_{j=1}^{N}\left[\mathbf{z}(x_{j}^{M},c_{j})-\mathbf{z}(x_{j}^{F},c_{j})\right].\]偏移加在调节表征的哪里,门控何时绕过
有了方向之后,实际干预是对每个未被掩码的词向量加上门控乘以强度再乘以偏差向量。门控是对提示做大小写不敏感的词边界匹配,词表只包含男性、女性、男人、女人、男孩、女孩这几个明确性别词,命中任何一个就置零并绕过,保持原表征不变。没有命中才加偏移,强度为零时完全回到原模型。不同模型的落点不同,Parler 这类模型是词级别的,在声学交叉注意力之前加,PromptTTS++ 这类是全局风格,只有一个池化后的风格向量,相当于序列长度为一的情形,VoxInstruct 是双流结构,对自回归流和非自回归流分别估计各自的偏差向量并使用各自的强度。所有设置下生成器参数都冻结,只改推理时的调节特征。
条件表征接口 × 词法门控: 条件表征接口指文本编码器之后、声学解码器之前的那组调节表征,是干预实际发生的位置,词法门控指先检查提示里有没有明确性别词、有就直接绕过干预的确定性开关,两者搭配保证只对未指定性别的提示做偏移,不覆盖用户明确写出的性别意图。
\[\mathbf{h}^{\prime}_{t}=\mathbf{h}_{t}+g(x)\,a_{t}\,\alpha\,\mathbf{d},\]没有训练时,方向和强度实际经过哪些计算和搜索
本研究没有训练任何合成模型,也没有更新生成器参数或加适配器,实际计算是估计方向和搜索强度两步。方向估计用 2500 对锚点,其中一部分来自开发集提示扩展,其余是自构造的补充对,锚点与测试集的提示编号不重叠。强度搜索把偏差向量冻结,只在 500 条开发集上试不同的强度,开发集在 5 个层上各 100 条。
对每个候选强度生成语音并统计总体和每层的女性占比,先丢弃导致任何一层完全塌缩到零或 100% 的候选,再最小化总体差距加分层平均差距的联合目标。只看总体会让层间误差抵消,加上分层项就是为了惩罚这种抵消。目标不可微,所以用网格搜索,先粗后细。单流模型先试零和正 -1.0 到 2.5 的粗网格,PromptTTS++ 再在 -0.375 到 -0.125 之间细化,双流模型在 2 个流的强度组合上搜 4 乘 4 粗网格。
出现并列时先选最差层差距更小的,再选范数更小的,选定后冻结到测试集上不再改动。
\[J(\theta)=|p_{F}(\theta)-0.5|+\frac{1}{|\mathcal{S}|}\sum_{s\in\mathcal{S}}|p_{F,s}(\theta)-0.5|.\]测试集、基线和指标如何保证比较条件一致
基准一共 13300 条指令提示,分成 500 条开发集和 12800 条 held-out 测试集。测试集里状态 100 条、职业 2600 条、人设 3900 条、双轴 3100 条、三轴 3100 条。校准参数只在开发集上优化,测试生成时冻结,种子、文本和批量设置在不同干预之间保持一致。基线有两个且都不更新参数,一是在提示后追加性别未指定、不要从职业或人设推断性别的中性指令,二是在池化特征上做线性擦除类方法的池化版本并用同一联合目标调权重。
声学性别用预训练语音分类器的女性与男性打分比较得到二值代理标签,儿童类别的打分被排除在比较之外但仍按女性与男性二选一归类,原文强调这只是统计合成分布的自动代理,不是认定真实身份。语音可用性在共享的 500 条测试子集上算绝对均值,自然度用自动打分越高越好,转写错误率用大模型转写后计算越低越好。统计上用分层自助法给置信区间,设置差异用配对自助法,可用性变化用配对符号秩检验。
聚合校准误差 × 分层校准误差: 聚合校准误差指全部测试提示上女性占比与百分之五十的绝对差距,分层校准误差指按状态、职业、人设、双轴、三轴五个提示类型分别算差距再平均或取最大,前者看总体是否回到一半,后者防止不同类型之间正负抵消,论文用两者联合目标选操作点。
声学性别代理分类器 × 语音可用性: 声学性别代理分类器指用预训练语音模型对合成波形判女性或男性的自动工具,只用于统计输出分布,不是认定真实身份,语音可用性指用自然度打分和转写错误率衡量干预有没有损坏可听性和内容正确性,两者分工是前者看公平效果,后者看代价。
\[G(y)=\mathbb{I}\left(q_{F}(y)\geq q_{M}(y)\right).\]总体校准误差降了多少,代价出现在哪些数字上
主结果要回答的是总体分布有没有回到一半附近。下表整理的是论文直接报告的总体区间与示例模型变化,比较问题是同一批 held-out 提示上原模型与本方法校准后的总体差距,公平条件是种子文本批量一致,指标方向是校准误差越小越好,女性占比越接近 50% 越好。
| 比较对象 | 指标 | 原始 | 校准后 | 含义 |
|---|---|---|---|---|
| 4 模型总体 | 聚合校准误差 | 11.5–28.1 百分点 | 0.8–5.9 百分点 | 总体女性占比与 50% 的差距 |
| 示例模型 | 女性占比 | 78.1% 与 27.3% | 50.8–52.4% | 小模型偏女性与另一模型偏男性的校准示例 |
这些数字放在一起看,含义分成两层。聚合误差区间的大幅下降是 4 个模型上的总体结论,示例数字说明起点方向不同,一个起点偏女性,一个起点偏男性,方法通过正负不同的强度把两者都拉回一半附近。中性指令基线在 Parler 模型上反而加重了女性偏斜,线性擦除基线在部分模型上能降总体误差但会留下单层欠校准,例如状态层仍然偏低而人设层被推高,这说明只看总体容易漏掉分层问题,论文因此同时报告分层平均和最差层。锚点稳健性和语音可用代价的上限数字见后两节各自的比较表,这里不再重复填入。
分层和描述词层面还有哪些残留的不均匀
总体回到一半不等于每一层都回到一半。论文报告最差层差距在本方法下大多在六点多到十点多百分点之间,但大模型仍在职业层留下约二十多百分点的差距,这与其原始层间差异很大有关,单一全局偏移能缓解但不能消除。描述词层面的分析进一步显示,Parler 模型上原始与校准后描述词女性率的排序相关性很高,接近二项重抽样的噪声上限,说明相对排序基本保留,但描述词之间标准差反而变大,提示全局偏移在拉回均值的同时可能拉开离散程度。
PromptTTS++ 的标准差是收窄的,双流模型基本持平。分类器后验方面,落在中间模糊区间的输出比例在原始和校准后都只有百分之几,说明一半附近的总体比例是清晰女性和清晰男性声音混合出来的,不是靠大量模糊声音凑出来的。这些细节限定了总体数字的解释范围,即方法调的是分布位置,没有把每个细分语义都调平,也没有制造模糊语音。
锚点数量变化时,已固定的操作点是否还稳定
这个比较要回答方向估计对锚点数量是否敏感,比较问题固定为操作点不变、只换锚点子集大小,公平条件是同一 12800 条 held-out 测试集和同一强度,指标是女性占比随锚点数量的最大变化,变化越小说明方向估计越稳。下表整理原文第三张表,原表只报告固定操作点下不同锚点数量的女性分类率。
| 模型 | 最大变化 |
|---|---|
| Parler-Mini | 0.39 百分点 |
| Parler-Large | 0.88 百分点 |
| PromptTTS++ | 0.70 百分点 |
| VoxInstruct | 0.44 百分点 |
从结果看,4 个系统在 500、1500、2500 对嵌套子集上的最大变化都不超过 0.88 百分点,其中最大的一项来自 Parler-Large。限制同样明确,这只是每模型一条嵌套序列上的观察,不是多次随机抽样的方差估计,只能说在这组嵌套子集上稳健。自然度与可懂度的数字属于另一处比较,是原文第一张表中共用 500 条测试子集上相对原模型的干预代价,UTMOS 最多下降 0.076,WER 从 Parler-Mini 的 -4.13 百分点到 Parler-Large 的 +3.26 百分点,不属于本表锚点数量敏感性的结论,这里不并入上表。
语音自然度和可懂度的代价具体落在什么范围
这个比较要回答的是校准有没有损坏语音,比较问题是同一 500 条测试子集上本方法相对原模型的变化,公平条件是文本种子一致,指标方向是自然度越高越好、错误率越低越好。下表整理的是正文直接报告的干预代价,锚点数量敏感性表格里的波动上限不能填到这里,原始与校准后的聚合误差和示例女性占比也不能填到这里,因为它们不是同一指标。
| 比较条件 | 指标 | 本方法相对原模型 | 基线对照 | 含义与限制 |
|---|---|---|---|---|
| 共享 500 条子集 | 自然度下降 | 最多 0.076 | 线性擦除在 3 模型上更高 | 自动打分的最大下降 |
| 共享 500 条子集 | 可用性上限口径 | 自然度最多 0.08,错误率最多 3.3 百分点 | 同上 | 摘要口径的取整表述 |
| 显著性 | 配对检验 | 自然度 4 模型中一显著,错误率四中二显著 | 中位数变化为零 | 感知评测留待未来 |
| 未胜出项 | 可用性 | 本方法可用性不如线性擦除 | 线性擦除公平性更差 | 用小代价换更低校准误差 |
具体而言,代价总体温和但不是零,最大自然度下降 0.076,错误率在小模型上甚至下降四点多百分点,在大模型上恶化三点多百分点。未胜出的事实也要保留,线性擦除在多数模型上自然度和错误率更好,但校准误差明显更大,论文的选择是用小的可用性代价换分布校准。显著性结果说明多数变化不大,且原文没有做人类听感评测,自动指标不能等同于人工评价。
这些结论在什么条件下才成立,有哪些明确边界
首先是性别建模的边界,评测把性别处理成女性与男性的二值代理标签,是为了对接可用的预训练声学模型和标注,这种工程简化不反映完整的性别谱系,也只看了声学性别,没有涉及年龄、族裔、口音等交叉维度。其次是语言边界,所有基准、词表和模型都限于英语,向有语法性别或其他文化关联的语言推广时需要谨慎。
再次是统计边界,测试集中状态层只有 100 条,由此驱动的最差层差距带有约 ±9.8 百分点的宽置信区间,开发集每层 100 条选出的操作点在个别模型上落在网格边缘,说明最优强度可能在网格之外。还有机制边界,偏差向量是经验方向,不是性别与相关语义解耦的理论证明,全局单一偏移会保留甚至拉大描述词间离散,论文用实例说明了这一点。
最后是测量边界,代理分类器只刻画合成分布的统计偏斜,不能用于判断真实身份,自然度和错误率都是自动指标,没有人类感知验证。
复现第一步做什么,需要哪些数据和超参数
复现时先不要动合成模型,先准备三份数据。第一份是成对锚点,同一模板同一文本只差明确性别描述词,与测试编号不重叠,论文用 2500 对并测试了五百和一千五百的子集。第二份是 500 条开发集,5 个层各 100 条,用于网格搜索选强度。第三份是 12800 条 held-out 测试集,层分布按原文固定。
关键超参数是每个模型自己的操作点,单流模型是单个强度,双流模型是 2 个流各自的强度,论文选出的点包括大跨度的正值和小幅负值,搜索范围单流在零和正负一到 2.5 之间,双流在两个离散集合的组合上。门控词表固定为 6 个明确性别词,大小写不敏感的词边界匹配。生成时固定种子文本批量,编码器解码器声码器冻结,只在调节接口加偏移。
评测时用同一代理分类器按女性打分是否不小于男性打分得到二值标签,再算总体、分层平均和最差层差距,同时在共享 500 条子集上算自然度和转写错误率。第三方代码链接在论文中有提及,但本次只按论文内容复述方法,不对链接的可用性做断言,代码可运行、权重可下载、系统可运行是三件不同的事,需要分别确认。
什么时候值得尝试,还缺哪项验证
当你的指令语音系统在未指定性别的职业或人设提示下出现系统性偏斜,又不能重训模型或加适配器,且明确性别提示必须原样保留时,这个方法值得尝试。它的适用条件很具体,偏置在调节空间里近似呈方向性,开发集能覆盖你关心的提示类型,且你能接受小的自动指标代价。复现的第一步是为你的模型单独估计组偏差向量并在你自己的开发集上搜操作点,不能直接搬运论文里的强度数值,因为方向和起点偏斜都是模型自适应的。
还需要补的验证包括人类听感评测、多语言和交叉人口维度的审计、多次随机锚点抽样下的方差估计,以及网格边缘模型上更大搜索范围的检查。容易产生的误解是把总体回到一半当成每层每词都公平,原文的分层和描述词分析恰恰说明不是这样,总体数字好看时仍可能留下单层残留和离散拉大,阅读结果时要把总体、分层和可用性 3 类数字一起看。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses