📄 不用训练也能让语音大模型专心做一件事:对比激活相加转向
标签:#语音识别 | #语音情感识别 | #音频字幕生成 | #测试时自适应
评分:6.5/10 | 创新 1.3/2 | 技术严谨 1/1.5 | 实验充分 1.1/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Séverin Baroudi:机构信息未在 arXiv HTML 中可靠披露
- Yanis Labrak:机构信息未在 arXiv HTML 中可靠披露
- Pierfrancesco Melucci:机构信息未在 arXiv HTML 中可靠披露
- Sergio Burdisso:机构信息未在 arXiv HTML 中可靠披露
- Petr Motlicek:机构信息未在 arXiv HTML 中可靠披露
- Hervé Bredin:机构信息未在 arXiv HTML 中可靠披露
- Mirco Ravanelli:机构信息未在 arXiv HTML 中可靠披露
- Ricard Marxer:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
语音大模型通常靠文字提示词指定转写、情感识别或字幕生成等任务,但同义提示词的效果波动大,而为每个任务单独微调又需要标注数据和多套权重。论文提出免训练的对比激活加法(Contrastive Activation Addition,CAA)流程,先用同一批音频分别搭配目标任务指令与其他任务指令输入冻结的语音大模型,取提示词最后一个位置在某层的残差激活均值并求差得到任务向量。推理时把该向量按强度加到选定层的所有或文本位置上,有效注入集中在中间层且强度与层位经小规模音频集网格搜索确定,必要时再叠加一个脚本归一化向量以约束输出文字。在 Qwen2-Audio-7B-Instruct 上,提示词加任务转向在 LibriSpeech 四个划分平均的字错率由 4.18%降至 3.75%,CommonVoice 五种语言平均的字形错误率由 28.6%降至 25.7%,同时跨三条提示词的标准差约缩小一半。该结论适用于所测的两个指令跟随语音大模型与所列的英语、法语、阿拉伯语、印地语、俄语转写及情感与字幕任务。转写向量在 LibriSpeech 与 CommonVoice之间迁移时性能下降很小,非拉丁文字仍可能输出拉丁字母或出现幻觉延续。原文未披露训练、推理或部署成本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
语音模型要解决的输入输出是什么
刚接触语音的研究生可以先把任务想成音频加文字进、文字出。输入是一段波形经过语音编码器变成的音频标记序列,再拼接一段文字提示词,例如请转写或请判断情感。输出是模型逐个生成的文字,可以是逐词转写稿,可以是从愤怒、高兴、中性、悲伤四选一的情感标签,也可以是对声音事件的一句描述。必须保留的信息是音频里的语言内容或副语言线索,不能在处理中丢失;必须输出的是符合任务格式的文字,而不是闲聊或拒绝。
评价时转写看词或字符错了多少,情感看加权准确率,描述看与参考字句的重叠度。论文研究的就是如何在不改模型权重的前提下,让同一个语音语言模型更可靠地进入这 3 种工作状态。
提示词、微调和转向三条路线有何不同
同一个语音语言模型做不同任务,最常见的做法是换提示词。优点是不需要训练,缺点是换一种同义说法效果可能差很多,论文称之为提示词敏感。另一条路是有监督微调,例如只在注意力投影上加低秩适配器,用几十到几 100 条音频训练,代价是每个任务一套权重,数据少时容易过拟合,部署麻烦。第三条路是激活转向,直接在推理时改中间隐藏状态。语音合成里曾有用中性与情感激活之差控制情感的做法,也有训练小网络学转向向量的做法。
免训练的对比激活相加在文本大模型里已有拒答方向等例子,在语音里此前只试过口音转写和思维链两种窄场景。本文要回答的是这种免训练向量能否推广到转写、情感、描述等多个语音任务,能否单独起作用,能否与提示词叠加,以及是否跨数据集通用。
论文具体要验证的三个问题
论文把大问题拆成三问。第一,语音任务是否以线性方向编码在语音大模型的表示空间里,能否用向量加法诱发,例如不给任何文字指令只加转写向量就让模型转写。第二,这种向量能否作为提示词的补充,提高可控性并降低对提示词措辞的敏感,而不是只在某一句话术下有效。第三,这种方向是否定位在某些层、是否与数据集无关,能否在 LibriSpeech 上提取后用到 CommonVoice 上。为此作者固定用两个指令跟随模型做验证,一个是 Qwen2-Audio-7B-Instruct,另一个是 Phi-4-Multimodal-5.6B-Instruct,只用指令微调版以便自由提示,并用训练集的一小部分提取向量、用官方测试集评价。
从对比指令到推理相加的整体流程
整体流程分两步,提取只做 1 次,推理每次都做。提取时准备同一个小音频池,分别配上目标任务指令和其它任务指令,送入冻结的语音大模型,取某一层最后一个提示词标记的残差激活,分别求平均再相减,得到该层的任务向量。推理时选定一层和一个强度,把该向量加到该层每个解码步的指定位置上,可以只加文字位置,也可以把音频位置一起加。直观理解是先用对比把任务成分提纯出来,再在生成时持续施加一个偏置。
例如同样一段吃饭的音频,加转写向量后模型更倾向于输出逐词稿,而不是总结或翻译。下图展示了左右两部分如何衔接,左边是对比取差,右边是单层全位置相加。
读图时注意上面是提取、下面是推理,音频池、冻结模型和向量符号的对应关系,以及全标记位置包含音频的标注。
看图路径: 1. 先看上面分支:同一音频池如何分别接转写指令和总结指令进入冻结模型;2. 再看中间取平均位置:最后一提示词标记的层激活如何相减得到任务向量;3. 最后看下面推理分支:任务向量在单层加到音频、提示和生成全部位置
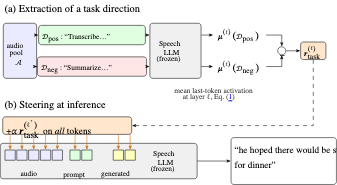
论文图 1。原论文 Figure 1::“Method overview: (a) extraction of a task direction (ASR in this case) from contrasting instructions on the same audio; (b) steering at inference: the direction is added at a…”。
上半部分用同一音频池对比转写与总结两组指令,取每层最后一个标记激活的平均再相减得到任务向量;下半部分在选定层把该向量加到音频、提示和已生成标记上,冻结模型随后生成转写句。图注明确写了在单层加到每个标记且包含音频位置,这与后文比较只加文字位置的实验直接对应。
同一批音频如何相减得到任务方向
提取的关键是控制变量。设模型有 L 个变换块,残差流宽度为 d,输入是 Ta 个音频标记加 Tp 个指令标记。对音频 a 和指令 p,记第 l 层位置 i 的残差激活为 h。作者沿用文本拒答方向的做法,只读指令最后一个标记 i 等于负 1 的位置,认为它汇总了指令语义。对正集求平均得到 mu,对负集同样求平均,两组共用同一个音频池 A,因此声学、说话人和词汇差异在平均中大致抵消,剩下的是指令差异。
两均值相减即任务向量。举例就是同一批朗读分别配请逐词转写和请总结,平均激活之差被当作转写方向。
正指令集 × 负指令集: 正指令集指携带目标任务的文本指令集合,如转写;负指令集指其他任务指令集合,如总结或翻译。二者配同一批音频求平均后相减,目的是让声学、说话人和词内容在平均中抵消,只留下指令带来的任务成分,组合后得到任务向量。
符号与平均过程由下式给出,先对音频和指令双重求平均。
\[\boldsymbol{\mu}^{(\ell)}(\mathcal{D})=\frac{1}{|\mathcal{A}|\,|\mathcal{D}|}\sum_{a\in\mathcal{A}}\;\sum_{p\in\mathcal{D}}\boldsymbol{h}^{(\ell)}_{-1}(a,p),\]相减得到任务方向的定义如下,每层都有一个向量,后续要选层使用。
\[\boldsymbol{r}^{(\ell)}_{\mathrm{task}}=\boldsymbol{\mu}^{(\ell)}(\mathcal{D}_{\mathrm{pos}})-\boldsymbol{\mu}^{(\ell)}(\mathcal{D}_{\mathrm{neg}}).\]这里没有训练,只是前向记录激活并做均值和减法,代价是几十到上 100 条音频的前向计算,优点是不需要标注输出,只需要指令文本和音频配对。
推理时把向量加到哪些位置
推理时的操作是残差平移。在选定层 l 星上,每个被选位置 i 的激活都加上强度 alpha 乘以该层任务向量,alpha 以该向量范数为单位。被选位置集合 P 有两种做法,全位置包含音频、输入文字和已生成文字,只文字位置则不动音频帧。文本模型此前多用全位置,但语音里担心扰动音频会破坏内容,因此论文对比了两种。选层和强度靠小训练池上的网格搜索定目标,自动语音识别看词错误率最低,情感识别看加权准确率最高。有效层集中在中间层 10 到 16 附近,越深的注入经过的归一化越少,小强度即可,过大反而饱和使任务做不出来。
任务向量 × 提示词: 任务向量指残差流空间中代表做某任务的方向,加到激活上直接改变模型行为;提示词指输入的文字指令,靠语言理解引导行为。二者分工不同,前者是向量层面的偏置,后者是语义层面的说明,叠加后既有明确指令又有持续的行为偏置,论文报告多数任务上叠加优于只用提示词。
单向量注入的计算形式如下,理解为每个解码步都持续施加同一偏置。
\[\tilde{\boldsymbol{h}}^{(\ell^{\star})}_{i}=\boldsymbol{h}^{(\ell^{\star})}_{i}+\alpha\,\boldsymbol{r}^{(\ell^{\star})}_{\mathrm{task}},\qquad i\in\mathcal{P},\]实际运行时全位置在转写上明显更好,说明在选对向量和强度的条件下,移动音频激活并没有洗掉声学语义,反而更强地诱发了任务行为,这是后文表格要量化的关键对照。
转写向量如何与文字向量一起管字母表
非拉丁语转写有个特殊麻烦,内容对了但字母写错,例如俄语用拉丁字母写出,词错率和字符错误率仍会判错。作者用同样加法再引入一个脚本归一化向量。该向量完全从文本得到,让模型把英文句译成目标语言并给出目标字母表示,用 30 个句子提取,不需要语音数据。推理时两个向量同时加,各自只在自己选定的层非零,转写强度先由任务网格搜索固定,再第二次搜索脚本向量的层和强度 beta。这种线性叠加成立的前提是两方向近似正交,实践中在部分语言上确实同时改善了任务和文字。
转录向量 × 脚本归一化向量: 转录向量指从转写对比中提取的任务方向,负责让模型做逐词转写;脚本归一化向量指从英文到目标文字翻译中提取的方向,负责把输出字母表压向目标文字。二者加在各自选定的层上同时注入,一个管任务,一个管文字,组合后在保持语义的同时减少拉丁字母代替阿拉伯或西里尔字母的情况。
双向量叠加的写法如下,h 收集同一位置所有层的残差流,每个方向只在对应层起作用。
\[\tilde{\boldsymbol{h}}_{i}=\boldsymbol{h}_{i}+\alpha\,\boldsymbol{r}_{\mathrm{task}}+\beta\,\boldsymbol{r}_{\mathrm{script}},\]教学上可以这样想,转写向量负责让模型进入逐词听写状态,脚本向量负责把输出字符表压向阿拉伯、西里尔或天城体,二者各管一层,相加后 1 次前向同时生效。
没有训练时参数如何处理与如何选点
本研究没有更新主模型权重,语音编码器和语言主干全程冻结。所谓构造过程就是前向取激活、求平均、相减得到向量,再在小训练池上网格搜索层和强度。自动语音识别用 LibriSpeech 训练集取 50 条,加上 CommonVoice 英法阿印俄各 50 条共 300 条提取转写方向;情感用 IEMOCAP 按留 1 会话交叉验证、每训练会话取 50 条;描述用 AudioCaps 随机 100 条。
脚本向量用 30 个文本翻译句。为对比,作者另做低秩适配器微调,只训注意力投影,秩 16,缩放 32,丢弃 0.05,用同样少量音频加早停,且只喂音频不给提示词。结果上微调数据太少时过拟合明显,在 LibriSpeech 上未必优于提示词,这恰好说明免训练向量在低资源下的价值,但也不能反推微调无用。
网格搜索 × LoRA 微调: 网格搜索指在小训练池上遍历层和强度选最优注入点,不改权重;LoRA 微调指只训练注意力投影上的低秩适配器,需要梯度更新和早停。二者都是用同样少量音频找任务适配,但前者是推理时加向量,后者是改参数,对比说明免训练向量在极少数据下可作为替代或补充。
复现时注意冻结意味着输出仍是自回归采样,不因无训练而确定;网格选出的最优点是事后最优,部署时换数据可能偏移,需要重新小规模验证。
数据划分、提示词平均与指标方向
评价严格用官方测试集,向量来自训练集,避免测泄漏。自动语音识别在 LibriSpeech 报词错误率,在 CommonVoice 英法阿印俄报字符错误率,都是越低越好。情感在 IEMOCAP 报加权准确率,越高越好,提示词中给出 4 个候选情感。描述在 AudioCaps 报 CIDEr 和 ROUGE-1,前者算带逆文档加权的 n 元重叠、压制套话,后者算单字重叠,都是越高越好。为减少提示词波动,所有带提示词的结果都是 3 个措辞的平均,非拉丁转写还会在提示词里写明目标文字,例如要求用西里尔字母逐词转写且只输出转写。基线包括只提示词、只转向、提示词加转向,以及同数据低秩微调,后者标灰以表明本文焦点仍是免训练方法。
词错误率 × 字符错误率: 词错误率指按词计算的转写错误比例,用于英文 LibriSpeech;字符错误率指按字符计算的错误比例,用于多语言 CommonVoice。二者都是越低越好,分工是适配不同语言的切分粒度,组合使用才能同时反映英文长句和阿拉伯、印地、俄语等文字的转写质量。
聚合方式要看清,LibriSpeech 常对 4 个子集取均值,CommonVoice 对五语言取均值,跨提示词还报告均值加减标准差,不能把不同聚合的数字直接比大小。
向量加到音频位置是否真的有帮助
第一个要回答的是扰动音频会不会破坏内容。作者在 Qwen2-Audio 上固定任务向量,只改变注入范围,比较只加文字位置与文字加音频一起加。LibriSpeech 取 4 个子集词错误率的均值,CommonVoice 取五语言字符错误率的均值,方向都是越低越好。结果是一起加明显更好,论文给出相对改善数字,说明声学内容基本保留且任务诱发更强,Phi 模型上趋势相同。这个对照的代价是每次解码都要多 1 次向量加法,但相对前向计算可忽略;限制是它只证明在选对层和强度时成立,强度过大仍会饱和。
下表整理该对照的比较问题、公平条件与原文报告的相对收益,基线是只加文字位置,本方法是文字加音频一起加。
| 比较条件 | 被比较策略 | 本方法策略 | LibriSpeech 相对改善 | CommonVoice 相对改善 |
|---|---|---|---|---|
| 同一任务向量同层同强度 | 只加文字位置 | 文字加音频一起加 | 43.9% | 19.1% |
结果中的 43.9% 与 19.1% 是相对减少,不是百分点下降,也不是绝对错误率。它的适用条件是 Qwen2-Audio 的自动语音识别,且向量与强度已经过小训练池优选。未胜出的只加文字策略并非无用,它在担心音频失真时更保守,只是本实验中诱发任务的强度不足。单独看此表不能推出所有模型和任务都应加音频,需结合主结果与跨域表一起判断。
提示词加转向能否超过只用提示词
主结果比较 4 种做法:只提示词、只转向、提示词加转向、同数据低秩微调。只转向不给文字指令也能诱发任务,在 LibriSpeech 干净集上接近或超过提示词,在 Qwen 描述上也提升明显,但在 CommonVoice 非拉丁语上混杂。更稳定的结论是提示词加转向在 Qwen 全部基准上超过只提示词,在 Phi 除俄语和描述 CIDEr 外也超过只提示词。作者还观察到措辞改善、拒答减少,以及抑制了只转向时转写停不下来、幻觉续写的问题。代价是需要为每任务做 1 次层和强度搜索;限制是非拉丁语仍受模型本身语言支持影响,例如 Phi 在阿拉伯和印地语上较弱。
下表把原文用句子报告的增益集中呈现,指标方向是错误率越低越好,相对改善越高越好,绝对下降单位是百分点。
| 模型 | 数据集与子集 | 报告改善幅度 | 基线对照 | 适用条件限定 |
|---|---|---|---|---|
| Qwen2-Audio | CommonVoice 印地语 | 5.1 | 只提示词 | 提示词加转向,字符错误率绝对下降 |
| Qwen2-Audio | CommonVoice 阿拉伯语 | 6.4 | 只提示词 | 提示词加转向,字符错误率绝对下降 |
| Phi-4-Multimodal | LibriSpeech 测试干净集 | 21.2% | 只提示词 | 提示词加转向,相对改善 |
| Phi-4-Multimodal | LibriSpeech 测试其他集 | 13.6% | 只提示词 | 提示词加转向,相对改善 |
| Phi-4-Multimodal | CommonVoice 法语 | 82.4% | 只提示词 | 提示词加转向,字符错误率相对减少 |
| Phi-4-Multimodal | CommonVoice 英语 | 38.1% | 只提示词 | 提示词加转向,字符错误率相对减少 |
解释时注意百分点与相对百分比不可混淆,5.1 和 6.4 是百分点,21.2% 等是相对比例。表中未列出的阿拉伯和印地语在 Phi 上表现差,说明增益不具普遍性,依赖模型原有语言能力。情感上 Qwen 加权准确率提高约 4.2 个百分点并接近微调,Phi 增益较小,描述上 Qwen 只转向已强,Phi 则不强,这些都是同一结论的边界。
换数据集提取向量还能用吗
为验证方向是否数据集无关,作者把 300 条转写池拆成 LibriSpeech 和 CommonVoice 两部分,分别提取向量再交叉使用,层和强度固定为表 1 所用组合。评价仍用原来定义的 LibriSpeech 词错误率均值和 CommonVoice 字符错误率均值,带提示词时报告三提示词均值加减标准差。结果是跨域与域内差距很小,基本可互换。为证明增益来自任务方向本身,加入无转向和同范数随机向量两个负对照。无提示词时两者都失败,错误率超过 150%,因为没有任务说明;有提示词时任务向量稳定优于只提示词,随机向量反而更差,且任务转向把跨提示词标准差缩小约一半。
下表整理有提示词时的基线、任务向量与随机对照,数值越低越好,箭头表示从基线到方法的移动。
| 评估集 | 只提示词基线 | 加任务向量后 | 随机向量对照 | 跨提示词波动变化 |
|---|---|---|---|---|
| LibriSpeech 词错误率 | 4.18 | 4.18→3.75 | 差于基线 | 标准差缩小约一半 |
| CommonVoice 字符错误率 | 28.6 | 28.6→25.7 | 差于基线 | 标准差缩小约一半 |
该表的限制是层和强度是事后沿用的,若换新领域重新搜索可能更优或更差;随机向量只证明方向特异性,不证明该方向最优。未胜出的随机向量恰好说明不能用任意扰动代替任务向量,也不能把事后最优当部署保证。结合上一节看,跨域可用且降低提示词敏感是本文较强的证据,但仍限于转写任务和这 2 个数据集。
哪些语言和错误仍未解决
论文如实报告了两类失败。只转向无提示词时模型常能写对开头但停不下来,继续幻觉,说明任务向量诱发了转写行为但没有编码音频何时结束;加上提示词后该问题减轻。另一类是非拉丁文字,语义对但字母用拉丁文写,导致错误率虚高,加提示词并写明目标文字仍有此问题。作者因此叠加脚本向量,完全从文本翻译提取,不用语音。效果因语言和模型而异,不是普遍根治。
下表集中呈现原文报告的脚本向量带来的字符错误率绝对下降,数值单位是百分点,基线是提示词加任务转向。
| 模型 | 阿拉伯语下降 | 印地语下降 | 俄语下降 | 限制说明 |
|---|---|---|---|---|
| Qwen2-Audio | 5.4 | 2.5 | 未明显改善 | 部分语言有效,非全部 |
| Phi-4-Multimodal | 停滞 | 1.2 | 29.2 | 俄语主要纠正字母,阿拉伯语未动 |
解释时注意 29.2 个百分点的下降主要来自字母纠正而非内容纠错,不能理解为识别能力跃升。代价是需要第二次搜索脚本向量的层和强度,且要人工核对翻译句义。尚未评测的范围包括更多语种、更多文字混排,以及脚本向量与其他任务向量的正交性,原文只验证了与转写的叠加。自动指标下降也不等于人工可读性同等提升,这点没有测量就不能承诺。
复现第一步做什么与需要多少资源
复现应从转写开始,因为数据和指标最清楚。第一步准备冻结的指令跟随语音模型,确认能自由提示;准备同一小音频池,例如 LibriSpeech 训练集 50 条,配 2 到 3 个转写措辞作正集,配总结和翻译措辞作负集;前向记录选定层最后一个提示词标记的激活,分别平均相减得到各层向量。然后在该小池上网格搜索中间层附近和几个强度,用词错误率选点,注意同时试全位置与只文字位置。
验证时固定层和强度,在官方测试集上用 3 个提示词分别解码再平均,并加入无转向和随机向量对照。资源上主要是前向和解码计算,不需梯度训练;低秩微调对照若要复现,需另准备早停开发集并接受小数据过拟合风险。来源方面,本次未确认作者代码、模型或数据已公开,不得按已开源来写计划,缺的是可直接运行的脚本,不是技术缺陷。
什么时候值得尝试与还缺哪项验证
当只有几十到几 100 条音频、换提示词波动大、又不想为每任务存一套微调权重时,这种对比向量值得一试,尤其转写和情感这类任务诱发明确的场景。复现第一步是按上述小池提取转写向量并做层与强度搜索,先看提示词加转向是否稳定优于只提示词,再看跨提示词标准差是否缩小。还需补的验证是新领域、新语言和新任务上的重新搜索,以及对长音频截断、幻觉续写率的人工抽查,因为现有证据主要来自自动错误率和加权准确率。
关键超参数是注入层、强度和注入范围,信息条件是正负指令文本、同一音频池和 3 个提示词的平均。总体上论文支持任务方向线性编码且可迁移的判断,但所有增益都附带模型、语言和有提示词等条件,脱离这些条件就不成立。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses