📄 按问题选参数:SkillFormer 用技能分组适配器缓解音频多任务干扰
英文题目:SkillFormer: Skill-Decomposed Adaptation for Audio Language Models
标签:#音频问答 | #混合专家模型 | #LoRA | #音频大模型
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Lee Seung-woo:机构信息未在 arXiv HTML 中可靠披露
- Bowen Qi:机构信息未在 arXiv HTML 中可靠披露
- Kim Min-jun:机构信息未在 arXiv HTML 中可靠披露
- Jang Won-young:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
大型音频语言模型用同一套参数回答语音、声音和音乐问题,一个技能簇上的更新常损害另一个技能,论文称之为技能干扰。SkillFormer在音频编码器与语言骨干之间插入6个技能专用低秩适配器(Low-Rank Adaptation, LoRA),由问题条件路由器为每个问题输出稀疏权重,只激活权重最高的2个适配器并加权合并。训练分两段进行,先让每个适配器在各自技能簇上独立 specialization,再在均衡混合数据上联合校准路由器与适配器,避免多任务梯度冲突。相对单LoRA全数据微调和均匀混合多LoRA,新增设计是按问题语义选择参数子集,而不是加深推理或改课程。与已有参数高效方法的区别在于适配器按技能划分且组合权重来自问题文本,同一段音频配不同问题会走不同通路。在Qwen2.5-Omni-7B上,MMSU、MMAU-Pro和MMAR三个基准的平均准确率从59.3%提高到63.4%,提升分布在感知、推理和语义子项。方法增加基座参数的3.2%到3.8%,训练使用4张NVIDIA A100-80G,推理因每次只合并2个适配器而代价不随适配器总数增长,适用范围限于论文所用问答式评测,对开放生成和跨域迁移尚未验证。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
音频语言模型要同时处理多少种技能
刚接触语音、音乐或音频问答的同学,可以先把任务想成听音做题:输入是一段或多段波形加一个自然语言问题,输出是选项或简短答案,问题覆盖音高比较、语速快慢、说话人计数、对话内容、声音事件、乐器与流派、节拍估计、情绪识别等几十种技能。论文要解决的具体困难是把这些技能放在一个模型里一起训练时出现的互相拖累:在声音事件计数上多练一点,情绪识别可能掉点,反之亦然。
评测显示这种干扰不是个别现象,而是横跨开放问答、空间感知和组合推理的普遍情况。对下游应用来说,平均分好看不够,关键子集必须可靠,例如副语言分析只关心韵律和情绪,安全与隐私评估只关心特定语音属性,一旦偏科就会在真正要用的地方失手。
音频语言模型 × 技能干扰: 音频语言模型指能听音频并回答语音、声音、音乐问题的统一模型,技能干扰指一起训练多类问题时一类变好另一类变差的现象,二者搭配点明本文要解决的矛盾:同一个接口要可靠处理几十种能力,而统一更新参数容易顾此失彼,因此需要按技能拆分参数。
已有路线改了学什么和想多深,本文改用哪组参数
按论文的梳理,音频领域的改进大多沿着两条线走。一条是改模型学什么:课程设计、奖励塑形、自我改进、工具库构造可验证问答,让训练数据更有针对性。另一条是改模型想多深:循环隐变量推理、增加推理步数,让同一组参数算得更久。还有大家熟悉的通用手段:共享主干的多任务学习、稀疏混合专家、LoRA 这类低秩适配器、AdaLoRA 和前缀微调,让大模型在 7B 量级也能低成本特化。但论文指出,音频问答缺的是第 3 个维度:面对具体问题时激活哪组参数。
SkillFormer 就补这一块,不换音频编码器也不换语言主干,只在两者之间加一排小适配器,再学一个按问题选权重的路由器。作者也提到,结构化推理和序列预测中按任务路由已被验证有效,语音建模、空间感知和声学分析的多样性正好适合把这种思想搬到音频理解。
为什么统一微调容易顾此失彼
可以把一次多任务梯度更新想成多只手同时拽同一根绳子:韵律题希望某组权重往 1 个方向走,音乐题希望往另一个方向走,合在一起的平均梯度可能谁的需求都没满足。论文把这称为梯度冲突,联合优化时在一个技能上的增益会被另一个技能的更新抹掉。教学例子:同一段双人对话录音,问题 A 问说的是哪种语言,问题 B 问第二个说话人音高是否高于第一个,如果只看音频就走同一条通路,模型被迫用同一组修正去应付语言辨识和音高比较,很容易折中成两头不讨好。SkillFormer 的假设是语义上不同的技能值得用不同的参数,关键是让问题参与选择,而不是只看音频。
SkillFormer 的整体流程是什么
读图说明:下面这张结构图是全文的方法总览,建议先看从左到右的主数据流,再看从下往上的控制流,最后看两者在合并点的交汇,理解谁提供特征、谁提供权重。
看图路径: 1. 沿波形到音频编码器再到适配器组的横向主路径看特征走向;2. 看问题到路由器的下路如何输出权重并与上路汇合;3. 对比各适配器并联与合并后送入语言模型的位置
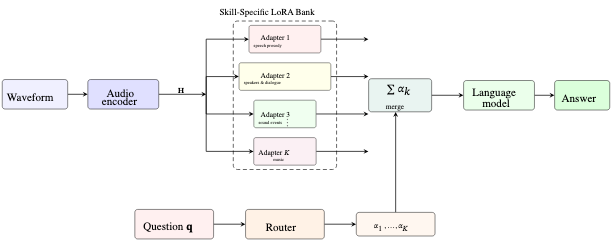
论文图 1。原论文 Figure 1::“SkillFormer routes audio features through a bank of K skill-specific LoRA adapters.”。
流程可以按一个样本走一遍。波形先经过冻结的音频编码器得到特征序列,记作 H,同时问题文本送入路由器。路由器把问题编码成一个向量,经过两层网络输出 6 个权重,默认只保留最大的 2 个,其余置零。6 个技能适配器并排放在编码器之后,各自对 H 做一次低秩修正,得到各自的增量。最后按路由器权重把这些增量加权求和,加回 H,送入语言模型生成答案。
训练时编码器始终不动,适配器先各自专精再联合校准,推理时稀疏选 2 个,因此计算量不随适配器总数线性增长。直观比喻只是帮助记忆位置关系:适配器像按科室分开的会诊意见,路由器像分诊台按问题单决定请哪两个科室、各自听多少,真正的依据还是后面的权重分布和消融对照。
每块技能适配器对音频特征做了什么变换
每块适配器处理的对象都是编码器输出的特征矩阵 H,形状是帧数乘以特征维数。适配器不直接改 H,而是学一个小的修正量。做法是让 H 先乘一个瘦矩阵 B 把维度压到很小的秩 r,再乘一个矩阵 A 把维度升回去,得到该适配器建议的增量。原文所有适配器共享同样的秩和维度,只是个自权重不同,例如第 1 块可能偏向音高和语速,第 3 块偏向声音事件。初始化很关键:B 按小方差正态分布随机初始化,A 初始化为零,这样训练开始前增量为零,基模型行为被完整保留。
训练时在 B 和 A 之间加 0.05 的丢弃,防止对特定维度过拟合。各适配器互相并联,输出在进入语言模型前才合并,因此增加或减少块数不需要动主干。
\[\Delta\mathbf{H}_{k}=\mathbf{H}\,\mathbf{B}_{k}\,\mathbf{A}_{k},\qquad\mathbf{B}_{k}\in\mathbb{R}^{d\times r},\;\mathbf{A}_{k}\in\mathbb{R}^{r\times d},\]上式就是第 k 块的增量计算,B 和 A 的形状决定了参数量很小,r 远小于特征维数 d。r 取 16 是默认设置,后面消融会说明改成 8 或 32 的影响。
技能专用低秩适配器 × 问题条件路由器: 技能专用低秩适配器是放在音频特征之后的小幅修正模块,每块只学一类技能的变换,问题条件路由器是看问题文本决定每块用多少权重的门控网络,二者分工是适配器存技能知识、路由器按题分配,组合后同一段音频配不同问题可以走不同参数路径。
路由器如何只看问题就决定用哪两块
路由器的输入是问题词元的向量序列,先做平均池化压成一个问题向量,再过两层感知机加激活函数得到 6 维打分,最后做只保留前 2 名的稀疏归一化,得到权重向量。稀疏的直接好处是每次只算权重非零的适配器,推理代价与总数解耦。为什么只看问题不看音频,论文给了明确理由:同一段音频配不同问题应该走不同路径,如果只看音频,语言辨识题和音高比较题会被迫同路。实现上路由器很轻,只是两个矩阵加偏置,但消融显示它的选择有真实信号,随机选反而比均匀融合更差。
\[\boldsymbol{\alpha}=\operatorname{Top\text{-}n\text{-}Softmax}\!\bigl(\mathbf{W}_{2}\,\operatorname{GELU}(\mathbf{W}_{1}\,\bar{\mathbf{q}}+\mathbf{b}_{1})+\mathbf{b}_{2}\bigr),\]上式是路由器从平均问题向量到稀疏权重的计算,n 在全部实验中固定为 2。得到权重后,合并方式是把各块增量按权重加权求和,再与原始特征相加。
\[\Delta\mathbf{H}=\sum_{k=1}^{K}\alpha_{k}\,\Delta\mathbf{H}_{k},\qquad\hat{\mathbf{H}}=\mathbf{H}+\Delta\mathbf{H},\]上式前半是加权合并,后半是残差相加,合并后的特征才送入语言主干。这种残差形式保证即使路由权重很小,原始音频信息也不会丢失。
技能分组从哪里来,两阶段训练各更新谁
6 个技能分组不是人工手写规则,而是训练前用语言模型自己的分词器把每个训练问题嵌成向量,再做 k 均值聚类得到。在本实验中 6 组大致对应语音韵律、说话人与对话、语音内容、声音事件、音乐和多片段场景,这与 EvoAudio 工具库的问题分类相吻合。每组数据决定哪块适配器在专精阶段看什么。训练数据是来自该工具库的 50,000 条可验证问答,覆盖 LibriSpeech、FSD50K、AudioSet、MELD 以及合成语音与混音工具生成的数据,专精阶段每块大约分到总数除以 6 的数据,校准阶段用全部 50,000 条的均衡采样。
交替 schedule 分两段:A 段每块练 500 步,只更新自己那块,其他适配器和路由器冻结,编码器和语言模型也冻结,学习率 5 乘 10 的负 5 次方加余弦衰减;B 段练 2000 步,路由器和全部适配器一起在混合数据上学,学习率降到 1 乘 10 的负 5 次方,此时语言模型参数解冻参与更新。整个流程只跑一次 A 再跑一次 B。硬件是 4 张 80G 显存的 A100,每卡批量 2,梯度累积 4 步。
技能聚类 × 交替训练: 技能聚类是先把训练问题按文本嵌入分成 6 组,决定每块适配器看哪些数据,交替训练是先让每块在自己组内专精、再联合校准路由器,二者搭配的意义是先隔离梯度避免互相冲刷,再学组合方式,让分工在组合阶段仍能保留。
在哪些模型和基准上测,比较条件是否公平
评测用了 3 个结构不同的 7B 级模型:Qwen2.5-Omni-7B、Kimi-Audio-7B-Instruct 和 MiMo-Audio-7B-Instruct,编码器家族覆盖基于 Whisper、自监督和卷积增强变体,语言主干分别源自 Qwen2、LLaMA 和 DeepSeek,这样可以检验方法是否依赖特定结构。基准是 MMSU、MMAU-Pro 和 MMAR,MMAU-Pro 用与前人相同的封闭非空间子集,无效预测按错误计。比较的基线条件一致:Base 是官方发布权重;SFT 是单块秩 16 适配器在全部数据上训;Multi-LoRA 是 6 块全开但权重固定均匀、无路由器。
SkillFormer 是完整方法,6 块加问题路由。MiMo 只报告 Base 和 SkillFormer。适配器秩 16、6 块、前 2 路由,额外参数占基模型的 3.2% 到 3.8%。平均分是 3 个基准各自总分再平均,MMAU-Pro 的语音、声音、音乐三列没有覆盖全部计分题,所以总分不是三列的平均,这点在读表时要留意,避免自己加权验算。
平均分提高了多少,增益是否只集中在一类题
先看平均准确率的总体结论。下表整理 3 个骨干上的平均提升,评价范围是 3 个基准总分的平均,指标越大越好,比较条件是同数据、同训练步数预算下的不同参数组织方式。表前说明比较问题:同样的数据能不能靠拆分参数和按题选择获得额外增益,公平条件是基线与方法共享同一批 50,000 条训练数据。
| 骨干模型 | 评价范围 | 指标 | 平均提升 | 原文结论 |
|---|---|---|---|---|
| Qwen2.5-Omni-7B | MMSU、MMAU-Pro、MMAR | 平均准确率 | 4.1 points | 最高平均 |
| Kimi-Audio-7B-Instruct | MMSU、MMAU-Pro、MMAR | 平均准确率 | 3.8 points | 最高平均 |
| MiMo-Audio-7B-Instruct | MMSU、MMAU-Pro、MMAR | 平均准确率 | 2.4 points | 最高平均 |
3 条线的提升分别是 4.1、3.8 和 2.4 个百分点,注意这是百分点差值,不是相对百分比。论文强调增益分散在感知、推理和语义子类,而不是只刷某一轴,例如 Qwen 上 12 个子类全部上升。限制是这仍是同分布基准上的准确率比较,没有报告延迟、误判率或人工评价,不能直接推出部署体验。未胜出项也要看到:单适配器微调本身已有 1.3 到 1.5 个点的增益,说明一部分提升来自多看了这批数据,而路由是在此基础上的进一步增益。
单一低秩微调 × 多适配器均匀融合 × 路由加权融合: 单一低秩微调指只用一块适配器学全部数据,多适配器均匀融合指放 6 块但权重固定相等,路由加权融合指由问题决定每块权重,三者构成递进对照:从有无容量、到有无分工、再到有无按题选择,从而分离出路由带来的增益。
路由器真的学会了分工吗
读图说明:下面是 Qwen 上按问题类型统计的平均路由器权重,每组条形是六块适配器的权重分配,重点看韵律与音乐是否集中、场景是否分散,不要硬读图中辨不清的具体小数,关键比例以正文报告的数字为准。
看图路径: 1. 先看横轴六类问题与纵轴平均路由器权重的含义;2. 比较韵律和音乐条形是否集中在单一颜色段;3. 看场景类条形是否比其他条形更分散
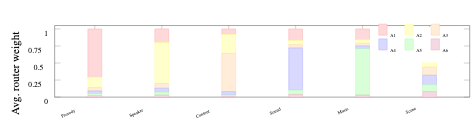
论文图 2。原论文 Figure 2::“Router weight distribution by question type on Qwen2.5-Omni-7B.”。
图后解释:可见的分工是韵律题约 71% 权重给第 1 块,音乐题约 68% 给第 5 块,声音事件题约 62% 给第 4 块,内容与说话人题也有偏向但没那么极端,这符合两者都涉及语音理解、共用基础较多。多片段场景题最分散,需要跨模态拼信息。重要的是这种对齐没有人工监督,分组只来自问题嵌入聚类,路由器独立学出了匹配关系,支持了语义不同值得参数不同的假设。但这只是相关性证据:权重集中不等于因果上必须用这块,真正的因果证据要看消融中去掉路由器掉 1.7 个点、随机路由掉 2.5 个点。
感知 × 推理 × 语义: 感知指听出音高、事件、语种等声学属性,推理指比较、计数、跨片段关联,语义指语言内容与世界知识,三者是评测划分的不同能力轴,本文强调增益分散在三轴而不是只刷某一轴,用来检验是否真正缓解了偏科式的干扰。
哪些子类涨得多,弱项有没有被拉起来
下表聚焦论文点名的关键数字,比较问题是增益是否来自强项刷分还是弱项补齐,指标方向都是准确率越高越好。MMAU-Pro 的语音、声音、音乐需要不同感知能力,适合检验按题分流的价值;Qwen 与 Kimi 的两组数字来自正文点名,不是全表复述。
| 骨干与范围 | 关注子集 | 基线 | 方法 | 提升 |
|---|---|---|---|---|
| Qwen2.5-Omni MMAU-Pro All | 全部 | Base | 60.4 | up 4.0 |
| Kimi-Audio MMAU-Pro All | 全部 | 49.6 | 53.6 | 4.0 points |
| Kimi-Audio sound | 声音 | 37.1 | 改善 | 5.7 points |
| Qwen 十二子类区间 | 语义到感知 | 1.7 MMAR 语义 | 8.0 MMSU 感知 | 分散增益 |
Qwen 的 MMAU-Pro 总分到 60.4,比 Base 高 4.0,是该骨干单基准最大涨幅;Kimi 的 MMAU-Pro 总分从 49.6 到 53.6 同样涨 4.0,而起点最低的声音子类从 37.1 起涨了 5.7,是全篇点名的单子类最大涨幅,说明弱项确实被拉动。十二子类区间从 1.7 到 8.0 也支持增益分散。限制是这些是点估计,没有报告方差或显著性,且 MMAU-Pro 总分与三列的关系已声明不是简单平均,读数时不要自行平均验证。尚未评测的范围包括开放式生成质量和空间问答,这些不在本次封闭子集内。
拿掉路由器、打乱路由或一起训练会掉多少
下表整理 Qwen 上的消融代价,比较问题是每个设计选择的独立贡献,指标是 3 基准平均准确率,基线平均 59.3%。每行只改一处,其余保持 6 块、前 2 路由与交替训练不变,数值是平均分的变化量,负号表示下降。
| 改动 | 平均分变化 | 含义 | 参数与计算 | 适用条件 |
|---|---|---|---|---|
| No router 均匀融合 | costs 1.7 points | 路由最有价值 | 同样 6 块 | 需按题选择 |
| No alternating schedule | drops 2.3 points | 需先专精后组合 | 同样数据 | 避免梯度冲突 |
| r 16 到 8 | costs 0.3 points Avg. 63.1 | 秩不敏感 | 省内存 | 资源紧可降秩 |
| r 32 | adds 0.1 Avg. 63.5 | 增益小 | 费内存 | 一般不值得 |
去掉路由器只剩均匀融合掉 1.7 个点,是单项最大代价;随机路由掉 2.5 个点,说明不是参数量多就好;不做交替、从头联合训练掉 2.3 个点,几乎与路由同等重要,支持先隔离再组合的说法。秩从 16 降到 8 只掉 0.3,升到 32 只涨 0.1,说明容量不是瓶颈。前 2 优于前 1 和全稠密,6 组优于 3 组和 12 组,分别对应融合太多会稀释、分组太粗会挤占、太细会每组数据不足。限制是这些消融只在 Qwen 上做,是否搬到另两个骨干同样成立还需要补验证。
结论在什么条件下才成立,还有哪些没测
先划清已验证的范围:提升是在同一批 50,000 条 EvoAudio 可验证问答上训练后,在 MMSU、MMAU-Pro 封闭非空间子集和 MMAR 上的准确率比较,3 个 7B 骨干一致向好,但数值只在该数据与评测组合下成立,换数据、换开放问答或空间题不能直接套用。训练只跑一次 A 加一次 B,没有报告多次随机的波动,2 到 4 个点的差值是否每次都稳,需要方差或交叉验证来补。成本只给了参数占比 3.2% 到 3.8% 和 A100 训练配置,没有报告推理延迟、吞吐或显存峰值,不能承诺更快更省。
语言模型在 B 段解冻意味着一部分增益可能来自主干继续适配,而不全是路由结构,论文没有单独分离这一项。容易误解的是 6 个聚类等于人工定义的 6 种能力,实际上聚类来自问题嵌入,名称只是事后对齐的直观标签;另一个误解是权重集中等于模型懂了技能边界,它只是统计上的偏好,跨技能共享仍然存在,尤其内容与说话人题就不那么稀疏。
复现第一步做什么,需要哪些信息条件
复现不要先调参,先把信息条件对齐:拿到 3 个骨干的发布权重,拿到同一批 50,000 条训练问答及其来源划分,确认 MMSU、MMAU-Pro 封闭子集和 MMAR 的评测脚本与无效预测计错规则。第一步建议在 Qwen2.5-Omni-7B 上复刻最小闭环:冻结编码器,按问题嵌入做 6 类聚类,每类训一块秩 16 适配器各 500 步,再用混合数据联合训路由器与适配器 2000 步,同时在 B 段解冻语言模型,学习率分别用 5 乘 10 的负 5 次方和 1 乘 10 的负 5 次方。关键超参数记全:K 为 6、前 2 路由、丢弃 0.05、B 零初始化 A、每卡批量 2 累积 4 步。
核对点是 Base 平均 59.3% 能否复现,再看均匀融合与路由的 1.7 个点差距是否存在。关于资源可用性,本次没有发现来源绑定且完成验证的代码、模型或数据链接,因此不能说作者资源已公开或可下载,需要按论文描述自建流程。
什么时候值得尝试,还要补哪项验证
什么时候值得尝试:如果你的音频问答同时覆盖语音、声音和音乐,且已观察到单任务微调互相拖累,又不想动编码器和主干,可以试这种小适配器加问题路由,尤其问题文本本身能区分技能时收益更明确;如果任务全是同一类技能,或问题文本信息很弱,路由可能分不出路,预期增益会小。复现第一步如上一节,先在单骨干上跑通聚类加 2 阶段流程。
还需要补的验证:多次随机种子下的方差、另两个骨干上的完整消融、推理延迟与显存的实测,以及开放式回答的人工评价,避免把封闭选项准确率直接当成体验提升。长远看,论文结尾指出的方向是把技能分解与更丰富的自改进课程、自适应推理深度结合,一个管用哪组参数,一个管学什么、想多深,三者正交互补,但这在本篇还没有实验,需要后续工作来证明。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses