📄 把 Kokoro 单音色蒸馏到 8M 参数:Paradee 如何分半训练与修复嗡嗡声
英文题目:Paradee: Distilling Kokoro-82M into an 8M-Parameter Single-Voice Text-to-Speech Model
标签:#文本到语音 | #知识蒸馏 | #生成对抗网络 | #模型量化 | #实时处理
评分:6.5/10 | 创新 1.2/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 0.8/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Sahil Mahendrakar:机构信息未在 arXiv HTML 中可靠披露
📌 核心摘要
Kokoro面向多音色通用合成而体积与算量偏大,设备端单音色场景只需固定读出af_heart,如何在保留自然度前提下大幅压缩并让蒸馏与运行都落在笔记本上是本文难点。教师先合成英语朗读语料并保存每句时长基频能量与音素特征及对应波形,这些保存量同时作为两半学生的训练目标。文本侧学生读取音素并学习预测教师保存的时长基频能量与音素特征,解码器学生则以教师保存的中间量为输入先经频谱损失再经对抗训练学习重建教师波形。两半连接后不再联合训练,也无需学习对齐,最后对权重做整数量化,并以免训练的锁相滤波修正浊音段残留嗡鸣声。与已有做法的关键差异是两侧分别蒸馏且监督音素特征,同时给出参数与算量分布及量化敏感性分析并定位嗡鸣声频带与相位来源。在200句保留测试平均的fp32条件下以UTMOS为指标比较自然度,Paradee为4.41,低于教师的4.52。在同一200句保留测试上经单CPU线程PyTorch计时以实时倍速为指标比较运行速度,Paradee为25.0倍,高于教师的7.6倍,整数量化后文件为8.45MB,训练在单台MacBook Pro上完成,结论仅适用于单英语音色与相近朗读文本。
🔗 开源与复现资源
本次未形成可展示的已核验资源记录,开放状态尚未核实。
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
这篇论文要解决什么设备端语音合成问题
论文研究的是只用一个声音的设备端英语文本转语音。输入是音素序列,目标是在一块普通笔记本电脑中央处理器上快速生成自然语音,输出是 24 kHz 采样率的波形。必须保留的信息包括说什么内容、每个音素的时长、每帧的音高与能量,以及说话人听起来是同一个声音。教师模型是 Kokoro-82M,它有 54 个声音,论文只取其中 af_heart 这一个声音做蒸馏。教师总参数按 PyTorch 统计为 81.8M,每秒音频需要 55 GFLOP 计算量,体积和算力都不适合直接装进小设备。
学生 Paradee 的目标是 8.07M 参数、每秒音频约 3.4 GFLOP,int8 存储约 8.45 MB,单中央处理器线程达到 25 倍实时,UTMOS 自然度接近教师。理解这个任务时要抓住单音色这个前提,所有训练语料、风格向量处理和评测都只围绕 af_heart 展开,换声音或换语言的效果论文没有训练也没有验证。
Kokoro 的结构来源与已有压缩路线有何不同
Kokoro 沿用 StyleTTS 2 的设计思路。文本先转成音素,文本侧用音素级 BERT 结构读取音素,韵律预测器给出每个音素的时长、基频轮廓和能量轮廓,另有一个文本编码器输出描述每个音素发音的音素特征。解码器先用带自适应实例归一化的残差卷积块融合音素特征与韵律,再用基于 HiFi-GAN 的 iSTFTNet 波形生成器输出波形,生成器还额外输入由预测基频构造的正弦谐波激励,包含基频及其前 8 个泛音。
已有压缩路线包括 FastSpeech 用自回归教师提供时长并监督输出,LightSpeech 先剖析再压缩,Nix-TTS 把 VITS 按模块蒸馏到 5.23M 参数,sanoTTS 把 Piper 的 VITS 声音蒸馏到 2M 参数以下用于微控制器。Kokoro-7M-Distill 是同期未发表的同类工作,同样是 Kokoro-82M 的单音色英语小模型,用教师时长、变窄解码器、多分辨率频谱与对数梅尔损失、多周期与多分辨率判别器,并加 WavLM 特征匹配。Paradee 与它们在相同输入输出和单音色任务上可比,区别在于论文明确监督教师内部的基频、能量和音素特征,并把文本侧与解码器分开训练后直接拼接,不做联合训练。
论文还报告了教师的参数计算量普查、量化敏感性和嗡嗡声定位,这些是其他小模型工作没有覆盖的分析。
为什么只保留一个声音就能大幅缩小模型
多声音模型需要用风格向量区分 54 个声音,还要处理不同声音随句子长度变化的风格偏移。论文把问题限定为只说 af_heart,因此学生两侧都去掉风格输入,改用一个可学习的常量向量,学生只需从训练数据中学到该声音随长度的变化规律。另一个可压缩的依据是教师内部存在冗余。论文测得教师 512 通道音素特征中约 190 维就占 90% 方差,430 维占 99% 方差,说明文本特征通道可以大幅收窄。
计算量方面,波形生成器只占约 1/4 参数却占 89% 计算量,因为其末级卷积运行在 60 倍帧率的采样率上。也就是说,参数总量决定文件大小,生成器的每采样点卷积决定中央处理器速度,压缩必须重点缩小生成器。论文的解决思路因此是整体保持 Kokoro 代码结构但大幅收窄宽度,文本侧与解码器各自向冻结教师对齐,推理时不再需要教师。
两半分别蒸馏再直连的总体流程是什么
总体流程分 4 步。第一步用冻结教师合成 12000 句来自 WikiText-103 的英语句子,共 23.9 小时音频,保存每句的音素、预测时长、基频与能量轮廓、音素特征和波形,约 6.9 GB,前 200 句留作评测。第二步训练小的文本侧,输入音素,在给定教师时长做教师强制的条件下预测教师的对数时长、基频、能量和音素特征。第三步训练小的解码器,输入教师保存的音素特征、基频和能量,目标是复现教师保存的波形,先只用频谱损失训练,再加入对抗训练。
第 4 步把学生文本侧的输出直接接到学生解码器的输入,之后不做联合再训练,最后把权重矩阵按输出通道量化到 int8。推理时文本侧读入音素并预测每个音素时长,把音素特征按时长拉伸到每音频帧一个,再预测每帧基频与能量,解码器据此生成音频。下图展示了教师上下两半与学生上下两半的对应关系,以及虚线表示的分别监督。
下面这张示意图把教师与学生的两半结构、参数规模与监督方向画在同一张图上,适合对照阅读。
看图路径: 1. 沿上方教师箭头看音素到时长基频能量特征再到音频的主路径;2. 对比下方学生两半的参数标注与虚线监督来源;3. 确认推理时学生两半直连且不再需要教师
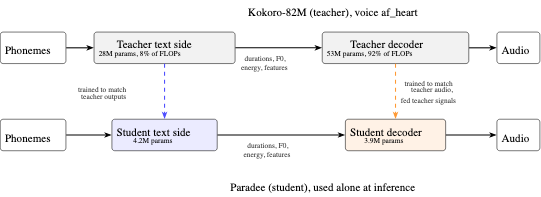
论文图 1。原论文 Figure 1::“Kokoro’s two halves (top) and Paradee’s (bottom).”。
上半是教师从音素经文本侧到时长基频能量特征再经解码器到音频的路径,下半是学生文本侧与学生解码器各自向冻结教师对齐的路径。学生文本侧标注约 4.2M 参数,学生解码器标注约 3.85M 参数,推理时两段学生模块直连,虚线监督在推理阶段不再出现。
文本侧与解码器各自变窄后保留了什么
学生文本侧共 4.23M 参数,包含隐层 256、6 层、4 头的 ALBERT,以及 192 通道 3 层的韵律预测器与文本编码器,另用两层多层感知机把 192 通道文本特征投影到解码器需要的 512 通道。论文还试过线性投影的 4.0M 版本和更宽的 7.1M 版本,用于检验投影方式与容量的影响。学生解码器共 3.85M 参数,保持 Kokoro 布局,把解码器自适应实例归一化块从 1024 通道缩到 256 通道,生成器从 512 通道缩到 128 通道,保留上采样倍数、卷积核尺寸 3、7、11、激励模块和逆短时傅里叶变换头。整个解码器每秒音频需 3.36 GFLOP,比教师解码器少约 15 倍,其中生成器占 1.19M 参数。这样的变窄保留了每一学生层都有教师对应层可学,但把计算最重的生成器压到原来的零头。
音素时长 × 基频与能量轮廓: 音素时长决定每个音素占多少音频帧,用于把按音素排列的特征拉伸到按帧排列;基频与能量轮廓则描述每一帧的音高和响度变化。两者分工是时长管对齐拉伸,基频与能量管逐帧韵律,组合后解码器才能知道每一帧该发什么音、用什么音高能量去发。
音素特征 × 波形生成器: 音素特征是文本编码器输出的描述每个音素发音内容的向量,通道数在教师为 512;波形生成器是解码器末端把帧级表示变成 24 kHz 波形的卷积与逆短时傅里叶变换堆叠。两者搭配的意义是前者提供说什么,后者负责把说什么加上韵律条件高效地渲染成采样点。
两半分别用什么目标训练,判别器何时介入
文本侧训练读取音素,在给定教师时长下用 L1 损失预测教师的对数时长、基频、能量和音素特征,训练 8000 步,批量 32,用 AdamW,学习率 5×10⁻⁴。解码器训练输入教师自己的音素特征、基频和能量,在 1.6 秒片段上复现教师波形。第一阶段只用频谱损失 50000 步,批量 16,学习率 2×10⁻⁴,包括对数梅尔 L1 损失和多分辨率短时傅里叶损失,后者在傅里叶点数 512、1024 和 2048 下比较普通频谱,这类损失比较各频率随时间的响度但忽略相位。第二阶段加入 HiFi-GAN 风格对抗训练,小判别器网络学习区分学生音频与教师音频,学生学习骗过它们。
判别器采用周期 2、3、5、7、11 的多周期判别器和多分辨率频谱判别器,共 3.2M 参数,用最小二乘生成对抗损失和特征匹配,批量 8。论文先跑 5000 步把频谱损失权重设为对抗损失的 10 倍,再跑 5000 步降到 3 倍。组装后不做联合训练,直接连接。相位锁定滤波在合成后执行,不参与训练且无参数。
对数梅尔频谱损失 × 多分辨率短时傅里叶损失: 对数梅尔频谱损失在符合人耳听觉的梅尔频率尺度上比较响度,关注整体音色平衡;多分辨率短时傅里叶损失在 512、1024 和 2048 三种傅里叶点数下比较普通频谱,兼顾时间与频率分辨率。两者都是只看幅度不看相位的频谱损失,组合后让解码器第一阶段先把响度随时间频率的分布学对。
多周期判别器 × 多分辨率频谱判别器: 多周期判别器在周期 2、3、5、7 和 11 上看波形,擅长发现周期性浊音的谐波结构问题;多分辨率频谱判别器看频谱幅度,擅长发现频段级的不自然纹理。两者都是第二阶段与学生对抗的小网络,分工覆盖时域周期与频域纹理,组合后迫使学生输出在听感上更接近教师录音。
用什么指标、数据划分和硬件测速度与质量
评测用 200 句 held-out 句子。动态时间规整对数梅尔距离比较与教师的频谱差异,做法是对均方根归一化后的对数梅尔频谱做动态时间规整对齐后取平均绝对差,时快时慢不单独扣分,适合教师强制比较,但自由运行学生的合理韵律差异会使其饱和,论文指出仅 3% 语速变化就能得到 0.36。UTMOS 用 utmos22_strong 检查点预测听众会给的 1 到 5 分自然度平均意见分,是自由运行学生的主要比较指标,教师均值 95% 置信区间为正负 0.003,学生为正负 0.01 到正负 0.04。词错率由 Whisper base 转写后与原文比较得到,衡量可懂度。
说话人相似度是 Resemblyzer 说话人嵌入在同句教师与系统输出之间的余弦相似度。速度在同一台 Apple M4 Pro 上单中央处理器线程测 8 句约 61 秒音频,不含字形到音素转换。训练也在同一台 24 GB MacBook Pro 上用 MPS 后端完成。
动态时间规整对数梅尔距离 × UTMOS: 动态时间规整对数梅尔距离先用动态时间规整把两段音频局部拉伸对齐再比较频谱,适合固定时序的教师强制比较,但对自由运行的合理变速会饱和;UTMOS 是在人类评分上训练的神经网络,预测 1 到 5 分的自然度平均意见分,用作自由运行学生的直接比较。两者搭配是前者诊断贴近教师的程度,后者评价独立听感。
教师的参数与计算量集中在哪里
在动手压缩前,论文先普查 Kokoro-82M v1.0 用 af_heart 声音时的分布。参数上解码器自适应实例归一化编码解码块占 33.6M 约 41%,iSTFTNet 生成器占 19.7M 约 24%,文本编码器与韵律预测器的长短期记忆网络占 11.2M 约 14%,ALBERT 及其输出投影占 6.7M 约 8%,基频能量时长头占 6.6M 约 8%,文本编码器卷积与音素嵌入占 4.0M 约 5%,合计 81.8M。计算量上生成器占每秒音频 55 GFLOP 中的 89%,文本侧不足 10%。这说明文件大小由各部分参数分摊,运行时长主要由生成器末级高帧率卷积决定。下图直观对比了三部分的参数占比与计算量占比的错位。
下图用并排柱状对比文本侧、解码器 AdaIN 块和生成器的参数份额与计算量份额,是理解为何必须压缩生成器的关键证据。
看图路径: 1. 比较文本侧、解码器 AdaIN 块和生成器三组蓝色参数占比;2. 比较同三组橙色每秒音频计算量占比的悬殊差异;3. 确认生成器参数只占约四分之一但计算量占近九成的结论

论文图 2。原论文 Figure 2::“Share of Kokoro’s parameters and of its compute (FLOPs per second of audio) in each part.”。
图中蓝色为参数份额,橙色为每秒音频计算量份额,可见文本侧参数约 35% 但计算量仅约 8%,解码器 AdaIN 块参数约 41% 但计算量仅约 3%,生成器参数约 24% 但计算量高达 89%。这种错位直接支持后文把生成器通道从 512 压到 128 的选择。
下面这张参数普查表给出了各子系统的具体参数量与占比,用于核对上图的 3 个合并分组。
| Subsystem | Parameters | Share |
|---|---|---|
| Decoder AdaIN encode/decode blocks (1024 channels) | 33.6M | 41% |
| Decoder iSTFTNet generator | 19.7M | 24% |
| LSTMs (text encoder and prosody predictor) | 11.2M | 14% |
| Total (PyTorch) | 81.8M |
该表把教师拆成六行加总计,解码器两部分合计约 65%,文本侧三部分合计约 35%。它的限制是只统计参数量,不反映运行速度,速度结论需结合生成器高帧率卷积的计算量分析一起读,不能只看参数份额判断快慢。
Paradee 的主结果在什么条件下成立
主结果的配置是 4.23M 特征监督带多层感知机投影的文本侧,加 2 阶段训练后的 3.85M 解码器,再加相位锁定滤波。论文报告参数从 81.8M 到 8.07M 约 10.1 倍减少,每秒音频计算量从 55 GFLOP 到 3.4 GFLOP 约 15 倍减少,int8 文件从教师 ONNX 的 325 MB 到 8.45 MB,PyTorch 单中央处理器线程从 7.6 倍实时到 25.0 倍实时。质量上 fp32 的 UTMOS 为教师 4.52 对学生 4.41,int8 后学生仍为 4.41,Whisper 词错率两者均为 5.7%,说话人相似度 0.958,而另一 Kokoro 声音 af_bella 同文本仅 0.842。论文还说明速度提升 3.3 倍小于计算量下降 15 倍,因为小卷积与长短期记忆网络在 PyTorch 下的单算子开销占主导,滤波占运行时间约 5%。
4 比特量化在 3 句早期测试中把解码器 UTMOS 降到 3.98,而教师大解码器块在 4 比特下变化小,原因是小模型已无冗余通道吸收舍入。这些结论只在单音色 af_heart、200 句 held-out、同一台机器与同一评分检查点下成立,换声音、换语言或换评测集都需要重新验证。论文正文给出教师与学生的逐项对照,关键数字与上文一致,阅读时注意教师 int8 的 UTMOS 在部分表格中未单独列出,不能自行补齐。
与其他小模型的同条件对比说明了什么
论文在同一 200 句 held-out、同一种评分流程下比较了 3 个小开放模型。需要先说明公平条件:文件大小按各模型发布形态比较,Paradee 为 int8,其余为 fp32;速度均为同一机器单中央处理器线程的实时倍数,但 Paradee 与 Kokoro 系模型从音素计时,Piper 与 KittenTTS 从文本计时因此包含音素化时间;每个模型说自己的声音,所以 UTMOS 比的是自然度而非与 af_heart 的接近程度。结果是 Paradee 在 UTMOS 上最高且文件最小,发布的单 int8 ONNX 文件为 9.0 MB、17.8 倍实时、UTMOS 4.41、词错率 6.0%,比论文 PyTorch 版本稍大稍慢但质量相同。
Kokoro-7M-Distill 约快 1.4 倍但 UTMOS 低 0.23,Piper 中等规模下自然度次之但词错率较高,KittenTTS nano 词错率最低但自然度最低。该对比的限制是基线各说各的声音,UTMOS 不能读作谁更像 af_heart,说话人相似度只在主结果中对教师报告,不适用于跨声音基线。
文本侧的容量、投影与训练目标哪个更关键
把各学生文本侧接到冻结教师解码器上测试,可以隔离文本侧的影响。教师文本侧本身参数 28M,动态时间规整对数梅尔距离 0.12 为 2 次运行的下限,UTMOS 4.52。学生小模型线性投影版 4.0M 距离 0.97、UTMOS 4.15,换多层感知机投影后 4.2M 距离 0.91、UTMOS 4.36,加宽到 7.1M 后距离 0.89、UTMOS 4.35,说明从 4.2M 加到 7.1M 教师强制损失略好但自由运行不变,瓶颈在训练目标而非容量。投影分析指出教师 512 通道特征高度冗余,192 通道线性投影最多表达 192 维,误差 0.079 已接近该类投影极限 0.068,换两层网络后误差降到 0.066,低于任何线性投影可达值,UTMOS 从 4.15 升到 4.36。
按输出拆分,相对教师自身下限 0.12,学生音素特征增加约 0.47,基频与能量增加约 0.35,时长仅增加约 0.13。另一条路线是让文本侧经过冻结教师解码器再算对数梅尔损失,该 4.2M 版本距离最差 0.99 但 UTMOS 达到教师的 4.52,可是接到学生解码器时跌到 3.78,而直接监督教师数值的版本接学生解码器为 4.39。结论是直接匹配教师数值学到的特征可迁移,讨好特定解码器的特征不可迁移,Paradee 因此采用特征监督版本。
下面这张文本侧对照表固定使用教师解码器渲染,比较了容量与训练目标的影响。
| Text side, rendered by the teacher decoder | Params | DTW log-mel | UTMOS |
|---|---|---|---|
| Teacher text side | 28M | 0.12 (floor) | 4.52 |
| Student s, MLP projection | 4.2M | 0.91 | 4.36 |
| Student m, MLP projection | 7.1M | 0.89 | 4.35 |
| Student s, MLP, trained through the teacher decoder | 4.2M | 0.99 | 4.52 |
最后一行虽然 UTMOS 达到 4.52 与教师持平,但动态时间规整距离为 0.99 最差,接到学生解码器后跌到 3.78,而直接监督教师数值的版本接学生解码器为 4.39,因此不能只看教师解码器下的最高分,还要结合跨解码器迁移条件来判断文本侧是否真正可用。
解码器为何更依赖损失权重而非加宽
学生解码器 A 为 3.85M,单独由教师文本侧驱动时只用频谱损失训练 50,000 步后动态时间规整距离 0.50 但 UTMOS 仅 2.98,完整学生为 3.00,听感是 af_heart 声上叠加一个同时说话的机器声,频谱显示学生在 6 到 8 kHz 仍保留清晰谐波条纹而教师在 3 到 4 kHz 以上已化为气息噪声,正弦激励几乎原样漏过。加入对抗后若沿用默认频谱权重 45,频谱项约 15 比 1 压过对抗项,3000 步仅从 2.98 到 3.02。把权重降到 10 再跑 5000 步,解码器到 4.29、完整学生到 4.32;再降到 3 跑 5000 步,解码器到 4.37、完整学生到 4.39。相位锁定滤波只把完整学生从 4.39 推到 4.41,但去除了大部分可闻嗡嗡声。
拼接方式上,频谱解码器阶段学生文本侧经教师解码器距离 0.87,教师文本侧经学生解码器 0.50,完整学生 0.81,反而优于文本侧单独,原因是教师解码器对精确特征敏感会放大误差,学生解码器对音频训练更宽容,因此用各自接教师一半测得的损失会高估组合损失,无需联合训练。最终 UTMOS 也一致:学生文本侧经教师解码器 4.36,教师文本侧经学生解码器 4.37,各比教师低约 0.15,但完整学生滤波前已达 4.39,误差没有叠加。
残余嗡嗡声定位在哪个频段与相位
对抗训练后唯一的明显缺陷是浊音上的轻微嗡嗡声。论文用相同激励做幅度与相位互换:学生幅度配教师相位无嗡嗡声,UTMOS 4.49,接近教师 4.52 而高于学生 4.37;教师幅度配学生相位仍嗡嗡作响,为 4.45。只在 2 到 8 kHz 换入教师相位就足以去除嗡嗡声,该频段起点恰在激励音 9 个谐波上限附近,对该声音约 1.9 kHz,之上生成器必须自己合成谐波而小学生把时序弄错。加宽判别器、直接波形与相位损失、蒸馏教师末层、加大解码器都未去除嗡嗡声。
解决办法是合成后相位锁定滤波:在浊音帧与 2 到 8 kHz 频带内测量输出相位相对解码器自身激励音的漂移,在约三分之 1 秒上平滑后用平滑相位与原始幅度重合成音频,思路接近相声码器的恒等相位锁定。该滤波无参数,占 Paradee 运行时间约 5%。人耳听感去除大部分嗡嗡声,但在部分重读音乐节上仍有残留,那里学生在 2 到 8 kHz 比教师安静 3 到 6 dB,相位修正无法补响度。UTMOS 对该变化只从 4.39 到 4.41,且 elsewhere 也曾把人耳听感相同的两个解码器打出 0.5 分差距,因此该缺陷以听感为准,自动分只能参考。
证据的边界与尚未验证的范围有哪些
Paradee 只说一个英语声音,本次未训练也未验证其他声音或语言,不能反过来理解为架构无法扩展,论文原话是未训练它说其他声音或语言。质量证据是 200 句上的自动预测分加作者非正式听感,没有正式听音测试。基线只比较了 3 个小开放系统且各说各的声音,速度只在一台机器上测量。模型仍在部分浊音上保留轻微嗡嗡声,源于 2 到 8 kHz 的相位与响度误差。量化方面,int8 权重无可测变化,但 4 比特会明显下降。
附录的量化敏感性显示趋势与尺寸相反:解码器卷积块占 41% 参数但 8 比特几乎无变化、4 比特变化小,文本侧 8 比特变化更大,因为时长被轻微扰动会移动其后所有帧。全权重 8 比特平均移动时长 25 毫秒,预构建的动态 int8 ONNX 因同时量化激活移动 65 毫秒并使距离翻倍。全权重 fp16 与 fp32 听感无差别。下表按每次只量化一部分、其余保持全精度的方式给出距离,数值越低越好,0.09 为教师自身 2 次运行的无实质变化水平。
下面这张量化表用于说明小文本侧更敏感、大解码器块更鲁棒的反直觉结论。
| Part | Params | 8-bit | 4-bit (groups) | Timing shift, 8-bit |
|---|---|---|---|---|
| Prosody predictor | 16.2M | 0.312 | 0.379 | 25 ms |
| Decoder AdaIN | 33.6M | 0.090 | 0.126 | 0 |
| Generator | 19.7M | 0.103 | 0.354 | 0 |
| All weights | 81.8M | 0.270 | 0.624 | 25 ms |
表前比较问题是各部分对权重量化的敏感性,公平条件是每次只量化一部分且激活保持 fp32,指标为 5 句上的动态时间规整对数梅尔距离。表后解释是解码器 AdaIN 在 8 比特为 0.090 与教师自比下限相当,生成器为 0.103,而韵律预测器在 8 比特已达 0.312 且带来 25 毫秒时移。限制是该表只用 5 句且只看与全精度教师的距离,不能直接换算成 UTMOS 或听感分,4 比特分组与逐通道的差异也只在该小样本下成立。
复现第一步做什么,需要哪些数据与配置
复现应从教师语料复刻开始。用 Kokoro-82M v1.0 与 af_heart 声音,在中央处理器上按每句固定种子合成 12000 句 WikiText-103 英语句子,保存音素、预测时长、基频与能量轮廓、音素特征和波形,前 200 句留作评测,注意教师在中央处理器与图形处理器输出略有差异,固定种子才能精确复现激励。文本侧按 8000 步、批量 32、AdamW、学习率 5×10⁻⁴ 训练,直接监督教师的对数时长、基频、能量和音素特征。解码器按 1.6 秒片段,先 50000 步只用频谱损失、批量 16、学习率 2×10⁻⁴,再分两段加入对抗并把频谱权重从 10 倍降到 3 倍。
组装后不做联合训练,直接连接并做逐输出通道 int8 量化,其余参数保持 fp16。附录 C 给出 6 组学生解码器加一组教师的尺寸预设,学生参数从 1.15M 到 7.86M,教师解码器为 53.3M,不要把教师混入学生范围。Paradee 采用其中 A 预设,宽度与核为 256/128 与 3、7、11,参数 3.85M,生成器 1.19M,每秒音频 3.36 GFLOP。论文正文给出论文中提到的代码与模型链接,但本次未确认来源可用性,因此代码可运行、权重可下载与系统可运行要分开验证,不能仅凭链接断定已公开可用。
下面这张解码器尺寸表列出各预设的宽度、参数与计算量,是选择 A 作为 Paradee 的依据。
| Preset | Widths and kernels | Params | Generator | GFLOP/s audio |
|---|---|---|---|---|
| Teacher | 1024 / 512 / 3,7,11 | 53.3M | 19.7M | 51.9 |
| A (Paradee) | 256 / 128 / 3,7,11 | 3.85M | 1.19M | 3.36 |
| C | 192 / 96 / 3,7 | 2.16M | 0.48M | 1.31 |
| L | 384 / 192 / 3,7,11 | 7.86M | 2.58M | 7.44 |
表前比较问题是不同宽度解码器的参数与计算量代价,指标方向为参数越少文件越小、每秒音频 GFLOP 越低则中央处理器越快。表后解释是 A 在 3.85M 下把计算量压到 3.36,而更宽的 L 到 7.86M 需 7.44,论文报告加宽并未解决嗡嗡声,因此不能只按参数越大越好来选型,还要看损失权重与相位缺陷这一反例。
什么时候值得尝试,还缺哪项验证
当应用只需要一个固定英语声音、能在笔记本电脑上训练并在单中央处理器线程实时运行时,这条分半蒸馏路线值得尝试。它的可复述关键步骤是冻结教师存数、文本侧直接回归教师数值、解码器先频谱后对抗且让判别器权重真正起作用、两半直连不联合训练、合成后用无参数相位锁定滤波修正 2 到 8 kHz 浊音相位、最后逐通道 int8 量化。代价是自然度仍比教师低约 0.11,残留嗡嗡声在重读音节上与响度不足有关,4 比特量化不可用,速度提升受小算子开销限制。
还需要补的验证是正式听音测试、大样本量化与多机器速度测试,以及其他声音或语言上的重新训练与评测。教学例子:可以把文本侧想象成先写好每字读多长、每帧多高多响的乐谱,解码器是按乐谱演奏的乐队,判别器是挑毛病的听众,滤波是演出后把 2 到 8 kHz 声部对齐到乐队自己节拍器的微调,该比喻只对应信号与模块分工,不构成证明。
📎 论文与评分元数据
排名:前50% | 文档类型:模型报告 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses