📄 把音频变成可读文字再推理:Listen-to-Reason 的树、路由与冻结阅读器
英文题目:Listen-to-Reason: Listen with Experts, Retrieve over a Graph, Reason with LLMs
标签:#音频推理 | #检索增强 | #可解释性 | #少样本
评分:7.0/10 | 创新 1.5/2 | 技术严谨 1.2/1.5 | 实验充分 1.2/1.5 | 清晰度 0.8/1 | 影响力 1/1.5 | 开源 0/1.5 | 可复现 0.3/0.5 | 工程/实践 1/1.5
👥 作者与机构
- Pooneh Mousavi:Concordia University;Mila – Quebec AI Institute
- Mirco Ravanelli:Concordia University;Mila – Quebec AI Institute
- Cem Subakan:Concordia University;Mila – Quebec AI Institute;Laval University
📌 核心摘要
音频问答指根据音频证据回答文本问题,难点在于大型音频语言模型把音频融进隐状态,思维链是事后解释,换编码器或大语言模型都要重训。Listen-to-Reason先从训练片段生成含语音、音乐、环境声属性的四层多模态树,再由冻结专家编码器上的小型路由头把每个音频块映射到命名节点并与自动语音识别转写拼接成文本上下文,最后冻结的纯文本读者在不听音频的情况下仅据该上下文作答。与直接融合嵌入不同,感知与推理只通过可读文本交互,更换读者或新增域不必重训已有部分,且答案可追溯到检索路径。在SAKURA全集上以准确率为指标,7B读者准确率为80.1%,超过同指标下直接听音频的Qwen2.5-Omni-7B的73.3%。在MMAU test-mini上以准确率为指标,该7B读者准确率为68.3%,低于同一基线6.8个百分点,树与转写互补且更强读者无需改动音频侧即可缩小差距。在48类鸟类物种辨识任务上以准确率为指标,每类5个标注片段训练的新域头准确率为79.6%,明显高于同数据下QLoRA微调该基线的54.1%。系统只训练7.7M参数,约为Omni-7B的1400分之一,但单题推理需要5.3 TMACs和0.57 s,高于Omni-7B的2.7 TMACs和0.12 s;树继承标注与教师分类器误差,读者会跟随错误节点,且新域仅在物种辨识任务验证,需要身份之外推理的新域仍待探索。
🔗 开源与复现资源
第三方资源:https://poonehmousavi.github.io/listen-to-reason/ — 链接可访问(HTTP 200)
模型相关资源:https://huggingface.co/poonehmousavi/listen-to-reason — 暂时无法访问
可达状态仅表示本次链接检查结果,不代表许可证、本文权重或运行复现已验证。
🧭 深度解读
这篇论文要解决的音频问答问题是什么
输入是一段音频与一道选择题,目标是选出正确选项。音频可能是说话、音乐、环境声或它们的混合,题目既问听到了什么,也问需要外部知识的推理,例如由动物叫声推出相关事实。必须保留的信息包括说话内容、说话人属性、乐器与风格、声音事件及其大致时间。输出是一个选项字母,评价用准确率,越高越好。
已有主流路线是大型音频语言模型,把音频编码器输出映射成大语言模型的连续嵌入,再经过多阶段对齐、指令微调与思维链训练联合优化。它的优点是端到端感知细腻,缺点是编码器与语言模型耦合,换更强语言模型或加新领域都要重训,且思维链是同一网络在融合音频后生成的,事后解释不一定忠实于真正听到的证据。另一条路线是符号级联与工具调用,先把音频变成文字描述再让文本模型推理,证据可读但过去多用现成提取器各自为政的标签,没有统一词汇,也缺少对证据因果性的定量检验。本文属于后者,并希望做到可读、可替换、可扩展。
与已有路线相比本文的输入输出有何不同
与直接听音频的音频语言模型相比,本文阅读器从不接触波形,只读路由生成的树节点文字与语音转写文本。输入相同的是同一段音频与同一道题,输出相同的都是选项,但监督与运行阶段不同:前者在音频文本大数据上训练适配器乃至编码器与语言模型,后者冻结所有编码器与阅读器,只训练每个属性上的小头。
与 SAR-LM 这类同样先转文字再推理的工作相比,区别在于本文用一棵统一的 4 层树词汇覆盖语音、音乐、环境声,而不是拼接多个提取器的标签空间;节点由为该词汇训练的小头预测,不确定时从叶退回类;新领域作为树的一个新属性加一个小头;并用音频大模型打分与节点干预检验可解释性。与基于知识图谱的检索增强相比,本文的图不是存储关于声音的外部事实,而是描述本段音频中听到了什么,世界知识由阅读器自身提供。
冻结阅读器 × 音频语言模型: 音频语言模型指直接听到音频波形或连续音频嵌入并生成答案的端到端模型,感知与推理耦合在一起;冻结阅读器指从不听音频、只读树节点与转写文本的纯文本大模型,参数完全不更新。二者对照说明本文把感知固定在树一侧、把推理留给文本模型,换更强的文本模型无需重训音频侧。
为什么可追溯性在这里是硬要求
在医疗等高风险场景,预测必须能被检查。语音可用于抑郁、帕金森、阿尔茨海默等评估,但若模型只给出答案与一段事后生成的思维链,医生无法确认模型到底听到了哪句、哪种声音。事后解释方法的问题在于解释与决策分离,显著图可能对权重不敏感,注意力权重也不可靠。
本文把可解释性做进结构:答案只能以提示词中打印出的节点与转写为条件,错误可以定位到某一行节点并通过改节点修正。例子是路由器把 waterfall 听成 Rain,阅读器就跟着选 Rain,修复位置明确在 water 类下的一个节点,而不是去猜语言模型的隐藏状态。这种设计把证据检查变成读输入,而不是另做 1 次外部探针分析。
整体流程如何把波形变成答案
全流程分 4 步。第一步建树,用 4 层结构组织音频概念;第二步路由,把每个短音频块映射到树节点并与转写拼成可读上下文;第三步推理,冻结文本大模型只读上下文答题;第 4 步适配,新领域加一个编码器加一个小头的分支。
下面这张总览图值得先读,它把音频块切分、路由、树、上下文、问题与冻结阅读器的关系画在了一起,虚线是新增域,实线是每次推理都走的路径。读图时先看主路径,再看文字上下文如何成为唯一的桥梁。
看图路径: 1. 先沿左侧音频块经路由到右上音频树的实线箭头看主路径;2. 再看右下树上下文加转写如何进入左下冻结大模型

论文图 1。原论文 Figure 1::“Overview of Listen-to-Reason. Listen: a four-level tree describes speech, music and sound.”。
从图中可见,音频先被切成 3 秒块、1.5 秒步长,路由按区域门决定每块走语音、音乐还是环境声分支,各属性小头给出节点,节点与带时间戳的转写一起组成文本框。左下冻结大模型只读该文本框与问题,输出答案并可追溯到上方节点。新增域只加一条虚线分支,不动原有编码器、原有头与阅读器,因此不会灾难性遗忘原任务。图中星号表示冻结模块,橙色表示仅训练小头,图例区分了已走路径与新增域路径。
树长什么样,环境声身份如何划分
树有 4 层:区域、属性、类别、叶。区域只有语音、音乐、环境声 3 类。属性是每个区域下的刻画维度,例如语音有性别、年龄组、语言、说话人数、情感、说话风格,音乐有乐器、人声、体裁、情绪、速度、调式等,环境声有场景、动作材质、远近等。类别是属性下的封闭选项,叶是开放细化。环境声身份类目对齐 AudioSet 本体,整棵树共 39 个属性、363 个类别与 668 个叶。
建树时把训练音频切成短块,用单任务专家分类器与一个音频大模型共同标注。音频大模型不自由问答,只填固定模板:先判断出现哪些区域,再为每个区域的每个属性选已有类别或 unsure,并可附 1 到 3 个词的叶。单选属性取专家高置信标签否则取大模型标签,多选属性取并集。自由文本叶只有跨多个片段重复出现才成节点,并由外部文本大模型做同义词合并,再经数量、否定、极性与声学相近性检查。
专家编码器 × 路由头: 专家编码器指针对语音、音乐、环境声不同属性预训练并冻结的音频表征模型,只负责把波形变成向量;路由头指每个属性上训练的小分类头,负责把向量映射到树上的命名节点。二者搭配是因为编码器听得准但输出不可读,路由头把不可读向量翻译成人类可读的类别与细化叶节点,组合后音频侧输出就是一行行文字。
下表是环境声身份属性的划分方式,它说明每个身份属性有多少类别与叶、用哪个冻结编码器读取,以及典型例子。比较问题是不同声音类型是否需要不同编码器,条件是同一套 AudioSet 与 FSD50K 留出片段上的效果,指标是分类准确率越高越好。
| Attribute | Classes | Leaves | Router encoder | Example classes |
|---|---|---|---|---|
| animal | 26 | 96 | BEATs | bird, cat, cattle, dog, insect |
| vehicle | 12 | 40 | CLAP | aircraft, boat, car, emergency vehicle, train |
| machine | 2 | 37 | CLAP | engine, mechanisms |
| tool | 7 | 12 | CLAP | hammer, jackhammer, power tool, sanding |
| household | 23 | 38 | CLAP | blender, dishes, door, tap or sink, typing |
| human non-speech | 24 | 58 | BEATs | applause, breathing, cough, laughter |
表后可以看到,动物、非语音人类声、环境与活动用 BEATs,其余车辆、机械、工具、家居、自然、告警、撞击、声音质地用 CLAP,哪个在留出集上更高就用哪个。这种分工让每个域用听得最准的表征,而上层都统一成相同的树节点文字。限制是该表只给出编码器选择与规模,不直接证明下游问答增益,问答增益要看后文主结果与消融。
路由如何给每个音频块打分并退回
路由不对波形直接分类成答案,而是为每个属性选树节点。每个属性绑定一个合适的冻结编码器,例如声音与音乐用 CLAP,情感用 emotion2vec,共享同一编码器的属性组成一个路由器:冻结嵌入先过小的主干网络,再进各属性头。每个头对该属性每个节点输出一个分数,训练目标是让与标注一致的节点分数最高。
类别节点 × 叶节点: 类别节点是属性下的封闭选项,例如 water 或 happy,指一类可稳定判断的声音或状态;叶节点是类别下的开放细化,例如 happy 下的 sarcastic 或 engine 下的 knocking,指更具体的听感。路由先保证类别正确,不确定时退回类别,确定时才给出叶,组合后既有兜底精度又有细粒度信息。
类别分数把自身节点与所属叶的指数求和再取对数,因此确信的叶也会支撑其类别。公式中 x 是音频块,h 是冻结嵌入,phi 是小主干,g 是属性头,v 是类别,L 是该类别下的叶集合,s 是类别得分。原式由代码显示:
\[s_{a}(v\mid x)=\log\sum_{n\in\{v\}\cup\mathcal{L}_{a,v}}\exp g_{a}\big(\phi(h)\big)_{n},\]推理时区域门先决定每块含哪些区域,开放属性取最可能的类,叶只有置信才保留,否则退回类,例如只给 engine 而不给 engine knocking。片段级属性每块独立决策,整段级属性对各块对数概率平均。阅读器侧把全段节点去重并按属性分组,例如同时听到女声与狗叫就写成两行;若听到语音或歌声则加转写,需要顺序、时长或计数时才加事件时间线。
树上下文 × 转写文本: 树上下文指路由从各音频块收集并去重后按属性分组的节点文字,例如 gender 与 animal 各写一行;转写文本指 Whisper 对其中语音或歌声的识别结果。树负责声音身份与音乐语音属性,转写负责话语内容,二者互补后阅读器才能同时回答听到了什么和说的是什么。
阅读器不生成自由文本,而是比较选项字母的概率。c 是上下文,q 是问题与选项,O 是选项字母集合,第二项是同一阅读器不看上下文的先验,beta 取 0.1,用于减少解析误差并引入微弱先验。原式由代码显示:
\[\hat{o}=\arg\max_{o\in\mathcal{O}}\Big[\log p(o\mid c,q)+\beta\log p(o\mid q)\Big],\]训练时更新什么冻结什么,监督从哪里来
所有音频编码器与文本阅读器全程冻结,梯度只进路由小头与主干。监督来自两部分:一是建树时的专家与大模型标注,二是 AudioSet、FSD50K、ESC-50、MusicCaps、IRMAS、FLEURS 等人类标签。每个块只在部分属性上有标注,因此损失按属性掩码,只在有标注的属性上计算类别交叉熵或二分类交叉熵加叶交叉熵。叶损失只在标注类别内部比较节点,学叶不搬动类别间概率。罕见叶不单独成节点,训练时指向其类别,迫使模型学会何时不细化。
总损失对每个块把有标注属性的类别项与叶项相加,m 为掩码,标记该属性在该块是否有标签。原式由代码显示:
\[\mathcal{L}(x)=\sum_{a}m_{a}(x)\Big[\ell^{\mathrm{class}}_{a}(x)+\ell^{\mathrm{leaf}}_{a}(x)\Big],\]实现上语音、音乐、场景头用 1 到 3 层宽 256 的多层感知机,环境声身份头用归一化加 1024 单元层,音乐属性头用两层网络,事件时间线用 PANNs 帧上的线性层,新域头用一层主体加类别与 none 类。优化器均为 AdamW,按属性标注量平方根采样,叶阈值按 0.75 精确率拟合。新域训练还加入无目标域的块,学出 none 概率,避免在无关音频上误入新域。
单选属性 × 多选属性: 单选属性指一个时刻只能取一个值的属性,例如性别或 tempo;多选属性指可同时成立多个值的属性,例如重叠乐器或声音事件。单选属性用 softmax 在类别间竞争,多选属性对每个类别独立做二分类,训练与推理的损失和阈值因此分开,组合后才能同时处理独占判断与重叠听感。
在什么数据与题面上测,条件是否公平
树用 4054 个训练片段生成,路由另用 AudioSet 等大数据的人类标签,评测音频不参与训练。主评测是 4 套多选音频推理题:MMAU test-mini 1000 题,MMAR 1000 题,SAKURA 4000 题覆盖性别、语言、情感、动物各 500 单跳加 500 多跳,MMAU-Pro 取单音频多选题 4133 题并对所有系统统一打乱选项。指标都是准确率,方向越高越好。阅读器固定读同一份缓存树加转写,共测 26 个 0.5B 到 72B 的冻结文本模型,转写来自 Whisper-large-v3。对照是 3 个直接听音频的模型:Qwen2.5-Omni-7B、Audio Flamingo 3、Qwen3-Omni-30B。
新域评测是两个当前音频大模型接近随机的物种识别任务:鸟类 48 种 938 题,海洋哺乳动物 31 种 678 题,每题四选一,干扰项选分类学相近物种,随机基线 25%。本文方法为鸟类用 BirdNET,为海洋哺乳动物用 CLAP,各训一个小头;对照是同一批标注条给 Omni-7B 做零样本、上下文示例与 QLoRA 微调,训练条数与禁测泄漏条件一致。打分时 MMAR 按选项文本映射到字母,MMAU-Pro 长录音路由只看前 60 秒、转写看前 180 秒,各系统相同。
主结果在什么条件下成立,差距有多大
先看阅读器规模带来的总体趋势。下图所有点读的是同一份缓存上下文,因此点间差异只能来自文本推理能力,不是听到了不同音频。横轴是阅读器参数,纵轴是准确率,三块面板分别是 MMAU、MMAR、SAKURA,水平线是直接听音频的模型。读图时先看曲线随规模上升再趋平,再看 SAKURA 上大阅读器超过水平线的位置。
看图路径: 1. 先看横轴阅读器参数与纵轴准确率的单调趋势;2. 再比较 Qwen2.5 实线与 Qwen3 虚线在三块面板中的位置;3. 注意水平线代表直接听音频的三个音频大模型

论文图 2。原论文 Figure 2::“Accuracy of Listen-to-Reason as a function of the frozen reader.”。
图中可见,7B 以前上升陡峭,7B 以后趋缓;MMAR 从 7B 到 14B 提升最多,因为更多题目需对转写做多步推理;SAKURA 上 2024 年后 7B 以上阅读器普遍超过直接听音频的最强对照,原因是单跳题答案常是节点名,多跳题节点名加阅读器自身知识已够。下表是 4 套题上的完整准确率对比,公平条件是同一题面与同一打乱选项,指标是准确率越高越好,基线包含盲猜、单通道与 3 个听音频的模型。
| B | SAKURA↑\uparrow | MMAU↑\uparrow | MMAR↑\uparrow | MMAU-Pro↑\uparrow | ||
|---|---|---|---|---|---|---|
| Input ablation (Qwen2.5-7B) | Blind (question and options only) | 7.6 | 32.6 | 50.2 | 37.8 | 38.9 |
| Input ablation (Qwen2.5-7B) | Transcript only | 7.6 | 51.8 | 60.1 | 47.8 | 44.6 |
| Input ablation (Qwen2.5-7B) | Tree only | 7.6 | 74.7 | 57.5 | 40.3 | 39.3 |
| L2R (ours) (tree + transcript) by reader | Qwen2.5-7B | 7.6 | 80.1 | 68.3 | 51.6 | 45.7 |
| L2R (ours) (tree + transcript) by reader | Qwen2.5-14B | 14.7 | 83.3 | 69.4 | 55.6 | 48.5 |
| L2R (ours) (tree + transcript) by reader | Qwen2.5-32B | 32.8 | 85.1 | 71.4 | 55.7 | 49.8 |
| L2R (ours) (tree + transcript) by reader | Qwen2.5-72B | 72.7 | 85.3 | 70.5 | 56.6 | 50.1 |
| L2R (ours) (tree + transcript) by reader | Phi-4 | 14.7 | 83.5 | 71.7 | 54.9 | 46.1 |
| Audio LLMs (hear the clip) | Qwen2.5-Omni-7B | 10.7 | 73.3 | 75.1 | 63.6 | 57.4 |
| Audio LLMs (hear the clip) | Audio Flamingo 3 | 8.3 | 68.2 | 75.5 | 57.8 | 49.1 |
| Audio LLMs (hear the clip) | Qwen3-Omni-30B-A3B | 35.3 | 73.0 | 74.0 | 62.0 | 58.2 |
表后解释是,用 Qwen2.5-7B 阅读器时本文在 SAKURA 上超过所有音频大模型,在 MMAU 上落后 Omni-7B 约 6.8 个百分点,在 MMAR 上落后约 12 个百分点。树与转写互补,合用在 4 套题上都高于单用。更强阅读器不改音频侧即可缩小差距,Phi-4 在 MMAU 上追回约一半差距,72B 在 MMAR 上追回约 40%,32B 与 72B 在 MMAU-Pro 上超过 Audio Flamingo 3。限制是剩余差距集中在计数、场景与需深层推理的题,后文会拆解。
新域为什么只需一个小头就能加上去
新域作为区域下的一个新属性加入,需要一个适合该域的冻结编码器与一个在每类 k 条加无域块上训练的小头。树、其他头与阅读器都不更新,因此原任务几乎不遗忘,加两个域头后 SAKURA、MMAU、MMAR 最多掉 0.6 个百分点。下图比较随标注条数增加的准确率,横轴是每类条数,纵轴是准确率,圆点是本文小头,方形是 QLoRA,三角是上下文示例,虚线是零样本。读图时先看 5 条处圆点与方形的垂直差距,再看曲线随条数增加是否收敛。
看图路径: 1. 先看横轴每类标注条数从 1 到 50 的变化;2. 再比较圆点新域小头与方形 QLoRA 微调两条曲线的相对高低;3. 注意左右两图分别为鸟类与海洋哺乳动物的纵轴含义
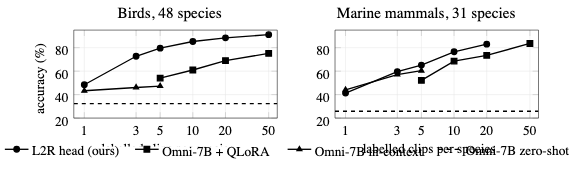
论文图 3。原论文 Figure 3::“Data efficiency on new domains. One small head (0.34M parameters for birds, 0.17M for marine mammals) on a frozen encoder (BirdNET for birds, CLAP for marine mammals), read by a…”。
图中可见,1 条时三者接近,3 到 5 条后本文小头迅速拉开,QLoRA 需 20 到 50 条才接近本文 5 到 20 条的水平。上下文示例受提示长度限制,最多每候选 5 条,在鸟类上弱于 QLoRA,在叫声短的海洋任务上介于两者之间。下表整理每类 5 条时的关键数字对比,比较问题是同批少量标注下谁更准更省,条件是同物种同条数,指标是四选一准确率越高越好。
| 方法 | 鸟类准确率 | 海洋准确率 | 可训练参数 | 训练耗时 |
|---|---|---|---|---|
| 本文新域小头 | 79.6 | 65.2 | 0.34M 与 0.17M | 不到 1 分钟 |
| Omni-7B 加 QLoRA | 54.1 | 52.2 | 40.4M | 7 到 29 分钟每点 |
表后解释是每类 5 条时本文在鸟类与海洋任务上分别领先约 25 与 13 个百分点,而对方训练更多参数并花更多 GPU 分钟,本文鸟头与海洋头都很小且 1 分钟内训完。限制是该结论只在物种身份识别任务上验证,编码器选择很关键,鸟类用 BirdNET 而海洋用 CLAP,阅读器在 1.5B 到 72B 间几乎不影响结果,因为域节点已携带答案。未胜出项是 QLoRA 在海洋 50 条处反超本文 20 条,说明数据足够多时微调整体语言模型仍有后劲。
树与转写各自带来什么,拿掉会怎样
消融把问题、转写、树拆开给同一 7B 阅读器。在 SAKURA 上树单独已达较高水平,比只看转写高出一大截,因为题目问的是动物、情感、性别、语言的身份;在 MMAU 与 MMAR 上转写更重要,因为题目混入大量语音内容推理。两者合用在 4 套题上都超过单用,说明身份通道与内容通道互补。树规模为 39 个属性、363 类、668 叶,语音 6、音乐 18、环境 15,仅树就在 SAKURA 上拿到较高准确率并比转写高出 28.3 个百分点。
限制是该增益只在身份题集中的 SAKURA 上这么大,在 MMAU 与 MMAR 上树单独弱于转写单独;去掉所有叶只留类会使 SAKURA 掉 8 个百分点,说明细化叶在身份题上不可少。
下图检验节点与音频的相关性,评委是 3 个听到音频的大模型,按 1 到 5 打分并与错配音频的节点对照。读图时先看深浅柱高低,再看柱上 97% 到 99% 的含义,标记形状区分不同评委。
看图路径: 1. 先看深色本文节点与浅色错配节点两组柱子的高低;2. 再看每个柱子上方 99% 与 97% 等数字的含义;3. 注意三种形状标记代表三个不同的音频大模型评委

论文图 4。原论文 Figure 4::“Relatedness of the served nodes to the audio (1–5).”。
图中可见,3 个评委都给本文节点打分明显高于错配节点,且在 97% 到 99% 的条目上更高。评委尺度不同,有的给错配节点也打 3 分以上,但方向一致。限制是评委本身也是音频大模型,存在同源偏好,只能证明相关性,不能证明因果,还需下节干预实验。
节点是否真正决定答案,换掉会怎样
因果检验分两层。整树替换时,用别段音频的树配本段转写,7B 阅读器在 MMAU 上从 68.3 掉到 55.0,在 MMAR 上从 51.6 掉到 46.4,都低于只看转写,说明阅读器确实在用节点,错树比无树更差。在 SAKURA 上用别类树会从 80.1 掉到 40.0,性别甚至掉到 11.7%,远低于随机,因为阅读器跟着错性别节点走。下表整理单节点编辑的破坏与修复率,比较问题是只改决定性属性一行能否翻转答案,条件是 SAKURA 单跳题且只改该属性子句,指标是被翻转的比例越高说明因果越强。
| 操作 | 总体 | 动物 | 情感 | 性别 | 语言 |
|---|---|---|---|---|---|
| 换成干扰项后正确变错 | 78.3% | 93.8% | 96.9% | 99.8% | 8.0% |
| 换成金标后错误变对 | 90.9% | 87.5% | 94.8% | 97.8% | 未报告 |
表后解释是动物、情感、性别上替换几乎必翻转,注入修复率也超 87%,总体破坏 78.3% 与修复 90.9%,说明这些答案由节点携带。反例是语言替换仅破坏 8.0%,因为转写文字本身暴露语种,阅读器更信文字而非矛盾节点。这恰好划出方法边界:当转写与节点冗余时,阅读器会按文字走,节点不再是唯一决定因素。例子上,正确两题的决策节点都在上下文中,错误一题把 Waterfall 听成 Rain,阅读器跟着选 Rain,修复应是给 water 类补 Waterfall 叶与训练片段。
还差在哪里,哪些题注定做不好
按题型拆,计数题最弱,在 MMAU 与 MMAR 上都只比盲猜高一点,因为路由描述 3 秒块而不表示单个事件,论文没有表示单个事件出现次数的节点,没有节点陈述数量。顺序与时间题在 MMAU 上接近对照,在 MMAR 上落后 11 题。身份与场景题在 MMAU 上各净输 18 题,多因走到正确类别但错叶或给出多个候选叶,例如把 waterfall 写成 rain,或场景描述太粗。
按子类别看,MMAU 丢分集中在声景推理、音乐织体、基于事件的声音推理,MMAR 丢分集中在环境感知、内容分析、计数统计。MMAR 上说话人与内容分析需对转写做较深推理,这正是大阅读器帮助最大的部分。树词汇封闭、块级而非事件级、缺记谱节拍与说话人分离等信号级专家,是剩余差距的主要来源。推理开销上,每 MMAU 题本文需较多乘加与时间,高于同级稠密音频模型,其中一半来自 Whisper,阅读器两遍占大头,6 个路由编码器虽小但串行增加耗时。训练省不等于推理省,这是采用前必须接受的代价。
复现第一步做什么,需要哪些资源
先准备冻结组件:CLAP、BEATs、MuQ-MuLan、WavLM-SV、emotion2vec、Whisper 等编码器与 Whisper-large-v3 转写,以及选定的文本阅读器如 Qwen2.5-7B。再按附录切 3 秒块、1.5 秒步长抽嵌入并缓存,训练各属性小头时只更新头与小主干,掩码损失忽略无标注属性,阈值在留出训练集上按精确率与 F1 拟合。评测时缓存树加转写文本,同一份文本可给 26 个阅读器复用,阅读器用带 beta 0.1 的字母概率打分,模板在每套题 100 道开发题上选定后锁定。
数据上树池 4054 片来自 19 源,路由人类标签约 0.2M 片,AudioSet 测试与 FSD50K 评估集留出,评测音频不进训练。新域复现需保证训练与评测录制者不重叠并过滤 CLAP 相似度 0.95 以上片段,每类 k 条加 2000 个无域块训 none 类。作者资源方面,项目页链接本次可达但属于第三方证明,只说明论文提到该页,不证明代码权重已开源;HuggingFace 模型链接本次未能确认可达,不能写成已公开可下载。是否可运行需等拿到代码与检查点后才能确认,本文的三件事要分开核实。
什么时候值得尝试,还缺哪项验证
当任务以声音与说话人身份为核心、需要向人展示证据、或需低成本加新域时值得尝试,例如动物、情感、性别、乐器体裁等身份题,以及每类只有几条标注的物种识别。此时小头加冻结编码器远比微调整个音频大模型省参数,且换更强文本模型无需重训。当任务重度依赖计数、事件顺序、整体场景与乐理结构时要谨慎,这些正是本文落后最多的部分,需补事件级节点与信号级专家。
还缺的验证包括新域上超越身份识别的推理题、更小转写模型替换 Whisper 后的精度成本曲线、编码器并行后的真实延迟,以及临床等高风险场景的专项评估,论文明确未做医疗验证。关键超参数要保留:块 3 秒步长 1.5 秒、区域门 0.5、情感多取阈值 0.2、音乐多选 0.3、新域 none 阈值 0.995、阅读器 beta 0.1。信息条件也要记住:阅读器只见文字不见音频,时间戳与概率留在遍历轨迹而不进提示,语言在有转写时从文本预测。误解澄清:训练参数少不等于推理便宜,本文恰相反;思维链缺失不是缺推理,而是把推理搬到可读输入上,错误定位因此变容易,但阅读器仍会盲从错节点,不会自动纠错。
📎 论文与评分元数据
排名:前50% | 文档类型:方法研究 | arXiv 原文
⚖️ 评分明细
评分属于系统判断,不是论文实验结果;八维数值与总分见页首,原始审计记录保留在后端。
评分规则:type-aware-v1
评分模型:muse-spark-1.3-contributor
评分请求协议:openai_responses